Знайомство з scikit-learn
У попередній статті ми розглянули теоретичні основи лінійної регресії: формули, градієнтний спуск, функцію втрат. Тепер настав час перейти від теорії до практики та навчитися будувати моделі машинного навчання за допомогою найпопулярнішої бібліотеки Python — scikit-learn.
Excel + калькулятор vs scikit-learn
Уявіть, що вам потрібно обчислити лінійну регресію для датасету з 1000 рядків та 10 ознак. Якби ви робили це "вручну", код виглядав би приблизно так:
import numpy as np

def fit_linear_regression(X, y, learning_rate=0.01, epochs=1000):
    """Навчання лінійної регресії через градієнтний спуск"""
    n_samples, n_features = X.shape

    # Ініціалізація параметрів
    weights = np.zeros(n_features)
    bias = 0

    # Градієнтний спуск
    for epoch in range(epochs):
        # Передбачення
        y_pred = np.dot(X, weights) + bias

        # Обчислення градієнтів
        dw = (1 / n_samples) * np.dot(X.T, (y_pred - y))
        db = (1 / n_samples) * np.sum(y_pred - y)

        # Оновлення параметрів
        weights -= learning_rate * dw
        bias -= learning_rate * db

    return weights, bias

def predict(X, weights, bias):
    """Передбачення"""
    return np.dot(X, weights) + bias

# Використання
X_train = np.array([[1], [2], [3], [4], [5]])
y_train = np.array([2, 4, 6, 8, 10])

weights, bias = fit_linear_regression(X_train, y_train)
predictions = predict(np.array([[6], [7]]), weights, bias)
from sklearn.linear_model import LinearRegression

# Використання
X_train = np.array([[1], [2], [3], [4], [5]])
y_train = np.array([2, 4, 6, 8, 10])

model = LinearRegression()
model.fit(X_train, y_train)
predictions = model.predict([[6], [7]])
Різниця очевидна: 3 рядки замість 50! При цьому scikit-learn працює швидше (оптимізований C-код), надійніше (перевірений мільйонами користувачів) і зручніше (єдиний інтерфейс для всіх алгоритмів).
Аналогія: scikit-learn — це як кухонний комбайн для машинного навчання. Замість того, щоб різати, місити та збивати вручну (писати алгоритми з нуля), ви просто натискаєте кнопку
.fit(). Усередині — та сама математика, але упакована у зручний інструмент.
Що таке scikit-learn?
scikit-learn (sklearn) — найпопулярніша бібліотека машинного навчання для Python. Вона надає простий та ефективний інструментарій для аналізу даних та побудови прогнозних моделей.
🎯 Основні переваги
- Єдиний API для всіх алгоритмів
- Open-source з активною спільнотою
- Відмінна документація з прикладами
- Швидкість (оптимізований C/Cython код)
- Стабільність (v1.0+ — зворотна сумісність)
🔧 Що входить у scikit-learn?
- Алгоритми регресії та класифікації
- Методи кластеризації
- Інструменти preprocessing (масштабування, кодування)
- Метрики оцінки моделей
- Cross-validation та підбір гіперпараметрів
- Інтеграція з NumPy, pandas, matplotlib
Встановлення scikit-learn
pip install scikit-learn
uv pip install scikit-learn
poetry add scikit-learn
Після встановлення перевірте версію:
import sklearn

print(f"scikit-learn version: {sklearn.__version__}")
sparse_output=False замість застарілого sparse=False у OneHotEncoder), додано нові алгоритми та виправлено помилки.Філософія scikit-learn — універсальний API
Ключова ідея scikit-learn — єдиний інтерфейс для всіх моделей. Будь-яка модель машинного навчання (від простої лінійної регресії до складного градієнтного бустингу) має три основні методи:
.fit(X, y)
.predict(X)
.score(X, y)
Це означає, що навчившись працювати з LinearRegression, ви автоматично знаєте, як працювати з Ridge, RandomForest, GradientBoosting та іншими моделями — API однаковий!
Аналогія: всі автомобілі мають руль, педалі газу та гальма, коробку передач — незалежно від марки. Так само всі моделі scikit-learn мають
.fit(),.predict(),.score()— незалежно від алгоритму.
Додатково для трансформерів (preprocessing: scaler, encoder) є методи:
.transform(X)— перетворити дані (після навчання).fit_transform(X)— навчити + перетворити за один виклик
Перша модель — ідеальні дані
Почнемо з найпростішого прикладу: ідеальна лінійна залежність y = 2x. Створимо дані вручну та навчимо модель їх розпізнати.
Формат даних у scikit-learn
X (ознаки) буде двовимірним масивом (матрицею), навіть якщо у вас лише одна ознака. Це пов'язано з тим, що scikit-learn розроблений для роботи з багатовимірними даними.- ✅ Правильно:
X = [[1], [2], [3]]— двовимірний масив (3 рядки, 1 стовпець) - ❌ Неправильно:
X = [1, 2, 3]— одновимірний масив (викличе помилку)
from sklearn.linear_model import LinearRegression
import numpy as np

# Створення даних: y = 2x
X = np.array([[1], [2], [3], [4], [5]])
y = np.array([2, 4, 6, 8, 10])

print("X (ознаки):")
print(X)
print(f"\nФорма X: {X.shape}")  # (5, 1) — 5 рядків, 1 стовпець
print(f"\ny (цільова змінна): {y}")
# Створити модель
model = LinearRegression()

# Навчити модель (знайти оптимальні w та b)
model.fit(X, y)

print("Модель навчена!")
print(f"Коефіцієнт (w): {model.coef_}")      # Очікуємо [2.]
print(f"Зсув (b): {model.intercept_}")       # Очікуємо 0.0
y = 2 * x + 0. Коефіцієнт w = 2 означає, що при збільшенні x на 1, значення y збільшується на 2. Зсув b = 0, тому що пряма проходить через початок координат.Крок 3: Передбачення для нових даних
Тепер використаємо навчену модель для передбачення значень y для нових x:
# Передбачити значення для x = 6 та x = 7
X_new = np.array([[6], [7]])
predictions = model.predict(X_new)

print("Передбачення:")
for x_val, y_pred in zip(X_new, predictions):
    print(f"  x = {x_val[0]} → y = {y_pred:.1f}")
Модель правильно передбачила: 6 * 2 = 12 та 7 * 2 = 14. Це підтверджує, що вона зрозуміла залежність y = 2x.
Візуалізація результатів
Побудуємо графік, щоб наочно побачити, як модель "проводить лінію" через дані:
import matplotlib.pyplot as plt

# Створення графіка
plt.figure(figsize=(10, 6))

# Вихідні дані
plt.scatter(X, y, color='dodgerblue', s=120, label='Вихідні дані', zorder=3, edgecolor='black')

# Лінія регресії
X_line = np.linspace(0, 8, 100).reshape(-1, 1)
y_line = model.predict(X_line)
plt.plot(X_line, y_line, color='crimson', linewidth=2.5, label='Лінія регресії', zorder=2)

# Передбачення для нових точок
plt.scatter(X_new, predictions, color='limegreen', s=180, marker='*',
            label='Передбачення', zorder=4, edgecolor='black')

# Оформлення
plt.xlabel('X', fontsize=12)
plt.ylabel('y', fontsize=12)
plt.title('Перша модель scikit-learn: y = 2x', fontsize=14, fontweight='bold')
plt.legend(fontsize=10)
plt.grid(alpha=0.3, linestyle='--')
plt.xlim(0, 8)
plt.ylim(0, 16)
plt.tight_layout()
plt.show()
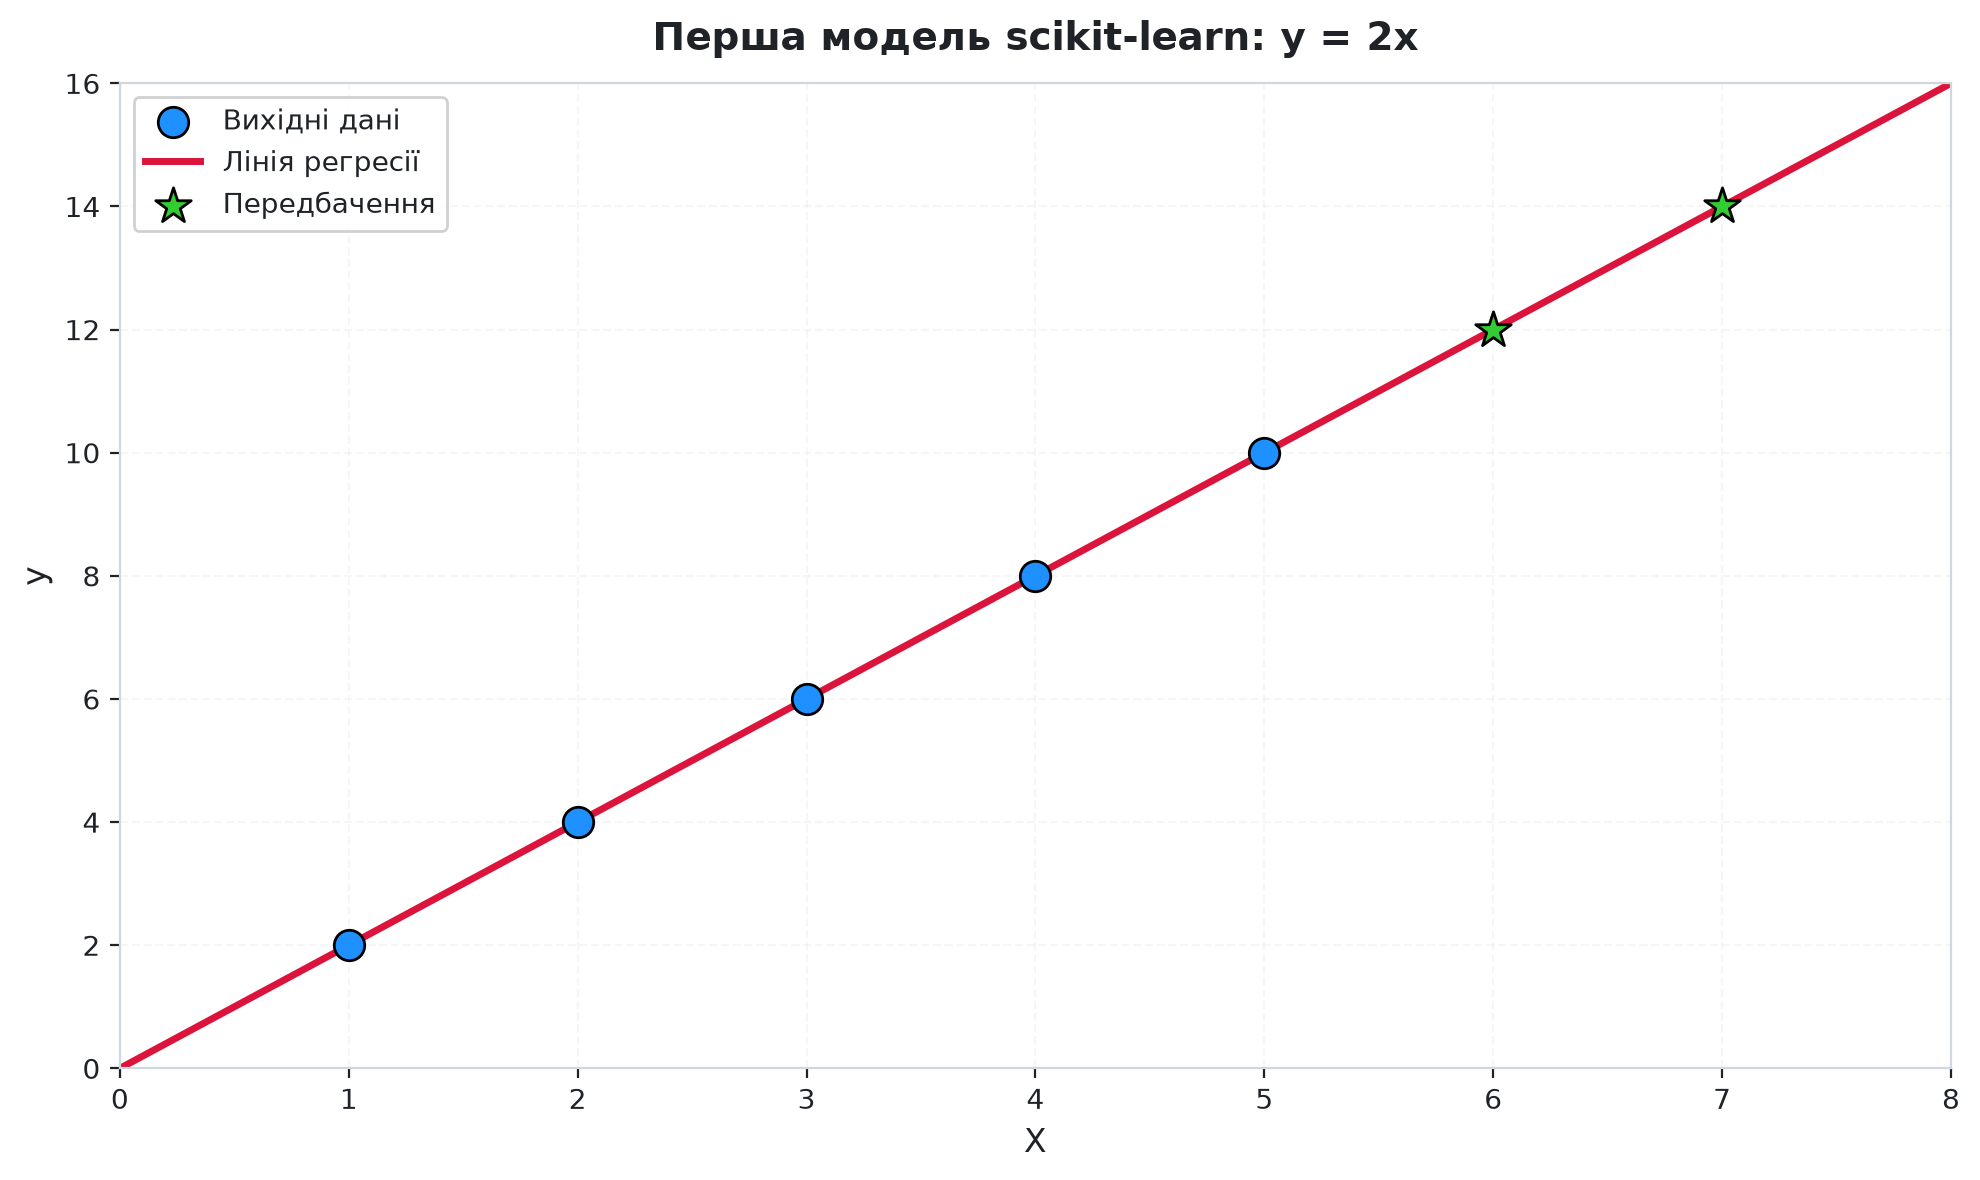
- Сині точки — вихідні дані, на яких навчалась модель
- Червона лінія — лінія регресії
y = 2x, знайдена моделлю - Зелені зірочки — передбачення для нових точок (x=6, x=7)
Метрики якості моделі
Як зрозуміти, наскільки добре модель працює? Для цього використовуються метрики якості. У попередній статті ми розглянули три основні метрики для регресії:
- MAE (Mean Absolute Error) — середня абсолютна помилка
- MSE (Mean Squared Error) — середня квадратична помилка
- R² (R-squared) — коефіцієнт детермінації
Метод .score() — швидка оцінка
Найпростіший спосіб оцінити модель — метод .score(X, y), який повертає R²:
# Оцінка якості на тренувальних даних
r2 = model.score(X, y)

print(f"R² (коефіцієнт детермінації): {r2:.4f}")
R² = 1.0 означає ідеальну модель — вона на 100% пояснює варіацію даних. Це логічно, адже дані ідеальні (без шуму), і модель точно знайшла закономірність.
Обчислення всіх трьох метрик
Для детальної оцінки можна обчислити всі три метрики окремо:
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score

# Передбачення на тренувальних даних
y_pred = model.predict(X)

# Обчислення метрик
mae = mean_absolute_error(y, y_pred)
mse = mean_squared_error(y, y_pred)
r2 = r2_score(y, y_pred)

print("Метрики якості:")
print(f"  MAE:  {mae:.6f}")
print(f"  MSE:  {mse:.6f}")
print(f"  R²:   {r2:.6f}")
Усі метрики підтверджують: модель ідеальна. MAE та MSE дорівнюють нулю (жодної помилки), R² дорівнює 1.0 (пояснює 100% варіації).
- MAE = 0 → в середньому помилка 0 (ідеально)
- MSE = 0 → квадратична помилка 0 (ідеально)
- R² = 1.0 → модель пояснює 100% варіації (ідеально)
- R² > 0.7 — добра модель
- R² > 0.5 — прийнятна модель
- R² < 0.3 — погана модель (потрібно покращувати)
Приклад з реальнішими даними — Зріст vs Вага
Тепер розглянемо приклад, ближчий до реальності: залежність ваги людини від зросту. Дані містять шум (індивідуальні відмінності), тому модель не буде ідеальною.
import numpy as np
from sklearn.linear_model import LinearRegression

# Дані: 10 людей
heights = np.array([[150], [160], [165], [170], [175],
                    [180], [185], [190], [195], [200]])  # см
weights = np.array([50, 58, 62, 68, 73, 78, 83, 88, 93, 98])  # кг

print(f"Кількість зразків: {len(heights)}")
print(f"Діапазон зросту: {heights.min()} - {heights.max()} см")
print(f"Діапазон ваги: {weights.min()} - {weights.max()} кг")
# Створити та навчити модель
model = LinearRegression()
model.fit(heights, weights)

print("Модель навчена!")
print(f"Коефіцієнт (w): {model.coef_[0]:.4f} кг/см")
print(f"Зсув (b): {model.intercept_:.4f} кг")
print(f"\nРівняння: вага = {model.coef_[0]:.4f} * зріст + {model.intercept_:.4f}")
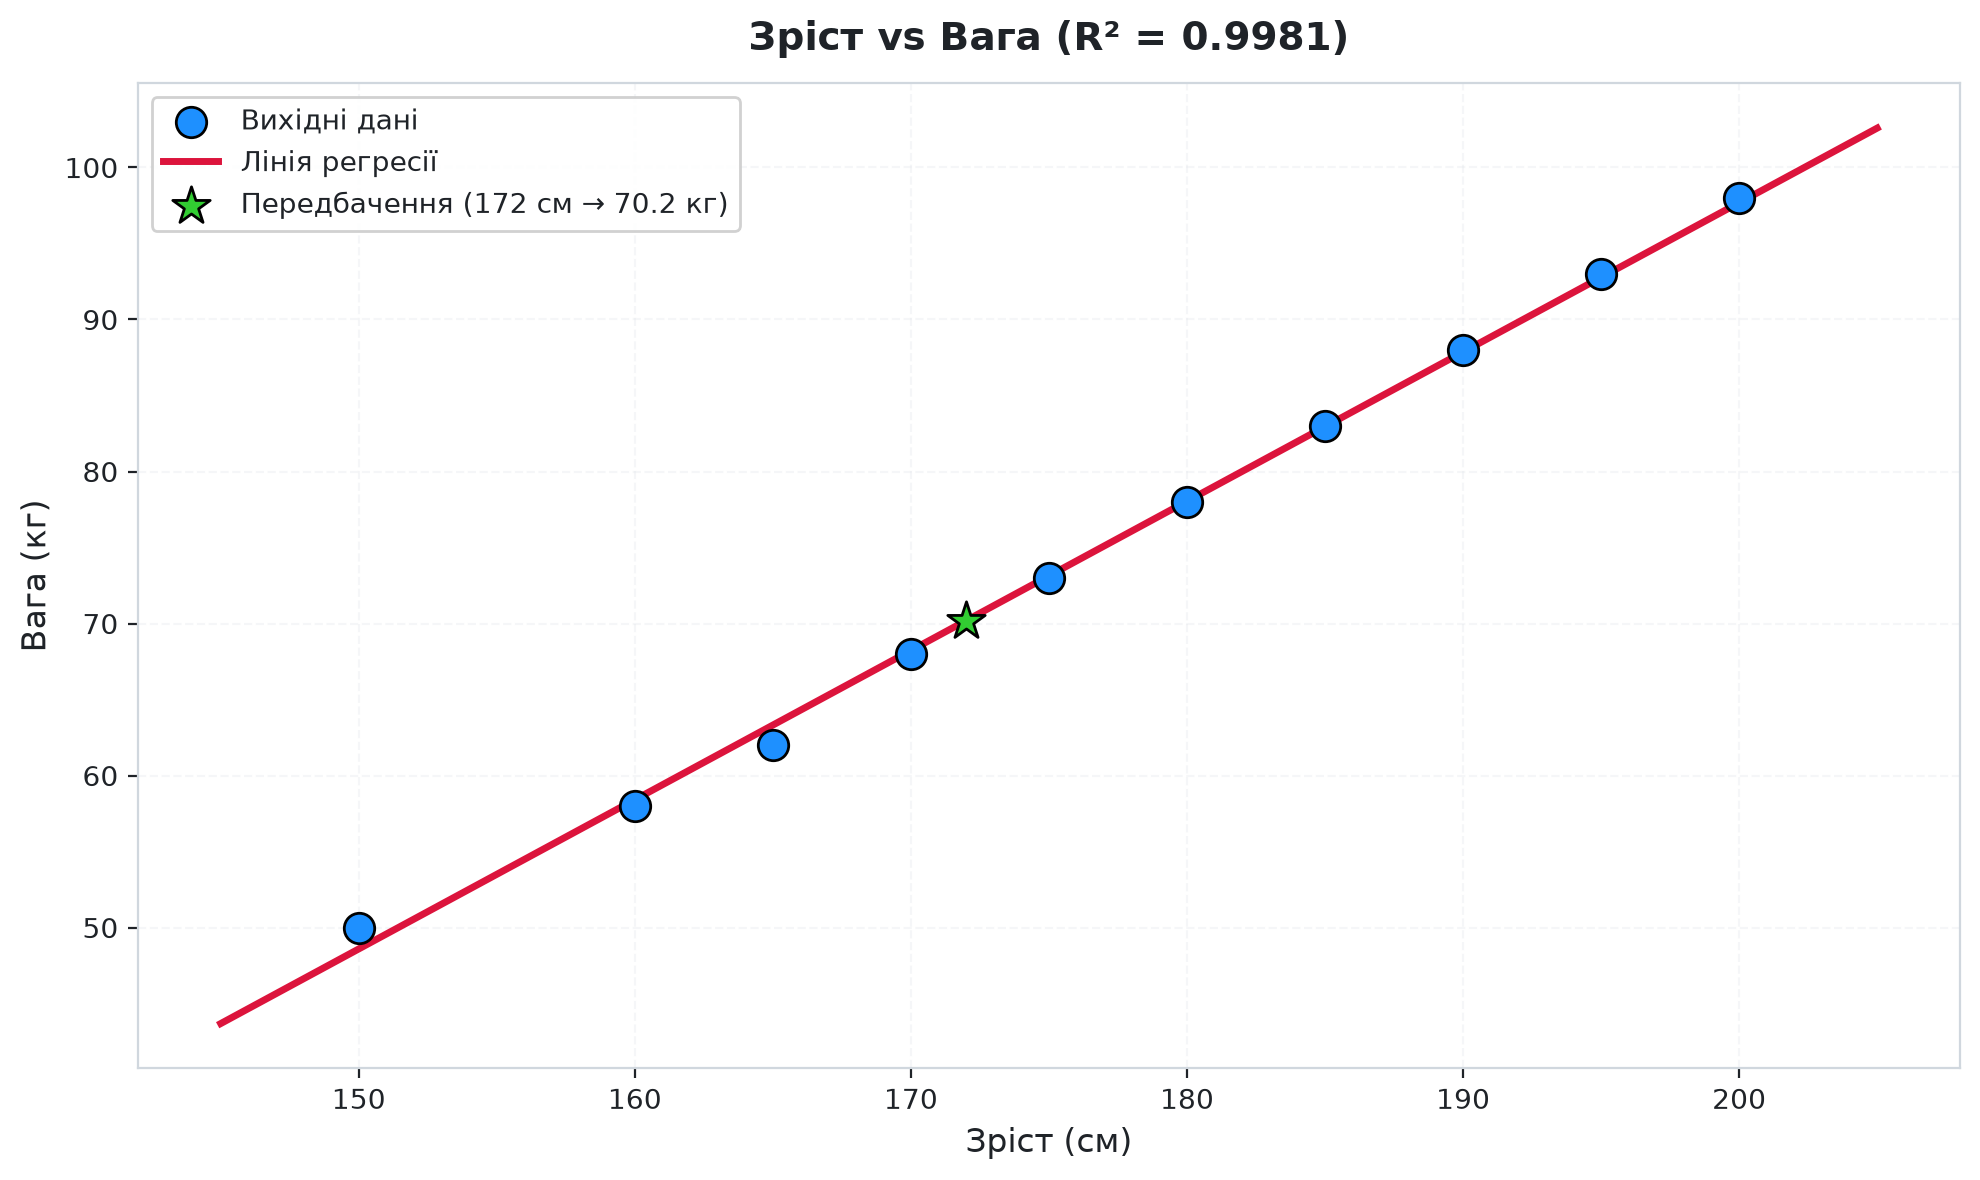
Модель знайшла залежність: вага ≈ 0.98 × зріст - 98.7. Це означає, що зі збільшенням зросту на 1 см вага зростає приблизно на 0.98 кг.
Передбачення для нового зросту
# Передбачити вагу для зросту 172 см
new_height = np.array([[172]])
predicted_weight = model.predict(new_height)

print(f"Зріст: {new_height[0][0]} см")
print(f"Передбачена вага: {predicted_weight[0]:.2f} кг")
Оцінка якості моделі
from sklearn.metrics import mean_absolute_error, r2_score

# Передбачення на всіх даних
y_pred = model.predict(heights)

# Метрики
mae = mean_absolute_error(weights, y_pred)
r2 = model.score(heights, weights)

print(f"R²:  {r2:.4f}")
print(f"MAE: {mae:.4f} кг")
print(f"\nІнтерпретація:")
print(f"  - Модель пояснює {r2*100:.2f}% варіації ваги")
print(f"  - Середня помилка: ±{mae:.2f} кг")
Візуалізація моделі
import matplotlib.pyplot as plt

# Графік
plt.figure(figsize=(10, 6))

# Вихідні дані
plt.scatter(heights, weights, color='dodgerblue', s=120,
            label='Вихідні дані', zorder=3, edgecolor='black')

# Лінія регресії
heights_line = np.linspace(145, 205, 100).reshape(-1, 1)
weights_line = model.predict(heights_line)
plt.plot(heights_line, weights_line, color='crimson', linewidth=2.5,
         label='Лінія регресії', zorder=2)

# Нове передбачення
plt.scatter(new_height, predicted_weight, color='limegreen', s=200, marker='*',
            label=f'Передбачення ({new_height[0][0]} см → {predicted_weight[0]:.1f} кг)',
            zorder=4, edgecolor='black')

# Оформлення
plt.xlabel('Зріст (см)', fontsize=12)
plt.ylabel('Вага (кг)', fontsize=12)
plt.title(f'Зріст vs Вага (R² = {r2:.4f})', fontsize=14, fontweight='bold')
plt.legend(fontsize=10)
plt.grid(alpha=0.3, linestyle='--')
plt.tight_layout()
plt.show()
Порівняння: ручна реалізація vs scikit-learn
Підсумуємо переваги використання scikit-learn замість написання алгоритмів з нуля:
| Аспект | Ручна реалізація | scikit-learn |
|---|---|---|
| Кількість коду | ~50 рядків | 3 рядки (.fit(), .predict(), .score()) |
| Складність | Потрібна математика (градієнти, матриці) | Не потрібна (абстрагована) |
| Час розробки | Години (написання + налагодження) | Хвилини |
| Швидкість виконання | Повільно (Python loops) | Швидко (C/Cython, оптимізовано) |
| Надійність | Легко зробити помилку | Перевірено мільйонами користувачів |
| Підтримка | Самостійна | Велика спільнота, документація |
| Інші алгоритми | Кожен треба писати з нуля | Доступно 50+ алгоритмів з тим самим API |
- Для навчання — щоб зрозуміти, як працює алгоритм (саме це ми робили у статті 3.1)
- Для дослідження — якщо потрібен унікальний алгоритм, якого немає в scikit-learn
- Для оптимізації — якщо стандартна реалізація не підходить під специфічні вимоги
Що далі?
У цій статті ми познайомились з основами scikit-learn:
✅ Встановили бібліотеку та перевірили версію
✅ Зрозуміли універсальний API: .fit(), .predict(), .score()
✅ Побудували першу модель на синтетичних даних
✅ Навчились обчислювати метрики якості (MAE, MSE, R²)
✅ Візуалізували результати з matplotlib
У наступній статті ми перейдемо до роботи з реальним датасетом Housing Prices — датасетом про ціни на житло з Kaggle. Це змагання, в якому брали участь тисячі Data Scientists. Ми:
- Завантажимо датасет з 80 ознаками та 1460 будинками
- Проведемо Exploratory Data Analysis (EDA) — розвідувальний аналіз даних
- Виявимо пропуски, викиди, кореляції між ознаками
- Побудуємо візуалізації для розуміння даних
- Підготуємо базу для побудови моделі у наступних статтях
Практика
Завдання: Створіть датасет з 5 точок "Площа квартири (м²) → Ціна ($)", навчіть модель LinearRegression, передбачіть ціну для площі 65 м² та виведіть R².
Підказка:
X = np.array([[40], [50], [60], [70], [80]])  # площа
y = np.array([30000, 40000, 50000, 60000, 70000])  # ціна
Завдання: Завантажте датасет California Housing з sklearn (from sklearn.datasets import fetch_california_housing), навчіть модель на всіх ознаках, оцініть R² та MAE.
Підказка:
from sklearn.datasets import fetch_california_housing

data = fetch_california_housing()
X, y = data.data, data.target
# Далі: model.fit(X, y), model.score(X, y), тощо
Завдання: Створіть власний датасет (10+ точок) для будь-якої залежності на ваш вибір:
- Температура повітря → Продаж морозива
- Години навчання → Оцінка на іспиті
- Відстань до роботи → Час у дорозі
Побудуйте модель, візуалізуйте результати з matplotlib (scatter plot + лінія регресії), обчисліть R², MAE. Напишіть інтерпретацію результатів.
Резюме
scikit-learn
Estimator
.fit(), .predict(), .score()..fit(X, y)
.predict(X)
.score(X, y)
MAE
MSE
R² (R-squared)
Практичні завдання та резюме модуля
Три рівні практичних завдань для закріплення знань з лінійної регресії, підсумкові картки ключових концепцій
Exploratory Data Analysis датасету Housing Prices
Розвідувальний аналіз даних реального датасету про ціни на житло. Виявлення пропусків, кореляцій та проблем перед побудовою моделі.