Практичні завдання та резюме модуля
Практичні завдання та резюме модуля
🎯 Мета підрозділу
- Закріпити знання через практичні завдання
- Пройти три рівні складності: базовий, середній, просунутий
- Систематизувати вивчений матеріал через резюме
- Підготуватися до наступного модуля
🎓 Структура завдань
- Рівень 1 (базовий): основні операції, простий код
- Рівень 2 (середній): алгоритмічні задачі, аналіз
- Рівень 3 (просунутий): комплексні проєкти, дослідження
Рівень 1: Базові завдання
Ці завдання перевіряють розуміння основних концепцій.
Завдання 1.1: Обчислення передбачення вручну
Дано модель лінійної регресії з параметрами:
- Завантаження... ($/м²)
- Завантаження... ($)
Питання:
- Обчисліть передбачену ціну для квартири площею 65 м²
- Обчисліть передбачену ціну для квартири площею 120 м²
- На скільки зросте ціна при збільшенні площі з 50 до 51 м²?
Розв'язок:
Формула: Завантаження...
- Для 65 м²:
- Завантаження... $
- Для 120 м²:
- Завантаження... $
- Зростання ціни при +1 м²:
- Завантаження... $
- Завантаження... $
- Різниця = Завантаження... $ (саме коефіцієнт Завантаження...!)
Висновок: коефіцієнт Завантаження... показує, на скільки змінюється Завантаження... при зміні Завантаження... на 1 одиницю.
Завдання 1.2: Обчислення метрик якості
Дано три спостереження:
| Реальна ціна (Завантаження...) | Передбачення (Завантаження...) |
|---|---|
| 30 000 $ | 31 000 $ |
| 45 000 $ | 44 000 $ |
| 60 000 $ | 58 000 $ |
Завдання: обчисліть вручну (з калькулятором):
- MAE (Mean Absolute Error)
- MSE (Mean Squared Error)
- RMSE (Root Mean Squared Error)
Розв'язок:
Крок 1: Обчислюємо залишки (residuals):
| Завантаження... | Завантаження... | Завантаження... | Завантаження... | Завантаження... |
|---|---|---|---|---|
| 30 000 | 31 000 | -1 000 | 1 000 | 1 000 000 |
| 45 000 | 44 000 | +1 000 | 1 000 | 1 000 000 |
| 60 000 | 58 000 | +2 000 | 2 000 | 4 000 000 |
Крок 2: Обчислюємо метрики:
- MAE = Завантаження... $
- MSE = Завантаження... $²
- RMSE = Завантаження... $
Інтерпретація:
- MAE: в середньому модель помиляється на 1 333 $
- RMSE: із врахуванням «штрафу» за великі помилки — 1 414 $
Завдання 1.3: Реалізація передбачення на NumPy
Напишіть функцію predict(X, w, b), яка приймає:
- X: масив ознак (одна або кілька)
- w: вага або вектор вагів
- b: bias
і повертає передбачення Завантаження....
import numpy as np

def predict(X, w, b):
    """
    Обчислює передбачення лінійної регресії.

    Параметри:
        X: np.array, форма (n_samples, n_features) або (n_samples,)
        w: np.array, форма (n_features,) або скаляр
        b: float, bias

    Повертає:
        np.array, форма (n_samples,) — передбачення
    """
    # Якщо X одновимірний (проста регресія)
    if X.ndim == 1:
        return w * X + b

    # Якщо X двовимірний (множинна регресія)
    return X @ w + b  # або np.dot(X, w) + b

# Тест 1: проста регресія
X1 = np.array([50, 70, 90])
w1, b1 = 500, 10000
print("Тест 1 (проста регресія):")
print(f"X = {X1}")
print(f"ŷ = {predict(X1, w1, b1)}")

# Тест 2: множинна регресія
X2 = np.array([
    [70, 2],    # 70 м², 2 кімнати
    [100, 3],   # 100 м², 3 кімнати
])
w2 = np.array([500, 3000])
b2 = 10000
print("\nТест 2 (множинна регресія):")
print(f"X =\n{X2}")
print(f"ŷ = {predict(X2, w2, b2)}")
Очікуваний вивід:
Тест 1 (проста регресія):
X = [50 70 90]
ŷ = [35000 45000 55000]

Тест 2 (множинна регресія):
X =
[[ 70   2]
 [100   3]]
ŷ = [51000 69000]
Рівень 2: Середні завдання
Ці завдання вимагають глибшого розуміння та написання більшого коду.
Завдання 2.1: Реалізація градієнтного спуску для простої регресії
Реалізуйте функцію gradient_descent_simple(X, y, lr, epochs), яка:
- Ініціалізує w та b нулями
- Виконує
epochsітерацій градієнтного спуску - Повертає фінальні w, b та історію втрат
Формули градієнтів для однієї змінної:
import numpy as np
import matplotlib.pyplot as plt

def gradient_descent_simple(X, y, lr=0.01, epochs=1000):
    """
    Градієнтний спуск для простої лінійної регресії.

    Параметри:
        X: np.array (n_samples,) — одна ознака
        y: np.array (n_samples,) — ціль
        lr: float — learning rate
        epochs: int — кількість епох

    Повертає:
        w, b, loss_history
    """
    n = len(X)
    w, b = 0.0, 0.0
    loss_history = []

    for epoch in range(epochs):
        # 1. Передбачення
        y_pred = w * X + b

        # 2. Обчислення втрат (MSE)
        loss = np.mean((y - y_pred) ** 2)
        loss_history.append(loss)

        # 3. Градієнти
        dw = -(2/n) * np.sum(X * (y - y_pred))
        db = -(2/n) * np.sum(y - y_pred)

        # 4. Оновлення параметрів
        w = w - lr * dw
        b = b - lr * db

    return w, b, loss_history

# Тестові дані
rng = np.random.default_rng(seed=42)
X = np.array([50, 60, 70, 80, 90, 100])
y = 500 * X + 10000 + rng.normal(0, 2000, len(X))

# Навчання
w_final, b_final, losses = gradient_descent_simple(X, y, lr=0.0001, epochs=1000)

print(f"Фінальні параметри:")
print(f"  w = {w_final:.2f}")
print(f"  b = {b_final:.2f}")
print(f"  Фінальний Loss = {losses[-1]:.2f}")

# Візуалізація
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 5))

# Крива навчання
ax1.plot(losses, linewidth=2)
ax1.set_title('Крива навчання')
ax1.set_xlabel('Епоха')
ax1.set_ylabel('MSE Loss')
ax1.grid(True, alpha=0.3)

# Модель
ax2.scatter(X, y, label='Дані', s=100)
ax2.plot(X, w_final * X + b_final, 'r-', linewidth=2, label=f'ŷ = {w_final:.0f}x + {b_final:.0f}')
ax2.set_title('Навчена модель')
ax2.set_xlabel('X')
ax2.set_ylabel('y')
ax2.legend()
ax2.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
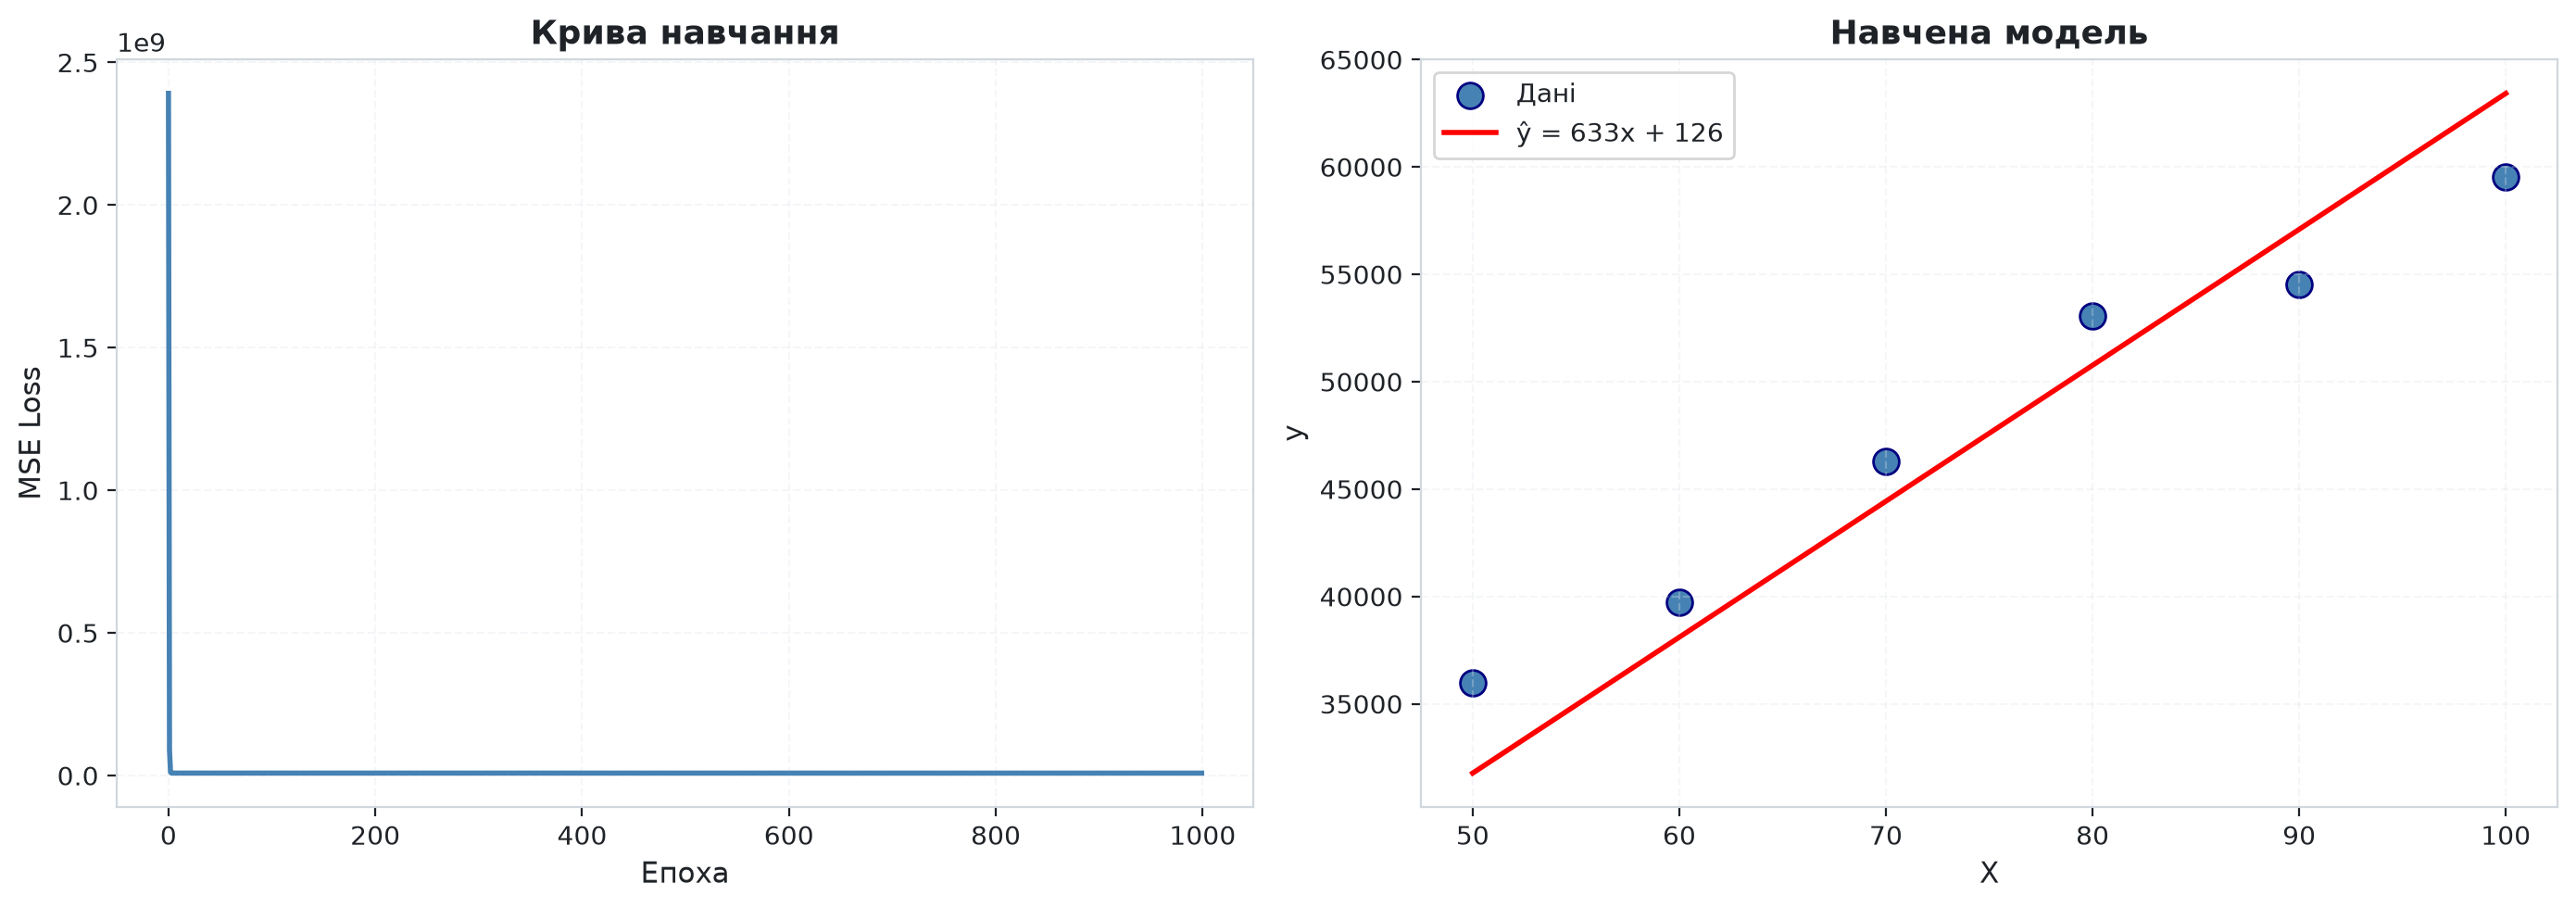
Завдання 2.2: Порівняння різних learning rates
Використайте функцію з попереднього завдання, щоб порівняти три значення learning rate:
- Завантаження... (дуже малий)
- Завантаження... (оптимальний)
- Завантаження... (великий)
Побудуйте графік кривих навчання (Loss по епохах) для всіх трьох випадків на одному графіку.
Питання для аналізу:
- Який Завантаження... збігається найшвидше?
- Чи є Завантаження..., що призводить до розбіжності (втрати зростають)?
- Як обрати оптимальний learning rate для нових даних?
Завдання 2.3: Дослідження реального датасету
Завантажте датасет Boston Housing або California Housing з scikit-learn:
from sklearn.datasets import fetch_california_housing

data = fetch_california_housing(as_frame=True)
df = data.frame
Завдання:
- Дослідіть дані:
df.head(),df.info(),df.describe() - Побудуйте кореляційну матрицю та heatmap (seaborn)
- Оберіть одну найкорельованішу ознаку з ціною
- Навчіть просту лінійну регресію (одна ознака → ціна)
- Обчисліть MAE, RMSE, R²
- Побудуйте scatter plot з лінією регресії
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.datasets import fetch_california_housing
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score

# 1. Завантаження
data = fetch_california_housing(as_frame=True)
df = data.frame

# 2. EDA (Exploratory Data Analysis)
print(df.head())
print("\nКореляція з ціною:")
print(df.corr()['MedHouseVal'].sort_values(ascending=False))

# 3. Обираємо ознаку з найвищою кореляцією
# ... ваш код ...

# 4. Train/Test split
# ... ваш код ...

# 5. Навчання моделі
# ... ваш код ...

# 6. Метрики та візуалізація
# ... ваш код ...
Рівень 3: Просунуті завдання
Ці завдання вимагають комплексного підходу та творчості.
Завдання 3.1: Реалізація Mini-Batch Gradient Descent
Реалізуйте варіант градієнтного спуску, де градієнт обчислюється не на всіх даних (Batch GD), а на випадковій підмножині розміром batch_size (наприклад, 32 зразки).
Алгоритм:
- На кожній епосі перемішайте дані (
rng.shuffleабо індексиrng.permutation) - Розділіть на міні-батчі по
batch_sizeзразків - Для кожного батчу обчисліть градієнт та оновіть параметри
- Повторіть для всіх епох
Порівняйте:
- Batch GD (весь датасет)
- Mini-Batch GD (batch_size = 32)
- Stochastic GD (batch_size = 1)
Побудуйте криві навчання для всіх трьох методів.
Завдання 3.2: Поліноміальна регресія
Дослідіть випадок, коли дані мають нелінійну залежність.
Кроки:
- Згенеруйте дані з квадратичною залежністю:
rng = np.random.default_rng(seed=42) X = np.linspace(0, 10, 100) y = 2*X**2 - 5*X + 3 + rng.normal(0, 10, 100) - Навчіть три моделі:
- Лінійну регресію (степінь 1)
- Поліноміальну регресію степеня 2
- Поліноміальну регресію степеня 5
- Побудуйте всі три моделі на одному графіку
- Порівняйте R² для кожної моделі
Підказка: використовуйте PolynomialFeatures з scikit-learn:
from sklearn.preprocessing import PolynomialFeatures

poly = PolynomialFeatures(degree=2)
X_poly = poly.fit_transform(X.reshape(-1, 1))

model = LinearRegression()
model.fit(X_poly, y)
Завдання 3.3: Проєкт «Передбачення зарплати за стажем»
Мета: створити повноцінний ML-проєкт з нуля.
Датасет: знайдіть або створіть дані про зарплати та стаж (можна згенерувати синтетично або використати Kaggle).
Етапи проєкту:
- Збір та аналіз даних
- Завантаження даних
- EDA: розподіли, викиди, кореляції
- Візуалізація scatter plot
- Підготовка даних
- Обробка пропусків (якщо є)
- Розділення на train/test (80/20)
- Нормалізація (StandardScaler)
- Навчання моделі
- Реалізувати градієнтний спуск з нуля
- Порівняти з scikit-learn LinearRegression
- Підібрати оптимальний learning rate
- Оцінка якості
- Обчислити MAE, RMSE, R²
- Побудувати residual plot (залишки vs передбачення)
- Діагностика: чи є систематичні помилки?
- Візуалізація результатів
- Scatter plot з лінією регресії
- Крива навчання (Loss по епохах)
- Порівняння реальних та передбачених значень
- Звіт
- Документ (Markdown або Jupyter Notebook) з описом кожного етапу
- Висновки: чи можна використовувати модель в production?
- Код чистий, коментований, структурований
- Всі графіки мають заголовки, підписи осей, легенди
- Є чіткі висновки після кожного етапу
- Порівняння кількох підходів (власна реалізація vs scikit-learn)
Додаткові ресурси для практики
📊 Датасети для практики
- Kaggle Datasets: kaggle.com/datasets
- House Prices (Advanced Regression)
- Car Price Prediction
- Salary Prediction
- UCI Machine Learning Repository: класичні датасети
- Boston Housing
- Auto MPG
- Wine Quality
- Scikit-learn datasets:
from sklearn.datasets import load_*- California Housing
- Diabetes
- Linnerud
🛠️ Інструменти та бібліотеки
- NumPy: векторні обчислення
- Pandas: робота з табличними даними
- Matplotlib / Seaborn: візуалізація
- Scikit-learn: ML алгоритми
- Jupyter Notebook: інтерактивні експерименти
📚 Додаткове читання
- Документація scikit-learn: LinearRegression
- Khan Academy: Statistics & Probability
- 3Blue1Brown (YouTube): Linear Algebra
- StatQuest (YouTube): Regression Series
Підсумкове резюме модуля
📌 Регресійна задача
- Регресія — передбачення неперервного числового значення
- Відмінність від класифікації: число vs категорія
- Приклади: ціна квартири, зарплата, температура
📐 Лінійна регресія
- Формула: Завантаження... (для 1 ознаки)
- Завантаження... (weight) — нахил, вплив ознаки на результат
- Завантаження... (bias) — зсув, базове значення
- Геометрія: пряма лінія (1D), площина (2D), гіперплощина (nD)
📊 Метрики якості
- MAE — середня абсолютна помилка (інтуїтивна)
- MSE — середня квадратична помилка (штрафує великі помилки)
- RMSE — корінь з MSE (зручні одиниці)
- Завантаження... — частка поясненої варіації (0–1, нормалізована)
⚙️ Градієнтний спуск
- Функція втрат — міра помилки моделі (MSE)
- Градієнт — вектор похідних, напрямок зростання
- Алгоритм: рухатися проти градієнта до мінімуму
- Learning rate — розмір кроку (критичний гіперпараметр)
🔢 Множинна регресія
- Формула: Завантаження...
- Векторна форма: Завантаження...
- Матрична форма: Завантаження... (для батчу)
- Feature importance — які ознаки найвпливовіші
⚠️ Обмеження та застереження
- Працює лише для лінійних залежностей
- Чутлива до викидів (outliers)
- Мультиколінеарність — проблема корельованих ознак
- Припущення: нормальність залишків, гомоскедастичність
Перевірочні питання
Перед переходом до наступного модуля переконайтеся, що ви можете відповісти на ці питання:
Регресія — передбачення неперервного числового значення (ціна, температура, вага).
Класифікація — передбачення категорії з фіксованого набору (спам/не спам, кішка/собака).
Приклад:
- Регресія: «Ця квартира коштує 45 123 $» (будь-яке число)
- Класифікація: «Цей лист — спам» (одна з двох категорій)
Завантаження... (weight) — це нахил прямої, який показує, на скільки зміниться Завантаження... при зміні Завантаження... на 1 одиницю.
Інтерпретація:
- Завантаження...: кожен додатковий м² додає 500 $ до ціни
- Завантаження...: кожен км від метро віднімає 200 $
- MAE (Mean Absolute Error) — середня абсолютна помилка. Всі помилки рівноцінні.
- RMSE (Root Mean Squared Error) — корінь з середньої квадратичної помилки. Штрафує великі помилки сильніше через квадрат.
Коли використовувати:
- MAE: коли всі помилки однаково важливі
- RMSE: коли великі помилки критичні (медицина, фінанси)
Градієнтний спуск — це ітеративний алгоритм оптимізації, який:
- Обчислює градієнт функції втрат (напрямок зростання)
- Робить крок у протилежному напрямку (проти градієнта)
- Повторює до досягнення мінімуму функції втрат
Аналогія: спуск з гори в тумані, де градієнт — це нахил під ногами.
Алгоритм робить занадто великі кроки і перестрибує через мінімум. Функція втрат може:
- Коливатися навколо мінімуму (не збігається)
- Зростати (розбіжність, divergence)
Ознака: втрати на графіку хаотично стрибають або зростають.
Рішення: зменшити learning rate (наприклад, з Завантаження... до Завантаження...).
Завантаження... означає, що модель пояснює 85% варіації даних.
Простими словами:
- 85% відмінностей у цінах квартир пояснюється обраними ознаками (площа, поверх тощо)
- 15% варіації залишається не поясненою (випадковий шум, фактори, яких ми не врахували)
Оцінка:
- Завантаження... — хороша модель
- Завантаження... — відмінна модель (але можливе перенавчання)
Що далі?
🎓 Ви опанували
- Основи регресійного аналізу
- Лінійну регресію з однією та багатьма змінними
- Метрики якості моделей
- Алгоритм градієнтного спуску
- Практичну реалізацію на Python
🔜 Наступний модуль
Стаття 3.2: Практична регресія з scikit-learn
Задача Housing Prices
Ми застосуємо вивчені методи до реального датасету Kaggle, навчимося:
- Обробляти категоріальні ознаки
- Масштабувати дані (StandardScaler, MinMaxScaler)
- Заповнювати пропуски (SimpleImputer)
- Боротися з перенавчанням (train/test split, крос-валідація)
- Оптимізувати гіперпараметри (GridSearchCV)
Мотиваційна цитата
Ви щойно опанували перший двигун у своїй ML-подорожі — лінійну регресію. Це фундамент, на якому будуються складніші моделі. Попереду — нейронні мережі, випадковий ліс, градієнтний бустинг. Але всі вони спираються на ті ж принципи: функція втрат, градієнтний спуск, оптимізація параметрів.Продовжуйте практикуватися! Машинне навчання — це 10% теорії і 90% практики. Чим більше задач ви розв'яжете, тим глибше розумітимете матеріал.«Дані — це новий oil, але machine learning — це двигун внутрішнього згорання, який перетворює oil на енергію.»
— Andrew Ng, співзасновник Google Brain, професор Stanford
Фінальне резюме у вигляді карток
✅ MAE (Mean Absolute Error)
Формула: Завантаження...
Інтерпретація: «На скільки в середньому помиляємося»
✅ MSE (Mean Squared Error)
Формула: Завантаження...
Особливість: штрафує великі помилки
✅ R² (Коефіцієнт детермінації)
Діапазон: 0–1 (чим більше — тим краще)
Інтерпретація: Завантаження... → модель пояснює 85% даних
✅ Градієнтний спуск
Формула: Завантаження...
Ключовий параметр: Завантаження... (learning rate)
✅ Функція втрат
Формула: Завантаження...
Мета: мінімізувати
✅ Множинна регресія
Формула: Завантаження...
Геометрія: гіперплощина
Вітаємо з завершенням модуля «Лінійна регресія»! 🎉
Множинна лінійна регресія — модель з багатьма ознаками
Узагальнення лінійної регресії на випадок кількох вхідних змінних, векторна форма запису, приклад передбачення ціни квартири за 4 ознаками
Знайомство з scikit-learn
Вступ до бібліотеки scikit-learn — стандарту машинного навчання в Python. Універсальний API, перша модель та базові метрики якості.