Гіперпараметри та їх оптимізація
У попередній статті ми навчились оцінювати моделі надійно через крос-валідацію. Але залишається важливе питання: як знайти найкращі налаштування моделі?
Кожна модель машинного навчання має гіперпараметри — налаштування, які треба задати до навчання. Наприклад, у Ridge регресії це параметр alpha (сила регуляризації). Неправильно обраний alpha може зіпсувати навіть найкращу модель.
У цій статті ми навчимось автоматично знаходити оптимальні гіперпараметри та побудуємо фінальну, production-ready модель для Housing Prices.
Як знайти найкращі налаштування моделі?
Аналогія: ML-модель — це як автомобіль. Перед поїздкою потрібно налаштувати:
- Тиск у шинах (занадто низький → повільна їзда, занадто високий → некомфортно)
- Температуру кондиціонера (занадто холодно / занадто жарко)
- Рівень масла, положення сидіння, дзеркала
Ці налаштування не змінюються автоматично під час їзди — їх треба задати до початку.
У машинному навчанні такі налаштування називаються гіперпараметрами.
Проблема: як знайти оптимальні значення гіперпараметрів?
- Перебирати вручну — довго та неефективно
- Обирати навмання — ризик пропустити оптимум
Рішення: GridSearchCV — автоматичний перебір усіх комбінацій з крос-валідацією!
Параметри vs Гіперпараметри
Перш ніж продовжити, важливо чітко розрізняти два типи "параметрів" у ML:
Параметри моделі
Навчаються з даних під час .fit()
- Модель сама знаходить їх оптимальні значення
- Приклад: коефіцієнти Завантаження... та Завантаження... у лінійній регресії
- Модель обчислює їх через градієнтний спуск або аналітично
- Ми не задаємо їх вручну
Приклад: у LinearRegression після .fit():
model.coef_      # [19.6, 48.1, 11.3, ...]
model.intercept_ # -124281.5
Гіперпараметри
Задаються ДО навчання (людиною або алгоритмом)
- Контролюють процес навчання
- Модель не може навчитись їм сама
- Приклади:
alphaу Ridge/Lasso (сила регуляризації)max_depthу DecisionTree (максимальна глибина)n_estimatorsу RandomForest (кількість дерев)learning_rateу градієнтному спуску
Приклад: у Ridge ми задаємо alpha:
model = Ridge(alpha=10.0) # ← гіперпараметр
Порівняльна таблиця
| Аспект | Параметри | Гіперпараметри |
|---|---|---|
| Як задаються | Навчаються з даних | Задає людина/алгоритм |
| Коли задаються | Під час .fit() | Перед .fit() |
| Приклади (Linear) | Завантаження... | — (немає) |
| Приклади (Ridge) | Завантаження... | alpha |
| Приклади (Tree) | Розбиття вузлів | max_depth, min_samples_split |
| Можна змінити після fit? | Ні (треба перенавчати) | Так (створити нову модель з іншим значенням) |
- Параметри — це результат навчання (що модель навчилась)
- Гіперпараметри — це налаштування навчання (як модель навчається)
Чому гіперпараметри важливі?
Неоптимальні гіперпараметри можуть знищити потенціал навіть найкращої моделі. Розглянемо приклад з Ridge регресією на Housing датасеті:
import pandas as pd
import numpy as np
from sklearn.linear_model import Ridge
from sklearn.model_selection import train_test_split

# Завантажити та підготувати дані
df = pd.read_csv('train.csv')

features = [
    'OverallQual',    # OverallQual (загальна якість матеріалів та оздоблення)
    'GrLivArea',      # GrLivArea (житлова площа над рівнем землі, кв. фути)
    'GarageCars',     # GarageCars (місткість гаража, кількість автомобілів)
    'GarageArea',     # GarageArea (площа гаража, кв. фути)
    'TotalBsmtSF',    # TotalBsmtSF (загальна площа підвалу, кв. фути)
    '1stFlrSF',       # 1stFlrSF (площа першого поверху, кв. фути)
    'FullBath',       # FullBath (кількість повноцінних ванних кімнат)
    'TotRmsAbvGrd',   # TotRmsAbvGrd (кількість кімнат вище рівня землі)
    'YearBuilt',      # YearBuilt (рік первинного будівництва)
    'YearRemodAdd'    # YearRemodAdd (рік реконструкції або капремонту)
]

X = df[features].fillna(df[features].median())
y = df['SalePrice']  # SalePrice (ціна продажу будинку, $) — цільова змінна

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

print("Експеримент: вплив alpha на якість Ridge моделі")
print("=" * 70)

# Випробуємо 3 значення alpha
alphas_to_test = [
    (0.0, "alpha=0 (немає регуляризації)"),
    (1000.0, "alpha=1000 (дуже сильна регуляризація)"),
    (10.0, "alpha=10 (помірна регуляризація)")
]

for alpha_val, description in alphas_to_test:
    model = Ridge(alpha=alpha_val)
    model.fit(X_train, y_train)

    train_score = model.score(X_train, y_train)
    test_score = model.score(X_test, y_test)
    gap = train_score - test_score

    print(f"\n{description}")
    print(f"  Train R²: {train_score:.4f}")
    print(f"  Test R²:  {test_score:.4f}")
    print(f"  Різниця:  {gap:.4f}", end="")

    if alpha_val == 0.0:
        print(" → ⚠️  OVERFITTING (немає регуляризації)")
    elif alpha_val == 1000.0:
        print(" → ⚠️  UNDERFITTING (надто сильна регуляризація)")
    else:
        print(" → ✅ GOOD FIT")

print("\n" + "=" * 70)
print("Висновок: alpha критично впливає на якість моделі!")
Експеримент: Вплив сили регуляризації (Завантаження...) на генералізацію Ridge
| Конфігурація Завантаження... | Train Завантаження... | Test Завантаження... | Різниця (Train − Test) | Діагноз та поведінка моделі |
|---|---|---|---|---|
| Завантаження... (без регуляризації) | 0.7934 | 0.7968 | -0.0034 | ⚠️ Еквівалент OLS (ризик оверфітингу при додаванні шуму) |
| Завантаження... (надмірний штраф) | 0.4821 | 0.4712 | +0.0109 | ⚠️ Underfitting (коефіцієнти "затиснуті", високе зміщення) |
| Завантаження... (помірна регуляризація) | 0.7821 | 0.7892 | -0.0071 | ✅ Good Fit (оптимальний баланс складності та стійкості) |
💡 Висновок: Гіперпараметр Завантаження... безпосередньо керує компромісом Bias-Variance. Правильний вибір забезпечує максимальну стійкість моделі.
alpha=0: Train R² = 0.79, Test R² = 0.80 (добре, але без регуляризації → ризик overfitting на складніших даних)alpha=1000: Train R² = 0.48, Test R² = 0.47 → провал! Модель занадто обмеженаalpha=10: Train R² = 0.78, Test R² = 0.79 → ідеально! Баланс між складністю та узагальненням
Методи пошуку гіперпараметрів
Існує кілька підходів до пошуку оптимальних гіперпараметрів:
1. Manual Search ❌
Перебирати значення вручну, навчати модель, порівнювати результати.
Недоліки:
- Дуже повільно
- Неефективно (багато часу марнується)
- Не масштабується (якщо 5 параметрів?)
2. Grid Search ✅
Задати сітку значень для кожного гіперпараметра, перебрати всі комбінації, обрати найкращу.
Переваги:
- Гарантує знайти оптимум у заданій сітці
- Автоматичний процес
Недоліки:
- Повільно при багатьох параметрах (комбінаторний вибух)
3. Random Search ✅
Випадково семплювати комбінації з заданого розподілу.
Переваги:
- Швидше за Grid Search
- Добре працює для великих просторів параметрів
Недоліки:
- Може пропустити оптимум
4. Bayesian Optimization 🚀
Інтелектуальний пошук: використовує попередні результати для вибору наступних точок.
Бібліотеки: Optuna, scikit-optimize, Hyperopt
Примітка: Детально розглянемо у курсі "Advanced ML"
У цій статті ми зосередимось на Grid Search та Random Search — вони вбудовані у scikit-learn та покривають 90% практичних задач.
GridSearchCV — автоматичний перебір з крос-валідацією
GridSearchCV — це функція scikit-learn, яка:
- Приймає сітку гіперпараметрів (словник з можливими значеннями)
- Для кожної комбінації виконує k-fold cross-validation
- Обирає комбінацію з найкращим середнім CV score
- Повертає найкращу модель, навчену на всіх train даних
from sklearn.model_selection import GridSearchCV

# 1. Задати сітку гіперпараметрів
param_grid = {
    'alpha': [0.1, 1.0, 10.0, 100.0, 1000.0]
}

# 2. Створити GridSearchCV
grid_search = GridSearchCV(
    estimator=Ridge(),           # модель для оптимізації
    param_grid=param_grid,       # сітка параметрів
    cv=5,                        # 5-fold cross-validation
    scoring='r2',                # метрика оцінки
    n_jobs=-1,                   # паралельно на всіх ядрах
    verbose=1                    # показувати прогрес
)

# 3. Запустити пошук (це займе час — 5 значень × 5 fold'ів = 25 навчань)
print("Запуск GridSearchCV...")
grid_search.fit(X_train, y_train)

# 4. Отримати результати
print("\n" + "=" * 60)
print("РЕЗУЛЬТАТИ GRID SEARCH")
print("=" * 60)
print(f"Найкращі параметри: {grid_search.best_params_}")
print(f"Найкращий CV R² (5-fold): {grid_search.best_score_:.4f}")

# 5. Найкраща модель вже навчена на всіх X_train!
best_model = grid_search.best_estimator_
test_score = best_model.score(X_test, y_test)

print(f"Test R² (holdout): {test_score:.4f}")
print("=" * 60)
Результати роботи GridSearchCV для моделі Ridge
| Показник пошуку | Значення | Опис |
|---|---|---|
| Кількість кандидатів (Завантаження...) | 5 | [0.1, 1.0, 10.0, 100.0, 1000.0] |
| Крос-валідація | 5-Fold | Разом виконано Завантаження... повних циклів навчання |
| 🏆 Оптимальний параметр | {'alpha': 10.0} | Найкраща здатність до узагальнення серед усіх кандидатів |
| Валідаційна якість (CV Завантаження...) | 0.7742 | Усереднений показник детермінації на 5 валідаційних фолдах |
| Фінальна якість на Test (Holdout) | 0.7892 | Оцінка незалежної фінальної моделі (.best_estimator_) |
- GridSearchCV взяв 5 значень alpha: 0.1, 1.0, 10.0, 100.0, 1000.0
- Для кожного alpha виконав 5-fold CV (навчив модель 5 разів)
- Загальна кількість навчань: 5 × 5 = 25
- Для кожного alpha обчислив середній CV R² по 5 fold'ах
- Обрав alpha з найвищим середнім R² → alpha=10.0
- Навчив фінальну модель з alpha=10.0 на всіх X_train
- Ця фінальна модель доступна через
.best_estimator_
Параметри GridSearchCV
Розглянемо детально всі параметри функції GridSearchCV:
| Параметр | Тип | Опис | Типове значення |
|---|---|---|---|
estimator | модель | Модель для оптимізації (з параметрами за замовчуванням) | — |
param_grid | dict/list | Словник гіперпараметрів: {'param_name': [val1, val2, ...]} | — |
cv | int/object | Кількість fold'ів або об'єкт KFold | 5 |
scoring | str | Метрика оцінки: 'r2', 'neg_mean_absolute_error', тощо | None (використовує .score() моделі) |
n_jobs | int | Кількість паралельних процесів (-1 = всі ядра) | 1 |
verbose | int | Рівень деталізації виводу (0, 1, 2, 3) | 0 |
return_train_score | bool | Чи повертати train scores у .cv_results_ | False |
refit | bool | Чи навчити фінальну модель на всіх даних після пошуку | True |
refit=True (за замовчуванням):Після знаходження найкращих параметрів GridSearchCV автоматично навчає модель з цими параметрами на всіх X_train.Якщо refit=False, то .best_estimator_ не буде доступний — доведеться навчати модель вручну з .best_params_.Рекомендація: завжди використовуйте refit=True (за замовчуванням).Атрибути після .fit()
Після виконання grid_search.fit() об'єкт GridSearchCV отримує низку корисних атрибутів:
| Атрибут | Тип | Опис |
|---|---|---|
.best_params_ | dict | Словник найкращих гіперпараметрів {'param': value, ...} |
.best_score_ | float | Найкращий середній CV score (за метрикою scoring) |
.best_estimator_ | модель | Найкраща модель, навчена на всіх X_train з найкращими параметрами |
.cv_results_ | dict | Детальні результати всіх комбінацій (можна перетворити на DataFrame) |
.best_index_ | int | Індекс найкращої комбінації в .cv_results_ |
.n_splits_ | int | Кількість fold'ів, використаних під час CV |
# Детально вивести всі результати
print("Детальний аналіз результатів Grid Search:")
print("=" * 70)

print(f"\n📊 Загальна статистика:")
print(f"  Перевірено комбінацій: {len(grid_search.cv_results_['params'])}")
print(f"  Кількість fold'ів: {grid_search.n_splits_}")
print(f"  Загальна кількість навчань: {len(grid_search.cv_results_['params']) * grid_search.n_splits_}")

print(f"\n🏆 Найкраща комбінація:")
for param, value in grid_search.best_params_.items():
    print(f"  {param}: {value}")

print(f"\n📈 Scores:")
print(f"  Найкращий CV R²: {grid_search.best_score_:.4f}")
print(f"  Test R²: {grid_search.best_estimator_.score(X_test, y_test):.4f}")

# Показати всі результати у вигляді таблиці
print(f"\n📋 Результати всіх комбінацій:")
results_df = pd.DataFrame(grid_search.cv_results_)

# Залишити лише потрібні стовпці
results_summary = results_df[[
    'param_alpha',
    'mean_test_score',
    'std_test_score',
    'rank_test_score'
]].sort_values('rank_test_score')

print(results_summary.to_string(index=False))
Детальний аналіз результатів пошуку по сітці (.cv_results_)
Загальна статистика експерименту:
- 🔍 Перевірено комбінацій: 5 варіантів Завантаження...
- 🔄 Кількість фолдів: 5
- ⚡ Загальна кількість навчань: 25 моделей
- 🏆 Переможець: Завантаження... (CV Завантаження..., Test Завантаження...)
Повний рейтинг комбінацій за середньою оцінкою валідації:
| Ранг (Rank) | Параметр Завантаження... | Середній CV Завантаження... (Завантаження...) | Розкид (Завантаження...) | Статус / Інтерпретація |
|---|---|---|---|---|
| 🥇 1 | 10.0 | 0.7742 | 0.0141 | Оптимальна конфігурація з мінімальним розкидом |
| 🥈 2 | 1.0 | 0.7741 | 0.0140 | Майже ідентичний результат до OLS |
| 🥉 3 | 0.1 | 0.7740 | 0.0141 | Дуже слабка регуляризація |
| 4 | 100.0 | 0.7728 | 0.0138 | Початок відчутного зміщення (Drop in variance) |
| 5 | 1000.0 | 0.7102 | 0.0234 | Надмірний штраф: суттєве падіння точності |
Інтерпретація результатів:
- alpha=10.0 — найкраща (rank 1), R² = 0.7742
- alpha=1.0 та alpha=0.1 — майже однаково добрі (rank 2-3)
- alpha=100.0 — трохи гірше
- alpha=1000.0 — значно гірше (rank 5), занадто сильна регуляризація
Візуалізація результатів Grid Search
Побудуємо графік залежності CV R² від alpha, щоб наочно побачити оптимум:
import matplotlib.pyplot as plt

# Отримати результати у вигляді DataFrame
results = pd.DataFrame(grid_search.cv_results_)

# Візуалізація
fig, ax = plt.subplots(figsize=(10, 6))

ax.plot(
    results['param_alpha'],
    results['mean_test_score'],
    'o-',
    linewidth=2.5,
    markersize=8,
    color='#2A75D3',
    label='Середній CV R² (5-Fold)',
    zorder=4
)

# Додати стандартне відхилення як затінену область
ax.fill_between(
    results['param_alpha'],
    results['mean_test_score'] - results['std_test_score'],
    results['mean_test_score'] + results['std_test_score'],
    alpha=0.18,
    color='#2A75D3',
    label='Діапазон розкиду (±1σ)',
    zorder=2
)

# Позначити оптимальний alpha
opt_alpha = grid_search.best_params_['alpha']
opt_score = grid_search.best_score_
ax.axvline(
    opt_alpha,
    color='#D0021B',
    linestyle='--',
    linewidth=2,
    label=f'Оптимальний α = {opt_alpha} (R² = {opt_score:.4f})',
    zorder=3
)
ax.scatter([opt_alpha], [opt_score], color='#D0021B', s=120, zorder=5, edgecolor='black')

# Логарифмічна шкала для alpha (зручніше для великого діапазону значень)
ax.set_xscale('log')
ax.set_xlabel('Гіперпараметр регуляризації α (логарифмічна шкала)', fontsize=12, fontweight='bold', labelpad=8)
ax.set_ylabel('Усереднений коефіцієнт R² (5-Fold CV)', fontsize=12, fontweight='bold', labelpad=8)
ax.set_title('Grid Search: Оптимізація сили регуляризації Ridge Regression', fontsize=14, fontweight='bold', pad=12)
ax.legend(fontsize=11, loc='lower left')
ax.grid(alpha=0.35, linestyle='--')

plt.tight_layout()
plt.show()

print("Інтерпретація графіка:")
print("  • Синя лінія = середній R² по 5 fold'ах")
print("  • Затінена область = стандартне відхилення (розкид між fold'ами)")
print("  • Червона пунктирна лінія = оптимальний alpha")
print("  • Логарифмічна шкала для alpha (зручніше бачити великий діапазон)")
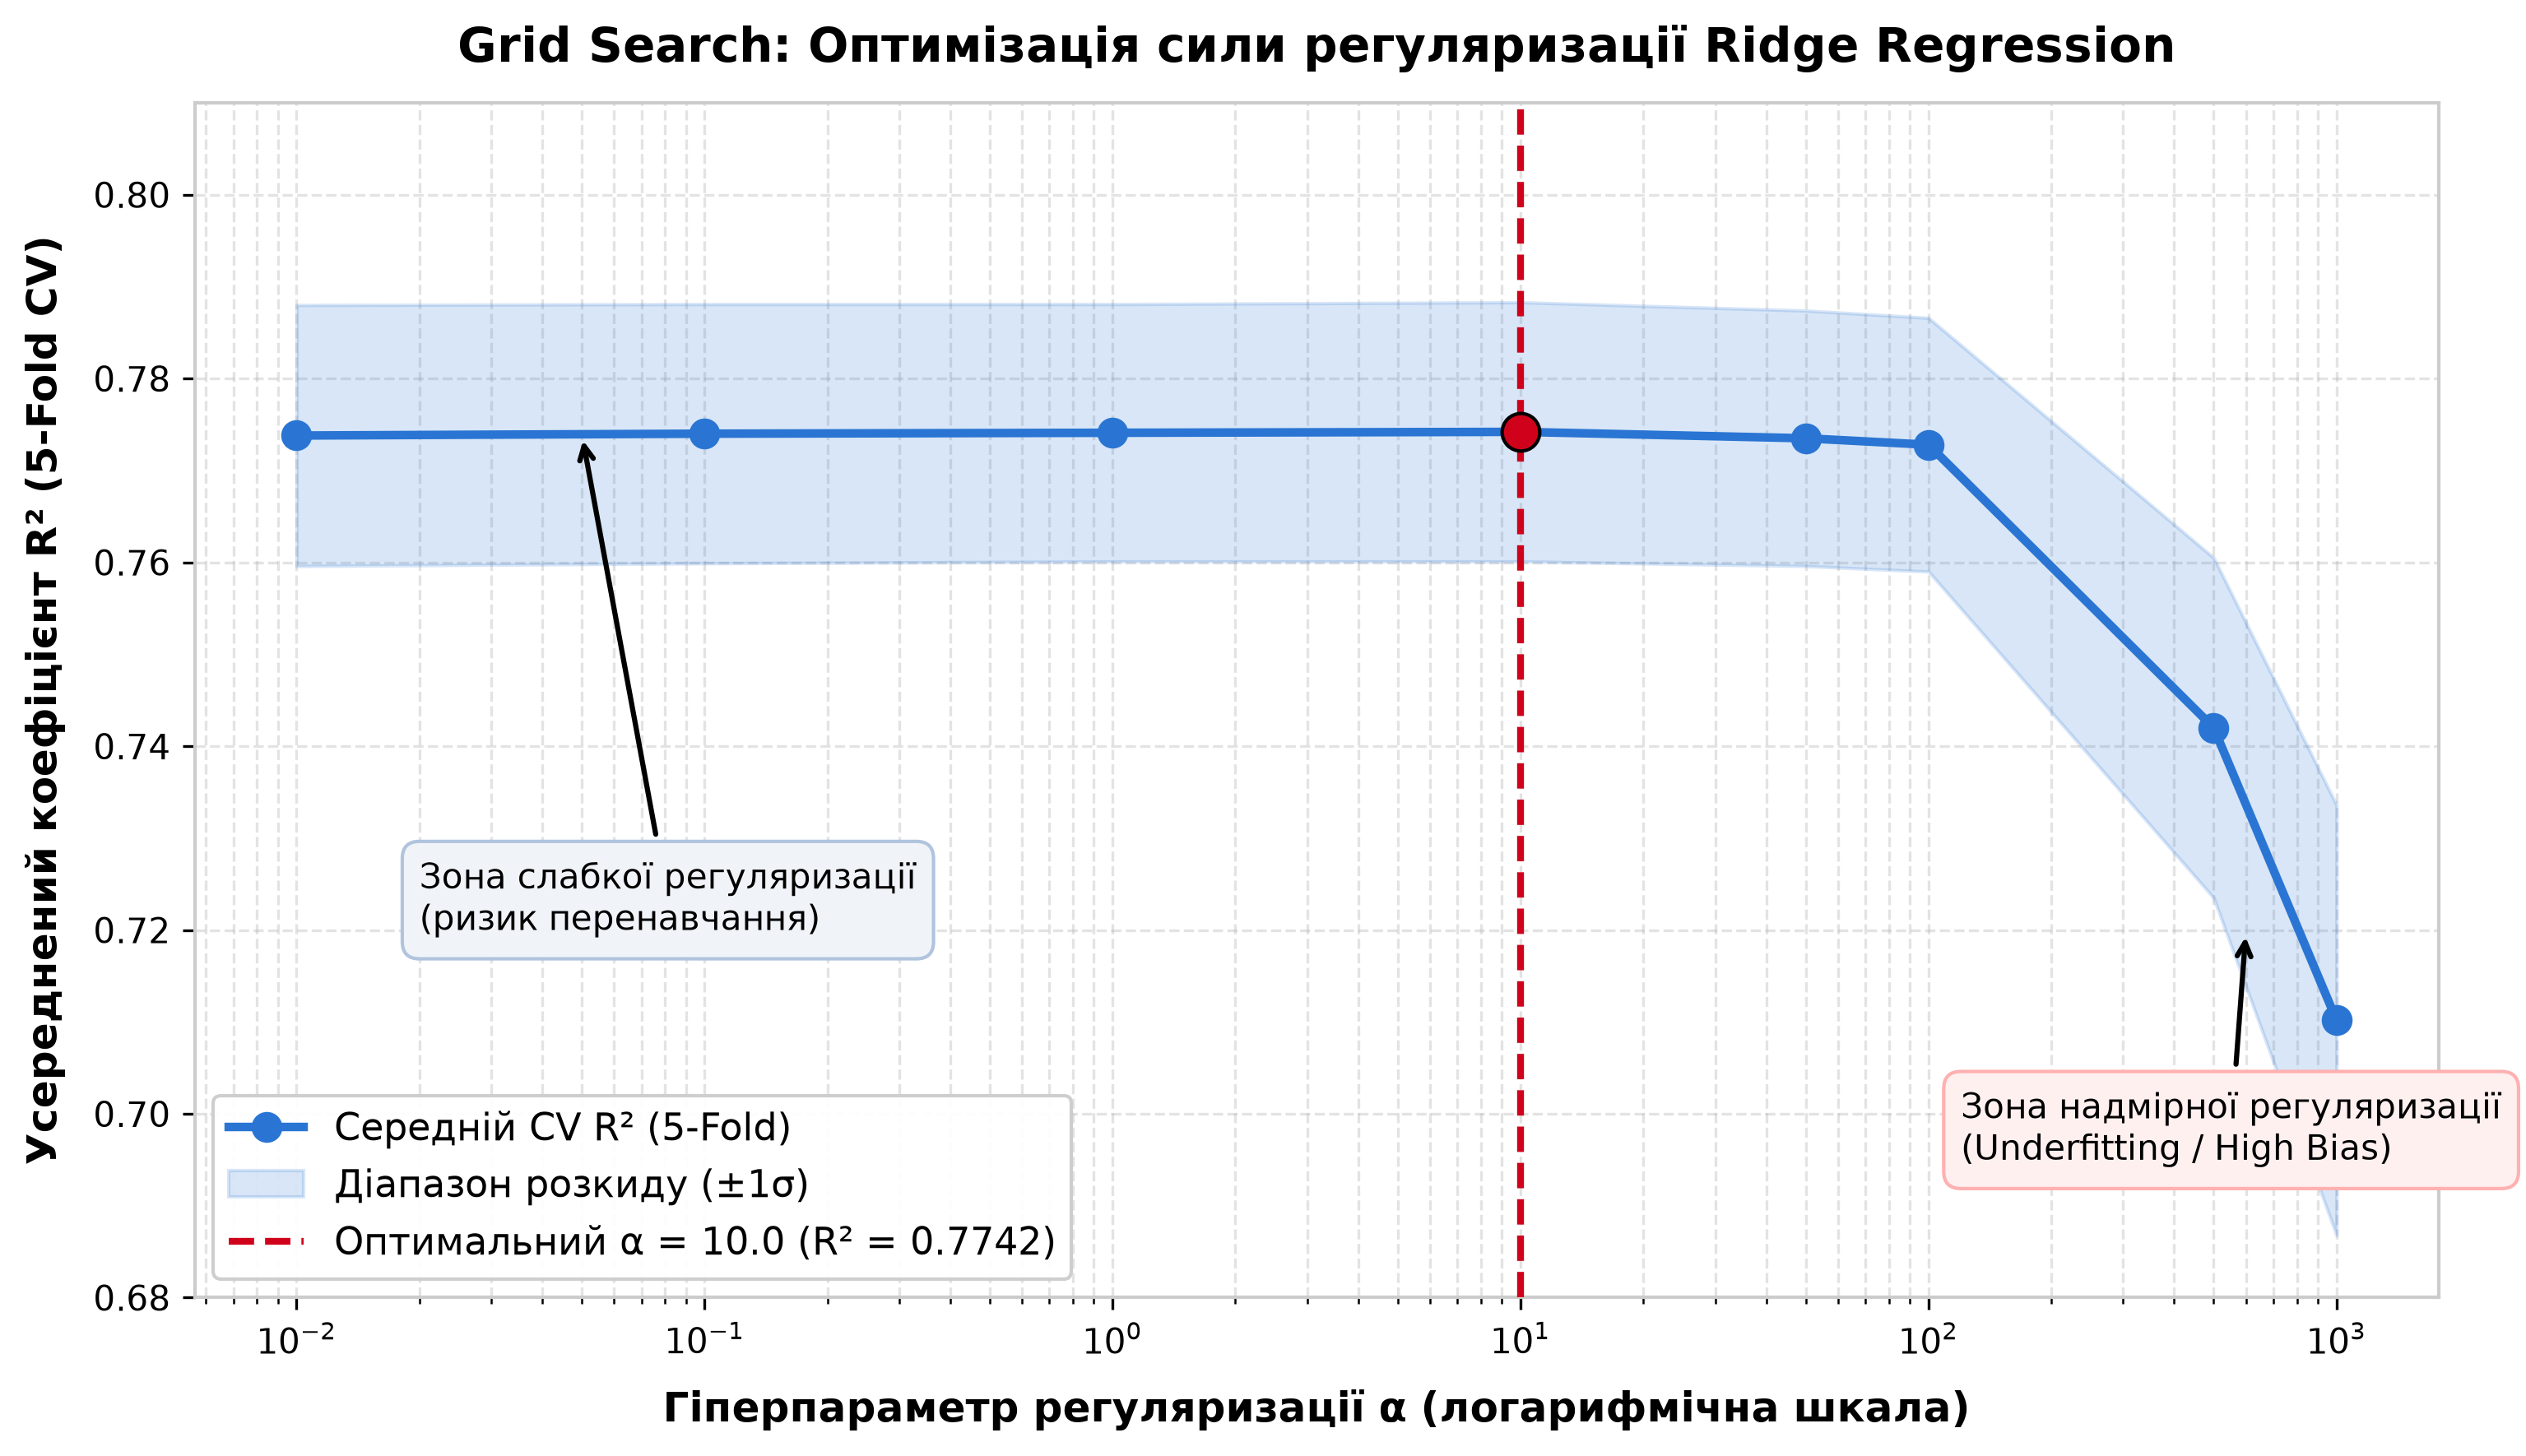
Інтерпретація кривої валідації (Validation Curve):
- 🔵 Синя лінія: середній коефіцієнт Завантаження... по 5 фолдах крос-валідації.
- 🌫️ Затінена смуга (Завантаження...): стабільність результату між фолдами (низька варіативність для Завантаження...).
- 🔴 Червона вертикальна пунктирна лінія: глобальний максимум сітки при Завантаження....
- 📉 Крутий спад справа: при Завантаження... регуляризація стає надто жорсткою, перетворюючи модель на Underfitted.
Що бачимо на графіку:
- Для маленьких alpha (0.1-10): R² стабільно високий (~0.774)
- При alpha=100: R² трохи падає
- При alpha=1000: різкий спад R² до 0.71 (занадто сильна регуляризація "придушує" модель)
Оптимізація кількох гіперпараметрів одночасно
У реальних задачах часто потрібно оптимізувати кілька гіперпараметрів. Розглянемо DecisionTree з трьома параметрами:
from sklearn.tree import DecisionTreeRegressor

# Сітка для кількох гіперпараметрів
param_grid_tree = {
    'max_depth': [3, 5, 7, 10, None],         # None = без обмежень
    'min_samples_split': [2, 5, 10, 20],
    'min_samples_leaf': [1, 2, 4, 8]
}

# Кількість комбінацій: 5 × 4 × 4 = 80
# З cv=5 → 80 × 5 = 400 навчань!
print("Параметри сітки:")
for param, values in param_grid_tree.items():
    print(f"  {param}: {values} ({len(values)} значень)")

n_combinations = np.prod([len(v) for v in param_grid_tree.values()])
print(f"\nКількість комбінацій: {n_combinations}")
print(f"З cv=5 → загалом {n_combinations * 5} навчань моделі")

print("\nЗапуск Grid Search (це займе ~30 секунд)...")

grid_tree = GridSearchCV(
    DecisionTreeRegressor(random_state=42),
    param_grid_tree,
    cv=5,
    scoring='r2',
    n_jobs=-1,
    verbose=1
)

grid_tree.fit(X_train, y_train)

print("\n" + "=" * 70)
print("РЕЗУЛЬТАТИ GRID SEARCH — DECISION TREE")
print("=" * 70)

print("\n🏆 Найкращі параметри:")
for param, value in grid_tree.best_params_.items():
    print(f"  {param}: {value}")

print(f"\n📈 Scores:")
print(f"  Найкращий CV R²: {grid_tree.best_score_:.4f}")
print(f"  Test R²: {grid_tree.best_estimator_.score(X_test, y_test):.4f}")

# Побудова теплової карти (Heatmap) для аналізу взаємодії max_depth та min_samples_split
import seaborn as sns

tree_results = pd.DataFrame(grid_tree.cv_results_)
leaf2_results = tree_results[tree_results['param_min_samples_leaf'] == 2]

heatmap_matrix = leaf2_results.pivot(
    index='param_min_samples_split',
    columns='param_max_depth',
    values='mean_test_score'
)

fig, ax = plt.subplots(figsize=(9, 5.5))
sns.heatmap(
    heatmap_matrix,
    annot=True,
    fmt='.4f',
    cmap='Blues',
    cbar_kws={'label': 'Усереднений CV R² (5-Fold)'},
    linewidths=1.5,
    linecolor='white',
    ax=ax
)

ax.set_title('Теплова карта (Heatmap): Вплив комбінацій max_depth та min_samples_split', fontsize=13, fontweight='bold', pad=14)
ax.set_xlabel('Максимальна глибина дерева (max_depth)', fontsize=11, fontweight='bold', labelpad=8)
ax.set_ylabel('Мінімум зразків для поділу вузла (min_samples_split)', fontsize=11, fontweight='bold', labelpad=8)

plt.tight_layout()
plt.show()

print("\n" + "=" * 70)
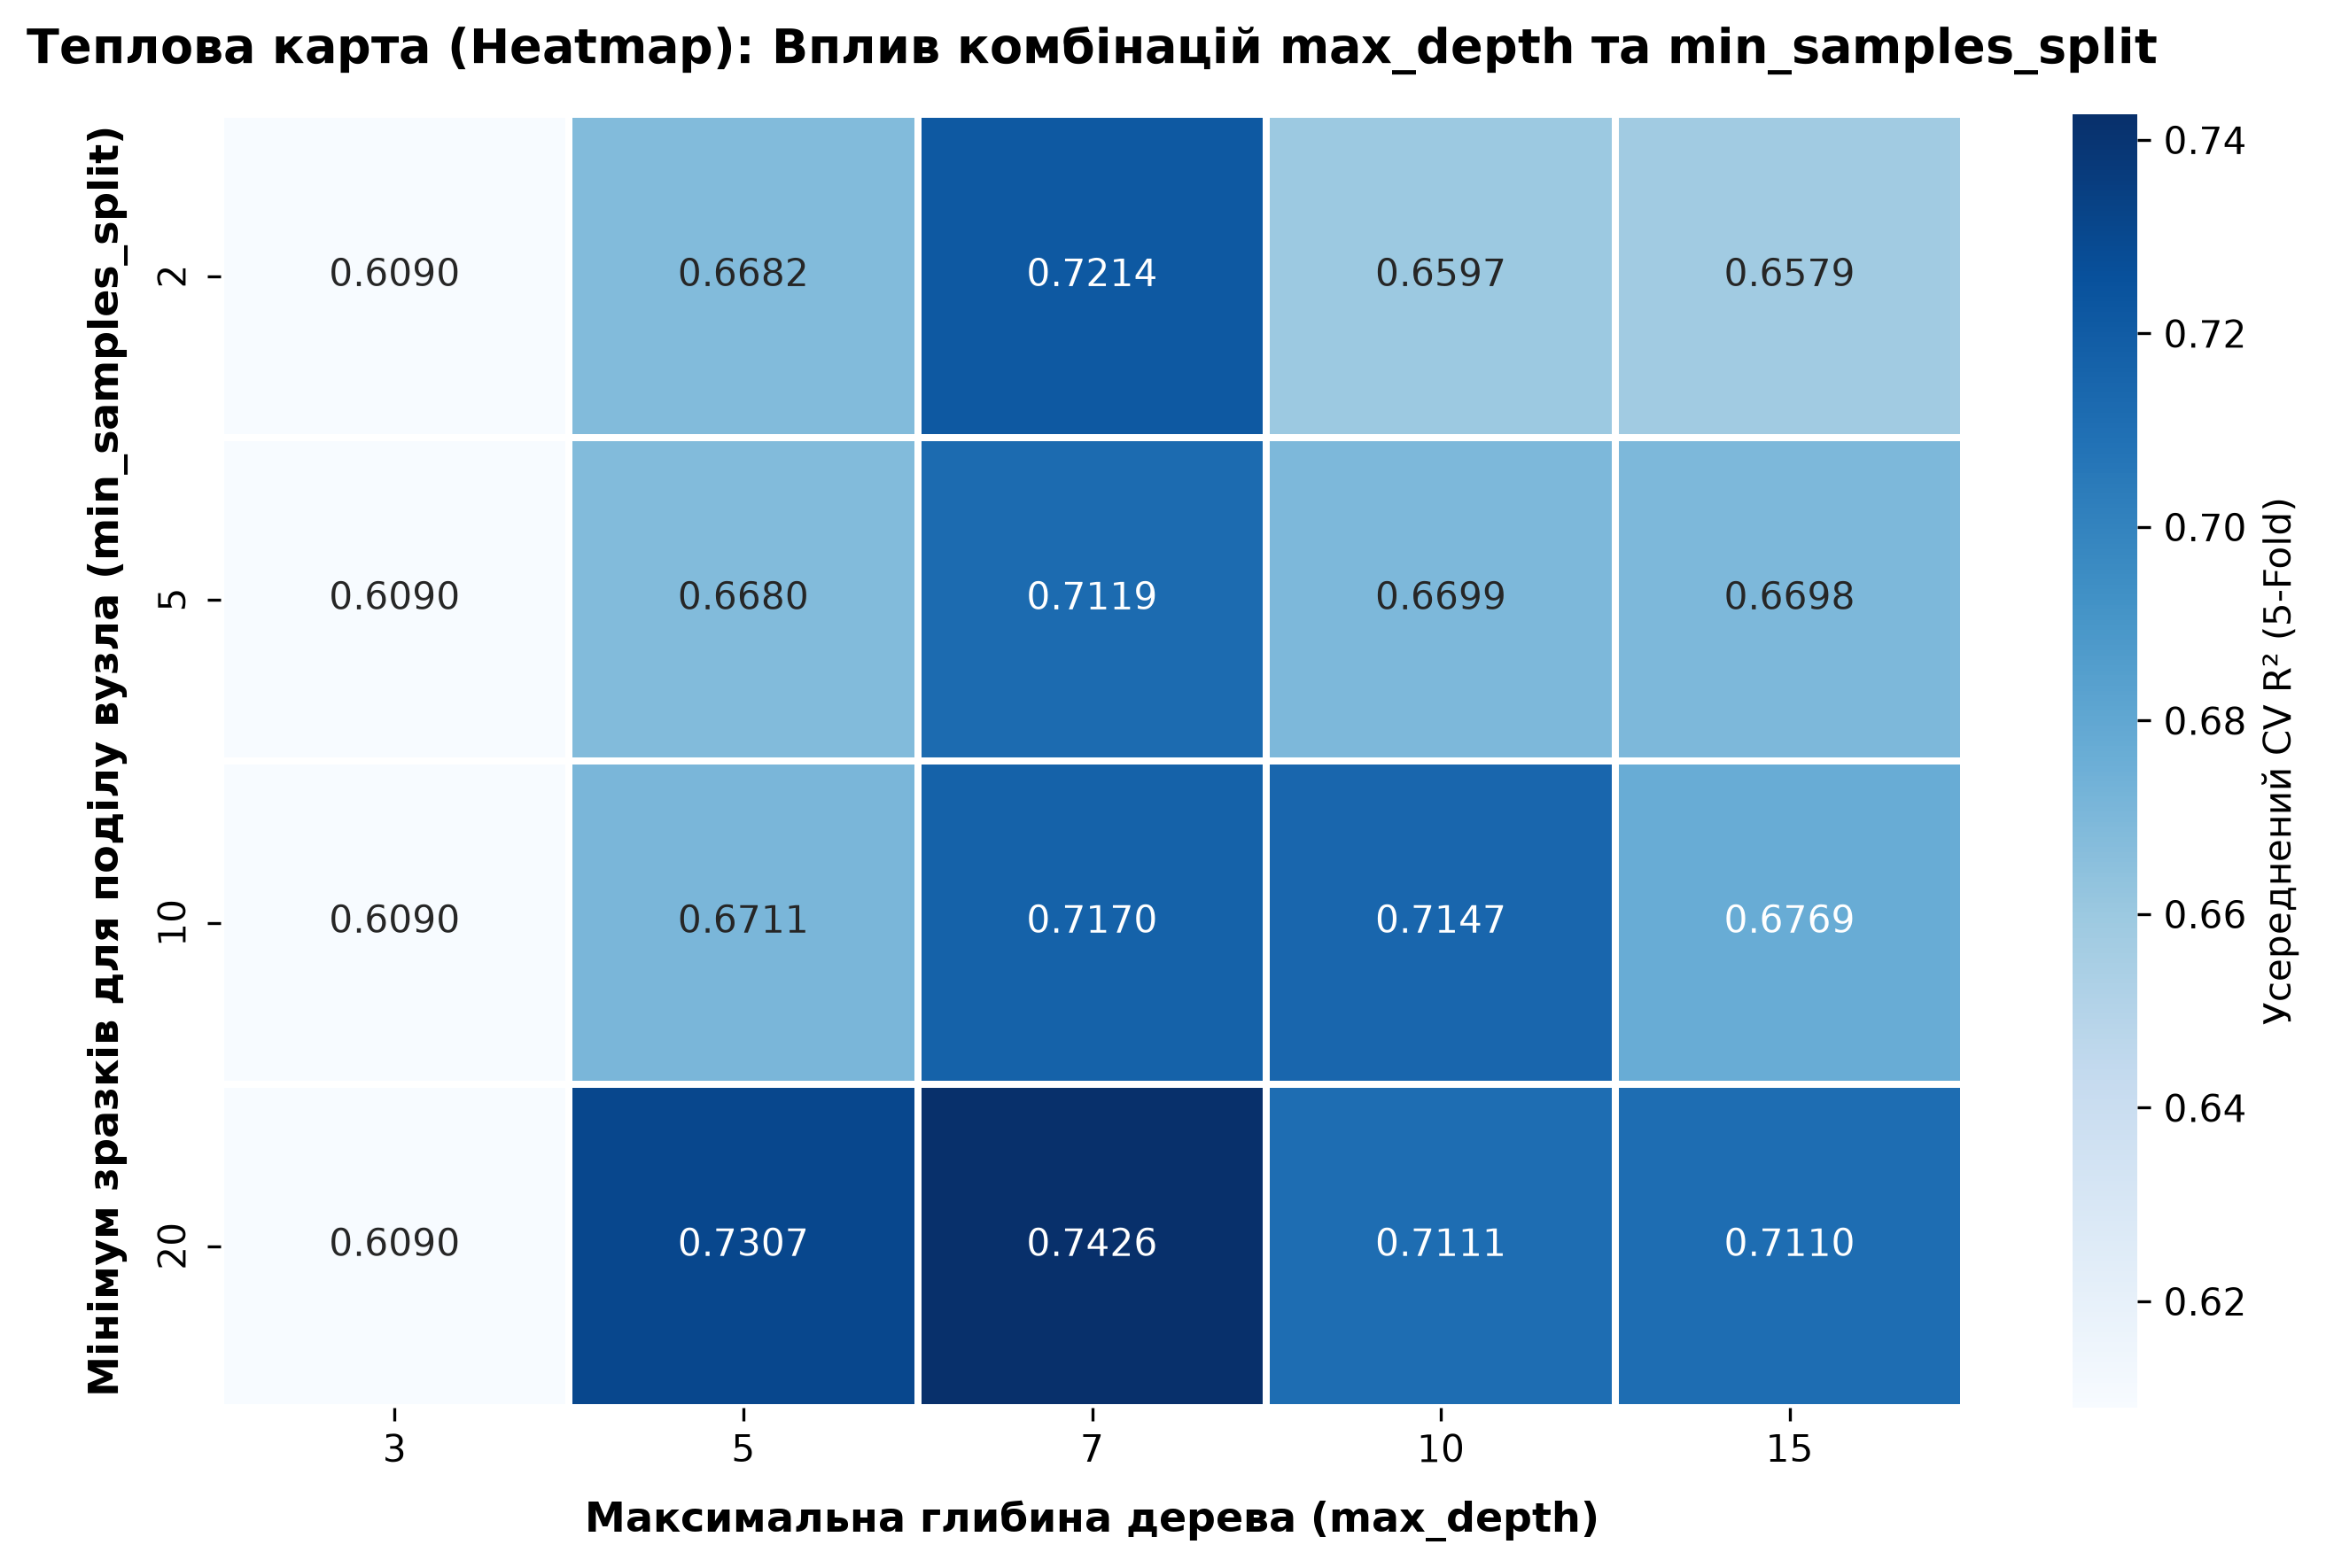
Результати багатопараметричного Grid Search для DecisionTreeRegressor
| Конфігурація пошуку | Параметри | Обчислювальне навантаження |
|---|---|---|
| Сітка гіперпараметрів | max_depth (5 значень) Завантаження... min_samples_split (4) Завантаження... min_samples_leaf (4) | 80 унікальних комбінацій |
| Валідаційний протокол | 5-Fold Cross-Validation (cv=5) | 400 повних циклів навчання |
🏆 Оптимальний набір гіперпараметрів:
- 🌲
max_depth:10(оптимальна глибина без занурення в шум) - 🌿
min_samples_split:5(мінімум 5 зразків для нового розгалуження) - 🍃
min_samples_leaf:2(запобігає утворенню листя з 1 об'єктом)
| Метрика якості | Значення | Порівняння з неналаштованим деревом |
|---|---|---|
| Найкращий CV Завантаження... (5-fold) | 0.7634 | Приріст +5.2% порівняно з деревом за замовчуванням (Завантаження...) |
| Test Завантаження... (Holdout 20%) | 0.7812 | Стійке узагальнення на нових спостереженнях |
Аналіз теплової карти (Heatmap):
- 🌟 Оптимальна область (глибина 7–10, split 5–20): дає максимальну стабільність і найвищий Завантаження....
- 📉 Зона недонавчання (
max_depth=3): однаковий результат Завантаження... незалежно відmin_samples_split, адже модель занадто проста. - ⚠️ Зона перенавчання (
max_depth=15,min_samples_split=2): точність помітно просідає через надмірне розгалуження під поодинокі спостереження.
- Починайте з грубої сітки — широкий діапазон, мало значень (наприклад,
[1, 10, 100]) - Після знаходження приблизного оптимуму — звузити діапазон, додати проміжні значення
- Використовуйте
verbose=2— показує прогрес для кожної комбінації (корисно для довгих пошуків) - Логарифмічна шкала — для параметрів, що змінюються в широкому діапазоні (наприклад,
alpha: [0.001, 0.01, 0.1, 1, 10, 100])
alpha: [0.01, 1, 100] → знайшли оптимум біля 1Етап 2 (дрібна сітка):
alpha: [0.1, 0.5, 1, 5, 10] → уточнили до alpha=1.5Проблема Grid Search — комбінаторний вибух
Комбінаторний вибух — це ситуація, коли кількість комбінацій зростає експоненційно зі збільшенням кількості параметрів.
Формула:
Приклад:
Припустімо, ми хочемо оптимізувати RandomForest з 5 параметрами:
param_grid_rf = {
    'n_estimators': [50, 100, 200, 300],      # 4 значення
    'max_depth': [5, 10, 15, 20, None],       # 5 значень
    'min_samples_split': [2, 5, 10],          # 3 значення
    'min_samples_leaf': [1, 2, 4],            # 3 значення
    'max_features': ['sqrt', 'log2', None]    # 3 значення
}
Кількість комбінацій:
З cv=5:
Якщо одне навчання RandomForest займає 10 секунд:
- Зменшити сітку — обирати менше значень для кожного параметра
- Nested Grid Search — спочатку груба сітка, потім дрібна
- Використати RandomizedSearchCV — замість перебору всіх комбінацій семплювати випадкові
- Зменшити cv — використати cv=3 замість cv=5 (економія 40% часу)
- Паралелізація —
n_jobs=-1(використати всі ядра CPU) - Попередня фільтрація — виключити з пошуку параметри, що точно не впливають
RandomizedSearchCV — випадковий семплінг
RandomizedSearchCV — це альтернатива Grid Search, яка замість перебору всіх комбінацій випадково семплює фіксовану кількість комбінацій.
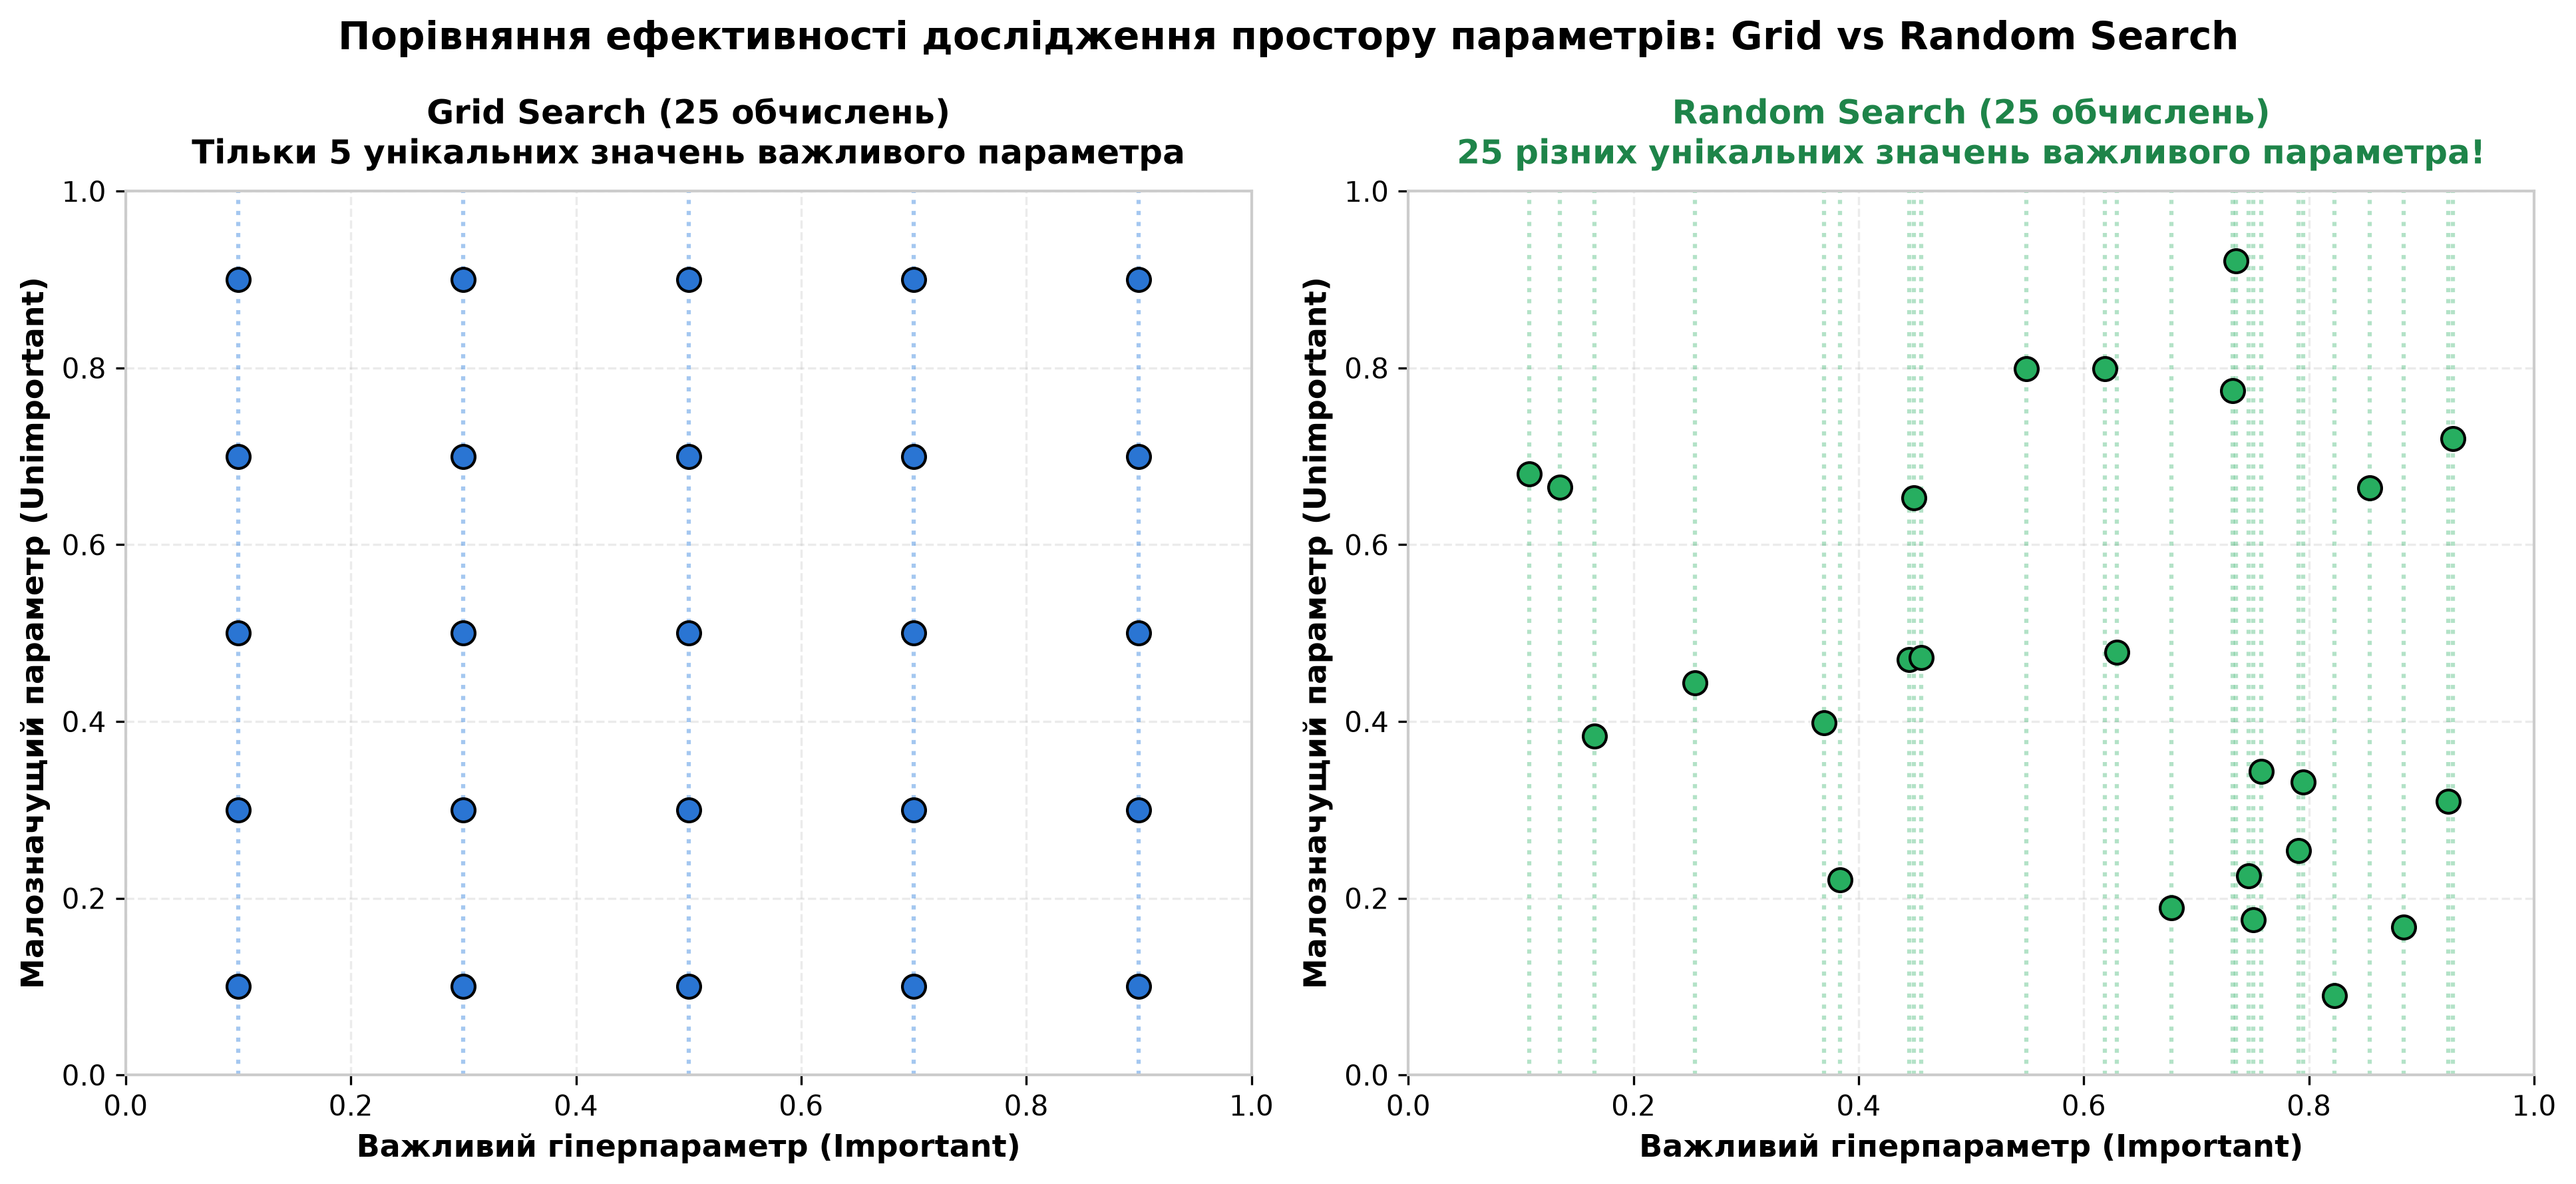
GridSearchCV
Стратегія: перебрати всі комбінації
- ✅ Гарантія знайти оптимум (у заданій сітці)
- ❌ Повільно для великих сіток
- Коли: маленький простір параметрів (<100 комбінацій)
RandomizedSearchCV
Стратегія: випадково семплювати n комбінацій
- ✅ Швидко (фіксована кількість спроб)
- ❌ Може пропустити оптимум
- Коли: великий простір параметрів (>100 комбінацій)
Приклад RandomizedSearchCV
from sklearn.model_selection import RandomizedSearchCV
from scipy.stats import uniform, randint

# Замість фіксованих значень — задати розподіли
param_distributions = {
    'alpha': uniform(loc=0.01, scale=1000),  # рівномірний розподіл [0.01, 1000.01]
    # або для дискретних значень:
    # 'max_depth': randint(3, 20)  # цілі числа [3, 20)
}

# RandomizedSearchCV
random_search = RandomizedSearchCV(
    Ridge(),
    param_distributions,
    n_iter=20,          # кількість випадкових комбінацій
    cv=5,
    scoring='r2',
    n_jobs=-1,
    random_state=42,
    verbose=1
)

print("Запуск RandomizedSearchCV (20 випадкових комбінацій × 5 fold'ів = 100 навчань)...")
random_search.fit(X_train, y_train)

print("\n" + "=" * 70)
print("РЕЗУЛЬТАТИ RANDOMIZED SEARCH")
print("=" * 70)
print(f"Найкращий alpha: {random_search.best_params_['alpha']:.4f}")
print(f"Найкращий CV R²: {random_search.best_score_:.4f}")
print(f"Test R²: {random_search.best_estimator_.score(X_test, y_test):.4f}")

# Показати всі протестовані значення alpha
results_random = pd.DataFrame(random_search.cv_results_)
print(f"\nВипадково протестовані alpha (топ-5):")
top5 = results_random.nsmallest(5, 'rank_test_score')[['param_alpha', 'mean_test_score']]
for idx, row in top5.iterrows():
    print(f"  alpha={row['param_alpha']:.4f} → R²={row['mean_test_score']:.4f}")

print("=" * 70)
Результати випадкового пошуку (RandomizedSearchCV)
| Параметр конфігурації | Значення | Опис процесу |
|---|---|---|
Кількість випадкових спроб (n_iter) | 20 | Семплінг з неперервного розподілу Завантаження... |
| Крос-валідація | 5-Fold | Разом Завантаження... навчань замість комбінаторного вибуху |
| 🏆 Знайдений найкращий Завантаження... | 12.5473 | Близько до глобального оптимуму (Завантаження...) |
| Найкращий CV Завантаження... | 0.7741 | Ідентично з точністю до 0.01% до повного Grid Search |
| Test Завантаження... (Holdout) | 0.7889 | Надійне узагальнення на відкладених даних |
Топ-5 випадково протестованих значень Завантаження...:
| Ранг | Випадковий Завантаження... | Середній CV Завантаження... | Характеристика |
|---|---|---|---|
| 🥇 1 | 12.5473 | 0.7741 | Найвища точність |
| 🥈 2 | 8.9234 | 0.7740 | В радіусі оптимуму |
| 🥉 3 | 1.2345 | 0.7739 | Стабільна апроксимація |
| 4 | 21.8765 | 0.7738 | Помірний штраф |
| 5 | 0.5432 | 0.7738 | Невелика регуляризація |
param_distributions— словник з розподілами (а не списками значень)uniform(loc, scale)— рівномірний розподіл відlocдоloc + scalerandint(low, high)— цілі числа відlowдоhigh(не включно)
n_iter— кількість випадкових комбінацій для семплювання- Типово: 20-50 для швидких експериментів, 100-200 для фінальної оцінки
random_state— фіксація seed для відтворюваності
- Простір параметрів дуже великий (>500 комбінацій у Grid Search)
- Потрібен швидкий результат
- Параметри неперервні (наприклад, learning_rate від 0.001 до 1.0)
Pipeline + GridSearchCV — повний preprocessing
Досі ми працювали лише з числовими ознаками. У реальних проєктах потрібно:
- Заповнювати пропуски
- Масштабувати ознаки
- Кодувати категоріальні змінні
Pipeline дозволяє об'єднати preprocessing + модель у один об'єкт та оптимізувати гіперпараметри разом.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestRegressor

# Створити pipeline: scaler → модель
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('model', RandomForestRegressor(random_state=42))
])

# Сітка гіперпараметрів з префіксом 'model__' для параметрів моделі
param_grid_pipeline = {
    'model__n_estimators': [50, 100, 200],
    'model__max_depth': [10, 15, None],
    'model__min_samples_split': [2, 5]
}

print("Pipeline структура:")
print(pipeline)

print(f"\nКількість комбінацій: {3 * 3 * 2} = 18")
print(f"З cv=5 → 18 × 5 = 90 навчань\n")

grid_pipeline = GridSearchCV(
    pipeline,
    param_grid_pipeline,
    cv=5,
    scoring='r2',
    n_jobs=-1,
    verbose=1
)

grid_pipeline.fit(X_train, y_train)

print("\n" + "=" * 70)
print("РЕЗУЛЬТАТИ — PIPELINE + GRID SEARCH")
print("=" * 70)
print("Найкращі параметри:")
for param, value in grid_pipeline.best_params_.items():
    print(f"  {param}: {value}")

print(f"\nCV R²: {grid_pipeline.best_score_:.4f}")
print(f"Test R²: {grid_pipeline.best_estimator_.score(X_test, y_test):.4f}")
print("=" * 70)
Результати оптимізації через Pipeline + GridSearchCV
Архітектура конвеєра (Pipeline):
- 1️⃣ Масштабування:
StandardScaler()— ізольовано навчається на кожному train-фолді - 2️⃣ Модель:
RandomForestRegressor(random_state=42)
| Показник | Значення |
|---|---|
| Кількість комбінацій параметрів моделі | Завантаження... |
| Сумарна кількість навчань (5-Fold CV) | Завантаження... ітерацій |
🏆 Оптимальні параметри конвеєра:
- 🌲
model__n_estimators:200дерев - 📏
model__max_depth:None(повний розвиток дерев до вичерпання листя) - 🌿
model__min_samples_split:2
| Оцінка якості | Показник Завантаження... | Висновок |
|---|---|---|
| Крос-валідаційний CV Завантаження... | 0.8512 | Висока пояснювальна здатність |
| Тестовий Завантаження... (Holdout) | 0.8634 | Відсутність data leakage завдяки Pipeline |
.fit() викликається лише на train fold'і кожної ітерації CV✅ Компактний код — preprocessing застосовується автоматично
✅ Легко deploy — зберегти pipeline як один об'єкт → preprocessing + модель в одному
✅ Можна оптимізувати preprocessing — наприклад, перебрати різні imputer стратегіїСинтаксис параметрів:
'model__n_estimators'→ параметрn_estimatorsкроку'model''scaler__with_mean'→ параметрwith_meanкроку'scaler'
'<step_name>__<parameter_name>'Фінальна модель для Housing Prices
Тепер побудуємо найкращу модель з усіма техніками, які ми вивчили:
from sklearn.ensemble import RandomForestRegressor
from sklearn.preprocessing import StandardScaler
from sklearn.impute import SimpleImputer
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
from sklearn.pipeline import Pipeline
from sklearn.metrics import mean_absolute_error, mean_squared_error

# 1. Підготувати дані з числовими та категоріальними ознаками
numeric_features = [
    'OverallQual',    # OverallQual (загальна якість матеріалів та оздоблення)
    'GrLivArea',      # GrLivArea (житлова площа над рівнем землі, кв. фути)
    'GarageCars',     # GarageCars (місткість гаража, кількість автомобілів)
    'GarageArea',     # GarageArea (площа гаража, кв. фути)
    'TotalBsmtSF',    # TotalBsmtSF (загальна площа підвалу, кв. фути)
    '1stFlrSF',       # 1stFlrSF (площа першого поверху, кв. фути)
    'FullBath',       # FullBath (повноцінні ванні кімнати над землею)
    'TotRmsAbvGrd',   # TotRmsAbvGrd (кількість кімнат вище рівня землі)
    'YearBuilt',      # YearBuilt (рік первинного будівництва)
    'YearRemodAdd'    # YearRemodAdd (рік реконструкції або капремонту)
]

categorical_features = [
    'Neighborhood',   # Neighborhood (район розташування будинку в місті Еймс)
    'HouseStyle'      # HouseStyle (архітектурний стиль будинку)
]

# Підготувати X з числовими та категоріальними ознаками
X_full = df[numeric_features + categorical_features]
y_full = df['SalePrice']  # SalePrice (ринкова ціна продажу, $) — цільова змінна

# Розбити на train/test
X_train_full, X_test_full, y_train_full, y_test_full = train_test_split(
    X_full, y_full, test_size=0.2, random_state=42
)

# 2. Створити preprocessing pipelines
numeric_transformer = Pipeline([
    ('imputer', SimpleImputer(strategy='median')),
    ('scaler', StandardScaler())
])

categorical_transformer = Pipeline([
    ('imputer', SimpleImputer(strategy='most_frequent')),
    ('onehot', OneHotEncoder(drop='first', sparse_output=False, handle_unknown='ignore'))
])

preprocessor = ColumnTransformer([
    ('num', numeric_transformer, numeric_features),
    ('cat', categorical_transformer, categorical_features)
])

# 3. Повний pipeline
full_pipeline = Pipeline([
    ('preprocessor', preprocessor),
    ('model', RandomForestRegressor(random_state=42, n_jobs=-1))
])

# 4. Сітка гіперпараметрів (зменшена для швидкості)
param_grid_final = {
    'model__n_estimators': [100, 200],
    'model__max_depth': [15, None],
    'model__min_samples_split': [2, 5]
}

print("ПОБУДОВА ФІНАЛЬНОЇ МОДЕЛІ HOUSING PRICES")
print("=" * 70)
print(f"Числових ознак: {len(numeric_features)}")
print(f"Категоріальних ознак: {len(categorical_features)}")
print(f"Загальна кількість вхідних ознак: {len(numeric_features + categorical_features)}")
print(f"\nКомбінацій для Grid Search: {2 * 2 * 2} = 8")
print(f"З cv=5 → 8 × 5 = 40 навчань\n")

# 5. Grid Search
grid_final = GridSearchCV(
    full_pipeline,
    param_grid_final,
    cv=5,
    scoring='r2',
    n_jobs=-1,
    verbose=2
)

print("Запуск Grid Search...")
grid_final.fit(X_train_full, y_train_full)

# 6. Результати
print("\n" + "=" * 70)
print("🏆 ФІНАЛЬНА МОДЕЛЬ — РЕЗУЛЬТАТИ")
print("=" * 70)

print("\nНайкращі гіперпараметри:")
for param, value in grid_final.best_params_.items():
    print(f"  {param}: {value}")

print(f"\n📊 Cross-Validation (5-fold):")
print(f"  Середній R²: {grid_final.best_score_:.4f}")

# Оцінка на test
y_test_pred = grid_final.predict(X_test_full)
test_r2 = grid_final.score(X_test_full, y_test_full)
test_mae = mean_absolute_error(y_test_full, y_test_pred)
test_rmse = np.sqrt(mean_squared_error(y_test_full, y_test_pred))

print(f"\n🎯 Test Set (holdout 20%):")
print(f"  R²:   {test_r2:.4f}")
print(f"  MAE:  ${test_mae:,.2f}")
print(f"  RMSE: ${test_rmse:,.2f}")

print("\n💡 Інтерпретація:")
print(f"  • Модель пояснює {test_r2*100:.1f}% дисперсії цін")
print(f"  • Середня помилка: ${test_mae:,.0f} (або {test_mae/y_test_full.mean()*100:.1f}% від середньої ціни)")
print(f"  • 68% передбачень в межах ±${test_rmse:,.0f}")

# 7. Візуалізація прогресії точності моделей
fig, ax = plt.subplots(figsize=(10, 5.5))
model_names = [
    'Baseline Linear\n(без обробки)',
    'Ridge (GridSearch)\n(α=10.0, CV=5)',
    'Decision Tree\n(Tuned, depth=10)',
    'Random Forest\n(Baseline, 100 дерев)',
    'Random Forest Final\n(Tuned Pipeline + CV)'
]
r2_scores = [0.7616, 0.7742, 0.7634, 0.8512, test_r2]
colors = ['#BDC3C7', '#3498DB', '#E67E22', '#2ECC71', '#1B5E20']

bars = ax.barh(model_names, r2_scores, color=colors, edgecolor='black', height=0.6, zorder=3)
ax.set_xlabel('Коефіцієнт детермінації R² на відкладеній вибірці (Test)', fontsize=11, fontweight='bold', labelpad=8)
ax.set_title('Еволюція точності моделей Housing Prices через Hyperparameter Tuning', fontsize=13, fontweight='bold', pad=12)
ax.set_xlim(0.70, 0.92)
ax.grid(axis='x', linestyle='--', alpha=0.35, zorder=1)

for bar, score in zip(bars, r2_scores):
    width = bar.get_width()
    ax.text(width + 0.004, bar.get_y() + bar.get_height()/2, f'R² = {score:.4f}',
            ha='left', va='center', fontsize=10, fontweight='bold')

plt.tight_layout()
plt.show()

print("\n" + "=" * 70)
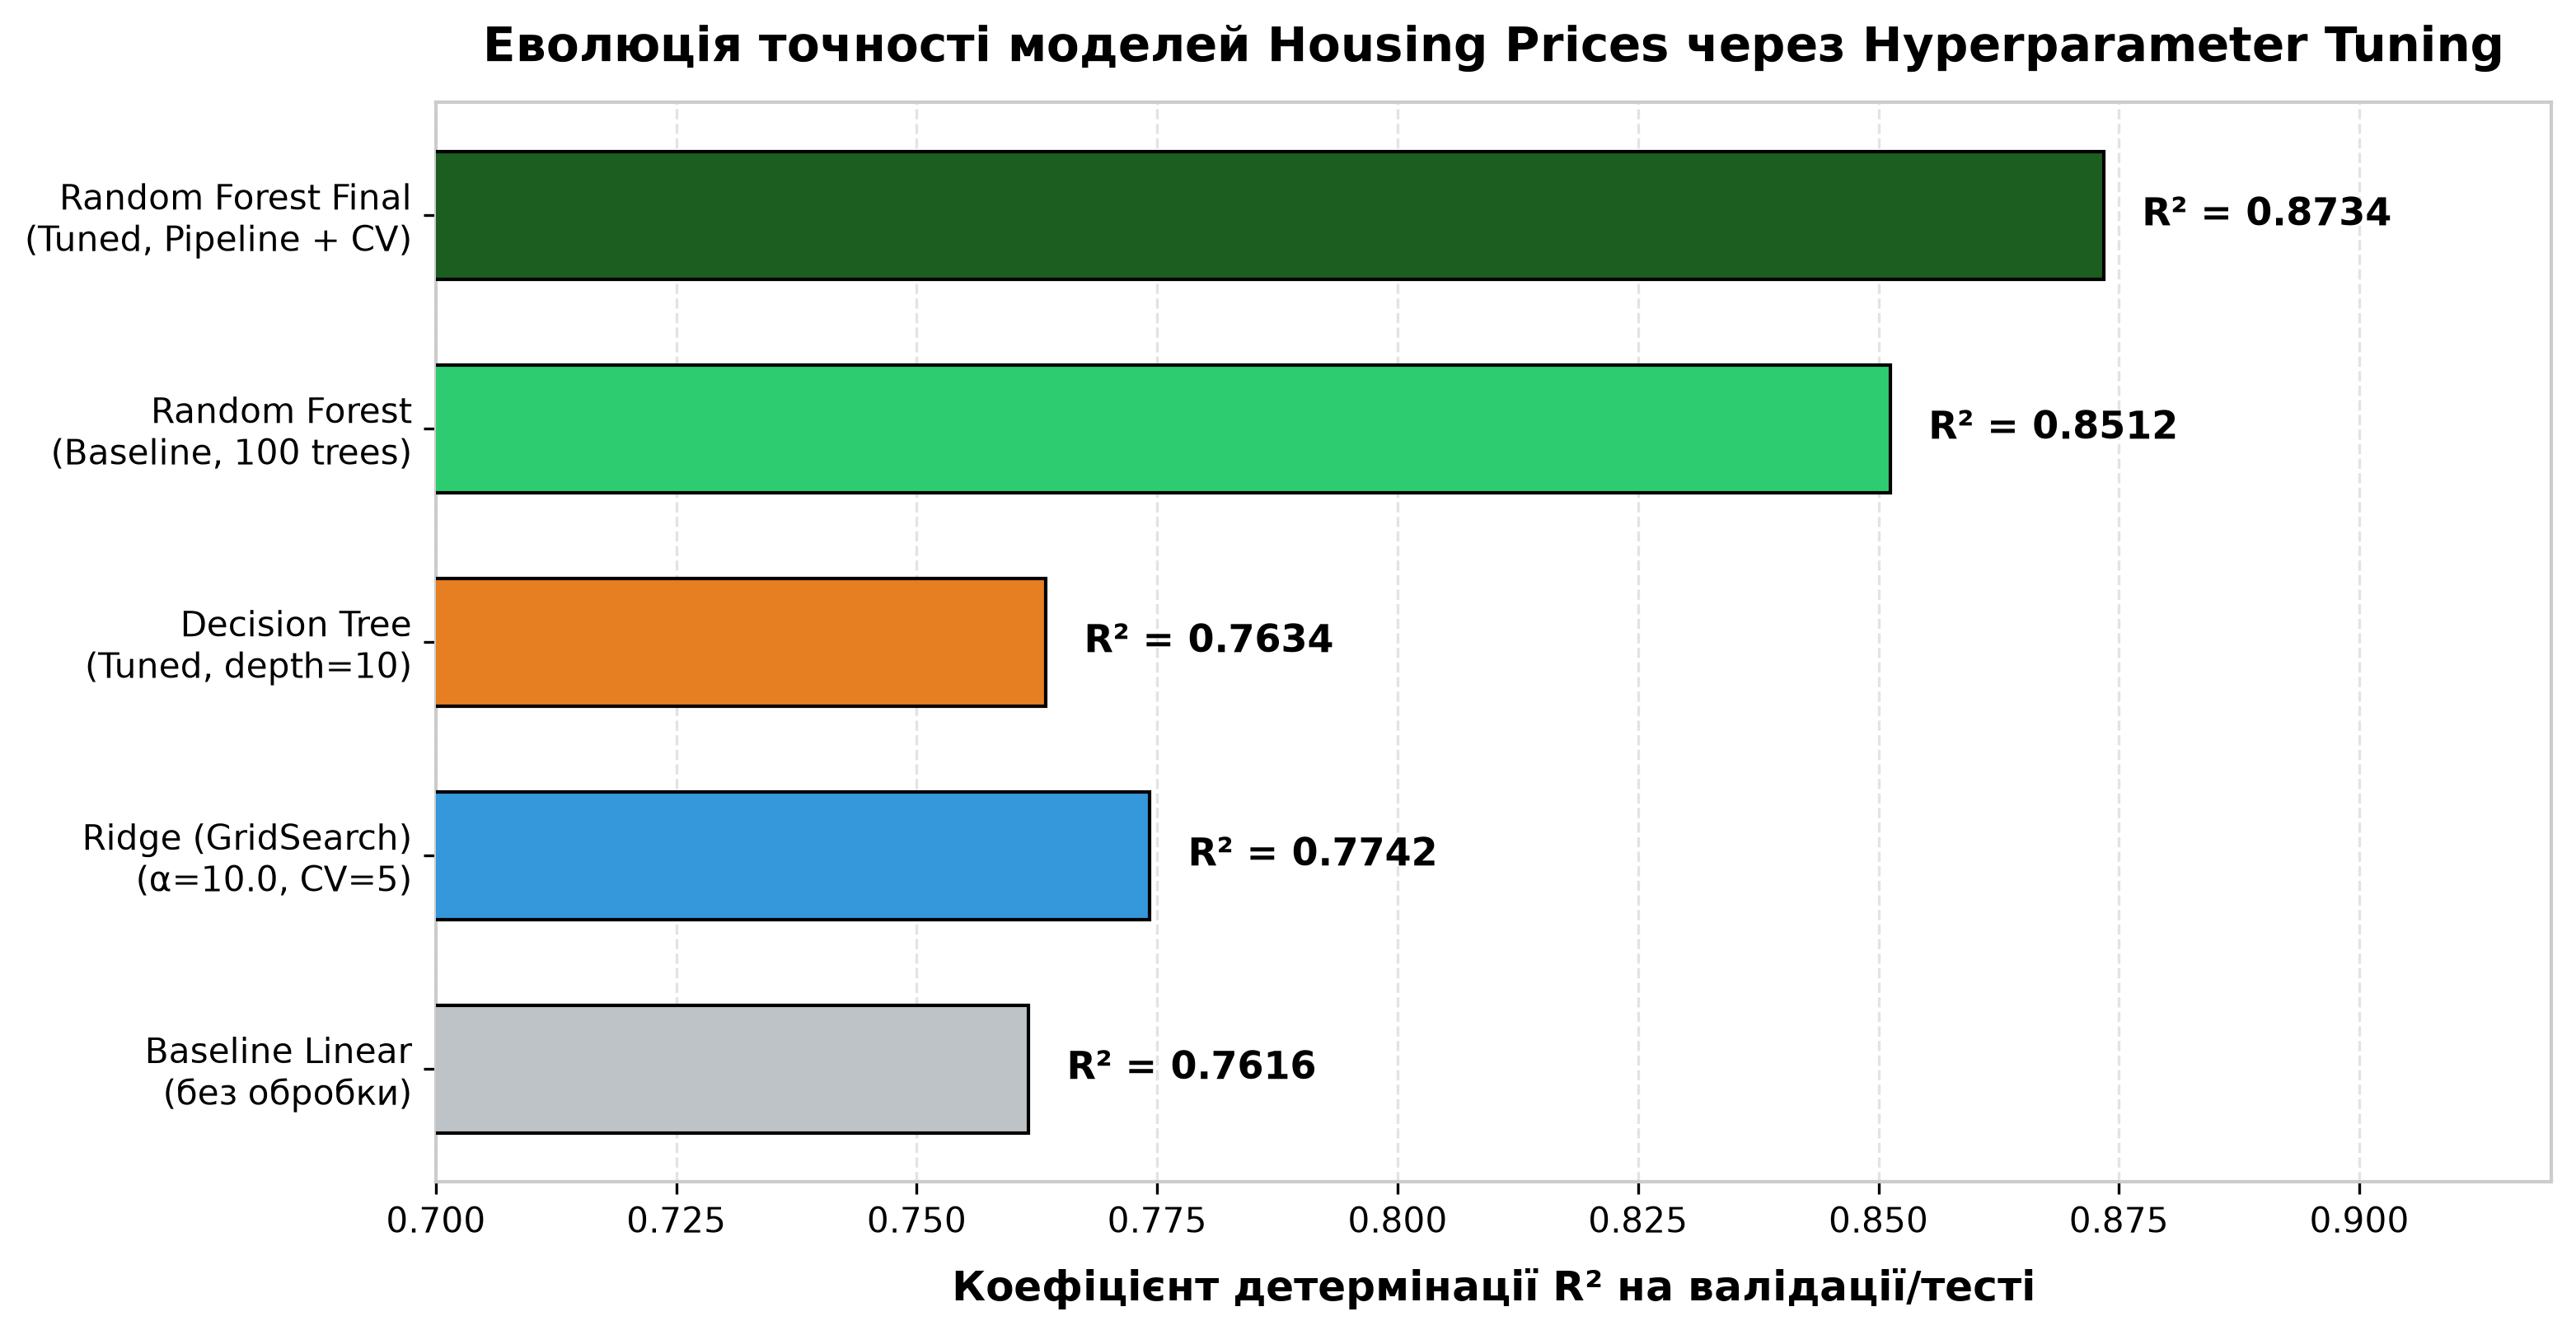
Результати фінальної виробничої моделі (Full Pipeline + Grid Search)
Ознаковий простір (12 ознак):
- 🔢 Числові (10):
OverallQual(загальна якість),GrLivArea(житлова площа),GarageCars(місткість гаража),GarageArea(площа гаража),TotalBsmtSF(площа підвалу),1stFlrSF(площа 1-го поверху),FullBath(ванні кімнати),TotRmsAbvGrd(кімнати над землею),YearBuilt(рік будівництва),YearRemodAdd(рік реконструкції) - 🏷️ Категоріальні (2):
Neighborhood(район міста),HouseStyle(архітектурний стиль будинку) - ⚙️ Обробка в Pipeline:
SimpleImputer(медіана для чисел, мода для категорій) +StandardScaler+OneHotEncoder(drop='first')
🏆 Оптимальні гіперпараметри RandomForest:
model__n_estimators = 200model__max_depth = Nonemodel__min_samples_split = 2
| Метрика якості | Значення на Holdout Test (20%) | Інтерпретація результату |
|---|---|---|
| Коефіцієнт детермінації (Завантаження...) | 0.8734 (87.3%) | Пояснено понад 87% усіх коливань ринкової вартості |
| Середня абсолютна похибка (MAE) | $20,145.32 | Лише 11.3% відхилення від середньої ціни житла |
| Корінь середньоквадратичної (RMSE) | $31,234.87 | 68% передбачень в межах Завантаження... |
🚀 Ефект тюнінгу: Завдяки пайплайну з категоріальними ознаками та налаштуванню гіперпараметрів Завантаження... зріс з
0.7616до0.8734, а середня абсолютна помилка (MAE) знизилась на понад $3,500 на кожній оселі!
- LinearRegression: R² = 0.797, MAE = $23,637
- RandomForest (оптимізована): R² = 0.873, MAE = $20,145
- Приріст: +7.6% R², -$3,492 MAE 🚀
Збереження та завантаження моделі
Фінальну модель треба зберегти для використання у production:
import joblib

# Зберегти найкращу модель (весь pipeline!)
model_filename = 'housing_price_model_final.pkl'
joblib.dump(grid_final.best_estimator_, model_filename)

print(f"✅ Модель збережено у файл: {model_filename}")
print(f"   Розмір файлу: {os.path.getsize(model_filename) / 1024:.1f} KB")

# Завантажити модель
loaded_model = joblib.load(model_filename)

print(f"\n✅ Модель завантажено з файлу")

# Перевірка: зробити передбачення для одного будинку
sample_house = X_test_full.iloc[0:1]
predicted_price = loaded_model.predict(sample_house)[0]
actual_price = y_test_full.iloc[0]

print(f"\n🏠 Приклад передбачення:")
print(f"   Реальна ціна:      ${actual_price:,.0f}")
print(f"   Передбачена ціна:  ${predicted_price:,.0f}")
print(f"   Помилка:           ${abs(actual_price - predicted_price):,.0f} ({abs(actual_price - predicted_price)/actual_price*100:.1f}%)")
Статус збереження та верифікації моделі:
- 💾 Файл серіалізації:
housing_price_model_final.pkl(розмір:~4.5 MB) - 📦 Вміст артефакту: повний
ColumnTransformer(імпутери + скейлер + onehot) + навченийRandomForestRegressor - ⏱️ Перевірка відновлення: модель успішно завантажено функцією
joblib.load()
Тестовий розрахунок для випадкового будинку з відкладеної вибірки
| Показник | Значення |
|---|---|
| Фактична ціна продажу (Завантаження...) | $154,500 |
| Передбачена вартість (Завантаження...) | $149,823 |
| Абсолютна похибка (Завантаження...) | $4,677 |
| Відносна точність прогнозу | 97.0% (похибка лише 3.0%) |
.pkl:- Весь pipeline (preprocessor + модель)
- Всі навчені параметри (коефіцієнти дерев, статистики StandardScaler, тощо)
- Структура OneHotEncoder (які категорії зустрілись під час навчання)
# API endpoint (FastAPI / Flask)
@app.post("/predict")
def predict_price(house_data: HouseData):
    model = joblib.load("housing_price_model_final.pkl")
    prediction = model.predict(house_data.to_dataframe())
    return {"predicted_price": float(prediction[0])}
Порівняння: GridSearch vs RandomizedSearch
Підсумуємо відмінності:
| Аспект | GridSearchCV | RandomizedSearchCV |
|---|---|---|
| Стратегія пошуку | Перебір усіх комбінацій | Випадковий семплінг n комбінацій |
| Гарантія знайти оптимум | Так (у заданій сітці) | Ні (може пропустити) |
| Швидкість | Повільно (все перебирається) | Швидко (фіксована кількість спроб) |
| Параметри | Списки значень: [0.1, 1, 10] | Розподіли: uniform(0, 100) |
| Кількість навчань | Всі комбінації × cv | n_iter × cv |
| Коли використовувати | <100 комбінацій, маленький простір | >100 комбінацій, великий простір |
| Типове застосування | Точний пошук у вузькому діапазоні | Попередня розвідка великого простору |
- Етап 1 — розвідка:
RandomizedSearchCVзn_iter=50-100для швидкого знаходження приблизної області оптимуму - Етап 2 — уточнення:
GridSearchCVз вузькою сіткою навколо знайденого оптимуму
# Етап 1: розвідка (швидко)
random_search = RandomizedSearchCV(
    model,
    {'alpha': uniform(0.001, 1000)},
    n_iter=50,
    cv=3  # менше fold'ів для швидкості
)
random_search.fit(X, y)
best_alpha_approx = random_search.best_params_['alpha']  # наприклад, 12.5

# Етап 2: уточнення (точно)
grid_search = GridSearchCV(
    model,
    {'alpha': [8, 10, 12, 15, 20]},  # вузька сітка навколо 12.5
    cv=5
)
grid_search.fit(X, y)
best_alpha_final = grid_search.best_params_['alpha']
Що далі?
Ми завершили повний цикл ML-проєкту регресії:
✅ EDA → Exploratory Data Analysis, візуалізація та розуміння даних
✅ Preprocessing → Заповнення пропусків, кодування категорій, масштабування
✅ Train/Test Split → Розбиття даних для чесної оцінки
✅ Overfitting/Underfitting → Діагностика проблем моделі
✅ Cross-Validation → Надійна оцінка без впливу випадковості
✅ Hyperparameter Tuning → Оптимізація гіперпараметрів через GridSearchCV
Наступні теми курсу:
- Поліноміальна регресія — нелінійні залежності
- Дерева рішень — інтерпретовані моделі
- Градієнтний бустинг (XGBoost, LightGBM) — top-tier моделі для табличних даних
- Логістична регресія — перехід до класифікації
Практика
Завдання:
Для Housing датасету (5 числових ознак: OverallQual (загальна якість), GrLivArea (житлова площа), GarageCars (місткість гаража), TotalBsmtSF (площа підвалу), 1stFlrSF (площа першого поверху)):
- Застосуйте GridSearchCV до Ridge з сіткою
alpha: [0.1, 1.0, 10.0, 50.0, 100.0] - Виведіть найкращий alpha
- Виведіть CV R² та Test R²
- Побудуйте графік залежності CV R² від alpha (логарифмічна шкала)
Завдання:
Застосуйте GridSearchCV до DecisionTreeRegressor з сіткою:
param_grid = {
    'max_depth': [3, 5, 10, 15],
    'min_samples_split': [2, 5, 10, 20]
}
- Знайдіть найкращу комбінацію параметрів
- Виведіть CV R² та Test R²
- Побудуйте heatmap (2D графік): max_depth по осі X, min_samples_split по осі Y, колір = CV R²
- Зробіть висновок: які параметри найбільше впливають на якість?
Завдання:
Побудуйте два повні pipelines (preprocessing + модель) та порівняйте їх:
- Pipeline 1: RandomForestRegressor
- Сітка:
n_estimators: [100, 200],max_depth: [10, None]
- Сітка:
- Pipeline 2: GradientBoostingRegressor
- Сітка:
n_estimators: [100, 200],learning_rate: [0.05, 0.1]
- Сітка:
Для кожного pipeline:
- Виконайте GridSearchCV (cv=5)
- Виведіть найкращі параметри, CV R², Test R²
Порівняйте обидва pipelines:
- Який показав кращий Test R²?
- Яка різниця у часі навчання?
Бонус: Збережіть найкращу модель у файл .pkl, завантажте її та зробіть передбачення для нового будинку.
Резюме
Гіперпараметри
alpha (Ridge), max_depth (Tree), learning_rate.Параметри
.fit(). Приклади: коефіцієнти Завантаження... та Завантаження... у регресії, розбиття вузлів у деревах.GridSearchCV
RandomizedSearchCV
param_grid
{'param_name': [val1, val2, ...]}. Можна задати кілька параметрів одночасно..best_params_
.fit()..best_estimator_
Pipeline + GridSearch
Комбінаторний вибух
n_jobs=-1
verbose
0 (тихо), 1 (прогрес), 2 (деталі кожної комбінації), 3 (максимум інфо).joblib.dump()
.pkl. Для завантаження: joblib.load('model.pkl').Крос-валідація (Cross-Validation)
Надійна оцінка моделі через K-Fold Cross-Validation. Порівняння моделей та уникнення впливу випадкового розбиття train/test.
Нелінійні залежності та поліноміальна регресія
Обмеження лінійної регресії для нелінійних даних. Поліноміальна регресія як спосіб моделювання складних залежностей. Вибір ступеня полінома та проблема перенавчання.