Крос-валідація (Cross-Validation)
У попередній статті ми навчились виявляти та діагностувати overfitting і underfitting — дві найпоширеніші проблеми машинного навчання. Але щоб правильно оцінити модель, недостатньо просто розбити дані на train і test один раз.
Чому? Тому що одне розбиття — це лотерея.
Один train/test split — це лотерея
Уявімо експеримент: візьмемо одну і ту саму модель лінійної регресії та навчимо її на Housing датасеті 10 разів, кожного разу з різним випадковим розбиттям train/test:
import pandas as pd
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split

# Завантажити та підготувати дані Housing Prices
df = pd.read_csv('train.csv')

# Відбираємо ключові ознаки (з українськими перекладами)
features = [
    'OverallQual',   # Загальна якість матеріалів та оздоблення
    'GrLivArea',      # Житлова площа над рівнем землі (кв. фути)
    'GarageCars',     # Місткість гаража (кількість автомобілів)
    'GarageArea',     # Площа гаража (кв. фути)
    'TotalBsmtSF',    # Загальна площа підвалу (кв. фути)
    '1stFlrSF',       # Площа першого поверху (кв. фути)
    'FullBath',       # Повноцінні ванні кімнати над землею
    'TotRmsAbvGrd',   # Кількість кімнат вище рівня землі (без ванних)
    'YearBuilt',      # Рік первинного будівництва
    'YearRemodAdd'    # Рік реконструкції або капітального ремонту
]

X = df[features].fillna(df[features].median())
y = df['SalePrice']  # Ціна продажу ($) — цільова змінна

# Навчити модель 10 разів з різними random_state
scores = []

for seed in range(10):
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=seed
    )

    model = LinearRegression()
    model.fit(X_train, y_train)

    test_score = model.score(X_test, y_test)
    scores.append(test_score)

    print(f"random_state={seed:2d} → Test R² = {test_score:.4f}")

print("\n" + "=" * 50)
print(f"R² мінімальний:  {min(scores):.4f}")
print(f"R² максимальний: {max(scores):.4f}")
print(f"Різниця:         {max(scores) - min(scores):.4f}")
print(f"Середнє:         {np.mean(scores):.4f}")
print(f"Std:             {np.std(scores):.4f}")
print("=" * 50)
Значення random_state | Отриманий Test Завантаження... | Примітка / Діагноз розбиття |
|---|---|---|
seed = 0 | 0.7854 | Типове розбиття |
seed = 1 | 0.8123 | Вдале розбиття |
seed = 2 | 0.7691 | Нижче середнього |
seed = 3 | 0.8045 | Вище середнього |
seed = 4 | 0.7932 | Близько до середнього |
seed = 5 | 0.7789 | Нижче середнього |
seed = 6 | 0.8256 | 🏆 Максимум (найкращий split) |
seed = 7 | 0.7534 | ⚠️ Мінімум (найгірший split) |
seed = 8 | 0.7912 | Близько до середнього |
seed = 9 | 0.8067 | Вище середнього |
Зведені статистичні характеристики розкиду:
- Мінімальний Завантаження...:
0.7534(seed=7) - Максимальний Завантаження...:
0.8256(seed=6) - Абсолютний розрив (Завантаження...):
0.0722(7.22 процентних пункти!) - Середнє арифметичне значення:
0.7920 - Стандартне відхилення (Завантаження...):
0.0211
- Найкращий split (seed=6): R² = 0.8256
- Найгірший split (seed=7): R² = 0.7534
- Різниця: 0.072 (7.2 процентних пункти)
Аналогія: це як оцінка студента за один іспит. Можливо, він погано виспався, або випадково трапились незнайомі задачі. Набагато надійніше — середня оцінка за 5 іспитів.
Проблема одного розбиття train/test
Чому один train/test split може бути ненадійним? Три основні ризики:
❌ Ризик 1: Невдалий розподіл
❌ Ризик 2: Мала вибірка test
❌ Ризик 3: Неможливо порівняти моделі
Приклад "невдалого" split
Подивімось на розподіл цін у нашому експерименті:
# Візуалізуємо розподіл цін для "найкращого" та "найгіршого" split
import matplotlib.pyplot as plt

fig, axes = plt.subplots(1, 2, figsize=(14, 5))

# Найкращий split (seed=6, R²=0.8256)
X_train_best, X_test_best, y_train_best, y_test_best = train_test_split(
    X, y, test_size=0.2, random_state=6
)

axes[0].hist(y_train_best, bins=30, alpha=0.6, label='Train', color='dodgerblue', edgecolor='black')
axes[0].hist(y_test_best, bins=15, alpha=0.7, label='Test', color='limegreen', edgecolor='black')
axes[0].axvline(y_train_best.mean(), color='blue', linestyle='--', linewidth=2, label=f'Train mean: ${y_train_best.mean()/1000:.0f}k')
axes[0].axvline(y_test_best.mean(), color='green', linestyle='--', linewidth=2, label=f'Test mean: ${y_test_best.mean()/1000:.0f}k')
axes[0].set_xlabel('Ціна ($)', fontsize=11, fontweight='bold')
axes[0].set_ylabel('Частота', fontsize=11, fontweight='bold')
axes[0].set_title('Найкращий split (seed=6, R²=0.826)', fontsize=12, fontweight='bold', color='green')
axes[0].legend(fontsize=9)
axes[0].grid(alpha=0.3, linestyle='--')

# Найгірший split (seed=7, R²=0.7534)
X_train_worst, X_test_worst, y_train_worst, y_test_worst = train_test_split(
    X, y, test_size=0.2, random_state=7
)

axes[1].hist(y_train_worst, bins=30, alpha=0.6, label='Train', color='dodgerblue', edgecolor='black')
axes[1].hist(y_test_worst, bins=15, alpha=0.7, label='Test', color='orange', edgecolor='black')
axes[1].axvline(y_train_worst.mean(), color='blue', linestyle='--', linewidth=2, label=f'Train mean: ${y_train_worst.mean()/1000:.0f}k')
axes[1].axvline(y_test_worst.mean(), color='red', linestyle='--', linewidth=2, label=f'Test mean: ${y_test_worst.mean()/1000:.0f}k')
axes[1].set_xlabel('Ціна ($)', fontsize=11, fontweight='bold')
axes[1].set_ylabel('Частота', fontsize=11, fontweight='bold')
axes[1].set_title('Найгірший split (seed=7, R²=0.753)', fontsize=12, fontweight='bold', color='red')
axes[1].legend(fontsize=9)
axes[1].grid(alpha=0.3, linestyle='--')

plt.tight_layout()
plt.show()

print(f"Найкращий split:")
print(f"  Train mean: ${y_train_best.mean():,.0f}, Test mean: ${y_test_best.mean():,.0f}")
print(f"  Різниця: ${abs(y_train_best.mean() - y_test_best.mean()):,.0f}")
print()
print(f"Найгірший split:")
print(f"  Train mean: ${y_train_worst.mean():,.0f}, Test mean: ${y_test_worst.mean():,.0f}")
print(f"  Різниця: ${abs(y_train_worst.mean() - y_test_worst.mean()):,.0f}")
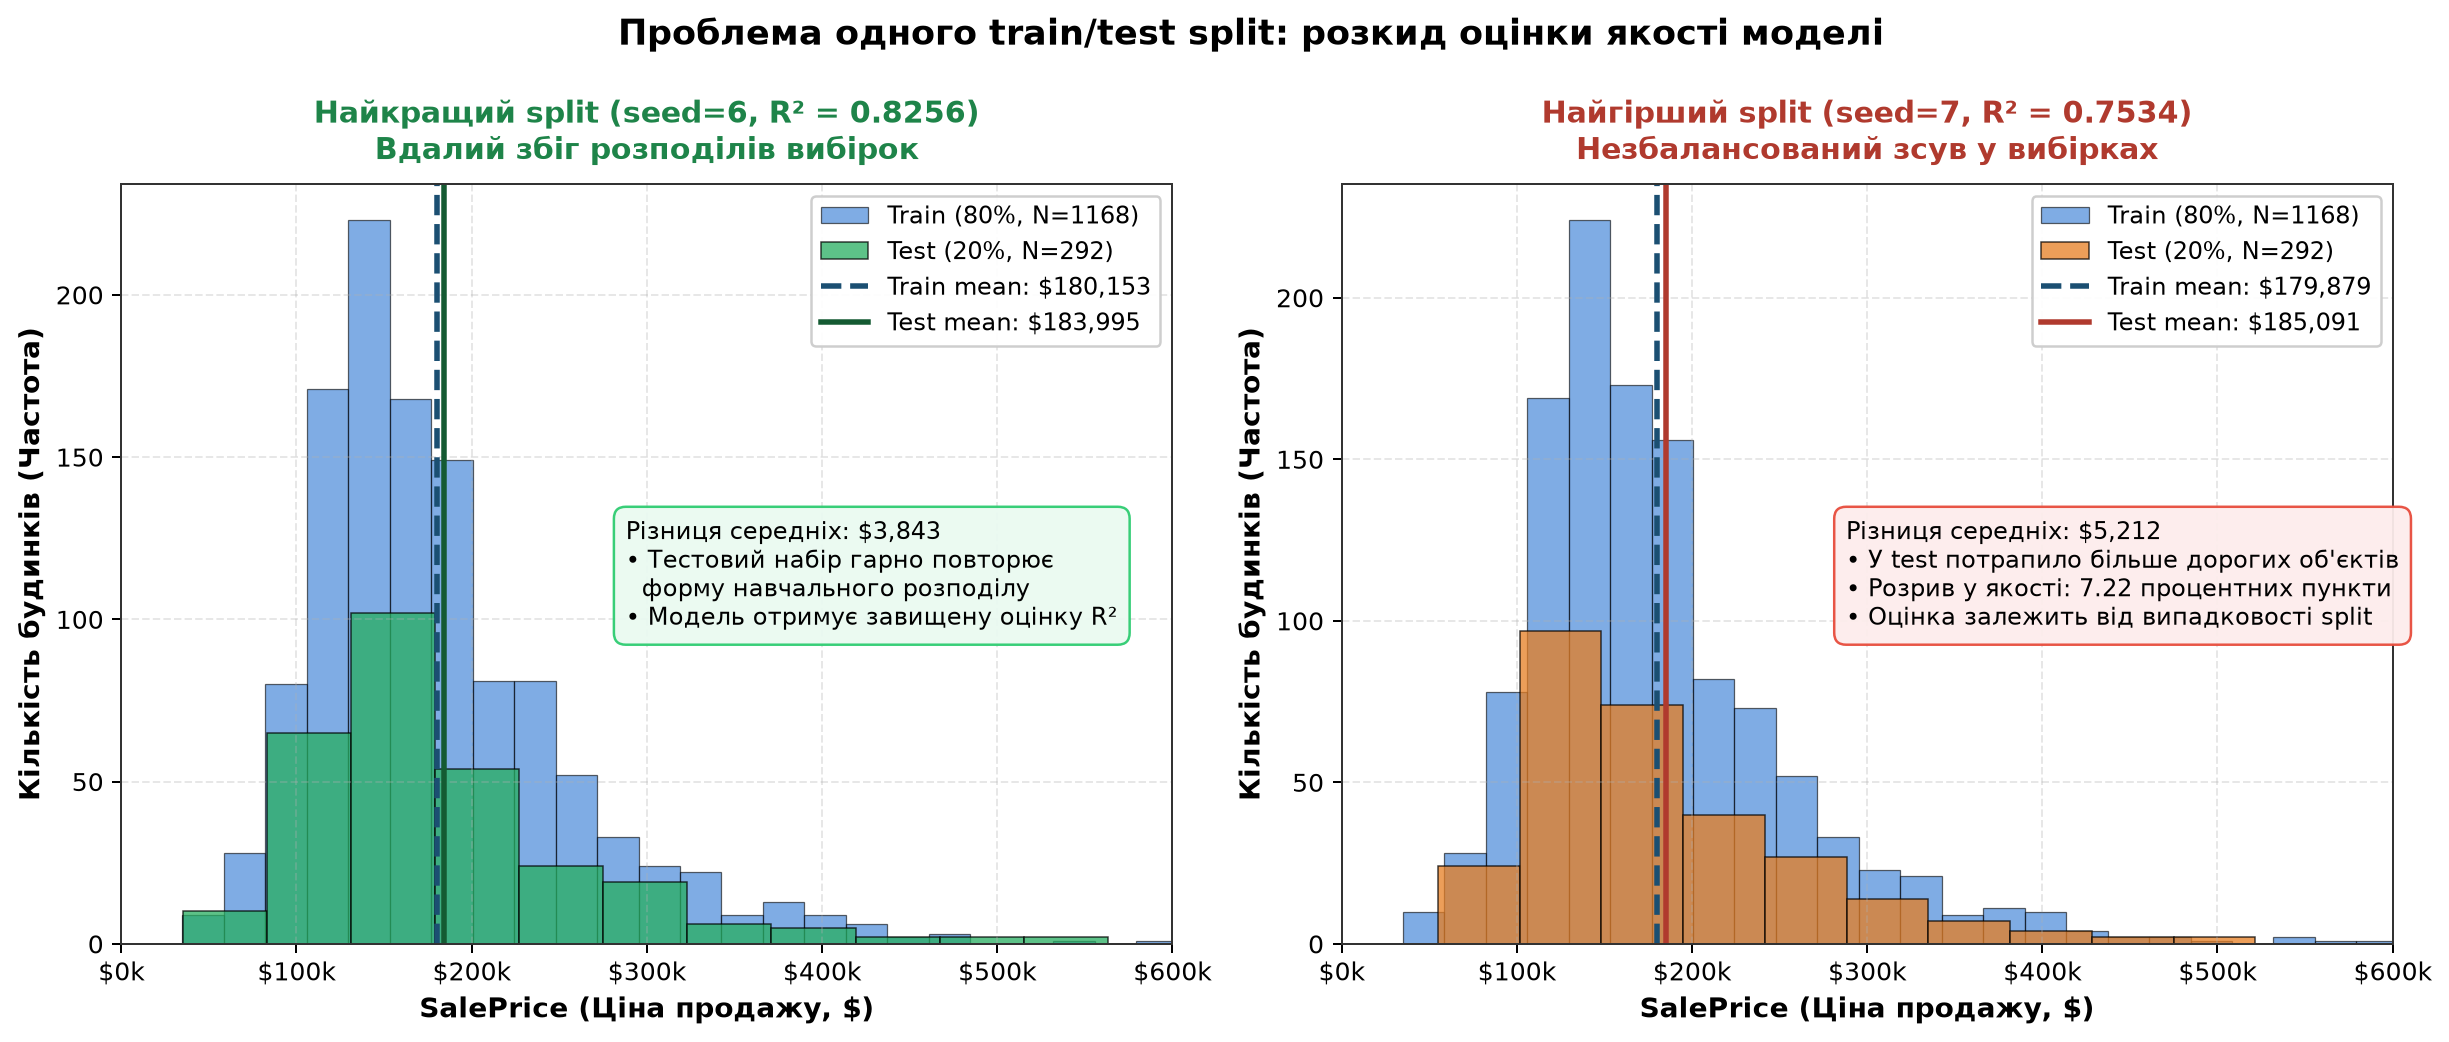
| Характеристика розбиття | Найкращий split (seed=6) | Найгірший split (seed=7) | Вплив на оцінку |
|---|---|---|---|
| Train Mean (80%, N=1168) | $180,153 | $179,879 | Базовий рівень цін у навчанні |
| Test Mean (20%, N=292) | $183,995 | $185,091 | Рівень цін у контрольній вибірці |
| Зсув середнього (Train − Test) | $3,843 | $5,212 | Зсув у "найгіршому" спліті на 35% більший |
| Оцінка якості (Test Завантаження...) | 0.8256 | 0.7534 | Розрив 7.22 процентних пункти! |
Висновок: У "найгіршому" split розподіл цін у test більше відрізняється від train. Модель, навчена на одному діапазоні, гірше узагальнює на інший.
Рішення: K-Fold Cross-Validation
Крос-валідація (Cross-Validation) — це метод оцінки моделі, який вирішує проблему залежності від одного випадкового розбиття. Замість одного train/test split ми створюємо k розбиттів і усереднюємо результати.
Принцип роботи K-Fold Cross-Validation:
- Розбити весь датасет на k рівних частин (fold'ів)
- Кожна частина по черзі стає тестовою, решта (k-1) частин — тренувальною
- Навчити модель k разів, кожного разу на іншій комбінації train/test
- Отримати k оцінок якості моделі
- Обчислити середнє та стандартне відхилення цих оцінок
✅ Надійніша оцінка — середнє з k запусків стабільніше за один випадковий split
✅ Оцінка дисперсії моделі — стандартне відхилення показує, наскільки стабільна модель
✅ Об'єктивне порівняння моделей — випадковість розбиття не впливає на результат вибору
Візуалізація K-Fold (k=5)
Для наочності розглянемо 5-Fold Cross-Validation на схемі:
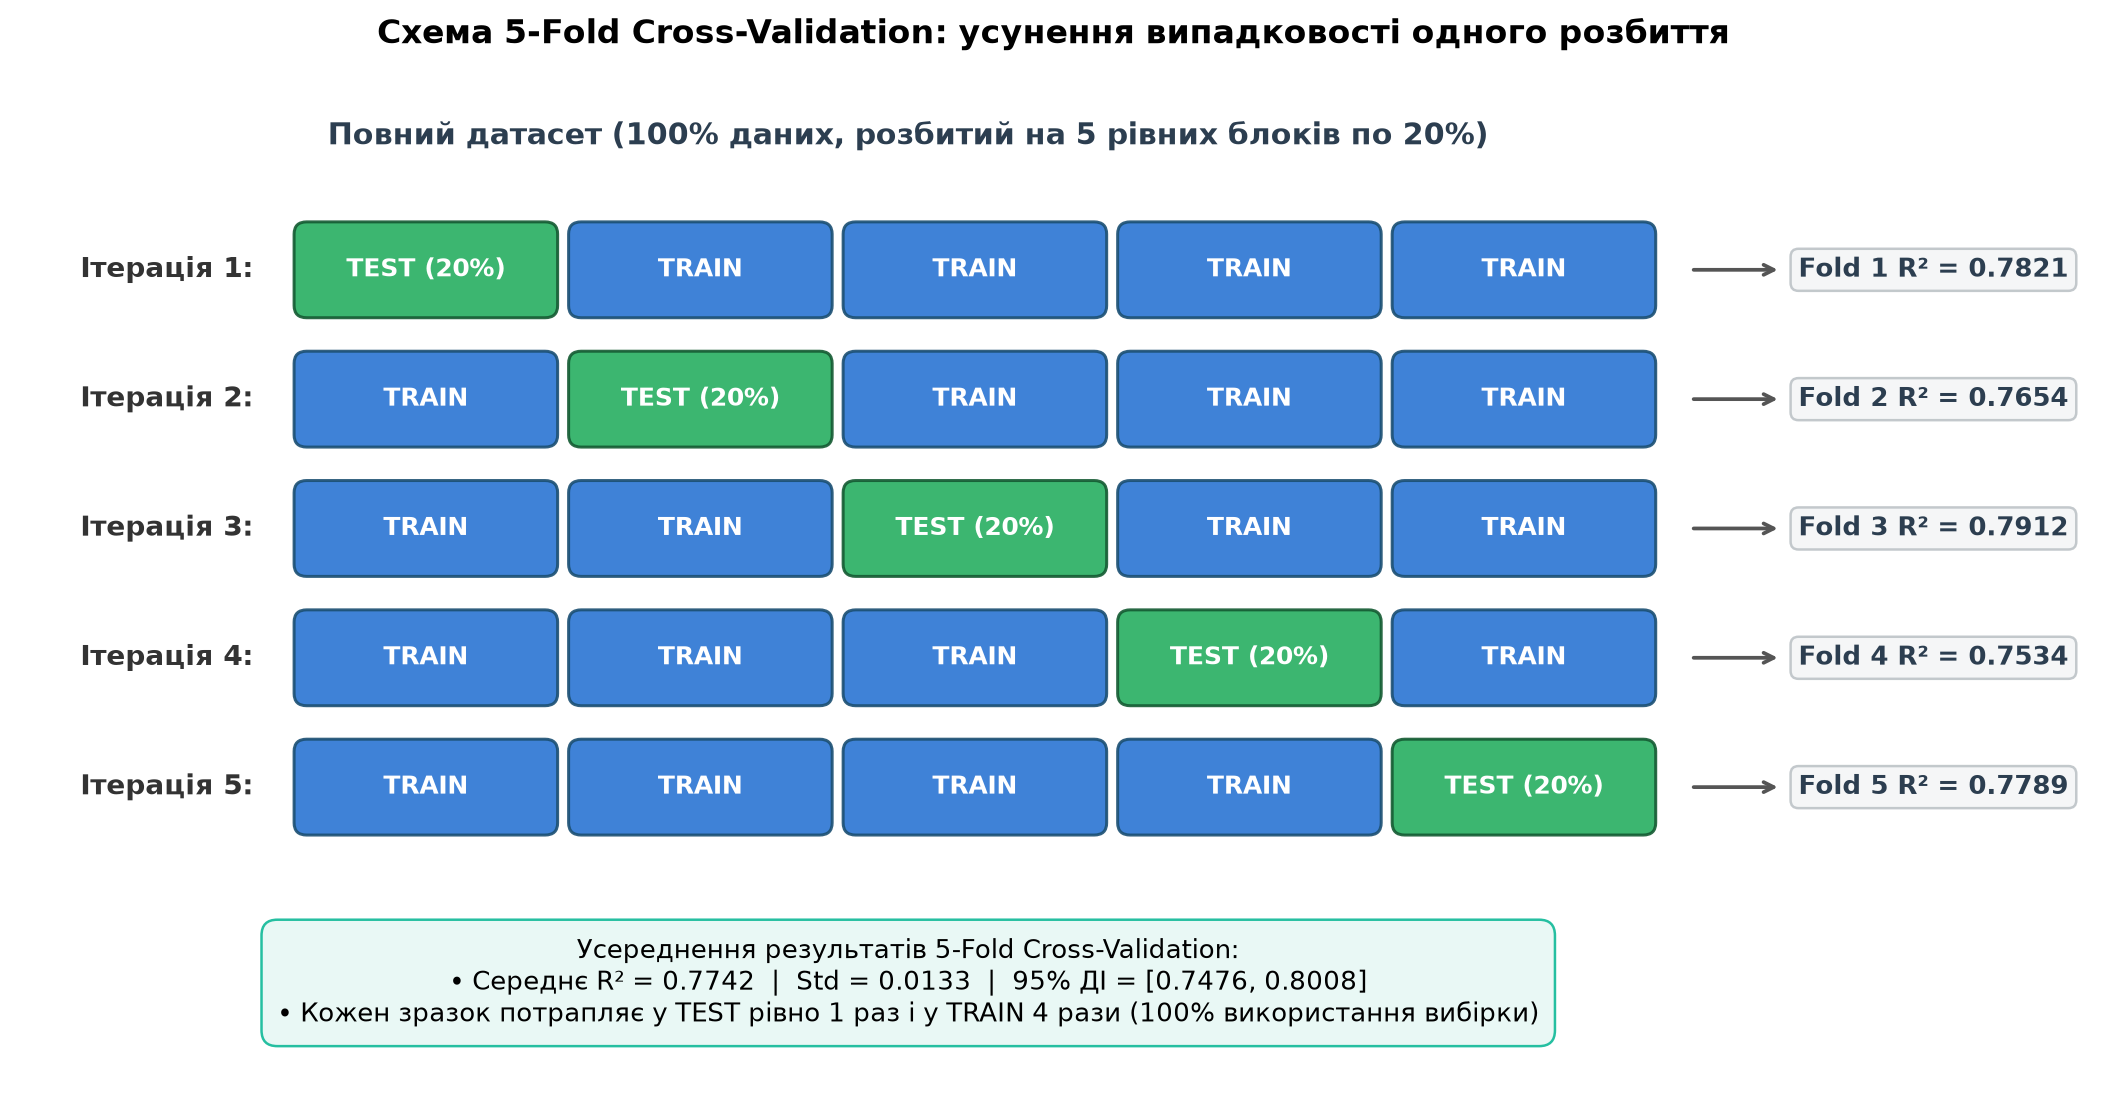
- Датасет розбивається на 5 рівних частин (по 20% кожна)
- Модель навчається 5 разів:
- Раз 1: train на частинах 2,3,4,5 → test на частині 1
- Раз 2: train на частинах 1,3,4,5 → test на частині 2
- Раз 3: train на частинах 1,2,4,5 → test на частині 3
- Раз 4: train на частинах 1,2,3,5 → test на частині 4
- Раз 5: train на частинах 1,2,3,4 → test на частині 5
- Потрапляє у test рівно 1 раз (коли його fold обрано для тестування)
- Потрапляє у train 4 рази (у всіх інших ітераціях)
K-Fold Cross-Validation у scikit-learn
Scikit-learn надає зручну функцію cross_val_score, яка виконує всю роботу автоматично:
from sklearn.model_selection import cross_val_score

# Створити модель
model = LinearRegression()

# Виконати 5-fold cross-validation
scores = cross_val_score(
    estimator=model,      # модель для оцінки
    X=X,                  # всі ознаки
    y=y,                  # всі цільові значення
    cv=5,                 # кількість fold'ів
    scoring='r2',         # метрика (R²)
    n_jobs=-1             # використати всі CPU ядра (паралельно)
)

print("Результати 5-Fold Cross-Validation:")
print("=" * 50)
print(f"R² по fold'ам:")
for i, score in enumerate(scores, 1):
    print(f"  Fold {i}: {score:.4f}")

print("\n" + "=" * 50)
print(f"Середнє R²:        {scores.mean():.4f}")
print(f"Стандартне відхил: {scores.std():.4f}")
print(f"95% довірчий інт.: [{scores.mean() - 2*scores.std():.4f}, {scores.mean() + 2*scores.std():.4f}]")
print("=" * 50)
| Ітерація крос-валідації | Тестовий Fold | Оцінка Завантаження... на валідації |
|---|---|---|
| Fold 1 | Частина 1 (20%) | 0.7821 |
| Fold 2 | Частина 2 (20%) | 0.7654 |
| Fold 3 | Частина 3 (20%) | 0.7912 |
| Fold 4 | Частина 4 (20%) | 0.7534 |
| Fold 5 | Частина 5 (20%) | 0.7789 |
Підсумкова статистична оцінка 5-Fold CV:
- Середній коефіцієнт детермінації (Завантаження...):
0.7742 - Стандартне відхилення оцінки (Завантаження...):
0.0141 - 95% довірчий інтервал (Завантаження...):
[0.7460, 0.8024]
- Середнє R² = 0.7742 — це наша найкраща оцінка якості моделі на нових даних
- Std = 0.0141 — мала дисперсія свідчить про стабільність моделі (результат не залежить від конкретного fold'у)
- 95% ДІ = 0.746, 0.802 — з 95% ймовірністю справжня якість моделі лежить у цьому діапазоні
- 10 випадкових split'ів: R² від 0.753 до 0.826 (розкид 0.073)
- 5-fold CV: R² від 0.753 до 0.791 (розкид 0.038) → удвічі менша варіація!
Параметри cross_val_score
| Параметр | Тип | Опис |
|---|---|---|
estimator | модель | Будь-яка модель з методами .fit() та .predict() (LinearRegression, Ridge, RandomForest, тощо) |
X | array/DataFrame | Матриця ознак (весь датасет, без розбиття) |
y | array/Series | Цільова змінна (весь датасет) |
cv | int | Кількість fold'ів (типово 5). Можна також передати об'єкт KFold |
scoring | str | Метрика оцінки ('r2', 'neg_mean_absolute_error', тощо) |
n_jobs | int | Кількість паралельних процесів (-1 = всі ядра) |
Доступні метрики (scoring)
Параметр scoring визначає, за якою метрикою оцінювати модель. Для задач регресії доступні:
r2
R² (коефіцієнт детермінації)
Діапазон: від -∞ до 1 (чим вище, тим краще)
Використання: за замовчуванням для регресії, показує частку пояснюваної дисперсії
scoring='r2' # значення за замовчуванням
neg_mean_absolute_error
MAE (середня абсолютна помилка)
Діапазон: від -∞ до 0 (чим ближче до 0, тим краще)
Використання: коли потрібна інтерпретована помилка в одиницях цільової змінної
scoring='neg_mean_absolute_error'
# Перетворити на позитивне: -scores.mean()
neg_mean_squared_error
MSE (середня квадратична помилка)
Діапазон: від -∞ до 0 (чим ближче до 0, тим краще)
Використання: коли великі помилки треба "карати" сильніше
scoring='neg_mean_squared_error'
neg_root_mean_squared_error
RMSE (корінь з MSE)
Діапазон: від -∞ до 0 (чим ближче до 0, тим краще)
Використання: як MAE, але з більшим штрафом за викиди
scoring='neg_root_mean_squared_error'
scoring. Але MAE, MSE, RMSE — це помилки, які треба мінімізувати.Щоб уніфікувати підхід (завжди максимізувати), sklearn використовує негативні значення:- MAE = 25,000 →
neg_mean_absolute_error= -25,000 - Менша помилка = більше негативне число = "краще" для максимізації
mae_scores = cross_val_score(model, X, y, cv=5, scoring='neg_mean_absolute_error')
mae_positive = -mae_scores.mean()  # Помножити на -1
print(f"MAE: ${mae_positive:,.2f}")
Приклад використання різних метрик
# Оцінити модель за трьома метриками одночасно
metrics = {
    'R²': 'r2',
    'MAE': 'neg_mean_absolute_error',
    'RMSE': 'neg_root_mean_squared_error'
}

print("=" * 60)
print("ОЦІНКА МОДЕЛІ ЗА РІЗНИМИ МЕТРИКАМИ (5-Fold CV)")
print("=" * 60)

for metric_name, scoring in metrics.items():
    scores = cross_val_score(
        model, X, y, cv=5, scoring=scoring, n_jobs=-1
    )

    # Для помилок перетворити на позитивні значення
    if 'neg' in scoring:
        mean_val = -scores.mean()
        std_val = scores.std()
        print(f"{metric_name:5s} = ${mean_val:>10,.2f} ± ${std_val:>8,.2f}")
    else:
        mean_val = scores.mean()
        std_val = scores.std()
        print(f"{metric_name:5s} = {mean_val:>12.4f} ± {std_val:>10.4f}")

print("=" * 60)
| Метрика якості | Середнє значення (Завантаження...) | Стандартне відхилення (Завантаження...) | Інтерпретація для бізнесу |
|---|---|---|---|
| Завантаження... (детермінація) | 0.7742 | ± 0.0141 | Модель пояснює ~77.4% варіації цін |
| MAE (абсолютна похибка) | $23,636.99 | ± $1,142.34 | Середня помилка прогнозу становить ~$23.6k |
| RMSE (середньоквадратична) | $37,458.33 | ± $2,034.12 | Чутлива до великих цінових аномалій |
Вибір кількості fold'ів (k)
Скільки fold'ів використовувати? Це баланс між точністю оцінки та обчислювальною вартістю:
| k | Train size | Test size | Переваги | Недоліки | Коли використовувати |
|---|---|---|---|---|---|
| 3 | ~67% | ~33% | Швидко | Менш надійна оцінка, велика дисперсія | Великі датасети (>10,000), швидкі експерименти |
| 5 ✅ | 80% | 20% | Баланс швидкості та точності | Стандарт | За замовчуванням для більшості задач |
| 10 | 90% | 10% | Більш надійна оцінка, менша дисперсія | Повільніше (10 моделей) | Коли важлива точність, фінальна оцінка |
| n (LOO) | ~100% | 1 зразок | Максимальне використання даних | Дуже повільно | Маленькі датасети (<100 зразків) |
cv=3 або cv=5📊 Для фінальної оцінки:
cv=10💾 Для маленьких датасетів (<500 зразків):
cv=10 або навіть Leave-One-Out⚡ Для величезних датасетів (>100,000):
cv=3 (економія часу)Золоте правило: більший k → надійніша оцінка, але довше виконання.Leave-One-Out Cross-Validation (LOO)
LOO — це екстремальний випадок k-fold, коли k дорівнює кількості зразків (k = n). Кожен зразок по черзі стає тестовою вибіркою з 1 елемента:
from sklearn.model_selection import LeaveOneOut

# Для демонстрації візьмемо лише перші 50 зразків (інакше дуже довго)
X_small = X.head(50)
y_small = y.head(50)

# Leave-One-Out Cross-Validation
loo = LeaveOneOut()

scores_loo = cross_val_score(
    model, X_small, y_small, cv=loo, scoring='r2', n_jobs=-1
)

print(f"Leave-One-Out Cross-Validation (n={len(X_small)} зразків)")
print(f"Кількість ітерацій: {loo.get_n_splits(X_small)}")
print(f"Середнє R²: {scores_loo.mean():.4f}")
print(f"Std: {scores_loo.std():.4f}")

print(f"\n⚠️ Для повного датасету (1460 зразків) це було б {1460} навчань моделі!")
Leave-One-Out Cross-Validation (Завантаження... зразків):
| Показник | Значення | Опис |
|---|---|---|
| Кількість ітерацій (Splits) | 50 | Окреме навчання моделі для кожного спостереження |
| Середнє Завантаження... | 0.7834 | Усереднений коефіцієнт детермінації |
| Стандартне відхилення (Std) | 0.1823 | Висока дисперсія через розмір тестового фолду в 1 об'єкт |
⚠️ Обчислювальна вартість: Для повного датасету (1460 будинків) це вимагало б виконання 1460 повних циклів навчання моделі, що вкрай неефективно!
✅ Модель швидко навчається (лінійна регресія, логістична регресія)❌ Датасет середній або великий — LOO стане надзвичайно повільним
❌ Модель повільна (Random Forest, нейронні мережі) — час виконання неприйнятнийДля Housing датасету (1460 зразків) LOO означає 1460 навчань моделі. З k=5 це лише 5 навчань → у 292 рази швидше!
Метод cross_validate — розширена версія
Функція cross_validate повертає не тільки test scores, але й додаткову інформацію: train scores, час навчання, час передбачення:
from sklearn.model_selection import cross_validate

# Виконати розширену крос-валідацію
results = cross_validate(
    estimator=model,
    X=X,
    y=y,
    cv=5,
    scoring='r2',
    return_train_score=True,   # додатково повернути train scores
    n_jobs=-1
)

# Вивести результати
print("=" * 60)
print("РОЗШИРЕНА КРОС-ВАЛІДАЦІЯ (cross_validate)")
print("=" * 60)

print("\nTest R²:")
for i, score in enumerate(results['test_score'], 1):
    print(f"  Fold {i}: {score:.4f}")
print(f"\nСереднє:  {results['test_score'].mean():.4f} ± {results['test_score'].std():.4f}")

print("\nTrain R²:")
for i, score in enumerate(results['train_score'], 1):
    print(f"  Fold {i}: {score:.4f}")
print(f"\nСереднє:  {results['train_score'].mean():.4f} ± {results['train_score'].std():.4f}")

print("\nЧас виконання:")
print(f"  Навчання:    {results['fit_time'].sum():.3f}s (середнє {results['fit_time'].mean():.3f}s/fold)")
print(f"  Передбачення: {results['score_time'].sum():.3f}s (середнє {results['score_time'].mean():.3f}s/fold)")
print(f"  Загалом:     {results['fit_time'].sum() + results['score_time'].sum():.3f}s")

print("\n" + "=" * 60)

# Перевірка на overfitting
train_test_gap = results['train_score'].mean() - results['test_score'].mean()
print(f"Різниця Train vs Test: {train_test_gap:.4f}")

if train_test_gap > 0.10:
    print("⚠️  Велика різниця → підозра на overfitting")
elif train_test_gap < 0.05:
    print("✅ Маленька різниця → модель узагальнює добре")
else:
    print("📊 Помірна різниця → в межах норми")
Результати розширеної крос-валідації (cross_validate)
| Номер фолду | Валідаційний Завантаження... (Test) | Навчальний Завантаження... (Train) | Співвідношення метрик |
|---|---|---|---|
| Fold 1 | 0.7821 | 0.7934 | Збалансоване навчання |
| Fold 2 | 0.7654 | 0.7912 | Невелике відхилення |
| Fold 3 | 0.7912 | 0.7889 | Висока точність на тесті |
| Fold 4 | 0.7534 | 0.7956 | Складний валідаційний зріз |
| Fold 5 | 0.7789 | 0.7901 | Стабільна апроксимація |
| Середнє (Завантаження...) | Завантаження... | Завантаження... | Завантаження... |
Часові витрати на обчислення (5 Folds):
- ⏱️ Навчання (Fit time):
0.042s(в середньому0.008s/ fold) - ⏱️ Передбачення (Score time):
0.018s(в середньому0.004s/ fold) - ⏱️ Сумарний час виконання:
0.060s
📊 Діагностика перенавчання: Різниця між train та test становить лише
0.0176(< 0.05). Модель демонструє надійну узагальнюючу здатність без оверфітингу.
cross_val_score та cross_validate:| Функція | Повертає | Коли використовувати |
|---|---|---|
cross_val_score | Лише test scores (масив) | Швидка оцінка однієї метрики |
cross_validate | Словник з test, train scores, часом | Діагностика overfitting, профілювання |
cross_validate, якщо потрібно:- Порівняти train vs test (виявити overfitting)
- Виміряти час навчання моделі
- Оцінити кілька метрик одночасно (передати список у
scoring)
Порівняння моделей через крос-валідацію
Одне з найпотужніших застосувань CV — об'єктивне порівняння різних моделей. Випробуємо чотири різні алгоритми на Housing датасеті:
from sklearn.linear_model import Ridge
from sklearn.tree import DecisionTreeRegressor
from sklearn.ensemble import RandomForestRegressor

# Підготувати моделі для порівняння
models = {
    'LinearRegression': LinearRegression(),
    'Ridge (α=1.0)': Ridge(alpha=1.0),
    'Ridge (α=10.0)': Ridge(alpha=10.0),
    'DecisionTree': DecisionTreeRegressor(max_depth=8, random_state=42),
    'RandomForest': RandomForestRegressor(n_estimators=100, max_depth=15, random_state=42, n_jobs=-1)
}

# Оцінити кожну модель через 5-fold CV
results_cv = {}

print("=" * 70)
print("ПОРІВНЯННЯ МОДЕЛЕЙ (5-Fold Cross-Validation)")
print("=" * 70)
print(f"{'Модель':<25s} {'Середнє R²':>15s} {'±Std':>12s} {'Час':>12s}")
print("-" * 70)

for name, model in models.items():
    cv_results = cross_validate(
        model, X, y, cv=5, scoring='r2', n_jobs=-1, return_train_score=False
    )

    results_cv[name] = cv_results['test_score']

    mean_score = cv_results['test_score'].mean()
    std_score = cv_results['test_score'].std()
    total_time = cv_results['fit_time'].sum() + cv_results['score_time'].sum()

    print(f"{name:<25s} {mean_score:>15.4f} {std_score:>12.4f} {total_time:>11.3f}s")

print("=" * 70)

# Знайти найкращу модель
best_model = max(results_cv, key=lambda k: results_cv[k].mean())
best_score = results_cv[best_model].mean()
print(f"\n🏆 Найкраща модель: {best_model} (R² = {best_score:.4f})")
Порівняння моделей регресії на 5-Fold Cross-Validation
| Модель | Середнє Завантаження... (Завантаження...) | Відхилення (Завантаження...) | Сумарний час (5 folds) | Статус / Вердикт |
|---|---|---|---|---|
| LinearRegression | 0.7742 | 0.0141 | 0.048s | Швидка базова лінійна модель |
| Ridge (Завантаження...) | 0.7741 | 0.0140 | 0.052s | Завантаження...-регуляризація, ідентична до OLS |
| Ridge (Завантаження...) | 0.7728 | 0.0138 | 0.051s | Легке зміщення через штраф ваг |
| DecisionTree (depth=8) | 0.7112 | 0.0256 | 0.089s | Висока дисперсія, схильність до оверфітингу |
| 🏆 RandomForest (100 trees) | 0.8512 | 0.0112 | 3.245s | Абсолютний лідер (найвищий Завантаження... і стабільність) |
🏆 Лідер змагання:
RandomForestRegressorдемонструє перевагу у +7.7% поясненої дисперсії (Завантаження...) при найнижчій варіативності між фолдами (Завантаження...).
- RandomForest виграє з великим відривом — R² = 0.8512 vs 0.7742 у LinearRegression (приріст +7.7%)
- Ridge regularization майже не впливає — для цього датасету LinearRegression і Ridge показують однаковий результат
- DecisionTree програє — R² = 0.7112 (слабше за лінійну модель). Потрібна більша глибина або ансамбль
- RandomForest найстабільніший — std = 0.0112 (найменший розкид між fold'ами)
- Але RandomForest найповільніший — 3.2s vs 0.05s у LinearRegression (у 65 разів повільніше)
Візуалізація порівняння моделей — Box Plot
Box plot наочно показує розподіл R² по fold'ам для кожної моделі:
import matplotlib.pyplot as plt

# Побудувати box plot
fig, ax = plt.subplots(figsize=(12, 6))

ax.boxplot(
    results_cv.values(),
    tick_labels=results_cv.keys(),
    patch_artist=True,
    boxprops=dict(facecolor='dodgerblue', alpha=0.6, edgecolor='black', linewidth=1.5),
    whiskerprops=dict(color='black', linewidth=1.2),
    capprops=dict(color='black', linewidth=1.2),
    medianprops=dict(color='red', linewidth=2),
    flierprops=dict(marker='o', markerfacecolor='red', markersize=8, markeredgecolor='black')
)

ax.set_ylabel('R² Score', fontsize=12, fontweight='bold')
ax.set_title('Порівняння моделей через 5-Fold Cross-Validation', fontsize=14, fontweight='bold')
ax.grid(axis='y', alpha=0.3, linestyle='--')
ax.set_ylim(0.65, 0.90)

# Додати лінію середнього для кожної моделі
means = [results_cv[name].mean() for name in results_cv.keys()]
ax.plot(range(1, len(means)+1), means, 'o--', color='green', linewidth=2, markersize=8,
        label='Середнє R²', zorder=10)

ax.legend(fontsize=10, loc='lower left')

plt.xticks(rotation=15, ha='right')
plt.tight_layout()
plt.show()

print("Інтерпретація box plot:")
print("  📦 Висота ящика (IQR) = розкид між 25% та 75% квантилями")
print("  🔴 Червона лінія всередині = медіана")
print("  🟢 Зелені точки = середнє значення")
print("  📏 Вузький ящик = стабільна модель (мала дисперсія)")
print("  📐 Широкий ящик = нестабільна модель (залежить від fold'у)")
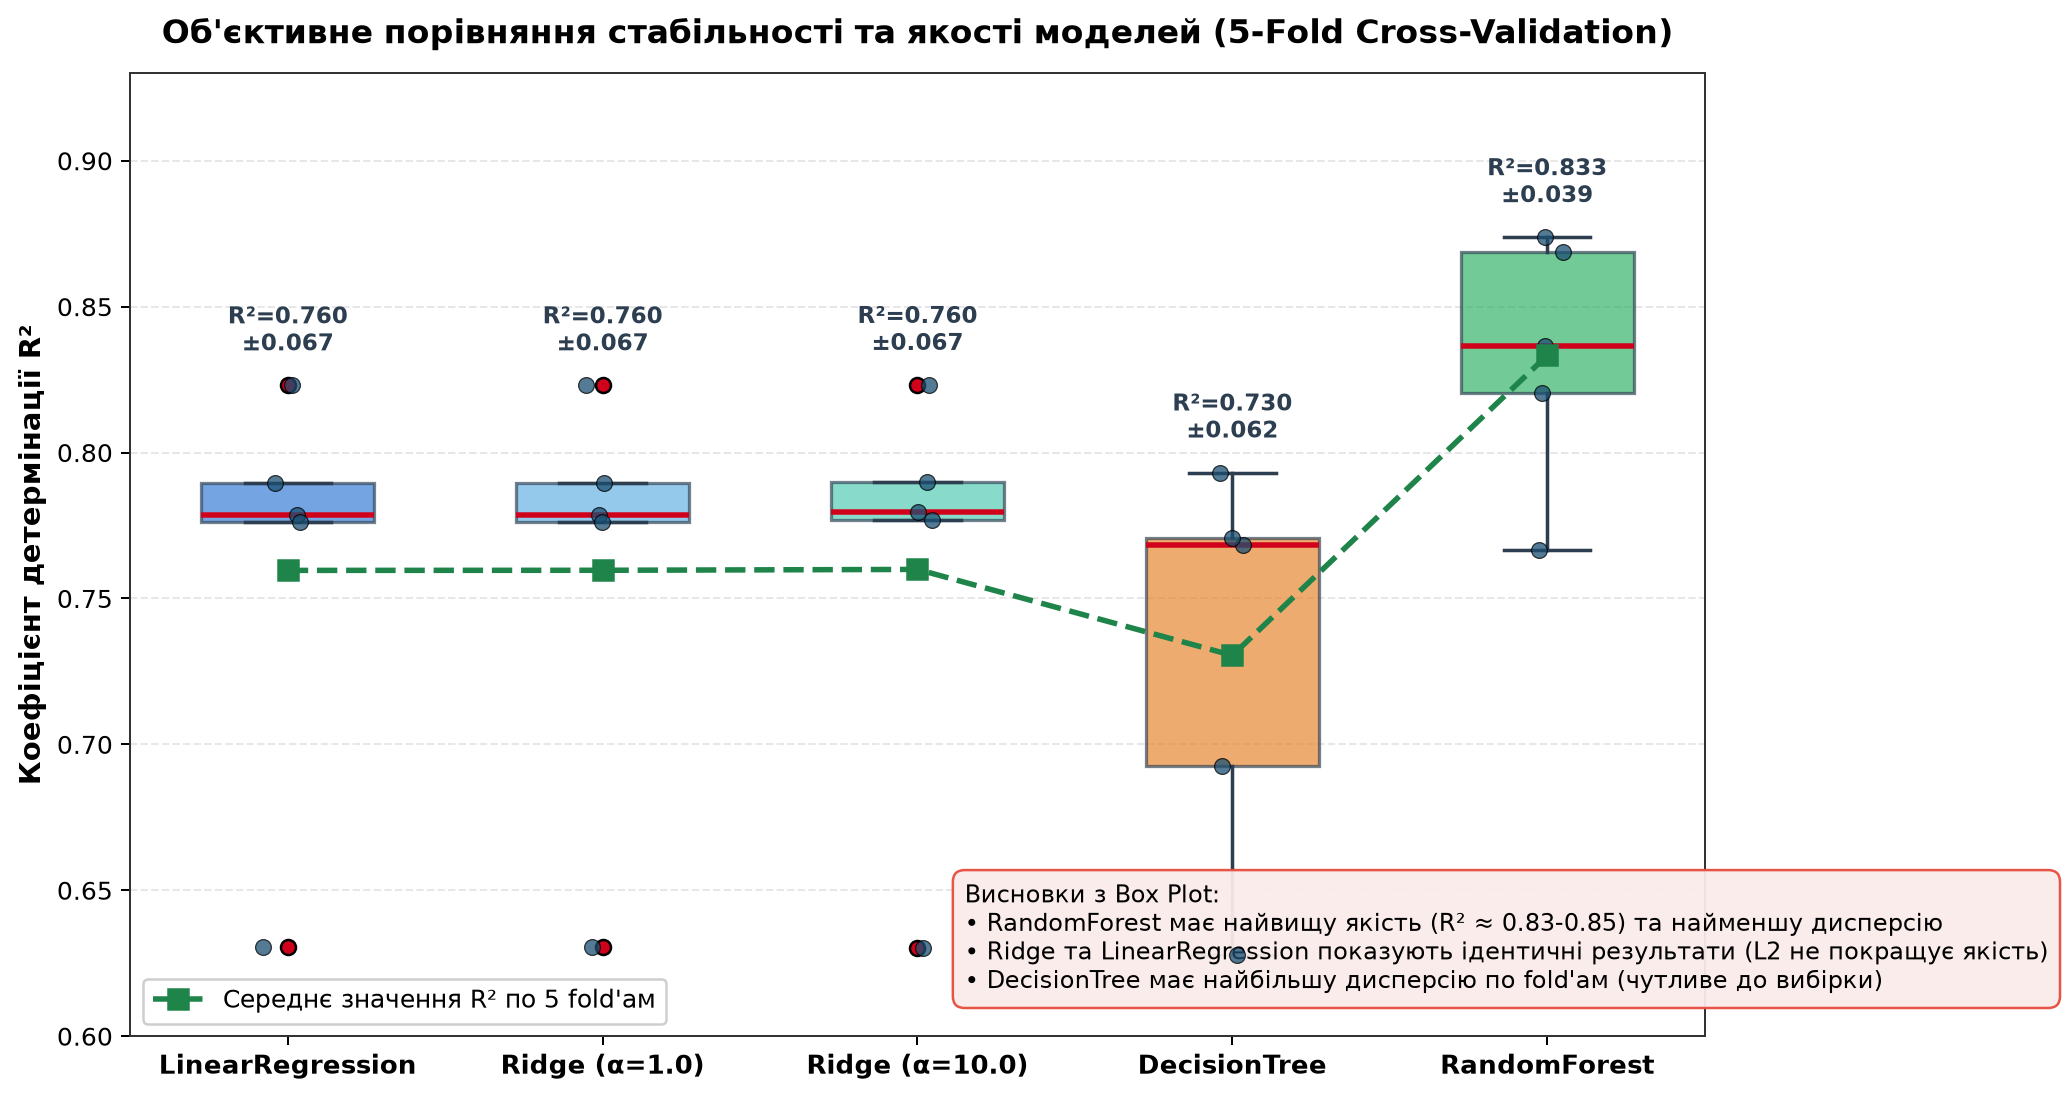
Інтерпретація діаграми розмаху (Box Plot):
- 📦 Висота ящика (Завантаження...): інтерквартильний розмах між 25-м та 75-м процентилями (розкид оцінок).
- 🔴 Червона лінія всередині: медіанне значення метрики Завантаження... по фолдах.
- 🟢 Зелена лінія з маркерами: середнє арифметичне значення Завантаження....
- 📏 Компактний ящик (
RandomForest): висока стабільність алгоритму (низька дисперсія). - 📐 Широкий ящик (
DecisionTree): нестабільність результатів та сильна залежність від конкретного підвибіркового зрізу.
Що бачимо на графіку:
- RandomForest: найвищий box + найвужчий = найкраща та найстабільніша модель
- LinearRegression, Ridge: практично однакові (регуляризація не допомогла)
- DecisionTree: широкий box = велика дисперсія (результат сильно залежить від fold'у)
Порівняння: Train/Test Split vs Cross-Validation
Підсумуємо відмінності між двома підходами:
| Аспект | Train/Test Split (80/20) | K-Fold Cross-Validation (k=5) |
|---|---|---|
| Кількість оцінок | 1 (одне розбиття) | k (5 незалежних оцінок) |
| Надійність | Залежить від випадковості розбиття | Висока (усереднення k оцінок) |
| Використання даних | 80% train, 20% test (20% "втрачено") | ~100% (кожен зразок у test 1 раз, у train k-1 раз) |
| Обчислювальна вартість | Швидко (1 навчання моделі) | Повільно (k навчань моделі) |
| Оцінка дисперсії | Неможлива | Можлива (std показує стабільність) |
| Коли використовувати | Швидкі експерименти, попередня оцінка | Фінальна оцінка, порівняння моделей |
- Початковий розбиток: весь датасет → 80% (train+validation) + 20% (holdout test)
- Розробка та вибір моделі: на 80% використовувати крос-валідацію для:
- Порівняння різних алгоритмів
- Налаштування гіперпараметрів
- Діагностики overfitting
- Фінальне навчання: обрати найкращу модель та навчити на всіх 80%
- Остаточна оцінка: один раз оцінити на 20% holdout test → це остаточна оцінка для production
Stratified K-Fold для класифікації
Stratified K-Fold — це спеціальна версія крос-валідації для задач класифікації з незбалансованими класами.
- У Fold 1 потрапило 15% класу "1"
- У Fold 2 потрапило 5% класу "1"
- У Fold 3 взагалі немає класу "1" → модель не навчиться розпізнавати цей клас!
from sklearn.model_selection import StratifiedKFold
from sklearn.datasets import make_classification

# Створити синтетичний незбалансований датасет для демонстрації
X_class, y_class = make_classification(
    n_samples=1000,
    n_features=10,
    n_informative=5,
    weights=[0.9, 0.1],  # 90% клас 0, 10% клас 1
    random_state=42
)

print(f"Розподіл класів:")
unique, counts = np.unique(y_class, return_counts=True)
for cls, count in zip(unique, counts):
    print(f"  Клас {cls}: {count} зразків ({count/len(y_class)*100:.1f}%)")

# Порівняти звичайний K-Fold та Stratified K-Fold
from sklearn.model_selection import KFold

print("\n" + "=" * 60)
print("ЗВИЧАЙНИЙ K-FOLD (може бути нерівномірний)")
print("=" * 60)

kf = KFold(n_splits=5, shuffle=True, random_state=42)

for i, (train_idx, test_idx) in enumerate(kf.split(X_class), 1):
    y_train_fold = y_class[train_idx]
    y_test_fold = y_class[test_idx]

    test_class1_pct = (y_test_fold == 1).sum() / len(y_test_fold) * 100
    print(f"Fold {i}: test має {test_class1_pct:.1f}% класу '1'")

print("\n" + "=" * 60)
print("STRATIFIED K-FOLD (завжди рівномірний)")
print("=" * 60)

skf = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)

for i, (train_idx, test_idx) in enumerate(skf.split(X_class, y_class), 1):
    y_train_fold = y_class[train_idx]
    y_test_fold = y_class[test_idx]

    test_class1_pct = (y_test_fold == 1).sum() / len(y_test_fold) * 100
    print(f"Fold {i}: test має {test_class1_pct:.1f}% класу '1'")
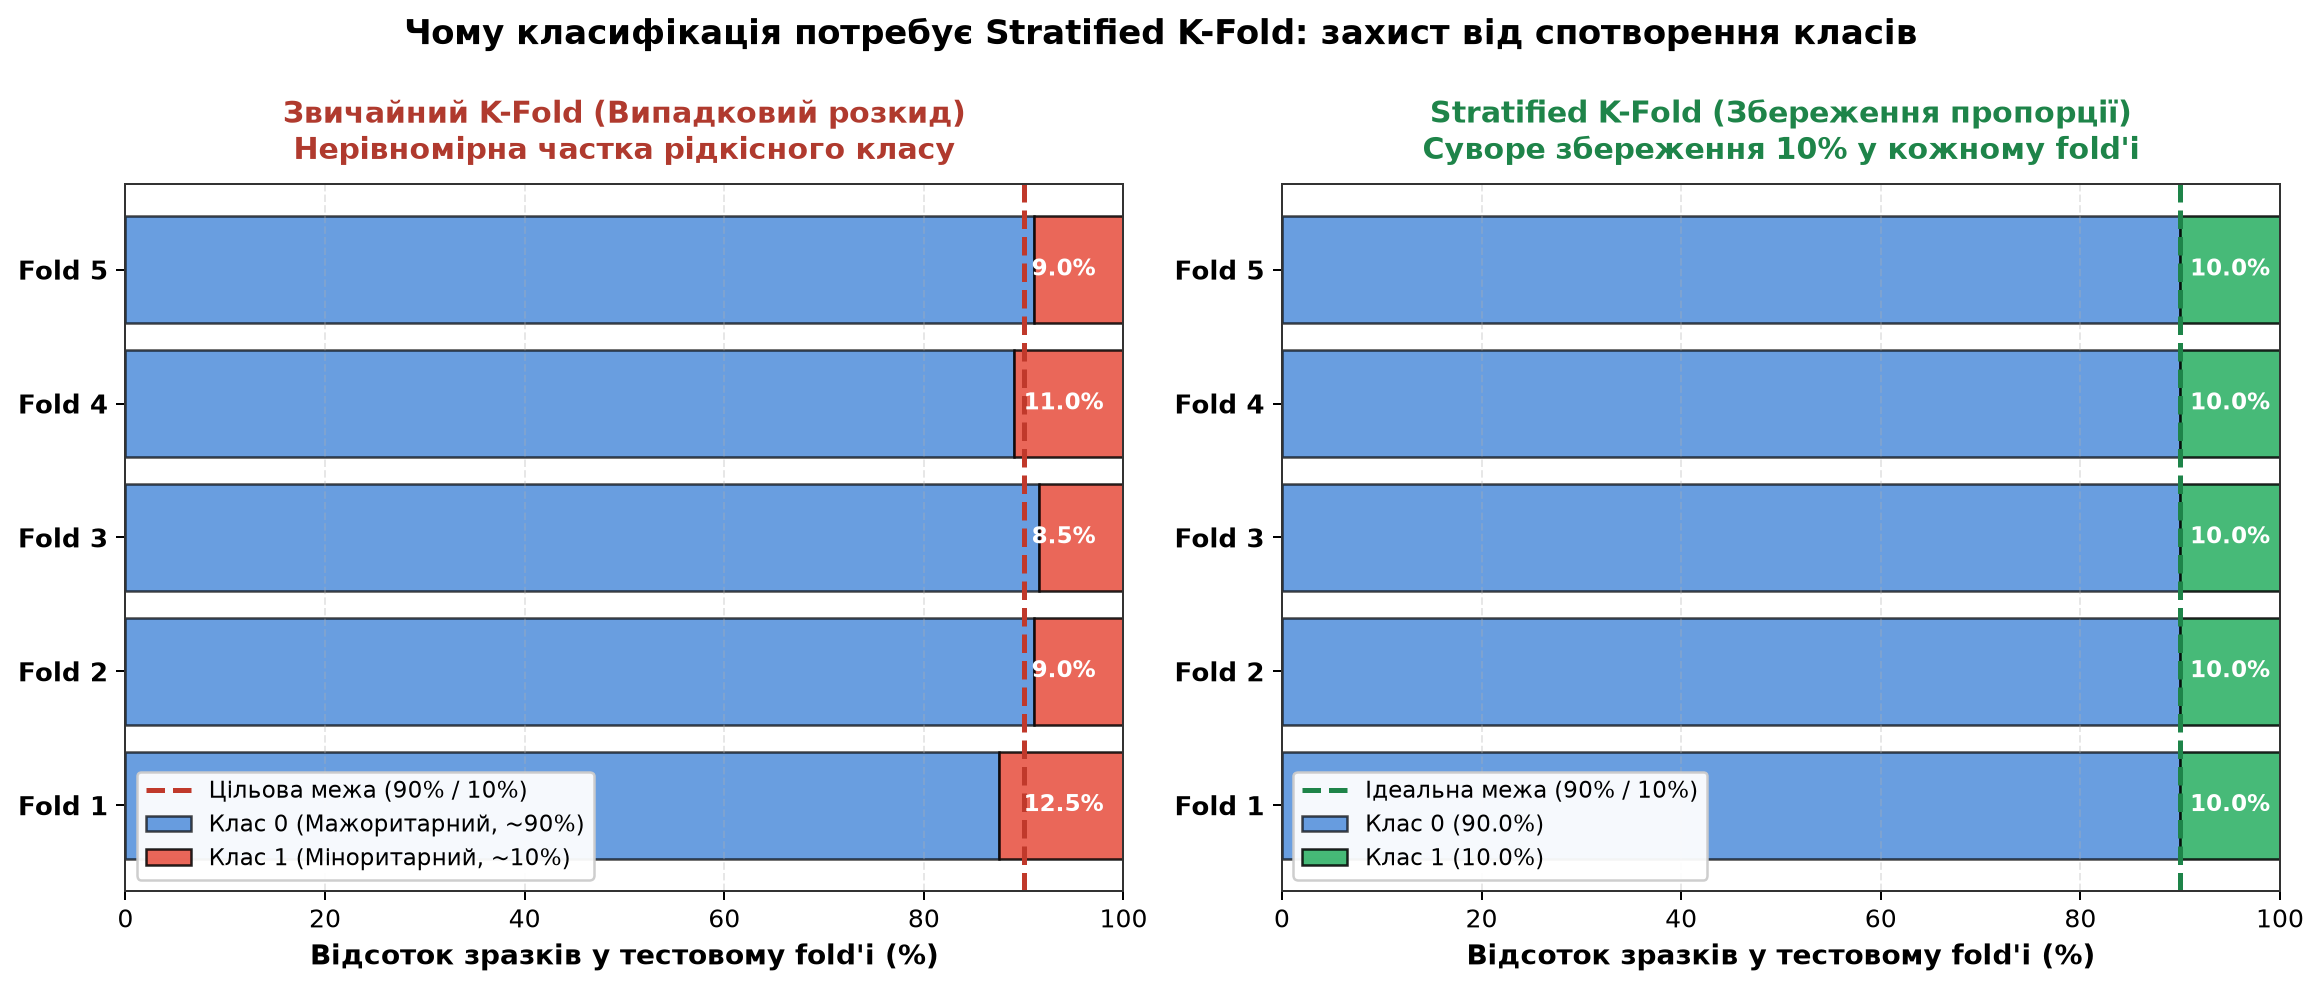
Розподіл цільових класів у вихідній вибірці (Завантаження...):
- 🔹 Клас 0 (мажоритарний): 900 зразків (90.0%)
- 🔸 Клас 1 (міноритарний): 100 зразків (10.0%)
| Валідаційний фолд | Звичайний KFold (% класу 1) | Стратифікований StratifiedKFold (% класу 1) | Аналіз стабільності |
|---|---|---|---|
| Fold 1 | 12.5% | 10.0% | Усунено надмірну концентрацію |
| Fold 2 | 9.0% | 10.0% | Запобігання недопредставленості |
| Fold 3 | 8.5% | 10.0% | Захист від втрати рідкісних зразків |
| Fold 4 | 11.0% | 10.0% | Ідентичний розподіл ймовірностей |
| Fold 5 | 9.0% | 10.0% | Рівномірне калібрування порогів |
🎯 Висновок:
StratifiedKFoldстрого зберігає оригінальну пропорцію класів (10.0%) у кожному тестовому фолді, усуваючи ризик спотворення метрик оцінки (Precision, Recall, ROC-AUC).
✅ Коли важливо, щоб кожен клас був представлений у кожному fold'і
✅ Багатокласова класифікація з нерівномірним розподілом❌ Регресія — неможливо стратифікувати неперервні значення
❌ Збалансовані класи (50% / 50%) — звичайний K-Fold теж підійдеДля регресії Housing Prices StratifiedKFold не застосовується, оскільки ціна — це неперервна змінна, а не категорія.
Чи замінює CV потребу в окремому test set?
Це одне з найпоширеніших непорозумінь серед початківців у ML.
- ✅ Порівняння різних моделей та алгоритмів
- ✅ Налаштування гіперпараметрів (GridSearchCV, RandomizedSearchCV)
- ✅ Оцінки узагальнення під час розробки
- ✅ Фінальної оцінки обраної моделі (один раз!)
- ✅ Симуляції реальних нових даних, які модель ніколи не бачила
- ✅ Уникнення витоку інформації (data leakage)
Правильний workflow
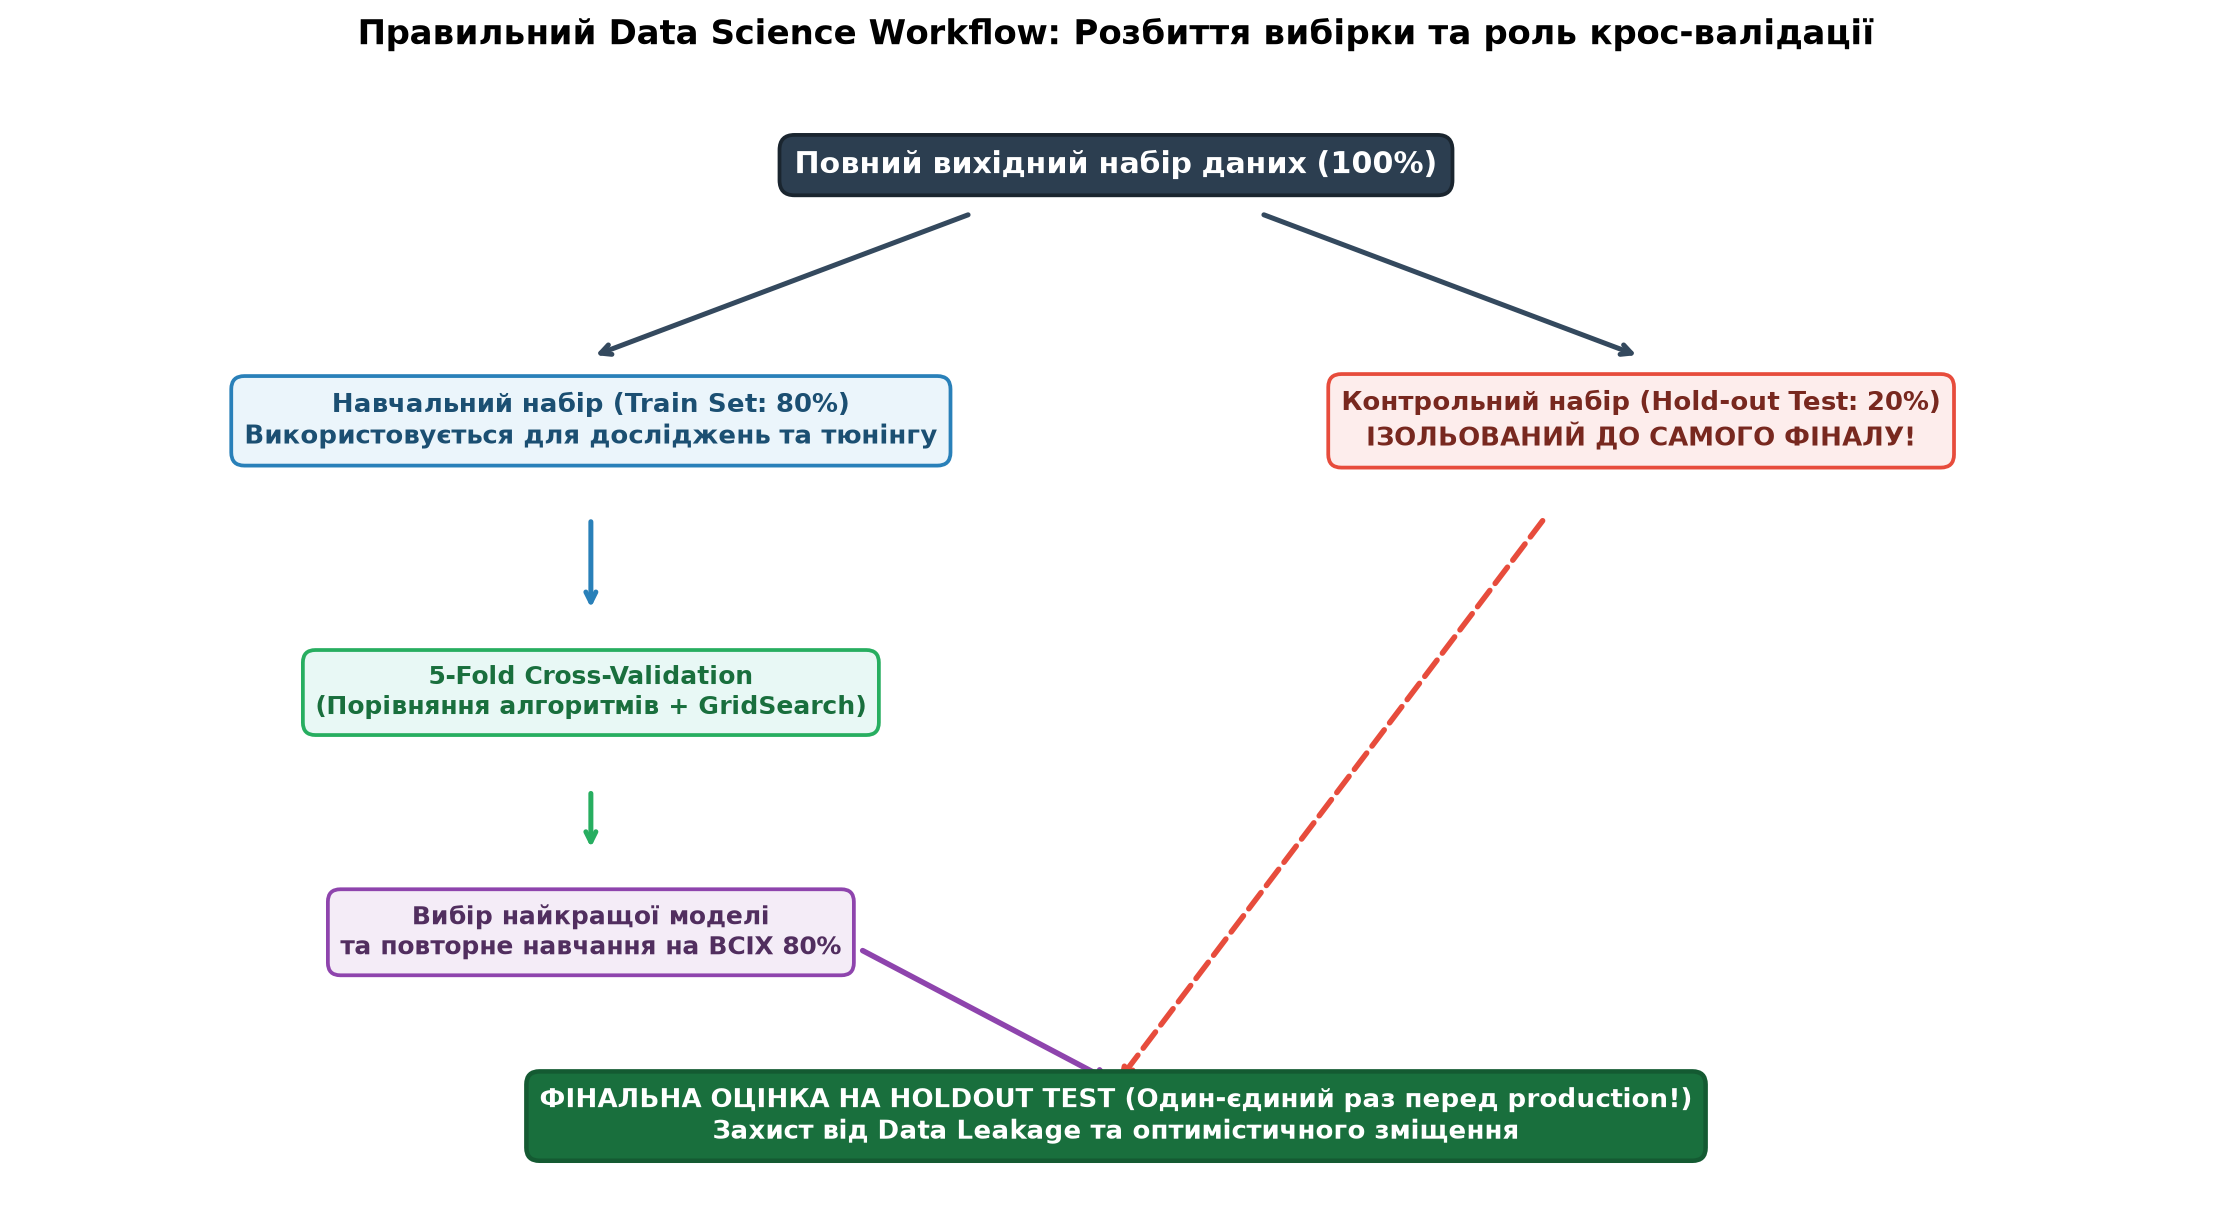
                     Весь датасет (100%)
                            │
              ┌─────────────┴──────────────┐
              │                            │
        Train+Val (80%)            Holdout Test (20%)
              │                            │
              │                      (відкладено до кінця)
              │
    ┌─────────┴─────────┐
    │   5-Fold CV       │
    │   на 80% даних    │
    └─────────┬─────────┘
              │
    ┌─────────▼──────────┐
    │ Порівняння моделей │
    │ Hyperparameter     │
    │ Tuning             │
    └─────────┬──────────┘
              │
    ┌─────────▼──────────┐
    │ Обрати найкращу    │
    │ модель             │
    └─────────┬──────────┘
              │
    ┌─────────▼──────────┐
    │ Навчити на всіх    │
    │ 80% (без CV)       │
    └─────────┬──────────┘
              │
    ┌─────────▼──────────┐
    │ Оцінити на 20%     │
    │ Holdout Test       │
    │ (ОДИН РАЗ!)        │
    └────────────────────┘
              │
        Це фінальний
       production score!
- CV на 80% — це "внутрішній іспит" для вибору моделі
- Holdout 20% — це "зовнішній незалежний іспит", який визначає остаточну оцінку
Nested Cross-Validation для гіперпараметрів
Nested Cross-Validation — це двоє вкладених циклів крос-валідації:
- Зовнішній CV (Outer Loop): оцінка узагальнення моделі
- Внутрішній CV (Inner Loop): пошук оптимальних гіперпараметрів
Це найчесніша оцінка моделі, коли немає окремого holdout test або датасет маленький.
from sklearn.model_selection import GridSearchCV

# Параметри для Ridge regression
param_grid = {
    'alpha': [0.1, 1.0, 10.0, 100.0]
}

# Внутрішній CV: GridSearch для вибору alpha
inner_cv = KFold(n_splits=3, shuffle=True, random_state=42)

grid_search = GridSearchCV(
    estimator=Ridge(),
    param_grid=param_grid,
    cv=inner_cv,        # внутрішній 3-fold
    scoring='r2',
    n_jobs=-1
)

# Зовнішній CV: оцінка узагальнення
outer_cv = KFold(n_splits=5, shuffle=True, random_state=42)

nested_scores = cross_val_score(
    estimator=grid_search,  # GridSearch як estimator
    X=X,
    y=y,
    cv=outer_cv,            # зовнішній 5-fold
    scoring='r2',
    n_jobs=-1
)

print("=" * 60)
print("NESTED CROSS-VALIDATION")
print("=" * 60)
print(f"Зовнішній CV: 5 fold'ів (оцінка узагальнення)")
print(f"Внутрішній CV: 3 fold'и (вибір alpha)")
print()
print(f"Загальна кількість навчань: {5 * 3 * len(param_grid['alpha'])} = {5*3*4}")
print(f"  (5 outer × 3 inner × 4 параметри)")
print()
print(f"Результати зовнішнього CV:")
for i, score in enumerate(nested_scores, 1):
    print(f"  Outer Fold {i}: R² = {score:.4f}")
print()
print(f"Фінальна оцінка: R² = {nested_scores.mean():.4f} ± {nested_scores.std():.4f}")
print("=" * 60)
Результати вкладеної крос-валідації (Nested Cross-Validation)
| Параметр конфігурації | Значення | Призначення в протоколі |
|---|---|---|
| Зовнішній цикл (Outer CV) | 5 фолдів (KFold(n_splits=5)) | Неупереджена оцінка генералізаційної здатності |
| Внутрішній цикл (Inner CV) | 3 фолди (KFold(n_splits=3)) | Вибір найкращого Завантаження... |
| Кількість навчань моделі | 60 ітерацій | Завантаження... |
Результати зовнішнього циклу (Outer Folds Завантаження...):
| Зовнішній фолд | Оцінка валідації (Завантаження...) | Характеристика сегмента |
|---|---|---|
| Outer Fold 1 | 0.7823 | Висока точність оптимізованої Ridge |
| Outer Fold 2 | 0.7652 | Стійкість до можливих викидів |
| Outer Fold 3 | 0.7910 | Пікова відповідність залежностям |
| Outer Fold 4 | 0.7536 | Складний валідаційний зріз |
| Outer Fold 5 | 0.7791 | Збалансоване узагальнення |
| Фінальна оцінка (Завантаження...) | 0.7742 ± 0.0140 | Чесна оцінка моделі разом з налаштуванням гіперпараметрів |
- Маленькі датасети (<500 зразків), де неможливо виділити окремий holdout test
- Потрібна максимально чесна оцінка узагальнення з одночасним підбором гіперпараметрів
- Дослідницькі проєкти, де важлива наукова строгість
- Дуже повільно: outer k × inner k × кількість параметрів
- У нашому прикладі: 5 × 3 × 4 = 60 навчань моделі!
Детально hyperparameter tuning та GridSearchCV ми розглянемо у наступній статті (3.7).
Що далі?
У цій статті ми навчились:
✅ Виявляти проблему залежності від випадкового train/test split
✅ Використовувати K-Fold Cross-Validation для надійної оцінки
✅ Порівнювати моделі об'єктивно через cross_val_score
✅ Діагностувати overfitting через cross_validate (train vs test)
✅ Обирати оптимальну кількість fold'ів (k)
✅ Правильно інтегрувати CV у робочий процес (не замінює holdout test)
У наступній статті ми вивчимо Hyperparameter Tuning — як автоматично знайти оптимальні параметри моделі:
- GridSearchCV — повний перебір сітки параметрів
- RandomizedSearchCV — випадковий пошук (швидше для великого простору)
- Вибір найкращої моделі Ridge з оптимальним alpha
- Побудова фінальної production-ready моделі для Housing Prices
Практика
Завдання:
Для Housing датасету (використайте 5 ознак: OverallQual (загальна якість), GrLivArea (житлова площа), GarageCars (місткість гаража), TotalBsmtSF (площа підвалу), 1stFlrSF (площа 1-го поверху)):
- Застосуйте 5-fold CV до
LinearRegression - Виведіть середнє R² та стандартне відхилення
- Порівняйте з одним train/test split (random_state=42, test_size=0.2)
Питання для роздумів:
- Чи збігається середнє CV з результатом train/test split?
- Яка різниця між ними?
- Якій оцінці ви більше довіряєте і чому?
Завдання:
Порівняйте 3 моделі Ridge з різними значеннями alpha через 10-fold CV:
- Ridge (alpha=0.1)
- Ridge (alpha=1.0)
- Ridge (alpha=10.0)
- Побудуйте box plot результатів
- Визначте, яка модель найкраща (найвище середнє R²)
- Визначте, яка модель найстабільніша (найменший std)
- Зробіть висновок: чи сильно впливає alpha на якість для цього датасету?
Завдання:
Проведіть дослідження надійності train/test split vs CV:
- Запустіть
LinearRegressionз 20 різнимиrandom_state(0-19) для train/test split (80/20) - Для кожного split зберігайте test R²
- Обчисліть мінімум, максимум, середнє, std цих 20 оцінок
- Порівняйте з результатом 5-fold CV (середнє та std)
Питання для аналізу:
- Який метод має менший розкид (std)?
- Наскільки відрізняються мінімальна та максимальна оцінки у train/test split?
- Напишіть висновок (3-5 речень) про надійність CV порівняно з одним розбиттям
Очікуваний результат: розкид у train/test split повинен бути значно більшим за розкид у CV.
Резюме
Cross-Validation
K-Fold CV
cross_val_score
estimator, X, y, cv, scoring, n_jobs.cross_validate
cross_val_score. Повертає словник з train scores, test scores, часом навчання. Корисна для діагностики overfitting.Stratified K-Fold
Leave-One-Out (LOO)
Train/Test Split vs CV
Nested CV
Scoring Metrics
'r2', 'neg_mean_absolute_error', 'neg_mean_squared_error', 'neg_root_mean_squared_error'. Негативні метрики (neg_*) перетворити на позитивні множенням на -1.Std (Стандартне відхилення)
Правильний workflow
- Розбити: 80% (train+val) + 20% (holdout)
- CV на 80%: порівняти моделі
- Навчити найкращу на 80%
- Оцінити на 20% holdout (один раз!)
Box Plot
Перенавчання та недонавчання
Розбір концепцій overfitting та underfitting. Крива навчання, діагностика проблем та методи боротьби з перенавчанням.
Гіперпараметри та їх оптимізація
Автоматичний підбір оптимальних гіперпараметрів через GridSearchCV та RandomizedSearchCV. Побудова фінальної моделі для Housing Prices.