Exploratory Data Analysis датасету Housing Prices
У попередній статті ми навчились працювати з scikit-learn на простих синтетичних даних. Тепер настав час зануритись у реальну задачу машинного навчання — передбачення цін на житло на основі датасету з Kaggle.
Але перш ніж будувати модель, потрібно зрозуміти дані. Саме цьому присвячена практика Exploratory Data Analysis (EDA) — розвідувальний аналіз даних.
Kaggle Competition — реальна задача ML
Housing Prices: Advanced Regression Techniques — одне з найпопулярніших навчальних змагань на платформі Kaggle. У ньому взяли участь понад 5000 команд Data Scientists з усього світу.
🎯 Мета змагання
SalePrice — ціна продажу) на основі 79 ознак: площа, кількість кімнат, рік будівництва, район, якість ремонту, тощо.📊 Датасет
- 1460 будинків у тренувальному наборі
- 80 стовпців (79 ознак + ціна)
- Реальні дані з міста Ames, Iowa (США)
- Різноманітні типи ознак: числові, категоріальні
🏆 Метрика оцінки
Аналогія: це як "олімпіада з ML" — реальні дані, реальна конкуренція, реальні виклики. Те, що ви навчитесь тут, застосовується в production-моделях.
Що таке EDA (Exploratory Data Analysis)?
Exploratory Data Analysis (EDA) — це перший обов'язковий крок перед побудовою будь-якої ML-моделі. Це процес детального вивчення даних для розуміння їхньої структури, виявлення проблем та пошуку закономірностей.
Ключові питання EDA:
📋 Структура
- Які ознаки є в датасеті?
- Скільки рядків та стовпців?
- Які типи даних (числові, текстові)?
❓ Проблеми
- Чи є пропуски (NaN)?
- Чи є викиди (outliers)?
- Чи є дублікати рядків?
🔗 Зв'язки
- Які ознаки корелюють з ціною?
- Які ознаки корелюють між собою?
- Чи є нелінійні залежності?
Аналогія: EDA — це як медичний огляд перед операцією. Лікар має знати стан "пацієнта" (датасету): чи є "хвороби" (пропуски), чи все "на місці" (ознаки правильного типу), як працюють "органи" (взаємодія ознак).
Завантаження датасету
Датасет Housing Prices можна завантажити кількома способами:
# Встановіть kaggle CLI
pip install kaggle

# Завантажте датасет
kaggle competitions download -c house-prices-advanced-regression-techniques

# Розпакуйте
unzip house-prices-advanced-regression-techniques.zip
import pandas as pd

# Завантаження з GitHub (резервна копія)
url = "https://raw.githubusercontent.com/manavkapadnis/House-prices-Advanced-regression-techniques/master/train.csv"
df = pd.read_csv(url)

# Або локальний файл (якщо вже завантажили)
df = pd.read_csv("train.csv")
train.csv вручну з цього посилання та збережіть у робочу папку.Для цієї статті будемо вважати, що файл train.csv вже завантажений у вашу робочу папку.
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

# Налаштування відображення
pd.set_option('display.max_columns', None)  # Показувати всі стовпці
pd.set_option('display.width', None)
sns.set_style('whitegrid')  # Стиль графіків

# Завантаження даних
df = pd.read_csv('train.csv')

print(f"Датасет завантажено!")
print(f"Розмір: {df.shape[0]} рядків × {df.shape[1]} стовпців")
- 1460 рядків — 1460 будинків у датасеті
- 81 стовпець — 1 ідентифікатор (
Id) + 79 ознак + 1 цільова змінна (SalePrice— ціна продажу)
Перший погляд — базові методи pandas
Почнемо з швидкого огляду структури даних.
Перші рядки датасету
# Перші 5 рядків
df.head()
| Id | MSSubClass | MSZoning | LotFrontage | LotArea | Street | Alley | LotShape | ... | SalePrice | |
|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 60 | RL | 65.0 | 8450 | Pave | NaN | Reg | ... | 208500 |
| 1 | 2 | 20 | RL | 80.0 | 9600 | Pave | NaN | Reg | ... | 181500 |
| 2 | 3 | 60 | RL | 68.0 | 11250 | Pave | NaN | IR1 | ... | 223500 |
| 3 | 4 | 70 | RL | 60.0 | 9550 | Pave | NaN | IR1 | ... | 140000 |
| 4 | 5 | 60 | RL | 84.0 | 14260 | Pave | NaN | IR1 | ... | 250000 |
5 rows × 81 columns
Що бачимо:
- Багато стовпців (показано лише частину)
- Різні типи даних: числа (
LotArea— площа ділянки), текст (MSZoning— зона забудови), пропуски (NaNвAlley— тип під'їзного провулка) - Цільова змінна
SalePrice(ціна продажу) — ціна в доларах США
Інформація про стовпці
# Детальна інформація про датасет
df.info()
- Типи даних:
int64— цілі числа (35 стовпців)float64— дробові числа (3 стовпці)object— текст/категорії (43 стовпці)
- Пропуски:
LotFrontage(довжина фасаду ділянки): 1201 non-null → 259 пропусків (1460 - 1201)Alley(тип під'їзного провулка): 91 non-null → 1369 пропусків! (майже 94%)
Статистичний опис числових ознак
# Статистика для числових стовпців
df.describe()
| Id | MSSubClass | LotFrontage | LotArea | ... | SalePrice | |
|---|---|---|---|---|---|---|
| count | 1460.000000 | 1460.000000 | 1201.000000 | 1460.000000 | ... | 1460.000000 |
| mean | 730.500000 | 56.897260 | 70.049958 | 10516.828082 | ... | 180921.195890 |
| std | 421.610009 | 42.300571 | 24.284752 | 9981.264932 | ... | 79442.502883 |
| min | 1.000000 | 20.000000 | 21.000000 | 1300.000000 | ... | 34900.000000 |
| 25% | 365.750000 | 20.000000 | 59.000000 | 7553.500000 | ... | 129975.000000 |
| 50% | 730.500000 | 50.000000 | 69.000000 | 9478.500000 | ... | 163000.000000 |
| 75% | 1095.250000 | 70.000000 | 80.000000 | 11601.500000 | ... | 214000.000000 |
| max | 1460.000000 | 190.000000 | 313.000000 | 215245.000000 | ... | 755000.000000 |
8 rows × 38 columns
SalePrice (ціна продажу):- Середня ціна: $180,921
- Медіана (50%): $163,000 (нижча за середню → розподіл скошений вправо)
- Мінімум: $34,900 (дуже дешевий будинок)
- Максимум: $755,000 (дорогий будинок-викид)
- Стандартне відхилення: $79,443 (велика варіація цін)
Аналіз пропусків (Missing Values)
Пропуски — одна з найбільших проблем реальних датасетів. Давайте виявимо всі стовпці з пропусками та оцінимо їх масштаб.
# Підрахунок пропусків для кожного стовпця
missing = df.isnull().sum()
missing = missing[missing > 0].sort_values(ascending=False)

# Відсоток пропусків
missing_percent = (missing / len(df)) * 100

# Об'єднати в DataFrame
missing_df = pd.DataFrame({
    'Стовпець': missing.index,
    'Пропусків': missing.values,
    'Відсоток': missing_percent.values
})

print(f"Стовпців з пропусками: {len(missing_df)}\n")
print(missing_df.head(10))
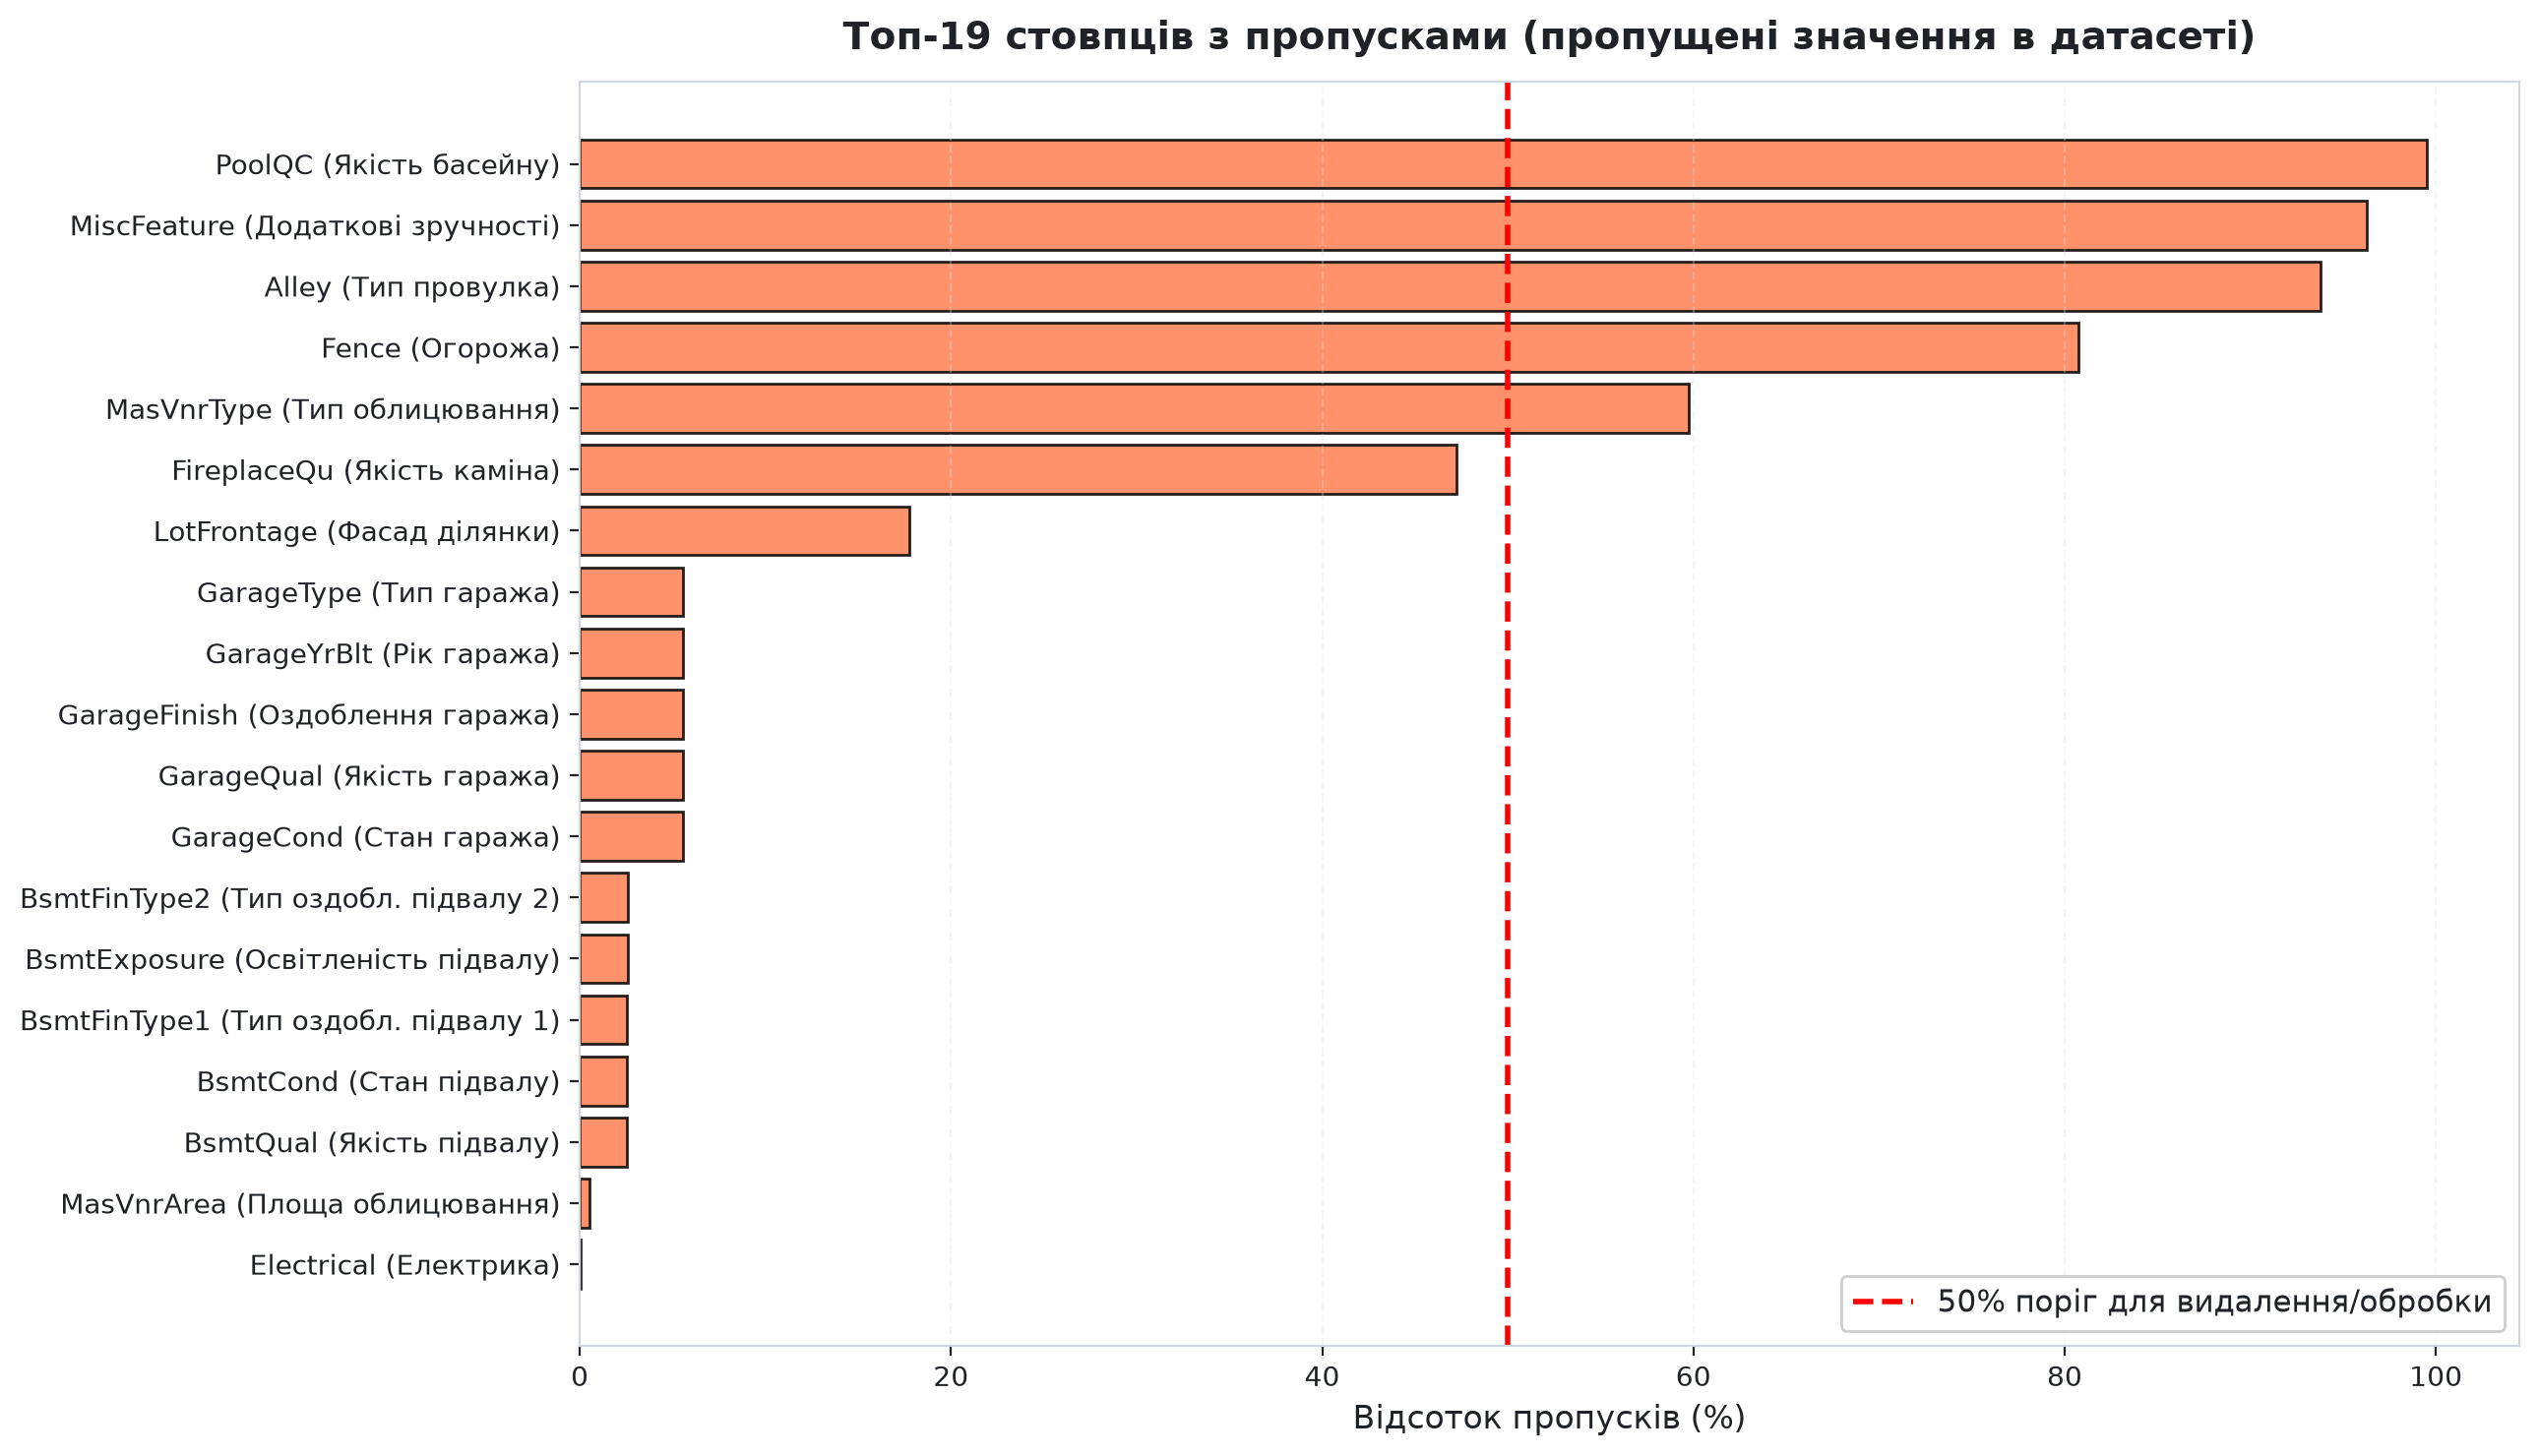
- PoolQC (якість басейну): 99.5% пропусків → майже ніхто не має басейну
- MiscFeature (додаткові зручності): 96.3% пропусків → сараї, тенісні корти тощо
- Alley (тип під'їзного провулка): 93.8% пропусків → більшість будинків без провулка
- Fence (наявність та якість огорожі): 80.8% пропусків
- FireplaceQu (якість каміна): 47.3% пропусків → у багатьох будинках взагалі немає каміна
- LotFrontage (лінійна довжина фасаду ділянки): 17.7% пропусків
- Характеристики гаража (GarageType — тип гаража, GarageYrBlt — рік побудови гаража, GarageFinish — стан внутрішнього оздоблення, GarageQual — якість гаража): по 5.5% (81 будинок взагалі не має гаража)
NaN — це проблема.Стратегія:- Стовпці з >50% пропусків → видалити або заповнити спеціальним значенням "None"
- Стовпці з <20% пропусків → заповнити (imputation)
Візуалізація пропусків
# Графік пропусків
plt.figure(figsize=(12, 6))
plt.barh(range(len(missing_df)), missing_df['Відсоток'], color='coral', edgecolor='black')
plt.yticks(range(len(missing_df)), missing_df['Стовпець'])
plt.xlabel('Відсоток пропусків (%)', fontsize=12)
plt.title('Топ-19 стовпців з пропусками', fontsize=14, fontweight='bold')
plt.axvline(50, color='red', linestyle='--', linewidth=2, label='50% поріг')
plt.legend()
plt.gca().invert_yaxis()
plt.grid(axis='x', alpha=0.3)
plt.tight_layout()
plt.show()
Аналіз цільової змінної — SalePrice (ціна продажу)
Це те, що ми хочемо передбачити. Важливо зрозуміти розподіл цін перед побудовою моделі.
Статистика та розподіл
# Базова статистика
print("Статистика SalePrice:")
print(f"  Середня:  ${df['SalePrice'].mean():,.0f}")
print(f"  Медіана:  ${df['SalePrice'].median():,.0f}")
print(f"  Мінімум:  ${df['SalePrice'].min():,.0f}")
print(f"  Максимум: ${df['SalePrice'].max():,.0f}")
print(f"  Std:      ${df['SalePrice'].std():,.0f}")

# Skewness (асиметрія)
skewness = df['SalePrice'].skew()
print(f"\nSkewness: {skewness:.4f}")
if skewness > 0.5:
    print("  → Розподіл скошений вправо (right-skewed)")
    print("  → Більшість будинків дешевші, є кілька дорогих")
Гістограма розподілу цін
# Гістограма
plt.figure(figsize=(12, 5))

plt.subplot(1, 2, 1)
plt.hist(df['SalePrice'], bins=50, color='skyblue', edgecolor='black', alpha=0.7)
plt.axvline(df['SalePrice'].mean(), color='red', linestyle='--', linewidth=2,
            label=f'Середня: ${df["SalePrice"].mean():,.0f}')
plt.axvline(df['SalePrice'].median(), color='green', linestyle='--', linewidth=2,
            label=f'Медіана: ${df["SalePrice"].median():,.0f}')
plt.xlabel('Ціна ($)', fontsize=11)
plt.ylabel('Кількість будинків', fontsize=11)
plt.title('Розподіл цін на будинки', fontsize=13, fontweight='bold')
plt.legend()
plt.grid(alpha=0.3)

# Box plot для виявлення викидів
plt.subplot(1, 2, 2)
plt.boxplot(df['SalePrice'], vert=False, patch_artist=True,
            boxprops=dict(facecolor='lightgreen', alpha=0.7),
            medianprops=dict(color='red', linewidth=2))
plt.xlabel('Ціна ($)', fontsize=11)
plt.title('Box Plot — виявлення викидів', fontsize=13, fontweight='bold')
plt.grid(alpha=0.3)

plt.tight_layout()
plt.show()
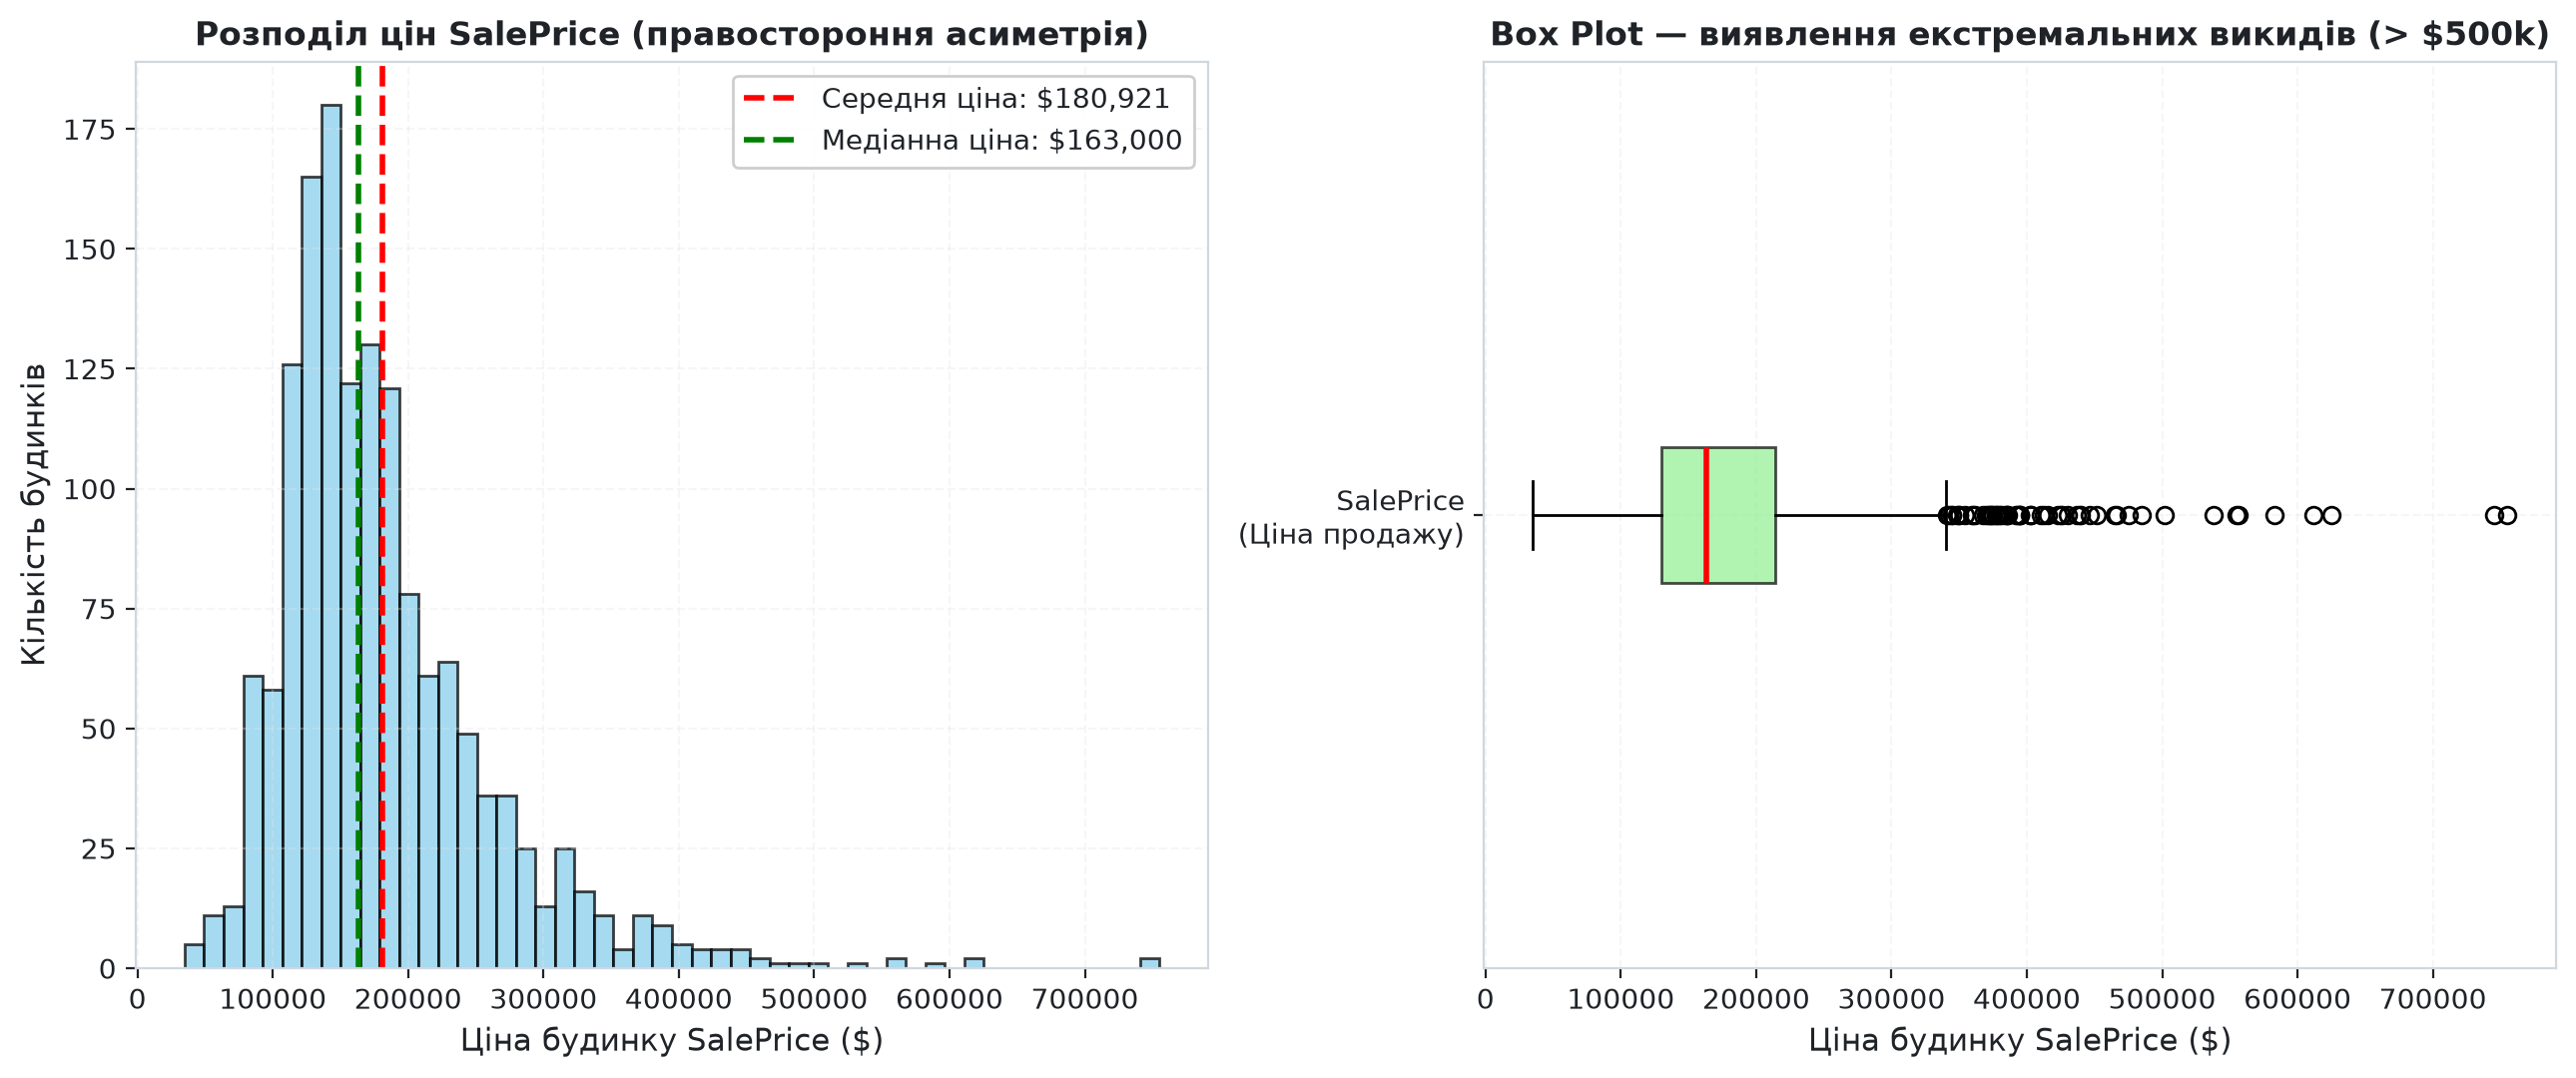
- Right-skewed — більшість будинків у діапазоні $100k-$200k
- Викиди — є будинки дорожче $500k (видно на box plot справа)
- Медіана < Середня — підтверджує скошеність розподілу
- Для ML: можливо, варто застосувати log-transformation для нормалізації (детально в статті 3.3)
Кореляційний аналіз — зв'язок з ціною
Найважливіше питання EDA: які ознаки найбільше впливають на ціну? Для цього обчислимо кореляцію між усіма числовими ознаками та цільовою змінною SalePrice (ціна продажу).
# Обчислення кореляції з ціною
numeric_cols = df.select_dtypes(include=['int64', 'float64']).columns
correlations = df[numeric_cols].corr()['SalePrice'].sort_values(ascending=False)

print("Топ-10 ознак з найбільшою позитивною кореляцією:\n")
print(correlations.head(11))  # 11, бо перший — сама ціна (1.0)

print("\n\nТоп-5 ознак з найбільшою негативною кореляцією:\n")
print(correlations.tail(5))
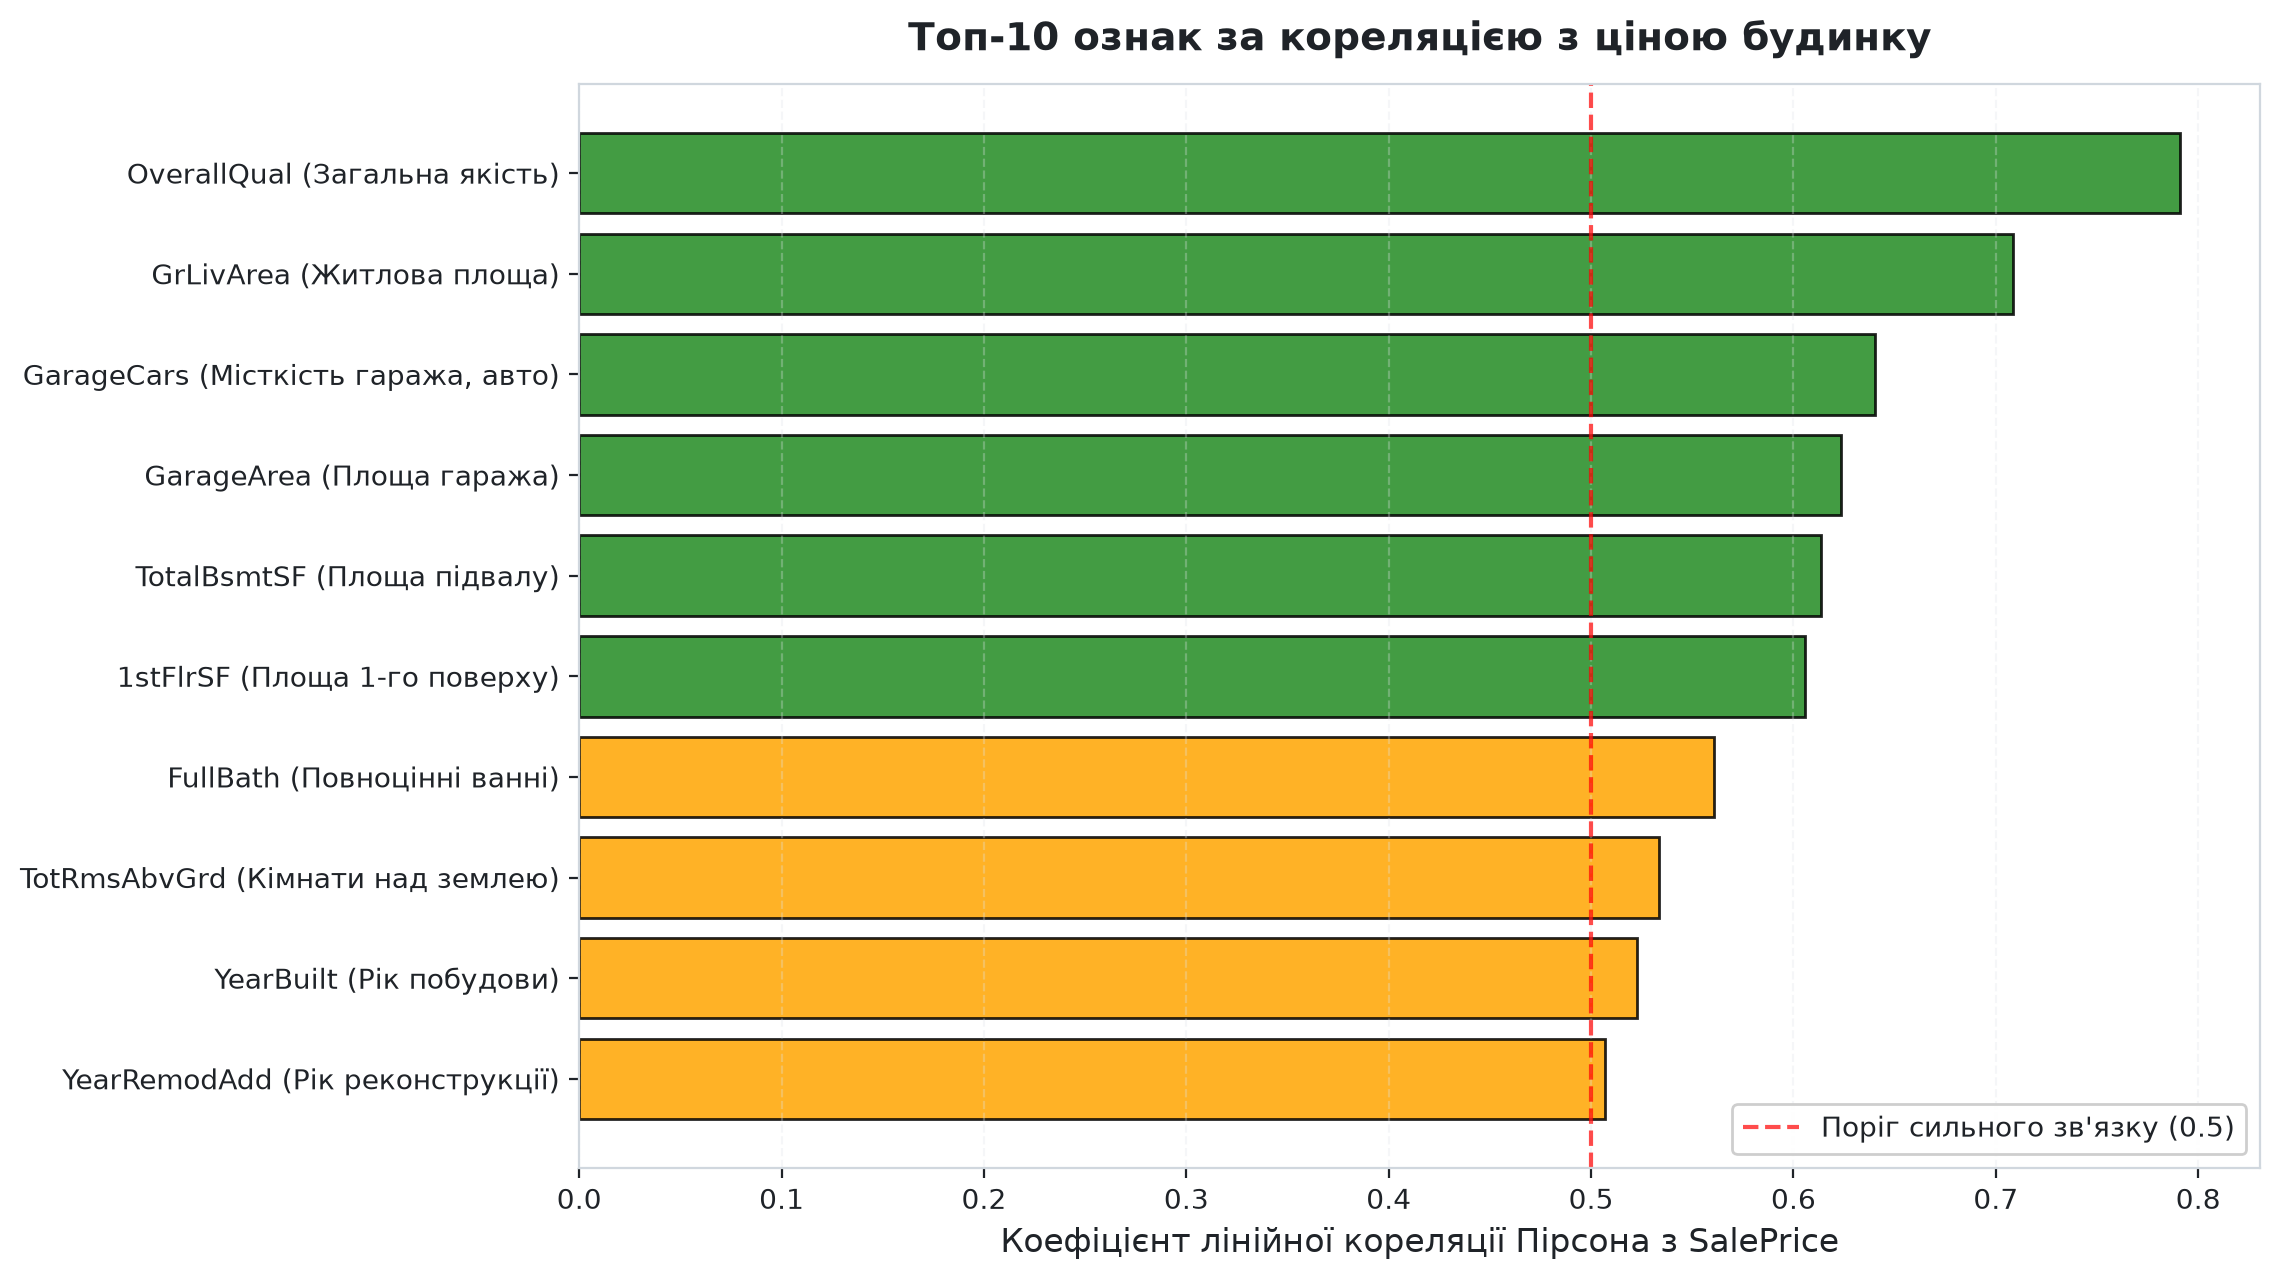
- OverallQual (загальна якість матеріалів та оздоблення, 0.79) — має найсильніший позитивний зв'язок з ціною
- GrLivArea (житлова площа над землею, 0.71) — на другому місці за силою впливу
- GarageCars (місткість гаража, 0.64) та GarageArea (площа гаража, 0.62) — суттєво підвищують вартість
- TotalBsmtSF (площа підвалу, 0.61) та 1stFlrSF (площа 1-го поверху, 0.61) — просторові метрики з високою кореляцією
- FullBath (повноцінні ванні кімнати, 0.56) та TotRmsAbvGrd (кількість кімнат над землею, 0.53) — показники просторості
- YearBuilt (рік побудови, 0.52) та YearRemodAdd (рік реконструкції, 0.51) — новіші та оновлені будинки коштують дорожче
- Негативні кореляції слабкі (< -0.14, наприклад
KitchenAbvGr(кількість кухонь вище рівня землі),EnclosedPorch(площа закритої веранди),MSSubClass(підклас типу будівлі)) — майже не мають лінійного зв'язку з ціною
Візуалізація кореляції (Bar Plot)
# Візуалізація топ-10 кореляцій
top_corr = correlations[1:11]  # без SalePrice (1.0)

plt.figure(figsize=(10, 6))
colors = ['forestgreen' if x > 0.6 else 'orange' for x in top_corr.values]
plt.barh(range(len(top_corr)), top_corr.values, color=colors, edgecolor='black')
plt.yticks(range(len(top_corr)), top_corr.index)
plt.xlabel('Кореляція з SalePrice', fontsize=12)
plt.title('Топ-10 ознак за кореляцією з ціною', fontsize=14, fontweight='bold')
plt.axvline(0.5, color='red', linestyle='--', linewidth=1.5, alpha=0.7, label='Поріг 0.5')
plt.gca().invert_yaxis()
plt.legend()
plt.grid(axis='x', alpha=0.3)
plt.tight_layout()
plt.show()
Кореляційна матриця (Heatmap)
Для розуміння взаємозв'язків між усіма ознаками побудуємо heatmap топ-15 ознак.
# Топ-15 ознак за кореляцією з ціною + сама ціна
top_features = correlations[1:16].index.tolist() + ['SalePrice']
corr_matrix = df[top_features].corr()

# Побудова heatmap
plt.figure(figsize=(14, 12))
sns.heatmap(
    corr_matrix,
    annot=True,          # показувати числа
    fmt='.2f',           # формат: 2 знаки після коми
    cmap='coolwarm',     # колірна схема
    square=True,         # квадратні клітинки
    linewidths=0.5,      # лінії між клітинками
    cbar_kws={"shrink": 0.8},  # розмір колірної шкали
    vmin=-1, vmax=1      # діапазон від -1 до 1
)
plt.title('Кореляційна матриця топ-15 ознак', fontsize=15, fontweight='bold', pad=20)
plt.tight_layout()
plt.show()
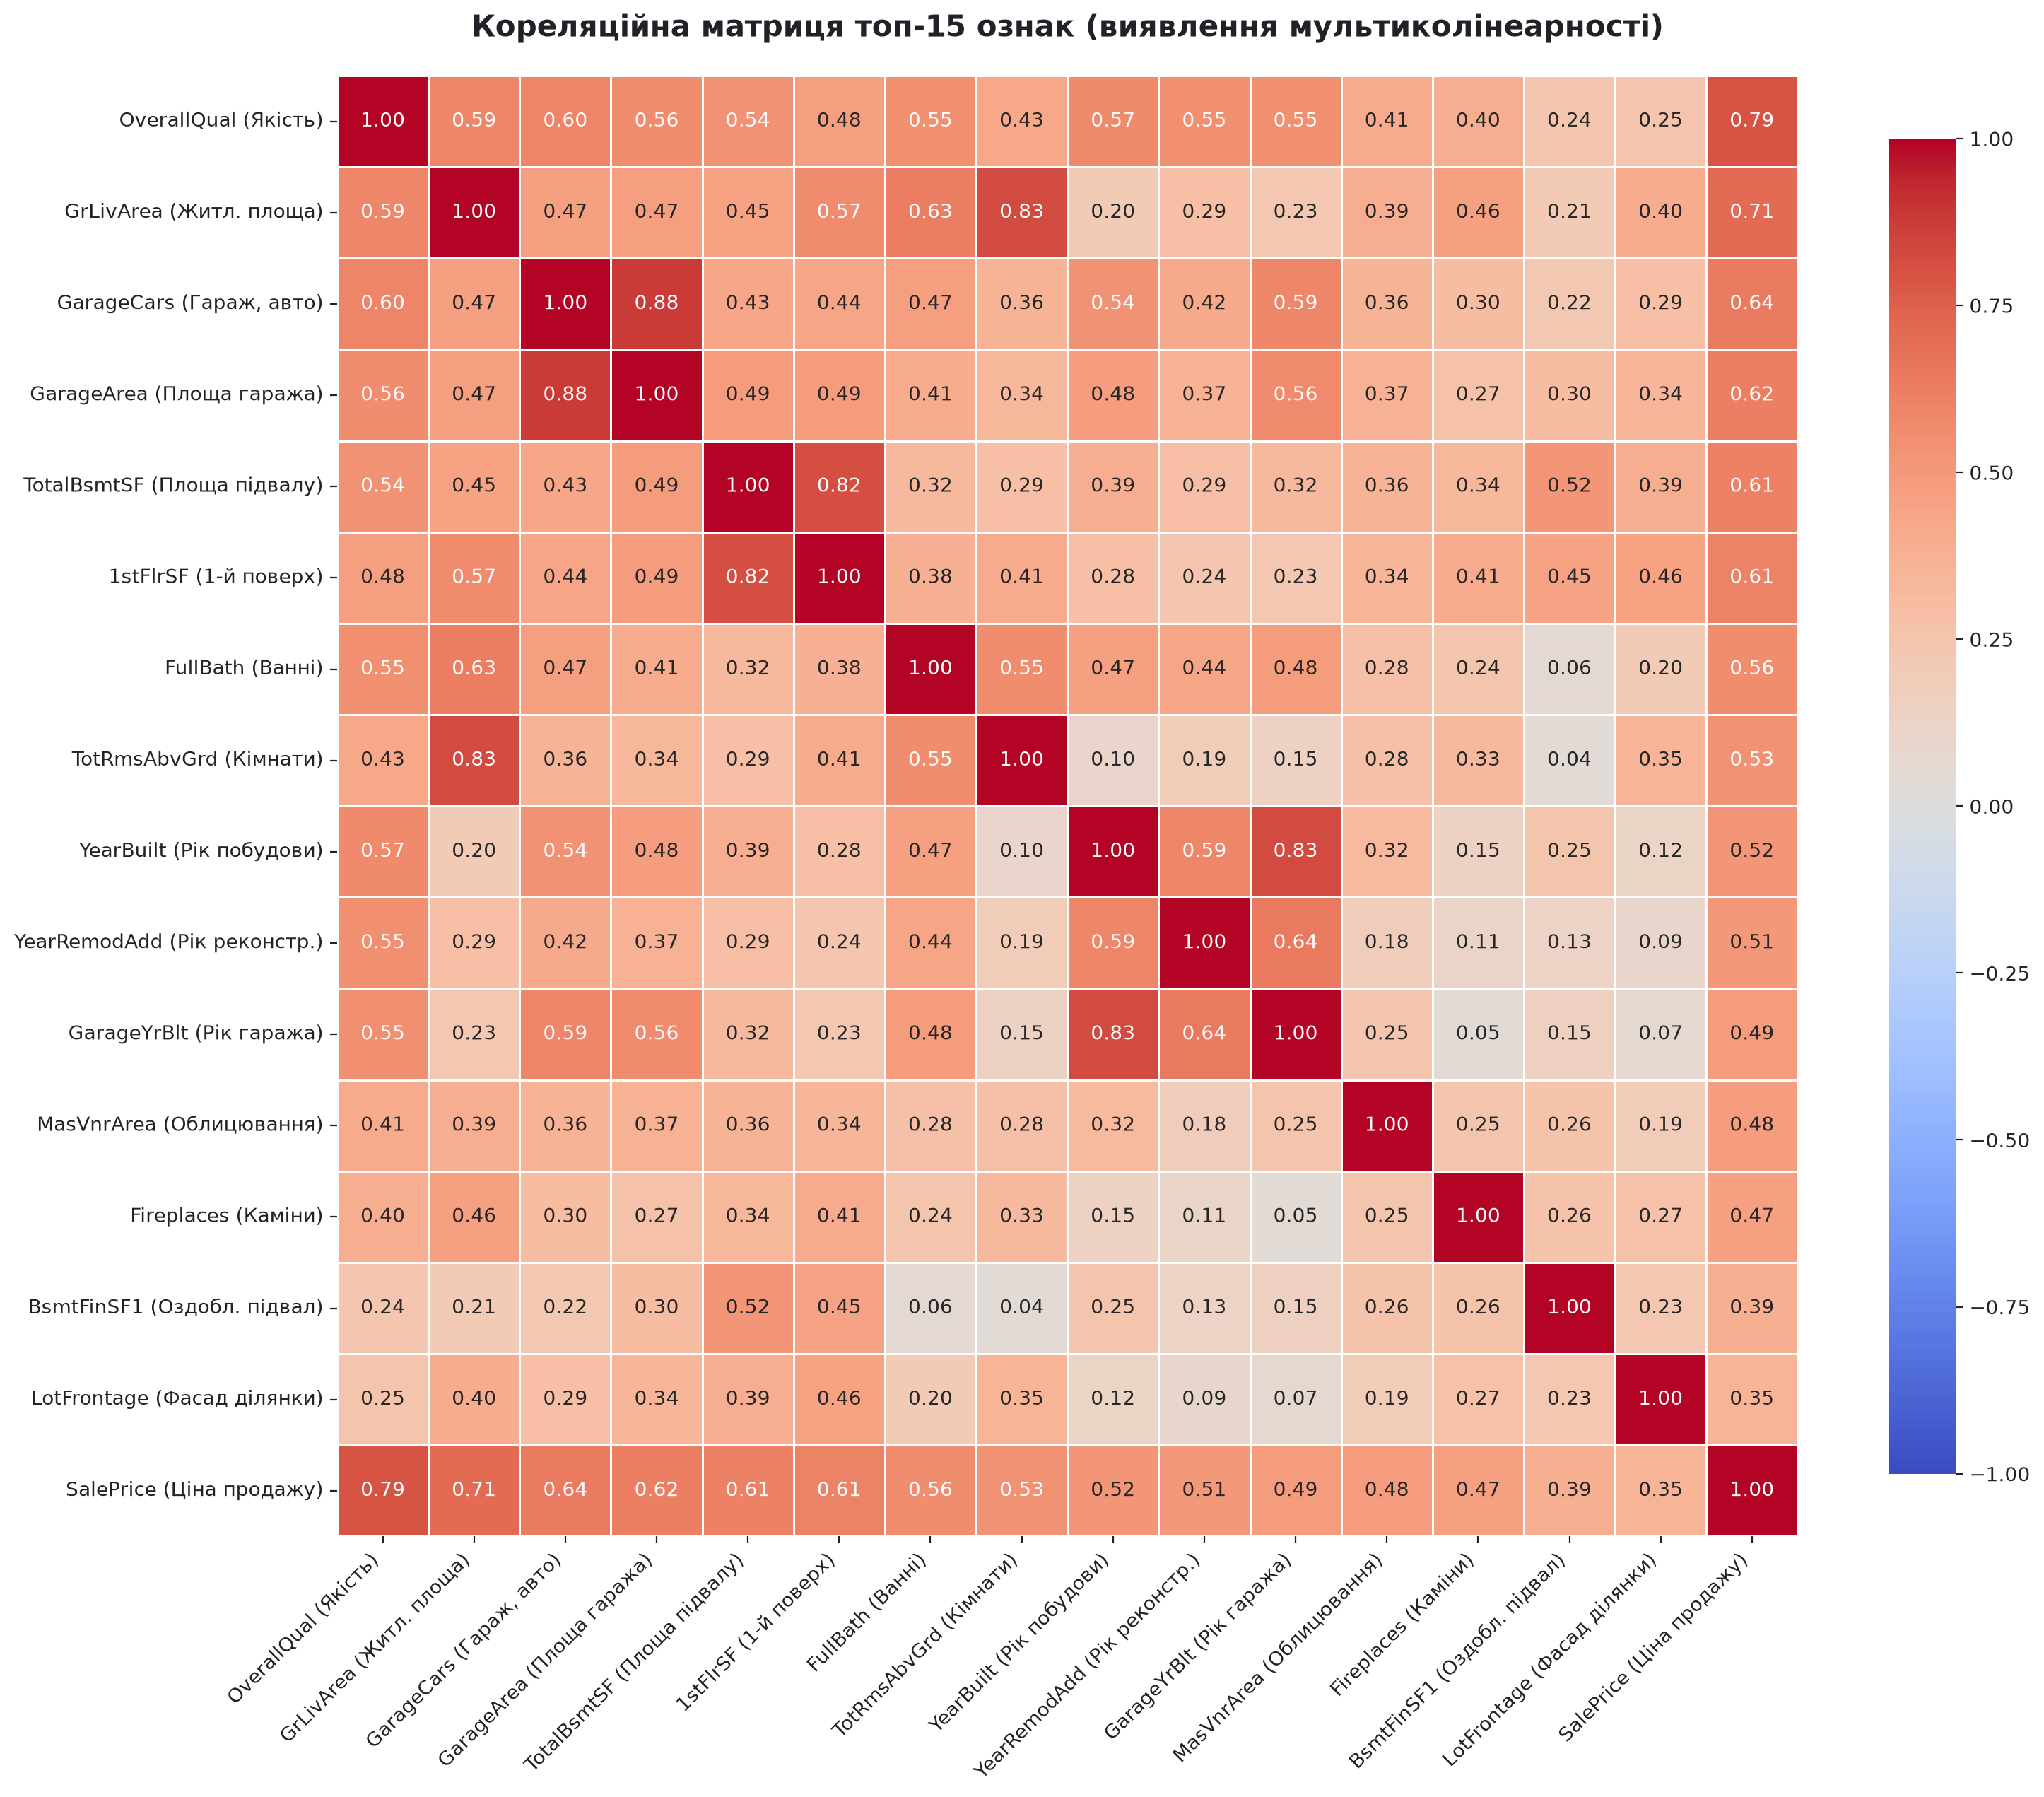
- GarageCars (місткість гаража в авто) ↔ GarageArea (площа гаража): кореляція 0.88 (дуже сильна!)
- TotalBsmtSF (загальна площа підвалу) ↔ 1stFlrSF (площа 1-го поверху): кореляція 0.82
- GrLivArea (житлова площа над землею) ↔ TotRmsAbvGrd (загальна кількість кімнат над землею): кореляція 0.83
Scatter Plots — візуалізація зв'язків
Побудуємо точкові діаграми для топ-4 ознак vs ціна (SalePrice — ціна продажу), щоб побачити характер залежності.
# Топ-4 ознаки
top_4 = ['OverallQual', 'GrLivArea', 'GarageCars', 'TotalBsmtSF']

fig, axes = plt.subplots(2, 2, figsize=(14, 10))
axes = axes.flatten()

for i, col in enumerate(top_4):
    axes[i].scatter(df[col], df['SalePrice'], alpha=0.5, color='dodgerblue', edgecolor='black', s=30)
    axes[i].set_xlabel(col, fontsize=11)
    axes[i].set_ylabel('SalePrice ($)', fontsize=11)
    axes[i].set_title(f'{col} vs SalePrice (corr={correlations[col]:.3f})',
                      fontsize=12, fontweight='bold')
    axes[i].grid(alpha=0.3, linestyle='--')

plt.suptitle('Scatter Plots: Топ-4 ознаки vs Ціна', fontsize=14, fontweight='bold', y=1.00)
plt.tight_layout()
plt.show()
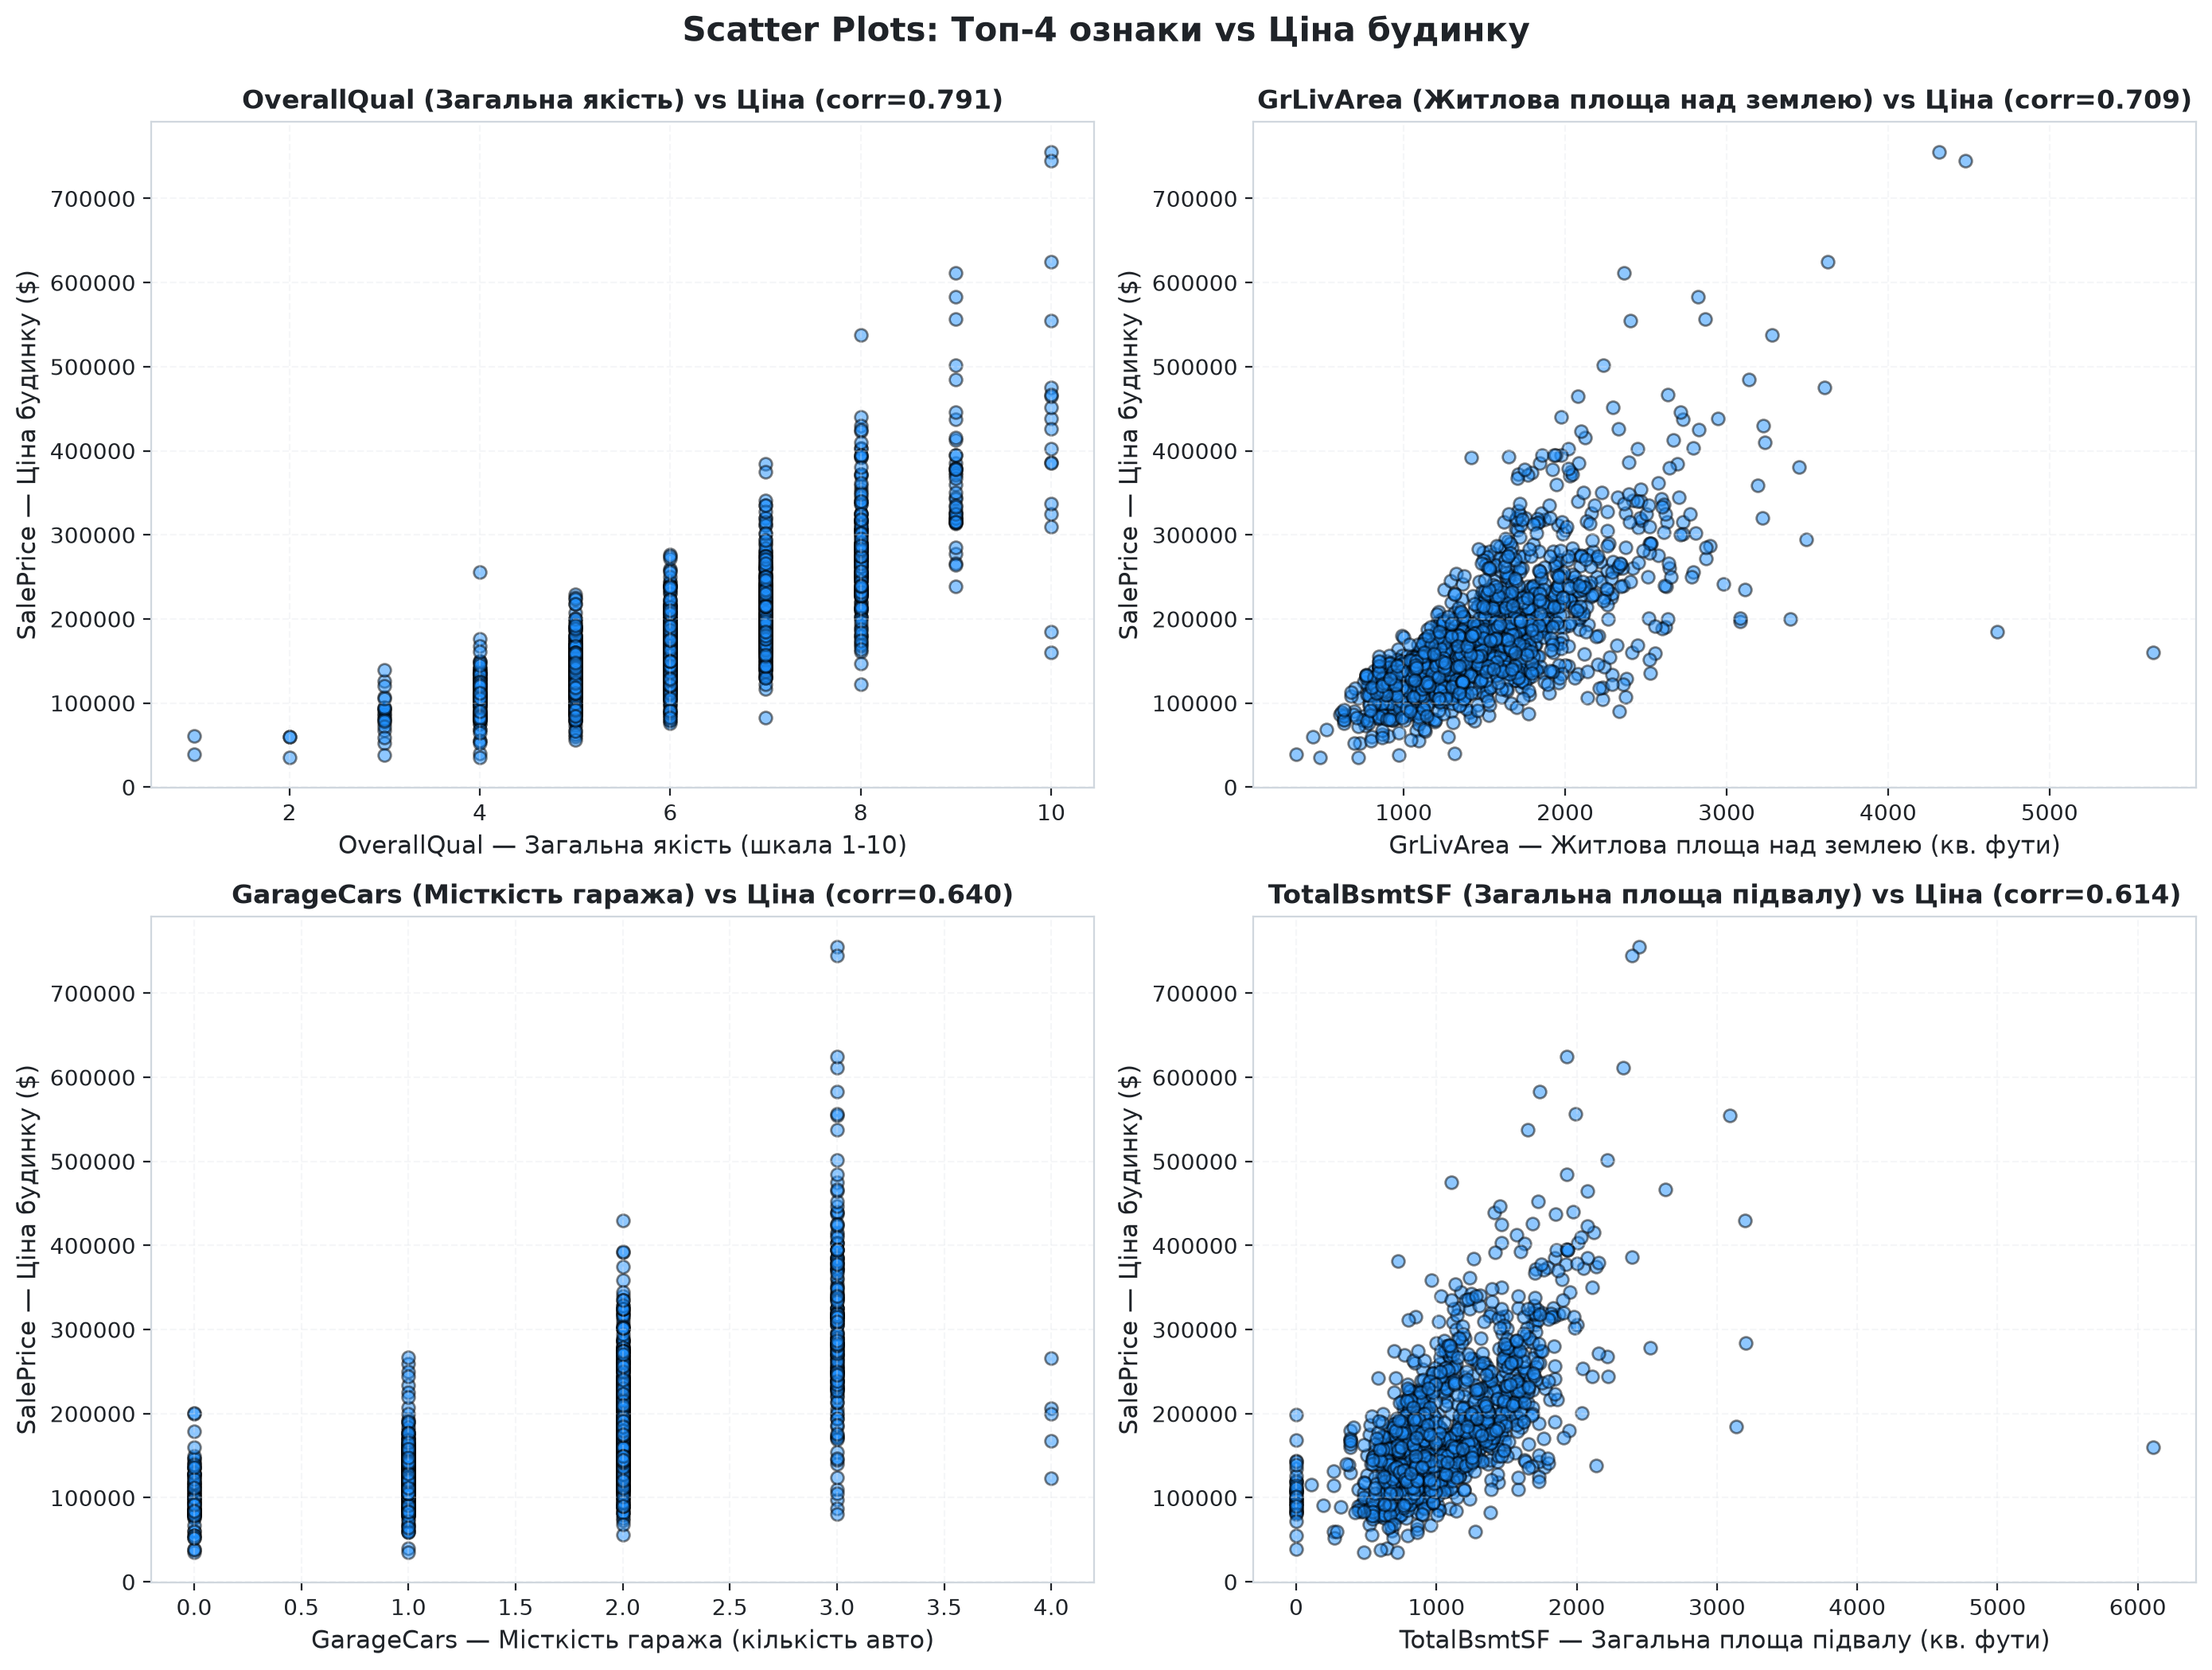
- OverallQual (загальна якість) vs SalePrice (ціна продажу) — чіткий позитивний лінійний зв'язок (якість ↑ → ціна ↑)
- GrLivArea (житлова площа) vs SalePrice (ціна продажу) — лінійна залежність, але є 2 викиди (дуже великі будинки з низькою ціною справа внизу)
- GarageCars (місткість гаража в авто) vs SalePrice (ціна продажу) — дискретні значення (0, 1, 2, 3, 4 машиномісця), позитивний зв'язок
- TotalBsmtSF (площа підвалу) vs SalePrice (ціна продажу) — лінійна залежність, багато будинків з площею підвалу = 0
Виявлення викидів (Outliers)
Викиди — це екстремальні значення, що можуть спотворити модель. Використаємо box plot для їх виявлення в ключових ознаках: GrLivArea (житлова площа над землею), TotalBsmtSF (площа підвалу), LotArea (площа ділянки) та SalePrice (ціна продажу).
# Box plots для ключових ознак + ціна
outlier_features = ['GrLivArea', 'TotalBsmtSF', 'LotArea', 'SalePrice']

fig, axes = plt.subplots(1, 4, figsize=(16, 4))

for i, col in enumerate(outlier_features):
    bp = axes[i].boxplot(df[col].dropna(), patch_artist=True,
                          boxprops=dict(facecolor='lightyellow', alpha=0.7),
                          medianprops=dict(color='red', linewidth=2),
                          whiskerprops=dict(linewidth=1.5),
                          capprops=dict(linewidth=1.5))
    axes[i].set_ylabel(col, fontsize=11)
    axes[i].set_title(f'{col}', fontsize=12, fontweight='bold')
    axes[i].grid(axis='y', alpha=0.3)

plt.suptitle('Box Plots — виявлення викидів', fontsize=14, fontweight='bold')
plt.tight_layout()
plt.show()
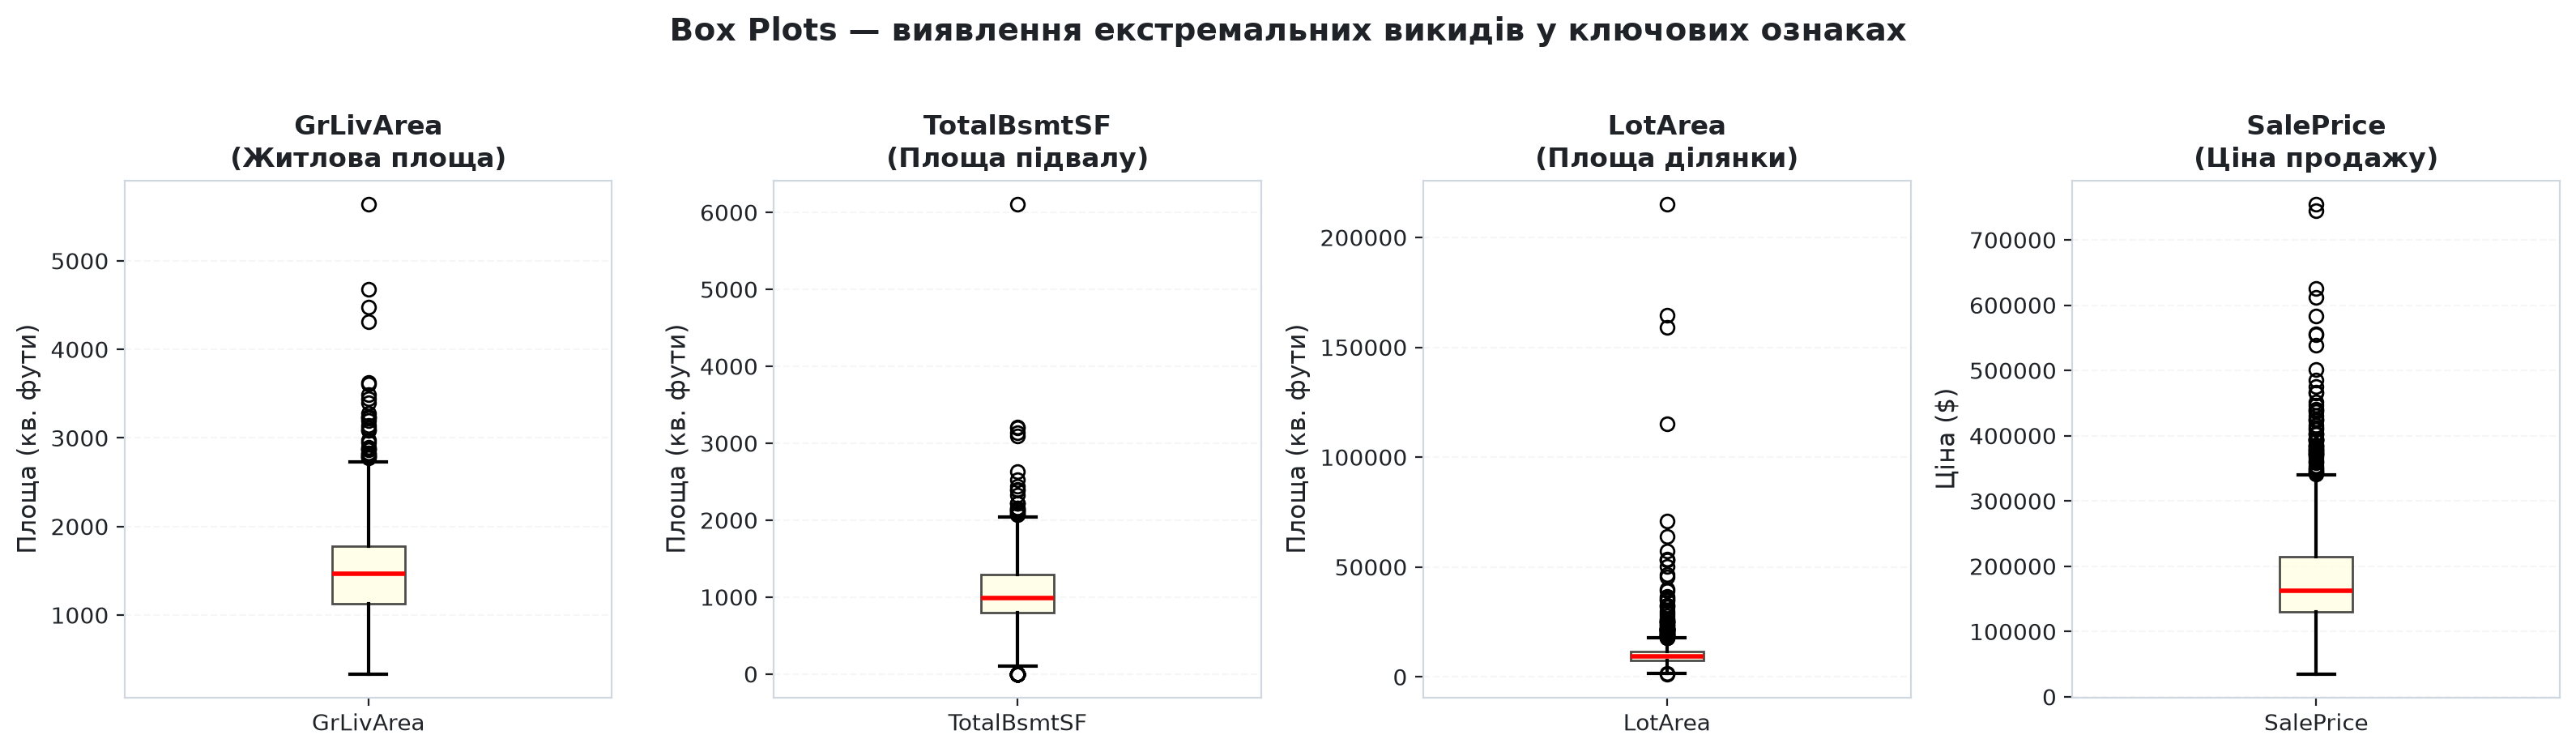
Детальний аналіз викидів GrLivArea (житлова площа над землею)
# Будинки з площею > 4000 кв. футів
outliers = df[df['GrLivArea'] > 4000][['GrLivArea', 'SalePrice', 'OverallQual', 'Neighborhood']]

print(f"Виявлено {len(outliers)} будинків-викидів (GrLivArea > 4000):\n")
print(outliers)

print("\nСередня ціна всіх будинків: $", df['SalePrice'].mean())
print("Ціна викидів: ", outliers['SalePrice'].values)
- Будинок #691: площа 4676 кв.фт, ціна $755k → нормальний дорогий будинок (
OverallQual=10— найвища якість матеріалів та оздоблення) - Будинки #1182 та #1298: площа >4000 кв.фт, але ціна $160k-$184k → аномалії!
- Можливо, помилки в даних
- Або особливі умови (наприклад, будинок потребує ремонту)
Висновки з EDA — що ми дізналися?
Після повного розвідувального аналізу даних ми маємо чітку картину датасету Housing Prices:
📊 Структура даних
- 1460 будинків, 80 ознак
- 38 числових + 43 категоріальні
- Цільова змінна:
SalePrice(ціна продажу, від $35k до $755k)
❌ Проблеми виявлені
- Пропуски: 19 стовпців мають NaN (від 5% до 99%)
- Категорії: 43 текстові стовпці → потрібно кодувати
- Різні масштаби:
GrLivArea(житлова площа, сотні/тисячі) vsYearBuilt(рік будівництва, тисячі) → потрібне масштабування - Мультиколінеарність:
GarageCars(місткість гаража) ↔GarageArea(площа гаража) (0.88) - Викиди: 2-4 аномальні будинки (великі, але дешеві)
🎯 Ключові ознаки
Топ-10 за кореляцією з ціною SalePrice:
OverallQual(загальна якість матеріалів): 0.79GrLivArea(житлова площа над землею): 0.71GarageCars(місткість гаража в авто): 0.64GarageArea(площа гаража): 0.62TotalBsmtSF(загальна площа підвалу): 0.611stFlrSF(площа першого поверху): 0.61FullBath(повноцінні ванні кімнати): 0.56TotRmsAbvGrd(кількість кімнат над землею): 0.53YearBuilt(рік будівництва): 0.52YearRemodAdd(рік реконструкції): 0.51
- Preprocessing (стаття 3):
- Обробка пропусків (SimpleImputer)
- Кодування категорій (one-hot encoding)
- Масштабування ознак (StandardScaler)
- Видалення викидів
- Feature Selection (стаття 4):
- Відбір топ-15 ознак для моделі
- Вирішення мультиколінеарності
- Modeling (статті 4-7):
- Train/test split
- Навчання моделі
- Оцінка та покращення
Що далі?
У цій статті ми провели повний Exploratory Data Analysis реального датасету:
✅ Завантажили датасет Housing Prices (1460 будинків, 80 ознак)
✅ Виявили пропуски (19 стовпців з NaN, до 99%)
✅ Проаналізували розподіл цільової змінної (right-skewed)
✅ Обчислили кореляції (топ-10 ознак)
✅ Побудували візуалізації (heatmap, scatter, box plots)
✅ Виявили викиди та мультиколінеарність
✅ Сформулювали план preprocessing
У наступній статті ми перейдемо до Preprocessing (попередня обробка даних). Ми навчимося:
- Заповнювати пропуски за допомогою
SimpleImputer - Кодувати категоріальні ознаки (
OneHotEncoder,pd.factorize) - Масштабувати числові ознаки (
StandardScaler,MinMaxScaler) - Будувати preprocessing pipeline для автоматизації
Після цього дані будуть готові для навчання ML-моделі!
Практика
Завдання: Завантажте датасет Housing Prices. Виведіть:
.info()— кількість стовпців, типи даних.describe()— статистику числових ознак- Підрахуйте пропуски (
.isnull().sum()) - Визначте топ-3 стовпці з найбільшою кількістю пропусків
Підказка:
missing = df.isnull().sum()
top_missing = missing[missing > 0].sort_values(ascending=False).head(3)
Завдання:
- Побудуйте кореляційну матрицю для топ-10 числових ознак
- Визначте, які дві ознаки (окрім
SalePrice— ціна продажу) мають найбільшу кореляцію між собою - Створіть scatter plot для цих двох ознак
- Напишіть висновок: чи можна видалити одну з них?
Підказка:
# Кореляція між усіма парами
corr = df[top_10_features].corr()
# Знайти максимум (окрім діагоналі)
Завдання: Проведіть повний EDA для датасету Titanic (from sklearn.datasets import fetch_openml або з Kaggle).
Етапи:
- Завантажити дані
- Виявити пропуски, побудувати графік
- Проаналізувати цільову змінну (
Survived— факт виживання) - Обчислити кореляції з виживанням
- Створити 5+ різних візуалізацій:
- Розподіл віку (
Age) - Виживання за класами квитка (
Pclass— bar plot) - Boxplot віку для тих, хто вижив vs не вижив
- Кореляційна матриця
- Scatter plot (вік
Agevs вартість квиткаFare)
- Розподіл віку (
- Написати висновки (мінімум 5 пунктів)
Резюме
EDA (Exploratory Data Analysis)
.info()
.describe()
.isnull().sum()
.corr()
Heatmap
Scatter Plot
Box Plot
Outliers
Multicollinearity
Знайомство з scikit-learn
Вступ до бібліотеки scikit-learn — стандарту машинного навчання в Python. Універсальний API, перша модель та базові метрики якості.
Попередня обробка даних (Data Preprocessing)
Підготовка реальних даних до навчання моделі. Обробка пропусків, кодування категорій, масштабування ознак та побудова preprocessing pipeline.