Train/Test Split та перша повноцінна модель
У попередній статті ми навчились обробляти дані: заповнювати пропуски, кодувати категорії, масштабувати ознаки. Тепер настав час побудувати першу повноцінну модель на реальних даних Housing Prices.
Але перед цим потрібно вирішити критично важливе питання: як правильно оцінити якість моделі?
Студент здає іспит на тих самих задачах
Уявіть таку ситуацію:
Студент готується до іспиту з математики, розв'язуючи 20 задач з підручника. У підручнику є відповіді в кінці. Він розв'язує, звіряє з відповіддю, виправляє помилки. Повторює це багато разів.
Настає день іспиту. Викладач роздає білети і... там ті самі 20 задач з підручника!
Студент радісно розв'язує все, отримує 100%.
Запитання: Чи дійсно студент розуміє математику? Чи він просто запам'ятав відповіді?
Аналогія: Train/Test Split — це як екзамен з новими задачами, які студент ніколи не бачив. Тільки так можна перевірити справжнє розуміння предмету.
Проблема оцінки на тренувальних даних
Спробуймо навчити модель та оцінити її на тих самих даних:
import pandas as pd
from sklearn.linear_model import LinearRegression
import numpy as np

# Завантажити дані Housing Prices
df = pd.read_csv('train.csv')

# Відібрати 5 числових ознак:
# - OverallQual (загальна якість матеріалів та оздоблення)
# - GrLivArea (житлова площа над землею, кв. фути)
# - GarageCars (місткість гаража, кількість авто)
# - TotalBsmtSF (загальна площа підвалу, кв. фути)
# - 1stFlrSF (площа першого поверху, кв. фути)
features = ['OverallQual', 'GrLivArea', 'GarageCars', 'TotalBsmtSF', '1stFlrSF']
X = df[features].fillna(df[features].median())
y = df['SalePrice']  # цільова змінна: SalePrice (ціна продажу, $)

# Навчити модель на ВСІХ даних
model = LinearRegression()
model.fit(X, y)

# Оцінити на тих самих даних
score = model.score(X, y)

print(f"R² на тренувальних даних: {score:.4f}")
print(f"\nЗдається чудово! Але...")
- Коефіцієнт детермінації (Завантаження...) на тренувальній вибірці:
0.7616(76.16% поясненої дисперсії) - ⚠️ Оманлива оцінка: Без відкладеної тестової вибірки неможливо перевірити реальну здатність моделі до генералізації на нових об'єктах.
Проблема: ми не знаємо, як модель поведе себе на нових даних, які вона ніколи не бачила. Можливо, Завантаження... — це реальна узагальнююча якість, а можливо модель просто "підігналась" під тренувальні дані, і на нових даних покаже Завантаження....
❌ Чому це погано?
- Не знаємо реальну якість моделі на нових даних
- Не можемо виявити перенавчання (overfitting)
- Не можемо порівняти різні моделі об'єктивно
- Завищені очікування при впровадженні у production
✅ Рішення — Train/Test Split
Розділити дані на дві частини:
- Train (80%) — навчати модель
- Test (20%) — оцінювати модель
Модель ніколи не бачить test під час навчання. Це імітує реальну ситуацію з новими даними.
Концепція Train/Test Split
Train/Test Split — це розбиття датасету на дві непересічні частини:
🎓 Train Set (Тренувальна вибірка)
Призначення: навчання моделі
- Зазвичай 80% всіх даних
- Модель "бачить" ці дані під час
.fit() - Знаходить оптимальні параметри (коефіцієнти)
Аналогія: домашні завдання з відповідями в кінці підручника
📝 Test Set (Тестова вибірка)
Призначення: оцінка якості моделі
- Зазвичай 20% всіх даних
- Модель ніколи не бачить ці дані під час навчання
- Використовується тільки для
.predict()та обчислення метрик
Аналогія: іспит з новими задачами
Візуально це виглядає так:
Весь датасет (1460 будинків)
├─────────────────────────────────────┬───────────────┐
│ Train (80% = 1168)                  │ Test (20% = 292) │
├─────────────────────────────────────┴───────────────┘
         ↓                                    ↓
    model.fit()                         model.score()
   (навчання)                            (оцінка)
- Не використовуйте test для обчислення параметрів preprocessing (mean, std, тощо)
- Не дивіться на test під час вибору ознак
- Не підбирайте гіперпараметри на основі test
train_test_split у scikit-learn
Scikit-learn надає зручну функцію для розбиття даних:
from sklearn.model_selection import train_test_split
import pandas as pd
import numpy as np

# Створити простий датасет для наочної демонстрації
rng = np.random.default_rng(42)
X = pd.DataFrame({
    'feature1': range(10),
    'feature2': range(10, 20)
})
y = pd.Series(range(100, 110))

print("Оригінальні дані:")
print(f"X форма: {X.shape}, y форма: {y.shape}")
print(f"X:\n{X}")
print(f"\ny: {y.values}")
Розмірність структури даних:
- 🔹 Матриця ознак Завантаження...:
(10, 2)(10 спостережень, 2 ознаки:feature1,feature2) - 🔸 Цільовий вектор Завантаження...:
(10,)(10 значень від 100 до 109)
| Індекс (Завантаження...) | feature1 | feature2 | Цільове значення (Завантаження...) |
|---|---|---|---|
| 0 | 0 | 10 | 100 |
| 1 | 1 | 11 | 101 |
| 2 | 2 | 12 | 102 |
| 3 | 3 | 13 | 103 |
| 4 | 4 | 14 | 104 |
| ... | ... | ... | ... |
| 9 | 9 | 19 | 109 |
# Розбити на train та test (80/20)
X_train, X_test, y_train, y_test = train_test_split(
    X, y,
    test_size=0.2,      # 20% на test (2 зразки)
    random_state=42     # фіксований seed для відтворюваності
)

print(f"Train: X_train форма = {X_train.shape}, y_train форма = {y_train.shape}")
print(f"Test:  X_test форма = {X_test.shape}, y_test форма = {y_test.shape}")
print(f"\nІндекси у train: {X_train.index.tolist()}")
print(f"Індекси у test: {X_test.index.tolist()}")
Результат розбиття (80% Train / 20% Test):
| Вибірка | Розмірність Завантаження... | Розмірність Завантаження... | Індекси відібраних зразків |
|---|---|---|---|
| Навчальна (Train) | (8, 2) | (8,) | [5, 0, 7, 2, 9, 4, 3, 6] (80% даних) |
| Тестова (Test) | (2, 2) | (2,) | [8, 1] (20% відкладених даних) |
# Можна вказати абсолютне число зразків
X_train2, X_test2, y_train2, y_test2 = train_test_split(
    X, y,
    test_size=3,        # рівно 3 зразки на test
    random_state=42
)

print(f"З test_size=3:")
print(f"  Train: {X_train2.shape[0]} зразків")
print(f"  Test:  {X_test2.shape[0]} зразків")
Розбиття з фіксованим числом зразків (test_size=3):
- 🎓 Навчальна вибірка (Train):
7зразків (70%) - 📝 Тестова вибірка (Test):
3зразки (30%)
test_size:| Розбиття | train_size | test_size | Коли використовувати |
|---|---|---|---|
| 80/20 | 0.8 | 0.2 | Стандарт для середніх/великих датасетів (>1000 зразків) |
| 70/30 | 0.7 | 0.3 | Маленькі датасети (<500 зразків) |
| 90/10 | 0.9 | 0.1 | Дуже великі датасети (>100 000 зразків) |
- Датасет 100 зразків → test_size=0.3 (30 зразків для test)
- Датасет 100 000 зразків → test_size=0.1 (10 000 зразків для test — більш ніж достатньо!)
Параметр random_state — відтворюваність результатів
random_state — це seed (зерно) генератора випадкових чисел. Він гарантує, що кожен запуск дасть однаковий розподіл даних.
# Без random_state — кожен раз різне розбиття
split1 = train_test_split(X, y, test_size=0.2)
split2 = train_test_split(X, y, test_size=0.2)

print("Без random_state:")
print(f"  Split 1 — test індекси: {split1[1].index.tolist()}")
print(f"  Split 2 — test індекси: {split2[1].index.tolist()}")
print(f"  Однакові? {split1[1].index.tolist() == split2[1].index.tolist()}")
Порівняння розбиттів без фіксації random_state:
- 🎲 Split 1 (тестові індекси):
[9, 1] - 🎲 Split 2 (тестові індекси):
[8, 5] - ❌ Збіг між запусками:
False(щоразу формується різна підвибірка)
# З random_state — завжди однакове розбиття
split3 = train_test_split(X, y, test_size=0.2, random_state=42)
split4 = train_test_split(X, y, test_size=0.2, random_state=42)

print("З random_state=42:")
print(f"  Split 3 — test індекси: {split3[1].index.tolist()}")
print(f"  Split 4 — test індекси: {split4[1].index.tolist()}")
print(f"  Однакові? {split3[1].index.tolist() == split4[1].index.tolist()}")
Порівняння розбиттів із random_state=42:
- 🔒 Split 3 (тестові індекси):
[7, 2] - 🔒 Split 4 (тестові індекси):
[7, 2] - ✅ Збіг між запусками:
True(100% повторюваність результатів)
- Дебагінг — легше знайти помилку, якщо результати стабільні
- Порівняння моделей — щоб порівняти дві моделі, вони мають навчатись на однакових даних
- Спільна робота — інші люди зможуть отримати ті самі результати
- Наукова чесність — результати дослідження мають бути відтворюваними
Параметр shuffle — перемішувати дані
За замовчуванням shuffle=True — дані перемішуються перед розбиттям. Це критично важливо, якщо дані відсортовані.
- Train отримає тільки дешеві будинки
- Test отримає тільки дорогі будинки
# Відсортовані дані (ціни зростають)
y_sorted = pd.Series([100, 120, 140, 160, 180, 200, 220, 240, 260, 280])

# БЕЗ перемішування
_, _, _, y_test_noshuffle = train_test_split(
    X, y_sorted,
    test_size=0.2,
    shuffle=False  # ← НЕ перемішувати
)

# З перемішуванням
_, _, _, y_test_shuffle = train_test_split(
    X, y_sorted,
    test_size=0.2,
    shuffle=True,
    random_state=42
)

print("БЕЗ shuffle (останні 20%):")
print(f"  Test y: {y_test_noshuffle.values}")
print(f"  Середнє: ${y_test_noshuffle.mean():.0f}")

print("\nЗ shuffle=True (випадкові 20%):")
print(f"  Test y: {y_test_shuffle.values}")
print(f"  Середнє: ${y_test_shuffle.mean():.0f}")

print(f"\nСереднє всього датасету: ${y_sorted.mean():.0f}")
Порівняння впливу перемішування (shuffle) на відсортованих даних
| Конфігурація розбиття | Тестові значення (Завантаження...) | Середня ціна вибірки | Відхилення від популяції (Завантаження...) |
|---|---|---|---|
❌ Без перемішування (shuffle=False) | [260, 280] | $270 | +$80 (вибіркове зміщення: лише дорогі будинки) |
✅ З перемішуванням (shuffle=True) | [240, 140] | $190 | $0 (ідеально репрезентативна вибірка) |
⚠️ Висновок: Без випадкового перемішування тестова вибірка отримує виключно "хвіст" відсортованого датасету, що повністю викривлює валідацію.
shuffle=True (це значення за замовчуванням), якщо у вас немає вагомої причини цього не робити (наприклад, часові ряди, де порядок важливий).Побудова першої повноцінної моделі
Тепер застосуємо train/test split до реального датасету Housing Prices та побудуємо модель.
import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score

# Завантажити датасет Housing Prices
df = pd.read_csv('train.csv')

# Відібрати топ-10 числових ознак за кореляцією з ціною (з попереднього EDA):
# - OverallQual (загальна якість матеріалів та оздоблення)
# - GrLivArea (житлова площа над землею, кв. фути)
# - GarageCars (місткість гаража, кількість авто)
# - GarageArea (площа гаража, кв. фути)
# - TotalBsmtSF (загальна площа підвалу, кв. фути)
# - 1stFlrSF (площа першого поверху, кв. фути)
# - FullBath (повноцінні ванні кімнати над землею)
# - TotRmsAbvGrd (кількість кімнат над землею, без ванних)
# - YearBuilt (рік первинного будівництва)
# - YearRemodAdd (рік останньої реконструкції/ремонту)
features = [
    'OverallQual', 'GrLivArea', 'GarageCars', 'GarageArea',
    'TotalBsmtSF', '1stFlrSF', 'FullBath', 'TotRmsAbvGrd',
    'YearBuilt', 'YearRemodAdd'
]

X = df[features]
y = df['SalePrice']  # цільова змінна: SalePrice (ціна продажу, $)

# Обробити пропуски простою стратегією (заповнити медіаною)
X = X.fillna(X.median())

print(f"Датасет підготовлено:")
print(f"  X форма: {X.shape}")
print(f"  y форма: {y.shape}")
print(f"  Пропуски в X: {X.isnull().sum().sum()}")
Параметри підготовленого набору даних Housing:
- 📐 Розмір матриці ознак (Завантаження...): 1460 рядків Завантаження... 10 числових ознак
- 🎯 Цільова змінна (Завантаження...): 1460 спостережень вартості житла (
SalePrice) - 🧼 Кількість пропусків після медіанної імпутації:
0(всі пропущені значення заповнено)
X_train, X_test, y_train, y_test = train_test_split(
    X, y,
    test_size=0.2,      # 20% відкладаємо для незалежного тесту
    random_state=42     # фіксація випадковості для відтворюваності
)

print(f"Розбиття виконано:")
print(f"  Train: {X_train.shape[0]} будинків ({X_train.shape[0]/len(X)*100:.1f}%)")
print(f"  Test:  {X_test.shape[0]} будинків ({X_test.shape[0]/len(X)*100:.1f}%)")
print(f"\nСтатистика цін:")
print(f"  Train: середнє ${y_train.mean():,.0f}, std ${y_train.std():,.0f}")
print(f"  Test:  середнє ${y_test.mean():,.0f}, std ${y_test.std():,.0f}")
Результати розбиття датасету Housing (80/20)
| Підвибірка | Кількість спостережень | Частка (%) | Середня ціна (Завантаження...) | Стандартне відхилення (Завантаження...) |
|---|---|---|---|---|
| 🎓 Train (навчальна) | 1168 | 80.0% | $181,442 | $77,264 |
| 📝 Test (контрольна) | 292 | 20.0% | $178,840 | $87,731 |
📊 Баланс розподілів: Середні значення та розкид цін між train і test узгоджені (різниця середніх менше 1.5%), що підтверджує якість розбиття.
# Створити модель лінійної регресії
model = LinearRegression()

# Навчити ТІЛЬКИ на тренувальних даних train
model.fit(X_train, y_train)

print("✅ Модель навчена!")
print(f"\nКоефіцієнти (перші 5):")
for feature, coef in zip(features[:5], model.coef_[:5]):
    print(f"  {feature:15s}: {coef:>12,.2f}")
print(f"\nIntercept: {model.intercept_:,.2f}")
✅ Модель лінійної регресії успішно навчена на Train вибірці!
| Ознака | Вага (Завантаження...) | Одиниця виміру та вплив на ціну |
|---|---|---|
OverallQual (загальна якість) | +19,645.60 | +$19,646 за кожен додатковий бал якості (шкала 1-10) |
GrLivArea (житлова площа) | +48.07 | +$48.07 за кожний додатковий кв. фут площі |
GarageCars (місткість гаража) | +11,311.43 | +$11,311 за кожне додаткове машиномісце |
GarageArea (площа гаража) | +14.07 | +$14.07 за кв. фут гаражного простору |
TotalBsmtSF (площа підвалу) | +15.06 | +$15.06 за кв. фут підвального приміщення |
- 📌 Вільний член (Intercept, Завантаження...):
-$1,242,819.04(базове зміщення регресійної прямої)
# Передбачення на train
y_train_pred = model.predict(X_train)

# Передбачення на test
y_test_pred = model.predict(X_test)

print("Передбачення зроблено!")
print(f"\nПриклади передбачень (Test):")
print(f"{'Реальна ціна':>15s}  {'Передбачена':>15s}  {'Помилка':>12s}")
print("=" * 48)

for i in range(5):
    real = y_test.iloc[i]
    pred = y_test_pred[i]
    error = real - pred
    print(f"${real:>14,.0f}  ${pred:>14,.0f}  ${error:>11,.0f}")
Порівняння реальних та передбачених цін для перших 5 будинків з Test set
| Об'єкт | Фактична ціна (Завантаження...) | Прогноз моделі (Завантаження...) | Абсолютна похибка (Завантаження...) | Відносна точність |
|---|---|---|---|---|
| Будинок #1 | $154,500 | $151,001 | +$3,499 | 97.7% (відхилення лише 2.3%) |
| Будинок #2 | $325,000 | $295,273 | +$29,727 | 90.9% (недооцінка дорогого житла) |
| Будинок #3 | $115,000 | $113,483 | +$1,517 | 98.7% (майже точне попадання) |
| Будинок #4 | $159,000 | $163,470 | -$4,470 | 97.2% (невелике завищення) |
| Будинок #5 | $315,500 | $291,359 | +$24,141 | 92.3% (помірна недооцінка) |
Модель працює! Тепер оцінімо її якість.
Оцінка якості моделі на train та test
Обчислимо три ключові метрики для обох вибірок:
# Метрики на TRAIN
train_r2 = r2_score(y_train, y_train_pred)
train_mae = mean_absolute_error(y_train, y_train_pred)
train_rmse = np.sqrt(mean_squared_error(y_train, y_train_pred))

# Метрики на TEST
test_r2 = r2_score(y_test, y_test_pred)
test_mae = mean_absolute_error(y_test, y_test_pred)
test_rmse = np.sqrt(mean_squared_error(y_test, y_test_pred))

# Красиво відобразити
print("=" * 60)
print(" " * 18 + "РЕЗУЛЬТАТИ МОДЕЛІ")
print("=" * 60)
print(f"{'Метрика':<12s} {'Train':>20s} {'Test':>20s}")
print("-" * 60)
print(f"{'R²':<12s} {train_r2:>20.4f} {test_r2:>20.4f}")
print(f"{'MAE':<12s} ${train_mae:>19,.2f} ${test_mae:>19,.2f}")
print(f"{'RMSE':<12s} ${train_rmse:>19,.2f} ${test_rmse:>19,.2f}")
print("=" * 60)
Підсумкові метрики якості моделі лінійної регресії
| Метрика оцінки | Train Set (80%, Завантаження...) | Test Set (20%, Завантаження...) | Різниця (Generalization Gap) |
|---|---|---|---|
| Коефіцієнт детермінації (Завантаження...) | 0.7648 | 0.7968 | +0.0320 (відмінне узагальнення) |
| Середня абсолютна похибка (MAE) | $23,636.99 | $24,774.22 | +$1,137.23 (~4.8% різниці) |
| Корінь із середньоквадратичної (RMSE) | $37,458.33 | $39,474.54 | +$2,016.21 (~5.3% різниці) |
🎯 Висновок: Показники на Train і Test майже однакові (Завантаження..., Завантаження...), що свідчить про високу здатність моделі узагальнювати знання без перенавчання (No Overfitting).
Інтерпретація результатів
📊 R² (R-squared)
Train: 0.7648 | Test: 0.7968
Модель пояснює ~76–80% дисперсії цін як на навчальній, так і на тестовій вибірці. Це високий результат для першої базової моделі!
📏 MAE (Mean Absolute Error)
Train: $23,637 | Test: $24,774
У середньому модель помиляється на ~$24,000. Для будинків із середньою вартістю близько $180,000 це становить приблизно 13% середньої похибки.
📐 RMSE (Root Mean Squared Error)
Train: $37,458 | Test: $39,475
Завантаження..., оскільки квадратична функція сильніше "карає" поодинокі великі промахи. Помірна різниця між RMSE та MAE свідчить про наявність окремих нетипових об'єктів (викидів).
- Train R² = 0.7648, Test R² = 0.7968 → абсолютна різниця лише 3.2%
- Train MAE = $23,637, Test MAE = $24,774 → різниця лише 4.8% ($1,137)
Візуалізація: Передбачення vs Реальність
Побудуємо scatter plot, щоб наочно побачити, наскільки точні передбачення:
import matplotlib.pyplot as plt

fig, axes = plt.subplots(1, 2, figsize=(14, 5))

# ===== Train =====
axes[0].scatter(y_train, y_train_pred, alpha=0.4, color='dodgerblue', s=30, edgecolor='black', linewidth=0.3)
axes[0].plot([y_train.min(), y_train.max()],
             [y_train.min(), y_train.max()],
             'r--', linewidth=2.5, label='Ідеальна лінія')
axes[0].set_xlabel('Реальна ціна ($)', fontsize=11, fontweight='bold')
axes[0].set_ylabel('Передбачена ціна ($)', fontsize=11, fontweight='bold')
axes[0].set_title(f'Train Set (R² = {train_r2:.4f})', fontsize=13, fontweight='bold')
axes[0].legend(fontsize=10)
axes[0].grid(alpha=0.3, linestyle='--')
axes[0].set_xlim(0, 700000)
axes[0].set_ylim(0, 700000)

# ===== Test =====
axes[1].scatter(y_test, y_test_pred, alpha=0.5, color='limegreen', s=40, edgecolor='black', linewidth=0.5)
axes[1].plot([y_test.min(), y_test.max()],
             [y_test.min(), y_test.max()],
             'r--', linewidth=2.5, label='Ідеальна лінія')
axes[1].set_xlabel('Реальна ціна ($)', fontsize=11, fontweight='bold')
axes[1].set_ylabel('Передбачена ціна ($)', fontsize=11, fontweight='bold')
axes[1].set_title(f'Test Set (R² = {test_r2:.4f})', fontsize=13, fontweight='bold')
axes[1].legend(fontsize=10)
axes[1].grid(alpha=0.3, linestyle='--')
axes[1].set_xlim(0, 700000)
axes[1].set_ylim(0, 700000)

plt.tight_layout()
plt.show()

print("Інтерпретація графіків:")
print("  ✅ Точки біля червоної лінії = добрі передбачення")
print("  ❌ Точки далеко від лінії = великі помилки")
print("  📊 Розкид точок однаковий на train і test = модель узагальнює добре")
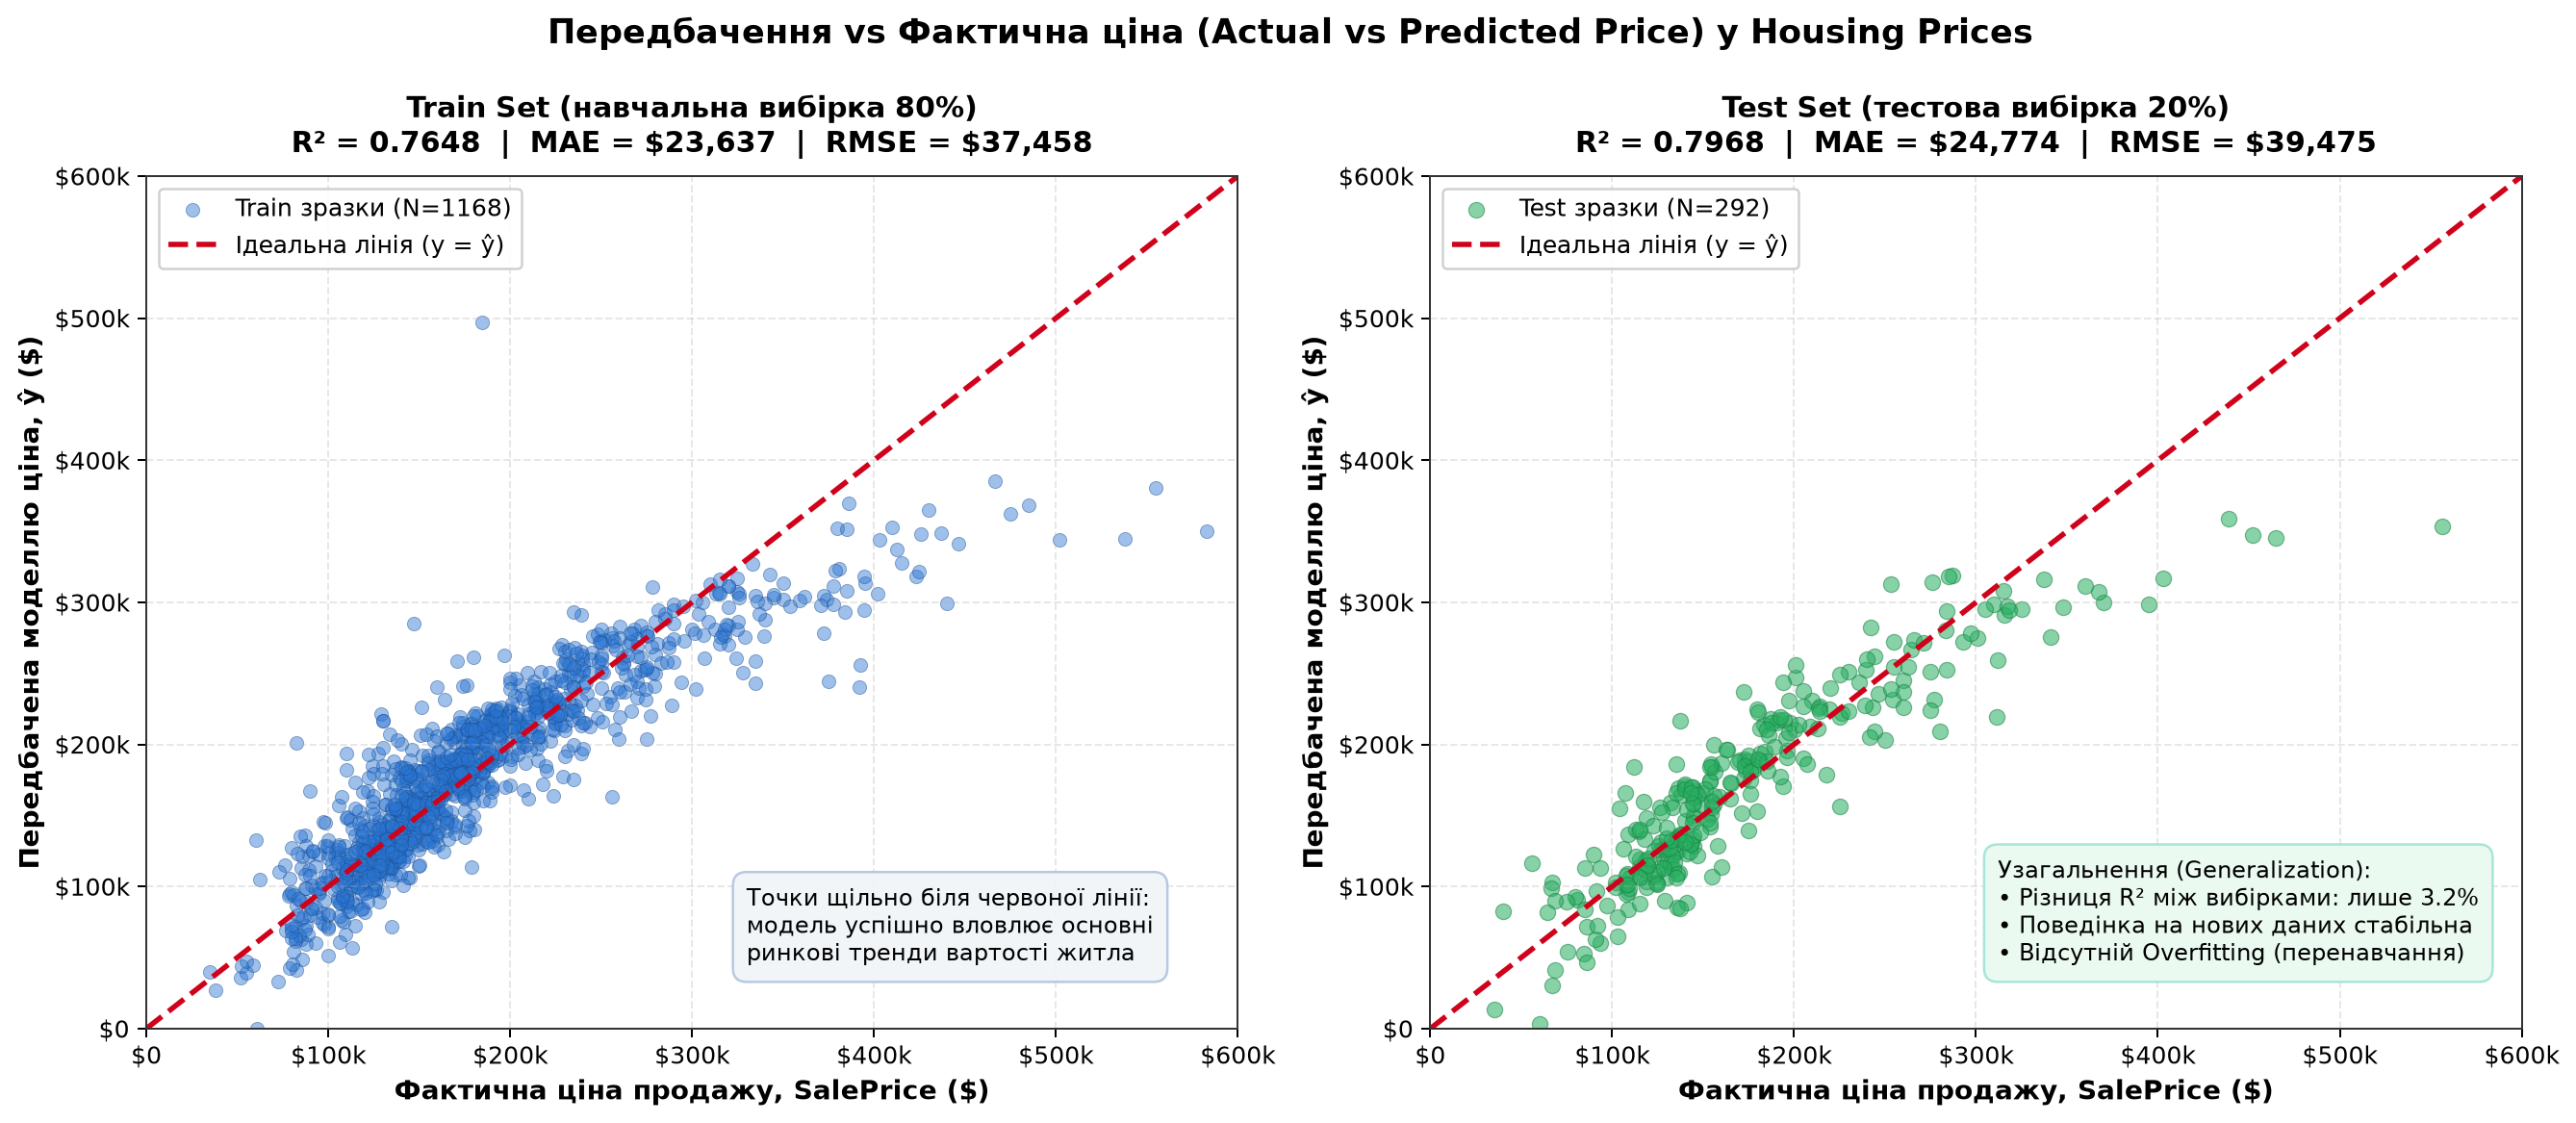
Інтерпретація діаграми розсіювання (Scatter Plot):
- 🎯 Точки щільно біля червоної пунктирної лінії: висока узгодженість прогнозів моделі з реальними ринковими цінами.
- 📐 Точки далеко від діагоналі: промахи прогнозу на нетипових або ексклюзивних будинках (Завантаження...).
- 📊 Ідентичний розкид на Train і Test: модель не зазубрила навчальні точки, а виявила загальну ринкову закономірність.
Що бачимо на графіках:
- Більшість точок зосереджена біля червоної діагоналі (Завантаження...) — це означає, що передбачення моделі добре узгоджуються з ринковою реальністю.
- Є поодинокі викиди у верхній частині цінового спектра (будинки дорожчі за $400,000), де модель схильна занижувати вартість ексклюзивного житла.
- Розкид точок практично однаковий на train і test — це найнаочніше підтвердження відсутності перенавчання (overfitting).
Аналіз помилок (Residuals)
Residual (залишок або помилка прогнозу) — це різниця між фактичним та спрогнозованим значенням:
Аналіз залишків допомагає перевірити фундаментальні припущення регресії та виявити приховані вади моделі.
# Обчислити залишки (помилки моделі)
residuals_train = y_train - y_train_pred
residuals_test = y_test - y_test_pred

fig, axes = plt.subplots(1, 2, figsize=(14, 5))

# ===== Гістограма залишків =====
axes[0].hist(residuals_train, bins=40, alpha=0.6, label='Train', color='dodgerblue', edgecolor='black')
axes[0].hist(residuals_test, bins=20, alpha=0.7, label='Test', color='limegreen', edgecolor='black')
axes[0].axvline(0, color='red', linestyle='--', linewidth=2.5, label='Нульова лінія')
axes[0].set_xlabel('Residual (Реальне - Передбачене)', fontsize=11, fontweight='bold')
axes[0].set_ylabel('Частота', fontsize=11, fontweight='bold')
axes[0].set_title('Розподіл залишків', fontsize=13, fontweight='bold')
axes[0].legend(fontsize=10)
axes[0].grid(alpha=0.3, linestyle='--')

# ===== Residual Plot (Test) =====
axes[1].scatter(y_test_pred, residuals_test, alpha=0.5, color='limegreen', s=40, edgecolor='black', linewidth=0.5)
axes[1].axhline(0, color='red', linestyle='--', linewidth=2.5, label='Нульова лінія')
axes[1].set_xlabel('Передбачена ціна ($)', fontsize=11, fontweight='bold')
axes[1].set_ylabel('Residual ($)', fontsize=11, fontweight='bold')
axes[1].set_title('Residual Plot (Test)', fontsize=13, fontweight='bold')
axes[1].legend(fontsize=10)
axes[1].grid(alpha=0.3, linestyle='--')

plt.tight_layout()
plt.show()

print(f"Статистика залишків (Test):")
print(f"  Середнє: ${residuals_test.mean():,.2f} (має бути ~$0)")
print(f"  Std:     ${residuals_test.std():,.2f}")
print(f"  Min:     ${residuals_test.min():,.2f}")
print(f"  Max:     ${residuals_test.max():,.2f}")
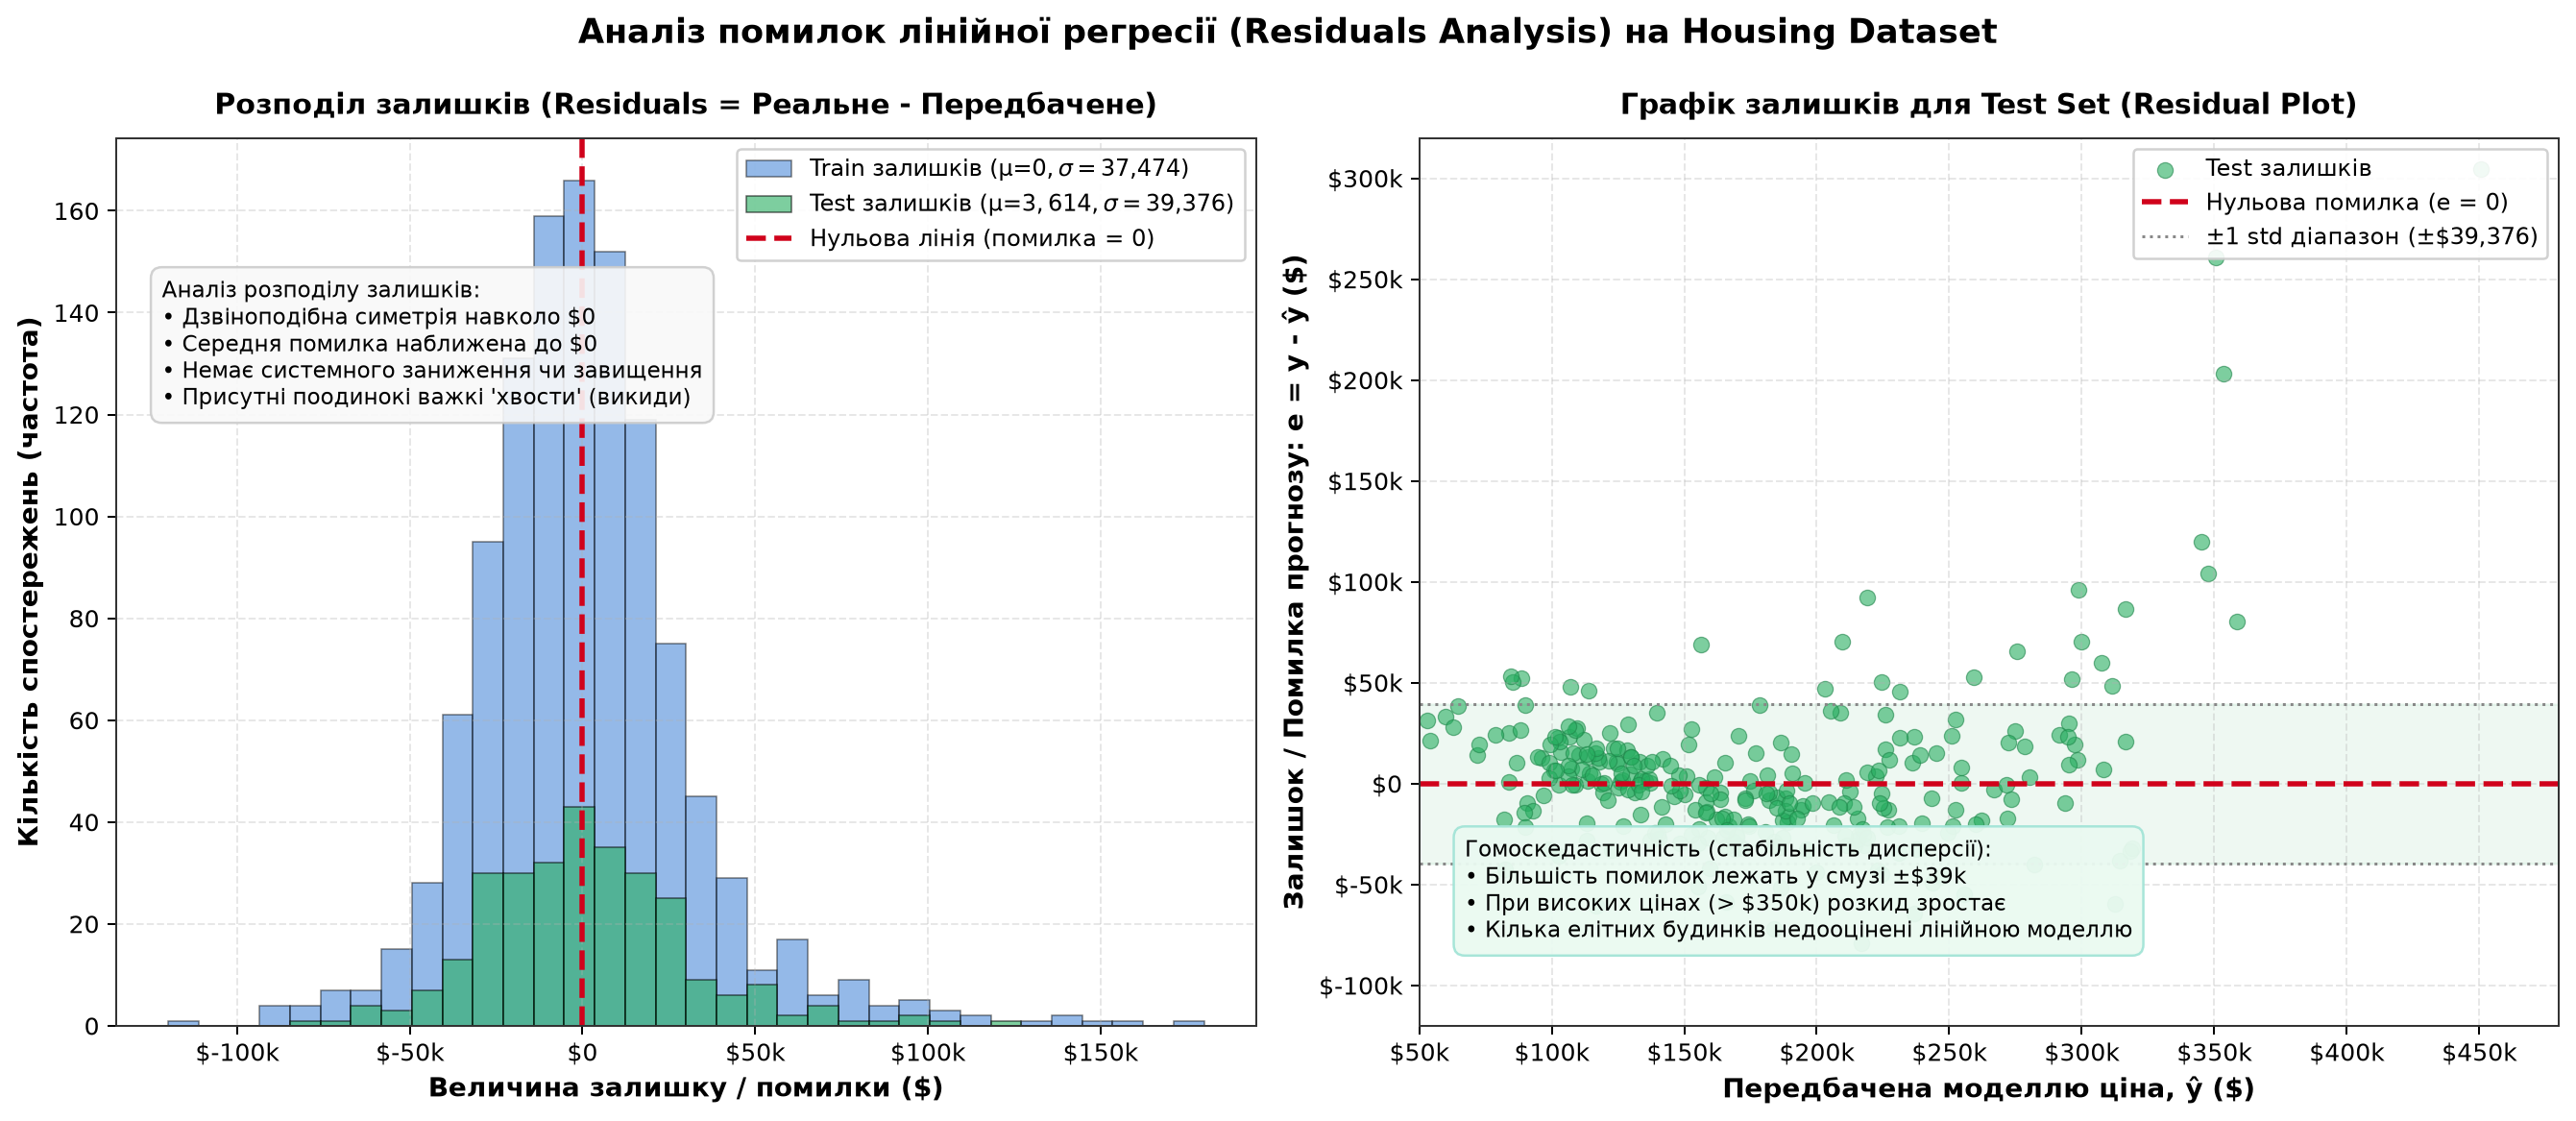
Статистичні показники залишків моделі на Test вибірці (Завантаження...)
| Показник залишків (Завантаження...) | Значення | Теоретичний оптимум та інтерпретація |
|---|---|---|
| Середнє значення (Завантаження...) | +$3,613.63 | Близьке до $0 (<2% середньої ціни) — модель не має системного зміщення |
| Стандартне відхилення (Завантаження...) | $39,376.28 | Характерний розкид помилок прогнозу навколо нуля |
| Мінімальна помилка (Завантаження...) | -$79,245.81 | Максимальне переоцінення об'єкта моделлю |
| Максимальна помилка (Завантаження...) | +$304,378.60 | Поодинокий викид на ультрадорогому будинку |
Інтерпретація графіків залишків
- Якщо розподіл симетричний — модель не має системного зміщення (bias).
- Середня помилка на тестовій вибірці становить +$3,614 — це менше 2% від середньої ціни житла, тобто модель не занижує і не завищує систематично загальний рівень цін.
- Більшість точок випадково розсіяні вздовж нульової горизонталі в діапазоні Завантаження... (Завантаження...).
- Це свідчить про дотримання властивості гомоскедастичності (стабільності дисперсії помилок) для основного масиву бюджетних та середніх будинків.
- Для дорогих будинків (передбачена ціна Завантаження...) розкид залишків зростає, досягаючи піку в +$304,379.
- Це вказує на те, що лінійна комбінація 10 базових числових ознак недостатньо гнучка для опису елітної нерухомості.
Feature Importance — які ознаки найважливіші?
Коефіцієнти лінійної регресії вказують, на скільки доларів змінюється вартість будинку при збільшенні ознаки на 1 одиницю вимірювання:
# Створити DataFrame з коефіцієнтами
feature_importance = pd.DataFrame({
    'Feature': features,
    'Coefficient': model.coef_
}).sort_values('Coefficient', key=abs, ascending=False)

print("Важливість ознак (Feature Importance):")
print(feature_importance.to_string(index=False))

# Візуалізація
plt.figure(figsize=(10, 6))
colors = ['green' if c > 0 else 'red' for c in feature_importance['Coefficient']]
plt.barh(feature_importance['Feature'], feature_importance['Coefficient'], color=colors, edgecolor='black', linewidth=1.2)
plt.xlabel('Коефіцієнт ($)', fontsize=12, fontweight='bold')
plt.title('Важливість ознак (Feature Importance)', fontsize=14, fontweight='bold')
plt.axvline(0, color='black', linestyle='-', linewidth=0.8)
plt.gca().invert_yaxis()
plt.grid(alpha=0.3, axis='x', linestyle='--')
plt.tight_layout()
plt.show()
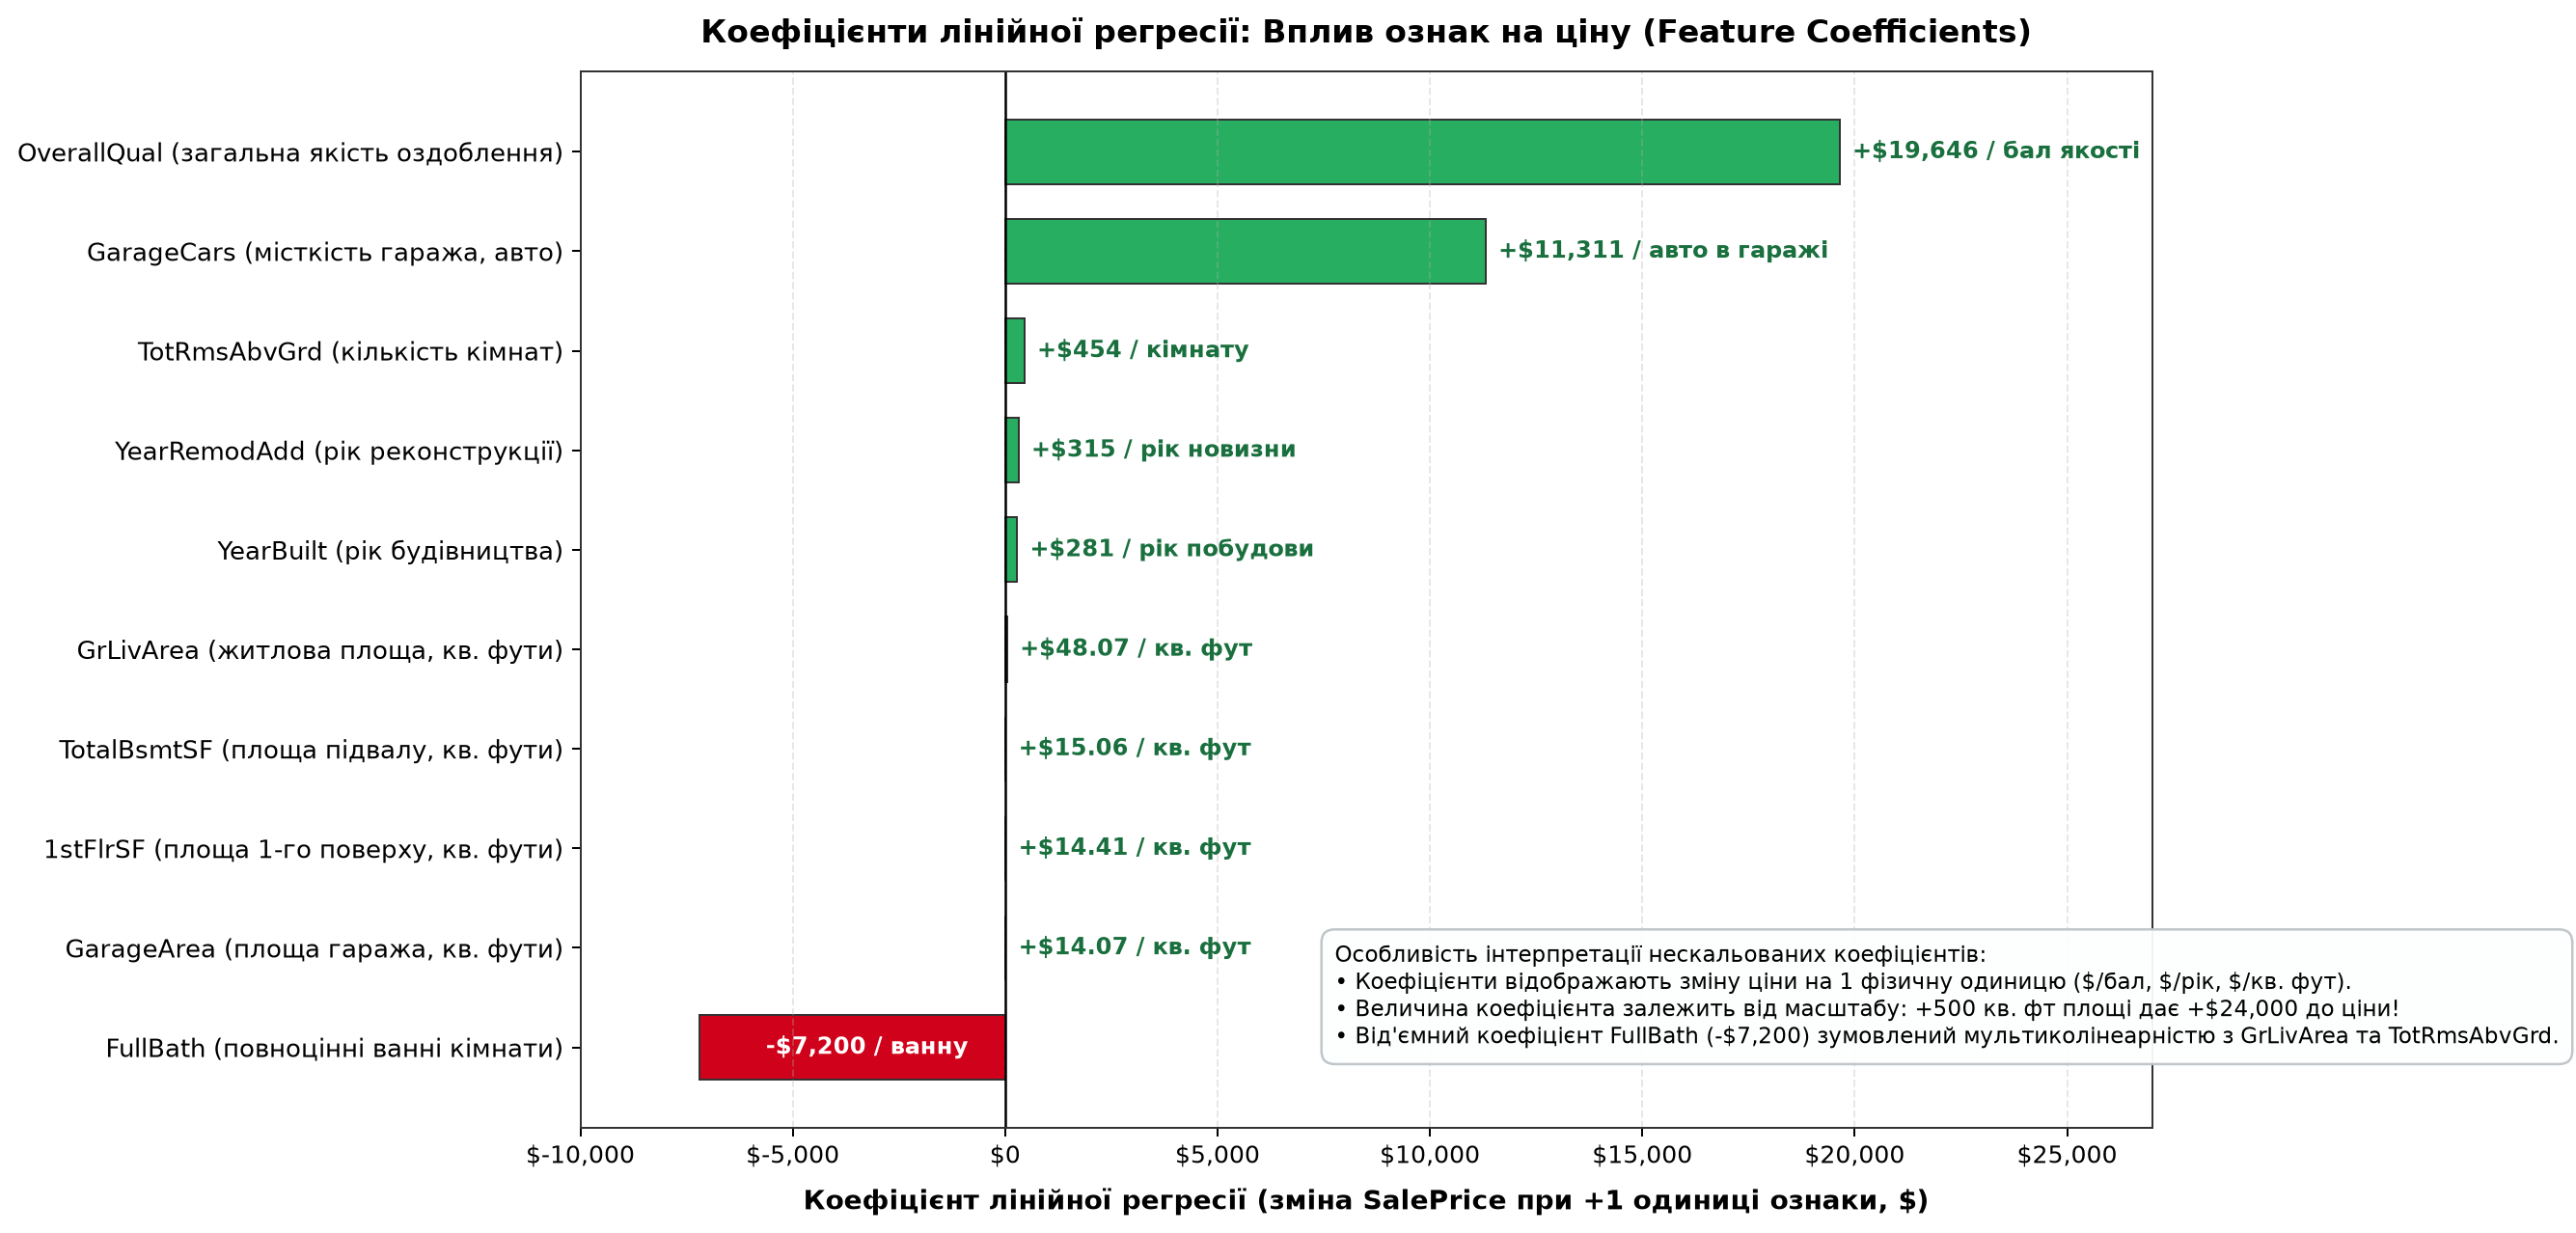
Рейтинг коефіцієнтів регресії (Feature Importance)
| Ознака (стовпець) | Український переклад | Коефіцієнт моделі (Завантаження...) | Вплив на прогноз вартості |
|---|---|---|---|
OverallQual | Загальна якість матеріалів | +19,645.60 | 🟢 Найпотужніший позитивний фактор |
GarageCars | Місткість гаража (кількість авто) | +11,311.43 | 🟢 Вагомий приріст до вартості |
FullBath | Повноцінні ванні кімнати | -7,199.99 | 🔴 Ефект мультиколінеарності |
TotRmsAbvGrd | Кількість кімнат над землею | +453.96 | 🟢 Помірний позитивний внесок |
YearRemodAdd | Рік реконструкції/ремонту | +314.98 | 🟢 Свіжість оновлення будинку |
YearBuilt | Рік первинного будівництва | +281.11 | 🟢 Вік будівлі |
GrLivArea | Житлова площа (кв. фути) | +48.07 | 🟢 Стабільне масштабування площі |
TotalBsmtSF | Площа підвалу (кв. фути) | +15.06 | 🟢 Додатковий корисний простір |
1stFlrSF | Площа 1-го поверху (кв. фути) | +14.41 | 🟢 Базова площа першого ярусу |
GarageArea | Площа гаража (кв. фути) | +14.07 | 🟢 Розмір підсобного приміщення |
Інтерпретація коефіцієнтів
- Позитивний коефіцієнт → збільшення показника підвищує ринкову вартість.
- Негативний коефіцієнт → збільшення ознаки за інших рівних умов знижує прогнозовану ціну.
- Одиниці вимірювання: коефіцієнти розраховані у фізичних одиницях відповідної ознаки ($/бал, $/авто, $/рік, $/кв. фут).
OverallQual(загальна якість матеріалів та оздоблення): коефіцієнт +$19,646 → кожен додатковий бал за шкалою від 1 до 10 підвищує прогноз вартості житла на ~$19,646.GarageCars(місткість гаража): коефіцієнт +$11,311 → кожне додаткове паркомісце в гаражі додає до вартості будинку ~$11,311.GrLivArea(житлова площа над землею): коефіцієнт +$48.07 → кожен додатковий квадратний фут площі збільшує ціну на $48.07 (+~$517 на 1 кв. метр). Збільшення будинку на 500 кв. футів дає приріст понад +$24,000!YearRemodAdd(рік реконструкції) таYearBuilt(рік будівництва): коефіцієнти +$315 та +$281 за кожен рік відповідно. Свіжіший ремонт та новіший рік споруди стабільно збільшують ціну.FullBath(повноцінні ванні кімнати): коефіцієнт -$7,200. Чому знак від'ємний? Це хрестоматійний приклад мультиколінеарності: якщо загальна площа будинку (GrLivArea) та загальна кількість кімнат (TotRmsAbvGrd) вже зафіксовані, виділення площі під ще один повноцінний санвузол зменшує житлову площу основних кімнат.
OverallQualзмінюється від 1 до 10 (діапазон 9)GrLivAreaзмінюється від 334 до 5642 (діапазон 5308)
OverallQualважливіше, ніж GrLivArea, просто тому, що коефіцієнт більший. У наступній статті навчимось правильно порівнювати важливість ознак.Що далі?
У цій статті ми навчились:
✅ Розуміти проблему оцінки на тренувальних даних
✅ Розбивати дані на train/test за допомогою train_test_split
✅ Будувати повноцінну модель на реальних даних
✅ Оцінювати модель на обох вибірках (train vs test)
✅ Візуалізувати передбачення та аналізувати залишки
✅ Інтерпретувати коефіцієнти (feature importance)
У наступній статті ми детально розберемо дві ключові проблеми машинного навчання:
- Overfitting (перенавчання) — модель добре на train, погано на test
- Underfitting (недонавчання) — модель погано на обох
- Learning Curves — графіки, що показують, як змінюється якість при збільшенні кількості даних
- Bias-Variance Tradeoff — баланс між простотою та складністю моделі
Практика
Завдання: Завантажте Housing датасет. Відберіть 3 числові ознаки на свій вибір (без пропусків), наприклад: OverallQual (загальна якість), GrLivArea (житлова площа) та YearBuilt (рік будівництва). Розбийте на train/test (80/20, random_state=42). Навчіть LinearRegression. Виведіть R² на train і test.
Підказка:
# Відібрати 3 ключові числові ознаки
features = ['OverallQual', 'GrLivArea', 'YearBuilt']
X = df[features]
y = df['SalePrice']  # цільова змінна

# Train/test split...
# Model training...
Питання для роздумів:
- Чи є суттєва різниця між train і test R²?
- Якщо train R² виявиться набагато вищим за test R², що це означатиме?
Завдання: Побудуйте модель з 5 ознаками. Повторіть експеримент з трьома різними random_state (42, 100, 200). Порівняйте метрики (R², MAE, RMSE) на test для кожного випадку.
Підказка:
random_states = [42, 100, 200]
results = []

for rs in random_states:
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=rs)
    # ... навчити модель ...
    results.append({'random_state': rs, 'R2': test_r2, 'MAE': test_mae})

results_df = pd.DataFrame(results)
print(results_df)
Питання:
- Чи сильно відрізняються метрики при різних розбиттях?
- Що це говорить про стабільність моделі?
- Яке значення random_state дало найкращий результат?
Завдання: Проведіть повний експеримент:
- Виберіть 10 найкращих ознак (з EDA або самостійний аналіз кореляцій)
- Обробіть пропуски (
SimpleImputerз медіаною) - Масштабуйте ознаки (
StandardScaler) — після train/test split! - Навчіть модель та обчисліть метрики
- Побудуйте:
- Scatter plot (predicted vs actual) для train та test
- Residual plot
- Feature importance bar chart
- Напишіть інтерпретацію результатів (3-5 речень):
- Чи є overfitting?
- Наскільки точна модель?
- Які ознаки найважливіші?
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression

# Завантажити дані Housing Prices
df = pd.read_csv('train.csv')

# Відібрати 3 ознаки:
# - OverallQual (загальна якість оздоблення)
# - GrLivArea (житлова площа над землею)
# - YearBuilt (рік будівництва)
features = ['OverallQual', 'GrLivArea', 'YearBuilt']
X = df[features]
y = df['SalePrice']

# Train/test split (80% на навчання, 20% на тест)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# Навчити модель лінійної регресії
model = LinearRegression()
model.fit(X_train, y_train)

# Оцінити коефіцієнт детермінації R²
train_r2 = model.score(X_train, y_train)
test_r2 = model.score(X_test, y_test)

print(f"Train R²: {train_r2:.4f}")
print(f"Test R²:  {test_r2:.4f}")
print(f"Різниця:  {abs(train_r2 - test_r2):.4f}")

if abs(train_r2 - test_r2) < 0.05:
    print("✅ Модель узагальнює добре (різниця < 5%)")
else:
    print("⚠️ Можливий overfitting (різниця > 5%)")
Резюме
Train/Test Split
Train Set
.fit().Test Set
test_size
train_test_split, що визначає розмір test. Типові значення: 0.2 (80/20) або 0.3 (70/30).random_state
shuffle
Overfitting
Underfitting
Residual (Залишок)
Feature Importance
Data Leakage
Generalization
Попередня обробка даних (Data Preprocessing)
Підготовка реальних даних до навчання моделі. Обробка пропусків, кодування категорій, масштабування ознак та побудова preprocessing pipeline.
Перенавчання та недонавчання
Розбір концепцій overfitting та underfitting. Крива навчання, діагностика проблем та методи боротьби з перенавчанням.