Попередня обробка даних (Data Preprocessing)
У попередніх статтях ми провели детальний EDA датасету Housing Prices та виявили ключові проблеми: пропуски у даних, категоріальні ознаки (текстові значення) та різні масштаби числових ознак. Тепер настав час вирішити ці проблеми та підготувати дані для навчання моделі.
Цей процес називається Data Preprocessing (попередня обробка даних) — один з найважливіших етапів машинного навчання.
Чому модель не може працювати з сирими даними?
Спробуймо навчити модель на реальних даних Housing без жодної обробки:
import pandas as pd
from sklearn.linear_model import LinearRegression

# Завантажити дані (файл train.csv з попередніх занять)
df = pd.read_csv('train.csv')

# Спробувати навчити модель на всіх ознаках для передбачення ціни SalePrice
X = df.drop('SalePrice', axis=1)  # Всі ознаки крім ціни
y = df['SalePrice']               # SalePrice (ціна продажу) — цільова змінна

model = LinearRegression()
model.fit(X, y)  # Що станеться?
Модель відразу повідомляє про дві критичні проблеми:
- Пропуски (NaN) — алгоритми лінійної регресії не вміють обчислювати вирази з відсутніми значеннями
- Текстові дані ('RL') — значення
'RL'(Residential Low Density у стовпціMSZoning— зона забудови) не є числом, а моделі працюють виключно з числовими тензорами та матрицями
Додатково є третя прихована проблема, яку ми побачимо пізніше — різні масштаби ознак.
Аналогія: сирі дані — це як сирі інгредієнти перед готуванням. Перед тим, як почати готувати страву (навчати модель), потрібно помити овочі (прибрати пропуски), почистити їх (закодувати категорії), порізати на однакові шматочки (масштабувати). Інакше страва не вийде.
🎯 Три основні проблеми сирих даних
- Пропуски (NaN) → алгоритми не можуть обчислити результат
- Категоріальні ознаки (текст) → потрібні числа
- Різні масштаби (1 vs 100 000) → одна ознака затьмарює інші
🔧 Рішення — Preprocessing
- SimpleImputer — заповнити пропуски
- Encoding — перетворити текст → числа
- Scaling — привести до єдиного масштабу
Проблема 1: Пропуски (Missing Values)
Чому виникають пропуски?
У реальних даних пропуски — це норма, а не виняток. Основні причини:
📊 Не застосовно
GarageArea (площа гаража) = NaN. Це не помилка, а факт: якщо об'єкта немає, то і його параметри відсутні.❌ Помилки збору
🔒 Приватність
Чому пропуски — це проблема?
y = w₁x₁ + w₂x₂ + b, якщо x₁ = NaN — що таке "NaN помножити на число"?Друга проблема — втрата даних: якщо просто видалити всі рядки з пропусками, може залишитися лише 10-20% датасету.Перевіримо, скільки пропусків у нашому датасеті:
import pandas as pd
import numpy as np

# Завантажити дані
df = pd.read_csv('train.csv')

# Порахувати пропуски
missing = df.isnull().sum()
missing = missing[missing > 0].sort_values(ascending=False)

# Відсоток пропусків
missing_percent = (missing / len(df) * 100).round(2)

# Об'єднати у таблицю
missing_data = pd.DataFrame({
    'Пропуски': missing,
    'Відсоток (%)': missing_percent
})

print(f"Загальна кількість стовпців: {df.shape[1]}")
print(f"Стовпців з пропусками: {len(missing_data)}")
print(f"\nТоп-10 стовпців з найбільшою кількістю пропусків:\n")
print(missing_data.head(10))
| Ознака (стовпець) | Пропусків | Відсоток (%) | Тип ознаки |
|---|---|---|---|
| PoolQC (якість басейну) | 1453 | 99.52% | категоріальна |
| MiscFeature (додаткові зручності: сарай, корт) | 1406 | 96.30% | категоріальна |
| Alley (тип під'їзного провулка) | 1369 | 93.77% | категоріальна |
| Fence (наявність та тип огорожі) | 1179 | 80.75% | категоріальна |
| FireplaceQu (якість каміна) | 690 | 47.26% | категоріальна |
| LotFrontage (довжина фасаду ділянки) | 259 | 17.74% | числова (кв. фути) |
| GarageType (тип розташування гаража) | 81 | 5.55% | категоріальна |
| GarageYrBlt (рік побудови гаража) | 81 | 5.55% | числова (рік) |
| GarageFinish (стан оздоблення гаража) | 81 | 5.55% | категоріальна |
| GarageQual (якість гаража) | 81 | 5.55% | категоріальна |
Бачимо, що 19 стовпців містять пропуски. Стовпець PoolQC (якість басейну) має 99.5% пропусків — це логічно, адже у переважної більшості будинків взагалі немає басейну.
Стратегії обробки пропусків
Існує два основні підходи:
🗑️ Видалити
Видалити рядки (df.dropna(axis=0)) або видалити стовпці (df.dropna(axis=1)) з пропусками.
Коли використовувати:
- Якщо пропусків >50% у стовпці
- Якщо пропуски випадкові та їх мало (<5%)
Недоліки:
- Втрата цінних даних
- Може залишитися дуже мало рядків
🔧 Заповнити (Imputation)
Заповнити пропуски розумним значенням: середнім, медіаною, модою або константою.
Коли використовувати:
- Якщо пропусків не дуже багато (<50%)
- Якщо стовпець важливий для моделі
Недоліки:
- Може спотворити розподіл даних
- Потрібно обирати правильну стратегію
Розглянемо другий підхід детальніше, адже він зберігає більше інформації.
SimpleImputer — заповнення пропусків
SimpleImputer з scikit-learn надає чотири основні стратегії заповнення пропусків:
| Стратегія | Що робить | Коли використовувати | Приклад |
|---|---|---|---|
mean | Заповнює середнім арифметичним | Числові ознаки без викидів | Площа будинку |
median | Заповнює медіаною | Числові ознаки з викидами | Ціна (є дуже дорогі будинки) |
most_frequent | Заповнює модою (найчастішим значенням) | Категоріальні ознаки | Тип гаража ("Attached") |
constant | Заповнює фіксованою константою | Спеціальні випадки | 0, "Unknown", -1 |
- Числова ознака без викидів →
mean(швидше обчислюється) - Числова ознака з викидами →
median(стійка до викидів) - Категоріальна ознака →
most_frequent(текст не має "середнього") - Семантичне значення →
constant(наприклад, "Немає гаража" → 0)
Приклад 1: Заповнення середнім (mean)
from sklearn.impute import SimpleImputer
import numpy as np

# Створимо дані з пропусками
data = np.array([[1, 2],
                 [np.nan, 3],
                 [7, 6],
                 [5, np.nan]])

print("Оригінальні дані:")
print(data)
print(f"\nФорма: {data.shape}")
# Створити imputer з стратегією 'mean'
imputer = SimpleImputer(strategy='mean')

# Навчити (обчислити середні для кожного стовпця)
imputer.fit(data)

print("Обчислені середні значення для кожного стовпця:")
print(imputer.statistics_)  # [середнє для стовпця 0, середнє для стовпця 1]
# Застосувати заповнення
data_imputed = imputer.transform(data)

print("Після заповнення пропусків:")
print(data_imputed)
print("\nПояснення:")
print("  Стовпець 0: NaN замінено на 4.33 (середнє з 1, 7, 5)")
print("  Стовпець 1: NaN замінено на 3.67 (середнє з 2, 3, 6)")
.fit() та .transform():.fit(data)— "навчитися" на даних (обчислити середнє, медіану, моду).transform(data)— застосувати навчені параметри (заповнити NaN).fit_transform(data)— навчитися + застосувати за один виклик
Приклад 2: Заповнення медіаною (median)
Медіана стійка до викидів. Подивимось на приклад з викидом:
# Дані з викидом (999 — явно некоректне значення)
data_with_outlier = np.array([[10], [12], [11], [np.nan], [13], [999]])

# Стратегія 1: середнє (чутливе до викидів)
imputer_mean = SimpleImputer(strategy='mean')
data_mean = imputer_mean.fit_transform(data_with_outlier)

# Стратегія 2: медіана (стійка до викидів)
imputer_median = SimpleImputer(strategy='median')
data_median = imputer_median.fit_transform(data_with_outlier)

print("Оригінал:", data_with_outlier.flatten())
print(f"Середнє: {imputer_mean.statistics_[0]:.2f}")
print(f"Медіана: {imputer_median.statistics_[0]:.2f}")
print(f"\nПісля заповнення MEAN:", data_mean.flatten())
print(f"Після заповнення MEDIAN:", data_median.flatten())
Висновок: викид (999) сильно зміщує середнє (209), але медіана залишається адекватною (12). Тому для даних з потенційними викидами завжди використовуйте median, а не mean.
Приклад 3: Заповнення модою (most_frequent)
Для категоріальних ознак (текстових) потрібно використовувати моду — найчастіше значення:
# Категоріальні дані: типи гаражів
garage_types = np.array([['Attached'],
                         ['Detached'],
                         ['Attached'],
                         [np.nan],
                         ['Attached'],
                         [np.nan]])

imputer_mode = SimpleImputer(strategy='most_frequent')
garage_filled = imputer_mode.fit_transform(garage_types)

print("Оригінал:")
print(garage_types.flatten())
print(f"\nМода (найчастіше): {imputer_mode.statistics_[0]}")
print("\nПісля заповнення:")
print(garage_filled.flatten())
most_frequent:Якщо розподіл категорій рівномірний (наприклад, 33% "A", 33% "B", 34% "C"), заповнення модою може бути некоректним. У таких випадках краще використовувати constant зі значенням "Unknown" або видалити рядки з пропусками.Практичний приклад на Housing датасеті
Застосуймо SimpleImputer до реальних даних. Оберемо дві ознаки з пропусками:
LotFrontage(числова) — лінійна довжина фасаду ділянки у футах (17.7% пропусків)GarageType(категоріальна) — тип розташування гаража (5.5% пропусків)
# Перевірити пропуски до обробки
print("Пропуски ДО обробки:")
print(f"  LotFrontage: {df['LotFrontage'].isnull().sum()} ({df['LotFrontage'].isnull().sum() / len(df) * 100:.1f}%)")
print(f"  GarageType:  {df['GarageType'].isnull().sum()} ({df['GarageType'].isnull().sum() / len(df) * 100:.1f}%)")
# Заповнити LotFrontage медіаною (числова ознака, можуть бути викиди)
imputer_median = SimpleImputer(strategy='median')
df['LotFrontage'] = imputer_median.fit_transform(df[['LotFrontage']])

# Заповнити GarageType модою (категоріальна ознака)
imputer_mode = SimpleImputer(strategy='most_frequent')
df['GarageType'] = imputer_mode.fit_transform(df[['GarageType']])

# Перевірити результат
print("Пропуски ПІСЛЯ обробки:")
print(f"  LotFrontage: {df['LotFrontage'].isnull().sum()}")
print(f"  GarageType:  {df['GarageType'].isnull().sum()}")
print(f"\nЗаповнено LotFrontage значенням: {imputer_median.statistics_[0]:.1f}")
print(f"Заповнено GarageType значенням: {imputer_mode.statistics_[0]}")
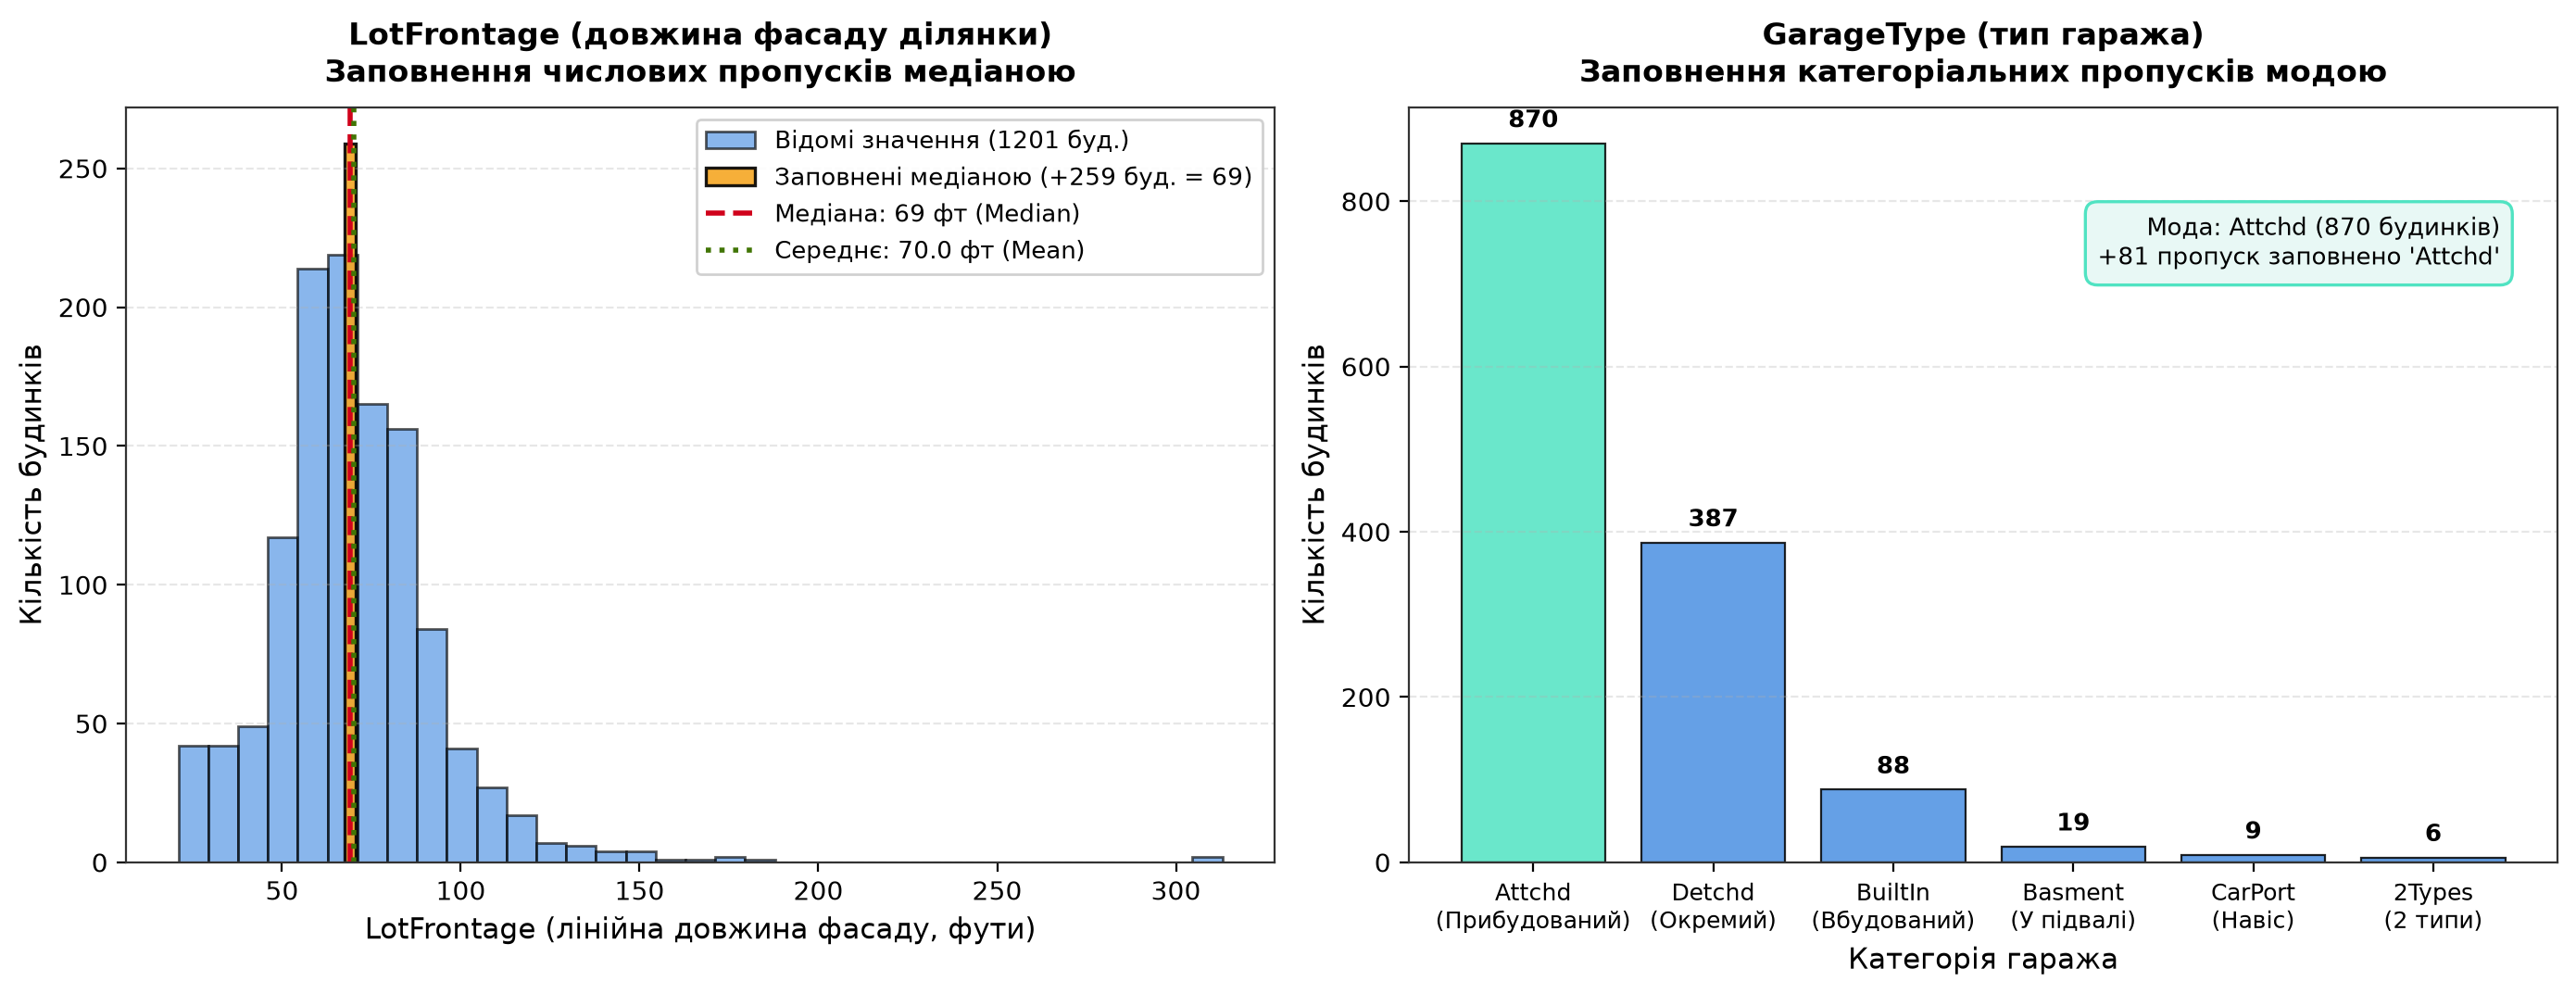
Чудово! Тепер ці дві ознаки не мають жодного пропуску і готові для подальшої обробки та навчання моделі.
Проблема 2: Категоріальні ознаки
Алгоритми машинного навчання працюють виключно з числами (матрицями, векторами). Але у реальних даних часто є текстові ознаки: назви районів, типи будинків, кольори, тощо.
# Приклад категоріальної ознаки з Housing
print("Унікальні значення Neighborhood (район):")
print(df['Neighborhood'].unique()[:10])  # Перші 10
print(f"\nВсього унікальних районів: {df['Neighborhood'].nunique()}")
Як перетворити текст "CollgCr", "Veenker" тощо у числа, з якими може працювати модель? Існує два основні методи.
Метод 1: Factorize (Label Encoding)
Принцип: присвоїти кожній унікальній категорії числовий індекс (0, 1, 2, ...).
Аналогія: це як присвоїти кожному студенту в класі номер: Іван = 1, Марія = 2, Олег = 3. Зручно, але виникає штучний порядок: "Олег > Марія > Іван"?
Pandas метод: pd.factorize()
# Приклад з кольорами
colors = ['red', 'blue', 'red', 'green', 'blue', 'green', 'red']

# Factorize повертає два значення:
# 1. codes — числові коди
# 2. uniques — порядок унікальних значень
codes, uniques = pd.factorize(colors)

print("Оригінал:  ", colors)
print("Codes:     ", codes)
print("Uniques:   ", uniques.tolist())
print("\nІнтерпретація: red=0, blue=1, green=2")
Scikit-learn метод: LabelEncoder
from sklearn.preprocessing import LabelEncoder

encoder = LabelEncoder()

# Fit + Transform
colors_encoded = encoder.fit_transform(colors)

print("Оригінал:        ", colors)
print("Після кодування: ", colors_encoded)
print("Класи:           ", encoder.classes_)
pd.factorize() та LabelEncoder:pd.factorize()присвоює індекси у порядку першої зустрічі (red=0, blue=1, green=2)LabelEncoderприсвоює індекси в алфавітному порядку (blue=0, green=1, red=2)
Ключова перевага LabelEncoder — можливість зворотнього перетворення:
# Зворотнє перетворення: числа → текст
decoded = encoder.inverse_transform([2, 0, 1])
print("Закодовано: [2, 0, 1]")
print("Декодовано:", decoded)
Проблема Factorize — штучний порядок
green (2) > blue (1) > red (0)- Модель може "подумати", що green "ближче" до blue, ніж red до blue
- Якість: "Bad" (0) < "Average" (1) < "Good" (2) < "Excellent" (3)
- Освіта: "School" (0) < "Bachelor" (1) < "Master" (2) < "PhD" (3)
- Кольори: "Red", "Blue", "Green" — немає порядку
- Міста: "Kyiv", "Lviv", "Odesa" — немає порядку
- Типи гаражів: "Attached", "Detached", "Built-in" — немає порядку
Для номінальних категорій потрібен інший метод — One-Hot Encoding.
Метод 2: One-Hot Encoding
Принцип: створити окремий бінарний стовпець для кожної категорії. Значення 1 означає "так", 0 означає "ні".
Аналогія: замість того, щоб сказати "студент №3", ми створюємо анкету:
- Чи є це Іван? 0
- Чи є це Марія? 0
- Чи є це Олег? 1 ← так, це Олег
Візуальний приклад трансформації:
Оригінальна таблиця:
┌────────┐
│ Color  │
├────────┤
│ red    │
│ blue   │
│ green  │
│ red    │
└────────┘

Після One-Hot Encoding:
┌───────────┬────────────┬──────────────┐
│ Color_red │ Color_blue │ Color_green  │
├───────────┼────────────┼──────────────┤
│     1     │      0     │      0       │
│     0     │      1     │      0       │
│     0     │      0     │      1       │
│     1     │      0     │      0       │
└───────────┴────────────┴──────────────┘
Pandas метод: pd.get_dummies()
# Створити DataFrame з категоріальною ознакою
df_colors = pd.DataFrame({
    'ID': [1, 2, 3, 4],
    'Color': ['red', 'blue', 'green', 'red']
})

print("Оригінальний DataFrame:")
print(df_colors)
print(f"Форма: {df_colors.shape}\n")

# One-Hot Encoding
df_encoded = pd.get_dummies(df_colors, columns=['Color'], prefix='Color')

print("Після One-Hot Encoding:")
print(df_encoded)
print(f"Форма: {df_encoded.shape}")
| Рядок | ID | Color (категоріальна ознака) |
|---|---|---|
| 0 | 1 | red |
| 1 | 2 | blue |
| 2 | 3 | green |
| 3 | 4 | red |
| Рядок | ID | Color_blue | Color_green | Color_red |
|---|---|---|---|---|
| 0 | 1 | False (0) | False (0) | True (1) |
| 1 | 2 | True (1) | False (0) | False (0) |
| 2 | 3 | False (0) | True (1) | False (0) |
| 3 | 4 | False (0) | False (0) | True (1) |
pd.get_dummies():columns— список стовпців для кодуванняprefix— префікс для нових стовпців (краще вказувати, щоб уникнути конфліктів імен)drop_first=True— видалити перший стовпець (уникнення мультиколінеарності, пояснимо далі)
Scikit-learn метод: OneHotEncoder
from sklearn.preprocessing import OneHotEncoder

# Підготувати дані (OneHotEncoder потребує 2D масив)
colors_array = np.array(['red', 'blue', 'green', 'red']).reshape(-1, 1)

# Створити encoder
encoder = OneHotEncoder(sparse_output=False)  # sklearn 1.2+

# Fit + Transform
colors_onehot = encoder.fit_transform(colors_array)

print("Оригінал:")
print(colors_array.flatten())
print("\nКатегорії (порядок стовпців):")
print(encoder.categories_)
print("\nOne-Hot Encoding (матриця):")
print(colors_onehot)
print(f"\nФорма: {colors_onehot.shape} — 4 рядки, 3 стовпці (blue, green, red)")
| Рядок | Вхідне значення | Стовпець 0 (blue) | Стовпець 1 (green) | Стовпець 2 (red) |
|---|---|---|---|---|
| 0 | 'red' | 0.0 | 0.0 | 1.0 |
| 1 | 'blue' | 1.0 | 0.0 | 0.0 |
| 2 | 'green' | 0.0 | 1.0 | 0.0 |
| 3 | 'red' | 0.0 | 0.0 | 1.0 |
sparse_output:У версіях scikit-learn 1.2+ параметр називається sparse_output (раніше був sparse). За замовчуванням повертається розріджена матриця (sparse matrix) — формат, що економить пам'ять для великих датасетів з багатьма категоріями.Встановіть sparse_output=False, щоб отримати звичайний NumPy масив (зручніше для малих даних та навчання).Параметр drop='first' — уникнення мультиколінеарності
Якщо у категорії 3 значення (red, blue, green), то насправді достатньо 2 стовпців, а не 3:
Якщо Color_blue=0 та Color_green=0, то автоматично Color_red=1
Це називається dummy variable trap (пастка фіктивних змінних) або мультиколінеарність — один стовпець повністю передбачається з інших. Це може погіршити роботу деяких алгоритмів (особливо лінійної регресії).
# Видалити перший стовпець (drop='first')
encoder_drop = OneHotEncoder(drop='first', sparse_output=False)
colors_onehot_drop = encoder_drop.fit_transform(colors_array)

print("Без drop='first' — 3 стовпці:")
print(colors_onehot)
print(f"Форма: {colors_onehot.shape}\n")

print("З drop='first' — 2 стовпці (видалено 'blue'):")
print(colors_onehot_drop)
print(f"Форма: {colors_onehot_drop.shape}")
print("\nТепер: [0, 0] = blue, [1, 0] = green, [0, 1] = red")
| Рядок | Вхідний колір | blue | green | red |
|---|---|---|---|---|
| 0 | 'red' | 0.0 | 0.0 | 1.0 |
| 1 | 'blue' | 1.0 | 0.0 | 0.0 |
| 2 | 'green' | 0.0 | 1.0 | 0.0 |
| 3 | 'red' | 0.0 | 0.0 | 1.0 |
| Рядок | Вхідний колір | green | red | Інтерпретація |
|---|---|---|---|---|
| 0 | 'red' | 0.0 | 1.0 | red (активний 2-й стовпець) |
| 1 | 'blue' | 0.0 | 0.0 | blue (базовий стан: 0, 0) |
| 2 | 'green' | 1.0 | 0.0 | green (активний 1-й стовпець) |
| 3 | 'red' | 0.0 | 1.0 | red (активний 2-й стовпець) |
drop='first'?- ✅ Використовуйте для лінійної/логістичної регресії (уникає мультиколінеарності)
- ❌ Не обов'язково для дерев рішень, випадкових лісів (вони стійкі до колінеарності)
- ❌ Не обов'язково якщо важлива інтерпретованість (простіше розуміти "Color_red=1", ніж "0,1=red")
drop='first' за замовчуванням, якщо не маєте вагомої причини цього не робити.Порівняння: Factorize vs One-Hot Encoding
| Аспект | Label Encoding (Factorize) | One-Hot Encoding |
|---|---|---|
| Кількість стовпців | 1 | n (кількість унікальних категорій) |
| Вводить порядок? | ✅ Так (0 < 1 < 2) | ❌ Ні |
| Тип категорій | Ординальні (з порядком) | Номінальні (без порядку) |
| Приклад використання | "Low" < "Medium" < "High" | "Red", "Blue", "Green" |
| Розмір датасету | Компактний | Може значно збільшитися |
| Алгоритми | Дерева рішень (можуть впоратись) | Лінійна регресія, SVM |
| Інтерпретованість | Висока (1 число на категорію) | Середня (n чисел на категорію) |
🎯 Коли використовувати Label Encoding
✅ Ординальні категорії з природним порядком:
- Оцінки якості: Poor < Fair < Good < Excellent
- Рівні освіти: School < Bachelor < Master < PhD
- Розміри: S < M < L < XL
✅ Дерева рішень (Random Forest, XGBoost) — можуть працювати з кодованими категоріями без проблем
🎯 Коли використовувати One-Hot Encoding
✅ Номінальні категорії без природного порядку:
- Кольори: Red, Blue, Green
- Міста: Kyiv, Lviv, Odesa
- Типи будинків: Condo, Townhouse, Single-Family
✅ Лінійна/логістична регресія, SVM — ці алгоритми чутливі до штучного порядку
✅ За замовчуванням — якщо сумніваєтесь, використовуйте One-Hot
Практичний приклад на Housing
Закодуймо категоріальну ознаку Neighborhood (район розташування будинку) за допомогою One-Hot Encoding:
# Перевірити унікальні значення
print(f"Унікальних районів: {df['Neighborhood'].nunique()}")
print(f"Форма датасету ДО кодування: {df.shape}\n")

# One-Hot Encoding з drop_first=True
df_encoded = pd.get_dummies(df, columns=['Neighborhood'], prefix='Neighborhood', drop_first=True)

print(f"Форма датасету ПІСЛЯ кодування: {df_encoded.shape}")
print(f"Додано стовпців: {df_encoded.shape[1] - df.shape[1] + 1}")
print(f"\nНові стовпці (перші 5):")
print([col for col in df_encoded.columns if col.startswith('Neighborhood')][:5])
Результат: замість одного стовпця Neighborhood (район) з текстовими значеннями, тепер маємо 24 бінарні стовпці (25 районів - 1 базовий, видалений через drop_first=True для уникнення мультиколінеарності).
- Збільшення часу навчання
- Потреба у більшій кількості даних
- Ризик перенавчання (overfitting)
- Групувати рідкісні категорії в "Other"
- Використовувати Target Encoding (для просунутих проєктів)
- Застосовувати Feature Selection (відбір важливих ознак)
Проблема 3: Різні масштаби ознак
Третя проблема сирих даних — різні масштаби числових ознак. Порівняємо діапазони трьох ключових ознак: YearBuilt (рік будівництва), GrLivArea (житлова площа над землею) та SalePrice (ціна продажу):
# Порівняти масштаби різних ознак
print("Статистика числових ознак Housing:\n")
features_to_compare = ['YearBuilt', 'GrLivArea', 'SalePrice']
print(df[features_to_compare].describe())
| Метрика | YearBuilt (рік будівництва) | GrLivArea (житлова площа, кв.фт) | SalePrice (ціна продажу, $) |
|---|---|---|---|
| count (кількість) | 1460 | 1460 | 1460 |
| mean (середнє) | 1971 | 1515 | $180,921 |
| std (станд. відхилення) | 30.2 | 525.5 | $79,443 |
| min (мінімум) | 1872 | 334 | $34,900 |
| 25% (перший квартиль) | 1954 | 1130 | $129,975 |
| 50% (медіана) | 1973 | 1464 | $163,000 |
| 75% (третій квартиль) | 2000 | 1777 | $214,000 |
| max (максимум) | 2010 | 5642 | $755,000 |
Бачимо кардинальну різницю у вимірах:
YearBuilt(рік будівництва): 1872–2010 (діапазон ~140 років)GrLivArea(житлова площа над землею): 334–5642 кв.фт (діапазон ~5300 кв.фт)SalePrice(ціна продажу): $34,900–$755,000 (діапазон ~$720,000)
Чому це проблема?
Аналогія: уявіть двох учнів. Один отримує оцінки від 0 до 5, інший — від 0 до 100. Якщо ви просто підсумуєте їхні оцінки, то оцінки другого учня завжди "затьмарять" оцінки першого. Щоб порівняти, потрібно привести обидва до єдиної шкали.
- Лінійна регресія: коефіцієнти будуть некоректними (ознака з більшим діапазоном отримає меншу вагу просто через масштаб)
- Градієнтний спуск: буде сходитися набагато повільніше або взагалі не зійдеться
- KNN, SVM: ознаки з більшим діапазоном домінують у обчисленні відстаней
- Нейронні мережі: погана ініціалізація ваг, нестабільне навчання
Рішення — масштабування ознак (feature scaling).
Метод 1: MinMaxScaler (Normalization)
MinMaxScaler масштабує дані до фіксованого діапазону 0, 1 за формулою:
Де:
- Завантаження... — оригінальне значення
- Завантаження... — мінімум у стовпці
- Завантаження... — максимум у стовпці
Результат: всі значення будуть у діапазоні від 0 до 1.
from sklearn.preprocessing import MinMaxScaler
import numpy as np

# Дані: вік людей
ages = np.array([[20], [25], [30], [35], [40]])

print("Оригінальні дані (вік):")
print(ages.flatten())
print(f"Мін: {ages.min()}, Макс: {ages.max()}")
# Створити scaler
scaler = MinMaxScaler()

# Fit (знайти min та max)
scaler.fit(ages)

print("Параметри scaler:")
print(f"  data_min_: {scaler.data_min_}")
print(f"  data_max_: {scaler.data_max_}")
# Transform (масштабувати)
ages_scaled = scaler.transform(ages)

print("\nПісля масштабування (MinMax):")
print(ages_scaled.flatten())
print("\nПеревірка формули для 30:")
print(f"  (30 - 20) / (40 - 20) = {(30 - 20) / (40 - 20)}")
Інтерпретація:
- 20 (мінімум) → 0.0
- 30 (середина) → 0.5
- 40 (максимум) → 1.0
✅ Переваги MinMaxScaler
- Фіксований діапазон 0, 1 — легко інтерпретувати
- Зберігає розподіл даних (форма гістограми не змінюється)
- Підходить для алгоритмів, що працюють з ймовірностями або відстанями (KNN, нейромережі)
❌ Недоліки MinMaxScaler
- Дуже чутливий до викидів (outliers)
- Один викид може "стиснути" всі нормальні значення до вузького діапазону
- Приклад: якщо є значення 10, 12, 11, 13, 999, то 10, 12, 11, 13 будуть близько до 0, а 999 буде 1
Метод 2: StandardScaler (Standardization)
StandardScaler стандартизує дані: центрує навколо 0 та встановлює стандартне відхилення = 1. Формула:
Де:
- Завантаження... — середнє значення стовпця
- Завантаження... — стандартне відхилення стовпця
Результат: середнє = 0, std = 1. Діапазон не фіксований (зазвичай від -3 до +3 для нормального розподілу).
from sklearn.preprocessing import StandardScaler

# Використати ті самі дані
scaler_std = StandardScaler()

# Fit + Transform
ages_standardized = scaler_std.fit_transform(ages)

print("Оригінальні дані:")
print(ages.flatten())
print(f"\nПараметри scaler:")
print(f"  mean: {scaler_std.mean_[0]:.1f}")
print(f"  std:  {scaler_std.scale_[0]:.2f}")
print(f"\nПісля стандартизації:")
print(ages_standardized.flatten())
print(f"\nПеревірка:")
print(f"  Середнє: {ages_standardized.mean():.10f} (має бути ~0)")
print(f"  Std:     {ages_standardized.std():.10f} (має бути ~1)")
Інтерпретація:
- Значення 0 означає "середнє"
- Значення -1 означає "на 1 стандартне відхилення нижче середнього"
- Значення +1 означає "на 1 стандартне відхилення вище середнього"
✅ Переваги StandardScaler
- Стійкий до викидів (використовує середнє та std, а не min/max)
- Добре працює з алгоритмами, що припускають нормальний розподіл (лінійна регресія, SVM)
- Стандартна практика у більшості ML-задач
❌ Недоліки StandardScaler
- Немає фіксованого діапазону (може бути від -5 до +5 для даних з великим розкидом)
- Якщо потрібні значення в 0, 1 (наприклад, для нейромереж з сигмоїдою), то треба MinMax
Візуалізація порівняння масштабування
Побудуємо графіки, щоб наочно побачити різницю між MinMaxScaler та StandardScaler:
import matplotlib.pyplot as plt

# Використати реальну ознаку з Housing
feature = df[['GrLivArea']].values

# Три варіанти: оригінал, MinMax, Standard
scaler_minmax = MinMaxScaler()
scaler_standard = StandardScaler()

data_minmax = scaler_minmax.fit_transform(feature)
data_standard = scaler_standard.fit_transform(feature)

# Побудувати графіки
fig, axes = plt.subplots(1, 3, figsize=(15, 4))

# Оригінальні дані
axes[0].hist(feature, bins=30, color='skyblue', edgecolor='black', alpha=0.7)
axes[0].set_title('Оригінальні дані\n(GrLivArea)', fontweight='bold')
axes[0].set_xlabel('Площа (кв.фт)')
axes[0].set_ylabel('Частота')
axes[0].axvline(feature.mean(), color='red', linestyle='--', linewidth=2, label=f'Середнє: {feature.mean():.0f}')
axes[0].legend()
axes[0].grid(alpha=0.3)

# MinMaxScaler
axes[1].hist(data_minmax, bins=30, color='lightgreen', edgecolor='black', alpha=0.7)
axes[1].set_title('MinMaxScaler\n[0, 1]', fontweight='bold')
axes[1].set_xlabel('Масштабована площа')
axes[1].set_ylabel('Частота')
axes[1].axvline(data_minmax.mean(), color='red', linestyle='--', linewidth=2, label=f'Середнє: {data_minmax.mean():.2f}')
axes[1].legend()
axes[1].grid(alpha=0.3)

# StandardScaler
axes[2].hist(data_standard, bins=30, color='lightcoral', edgecolor='black', alpha=0.7)
axes[2].set_title('StandardScaler\n(μ=0, σ=1)', fontweight='bold')
axes[2].set_xlabel('Стандартизована площа')
axes[2].set_ylabel('Частота')
axes[2].axvline(0, color='red', linestyle='--', linewidth=2, label=f'Середнє: {data_standard.mean():.2e}')
axes[2].legend()
axes[2].grid(alpha=0.3)

plt.tight_layout()
plt.show()

print("Статистика:")
print(f"Оригінал:   min={feature.min():.0f}, max={feature.max():.0f}, mean={feature.mean():.0f}, std={feature.std():.0f}")
print(f"MinMax:     min={data_minmax.min():.2f}, max={data_minmax.max():.2f}, mean={data_minmax.mean():.2f}, std={data_minmax.std():.2f}")
print(f"Standard:   min={data_standard.min():.2f}, max={data_standard.max():.2f}, mean={data_standard.mean():.2e}, std={data_standard.std():.2f}")
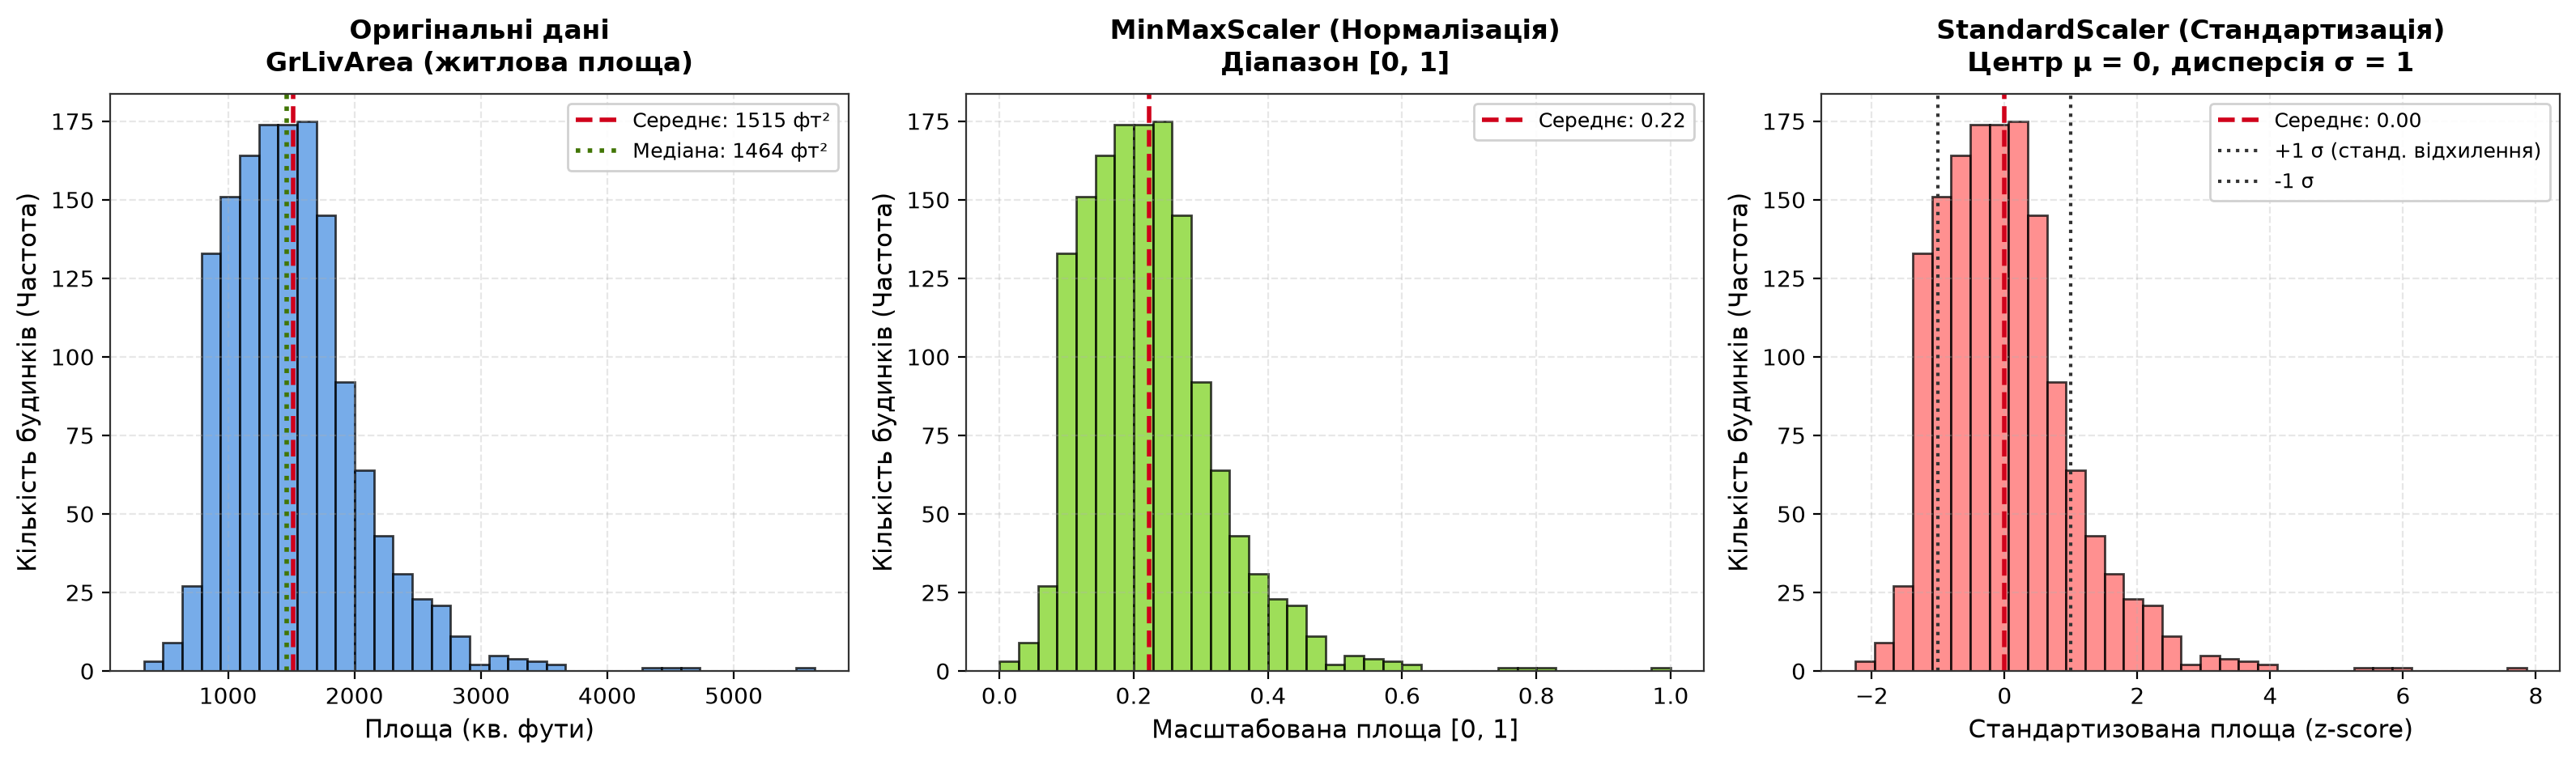
| Метод масштабування | Формула | Мінімум (min) | Максимум (max) | Середнє (mean) | Std (станд. відхилення) |
|---|---|---|---|---|---|
Оригінальні дані (GrLivArea) | $x$ | 334 фт² | 5642 фт² | 1515 фт² | 526 фт² |
| MinMaxScaler (нормалізація) | $\frac{x - x_{\min}}{x_{\max} - x_{\min}}$ | 0.00 | 1.00 | 0.22 | 0.10 |
| StandardScaler (стандартизація) | $\frac{x - \mu}{\sigma}$ | -2.25 | 7.86 | 0.00 | 1.00 |
- Форма гістограми залишається однаковою — масштабування не змінює розподіл, лише масштаб осі X
- MinMaxScaler: всі значення в 0, 1, щільність біля 0 (більшість будинків мають малу площу)
- StandardScaler: центр у 0, std = 1, є від'ємні значення (це нормально!)
Порівняльна таблиця: MinMax vs Standard
| Аспект | MinMaxScaler | StandardScaler |
|---|---|---|
| Формула | Завантаження... | Завантаження... |
| Діапазон | 0, 1 | Немає фіксованого (зазвичай -3 до +3) |
| Середнє після | Залежить від даних | 0 |
| Std після | Залежить від даних | 1 |
| Чутливість до викидів | ⚠️ Висока | ✅ Низька |
| Розподіл | Зберігається форма | Наближається до N(0,1) |
| Коли використовувати | Дані без викидів, потрібен 0,1 | Дані з викидами, нормальний розподіл |
| Алгоритми | KNN, нейромережі (sigmoid/tanh) | Лінійна регресія, SVM, логістична регресія |
- Не знаєте, що обрати
- Можливі викиди у даних
- Використовуєте лінійну регресію, SVM, логістичну регресію
- Точно немає викидів (або вони вже видалені)
- Потрібен конкретний діапазон 0, 1
- Використовуєте KNN або нейромережі з сигмоїдою
- Алгоритм стійкий до масштабу (дерева рішень, Random Forest, XGBoost)
⚠️ КРИТИЧНО: Масштабувати тільки після розбиття на train/test!
Одна з найпоширеніших помилок початківців у машинному навчанні — витік інформації (data leakage) при масштабуванні даних.
# ❌ НЕПРАВИЛЬНО — витік інформації!
scaler = StandardScaler()
X_scaled = scaler.fit(X)  # Навчилися на ВСІХ даних (включно з test)

X_train, X_test, y_train, y_test = train_test_split(X_scaled, y, test_size=0.2)
# Модель навчається на train, тестується на test
# Але параметри scaler (mean, std) були обчислені з урахуванням test даних!
.fit() та обчислив середнє та std з урахуванням їх. Це означає, що інформація з test "просочилась" у train. У реальному житті ви ніколи не бачите майбутні дані під час навчання моделі.Аналогія: це як підглядати у відповіді під час підготовки до іспиту, а потім здавати цей же іспит. Ваша оцінка буде завищеною, тому що ви вже знали відповіді.
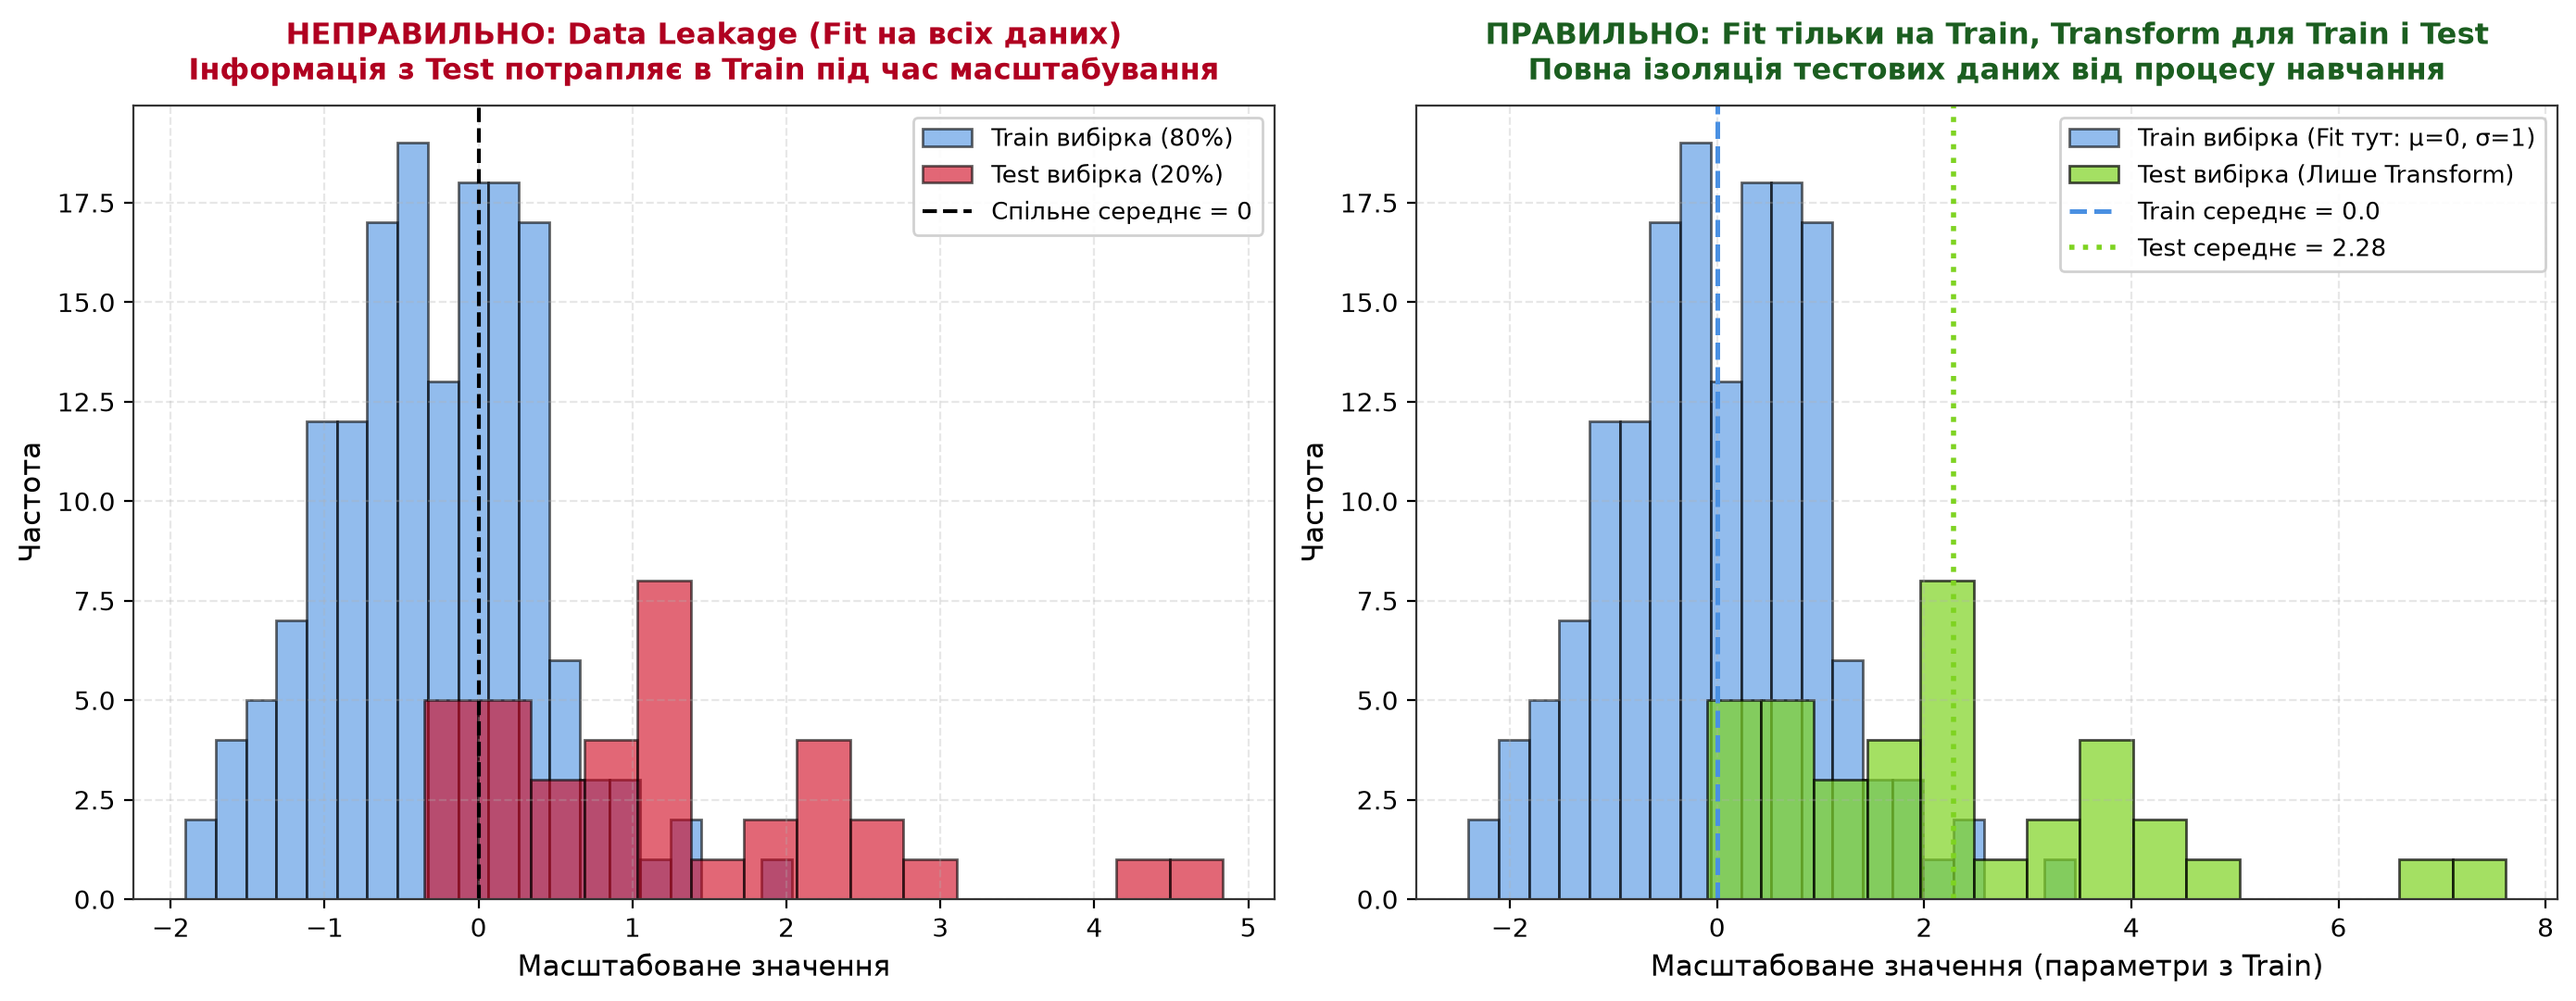
Правильний підхід — .fit() тільки на train
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
import numpy as np

# Створити синтетичні дані за допомогою сучасного Generator API
rng = np.random.default_rng(42)
X = rng.standard_normal((100, 3)) * 10 + 50  # 100 зразків, 3 ознаки
y = rng.standard_normal(100)

print(f"Форма X: {X.shape}")
print(f"Середнє X: {X.mean(axis=0)}")
print(f"Std X: {X.std(axis=0)}")
# Крок 1: Розбити на train та test
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

print(f"Train: {X_train.shape}, Test: {X_test.shape}")
# Крок 2: Створити scaler та FIT тільки на train
scaler = StandardScaler()
scaler.fit(X_train)  # ← FIT лише на train!

print("Параметри scaler (обчислені на train):")
print(f"  Mean: {scaler.mean_}")
print(f"  Std:  {scaler.scale_}")
# Крок 3: TRANSFORM обидва набори (використовуючи параметри з train)
X_train_scaled = scaler.transform(X_train)
X_test_scaled = scaler.transform(X_test)

print("Train після масштабування:")
print(f"  Mean: {X_train_scaled.mean(axis=0)}")
print(f"  Std:  {X_train_scaled.std(axis=0)}")

print("\nTest після масштабування:")
print(f"  Mean: {X_test_scaled.mean(axis=0)}")
print(f"  Std:  {X_test_scaled.std(axis=0)}")
- Train: середнє = 0, std = 1 (ідеально, бо scaler навчився на цих даних)
- Test: середнє ≈ -0.1, std ≈ 0.95 (трохи відрізняється — це нормально!)
- Розділіть дані на train та test
.fit()всі трансформери (Imputer, Scaler, Encoder) тільки на train.transform()застосуйте до обох наборів (train та test)
Побудова Preprocessing Pipeline
Замість того, щоб вручну викликати кожен крок обробки даних (imputation → encoding → scaling), можна об'єднати всі кроки в єдиний Pipeline.
✅ Переваги Pipeline
- Весь preprocessing в одному об'єкті — легко зберігати та використовувати
- Автоматичний порядок — гарантує правильну послідовність кроків
- Уникає помилок — не можна випадково пропустити крок
- Легко застосувати до нових даних — один виклик
.transform()
🔧 Основні компоненти
Pipeline— послідовність кроків для однорідних данихColumnTransformer— різні перетворення для різних стовпців (числові vs категоріальні)make_pipeline— спрощений спосіб створення pipeline
Приклад: Повний preprocessing для Housing
Створимо pipeline, що об'єднує всі три кроки:
- Обробка пропусків (SimpleImputer)
- Кодування категорій (OneHotEncoder)
- Масштабування (StandardScaler)
from sklearn.pipeline import Pipeline
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.model_selection import train_test_split
import pandas as pd

# Завантажити дані
df = pd.read_csv('train.csv')

# Обрати топ-5 числових та топ-3 категоріальних ознак:
# Числові: GrLivArea (житлова площа), TotalBsmtSF (площа підвалу), GarageArea (площа гаража), YearBuilt (рік будівництва), 1stFlrSF (площа 1-го поверху)
# Категоріальні: Neighborhood (район), HouseStyle (стиль будинку), GarageType (тип гаража)
numeric_features = ['GrLivArea', 'TotalBsmtSF', 'GarageArea', 'YearBuilt', '1stFlrSF']
categorical_features = ['Neighborhood', 'HouseStyle', 'GarageType']

# Підготувати X (ознаки) та y (SalePrice — ціна продажу як цільова змінна)
X = df[numeric_features + categorical_features]
y = df['SalePrice']

print(f"X форма: {X.shape}")
print(f"Числові ознаки: {len(numeric_features)}")
print(f"Категоріальні ознаки: {len(categorical_features)}")
print(f"\nПропуски до обробки:")
print(X.isnull().sum())
| Ознака | Пропусків | Тип ознаки | Опис ознаки |
|---|---|---|---|
| GrLivArea | 0 | числова | житлова площа над землею (кв. фути) |
| TotalBsmtSF | 0 | числова | загальна площа підвалу (кв. фути) |
| GarageArea | 0 | числова | площа гаража (кв. фути) |
| YearBuilt | 0 | числова | рік будівництва будинку |
| 1stFlrSF | 0 | числова | площа першого поверху (кв. фути) |
| Neighborhood | 0 | категоріальна | район розташування будинку |
| HouseStyle | 0 | категоріальна | архітектурний стиль споруди |
| GarageType | 81 | категоріальна | тип гаража (потребує імпутації модою) |
# Pipeline для числових ознак: imputer → scaler
numeric_transformer = Pipeline(steps=[
    ('imputer', SimpleImputer(strategy='median')),  # Заповнити пропуски медіаною
    ('scaler', StandardScaler())                    # Стандартизувати
])

# Pipeline для категоріальних ознак: imputer → one-hot
categorical_transformer = Pipeline(steps=[
    ('imputer', SimpleImputer(strategy='most_frequent')),  # Заповнити пропуски модою
    ('onehot', OneHotEncoder(drop='first', sparse_output=False))  # One-Hot кодування
])

print("Числовий transformer:")
print(numeric_transformer)
print("\nКатегоріальний transformer:")
print(categorical_transformer)
# Об'єднати обидва pipeline в один preprocessor
preprocessor = ColumnTransformer(
    transformers=[
        ('num', numeric_transformer, numeric_features),      # числові
        ('cat', categorical_transformer, categorical_features)  # категоріальні
    ])

print("Повний preprocessor:")
print(preprocessor)
# Розбити дані
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

print(f"Train: {X_train.shape}, Test: {X_test.shape}")

# FIT на train
preprocessor.fit(X_train)

# TRANSFORM обидва
X_train_processed = preprocessor.transform(X_train)
X_test_processed = preprocessor.transform(X_test)

print(f"\nПісля preprocessing:")
print(f"  Train: {X_train_processed.shape}")
print(f"  Test:  {X_test_processed.shape}")
print(f"\nПеревірка пропусків у train:")
print(f"  NaN count: {pd.DataFrame(X_train_processed).isnull().sum().sum()}")
Результат: замість 8 стовпців (5 числових + 3 категоріальні) тепер маємо 36 стовпців:
- 5 числових (масштабовані)
- 31 категоріальний (One-Hot кодування з
drop='first': 25 районів - 1 + 7 стилів - 1 + 6 типів гаражів - 1 = 31)
preprocessor
✅ Легко зберегти та завантажити (за допомогою joblib або pickle)
✅ Гарантія правильного порядку операцій
✅ Можна використати у production для нових даних:# Нові дані (наприклад, з production)
new_house = pd.DataFrame({...})
new_house_processed = preprocessor.transform(new_house)
prediction = model.predict(new_house_processed)
Що далі?
У цій статті ми розглянули три ключові проблеми preprocessing:
✅ Пропуски (Missing Values) → SimpleImputer (mean, median, mode, constant)
✅ Категоріальні ознаки → Label Encoding та One-Hot Encoding
✅ Різні масштаби → MinMaxScaler та StandardScaler
✅ Уникнення Data Leakage → fit() тільки на train
✅ Pipeline → об'єднання всіх кроків в один об'єкт
У наступній статті ми нарешті навчимо повноцінну модель лінійної регресії на оброблених даних Housing:
- Побудуємо модель з усіма топ-20 ознаками
- Оцінимо якість на train та test
- Проаналізуємо коефіцієнти моделі — які ознаки найважливіші?
- Виявимо проблему overfitting (перенавчання)
- Навчимося її вирішувати за допомогою регуляризації
Практика
Завдання: Створіть датасет з пропусками (10 рядків, 3 стовпці: 2 числові, 1 категоріальна). Застосуйте SimpleImputer з усіма чотирма стратегіями (mean, median, most_frequent, constant). Порівняйте результати.
Підказка:
import numpy as np
import pandas as pd
from sklearn.impute import SimpleImputer

# Створити дані з пропусками
data = pd.DataFrame({
    'age': [25, 30, np.nan, 35, 40, np.nan, 50, 55, 60, 65],
    'salary': [30000, np.nan, 45000, 50000, np.nan, 60000, 65000, np.nan, 75000, 80000],
    'city': ['Kyiv', 'Lviv', np.nan, 'Odesa', 'Kyiv', 'Lviv', np.nan, 'Kyiv', 'Odesa', 'Lviv']
})

# Застосувати різні стратегії...
Завдання: Створіть датасет з однією категоріальною ознакою "Transport" (6 значень: "Car", "Bus", "Train", "Bike", "Walk", "Plane"). Закодуйте двома способами:
LabelEncoder(factorize)OneHotEncoder
Порівняйте форму результатів. Поясніть, у якій задачі ML кожен метод був би кращим.
Завдання: Для датасету Housing створіть повний preprocessing pipeline:
- Оберіть 10 числових ознак:
GrLivArea(житлова площа),TotalBsmtSF(площа підвалу),GarageArea(площа гаража),YearBuilt(рік будівництва),1stFlrSF(площа 1-го поверху),LotArea(площа ділянки),OverallQual(загальна якість),OverallCond(загальний стан),YearRemodAdd(рік реконструкції),FullBath(повноцінні ванні кімнати) - Оберіть 5 категоріальних ознак:
Neighborhood(район),HouseStyle(стиль будинку),GarageType(тип гаража),Foundation(тип фундаменту),HeatingQC(якість опалення) - Створіть
ColumnTransformerз окремими pipeline для кожного типу - Числові: заповнення медіаною (
SimpleImputer(strategy='median')) + стандартизація (StandardScaler()) - Категоріальні: заповнення модою (
SimpleImputer(strategy='most_frequent')) + бінарне кодування (OneHotEncoder(drop='first', sparse_output=False)) - Розбийте на train/test (80/20) із фіксацією
random_state=42 - Навчіть pipeline (
fit) виключно на train та масштабуйте обидві вибірки (transform) - Перевірте:
- Форму даних до та після обробки
- Відсутність пропусків (NaN count має дорівнювати 0)
- Статистику числових ознак у train (середнє $\approx 0$, std $= 1$)
Підказка:
numeric_features = [
    'GrLivArea', 'TotalBsmtSF', 'GarageArea', 'YearBuilt', '1stFlrSF',
    'LotArea', 'OverallQual', 'OverallCond', 'YearRemodAdd', 'FullBath'
]
categorical_features = [
    'Neighborhood', 'HouseStyle', 'GarageType', 'Foundation', 'HeatingQC'
]

# Створити ColumnTransformer та навчити на X_train...
from sklearn.pipeline import Pipeline
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.model_selection import train_test_split
import pandas as pd
import numpy as np

# 1. Завантажити дані
df = pd.read_csv('train.csv')

# 2. Визначити ознаки з українськими відповідниками
numeric_features = [
    'GrLivArea',    # житлова площа над землею
    'TotalBsmtSF',  # загальна площа підвалу
    'GarageArea',   # площа гаража
    'YearBuilt',    # рік будівництва
    '1stFlrSF',     # площа першого поверху
    'LotArea',      # площа земельної ділянки
    'OverallQual',  # загальна якість матеріалів та оздоблення
    'OverallCond',  # загальний стан будинку
    'YearRemodAdd', # рік реконструкції
    'FullBath'      # повноцінні ванні кімнати
]

categorical_features = [
    'Neighborhood', # район розташування
    'HouseStyle',   # архітектурний стиль будинку
    'GarageType',   # тип розташування гаража
    'Foundation',   # тип фундаменту
    'HeatingQC'     # якість системи опалення
]

X = df[numeric_features + categorical_features]
y = df['SalePrice']  # SalePrice (ціна продажу)

print(f"Форма ДО: {X.shape}")
print(f"Пропуски ДО:\n{X.isnull().sum()[X.isnull().sum() > 0]}\n")

# 3. Створити окремі transformers
numeric_transformer = Pipeline(steps=[
    ('imputer', SimpleImputer(strategy='median')),
    ('scaler', StandardScaler())
])

categorical_transformer = Pipeline(steps=[
    ('imputer', SimpleImputer(strategy='most_frequent')),
    ('onehot', OneHotEncoder(drop='first', sparse_output=False))
])

# 4. Об'єднати у ColumnTransformer
preprocessor = ColumnTransformer(
    transformers=[
        ('num', numeric_transformer, numeric_features),
        ('cat', categorical_transformer, categorical_features)
    ])

# 5. Розбити на train/test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 6. Fit ТІЛЬКИ на train, Transform на train і test
preprocessor.fit(X_train)
X_train_processed = preprocessor.transform(X_train)
X_test_processed = preprocessor.transform(X_test)

print(f"Форма ПІСЛЯ:")
print(f"  Train: {X_train_processed.shape}")
print(f"  Test:  {X_test_processed.shape}")

print(f"\nПропуски ПІСЛЯ:")
print(f"  Train NaN: {pd.DataFrame(X_train_processed).isnull().sum().sum()}")
print(f"  Test NaN:  {pd.DataFrame(X_test_processed).isnull().sum().sum()}")

print(f"\nСтатистика числових ознак у train (10 ознак):")
print(f"  Mean (середнє): {np.round(X_train_processed[:, :10].mean(axis=0), 2)}")
print(f"  Std (відхил):   {np.round(X_train_processed[:, :10].std(axis=0), 2)}")
Резюме
Data Preprocessing
SimpleImputer
mean (середнє), median (медіана), most_frequent (мода), constant (константа).Label Encoding (Factorize)
One-Hot Encoding
MinMaxScaler
StandardScaler
Pipeline
ColumnTransformer
Data Leakage
.fit() на всіх даних → потім split. Правильно: split → .fit() тільки на train → .transform() обидва.`drop='first'`
`sparse_output=False`
OneHotEncoder (sklearn 1.2+). Повертає NumPy масив замість розрідженої матриці (sparse matrix). Зручніше для малих даних..fit() vs .transform()
.fit() — навчитися на даних (обчислити параметри). .transform() — застосувати навчені параметри. .fit_transform() — обидва за один виклик.Exploratory Data Analysis датасету Housing Prices
Розвідувальний аналіз даних реального датасету про ціни на житло. Виявлення пропусків, кореляцій та проблем перед побудовою моделі.
Train/Test Split та перша повноцінна модель
Розбиття даних на навчальну та тестову вибірки. Побудова першої ML-моделі на оброблених даних та оцінка її якості.