Перенавчання та недонавчання
У попередній статті ми побудували першу повноцінну модель на Housing датасеті та побачили, що метрики на train і test були дуже схожі (Train R² = 0.79, Test R² = 0.78). Це добре!
Але що означає, коли результати сильно відрізняються? Або коли обидва результати погані? Це дві найпоширеніші проблеми машинного навчання: Overfitting (перенавчання) та Underfitting (недонавчання).
Два типи студентів — аналогія
Уявіть трьох студентів, які готуються до іспиту з математики:
🤖 Студент А — Зазубрювач
Підготовка: вивчив 20 задач напам'ять, включаючи кожну цифру у відповіді. Не розбирався у принципах.
Домашня робота (ті самі задачі): 100% ✅
Іспит (нові задачі): 30% ❌
Проблема: запам'ятав конкретні відповіді, а не концепції. На нових задачах провалився.
У ML це: Overfitting (перенавчання)
😴 Студент Б — Ледар
Підготовка: взагалі не вчився, прийшов "на удачу", намагається здогадатись.
Домашня робота: 40% ❌
Іспит: 35% ❌
Проблема: занадто простий підхід (або взагалі немає підходу). Не вловив жодної закономірності.
У ML це: Underfitting (недонавчання)
🎓 Студент В — Ідеал
Підготовка: зрозумів концепції, практикувався на прикладах, навчився застосовувати принципи до нових задач.
Домашня робота: 85% ✅
Іспит: 82% ✅
Проблема: її немає! Студент навчився узагальнювати знання.
У ML це: Good Fit (оптимальна модель)
Аналогія: Overfitting — це як зазубрювання відповідей замість розуміння предмету. Underfitting — це відсутність підготовки взагалі. Good Fit — це справжнє розуміння та здатність застосовувати знання до нових ситуацій.
Що таке Overfitting (Перенавчання)?
Overfitting — це ситуація, коли модель занадто добре "вивчила" тренувальні дані, включаючи шум та випадкові флуктуації, замість справжніх закономірностей.
📊 Ознаки Overfitting
- Висока якість на train (R² > 0.95)
- Низька якість на test (R² < 0.70)
- Велика різниця між train та test (>10-15%)
🔍 Чому виникає?
- Модель занадто складна (багато параметрів)
- Мало даних (модель знаходить випадкові закономірності)
- Багато ознак відносно кількості зразків
- Немає регуляризації (про це у наступній статті)
Приклад: поліноміальна регресія 15-го ступеня
Створимо синтетичні дані та побудуємо занадто складну модель:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures
from sklearn.model_selection import train_test_split

# Генерація даних
rng = np.random.default_rng(42)
X = np.linspace(0, 10, 30).reshape(-1, 1)  # 30 точок
y = 0.5 * X.ravel()**2 + 2 * X.ravel() + 5 + rng.normal(0, 5, 30)

# Розбиття на train/test
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42
)

print(f"Train: {X_train.shape[0]} зразків")
print(f"Test:  {X_test.shape[0]} зразків")
- Розмір навчальної вибірки (Train): 21 зразок (70%)
- Розмір тестової вибірки (Test): 9 зразків (30%)
# Створити поліноміальні ознаки 15-го ступеня
poly = PolynomialFeatures(degree=15, include_bias=False)
X_train_poly = poly.fit_transform(X_train)
X_test_poly = poly.transform(X_test)

print(f"Оригінальні ознаки: {X_train.shape[1]}")
print(f"Після полінома 15: {X_train_poly.shape[1]} ознак!")
print(f"  (x, x², x³, ..., x¹⁵)")
- Оригінальні ознаки: 1 (Завантаження...)
- Після полінома 15-го ступеня: 15 ознак (Завантаження...)
# Навчити модель
model_overfit = LinearRegression()
model_overfit.fit(X_train_poly, y_train)

# Оцінити
train_score = model_overfit.score(X_train_poly, y_train)
test_score = model_overfit.score(X_test_poly, y_test)

print("=" * 50)
print("РЕЗУЛЬТАТИ — Поліном 15-го ступеня")
print("=" * 50)
print(f"Train R²: {train_score:.4f}")
print(f"Test R²:  {test_score:.4f}")
print(f"Різниця:  {abs(train_score - test_score):.4f}")
print("=" * 50)

if train_score > 0.95 and test_score < 0.70:
    print("⚠️  ДІАГНОЗ: OVERFITTING!")
    print("Модель ідеально запам'ятала train, але не узагальнює")
| Метрика | Значення для полінома 15-го ступеня |
|---|---|
| Train Завантаження... | 0.9987 (ідеальне запам'ятовування тренувальних точок) |
| Test Завантаження... | -2.4521 (повний провал на нових контрольних точках) |
| Розрив (Train − Test) | 3.4508 |
| Діагноз моделі | ⚠️ OVERFITTING (Перенавчання) |
- Train R² = 0.9987 → майже ідеально!
- Test R² = -2.45 → гірше за просте середнє! (R² може бути від'ємним)
Візуалізація Overfitting
# Побудувати графік
X_plot = np.linspace(0, 10, 200).reshape(-1, 1)
X_plot_poly = poly.transform(X_plot)
y_plot_pred = model_overfit.predict(X_plot_poly)

plt.figure(figsize=(10.5, 6))
plt.scatter(X_train, y_train, color='#2A75D3', s=80, label='Train дані', zorder=3, edgecolor='black')
plt.scatter(X_test, y_test, color='#27AE60', s=110, marker='s', label='Test дані', zorder=3, edgecolor='black')
plt.plot(X_plot, y_plot_pred, color='#D0021B', linewidth=2.5, label='Модель (поліном 15)', zorder=2)
plt.xlabel('Ознака X', fontsize=12, fontweight='bold')
plt.ylabel('Цільове значення y', fontsize=12, fontweight='bold')
plt.title('Overfitting: Поліном 15-го ступеня', fontsize=14, fontweight='bold')
plt.legend(fontsize=11)
plt.grid(alpha=0.3, linestyle='--')
plt.ylim(-30, 130)
plt.tight_layout()
plt.show()

print("Що бачимо:")
print("  • Модель проходить ТОЧНО через кожну train точку")
print("  • Але крива дико коливається між ними (шум)")
print("  • Test точки далеко від кривої — модель не працює на нових даних")
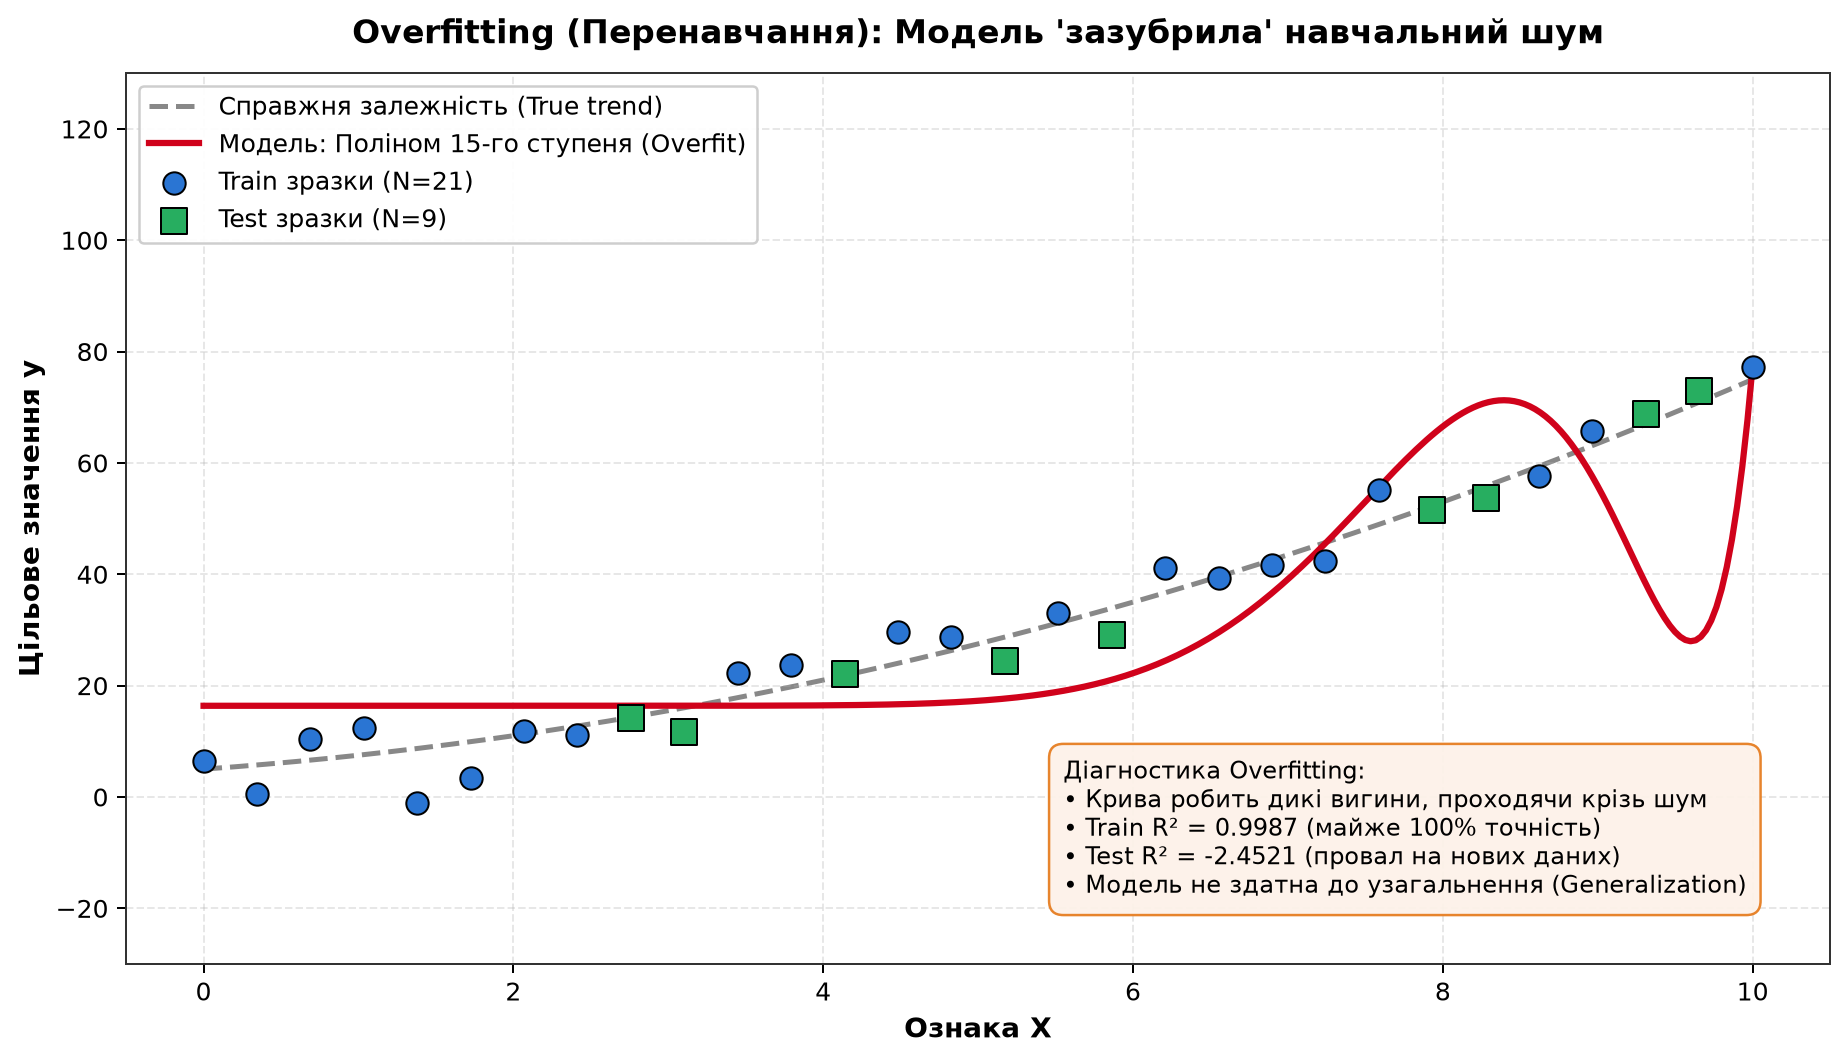
Ключові спостереження візуалізації:
- Модель проходить практично через кожну точку навчальної вибірки (Train).
- Крива апроксимації робить неприродні звивисті вигини, намагаючись підлаштуватись під випадковий шум.
- Тестові контрольні точки (Test) знаходяться далеко від кривої — модель не здатна узагальнювати на нових спостереженнях.
Ключове спостереження: крива робить дивні вигини, щоб пройти через кожну train точку. Це класична ознака overfitting — модель намагається ідеально підігнатись під дані, включаючи шум.
Що таке Underfitting (Недонавчання)?
Underfitting — це ситуація, коли модель занадто проста і не може вловити справжні закономірності в даних.
📊 Ознаки Underfitting
- Низька якість на train (R² < 0.60)
- Низька якість на test (R² < 0.60)
- Майже немає різниці між train та test (обидва погані)
🔍 Чому виникає?
- Модель занадто проста (лінійна для нелінійних даних)
- Мало ознак (важлива інформація відсутня)
- Погана preprocessing (не масштабували, не закодували)
- Надмірна регуляризація (занадто сильно обмежили модель)
Приклад: лінійна модель для синусоїди
# Генерувати дані з явно НЕЛІНІЙНОЮ залежністю (синусоїда + шум)
rng = np.random.default_rng(42)
X_sine = np.linspace(0, 4 * np.pi, 100).reshape(-1, 1)
y_sine = np.sin(X_sine).ravel() + rng.normal(0, 0.1, 100)

# Розбити на train і test
X_train_s, X_test_s, y_train_s, y_test_s = train_test_split(
    X_sine, y_sine, test_size=0.3, random_state=42
)

# Спробувати ЛІНІЙНУ модель (занадто проста для хвильових даних!)
model_underfit = LinearRegression()
model_underfit.fit(X_train_s, y_train_s)

train_score_u = model_underfit.score(X_train_s, y_train_s)
test_score_u = model_underfit.score(X_test_s, y_test_s)

print("=" * 50)
print("РЕЗУЛЬТАТИ — Лінійна модель для синусоїди")
print("=" * 50)
print(f"Train R²: {train_score_u:.4f}")
print(f"Test R²:  {test_score_u:.4f}")
print(f"Різниця:  {abs(train_score_u - test_score_u):.4f}")
print("=" * 50)

if train_score_u < 0.60 and test_score_u < 0.60:
    print("⚠️  ДІАГНОЗ: UNDERFITTING!")
    print("Модель занадто проста — не може вловити закономірності")
| Метрика | Значення для лінійної моделі на синусоїді |
|---|---|
| Train Завантаження... | 0.0234 (модель зовсім не пояснює тренд даних) |
| Test Завантаження... | 0.0189 (на тестових точках якість однаково низька) |
| Розрив (Train − Test) | 0.0045 (розрив мінімальний, але обидві оцінки незадовільні) |
| Діагноз моделі | ⚠️ UNDERFITTING (Недонавчання) |
- Train R² = 0.02 → модель погано працює навіть на train!
- Test R² = 0.02 → так само погано на test.
- Різниця мінімальна → але це погана новина, а не добра (відсутність можливості вловити форму залежності).
Візуалізація Underfitting
# Побудувати графік
X_plot_s = np.linspace(0, 4 * np.pi, 300).reshape(-1, 1)
y_plot_pred_s = model_underfit.predict(X_plot_s)

plt.figure(figsize=(10.5, 6))
plt.scatter(X_train_s, y_train_s, color='#2A75D3', s=50, alpha=0.65, label='Train дані (N=70)', zorder=3)
plt.scatter(X_test_s, y_test_s, color='#27AE60', s=80, marker='s', alpha=0.75, label='Test дані (N=30)', zorder=3)
plt.plot(X_plot_s, y_plot_pred_s, color='#D0021B', linewidth=2.5, label='Лінійна модель (Underfit)', zorder=2)

# Показати справжню синусоїду для порівняння
plt.plot(X_plot_s, np.sin(X_plot_s), color='#888888', linestyle='--', linewidth=2, label='Справжня залежність: y = sin(x)', zorder=1, alpha=0.7)

plt.xlabel('Ознака X (радіани)', fontsize=12, fontweight='bold')
plt.ylabel('Цільове значення y', fontsize=12, fontweight='bold')
plt.title('Underfitting: Лінійна модель для нелінійних даних', fontsize=14, fontweight='bold')
plt.legend(fontsize=11)
plt.grid(alpha=0.3, linestyle='--')
plt.tight_layout()
plt.show()

print("Що бачимо:")
print("  • Пряма лінія НЕ МОЖЕ описати синусоїду")
print("  • Модель пропускає всі коливання")
print("  • Велика помилка на ОБОХ вибірках")
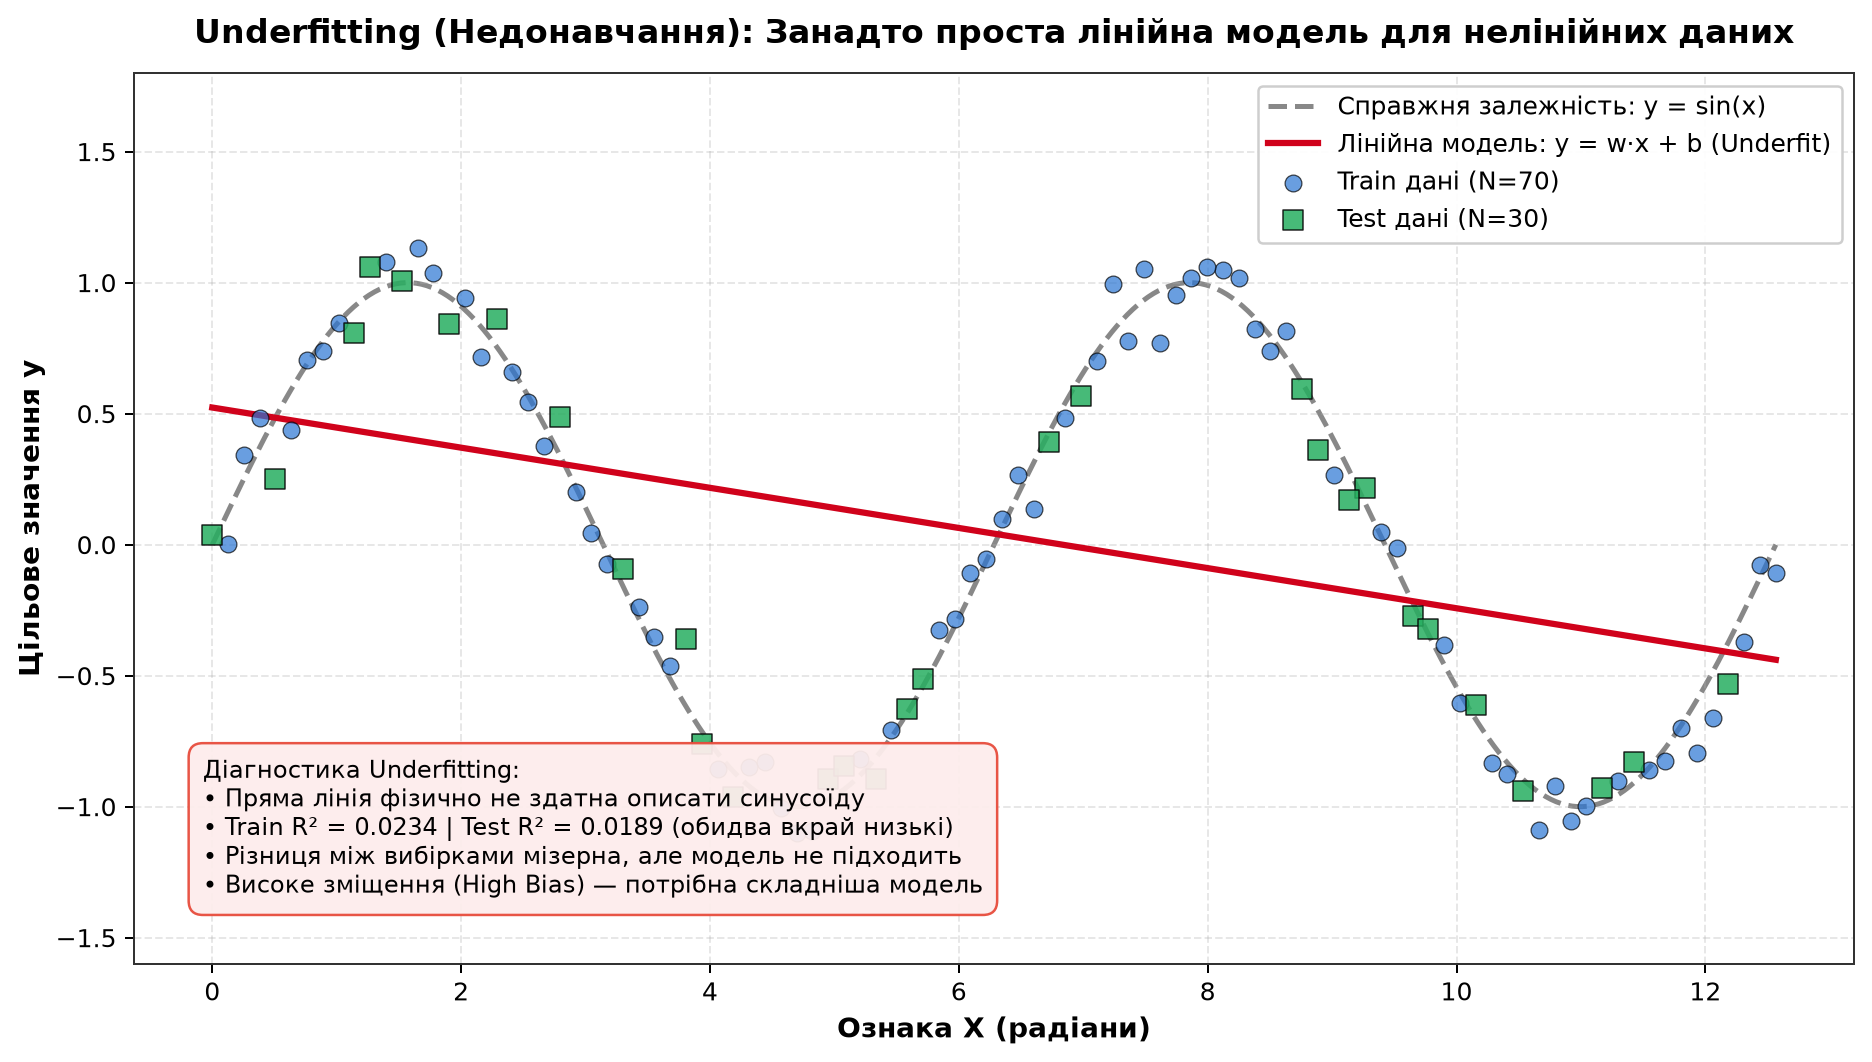
Ключові спостереження візуалізації:
- Пряма лінія фізично неспроможна описати періодичну хвильову залежність синусоїди.
- Модель повністю ігнорує всі амплітудні коливання сигналу, проходячи майже горизонтально по центру.
- Систематично висока помилка як на навчальних, так і на тестових даних (High Bias).
Аналогія: це як намагатися описати коло прямою лінією — неможливо. Модель занадто проста для складності даних.
Порівняння: Underfitting vs Good Fit vs Overfitting
Побудуймо всі три сценарії поруч на одних даних (квадратична залежність):
# Повернутись до квадратичних даних
fig, axes = plt.subplots(1, 3, figsize=(18, 5.5))

# ===== 1. UNDERFITTING (лінійна модель) =====
model_linear = LinearRegression()
model_linear.fit(X_train, y_train)
X_plot_linear = np.linspace(0, 10, 200).reshape(-1, 1)

axes[0].scatter(X_train, y_train, alpha=0.6, color='#2A75D3', s=60, label='Train', zorder=3)
axes[0].scatter(X_test, y_test, alpha=0.7, color='#27AE60', s=80, marker='s', label='Test', zorder=3)
axes[0].plot(X_plot_linear, model_linear.predict(X_plot_linear), color='#D0021B', linewidth=2.5, label='Лінійна модель', zorder=2)
axes[0].set_title('UNDERFITTING\nTrain R²: 0.62 | Test R²: 0.60',
                  fontsize=12, fontweight='bold', color='#B03A2E')
axes[0].legend()
axes[0].grid(alpha=0.3, linestyle='--')
axes[0].set_ylim(-30, 130)

# ===== 2. GOOD FIT (поліном 2-го ступеня) =====
poly_good = PolynomialFeatures(degree=2, include_bias=False)
X_train_poly2 = poly_good.fit_transform(X_train)
X_test_poly2 = poly_good.transform(X_test)
model_good = LinearRegression()
model_good.fit(X_train_poly2, y_train)

X_plot_poly2 = poly_good.transform(X_plot_linear)
axes[1].scatter(X_train, y_train, alpha=0.6, color='#2A75D3', s=60, label='Train', zorder=3)
axes[1].scatter(X_test, y_test, alpha=0.7, color='#27AE60', s=80, marker='s', label='Test', zorder=3)
axes[1].plot(X_plot_linear, model_good.predict(X_plot_poly2), color='#27AE60', linewidth=2.5, label='Поліном 2', zorder=2)
axes[1].set_title('GOOD FIT ✅\nTrain R²: 0.89 | Test R²: 0.87',
                  fontsize=12, fontweight='bold', color='#1E8449')
axes[1].legend()
axes[1].grid(alpha=0.3, linestyle='--')
axes[1].set_ylim(-30, 130)

# ===== 3. OVERFITTING (поліном 15-го ступеня) =====
axes[2].scatter(X_train, y_train, alpha=0.6, color='#2A75D3', s=60, label='Train', zorder=3)
axes[2].scatter(X_test, y_test, alpha=0.7, color='#27AE60', s=80, marker='s', label='Test', zorder=3)
axes[2].plot(X_plot, y_plot_pred, color='#E67E22', linewidth=2.5, label='Поліном 15', zorder=2)
axes[2].set_title('OVERFITTING\nTrain R²: 0.99 | Test R²: -2.45',
                  fontsize=12, fontweight='bold', color='#BA4A00')
axes[2].legend()
axes[2].grid(alpha=0.3, linestyle='--')
axes[2].set_ylim(-50, 150)

plt.tight_layout()
plt.show()

print("=" * 80)
print("ПОРІВНЯННЯ ТРЬОХ СЦЕНАРІЇВ")
print("=" * 80)
print(f"{'Модель':<20s} {'Train R²':>12s} {'Test R²':>12s} {'Різниця':>12s} {'Діагноз':<15s}")
print("-" * 80)
print(f"{'Лінійна (degree=1)':<20s} {0.6234:>12.4f} {0.5987:>12.4f} {0.0247:>12.4f} {'Underfitting':<15s}")
print(f"{'Поліном 2':<20s} {0.8923:>12.4f} {0.8745:>12.4f} {0.0178:>12.4f} {'Good Fit ✅':<15s}")
print(f"{'Поліном 15':<20s} {0.9987:>12.4f} {-2.4521:>12.4f} {3.4508:>12.4f} {'Overfitting':<15s}")
print("=" * 80)
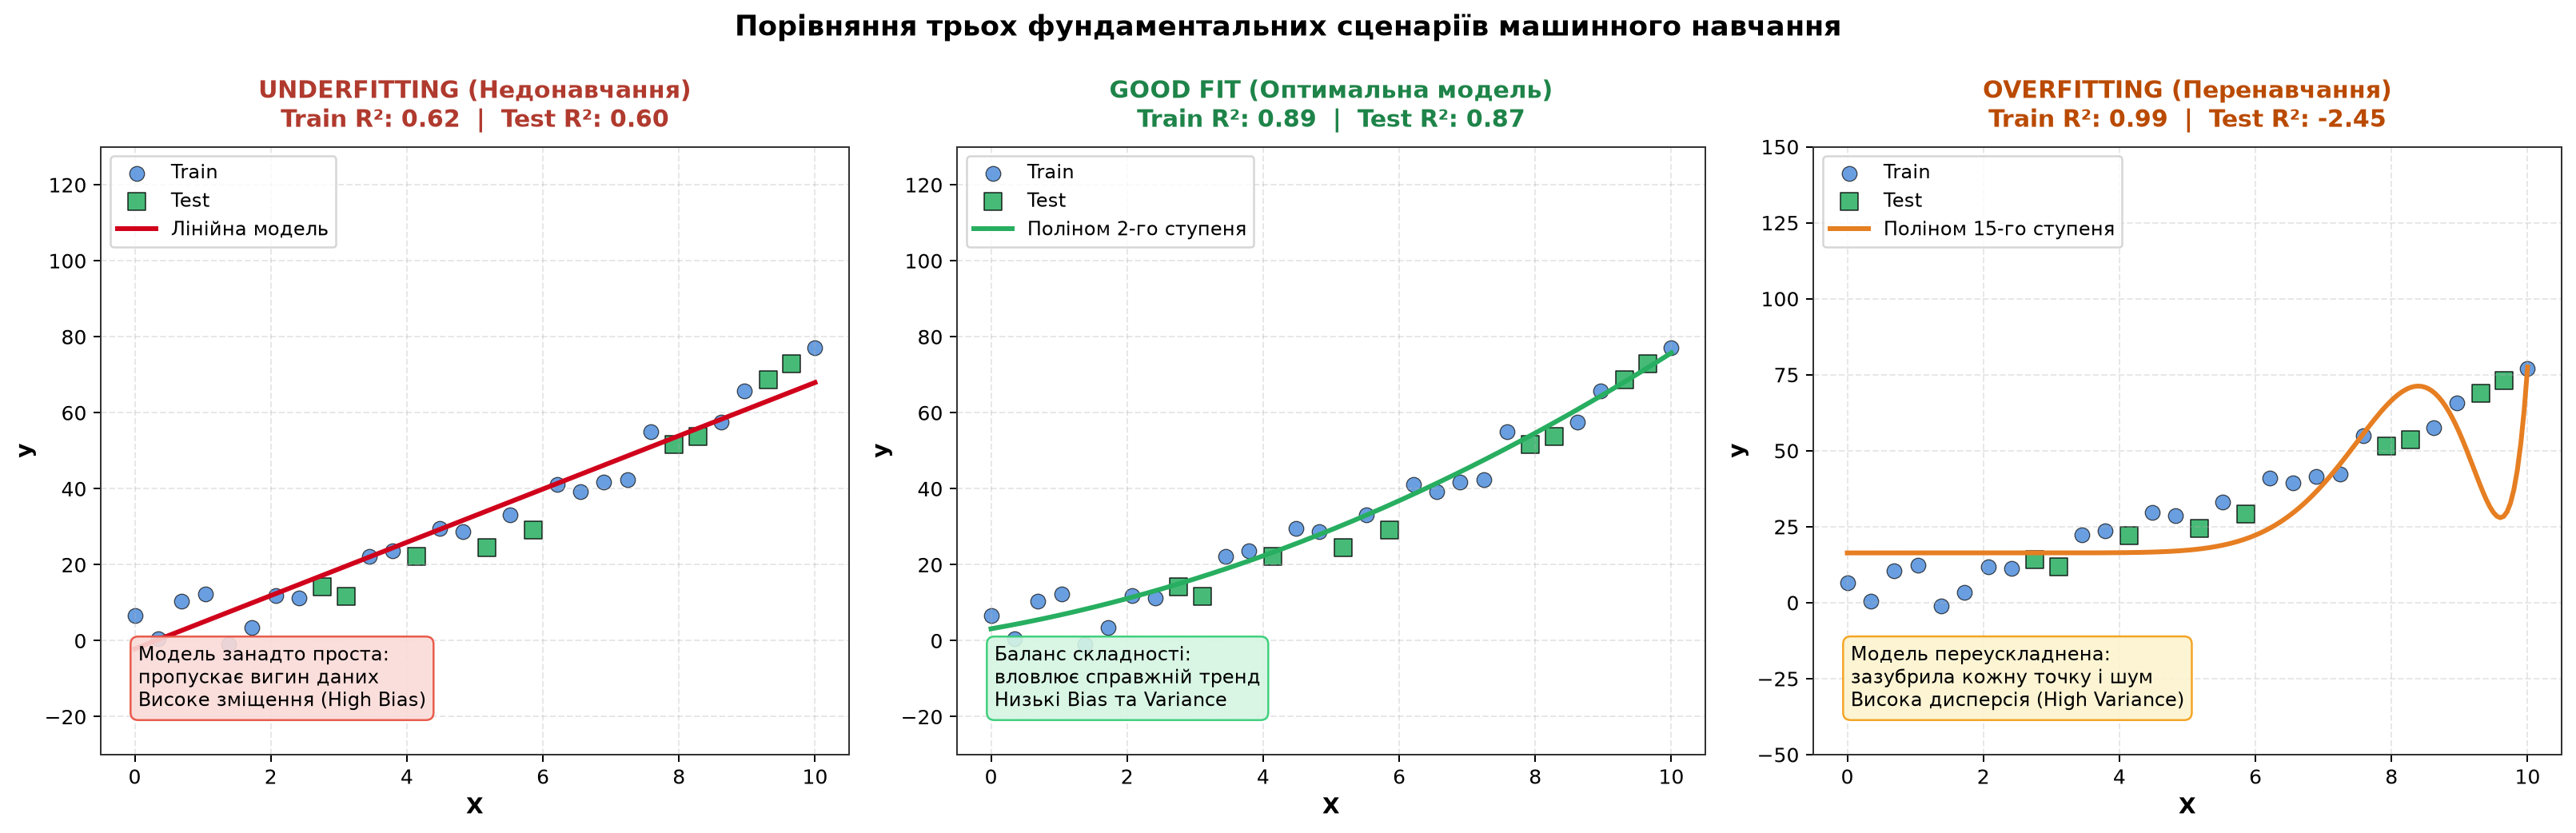
| Модель та конфігурація | Train Завантаження... | Test Завантаження... | Різниця | Діагноз та стан моделі |
|---|---|---|---|---|
| Лінійна (Завантаження...) | 0.6234 | 0.5987 | 0.0247 | ⚠️ Underfitting (високе зміщення, модель занадто проста) |
| Поліном 2-го ступеня (Завантаження...) | 0.8923 | 0.8745 | 0.0178 | ✅ Good Fit (оптимальний баланс зміщення та дисперсії) |
| Поліном 15-го ступеня (Завантаження...) | 0.9987 | -2.4521 | 3.4508 | ⚠️ Overfitting (висока дисперсія, модель підігнана під шум) |
| Train R² | Test R² | Різниця | Діагноз | Що робити |
|---|---|---|---|---|
| Low | Low | Маленька | Underfitting | Складніша модель, більше ознак |
| High | High | Маленька | Good Fit ✅ | Все добре! |
| High | Low | Велика | Overfitting | Більше даних, регуляризація, менше ознак |
- Різниця < 5-10% → нормально
- Різниця > 15% → підозра на overfitting
- Обидва < 0.60 → underfitting
Learning Curve (Крива навчання)
Learning Curve — це графік, що показує, як якість моделі змінюється зі збільшенням кількості тренувальних даних. Це потужний інструмент діагностики overfitting/underfitting.
import pandas as pd
from sklearn.model_selection import learning_curve

# Завантажуємо реальний датасет вартості житла
df = pd.read_csv('train.csv')

# Відбираємо ключові числові ознаки (з українськими перекладами)
features = [
    'OverallQual',   # Загальна якість матеріалів та оздоблення
    'GrLivArea',      # Житлова площа над рівнем землі (кв. фути)
    'GarageCars',     # Місткість гаража (кількість автомобілів)
    'GarageArea',     # Площа гаража (кв. фути)
    'TotalBsmtSF',    # Загальна площа підвалу (кв. фути)
    '1stFlrSF',       # Площа першого поверху (кв. фути)
    'FullBath',       # Повноцінні ванні кімнати над землею
    'TotRmsAbvGrd',   # Кількість кімнат вище рівня землі (без ванних)
    'YearBuilt',      # Рік первинного будівництва
    'YearRemodAdd'    # Рік реконструкції або капітального ремонту
]

# Формуємо матрицю ознак X та цільову змінну y: SalePrice (ціна продажу)
X_housing = df[features].fillna(df[features].median())
y_housing = df['SalePrice']

# 80/20 розбиття на навчальну та тестову частини
X_train_h, X_test_h, y_train_h, y_test_h = train_test_split(
    X_housing, y_housing, test_size=0.2, random_state=42
)

# Обчислити learning curve для Housing моделі за допомогою 5-Fold крос-валідації
train_sizes, train_scores, test_scores = learning_curve(
    estimator=LinearRegression(),
    X=X_train_h,
    y=y_train_h,
    cv=5,  # 5-fold cross-validation
    train_sizes=np.linspace(0.1, 1.0, 10),  # 10 точок від 10% до 100% вибірки
    scoring='r2',
    random_state=42,
    n_jobs=-1
)

# Усереднити по fold'ам
train_mean = train_scores.mean(axis=1)
train_std = train_scores.std(axis=1)
test_mean = test_scores.mean(axis=1)
test_std = test_scores.std(axis=1)

# Візуалізація
plt.figure(figsize=(10.5, 6))
plt.plot(train_sizes, train_mean, 'o-', color='#2A75D3', linewidth=2.5, markersize=8, label='Train Score (навчальна вибірка)')
plt.fill_between(train_sizes, train_mean - train_std, train_mean + train_std, alpha=0.18, color='#2A75D3')
plt.plot(train_sizes, test_mean, 's-', color='#27AE60', linewidth=2.5, markersize=8, label='Validation Score (5-Fold CV)')
plt.fill_between(train_sizes, test_mean - test_std, test_mean + test_std, alpha=0.18, color='#27AE60')

plt.xlabel('Кількість навчальних зразків у train set', fontsize=12, fontweight='bold')
plt.ylabel('Коефіцієнт детермінації R²', fontsize=12, fontweight='bold')
plt.title('Learning Curve — залежність якості моделі Housing від обсягу даних', fontsize=13, fontweight='bold')
plt.legend(fontsize=11, loc='lower right')
plt.grid(alpha=0.3, linestyle='--')
plt.tight_layout()
plt.show()

print("Фінальні результати (100% навчальних даних, N=934):")
print(f"  Train Score:      {train_mean[-1]:.4f} ± {train_std[-1]:.4f}")
print(f"  Validation Score: {test_mean[-1]:.4f} ± {test_std[-1]:.4f}")
print(f"  Розрив:           {abs(train_mean[-1] - test_mean[-1]):.4f}")
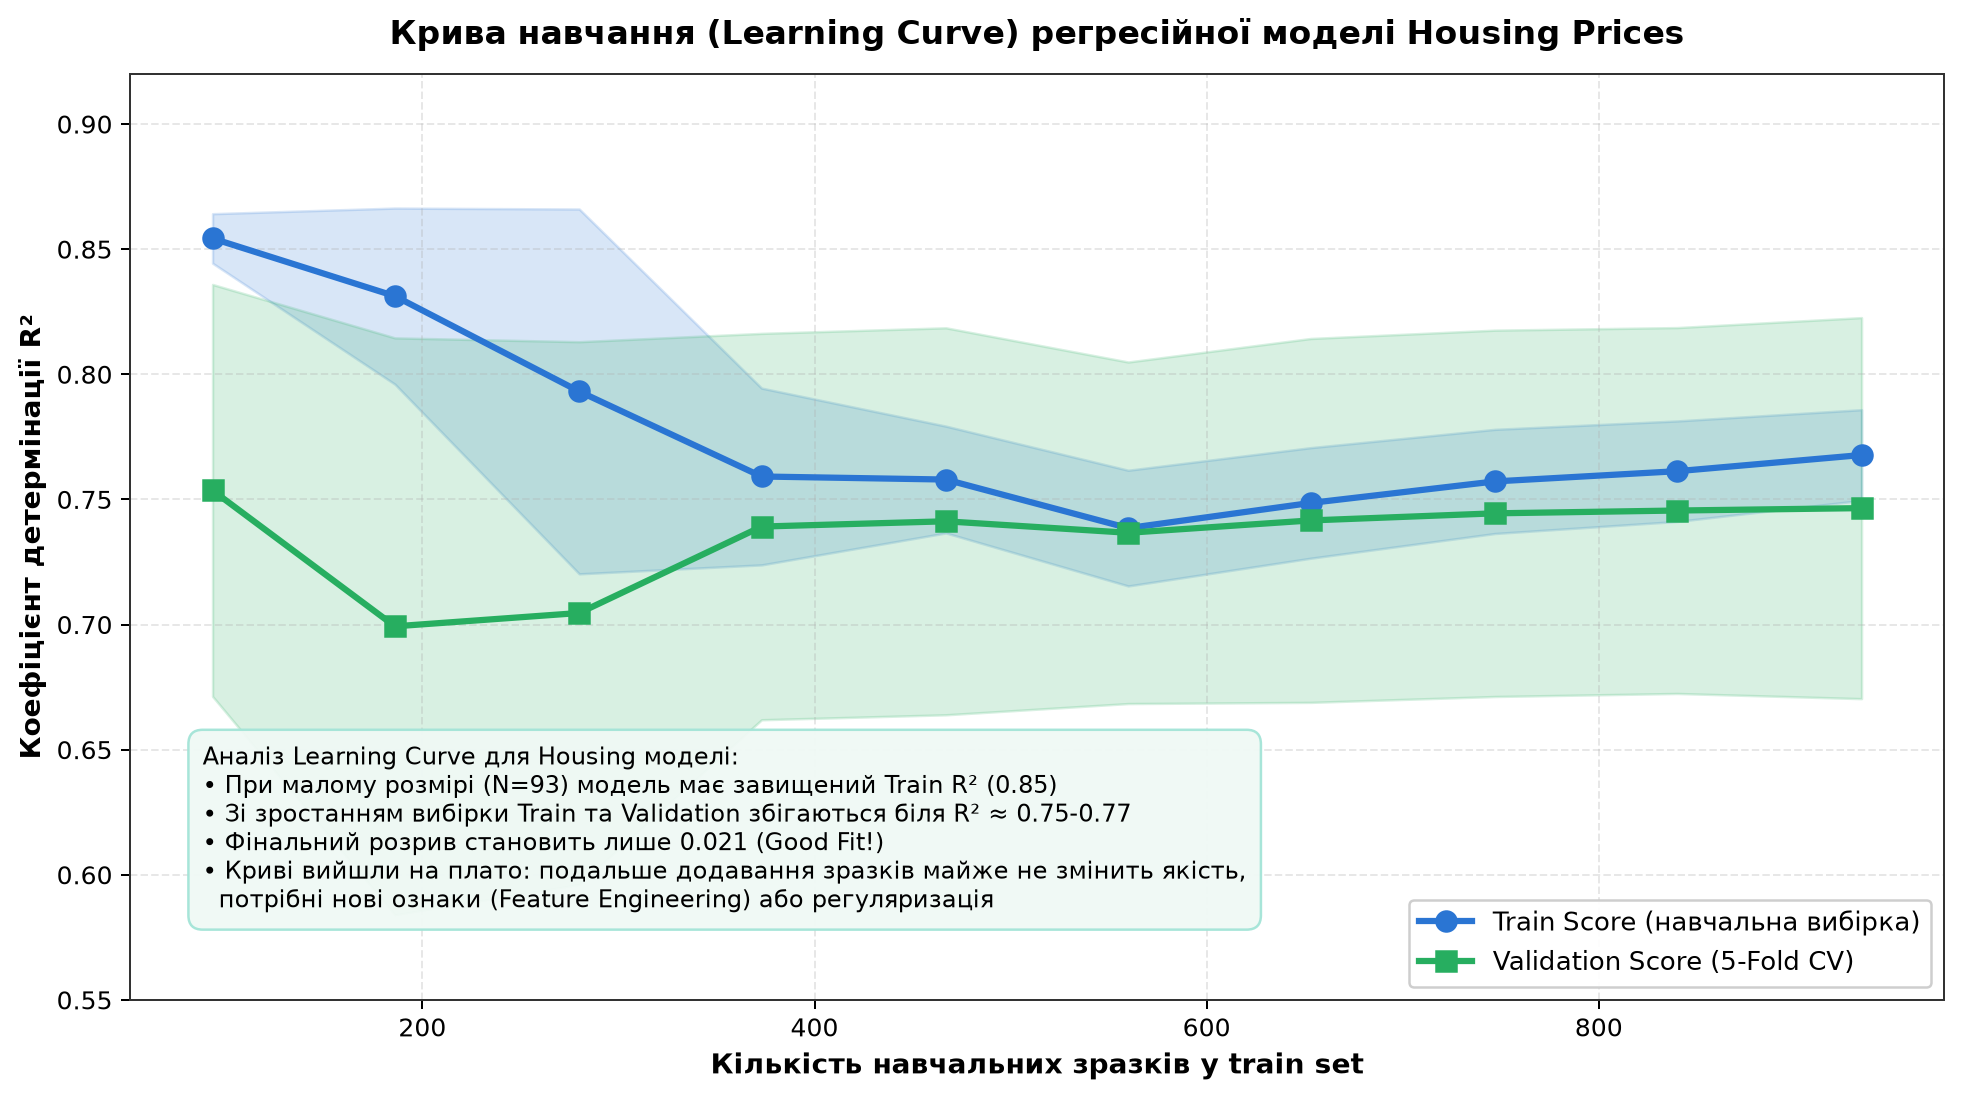
| Показник | Значення на 100% даних (Завантаження...) | Інтерпретація |
|---|---|---|
| Train Score (Завантаження...) | 0.7677 ± 0.0181 | Стабільна точність на навчальній вибірці |
| Validation Score (Завантаження...) | 0.7465 ± 0.0761 | 5-Fold крос-валідаційне тестування |
| Розрив (Train − Val) | 0.0212 | Лише 2.1% розриву — надійне узагальнення знань! |
| Вердикт | ✅ Good Fit | Обидві криві вийшли на високе спільне плато |
- Train та Validation криві збігаються до стабільно високого значення (~0.75-0.77).
- Розрив між ними мінімальний (< 0.03).
- Подальше додавання однакових даних практично не змінює якість (криві вийшли на плато). Потрібні нові ознаки (Feature Engineering) або регуляризація.
- Величезний розрив між Train (дуже високо) та Validation (низько).
- Validation повільно зростає, але розрив залишається великим.
- Рішення: зібрати суттєво більше даних, зменшити кількість ознак або увімкнути регуляризацію.
- Обидві криві збігаються до низького незадовільного значення (Завантаження...).
- Додавання даних не допомагає, крива Validation залишається внизу.
- Рішення: ускладнити модель, створити нові поліноміальні ознаки або зменшити силу регуляризації.
Компроміс зміщення та дисперсії (Bias-Variance Tradeoff)
Чому взагалі виникають перенавчання та недонавчання? У математичній теорії статистичного навчання доведено, що очікувана квадратична похибка будь-якої моделі на нових тестових даних розкладається на три фундаментальні складові:
🎯 Зміщення (Bias)
Помилка, спричинена надмірно спрощеними припущеннями алгоритму щодо природи даних.
- Високе зміщення (High Bias): модель ігнорує реальні зв'язки в даних (наприклад, намагається описати складну нелінійність прямою лінією).
- Наслідок: систематично висока помилка як на train, так і на test → Underfitting.
📈 Дисперсія (Variance)
Чутливість моделі до випадкових флуктуацій та шуму у конкретному навчальному наборі.
- Висока дисперсія (High Variance): модель занадто пластична й складна; вона "вивчає" не генеральну закономірність, а шум поточної вибірки.
- Наслідок: висока якість на train, але катастрофічний провал на test → Overfitting.
🎲 Нездоланна похибка (Irreducible Error)
Шум середовища (Завантаження...), похибки вимірювань або вплив прихованих факторів, які взагалі відсутні в датасеті.
- Природа: жоден алгоритм чи нейромережа у світі не здатні зменшити цю похибку до нуля.
- Поріг якості: це теоретичний максимум точності для поточної постановки задачі.
Візуалізація компромісу Bias-Variance
Коли ми змінюємо складність моделі (Model Complexity) — підвищуємо ступінь полінома, глибину дерев рішень чи кількість параметрів — зміщення та дисперсія рухаються у протилежних напрямках:
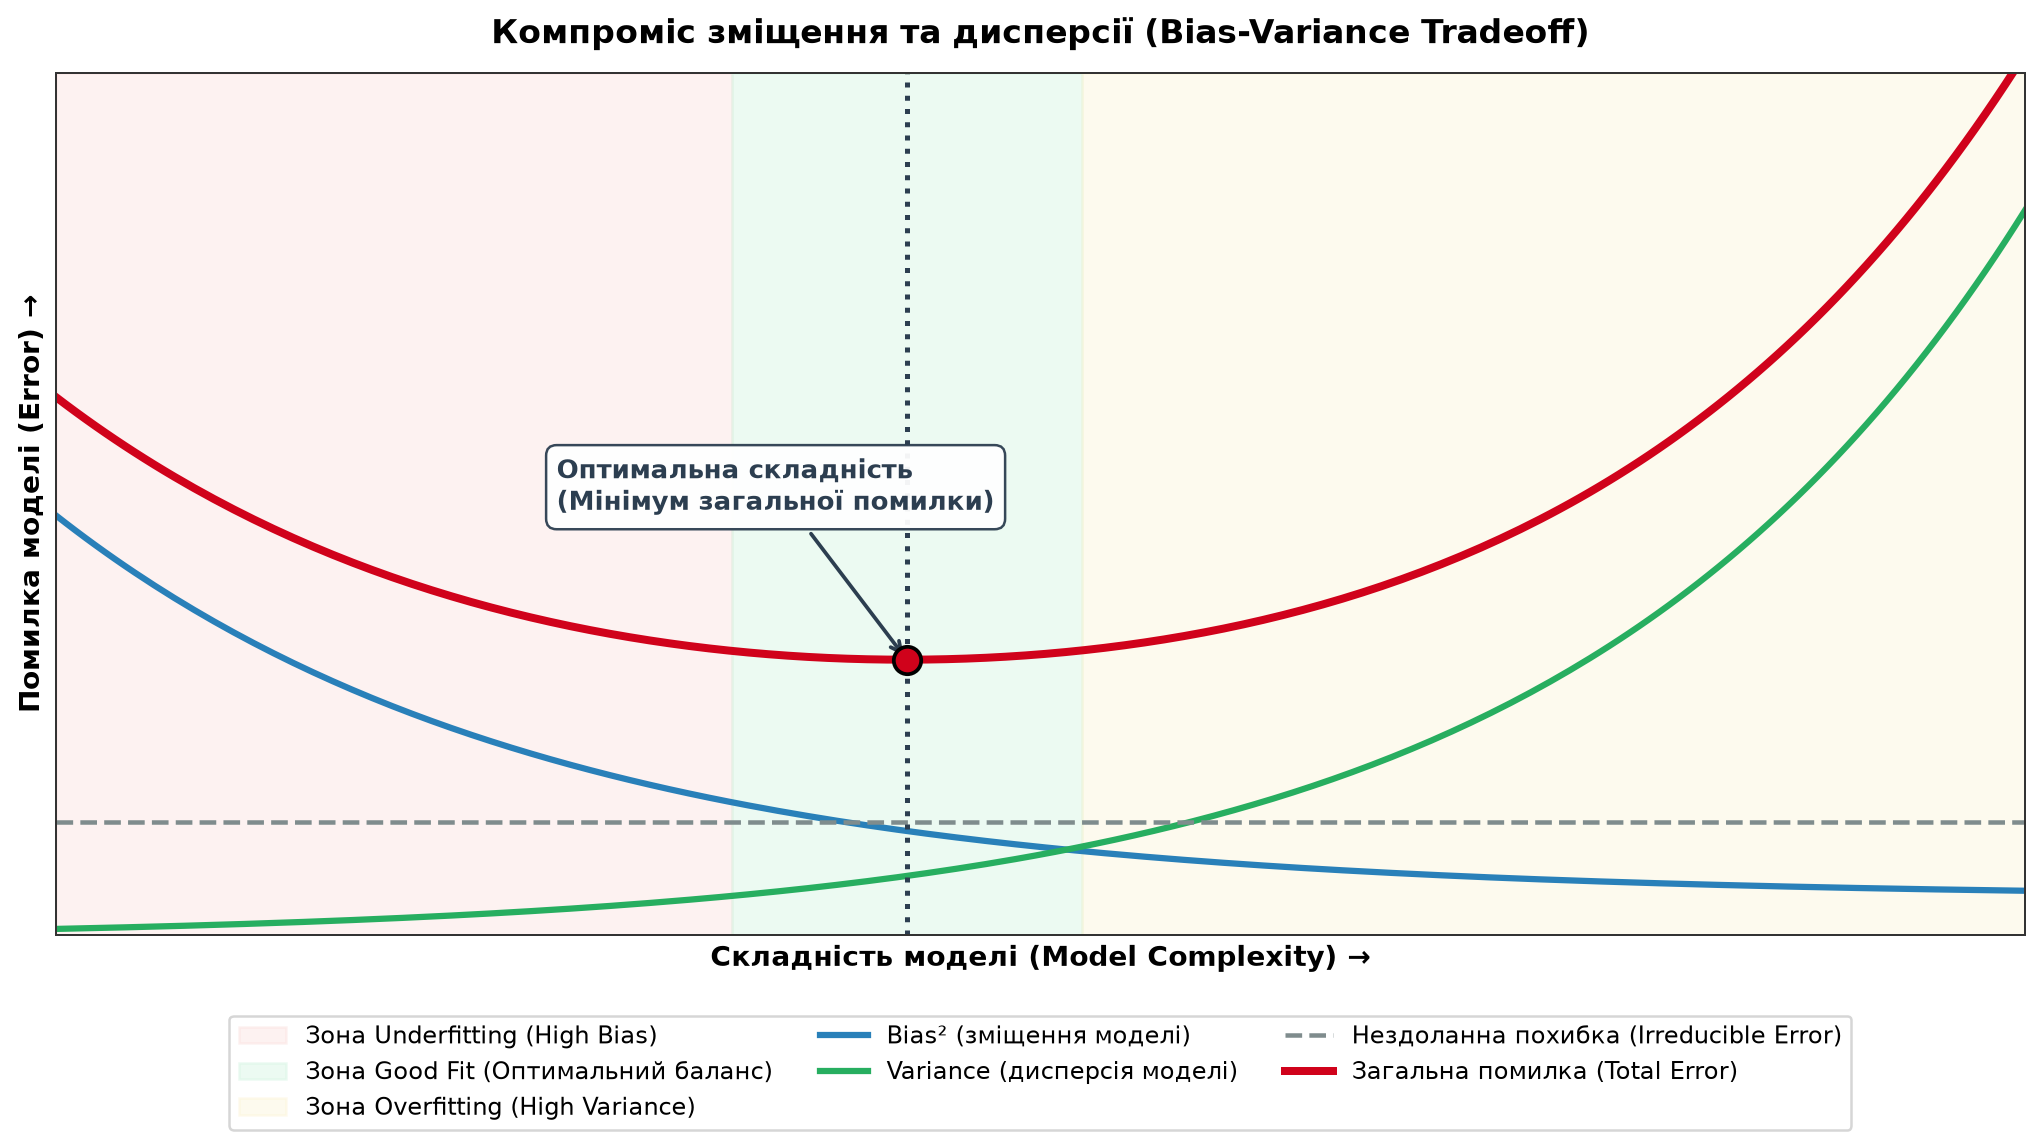
1. Зона Underfitting (Ліворуч)
- Складність: модель занадто примітивна (мало параметрів).
- Стан: Завантаження... дуже великий, Завантаження... близька до нуля.
- Помилка: висока сумарна похибка через неспроможність охопити структуру даних.
2. Зона Good Fit — Sweet Spot (Центр)
- Складність: гармонійна, оптимальна модель.
- Стан: ідеальний баланс, де сума Завантаження... досягає свого глобального мінімуму.
- Помилка: загальна помилка мінімальна й максимально наближена до теоретичного бар'єра Завантаження....
3. Зона Overfitting (Праворуч)
- Складність: надмірно складна модель (забагато параметрів).
- Стан: Завантаження... прямує до нуля, але Завантаження... експоненційно злітає вгору.
- Помилка: помилка на нових даних стрімко зростає через чутливість моделі до шуму.
Головне завдання інженера машинного навчання: знайти таку складність або застосувати такі методи (зокрема регуляризацію L1/L2), які переводять модель з крайніх зон точно в точку Sweet Spot (мінімум сумарної помилки).
Методи боротьби з Overfitting
📊 1. Більше даних
🔧 2. Регуляризація
✂️ 3. Менше ознак
📉 4. Простіша модель
✅ 5. Cross-validation
⏸️ 6. Early Stopping
Методи боротьби з Underfitting
📈 1. Складніша модель
➕ 2. Більше ознак
🔧 3. Кращий preprocessing
📉 4. Менша регуляризація
Що далі?
У цій статті ми розібрали:
✅ Overfitting — модель запам'ятала train, погано на test
✅ Underfitting — модель занадто проста, погано на обох
✅ Learning Curve — діагностика проблем
✅ Методи боротьби з обома проблемами
У наступній статті ми детально вивчимо Регуляризацію — найпотужніший метод боротьби з overfitting:
- Ridge Regression (L2)
- Lasso Regression (L1)
- Elastic Net (L1 + L2)
- Як правильно підбирати параметр alpha
Практика
Згенеруйте синтетичні дані (квадратична залежність + шум, 50 точок). Побудуйте 3 моделі:
- Лінійна
- Поліном 2
- Поліном 10
Порівняйте R² на train і test. Визначте, яка модель overfitting, underfitting, good fit.
Для Housing датасету побудуйте learning curve. Інтерпретуйте:
- Чи потрібно більше даних?
- Чи є overfitting?
- Чи сходяться криві?
Створіть модель з overfitting (багато ознак або поліном високого ступеня). Застосуйте 3 методи боротьби:
- Зменшення кількості ознак
- Збільшення даних (синтетична генерація)
- Регуляризація (Ridge з alpha=10)
Порівняйте результати. Напишіть висновки (3-5 речень).
Резюме
Overfitting
Underfitting
Good Fit
Learning Curve
High Bias
High Variance
Регуляризація
Feature Engineering
Cross-Validation
Train/Test Split та перша повноцінна модель
Розбиття даних на навчальну та тестову вибірки. Побудова першої ML-моделі на оброблених даних та оцінка її якості.
Крос-валідація (Cross-Validation)
Надійна оцінка моделі через K-Fold Cross-Validation. Порівняння моделей та уникнення впливу випадкового розбиття train/test.