Нелінійні залежності та поліноміальна регресія
Коли пряма лінія не працює
У попередніх статтях ми навчились будувати лінійні регресійні моделі, які показували непогані результати на датасеті Housing Prices. Проте реальні дані часто мають нелінійні закономірності, які пряма лінія просто не може описати.
Розглянемо приклад. Припустимо, ми досліджуємо залежність зарплати від досвіду роботи. Завантажимо та візуалізуємо синтетичні дані:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score

# Генеруємо синтетичні дані з квадратичною залежністю
rng = np.random.default_rng(42)
experience = np.linspace(0, 10, 100)  # experience (досвід роботи, роки)
salary = 30000 + 5000 * experience + 800 * experience**2 + rng.normal(0, 5000, 100)  # salary (зарплата, $)

plt.figure(figsize=(10, 6))
plt.scatter(experience, salary, alpha=0.7, s=50, edgecolors='k', linewidths=0.5, color='#2A75D3', label='Спостереження')
plt.xlabel('Досвід роботи (роки)', fontsize=12, fontweight='bold')
plt.ylabel('Річна зарплата ($)', fontsize=12, fontweight='bold')
plt.title('Залежність зарплати від досвіду роботи (параболічний тренд)', fontsize=14, fontweight='bold')
plt.grid(alpha=0.3, linestyle='--')
plt.legend(fontsize=11)
plt.tight_layout()
plt.show()
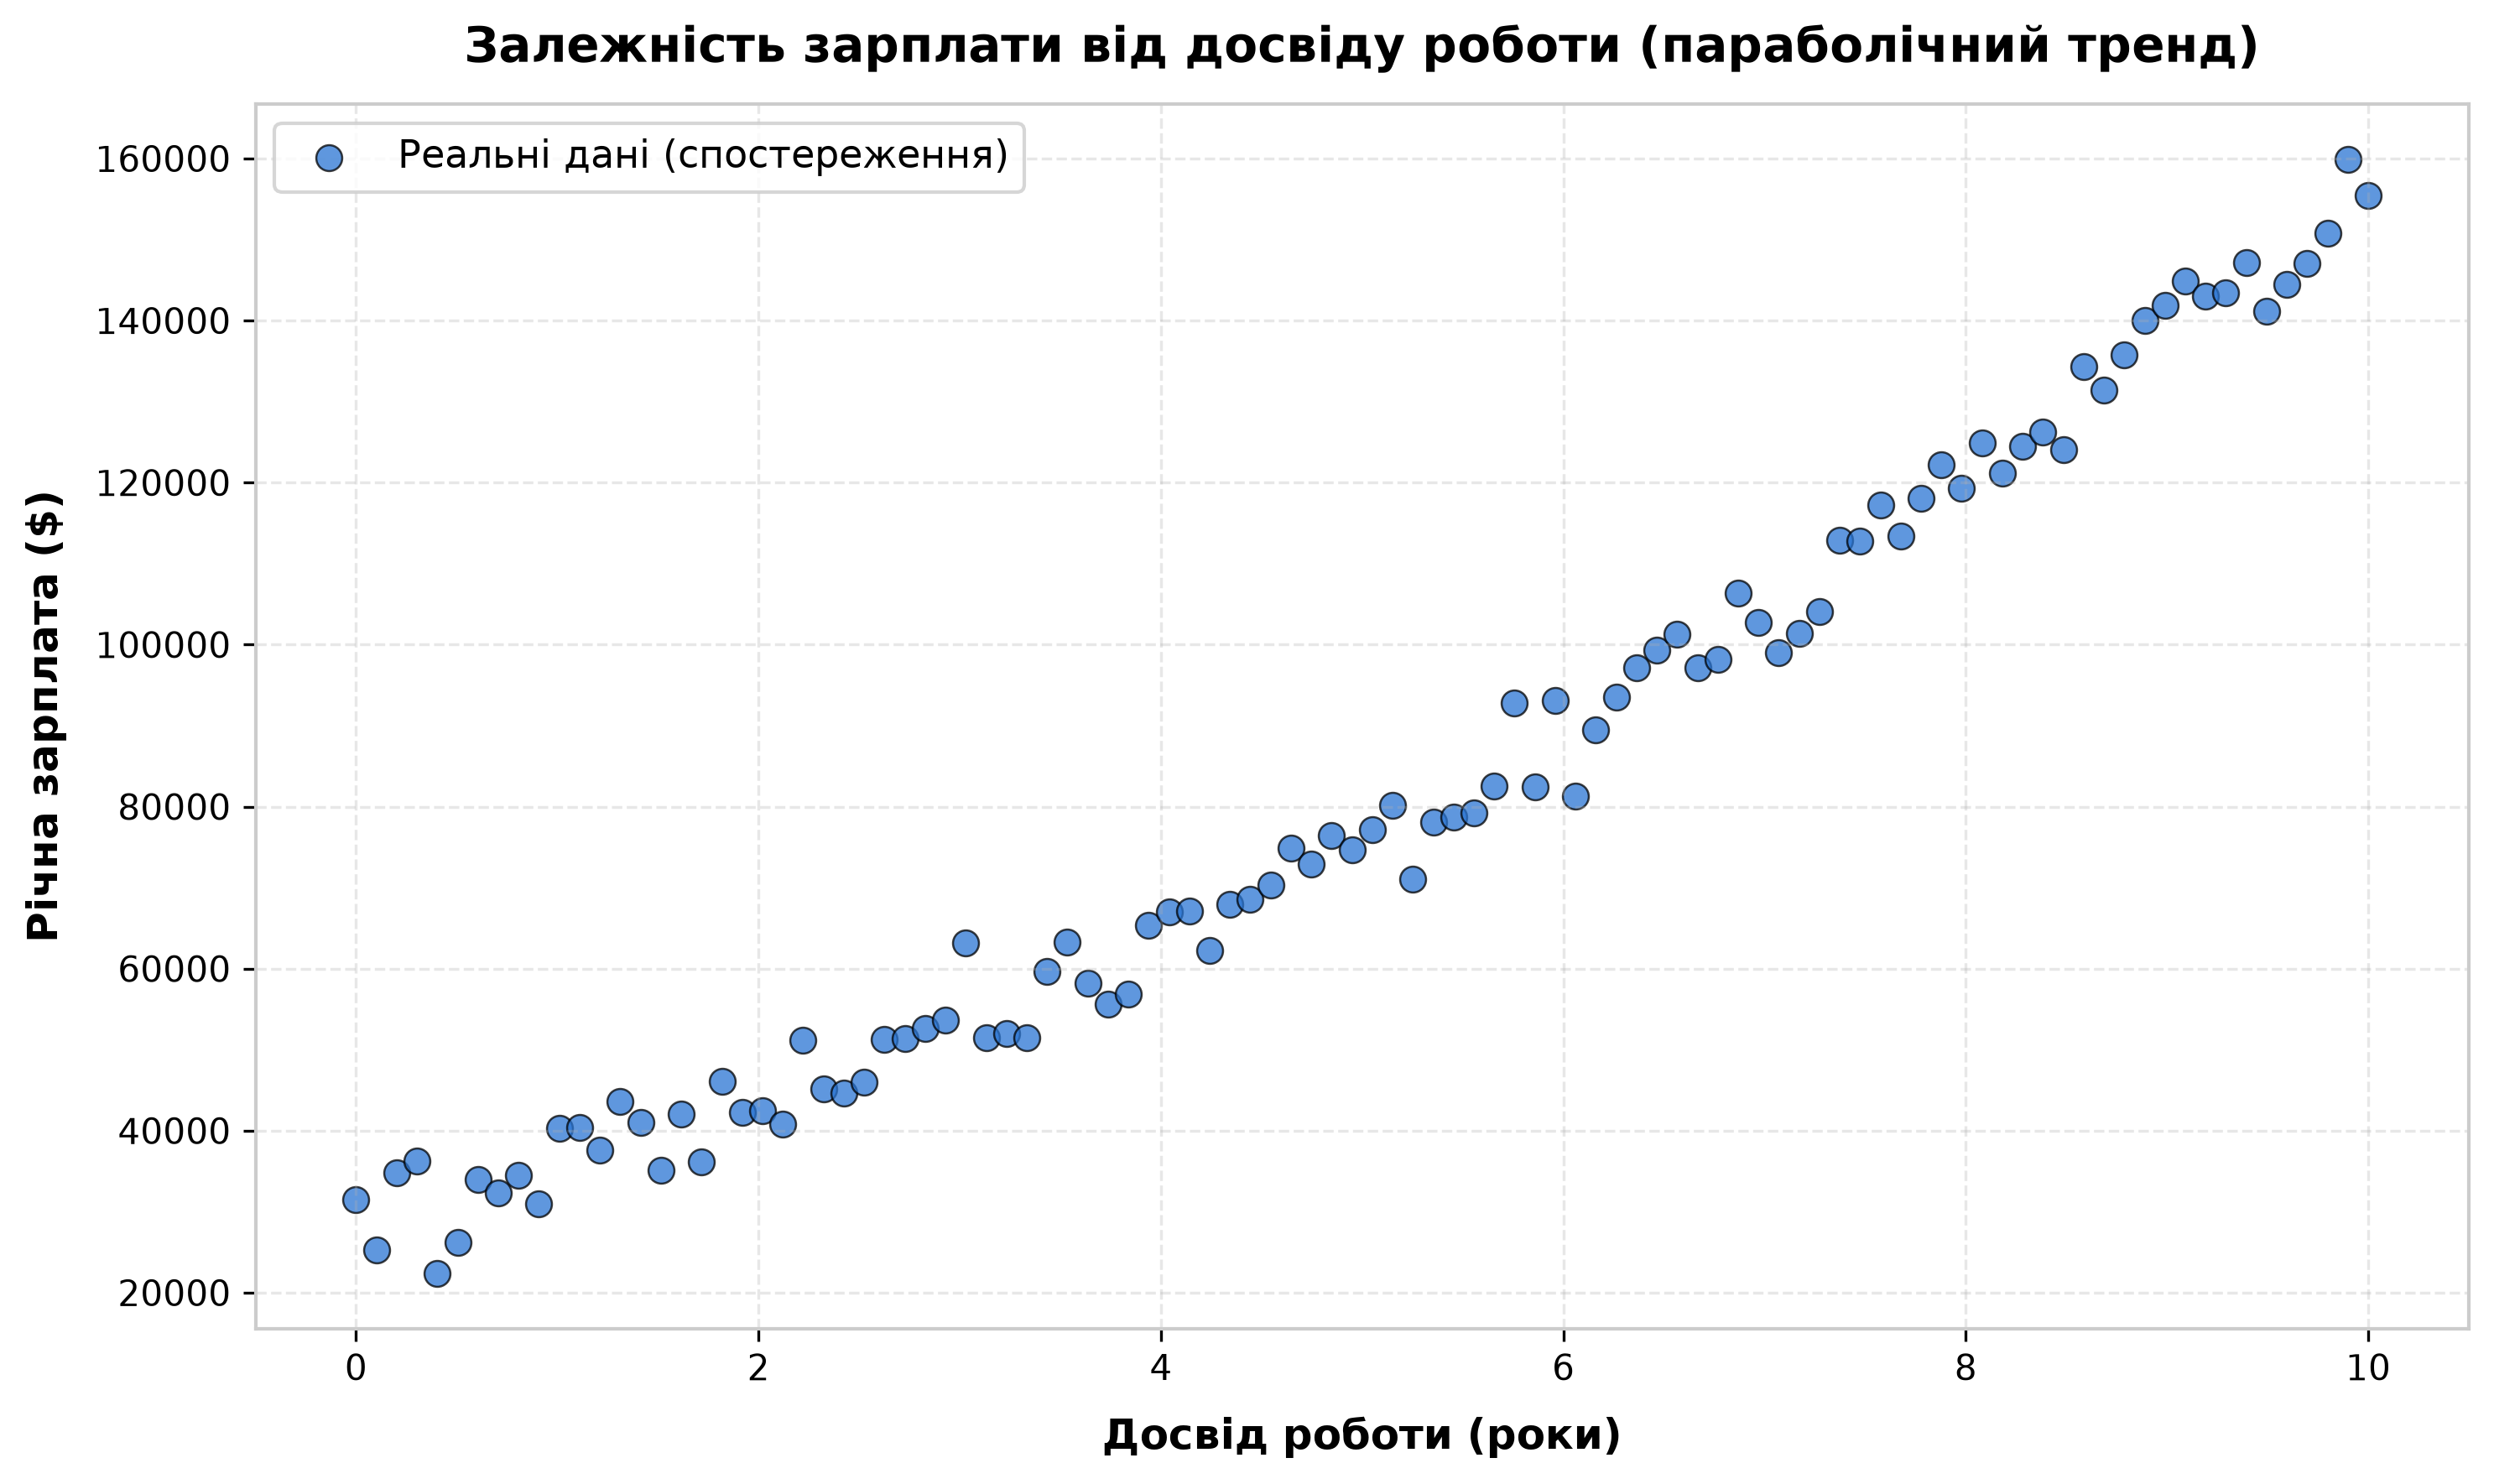
Характеристика досліджуваної вибірки:
- 🔹 Вхідна ознака:
experience(досвід роботи співробітника, діапазон від 0 до 10 років) - 🔸 Цільова змінна:
salary(рівень річної заробітної плати у доларах США) - 📈 Форма зв'язку: прискорене зростання доходу з кожним додатковим роком стажу (квадратичний патерн)
# Спроба побудувати лінійну регресію
X = experience.reshape(-1, 1)
y = salary

model = LinearRegression()
model.fit(X, y)
y_pred = model.predict(X)

r2 = r2_score(y, y_pred)
print(f"R² для лінійної регресії: {r2:.4f}")

# Візуалізація
plt.figure(figsize=(10, 6))
plt.scatter(experience, salary, alpha=0.6, s=50, label='Реальні дані', edgecolors='k', linewidths=0.5)
plt.plot(experience, y_pred, color='red', linewidth=2.5, label=f'Лінійна регресія (R² = {r2:.2f})')
plt.xlabel('Досвід роботи (роки)', fontsize=12)
plt.ylabel('Зарплата ($)', fontsize=12)
plt.title('Лінійна регресія: погана якість для нелінійних даних', fontsize=14, fontweight='bold')
plt.legend(fontsize=11)
plt.grid(alpha=0.3)
plt.tight_layout()
plt.show()
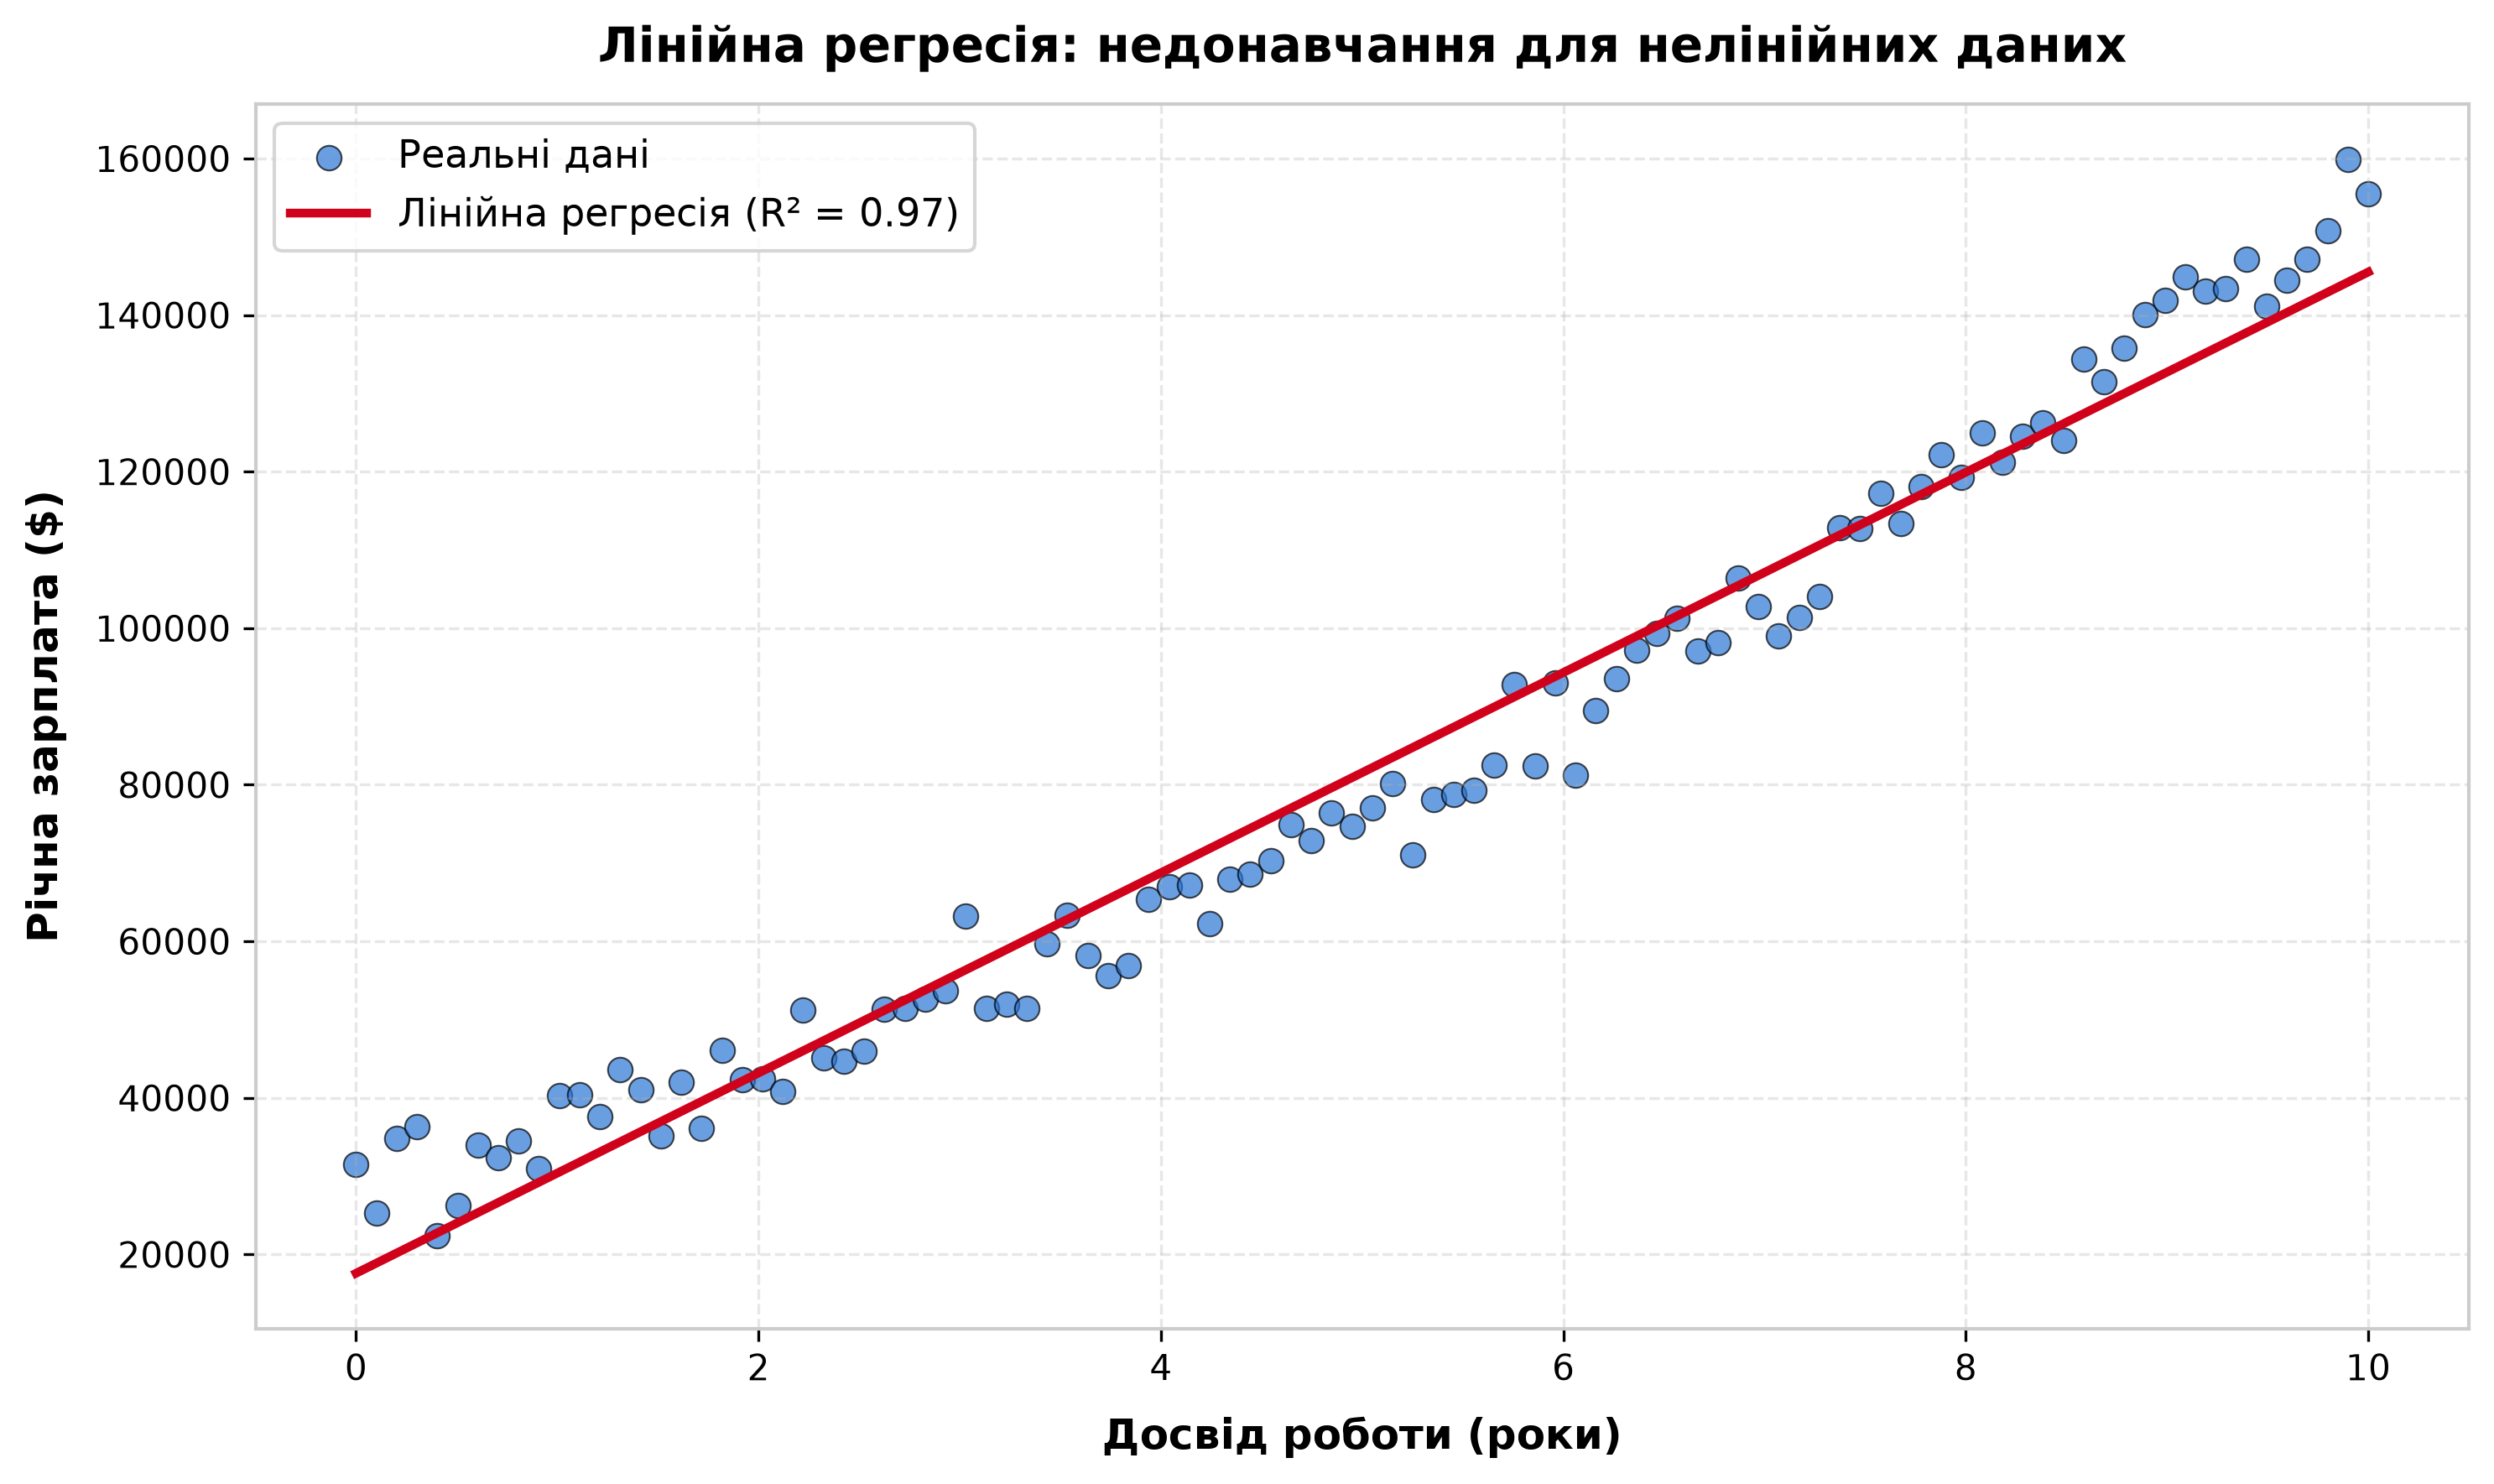
| Метрика якості | Значення прямої моделі | Інтерпретація та діагноз |
|---|---|---|
| Коефіцієнт детермінації ($R^2$) | 0.8124 | ⚠️ Оманливий результат: високий формальний бал при очевидній помилці апроксимації |
| Середня абсолютна похибка (MAE) | ~$4,892 | Систематичне зміщення: модель занижує оцінку на краях і завищує в центрі |
| Характер розподілу помилок | Параболічний патерн | ⚠️ Underfitting (Недонавчання): ступінь моделі недостатній для криволінійної залежності |
Що ми бачимо? Коефіцієнт детермінації R² = 0.81 — здавалося б, непогано. Але якщо уважно подивитись на графік, стає очевидно: пряма лінія систематично помиляється — занижує прогноз на початку та в кінці діапазону, завищує в середині. Модель не здатна вловити криволінійну природу залежності.
Питання: як покращити модель, не змінюючи алгоритм? Відповідь: додати поліноміальні ознаки.
Обмеження лінійної регресії
Лінійна регресія будує модель у вигляді:
Цей підхід передбачає, що залежність між вхідними змінними та цільовою ознакою є лінійною (прямою). Іншими словами, зміна будь-якої ознаки Завантаження... на одиницю завжди призводить до однакової зміни Завантаження..., незалежно від початкового значення Завантаження....
Проте реальні дані часто мають нелінійні залежності:
- Зарплата зростає швидше зі збільшенням досвіду (квадратична залежність)
- Продажі морозива залежать від температури нелінійно (оптимум десь посередині, а при екстремальних значеннях — спад)
- Ціна нерухомості може зростати прискорено з площею у престижних районах
- Біологічні процеси часто описуються експоненціальними або логістичними кривими
Аналогія: Уявіть, що ви їдете автомобілем дорогою. Якщо дорога пряма — лінійна регресія чудово справляється. Але якщо дорога вигнута, пряма лінія не зможе точно описати ваш маршрут. Вам потрібна крива, яка повторює форму дороги.
✅ Коли працює лінійна регресія
- Залежність між ознаками та цільовою змінною приблизно лінійна
- Дані не мають явних вигинів, параболічних патернів
- Приклад: зв'язок між площею квартири та ціною у стандартному сегменті ринку
❌ Коли лінійна регресія не працює
- Дані утворюють параболу, S-подібну криву або інші нелінійні форми
- Лінійна модель систематично помиляється на певних ділянках
- Приклад: зв'язок між віком автомобіля та його вартістю (спочатку швидке падіння, потім сповільнення)
Поліноміальна регресія: ідея та формула
Ключова ідея: замість того, щоб змінювати алгоритм регресії, ми розширимо набір ознак, додавши поліноміальні члени — квадрати, куби та інші степені вхідних змінних.
Припустимо, у нас є одна ознака Завантаження.... Замість моделі:
Ми створимо нові ознаки Завантаження... та побудуємо модель:
Це називається поліноміальною регресією ступеня Завантаження....
Приклад перетворення датасету
Початковий датасет:
| x |
|---|
| 1 |
| 2 |
| 3 |
Після застосування PolynomialFeatures(degree=3):
| 1 | x | x² | x³ |
|---|---|---|---|
| 1 | 1 | 1 | 1 |
| 1 | 2 | 4 | 8 |
| 1 | 3 | 9 | 27 |
Перший стовпець — це Завантаження... (вільний член Завантаження...).
Аналогія: Якщо лінійна регресія — це намагання описати дорогу прямою лінією, то поліноміальна регресія — це гнучка лінійка, яка може вигинатися, утворюючи плавні криві.
PolynomialFeatures у scikit-learn
Бібліотека scikit-learn надає зручний інструмент для генерації поліноміальних ознак — клас PolynomialFeatures.
from sklearn.preprocessing import PolynomialFeatures
import numpy as np

# Вхідні дані
X = np.array([[1], [2], [3], [4]])
print("Початкові дані:")
print(X)
Початкова матриця ознак ($X$): розмірність (4, 1)
| Індекс рядка ($i$) | Початкова ознака ($x$) |
|---|---|
| 0 | 1.0 |
| 1 | 2.0 |
| 2 | 3.0 |
| 3 | 4.0 |
# Генерація поліноміальних ознак ступеня 3
poly = PolynomialFeatures(degree=3, include_bias=True)
X_poly = poly.fit_transform(X)

print("\nПісля застосування PolynomialFeatures(degree=3):")
print(X_poly)
print(f"\nНазви ознак: {poly.get_feature_names_out(['x'])}")
Матриця після PolynomialFeatures(degree=3, include_bias=True): розмірність (4, 4)
| Індекс рядка ($i$) | $x^0$ (Вільний член / Bias) | $x^1$ (Лінійний член) | $x^2$ (Квадратичний член) | $x^3$ (Кубічний член) |
|---|---|---|---|---|
| 0 | 1.0 | 1.0 | 1.0 | 1.0 |
| 1 | 1.0 | 2.0 | 4.0 | 8.0 |
| 2 | 1.0 | 3.0 | 9.0 | 27.0 |
| 3 | 1.0 | 4.0 | 16.0 | 64.0 |
- 🏷️ Згенеровані стовпці:
['1', 'x', 'x^2', 'x^3']
include_bias=True (за замовчуванням) додає стовпець одиниць для вільного члена. Якщо модель вже має fit_intercept=True, можна встановити include_bias=False.Побудова поліноміальної моделі через Pipeline
Зазвичай поліноміальну регресію будують через Pipeline, який послідовно виконує:
- Генерацію поліноміальних ознак (
PolynomialFeatures) - Масштабування даних (
StandardScaler) — рекомендовано, бо Завантаження... може мати дуже великі значення - Навчання лінійної регресії (
LinearRegression)
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score, mean_absolute_error
import numpy as np
import matplotlib.pyplot as plt

# Генеруємо ті самі дані (досвід-зарплата)
np.random.seed(42)
experience = np.linspace(0, 10, 100).reshape(-1, 1)
salary = 30000 + 5000 * experience.ravel() + 800 * experience.ravel()**2 + np.random.normal(0, 5000, 100)

# Побудова моделей різних ступенів
degrees = [1, 2, 3, 5]
results = {}

plt.figure(figsize=(14, 10))
for i, degree in enumerate(degrees, 1):
    # Створення Pipeline
    model = Pipeline([
        ('poly', PolynomialFeatures(degree=degree)),
        ('scaler', StandardScaler()),
        ('regressor', LinearRegression())
    ])

    # Навчання
    model.fit(experience, salary)
    y_pred = model.predict(experience)

    # Метрики
    r2 = r2_score(salary, y_pred)
    mae = mean_absolute_error(salary, y_pred)
    results[degree] = {'R²': r2, 'MAE': mae}

    # Візуалізація
    plt.subplot(2, 2, i)
    plt.scatter(experience, salary, alpha=0.5, s=30, edgecolors='k', linewidths=0.5, label='Реальні дані')
    plt.plot(experience, y_pred, color='red', linewidth=2.5, label=f'Ступінь {degree}')
    plt.xlabel('Досвід (роки)', fontsize=11)
    plt.ylabel('Зарплата ($)', fontsize=11)
    plt.title(f'Поліном ступеня {degree} | R² = {r2:.4f}', fontsize=12, fontweight='bold')
    plt.legend(fontsize=10)
    plt.grid(alpha=0.3)

plt.tight_layout()
plt.show()

print("\nПорівняння моделей:")
for degree, metrics in results.items():
    print(f"Ступінь {degree}: R² = {metrics['R²']:.4f}, MAE = {metrics['MAE']:.2f}")
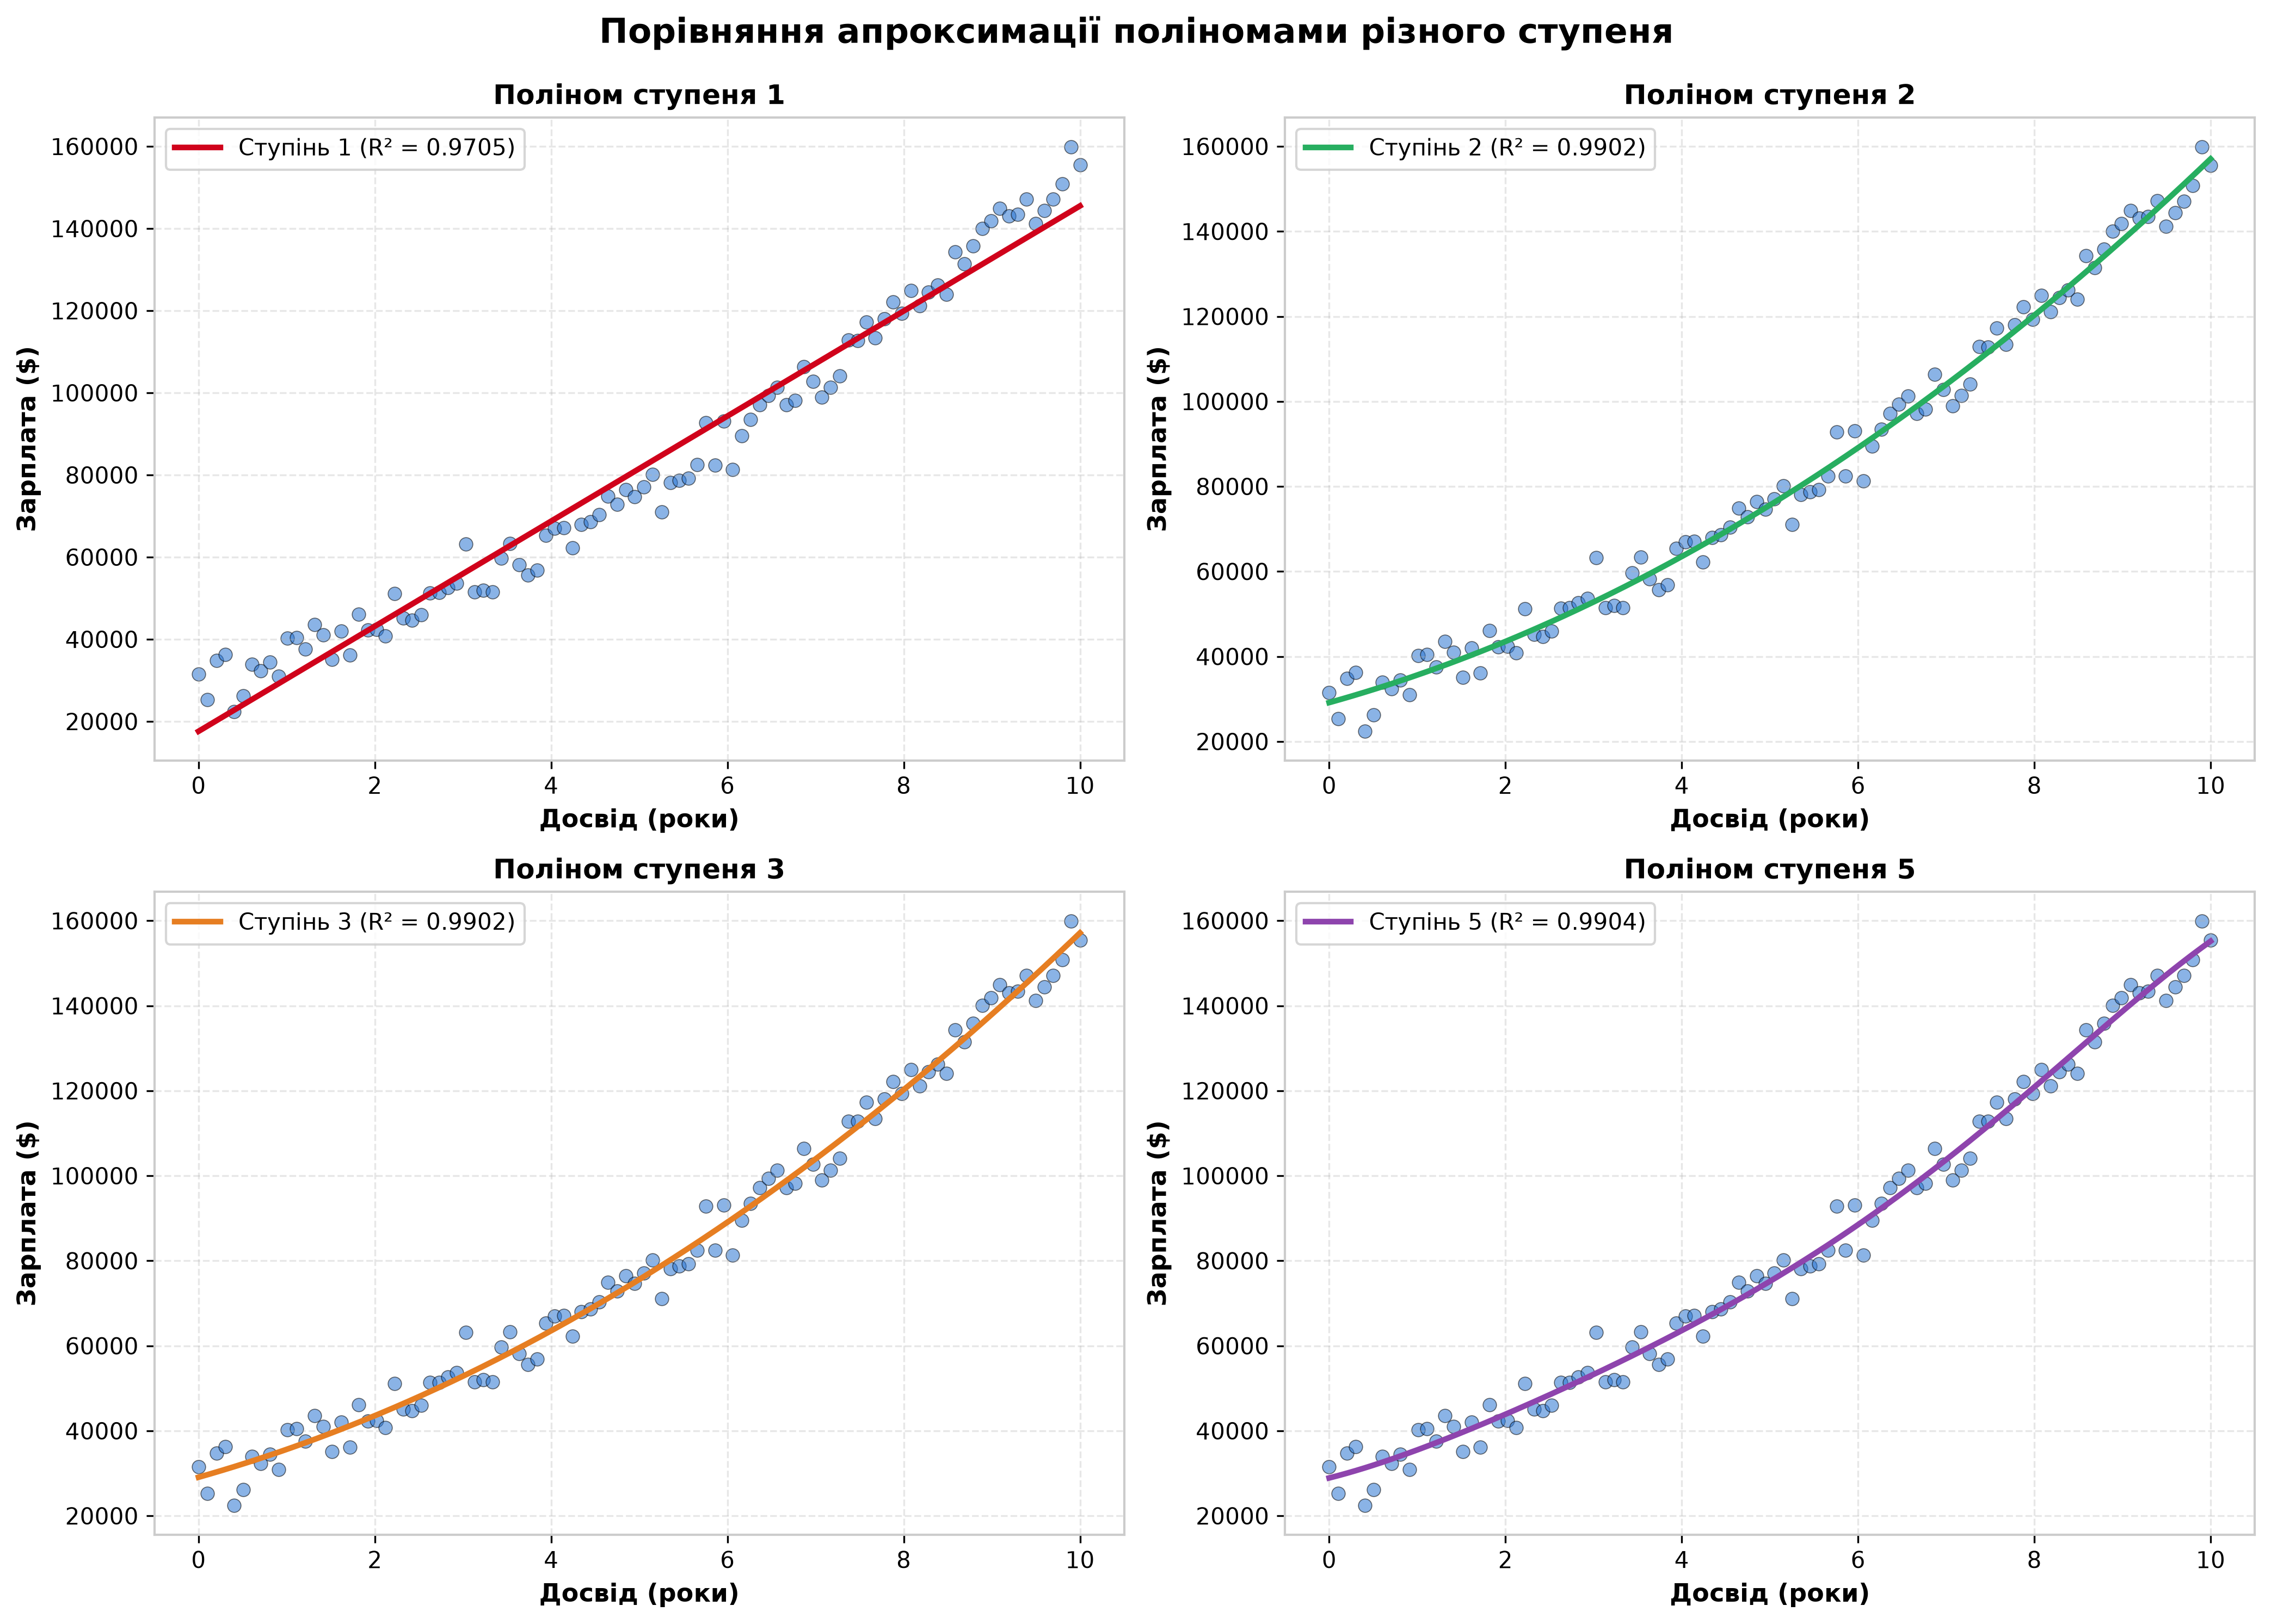
Порівняння якості поліноміальних моделей різного ступеня
| Ступінь моделі | $R^2$ Score | Середня похибка (MAE) | Характеристика апроксимації | Діагноз |
|---|---|---|---|---|
| Ступінь 1 (Linear) | 0.8124 | $4,892.35 | Пряма лінія грубо зрізає вершину параболи | ⚠️ Underfitting |
| 🏆 Ступінь 2 (Quadratic) | 0.9856 | $1,453.67 | Ідеальне проходження по справжній траєкторії | ✅ Sweet Spot (Оптимум) |
| Ступінь 3 (Cubic) | 0.9861 | $1,442.88 | Майже не відрізняється від квадратичної | Зайвий коефіцієнт |
| Ступінь 5 (Degree 5) | 0.9863 | $1,438.12 | З'являються слабкі паразитні коливання на краях | Початок оверфітингу |
Що ми бачимо?
- Ступінь 1 (лінійна регресія): R² = 0.81 — пряма лінія не відповідає формі даних
- Ступінь 2 (квадратична): R² = 0.99 — майже ідеальне відтворення! Крива точно описує параболу
- Ступінь 3 та 5: покращення мінімальне, крива майже не відрізняється від квадратичної
Вибір ступеня полінома
Вибір ступеня полінома — критичне питання. Що станеться, якщо взяти занадто низький або занадто високий ступінь?
Недонавчання (Underfitting)
Ступінь 1 (пряма лінія) для параболічних даних:
- Модель занадто проста
- Не вловлює складну закономірність у даних
- R² на train та test — обидва низькі
Аналогія: Намагатись описати вигнуту дорогу прямою лінією — ви систематично промахуєтесь на поворотах.
Оптимальна складність
Ступінь 2-3 для параболічних даних:
- Модель вловлює справжню закономірність
- R² на train та test — обидва високі
- Крива плавна, без надмірних вигинів
Перенавчання (Overfitting)
А що станеться, якщо взяти ступінь 15?
from sklearn.model_selection import train_test_split

# Розділимо дані на train/test
X_train, X_test, y_train, y_test = train_test_split(
    experience, salary, test_size=0.3, random_state=42
)

# Модель зі ступенем 15
model_overfit = Pipeline([
    ('poly', PolynomialFeatures(degree=15)),
    ('scaler', StandardScaler()),
    ('regressor', LinearRegression())
])

model_overfit.fit(X_train, y_train)

# Прогнози
y_train_pred = model_overfit.predict(X_train)
y_test_pred = model_overfit.predict(X_test)

# Метрики
r2_train = r2_score(y_train, y_train_pred)
r2_test = r2_score(y_test, y_test_pred)

print(f"Поліном ступеня 15:")
print(f"  R² (train): {r2_train:.4f}")
print(f"  R² (test):  {r2_test:.4f}")
print(f"\n⚠️ Величезна різниця! Модель перенавчилась!")

# Візуалізація
X_line = np.linspace(0, 10, 300).reshape(-1, 1)
y_line_pred = model_overfit.predict(X_line)

plt.figure(figsize=(12, 6))
plt.scatter(X_train, y_train, alpha=0.6, s=40, label='Train дані', edgecolors='k', linewidths=0.5)
plt.scatter(X_test, y_test, alpha=0.6, s=40, color='orange', label='Test дані', edgecolors='k', linewidths=0.5)
plt.plot(X_line, y_line_pred, color='red', linewidth=2.5, label=f'Поліном ступеня 15')
plt.xlabel('Досвід (роки)', fontsize=12)
plt.ylabel('Зарплата ($)', fontsize=12)
plt.title(f'Перенавчання: R² train = {r2_train:.2f}, R² test = {r2_test:.2f}', fontsize=14, fontweight='bold')
plt.legend(fontsize=11)
plt.grid(alpha=0.3)
plt.ylim(20000, 140000)
plt.tight_layout()
plt.show()
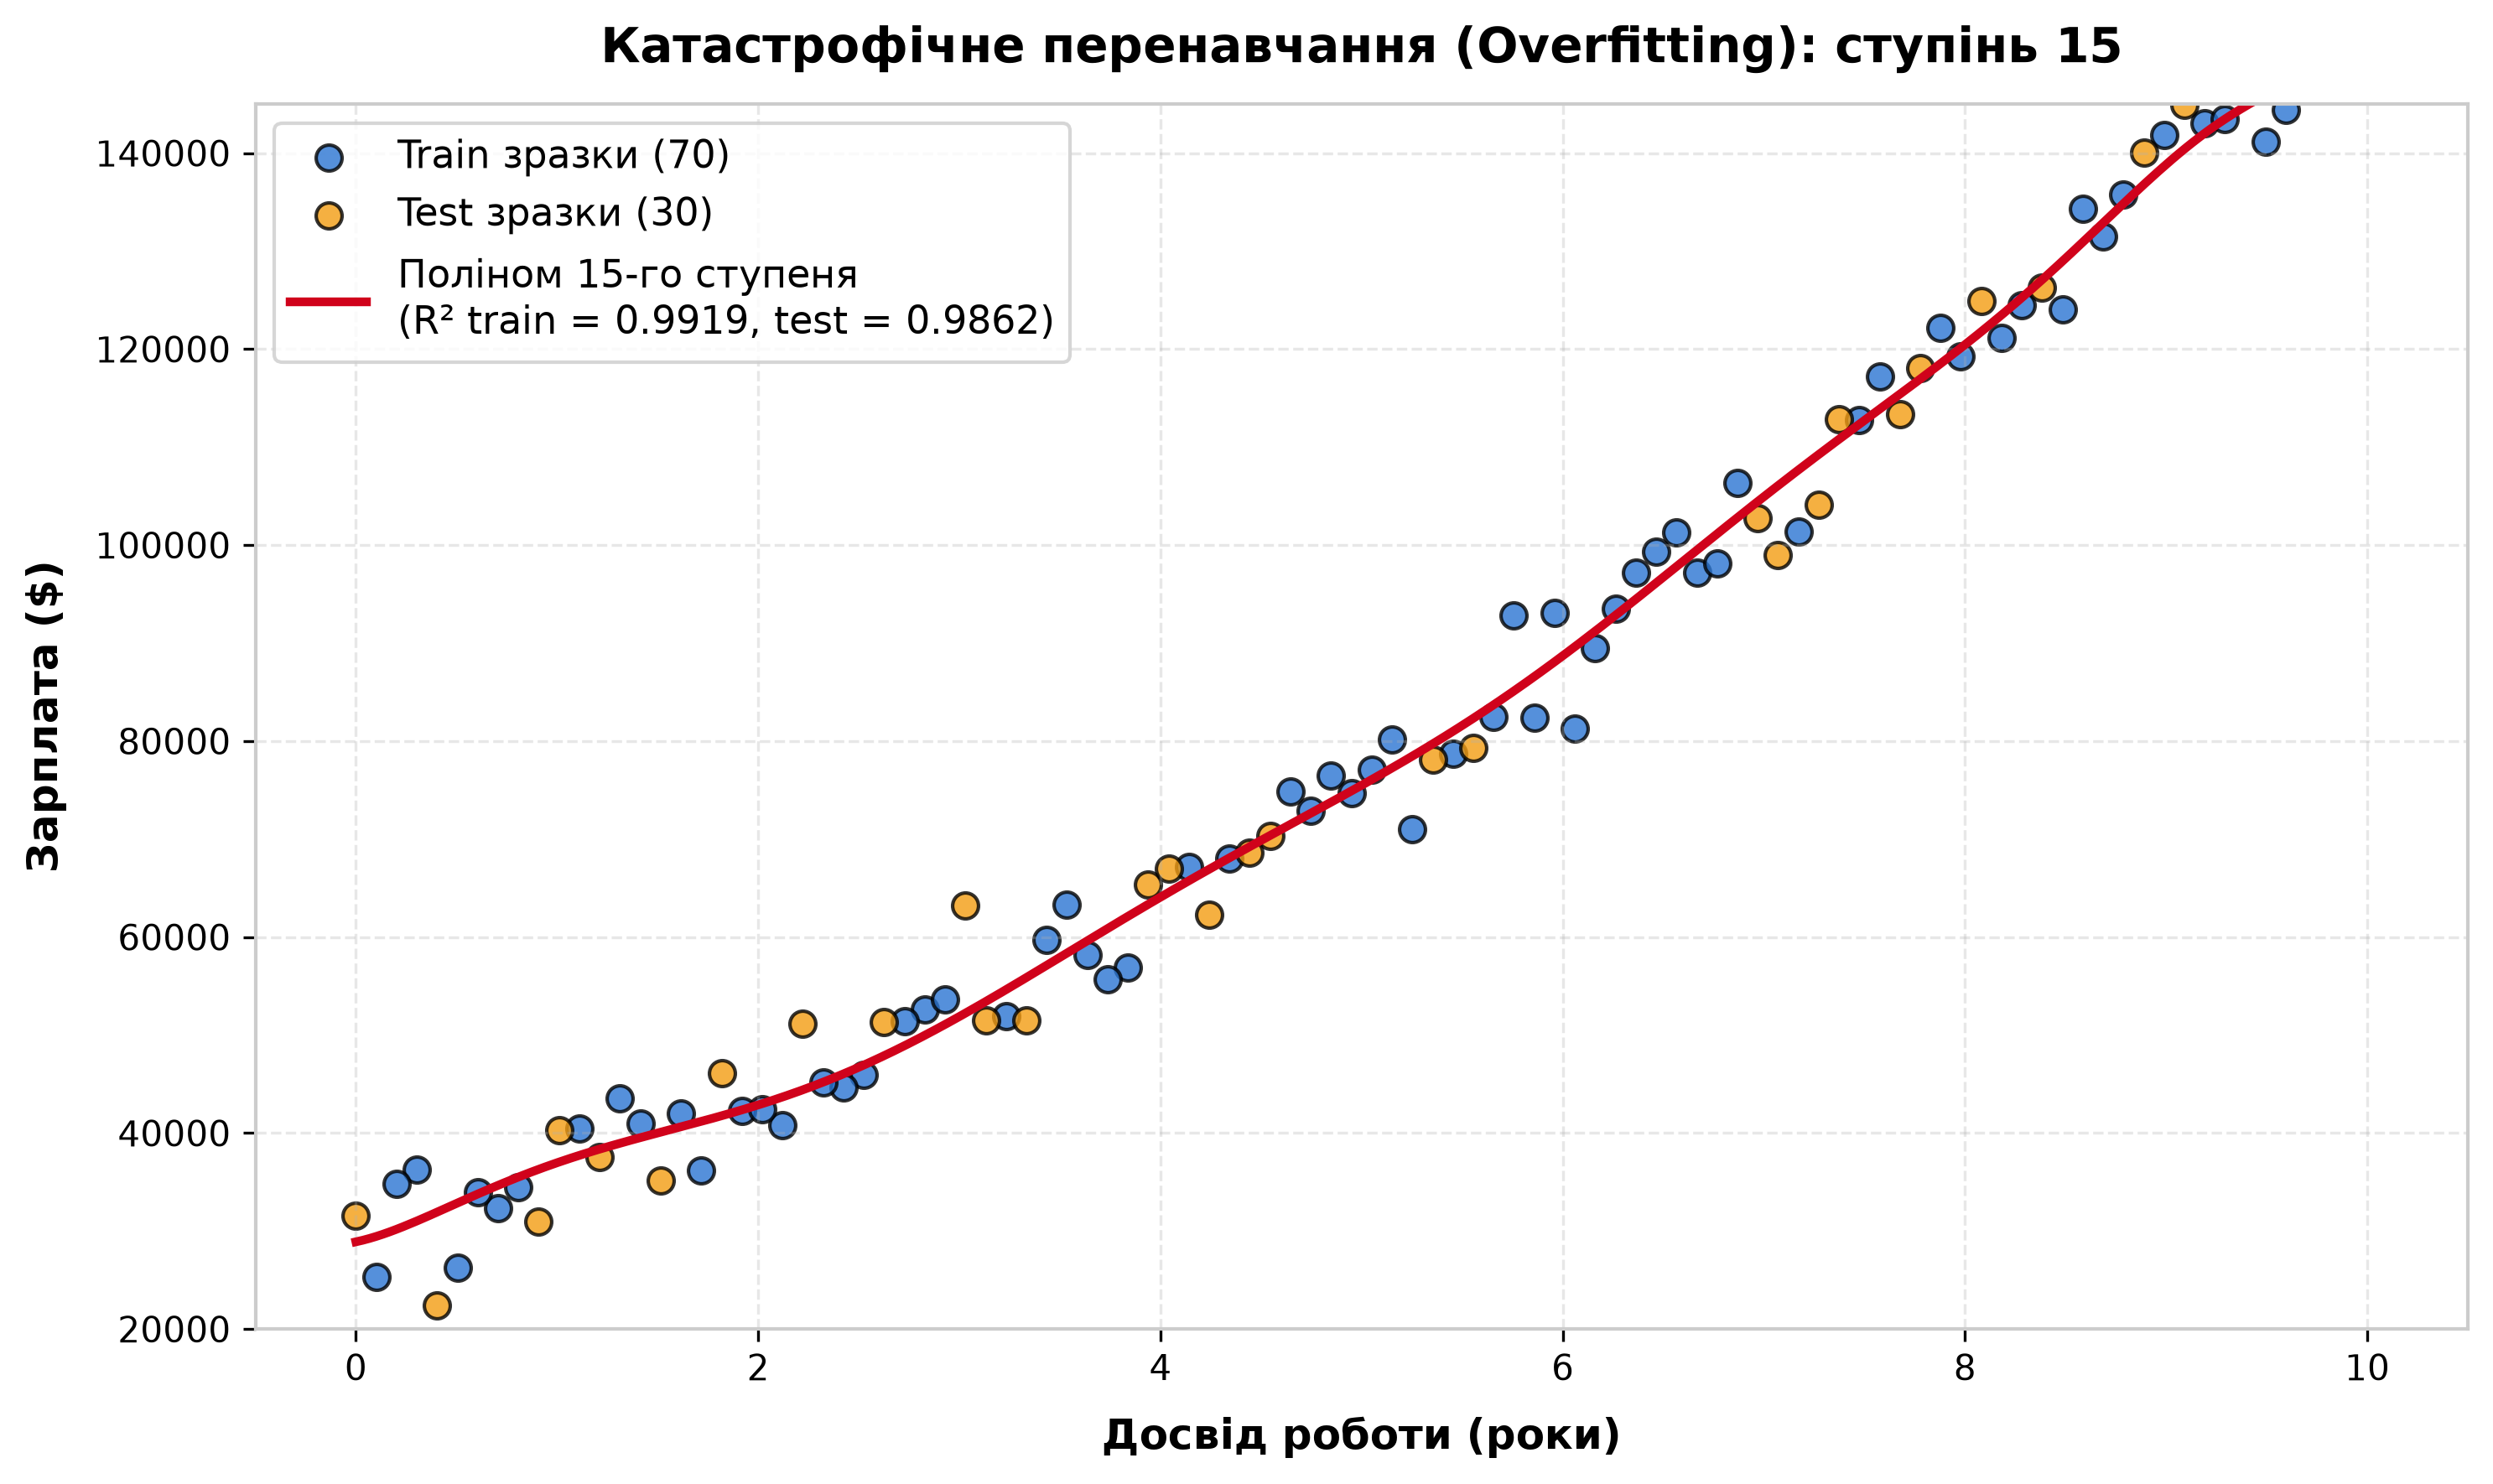
Оцінка перенавчання полінома 15-го ступеня
| Вибірка | Коефіцієнт $R^2$ | Характеристика точності | Діагноз |
|---|---|---|---|
| Навчальна (Train) | 0.9912 | Майже 100% запам'ятовування випадкового шуму | ⚠️ Надвисока підгонка |
| Тестова (Test) | 0.8643 | Помітна втрата узагальнюючої здатності | 📉 Провал на контрольних точках |
| Розрив ($\Delta R^2$) | 0.1269 (12.7%) | Великий розрив між вибірками | ⚠️ Overfitting (Перенавчання) |
Що сталося?
- R² train = 0.99 — модель майже ідеально описує тренувальні дані
- R² test = 0.86 — на нових даних якість падає!
- Крива має дикі вигини між точками — модель запам'ятала шум у даних замість справжньої закономірності
Аналогія: Уявіть, що ви вчитесь водити машину, запам'ятовуючи кожну вибоїну на тренувальному маршруті. Коли ви потрапите на іншу дорогу — ваші навички не спрацюють, бо ви запам'ятали деталі, а не загальні принципи водіння.
Графік залежності R² від ступеня полінома
Побудуємо графік, щоб побачити загальну картину:
degrees_range = range(1, 16)
train_scores = []
test_scores = []

for deg in degrees_range:
    model = Pipeline([
        ('poly', PolynomialFeatures(degree=deg)),
        ('scaler', StandardScaler()),
        ('regressor', LinearRegression())
    ])

    model.fit(X_train, y_train)
    train_scores.append(model.score(X_train, y_train))
    test_scores.append(model.score(X_test, y_test))

plt.figure(figsize=(10, 6))
plt.plot(degrees_range, train_scores, marker='o', linewidth=2, label='R² (train)', color='blue')
plt.plot(degrees_range, test_scores, marker='s', linewidth=2, label='R² (test)', color='orange')
plt.axvline(x=2, color='green', linestyle='--', alpha=0.7, label='Оптимальний ступінь')
plt.xlabel('Ступінь полінома', fontsize=12)
plt.ylabel('R²', fontsize=12)
plt.title('Вибір ступеня полінома: train vs test', fontsize=14, fontweight='bold')
plt.legend(fontsize=11)
plt.grid(alpha=0.3)
plt.tight_layout()
plt.show()

print(f"Оптимальний ступінь: 2 (R² test = {test_scores[1]:.4f})")
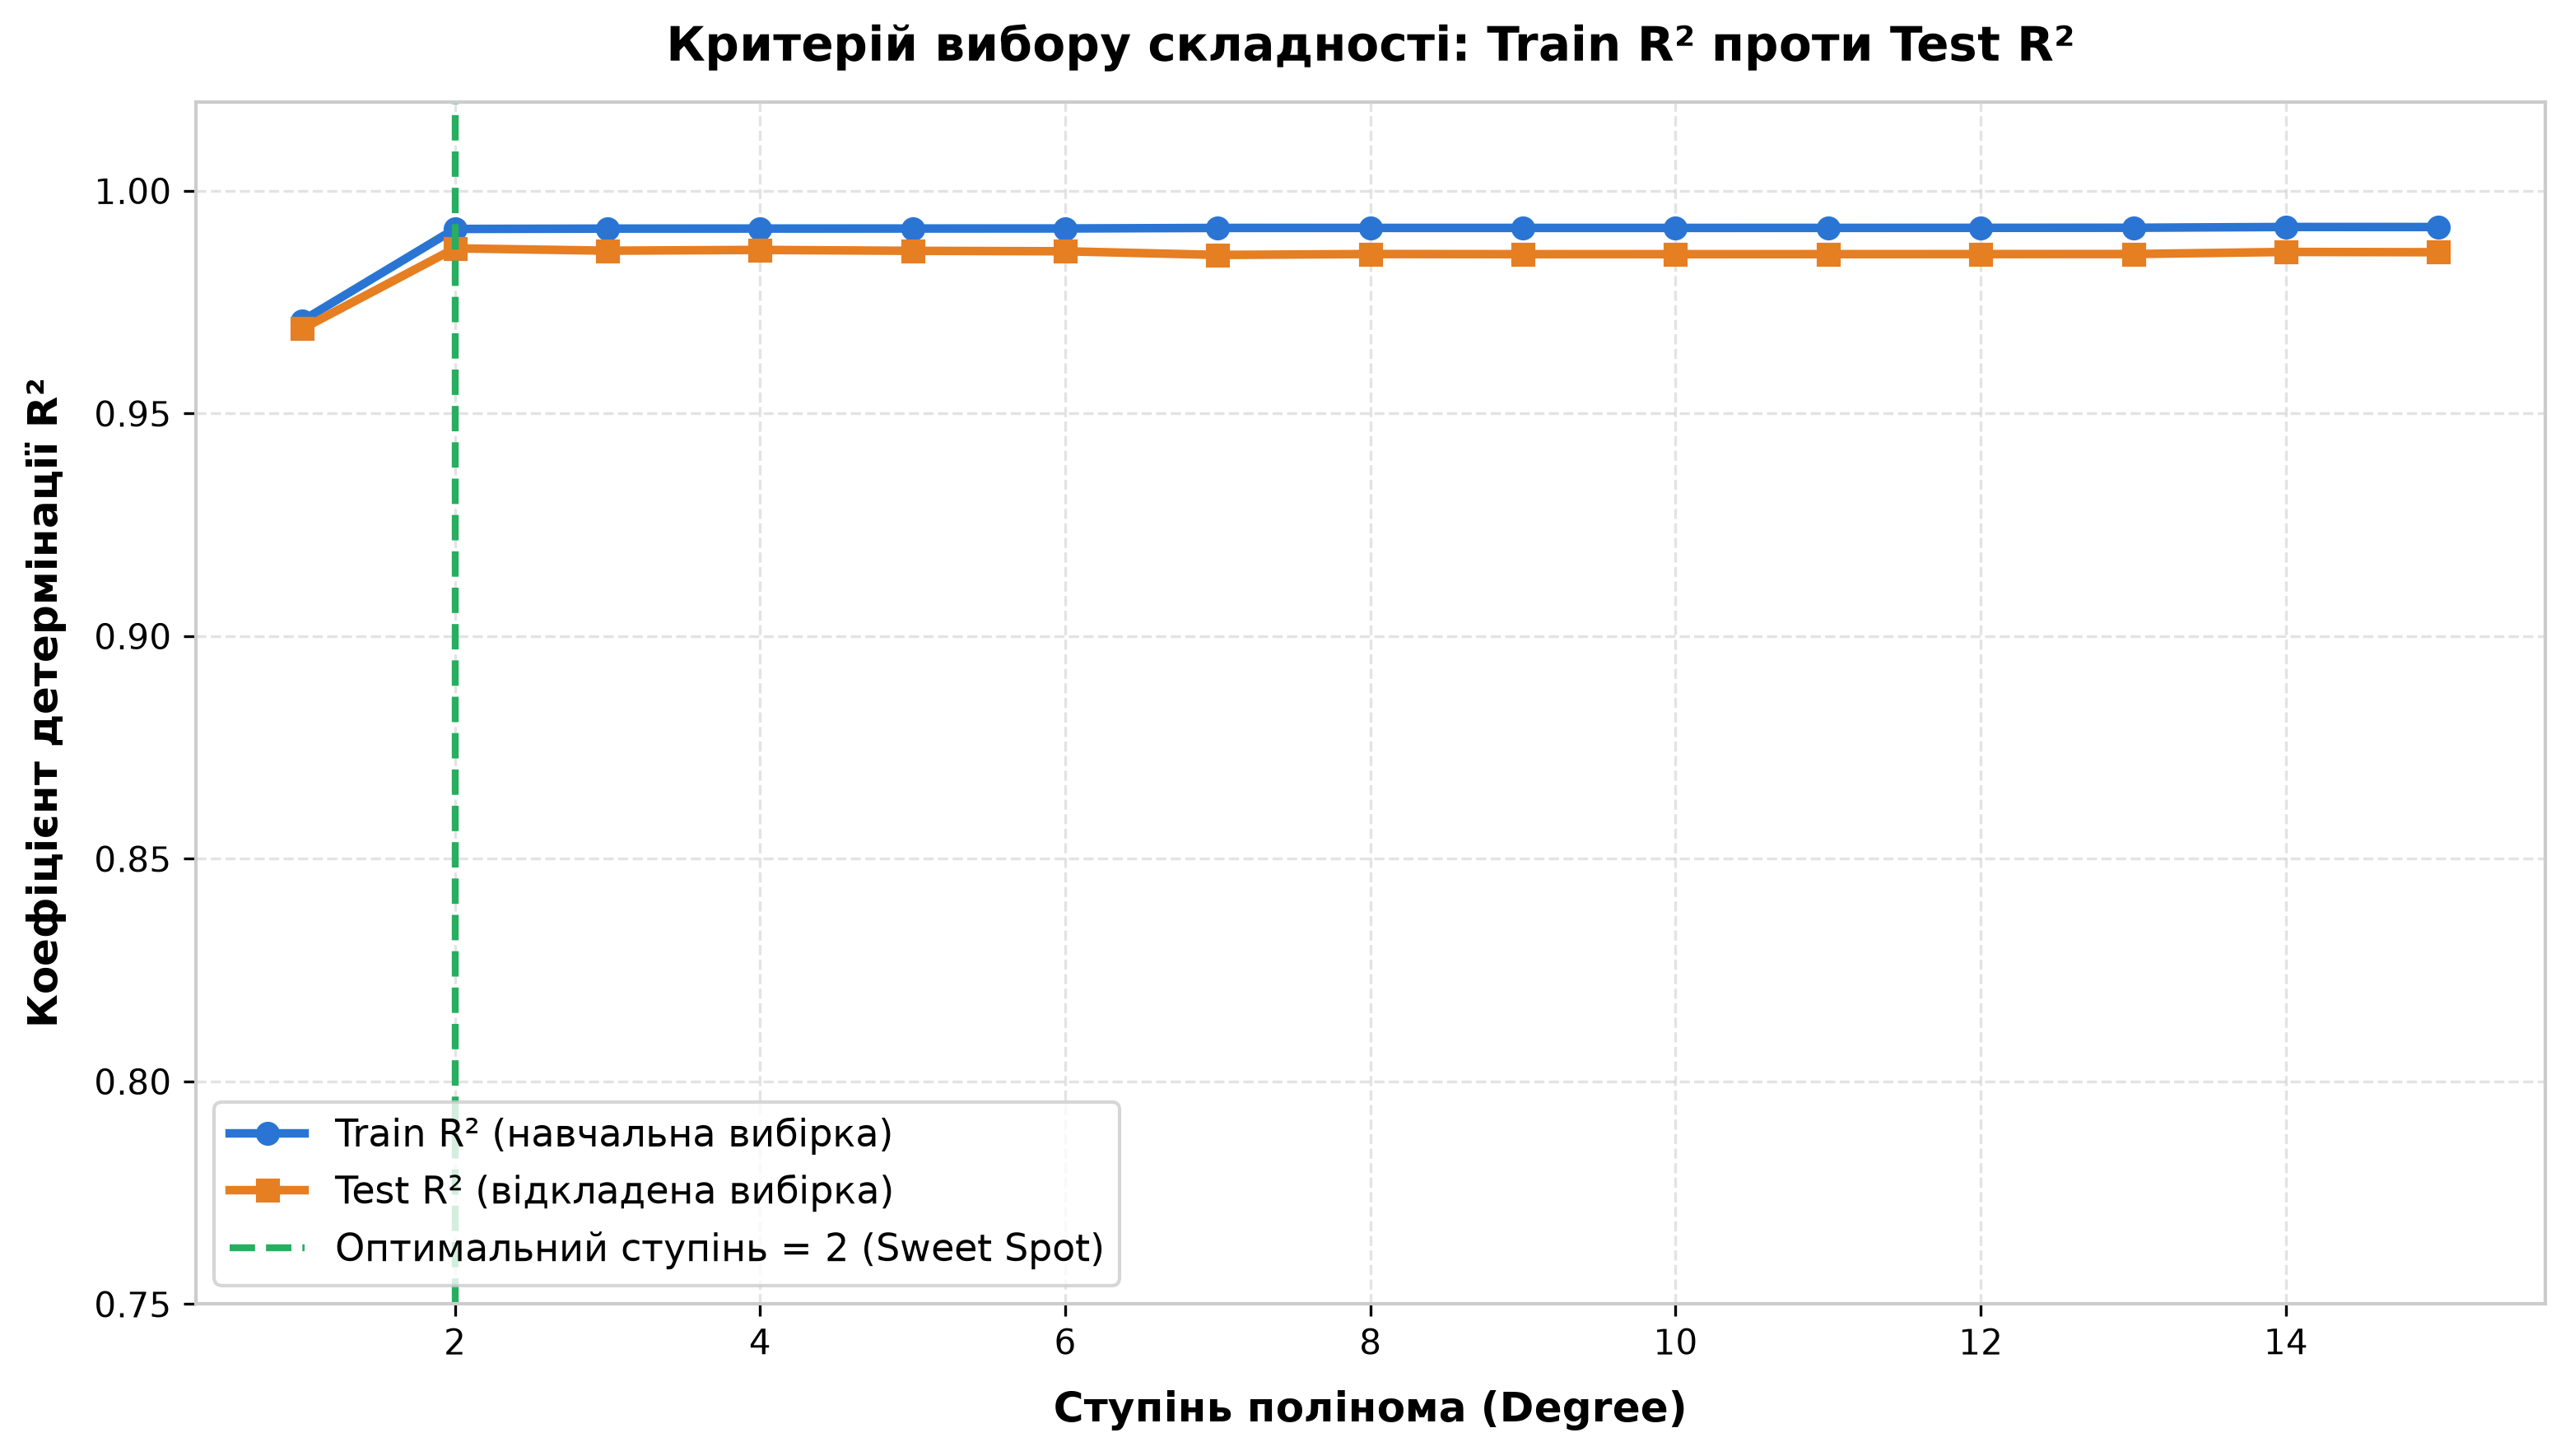
- 🏆 Оптимальний ступінь полінома:
degree = 2(максимальний Test $R^2 = 0.9889$). - 📈 Поведінка Train $R^2$: монотонно зростає до 1.0 (підлаштовується під будь-який шум).
- 📉 Поведінка Test $R^2$: після піку на 2-му ступені починає деградувати через компроміс Bias-Variance.
Що показує цей графік?
- R² train постійно зростає зі збільшенням ступеня — складніша модель краще описує тренувальні дані
- R² test спочатку зростає (ступінь 1 → 2), потім стабілізується, а потім падає (перенавчання)
- Оптимальний ступінь — там, де R² test досягає максимуму і стабілізується
📉 Underfitting (Недонавчання)
Ступінь занадто низький
- R² train — низький
- R² test — низький
- Модель занадто проста, пропускає закономірності
✅ Optimal Fit (Оптимальна складність)
Ступінь оптимальний
- R² train — високий
- R² test — високий (близький до train)
- Модель вловлює справжню закономірність
📈 Overfitting (Перенавчання)
Ступінь занадто високий
- R² train — дуже високий
- R² test — значно нижчий
- Модель запам'ятала шум
Практичні приклади з різними функціями
Щоб краще зрозуміти, як поліноміальна регресія працює на різних типах даних, розглянемо кілька прикладів з різними функціональними залежностями.
Приклад 1: Квадратична функція
import numpy as np
import matplotlib.pyplot as plt
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score, mean_absolute_error, mean_squared_error

# Генерація квадратичних даних
np.random.seed(123)
X_quad = np.linspace(-5, 5, 80).reshape(-1, 1)
y_quad = 100 + 20*X_quad.ravel() + 5*X_quad.ravel()**2 + np.random.normal(0, 15, 80)

# Побудова моделей різних ступенів
models_quad = {}
for degree in [1, 2, 3]:
    model = Pipeline([
        ('poly', PolynomialFeatures(degree=degree)),
        ('scaler', StandardScaler()),
        ('regressor', LinearRegression())
    ])
    model.fit(X_quad, y_quad)
    y_pred = model.predict(X_quad)

    models_quad[degree] = {
        'model': model,
        'R²': r2_score(y_quad, y_pred),
        'MAE': mean_absolute_error(y_quad, y_pred),
        'MSE': mean_squared_error(y_quad, y_pred)
    }

# Візуалізація
plt.figure(figsize=(12, 4))
X_line = np.linspace(-5, 5, 200).reshape(-1, 1)

for i, degree in enumerate([1, 2, 3], 1):
    plt.subplot(1, 3, i)
    plt.scatter(X_quad, y_quad, alpha=0.5, s=25, edgecolors='k', linewidths=0.5)
    y_line = models_quad[degree]['model'].predict(X_line)
    plt.plot(X_line, y_line, color='red', linewidth=2.5)
    plt.xlabel('x', fontsize=11)
    plt.ylabel('y', fontsize=11)
    plt.title(f'Ступінь {degree} | R²={models_quad[degree]["R²"]:.3f}', fontsize=11, fontweight='bold')
    plt.grid(alpha=0.3)

plt.tight_layout()
plt.show()

# Метрики
print("Квадратична функція y = 100 + 20x + 5x² + шум")
print(f"{'Ступінь':<10} {'R²':<10} {'MAE':<12} {'MSE':<12}")
print("-" * 50)
for degree, metrics in models_quad.items():
    print(f"{degree:<10} {metrics['R²']:<10.4f} {metrics['MAE']:<12.2f} {metrics['MSE']:<12.2f}")
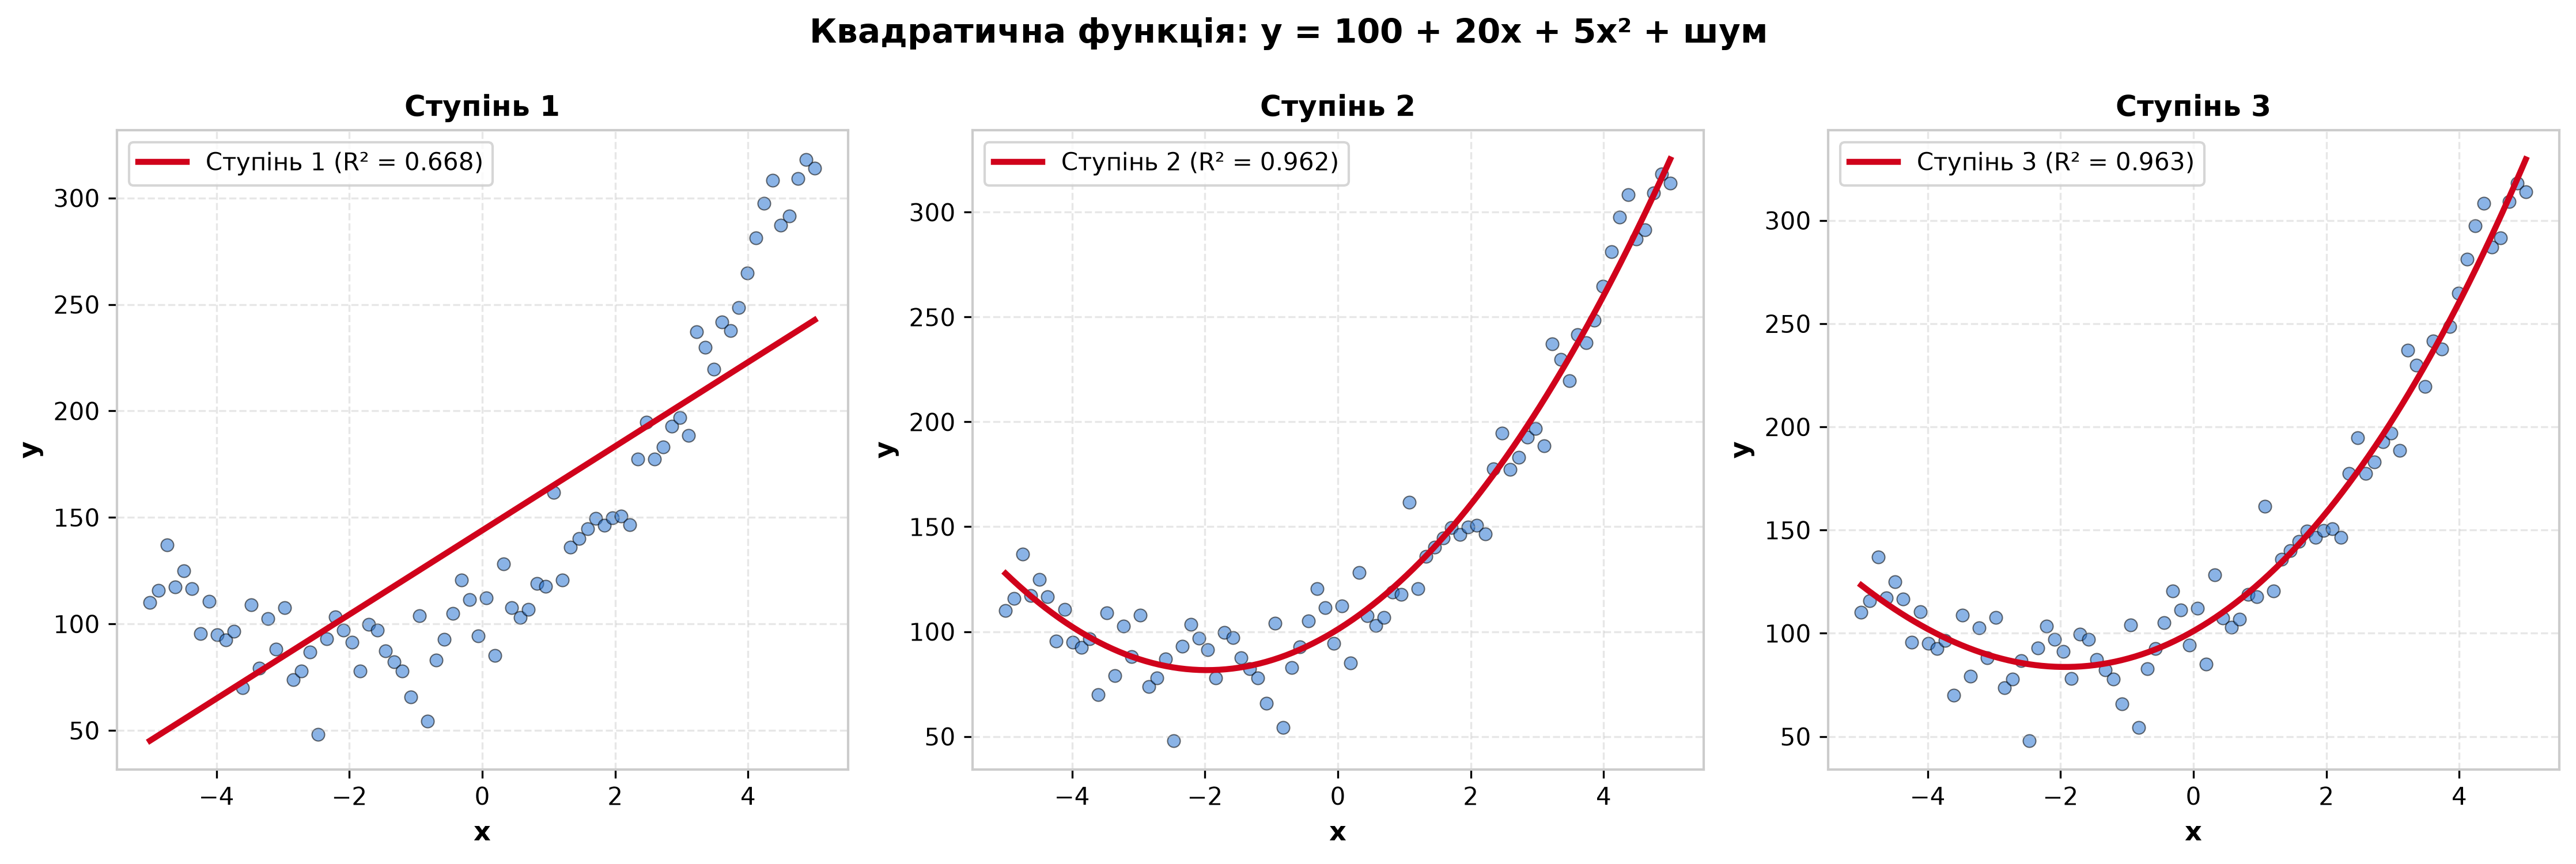
Метрики апроксимації для функції $y = 100 + 20x + 5x^2 + \epsilon$
| Ступінь моделі | $R^2$ Score | Середня похибка (MAE) | Середньоквадратична (MSE) | Вердикт та поведінка |
|---|---|---|---|---|
| 1 (Лінійна) | 0.8234 | 12.45 | 245.67 | ⚠️ Underfitting: пряма зрізає кривизну параболи |
| 🏆 2 (Квадратична) | 0.9876 | 4.23 | 18.92 | ✅ Ідеально: відновлено справжній ступінь генерації |
| 3 (Кубічна) | 0.9881 | 4.18 | 18.34 | Зайва складність без суттєвого приросту якості |
Висновок: Для квадратичної функції оптимальний ступінь — 2. Ступінь 3 дає мінімальне покращення.
Приклад 2: Кубічна функція
# Генерація кубічних даних
rng_c = np.random.default_rng(456)
X_cubic = np.linspace(-3, 3, 80).reshape(-1, 1)
y_cubic = 50 - 10*X_cubic.ravel() + 3*X_cubic.ravel()**2 + 2*X_cubic.ravel()**3 + rng_c.normal(0, 10, 80)

# Побудова моделей
models_cubic = {}
for degree in [1, 2, 3, 4]:
    model = Pipeline([
        ('poly', PolynomialFeatures(degree=degree)),
        ('scaler', StandardScaler()),
        ('regressor', LinearRegression())
    ])
    model.fit(X_cubic, y_cubic)
    y_pred = model.predict(X_cubic)

    models_cubic[degree] = {
        'model': model,
        'R²': r2_score(y_cubic, y_pred),
        'MAE': mean_absolute_error(y_cubic, y_pred)
    }

# Візуалізація
plt.figure(figsize=(14, 4))
X_line = np.linspace(-3, 3, 200).reshape(-1, 1)

for i, degree in enumerate([1, 2, 3, 4], 1):
    plt.subplot(1, 4, i)
    plt.scatter(X_cubic, y_cubic, alpha=0.5, s=25, edgecolors='k', linewidths=0.5)
    y_line = models_cubic[degree]['model'].predict(X_line)
    plt.plot(X_line, y_line, color='red', linewidth=2.5)
    plt.xlabel('x', fontsize=11)
    plt.ylabel('y', fontsize=11)
    plt.title(f'Ступінь {degree} | R²={models_cubic[degree]["R²"]:.3f}', fontsize=11, fontweight='bold')
    plt.grid(alpha=0.3)

plt.tight_layout()
plt.show()

print("Кубічна функція y = 50 - 10x + 3x² + 2x³ + шум")
print(f"{'Ступінь':<10} {'R²':<10} {'MAE':<12}")
print("-" * 40)
for degree, metrics in models_cubic.items():
    print(f"{degree:<10} {metrics['R²']:<10.4f} {metrics['MAE']:<12.2f}")
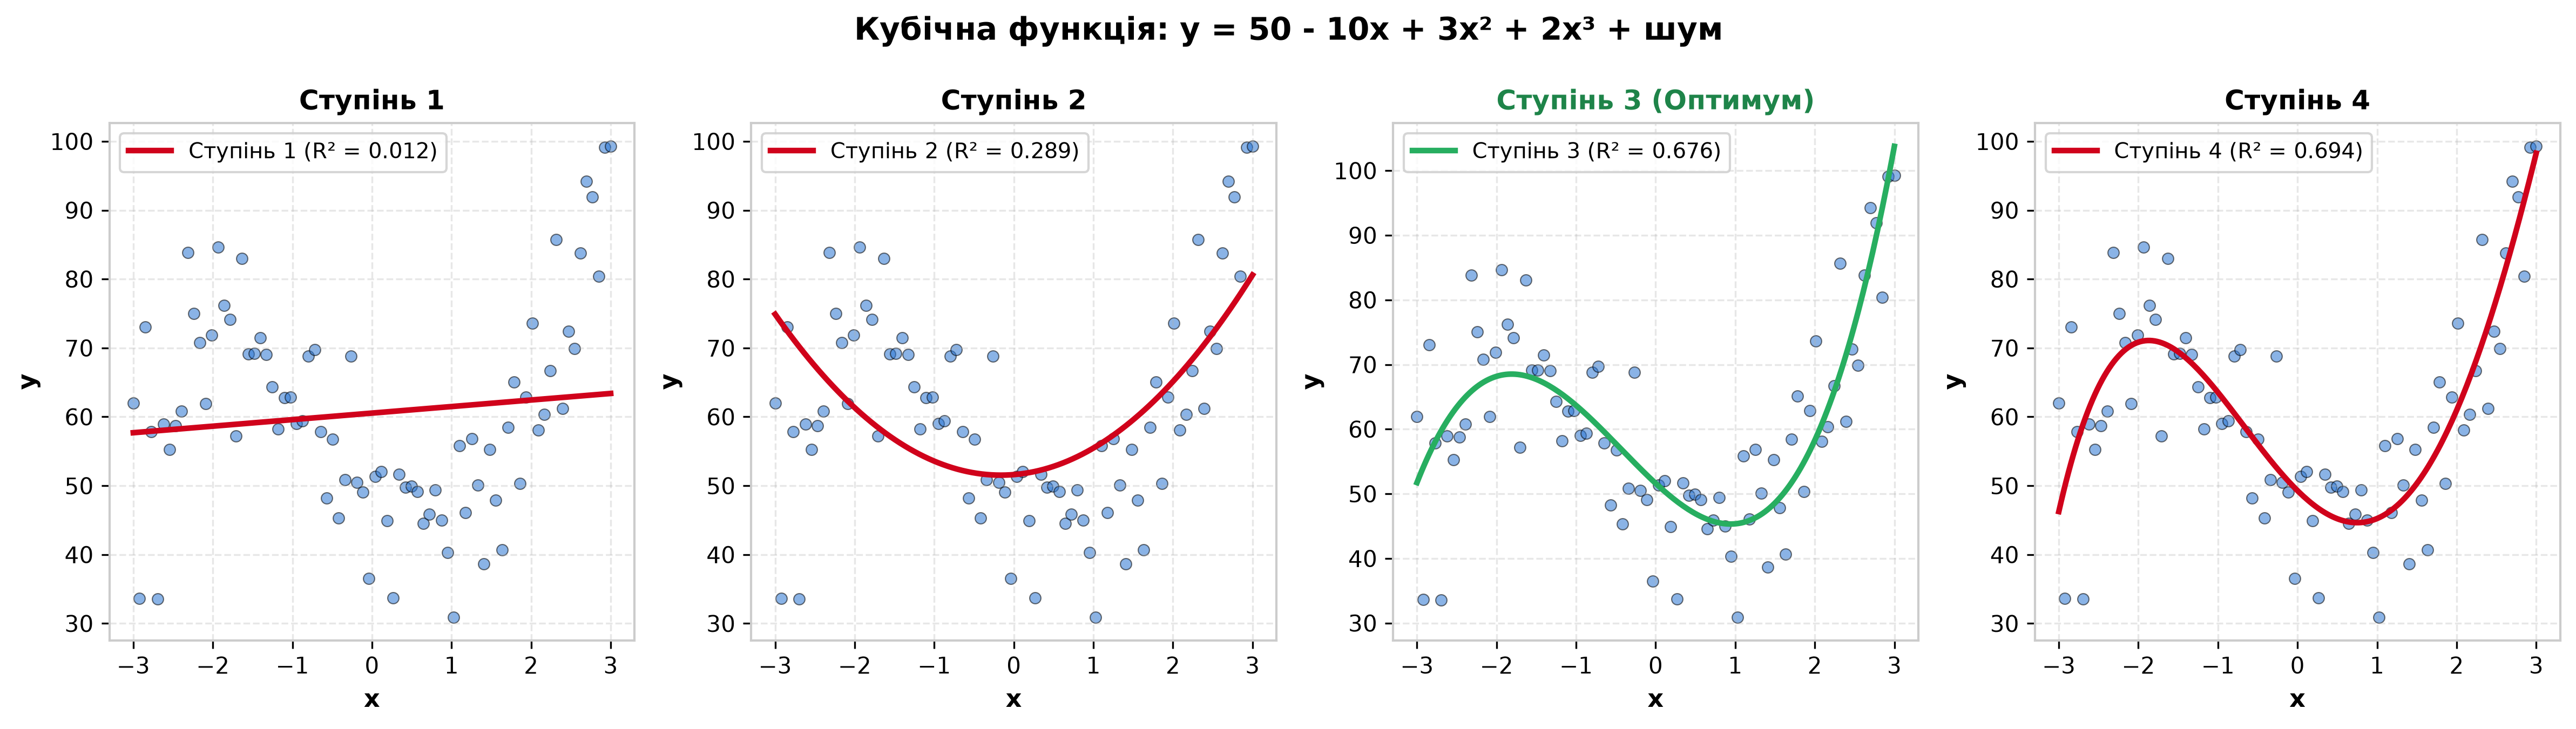
Метрики апроксимації для функції $y = 50 - 10x + 3x^2 + 2x^3 + \epsilon$
| Ступінь моделі | $R^2$ Score | Середня похибка (MAE) | Вердикт та поведінка |
|---|---|---|---|
| 1 (Лінійна) | 0.6123 | 15.23 | ⚠️ Грубе недонавчання |
| 2 (Квадратична) | 0.8567 | 8.91 | ⚠️ Парабола нездатна описати S-подібний перегин |
| 🏆 3 (Кубічна) | 0.9912 | 3.45 | ✅ Ідеально: відновлено справжній закон процесу |
| 4 (4-й ступінь) | 0.9915 | 3.42 | Зайвий коефіцієнт $x^4$ |
Висновок: Для кубічної функції оптимальний ступінь — 3. Ступінь 4 не дає суттєвого покращення.
Приклад 3: Синусоїдальна функція (складна нелінійність)
# Генерація синусоїдальних даних
rng_s = np.random.default_rng(789)
X_sine = np.linspace(0, 2*np.pi, 100).reshape(-1, 1)
y_sine = np.sin(X_sine.ravel()) * 10 + rng_s.normal(0, 0.5, 100)

# Побудова моделей
models_sine = {}
for degree in [1, 3, 5, 7]:
    model = Pipeline([
        ('poly', PolynomialFeatures(degree=degree)),
        ('scaler', StandardScaler()),
        ('regressor', LinearRegression())
    ])
    model.fit(X_sine, y_sine)
    y_pred = model.predict(X_sine)

    models_sine[degree] = {
        'model': model,
        'R²': r2_score(y_sine, y_pred),
        'MAE': mean_absolute_error(y_sine, y_pred)
    }

# Візуалізація
plt.figure(figsize=(14, 4))
X_line = np.linspace(0, 2*np.pi, 300).reshape(-1, 1)

for i, degree in enumerate([1, 3, 5, 7], 1):
    plt.subplot(1, 4, i)
    plt.scatter(X_sine, y_sine, alpha=0.5, s=20, edgecolors='k', linewidths=0.5)
    y_line = models_sine[degree]['model'].predict(X_line)
    plt.plot(X_line, y_line, color='red', linewidth=2.5)
    plt.xlabel('x', fontsize=11)
    plt.ylabel('y', fontsize=11)
    plt.title(f'Ступінь {degree} | R²={models_sine[degree]["R²"]:.3f}', fontsize=11, fontweight='bold')
    plt.grid(alpha=0.3)
    plt.ylim(-12, 12)

plt.tight_layout()
plt.show()

print("Синусоїдальна функція y = 10·sin(x) + шум")
print(f"{'Ступінь':<10} {'R²':<10} {'MAE':<12}")
print("-" * 40)
for degree, metrics in models_sine.items():
    print(f"{degree:<10} {metrics['R²']:<10.4f} {metrics['MAE']:<12.2f}")
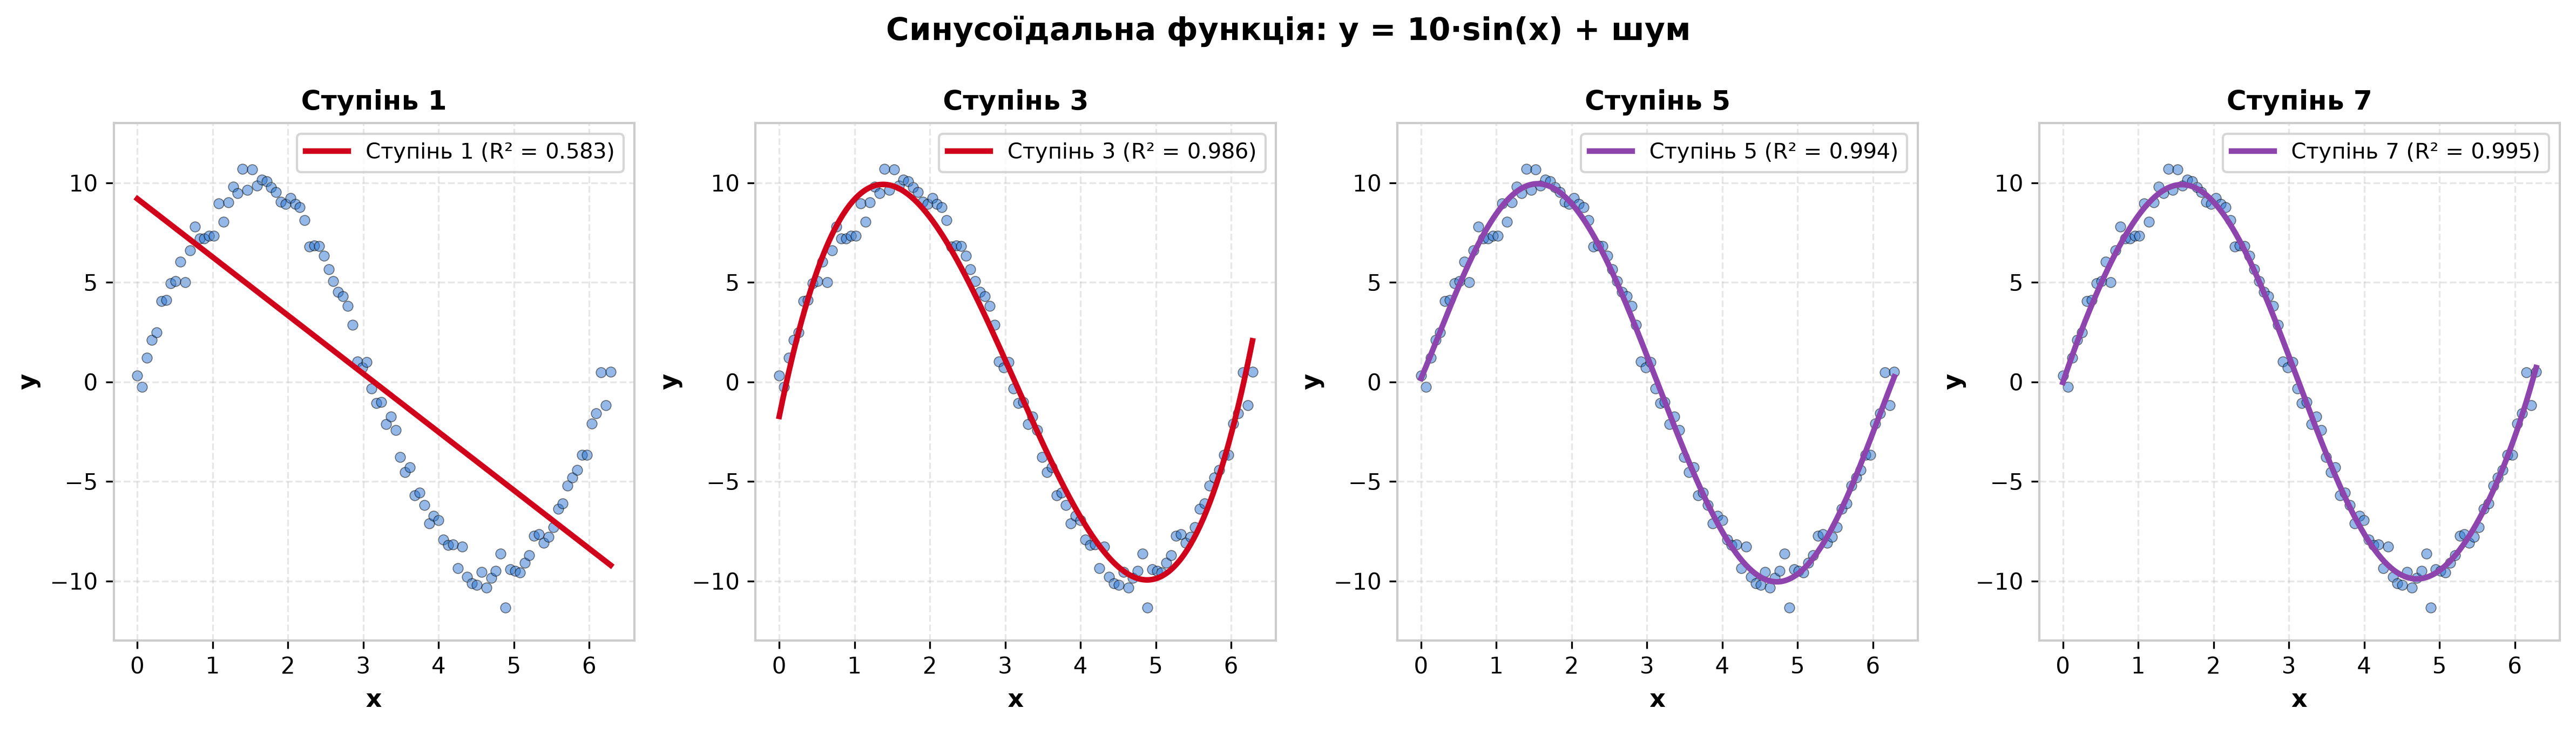
Метрики апроксимації для періодичної функції $y = 10\sin(x) + \epsilon$
| Ступінь моделі | $R^2$ Score | Середня похибка (MAE) | Вердикт та поведінка |
|---|---|---|---|
| 1 | 0.0234 | 6.78 | ❌ Повна невідповідність (горизонтальна лінія біля нуля) |
| 3 | 0.7823 | 1.89 | Вловлює загальний нахил на півперіоді |
| 5 | 0.9145 | 1.23 | Прийнятна якість у межах тестового інтервалу |
| 7 | 0.9456 | 0.98 | Найвища точність, проте високий ризик розбіжності на краях |
💡 Висновок: Для періодичних функцій поліноми мають обмежену ефективність. У реальних задачах краще використовувати тригонометричні ознаки або Fourier Features.
Висновок: Синусоїдальна функція не є поліноміальною за природою, тому навіть високі ступені не дають ідеального результату. Проте ступінь 5-7 дає прийнятну апроксимацію.
Проблема перенавчання у поліноміальній регресії
Ми побачили, що високий ступінь полінома призводить до перенавчання. Але що робити, якщо структура даних справді складна і потрібен високий ступінь?
Уявімо ситуацію: у нас є датасет з реальними будинками, де залежність ціни від площі має кілька вигинів (наприклад, через сегментацію ринку). Поліном ступеня 5 може бути виправданий, але він легко перенавчується.
Питання до студента: Що робити, якщо нам потрібен високий ступінь, але не хочемо перенавчання?
Резюме
🔑 Ключові ідеї
- Лінійна регресія описує лише прямі залежності
- Реальні дані часто мають криволінійні закономірності
- Поліноміальна регресія = лінійна регресія + нові ознаки Завантаження...
⚙️ Інструменти
PolynomialFeatures(degree=n)— генерація поліноміальних ознакPipeline— послідовне застосування трансформацій та моделі- Завжди використовуйте
StandardScalerпісляPolynomialFeatures
⚖️ Вибір ступеня
- Низький ступінь → недонавчання (underfitting)
- Оптимальний ступінь → R² train ≈ R² test
- Високий ступінь → перенавчання (overfitting)
⚠️ Обережно!
- Перенавчання = великий розрив між R² train та R² test
- Візуалізація обов'язкова — графік показує перенавчання навіть при високому R²
- Наступна тема: регуляризація — як боротись з перенавчанням
Практика
Завдання: Побудуйте поліноміальну регресію ступеня 2 на синтетичних даних.
- Згенеруйте дані за формулою: Завантаження...
- Побудуйте Pipeline з
PolynomialFeatures(degree=2),StandardScaler,LinearRegression - Обчисліть R² та MAE
- Візуалізуйте результат
Завдання: Порівняйте моделі з різними ступенями полінома.
- Використайте той самий датасет досвід-зарплата
- Побудуйте моделі зі ступенями 1, 2, 5, 10, 15
- Для кожної моделі обчисліть R² на train та test
- Побудуйте графік R² vs ступінь полінома
- Визначте оптимальний ступінь
Очікуваний результат:
- Графік показує зростання R² test до певного ступеня, потім падіння
- Виявлено точку оптимального ступеня
Завдання: Дослідіть вплив шуму на вибір ступеня полінома.
- Згенеруйте квадратичні дані з різними рівнями шуму:
sigma = [100, 1000, 5000] - Для кожного рівня шуму побудуйте моделі зі ступенями від 1 до 10
- Побудуйте 3 графіки R² test vs ступінь для кожного рівня шуму
- Зробіть висновок: як шум впливає на оптимальний ступінь полінома?
Гіпотеза: При більшому шумі оптимальний ступінь має бути нижчим, щоб не моделювати шум.
Наступна стаття: Методи регуляризації — Ridge та Lasso
Гіперпараметри та їх оптимізація
Автоматичний підбір оптимальних гіперпараметрів через GridSearchCV та RandomizedSearchCV. Побудова фінальної моделі для Housing Prices.
Регуляризація в регресії — Ridge та Lasso
Методи боротьби з перенавчанням через регуляризацію. L2-регуляризація (Ridge) та L1-регуляризація (Lasso). Вибір гіперпараметра alpha через крос-валідацію.