Метрики якості регресії — як оцінити модель
Метрики якості регресії — як оцінити модель
🎯 Мета підрозділу
- Зрозуміти, чому потрібні метрики якості
- Опанувати чотири ключові метрики: MAE, MSE, RMSE, R²
- Навчитися обирати метрику залежно від задачі
- Реалізувати обчислення метрик на Python
🔑 Ключові терміни
- MAE (Mean Absolute Error) — середня абсолютна помилка
- MSE (Mean Squared Error) — середня квадратична помилка
- RMSE (Root Mean Squared Error) — корінь з MSE
- R² (коефіцієнт детермінації) — частка поясненої варіації
- Residual (залишок) — різниця між реальним та передбаченим значенням
Проблема: яка модель краща?
У попередньому підрозділі ми побачили три варіанти моделі з різними параметрами w та b. Візуально зрозуміло, що помаранчева лінія (w=500, b=0) найкраща — вона проходить посередині точок.
Але що робити, якщо:
- У нас 1000 варіантів моделі?
- Різниця між ними мізерна і візуально непомітна?
- Дані багатовимірні (3+ ознак) і графік побудувати неможливо?
Потрібен об'єктивний математичний критерій — число, яке скаже: «Модель A краща за модель B на 15%».
Поняття залишку (Residual)
Перед тим як говорити про інтегральні метрики якості, введемо фундаментальне поняття похибки моделі на одиничному спостереженні.
Залишок (residual) — це різниця між фактичним емпіричним значенням Завантаження... та прогнозом математичної моделі Завантаження...:
де:
- Завантаження... — реальна ціна Завантаження...-ї квартири з нашої вибірки спостережень;
- Завантаження... — розрахункова ціна, яку прогнозує модель для площі цієї квартири;
- Завантаження... — похибка апроксимації (residual / error).
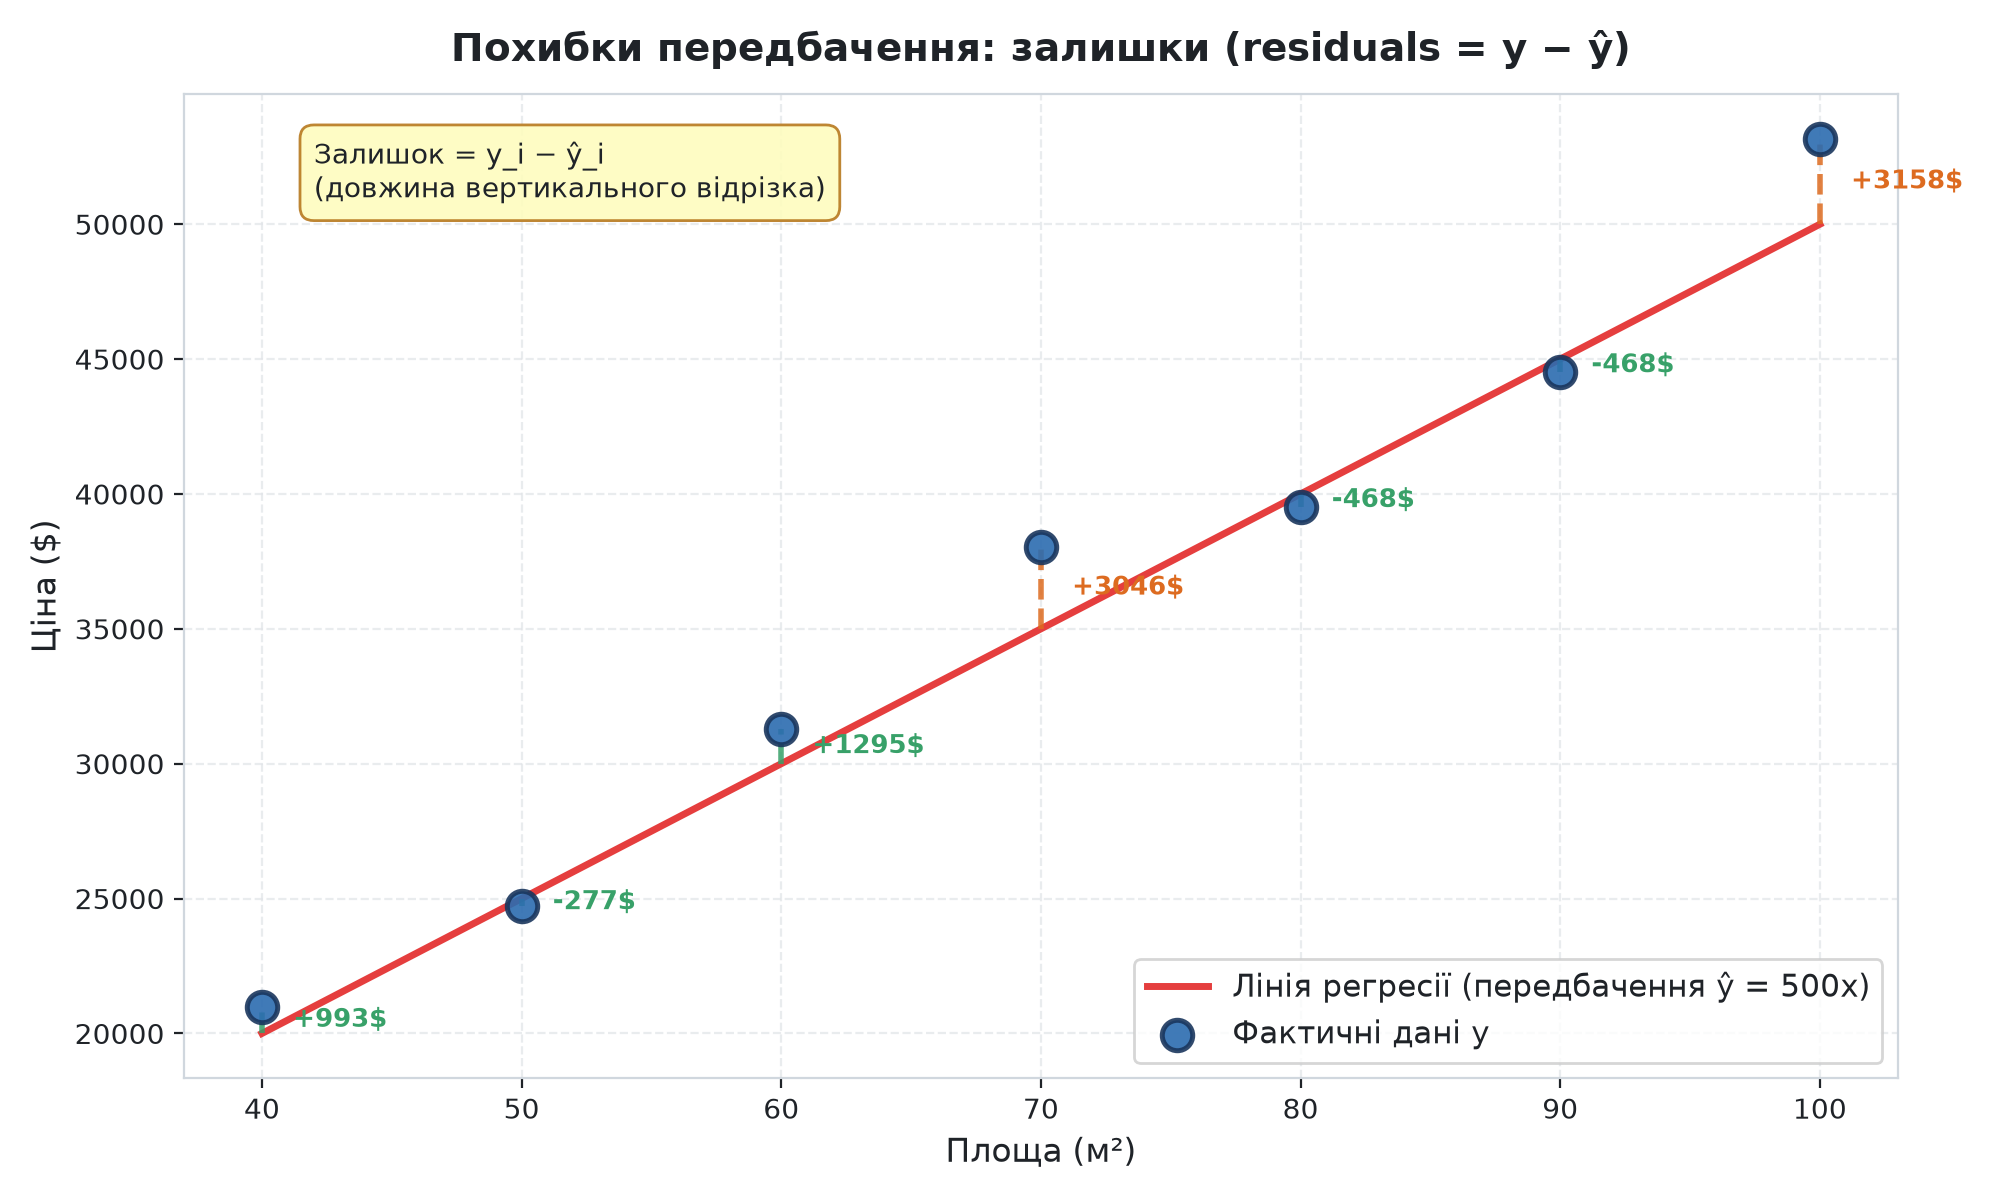
Геометрична природа залишку
Зверніть увагу на ключову геометричну деталь: залишок вимірюється суто як вертикальна відстань паралельно осі ординат Завантаження... між спостережуваною точкою Завантаження... та лінією регресії Завантаження..., а не як найкоротша евклідова перпендикулярна відстань до прямої.
Це зумовлено самою постановкою задачі: вхідна ознака Завантаження... (площа) вважається детермінованою та точно виміряною величиною, тоді як цільова змінна Завантаження... (ціна) містить стохастичний шум, який ми прагнемо мінімізувати.
Приклад обчислення залишків
import numpy as np

# Реальні дані (3 квартири)
area = np.array([50, 80, 120])
price_real = np.array([24500, 39800, 59200])  # реальні ціни

# Модель: ŷ = 500 * x + 0
w, b = 500, 0
price_pred = w * area + b  # передбачення моделі

# Обчислюємо залишки
residuals = price_real - price_pred

# Виводимо таблицю
print("Площа | Реальна ціна | Передбачення | Залишок (помилка)")
print("------|--------------|--------------|------------------")
for i in range(len(area)):
    print(f"{area[i]:5} | ${price_real[i]:11} | ${price_pred[i]:11.0f} | ${residuals[i]:+7.0f}")
| Площа | Реальна ціна | Передбачення | Залишок (помилка) |
|---|---|---|---|
| 50 | $ 24500 | $ 25000 | -500 |
| 80 | $ 39800 | $ 40000 | -200 |
| 120 | $ 59200 | $ 60000 | -800 |
Інтерпретація:
- Для квартири 50 м²: модель переоцінила на 500$ (залишок негативний)
- Для квартири 80 м²: модель переоцінила на 200$ (майже влучила!)
- Для квартири 120 м²: модель переоцінила на 800$
Ідеальна модель матиме всі залишки = 0. Але в реальності це неможливо через шум у даних.
- Завантаження... (позитивний): модель недооцінила (передбачила менше, ніж насправді)
- Завантаження... (негативний): модель переоцінила (передбачила більше, ніж насправді)
- Завантаження...: ідеальне передбачення
Метрика 1: MAE (Mean Absolute Error)
MAE — це середнє абсолютних значень усіх залишків. Ігноруємо знак (беремо модуль), підсумовуємо та ділимо на кількість спостережень.
Формула
де Завантаження... — кількість спостережень у датасеті.
Інтуїція
MAE відповідає на питання: «На скільки в середньому ми помиляємося?»
- Якщо MAE = 2000$, це означає: «В середньому наші передбачення відрізняються від реальності на 2000 доларів»
- MAE завжди Завантаження.... Чим менше — тим краще.
- Одиниці виміру: такі ж, як у цільової змінної (долари, метри, кілограми тощо)
Приклад обчислення
import numpy as np

# Дані з попереднього прикладу
price_real = np.array([24500, 39800, 59200])
price_pred = np.array([25000, 40000, 60000])

# Обчислюємо залишки
residuals = price_real - price_pred

# MAE: середнє абсолютних значень
mae = np.mean(np.abs(residuals))

print(f"Залишки: {residuals}")
print(f"Абсолютні залишки: {np.abs(residuals)}")
print(f"\nMAE = {mae:.2f}$")
print(f"\nІнтерпретація: модель в середньому помиляється на {mae:.0f} доларів")
Залишки: -500 -200 -800 Абсолютні залишки: 500 200 800
MAE = 500.00$
Інтерпретація: модель в середньому помиляється на 500 доларів
- Легко інтерпретується (в тих же одиницях, що й дані)
- Стійка до викидів (outliers) — одна велика помилка не «вибухне» результат
- Інтуїтивно зрозуміла для бізнесу
- Не штрафує великі помилки сильніше за маленькі (усі помилки рівноцінні)
Метрика 2: MSE (Mean Squared Error)
MSE — це середнє квадратів залишків. На відміну від MAE, тут ми піднесемо помилку до квадрату перед усередненням.
Формула
Інтуїція
MSE відповідає на питання: «Наскільки сильно розкидані наші помилки?»
Ключова відмінність від MAE: квадрат помилки.
Розглянемо два сценарії:
Сценарій A: три помилки = 100, 100, 100
- MAE = (100 + 100 + 100) / 3 = 100
- MSE = Завантаження... 10 000
Сценарій B: три помилки = 10, 10, 280
- MAE = (10 + 10 + 280) / 3 = 100 (так само!)
- MSE = Завантаження... 26 200 (набагато більше!)
Висновок: MSE сильно штрафує великі помилки. У сценарії B одна велика помилка (280) «вибухнула» через квадрат. Це корисно, коли великі помилки критичні для бізнесу.
Чому саме квадрат? Уявіть систему контролю дорожнього руху:
- Перевищення дозволеної швидкості на 10 км/год — помірний штраф 340 грн.
- Перевищення на 30 км/год — це не втричі більший штраф, а позбавлення прав або конфіскація авто (покарання у десятки разів суворіше!).
Медичний приклад: Помилка в дозуванні препарату на 0.5 мг для організму непомітна, проте помилка на 5 мг може стати летальною. У таких критичних системах оптимізують саме MSE або RMSE.
Приклад обчислення
import numpy as np

price_real = np.array([24500, 39800, 59200])
price_pred = np.array([25000, 40000, 60000])

residuals = price_real - price_pred

# MSE: середнє квадратів
mse = np.mean(residuals ** 2)

print(f"Залишки: {residuals}")
print(f"Квадрати залишків: {residuals ** 2}")
print(f"\nMSE = {mse:.2f}$²")
print(f"\nУвага: одиниці виміру — долари У КВАДРАТІ (не інтуїтивно)")
Залишки: -500 -200 -800 Квадрати залишків: 250000 40000 640000
MSE = 310000.00$²
Увага: одиниці виміру — долари У КВАДРАТІ (не інтуїтивно)
Метрика 3: RMSE (Root Mean Squared Error)
RMSE — це просто квадратний корінь з MSE. Це повертає нам зручні одиниці виміру.
Формула
Інтуїція
RMSE поєднує переваги обох попередніх метрик:
- Штрафує великі помилки сильніше (як MSE)
- Має зручні одиниці виміру (як MAE)
import numpy as np

price_real = np.array([24500, 39800, 59200])
price_pred = np.array([25000, 40000, 60000])

residuals = price_real - price_pred

# MSE
mse = np.mean(residuals ** 2)

# RMSE: корінь з MSE
rmse = np.sqrt(mse)

print(f"MSE  = {mse:.2f}$²")
print(f"RMSE = {rmse:.2f}$ ← зручніше для інтерпретації!")
print(f"\nПорівняння:")
print(f"  MAE  = {np.mean(np.abs(residuals)):.2f}$ (не штрафує великі помилки)")
print(f"  RMSE = {rmse:.2f}$ (штрафує великі помилки)")
MSE = 310000.00$² RMSE = 556.78$ ← зручніше для інтерпретації!
Порівняння: MAE = 500.00$ (не штрафує великі помилки) RMSE = 556.78$ (штрафує великі помилки)
- MAE: коли всі помилки рівноцінні (наприклад, передбачення температури)
- RMSE: коли великі помилки критичні (наприклад, медична діагностика — краще 10 разів помилитися на 1%, ніж 1 раз на 50%)
Наскрізний числовий розрахунок: порівняння трьох метрик
Щоб остаточно закріпити математичну різницю між метриками, виконаємо покроковий розрахунок вручну для репрезентативної вибірки з 5 квартир:
| № | Реальна ціна (Завантаження...) | Прогноз моделі (Завантаження...) | Залишок (Завантаження...) | Модуль (Завантаження...) | Квадрат (Завантаження...) |
|---|---|---|---|---|---|
| 1 | 50 000 $ | 48 000 $ | +2 000 $ | 2 000 $ | 4 000 000 $² |
| 2 | 62 000 $ | 65 000 $ | −3 000 $ | 3 000 $ | 9 000 000 $² |
| 3 | 75 000 $ | 74 000 $ | +1 000 $ | 1 000 $ | 1 000 000 $² |
| 4 | 88 000 $ | 90 000 $ | −2 000 $ | 2 000 $ | 4 000 000 $² |
| 5 | 95 000 $ | 93 000 $ | +2 000 $ | 2 000 $ | 4 000 000 $² |
| Σ | — | — | — | 10 000 $ | 22 000 000 $² |
Обчислимо кожну метрику поетапно:
- Середня абсолютна помилка (MAE):Завантаження...
Зміст: у середньому розрахунки моделі відхиляються від реальної ринкової ціни рівно на 2000 $. - Середня квадратична помилка (MSE):Завантаження...
Зміст: значення в доларах у квадраті слугує аналітичною цільовою функцією для диференціювання в алгоритмах оптимізації. - Корінь із середньої квадратичної помилки (RMSE):Завантаження...
Зверніть увагу: у спостереженні №2 похибка становить 3000 $. У формулі MSE вона підноситься до квадрата і перетворюється на 9 000 000, що помітно збільшує підсумкове середнє значення кореня. Якби всі залишки були однаковими за модулем, то Завантаження.... Перевищення RMSE над MAE сигналізує аналітику про наявність великих поодиноких похибок у моделі.
Чутливість до викидів: порівняння стійкості MAE та MSE
У практичній інженерії даних датасети рідко бувають стерильними. Вони майже завжди містять викиди (outliers) — поодинокі аномальні спостереження, спричинені збоями сенсорів, друкарськими помилками оператора або специфічними ексклюзивними об'єктами (наприклад, розкішний пентхаус серед звичайних квартир).
Вибір між MAE та MSE кардинально змінює поведінку лінії регресії за наявності таких аномалій:
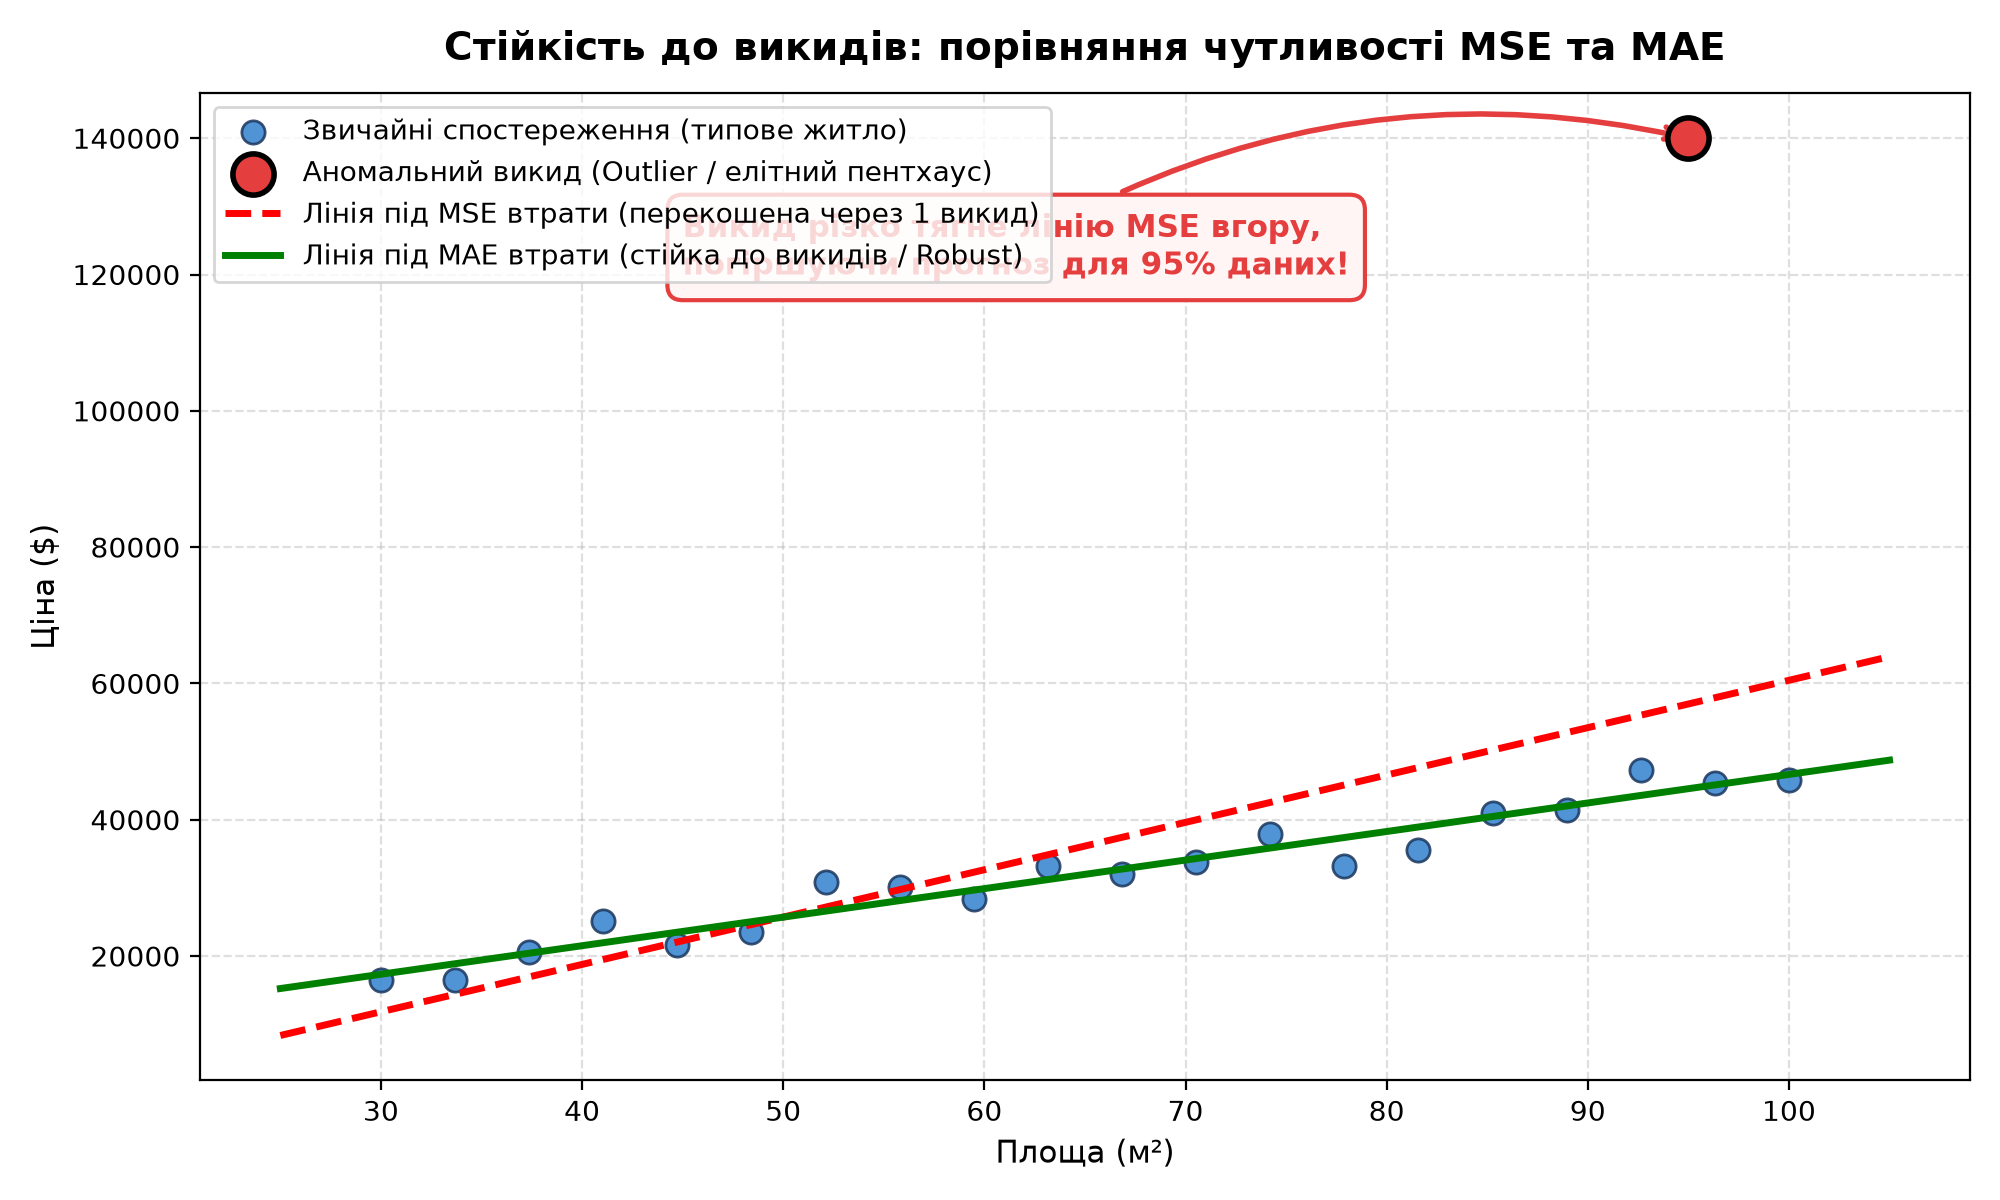
Анатомія геометричного конфлікту:
- Чому MSE «ламається» через один викид:
- Для аномальної точки відхилення є велетенським: Завантаження... $.
- У формулі MSE це число підноситься до квадрата: Завантаження....
- Цей єдиний доданок домінує над сумою похибок усіх інших 20 квартир разом узятих! Щоб зменшити цей гігантський штраф, алгоритм круто розвертає пряму вгору в бік викиду. Як результат — модель починає грубо завищувати оцінку для 95% звичайних типових квартир.
- Чому MAE є робастною (стійкою) метрикою:
- Формула MAE бере абсолютне значення Завантаження.... Штраф за відхилення зростає суто лінійно, а не квадратично.
- Один віддалений викид додає до загальної суми рівно свою фізичну відстань, не змушуючи лінію відхилятися від основного щільного кластера даних.
- Лінійна регресія, оптимізована за MAE (LAD — Least Absolute Deviations), зберігає об'єктивність для абсолютної більшості типових об'єктів.
- Якщо дані містять шум, рідкісні сплески або помилки вимірювання — використовуйте MAE або робастні втрати (Huber Loss).
- Якщо кожен промах є неприпустимим за регламентом безпеки (наприклад, аварійні перевантаження енергомережі чи дозування ліків) — використовуйте MSE / RMSE.
Метрика 4: R² (Coefficient of Determination)
Усі попередні метрики мали спільну проблему: немає верхньої межі. MAE може бути 100, 1000, 10 000 — що вважати «добре»?
R² (R-squared, коефіцієнт детермінації) вирішує цю проблему: він завжди від 0 до 1 (технічно може бути й негативним, але це рідкість).
Формула
де:
- SSᵣₑₛ (Завантаження..., Residual Sum of Squares) — сума квадратів залишків моделі
- SSₜₒₜ (Завантаження..., Total Sum of Squares) — сума квадратів відхилень від середнього
Інтуїція
Коефіцієнт детермінації Завантаження... відповідає на ключове питання: «Яку частку загального розкиду (варіативності) даних зуміла пояснити наша модель?»
В основі інтуїції цієї метрики лежить розклад повної дисперсії цільової змінної на два взаємодоповнюючі компоненти:
- Загальна варіація даних (Завантаження...): відображає сумарний природний розкид реальних значень Завантаження... відносно вибіркового середнього Завантаження.... Це базова помилка найпримітивнішої константної стратегії, коли для будь-якої квартири ми просто називаємо середню ціну на ринку.
- Пояснена варіація (Завантаження..., Regression Sum of Squares): та частина цінових коливань, яку модель успішно пов'язала зі зміною вхідної ознаки (наприклад, зростання вартості суворо через збільшення площі).
- Непояснена залишковий розкид (Завантаження..., Residual Sum of Squares): накопичена похибка прогнозу моделі, зумовлена шумом у даних, неврахованими прихованими факторами (ремонт, поверх, локація) або нелінійними ефектами.
Звідси частка Завантаження... показує, який відсоток розкиду залишився для моделі «сліпою зоною». Віднімаючи цю величину від одиниці, ми отримуємо значення Завантаження...: чим ближче воно до 1, тим повніше лінійна пряма описує структуру вибірки.
Інтерпретація значень R²:
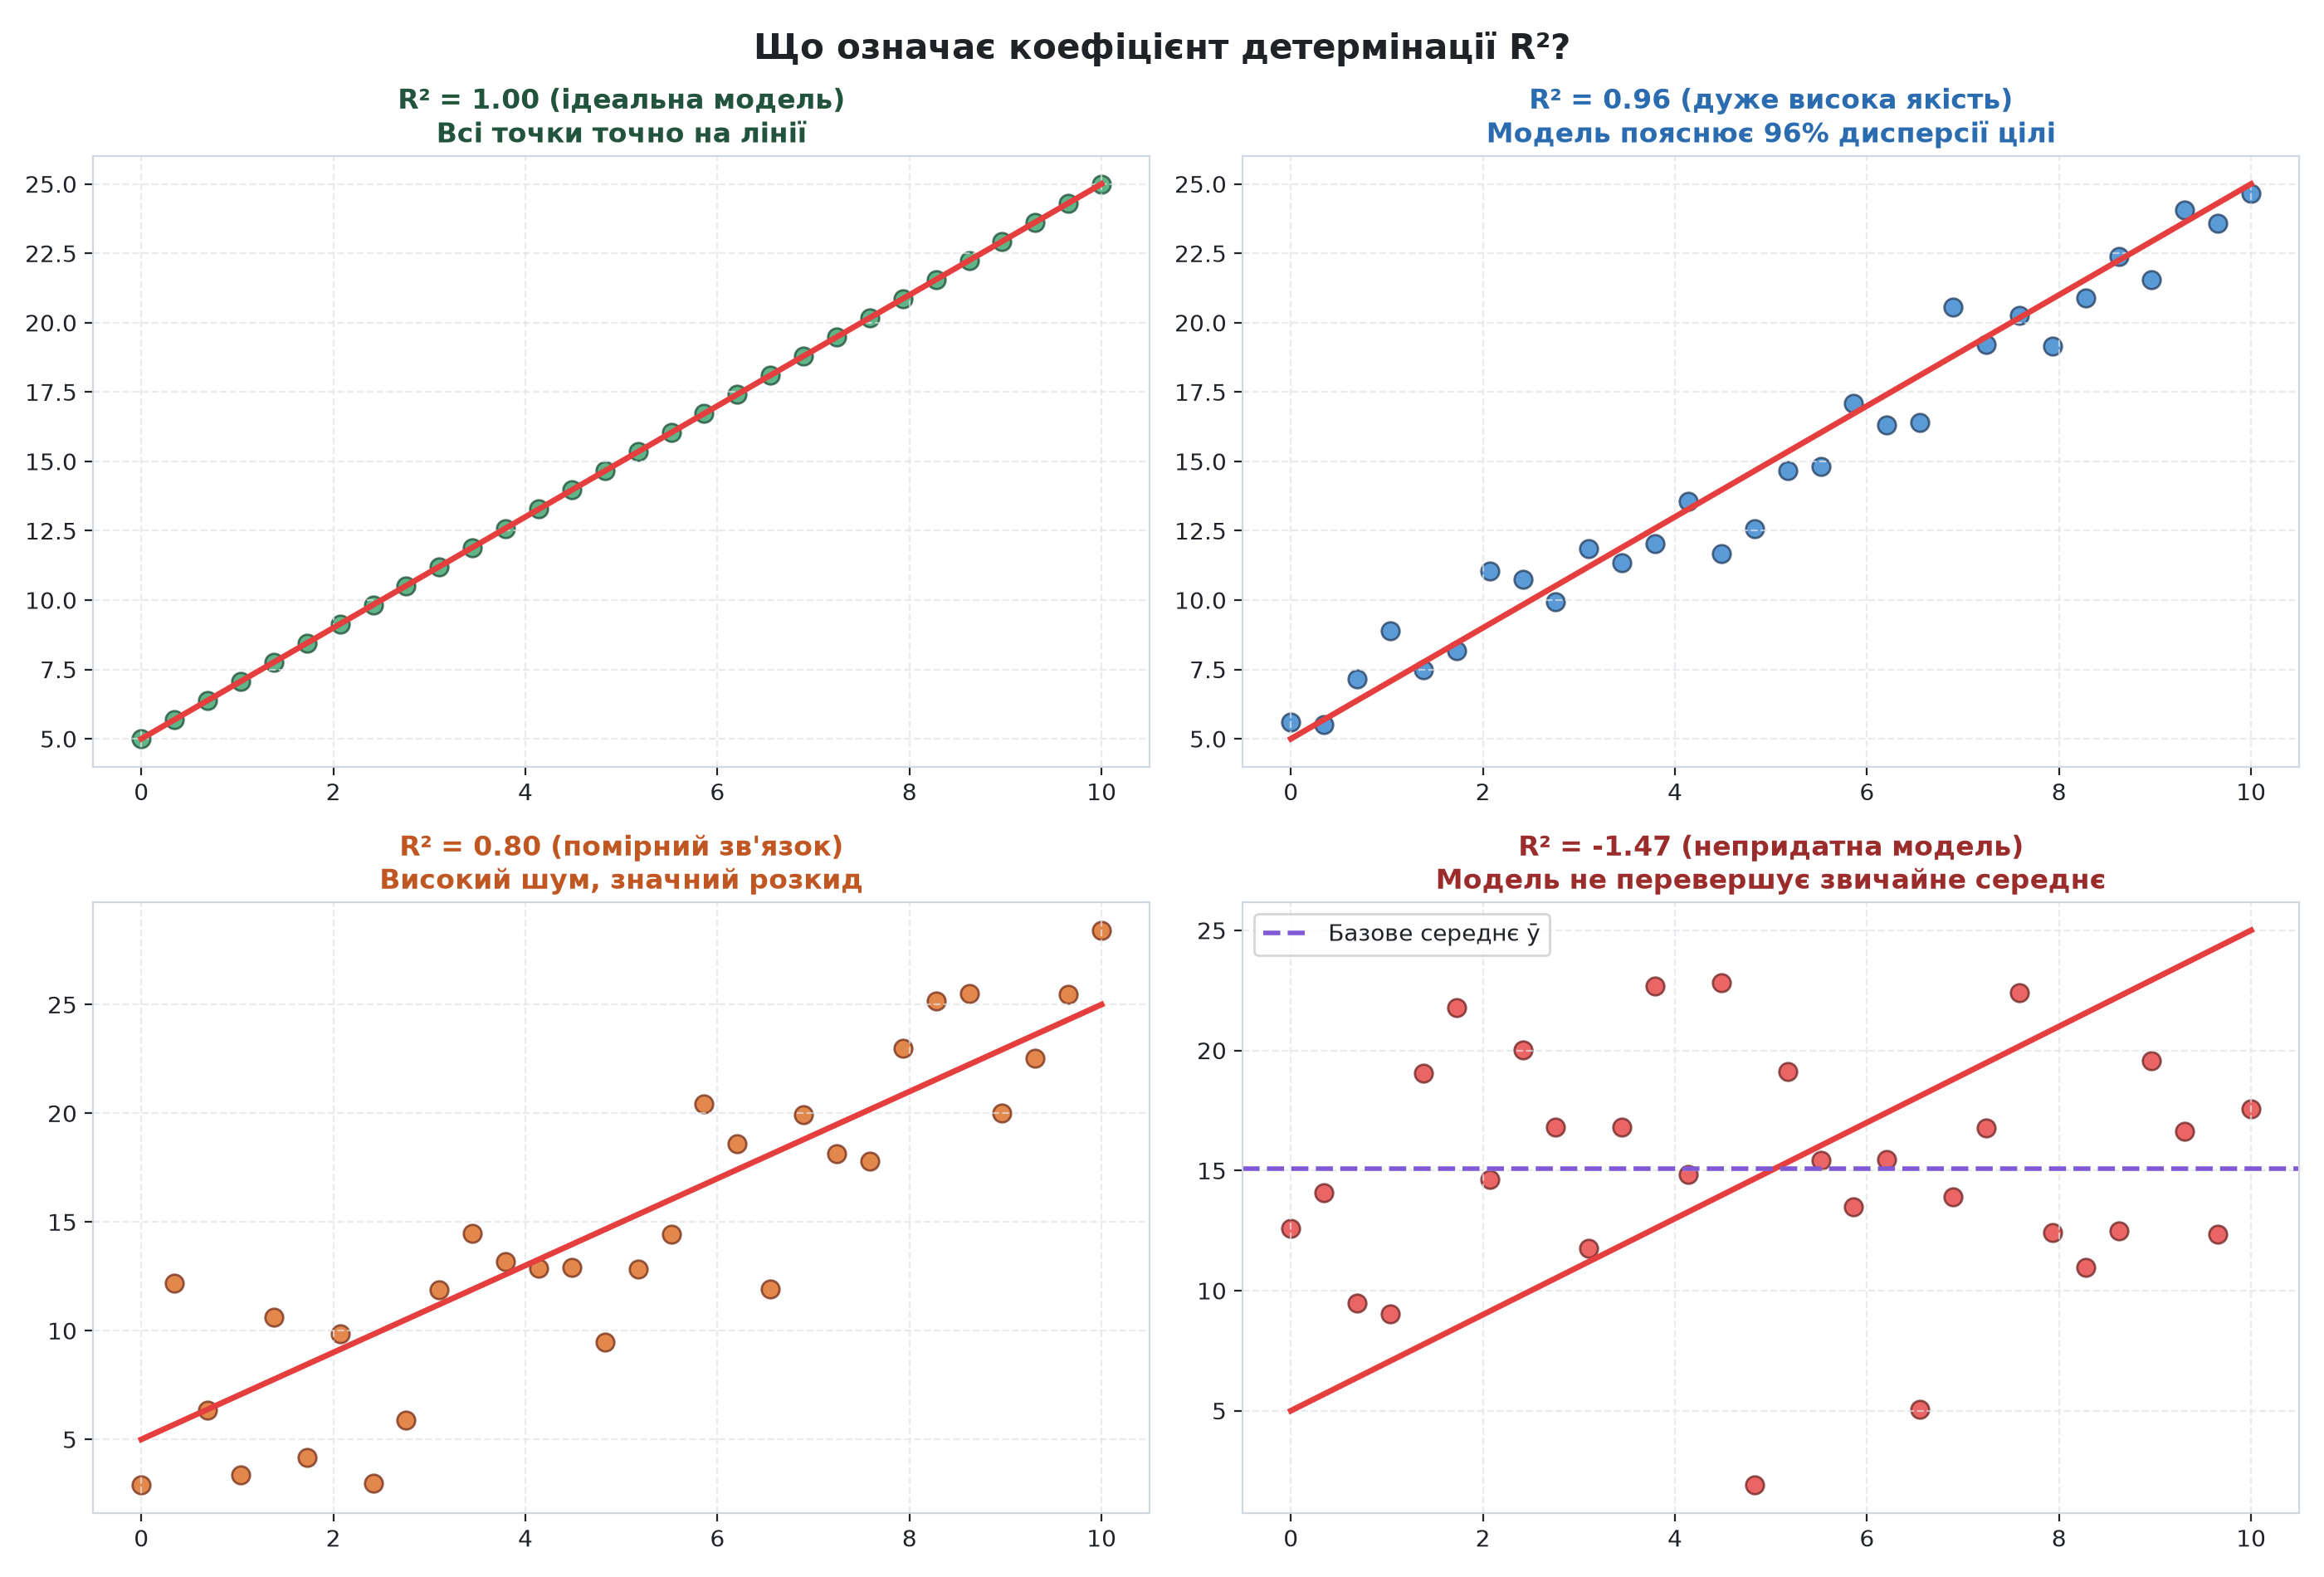
Для глибокого розуміння фізичного змісту коефіцієнта детермінації проаналізуємо чотири типові сценарії, проілюстровані на графіку вище:
- Ідеальна апроксимація (Завантаження...):
- Усі точки вибірки суворо лежать на розрахунковій прямій.
- Залишки тотожно дорівнюють нулю (Завантаження...), модель пояснює 100% дисперсії цільової змінної.
- У практичних інженерних задачах такий результат зазвичай свідчить про штучні дані або критичне перенавчання (data leakage / overfitting).
- Висока прогностична якість (Завантаження...):
- Більшість точок групуються щільно вздовж лінії регресії.
- Модель впевнено пояснює 90% варіативності ціни, а залишковий розкид у 10% пояснюється неврахованими випадковими шумами середовища.
- Помірний взаємозв'язок (Завантаження...):
- Загальний лінійний тренд усе ще вгадується, проте варіація залишків є значною.
- Модель здатна давати лише приблизні орієнтири; для підвищення якості необхідно залучати додаткові інформативні ознаки (наприклад, стан ремонту або поверх).
- Непридатна модель (Завантаження...):
- Точки розкидані хаотичною хмарою навколо лінії.
- Регресійна пряма не перевершує тривіальний прогноз константним середнім значенням вибірки Завантаження.... Лінійного зв'язку між ознакою та ціллю немає.
| R² | Інтерпретація | Якість моделі |
|---|---|---|
| 1.0 | Модель ідеально описує дані (усі точки на прямій) | Ідеальна (можливе перенавчання) |
| 0.9 | 90% варіації пояснено моделлю | Відмінна |
| 0.7 | 70% варіації пояснено | Хороша |
| 0.5 | 50% варіації пояснено | Посередня |
| 0.0 | Модель не краща за «середнє значення» | Погана |
| < 0 | Модель гірша за просте середнє | Катастрофічна |
Уявіть, що ви намагаєтеся пояснити, чому абітурієнт обрав саме цю спеціальність:
- Завантаження... (90%): Це означає, що 90% вибору професії повністю пояснюється рівнем заробітної плати (єдиний фактор у нашій моделі), і лише 10% припадає на інші невраховані обставини (порада батьків, престиж, локація).
- Завантаження... (10%): Лише 10% вибору залежить від зарплати, а 90% рішень зумовлено іншими прихованими факторами, яких немає в нашій таблиці.
- Завантаження... (0%): Модель не розумніша за банальну стратегію «вгадуй найпопулярнішу відповідь більшості» (прогнозування константного середнього Завантаження...).
Це означає, що наша навчена модель не краща за примітивну константну стратегію «завжди прогнозуй середнє арифметичне Завантаження...». Якщо ж Завантаження..., модель прогнозує настільки некоректно, що її похибка навіть перевищує дисперсію вихідних даних!
Приклад обчислення
import numpy as np

price_real = np.array([24500, 39800, 59200])
price_pred = np.array([25000, 40000, 60000])

# Середнє значення реальних цін
y_mean = np.mean(price_real)

# SS_res: сума квадратів залишків (residuals)
ss_res = np.sum((price_real - price_pred) ** 2)

# SS_tot: сума квадратів відхилень від середнього
ss_tot = np.sum((price_real - y_mean) ** 2)

# R²
r2 = 1 - (ss_res / ss_tot)

print(f"Середнє значення y: {y_mean:.2f}$")
print(f"\nSS_res (помилки моделі): {ss_res:.2f}")
print(f"SS_tot (варіація даних): {ss_tot:.2f}")
print(f"\nR² = 1 - {ss_res:.0f} / {ss_tot:.0f} = {r2:.4f}")
print(f"\nІнтерпретація: модель пояснює {r2*100:.2f}% варіації даних")
Середнє значення y: 41166.67$
SS_res (помилки моделі): 930000.00 SS_tot (варіація даних): 718433333.33
R² = 1 - 930000 / 718433333 = 0.9987
Інтерпретація: модель пояснює 99.87% варіації даних
Висновок: R² = 0.9987 — це відмінний результат! Модель майже ідеально описує залежність між площею та ціною.
У реальних задачах R² > 0.8 вже вважається дуже добрим результатом.
Порівняльна таблиця метрик
| Метрика | Формула | Одиниці | Діапазон | Переваги | Недоліки |
|---|---|---|---|---|---|
| MAE | Завантаження... | Ті ж, що y | [0, +∞) | Проста інтерпретація, стійка до викидів | Не штрафує великі помилки |
| MSE | Завантаження... | y² | [0, +∞) | Диференційована (для оптимізації) | Незручні одиниці (квадрати) |
| RMSE | Завантаження... | Ті ж, що y | [0, +∞) | Штрафує великі помилки + зручні одиниці | Складніша для інтерпретації |
| R² | Завантаження... | — | (−∞, 1] | Нормалізована (0–1), порівнянна між задачами | Може бути оманливою при малих даних |
Використовуйте кілька метрик одночасно. Наприклад:
- R² для загальної оцінки якості
- RMSE для розуміння масштабу помилок
- MAE для бізнес-комунікації (легше пояснити керівництву)
Реалізація всіх метрик на Python
import numpy as np

def calculate_metrics(y_true, y_pred):
    """
    Обчислює всі метрики якості регресії.

    Параметри:
        y_true: np.array — реальні значення
        y_pred: np.array — передбачення моделі

    Повертає:
        dict з метриками MAE, MSE, RMSE, R²
    """
    # Залишки
    residuals = y_true - y_pred

    # MAE
    mae = np.mean(np.abs(residuals))

    # MSE
    mse = np.mean(residuals ** 2)

    # RMSE
    rmse = np.sqrt(mse)

    # R²
    ss_res = np.sum(residuals ** 2)
    ss_tot = np.sum((y_true - np.mean(y_true)) ** 2)
    r2 = 1 - (ss_res / ss_tot)

    return {
        'MAE': mae,
        'MSE': mse,
        'RMSE': rmse,
        'R²': r2
    }

# Тест на наших даних
y_true = np.array([24500, 39800, 59200, 42000, 51500])
y_pred = np.array([25000, 40000, 60000, 41500, 52000])

metrics = calculate_metrics(y_true, y_pred)

print("Метрики якості моделі:")
print("=" * 40)
for name, value in metrics.items():
    if name == 'R²':
        print(f"{name:6} = {value:.4f} ({value*100:.2f}%)")
    else:
        print(f"{name:6} = ${value:,.2f}")
Метрики якості моделі:
MAE = $420.00 MSE = $250,000.00 RMSE = $500.00 R² = 0.9996 (99.96%)
Використання scikit-learn
У реальних проєктах не треба писати функції вручну — є готові реалізації в scikit-learn:
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score
import numpy as np

y_true = np.array([24500, 39800, 59200, 42000, 51500])
y_pred = np.array([25000, 40000, 60000, 41500, 52000])

mae = mean_absolute_error(y_true, y_pred)
mse = mean_squared_error(y_true, y_pred)
rmse = np.sqrt(mse)  # або mean_squared_error(y_true, y_pred, squared=False)
r2 = r2_score(y_true, y_pred)

print(f"MAE  = ${mae:,.2f}")
print(f"MSE  = ${mse:,.2f}")
print(f"RMSE = ${rmse:,.2f}")
print(f"R²   = {r2:.4f}")
Резюме підрозділу
✅ Ключові висновки
- MAE — середня абсолютна помилка, проста інтерпретація
- MSE — середня квадратична помилка, штрафує великі помилки
- RMSE — корінь з MSE, зручні одиниці виміру
- R² — частка поясненої варіації, нормалізована метрика (0–1)
- Завжди використовуйте кілька метрик для повної картини
🔜 Наступний крок
Тепер ми знаємо, як оцінити якість моделі. Але головне питання залишається: як знайти оптимальні параметри w та b?
Наступний підрозділ: Градієнтний спуск — алгоритм навчання моделі
Регресійна задача та лінійна регресія з однією змінною
Що таке регресія, чим вона відрізняється від класифікації, рівняння прямої та перша модель передбачення ціни квартири
Градієнтний спуск — як модель навчається
Функція втрат, локальний та глобальний мінімум, похідна та градієнт, алгоритм градієнтного спуску, learning rate