Регресійна задача та лінійна регресія з однією змінною
Регресійна задача та лінійна регресія з однією змінною
🎯 Мета підрозділу
- Зрозуміти різницю між регресією та класифікацією
- Опанувати поняття лінійної регресії з однією змінною
- Познайомитися з рівнянням прямої Завантаження...
- Навчитися інтерпретувати параметри Завантаження... (нахил) та Завантаження... (зсув)
🔑 Ключові терміни
- Регресія (regression) — передбачення неперервного числового значення
- Класифікація (classification) — передбачення категорії
- Лінійна регресія (linear regression) — модель залежності у вигляді прямої
- w (weight) — коефіцієнт нахилу прямої (Завантаження...)
- b (bias) — вільний член, зсув по осі Завантаження... (Завантаження...)
Історія про рієлтора, який хоче передбачати ціни
Олена працює рієлтором уже п'ять років. Щодня їй телефонують клієнти з питаннями: «У мене квартира 50 квадратних метрів у центрі міста — скільки вона може коштувати?» або «Хочу продати трикімнатну квартиру на 7 поверсі — яку ціну виставити?»
Зараз Олена відповідає інтуїтивно, «на око», спираючись на свій багатий досвід. Але такий підхід має недоліки:
- Неточність: інтуїція може помилятися, особливо для нестандартних квартир
- Повільність: треба згадати подібні угоди, прикинути поправки
- Немасштабованість: Олена не може обробити 100 запитів за годину
Але у неї є скарб — база даних за минулий рік: площа та ціна 100 проданих квартир. Чи можна використати ці дані, щоб формалізувати залежність математично? Щоб комп'ютер миттєво видавав відповідь для будь-якої площі?
Що таке регресійна задача?
Перед тим як розібратися з конкретним алгоритмом, потрібно зрозуміти, до якого класу задач належить наша проблема.
Регресія (regression) — це тип завдання машинного навчання, де потрібно передбачити неперервне числове значення на основі вхідних ознак.
Приклади регресійних задач
| Вхідні ознаки | Цільова змінна (що передбачаємо) | Тип задачі |
|---|---|---|
| Площа квартири (м²) | Ціна ($) | Регресія |
| Стаж роботи (роки), освіта, місто | Зарплата ($) | Регресія |
| Температура, вологість, опади | Врожай пшениці (тонн/га) | Регресія |
| Кількість кімнат, поверх, район | Вартість оренди ($/місяць) | Регресія |
| Пробіг автомобіля (км), рік випуску | Ціна автомобіля ($) | Регресія |
Регресія vs Класифікація
Студенти часто плутають ці два фундаментальні типи задач машинного навчання з учителем (supervised learning). Головна відмінність полягає у природі цільової змінної Завантаження...: чи є вона неперервною числовою величиною, чи належить до фіксованої дискретної множини класів.
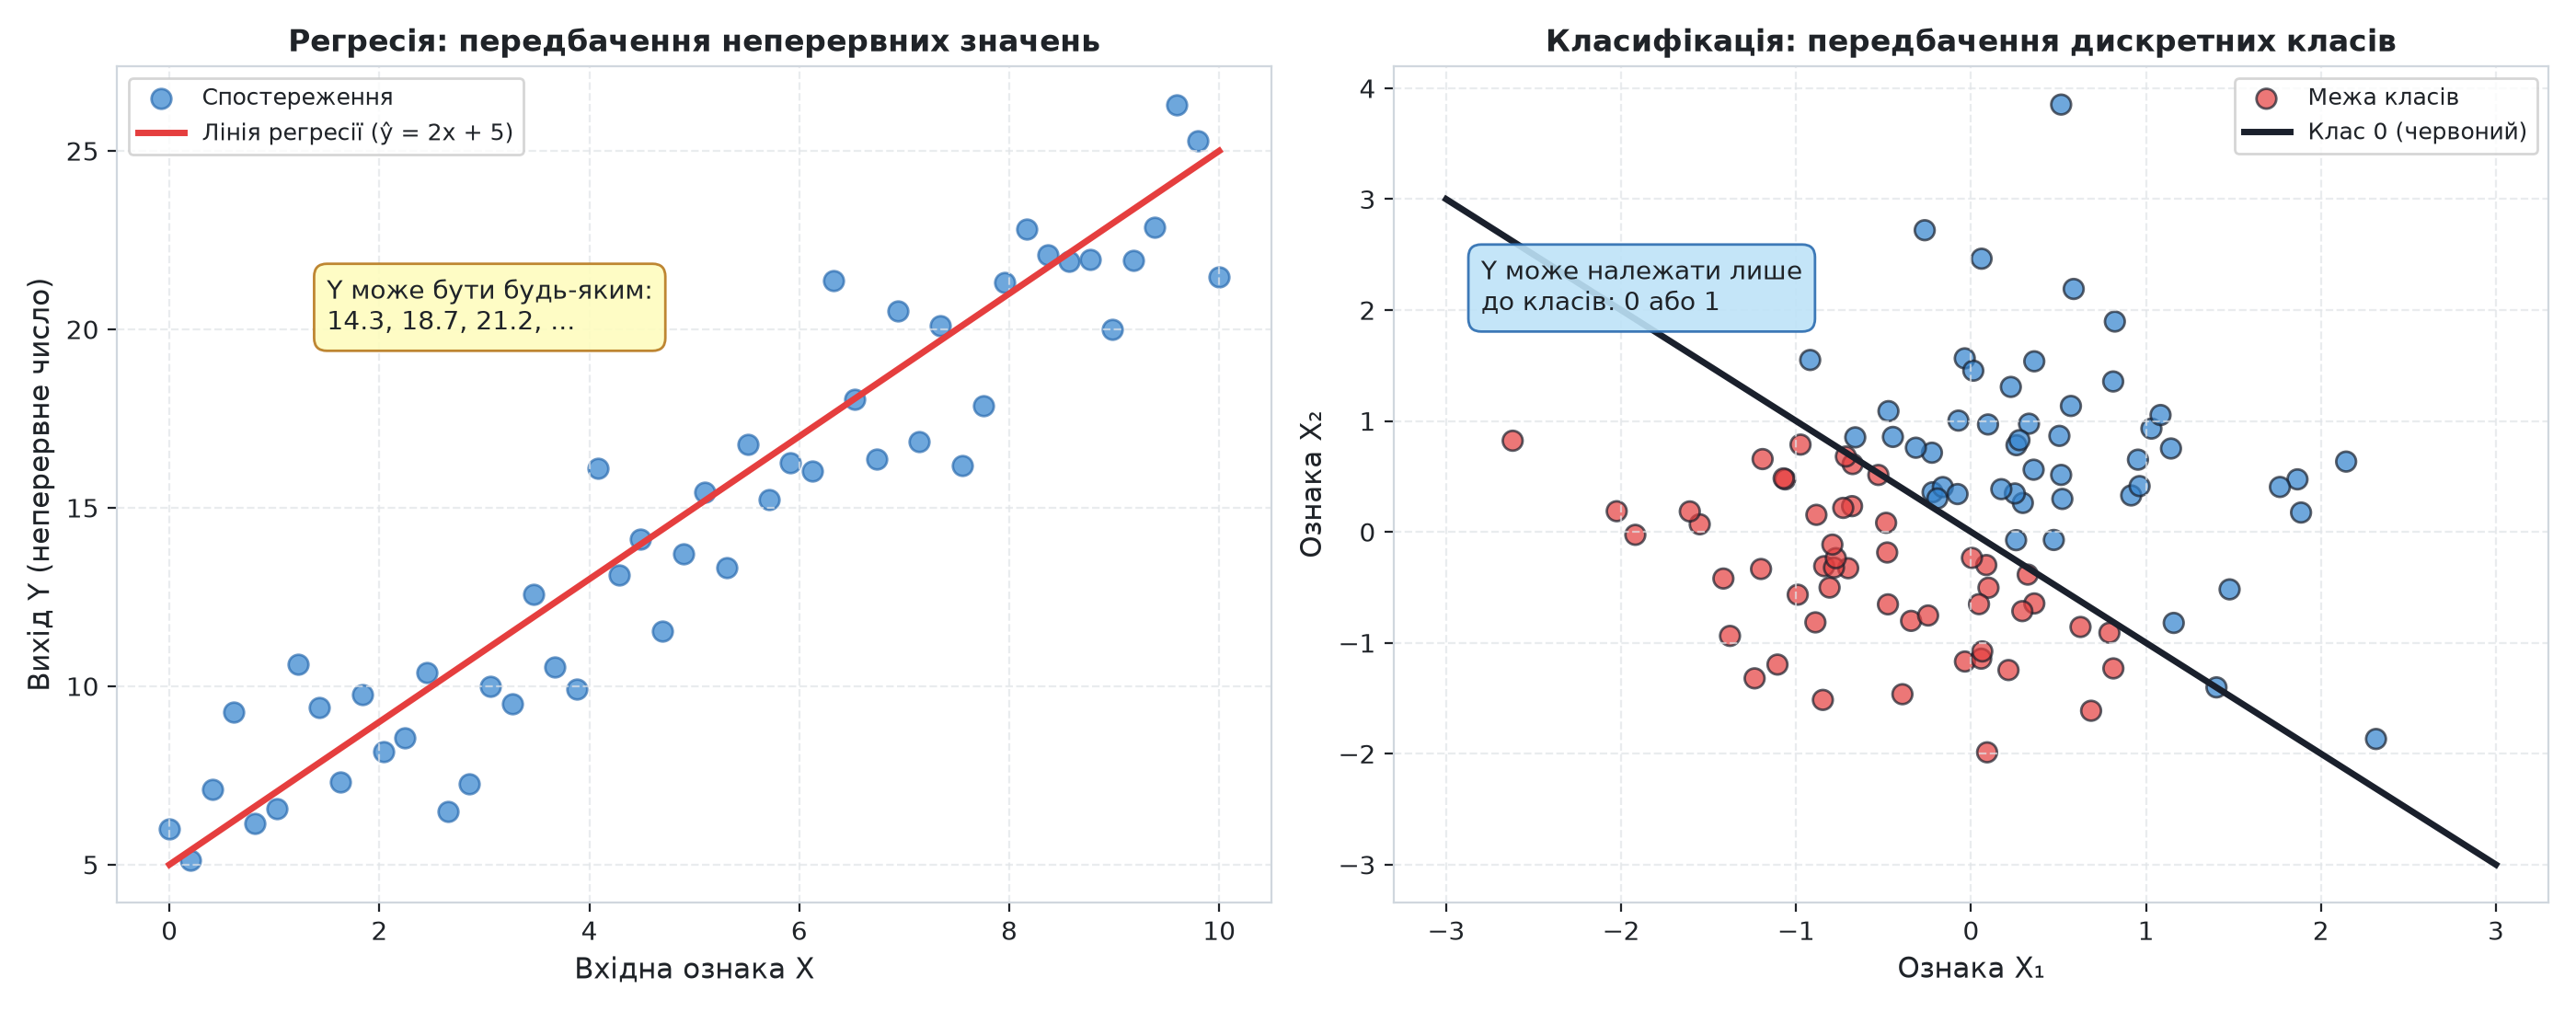
У задачі регресії ми шукаємо неперервну математичну функцію Завантаження..., яка проходить якомога ближче до точок у просторі спостережень. Прогноз моделі — це число (наприклад, 18.7 або 21.2). У задачі класифікації мета зовсім інша — знайти розділову межу (decision boundary), яка розділяє простір ознак на ізольовані регіони, що відповідають окремим класам (0 або 1).
# Передбачаємо ЧИСЛО
def predict_blood_pressure(age, weight, height):
    """
    Вхід: вік, вага, зріст
    Вихід: артеріальний тиск (число, наприклад 120.5 мм рт.ст.)
    """
    return model.predict([age, weight, height])

# Приклад виводу
>>> predict_blood_pressure(45, 80, 175)
122.3  # неперервне число
# Передбачаємо КАТЕГОРІЮ
def diagnose_disease(symptoms, test_results):
    """
    Вхід: симптоми, результати аналізів
    Вихід: діагноз (категорія: "здоровий" / "застуда" / "грип")
    """
    return model.predict([symptoms, test_results])

# Приклад виводу
>>> diagnose_disease(['кашель', 'температура'], [98.6, 'positive'])
"грип"  # одна з фіксованих категорій
Порівняльна таблиця:
| Характеристика | Регресія | Класифікація |
|---|---|---|
| Що передбачаємо? | Число (неперервне) | Категорію (дискретну) |
| Приклад виводу | 45 123.50 $ | "spam" / "не spam" |
| Діапазон значень | Безмежний (або великий) | Фіксована кількість класів |
| Метрики якості | MAE, MSE, R² | Accuracy, Precision, Recall |
| Приклади алгоритмів | Лінійна регресія, Ridge, Lasso | Логістична регресія, SVM |
- Регресія — це термометр: показує точне неперервне число на шкалі (Завантаження..., Завантаження..., Завантаження...).
- Класифікація — це світлофор: обирає один із кількох фіксованих дискретних станів (червоний, жовтий або зелений).
Типологія регресійних моделей у машинному навчанні
Залежно від кількості вхідних факторів та характеру фізичних взаємозв'язків у даних, у математичному моделюванні виділяють кілька фундаментальних класів регресійних моделей.
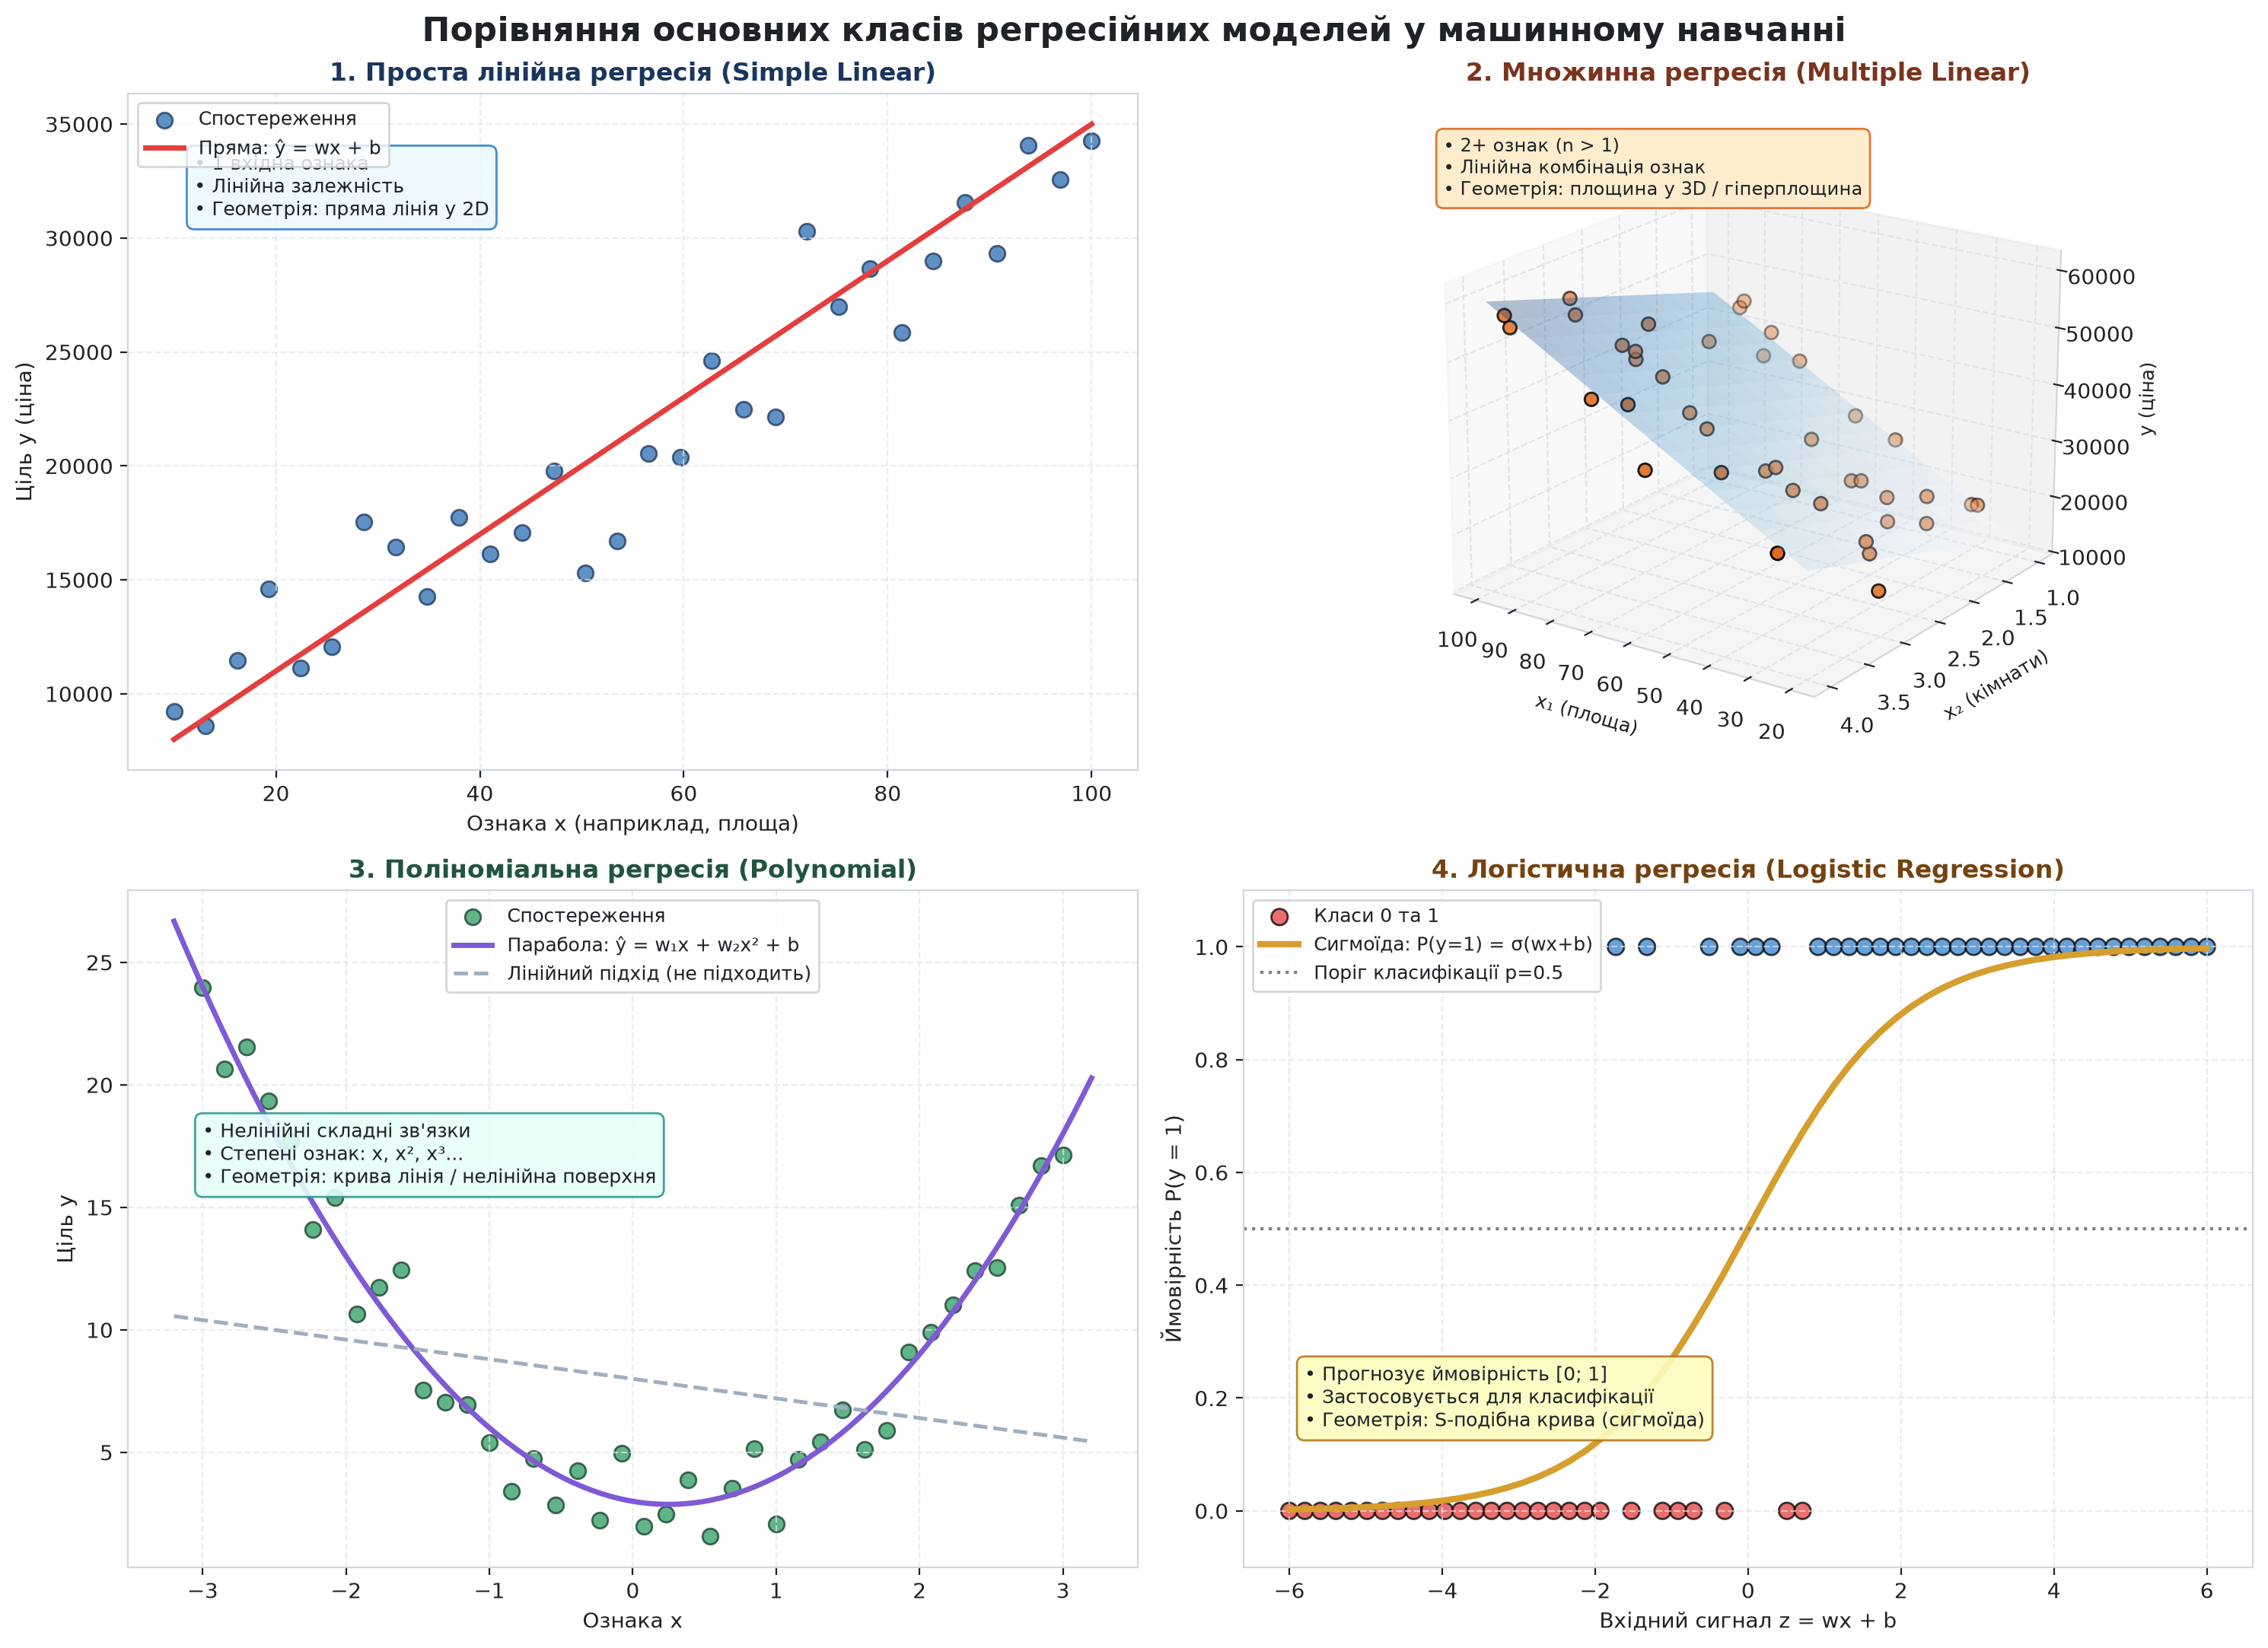
Розглянемо базові відмінності між ними:
- Проста лінійна регресія (Simple Linear Regression):
- Моделює залежність між однією вхідною ознакою Завантаження... та цільовою змінною Завантаження....
- Формула: Завантаження....
- Геометрична форма: пряма лінія у двовимірному просторі.
- Приклад: залежність вартості житла суто від площі.
- Множинна лінійна регресія (Multiple Linear Regression):
- Узагальнює задачу на випадок Завантаження... взаємопов'язаних факторів (Завантаження...).
- Формула: Завантаження....
- Геометрична форма: гіперплощина у багатовимірному просторі (для двох ознак — похила площина у 3D).
- Приклад: прогнозування ціни за площею, кількістю кімнат, поверхом та відстанню до метро.
- Поліноміальна регресія (Polynomial Regression):
- Застосовується, коли емпіричні спостереження демонструють виражену кривизну (прискорення, насичення або параболічний спад).
- Формула: Завантаження....
- Зберігає лінійність відносно ваг Завантаження..., але додає нелінійні степені вхідних факторів.
- Логістична регресія (Logistic Regression):
- Пропускає лінійну комбінацію через сигмоїдну функцію активації Завантаження..., перетворюючи будь-яке дійсне число на ймовірність від 0 до 1.
- Використовується для задач бінарної та багатокласової класифікації.
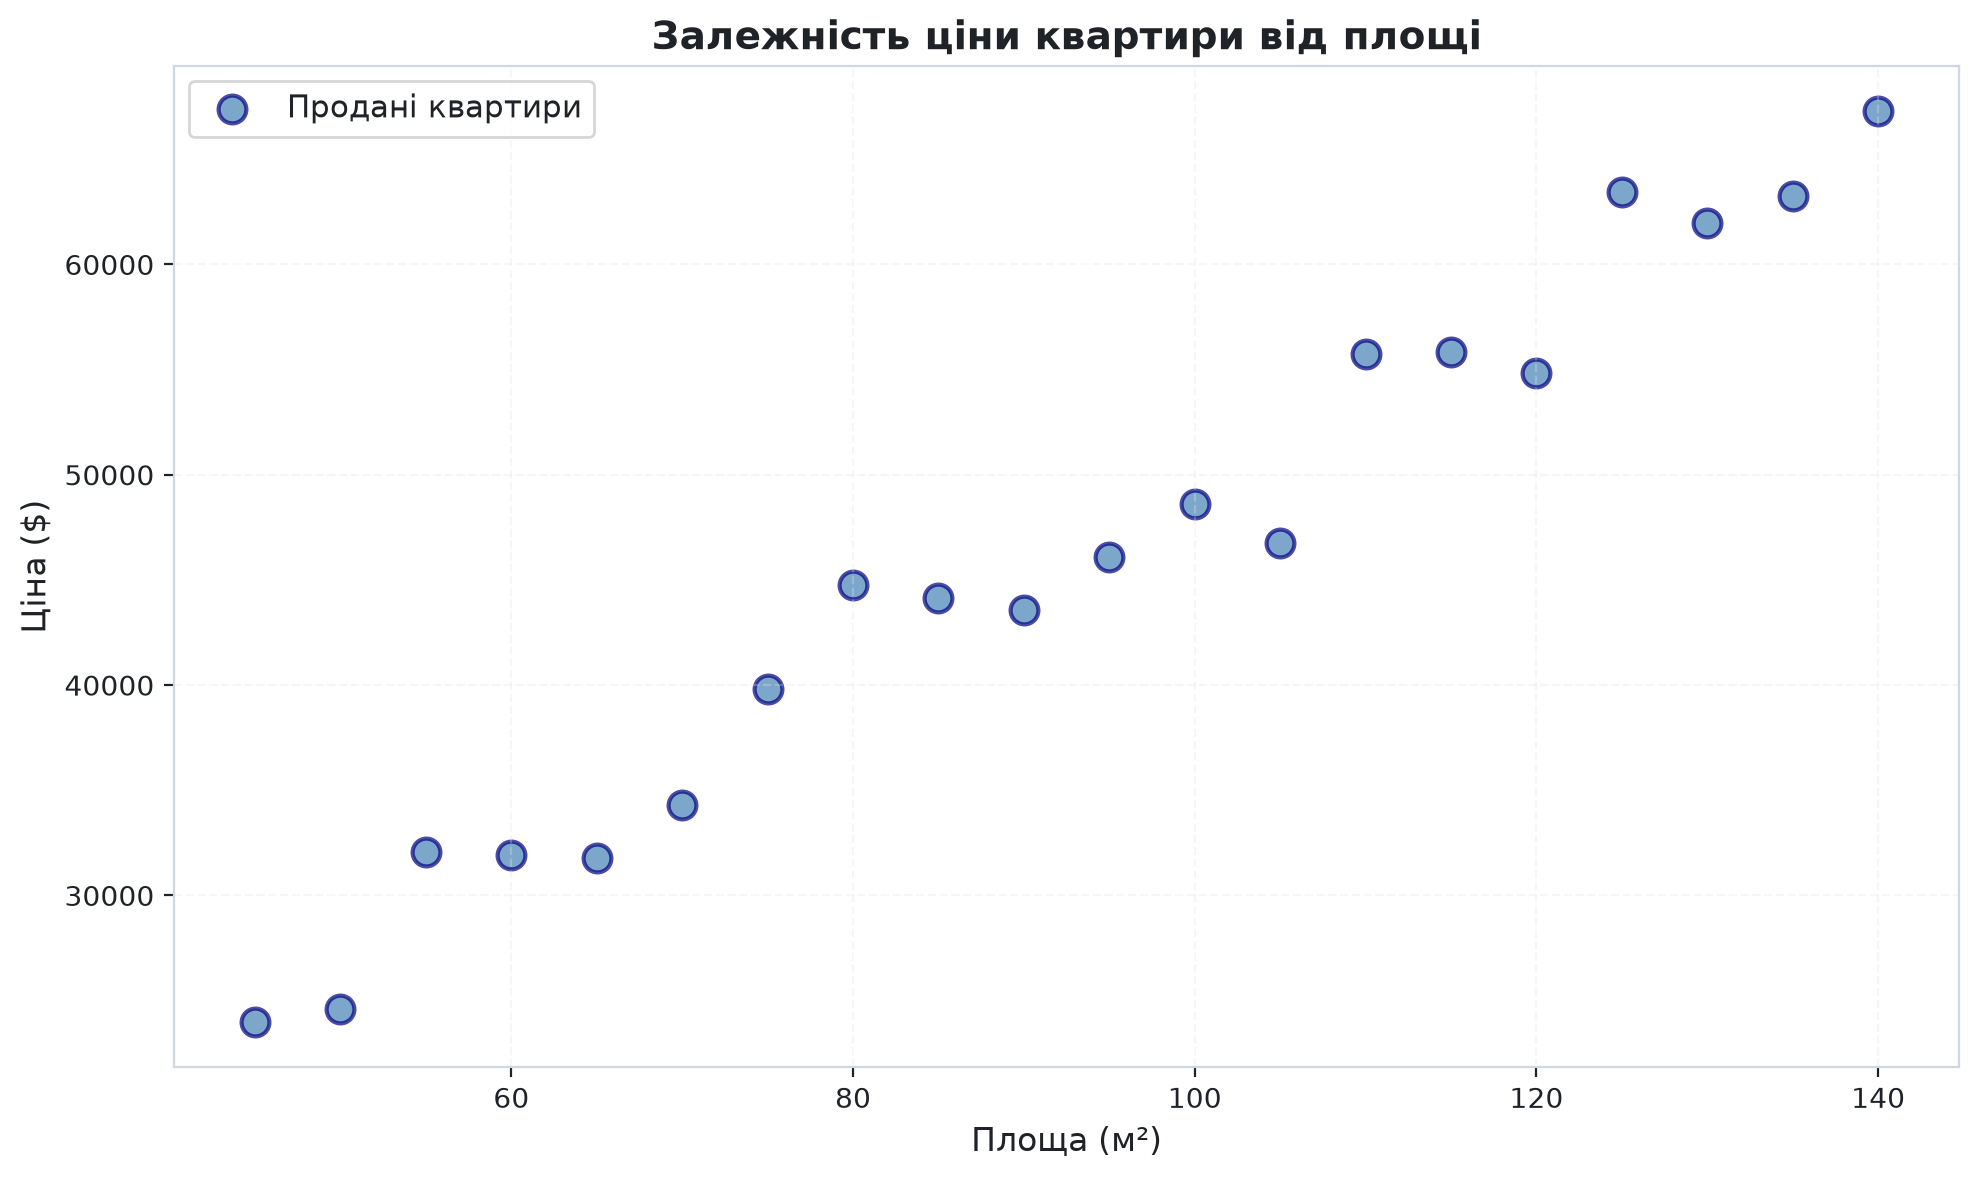
Візуалізація проблеми: який паттерн у даних?
Повернемося до задачі Олени. Завантажимо дані та подивимося на них.
import numpy as np
import matplotlib.pyplot as plt

# Генеруємо синтетичні дані (імітація бази Олени)
rng = np.random.default_rng(seed=42)
area = np.array([45, 50, 60, 55, 70, 65, 80, 75, 90, 85,
                 100, 95, 110, 105, 120, 115, 130, 125, 140, 135])
# Справжня залежність: ціна ≈ 500$/м² + випадковий шум
price = 500 * area + rng.normal(0, 3000, 20)

print(f"Кількість спостережень: {len(area)}")
print(f"Діапазон площ: {area.min()} — {area.max()} м²")
print(f"Діапазон цін: ${price.min():.0f} — ${price.max():.0f}")
# Побудуємо scatter plot (точкову діаграму)
fig, ax = plt.subplots(figsize=(10, 6))

ax.scatter(area, price, s=100, alpha=0.7, color="steelblue",
           edgecolor="navy", linewidth=1.5, label="Продані квартири")

ax.set_title("Залежність ціни квартири від площі",
             fontsize=14, fontweight="bold")
ax.set_xlabel("Площа (м²)", fontsize=12)
ax.set_ylabel("Ціна ($)", fontsize=12)
ax.grid(True, alpha=0.3)
ax.legend(fontsize=11)

plt.tight_layout()
plt.show()
- Особливості конкретної квартири (стан ремонту, вид з вікна)
- Помилки вимірювання
- Фактори, які ми не врахували (район, поверх, наявність балкона)
Рівняння прямої: математична основа лінійної регресії
Якщо залежність лінійна, її можна описати рівнянням прямої зі шкільного курсу алгебри:
Розшифруємо кожен символ:
| Символ | Назва | Що означає |
|---|---|---|
| Завантаження... | Вхідна ознака (feature) | Площа квартири (м²) — те, що ми знаємо |
| Завантаження... | Передбачення (prediction) | Ціна, яку передбачає модель ($) |
| Завантаження... | Вага, коефіцієнт нахилу (weight) | На скільки зростає ціна при збільшенні площі на 1 м² |
| Завантаження... | Зсув, вільний член (bias) | Базова ціна при площі = 0 (теоретичне значення) |
Рівняння лінійної регресії влаштоване точнісінько як рахунок за мобільний зв'язок або оплата поїздки в таксі:
- Завантаження... (зсув / bias) — це абонентська плата (або посадка в авто). Її сплачують обов'язково, навіть якщо за місяць виговорили 0 хвилин чи взагалі не рушили з місця (Завантаження...).
- Завантаження... (нахил / weight) — це тариф за кожну хвилину (або ціна за 1 км шляху). Визначає, на скільки зростає сума з кожною одиницею послуги.
- Завантаження... — це підсумковий чек за місяць.
Геометрична інтерпретація параметрів
Параметри Завантаження... та Завантаження... мають прозорий геометричний зміст, що визначає орієнтацію та положення регресійної прямої на декартовій площині:
- Коефіцієнт нахилу Завантаження... (weight / slope): задає кутовий коефіцієнт дотичної або самої прямої. Він показує темп зміни цільової змінної. Чим вище додатне значення Завантаження..., тим крутіше пряма підіймається вгору. Якщо Завантаження..., пряма є суворо горизонтальною (немає лінійного зв'язку). При Завантаження... залежність стає оберненою (наприклад, вік будівлі та її ринкова вартість).
- Зсув Завантаження... (bias / intercept): відповідає точці перетину прямої з віссю ординат Завантаження... при нульовому значенні аргументу (Завантаження...). Він зсуває пряму вгору чи вниз паралельно самій собі.
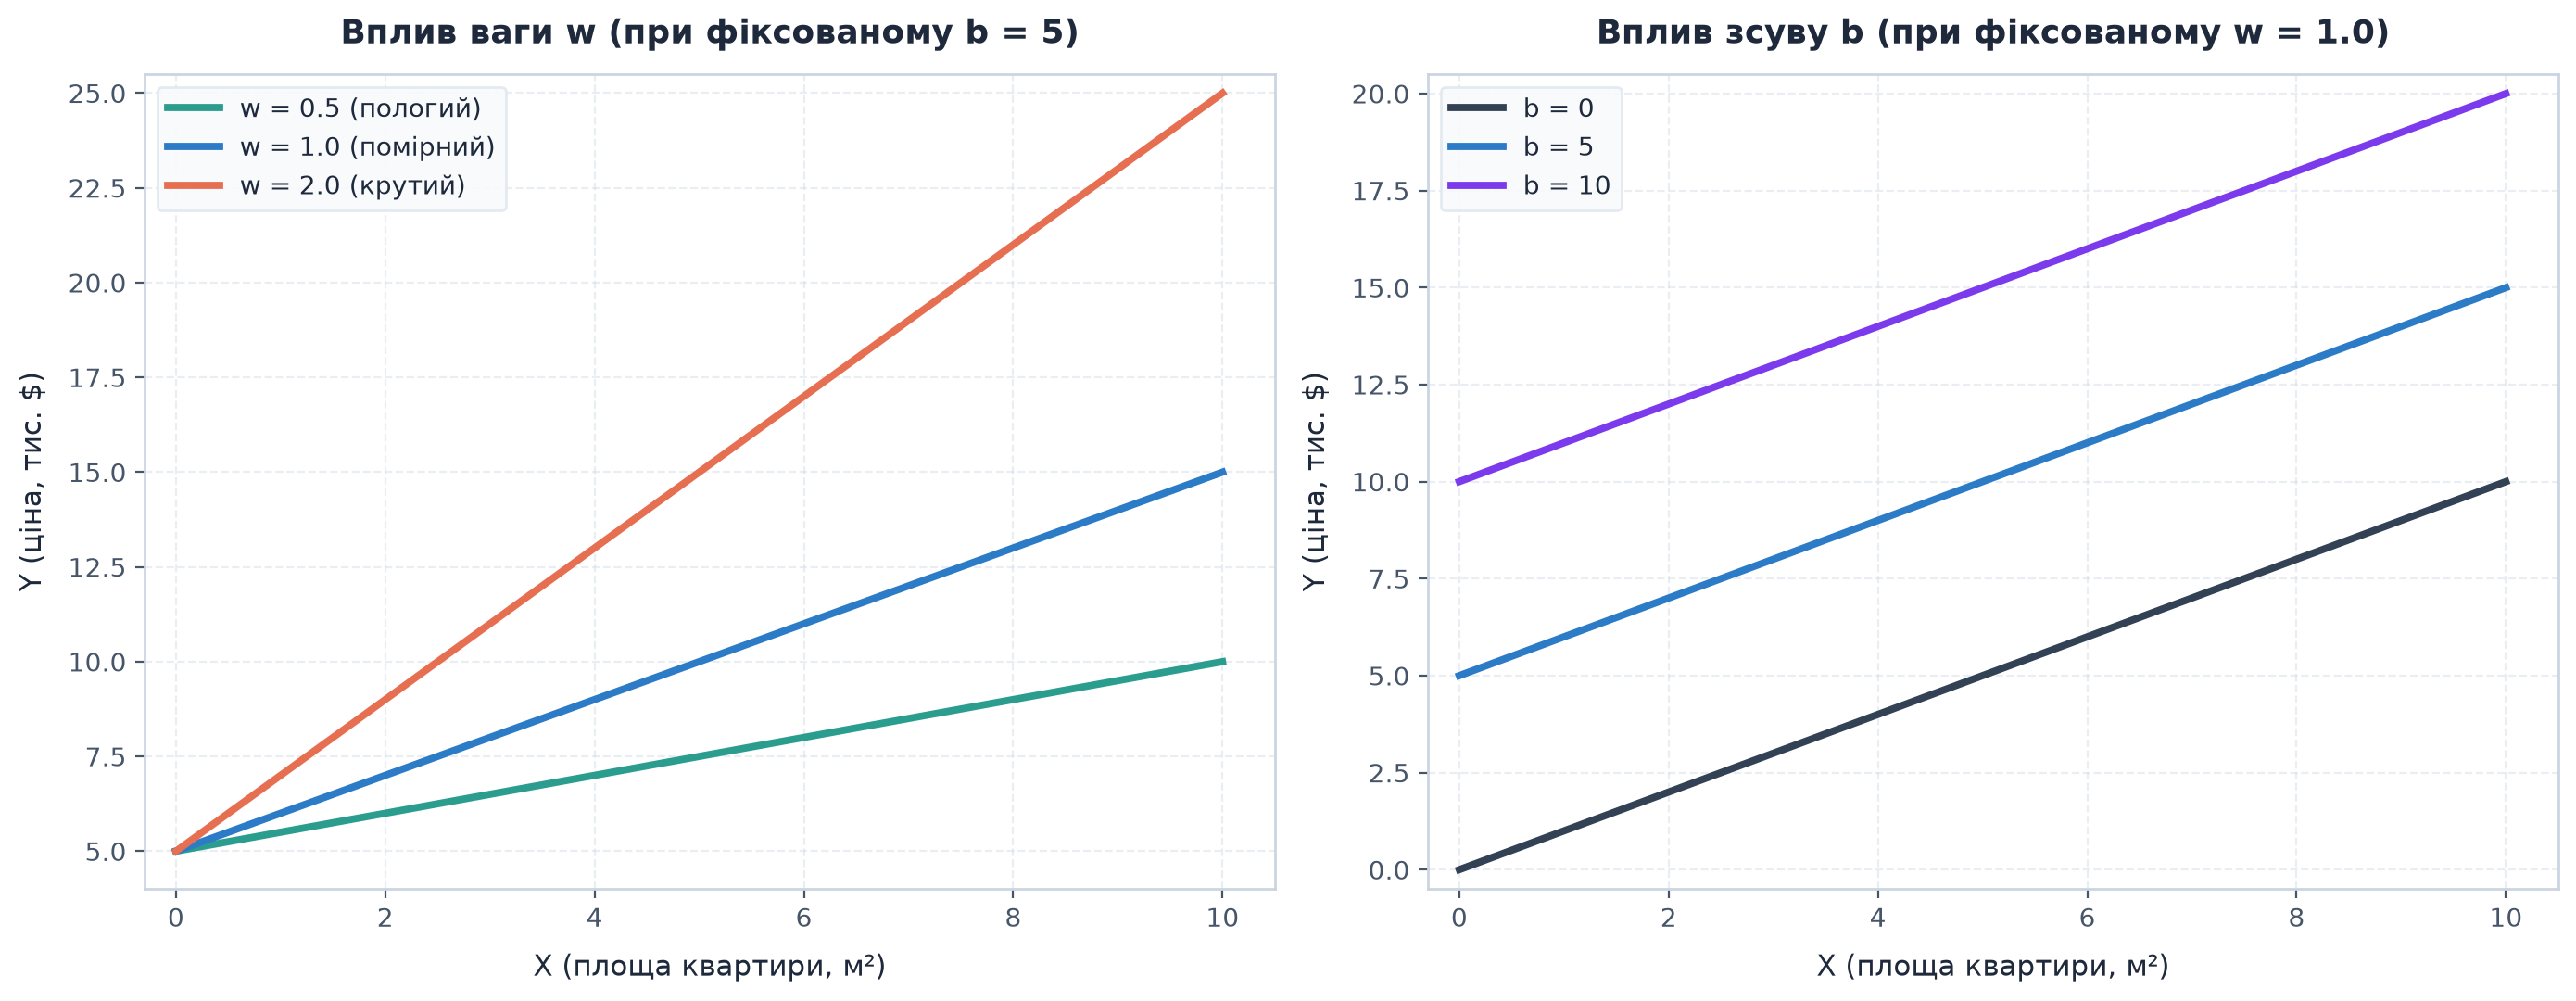
- На графіку вище: вісь Завантаження... вимірюється в тисячах доларів (тис. $), а вісь Завантаження... — у квадратних метрах (м²). Відповідно, Завантаження... означає приріст на Завантаження... тис. $/м², тобто рівно Завантаження... $/м². Невеликі числа (Завантаження...) використано для наочності геометричної сітки, щоб графік залишався компактним і легкочитним.
- У прикладах нижче: цільова змінна Завантаження... задається безпосередньо в одиничних доларах ($), тому нахил записано повним числом: Завантаження... $/м².
Приклад: три варіанти моделі
Спробуємо «вручну» підібрати параметри w та b і подивимося, як виглядають різні варіанти моделі.
import numpy as np
import matplotlib.pyplot as plt

# Ті ж дані
rng = np.random.default_rng(seed=42)
area = np.array([45, 50, 60, 55, 70, 65, 80, 75, 90, 85,
                 100, 95, 110, 105, 120, 115, 130, 125, 140, 135])
price = 500 * area + rng.normal(0, 3000, 20)

# Три варіанти моделі (різні w та b)
x_line = np.array([40, 145])

model_1 = {"w": 600, "b": -5000, "label": "Модель 1 (занадто крута)"}
model_2 = {"w": 300, "b": 10000, "label": "Модель 2 (занадто плоска)"}
model_3 = {"w": 500, "b": 0, "label": "Модель 3 (оптимальна)"}

fig, ax = plt.subplots(figsize=(10, 6))

# Точки даних
ax.scatter(area, price, s=100, alpha=0.7, color="steelblue",
           edgecolor="navy", linewidth=1.5, label="Реальні дані", zorder=3)

# Три прямі
ax.plot(x_line, model_1["w"] * x_line + model_1["b"],
        'r--', linewidth=2, alpha=0.6, label=model_1["label"])
ax.plot(x_line, model_2["w"] * x_line + model_2["b"],
        'g--', linewidth=2, alpha=0.6, label=model_2["label"])
ax.plot(x_line, model_3["w"] * x_line + model_3["b"],
        'orange', linewidth=3, label=model_3["label"], zorder=2)

ax.set_title("Порівняння трьох варіантів моделі", fontsize=14, fontweight="bold")
ax.set_xlabel("Площа (м²)", fontsize=12)
ax.set_ylabel("Ціна ($)", fontsize=12)
ax.grid(True, alpha=0.3)
ax.legend(loc="upper left", fontsize=10)
ax.set_ylim(15000, 75000)

plt.tight_layout()
plt.show()
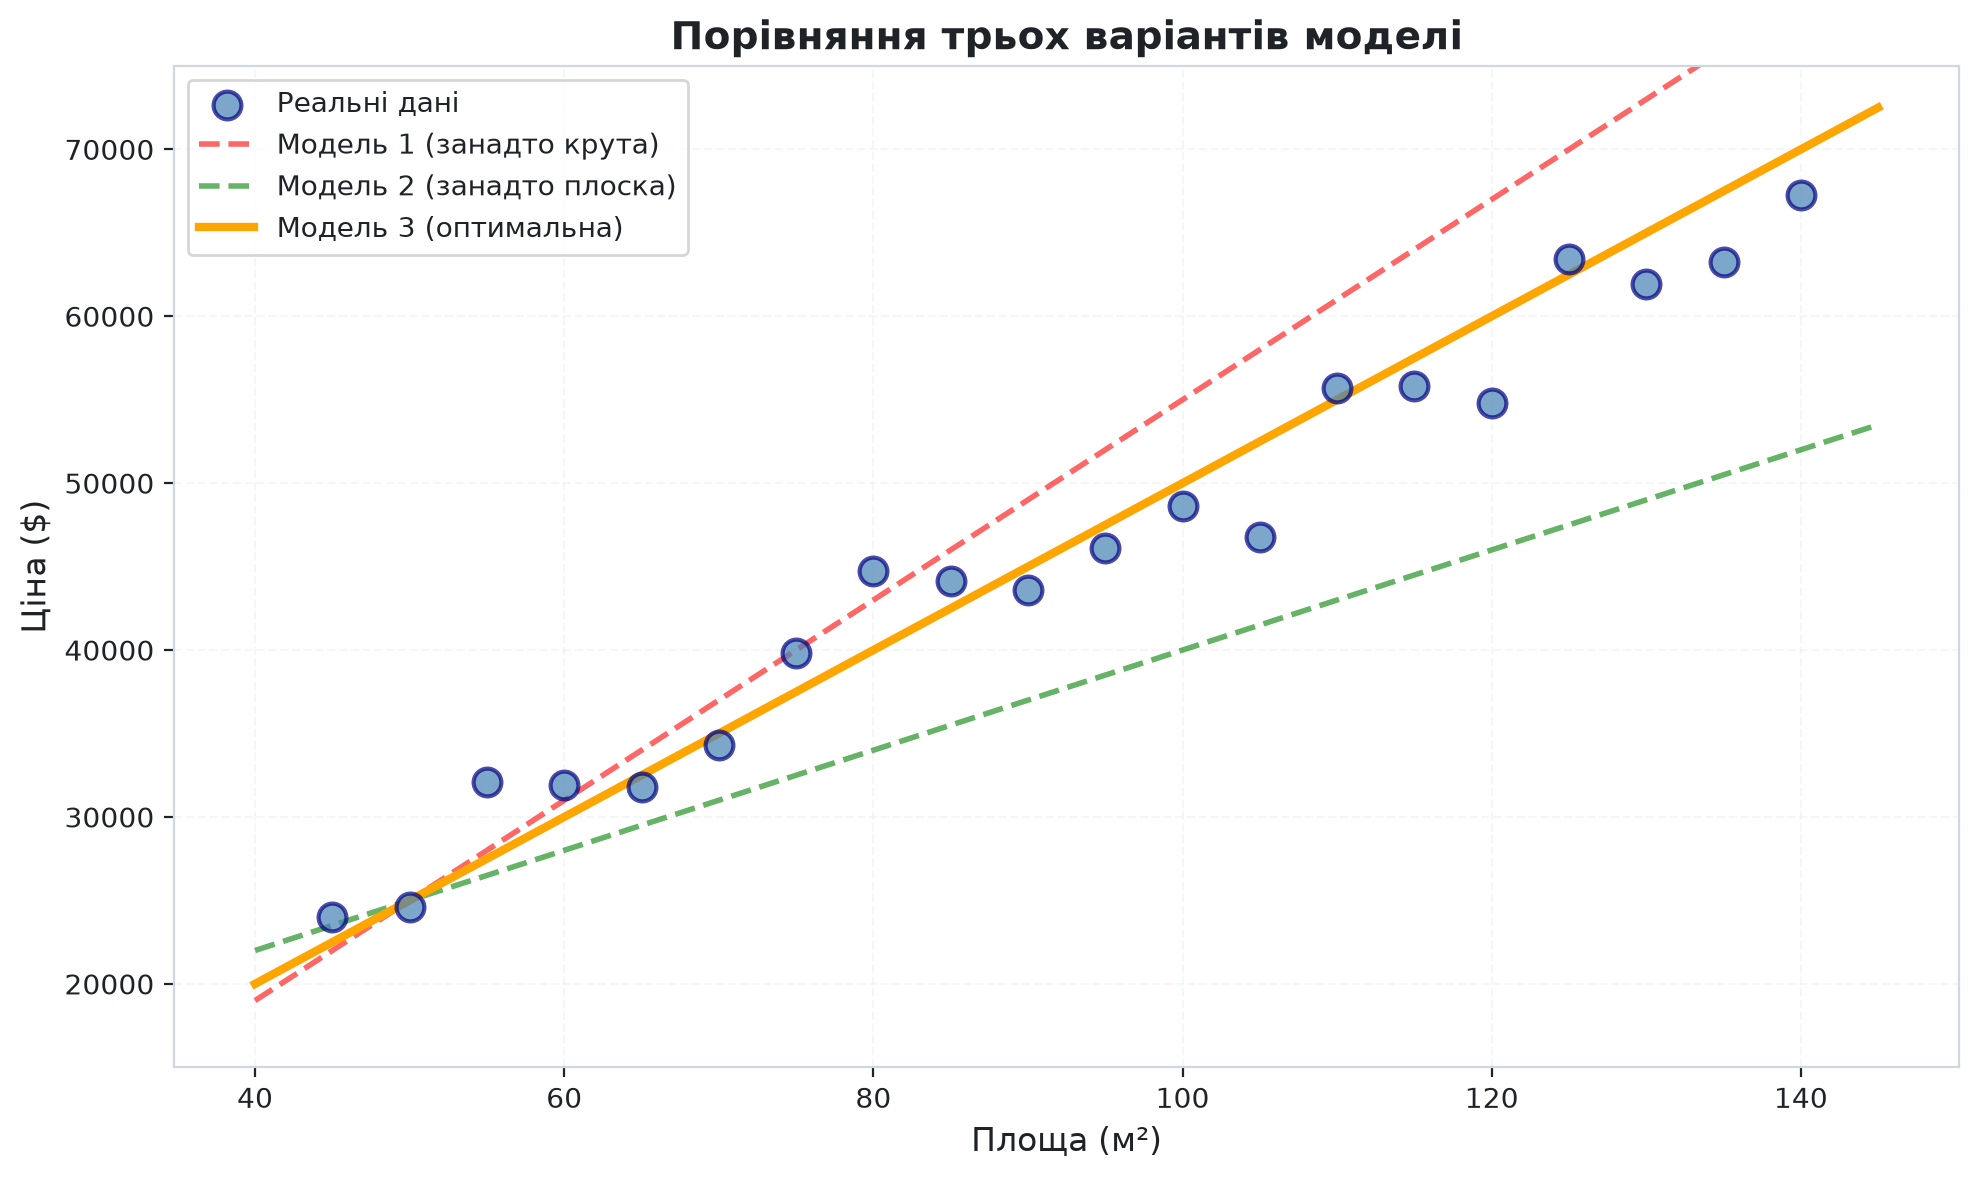
Аналіз:
- Модель 1 (червона): Завантаження... — занадто крутий нахил, переоцінює великі квартири
- Модель 2 (зелена): Завантаження... — занадто плоска, недооцінює великі та переоцінює малі
- Модель 3 (помаранчева): Завантаження... — проходить якраз посередині точок
Питання: як автоматично знайти найкращі значення Завантаження... та Завантаження...? Не «на око», а математично?
Відповідь буде в наступних підрозділах: метрики якості та градієнтний спуск.
Інтерпретація параметрів у контексті задачі
Розглянемо модель з параметрами w = 500 та b = 0:
Що означає w = 500?
Це коефіцієнт нахилу прямої. Він показує, на скільки зміниться ціна при збільшенні площі на 1 м².
Якщо w = 500, це означає:
- Квартира 50 м² коштує приблизно 50 × 500 = 25 000$
- Квартира 51 м² (на 1 м² більше) коштує 51 × 500 = 25 500$
- Різниця: 25 500 - 25 000 = 500$
Висновок: кожен додатковий квадратний метр додає до ціни 500 доларів. Це і є економічна інтерпретація параметра w.
Параметр b (bias, зсув) — це базова ціна при площі = 0. У нашому випадку b = 0 означає, що пряма проходить через початок координат.
Чи має це сенс? Формально — так: квартира нульової площі нічого не коштує. Але в реальності параметр b часто має інше значення:
- b > 0: є «базова вартість» незалежно від площі (наприклад, вартість землі, документів)
- b < 0: теоретично можлива ситуація, але зазвичай свідчить про проблеми з даними
Приклад реалістичнішої моделі:
Тут Завантаження... $ — це «фіксована частина» вартості (локація, інфраструктура), а 480 $/м² — вартість самої площі.
Економічний зміст: ціноутворення за районами міста
У реальному секторі нерухомості параметри Завантаження... та Завантаження... безпосередньо відображають географічну та ринкову диференціацію:
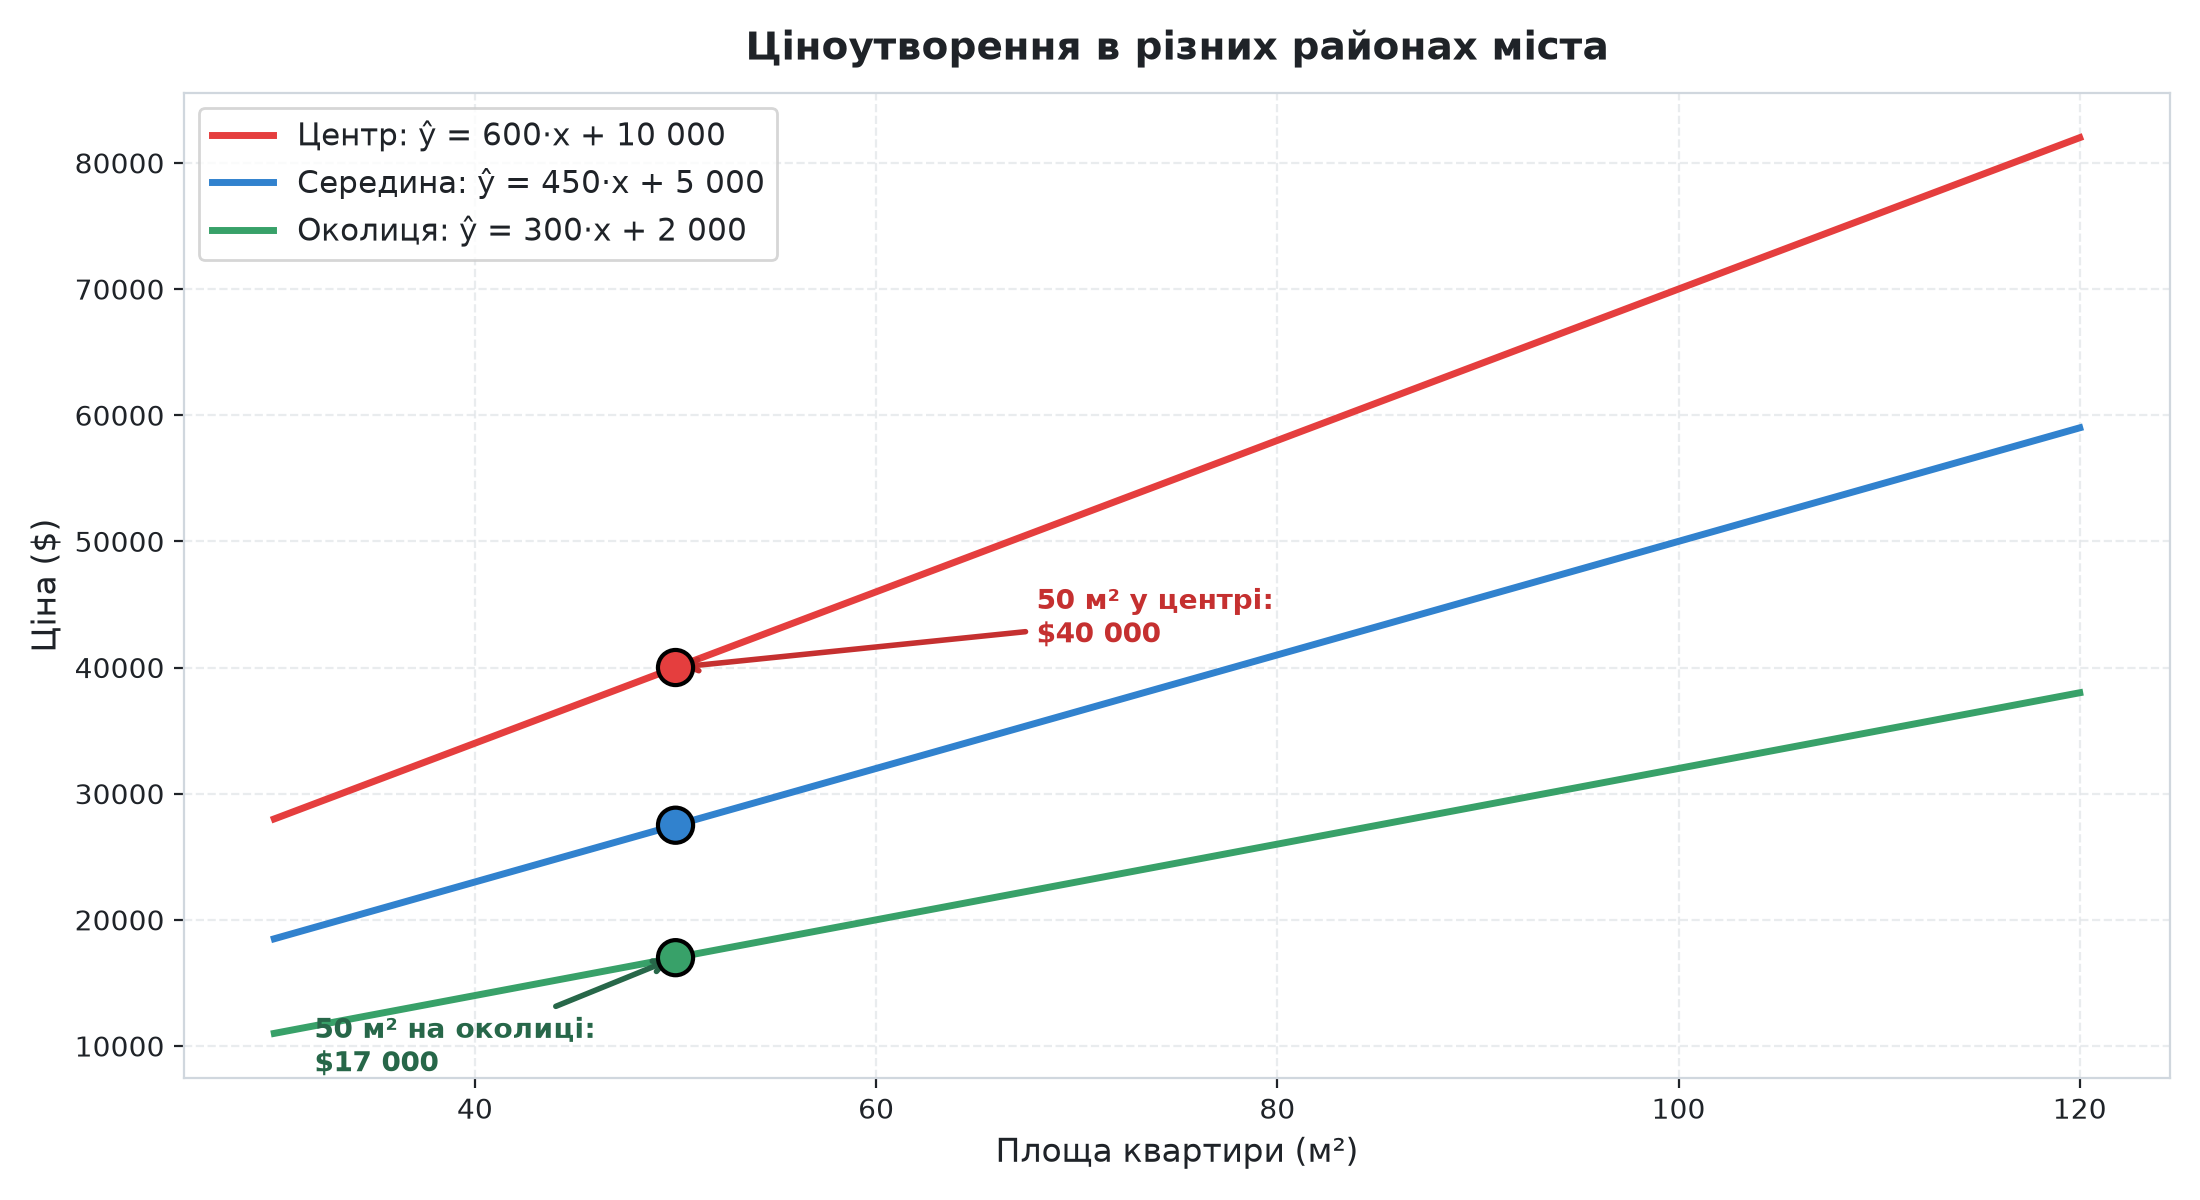
- Центр міста: Завантаження.... Тут як базова вартість престижної локації (Завантаження... $), так і питома ціна кожного квадратного метра (Завантаження... $/м²) є найвищими. Однокімнатна квартира 50 м² коштуватиме 40 000 $.
- Середня зона (спальний район): Завантаження.... Помірні показники (Завантаження..., Завантаження...), квартира 50 м² оцінюється у 27 500 $.
- Околиця (передмістя): Завантаження.... Низький поріг входу (Завантаження... $) та доступний метр (Завантаження... $/м²). Та сама площа 50 м² обійдеться всього у 17 000 $.
Цей приклад доводить: параметри лінійної регресії є не просто абстрактними коефіцієнтами оптимізації, а мають чіткий інженерний та бізнесовий зміст.
Формальне визначення лінійної регресії
Тепер, коли ми розглянули інтуїцію, дамо формальне визначення.
Лінійна регресія (Linear Regression) — це метод машинного навчання з учителем, який моделює залежність між:
- Однією або кількома вхідними ознаками Завантаження... (predictor variables, features)
- Однією цільовою змінною Завантаження... (target variable, response)
у вигляді лінійної функції:
для одної змінної, або
для багатьох змінних (про це детальніше в підрозділі 04).
Обмеження лінійної регресії
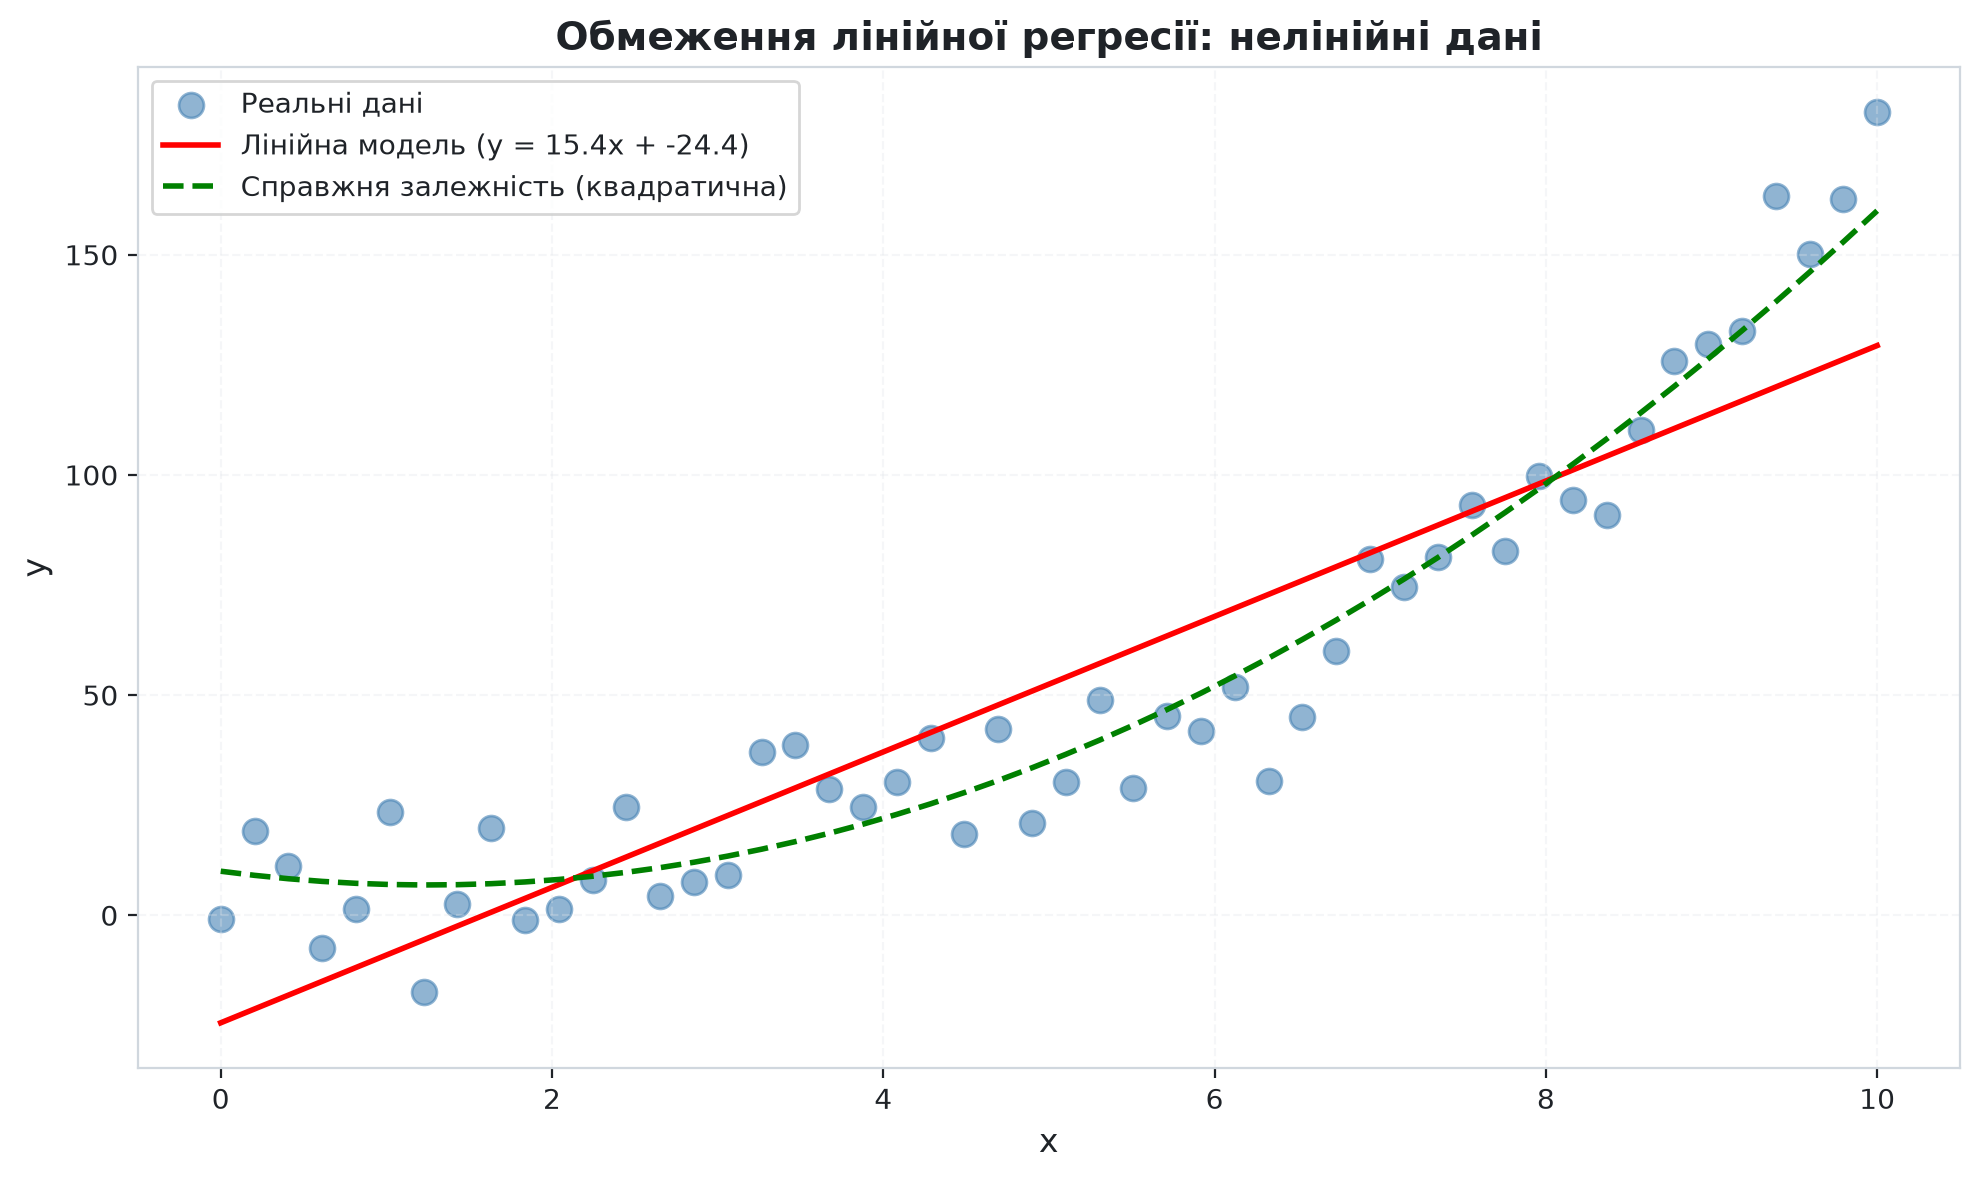
Лінійна регресія — це потужний та швидкий інструмент, проте вона демонструє надійні результати лише тоді, коли зв'язок між змінними дійсно є лінійним або близьким до нього. Якщо процес підпорядкований складному нелінійному закону, пряма лінія дасть систематично зміщені прогнози.
- Розгін автомобіля: Залежність швидкості від часу розгону не є прямою лінією. На старті прискорення максимальне (стрімкий підйом кривої), проте далі через наростаючий опір повітря темп розгону уповільнюється, виходячи на горизонтальне плато.
- Врожайність від кількості добрив: Перше внесення мінеральних добрив викликає бурхливе зростання культури, але після певної критичної дози ефект спадає, а надлишок призводить до токсичності ґрунту (класична парабола закону спадної віддачі).
- Втома та помилки від тривалості зміни: Перші години роботи супроводжуються високою концентрацією, проте після 8–10 годин безперервної праці кількість браку зростає експоненційно.
Величезна кількість природних, технічних та економічних процесів є приблизно лінійними у локальному робочому діапазоні: ціна квартири від площі (для типових планувань 30–120 м²), витрати пального на трасі при помірній швидкості, зарплата від років досвіду. У межах цього практичного діапазону лінійна модель забезпечує неперевершену швидкість та інтерпретованість.
- Суттєва нелінійність: якщо справжня залежність виражено квадратична, експоненційна або циклічна.
- Викиди (outliers): одне екстремально аномальне спостереження може сильно «перекосити» лінію МНК.
- Мультиколінеарність: якщо вхідні ознаки дублюють одна одну.
- Гетероскедастичність: якщо розкид помилок зростає разом зі зростанням ознаки Завантаження....
Візуалізація обмеження: нелінійні дані
import numpy as np
import matplotlib.pyplot as plt

# Генеруємо дані з квадратичною залежністю
rng = np.random.default_rng(seed=123)
x = np.linspace(0, 10, 50)
y = 2 * x**2 - 5 * x + 10 + rng.normal(0, 10, 50)

# Спробуємо підібрати лінійну модель (проста лінійна регресія)
w = np.polyfit(x, y, 1)[0]  # нахил
b = np.polyfit(x, y, 1)[1]  # зсув
y_pred_linear = w * x + b

fig, ax = plt.subplots(figsize=(10, 6))

ax.scatter(x, y, s=80, alpha=0.6, color="steelblue", label="Реальні дані")
ax.plot(x, y_pred_linear, 'r-', linewidth=2, label=f"Лінійна модель (y = {w:.1f}x + {b:.1f})")
ax.plot(x, 2 * x**2 - 5 * x + 10, 'g--', linewidth=2, label="Справжня залежність (квадратична)")

ax.set_title("Обмеження лінійної регресії: нелінійні дані", fontsize=14, fontweight="bold")
ax.set_xlabel("x", fontsize=12)
ax.set_ylabel("y", fontsize=12)
ax.legend()
ax.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
Резюме підрозділу
✅ Ключові висновки
- Регресія — це передбачення неперервного числового значення
- Лінійна регресія моделює залежність прямою лінією: Завантаження...
- Параметр w — це нахил прямої (на скільки змінюється Завантаження... при зміні Завантаження... на 1)
- Параметр b — це зсув (значення Завантаження... при Завантаження...)
- Лінійна регресія працює добре для лінійних залежностей, але має обмеження для складних нелінійних даних
🔜 Наступний крок
Тепер ми знаємо, що таке лінійна модель. Але як визначити, яка модель краща?
Для цього потрібні метрики якості — математичні формули, що вимірюють точність передбачень.
Наступний підрозділ: Метрики якості регресії (MAE, MSE, R²)
Композиції та стилізація — subplots та багатопанельні дашборди
Побудова кількох графіків на одній фігурі, GridSpec для складних компоновок, кольорові схеми, теми, стилізація для публікацій та презентацій
Метрики якості регресії — як оцінити модель
MAE, MSE, RMSE, R² — математичні способи виміряти точність передбачень моделі та обрати найкращу