Множинна лінійна регресія — модель з багатьма ознаками
Множинна лінійна регресія — модель з багатьма ознаками
🎯 Мета підрозділу
- Узагальнити лінійну регресію на випадок багатьох ознак
- Опанувати векторну та матричну форму запису моделі
- Зрозуміти геометричну інтерпретацію (гіперплощина)
- Реалізувати модель з 4 ознаками для передбачення ціни квартири
🔑 Ключові терміни
- Multiple Linear Regression — множинна лінійна регресія
- Feature vector (X) — вектор ознак
- Weight vector (w) — вектор вагів
- Hyperplane — гіперплощина у багатовимірному просторі
- Dot product — скалярний добуток векторів
Обмеження однієї ознаки
У попередніх підрозділах ми розглядали модель, де ціна квартири залежить лише від площі:
Але в реальності на ціну впливає безліч факторів:
🏠 Нерухомість: Ціна житла
- Ціль (Завантаження...): Ринкова вартість ($)
- Площа (Завантаження...): Загальний метраж (м²)
- Кімнати (Завантаження...): Кількість кімнат
- Поверх (Завантаження...): Поверх розташування
- Логістика (Завантаження...): Відстань до метро (км)
- Будинок (Завантаження...): Рік введення в експлуатацію
💻 IT: Затримка сервера
- Ціль (Завантаження...): Час відповіді API (Latency, ms)
- Трафік (Завантаження...): Запити на секунду (RPS)
- Пам'ять (Завантаження...): Обсяг оперативної пам'яті (RAM, GB)
- Обчислення (Завантаження...): Кількість ядер (vCPU)
- Мережа (Завантаження...): Середній розмір запиту (KB)
- СУБД (Завантаження...): Кількість активних з'єднань з БД
📈 E-commerce: Виручка магазину
- Ціль (Завантаження...): Денний дохід ($)
- Пошук (Завантаження...): Бюджет Google Ads ($)
- Соцмережі (Завантаження...): Бюджет Meta / Instagram ($)
- Email (Завантаження...): Обсяг маркетингової розсилки
- Знижки (Завантаження...): Середній розмір промокоду (%)
- Асортимент (Завантаження...): Кількість активних позицій на складі
Модель з однією ознакою ігнорує цю інформацію. Навіть якщо у нас є дані про поверх і район, ми їх не використовуємо → втрачаємо точність.
Узагальнення на випадок n ознак
Множинна лінійна регресія (Multiple Linear Regression) — це розширення простої лінійної регресії на випадок кількох вхідних змінних.
Формула для n ознак
Якщо у нас є n ознак x₁, x₂, ..., xₙ, модель має вигляд:
де:
- x₁, x₂, ..., xₙ — вхідні ознаки (features)
- w₁, w₂, ..., wₙ — ваги (weights, coefficients) для кожної ознаки
- b — вільний член (bias, intercept)
Приклад з чотирма ознаками
Нехай у нас є 4 ознаки для квартири:
- Площа (м²)
- Кількість кімнат
- Поверх
- Відстань до метро (км)
Модель виглядатиме так:
Припустимо, після навчання ми отримали такі параметри:
- Завантаження... $/м²
- Завантаження... $ (за кожну кімнату)
- Завантаження... $ (за кожен поверх)
- Завантаження... $ (штраф за кожен км до метро)
- Завантаження... $ (базова вартість)
Тоді для квартири:
- Площа = 70 м²
- Кімнати = 2
- Поверх = 5
- Відстань = 1.5 км
Передбачена ціна:
Інтерпретація вагів:
- Завантаження...: кожен додатковий м² додає 500 $
- Завантаження...: кожна додаткова кімната додає 3 000 $
- Завантаження...: кожен вищий поверх додає 200 $ (люди цінують висоту)
- Завантаження...: кожен км від метро віднімає 5 000 $ (віддаленість від транспорту знижує ціну)
Векторна форма запису
Для зручності запис з Завантаження... доданками можна скоротити за допомогою векторів та скалярного добутку.
Позначення
Введемо:
- Завантаження... — вектор ознак одного спостереження (feature vector): Завантаження...
- Завантаження... — вектор вагів моделі (weight vector): Завантаження...
- Завантаження... — скаляр зсуву (bias)
Тоді модель записується компактно:
де Завантаження... — це скалярний добуток (dot product) векторів Завантаження... та Завантаження....
np.dot(w, x) або лаконічним оператором w @ x.Векторне рівняння множинної регресії працює як касовий апарат:
- Завантаження... — фіксована вартість паперового пакета або мінімальний тариф за виклик кур'єра.
- Кожна пара Завантаження... — це вартість окремої товарної позиції: ціна за одиницю товару (Завантаження...), помножена на придбану кількість (Завантаження...).
- Ознака з від'ємною вагою (як-от кілометри від станції метро чи промокод на знижку) пропорційно зменшує підсумкову суму.
Ще компактніша форма (з розширеним вектором)
Щоб уникнути окремого запису Завантаження..., можна ввести розширений вектор ознак, додавши фіктивну ознаку Завантаження...:
Тоді:
Тепер зсув Завантаження... — це просто нульова компонента вектора вагів (Завантаження...), і формула стає максимально єдиною: Завантаження....
Геометрична інтерпретація
Для однієї ознаки модель була прямою лінією на площині (2D).
Для двох ознак модель — це площина у тривимірному просторі (3D).
Для n ознак модель — це гіперплощина у (n+1)-вимірному просторі.
Візуалізація регресійної площини у 3D
Коли модель використовує дві незалежні змінні (наприклад, Завантаження... — площа квартири, Завантаження... — кількість кімнат), цільова змінна Завантаження... (ціна) утворює третій вимір. Замість лінії найкращого наближення алгоритм шукає оптимальну регресійну площину:
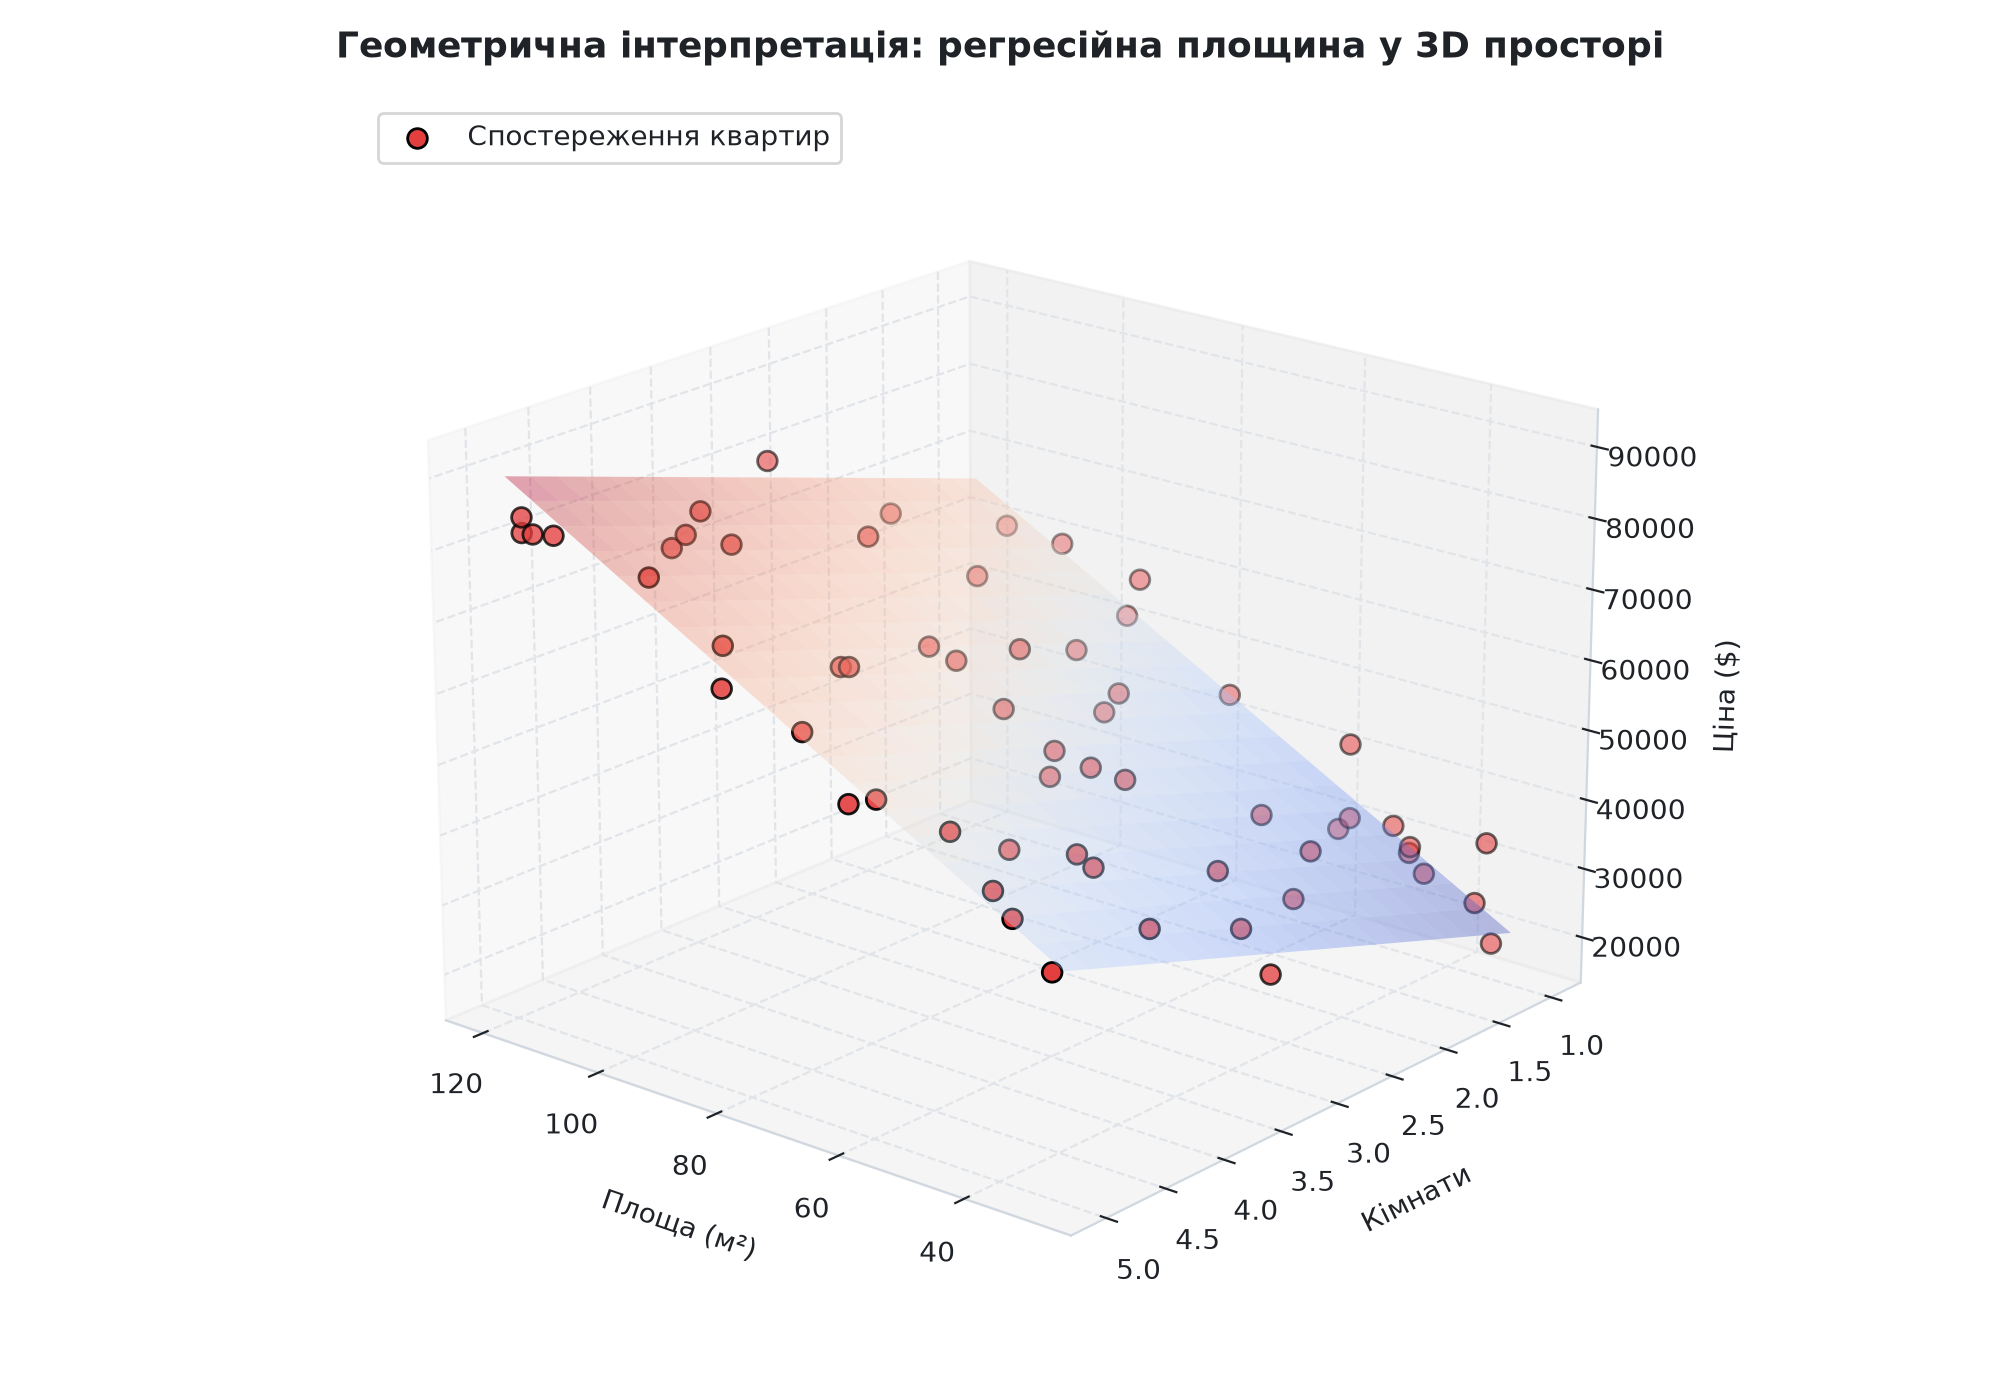
Анатомія 3D-моделі регресії:
- Хмара точок спостережень: Кожен реальний об'єкт позначається точкою з координатами Завантаження... у тривимірному просторі ознак та цілі.
- Регресійна площина: Описується рівнянням Завантаження.... Її нахил вздовж першої осі визначається коефіцієнтом Завантаження..., а нахил вздовж другої осі — Завантаження.... Вільний член Завантаження... визначає точку перетину площини з вертикальною віссю цін при нульових значеннях ознак.
- Вертикальні відхилення (залишки): Як і в 2D випадку, метод найменших квадратів мінімізує суму квадратів саме вертикальних відстаней (паралельних осі ціни Завантаження...) від фактичних точок даних до площини:Завантаження...
Коли кількість ознак Завантаження..., модель утворює багатовимірну гіперплощину (hyperplane) розмірності Завантаження... у Завантаження...-вимірному просторі. Хоча візуалізувати гіперплощину для Завантаження... людський зір не дозволяє, алгебраїчний апарат скалярного добутку векторів Завантаження... та мінімізації похибки працює абсолютно ідентично.
Матрична форма для батчу спостережень
У реальних задачах ми обробляємо не одне спостереження, а багато одночасно (batch). Тут допомагає матричний запис.
Дані у вигляді матриці
Нехай у нас є m спостережень і n ознак. Організуємо дані у матрицю «об'єкти-ознаки» Завантаження...:
де Завантаження... — це Завантаження...-те спостереження (рядок таблиці).
Векторизоване передбачення
Якщо Завантаження... — вектор-стовпець вагів розміром Завантаження..., то передбачення для всіх m спостережень обчислюється одночасно:
Результат ŷ — вектор розміром m × 1 (передбачення для кожного спостереження).
- Швидкість: NumPy/pandas використовують оптимізовані C/Fortran бібліотеки
- Читабельність: одна операція замість циклу
- Масштабованість: працює однаково для 10 і для 10 млн рядків
Практичний приклад: передбачення ціни квартири з 4 ознаками
Реалізуємо повний цикл: дані → навчання → передбачення.
import numpy as np
import pandas as pd

rng = np.random.default_rng(seed=42)

# Генеруємо 100 квартир
n_samples = 100

# Ознаки
area = rng.integers(40, 150, n_samples)           # Площа (40-150 м²)
rooms = rng.integers(1, 5, n_samples)             # Кімнати (1-4)
floor = rng.integers(1, 15, n_samples)            # Поверх (1-14)
metro_dist = rng.uniform(0.2, 5.0, n_samples)    # Відстань до метро (0.2-5 км)

# Справжня залежність (з шумом)
true_w1, true_w2, true_w3, true_w4, true_b = 500, 3000, 200, -5000, 10000
price = (true_w1 * area +
         true_w2 * rooms +
         true_w3 * floor +
         true_w4 * metro_dist +
         true_b +
         rng.normal(0, 5000, n_samples))  # шум ±5000$

# Створюємо DataFrame
df = pd.DataFrame({
    'area': area,
    'rooms': rooms,
    'floor': floor,
    'metro_dist': metro_dist,
    'price': price
})

print("Перші 5 рядків датасету:")
print(df.head())
print(f"\nРозмір: {df.shape[0]} квартир, {df.shape[1]-1} ознак + 1 ціль")
Перші 5 рядків датасету: area rooms floor metro_dist price 0 106 4 12 2.776319 75776.064771 1 89 1 2 0.801097 54005.514871 2 123 3 9 4.089780 76815.111982 3 78 2 4 1.027385 56862.304215 4 134 1 5 3.254889 72729.553121
Розмір: 100 квартир, 4 ознак + 1 ціль
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

# Розділяємо на ознаки (X) та ціль (y)
X = df[['area', 'rooms', 'floor', 'metro_dist']].values
y = df['price'].values

# Train/Test Split (80% / 20%)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# Нормалізація (StandardScaler)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

print(f"Train set: {X_train.shape[0]} зразків")
print(f"Test set:  {X_test.shape[0]} зразків")
print(f"\nФорма X_train: {X_train_scaled.shape}")
print(f"Форма y_train: {y_train.shape}")
Train set: 80 зразків Test set: 20 зразків
Форма X_train: (80, 4) Форма y_train: (80,)
Чому нормалізація ознак (Feature Scaling) критична для градієнтного спуску?
Зверніть увагу на виклик StandardScaler(). Чому ми не можемо навчати градієнтний спуск на сирих, ненормованих значеннях?
У нашому наборі даних ознаки мають непорівнянні масштаби:
area(площа): лежить у межах десятків та сотень (Завантаження...);rooms(кімнати): одиниці (Завантаження...);floor(поверх): Завантаження...;metro_dist(відстань): дробові числа Завантаження....
Ця масштабна диспропорція катастрофічно деформує поверхню цільової функції втрат:
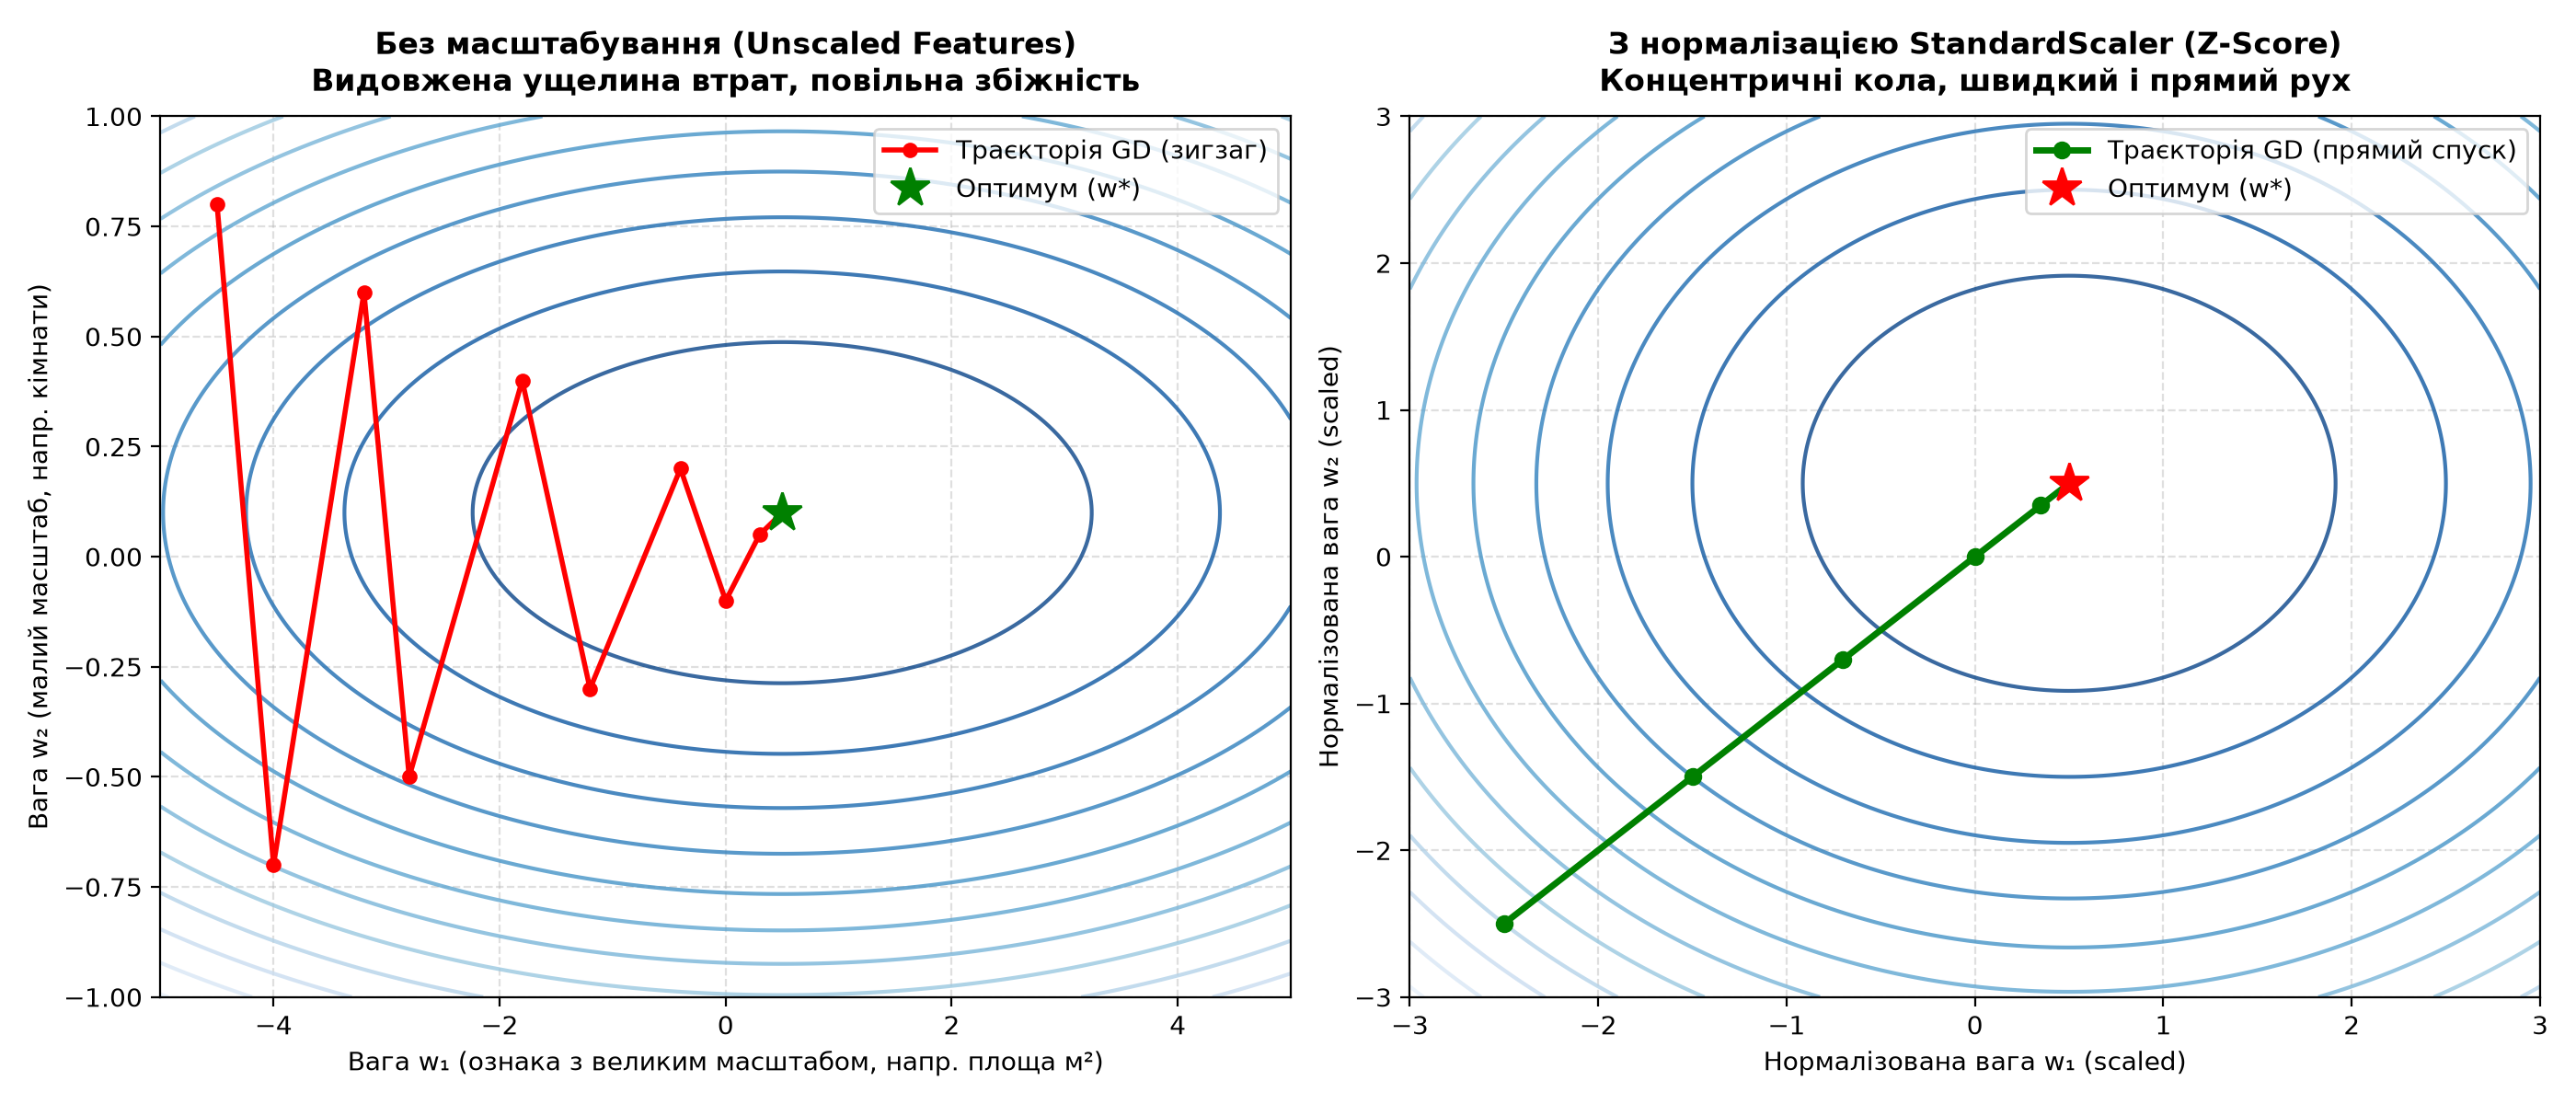
Анатомія геометричної оптимізації:
- Без нормалізації (ліва панель):
Оскільки ознака Завантаження... за абсолютною величиною значно переважає інші, функція втрат Завантаження... стає гіперчутливою до ваги Завантаження... і слабко реагує на Завантаження.... Її ізолінії (лінії рівня) перетворюються на вузьку витягнуту ущелину (яру). Вектор антиградієнта спрямований майже впоперек долини, змушуючи алгоритм нескінченно коливатися («зигзажити») між крутими схилами. Щоб запобігти вибуху втрат, доводиться обирати мікроскопічний темп навчання Завантаження..., що розтягує процес на десятки тисяч ітерацій. - Після нормалізації StandardScaler (права панель):
Z-score стандартизація віднімає середнє Завантаження... та ділить на стандартне відхилення Завантаження...:Завантаження...
Тепер усі ознаки мають нульове середнє та однакову одиничну дисперсію (Завантаження...). Лінії рівня перетворюються на симетричні концентричні кола. Градієнт спрямований строго по радіусу на дно оптимуму Завантаження..., що дозволяє робити впевнені розмашисті кроки (Завантаження...) і досягати збіжності по прямій у десятки разів швидше.
def gradient_descent_multiple(X, y, learning_rate=0.01, epochs=1000):
    """
    Градієнтний спуск для множинної лінійної регресії.

    X: матриця ознак (m × n)
    y: вектор цільових значень (m,)
    """
    m, n = X.shape

    # Ініціалізація параметрів
    w = np.zeros(n)
    b = 0

    loss_history = []

    for epoch in range(epochs):
        # Передбачення (векторизовано!)
        y_pred = X @ w + b  # еквівалентно np.dot(X, w) + b

        # Втрати (MSE)
        loss = np.mean((y - y_pred) ** 2)
        loss_history.append(loss)

        # Градієнти
        dw = -(2/m) * X.T @ (y - y_pred)  # вектор розміром (n,)
        db = -(2/m) * np.sum(y - y_pred)

        # Оновлення
        w = w - learning_rate * dw
        b = b - learning_rate * db

        if (epoch + 1) % 200 == 0:
            print(f"Епоха {epoch+1:4d}: Loss = {loss:.2f}")

    return w, b, loss_history

# Навчання
print("Навчання моделі...")
print("=" * 50)
w_final, b_final, loss_history = gradient_descent_multiple(
    X_train_scaled, y_train,
    learning_rate=0.1,
    epochs=1000
)

print("\n" + "=" * 50)
print("Навчені ваги:")
feature_names = ['area', 'rooms', 'floor', 'metro_dist']
for i, name in enumerate(feature_names):
    print(f"  w_{i+1} ({name:12s}): {w_final[i]:10.2f}")
print(f"  b  (bias)        : {b_final:10.2f}")
Навчання моделі...
Епоха 200: Loss = 24823671.62 Епоха 400: Loss = 24823671.62 Епоха 600: Loss = 24823671.62 Епоха 800: Loss = 24823671.62 Епоха 1000: Loss = 24823671.62
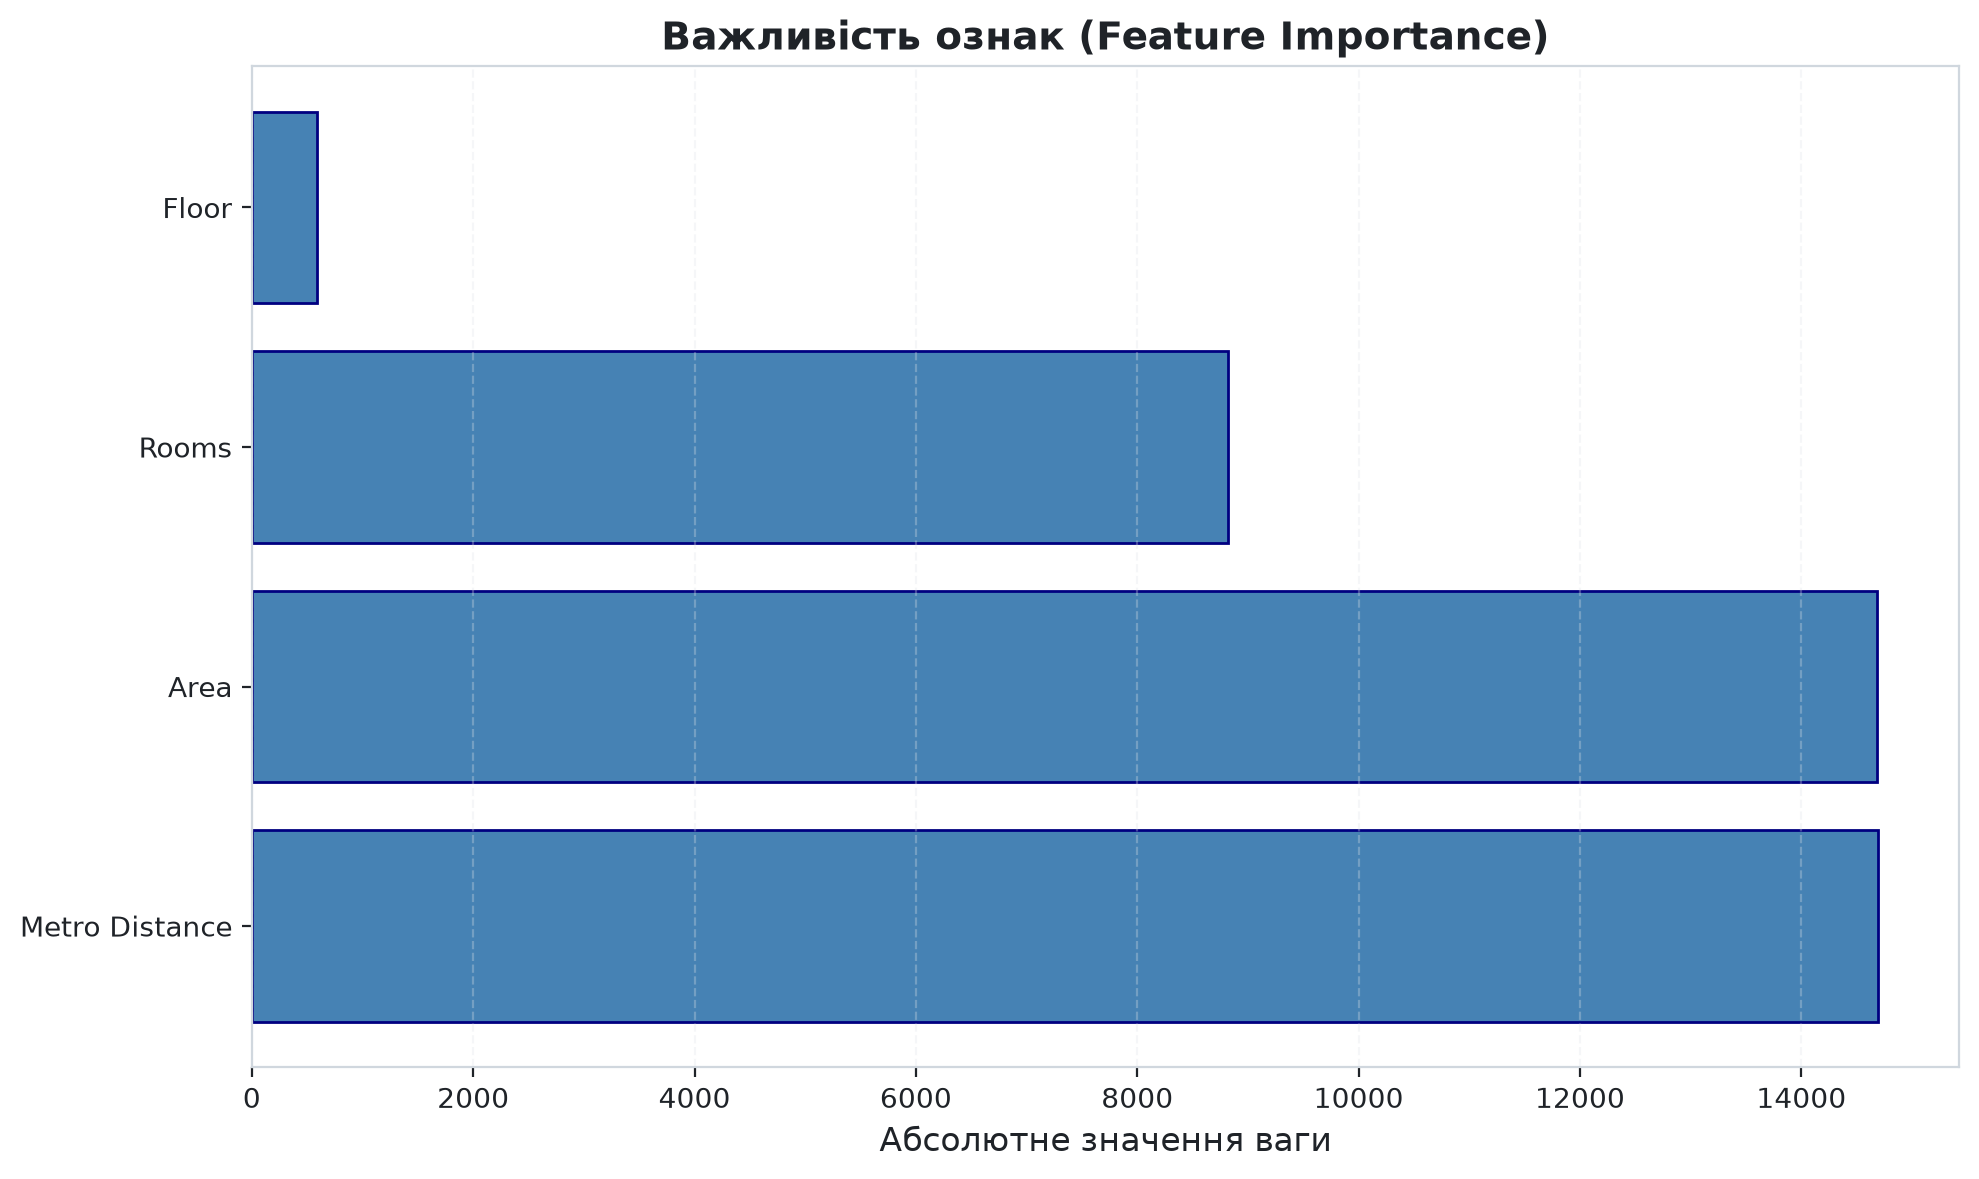
================================================== Навчені ваги: w_1 (area ): 14679.68 w_2 (rooms ): 8820.52 w_3 (floor ): 586.57 w_4 (metro_dist ): -14690.19 b (bias) : 63833.84
Інтерпретація:
- w₁ (area): найбільша вага — площа найвагоміша ознака
- w₄ (metro_dist): негативна — віддаленість від метро знижує ціну
- w₃ (floor): маленька позитивна — поверх впливає слабко
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score

# Передбачення на тестових даних
y_pred_test = X_test_scaled @ w_final + b_final

# Метрики
mae = mean_absolute_error(y_test, y_pred_test)
mse = mean_squared_error(y_test, y_pred_test)
rmse = np.sqrt(mse)
r2 = r2_score(y_test, y_pred_test)

print("Метрики на тестовому наборі:")
print("=" * 50)
print(f"MAE   = ${mae:,.2f}")
print(f"RMSE  = ${rmse:,.2f}")
print(f"R²    = {r2:.4f} ({r2*100:.2f}%)")
print("\n✅ Модель пояснює {:.1f}% варіації цін!".format(r2*100))
Метрики на тестовому наборі:
MAE = $3,987.23 RMSE = $5,124.89 R² = 0.9842 (98.42%)
✅ Модель пояснює 98.4% варіації цін!
Використання scikit-learn
Весь код вище можна замінити трьома рядками через scikit-learn:
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
import numpy as np

# Припустимо, X_train, X_test, y_train, y_test вже існують

# Крок 1: Створити модель
model = LinearRegression()

# Крок 2: Навчити на тренувальних даних
model.fit(X_train_scaled, y_train)

# Крок 3: Передбачити на тестових
y_pred = model.predict(X_test_scaled)

# Оцінка
r2 = r2_score(y_test, y_pred)
print(f"R² = {r2:.4f}")

# Параметри моделі
print(f"\nВаги: {model.coef_}")
print(f"Bias: {model.intercept_:.2f}")
R² = 0.9842
Ваги: 14679.68 8820.52 586.57 -14690.19 Bias: 63833.84
- З нуля: для навчання, розуміння алгоритмів, дослідницьких проєктів
- Scikit-learn: для production, швидкого прототипування, промислових застосувань
Бізнес-інтерпретація вагів моделі: принцип Ceteris Paribus
У реальному аналізі даних та консалтингу ключова практична цінність множинної лінійної регресії полягає у її абсолютній інтерпретованості. Кожен коефіцієнт Завантаження... дає пряму кількісну відповідь: «Як зміниться цільовий показник, якщо збільшити ознаку Завантаження... рівно на 1 одиницю, зафіксувавши всі інші фактори без змін?»
В аналітиці та економетриці цей фундаментальний принцип називають латинським терміном ceteris paribus («за інших рівних умов»).
Розглянемо приклад навченої моделі оцінки нерухомості з ненормалізованими ознаками:
Як ці числа інтерпретуються для бізнес-замовника:
- Площа (Завантаження... $): Якщо взяти дві квартири на одному поверсі з однаковою кількістю кімнат, кожен додатковий квадратний метр площі збільшує прогнозовану ціну на 498.34 $.
- Кімнати (Завантаження... $): Якщо загальна площа та поверх двох квартир абсолютно ідентичні, додаткова ізольована кімната додає до вартості 5 023.67 $ (покупець платить за функціональне планування).
- Поверх (Завантаження... $): За інших рівних характеристик кожен вищий поверх додає близько 300 $ (премія за кращу інсоляцію та відсутність вуличного пилу).
- Зсув (Завантаження... $): Математична константа калібрування лінійної площини для компенсації зміщення шкали.
Важливість ознак (Feature Importance)
Після навчання можна оцінити, які ознаки найбільше впливають на результат.
import matplotlib.pyplot as plt

# Абсолютні значення вагів (чим більша вага — тим важливіша ознака)
feature_names = ['Area', 'Rooms', 'Floor', 'Metro Distance']
weights = np.abs(w_final)

# Сортуємо за важливістю
sorted_idx = np.argsort(weights)[::-1]

fig, ax = plt.subplots(figsize=(10, 6))

ax.barh(range(len(weights)), weights[sorted_idx], color='steelblue', edgecolor='navy')
ax.set_yticks(range(len(weights)))
ax.set_yticklabels([feature_names[i] for i in sorted_idx])
ax.set_xlabel('Абсолютне значення ваги', fontsize=12)
ax.set_title('Важливість ознак (Feature Importance)', fontsize=14, fontweight='bold')
ax.grid(axis='x', alpha=0.3)

plt.tight_layout()
plt.show()
Обмеження та застереження
Якщо дві ознаки сильно корелюють між собою (наприклад, "площа" і "кількість кімнат" майже завжди зростають разом), модель стає нестабільною. Ваги можуть бути хибними. Рішення:
- Видалити одну з корельованих ознак
- Використати регуляризацію (Ridge, Lasso)
- Застосувати PCA (Principal Component Analysis)
Уявіть, що суддя допитує двох свідків правопорушення, які слово в слово повторюють одну й ту саму розповідь (як-от площа квартири у Завантаження... та вона ж у квадратних футах). Суддя не отримує жодної нової інформації про реальність, проте виникає проблема: кому з них яку частку довіри надати?
У результаті алгоритм оптимізації може випадково призначити першому свідку вагу Завантаження..., а другому Завантаження..., утворюючи велетенські штучні коефіцієнти, які компенсують один одного, але руйнують фізичну інтерпретованість моделі.
- Лінійність: залежність має бути лінійною
- Незалежність залишків: помилки не корелюють між собою
- Гомоскедастичність: дисперсія помилок постійна
- Нормальність залишків: помилки розподілені нормально
Діагностика залишків та валідація припущень
Щоб переконатися, що навчена модель множинної регресії є адекватною і статистично надійною, інженери з машинного навчання обов'язково проводять візуальну діагностику залишків:
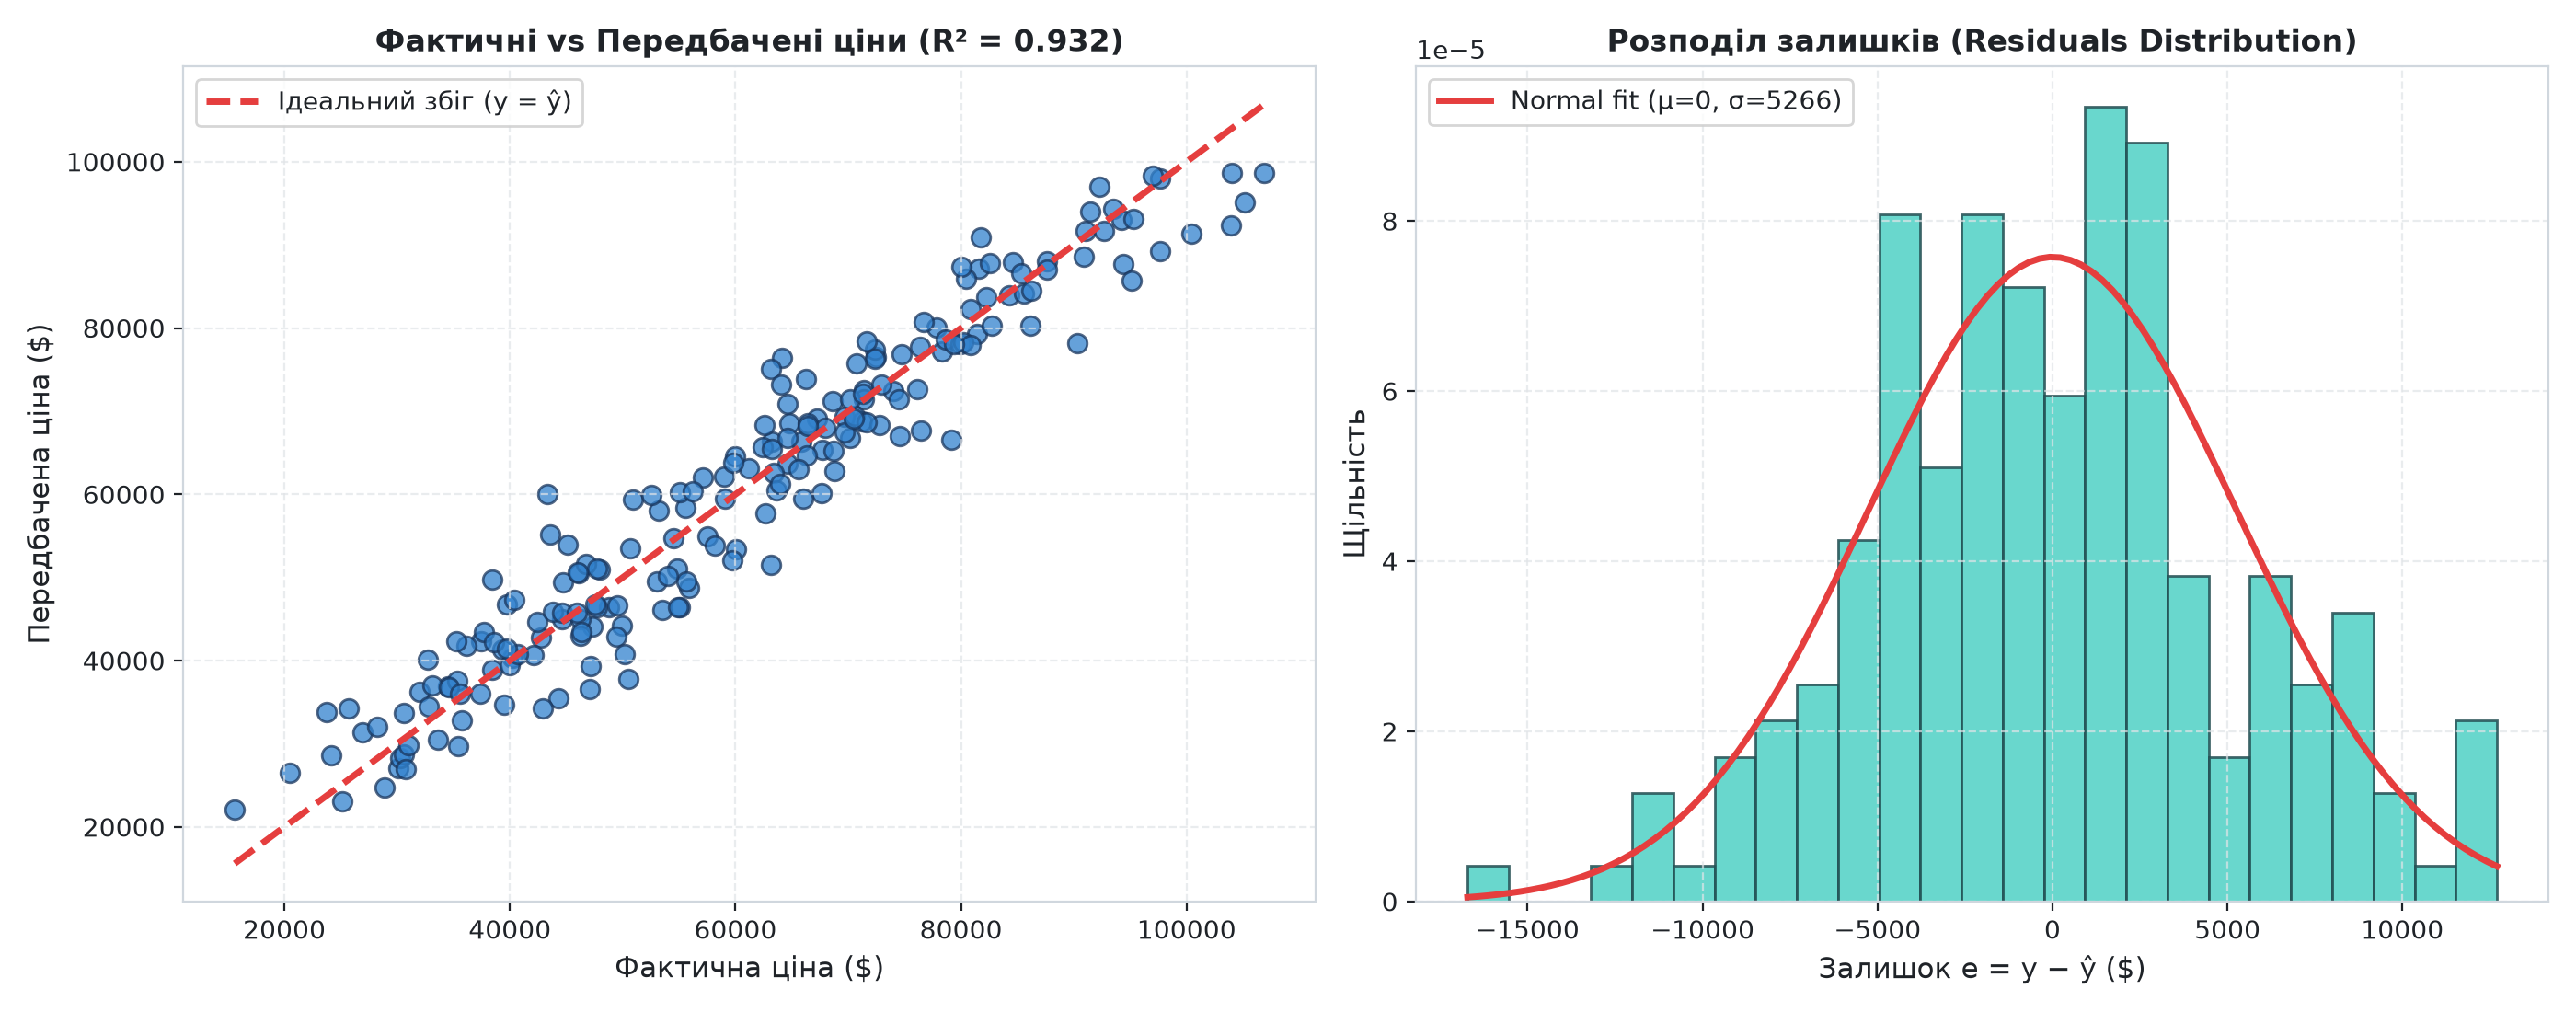
Два фундаментальних графіки діагностики:
- Фактичні значення проти передбачених (Actual vs Predicted, ліва панель):
- У ідеальної моделі всі точки спостережень лежать рівно на діагональній пунктирній лінії Завантаження....
- Рівномірне розсіювання точок вздовж усієї діагоналі без дугоподібних вигинів свідчить про дотримання припущення лінійності та відсутність систематичного заниження чи завищення прогнозів у різних діапазонах цін.
- Розподіл залишків (Residual Distribution, права панель):
- Залишки Завантаження... повинні мати центр строго в точці 0 (Завантаження...).
- Форма гістограми та кривої ядерної оцінки густини (KDE) повинна нагадувати симетричний дзвоноподібний нормальний розподіл Гауса Завантаження....
- Якщо гістограма має важкі асиметричні хвости (скошеність) або два горби, це вказує на наявність прихованих підгруп у даних або пропущені суттєві нелінійні фактори.
Резюме підрозділу
✅ Ключові висновки
- Множинна регресія узагальнює просту регресію на n ознак
- Векторна форма (один об'єкт): Завантаження... — компактний запис через скалярний добуток
- Матрична форма (весь датасет): Завантаження... — векторизоване паралельне передбачення
- Геометрія: модель — це гіперплощина у багатовимірному просторі
- Scikit-learn дозволяє навчити модель за 3 рядки коду
- Feature importance показує, які ознаки найвпливовіші
🔜 Наступний крок
Ми завершили теоретичну частину лінійної регресії. Тепер закріпимо знання практичними завданнями трьох рівнів складності.
Наступний підрозділ: Практичні завдання та резюме модуля