Випадкові величини та їх типи
Випадкові величини та їх типи
🎯 Мета підтеми
- Зрозуміти поняття випадкової величини та детермінованої величини
- Розрізняти дискретні та неперервні випадкові величини
- Навчитися генерувати випадкові дані за допомогою NumPy
- Побачити зв'язок між випадковістю та реальними даними в ML
🔑 Ключові терміни
- Випадкова величина (random variable) — величина, значення якої визначається випадковим експериментом
- Дискретна випадкова величина (discrete random variable) — може набувати лише певних окремих значень
- Неперервна випадкова величина (continuous random variable) — може набувати будь-яких значень із діапазону
- Простір можливих значень (sample space) — множина всіх можливих значень випадкової величини
Передбачення чи здогадка? Задача, яка розкриває правду
Уявіть: ви керуєте інтернет-магазином. Завтра понеділок, 9 ранку. Скільки замовлень ви отримаєте до обіду?
Спробуймо відповісти. Ви відкриваєте статистику за останні 10 понеділків:
Замовлень до обіду: 23, 31, 19, 28, 35, 22, 27, 30, 24, 29
Який буде результат завтра? Не знаєте точно. Можливо, 25, можливо 32, можливо навіть 40 (якщо хтось запустить вірусну рекламу). Ви можете здогадатися — «десь біля 27», але гарантувати не можете.
Тепер інше питання: якщо завтра буде 28 замовлень, а доставка одного коштує 50 грн, скільки ви витратите на доставку?
Відповідь: рівно 1400 грн. Тут немає невизначеності — ви просто множите 28 × 50.
Бачите різницю? У першому випадку ми маємо справу з випадковою величиною (кількість замовлень), у другому — з детермінованою (вартість доставки, якщо кількість відома).
Аналогія: детермінована величина — це як рецепт. Якщо ви поклали 200 г борошна та 3 яйця, результат завжди однаковий. Випадкова величина — це як погода завтра. Ви бачите прогноз «+18°C», але насправді може бути +15°C або +20°C. Ви не контролюєте результат повністю — він залежить від безлічі факторів.
Машинне навчання працює саме з випадковими величинами. Ми ніколи не знаємо напевно, чи клієнт купить товар, чи пацієнт хворий, чи ціна акції зросте. Але ми можемо оцінити ймовірність на основі даних минулого. Саме тому розуміння випадкових величин — це фундамент для ML.
Детерміновані та випадкові величини
Детерміновані величини
Детермінована величина (deterministic variable) — це величина, значення якої можна точно обчислити або передбачити за формулою чи правилом.
Приклади:
- Площа прямокутника зі сторонами 5 см і 10 см: завжди 50 см²
- Ціна 3 кавових зерен по 120 грн за кг: завжди 360 грн
- Кількість секунд у 5 хвилинах: завжди 300
- Відстань між Києвом та Львовом автодорогою: приблизно 540 км (фіксована)
Детерміновані величини підкоряються жорстким правилам. Якщо ви знаєте вхідні дані, ви знаєте результат. Ніяких сюрпризів.
Випадкові величини
Випадкова величина (random variable) — це величина, значення якої визначається результатом випадкового експерименту або процесу і не може бути точно передбачене заздалегідь.
Приклади:
- Кількість орлів при 10 підкиданнях монети
- Зріст випадково обраної людини на вулиці
- Час очікування автобуса на зупинці
- Кількість лайків під вашим постом у соцмережі
- Температура повітря завтра о 15:00
Випадкові величини не означають «хаос» або «повна невизначеність». Вони мають закономірності — одні значення трапляються частіше, інші рідше. Ці закономірності описуються розподілами, про які ми поговоримо в наступних статтях.
Порівняльна таблиця
| Характеристика | Детермінована величина | Випадкова величина |
|---|---|---|
| Передбачуваність | Точно обчислюється | Можна лише оцінити ймовірність |
| Повторюваність | Завжди той самий результат | Результат змінюється при повторенні |
| Залежність від даних | Формула чи правило | Ймовірнісний розподіл |
| Приклад | Площа кола: πr² | Кількість дощових днів у березні |
| Застосування в ML | Обчислення метрик | Прогнозування та класифікація |
- Детермінована величина схожа на чисту функцію (pure function), наприклад
math.Sqrt(16)абоhash("user@example.com"). За однакових вхідних аргументів вона завжди гарантовано повертає ідентичний результат без побічних ефектів. - Випадкова величина схожа на асинхронний виклик віддаленого мікросервісу через мережу (
http.Get("https://api.service/data")). Навіть якщо ви надсилаєте повністю однаковий HTTP-запит, тривалість очікування відповіді (network latency) та результат залежать від навантаження на процесор, стану маршрутизаторів, колізій пакетів та переповнення черг. Це типовий випадковий процес, що змушує інженерів проектувати таймаути, повторні спроби (retries) та оцінювати ймовірність збою.
Дискретні випадкові величини
Дискретна випадкова величина (discrete random variable) — це випадкова величина, яка може набувати лише окремих, відокремлених значень. Зазвичай це цілі числа або значення з фіксованого списку.
Ключова ознака
Між можливими значеннями дискретної величини існують «пропуски» — ви не можете отримати проміжне значення. Наприклад, якщо ви кидаєте кубик, результат може бути 1, 2, 3, 4, 5 або 6. Але не 2.5 або 3.7.
Приклади дискретних випадкових величин
- Результат кидка кубика: значення від 1 до 6 (цілі числа)
- Кількість клієнтів у магазині за день: 0, 1, 2, 3, ... (не буває 17.5 клієнтів)
- Кількість помилок у коді: 0, 1, 2, 3, ... (цілі числа)
- Оцінка студента на іспиті за 12-бальною шкалою: 1, 2, 3, ..., 12
- Категорія товару: «Електроніка», «Одяг», «Продукти» (обмежена множина варіантів)
Простір можливих значень
Для дискретної випадкової величини простір можливих значень (sample space) — це множина всіх значень, які вона може набути.
Приклади:
- Кидок монети:
{Орел, Решка}або{0, 1} - Кидок кубика:
{1, 2, 3, 4, 5, 6} - Кількість дітей у сім'ї:
{0, 1, 2, 3, 4, ...}(теоретично нескінченна, але дискретна)
Приклад: симуляція кидка кубика з NumPy
Давайте змоделюємо 20 кидків звичайного шестигранного кубика:
Симуляція 20 кидків кубика
Дискретна випадкова величина — результат може бути тільки цілим числом від 1 до 6
import numpy as np

# Створюємо генератор із фіксованим seed для відтворюваності результатів
rng = np.random.default_rng(seed=42)

# Генеруємо 20 кидків кубика (цілі числа від 1 до 6 включно)
rolls = rng.integers(low=1, high=7, size=20)
print("Результати 20 кидків кубика:")
print(rolls)
Результати 20 кидків кубика:
[6 4 1 4 4 1 6 1 3 3 3 2 1 2 5 5 3 6 1 1]
# Порахуємо, скільки разів випала кожна грань
unique, counts = np.unique(rolls, return_counts=True)
for face, count in zip(unique, counts):
    print(f"Грань {face}: {count} разів ({count/20*100:.1f}%)")
Грань 1: 6 разів (30.0%)
Грань 2: 2 рази (10.0%)
Грань 3: 4 рази (20.0%)
Грань 4: 3 рази (15.0%)
Грань 5: 2 рази (10.0%)
Грань 6: 3 рази (15.0%)
Бачите? Кожен результат — ціле число. Ви не побачите 3.5 або 4.2. Це класична дискретна випадкова величина.
rng = np.random.default_rng(seed=42) створює об'єкт-генератор випадкових чисел із зафіксованим початковим станом (seed). Це робить результати відтворюваними — кожного разу, коли ви запустите код із тим самим seed, генератор видаватиме ідентичну псевдовипадкову послідовність. Це критично для тестування та налагодження, але в робочих системах seed зазвичай не фіксують (викликаючи просто np.random.default_rng()).Неперервні випадкові величини
Неперервна випадкова величина (continuous random variable) — це випадкова величина, яка може набувати будь-яких значень у певному діапазоні. Між двома будь-якими значеннями завжди можна знайти ще одне проміжне значення.
Ключова ознака
Неперервні величини не мають «пропусків» між можливими значеннями. Якщо зріст людини може бути 170 см і 171 см, то він також може бути 170.5 см, 170.25 см, 170.125 см і так далі, до нескінченності. Обмеження накладає лише точність вимірювального приладу, а не сама величина.
Приклади неперервних випадкових величин
- Зріст людини: 165.3 см, 178.92 см, ... (будь-яке додатне дійсне число в розумних межах)
- Температура повітря: 18.7°C, 22.35°C, ... (може бути будь-яким дробовим числом)
- Час виконання запиту до сервера: 0.043 секунди, 1.259 секунди, ...
- Вага товару: 2.456 кг, 10.003 кг, ...
- Відстань від точки A до точки B: 3.14159 км (будь-яке додатне число)
Філософська тонкість: ідеальна vs реальна неперервність
У математиці неперервна величина теоретично може набувати будь-якого значення з нескінченною точністю. У реальному світі ми завжди маємо обмеження:
- Зріст вимірюється з точністю до міліметра (або сантиметра)
- Ваги показують 2–3 знаки після коми
- Час у комп'ютерах дискретний (наносекунди, мікросекунди)
Але концептуально ці величини залишаються неперервними, бо обмеження накладає інструмент, а не сама природа величини. Саме тому в статистиці та ML ми працюємо з ними як із неперервними.
int проти float64- Дискретні величини в пам'яті комп'ютера природно моделюються цілочисельними типами (
int,uint64). Вони покроково лічать квантовані об'єкти, між якими фізично немає проміжків (рядки в таблиці PostgreSQL, кількість підключень до сокета, лічильники запитів). - Неперервні величини моделюються числами з рухомою комою (
float32,float64). Хоча в цифровій пам'ятіfloat64дискретизується стандартом IEEE 754 через скінченну кількість бітів мантиси, концептуально в алгоритмах машинного навчання він описує неперервний спектр фізичного світу (вагу моделі, швидкість навчання, температуру, час відгуку).
Приклад: генерація випадкових дійсних чисел
Давайте згенеруємо випадкові дійсні числа, які моделюють зріст людей (у сантиметрах):
Симуляція зросту 15 випадкових людей
Неперервна випадкова величина — значення можуть бути дробовими
import numpy as np

rng = np.random.default_rng(seed=123)

# Генеруємо 15 випадкових значень зросту (рівномірний розподіл від 150 до 190 см)
heights = rng.uniform(low=150, high=190, size=15)

print("Зріст 15 випадкових людей (см):")
for i, h in enumerate(heights, 1):
    print(f"Людина {i:2d}: {h:.2f} см")
Зріст 15 випадкових людей (см):
Людина  1: 172.79 см
Людина  2: 186.76 см
Людина  3: 153.15 см
Людина  4: 177.12 см
Людина  5: 184.44 см
Людина  6: 176.68 см
Людина  7: 158.15 см
Людина  8: 189.04 см
Людина  9: 165.21 см
Людина 10: 160.35 см
Людина 11: 181.89 см
Людина 12: 167.43 см
Людина 13: 174.56 см
Людина 14: 155.92 см
Людина 15: 169.88 см
# Обчислимо середній зріст та діапазон
mean_height = heights.mean()
min_height = heights.min()
max_height = heights.max()

print(f"\nСтатистика:")
print(f"Середній зріст: {mean_height:.2f} см")
print(f"Мінімальний зріст: {min_height:.2f} см")
print(f"Максимальний зріст: {max_height:.2f} см")
Статистика:
Середній зріст: 171.56 см
Мінімальний зріст: 153.15 см
Максимальний зріст: 189.04 см
Зверніть увагу: кожне значення — дробове число. Немає «пропусків» — між 172.79 і 186.76 існує нескінченна кількість можливих значень (173.00, 173.01, 173.001, ...).
Аналогія: Уявіть числову пряму. Дискретна величина — це окремі точки на прямій (як станції метро). Неперервна величина — це вся пряма цілком, без розривів. Ви можете зупинитися в будь-якій точці, не тільки на станціях.
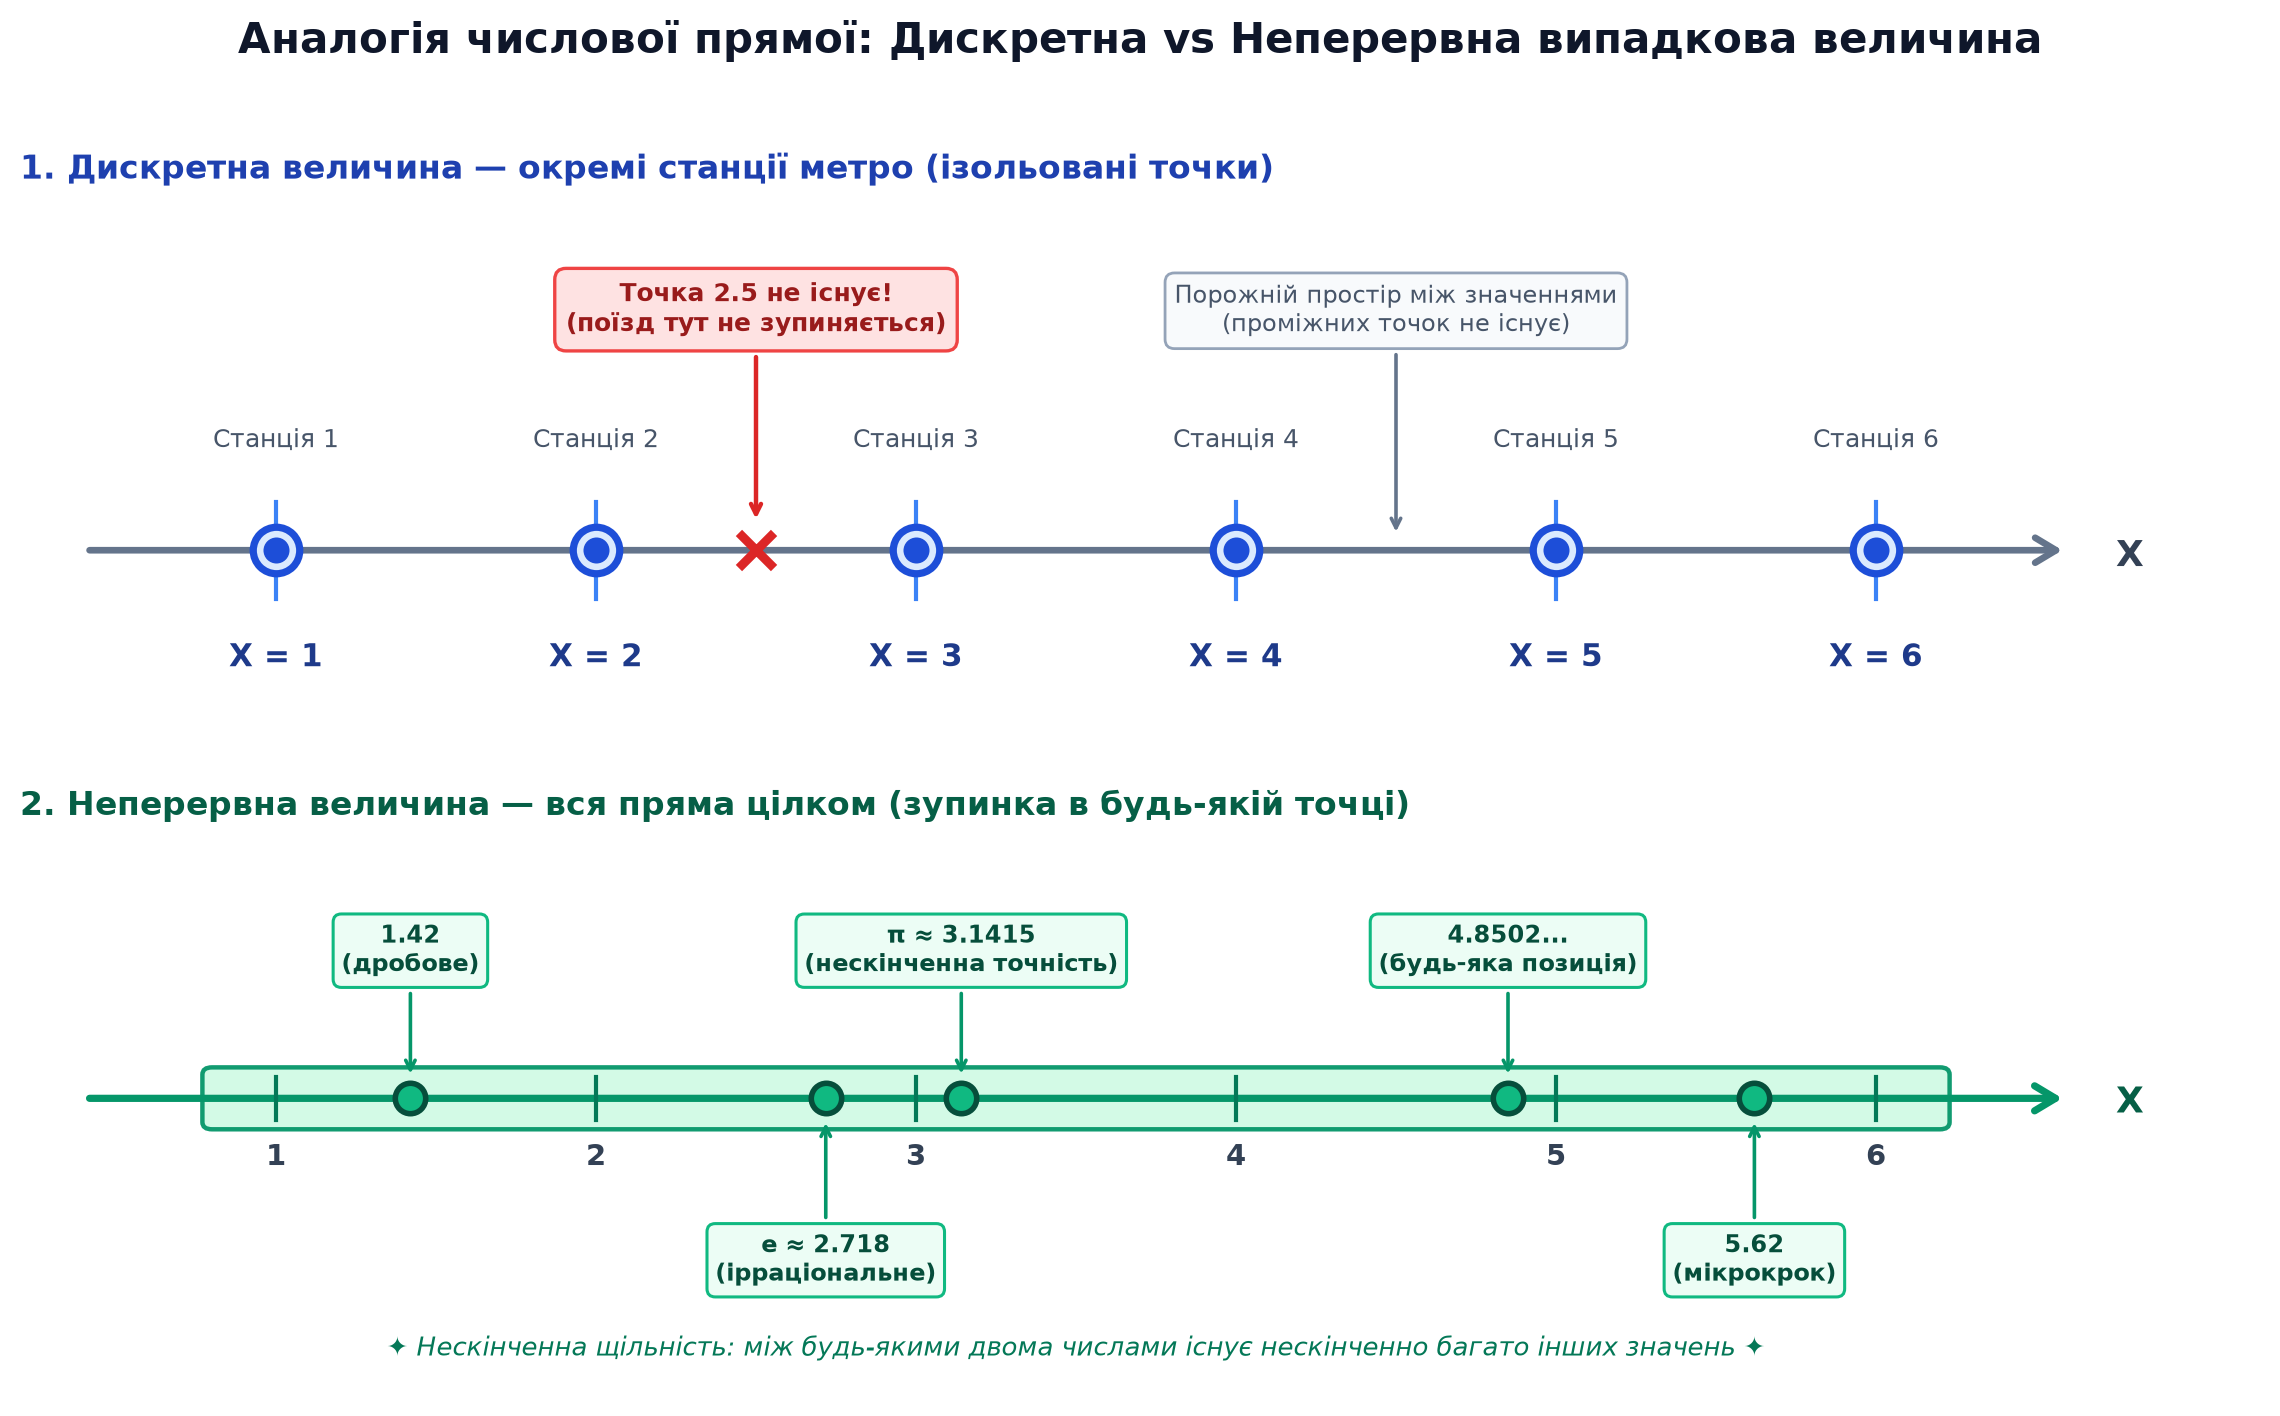
Порівняння дискретних та неперервних величин
Підсумуємо відмінності у зручній таблиці:
| Характеристика | Дискретна випадкова величина | Неперервна випадкова величина |
|---|---|---|
| Можливі значення | Окремі, відокремлені (зазвичай цілі числа) | Будь-які в діапазоні (дійсні числа) |
| Простір значень | Можна перерахувати | Неможливо перерахувати (нескінченна щільність) |
| Проміжні значення | Не існують | Завжди існують |
| Приклад із життя | Кількість дітей у сім'ї | Вага людини |
| Приклад із NumPy | rng.integers(1, 7) | rng.uniform(0, 1) |
| Ймовірність точного значення | Можна обчислити (напр., P(X=3)) | Дорівнює нулю! (P(X=170.00...)=0) |
| Графічне представлення | Стовпчаста діаграма (bar chart) | Гістограма (histogram) або крива |
Анатомія формули: Математичне сподівання дискретної величини
У теорії ймовірностей та статистиці центральним орієнтиром випадкової величини є її математичне сподівання (expected value, позначається Завантаження... або Завантаження...). Для дискретної величини воно обчислюється як зважена сума всіх її можливих значень:
- Завантаження... — Можливе значення: окремий числовий наслідок випадкової події (наприклад, результат випадання грані кубика Завантаження... або сума виграшу).
- Завантаження... — Ймовірнісна вага: шанс того, що випадкова величина набуде саме цього значення Завантаження.... Сума всіх ваг у розподілі завжди строго дорівнює одиниці: Завантаження....
- Завантаження... (множення) — Зважування: чим вища ймовірність події, тим більший внесок її значення робить у фінальний підсумок.
- Завантаження... — Акумулятор (суматор): проходження циклом від першого можливого результату (Завантаження...) до останнього (Завантаження...) та накопичення зважених значень в одну підсумкову величину.
- Завантаження... — Теоретичне середнє (центр маси): числове значення, до якого прямуватиме середнє арифметичне результатів при нескінченній кількості повторень експерименту.
Генерація випадкових даних у NumPy
NumPy надає модуль np.random для роботи з випадковими величинами. Це критично важливо для:
- Симуляцій — моделювання випадкових процесів
- Тестування алгоритмів — створення синтетичних датасетів
- Ініціалізації ML-моделей — випадкові початкові ваги нейронних мереж
- Випадкового розбиття даних — train/test split
Generator, який створюється через rng = np.random.default_rng().
Він працює на базі високоефективного 128-бітного генератора PCG-64, є потокобезпечним, не забруднює глобальний стан програми та позбавлений математичних зміщень (modulo bias). Старі функції на кшталт np.random.randint() чи np.random.seed() залишені лише для зворотної сумісності.Основні методи для дискретних величин
rng.integers() — цілі числа в діапазоні
Генерує випадкові цілі числа від low (включно) до high (виключно):
import numpy as np

rng = np.random.default_rng(seed=42)

# Кидок кубика (від 1 до 6 включно, тому high=7)
dice = rng.integers(1, 7, size=10)
print("10 кидків кубика:", dice)

# Випадкові роки народження від 1990 до 2005
birth_years = rng.integers(1990, 2006, size=5)
print("Роки народження:", birth_years)
10 кидків кубика: [4 1 6 3 5 2 6 4 1 3]
Роки народження: [1998 2003 1992 2001 1995]
high за замовчуванням не включається в діапазон (як і в Python range). Тому для граней кубика (1–6) пишемо rng.integers(1, 7). Також rng.integers має зручний параметр endpoint=True, якщо ви хочете включити верхню межу: rng.integers(1, 6, endpoint=True).rng.choice() — вибір із множини
Вибирає випадкові елементи з заданого масиву (з повторенням або без):
import numpy as np

rng = np.random.default_rng(seed=42)

# Вибір випадкових кольорів
colors = ['червоний', 'синій', 'зелений', 'жовтий']
random_colors = rng.choice(colors, size=7)
print("Випадкові кольори:", random_colors)

# Вибір без повторень (як витягування карт з колоди)
unique_colors = rng.choice(colors, size=3, replace=False)
print("Унікальні кольори:", unique_colors)
Випадкові кольори: ['зелений' 'червоний' 'червоний' 'синій' 'жовтий' 'зелений' 'червоний']
Унікальні кольори: ['синій' 'зелений' 'червоний']
Основні методи для неперервних величин
rng.uniform() — рівномірний розподіл
Генерує випадкові дійсні числа, рівномірно розподілені в діапазоні [low, high):
import numpy as np

rng = np.random.default_rng(seed=42)

# Випадкові дійсні числа від 0 до 1
probabilities = rng.uniform(0, 1, size=5)
print("Випадкові ймовірності:", probabilities)

# Випадкові температури від 15 до 30 градусів
temperatures = rng.uniform(15, 30, size=7)
print("\nТемператури (°C):")
for i, temp in enumerate(temperatures, 1):
    print(f"  День {i}: {temp:.1f}°C")
Випадкові ймовірності: [0.87 0.23 0.64 0.19 0.41]

Температури (°C):
  День 1: 22.3°C
  День 2: 18.7°C
  День 3: 26.1°C
  День 4: 19.4°C
  День 5: 24.8°C
  День 6: 21.5°C
  День 7: 27.9°C
Аналогія:
uniform(0, 1)— це як крутити рулетку з нескінченною кількістю секторів. Кожна точка на колі має однакову ймовірність. У реальному житті такий розподіл рідкісний — частіше зустрічається нормальний розподіл, про який ми поговоримо в наступних статтях.
rng.standard_normal() — стандартний нормальний розподіл
Генерує випадкові числа з нормального розподілу (середнє $\mu = 0$, стандартне відхилення $\sigma = 1$). Замінює застарілу функцію np.random.randn():
import numpy as np

rng = np.random.default_rng(seed=42)

# Генеруємо 10 значень зі стандартного нормального розподілу
data = rng.standard_normal(10)
print("Дані з нормального розподілу:")
print(data)
print(f"\nСереднє: {data.mean():.2f}")
print(f"Стандартне відхилення: {data.std():.2f}")
Дані з нормального розподілу:
[-0.23  1.58  0.77 -0.47  0.54 -1.08  0.88 -0.35  1.23 -0.67]

Середнє: 0.22
Стандартне відхилення: 0.82
rng.normal() — нормальний розподіл із параметрами
Більш гнучка версія — можна задати власне математичне сподівання (loc) та стандартне відхилення (scale):
import numpy as np

rng = np.random.default_rng(seed=42)

# Зріст людей: середнє 170 см, стандартне відхилення 10 см
heights = rng.normal(loc=170, scale=10, size=8)
print("Випадкові зрости (см):")
for i, h in enumerate(heights, 1):
    print(f"  Людина {i}: {h:.1f} см")
Випадкові зрости (см):
  Людина 1: 175.8 см
  Людина 2: 162.3 см
  Людина 3: 181.2 см
  Людина 4: 168.7 см
  Людина 5: 172.4 см
  Людина 6: 165.9 см
  Людина 7: 177.5 см
  Людина 8: 169.1 см
Контроль випадковості: seed у Generator API
У реальному житті випадковість — це непередбачуваність. Але в програмуванні та науці критично важлива відтворюваність — щоб колеги чи студенти могли запустити ваш код і отримати точнісінько такий самий результат.
Seed (зерно) — це стартовий стан внутрішнього регістра псевдовипадкового генератора. При передачі однакового seed у np.random.default_rng(seed) генератор формує повністю детерміновану числову послідовність.
import numpy as np

# Перший генератор із seed=42
rng1 = np.random.default_rng(seed=42)
data1 = rng1.integers(1, 100, size=5)
print("Перший запуск (seed=42):", data1)

# Інший генератор без seed — результат непередбачуваний
rng_rand = np.random.default_rng()
data2 = rng_rand.integers(1, 100, size=5)
print("Запуск без фіксованого seed:", data2)

# Новий генератор із тим самим seed=42 — результат 100% збігається з першим!
rng2 = np.random.default_rng(seed=42)
data3 = rng2.integers(1, 100, size=5)
print("Повторний запуск (seed=42):", data3)
Перший запуск (seed=42): [52 93  8 66 84]
Drugi запуск (без seed):  [75 28 44 19 62]
Третій запуск (seed=42):  [52 93  8 66 84]
- ✅ У навчальних прикладах (щоб результати співпадали з документацією)
- ✅ У наукових дослідженнях (для відтворюваності)
- ✅ При налагодженні коду (щоб помилка повторювалась)
- ❌ У продакшн-системах (справжня випадковість важливіша)
Візуалізація випадкових величин
Щоб зрозуміти поведінку випадкової величини, недостатньо просто подивитись на числа — потрібно побачити розподіл. Давайте порівняємо дискретну та неперервну величини візуально:
Порівняння дискретної та неперервної випадкових величин
Зліва: 1000 кидків кубика (дискретна) Справа: 1000 випадкових температур (неперервна)
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(seed=42)

# Дискретна: кидки кубика
dice_rolls = rng.integers(1, 7, size=1000)

# Неперервна: температури від 15 до 30 градусів
temperatures = rng.uniform(15, 30, size=1000)

# Створюємо два графіки поруч
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 4))

# Графік 1: дискретна величина (bar chart)
unique, counts = np.unique(dice_rolls, return_counts=True)
ax1.bar(unique, counts, color='steelblue', edgecolor='black')
ax1.set_title('Дискретна: 1000 кидків кубика', fontsize=12, weight='bold')
ax1.set_xlabel('Результат кидка')
ax1.set_ylabel('Кількість випадань')
ax1.set_xticks([1, 2, 3, 4, 5, 6])
ax1.grid(axis='y', alpha=0.3)

# Графік 2: неперервна величина (histogram)
ax2.hist(temperatures, bins=30, color='coral', edgecolor='black', alpha=0.7)
ax2.set_title('Неперервна: 1000 температур (15–30°C)', fontsize=12, weight='bold')
ax2.set_xlabel('Температура (°C)')
ax2.set_ylabel('Частота')
ax2.grid(axis='y', alpha=0.3)

plt.tight_layout()
plt.show()

print(f"Дискретна: найчастіше випадало {unique[counts.argmax()]} ({counts.max()} разів)")
print(f"Неперервна: середня температура {temperatures.mean():.1f}°C")
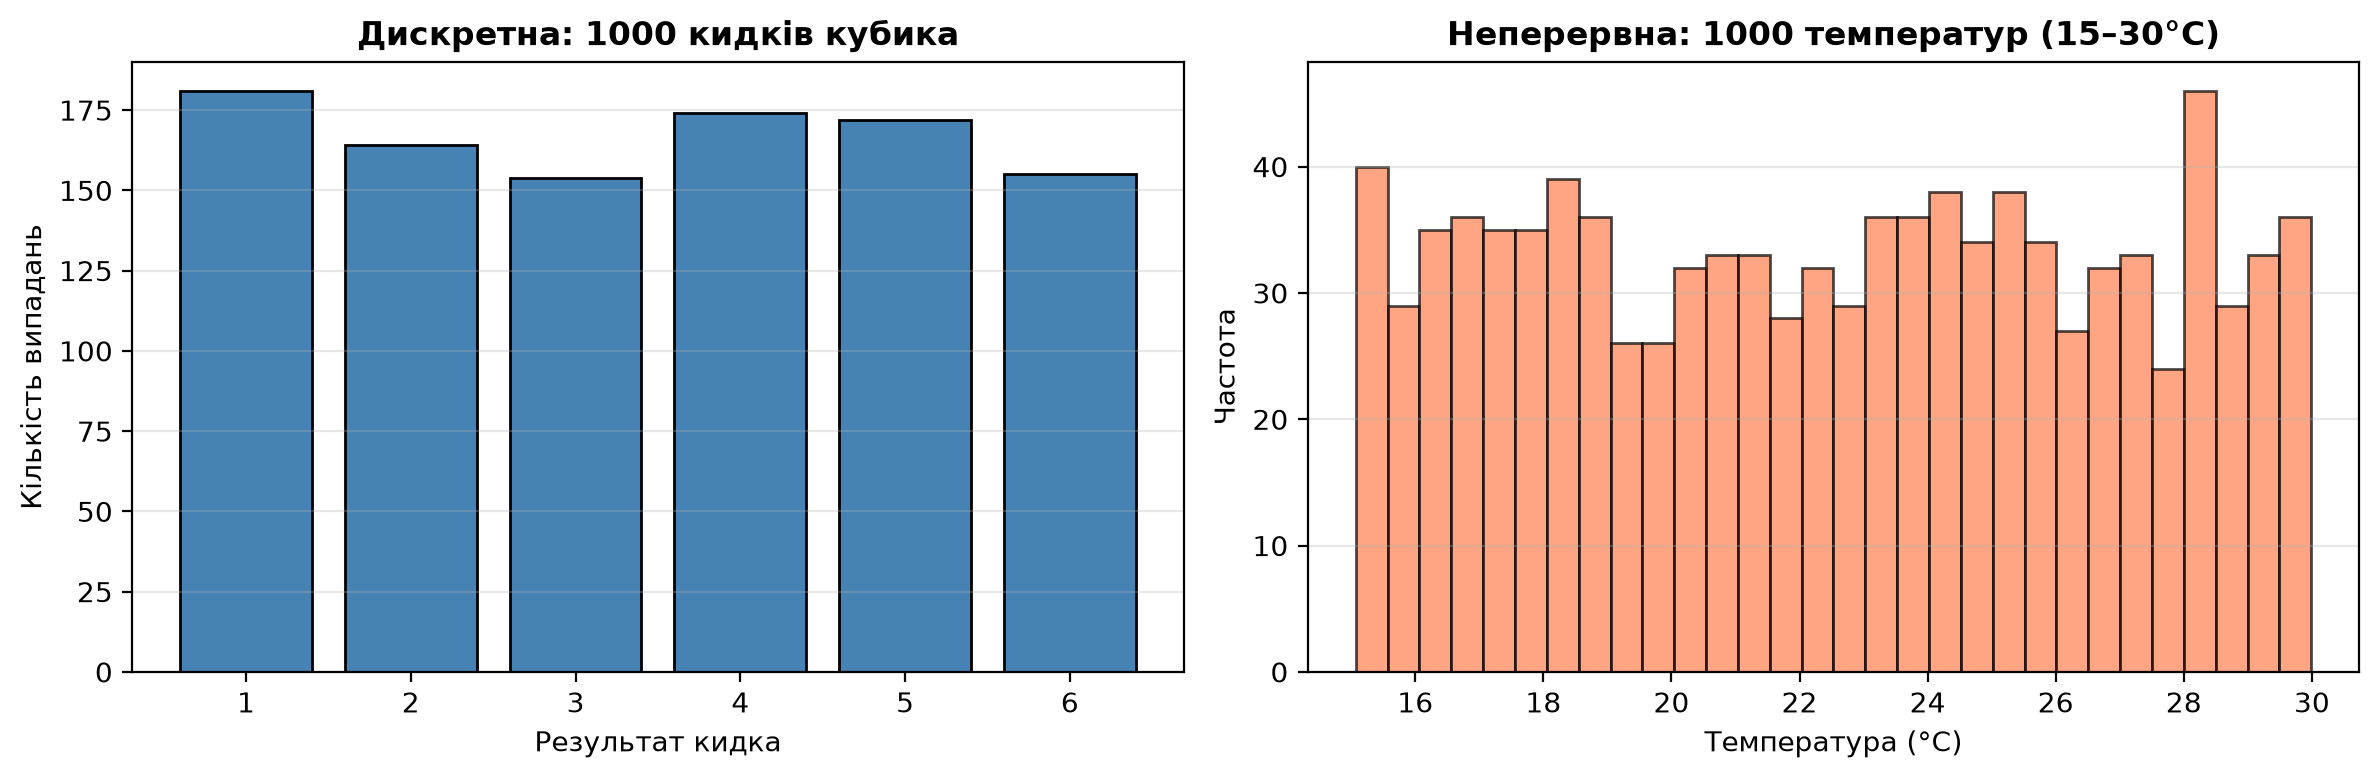
Дискретна: найчастіше випадало 5 (178 разів)
Неперервна: середня температура 22.4°C
- Зліва (дискретна): окремі стовпці для кожного можливого значення (1–6). Між ними «пропуски» — неможливо отримати 3.5.
- Справа (неперервна): суцільна гістограма. Температури розподілені рівномірно по всьому діапазону — немає «пропусків».
Зв'язок випадкових величин із Machine Learning
Тепер, коли ви розумієте випадкові величини, давайте побачимо, де вони з'являються в ML:
1. Цільова змінна (target) — випадкова величина
Коли ви будуєте модель для передбачення ціни квартири, оцінки студента або ймовірності захворювання — ви працюєте з випадковою величиною. Модель не може передбачити її з абсолютною точністю, бо завжди існує невизначеність.
2. Ознаки (features) — теж випадкові величини
Більшість ознак у датасетах — це реалізації випадкових величин:
- Зріст клієнта (неперервна)
- Кількість покупок за місяць (дискретна)
- Температура в день продажу (неперервна)
3. Ініціалізація моделей
Нейронні мережі ініціалізують ваги випадковими числами. Без цього навчання не працює — модель «застрягає» в локальному мінімумі.
4. Train/Test Split
Коли ви розбиваєте датасет на тренувальну та тестову частини, ви використовуєте випадковий вибір:
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42  # random_state — це seed!
)
5. Оцінка невизначеності
ML-модель не просто повертає одне число — вона може повертати розподіл ймовірностей. Наприклад, модель класифікації каже: «Цей лист — спам з ймовірністю 0.85». Це робота з випадковими величинами.
Аналогія: Якщо ML-модель — це компас, то випадкові величини — це магнітне поле, яке цей компас вимірює. Без розуміння поля компас безглуздий.
Практичні завдання
Рівень 1: Базові вправи
Створіть програму, яка симулює 50 підкидань монети (0 = решка, 1 = орел). Порахуйте, скільки разів випав орел та решка. Виведіть відсоток орлів.
Підказка: використайте rng = np.random.default_rng(42) та rng.integers(0, 2, size=50).
Згенеруйте 5 «паролів» довжиною 8 символів, де кожен символ — це випадкова цифра від 0 до 9. Виведіть їх списком.
Підказка: для кожного паролю створіть масив із 8 випадкових цифр через rng.integers(0, 10, size=8), потім склейте в рядок за допомогою ''.join(map(str, arr)).
Створіть DataFrame із 20 студентами. У кожного студента є оцінки з трьох предметів (випадкові цілі числа від 60 до 100). Обчисліть середню оцінку кожного студента.
Підказка:
import pandas as pd
import numpy as np

rng = np.random.default_rng(42)
data = {
    'Математика': rng.integers(60, 101, size=20),
    'Фізика': rng.integers(60, 101, size=20),
    'Історія': rng.integers(60, 101, size=20)
}
df = pd.DataFrame(data)
df['Середня'] = df.mean(axis=1)
Рівень 2: Алгоритмічні задачі
Кидайте «чесний» кубик 10, 100, 1000, 10000 разів. Для кожної кількості кидків обчисліть середнє значення результатів. Виведіть таблицю та зробіть висновок: що відбувається з середнім при зростанні кількості кидків?
Очікуваний результат: середнє наближається до 3.5 (теоретичне середнє для кубика).
Згенеруйте 1000 значень з:
- Рівномірного розподілу
uniform(0, 100) - Нормального розподілу
normal(50, 15)
Для кожного обчисліть: мінімум, максимум, середнє. Побудуйте гістограми поруч. Опишіть відмінності.
Інтернет-магазин отримує від 10 до 50 замовлень на день (рівномірний розподіл). Середній чек — 500 грн із стандартним відхиленням 150 грн (нормальний розподіл, але негативні значення замініть на 0).
Симулюйте продажі за 30 днів. Для кожного дня обчисліть загальний виторг. Виведіть:
- Загальний виторг за місяць
- Найкращий день (найбільше грошей)
- Найгірший день
Рівень 3: Проєктні завдання
Створіть функцію generate_housing_data(n_samples), яка генерує синтетичний датасет про нерухомість із такими стовпцями:
- Площа (неперервна): нормальний розподіл, середнє 75 м², σ=20
- Кімнати (дискретна): від 1 до 5, більше 2-кімнатних
- Поверх (дискретна): від 1 до 16, рівномірно
- Відстань до центру (неперервна): рівномірно від 1 до 20 км
- Ціна (цільова змінна): розрахуйте за формулою:
де шум — це
Ціна = 500 * Площа + 100_000 * Кімнати - 5_000 * Відстань_до_центру + випадковий_шумnormal(0, 50_000)
Згенеруйте 200 квартир, збережіть у DataFrame, виведіть перші 10 рядків та основну статистику.
Ви тестуєте дві версії сайту (A та B). Відомо:
- Версія A: конверсія 5% (з 100 відвідувачів 5 купують)
- Версія B: конверсія 7%
Симулюйте 1000 відвідувачів для кожної версії (випадково вирішуйте, чи купує кожен відвідувач). Порахуйте фактичну кількість покупок у кожній групі.
Запустіть симуляцію 50 разів. У скількох випадках версія B була кращою? Зробіть висновок про статистичну значущість.
Змоделюйте роботу банку протягом 8-годинного робочого дня (480 хвилин):
- Клієнти приходять із інтервалом: рівномірно від 3 до 10 хвилин
- Час обслуговування одного клієнта: нормальний розподіл, середнє 7 хвилин, σ=2 хвилини
- У банку працює 2 оператори
Порахуйте:
- Скільки всього клієнтів прийшло
- Скільки клієнтів було обслуговано
- Середній час очікування в черзі
Складно? Почніть із простішої версії: один оператор, клієнти приходять кожні 5 хвилин.
Часті запитання та типові пастки (FAQ)
Уявіть числовий відрізок зросту від 150 до 190 см. На цьому відрізку існує нескінченна множина дійсних чисел (Завантаження...). Якщо кожній окремій точці присвоїти бодай крихітну додатну ймовірність (наприклад, Завантаження...), то сума ймовірностей для всіх точок прямуватиме до нескінченності, що порушує аксіому теорії ймовірностей (сума всіх подій має дорівнювати 1.0 або 100%).
Тому в математичному аналізі геометрична ймовірність точки без ширини дорівнює нулю: площа лінії під кривою щільності дорівнює 0. Ймовірність з'являється лише тоді, коли ми вимірюємо інтервал певної ширини Завантаження..., наприклад: Завантаження....
Так, безумовно. Дискретність означає, що значення величини є ізольованими точками («станціями метро»), між якими є проміжки, але сама кількість цих точок може бути зліченно нескінченною.
Класичний приклад у розробці софту: кількість спроб повторного підключення до бази даних (retry attempts) до першого успішного з'єднання. Ви можете підключитися з 1-ї спроби, з 2-ї, 3-ї... або теоретично з Завантаження...-ї. Множина значень — це натуральні числа Завантаження.... Значення ізольовані (немає 2.4 спроби), отже величина строго дискретна, хоч і не обмежена зверху.
Резюме: ключові takeaways
Випадкова vs детермінована
Детермінована величина — обчислюється точно за формулою (площа прямокутника).
Випадкова величина — значення визначається випадковим процесом, можна лише оцінити ймовірність (кількість клієнтів завтра).
Дискретна випадкова величина
- Набуває окремих значень (зазвичай цілі числа)
- Можна перерахувати всі можливі значення
- Приклад: кидок кубика, кількість дітей
- NumPy Generator:
rng.integers(),rng.choice()
Неперервна випадкова величина
- Набуває будь-яких значень у діапазоні (дійсні числа)
- Між двома значеннями завжди є проміжні
- Приклад: зріст, температура, час
- NumPy Generator:
rng.uniform(),rng.normal(),rng.standard_normal()
Seed та Generator API
rng = np.random.default_rng(42) створює сучасний ізольований екземпляр генератора. Зафіксований seed гарантує 100% повторюваність наукових експериментів без модифікації глобального стану середовища.ML працює з випадковістю
- Цільова змінна — випадкова величина
- Ознаки — випадкові величини
- Ініціалізація моделей — випадкові числа
- Train/test split — випадковий вибір
- Передбачення — оцінка ймовірностей
Візуалізація — ключ до розуміння
- Дискретна: bar chart (окремі стовпці)
- Неперервна: histogram (суцільна гістограма)
Завжди візуалізуйте дані перед аналізом!
Що далі?
Ви опанували фундамент — тепер ви розумієте, що таке випадкова величина і як генерувати випадкові дані. У наступних статтях ми побудуємо на цьому фундаменті:
- Міри центральної тенденції — як знайти «типове» значення (середнє, медіана, мода)
- Міри варіації — як виміряти «розкиданість» даних (дисперсія, стандартне відхилення)
- Розподіли — закономірності поведінки випадкових величин (нормальний, Пуассона)
Робота з даними з використанням NumPy і pandas
Чому стандартних списків Python недостатньо для Data Science, як NumPy прискорює обчислення у 100 разів, що таке Series і DataFrame у pandas, як читати CSV і Excel та які методи потрібні для першого знайомства з датасетом
Міри центральної тенденції
Середнє арифметичне, медіана та мода — три способи знайти «типове» значення в даних, їхні переваги, недоліки та застосування в аналізі даних