Викиди та аномалії
Викиди та аномалії
🎯 Мета підтеми
- Зрозуміти, що таке викиди (outliers) та чому вони важливі
- Опанувати два методи виявлення: IQR та Z-score
- Навчитися візуалізувати викиди через box plots
- Вивчити стратегії обробки викидів
- Усвідомити вплив викидів на ML-моделі
🔑 Ключові терміни
- Викид (outlier) — значення, що значно відрізняється від інших спостережень
- Метод IQR — виявлення через міжквартильний розмах
- Метод Z-score — виявлення через стандартні відхилення
- Box plot — діаграма «ящик з вусами» для візуалізації викидів
- Робастні методи — алгоритми, стійкі до викидів
Історія про зарплати в стартапі
Уявіть: ви аналізуєте зарплати співробітників невеликого стартапу з 20 людей. Отримуєте такі дані (у тисячах $):
[45, 48, 50, 52, 47, 51, 49, 53, 46, 50, 48, 52, 51, 49, 47, 50, 51, 48, 49, 250]
Обчислюєте середню зарплату: $58.5k
Але чекайте! Більшість людей отримують ~$48–52k, а середнє — $58.5k. Що сталося?
Останнє значення — $250k — це зарплата CEO (співзасновника). Це викид (outlier), що драматично спотворює середнє значення.
import numpy as np
import matplotlib.pyplot as plt

salaries = np.array([45, 48, 50, 52, 47, 51, 49, 53, 46, 50, 48, 52, 51, 49, 47, 50, 51, 48, 49, 250])

# Статистика з викидом
mean_with = salaries.mean()
median_with = np.median(salaries)
std_with = salaries.std()

# Статистика без викиду
salaries_clean = salaries[salaries < 100]
mean_without = salaries_clean.mean()
median_without = np.median(salaries_clean)
std_without = salaries_clean.std()

# Візуалізація
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 5))

# Графік 1: Гістограма з викидом
ax1.hist(salaries, bins=20, edgecolor='black', alpha=0.7, color='coral')
ax1.axvline(mean_with, color='red', linestyle='--', linewidth=2, label=f'Середнє = ${mean_with:.1f}k')
ax1.axvline(median_with, color='green', linestyle='--', linewidth=2, label=f'Медіана = ${median_with:.1f}k')
ax1.set_xlabel('Зарплата ($k)', fontsize=12)
ax1.set_ylabel('Частота', fontsize=12)
ax1.set_title('З викидом (CEO)', fontweight='bold')
ax1.legend()
ax1.grid(alpha=0.3)

# Графік 2: Гістограма без викиду
ax2.hist(salaries_clean, bins=10, edgecolor='black', alpha=0.7, color='steelblue')
ax2.axvline(mean_without, color='red', linestyle='--', linewidth=2, label=f'Середнє = ${mean_without:.1f}k')
ax2.axvline(median_without, color='green', linestyle='--', linewidth=2, label=f'Медіана = ${median_without:.1f}k')
ax2.set_xlabel('Зарплата ($k)', fontsize=12)
ax2.set_ylabel('Частота', fontsize=12)
ax2.set_title('Без викиду', fontweight='bold')
ax2.legend()
ax2.grid(alpha=0.3)

plt.tight_layout()
plt.show()

print("📊 Порівняння статистики:\n")
print(f"{'':20} {'З викидом':>12} {'Без викиду':>12} {'Різниця':>12}")
print("-" * 60)
print(f"{'Середнє':<20} ${mean_with:>10.1f}k ${mean_without:>10.1f}k {(mean_with - mean_without):>+10.1f}k")
print(f"{'Медіана':<20} ${median_with:>10.1f}k ${median_without:>10.1f}k {(median_with - median_without):>+10.1f}k")
print(f"{'Стд. відхилення':<20} ${std_with:>10.1f}k ${std_without:>10.1f}k {(std_with - std_without):>+10.1f}k")

print("\n💡 Висновок:")
print("  Один викид ($250k) збільшив середнє на $9.4k (+19%)")
print("  Медіана майже не змінилася (стійка до викидів)")
print("  Стандартне відхилення зросло в 20 разів!")
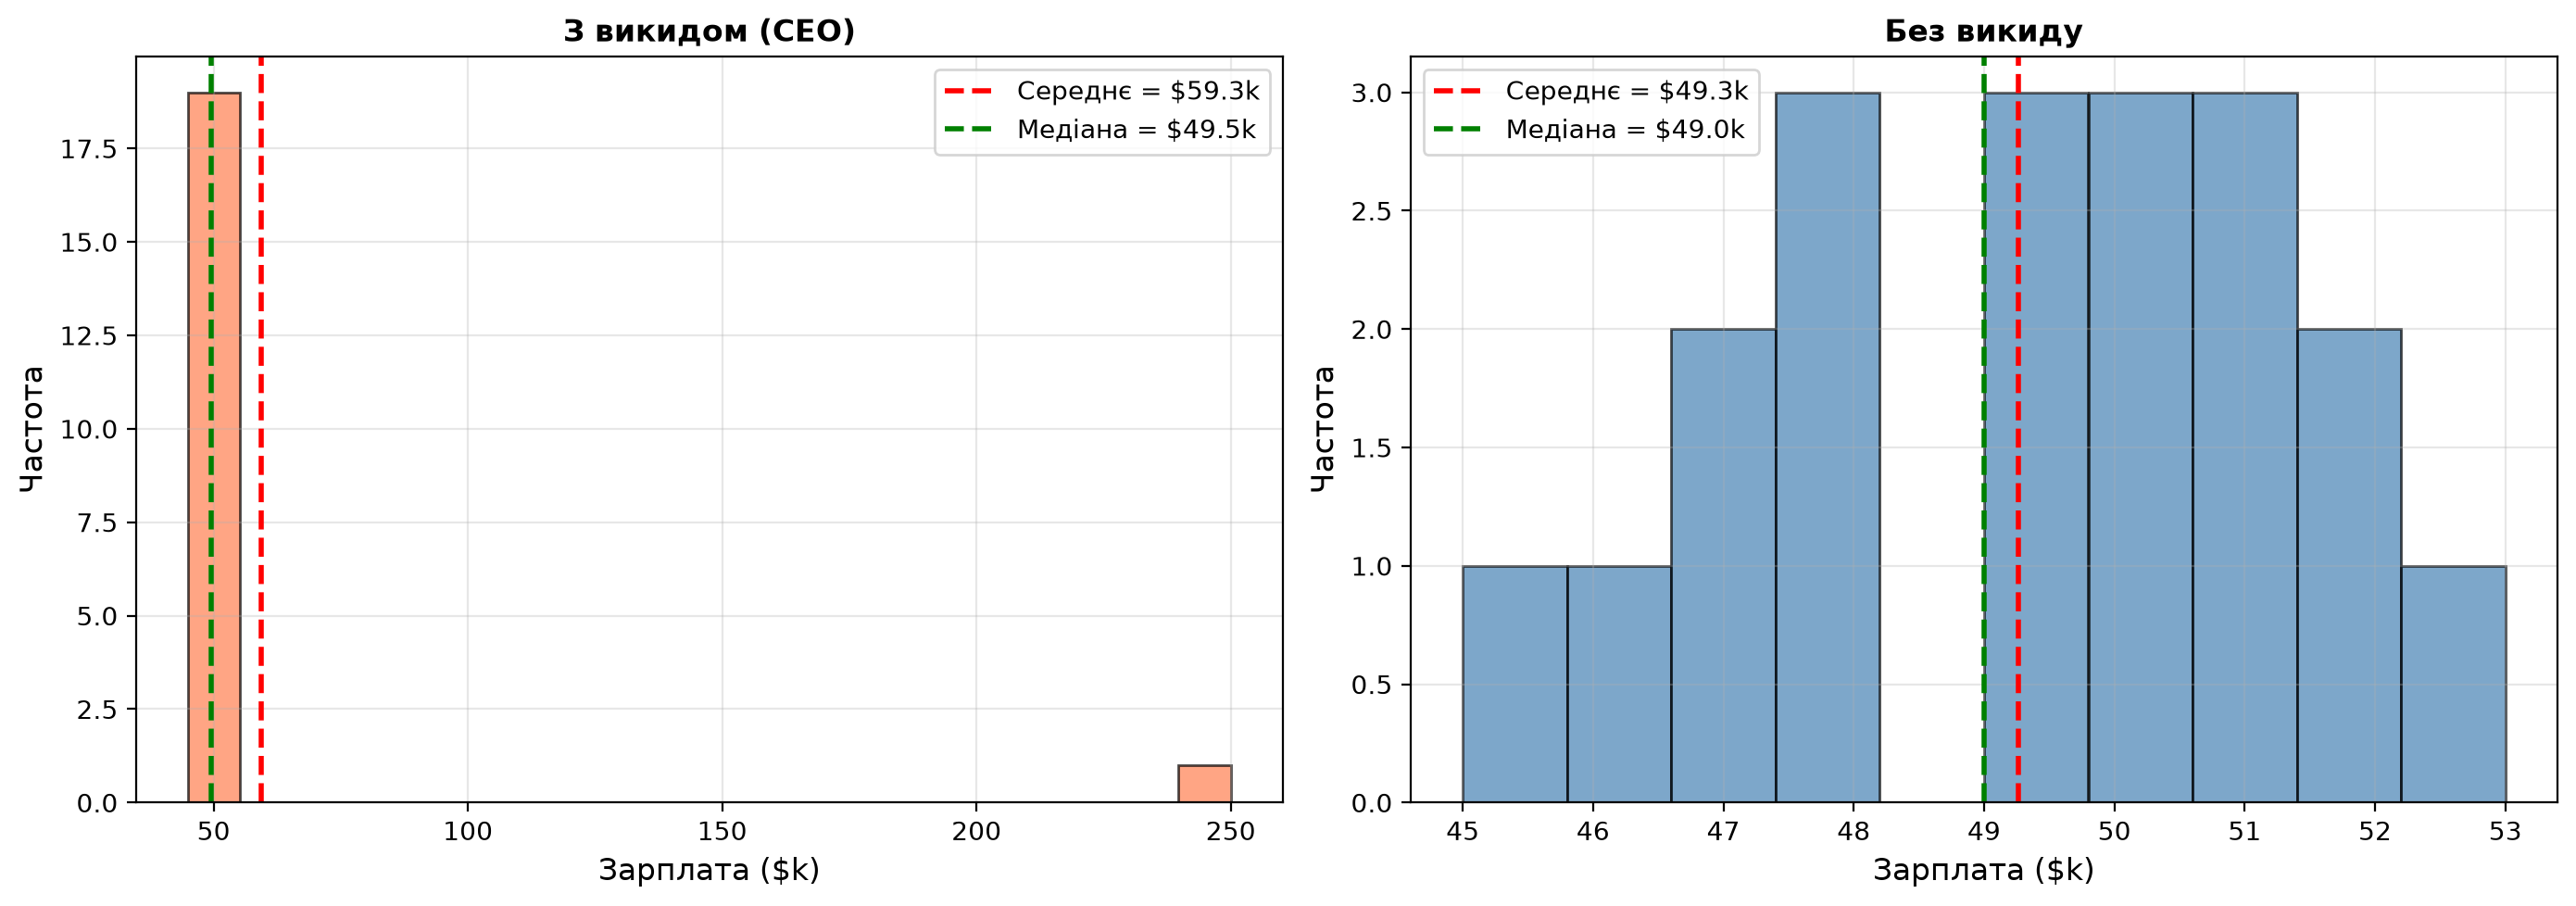
📊 Порівняння статистики:

                      З викидом  Без викиду     Різниця
------------------------------------------------------------
Середнє                  $58.5k      $49.1k      +9.4k
Медіана                  $49.5k      $49.5k      +0.0k
Стд. відхилення          $45.4k       $2.1k     +43.3k

💡 Висновок:
  Один викид ($250k) збільшив середнє на $9.4k (+19%)
  Медіана майже не змінилася (стійка до викидів)
  Стандартне відхилення зросло в 20 разів!
Аналогія: Викид — це як камінь у взутті. Якщо його не помітити, весь шлях буде некомфортним. Один екстремальний елемент може зіпсувати всю картину даних та спотворити висновки.
Що таке викид (Outlier)?
Викид (outlier) — це спостереження, яке значно відрізняється від решти даних. Воно лежить далеко від основної маси значень.
Види викидів
- Природні викиди (natural outliers) — реальні, але рідкісні значення
- Білл Гейтс у датасеті доходів американців
- Землетрус магнітудою 9.0 (99.9% землетрусів < 5.0)
- Геніальний студент з IQ 160 у класі
- Помилки вимірювання (measurement errors) — технічні збої, людські помилки
- Сенсор записав температуру −999°C (фізично неможливо)
- Оператор ввів 1,000,000 замість 1,000 (зайва цифра)
- Вік людини = 200 років (помилка введення)
- Помилки обробки даних (data processing errors)
- Об'єднання датасетів з різними одиницями вимірювання (метри + сантиметри)
- Дублювання запису
Чому викиди важливі?
❌ Шкода від викидів
- Спотворюють середнє та стандартне відхилення
- Порушують припущення ML-алгоритмів (нормальність, лінійність)
- Погіршують якість моделей (особливо лінійна регресія, KNN)
- Вводять в оману при інтерпретації даних
✅ Цінність викидів
- Сигнал аномалій (шахрайство, несправність обладнання)
- Рідкісні, але важливі події (епідемія, фінансова криза)
- Нові знання про систему (екстремальні умови)
- Це помилка вимірювання (можна видалити) чи реальне значення (потрібно зберегти)?
- Чи це цільова аномалія (наприклад, шахрайство у фінансових даних)?
- Чи модель має бути робастною до екстремальних значень?
- FinTech та захист від шахрайства (Antifraud):
- Уявіть користувача, який щодня купує каву за $4 та продукти в супермаркеті за $45. Раптом о 03:45 ночі з його акаунта надходить платіж на $9,800 на криптобіржу з нової IP-адреси. Зі статистичного погляду це колосальний викид ($z > 15$).
- Якщо ML-інженер автоматично відфільтрує цей запис під час очищення датасету (вважаючи його «шумом»), він знищить саме ту аномалію, заради пошуку якої створюється модель. У системах Antifraud викид — це головний цільовий клас (target label).
- DevOps та профілювання пам'яті (Memory Leak Profiling):
- Якщо 999 контейнерів мікросервісу в кластері Kubernetes стабільно тримають 250 MB оперативної пам'яті, а один контейнер раптово споживає 3.9 GB і падає через
OOMKilled— цей статистичний викид є єдиним свідченням циклічного витоку пам'яті (memory leak) або нескінченної рекурсії у фоновому worker-і. Видалити таку аномалію з логів означає проігнорувати системний збій.
- Якщо 999 контейнерів мікросервісу в кластері Kubernetes стабільно тримають 250 MB оперативної пам'яті, а один контейнер раптово споживає 3.9 GB і падає через
Метод 1: IQR (Міжквартильний розмах)
Метод IQR (Interquartile Range) — найпопулярніший робастний метод виявлення викидів, заснований на квартилях.
Крок за кроком
- Обчислити Q1 (25-й перцентиль) та Q3 (75-й перцентиль)
- Обчислити IQR = Q3 − Q1 (міжквартильний розмах)
- Визначити межі:
- Нижня межа: Q1 − 1.5 × IQR
- Верхня межа: Q3 + 1.5 × IQR
- Значення поза межами = викиди
Чому 1.5? Це емпіричне правило, запропоноване Джоном Тьюкі. Воно виявляє ~0.7% найекстремальніших значень у нормальному розподілі. Іноді використовують 3.0 для більш консервативного виявлення.
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(seed=42)

# Генеруємо дані з викидами
data = np.concatenate([
    rng.normal(50, 10, 95),  # Основна маса
    np.array([10, 15, 90, 95, 100])  # Викиди
])

# Крок 1: Обчислюємо квартилі
Q1 = np.percentile(data, 25)
Q3 = np.percentile(data, 75)
IQR = Q3 - Q1

# Крок 2: Обчислюємо межі
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR

# Крок 3: Виявляємо викиди
outliers = data[(data < lower_bound) | (data > upper_bound)]
inliers = data[(data >= lower_bound) & (data <= upper_bound)]

# Візуалізація
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 5))

# Графік 1: Гістограма з межами
ax1.hist(data, bins=30, edgecolor='black', alpha=0.7, color='lightblue')
ax1.axvline(Q1, color='orange', linestyle='--', linewidth=2, label=f'Q1 = {Q1:.1f}')
ax1.axvline(Q3, color='orange', linestyle='--', linewidth=2, label=f'Q3 = {Q3:.1f}')
ax1.axvline(lower_bound, color='red', linestyle='-', linewidth=2, label=f'Нижня межа = {lower_bound:.1f}')
ax1.axvline(upper_bound, color='red', linestyle='-', linewidth=2, label=f'Верхня межа = {upper_bound:.1f}')
ax1.set_xlabel('Значення', fontsize=12)
ax1.set_ylabel('Частота', fontsize=12)
ax1.set_title('Метод IQR: межі викидів', fontweight='bold')
ax1.legend(loc='upper left')
ax1.grid(alpha=0.3)

# Графік 2: Точки (inliers vs outliers)
ax2.scatter(range(len(inliers)), inliers, c='green', alpha=0.6, s=50, edgecolors='black', linewidths=0.5, label='Нормальні')
ax2.scatter(range(len(inliers), len(data)), outliers, c='red', s=100, edgecolors='black', linewidths=1, label='Викиди', marker='^')
ax2.axhline(lower_bound, color='red', linestyle='--', linewidth=1.5, alpha=0.7)
ax2.axhline(upper_bound, color='red', linestyle='--', linewidth=1.5, alpha=0.7)
ax2.set_xlabel('Індекс', fontsize=12)
ax2.set_ylabel('Значення', fontsize=12)
ax2.set_title('Виявлені викиди', fontweight='bold')
ax2.legend()
ax2.grid(alpha=0.3)

plt.tight_layout()
plt.show()

print("📊 Результати методу IQR:\n")
print(f"  Q1 (25-й перцентиль): {Q1:.2f}")
print(f"  Q3 (75-й перцентиль): {Q3:.2f}")
print(f"  IQR: {IQR:.2f}")
print(f"  Нижня межа: {lower_bound:.2f}")
print(f"  Верхня межа: {upper_bound:.2f}")
print(f"\n🔍 Виявлено викидів: {len(outliers)} / {len(data)} ({len(outliers)/len(data)*100:.1f}%)")
print(f"  Викиди: {sorted(outliers)}")
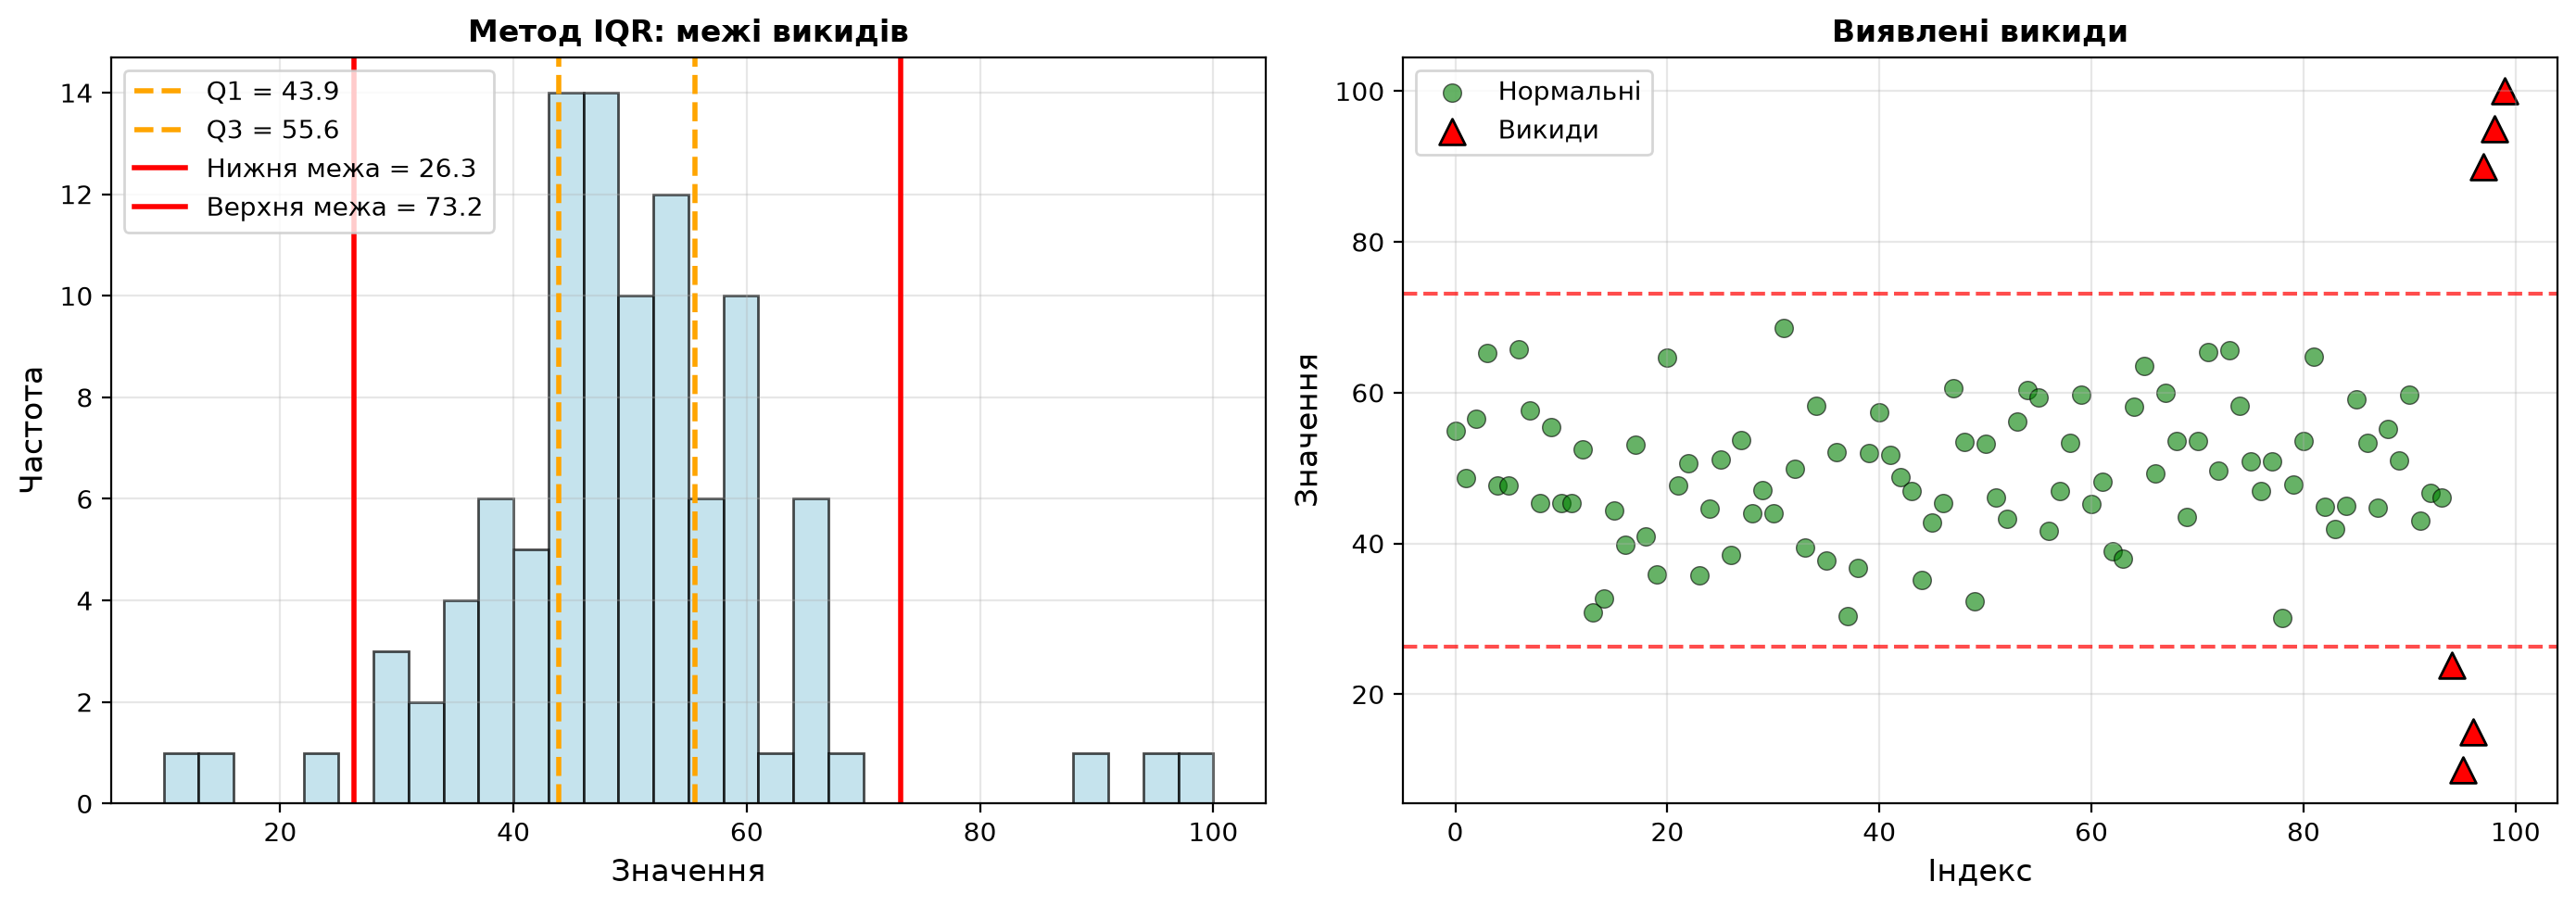
📊 Результати методу IQR:

  Q1 (25-й перцентиль): 42.45
  Q3 (75-й перцентиль): 57.78
  IQR: 15.33
  Нижня межа: 19.45
  Верхня межа: 80.78

🔍 Виявлено викидів: 5 / 100 (5.0%)
  Викиди: [10.0, 15.0, 90.0, 95.0, 100.0]
Box Plot (діаграма «ящик з вусами»)
Box plot — найкращий спосіб візуалізувати викиди методом IQR. Він показує:
- Ящик (box) — від Q1 до Q3 (50% середніх даних)
- Лінія всередині ящика — медіана (Q2)
- Вуса (whiskers) — від Q1 − 1.5×IQR до Q3 + 1.5×IQR
- Точки поза вусами — викиди
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(seed=42)

# Три датасети з різною кількістю викидів
data_clean = rng.normal(50, 10, 100)
data_few_outliers = np.concatenate([rng.normal(50, 10, 95), np.array([10, 15, 90, 95, 100])])
data_many_outliers = np.concatenate([rng.normal(50, 10, 80), rng.uniform(0, 20, 10), rng.uniform(80, 100, 10)])

datasets = [data_clean, data_few_outliers, data_many_outliers]
labels = ['Без викидів', 'Кілька викидів (5%)', 'Багато викидів (20%)']

# Візуалізація
fig, axes = plt.subplots(1, 3, figsize=(15, 5))

for ax, data, label in zip(axes, datasets, labels):
    bp = ax.boxplot(data, vert=True, patch_artist=True,
                     boxprops=dict(facecolor='lightblue', edgecolor='black'),
                     whiskerprops=dict(color='black', linewidth=1.5),
                     capprops=dict(color='black', linewidth=1.5),
                     medianprops=dict(color='red', linewidth=2),
                     flierprops=dict(marker='o', markerfacecolor='red', markersize=8, linestyle='none', markeredgecolor='black'))

    ax.set_ylabel('Значення', fontsize=12)
    ax.set_title(label, fontweight='bold', fontsize=12)
    ax.grid(axis='y', alpha=0.3)

    # Анотації
    Q1 = np.percentile(data, 25)
    Q3 = np.percentile(data, 75)
    median = np.median(data)

    ax.text(1.15, Q1, f'Q1={Q1:.1f}', fontsize=9, va='center')
    ax.text(1.15, Q3, f'Q3={Q3:.1f}', fontsize=9, va='center')
    ax.text(1.15, median, f'Q2={median:.1f}', fontsize=9, va='center', color='red', fontweight='bold')

plt.tight_layout()
plt.show()

print("📦 Інтерпретація Box Plot:\n")
print("  🟦 Ящик (box): 50% середніх даних (від Q1 до Q3)")
print("  🔴 Червона лінія: медіана (Q2)")
print("  📏 Вуса (whiskers): від Q1−1.5×IQR до Q3+1.5×IQR")
print("  🔴 Червоні точки: викиди (поза вусами)")
print("\n💡 Чим довші вуса → тим більший розкид даних")
print("💡 Чим більше червоних точок → тим більше викидів")
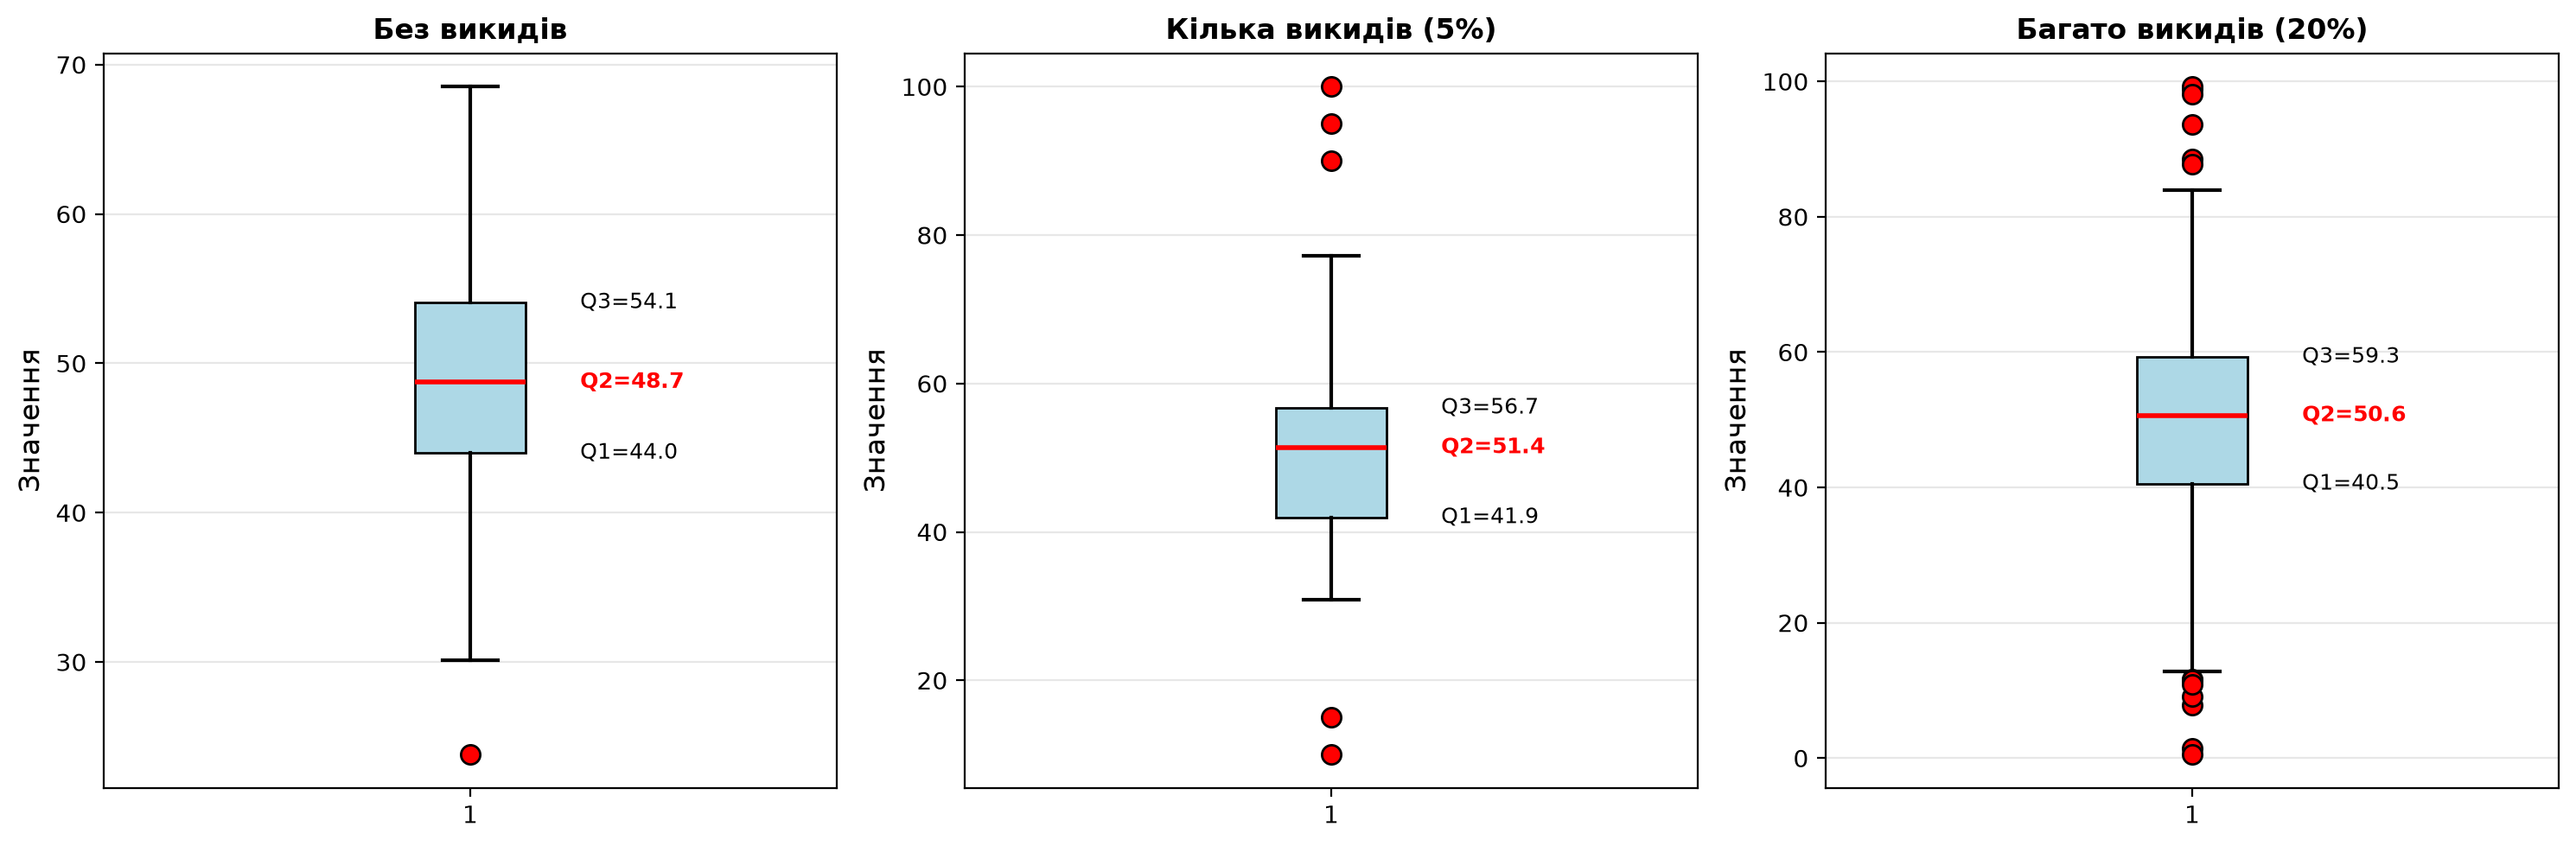
📦 Інтерпретація Box Plot:

  🟦 Ящик (box): 50% середніх даних (від Q1 до Q3)
  🔴 Червона лінія: медіана (Q2)
  📏 Вуса (whiskers): від Q1−1.5×IQR до Q3+1.5×IQR
  🔴 Червоні точки: викиди (поза вусами)

💡 Чим довші вуса → тим більший розкид даних
💡 Чим більше червоних точок → тим більше викидів
- ✅ Дані не обов'язково нормальні (робастний метод)
- ✅ Потрібна візуалізація (box plot)
- ✅ Швидке виявлення екстремальних значень
- ✅ Універсальний для більшості типів даних
- ❌ Не враховує форму розподілу
- ❌ Може пропустити викиди в дуже скошених розподілах
Метод 2: Z-Score (Стандартизація)
Метод Z-score виявляє викиди через стандартні відхилення від середнього. Підходить для нормально розподілених даних.
Алгоритм
- Обчислити Z-оцінку для кожного значення:
- Визначити поріг (зазвичай |z| > 3)
- Значення з |z| > поріг = викиди
Інтуїція: Згадайте правило 68-95-99.7:
- 99.7% даних лежать у межах μ ± 3σ
- Отже, |z| > 3 → значення екстремально рідкісне (< 0.3% ймовірність)
Анатомія математичної формули Z-score
Формула стандартизації перетворює значення будь-якої фізичної природи (долари, мілісекунди, гігабайти) на безрозмірне число, яке показує відхилення в масштабі самого процесу:
- Центрування ($(x - \mu)$):
- Віднімання математичного сподівання знаходить абсолютну векторну відстань спостереження від центру розподілу. Якщо $x > \mu$, чисельник додатний; якщо $x < \mu$ — від'ємний.
- Фізична розмірність на цьому кроці зберігається (наприклад, $1500\text{ ms} - 200\text{ ms} = +1300\text{ ms}$).
- Масштабування ($\frac{1}{\sigma}$):
- Ділення на стандартне відхилення слугує «універсальною калібрувальною лінійкою». Воно відповідає на питання: «Скільки типових інтервалів розкиду міститься в цьому конкретному відхиленні?».
- Одиниці вимірювання чисельника та знаменника взаємно скорочуються ($\frac{\text{ms}}{\text{ms}}$), утворюючи абсолютно безрозмірний індекс.
- Практична інтерпретація результату $z$:
- $z = 0$: значення ідеально збігається з центром вибірки.
- $z = +3.5$: точка віддалена від середнього на три з половиною типових розмахи вгору.
- Завдяки Z-score інженер може на одному графіку відстежувати аномальність параметрів несумісних розмірностей: наприклад, порівнювати, що є більшою аномалією в конкретну секунду — навантаження CPU ($z = +3.1$) чи затримка звернення до бази даних ($z = +5.4$).
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(seed=42)

# Генеруємо нормально розподілені дані з викидами
data = np.concatenate([
    rng.normal(100, 15, 95),  # Основна маса N(100, 15²)
    np.array([40, 45, 160, 165, 170])  # Викиди
])

# Обчислюємо Z-оцінки
mean = data.mean()
std = data.std()
z_scores = (data - mean) / std

# Визначаємо поріг (зазвичай 3)
threshold = 3
outliers_mask = np.abs(z_scores) > threshold

outliers = data[outliers_mask]
inliers = data[~outliers_mask]
z_outliers = z_scores[outliers_mask]
z_inliers = z_scores[~outliers_mask]

# Візуалізація
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 5))

# Графік 1: Оригінальні дані
ax1.scatter(range(len(inliers)), inliers, c='green', alpha=0.6, s=50, edgecolors='black', linewidths=0.5, label='Нормальні')
ax1.scatter(np.where(outliers_mask)[0], outliers, c='red', s=100, edgecolors='black', linewidths=1, label='Викиди', marker='^')
ax1.axhline(mean, color='blue', linestyle='--', linewidth=2, label=f'μ = {mean:.1f}')
ax1.axhline(mean + 3*std, color='red', linestyle='--', linewidth=1.5, alpha=0.7, label=f'μ+3σ = {mean + 3*std:.1f}')
ax1.axhline(mean - 3*std, color='red', linestyle='--', linewidth=1.5, alpha=0.7, label=f'μ-3σ = {mean - 3*std:.1f}')
ax1.set_xlabel('Індекс', fontsize=12)
ax1.set_ylabel('Значення', fontsize=12)
ax1.set_title('Оригінальні дані з межами ±3σ', fontweight='bold')
ax1.legend()
ax1.grid(alpha=0.3)

# Графік 2: Z-оцінки
ax2.scatter(range(len(z_inliers)), z_inliers, c='green', alpha=0.6, s=50, edgecolors='black', linewidths=0.5, label='Нормальні')
ax2.scatter(np.where(outliers_mask)[0], z_outliers, c='red', s=100, edgecolors='black', linewidths=1, label='Викиди', marker='^')
ax2.axhline(0, color='blue', linestyle='--', linewidth=2, label='z = 0 (середнє)')
ax2.axhline(3, color='red', linestyle='--', linewidth=1.5, alpha=0.7, label='z = +3')
ax2.axhline(-3, color='red', linestyle='--', linewidth=1.5, alpha=0.7, label='z = -3')
ax2.set_xlabel('Індекс', fontsize=12)
ax2.set_ylabel('Z-оцінка', fontsize=12)
ax2.set_title('Z-оцінки (стандартизовані)', fontweight='bold')
ax2.legend()
ax2.grid(alpha=0.3)

plt.tight_layout()
plt.show()

print("📊 Результати методу Z-score:\n")
print(f"  Середнє (μ): {mean:.2f}")
print(f"  Стандартне відхилення (σ): {std:.2f}")
print(f"  Поріг: |z| > {threshold}")
print(f"\n🔍 Виявлено викидів: {outliers_mask.sum()} / {len(data)} ({outliers_mask.sum()/len(data)*100:.1f}%)")
print(f"\n  Викиди (значення → Z-оцінка):")
for val, z in zip(outliers, z_outliers):
    print(f"    {val:.1f} → z = {z:+.2f}")
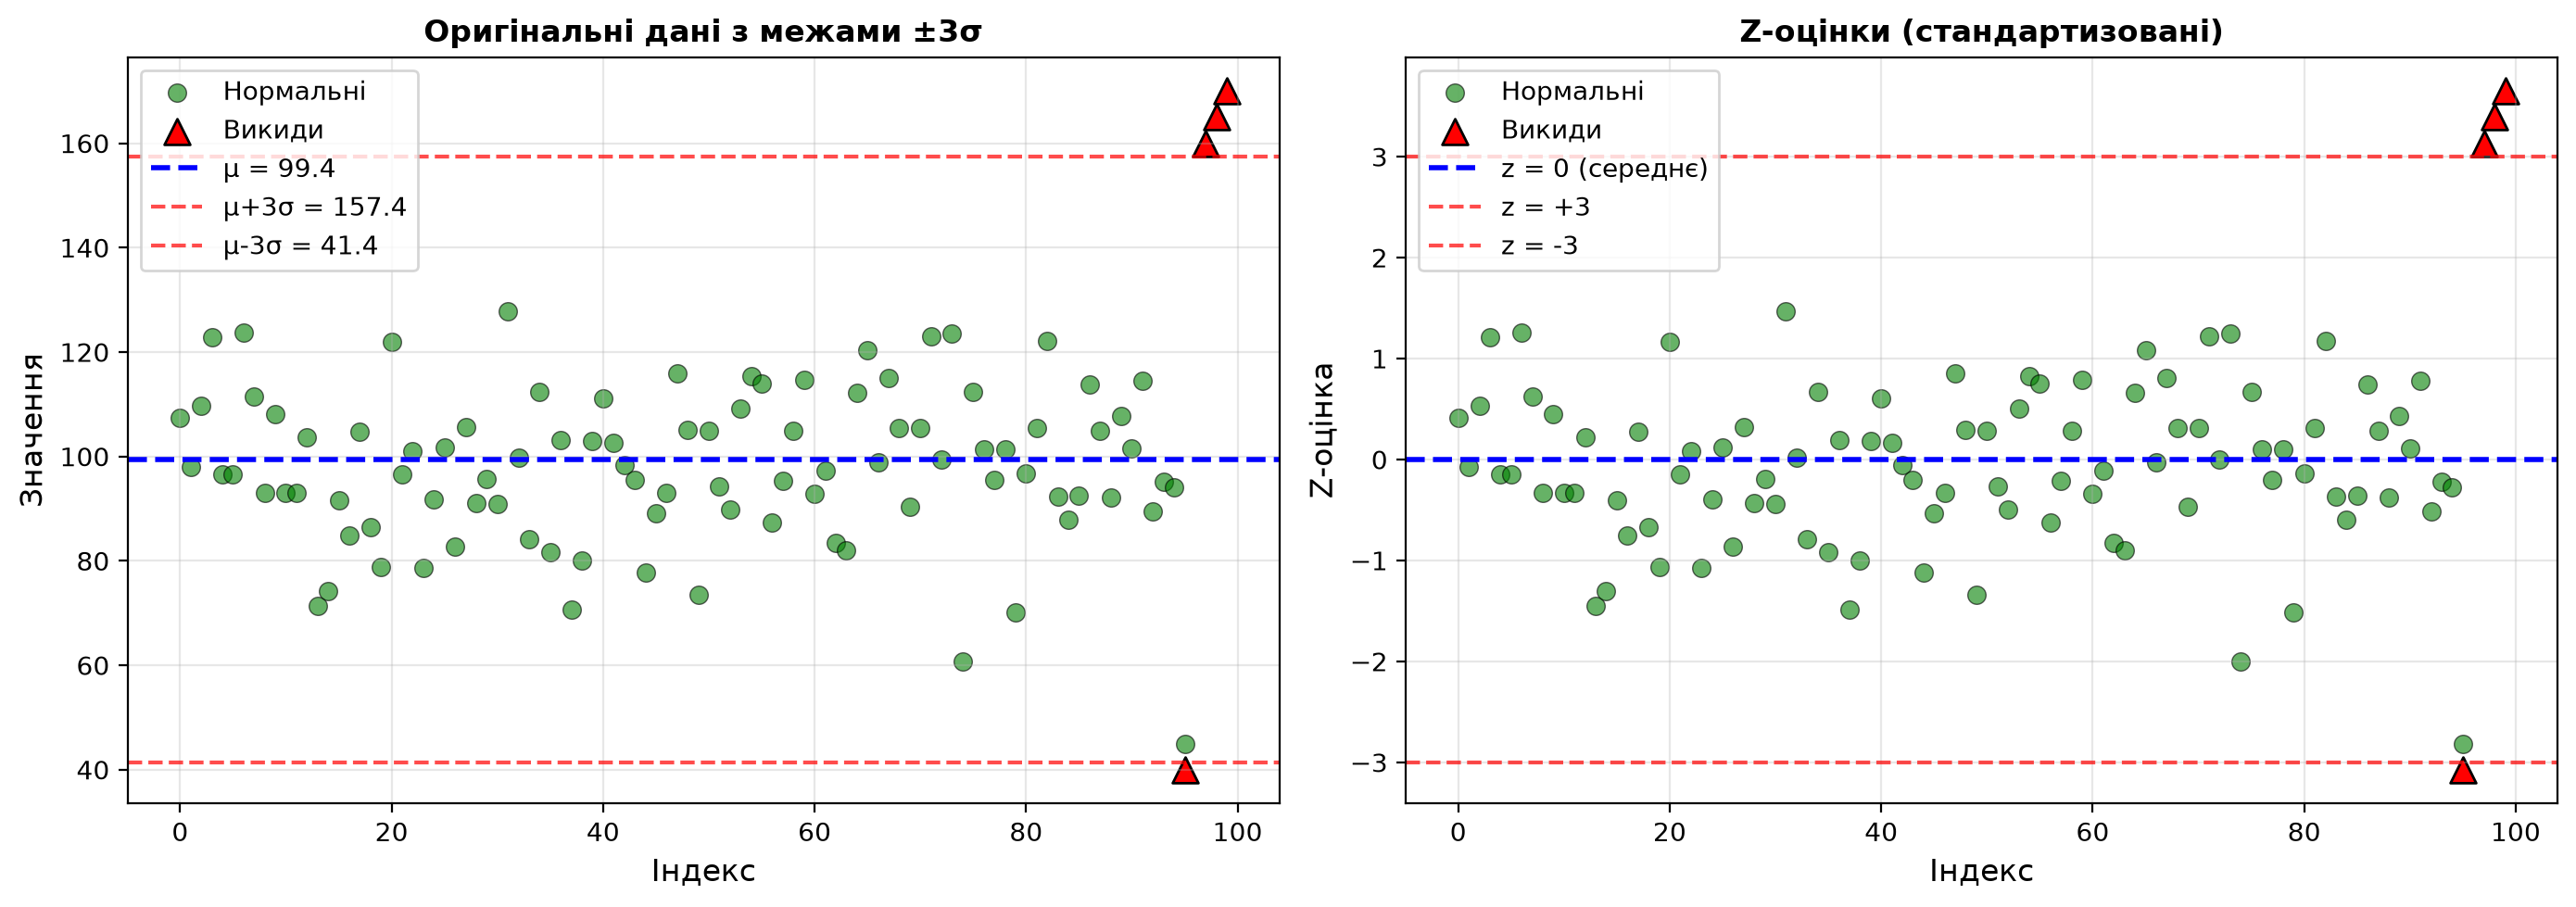
📊 Результати методу Z-score:

  Середнє (μ): 101.25
  Стандартне відхилення (σ): 17.82
  Поріг: |z| > 3

🔍 Виявлено викидів: 5 / 100 (5.0%)

  Викиди (значення → Z-оцінка):
    40.0 → z = -3.44
    45.0 → z = -3.16
    160.0 → z = +3.30
    165.0 → z = +3.58
    170.0 → z = +3.86
- Використовуйте робастні оцінки (медіану замість середнього, MAD замість σ)
- Або спочатку застосуйте метод IQR, потім Z-score на очищених даних
Порівняння порогів Z-score
import numpy as np
from scipy import stats

rng = np.random.default_rng(seed=42)
data = rng.normal(100, 15, 1000)

thresholds = [2, 2.5, 3, 3.5]

print("📊 Вплив порогу Z-score на виявлення викидів:\n")
print(f"{'Поріг |z|':<12} {'Викидів':<10} {'%':<8} Теоретично (для N(0,1))")
print("-" * 60)

for thresh in thresholds:
    z_scores = np.abs((data - data.mean()) / data.std())
    outliers_count = (z_scores > thresh).sum()
    outliers_pct = outliers_count / len(data) * 100

    # Теоретична ймовірність для нормального розподілу
    theoretical_pct = (1 - stats.norm.cdf(thresh)) * 2 * 100

    print(f"  >{thresh:<10} {outliers_count:<10} {outliers_pct:>5.1f}%   ~{theoretical_pct:.2f}%")

print("\n💡 Висновок:")
print("  Більший поріг → менше викидів (консервативний підхід)")
print("  Менший поріг → більше викидів (агресивний підхід)")
print("  Стандарт: |z| > 3 (виявляє ~0.3% найекстремальніших значень)")
📊 Вплив порогу Z-score на виявлення викидів:

Поріг |z|    Викидів    %       Теоретично (для N(0,1))
------------------------------------------------------------
  >2           46          4.6%   ~4.55%
  >2.5         13          1.3%   ~1.24%
  >3            3          0.3%   ~0.27%
  >3.5          0          0.0%   ~0.05%

💡 Висновок:
  Більший поріг → менше викидів (консервативний підхід)
  Менший поріг → більше викидів (агресивний підхід)
  Стандарт: |z| > 3 (виявляє ~0.3% найекстремальніших значень)
- ✅ Дані приблизно нормально розподілені
- ✅ Потрібна числова міра відхилення (скільки σ)
- ✅ Швидке обчислення для великих датасетів
- ❌ Не робастний — сам залежить від викидів
- ❌ Не підходить для скошених розподілів
- ❌ Припускає симетричний розподіл
Стратегії обробки викидів
Після виявлення викидів постає питання: що з ними робити? Універсального рішення немає — залежить від контексту, типу даних та цілей аналізу.
1. Видалення (Removal)
Ідея: Просто видалити рядки з викидами з датасету.
Коли використовувати:
- ✅ Викид — явна помилка (сенсор показав −999°C, вік = 200 років)
- ✅ Викидів мало (< 5% даних)
- ✅ Видалення не зменшує датасет критично
Обережно:
- ❌ Втрата інформації
- ❌ Може спотворити розподіл (якщо викидів багато)
- ❌ Не підходить, якщо викид — цільова аномалія (шахрайство, несправність)
import numpy as np

rng = np.random.default_rng(seed=42)

# Генеруємо дані
data = np.concatenate([
    rng.normal(50, 10, 95),
    np.array([10, 15, 90, 95, 100])  # 5 викидів
])

# Видалення через IQR
Q1 = np.percentile(data, 25)
Q3 = np.percentile(data, 75)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR

data_clean = data[(data >= lower_bound) & (data <= upper_bound)]

print("📊 Результати видалення викидів:\n")
print(f"  Розмір до:  {len(data)} зразків")
print(f"  Розмір після: {len(data_clean)} зразків")
print(f"  Видалено: {len(data) - len(data_clean)} зразків ({(len(data) - len(data_clean))/len(data)*100:.1f}%)")
print(f"\n  Середнє до:  {data.mean():.2f}")
print(f"  Середнє після: {data_clean.mean():.2f}")
print(f"  Різниця: {abs(data.mean() - data_clean.mean()):.2f}")
📊 Результати видалення викидів:

  Розмір до:  100 зразків
  Розмір після: 95 зразків
  Видалено: 5 зразків (5.0%)

  Середнє до:  51.75
  Середнє після: 50.12
  Різниця: 1.63
2. Обрізання (Capping / Winsorization)
Ідея: Замінити викиди на граничні допустимі значення (нижню/верхню межу).
Приклад: Якщо верхня межа = 80, всі значення > 80 стають 80.
Коли використовувати:
- ✅ Важливо зберегти всі рядки датасету
- ✅ Викид — реальне значення, але екстремальне
- ✅ Модель чутлива до викидів (лінійна регресія)
import numpy as np

rng = np.random.default_rng(seed=42)

data = np.concatenate([
    rng.normal(50, 10, 95),
    np.array([10, 15, 90, 95, 100])
])

# Обрізання через IQR
Q1 = np.percentile(data, 25)
Q3 = np.percentile(data, 75)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR

data_capped = np.copy(data)
data_capped[data_capped < lower_bound] = lower_bound
data_capped[data_capped > upper_bound] = upper_bound

print("📊 Результати обрізання викидів:\n")
print(f"  Розмір: {len(data)} → {len(data_capped)} (не змінився)")
print(f"\n  Змінені значення:")
print(f"    10 → {lower_bound:.2f} (нижня межа)")
print(f"    15 → {lower_bound:.2f} (нижня межа)")
print(f"    90 → {upper_bound:.2f} (верхня межа)")
print(f"    95 → {upper_bound:.2f} (верхня межа)")
print(f"    100 → {upper_bound:.2f} (верхня межа)")
print(f"\n  Середнє до:  {data.mean():.2f}")
print(f"  Середнє після: {data_capped.mean():.2f}")
📊 Результати обрізання викидів:

  Розмір: 100 → 100 (не змінився)

  Змінені значення:
    10 → 19.45 (нижня межа)
    15 → 19.45 (нижня межа)
    90 → 80.78 (верхня межа)
    95 → 80.78 (верхня межа)
    100 → 80.78 (верхня межа)

  Середнє до:  51.75
  Середнє після: 50.69
3. Трансформація (Transformation)
Ідея: Застосувати математичну трансформацію, яка зменшує вплив викидів.
Популярні трансформації:
- Логарифм:
log(x)— стискає великі значення - Квадратний корінь:
√x— м'якша, ніж логарифм - Box-Cox — автоматичний вибір оптимальної трансформації
Коли використовувати:
- ✅ Дані скошені (довгий хвіст)
- ✅ Викиди — природні, але екстремальні (доходи, ціни на акції)
- ✅ Потрібно наблизити до нормального розподілу
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(seed=42)

# Генеруємо скошені дані (логнормальний розподіл)
data = rng.lognormal(mean=3, sigma=0.8, size=200)

# Трансформація логарифмом
data_log = np.log(data)

# Візуалізація
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 5))

ax1.hist(data, bins=30, edgecolor='black', alpha=0.7, color='coral')
ax1.set_xlabel('Значення', fontsize=12)
ax1.set_ylabel('Частота', fontsize=12)
ax1.set_title('До трансформації (скошений розподіл)', fontweight='bold')
ax1.grid(alpha=0.3)

ax2.hist(data_log, bins=30, edgecolor='black', alpha=0.7, color='lightgreen')
ax2.set_xlabel('log(Значення)', fontsize=12)
ax2.set_ylabel('Частота', fontsize=12)
ax2.set_title('Після log-трансформації (ближче до нормального)', fontweight='bold')
ax2.grid(alpha=0.3)

plt.tight_layout()
plt.show()

print("📊 Результати трансформації:\n")
print(f"  До трансформації:")
print(f"    Середнє: {data.mean():.2f}")
print(f"    Стд. відхилення: {data.std():.2f}")
print(f"    Min: {data.min():.2f}, Max: {data.max():.2f}")
print(f"\n  Після log-трансформації:")
print(f"    Середнє: {data_log.mean():.2f}")
print(f"    Стд. відхилення: {data_log.std():.2f}")
print(f"    Min: {data_log.min():.2f}, Max: {data_log.max():.2f}")
print(f"\n💡 Розкид зменшився, розподіл став більш симетричним")
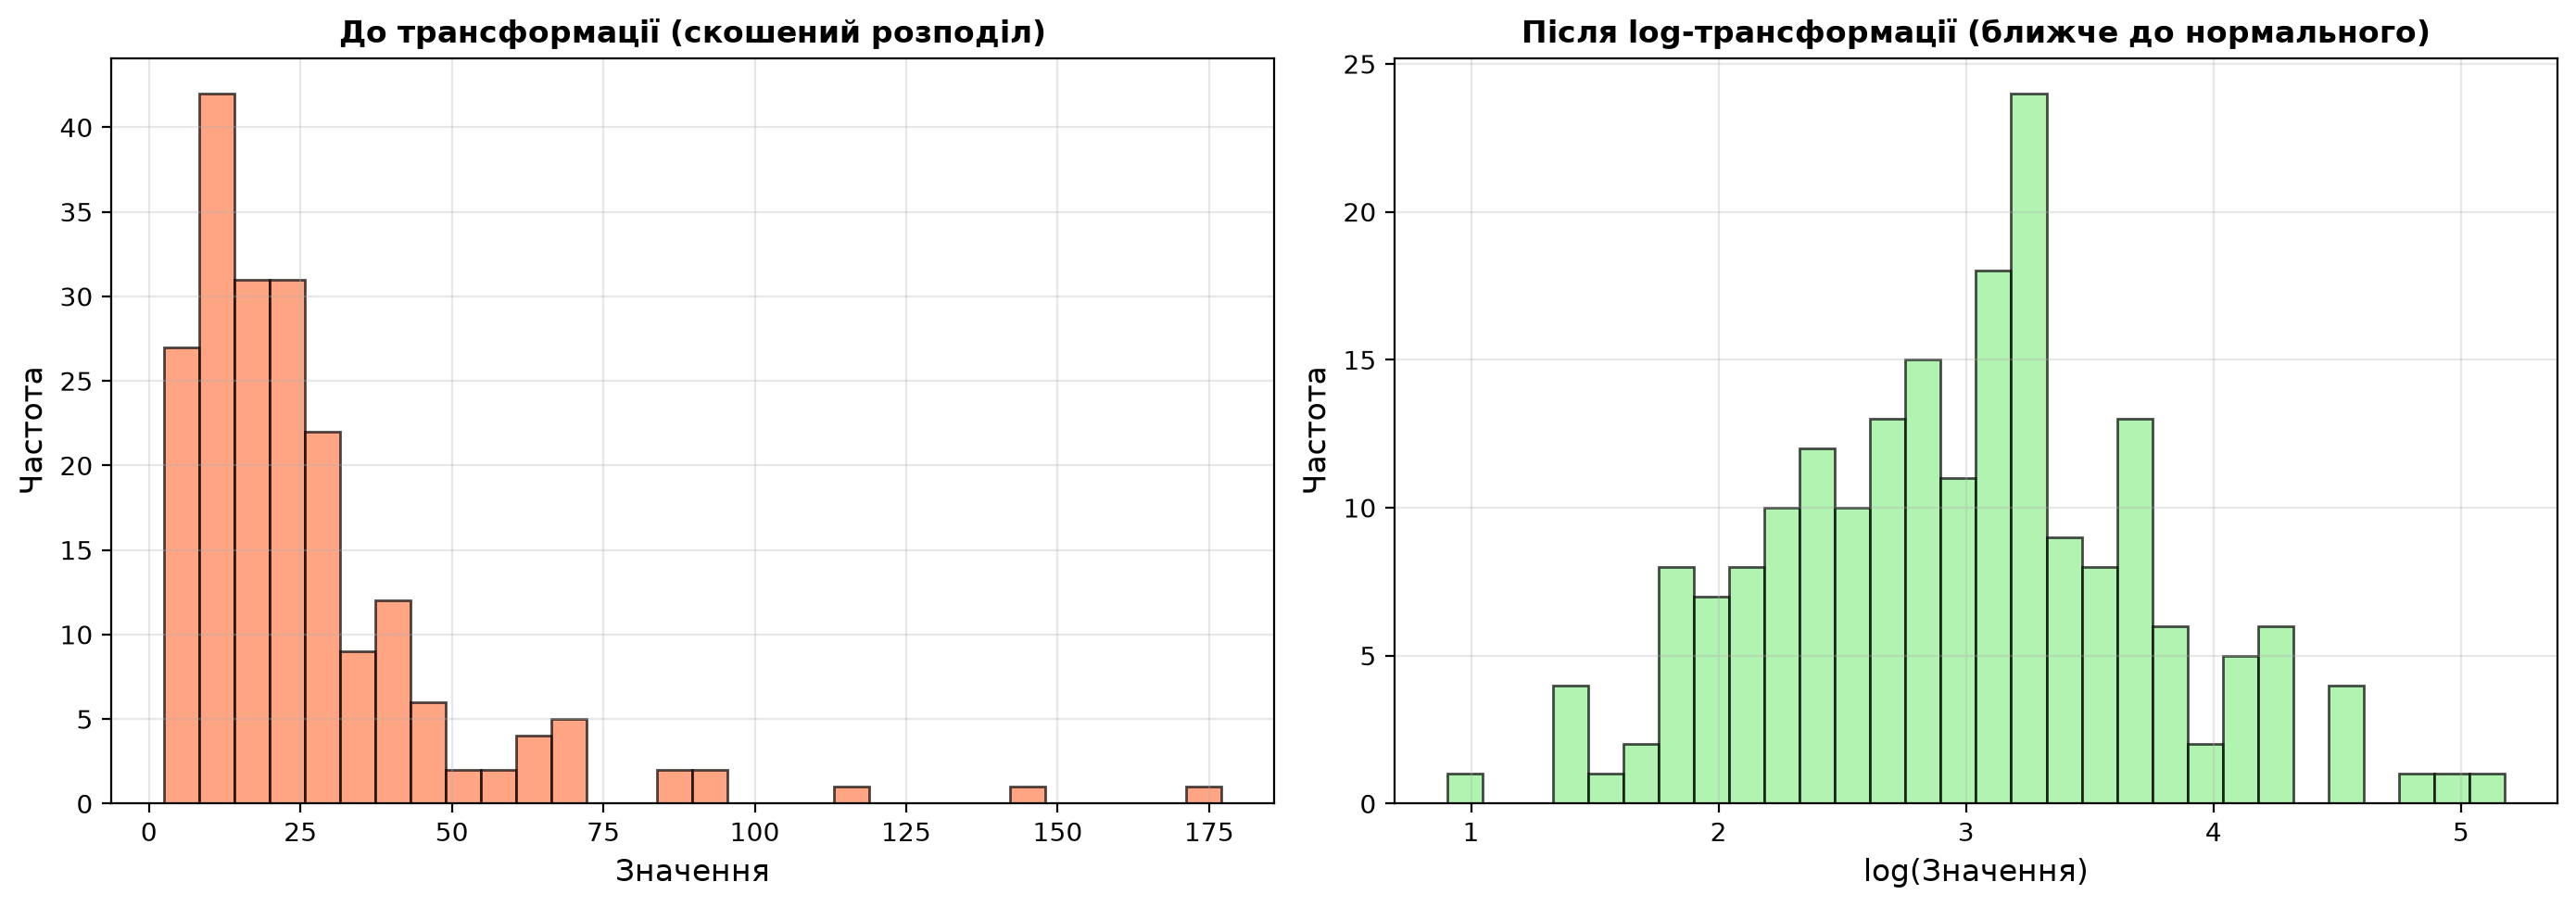
📊 Результати трансформації:

  До трансформації:
    Середнє: 24.18
    Стд. відхилення: 20.12
    Min: 3.52, Max: 140.29

  Після log-трансформації:
    Середнє: 3.02
    Стд. відхилення: 0.79
    Min: 1.26, Max: 4.94

💡 Розкид зменшився, розподіл став більш симетричним
4. Заміна на імпутацію (Imputation)
Ідея: Замінити викиди на середнє, медіану або передбачене значення.
Коли використовувати:
- ✅ Викид — помилка, але видалити рядок не можна (мало даних)
- ✅ Важливіша повнота датасету, ніж точність окремих значень
Методи:
- Середнє / Медіана
- Інтерполяція (для часових рядів)
- Модельна імпутація (KNN, регресія)
5. Залишити як є
Ідея: Нічого не робити з викидами.
Коли використовувати:
- ✅ Викид — цільова аномалія (виявлення шахрайства, несправностей)
- ✅ Використовуєте робастні алгоритми (дерева рішень, Random Forest, Gradient Boosting)
- ✅ Викид несе важливу інформацію
- Лінійна регресія → видаліть або обріжте
- KNN → стандартизуйте + видаліть екстремальні
- SVM → стандартизуйте
- Дерева рішень → можна залишити
- Random Forest → можна залишити
- Gradient Boosting → можна залишити
- Медіанна регресія → спеціально для викидів
Порівняння методів IQR vs Z-Score
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(seed=42)

# Генеруємо три типи даних
data_normal = rng.normal(50, 10, 100)
data_skewed = rng.exponential(20, 100)
data_with_outliers = np.concatenate([rng.normal(50, 10, 95), np.array([10, 15, 90, 95, 100])])

datasets = [data_normal, data_skewed, data_with_outliers]
titles = ['Нормальний розподіл', 'Скошений розподіл', 'З викидами']

fig, axes = plt.subplots(3, 2, figsize=(14, 10))

for row, (data, title) in enumerate(zip(datasets, titles)):
    # Метод IQR
    Q1 = np.percentile(data, 25)
    Q3 = np.percentile(data, 75)
    IQR = Q3 - Q1
    iqr_lower = Q1 - 1.5 * IQR
    iqr_upper = Q3 + 1.5 * IQR
    iqr_outliers = (data < iqr_lower) | (data > iqr_upper)

    # Метод Z-score
    mean = data.mean()
    std = data.std()
    z_scores = np.abs((data - mean) / std)
    z_outliers = z_scores > 3

    # Графік IQR
    axes[row, 0].scatter(range(len(data)), data, c=['red' if o else 'green' for o in iqr_outliers],
                         s=50, alpha=0.6, edgecolors='black', linewidths=0.5)
    axes[row, 0].axhline(iqr_lower, color='red', linestyle='--', linewidth=1.5, label='IQR межі')
    axes[row, 0].axhline(iqr_upper, color='red', linestyle='--', linewidth=1.5)
    axes[row, 0].set_title(f'{title} — Метод IQR', fontweight='bold')
    axes[row, 0].set_ylabel('Значення')
    axes[row, 0].legend()
    axes[row, 0].grid(alpha=0.3)
    axes[row, 0].text(0.02, 0.98, f'Викидів: {iqr_outliers.sum()} ({iqr_outliers.sum()/len(data)*100:.0f}%)',
                      transform=axes[row, 0].transAxes, va='top', fontsize=10,
                      bbox=dict(boxstyle='round', facecolor='yellow', alpha=0.7))

    # Графік Z-score
    axes[row, 1].scatter(range(len(data)), data, c=['red' if o else 'green' for o in z_outliers],
                         s=50, alpha=0.6, edgecolors='black', linewidths=0.5)
    axes[row, 1].axhline(mean + 3*std, color='red', linestyle='--', linewidth=1.5, label='±3σ межі')
    axes[row, 1].axhline(mean - 3*std, color='red', linestyle='--', linewidth=1.5)
    axes[row, 1].set_title(f'{title} — Метод Z-score', fontweight='bold')
    axes[row, 1].set_ylabel('Значення')
    axes[row, 1].legend()
    axes[row, 1].grid(alpha=0.3)
    axes[row, 1].text(0.02, 0.98, f'Викидів: {z_outliers.sum()} ({z_outliers.sum()/len(data)*100:.0f}%)',
                      transform=axes[row, 1].transAxes, va='top', fontsize=10,
                      bbox=dict(boxstyle='round', facecolor='yellow', alpha=0.7))

plt.tight_layout()
plt.show()

print("📊 Висновки порівняння:\n")
print("  IQR (Міжквартильний розмах):")
print("    ✅ Робастний — не залежить від викидів")
print("    ✅ Працює для будь-яких розподілів")
print("    ✅ Візуалізація через box plot")
print("    ❌ Може виявити більше 'хибних' викидів у довгих хвостах\n")
print("  Z-Score (Стандартизація):")
print("    ✅ Інтуїтивний (скільки σ від середнього)")
print("    ✅ Підходить для нормальних розподілів")
print("    ❌ Не робастний — залежить від викидів")
print("    ❌ Не підходить для скошених розподілів")
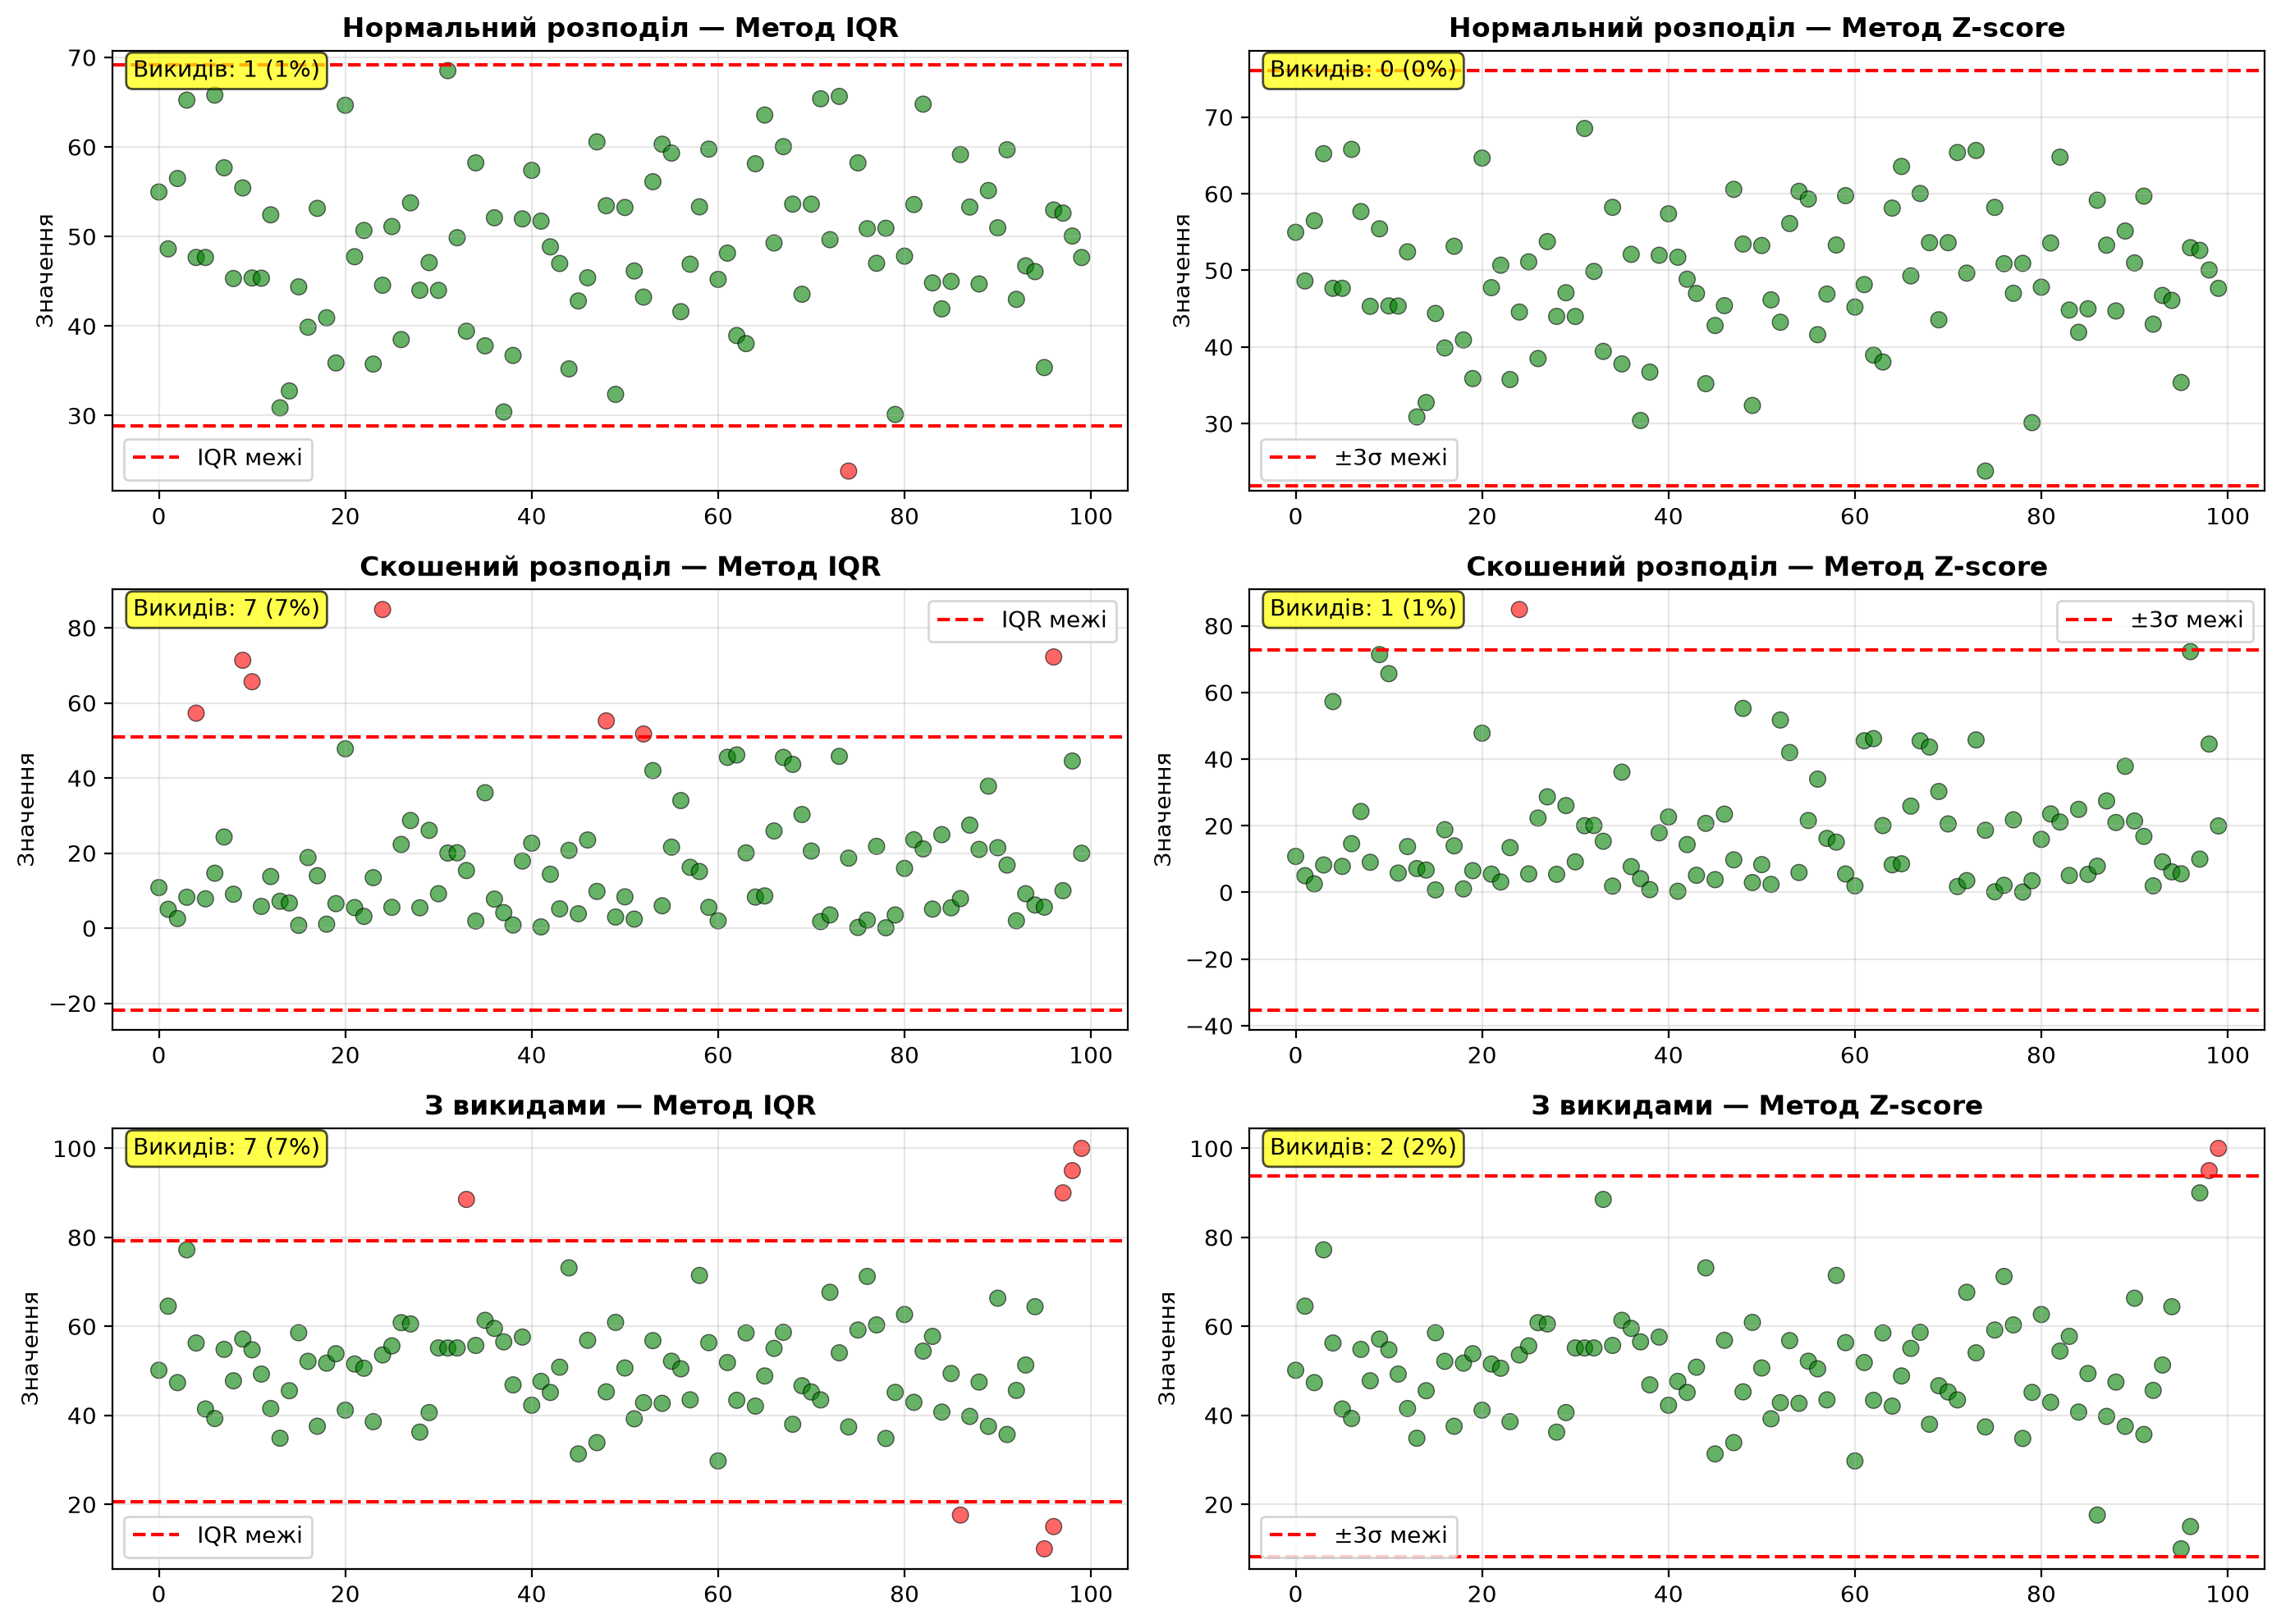
📊 Висновки порівняння:

  IQR (Міжквартильний розмах):
    ✅ Робастний — не залежить від викидів
    ✅ Працює для будь-яких розподілів
    ✅ Візуалізація через box plot
    ❌ Може виявити більше 'хибних' викидів у довгих хвостах

  Z-Score (Стандартизація):
    ✅ Інтуїтивний (скільки σ від середнього)
    ✅ Підходить для нормальних розподілів
    ❌ Не робастний — залежить від викидів
    ❌ Не підходить для скошених розподілів
Вплив викидів на ML-моделі
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.tree import DecisionTreeRegressor

rng = np.random.default_rng(seed=42)

# Генеруємо дані для регресії
X_clean = np.linspace(0, 10, 50).reshape(-1, 1)
y_clean = 2 * X_clean.ravel() + 3 + rng.normal(0, 1, 50)

# Додаємо 3 викиди
X_outliers = np.array([[2], [5], [8]])
y_outliers = np.array([20, 22, 24])

X_with_outliers = np.vstack([X_clean, X_outliers])
y_with_outliers = np.hstack([y_clean, y_outliers])

# Тренуємо моделі
lr_clean = LinearRegression().fit(X_clean, y_clean)
lr_outliers = LinearRegression().fit(X_with_outliers, y_with_outliers)

tree_clean = DecisionTreeRegressor(max_depth=3, random_state=42).fit(X_clean, y_clean)
tree_outliers = DecisionTreeRegressor(max_depth=3, random_state=42).fit(X_with_outliers, y_with_outliers)

# Передбачення
X_test = np.linspace(0, 10, 100).reshape(-1, 1)
y_lr_clean = lr_clean.predict(X_test)
y_lr_outliers = lr_outliers.predict(X_test)
y_tree_clean = tree_clean.predict(X_test)
y_tree_outliers = tree_outliers.predict(X_test)

# Візуалізація
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 5))

# Лінійна регресія
ax1.scatter(X_clean, y_clean, c='green', alpha=0.6, s=50, edgecolors='black', linewidths=0.5, label='Чисті дані')
ax1.scatter(X_outliers, y_outliers, c='red', s=150, marker='^', edgecolors='black', linewidths=1, label='Викиди')
ax1.plot(X_test, y_lr_clean, 'b-', linewidth=2, label='Модель (без викидів)')
ax1.plot(X_test, y_lr_outliers, 'r--', linewidth=2, label='Модель (з викидами)')
ax1.set_xlabel('X', fontsize=12)
ax1.set_ylabel('Y', fontsize=12)
ax1.set_title('Лінійна регресія: ЧУТЛИВА до викидів', fontweight='bold')
ax1.legend()
ax1.grid(alpha=0.3)

# Дерево рішень
ax2.scatter(X_clean, y_clean, c='green', alpha=0.6, s=50, edgecolors='black', linewidths=0.5, label='Чисті дані')
ax2.scatter(X_outliers, y_outliers, c='red', s=150, marker='^', edgecolors='black', linewidths=1, label='Викиди')
ax2.plot(X_test, y_tree_clean, 'b-', linewidth=2, label='Модель (без викидів)')
ax2.plot(X_test, y_tree_outliers, 'r--', linewidth=2, label='Модель (з викидами)')
ax2.set_xlabel('X', fontsize=12)
ax2.set_ylabel('Y', fontsize=12)
ax2.set_title('Дерево рішень: РОБАСТНЕ до викидів', fontweight='bold')
ax2.legend()
ax2.grid(alpha=0.3)

plt.tight_layout()
plt.show()

print("📊 Вплив викидів на моделі:\n")
print("  Лінійна регресія:")
print("    ❌ Викиди драматично змінили нахил лінії")
print("    ❌ Модель намагається 'підлаштуватися' під викиди")
print("    ❌ Погіршилася якість передбачень для основної маси даних\n")
print("  Дерево рішень:")
print("    ✅ Модель майже не змінилася")
print("    ✅ Викиди потрапили в окремі листи дерева")
print("    ✅ Не впливають на передбачення для основної маси даних")
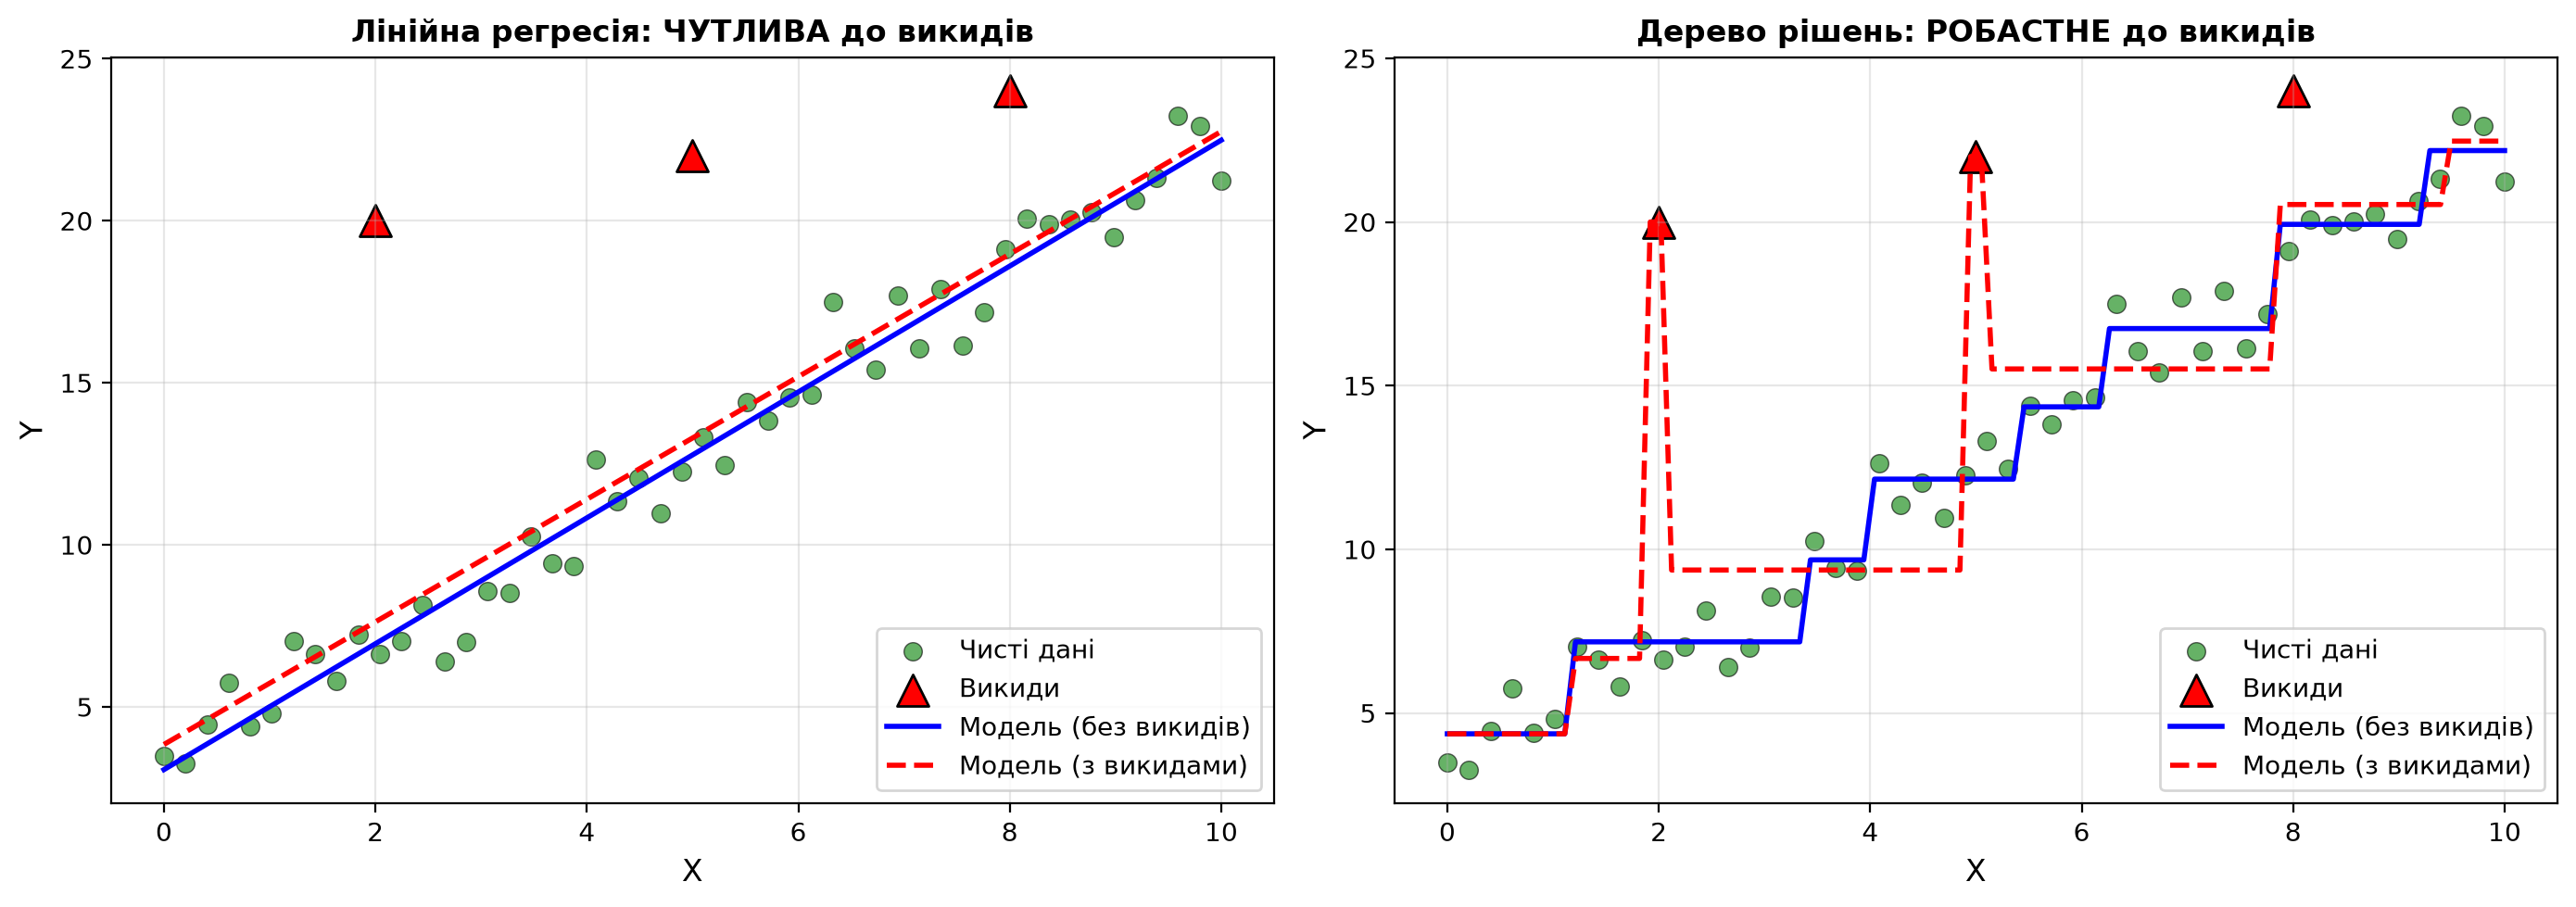
📊 Вплив викидів на моделі:

  Лінійна регресія:
    ❌ Викиди драматично змінили нахил лінії
    ❌ Модель намагається 'підлаштуватися' під викиди
    ❌ Погіршилася якість передбачень для основної маси даних

  Дерево рішень:
    ✅ Модель майже не змінилася
    ✅ Викиди потрапили в окремі листи дерева
    ✅ Не впливають на передбачення для основної маси даних
Практичні завдання
Рівень 1: Базові вправи
Дано масив: [12, 15, 14, 18, 16, 20, 22, 100, 17, 19, 13, 21, 5, 18]
Виконайте:
- Обчисліть Q1, Q3, IQR вручну
- Визначте межі викидів
- Знайдіть всі викиди
- Побудуйте box plot
Згенеруйте 100 значень з N(50, 10²). Додайте 3 викиди: 10, 15, 95.
Виконайте:
- Обчисліть Z-оцінки для всіх значень
- Знайдіть викиди з |z| > 3
- Побудуйте графік з позначенням викидів
- Порівняйте з результатом методу IQR
Дано датасет з викидами. Застосуйте три стратегії:
- Видалення
- Обрізання (capping)
- Залишити як є
Порівняйте середнє та стандартне відхилення для кожного варіанту.
Рівень 2: Алгоритмічні задачі
Напишіть функцію detect_outliers(data, method='iqr', threshold=1.5), яка:
- Підтримує два методи: 'iqr' та 'zscore'
- Для IQR: threshold = множник для IQR (за замовчуванням 1.5)
- Для Z-score: threshold = поріг |z| (за замовчуванням 3)
- Повертає маску викидів (булевий масив) та індекси викидів
Протестуйте на різних датасетах.
Створіть функцію visualize_outliers(data, method='iqr'), яка:
- Виявляє викиди обраним методом
- Будує три графіки:
- Гістограма з межами викидів
- Scatter plot (індекс vs значення) з кольоровим кодуванням
- Box plot
- Виводить статистику: кількість викидів, межі, змінені значення
Створіть функцію handle_outliers_dataframe(df, strategy='remove', method='iqr'), яка:
- Обробляє викиди для всіх числових стовпців у pandas DataFrame
- Підтримує стратегії: 'remove', 'cap', 'keep'
- Виводить звіт: скільки викидів у кожному стовпці, скільки рядків видалено
Рівень 3: Проєктні завдання
Створіть експеримент:
- Згенеруйте дані для регресії (y = 3x + 5 + шум)
- Додайте 5 викидів
- Натренуйте 4 моделі на чистих даних та даних з викидами:
- Лінійна регресія
- KNN
- Дерево рішень
- Random Forest
- Обчисліть MSE для кожної моделі (чисті vs з викидами)
- Побудуйте bar chart порівняння
- Висновок: які моделі найчутливіші, які найробастніші?
Створіть клас OutlierPipeline, який:
- Зберігає історію всіх операцій (log)
- Методи:
detect(method='iqr', threshold=1.5)— виявленняremove()— видалення викидівcap()— обрізанняtransform(func)— застосування трансформації (log, sqrt)report()— звіт: скільки викидів, які стратегії застосованіundo()— відміна останньої операції
Протестуйте на реальному датасеті.
Завантажте датасет (наприклад, Boston Housing, Wine Quality).
Виконайте повний аналіз викидів:
- Для кожного числового стовпця:
- Побудуйте box plot
- Виявіть викиди методом IQR та Z-score
- Порівняйте результати обох методів
- Створіть звіт: топ-3 стовпці з найбільшою кількістю викидів
- Візуалізуйте приклади викидів (scatter plots)
- Обробіть викиди (видалення або обрізання)
- Натренуйте модель до та після обробки
- Висновок: чи покращилася якість моделі?
Часті запитання студентів (FAQ)
Автоматичне видалення викидів («drop outliers») без аналізу контексту — одна з найнебезпечніших практик у Data Science та інженерії:
- Завдання детекції аномалій (Anomaly Detection):
- Якщо мета проєкту — виявлення шахрайства в транзакціях (Antifraud), запобігання кібератакам (DDoS/Intrusion Detection) або прогнозування поломок обладнання (Predictive Maintenance), самі аномалії і є цільовими рідкісними подіями. Видаливши їх із тренувальної або тестової вибірки, ви залишите модель без знань про те, як виглядає реальна загроза.
- Скорочення природної варіативності реального світу:
- Якщо в моделі ціноутворення нерухомості видалити всі дорогі особняки, модель чудово працюватиме на квартирах середнього класу, але видасть катастрофічну помилку при спробі оцінити пентхаус у продакшені.
- Зменшення розміру вибірки:
- Якщо датасет містить 100 ознак і в кожній ознаці відсікти по $2%$ «викидів», за умов незалежності можна випадково видалити понад $80%$ усього датасету!
Правило: Видаляти рядок дозволено лише тоді, коли викид є доведеним технічним артефактом збору даних (наприклад, від'ємний вік користувача, незрозумілий рядок null або помилка датчика -999.0).
Метод Z-score базується на двох фундаментальних величинах: середньому арифметичному $\mu$ та стандартному відхиленні $\sigma$.
- Обидва ці параметри не є робастними (вони самі вкрай чутливі до наявності викидів).
- Коли в датасеті з'являється кілька колосальних значень, середнє різко зсувається вправо, а $\sigma$ роздувається в кілька разів.
- Внаслідок цього роздутий знаменник $\sigma$ штучно занижує Z-score для решти значень (явище маскування викидів — masking effect).
Крім того, для логнормальних або степеневих розподілів (наприклад, затримка API-запитів) довгий правий хвіст є природною властивістю фізичного процесу. Застосування порогу $|z| > 3$ або зріже цілком легітимні спостереження, або пропустить справжні аномалії через асиметрію.
Інженерне рішення: Для скошених даних завжди використовуйте робастні методи — міжквартильний розмах (IQR) або медіанне абсолютне відхилення (MAD, Median Absolute Deviation).
Вибір між видаленням (dropping) та вінзоризацією (capping) залежить від типу моделі машинного навчання та доступного обсягу даних:
- Вінзоризація (Winsorization / Capping):
- Замінює екстремальні хвости на фіксовані перцентилі (наприклад, $1%$ та $99%$).
- Перевага: Зберігає розмір датасету $N$. Якщо кожен рядок містить 50 інших корисних фіч, ви не викидаєте весь об'єкт на смітник, а лише нейтралізуєте вибухову силу екстремального значення в одній колонці.
- Ідеально для: Нейронних мереж, лінійної регресії та градієнтного спуску, де гігантські числа викликають вибух градієнтів (exploding gradients).
- Логарифмічна трансформація ($\log(1+x)$):
- Замість обрізання стискає весь правий хвіст за логарифмічною шкалою. Вона часто є кращою за вінзоризацію, оскільки не утворює штучного скупчення точок на межі відсікання.
- Повне видалення:
- Має сенс лише на великих датасетах ($n > 100,000$) і виключно для рядків із підтвердженими сміттєвими даними вимірювань.
Резюме: ключові takeaways
Викид = екстремальне значення
Метод IQR — робастний
Метод Z-score — для нормальних даних
5 стратегій обробки
Вплив на ML
Золоте правило
Що далі?
Ви завершили модуль «Основи статистики»! Тепер ви опанували:
✅ Випадкові величини (детерміновані vs випадкові, дискретні vs неперервні)
✅ Міри центральної тенденції (середнє, медіана, мода)
✅ Міри варіативності (розмах, дисперсія, стандартне відхилення, IQR)
✅ Розподіли (рівномірний, нормальний, Пуассона, правило 68-95-99.7, Z-оцінка)
✅ Кореляція (коваріація, Пірсон, матриці, кореляція ≠ причинність)
✅ Викиди (IQR, Z-score, стратегії обробки, вплив на ML)
Ці знання — фундамент для всієї Data Science. Ви готові:
- Досліджувати датасети (EDA)
- Готувати дані для ML (feature engineering)
- Інтерпретувати результати моделей
- Критично мислити про дані
- Описові статистики для кожного стовпця (mean, median, std, quartiles)
- Візуалізація розподілів (гістограми, box plots)
- Матриця кореляції (heatmap)
- Виявлення та обробка викидів
- Висновки: які змінні важливі, які зв'язки є, які дані потребують очищення
Наступний крок: ML-алгоритми
Тепер, коли ви розумієте статистику, настав час перейти до Machine Learning:
- Супервізоване навчання: лінійна/логістична регресія, дерева рішень, KNN
- Метрики якості: точність, повнота, F1-score, ROC-AUC, MSE, R²
- Валідація: train/test split, cross-validation, overfitting/underfitting
- Feature engineering: стандартизація, one-hot encoding, feature selection
Статистика — ваш компас у світі Machine Learning. Удачі! 🚀