Розподіли випадкових величин
Розподіли випадкових величин
🎯 Мета підтеми
- Зрозуміти, що таке розподіл випадкової величини
- Опанувати три ключові розподіли: рівномірний, нормальний, Пуассона
- Навчитися розпізнавати розподіли в реальних даних
- Генерувати синтетичні дані з різними розподілами
- Побачити зв'язок між розподілами та алгоритмами ML
🔑 Ключові терміни
- Розподіл (distribution) — правило, за яким випадкова величина набуває значень
- Функція щільності ймовірності (PDF) — для неперервних величин
- Функція ймовірності (PMF) — для дискретних величин
- Нормальний розподіл (normal/Gaussian) — дзвоноподібна крива, найпоширеніший у природі
- Правило 68-95-99.7 — емпіричне правило для нормального розподілу
Навіщо передбачати завтра, коли є вчора?
Уявіть: ви власник кав'ярні. Щоранку потрібно замовляти молоко. Замало — залишите клієнтів без кави. Забагато — молоко скисне.
Ви вирішуєте вивчити історію. Записуєте, скільки літрів молока витрачається щодня протягом 100 днів. Отримуєте масив чисел:
[42, 38, 45, 41, 43, 39, 44, 40, 42, 41, ...]
Тепер питання: скільки замовити завтра? Середнє — 41.5 літра. Але чи достатньо знати лише середнє?
Ні. Вам потрібно знати розподіл — як часто трапляються різні значення:
- Чи майже завжди витрачається 40–43 літри (стабільно)?
- Чи бувають різкі стрибки до 50–60 літрів (непередбачувано)?
- Чи є дні з мінімальним споживанням 30–35 літрів (вихідні)?
Розподіл дає вам повну картину, а не лише одну цифру (середнє).
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(seed=42)

# Симулюємо споживання молока (нормальний розподіл)
milk_consumption = rng.normal(loc=41.5, scale=3.5, size=100)
milk_consumption = np.clip(milk_consumption, 30, 55)  # реалістичні межі

# Статистика
mean = milk_consumption.mean()
std = milk_consumption.std()

print(f"Середнє споживання: {mean:.1f} літрів")
print(f"Стандартне відхилення: {std:.1f} літрів")
print(f"\nПередбачення на завтра:")
print(f"  З ймовірністю 68%: {mean - std:.1f} — {mean + std:.1f} літрів")
print(f"  З ймовірністю 95%: {mean - 2*std:.1f} — {mean + 2*std:.1f} літрів")

# Візуалізація розподілу
plt.figure(figsize=(10, 5))
plt.hist(milk_consumption, bins=15, edgecolor='black', alpha=0.7, color='steelblue')
plt.axvline(mean, color='red', linestyle='--', linewidth=2, label=f'Середнє = {mean:.1f}')
plt.axvline(mean - std, color='orange', linestyle='--', linewidth=1.5, label=f'±1σ ({mean-std:.1f} — {mean+std:.1f})')
plt.axvline(mean + std, color='orange', linestyle='--', linewidth=1.5)
plt.xlabel('Споживання молока (літри)')
plt.ylabel('Частота (кількість днів)')
plt.title('Розподіл споживання молока за 100 днів', fontweight='bold')
plt.legend()
plt.grid(alpha=0.3)
plt.show()
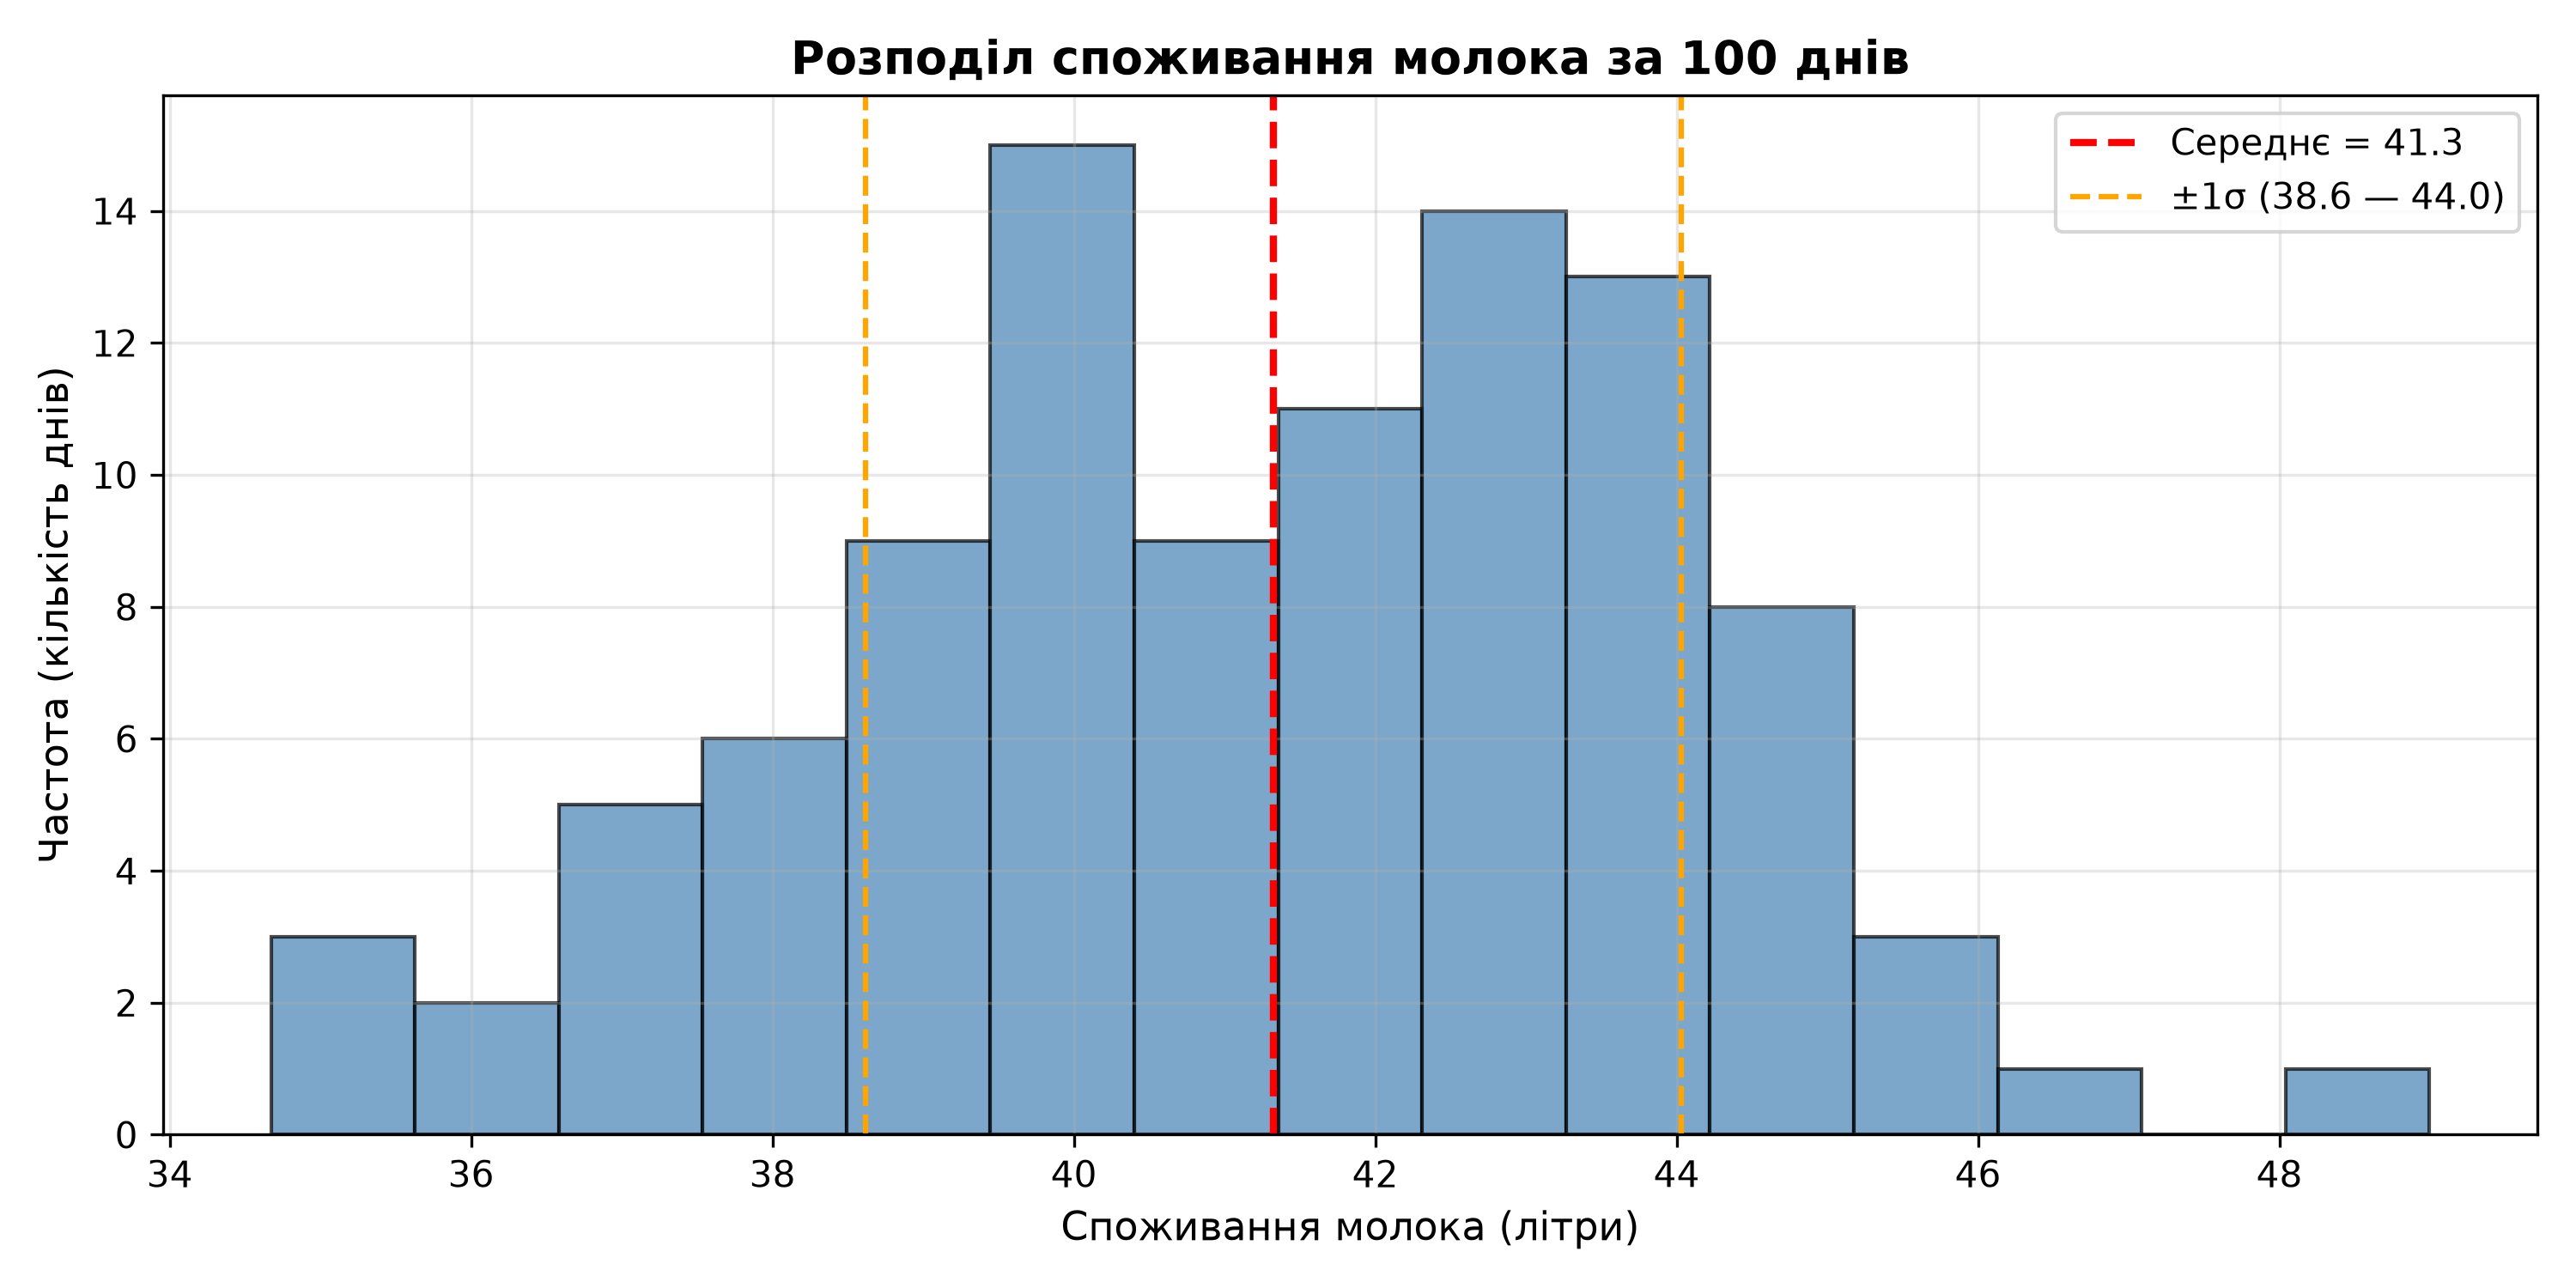
Середнє споживання: 41.3 літрів
Стандартне відхилення: 2.7 літрів

Передбачення на завтра:
  З ймовірністю 68%: 38.6 — 44.0 літрів
  З ймовірністю 95%: 35.9 — 46.7 літрів
Тепер ви володієте інженерним розрахунком:
- Якщо замовите 44.0 літри (Завантаження...), ви повністю задовольните попит у ~84.1% днів (50% днів із попитом нижче середнього плюс 34.1% днів у межах від Завантаження... до Завантаження...).
- Якщо ж бізнес вимагає надійності 95% (ризик нестачі лише в 5% випадків), вам потрібен односторонній квантиль: Завантаження... літра. Замовлення ж 46.7 літрів (Завантаження...) гарантує покриття аж у ~97.7% днів, оскільки лівий хвіст у 2.3% — це дні із заниженим споживанням, де молока гарантовано вистачить із надлишком.
Аналогія: Розподіл — це як високоточний прогноз погоди. Недостатньо знати лише «середня температура +15°C». Вам потрібен діапазон ймовірностей: «з ймовірністю 70% буде +12–18°C, з ймовірністю 95% — +8–22°C». Тільки це дозволяє прийняти зважене рішення: чи вдягати тепле пальто, чи брати парасольку.
Що таке розподіл випадкової величини?
Розподіл випадкової величини (probability distribution) — це фундаментальний математичний закон, що однозначно описує множину всіх можливих значень випадкової величини та визначає ймовірності їх появи.
Якщо у попередніх темах ми аналізували лише точкові характеристики датасету — міри центральної тенденції (де зосереджений центр) та міри варіації (наскільки розкидані дані), — то розподіл дає вичерпну інформацію про природу досліджуваного процесу:
- Які діапазони значень є найбільш типовими та формують локальні піки ймовірності;
- Чи є форма розсіювання симетричною або ж спостерігається асиметрія (скошеність) із довгими хвостами рідкісних аномалій;
- Яка точна математична ймовірність виходу показників за критичні межі SLA чи виникнення технічного збою;
- Як саме поводитиметься модель машинного навчання при масштабуванні вхідних даних на реальному продакшені.
Залежно від фізичної природи досліджуваної величини (дискретна вона чи неперервна), у математичній статистиці застосовують два принципово різні аналітичні інструменти: функцію ймовірності (PMF) або функцію щільності ймовірності (PDF). Єдиним же універсальним містком між обома світами виступає кумулятивна функція розподілу (CDF).
Дискретні величини та функція ймовірності (PMF)
Для дискретних випадкових величин множина значень є лічильною: це окремі, строго ізольовані точки числової осі (наприклад: кількість помилок у логах 0, 1, 2, ..., статус транзакції 0 або 1, або кількість повторних спроб HTTP-запиту).
Функція ймовірності (Probability Mass Function, PMF) ставить у пряму відповідність кожному конкретному можливому значенню Завантаження... точну ймовірність того, що випадкова величина набуде саме цього числа.
Анатомія формули: розбір позначень
- Завантаження... (велика літера): Сама випадкова величина як абстрактна математична сутність (генератор випадковості, експеримент, досліджуваний процес). Наприклад, «кількість невдалих спроб авторизації користувача».
- Завантаження... або Завантаження... (маленька літера): Конкретне чисельне значення (реалізація, результат експерименту), яке може випасти. Наприклад, Завантаження....
- Завантаження...: Ймовірність настання цієї конкретної чисельної події (число в діапазоні від Завантаження... до Завантаження...).
- Чому саме «Mass» (маса)? Термін запозичено з фізики: уся ймовірність (Завантаження... або 100%) сконцентрована не у вигляді неперервного поля, а зосереджена у вигляді точкових «масивних часток» (квантів) у фіксованих координатах Завантаження....
Що можна порахувати за допомогою PMF?
Знаючи функцію Завантаження..., ми отримуємо повний математичний опис процесу і можемо знайти його ключові моменти:
- Математичне сподівання (теоретичне середнє, центр тяжіння мас):Завантаження...
Кожне можливе значення Завантаження... зважується на його ймовірність (вагу). - Дисперсія (міра розкиду точкових мас навколо центру):Завантаження...
Аксіоми та фундаментальні властивості PMF
- Неприпустимість від'ємності та одинична межа: Ймовірність кожного значення лежить строго в межах одиничного інтервалу:
Завантаження...
- Повна ймовірність (умова нормування): Оскільки випадкова величина гарантовано набуде одного з можливих значень простору подій, сума всіх точкових ймовірностей завжди суворо дорівнює одиниці:
Завантаження...
Фізична аналогія точкових мас: Уявіть невагому струну, на яку нанизано важкі металеві кульки (намистини) у точках Завантаження.... Вага кожної кульки — це її ймовірність Завантаження.... Ви можете зняти будь-яку конкретну намистину і безпосередньо зважити її на вагах, а сумарна вага всіх намистин становить строго 1 кг (100% маси ймовірності).
Як народжується PMF? Простий приклад «на пальцях» (Перебір усіх комбінацій)
Найпростіший і найбільш наочний спосіб зрозуміти, як виникає функція ймовірності — виписати абсолютно всі можливі комбінації, які взагалі можуть статися в досліді.
Уявімо найпростішу життєву ситуацію: ми підкидаємо дві звичайні монети (або одну монету двічі поспіль). Кожна монета має дві сторони: «Герб» (Г) або «Число / Решка» (Ч). Шанс випадання кожної сторони однаковий — 50/50.
Нехай випадкова величина Завантаження... — «загальна кількість випадань Герба».
Які значення взагалі може прийняти Завантаження...? Логічно, що Герб може не випасти взагалі (Завантаження...), випасти один раз (Завантаження...) або випасти на обох монетах (Завантаження...).
Поширена пастка мислення початківців: Часто студенти міркують так: «У нас є лише три можливі результати: 0, 1 або 2 герби. Значить, кожен із них має однаковий шанс — по одній третині Завантаження...?»
Відповідь: Категорично ні! Значень справді три, але кількість шляхів до кожного значення зовсім різна.
Щоб дізнатися справжні ймовірності, випишемо повний простір елементарних комбінацій (Завантаження...):
| Комбінація (Монета 1, Монета 2) | Що випало на практиці? | Кількість гербів Завантаження... |
|---|---|---|
| (Ч, Ч) | На обох монетах випало число | Завантаження... |
| (Ч, Г) | Перша монета — число, друга — герб | Завантаження... |
| (Г, Ч) | Перша монета — герб, друга — число | Завантаження... |
| (Г, Г) | Обидві монети випали гербом догори | Завантаження... |
Як бачимо, фізично існує рівно 4 рівноможливі наслідки. Оскільки монети чесні й симетричні, кожна конкретна пара має ймовірність Завантаження... (25%).
Тепер порахуємо ймовірність для кожного значення Завантаження..., просто підсумовуючи сприятливі комбінації:
- Завантаження... (нуль гербів):
Цьому відповідає лише 1 комбінація з 4 можливих —(Ч, Ч):Завантаження... - Завантаження... (рівно один герб):
Цьому відповідають одразу 2 різні комбінації з 4 —(Ч, Г)та(Г, Ч):Завантаження...
Ось де розгадка: Результат Завантаження... з'являється вдвічі частіше, тому що до нього ведуть два незалежні сценарії (герб може випасти першим, або другим)! - Завантаження... (два герби):
Цьому відповідає лише 1 комбінація з 4 —(Г, Г):Завантаження...
Зведемо результати в підсумкову таблицю закону розподілу ймовірностей (PMF):
| Кількість гербів Завантаження... | Комбінації, що сюди ведуть | Ймовірність Завантаження... | Внесок у середнє Завантаження... |
|---|---|---|---|
| 0 | 1 варіант: (Ч, Ч) | Завантаження... (25%) | Завантаження... |
| 1 | 2 варіанти: (Ч, Г) або (Г, Ч) | Завантаження... (50%) | Завантаження... |
| 2 | 1 варіант: (Г, Г) | Завантаження... (25%) | Завантаження... |
| Сума | Усі 4 можливі варіанти враховано | 1.00 (100%) | Завантаження... |
Головні висновки:
- Нормування: Сума ймовірностей у таблиці Завантаження... (100%). Жоден можливий випадок не загубився.
- Математичне сподівання (середнє очікуване): Завантаження.... Якщо повторити експеримент 1000 разів, у середньому ми отримуватимемо рівно 1 герб за два кидки.
- Чому це важливо: Будь-який складний дискретний розподіл у програмуванні чи науці про дані будується саме за цим фундаментальним принципом: ми з'ясовуємо, скільки шляхів веде до кожного результату, і знаходимо сумарну вагу цих шляхів.
Класичний геймдев-приклад: Сума двох гральних кубиків (2d6) та народження піку
Розглянемо ще один класичний приклад із розробки ігор (Game Development, RPG, баланс луту та бойових систем): кидок двох шестигранних кубиків (нотація 2d6).
Нехай випадкова величина Завантаження... — «сума очок, що випала на двох кубиках».
Які значення взагалі може прийняти Завантаження...?
Мінімальна сума становить Завантаження..., а максимальна — Завантаження.... Тобто простір можливих числових наслідків містить 11 цілих чисел: Завантаження....
Знову типова пастка інтуїції: Чи означає наявність 11 можливих наслідків, що всі суми однаково ймовірні (по одній одинадцятій Завантаження...)?
Звісно, ні! Справжні шанси визначаються кількістю мікростанів (комбінацій), що формують кожну суму.
Випишемо повну матрицю простору елементарних подій Завантаження..., де на перетині рядка (Кубик 1) і стовпця (Кубик 2) записано їхню суму:
| Кубик 1 \ Кубик 2 | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | 6 | 7 |
| 2 | 3 | 4 | 5 | 6 | 7 | 8 |
| 3 | 4 | 5 | 6 | 7 | 8 | 9 |
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 5 | 6 | 7 | 8 | 9 | 10 | 11 |
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
Усього існує строго Завантаження... рівноможливих наслідків. Імовірність кожної окремої клітинки в таблиці становить Завантаження... (2.78%).
Тепер порахуємо кількість комбінацій (шляхів) для кожної суми:
- Завантаження...: лише 1 пара
(1, 1)$\to$ Завантаження... - Завантаження... (головна побічна діагональ): аж 6 пар
(1,6), (2,5), (3,4), (4,3), (5,2), (6,1)$\to$ Завантаження... - Завантаження...: лише 1 пара
(6, 6)$\to$ Завантаження...
Зведемо повний закон розподілу ймовірностей (PMF) для 2d6 у підсумкову таблицю:
| Сума Завантаження... | Кількість комбінацій | Точна частка | Ймовірність Завантаження... | Внесок у середнє Завантаження... |
|---|---|---|---|---|
| 2 | 1 | 1/36 | Завантаження... (2.78%) | Завантаження... |
| 3 | 2 | 2/36 | Завантаження... (5.56%) | Завантаження... |
| 4 | 3 | 3/36 | Завантаження... (8.33%) | Завантаження... |
| 5 | 4 | 4/36 | Завантаження... (11.11%) | Завантаження... |
| 6 | 5 | 5/36 | Завантаження... (13.89%) | Завантаження... |
| 7 | 6 (максимум) | 6/36 | Завантаження... (16.67%) | Завантаження... |
| 8 | 5 | 5/36 | Завантаження... (13.89%) | Завантаження... |
| 9 | 4 | 4/36 | Завантаження... (11.11%) | Завантаження... |
| 10 | 3 | 3/36 | Завантаження... (8.33%) | Завантаження... |
| 11 | 2 | 2/36 | Завантаження... (5.56%) | Завантаження... |
| 12 | 1 | 1/36 | Завантаження... (2.78%) | Завантаження... |
| Сума | 36 комбінацій | 36/36 | 1.0000 (100%) | Завантаження... |
Математичне сподівання обчислюється аналітично:
Чому розробники ігор обирають 2d6 замість 1d12?
- 1d12 (один 12-гранний кубик): Розподіл рівномірний — будь-яке число від 1 до 12 випадає з однаковим шансом Завантаження.... Це генерує повний хаос і непередбачуваність у грі.
- 2d6 (сума двох кубиків): Розподіл утворює трикутний пік навколо сімки. Майже половина всіх кидків (Завантаження...) припадає на типовий діапазон Завантаження..., а екстремальні критичні промахи (Завантаження...) та критичні удари (Завантаження...) трапляються вкрай рідко (Завантаження...).
- Філософський міст до Data Science: Це перший прояв фундаментального закону природи — Центральної Граничної Теореми (ЦГТ). Навіть підсумовування всього двох абсолютно плоских рівномірних процесів (кубик 1 + кубик 2) одразу народжує центральний дзвіноподібний пагорб навколо середнього!
Інженерний приклад: Виведення ймовірностей ретраїв через дерево подій
А як бути, якщо ймовірності окремих кроків неоднакові? Розглянемо реальну поведінку клієнта, що надсилає запит до зовнішнього платіжного шлюзу.
Припустимо:
- Кожен окремий запит проходить успішно з імовірністю Завантаження... (80%);
- Запит зазнає збою (таймаут) з імовірністю Завантаження... (20%);
- Клієнт робить максимум 3 спроби (до 2 ретраїв): якщо всі 3 спроби провалюються, операція завершується повною помилкою.
Нехай випадкова величина Завантаження... — «кількість повторних спроб (ретраїв)». Можливі наслідки: Завантаження... або повна відмова (Timeout).
Погляньмо на дерево прийняття рішень:
Виведемо ймовірність кожного результату крок за кроком за правилом множення незалежних подій:
- Завантаження... (0 ретраїв — успіх з першої спроби):
Запит пройшов одразу:Завантаження... - Завантаження... (1 ретрай — спочатку збій, потім успіх):
Перша спроба провалилася (0.2), а друга була успішною (0.8):Завантаження... - Завантаження... (2 ретраї — два збої поспіль, потім успіх):
Перша і друга спроби провалилися (Завантаження...), а третя пройшла (0.8):Завантаження... - Повна відмова (усі 3 спроби зазнали краху):
Три послідовні збої:Завантаження...
Зведемо розраховані значення в підсумкову таблицю PMF:
| Кількість ретраїв Завантаження... | Математичний ланцюжок | Ймовірність Завантаження... | Внесок у середнє Завантаження... |
|---|---|---|---|
| 0 | [Успіх] | Завантаження... (80.0%) | Завантаження... |
| 1 | [Збій] × [Успіх] | Завантаження... (16.0%) | Завантаження... |
| 2 | [Збій] × [Збій] × [Успіх] | Завантаження... (3.2%) | Завантаження... |
| 3 (Fail) | [Збій] × [Збій] × [Збій] | Завантаження... (0.8%) | Завантаження... |
| Сума | Повний простір усіх гілок дерева | 1.000 (100%) | Завантаження... |
Висновки для інженера:
- Перевірка суми: Завантаження.... Усі гілки дерева враховані, сума строго дорівнює 1.
- Очікувана середня кількість ретраїв: Завантаження... ретрая на 1 транзакцію. Тобто на 10 000 клієнтських платежів система згенерує лише близько Завантаження... додаткових повторних запитів.
Неперервні величини та функція щільності (PDF)
Неперервні випадкові величини здатні приймати будь-яке дійсне значення всередині певного неперервного інтервалу або на всій числовій прямій Завантаження... (наприклад: точний час відповіді API у мілісекундах, споживання оперативної пам'яті контейнером або вага товару).
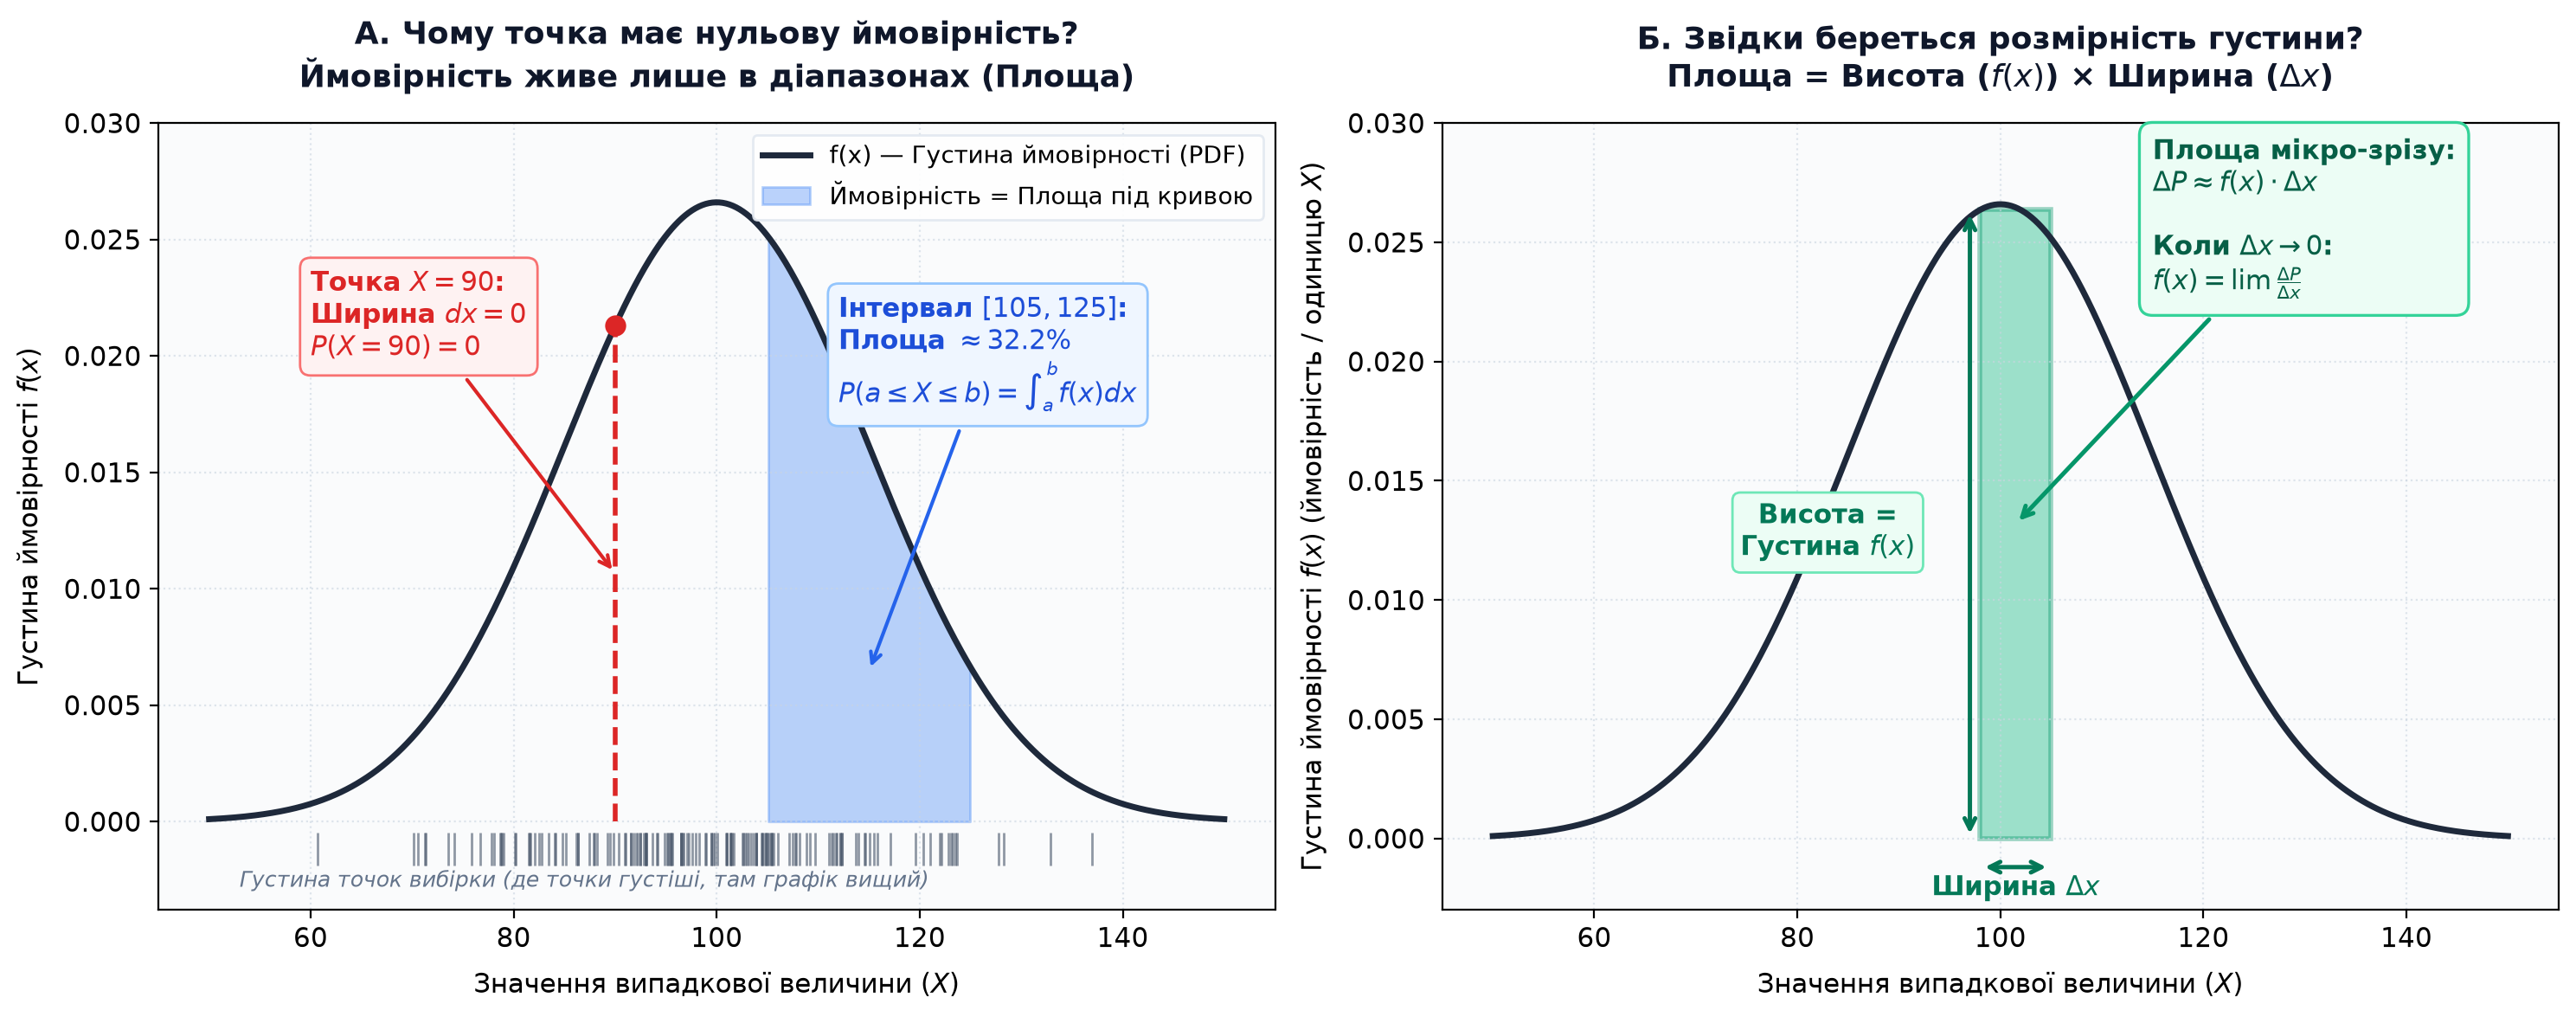
У неперервному континуумі діє фундаментальний і контрінтуїтивний парадокс: ймовірність будь-якого конкретного фіксованого значення строго дорівнює нулю:
Чому так відбувається? Навіть на найвужчому відрізку числової осі (наприклад, між 42 і 43 мс) міститься нескінченна незліченна кількість дійсних чисел. Якщо поділити одиницю (100% сумарної ймовірності) на нескінченність (Завантаження...), то частка окремо взятої точки перетворюється на нескінченно малу величину.
Саме тому для неперервних процесів оцінюють не ймовірність окремої точки, а густину (щільність) ймовірності навколо неї.
Функція щільності ймовірності (Probability Density Function, PDF), що позначається як Завантаження..., визначається як границя відношення ймовірності потрапляння в малий окіл до ширини цього самого околу Завантаження...:
Анатомія формули та геометричний зміст інтегрування
- Розмірність щільності Завантаження...:
Чисельник Завантаження... — це безрозмірна ймовірність (частка від 0 до 1). Знаменник Завантаження... — це фізична одиниця вимірювання досліджуваної величини (наприклад, мілісекунди або гігабайти). Тому значення Завантаження... вимірюється в одиницях виду Завантаження... або Завантаження.... Це саме густина ймовірності на одиницю шкали! - Формула розрахунку ймовірностей через площу (визначений інтеграл):
Ймовірність потрапляння випадкової величини в діапазон від Завантаження... до Завантаження... дорівнює площі під графіком функції щільності Завантаження...:Завантаження...
У цьому інтегралі:- Завантаження... — висота нескінченно вузького стовпчика криволінійної трапеції;
- Завантаження... — його нескінченно мала основа (диференціал);
- Завантаження... — елементарна площа прямокутника, яка й дорівнює елементарній ймовірності;
- Знак Завантаження... — неперервне підсумовування всіх цих мікроплощ від точки Завантаження... до точки Завантаження....
Аксіоми PDF:
- Невід'ємність щільності: Завантаження... для всіх Завантаження....
- Умова повної площі: Повна площа під усією нескінченною кривою від Завантаження... до Завантаження... суворо дорівнює 1 (100% ймовірності):
Завантаження...
Як зрозуміти PDF? Три наочні приклади «на пальцях»
Щоб остаточно подолати контрінтуїтивність неперервних розподілів і відчути фізичний та геометричний зміст функції щільності Завантаження..., розберемо три детальні приклади під різними кутами зору: від чистої шкільної геометрії прямокутника до фізики маси рідини та граничного переходу гістограми.
Приклад 1. Геометрія без інтегралів: Очікування автобуса або черга повідомлень (Рівномірний PDF)
Уявімо життєву ситуацію: міський автобус (або регулярний фоновий Cron-воркер, що забирає пачки повідомлень з черги RabbitMQ) прибуває рівно кожні 10 хвилин — без запізнень і пауз.
Пасажир (або новий клієнтський HTTP-запит) потрапляє на зупинку у випадковий, непередбачуваний момент часу всередині циклу. Нехай випадкова величина Завантаження... — «час очікування пасажиром наступного рейсу (у хвилинах)». Значення Завантаження... може бути будь-яким дійсним числом від 0 до 10 хвилин (Завантаження...).
Поширена пастка мислення початківців:
«Яка ймовірність того, що автобус під'їде рівно в момент Завантаження... хвилини?»
Інтуїція підказує відповісти: «1 з 10 можливих хвилин, тобто Завантаження...». Але що означає приїхати «рівно о 3-й хвилині»? Це означає рівно Завантаження... хвилини з нескінченною кількістю нулів після коми. Навіть на відрізку між 3.00 і 3.01 хвилини криється нескінченна кількість моментів часу на шкалі наносекунд. Оскільки ширина окремої точки дорівнює нулю (Завантаження...), то ймовірність такого збігу нульова:Завантаження...Запитувати «яка ймовірність потрапити точно в число 3?» — це геометрично те саме, що запитувати «яка площа лінії нульової товщини?». Її площа дорівнює 0!
Як знайти ймовірності без вищої математики? Через площу прямокутника!
Оскільки всі моменти часу рівноможливі, графік щільності Завантаження... — це ідеально пряма горизонтальна лінія над інтервалом від 0 до 10. Фігура під графіком — звичайнісінький прямокутник:
- Основа прямокутника: Завантаження... хвилин.
- Повна площа під кривою: згідно з аксіомою нормування, має строго дорівнювати одиниці (100% сумарної ймовірності).
- Визначаємо висоту графіка Завантаження...:Завантаження...
Висота Завантаження... — це не ймовірність 10%, це густина: 0.1 одиниці ймовірності на 1 хвилину очікування!
| Запитання щодо часу очікування | Геометричний розрахунок площі | Розрахунок через визначений інтеграл | Ймовірність |
|---|---|---|---|
| Очікування менше 2 хв (Завантаження...) | Завантаження... :math-formula{tex="\text{Площа} = 2 \times 0.1 = 0.20" inline} | Завантаження... | 20% |
| Очікування від 2 до 5 хв (Завантаження...) | Завантаження... :math-formula{tex="\text{Площа} = 3 \times 0.1 = 0.30" inline} | Завантаження... | 30% |
| Очікування понад 7 хв (Завантаження...) | Завантаження... :math-formula{tex="\text{Площа} = 3 \times 0.1 = 0.30" inline} | Завантаження... | 30% |
| Очікування рівно 5 хв (Завантаження...) | Завантаження... :math-formula{tex="\text{Площа} = 0 \times 0.1 = 0" inline} | Завантаження... | 0% |
Зверніть увагу: визначений інтеграл у неперервній статистиці — це не абстрактний бар'єр, а просто математичний інструмент точного підрахунку площі геометричної фігури під кривою.
Приклад 2. Фізична інтуїція: 1 літр води в акваріумі або розмазане масло (Від кульок до шару рідини)
Найкращий спосіб наочно відчути принципову різницю між PMF та PDF — звернутися до фізичної метафори розподілу речовини.
Уявіть, що вся сумарна ймовірність досліду (100%, або число 1.0) — це 1 літр забарвленої рідини (або 1 кілограм м'якого пластиліну):
- Дискретна величина (PMF): Колбочки або кульки на струні
У дискретному розподілі цей 1 літр розлито по окремих закритих мензурках (або кілограм металу розбито на окремі важкі кульки-намистини).- У прикладі з двома монетами ми мали три посудини: «0 гербів» (0.25 л), «1 герб» (0.50 л) та «2 герби» (0.25 л).
- Ви можете зняти з полиці одну конкретну посудину «1 герб» і зважити її: вона містить рівно півлітра (50%) ймовірності. Кожна точка володіє власною відокремленою масою.
- Неперервна величина (PDF): Вода у вузькому рельєфному акваріумі
У неперервному розподілі ми беремо цей самий 1 літр води і виливаємо його у вузький прозорий лоток-акваріум завдовжки 100 см із нерівним дном. Вода розтікається по всій довжині суцільним шаром:- Скільки літрів води міститься в одній математичній точці? Якщо ви візьмете надгостре лезо бритви і спробуєте «розсікти» воду рівно на позначці Завантаження... см, скільки рідини залишиться на вістрі леза? Рівно 0 грамів! Геометрична площина розрізу має нульову товщину, тому вона не містить фізичного об'єму.
- Що показує висота кривої Завантаження...? Висота кривої — це рівень (глибина) води над певною точкою шкали Завантаження.... У глибоких місцях рівень води високий (висока концентрація ймовірності), у мілководних — низький.
- Як отримати реальну воду (ймовірність)? Щоб зачерпнути воду, потрібно розсунути стінки черпака на певну ширину Завантаження... (наприклад, взяти відрізок від 48 до 52 см). Тоді об'єм зачерпнутої рідини складе:
Завантаження...
- Повний об'єм води в усьому акваріумі завжди залишається суворо незмінним — рівно 1 літр (Завантаження...).
Приклад 3. Граничний перехід: Кидок дротика в мішень (Як гістограма перетворюється на криву PDF)
Цей приклад показує, як неперервна гладка крива природно виростає зі звичайнісіньких дискретних стовпчиків, якщо нескінченно збільшувати точність вимірювання.
Уявіть гравця, який кидає дротик у горизонтальну смугу-мішень довжиною 100 см (від 0 до 100 см). Гравець цілиться в яблучко — центр мішені на позначці Завантаження... см. Через мікротремтіння руки, пориви повітря та випадкові фактори дротики лягають густіше біля центру і дедалі рідше — на краях.
Подивимося, що станеться з оцінкою ймовірностей, якщо ми будемо підраховувати влучання з різним ступенем деталізації сітки:
| Етап дроблення шкали | Кількість кишень (bins) та ширина Завантаження... | Що відбувається зі стовпчиками гістограми? | Ймовірність потрапляння в центральну кишеню |
|---|---|---|---|
| Етап 1: Грубий дискретний підрахунок | 5 зон по Завантаження... см[0-20], [20-40], [40-60], [60-80], [80-100] | 5 широких стовпчиків. Центральний сектор [40-60] см ловить близько 50% усіх кидків. Кожен стовпчик має велику власну ймовірність. | ~50% |
| Етап 2: Дрібна сітка | 100 зон по Завантаження... см[0-1], [1-2], ..., [49-50], ..., [99-100] | Стовпчики стають схожими на тонку частокіл-гребінку. Оскільки кишень тепер багато, ймовірність влучити в конкретний 1 см падає в десятки разів. | ~2.5% |
| Етап 3: Мікроскопічна сітка | 10 000 зон по Завантаження... мм (100 мкм) | Стовпчики тонші за волосину. Шанс влучити в окрему мікрощілину стає мізерним (Завантаження...). Окремий стовпчик майже втрачає значення. | ~0.025% |
| Етап 4: Неперервний PDF | Нескінченна кількість зон при Завантаження... (до атомів) | Сходинки стовпчиків зливаються в ідеальну неперервну дзвоноподібну криву Гауса. Висота окремого стовпчика стає густиною Завантаження.... | 0% (в окрему точку) |
Покроковий приклад розрахунку з інтегруванням
Припустимо, що час обробки транзакції Завантаження... (у секундах) локальним сервісом описується лінійно спадною щільністю на відрізку від Завантаження... до Завантаження... секунд (поза цим інтервалом Завантаження...):
- Крок 1: Перевіримо умову повної площі (нормування):Завантаження...
Умова нормування виконана: повна площа дорівнює 100%. - Крок 2: Знайдемо ймовірність того, що транзакція завершиться швидше ніж за 1 секунду:
Обчислюємо площу під кривою від Завантаження... до Завантаження...:Завантаження...
Отже, з імовірністю 75% запит виконається менш ніж за 1 секунду.
Кумулятивна функція розподілу (CDF): універсальний міст
І для дискретних, і для неперервних величин існує універсальний спільний опис — кумулятивна функція розподілу (Cumulative Distribution Function, CDF), яка завжди позначається великою літерою Завантаження....
Вона показує сумарну накопичену ймовірність того, що випадкова величина виявиться меншою або рівною заданому пороговому числу Завантаження...:
Анатомія та математичні властивості CDF
- Область значень: Оскільки це ймовірність, значення Завантаження... завжди лежить строго в межах від Завантаження... до Завантаження....
- Границі на нескінченностях:
- Завантаження... (до настання будь-яких подій накопичена ймовірність дорівнює нулю);
- Завантаження... (коли враховано всі можливі значення, накопичено 100% імовірності).
- Монотонність: Завантаження... є неспадною функцією. Якщо поріг зростає (Завантаження...), накопичена ймовірність може тільки зростати або залишатися незмінною: Завантаження....
Зв'язок із PMF та PDF
- У дискретному випадку: це східчаста функція накопиченої суми, яка робить стрибок вгору в кожній точці Завантаження... на величину її ймовірності Завантаження...:
Завантаження...
- У неперервному випадку: це плавна крива накопиченої площі зліва направо, яка пов'язана з PDF через інтегрування та взяття похідної:
Завантаження...
Чотири головні практичні інструменти CDF
Знаючи CDF, інженеру та аналітику більше не потрібно брати складні інтеграли вручну. Будь-яке практичне бізнес-питання вирішується простими арифметичними операціями:
- Ймовірність «не більше ніж поріг Завантаження...»:Завантаження...
- Ймовірність «суворо більше ніж поріг Завантаження...» (хвіст розподілу, Survival Function):Завантаження...Застосування: обчислення ймовірності порушення SLA (Service Level Agreement), якщо допустимий ліміт часу відгуку перевищено.
- Ймовірність потрапляння в довільний інтервал Завантаження...:Завантаження...Застосування: базова функція у бібліотеці
scipy.stats: викликdist.cdf(b) - dist.cdf(a)миттєво повертає точну площу між двома межами. - Квантилі та персентилі (обернена функція Завантаження...):
Якщо ми знаємо бажану ймовірність Завантаження... (наприклад, Завантаження... для 99-го персентиля затримок p99), обернена функція знаходить порогове значення Завантаження..., для якого накопичено цю ймовірність:Завантаження...Уscipy.statsцей метод називається PPF (Percent Point Function):dist.ppf(0.99).
Покроковий чисельний приклад розрахунку через CDF
Візьмемо попередній приклад із затримкою транзакцій, де Завантаження... на Завантаження....
Знайдемо аналітичний вигляд Завантаження... шляхом інтегрування від Завантаження... до Завантаження...:
Тепер розв'яжемо практичні задачі без інтегрування:
- Питання 1: Яка ймовірність, що транзакція триватиме від Завантаження... до Завантаження... секунди?
Завантаження...Завантаження...Завантаження...
- Питання 2: Яка ймовірність порушення регламенту, якщо допустимий ліміт становить Завантаження... секунди?
Завантаження...
Візуальне порівняння: PMF проти PDF
Проілюструємо принципову різницю між точковою масою дискретного процесу та щільністю площі неперервної величини на реалістичних даних у Python:
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 5))

# Графік 1: PMF для суми очок двох кубиків (дискретна величина)
dice_sums = []
for i in range(1, 7):
    for j in range(1, 7):
        dice_sums.append(i + j)

values, counts = np.unique(dice_sums, return_counts=True)
probabilities = counts / len(dice_sums)

ax1.bar(values, probabilities, edgecolor='black', color='steelblue', alpha=0.7)
ax1.set_title('PMF: Сума двох кубиків (дискретна)', fontweight='bold', fontsize=12)
ax1.set_xlabel('Сума очок', fontsize=11)
ax1.set_ylabel('Ймовірність P(X = x)', fontsize=11)
ax1.set_xticks(values)
ax1.grid(axis='y', alpha=0.3)

# Графік 2: PDF для зросту дорослих чоловіків (неперервна величина: μ=175 см, σ=7 см)
x = np.linspace(150, 200, 1000)
pdf = stats.norm.pdf(x, loc=175, scale=7)

ax2.plot(x, pdf, color='coral', linewidth=2)
ax2.fill_between(x, pdf, alpha=0.3, color='coral')
ax2.set_title('PDF: Зріст дорослих людей (неперервна)', fontweight='bold', fontsize=12)
ax2.set_xlabel('Зріст (см)', fontsize=11)
ax2.set_ylabel('Щільність ймовірності', fontsize=11)
ax2.grid(alpha=0.3)

# Позначимо діапазон ймовірності P(170 ≤ X ≤ 180) через інтеграл площі
mask = (x >= 170) & (x <= 180)
ax2.fill_between(x[mask], pdf[mask], alpha=0.6, color='green', label='P(170 ≤ Зріст ≤ 180)')
ax2.legend()

plt.tight_layout()
plt.show()

print("PMF (дискретна):")
print("  Кожен стовпець = точна ймовірність конкретного значення")
print("  Сума висот усіх стовпців = 1.0 (100%)")
print("\nPDF (неперервна):")
print("  Висота кривої f(x) = щільність ймовірності (може бути > 1)")
print("  Ймовірність = площа під кривою на інтервалі P(a ≤ X ≤ b)")
prob_range = stats.norm.cdf(180, 175, 7) - stats.norm.cdf(170, 175, 7)
print(f"  P(170 ≤ зріст ≤ 180) = {prob_range:.3f} (зелена площа під кривою)")
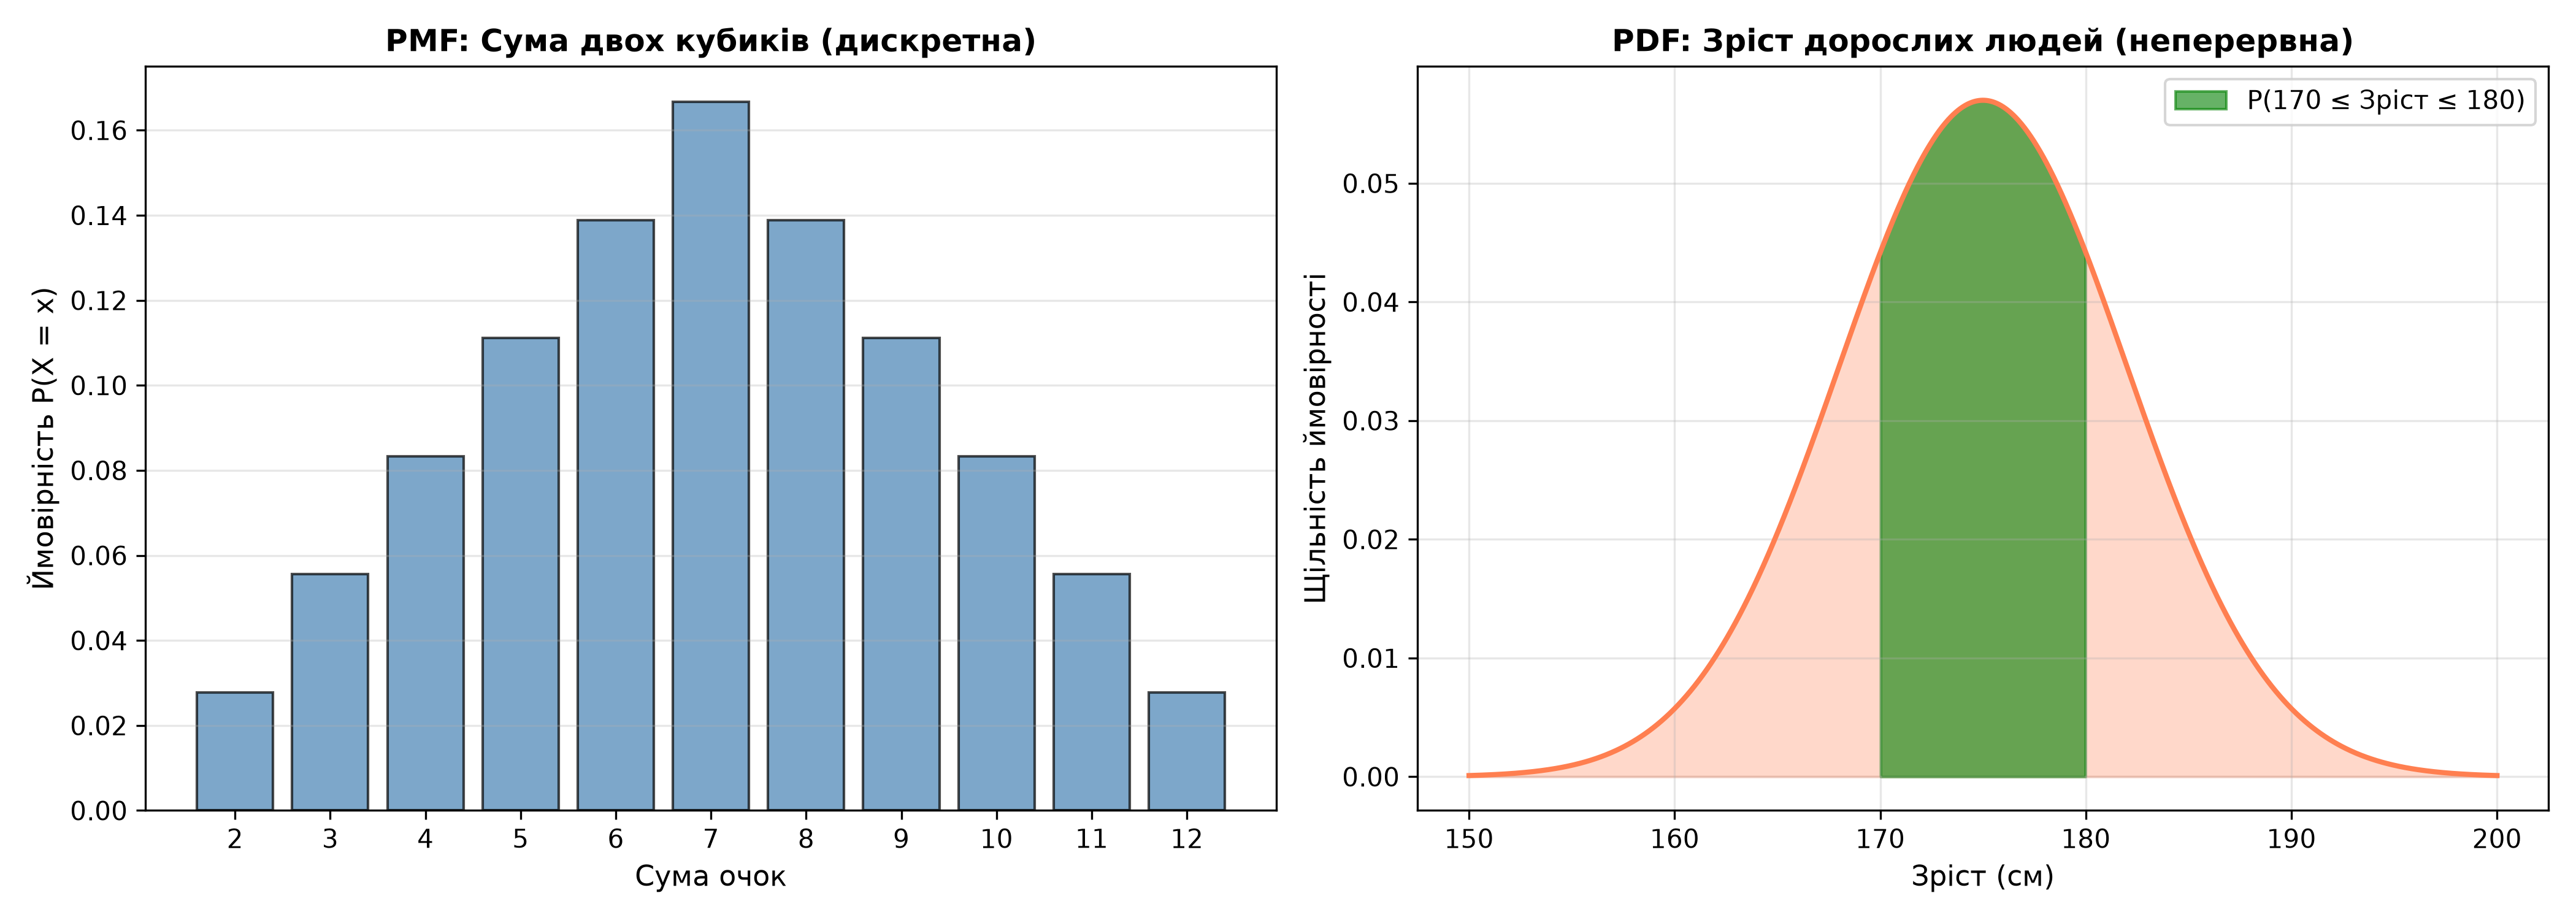
PMF (дискретна):
  Кожен стовпець = точна ймовірність конкретного значення
  Сума висот усіх стовпців = 1.0 (100%)

PDF (неперервна):
  Висота кривої f(x) = щільність ймовірності (може бути > 1)
  Ймовірність = площа під кривою на інтервалі P(a ≤ X ≤ b)
  P(170 ≤ зріст ≤ 180) = 0.525 (зелена площа під кривою)
- Усі ймовірності та значення щільності строго невід'ємні: Завантаження... та Завантаження....
- Універсальна сума становить 100%: Сума стовпців PMF або повний визначений інтеграл PDF на проміжку Завантаження... строго дорівнює 1.0.
- Розрахунок інтервалів: У неперервному випадку ймовірність точки дорівнює 0, тому границі інтервалу не змінюють його ймовірність: Завантаження....
Рівномірний розподіл (Uniform Distribution)
Рівномірний розподіл (uniform distribution) — це розподіл, у якому всі значення в діапазоні рівноймовірні. Немає «улюблених» чи «рідкісних» значень — кожне має однакову ймовірність.
Аналогія: Рівномірний розподіл — це як ідеальна рулетка з нескінченною кількістю секторів. Кожна точка на колі має однакову ймовірність. Немає «гарячих» чи «холодних» зон.
Дискретний рівномірний розподіл
Найпростіший приклад — кидок чесного кубика. Кожна грань (1, 2, 3, 4, 5, 6) випадає з однаковою ймовірністю 1/6 ≈ 0.167.
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(seed=42)

# Симулюємо 1000 кидків кубика
rolls = rng.integers(1, 7, size=1000)

# Підрахунок частот
values, counts = np.unique(rolls, return_counts=True)
frequencies = counts / len(rolls)

# Візуалізація
plt.figure(figsize=(8, 5))
plt.bar(values, frequencies, edgecolor='black', color='steelblue', alpha=0.7)
plt.axhline(1/6, color='red', linestyle='--', linewidth=2, label='Теоретична ймовірність (1/6 ≈ 0.167)')
plt.xlabel('Результат кидка')
plt.ylabel('Частота (емпірична ймовірність)')
plt.title('Дискретний рівномірний розподіл: 1000 кидків кубика', fontweight='bold')
plt.xticks(values)
plt.ylim(0, 0.25)
plt.legend()
plt.grid(axis='y', alpha=0.3)
plt.show()

print("Частоти кожної грані:")
for v, f in zip(values, frequencies):
    diff = (f - 1/6) * 100
    print(f"  {v}: {f:.3f} (відхилення від теорії: {diff:+.1f}%)")
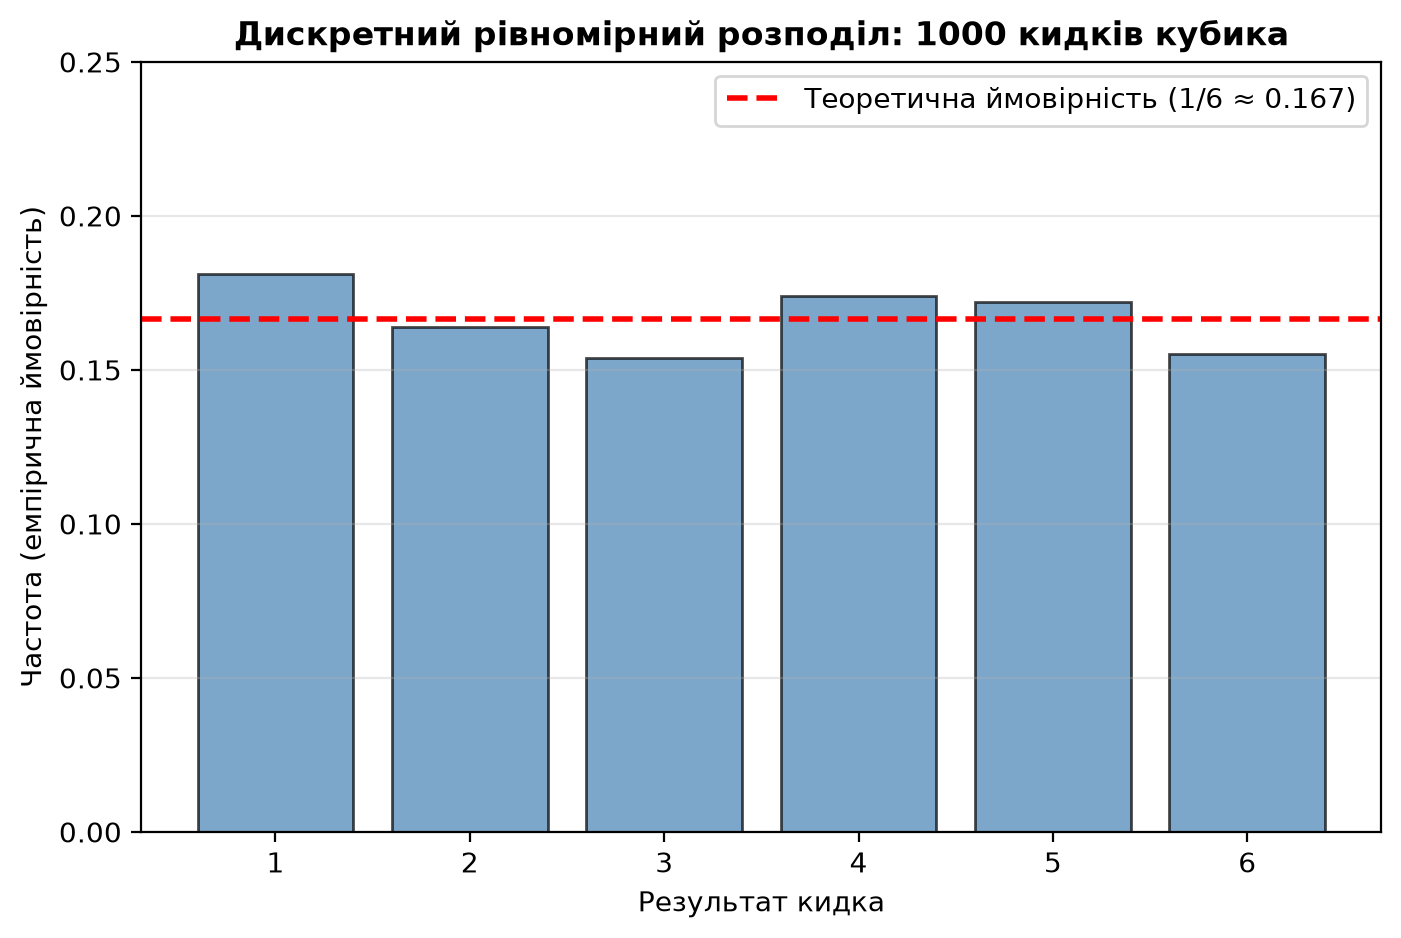
Частоти кожної грані:
  1: 0.182 (відхилення від теорії: +1.5%)
  2: 0.152 (відхилення від теорії: -1.5%)
  3: 0.157 (відхилення від теорії: -1.0%)
  4: 0.173 (відхилення від теорії: +0.6%)
  5: 0.177 (відхилення від теорії: +1.0%)
  6: 0.159 (відхилення від теорії: -0.8%)
Властивості та анатомія формул дискретного рівномірного розподілу
Якщо випадкова величина Завантаження... набуває будь-якого цілого значення від Завантаження... до Завантаження... включно, загальна кількість можливих варіантів дорівнює:
- Функція ймовірності (PMF):Завантаження...
Анатомія: Одиниця (100% сумарної ймовірності) порівну ділиться між усіма Завантаження... взаємовиключними наслідками. Жоден результат не має пріоритету (принцип повної байдужості). - Математичне сподівання (центр симетрії):Завантаження...
Анатомія: Через ідеальну симетрію центр ваги лежить рівно посередині між мінімальним значенням Завантаження... та максимальним Завантаження.... Для кубика (Завантаження...): Завантаження.... - Дисперсія (розкид навколо центру):Завантаження...
Звідки береться знаменник 12? Це результат точного математичного підсумовування квадратів відхилень Завантаження... через формулу суми квадратів послідовних чисел Завантаження.... Для 6-гранного кубика (Завантаження...): Завантаження..., а стандартне відхилення Завантаження....
Інженерний приклад: Рандомізований A/B спліттер
Балансувальник трафіку розподіляє користувачів між Завантаження... варіантами інтерфейсу (A = 1, B = 2, C = 3, D = 4). Кожен користувач із рівною ймовірністю Завантаження... (25%) потрапляє в одну з тестових когорт. Це гарантує відсутність системного зміщення (bias) в експерименті.
Неперервний рівномірний розподіл
Для неперервних даних рівномірний розподіл означає, що кожен інтервал однакової довжини всередині допустимих меж Завантаження... володіє однаковою ймовірністю.
Позначення: Завантаження... або Завантаження...
Функція щільності (PDF)
Анатомія формули: чому висота щільності дорівнює Завантаження...?
Графік функції щільності Завантаження... являє собою плоский прямокутник з основою завдовжки Завантаження... та постійною висотою Завантаження.... За аксіомою нормування повна площа під графіком неперервного розподілу зобов'язана суворо дорівнювати одиниці (100% ймовірності):
Отже, що ширший діапазон можливих значень Завантаження..., то нижчою стає щільність Завантаження..., розмазуючи ймовірність тоншим шаром.
Кумулятивна функція розподілу (CDF)
Шляхом інтегрування константи Завантаження... від лівої межі Завантаження... до точки Завантаження... отримуємо лінійну функцію накопичення:
Числові характеристики
- Математичне сподівання (центр інтервалу):Завантаження...
- Дисперсія (розкид):Завантаження...
Покроковий практичний приклад: очікування виконання cron-задачі
Уявіть фонову службу, яка кожні 10 хвилин скидає чергу завдань. Клієнтський запит прибуває у випадковий момент часу. Час очікування початку обробки Завантаження... (у хвилинах) розподілений рівномірно на відрізку від 0 до 10 хвилин: Завантаження....
- Параметри: Завантаження..., Завантаження....
- Функція щільності: Завантаження... для Завантаження....
- Питання: Яка ймовірність того, що клієнту доведеться чекати від 2 до 5 хвилин?
Завантаження...Або через формулу CDF:Завантаження...
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(seed=42)

# Генеруємо 10000 випадкових чисел від 0 до 10
data = rng.uniform(0, 10, size=10000)

# Візуалізація
plt.figure(figsize=(10, 5))
plt.hist(data, bins=50, edgecolor='black', alpha=0.7, color='coral', density=True)
plt.axhline(1/10, color='red', linestyle='--', linewidth=2, label='Теоретична щільність (1/10 = 0.1)')
plt.xlabel('Значення')
plt.ylabel('Щільність ймовірності')
plt.title('Неперервний рівномірний розподіл: Uniform(0, 10)', fontweight='bold')
plt.xlim(-1, 11)
plt.ylim(0, 0.15)
plt.legend()
plt.grid(alpha=0.3)
plt.show()

# Теоретичні vs емпіричні характеристики
theoretical_mean = (0 + 10) / 2
theoretical_std = (10 - 0) / np.sqrt(12)

print("Порівняння теорії та практики:")
print(f"  Середнє:")
print(f"    Теоретичне: {theoretical_mean:.2f}")
print(f"    Емпіричне:  {data.mean():.2f}")
print(f"  Стандартне відхилення:")
print(f"    Теоретичне: {theoretical_std:.2f}")
print(f"    Емпіричне:  {data.std():.2f}")
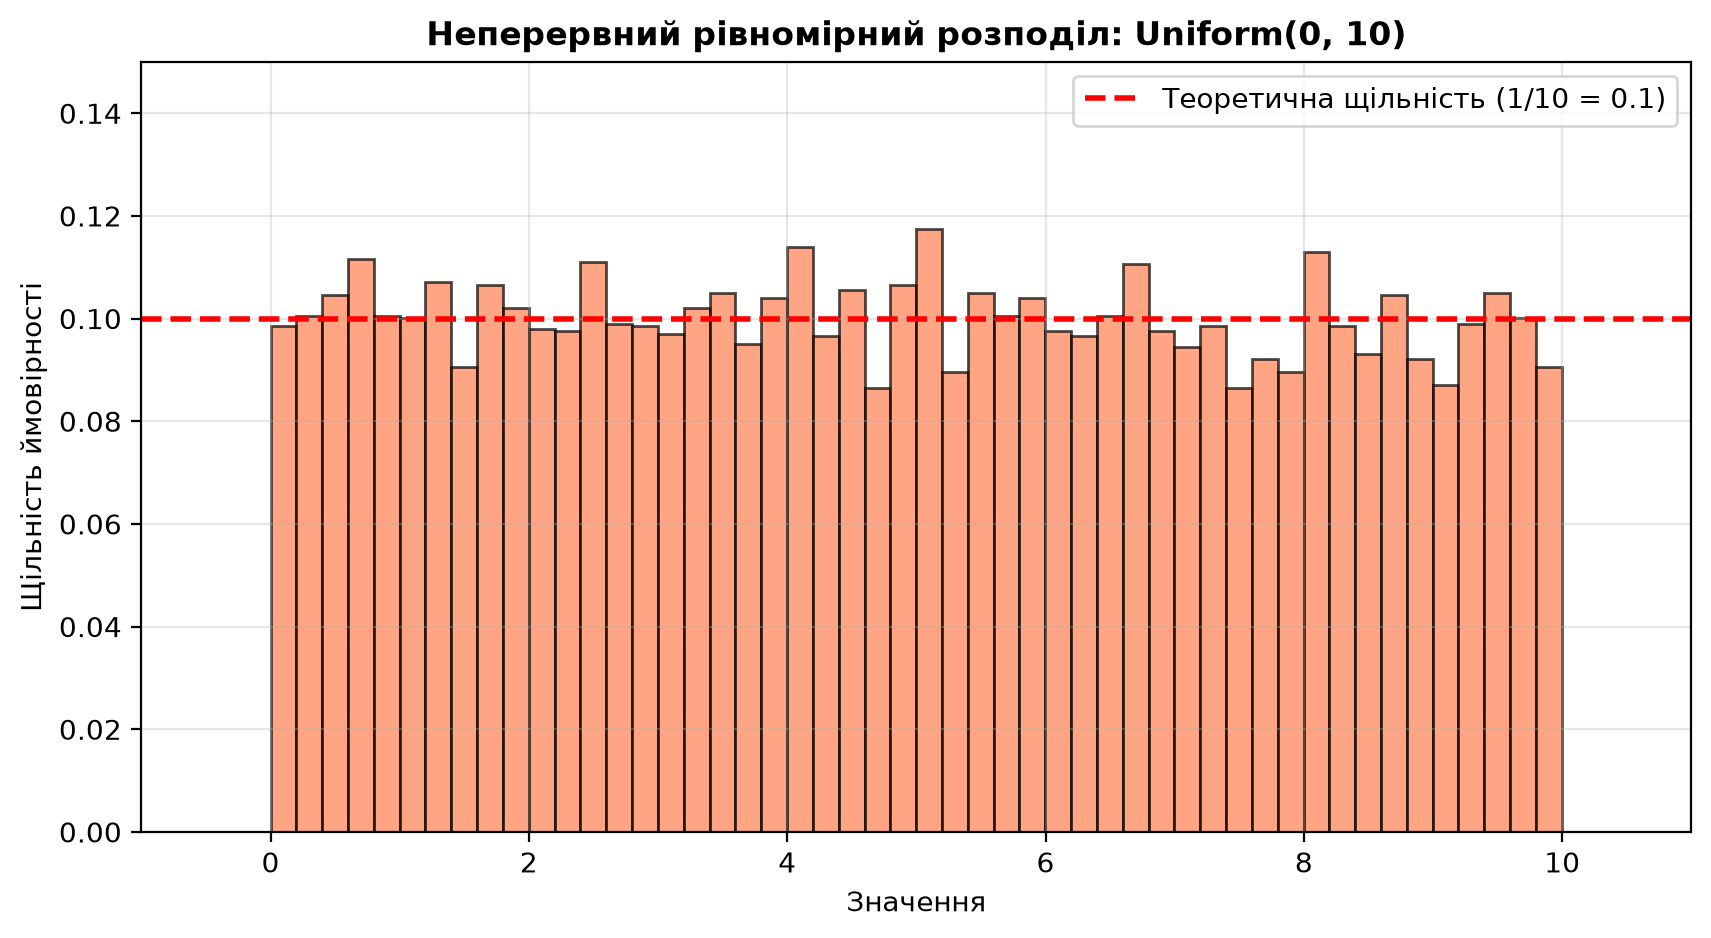
Порівняння теорії та практики:
  Середнє:
    Теоретичне: 5.00
    Емпіричне:  4.97
  Стандартне відхилення:
    Теоретичне: 2.89
    Емпіричне:  2.88
- Моделювання випадкового вибору (lottery, жеребкування)
- Ініціалізація параметрів ML-моделей (випадкові ваги)
- Генерація випадкових тестових даних
- Моделювання подій без переваг (чесна монета, ідеальний кубик)
Нормальний розподіл (Normal / Gaussian Distribution)
Нормальний розподіл (також розподіл Гауса) — найважливіший розподіл у статистиці та Machine Learning. Його форма — знаменита дзвоноподібна крива.
Чому нормальний розподіл такий важливий?
Центральна гранична теорема (Central Limit Theorem, CLT)
Якщо випадкова величина є результатом дії великої кількості незалежних випадкових факторів зі скінченною дисперсією (Завантаження...), то її сума (або середнє арифметичне) асимптотично прямує до нормального розподілу, незалежно від того, які початкові розподіли мали окремі доданки.
Аналогія: Уявіть, що 100 людей кидають монети. Підрахуйте загальну кількість «орлів». Повторіть експеримент 1000 разів. Розподіл цих сум буде ідеально дзвоноподібним, навіть якщо кожна окрема монета має лише два стани (0 або 1).
- Читання секторів із SSD
- Перемикання контексту процесів у ядрі ОС
- Очікування слота в пулі з'єднань бази даних
- Збирання сміття в рантаймі (Garbage Collection pause)
- Десеріалізація JSON-пейлоада
Природність походження
Більшість неперервних процесів у фізичному світі та суспільстві природно наближаються до нормального закону:
- Фізіологічні параметри (зріст дорослих чоловіків: Завантаження... см, Завантаження... см);
- Похибки прецизійних вимірювальних приладів та сенсорів;
- Стандартизовані психометричні тести (калібровані під Завантаження..., Завантаження...);
- Шум у сенсорах камер та аналогових радіоканалах.
Аналітична зручність для ML
Нормальний розподіл володіє чудовими математичними властивостями (диференційовність, симетрія, аналітична замкненість при лінійних перетвореннях). Більшість класичних статистичних критеріїв, моделей лінійної регресії (OLS) та алгоритмів оптимізації безпосередньо спираються на припущення гаусовості залишків.
Параметри нормального розподілу
Нормальний розподіл повністю визначається двома параметрами:
- μ (мю) — математичне сподівання (середнє значення), визначає положення центру дзвона на осі Завантаження...;
- σ (сігма) — стандартне відхилення, визначає ширину розкиду та крутизну спадання схилів.
Позначення: Завантаження... (читається: «X розподілена нормально з параметрами μ та дисперсією σ²»)
Функція щільності ймовірності (PDF):
- Завантаження... — Стандартизоване відхилення (Z-score): вимірює відстань від точки Завантаження... до центру Завантаження... у масштабі кроків Завантаження....
- Завантаження... — Формувач дзвона (експоненційне затухання): число Ейлера Завантаження... у від'ємному квадратичному степені. У точці центру (Завантаження...) степінь дорівнює нулю і Завантаження... (пік кривої). Що далі точка віддаляється від центру, то швидше множник Завантаження... спрямовує значення кривої до нуля, симетрично утворюючи характерні спадаючі «плечі».
- Завантаження... — Нормалізуючий множник (масштаб): константа площі, що гарантує, що повний інтеграл під усією нескінченною кривою від Завантаження... до Завантаження... завжди дорівнює строго 1.0 (100% ймовірності).
Як зрозуміти параметр μ (центр розподілу)? Інтуїтивні аналогії
- Примітивний приклад: ранкова маршрутка
Уявіть, що ви щодня сідаєте на одну й ту саму маршрутку, яка за розкладом приїжджає о 08:00.- Звичайний центр (без зсуву):
Маршрутка в середньому приїжджає рівно о 08:00 (Завантаження...). Більшість рейсів прибуває о 08:00. Іноді вона приїжджає на пару хвилин раніше (07:58), іноді на пару хвилин пізніше (08:02). Центр розподілу знаходиться в точці 08:00. - Що таке зсув центру?
На дорозі почали ремонт, і тепер маршрут займає на 10 хвилин більше. Водій їздить з такою самою точністю, як і раніше, але тепер маршрутка приїжджає в середньому о 08:10 (Завантаження...). Іноді вона з'явиться о 08:08, іноді о 08:12, але найчастіше — о 08:10. - Що відбулося математично:
Центр розподілу зсунувся на Завантаження... хвилин праворуч. Характер запізнень/випереджень не змінився (розкид Завантаження... залишився тим самим), але «точка притягання» перемістилася з 08:00 на 08:10.
- Звичайний центр (без зсуву):
- Ще простіша метафора: стрільба по мішені
- Якщо ви стріляєте в центр мішені (десятку), усі ваші кульки лягають кучно навколо десятки. Центр — це 10 (Завантаження...).
- Якщо у гвинтівки збився приціл праворуч, усі кульки так само кучно ляжуть на відстані 5 см праворуч від центру (Завантаження...).
- Форма купки кульок не змінилася (дисперсія та розкид Завантаження... залишилися тими самими), але центр влучань зсунувся.
Як зрозуміти параметр σ (ширина розкиду)? Інтуїтивні аналогії
Якщо центр (Завантаження...) відповідає на запитання «Де розташована більшість результатів?», то ширина розподілу (Завантаження..., сигма) відповідає на запитання: «Наскільки сильно результати розкидані навколо цього центру?».
У статистиці Завантаження... називають стандартним відхиленням. Воно визначає форму дзвона Гауса: чи буде він високим і вузьким, як гостра вежа, чи низьким і розпливчастим, як пологий пагорб.
- Примітивний приклад: кава в автоматі
Уявіть, що кавовий автомат налаштований наливати порцію 200 мл (це наш центр Завантаження... мл).- Варіант 1: Маленька сигма (Завантаження... мл) — висока точність:
Автомат працює як швейцарський годинник. Майже щоразу ви отримуєте майже рівно 200 мл: то 199 мл, то 201 мл, дуже рідко 196 чи 204 мл.
Графік: вузький, щільний і дуже високий пік прямо на позначці 200 мл. Усі значення зібрані в одну точну купку. - Варіант 2: Велика сигма (Завантаження... мл) — висока нестабільність:
Автомат зламався або неякісний: дозатор барахлить. Середнє значення за день — усе ще 200 мл, але в один стаканчик він налив 170 мл, в інший — 230 мл, а декому взагалі хлюпнув 140 мл або перелив до 260 мл.
Графік: дзвін стає широким, розплющеним і пологим. Результати сильно «розмазані» по шкалі.
- Варіант 1: Маленька сигма (Завантаження... мл) — висока точність:
- Метафора зі стрільбою (продовження):
- Маленька Завантаження...: стріляє майстер спорту. Усі кулі лягають майже дірка в дірку (величезна кучність).
- Велика Завантаження...: стріляє новачок, у якого тремтять руки. Кулі розлітаються по всій мішені в радіусі 30 см (великий розкид).
- Чому конкретна буква Завантаження... така важлива: правило «трьох сигм»
Для будь-якого нормального розподілу значення Завантаження... слугує універсальною лінійкою розкиду:- В межах Завантаження... від центру опиняється приблизно 68% усіх випадків (найбільш типові результати).
- В межах Завантаження... опиняється 95% усіх випадків (майже все, що трапляється за звичайних умов).
- В межах Завантаження... опиняється 99.7% результатів — тобто все, що виходить за межі трьох сигм, вважається практично аномалією або крайньою рідкістю.
Візуальний вплив параметрів
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

x = np.linspace(-10, 20, 1000)

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 5))

# Графік 1: Різні μ (центр), однакове σ
ax1.plot(x, stats.norm.pdf(x, 0, 2), label='μ=0, σ=2', linewidth=2)
ax1.plot(x, stats.norm.pdf(x, 5, 2), label='μ=5, σ=2', linewidth=2)
ax1.plot(x, stats.norm.pdf(x, 10, 2), label='μ=10, σ=2', linewidth=2)
ax1.set_title('Вплив μ: зсув центру розподілу', fontweight='bold')
ax1.set_xlabel('x')
ax1.set_ylabel('Щільність ймовірності')
ax1.legend()
ax1.grid(alpha=0.3)

# Графік 2: Однакове μ (центр), різні σ (розкид)
ax2.plot(x, stats.norm.pdf(x, 5, 1), label='μ=5, σ=1', linewidth=2)
ax2.plot(x, stats.norm.pdf(x, 5, 2), label='μ=5, σ=2', linewidth=2)
ax2.plot(x, stats.norm.pdf(x, 5, 4), label='μ=5, σ=4', linewidth=2)
ax2.set_title('Вплив σ: ширина розподілу', fontweight='bold')
ax2.set_xlabel('x')
ax2.set_ylabel('Щільність ймовірності')
ax2.legend()
ax2.grid(alpha=0.3)

plt.tight_layout()
plt.show()

print("Висновки:")
print("  μ (середнє) → зміщує центр кривої вліво/вправо")
print("  σ (стандартне відхилення) → робить криву вужчою (σ↓) або ширшою (σ↑)")
print("  Більше σ → більша варіація → менша передбачуваність")
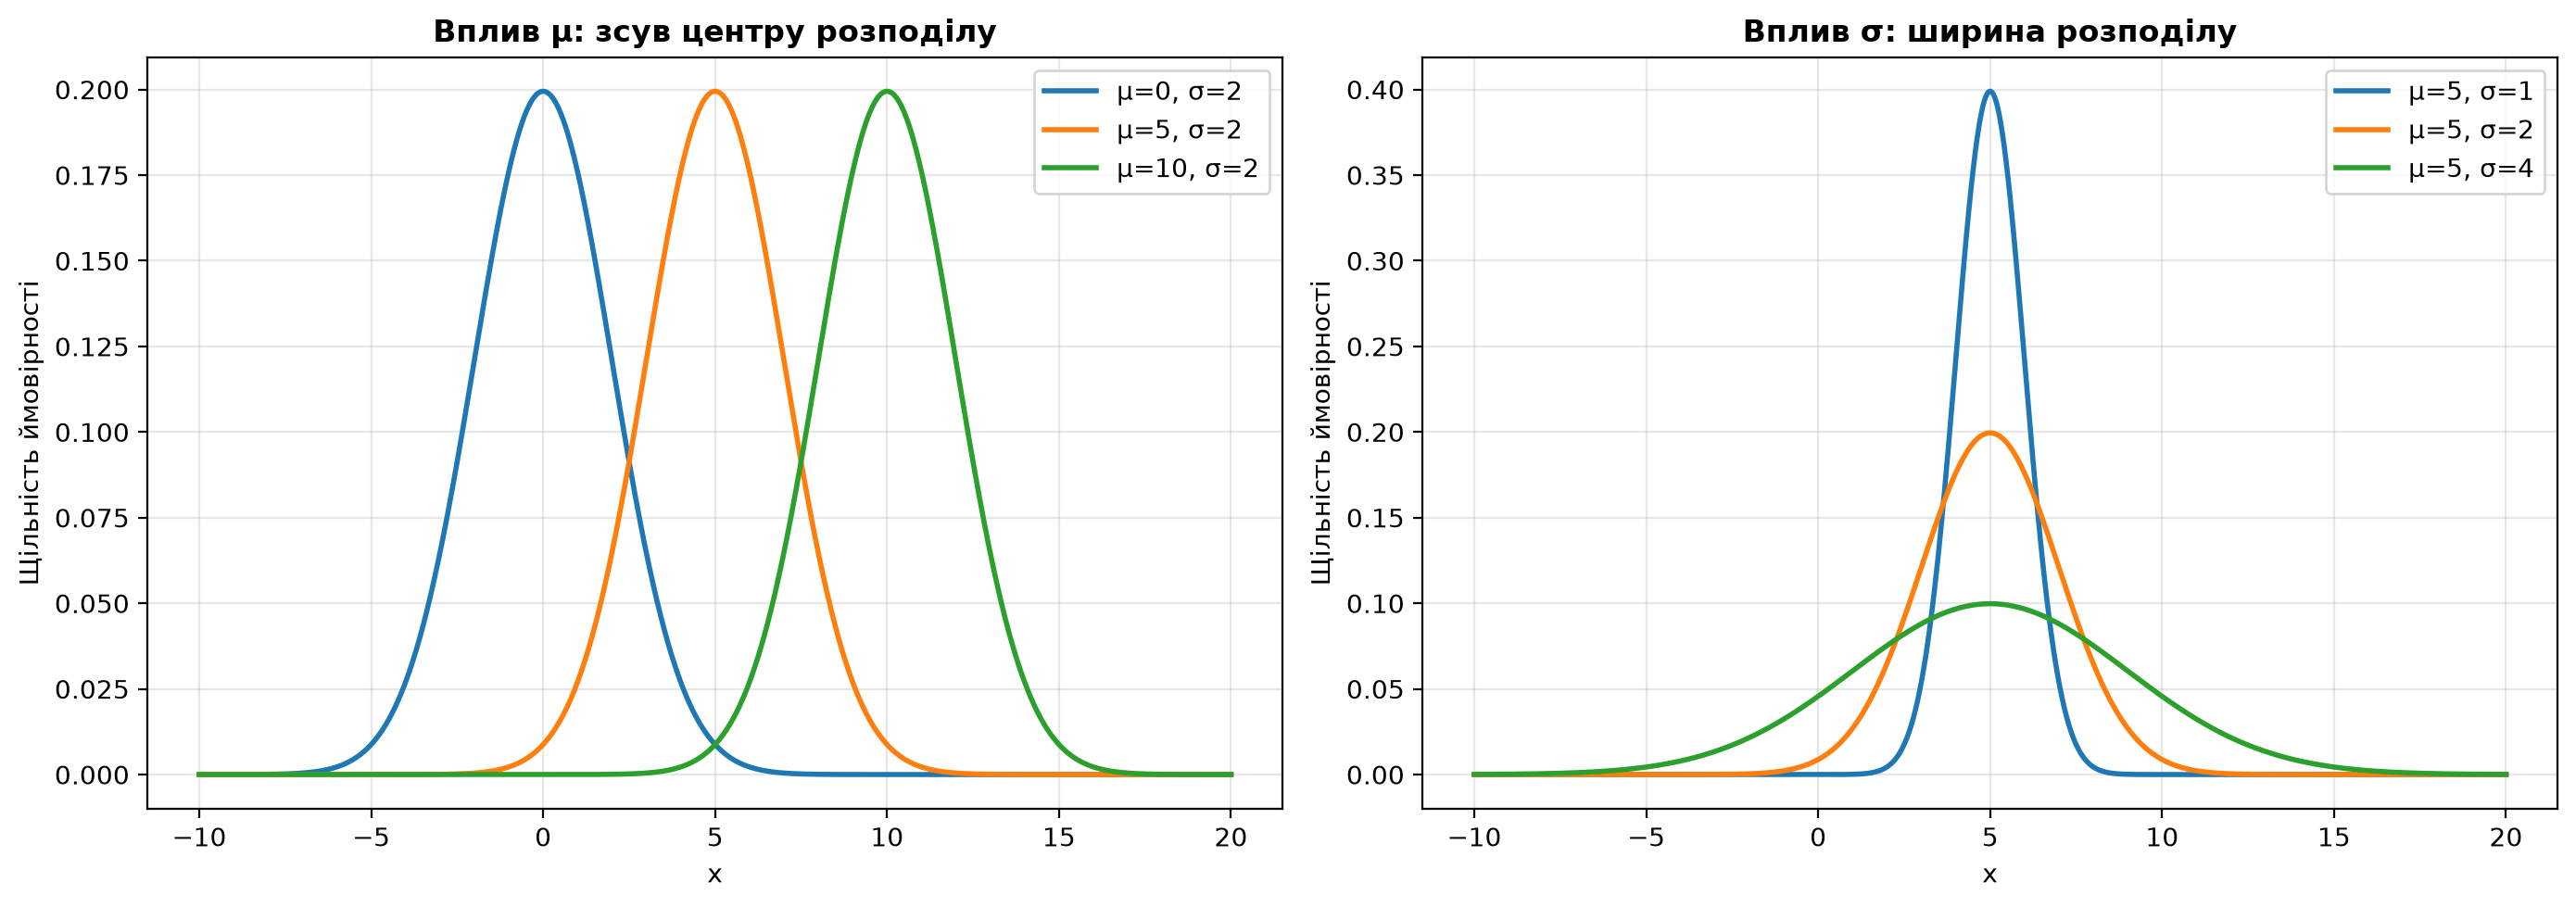
Висновки:
  μ (середнє) → зміщує центр кривої вліво/вправо
  σ (стандартне відхилення) → робить криву вужчою (σ↓) або ширшою (σ↑)
  Більше σ → більша варіація → менша передбачуваність
Правило 68-95-99.7 (Емпіричне правило трьох сигм)
Правило 68–95–99.7 (або правило трьох сигм) стверджує, що для будь-якої величини з нормальним розподілом Гауса (Завантаження...) майже всі дані лежать у межах трьох стандартних відхилень (Завантаження...) від середнього значення (Завантаження...).
Площа під кривою в межах стандартних кроків Завантаження... є універсальною математичною константою природи:
Суть трьох чисел
- Завантаження... спостережень потрапляють в інтервал Завантаження.... Це основа розподілу — звичайна, типова більшість.
- Завантаження... спостережень потрапляють в інтервал Завантаження.... Тут зосереджені майже всі стандартні випадки. Тільки близько 5% даних (по 2.3% з кожного боку) виходять за цей діапазон.
- Завантаження... спостережень потрапляють в інтервал Завантаження.... Усе, що виходить за межі трьох сигм (лише 0.3% подій), у статистиці вважають статистичною аномалією або винятком із правил.
Конкретний числовий приклад: Зріст чоловіків
Уявімо популяцію, де середній зріст дорослих чоловіків становить Завантаження... см, а стандартне відхилення — Завантаження... см.
| Інтервал | Формула | Діапазон зросту | Частка популяції |
|---|---|---|---|
| Завантаження... | Завантаження... | 168 – 182 см | Завантаження... (більшість людей на вулиці) |
| Завантаження... | Завантаження... | 161 – 189 см | Завантаження... (майже всі дорослі чоловіки) |
| Завантаження... | Завантаження... | 154 – 196 см | Завантаження... (практично все населення) |
Чоловік зі зростом понад 196 см або нижче 154 см виходить за межі трьох сигм: таких людей сумарно лише 0.3% (приблизно 3 особи на кожну 1000).
Де це застосовують на практиці?
- Контроль якості на заводах (концепція Six Sigma): якщо вага пачки печива або розмір деталі відхиляється від центру більше ніж на Завантаження..., конвеєр зупиняють і калібрують верстати.
- Виявлення аномалій (Fraud Detection): у банках та фінтеху операції клієнта, які відхиляються від його типового профілю витрат далі ніж на Завантаження..., маркуються як підозрілі й вимагають додаткового підтвердження.
Анатомія правила: що залишається за межами?
Математична сила правила трьох сигм розкривається, коли ми дивимося не на центр, а на хвости розподілу (те, що виходить за межі меж):
| Діапазон | Частка всередині інтервалу | Залишок у хвості (сумарно) | Площа кожного окремого хвоста | Частота появи події поза межами |
|---|---|---|---|---|
| Завантаження... | 68.27% | 31.73% | 15.86% (зліва) / 15.86% (справа) | Майже кожен 3-й випадок |
| Завантаження... | 95.45% | 4.55% | 2.27% (зліва) / 2.27% (справа) | Приблизно 1 із 22 випадків |
| Завантаження... | 99.73% | 0.27% | 0.135% (зліва) / 0.135% (справа) | Рідкість: 1 із 370 випадків |
| Завантаження... | 99.994% | 0.006% | 0.003% (зліва) / 0.003% (справа) | Екстремум: 1 із 15 787 випадків |
| Завантаження... | 99.99966% | 0.00034% | 0.00017% | Концепція Six Sigma: 3.4 дефекти на 1 млн |
Інтуїтивна аналогія: Фасування кави на конвеєрі
Автоматичний дозатор фасує пачки кави. Маса пачки розподілена нормально: середнє Завантаження... г, стандартне відхилення Завантаження... г.
- 68.3% пачок важать від 495 до 505 г (Завантаження...);
- 95.5% пачок важать від 490 до 510 г (Завантаження...);
- 99.7% пачок важать від 485 до 515 г (Завантаження...).
Якщо відділ контролю якості (QA) виявляє пачку вагою менше 485 г або більше 515 г, це означає, що відхилення перевищило Завантаження.... Такий збій трапляється з імовірністю менше ніж 0.14%! Інженер упевнено зупиняє лінію: це не випадкове коливання, а поломка механічного дозатора.
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

rng = np.random.default_rng(seed=42)

# Параметри розподілу
mu, sigma = 100, 15

# Генеруємо дані
data = rng.normal(mu, sigma, 10000)

# Візуалізація
fig, ax = plt.subplots(figsize=(12, 6))

# Гістограма даних
ax.hist(data, bins=50, density=True, alpha=0.7, color='lightblue', edgecolor='black', label='Дані (гістограма)')

# Теоретична крива
x = np.linspace(mu - 4*sigma, mu + 4*sigma, 1000)
pdf = stats.norm.pdf(x, mu, sigma)
ax.plot(x, pdf, 'r-', linewidth=2, label='Теоретична крива')

# Позначення середнього
ax.axvline(mu, color='black', linestyle='--', linewidth=2, label=f'μ = {mu}')

# Заповнення областей
colors = ['#90EE90', '#FFD700', '#FFB6C1']
labels = ['68% (μ±1σ)', '95% (μ±2σ)', '99.7% (μ±3σ)']
alphas = [0.5, 0.3, 0.2]

for i in range(3, 0, -1):
    mask = (x >= mu - i*sigma) & (x <= mu + i*sigma)
    ax.fill_between(x[mask], pdf[mask], alpha=alphas[i-1], color=colors[i-1], label=labels[i-1])

# Позначення меж σ
for i in range(1, 4):
    ax.axvline(mu - i*sigma, color='orange', linestyle=':', linewidth=1.5, alpha=0.7)
    ax.axvline(mu + i*sigma, color='orange', linestyle=':', linewidth=1.5, alpha=0.7)

ax.set_xlabel('Значення', fontsize=12)
ax.set_ylabel('Щільність ймовірності', fontsize=12)
ax.set_title(f'Правило 68-95-99.7 для N({mu}, {sigma}²)', fontweight='bold', fontsize=14)
ax.legend(loc='upper right')
ax.grid(alpha=0.3)
plt.show()

# Емпірична перевірка правила
within_1sigma = np.sum((data >= mu - sigma) & (data <= mu + sigma)) / len(data)
within_2sigma = np.sum((data >= mu - 2*sigma) & (data <= mu + 2*sigma)) / len(data)
within_3sigma = np.sum((data >= mu - 3*sigma) & (data <= mu + 3*sigma)) / len(data)

print("Емпірична перевірка правила 68-95-99.7:")
print(f"  μ±1σ ({mu-sigma}–{mu+sigma}): {within_1sigma:.1%} (теоретично 68.3%)")
print(f"  μ±2σ ({mu-2*sigma}–{mu+2*sigma}): {within_2sigma:.1%} (теоретично 95.4%)")
print(f"  μ±3σ ({mu-3*sigma}–{mu+3*sigma}): {within_3sigma:.1%} (теоретично 99.7%)")
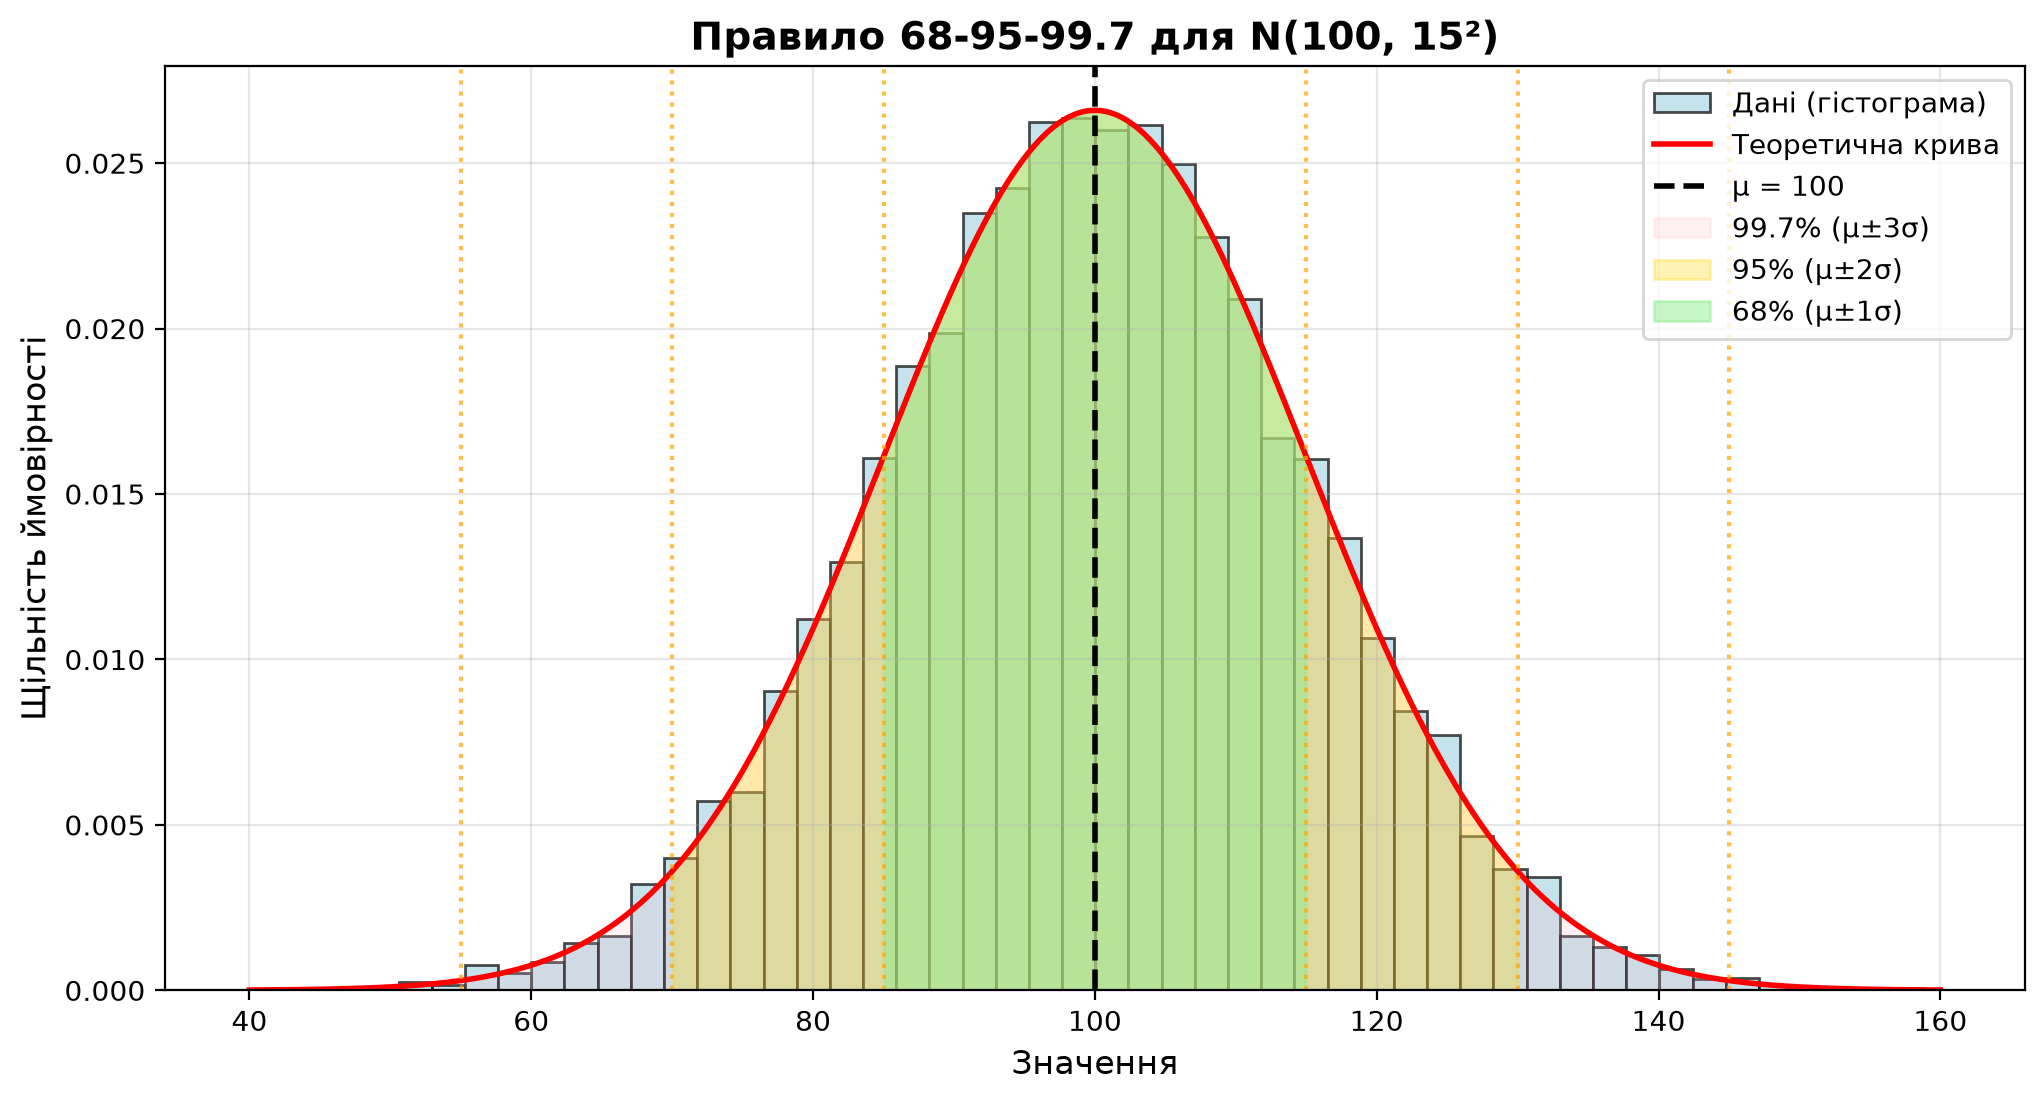
Емпірична перевірка правила 68-95-99.7:
  μ±1σ (85–115): 67.8% (теоретично 68.3%)
  μ±2σ (70–130): 95.4% (теоретично 95.4%)
  μ±3σ (55–145): 99.7% (теоретично 99.7%)
- Виявлення аномалій: значення далі ніж 3σ від середнього — сильний сигнал аномалії
- Довірчі інтервали: «з 95% ймовірністю результат у межах μ ± 2σ»
- Контроль якості: якщо вимірювання виходить за межі μ ± 3σ, процес вийшов з-під контролю
- A/B тестування: визначення статистичної значущості
Стандартний нормальний розподіл та Z-оцінка
Стандартний нормальний розподіл (standard normal distribution) — це еталонний нормальний розподіл, у якого центр зафіксовано в нулі (μ = 0), а стандартне відхилення дорівнює одиниці (σ = 1).
Позначення: Завантаження...
Інтуїтивна аналогія: Z-оцінка як універсальний валютний конвертер
Уявіть, що ви отримали 85 балів на важкому іспиті з вищої математики (де середній бал групи становив Завантаження..., а розкид Завантаження...), і 90 балів на іспиті з англійської мови (де тест був легким, середнє Завантаження..., а розкид Завантаження...).За абсолютним числом 90 > 85. Але в якій дисципліні ваш успіх справді видатний відносно всієї групи?
- Математика: Завантаження... (ви на 1.5 сигми вище за середній рівень);
- Англійська: Завантаження... (ви лише на 1.0 сигму вище за середній рівень).
Незважаючи на менший абсолютний бал, у математиці ви обійшли набагато більшу частку однокурсників! Z-оцінка працює як валютний конвертер: вона переводить різні шкали вимірювання (бали, кілограми, мілісекунди) в одну універсальну валюту — відстань у стандартних відхиленнях (сигмах).
Формула Z-оцінки (Z-score, стандартизація)
Для вибіркових даних замість параметрів генеральної сукупності Завантаження... та Завантаження... підставляють вибіркові оцінки Завантаження... та Завантаження...:
Анатомія формули: розбір по кроках
- Чисельник Завантаження... — Абсолютне відхилення (Distance):
Показує, на скільки одиниць реальне значення Завантаження... відхилилося від «центру тяжіння» Завантаження....- Якщо Завантаження... — чисельник додатний (значення більше за типове).
- Якщо Завантаження... — чисельник від'ємний (значення менше за типове).
- Якщо Завантаження... — чисельник строго дорівнює нулю (значення ідеально в центрі).
- Знаменник Завантаження... — Еталонна масштабна лінійка (Scale):
Стандартне відхилення Завантаження... задає типовий природний розкид значень у досліджуваному процесі. Поділ на Завантаження... дає відповідь на запитання: «Скільки стандартних кроків (сигм) поміщається у відхилення точки від норми?». - Результат Завантаження... — Універсальний безрозмірний індекс (Dimensionless Index):
Оскільки чисельник і знаменник мають однакові одиниці вимірювання (наприклад, мілісекунди діляться на мілісекунди), розмірності скорочуються! Число Завантаження... позбавлене будь-яких одиниць, що дає змогу напряму зіставляти абсолютно різні за фізичною природою метрики (наприклад, завантаження процесора у % та затримку диска в мс).
Таблиця інтерпретації значень Z-score
| Значення Завантаження... | Де знаходиться спостереження? | Частка популяції в межах цього Завантаження... | Практичний інженерний вердикт |
|---|---|---|---|
| Завантаження... | Рівно в центрі розподілу (Завантаження...) | 50% нижче, 50% вище | Типове середнє значення системи |
| Завантаження... | У межах Завантаження... від норми | ~68.3% | Абсолютно штатна робота |
| Завантаження... | У межах Завантаження... від норми | ~95.5% | Припустимі робочі коливання |
| Завантаження... | Між Завантаження... та Завантаження... | ~4.2% | Пікове навантаження або легка аномалія (Warning) |
| Завантаження... | Далі ніж Завантаження... від норми | лише 0.27% (менше 3 на 1000) | Критичний викид (Anomaly / Outlier) |
Чому Z-оцінка незамінна в Machine Learning?
Уявіть, що ви навчаєте алгоритм штучного інтелекту приймати рішення на основі таблиці даних клієнтів. Без попередньої стандартизації більшість популярних моделей (лінійна регресія, нейронні мережі, метод k-найближчих сусідів k-NN, SVM, метод головних компонентів PCA) будуть працювати некоректно.
Чому так відбувається? Розберемо на наочних аналогіях.
1. Аналогія «Яблука проти кавунів»: чому комп'ютер сліпий до фізичних одиниць?
Комп'ютерні алгоритми нічого не знають про реальний фізичний світ: вони не розуміють, що таке «роки», «сантиметри», «гривні» чи «мілісекунди». Алгоритм бачить лише голі числа в матриці:
Уявіть, що ми прогнозуємо благонадійність позичальника в банку за двома ознаками:
- Вік клієнта: від 18 до 70 років (розкид становить лише десятки одиниць, Завантаження...).
- Річний дохід: від 20 000 до 2 000 000 грн (розкид становить сотні тисяч одиниць, Завантаження...).
У чому пастка?
Різниця у віці в 40 років (різниця між 20-річним студентом і 60-річним досвідченим інженером) — це колосальний життєвий розрив. Але числова різниця становить лише число 40.
Водночас різниця в доході у 500 грн (вартість однієї пачки кави) — це число 500!
Алгоритм дивиться на числа: оскільки Завантаження..., модель вирішить, що пачка кави в 12 разів важливіша для фінансового скорингу, ніж різниця між студентом і пенсіонером! Ознака з великими цифрами просто «задушить» ознаку з малими цифрами.
А що, якби ми вимірювали дохід не в гривнях, а в мільйонах доларів (Завантаження... млн)? Тоді алгоритм повністю викинув би дохід і дивився б тільки на вік! Залежність ШІ від того, які одиниці вибрав аналітик (метри чи кілометри, копійки чи гривні) — неприпустима.
2. Аналогія «Геометрична відстань у просторі ознак» (Алгоритм k-NN)
Алгоритм Завантаження...-найближчих сусідів (Завантаження...-NN) шукає схожих користувачів, обчислюючи звичайну теорему Піфагора (евклідову відстань) між рядками:
Нехай ми порівнюємо двох клієнтів за параметрами [Кількість авто, Річні витрати на пальне]:
- Клієнт 1: має 0 авто, витрати 20 000 грн;
- Клієнт 2: має 3 авто, витрати 21 000 грн.
Обчислимо відстань між ними:
Зверніть увагу: різниця в кількості машин дала внесок у формулу лише Завантаження..., а різниця у витратах — Завантаження...! Для алгоритму ці два клієнти відрізняються рівно на тисячу гривень, а наявність 3 автомобілів взагалі розчинилася в похибці округлення.
3. Аналогія «Каньйон проти круглої чаші» (Градієнтний спуск у нейромережах)
Коли нейромережа навчається, алгоритм градієнтного спуску шукає точку найменшої помилки, рухаючись поверхнею функції втрат:
- Без стандартизації (ознаки різного масштабу): Поверхня функції помилки перетворюється на вузьку й витягнуту ущелину (каньйон). Схили вздовж великої ознаки круті, а вздовж малої — майже плоскі. Градієнтний спуск починає хаотично відбиватися від однієї стінки ущелини до іншої, рухаючись до мінімуму надзвичайно повільно або взагалі «вибухаючи» (розбіжність градієнта).
- Після Z-стандартизації: Поверхня стає ідеально симетричною круглою чашею. Градієнтний спуск спрямовує вектор кроку строго по радіусу в центр чаші — нейромережа навчається в десятки разів швидше та стабільніше.
Як саме Z-оцінка (StandardScaler) рятує ситуацію?
Клас StandardScaler у бібліотеці scikit-learn робить просту, але фундаментальну річ: він віднімає від кожної колонки її середнє значення Завантаження... і ділить на її розкид Завантаження...:
Після такого перетворення:
- Єдина шкала для всього: Кожна колонка датасету отримує центр Завантаження... та стандартне відхилення Завантаження....
- Універсальна мова даних: Замість запитання «Скільки у тебе гривень чи років?», алгоритм оперує питанням: «На скільки сигм від норми відхиляється це значення?».
- І рідкісний геній з IQ 145, і рідкісний мільйонер з великим капіталом отримають однакове стандартизоване значення Завантаження.... Тепер модель сприймає їх однаково потужними сигналами!
import numpy as np
from scipy import stats

# Дані про зріст (см)
heights = np.array([165, 170, 175, 180, 185, 190])

# Обчислення Z-оцінок
mean_height = heights.mean()
std_height = heights.std(ddof=0)
z_scores = (heights - mean_height) / std_height

print("Зріст людей та їхні Z-оцінки:\n")
print(f"{'Зріст (см)':<12} {'Z-оцінка':<12} Інтерпретація")
print("-" * 60)

for h, z in zip(heights, z_scores):
    if z > 0:
        interpret = f"{z:.2f}σ вище середнього"
    elif z < 0:
        interpret = f"{abs(z):.2f}σ нижче середнього"
    else:
        interpret = "дорівнює середньому"

    print(f"{h:<12} {z:>+6.2f}       {interpret}")

print(f"\nСереднє: {mean_height:.1f} см")
print(f"Стандартне відхилення: {std_height:.2f} см")

# Приклад: яка людина вища?
person_a_height = 185  # 185 см
person_b_iq = 130      # IQ 130 (μ=100, σ=15 для IQ тестів)

z_height = (person_a_height - mean_height) / std_height
z_iq = (person_b_iq - 100) / 15

print(f"\nПорівняння відносних показників:")
print(f"  Людина A: зріст {person_a_height} см → Z = {z_height:+.2f}")
print(f"  Людина B: IQ {person_b_iq} → Z = {z_iq:+.2f}")
print(f"\nЛюдина B має вищий відносний показник (далі від середнього у своїй групі)")
Зріст людей та їхні Z-оцінки:

Зріст (см)   Z-оцінка    Інтерпретація
------------------------------------------------------------
165           -1.46       1.46σ нижче середнього
170           -0.88       0.88σ нижче середнього
175           -0.29       0.29σ нижче середнього
180           +0.29       0.29σ вище середнього
185           +0.88       0.88σ вище середнього
190           +1.46       1.46σ вище середнього

Середнє: 177.5 см
Стандартне відхилення: 8.54 см

Порівняння відносних показників:
  Людина A: зріст 185 см → Z = +0.88
  Людина B: IQ 130 → Z = +2.00

Людина B має вищий відносний показник (далі від середнього у своїй групі)
- Нормалізація даних (feature scaling): багато алгоритмів працюють краще зі стандартизованими даними
- Виявлення аномалій: |z| > 3 — потенційний аутлайер
- Порівняння різних змінних: порівняти зріст та вагу у одних одиницях (σ)
Генерація нормальних даних у NumPy
import numpy as np

rng = np.random.default_rng(seed=42)

# Спосіб 1: rng.normal(loc, scale, size)
data1 = rng.normal(loc=100, scale=15, size=1000)
print(f"Спосіб 1 - rng.normal():")
print(f"  Середнє: {data1.mean():.2f}")
print(f"  Стандартне відхилення: {data1.std():.2f}\n")

# Спосіб 2: rng.standard_normal() — стандартний нормальний (μ=0, σ=1)
z_scores = rng.standard_normal(1000)  # N(0, 1)
data2 = z_scores * 15 + 100           # Перетворення на N(100, 15)
print(f"Спосіб 2 - rng.standard_normal() + трансформація:")
print(f"  Середнє: {data2.mean():.2f}")
print(f"  Стандартне відхилення: {data2.std():.2f}")
Спосіб 1 - rng.normal():
  Середнє: 100.12
  Стандартне відхилення: 15.03

Спосіб 2 - rng.standard_normal() + трансформація:
  Середнє: 99.87
  Стандартне відхилення: 14.95
Розподіл Пуассона (Poisson Distribution)
Розподіл Пуассона моделює кількість подій, що відбуваються за фіксований інтервал часу або простору, коли події:
- Відбуваються незалежно одна від одної
- Мають постійну середню частоту (λ)
- Не можуть відбутися одночасно
Параметр: λ (лямбда) — середня кількість подій за інтервал
Формула PMF (Функція ймовірності)
Де Завантаження... — кількість подій, що нас цікавить.
Анатомія формули: що робить кожен доданок?
Ця елегантна формула поєднує три математичні сили:
- Завантаження... (Масштабування інтенсивності):
Якщо в середньому за період відбувається Завантаження... подій, то для настання Завантаження... незалежних подій їхній потенціал зростає пропорційно степеню Завантаження.... - Завантаження... (Фактор спокою, ймовірність нульових подій):
Число Ейлера у від'ємному степені Завантаження.... Це ймовірність того, що на всьому інтервалі часу не відбудеться взагалі жодної події (Завантаження...). Чим вища інтенсивність потоку Завантаження..., тим менший шанс абсолютно тихого періоду. - Завантаження... (Факторіал — усунення перестановок):
Оскільки всі події однорідні (нам байдуже, чи перший клієнт зайшов об 11:05, а другий об 11:20, чи навпаки), ділення на кількість перестановок Завантаження... прибирає надлишковий підрахунок порядку прибуття. Крім того, факторіал росте значно швидше за степінь, що гарантує спадання ймовірності до нуля при нереалістично великих Завантаження....
Числові характеристики: унікальна властивість Пуассона
Головна візитна картка розподілу Пуассона — рівність середнього та дисперсії:
Якщо у вибірці виявлено, що дисперсія істотно відрізняється від середнього, дані не підкоряються простому закону Пуассона (це явище називають надлишковою дисперсією — overdispersion).
Покроковий приклад ручного розрахунку: збої в розподіленій черзі повідомлень
Припустимо, черга повідомлень RabbitMQ фіксує в середньому Завантаження... помилки відправки за годину. Інженеру потрібно оцінити ймовірності навантаження на систему:
- Задача 1: Який шанс абсолютно чистої години без жодного збою (Завантаження...)?
Оскільки Завантаження... та Завантаження...:Завантаження...
Тобто лише у ~5% годин система працює без жодної помилки. - Задача 2: Яка ймовірність отримати рівно 2 збої (Завантаження...)?Завантаження...
- Задача 3: Яка ймовірність перевантаження черги (більше 2 збоїв за годину)?
Застосуємо правило протилежної події:Завантаження...Завантаження...Завантаження...
З імовірністю майже 58% черговий інженер отримає більше двох сповіщень.
Приклади з реального світу
- Кількість дзвінків у call-центр за годину (Завантаження... дзвінків/год)
- Кількість відвідувачів сайту за хвилину (Завантаження... відвідувачів/хв)
- Кількість помилок на сторінці коду (Завантаження... помилок/сторінка)
- Кількість аварій на ділянці дороги за рік (Завантаження... аварії/рік)
- Кількість радіоактивних розпадів за секунду (Завантаження... розпадів/сек)
Аналогія: Ви керуєте кухнею піцерії. У середньому щогодини надходить 4 замовлення. Розподіл Пуассона дає строгу математичну відповідь: «Яка точна ймовірність того, що за наступну годину прийде рівно 6 замовлень?» або «Який шанс, що в першу годину відкриття не надійде жодного клієнта (0)?»
Генерація та візуалізація
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

rng = np.random.default_rng(seed=42)

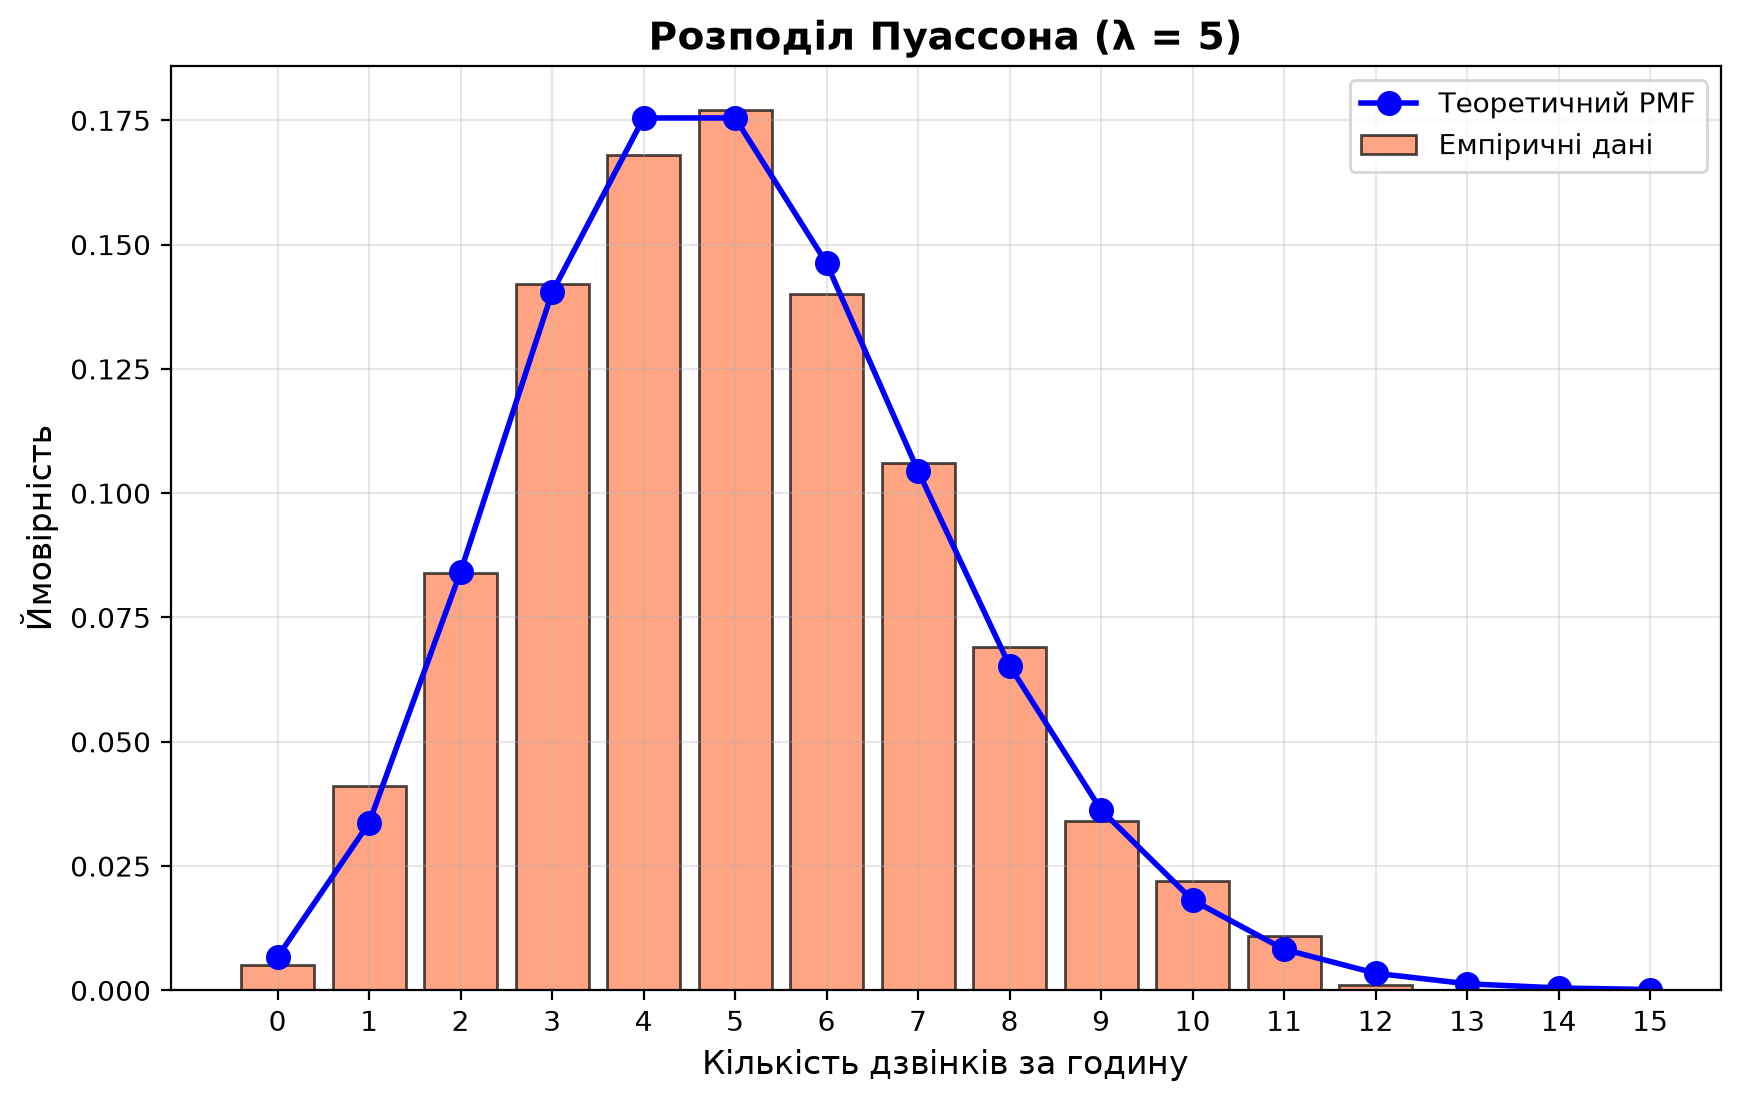
# Симулюємо 1000 годин роботи call-центру (λ = 5 дзвінків/год)
lambda_val = 5
calls_per_hour = rng.poisson(lam=lambda_val, size=1000)

# Візуалізація
fig, ax = plt.subplots(figsize=(10, 6))

# Гістограма емпіричних даних
values, counts = np.unique(calls_per_hour, return_counts=True)
probabilities = counts / len(calls_per_hour)

ax.bar(values, probabilities, edgecolor='black', alpha=0.7, color='coral', label='Емпіричні дані')

# Теоретичні ймовірності
x_theory = np.arange(0, 16)
pmf_theory = stats.poisson.pmf(x_theory, lambda_val)

ax.plot(x_theory, pmf_theory, 'bo-', markersize=8, linewidth=2, label='Теоретичний PMF')

ax.set_xlabel('Кількість дзвінків за годину', fontsize=12)
ax.set_ylabel('Ймовірність', fontsize=12)
ax.set_title(f'Розподіл Пуассона (λ = {lambda_val})', fontweight='bold', fontsize=14)
ax.set_xticks(range(0, 16))
ax.legend()
ax.grid(alpha=0.3)
plt.show()

# Статистика
print(f"Середня кількість дзвінків за годину:")
print(f"  Емпірична: {calls_per_hour.mean():.2f}")
print(f"  Теоретична (λ): {lambda_val}")
print(f"\nСтандартне відхилення:")
print(f"  Емпіричне: {calls_per_hour.std():.2f}")
print(f"  Теоретичне (√λ): {np.sqrt(lambda_val):.2f}")
print(f"\nОсобливість Пуассона: mean = variance = λ")
Середня кількість дзвінків за годину:
  Емпірична: 4.94
  Теоретична (λ): 5

Стандартне відхилення:
  Емпіричне: 2.24
  Теоретичне (√λ): 2.24

Особливість Пуассона: mean = variance = λ
# Практичні запитання
print("Практичні запитання (теоретичні відповіді):\n")

# 1. Ймовірність точно 3 дзвінків
prob_3 = stats.poisson.pmf(3, lambda_val)
print(f"1. P(точно 3 дзвінки) = {prob_3:.3f} ({prob_3*100:.1f}%)")

# 2. Ймовірність 0 дзвінків (тиха година)
prob_0 = stats.poisson.pmf(0, lambda_val)
print(f"2. P(жодного дзвінка) = {prob_0:.3f} ({prob_0*100:.1f}%)")

# 3. Ймовірність більше 8 дзвінків (перевантаження)
prob_more_8 = 1 - stats.poisson.cdf(8, lambda_val)
print(f"3. P(більше 8 дзвінків) = {prob_more_8:.3f} ({prob_more_8*100:.1f}%)")

# 4. Ймовірність від 4 до 6 дзвінків (типова година)
prob_4_to_6 = stats.poisson.cdf(6, lambda_val) - stats.poisson.cdf(3, lambda_val)
print(f"4. P(4–6 дзвінків) = {prob_4_to_6:.3f} ({prob_4_to_6*100:.1f}%)")
Практичні запитання (теоретичні відповіді):

1. P(точно 3 дзвінки) = 0.140 (14.0%)
2. P(жодного дзвінка) = 0.007 (0.7%)
3. P(більше 8 дзвінків) = 0.068 (6.8%)
4. P(4–6 дзвінків) = 0.578 (57.8%)
Властивості розподілу Пуассона
| Властивість | Значення |
|---|---|
| Середнє (μ) | λ |
| Дисперсія (σ²) | λ |
| Стандартне відхилення (σ) | √λ |
| Можливі значення | 0, 1, 2, 3, ... (невід'ємні цілі) |
Унікальна математична властивість: математичне сподівання строго дорівнює дисперсії: Завантаження....
- ✅ Лічимо дискретні рідкісні події (аварії, помилки в системі, відмови дисків);
- ✅ Події відбуваються незалежно одна від одної;
- ✅ Середня інтенсивність потоку подій є стабільною в часі;
- ✅ Імовірність одночасного виникнення двох і більше подій в одну мить є нескінченно малою.
- Пуассонівська регресія (Poisson Regression) для передбачення лічильних змінних (кількість кліків користувача, кількість транзакцій);
- Моделювання черг повідомлень та балансування навантаження мікросервісів;
- Оцінка ризиків відмов серверного обладнання.
- Він моделює потік вхідних HTTP-запитів до Nginx або повідомлень у чергу RabbitMQ/Kafka, якщо користувачі клацають незалежно один від одного із середньою інтенсивністю Завантаження... подій за одиницю часу.
- Унікальна інженерна властивість: якщо ви знаєте середній трафік (Завантаження... req/sec), ви автоматично знаєте стандартне відхилення можливих випадкових сплесків: Завантаження... req/sec. Це дозволяє точно розраховувати необхідний розмір буфера сокетів і порогові значення для Horizontal Pod Autoscaler (HPA) у Kubernetes.
Порівняння розподілів Пуассона з різними λ
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

lambdas = [1, 5, 10, 20]
x = np.arange(0, 40)

fig, axes = plt.subplots(2, 2, figsize=(12, 8))
axes = axes.ravel()

for i, lam in enumerate(lambdas):
    pmf = stats.poisson.pmf(x, lam)
    axes[i].bar(x, pmf, edgecolor='black', alpha=0.7, color='steelblue')
    axes[i].set_title(f'Пуассон(λ = {lam})', fontweight='bold')
    axes[i].set_xlabel('Кількість подій')
    axes[i].set_ylabel('Ймовірність')
    axes[i].set_xlim(-1, 40)
    axes[i].grid(alpha=0.3)
    axes[i].text(0.7, 0.9, f'μ = {lam}\nσ = {np.sqrt(lam):.2f}',
                 transform=axes[i].transAxes, fontsize=10,
                 bbox=dict(boxstyle='round', facecolor='wheat', alpha=0.5))

plt.tight_layout()
plt.show()

print("Спостереження:")
print("  При малому λ (1) → розподіл сильно скошений вправо (асиметричний)")
print("  При великому λ (20) → розподіл стає симетричним і наближається до нормального")
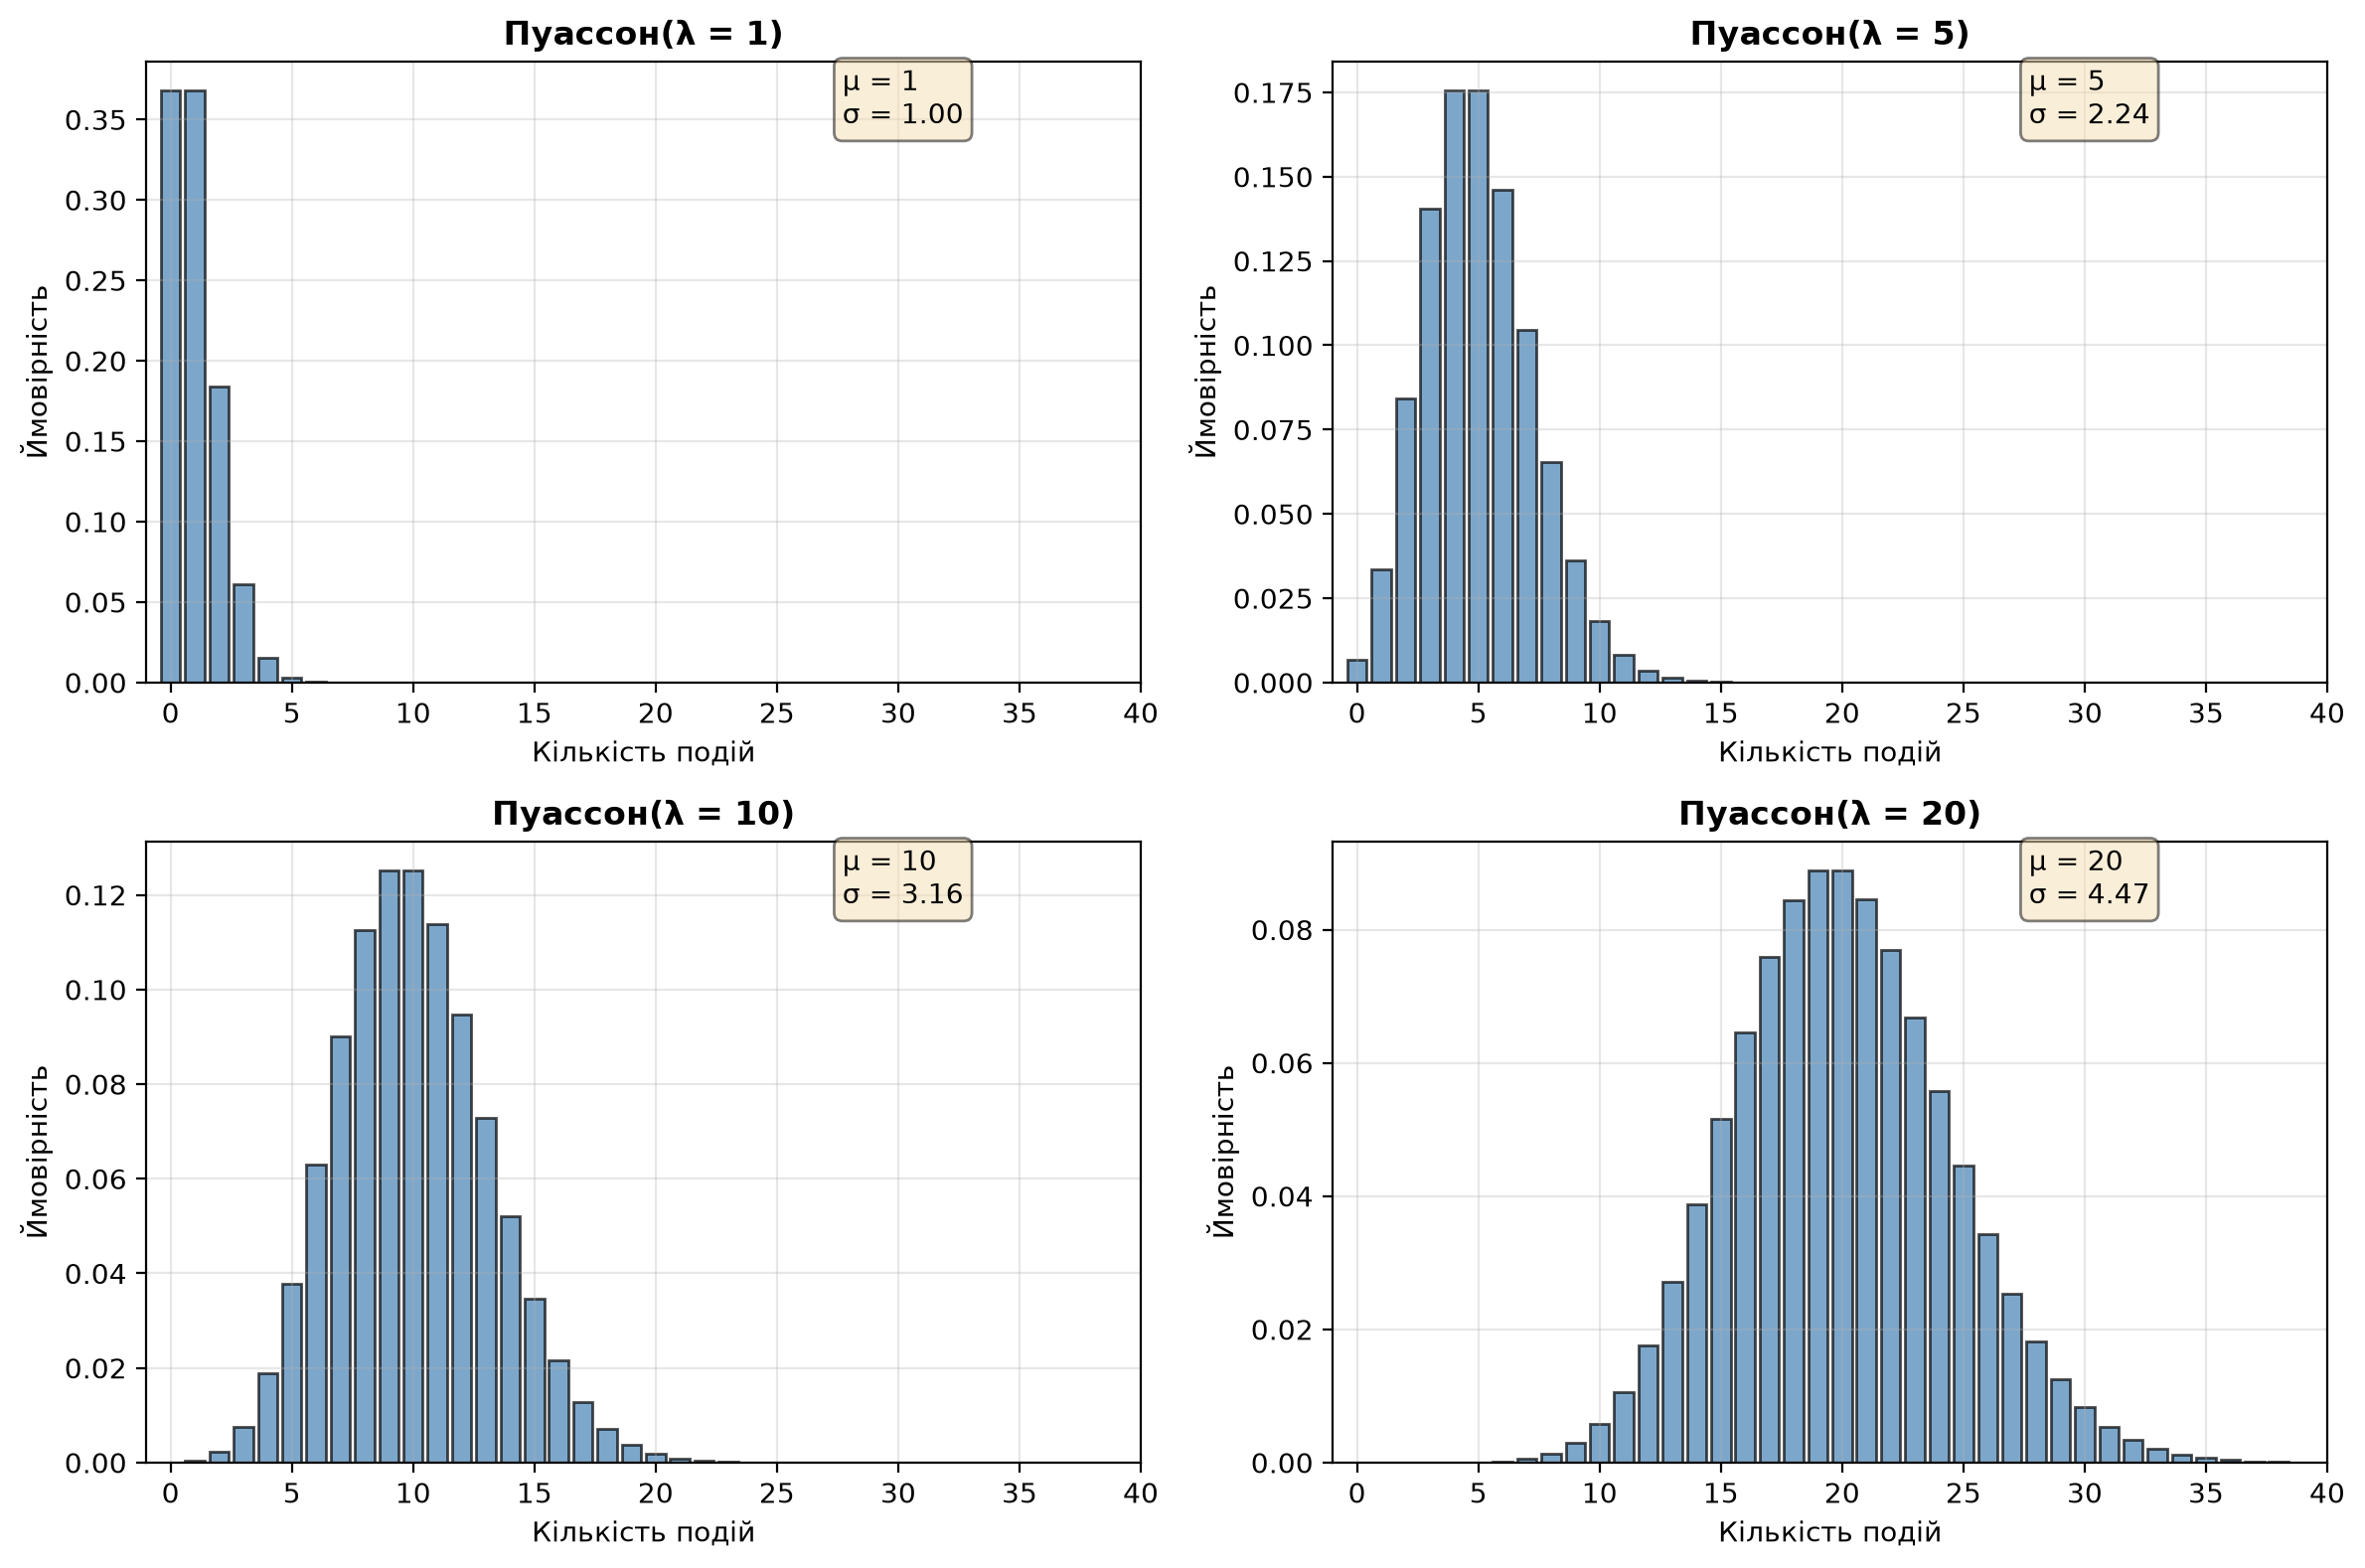
Спостереження:
  При малому λ (1) → розподіл сильно скошений вправо (асиметричний)
  При великому λ (20) → розподіл стає симетричним і наближається до нормального
Інші фундаментальні розподіли
Окрім нормального та пуассонівського розподілів, у комп'ютерних науках, аналізі даних та надійності систем щодня використовуються ще три базові математичні моделі.
1. Біноміальний розподіл (Binomial Distribution)
Біноміальний розподіл моделює кількість успіхів Завантаження... у серії з Завантаження... незалежних експериментів Бернуллі, де кожна спроба має фіксовану ймовірність успіху Завантаження... (та невдачі Завантаження...).
Позначення: Завантаження... або Завантаження...
Формула PMF (Функція ймовірності)
Де Завантаження....
Анатомія формули: розбір на складові
- Завантаження... (Біноміальний коефіцієнт):
Кількість можливих комбінацій, якими можна вибрати Завантаження... успішних спроб із загальної кількості Завантаження.... Наприклад, якщо з 3 спроб успішними були 2, це могло статись як(У, У, Н),(У, Н, У)або(Н, У, У)— рівно Завантаження... способи. - Завантаження... (Ймовірність обраних успіхів):
Оскільки спроби незалежні, ймовірність того, що всі обрані Завантаження... разів випаде успіх, дорівнює перемноженню ймовірностей: Завантаження.... - Завантаження... (Ймовірність решти невдач):
Решта Завантаження... спроб обов'язково повинні завершитися невдачею, кожна з імовірністю Завантаження....
Числові характеристики
- Математичне сподівання: Завантаження...
- Дисперсія: Завантаження...
Покроковий приклад: надійність доставки мережевих пакетів
Маршрутизатор відправляє повідомлення, розбите на Завантаження... мережевих пакетів. Через перешкоди на лінії зв'язку ймовірність успішного отримання окремого пакета становить Завантаження... (90%), а ймовірність втрати — Завантаження... (10%).
- Питання 1: Яка ймовірність того, що дійдуть абсолютно всі 5 пакетів (Завантаження...)?Завантаження...
- Питання 2: Яка ймовірність того, що загубиться рівно 1 пакет (тобто дійдуть Завантаження...)?
Обчислимо біноміальний коефіцієнт: Завантаження....
Завантаження...
- Питання 3: Скільки пакетів у середньому доходить до адресата?Завантаження...
Генерація в Python: rng.binomial(n=5, p=0.9, size=1000)
2. Експоненціальний розподіл (Exponential Distribution)
Якщо розподіл Пуассона рахує кількість дискретних подій за проміжок часу, то експоненціальний розподіл моделює неперервний час очікування між цими подіями.
Позначення: Завантаження...
Функція щільності (PDF) та кумулятивна функція (CDF)
Анатомія формули та фізичний зміст
- Завантаження... (інтенсивність потоку): Середня кількість подій за одиницю часу (наприклад, 2 збої на добу).
- Завантаження...: Ймовірність того, що за час Завантаження... не станеться жодної події (закон радіоактивного або інформаційного згасання).
- Завантаження...: Накопичена ймовірність того, що перша подія вже відбудеться до моменту часу Завантаження....
Числові характеристики та відсутність пам'яті
- Середній час очікування (Mean Time Between Failures, MTBF):Завантаження...
- Дисперсія:Завантаження...
- Властивість відсутності післядії (Memorylessness):Завантаження...Якщо сервер уже безперебійно пропрацював 100 днів (Завантаження...), ймовірність того, що він пропрацює ще 10 днів (Завантаження...), залишається точно такою самою, як і для щойно встановленого нового сервера. Експоненціальний процес моделює системи без фізичного старіння або зношування (раптові випадкові зовнішні збої).
Покроковий приклад: час до збою хмарного інстансу
У хмарній інфраструктурі середня тривалість безвідмовної роботи віртуальної машини становить Завантаження... діб. Відповідно, інтенсивність аварій Завантаження... збоїв на добу.
- Питання 1: Яка ймовірність того, що інстанс вийде з ладу протягом перших 5 діб?
За формулою CDF:
Завантаження...
- Питання 2: Яка ймовірність того, що сервер витримає понад 30 діб без перезавантаження?Завантаження...
Генерація в Python: rng.exponential(scale=1/lambda_val, size=1000) (параметр scale приймає середній час Завантаження...).
3. Логнормальний розподіл (Lognormal Distribution)
Випадкова величина Завантаження... має логнормальний розподіл, якщо її натуральний логарифм підкоряється класичному нормальному закону:
Оскільки експонента Завантаження... ніколи не буває від'ємною або нульовою, логнормальна величина набуває виключно строго додатних значень (Завантаження...) і має характерну правосторонню асиметрію з довгим «важким» хвостом рідкісних екстремальних подій.
Інтуїтивна аналогія: Ефект снігової кулі (Мультиплікативність проти Адитивності)
- Звичайна нормальна величина (Адитивна): Уявіть, що ви щодня додаєте до гаманця випадкову суму від -5 до +5 грн. Оскільки випадкові фактори додаються (Завантаження...), підсумковий баланс коливатиметься навколо середнього за ідеально симетричним нормальним дзвоном.
- Логнормальна величина (Мультиплікативна): А тепер уявіть венчурну інвестицію, вірусну інфекцію або затримку мережевого запиту в ланцюжку мікросервісів. Тут кожен етап не додає фіксований час, а множить результат на випадковий відсоток (Завантаження...). Якщо кілька вузлів мережі поспіль затримали пакет на Завантаження... та Завантаження..., виникає лавиноподібний ефект. Більшість запитів виконуються блискавично (10–20 мс), але рідкісні «снігові кулі» розростаються до 3000 мс.
Функція щільності (PDF)
Анатомія формули: що означає кожен елемент?
Зверніть увагу: параметри Завантаження... та Завантаження... — це параметри базового нормального розподілу логарифма Завантаження..., а не самої величини Завантаження...!
- Завантаження...: Ми переводимо число Завантаження... у логарифмічний масштаб Завантаження... та вимірюємо його відхилення від центру Завантаження....
- Завантаження...: Класичний гаусів дзвоноподібний множник, який затухає в логарифмічній шкалі.
- Завантаження... у знаменнику (Якобіан заміни змінних):
Це критичний математичний елемент. При переході від звичайного простору Завантаження... до логарифмічного Завантаження... вісь нелінійно розтягується. Похідна логарифма дорівнює:Завантаження...Множник Завантаження... компенсує це геометричне розтягнення, гарантуючи, що сумарна площа під кривою залишається строго рівною 1.00.
Числові характеристики: чому середнє не дорівнює медіані?
Через довгий правий хвіст у логнормальному розподілі виникає сувора ієрархія трьох центральних мір:
Точні аналітичні формули:
- Мода (найімовірніше, найчастіше значення):Завантаження...
- Медіана (50% спостережень лівіше, 50% правіше):Завантаження...
- Математичне сподівання (середнє арифметичне):Завантаження...Чому середнє більше за медіану? Множник Завантаження... відображає вплив важкого хвоста: нечисленні екстремально великі значення сильно відтягують середнє арифметичне вправо.
Покроковий розрахунок: аналіз затримок бекенду (Tail Latency)
Нехай затримка відповідей мікросервісу Завантаження... (у мілісекундах) підпорядковується логнормальному розподілу з параметрами Завантаження... та Завантаження... (у логарифмічній шкалі).
Обчислимо ключові інженерні показники вручну:
- Найчастіший час відповіді (Мода):Завантаження...
- Медіанний час відповіді (p50):Завантаження...Рівно половина всіх клієнтських запитів обробляється швидше ніж за 20 мілісекунд.
- Середній час відповіді (Mean):Завантаження...
- 95-й персентиль (Latency p95):
Для стандартного нормального розподілу 95% площі відповідає Завантаження.... Знаходимо поріг у вихідному масштабі:Завантаження... - 99-й персентиль (Latency p99):
Для 99% Завантаження...:Завантаження...
Де логнормальний розподіл зустрічається на практиці?
- Затримки у розподілених мережах (Tail Latency): Накопичення мультиплікативних мережевих затримок у мікросервісних пайплайнах.
- Розмір файлів у сховищах (AWS S3 / Google Cloud Storage): Мільйони крихітних конфігів і логів по кілька кілобайтів та одиничні важкі медіафайли на сотні мегабайтів.
- Доходи населення та обсяги онлайн-покупок: Левова частка чеків дрібні (кава, продукти), але рідкісні B2B-замовлення формують витягнутий правий хвіст.
Генерація в Python: rng.lognormal(mean=mu, sigma=sigma, size=1000)
Практичні завдання
Рівень 1: Базові вправи
Для кожного з наведених сценаріїв визначте, який розподіл найкраще описує випадкову величину (дискретний/неперервний рівномірний, нормальний чи Пуассона):
- Час очікування автобуса на зупинці (якщо автобуси курсують строго за розкладом кожні 15 хвилин).
- Кількість орфографічних помилок на сторінці книги.
- Результати стандартизованого IQ-тестування великої популяції людей.
- Результат кидка чесного шестигранного грального кубика.
- Кількість пасажирів, які входять на станцію метро протягом 1 хвилини в годину пік.
- Час очікування автобуса: Неперервний рівномірний Завантаження.... Якщо ви прийшли у довільний випадковий момент між двома регулярними рейсами, будь-який час очікування від 0 до 15 хвилин є рівноймовірним.
- Кількість помилок на сторінці: Розподіл Пуассона Завантаження.... Помилки — це рідкісні, дискретні та взаємно незалежні події на фіксованому інтервалі простору (1 сторінка).
- IQ-тести: Нормальний розподіл Завантаження.... Тести спеціально проектуються та стандартизуються психометристами за симетричною гаусовою кривою навколо центру 100.
- Кидок грального кубика: Дискретний рівномірний. Множина значень обмежена цілими числами Завантаження..., кожне з яких випадає з однаковою ймовірністю Завантаження....
- Кількість пасажирів за хвилину: Розподіл Пуассона Завантаження.... Моделює потік незалежних подій за фіксований проміжок часу (1 хвилина). За дуже великих потоків пасажирів за ЦГТ він наближається до нормального.
Згенеруйте по 1000 випадкових значень для кожного з трьох розподілів:
- Рівномірний: Завантаження...;
- Нормальний: Завантаження...;
- Пуассона: Завантаження....
Побудуйте три гістограми в один рядок (1x3 subplots). Порівняйте їхню форму та симетрію.
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(seed=42)

# Генерація вибірок
uniform_data = rng.uniform(0, 100, size=1000)
normal_data = rng.normal(loc=50, scale=10, size=1000)
poisson_data = rng.poisson(lam=10, size=1000)

fig, axes = plt.subplots(1, 3, figsize=(15, 4), sharey=False)

# 1. Рівномірний
axes[0].hist(uniform_data, bins=20, color='coral', edgecolor='black', alpha=0.7)
axes[0].set_title('Uniform(0, 100): Плоский профіль', fontweight='bold')
axes[0].set_xlabel('Значення')
axes[0].set_ylabel('Частота')
axes[0].grid(alpha=0.3)

# 2. Нормальний
axes[1].hist(normal_data, bins=20, color='steelblue', edgecolor='black', alpha=0.7)
axes[1].set_title('Normal(50, 10²): Симетричний дзвін', fontweight='bold')
axes[1].set_xlabel('Значення')
axes[1].grid(alpha=0.3)

# 3. Пуассона
axes[2].hist(poisson_data, bins=15, color='seagreen', edgecolor='black', alpha=0.7)
axes[2].set_title('Poisson(λ=10): Дискретний пік', fontweight='bold')
axes[2].set_xlabel('Кількість подій')
axes[2].grid(alpha=0.3)

plt.tight_layout()
plt.show()
Висновки:
- Рівномірний розподіл утворює прямокутний «стіл» без вираженого центру.
- Нормальний утворює гладкий симетричний дзвін із виразним піком біля Завантаження....
- Пуассон зосереджений на невід'ємних цілих числах з помірною правобічною асиметрією навколо Завантаження....
Дано: зріст дорослих чоловіків розподілений нормально Завантаження.... Аналітично та програмно обчисліть:
- Діапазон, у якому лежать 68.3% зростів;
- Діапазон, у якому лежать 95.4% зростів;
- Ймовірність зустріти чоловіка зростом понад 196 см (Завантаження...).
from scipy import stats

mu, sigma = 175, 7

# 1. ±1σ
r1_min, r1_max = mu - 1 * sigma, mu + 1 * sigma
# 2. ±2σ
r2_min, r2_max = mu - 2 * sigma, mu + 2 * sigma
# 3. > +3σ (196 см)
prob_over_196 = 1 - stats.norm.cdf(196, loc=mu, scale=sigma)

print(f"1. 68.3% зростів: від {r1_min:.1f} до {r1_max:.1f} см")
print(f"2. 95.4% зростів: від {r2_min:.1f} до {r2_max:.1f} см")
print(f"3. P(Зріст > 196 см): {prob_over_196:.5f} ({prob_over_196 * 100:.3f}%)")
Аналітичне пояснення: Оскільки в межах Завантаження... лежить 99.73% популяції, на обидва хвости припадає Завантаження.... Через симетрію на правий хвіст припадає строго половина: Завантаження....
Рівень 2: Алгоритмічні задачі
Реалізуйте функцію is_approximately_normal(data, tolerance=0.03), яка:
- Розраховує вибіркове середнє та стандартне відхилення;
- Обчислює фактичну частку спостережень у межах Завантаження..., Завантаження..., Завантаження...;
- Порівнює їх із теоретичними значеннями Завантаження...;
- Повертає
True, якщо кожне з відхилень не перевищуєtolerance.
import numpy as np

def is_approximately_normal(data, tolerance=0.03):
    data = np.asarray(data)
    mean = data.mean()
    std = data.std(ddof=1)

    # Фактичні частки
    p1 = np.mean((data >= mean - std) & (data <= mean + std))
    p2 = np.mean((data >= mean - 2*std) & (data <= mean + 2*std))
    p3 = np.mean((data >= mean - 3*std) & (data <= mean + 3*std))

    theoretical = [0.6827, 0.9545, 0.9973]
    actual = [p1, p2, p3]
    diffs = [abs(a - t) for a, t in zip(actual, theoretical)]

    passed = all(d <= tolerance for d in diffs)
    return passed, dict(zip(['1σ', '2σ', '3σ'], [f"{a:.1%}" for a in actual]))

rng = np.random.default_rng(seed=42)
normal_sample = rng.normal(loc=100, scale=15, size=5000)
uniform_sample = rng.uniform(50, 150, size=5000)

ok_norm, stats_norm = is_approximately_normal(normal_sample)
ok_unif, stats_unif = is_approximately_normal(uniform_sample)

print(f"Нормальні дані: {ok_norm} -> Частки: {stats_norm}")
print(f"Рівномірні дані: {ok_unif} -> Частки: {stats_unif}")
detect_outliers_zscore(data, threshold=3.0), яка стандартизує масив та знаходить індекси й значення всіх екстремальних точок з Завантаження....import numpy as np
def detect_outliers_zscore(data, threshold=3.0):
data = np.asarray(data)
mean = data.mean()
std = data.std(ddof=1)
z_scores = (data - mean) / std
outlier_mask = np.abs(z_scores) > threshold
outlier_indices = np.where(outlier_mask)[0]
outlier_values = data[outlier_mask]
return {
'indices': outlier_indices.tolist(),
'values': outlier_values.tolist(),
'z_scores': z_scores[outlier_mask].round(2).tolist(),
'percentage': float(np.mean(outlier_mask) * 100)
}
rng = np.random.default_rng(seed=42)
test_data = rng.normal(100, 10, size=1000)
# Додамо штучні аномалії
test_data[42] = 145 # +4.5σ
test_data[123] = 62 # -3.8σ
res = detect_outliers_zscore(test_data, threshold=3.0)
print(f"Виявлено викидів: {len(res['indices'])} ({res['percentage']:.2f}% від вибірки)")
for idx, val, z in zip(res['indices'], res['values'], res['z_scores']):
print(f" Індекс {idx:3d}: Значення = {val:.1f} (Z = {z:+5.2f}σ)")
Змоделюйте роботу технічної підтримки протягом 1000 годин, де вхідні звернення надходять за законом Пуассона з інтенсивністю Завантаження... дзвінків/год:
- Скільки годин оператори взагалі не мали дзвінків (Завантаження...)?
- Скільки годин виникало критичне перевантаження (Завантаження...)?
- Порівняйте емпіричні результати з теоретичними ймовірностями.
import numpy as np
from scipy import stats

rng = np.random.default_rng(seed=42)
lam = 6.0
n_hours = 1000

calls = rng.poisson(lam=lam, size=n_hours)

# 1. 0 дзвінків
empirical_0 = np.sum(calls == 0)
theory_prob_0 = stats.poisson.pmf(0, lam)

# 2. > 10 дзвінків
empirical_over_10 = np.sum(calls > 10)
theory_prob_over_10 = 1 - stats.poisson.cdf(10, lam)

print(f"Годин без жодного дзвінка (k=0):")
print(f"  Емпірично: {empirical_0} год ({empirical_0/n_hours:.1%}) | Теорія: {theory_prob_0:.1%}")

print(f"\nГодин із перевантаженням (k > 10):")
print(f"  Емпірично: {empirical_over_10} год ({empirical_over_10/n_hours:.1%}) | Теорія: {theory_prob_over_10:.1%}")
Рівень 3: Проєктні завдання
Розробіть діагностичну функцію analyze_distribution(data, feature_name="Feature"), яка формує інженерний звіт про характер змінної:
- Розраховує вибіркове середнє, медіану, дисперсію, коефіцієнт асиметрії (skewness) та ексцес (kurtosis);
- Виконує формальний критерій Шапіро-Вілка (
scipy.stats.shapiro); - Робить чіткий висновок про допустимість використання алгоритмів, що вимагають нормальності.
import numpy as np
from scipy import stats

def analyze_distribution(data, feature_name="Ознака"):
    data = np.asarray(data)
    mean = data.mean()
    median = np.median(data)
    std = data.std(ddof=1)
    skew = stats.skew(data)
    kurt = stats.kurtosis(data)

    # Тест Шапіро-Вілка (для вибірок до 5000 елементів)
    stat, p_value = stats.shapiro(data[:5000])
    is_normal = p_value > 0.05 and abs(skew) < 0.5

    print(f"=== Аналітичний звіт: {feature_name} ===")
    print(f"Розмір вибірки:       {len(data)}")
    print(f"Середнє / Медіана:    {mean:.2f} / {median:.2f}")
    print(f"Стандартне відхилення:{std:.2f}")
    print(f"Асиметрія (Skewness): {skew:+.3f} (0 = норма)")
    print(f"Ексцес (Kurtosis):    {kurt:+.3f} (0 = норма)")
    print(f"Shapiro-Wilk p-value: {p_value:.5f}")
    print(f"Висновок:             {'✅ Дані узгоджені з нормальною моделлю' if is_normal else '❌ Розподіл відхиляється від нормального'}\n")

rng = np.random.default_rng(seed=42)
analyze_distribution(rng.normal(50, 5, 1000), "Час рендерингу (мс)")
analyze_distribution(rng.exponential(scale=10, size=1000), "Час між сесіями (с)")
Напишіть скрипт, який емпірично демонструє механізм виникнення нормального розподілу із абсолютно ненормального джерела:
- Генерує матрицю розміром Завантаження... випадкових чисел з неперервного рівномірного розподілу Завантаження...;
- Рахує середнє арифметичне по кожному рядку (отримуючи 1000 вибіркових середніх);
- Будує гістограму отриманих середніх та накладає теоретичну щільність Завантаження....
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

rng = np.random.default_rng(seed=42)

a, b = 0, 10
n_samples = 30     # розмір групи доданків
n_experiments = 2000

# Теоретичні параметри початкового Uniform(a, b)
mu_orig = (a + b) / 2          # 5.0
var_orig = ((b - a)**2) / 12   # 100 / 12 = 8.333
std_means = np.sqrt(var_orig / n_samples)  # σ / √n ≈ 0.527

# Генерація вибірки
data = rng.uniform(a, b, size=(n_experiments, n_samples))
sample_means = data.mean(axis=1)

# Візуалізація
plt.figure(figsize=(10, 5))
plt.hist(sample_means, bins=35, density=True, alpha=0.6, color='steelblue', edgecolor='black', label='Емпіричні середні')

# Накладання теоретичної нормальної кривої ЦГТ
x = np.linspace(mu_orig - 4*std_means, mu_orig + 4*std_means, 500)
plt.plot(x, stats.norm.pdf(x, loc=mu_orig, scale=std_means), 'r-', linewidth=2.5, label=f'ЦГТ: N({mu_orig:.1f}, {std_means**2:.3f})')

plt.title(f'Демонстрація ЦГТ: Розподіл 2000 середніх значень з Uniform(0, 10) при n={n_samples}', fontweight='bold')
plt.xlabel('Вибіркове середнє')
plt.ylabel('Щільність')
plt.legend()
plt.grid(alpha=0.3)
plt.show()

print(f"Початкове теоретичне середнє: {mu_orig:.2f} | Емпіричне: {sample_means.mean():.2f}")
print(f"Теоретичне std середніх:      {std_means:.3f} | Емпіричне: {sample_means.std(ddof=1):.3f}")
Висновок: Попри те, що вихідний розподіл був абсолютно плоским, розподіл їхніх середніх при Завантаження... є невідмінним від ідеальної кривої Гаусса.
Інтернет-магазин проектує чергу обробки замовлень. Порівняйте дві математичні моделі потоку:
- Модель A (Пуассон): Завантаження... замовлень/год;
- Модель B (Нормальна апроксимація): Завантаження... (з Завантаження...).
Симулюйте 50 000 годин для обох моделей та оцініть:
- Чи здатна нормальна модель згенерувати некоректні від'ємні значення?
- Яка ймовірність перевантаження бекенду понад 35 замовлень/год?
- Чому для дискретних лічильників з малими значеннями Пуассон є єдино правильним вибором?
import numpy as np

rng = np.random.default_rng(seed=42)
n_hours = 50000

# Симуляція
poisson_orders = rng.poisson(lam=20, size=n_hours)
normal_orders = rng.normal(loc=20, scale=np.sqrt(20), size=n_hours)

# Аналіз
negatives_norm = np.sum(normal_orders < 0)
p_overload_poisson = np.mean(poisson_orders > 35)
p_overload_norm = np.mean(normal_orders > 35)

print(f"1. Від'ємні замовлення в нормальній моделі: {negatives_norm} (у Пуассона суворо 0)")
print(f"2. Ризик перевантаження (> 35 req/h):")
print(f"   Пуассон:           {p_overload_poisson:.4f} ({p_overload_poisson*100:.2f}%)")
print(f"   Нормальна модель:  {p_overload_norm:.4f} ({p_overload_norm*100:.2f}%)")
Інженерний висновок: Нормальний розподіл неперервний і симетричний, через що він недооцінює хвіст рідкісних екстремальних сплесків дискретних подій (у нашому випадку ризик перевищення 35 замовлень за Пуассоном у 4 рази вищий: 0.16% проти 0.04%). Крім того, при малих Завантаження... нормальна модель дає фізично неможливі від'ємні значення. Тому дискретні черги обов'язково розраховуються за Пуассоном.
Часті запитання студентів (FAQ)
Універсальність нормального розподілу безпосередньо випливає з Центральної граничної теореми (Central Limit Theorem, CLT).
У реальних інженерних та фізичних системах більшість вимірюваних величин є суперпозицією (сумою) десятків або сотень крихітних, слабко взаємопов'язаних незалежних випадкових збурень:
- Час рендерингу вебсторінки браузером складається з: латентності читання DOM-дерева, часу десеріалізації JSON, алокації буферів пам'яті V8, навантаження CPU фоновими вкладками та мікрозатримок відеокарти;
- Фізичний розмір деталі на заводському конвеєрі коливається через мікровібрації верстата, коливання напруги живлення, коливання температури цеху та ступінь зносу різця.
Навіть якщо кожне з цих окремих мікрозбурень розподілене абсолютно ненормально (наприклад, рівномірно чи біноміально), математична сума цих незалежних факторів неминуче збігається до гаусової форми. Єдині випадки, коли нормальний розподіл не формується — це коли один домінуючий фактор пригнічує решту (наприклад, глобальний мережевий збій каналу) або коли випадкові величини мультиплікативно множаться (що веде до логнормального розподілу) чи мають важкі хвости типу Парето (степеневі закони).
Часта помилка початківців — вважати, що вхідні ознаки (features) Завантаження... обов'язково мають підпорядковуватися нормальному розподілу. Насправді класична лінійна регресія (OLS) не накладає жорсткої вимоги нормальності на матрицю ознак Завантаження... (вони можуть бути бінарними, категоріальними чи скошеними).
Критична вимога стосується похибок моделі (залишків, residuals):
Чому це принципово:
- Довірчі інтервали та p-value: Усі t-статистики вагових коефіцієнтів, інтервали передбачення та F-тести адекватності моделі аналітично виведені на основі гаусового припущення. Якщо залишки сильно скошені, ці оцінки достовірності стають некоректними.
- Оптимальність методу найменших квадратів (OLS): Мінімізація середньоквадратичної похибки (MSE) математично еквівалентна методу максимальної правдоподіблості (Maximum Likelihood Estimation, MLE) лише тоді, коли шум є нормальним. Якщо розподіл залишків має важкі хвости або сильні викиди, MSE штрафує модель неадекватно, викривлюючи вагові коефіцієнти лінійної моделі.
У практичному аналізі даних (EDA) досвідчені розробники поєднують обидва підходи, оскільки статистичні тести мають підводні камені:
- Квантиль-квантильний графік (Q-Q plot):
- Візуально порівнює теоретичні квантилі ідеального нормального розподілу з емпіричними квантилями вашого датасету.
- Якщо точки лягають на діагональну лінію під кутом 45 градусів — розподіл близький до нормального. Якщо на краях спостерігаються характерні вигини (S-подібні відхилення), це наочно показує характер проблеми: важкі хвости (heavy tails) або наявність асиметрії (skewness).
- Тест Шапіро-Вілка (
scipy.stats.shapiro):- Формальний статистичний критерій: нульова гіпотеза Завантаження... стверджує, що вибірка належить до нормального розподілу.
- Пастка чутливості до розміру вибірки (Завантаження...): На малих вибірках (Завантаження...) тест має низьку статистичну потужність і часто пропускає помітні відхилення від норми (Завантаження...). Натомість на великих датасетах (Завантаження...) тест стає гіперчутливим: будь-яке мізерне, практично незначуще відхилення від ідеальної кривої призводить до Завантаження..., формально відкидаючи нормальність там, де для практичних цілей машинного навчання вона була абсолютно достатньою.
Інженерне правило: Для великих датасетів завжди надавайте перевагу візуалізації (Q-Q plot + оцінка коефіцієнтів асиметрії skew() та ексцесу kurtosis()), а формальні тести використовуйте як допоміжний сигнал на контрольованих вибірках помірного розміру.
Резюме: ключові takeaways
Розподіл = повна картина даних
Нормальний — король розподілів
Рівномірний — всі рівні
Пуассона — лічильник рідкісних подій
Центральна гранична теорема
Застосування в ML
- Припущення алгоритмів (лінійна регресія припускає нормальність залишків)
- Ініціалізація ваг нейромереж (нормальний або рівномірний)
- Виявлення аномалій (|z| > 3)
- Генерація синтетичних даних
Що далі?
Ви опанували три фундаментальні розподіли та зрозуміли, як випадкові величини поводяться в реальному світі. Тепер можете:
- Розпізнавати тип розподілу у даних
- Генерувати синтетичні дані
- Застосовувати правило 68-95-99.7
- Стандартизувати дані через Z-оцінку
Наступний крок — вивчити зв'язки між змінними: коваріацію та кореляцію.
Міри варіації (розсіювання)
Дисперсія, стандартне відхилення, розмах, міжквартильний розмах та коефіцієнт варіації — як виміряти «розкиданість» даних та зрозуміти їхню стабільність
Кореляція та взаємозв'язки
Коваріація, коефіцієнт кореляції Пірсона, матриці кореляції, візуалізація та критичне розуміння зв'язків між змінними