Кореляція та взаємозв'язки
Кореляція та взаємозв'язки
🎯 Мета підтеми
- Зрозуміти різницю між коваріацією та кореляцією
- Опанувати коефіцієнт кореляції Пірсона
- Навчитися інтерпретувати кореляційні матриці
- Візуалізувати зв'язки через scatter plots та heatmaps
- Усвідомити критичний принцип: кореляція ≠ причинність
🔑 Ключові терміни
- Коваріація (covariance) — міра спільної мінливості двох змінних
- Кореляція (correlation) — нормалізована коваріація, від −1 до +1
- Коефіцієнт Пірсона (Pearson's r) — найпоширеніша міра лінійного зв'язку
- Матриця кореляції (correlation matrix) — таблиця всіх парних кореляцій
- Кореляція ≠ причинність — золоте правило інтерпретації
Історія про зріст і вагу
Уявіть: ви збираєте дані про студентів вашого університету. Фіксуєте зріст (см) та вагу (кг) кожного з 100 студентів.
Інтуїтивно зрозуміло: вищі люди зазвичай важчі. Але як це описати математично? Як виміряти силу цього зв'язку?
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(seed=42)

# Генеруємо реалістичні дані зі зв'язком
height = rng.normal(170, 10, 100)  # Зріст: N(170, 10²)
weight = 0.8 * height + rng.normal(0, 5, 100) - 70  # Вага залежить від зросту + шум

# Візуалізація
plt.figure(figsize=(10, 6))
plt.scatter(height, weight, alpha=0.6, s=50, edgecolors='black', linewidths=0.5)
plt.xlabel('Зріст (см)', fontsize=12)
plt.ylabel('Вага (кг)', fontsize=12)
plt.title('Зв\'язок між зростом і вагою', fontweight='bold', fontsize=14)
plt.grid(alpha=0.3)
plt.show()

print("Статистика:")
print(f"  Зріст: μ = {height.mean():.1f} см, σ = {height.std():.1f} см")
print(f"  Вага:  μ = {weight.mean():.1f} кг, σ = {weight.std():.1f} кг")
print("\nВізуально помітно: точки утворюють хмару, що йде 'знизу-вліво до верху-вправо'")
print("Це сигнал ПОЗИТИВНОГО зв'язку: ↑зріст → ↑вага")
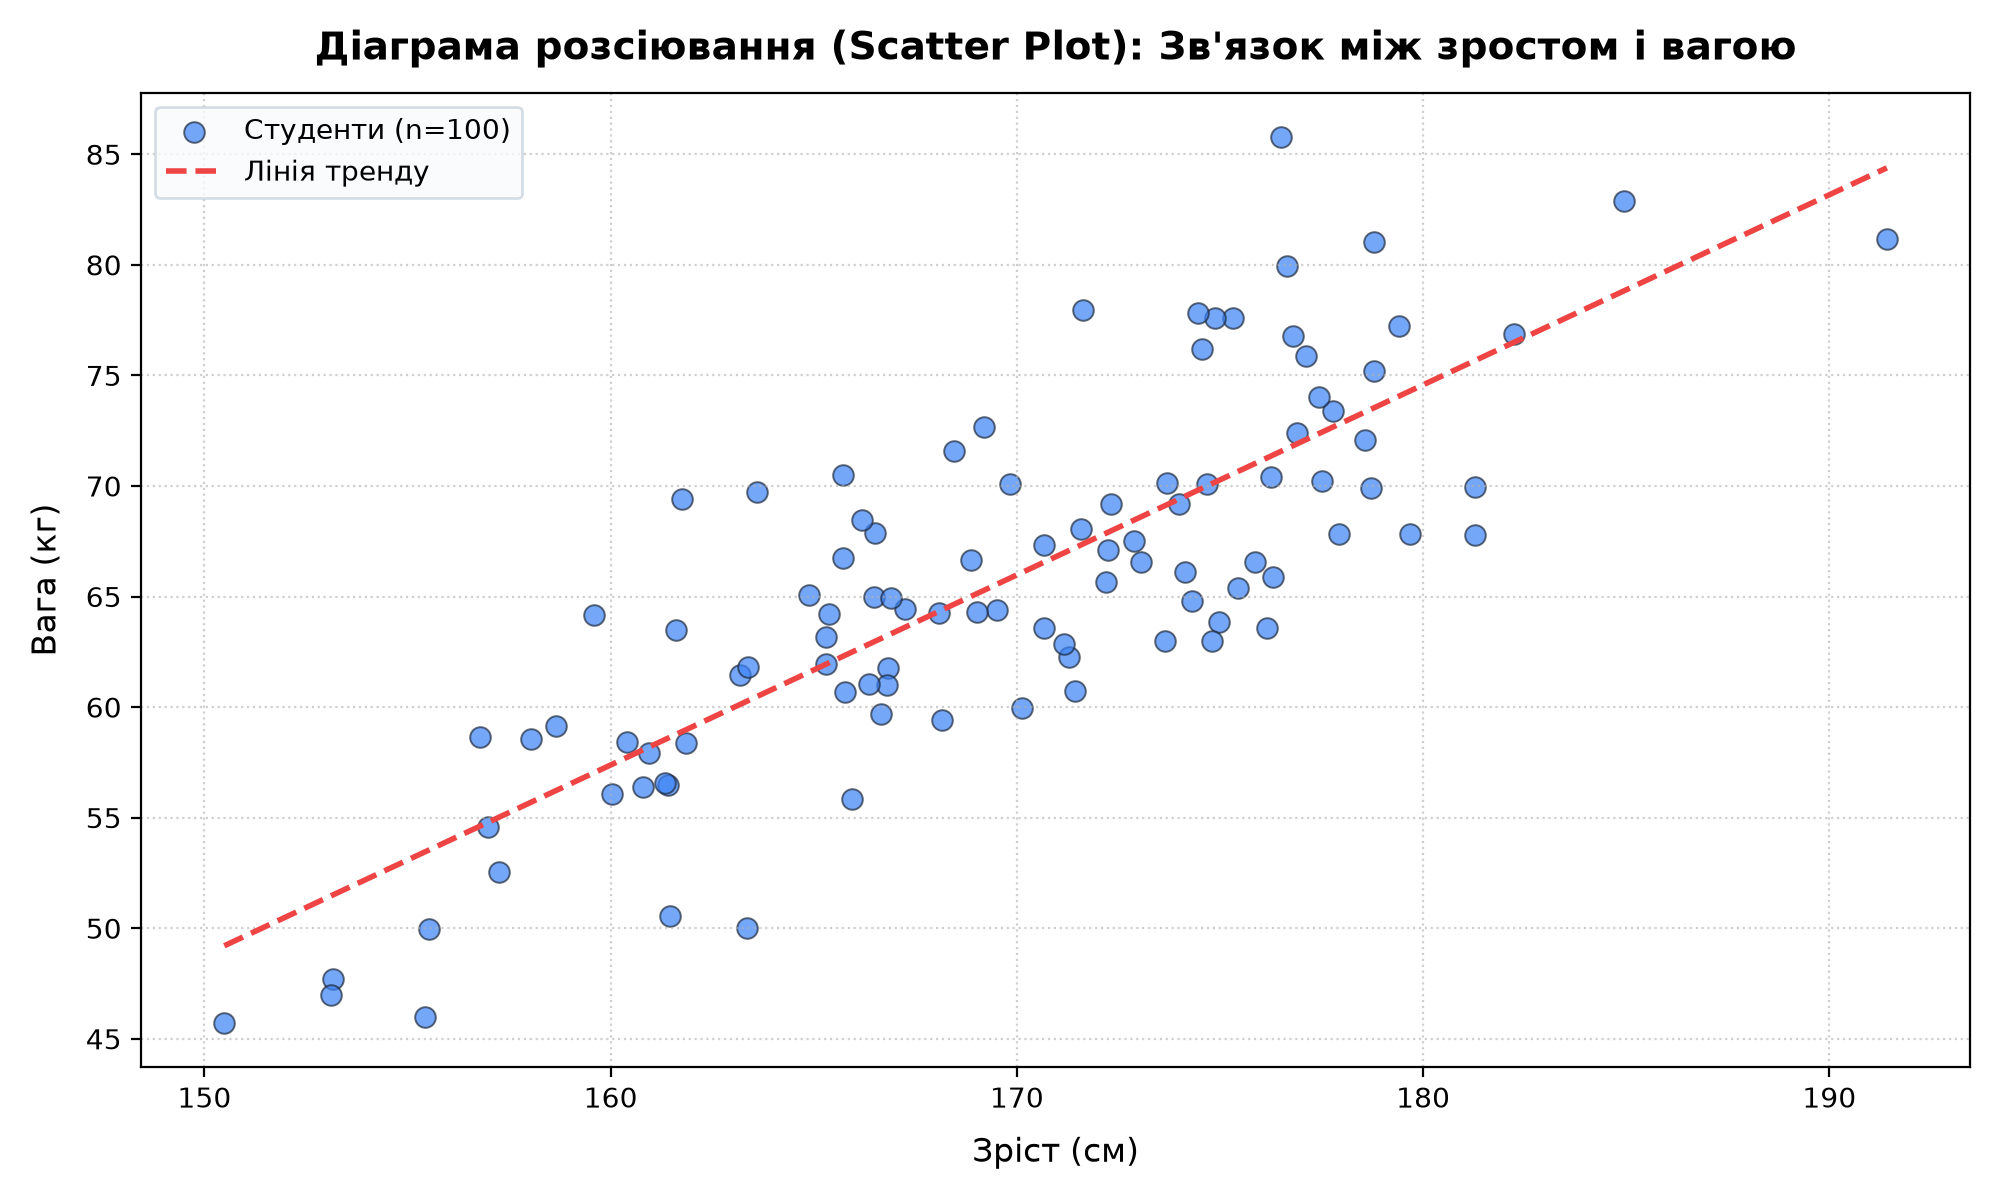
Статистика:
  Зріст: μ = 169.5 см, σ = 7.7 см
  Вага:  μ = 65.5 кг, σ = 8.2 кг

Візуально помітно: точки утворюють хмару, що йде 'знизу-вліво до верху-вправо'
Це сигнал ПОЗИТИВНОГО зв'язку: ↑зріст → ↑вага
Питання:
- Чи зріст завжди передбачає вагу? Ні — спостерігається природний розкид.
- Чи зв'язок є лінійним? Наближено так: через хмару точок можна провести узагальнюючу пряму лінію.
- Наскільки сильний цей зв'язок? Потрібна об'єктивна числова міра!
Для цього в статистиці використовують поняття коваріації та кореляції.
Аналогія: Кореляція — це як «сила магнітного поля» між двома змінними. Позитивна кореляція означає, що коли одна змінна зростає, інша притягується і зростає слідом (як північний і південний полюси). Негативна кореляція — коли зростання однієї виштовхує іншу донизу. Нульова кореляція — повна байдужість змінних одна до одної (магнітне поле відсутнє).
Коваріація (Covariance)
Коваріація (від латинського co- — «разом», «спільно» та variance — «мінливість», «дисперсія») — це фундаментальна міра спільної мінливості, яка показує, як дві випадкові величини змінюються разом. Вона визначає загальний напрямок сумісної лінійної тенденції двох числових ознак: чи зростають вони одночасно, чи змінюються в протилежних напрямках, чи взагалі не демонструють лінійної залежності.
Інтуїтивна аналогія:
Уявіть двомісний байдарочний човен або дитячу гойдалку-балансир:
- Позитивна коваріація: Обидва веслярі веслують в один бік — човен стрімко рухається вперед. Коли зусилля першого весляра перевищує його середній рівень, зусилля другого також перевищує середнє. Вони діють синхронно.
- Негативна коваріація: Дитяча гойдалка-балансир: коли одна дитина злітає вгору вище точки рівноваги, друга обов'язково опускається вниз. Їхні рухи узгоджені, але мають суворо протилежні напрямки.
- Нульова коваріація: Один весляр гребе, а другий пасажир поруч читає книгу або перевіряє пошту. Рівень зусиль першого ніяк не пов'язаний з тим, яку саме сторінку відкриває другий. Їхні відхилення від середнього повністю автономні.
Формула коваріації
Для генеральної сукупності (коли відомі абсолютно всі Завантаження... об'єктів або повна історія процесу):
Для реальної вибірки (з корекцією Бесселя Завантаження..., яка компенсує втрату одного ступеня вільності через використання вибіркових середніх Завантаження... та Завантаження...):
Анатомія формули: як вона працює під капотом?
Формула коваріації здається складною лише на перший погляд. Насправді вона виконує всього три послідовні математичні дії:
- Крок 1: Центрування (відхилення від «центру тяжіння»)
Для кожної точки обчислюються зміщення відносно вибіркових середніх:Завантаження...
Геометрично ми просто переносимо початок координат Завантаження... у центр мас нашої хмари точок — координату Завантаження.... Тепер важливі не абсолютні кілограми чи метри, а напрямок відхилення від типового середнього значення. - Крок 2: Множення відхилень та правило знаків
Для кожного спостереження ми перемножуємо отримані зміщення: Завантаження.... У цьому множенні криється вся магія знаку коваріації:- Якщо обидві змінні більші за середнє (Завантаження... і Завантаження...), маємо Завантаження....
- Якщо обидві змінні менші за середнє (Завантаження... і Завантаження...), маємо Завантаження.... Зверніть увагу: якщо обидві величини одночасно впали нижче за свої середні, це також підтверджує узгодженість їхньої поведінки, тому внесок залишається строго додатним!
- Якщо ж одна змінна виросла понад норму, а інша впала нижче середнього (Завантаження... або Завантаження...), добуток стає від'ємним Завантаження....
- Крок 3: Сумування та усереднення «голосів»
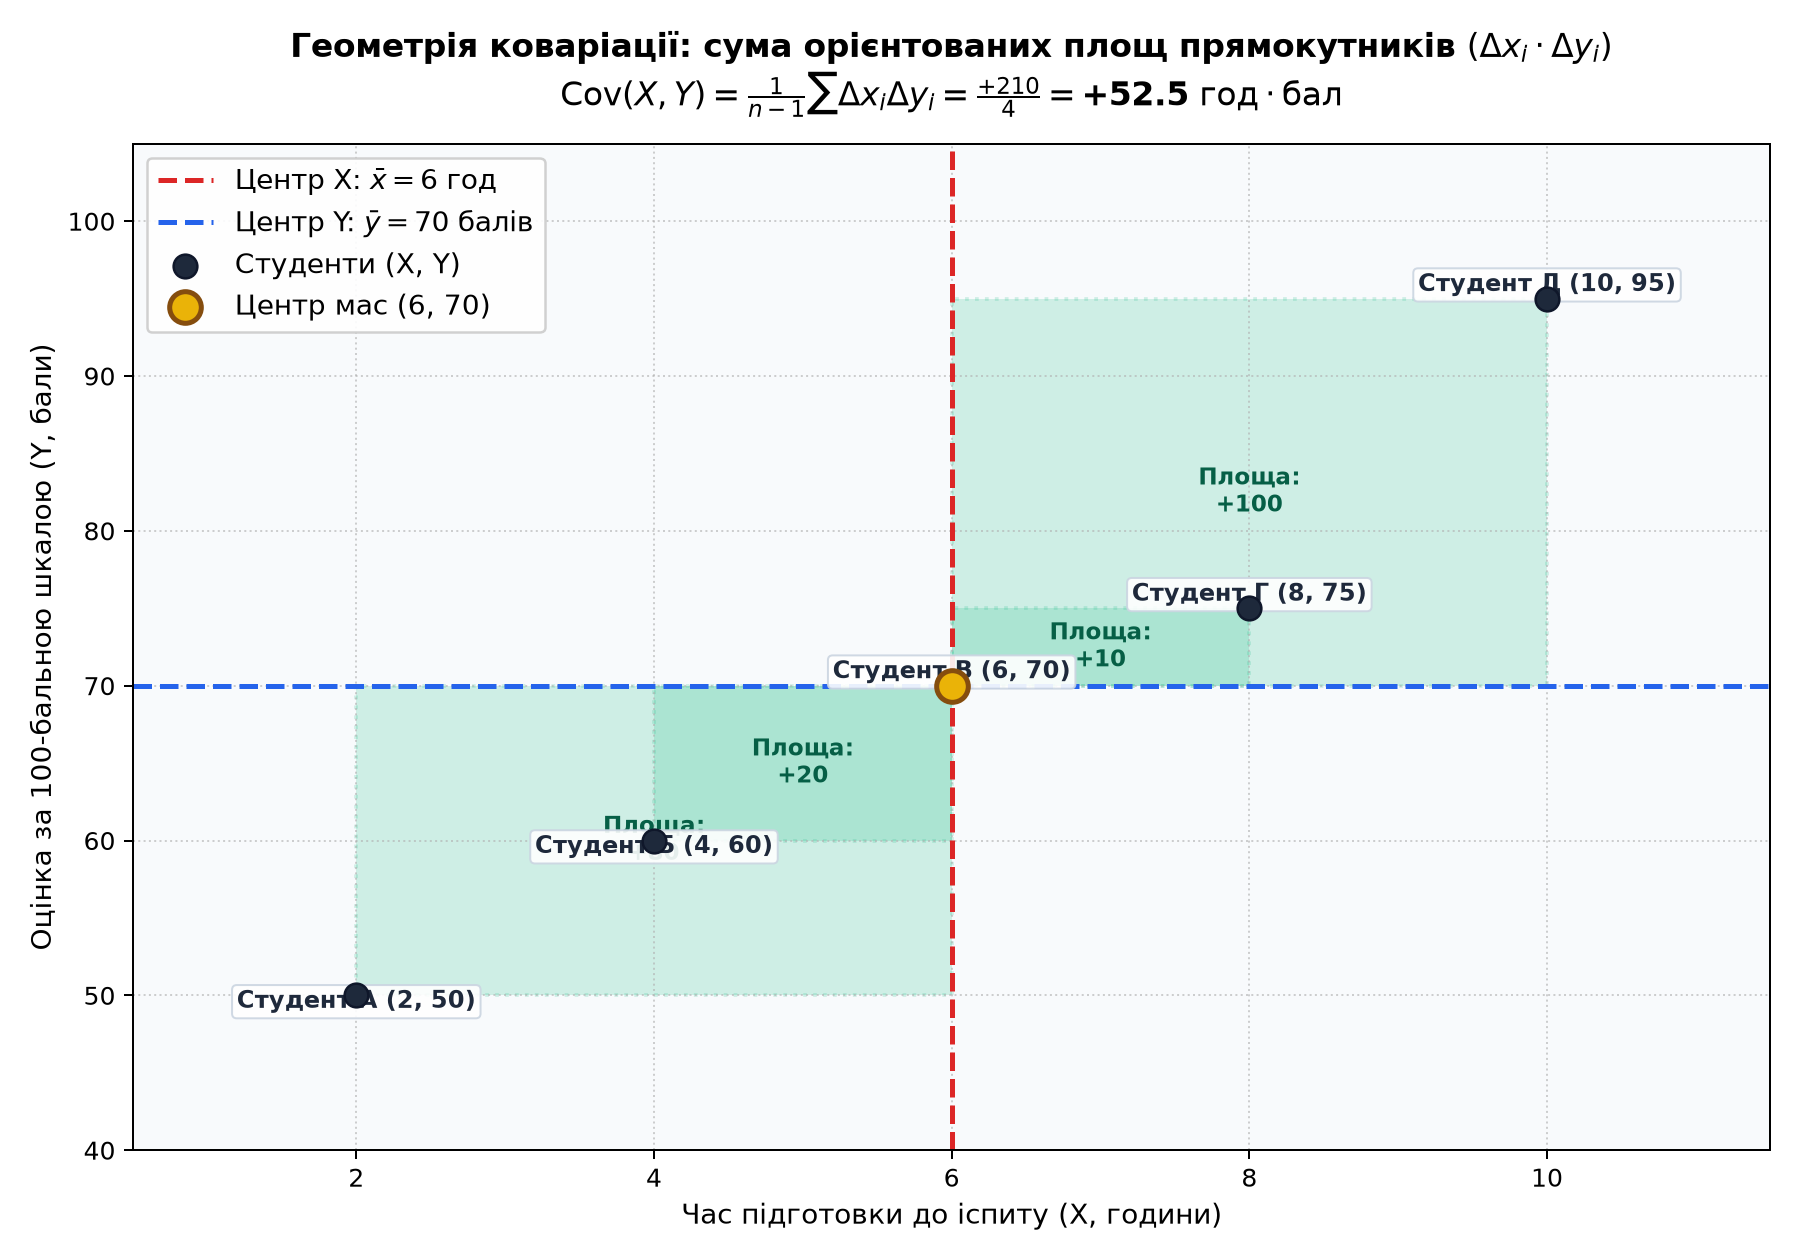
Ми додаємо всі отримані добутки. Кожна точка є «виборцем»: вона голосує або за додатний зв'язок (квадранти I та III), або за від'ємний (квадранти II та IV). Якщо узгоджених точок більше і вони лежать далі від центру, сумарна сума додатна (Завантаження...). Якщо точки взаємно компенсують одна одну — сума прямує до нуля (Завантаження...).
Практичний сценарій: покроковий розрахунок коваріації вручну
Щоб наочно побачити, як суха математична формула працює на практиці, розглянемо простий та життєвий сценарій: дослідження зв'язку між кількістю годин самостійної підготовки до іспиту (Завантаження..., години) та фінальною оцінкою за 100-бальною шкалою (Завантаження..., бали) для 5 студентів групи:
- Студент А: Завантаження... год, Завантаження... балів
- Студент Б: Завантаження... год, Завантаження... балів
- Студент В: Завантаження... год, Завантаження... балів
- Студент Г: Завантаження... год, Завантаження... балів
- Студент Д: Завантаження... год, Завантаження... балів
Крок 1. Обчислення вибіркових середніх (знаходження центру тяжіння)
Спочатку знаходимо середньоарифметичні значення Завантаження... та Завантаження...:
Отже, наш «центр мас» вибірки розташований у точці Завантаження....
Крок 2. Центрування відхилень та перемноження «голосів»
Складемо розрахункову таблицю, щоб побачити внесок кожного студента у спільну тенденцію:
| Студент | Завантаження... (год) | Завантаження... (бали) | Центроване Завантаження... | Центроване Завантаження... | Добуток Завантаження... | Квадрант | Внесок у спільну тенденцію |
|---|---|---|---|---|---|---|---|
| Студент А | 2 | 50 | Завантаження... | Завантаження... | Завантаження... | III | Завантаження... — обидва показники нижче середнього (синхронний спад) |
| Студент Б | 4 | 60 | Завантаження... | Завантаження... | Завантаження... | III | Завантаження... — узгоджений помірний спад |
| Студент В | 6 | 70 | Завантаження... | Завантаження... | Завантаження... | Центр | Точка точно в центрі вибірки (нейтральний внесок) |
| Студент Г | 8 | 75 | Завантаження... | Завантаження... | Завантаження... | I | Завантаження... — обидва показники вище середнього |
| Студент Д | 10 | 95 | Завантаження... | Завантаження... | Завантаження... | I | Завантаження... — максимальний позитивний ривок |
| Сума (Завантаження...) | 30 | 350 | 0 | 0 | +210 | — | Сумарний узгоджений імпульс |
Чому сума відхилень дорівнює нулю?
Зверніть увагу: Завантаження... та Завантаження.... Це фундаментальна перевірочна властивість середнього арифметичного: сума відхилень від власного центру тяжіння завжди суворо дорівнює нулю.
Крок 3. Обчислення вибіркової коваріації
Застосовуємо вибіркову формулу з поправкою Бесселя (Завантаження...):
Що розповідає нам це число? (Три інженерні висновки)
- Знак плюс (Завантаження...):
Зв'язок однозначно прямо пропорційний (позитивний). Студенти, які витрачають більше годин на підготовку, закономірно демонструють вищі результати на тестуванні. - Пастка одиниць вимірювання («людино-годино-бали»):
Числове значення коваріації вимірюється в комбінованих одиницях: година Завантаження... бал. Через це значення Завантаження... неможливо порівняти з іншими дослідженнями: це сильний зв'язок чи слабкий? Якщо ми переведемо час з годин у хвилини (Завантаження...), коваріація миттєво зросте в 60 разів:Завантаження...Хоча реальна поведінка студентів і ступінь їхньої старанності не змінилися ані на краплю! - Місток до кореляції:
Саме для подолання проблеми масштабу та розмірностей Карл Пірсон запропонував нормалізувати коваріацію — розділити її на добуток стандартних відхилень обох ознак. Це перетворює «незручні» Завантаження... на елегантне безрозмірне число від Завантаження... до Завантаження....
# Перевірка результату в Python / NumPy:
import numpy as np

hours = np.array([2, 4, 6, 8, 10])
scores = np.array([50, 60, 70, 75, 95])

# np.cov повертає симетричну коваріаційну матрицю 2x2:
# [[Var(X),     Cov(X, Y)],
#  [Cov(Y, X),  Var(Y)]]
cov_matrix = np.cov(hours, scores)
print(f"Вибіркова коваріація: {cov_matrix[0, 1]:.2f}")  # 52.50
Дисперсія як окремий випадок коваріації
Що станеться, якщо ми підставимо у вибіркову формулу коваріації змінну Завантаження... замість Завантаження...? Тобто розрахуємо коваріацію ознаки із самою собою:
Це глибокий концептуальний зв'язок: дисперсія — це просто коваріація змінної із самою собою. Дисперсія показує, як одновимірна величина розсіюється навколо власного середнього, тоді як коваріація узагальнює цей принцип на спільне сумісне розсіювання двох різних вимірів.
Інтерпретація знаку коваріації:
| Значення Завантаження... | Інтерпретація зв'язку | Геометрична поведінка хмари точок |
|---|---|---|
| Завантаження... | Прямий (позитивний): коли Завантаження... зростає, Завантаження... також має тенденцію зростати | Точки витягуються вздовж висхідної прямої (квадранти I та III) |
| Завантаження... | Обернений (негативний): коли Завантаження... зростає, Завантаження... прямує вниз | Точки витягуються вздовж низхідної прямої (квадранти II та IV) |
| Завантаження... | Відсутній лінійний зв'язок: зміна Завантаження... не дає інформації про напрямок зміни Завантаження... | Точки рівномірно заповнюють площину без вираженого нахилу |
Де застосовується коваріація на практиці?
Коваріація — це не просто теоретична проміжна формула. Вона є активним обчислювальним рушієм у багатьох сферах IT, науки про дані та інженерії:
1. Мінімізація ризику портфеля (Теорія Марковіца)
У фінансовому менеджменті інвестор намагається отримати максимальний дохід за мінімального ризику. Ризик портфеля з двох активів Завантаження... та Завантаження... із частками Завантаження... і Завантаження... визначається його дисперсією:
Завантаження...Якщо підібрати активи з від'ємною коваріацією (Завантаження...) — наприклад, акції золотодобувної компанії (дорожчають під час кризи) та акції авіаперевізника (дешевшають через кризу або зростання цін на пальне), — доданок Завантаження... стає від'ємним. У результаті загальний ризик портфеля стає меншим, ніж ризик будь-якого з цих активів окремо. Цей ефект є математичним фундаментом диверсифікації.
2. Злиття сенсорів та автопілоти (Фільтр Калмана)
Безпілотні автомобілі та дрони одночасно зчитують координати з GPS, гіроскопа (IMU) та одометра коліс. Кожен датчик має випадкові похибки: GPS втрачає супутники між хмарочосами, а колеса буксують на мокрому асфальті.
Фільтр Калмана використовує матрицю коваріації похибок оцінки Завантаження.... Її позадіагональні елементи показують спільну невизначеність: «наскільки похибка у визначенні поточної швидкості впливає на похибку визначення положення у просторі?». Завдяки коваріації, щойно система отримує свіже вимірювання швидкості від коліс, вона миттєво коригує оцінку координат GPS, усуваючи накопичений дрейф траєкторії.
3. Стиснення даних та ML (Метод головних компонент — PCA)
У машинному навчанні датасети часто містять сотні або тисячі ознак. Якщо дві ознаки мають сильну коваріацію (наприклад, площа квартири та кількість кімнат, або яскравість двох сусідніх пікселів медичного томографа), вони несуть майже однакову інформацію (проблема мультиколінеарності).
Алгоритм PCA бере повну коваріаційну матрицю ознак і знаходить її власні вектори. Це дає змогу повернути координатні осі вздовж напрямків найбільшої спільної мінливості та замінити 100 початкових взаємозалежних ознак на 5 нових некорельованих компонент, зберігши понад 95% корисної інформації датасету.
4. Моніторинг систем та SRE (DevOps Telemetry)
Інженери надійності сайтів (SRE) відстежують поведінку мікросервісів за допомогою коваріації між вхідним навантаженням (RPS — запити за секунду) та затримкою обробки (Latency p95/p99).
Доки сервер має достатньо ресурсів, зростання RPS не призводить до деградації сервісу, і коваріація між ними тримається близько нуля. Проте, якщо база даних вичерпує пул з'єднань або процесор потрапляє в throttling, коваріація між навантаженням та затримкою різко підскакує вгору. Системи моніторингу (наприклад, Prometheus або Datadog) використовують зростання коваріації як завчасний індикатор виникнення «пляшкового горла» (bottleneck), що дає змогу автоматично масштабувати сервіс до того, як клієнти почнуть отримувати помилки таймауту HTTP 504.
Обчислення коваріації в NumPy
import numpy as np

# Дані: температура (°C) та продажі морозива (шт)
temperature = np.array([15, 18, 22, 25, 28, 30, 32, 35])
ice_cream_sales = np.array([50, 65, 80, 95, 110, 125, 135, 150])

# Спосіб 1: Вручну за математичною формулою
temp_mean = temperature.mean()
sales_mean = ice_cream_sales.mean()

cov_manual = np.sum((temperature - temp_mean) * (ice_cream_sales - sales_mean)) / (len(temperature) - 1)

# Спосіб 2: Через матрицю коваріацій NumPy
cov_matrix = np.cov(temperature, ice_cream_sales)  # Матриця коваріацій 2×2
cov_numpy = cov_matrix[0, 1]  # Позадіагональний елемент [0,1] або [1,0]

print("Результати:")
print(f"  Коваріація (вручну):  {cov_manual:.2f}")
print(f"  Коваріація (NumPy):   {cov_numpy:.2f}")
print(f"\nІнтерпретація:")
print(f"  Cov > 0 → позитивний зв'язок")
print(f"  Коли температура зростає, продажі морозива теж зростають")
print(f"\nПроблема масштабу:")
print(f"  Чи {cov_numpy:.2f} — це багато? Без контексту дисперсій відповісти неможливо!")

# Візуалізація: розділення на квадранти відхилень навколо центру мас
import matplotlib.pyplot as plt

plt.figure(figsize=(9, 6))
plt.axvline(temp_mean, color='#dc2626', linestyle='--', label=f'$\\bar{{x}} = {temp_mean:.1f}^\\circ\\mathrm{{C}}$')
plt.axhline(sales_mean, color='#2563eb', linestyle='--', label=f'$\\bar{{y}} = {sales_mean:.1f}$ шт')
plt.scatter(temperature, ice_cream_sales, s=80, color='#0284c7', edgecolors='#0369a1', zorder=5, label='Дні спостережень')
plt.scatter([temp_mean], [sales_mean], s=130, color='#eab308', edgecolors='#ca8a04', zorder=6, label='Центр мас')
plt.title(f'Обчислення коваріації: Температура vs Продажі морозива (Cov = +{cov_numpy:.2f})', fontweight='bold')
plt.xlabel('Температура повітря (X, °C)')
plt.ylabel('Продажі морозива (Y, шт)')
plt.grid(True, linestyle=':', alpha=0.5)
plt.legend()
plt.tight_layout()
plt.show()
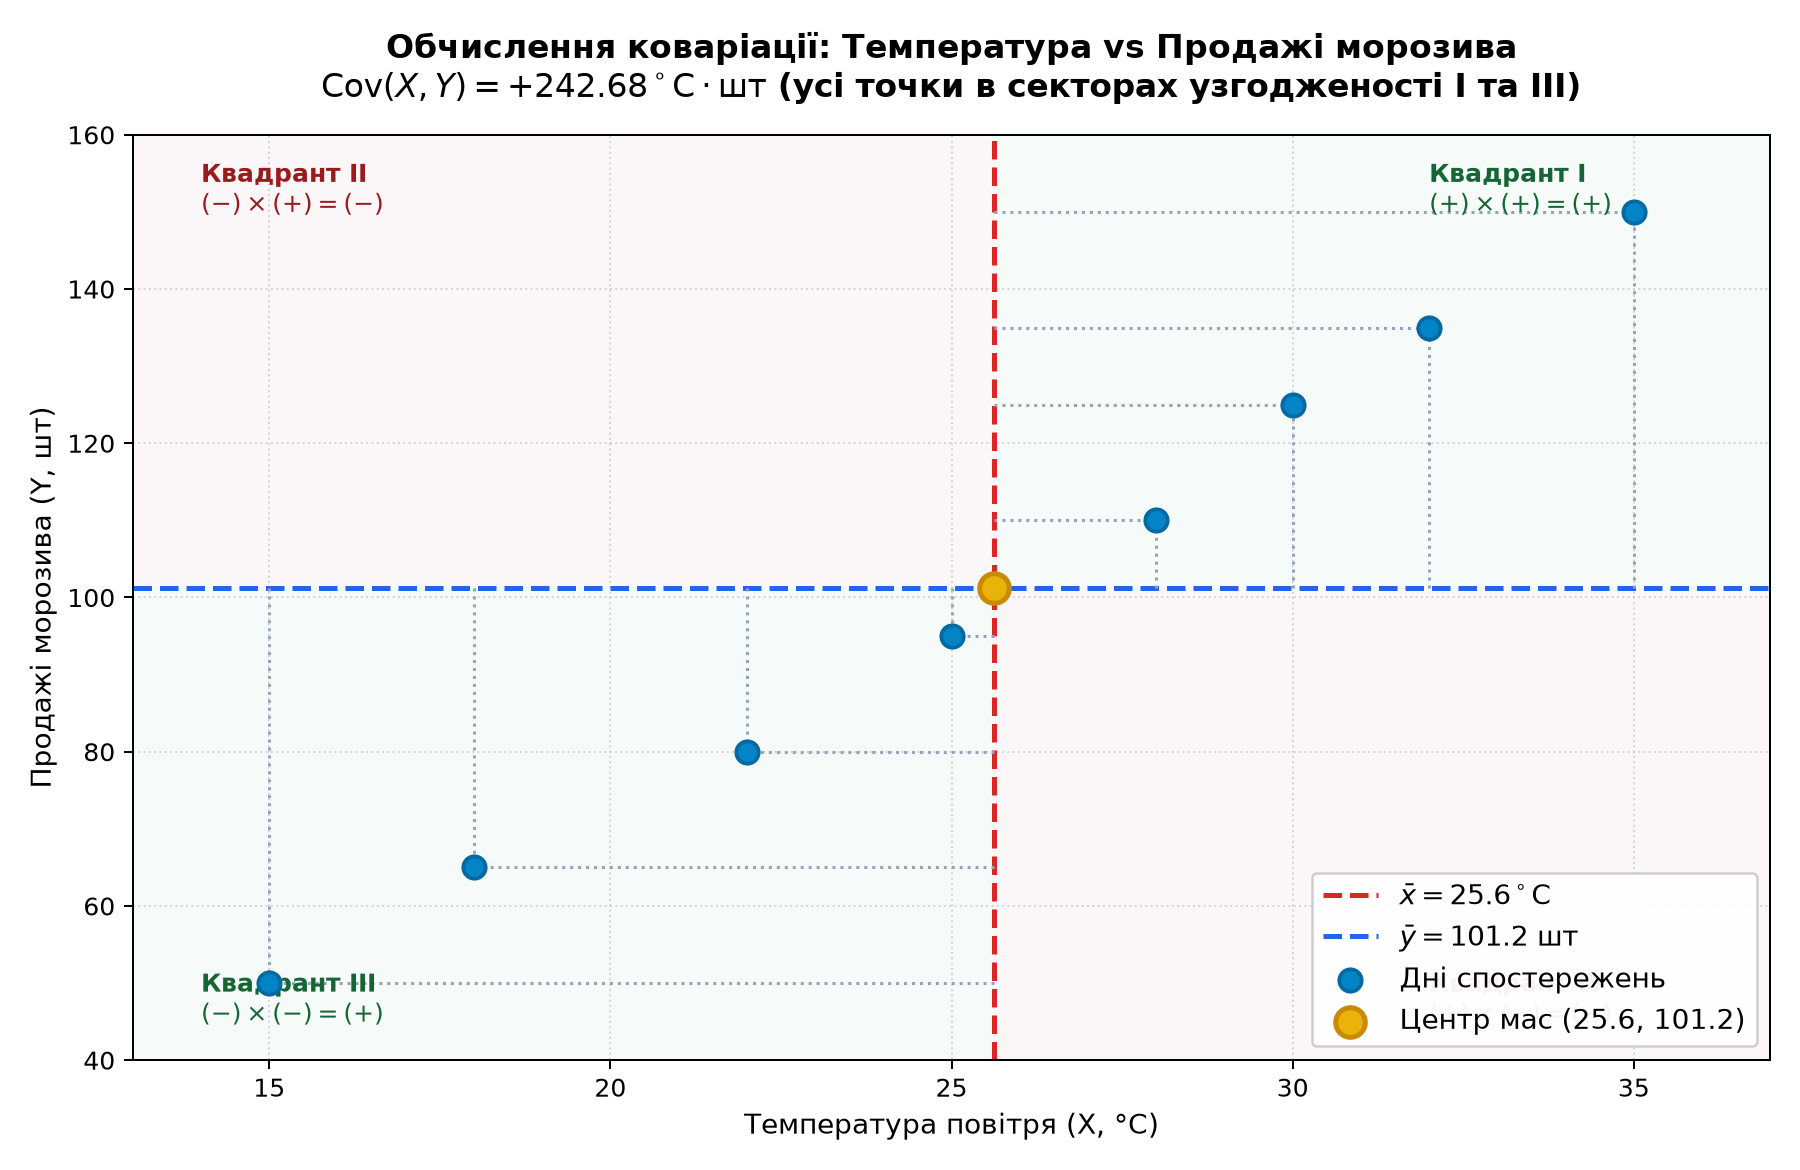
Результати:
  Коваріація (вручну):  242.68
  Коваріація (NumPy):   242.68

Інтерпретація:
  Cov > 0 → позитивний зв'язок
  Коли температура зростає, продажі морозива теж зростають

Проблема масштабу:
  Чи 242.68 — це багато? Без контексту дисперсій відповісти неможливо!
- Завантаження... — коваріація випадкової величини зі самою собою дорівнює її дисперсії.
- Завантаження... — операція коваріації строго симетрична.
- Завантаження... — білінійність: адитивні константи зникають, а мультиплікативні коефіцієнти виносяться наперед.
- Якщо змінні Завантаження... та Завантаження... незалежні, то Завантаження.... Увага: зворотне твердження не завжди істинне (нульова коваріація гарантує лише відсутність лінійного зв'язку, але не виключає нелінійну залежність).
Кореляція Пірсона (Pearson Correlation Coefficient)
Коефіцієнт лінійної кореляції Пірсона (Завантаження... або Завантаження...) — це нормалізована коваріація, значення якої завжди суворо обмежені інтервалом Завантаження....
Формула кореляції
В розгорнутому алгебраїчному вигляді для вибіркових спостережень:
Анатомія математичної формули кореляції Пірсона
Щоб глибинно зрозуміти, чому коефіцієнт Пірсона працює бездоганно і гарантовано потрапляє в діапазон Завантаження..., розберемо його математичну структуру на складові блоки:
- Центрування даних (Завантаження... та Завантаження...):
- Кожне окреме спостереження перетворюється на вектор відхилення від свого середнього. Це робить показник інваріантним до зсуву координат: якщо до кожного зросту або ваги додати константу Завантаження..., кореляція абсолютно не зміниться.
- Чисельник — узгодженість напрямку (спільна варіація):
- Якщо об'єкт має і Завантаження..., і Завантаження... вище за середнє: Завантаження... (додатний внесок).
- Якщо об'єкт має обидва параметри нижче за середнє: Завантаження... (підсилює позитивний зв'язок!).
- Якщо одне вище, а інше нижче: Завантаження... (штовхає кореляцію у від'ємну сторону).
- Сума всіх цих добутків у чисельнику є ненормалізованою коваріацією Завантаження....
- Знаменник — масштабний нормалізатор (евклідові норми):
- Добуток квадратних коренів — це добуток довжин (евклідових Завантаження...-норм) центрованих векторів Завантаження... та Завантаження....
- З погляду лінійної алгебри формула Завантаження... є косинусом кута Завантаження... між двома центрованими векторами в багатовимірному просторі Завантаження...:
Завантаження...
- За нерівністю Коші-Буняковського (Завантаження...), косинус завжди належить діапазону Завантаження.... Якщо вектори паралельні й однаково спрямовані (Завантаження...), Завантаження.... Якщо вектори ортогональні (Завантаження...), лінійний зв'язок відсутній (Завантаження...). Якщо вони спрямовані в протилежні боки (Завантаження...), Завантаження....
Інтерпретація значень r
| Значення r | Інтерпретація | Візуальна картина |
|---|---|---|
| r = +1 | Ідеальний позитивний лінійний зв'язок | Точки лежать на прямій ↗ |
| 0.7 < r < 1 | Сильний позитивний зв'язок | Чітка висхідна хмара |
| 0.3 < r < 0.7 | Помірний позитивний зв'язок | Розмита висхідна хмара |
| 0 < r < 0.3 | Слабкий позитивний зв'язок | Майже хаотична хмара |
| r ≈ 0 | Немає лінійного зв'язку | Хаотична хмара (коло, U-форма) |
| -0.3 < r < 0 | Слабкий негативний зв'язок | Майже хаотична хмара |
| -0.7 < r < -0.3 | Помірний негативний зв'язок | Розмита спадна хмара |
| -1 < r < -0.7 | Сильний негативний зв'язок | Чітка спадна хмара |
| r = −1 | Ідеальний негативний лінійний зв'язок | Точки лежать на прямій ↘ |
- Завантаження... — слабка кореляція
- Завантаження... — помірна кореляція
- Завантаження... — сильна (висока) кореляція
Практичні приклади кореляції: від IT-інфраструктури до повсякденності
Щоб абстрактні числові значення Завантаження... набули відчутного інженерного сенсу, проаналізуймо взаємозв'язки змінних у трьох ключових практичних сферах:
У сфері системного адміністрування, хмарних обчислень та бекенд-розробки кореляційний аналіз є щоденним інструментом моніторингу метрик і виявлення вузьких місць:
- Сильна позитивна кореляція (Завантаження...):
- Змінна Завантаження...: Кількість одночасних активних HTTP-запитів до бекенд-сервісу (Requests Per Second, RPS).
- Змінна Завантаження...: Споживання оперативної пам'яті (RAM) процесом додатку або пулом воркерів.
- Суть зв'язку: Кожен новий паралельний клієнт потребує створення сокетів, виділення мережевих буферів, десеріалізації JSON та розміщення об'єктів сесії в купі (heap memory). Зі зростанням потоку запитів споживання пам'яті майже монотонно зростає.
- Сильна негативна кореляція (Завантаження...):
- Змінна Завантаження...: Відсоток попадань у швидкий кеш Redis / Memcached (Cache Hit Ratio).
- Змінна Завантаження...: Середній час відповіді бекенду клієнту (Response Latency / TTFB).
- Суть зв'язку: Чим ефективніше працює кеш (ближче до 100%), тим рідше запити доходять до важкої реляційної бази даних. Відповідь віддається з RAM за частки мілісекунди, що радикально скорочує сумарну затримку.
- Нульова автономна кореляція (Завантаження...):
- Змінна Завантаження...: Довжина нікнейма розробника на GitHub або кількість символів у назві git-гілки.
- Змінна Завантаження...: Частота виникнення критичних помилок (Production Bug Rate) чи швидкість закриття Pull Request'ів.
- Суть зв'язку: Фізичні атрибути текстових імен жодним чином не визначають архітектурну зрілість коду та якість написання тестів.
Життєві приклади, з якими щодня стикається кожен студент і розробник-початківець:
- Помітна позитивна кореляція (Завантаження...):
- Змінна Завантаження...: Кількість годин, присвячених практичному написанню коду, розбору помилок та реалізації навчальних проєктів.
- Змінна Завантаження...: Підсумковий бал за екзаменаційний проєкт або успішність проходження технічного скринінгу на позицію Trainee/Junior.
- Суть зв'язку: Практична моторика, уміння читати стек-трейси та самостійний дебагінг прямо трансформуються у впевненість під час лайвкодингу та глибину відповідей.
- Помітна негативна кореляція (Завантаження...):
- Змінна Завантаження...: Кількість годин нічного безперервного скролінгу соцмереж чи комп'ютерних ігор перед дедлайном.
- Змінна Завантаження...: Швидкість концентрації, когнітивна витривалість та уважність наступного ранку.
- Суть зв'язку: Дефіцит глибоких фаз сну безпосередньо пригнічує когнітивні функції, призводячи до прикрих неуважних помилок (наприклад, пропущених точок з комою чи неправильних назв змінних).
- Нульова кореляція (Завантаження...):
- Змінна Завантаження...: Розмір взуття студента або його зріст.
- Змінна Завантаження...: Оцінка з курсу дискретної математики, теорії ймовірностей чи лінійної алгебри.
- Суть зв'язку: Антропометричні показники тіла не мають жодної залежності з розвитком аналітичного та математичного апарату мислення.
У комерційній аналітиці даних кореляція дає змогу виявляти точки втрати прибутку та фактори залучення клієнтів:
- Сильна позитивна кореляція (Завантаження...):
- Змінна Завантаження...: Бюджет на таргетовану та контекстну рекламу (Ad Spend).
- Змінна Завантаження...: Щоденна кількість унікальних відвідувачів інтернет-магазину (Unique Visitors / DAU).
- Суть зв'язку: Збільшення кількості показів якісно налаштованої реклами прямо пропорційно розширює верхню ланку маркетингової воронки.
- Помірна негативна кореляція (Завантаження...):
- Змінна Завантаження...: Вартість обов'язкової платної доставки або кількість полів у формі оформлення замовлення.
- Змінна Завантаження...: Відсоток успішного оформлення покупок (Checkout Conversion Rate).
- Суть зв'язку: Неочікувані додаткові збори або надмірна бюрократизація чекауту викликають психологічний опір і призводять до «покинутих кошиків» (Cart Abandonment).
- Хрестоматійний приклад хибної кореляції (Spurious Correlation, Завантаження...):
- Змінна Завантаження...: Обсяг продажів морозива в місті.
- Змінна Завантаження...: Кількість випадків сонячних опіків на пляжах міста.
- Увага, пастка: Математично Завантаження..., проте купівля морозива жодним чином не обпікає шкіру! Обидва показники одночасно стимулюються третім прихованим фактором (конфаундером) — спекотною сонячною літньою погодою.
Обчислення кореляції в NumPy та SciPy
import numpy as np
from scipy import stats

# Дані: температура та продажі морозива
temperature = np.array([15, 18, 22, 25, 28, 30, 32, 35])
ice_cream_sales = np.array([50, 65, 80, 95, 110, 125, 135, 150])

# Спосіб 1: Вручну (за формулою через коваріацію та стандарти)
cov = np.cov(temperature, ice_cream_sales)[0, 1]
std_temp = temperature.std(ddof=1)
std_sales = ice_cream_sales.std(ddof=1)
r_manual = cov / (std_temp * std_sales)

# Спосіб 2: np.corrcoef() — повертає матрицю кореляцій 2×2
corr_matrix = np.corrcoef(temperature, ice_cream_sales)
r_numpy = corr_matrix[0, 1]

# Спосіб 3: scipy.stats.pearsonr() — повертає r та p-value для перевірки гіпотези
r_scipy, p_value = stats.pearsonr(temperature, ice_cream_sales)

print("Результати обчислення кореляції:")
print(f"  Вручну:        r = {r_manual:.4f}")
print(f"  np.corrcoef(): r = {r_numpy:.4f}")
print(f"  scipy:         r = {r_scipy:.4f}, p-value = {p_value:.6f}")
print(f"\nІнтерпретація:")
print(f"  r = {r_scipy:.3f} → майже ідеальний позитивний лінійний зв'язок")
print(f"  p-value < 0.05 → зв'язок статистично значущий (нульова гіпотеза про r=0 відкидається)")

# Візуалізація: порівняння сирих одиниць та стандартизованого Z-простору
import matplotlib.pyplot as plt

slope, intercept, r_val, p_val, _ = stats.linregress(temperature, ice_cream_sales)
z_temp = (temperature - temperature.mean()) / std_temp
z_sales = (ice_cream_sales - ice_cream_sales.mean()) / std_sales

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 5.5))
ax1.scatter(temperature, ice_cream_sales, color='#0284c7', s=60, label='Дані')
x_grid = np.linspace(14, 36, 100)
ax1.plot(x_grid, slope * x_grid + intercept, color='#ea580c', lw=2, label=f'Тренд ($r = {r_val:.3f}$)')
ax1.set_title('Вихідні одиниці (Температура ↔ Продажі)', fontweight='bold')
ax1.set_xlabel('Температура (°C)')
ax1.set_ylabel('Продажі (шт)')
ax1.grid(True, linestyle=':', alpha=0.5)
ax1.legend()

ax2.scatter(z_temp, z_sales, color='#16a34a', s=60, label='Z-точки')
z_grid = np.linspace(-1.8, 1.8, 100)
ax2.plot(z_grid, r_val * z_grid, color='#dc2626', lw=2, label=f'Нахил = r = {r_val:.3f}')
ax2.axvline(0, color='#94a3b8', linestyle='--')
ax2.axhline(0, color='#94a3b8', linestyle='--')
ax2.set_title('Стандартизований Z-простір: кут нахилу = r', fontweight='bold')
ax2.set_xlabel('Z-оцінка температури')
ax2.set_ylabel('Z-оцінка продажів')
ax2.grid(True, linestyle=':', alpha=0.5)
ax2.legend()
plt.tight_layout()
plt.show()
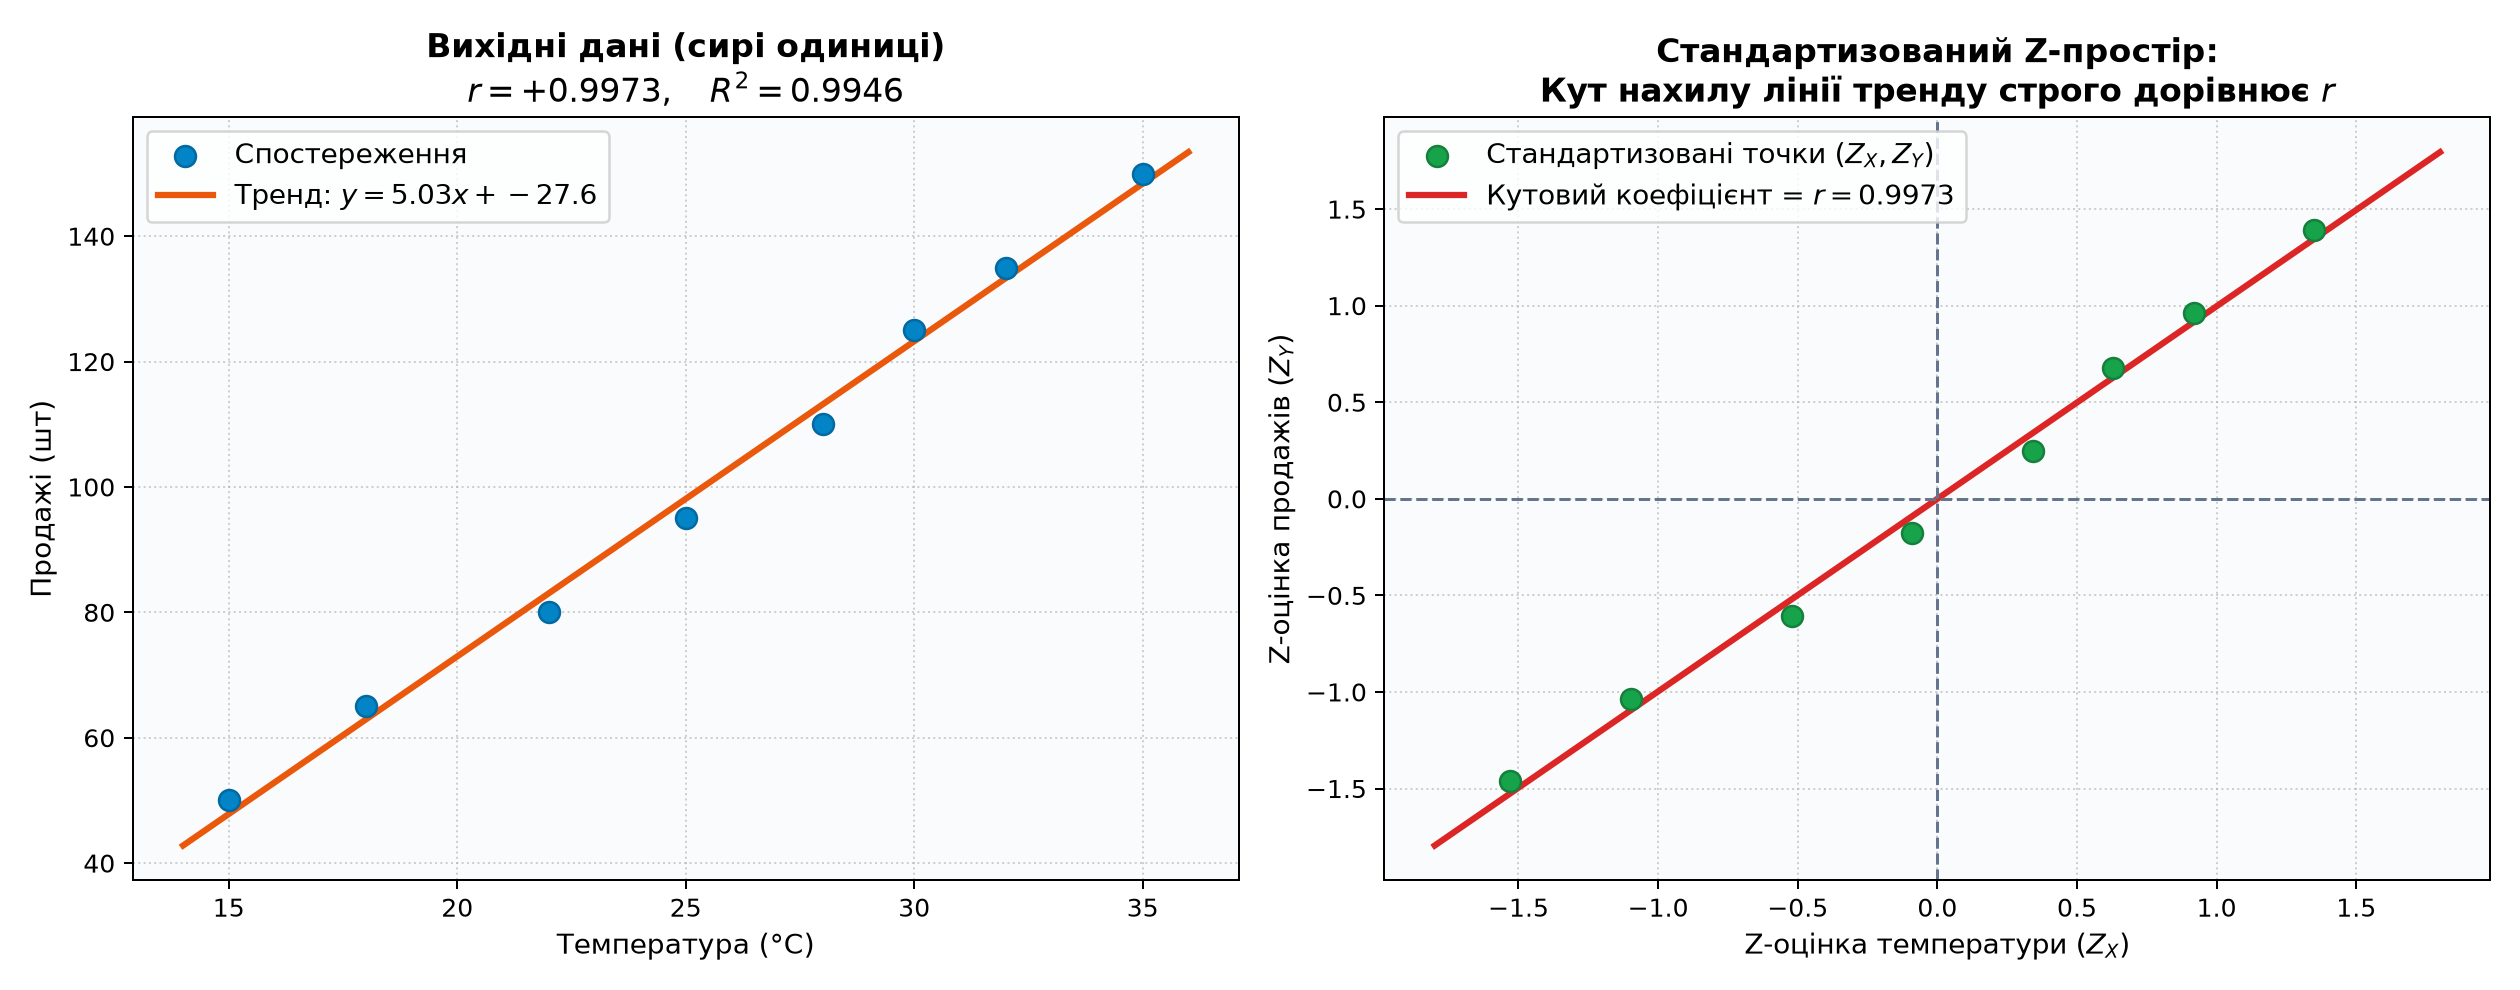
Результати обчислення кореляції:
  Вручну:        r = 0.9973
  np.corrcoef(): r = 0.9973
  scipy:         r = 0.9973, p-value = 0.000000

Інтерпретація:
  r = 0.997 → майже ідеальний позитивний лінійний зв'язок
  p-value < 0.05 → зв'язок статистично значущий (нульова гіпотеза про r=0 відкидається)
Візуалізація різних кореляцій
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(seed=42)
n = 100

def generate_correlated_data(r, n=100):
    """Генерує дві нормальні змінні з заданим коефіцієнтом кореляції r"""
    x = rng.standard_normal(n)
    y = r * x + np.sqrt(1 - r**2) * rng.standard_normal(n)
    return x, y

correlations = [1.0, 0.8, 0.4, 0.0, -0.4, -0.8, -1.0]
fig, axes = plt.subplots(2, 4, figsize=(16, 8))
axes = axes.ravel()

for i, r_target in enumerate(correlations):
    x, y = generate_correlated_data(r_target, n)
    r_actual = np.corrcoef(x, y)[0, 1]

    axes[i].scatter(x, y, alpha=0.6, s=30, edgecolors='black', linewidths=0.5)
    axes[i].set_title(f'r = {r_actual:.2f}', fontweight='bold', fontsize=12)
    axes[i].set_xlabel('X')
    axes[i].set_ylabel('Y')
    axes[i].grid(alpha=0.3)
    axes[i].axhline(0, color='gray', linewidth=0.5, linestyle='--')
    axes[i].axvline(0, color='gray', linewidth=0.5, linestyle='--')

# 8-й графік: нелінійний функціональний зв'язок (коло), де r ≈ 0
theta = np.linspace(0, 2*np.pi, n)
x_circle = np.cos(theta) + rng.standard_normal(n) * 0.1
y_circle = np.sin(theta) + rng.standard_normal(n) * 0.1
r_circle = np.corrcoef(x_circle, y_circle)[0, 1]

axes[7].scatter(x_circle, y_circle, alpha=0.6, s=30, edgecolors='black', linewidths=0.5, color='red')
axes[7].set_title(f'Коло: r = {r_circle:.2f}', fontweight='bold', fontsize=12)
axes[7].set_xlabel('X')
axes[7].set_ylabel('Y')
axes[7].grid(alpha=0.3)
axes[7].text(0, 0, 'Нелінійний зв\'язок!\nr ≈ 0', ha='center', fontsize=10,
             bbox=dict(boxstyle='round', facecolor='yellow', alpha=0.7))

plt.tight_layout()
plt.show()

print("Висновки:")
print("  r = +1: точки лежать точно на висхідній прямій ↗")
print("  r = -1: точки лежать точно на спадній прямій ↘")
print("  r ≈ 0: хаотична хмара АБО нелінійний зв'язок (коло, парабола)")
print("\n⚠ ВАЖЛИВО: r = 0 НЕ означає 'немає зв'язку', це означає лише 'немає ЛІНІЙНОГО зв'язку'!")
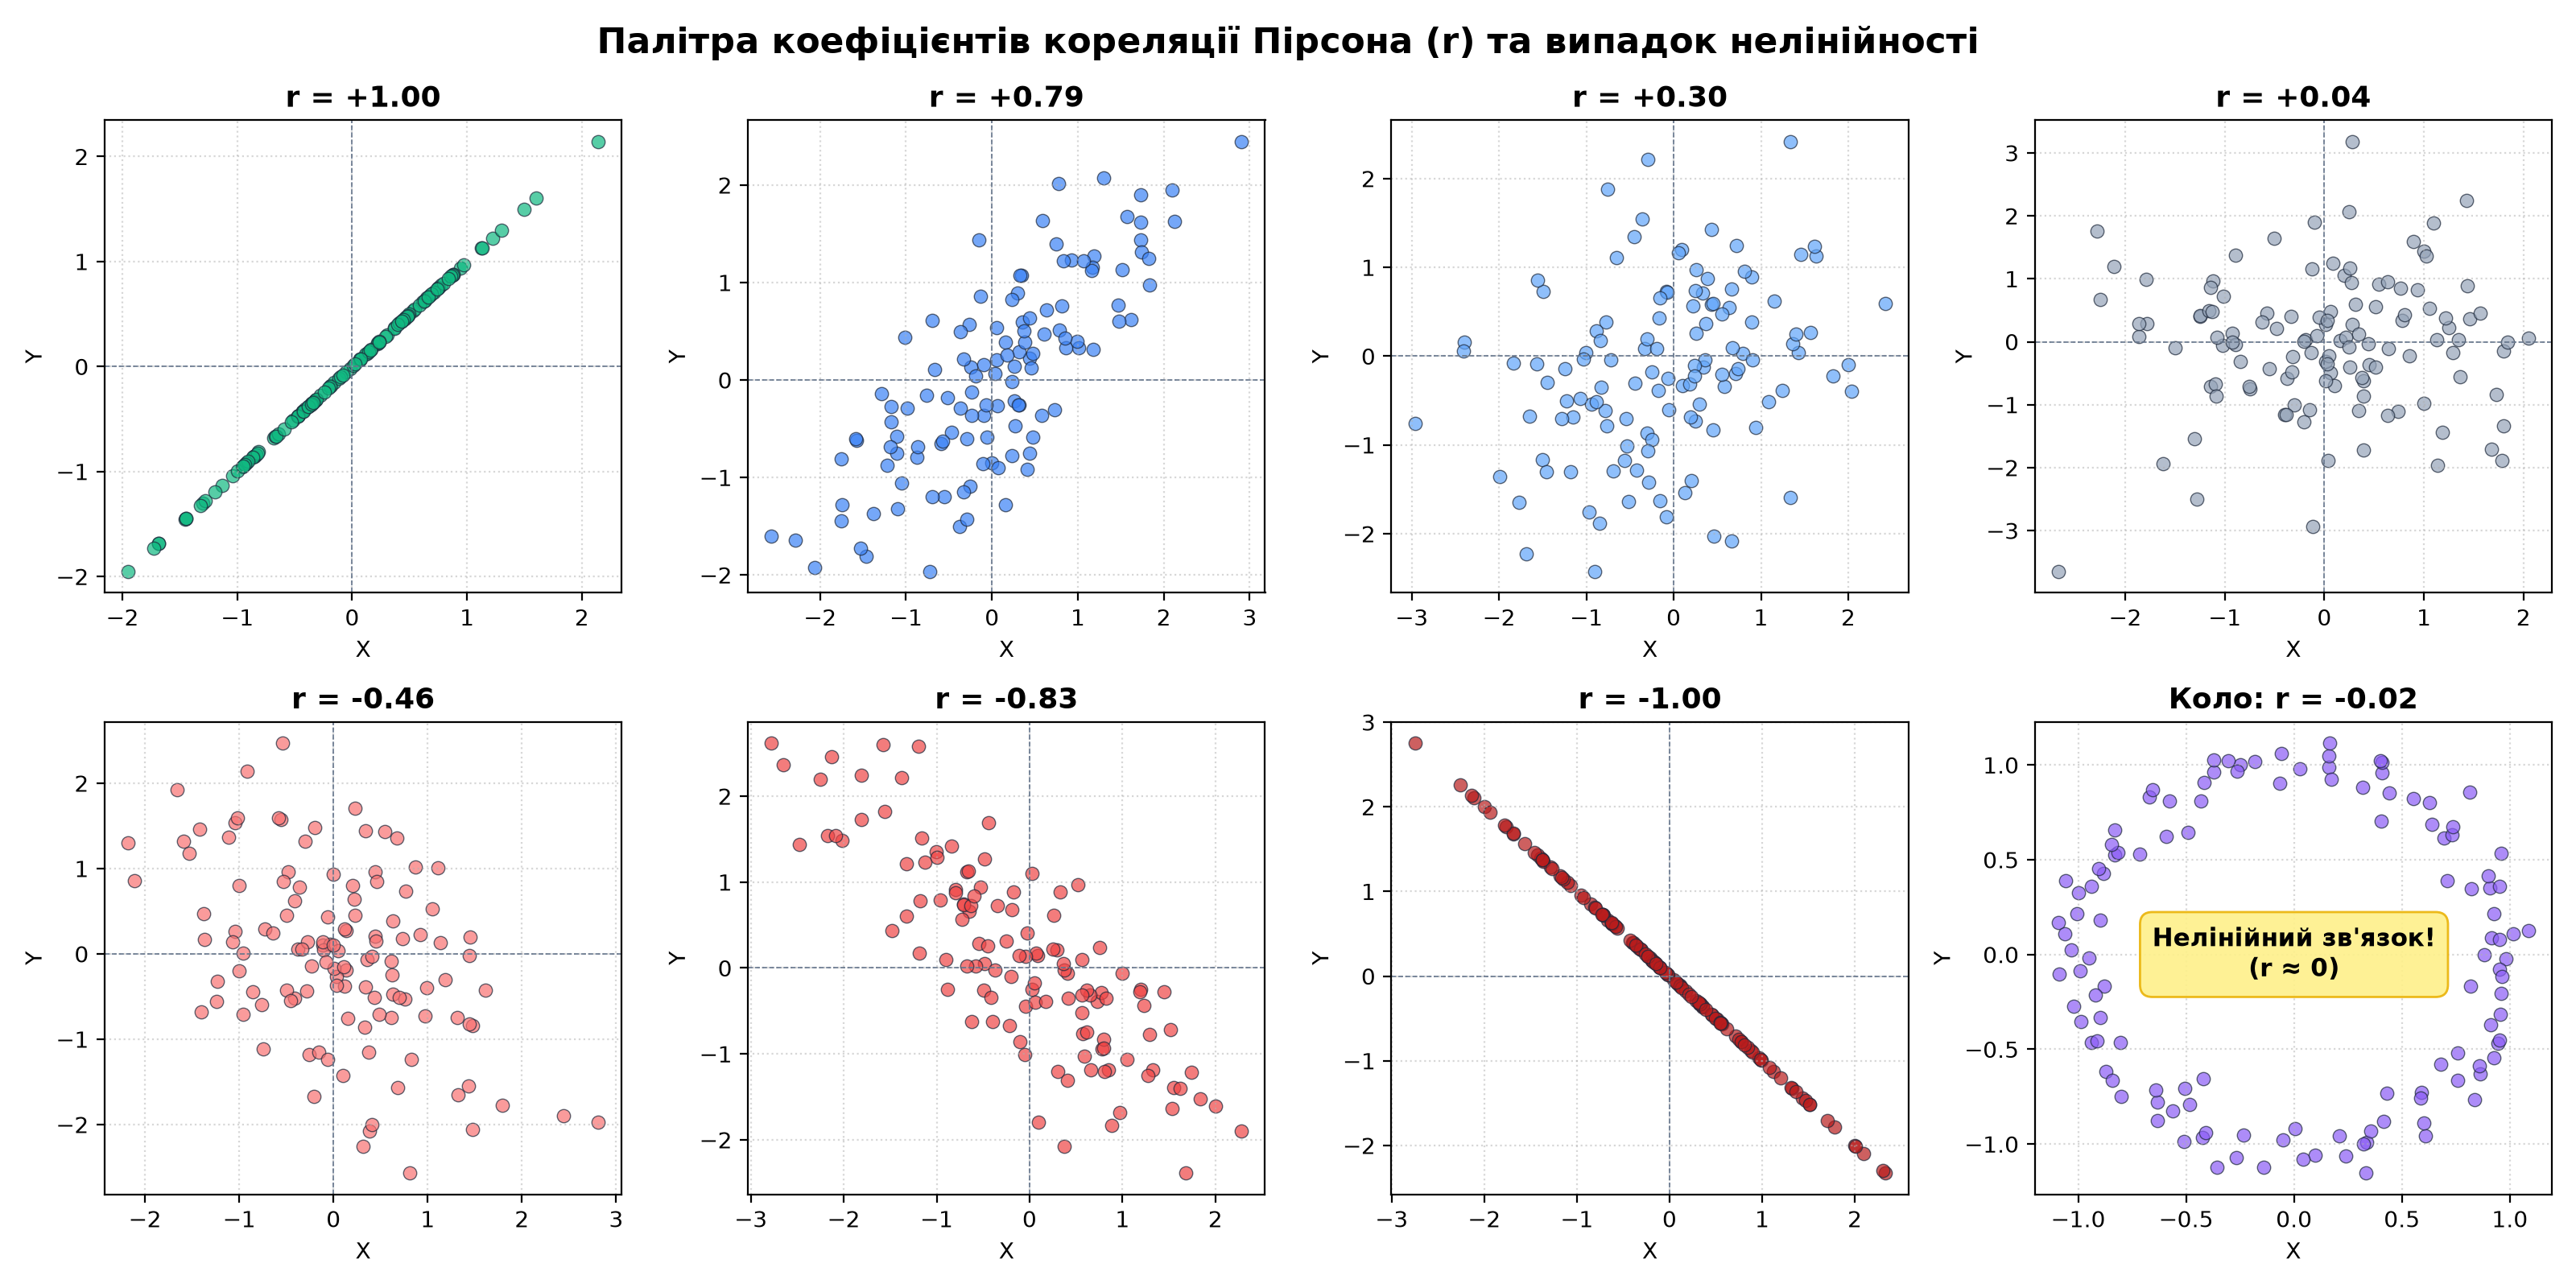
Висновки:
  r = +1: точки лежать точно на висхідній прямій ↗
  r = -1: точки лежать точно на спадній прямій ↘
  r ≈ 0: хаотична хмара АБО нелінійний зв'язок (коло, парабола)

⚠ ВАЖЛИВО: r = 0 НЕ означає 'немає зв'язку', це означає лише 'немає ЛІНІЙНОГО зв'язку'!
Квартет Анскомба (Anscombe's Quartet): чому не можна вірити лише числу r
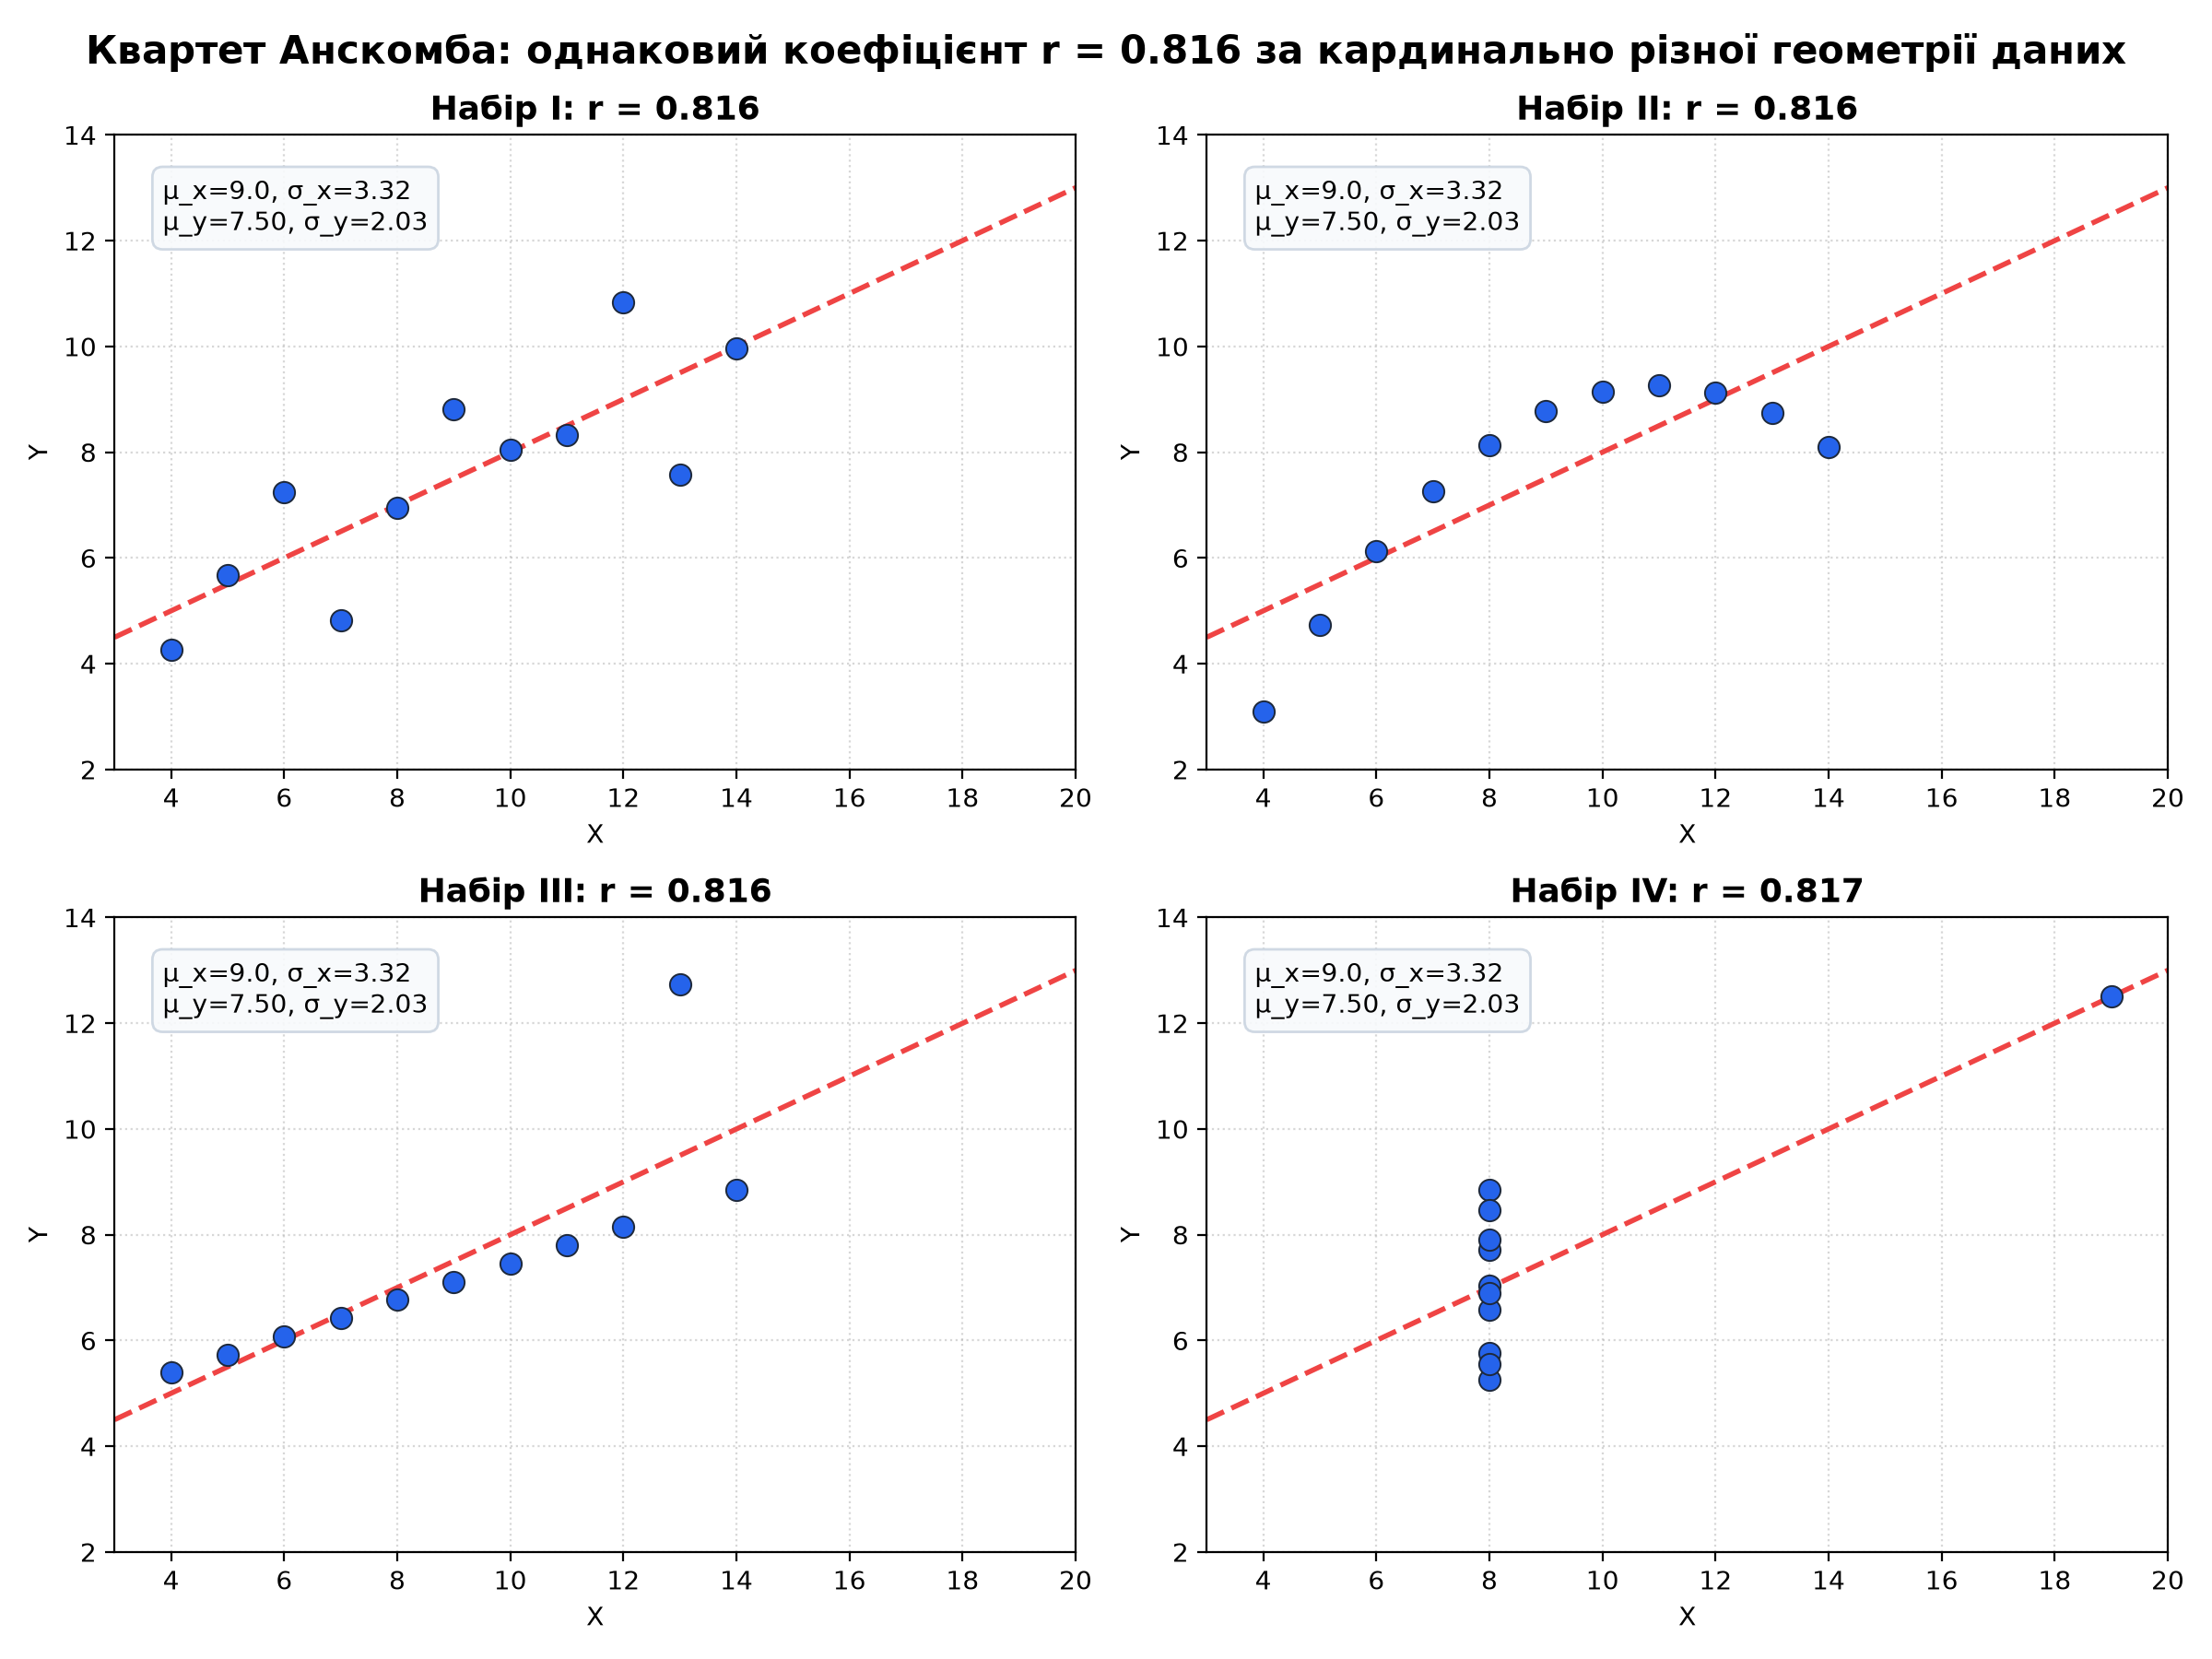
У 1973 році британський статистик Френсіс Анскомб сформував чотири набори числових даних, щоб проілюструвати фундаментальне правило: ніколи не робіть висновків про залежність змінних лише за коефіцієнтом кореляції без побудови графіка розсіювання (scatter plot).
Усі чотири набори даних мають майже ідентичні зведені статистичні характеристики:
- Середнє значення Завантаження..., вибіркова дисперсія Завантаження... (Завантаження...)
- Середнє значення Завантаження..., вибіркова дисперсія Завантаження... (Завантаження...)
- Коефіцієнт кореляції Пірсона Завантаження...
- Лінія регресії Завантаження... (Завантаження...)
Набір I (Лінійний зв'язок)
Набір II (Нелінійна парабола)
Набір III (Вплив одного викиду)
Набір IV (Важільна точка — Leverage)
Матриця кореляції (Correlation Matrix)
У реальних датасетах ми зазвичай маємо десятки або сотні ознак. Як швидко з'ясувати, які змінні тісно пов'язані між собою, а які дублюють інформацію?
Матриця кореляції — це симетрична таблиця розмірності Завантаження..., де елемент на перетині Завантаження...-го рядка та Завантаження...-го стовпця дорівнює коефіцієнту кореляції між змінними Завантаження... та Завантаження....
Структура матриці
Фундаментальні властивості:
- Головна діагональ завжди дорівнює 1.00 (Завантаження...).
- Симетричність відносно діагоналі: Завантаження....
- Діапазон усіх значень: Завантаження....
Обчислення та візуалізація матриці (Heatmap)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

rng = np.random.default_rng(seed=42)

# Створюємо синтетичний датасет (100 зразків, 5 змінних)
n = 100
age = rng.integers(20, 60, n)
income = age * 1200 + rng.normal(0, 5000, n)  # Тісно корелює з віком
education_years = rng.normal(14, 3, n)
savings = 0.15 * income + 1000 * education_years + rng.normal(0, 3000, n)
debt = -0.1 * income + rng.normal(5000, 2000, n)  # Від'ємна кореляція з доходом

# Формуємо DataFrame
data = pd.DataFrame({
    'Вік': age,
    'Дохід': income,
    'Освіта (роки)': education_years,
    'Заощадження': savings,
    'Борг': debt
})

# Обчислюємо кореляційну матрицю
corr_matrix = data.corr()

print("Матриця кореляції:\n")
print(corr_matrix.round(2))

# Візуалізуємо через теплову карту (Heatmap)
plt.figure(figsize=(9, 7.5))
sns.heatmap(corr_matrix, annot=True, fmt='.2f', cmap='coolwarm', center=0, vmin=-1, vmax=1,
            square=True, linewidths=1, cbar_kws={"shrink": 0.8, "label": "Коефіцієнт кореляції r"})
plt.title('Heatmap: Матриця кореляції фінансових показників', fontweight='bold', fontsize=13)
plt.tight_layout()
plt.show()

print("\n📊 Інтерпретація кольорів:")
print("  🔴 Червоний (r → +1): сильний позитивний зв'язок")
print("  🔵 Синій (r → -1): сильний негативний зв'язок")
print("  ⚪ Білий (r ≈ 0): лінійний зв'язок відсутній")
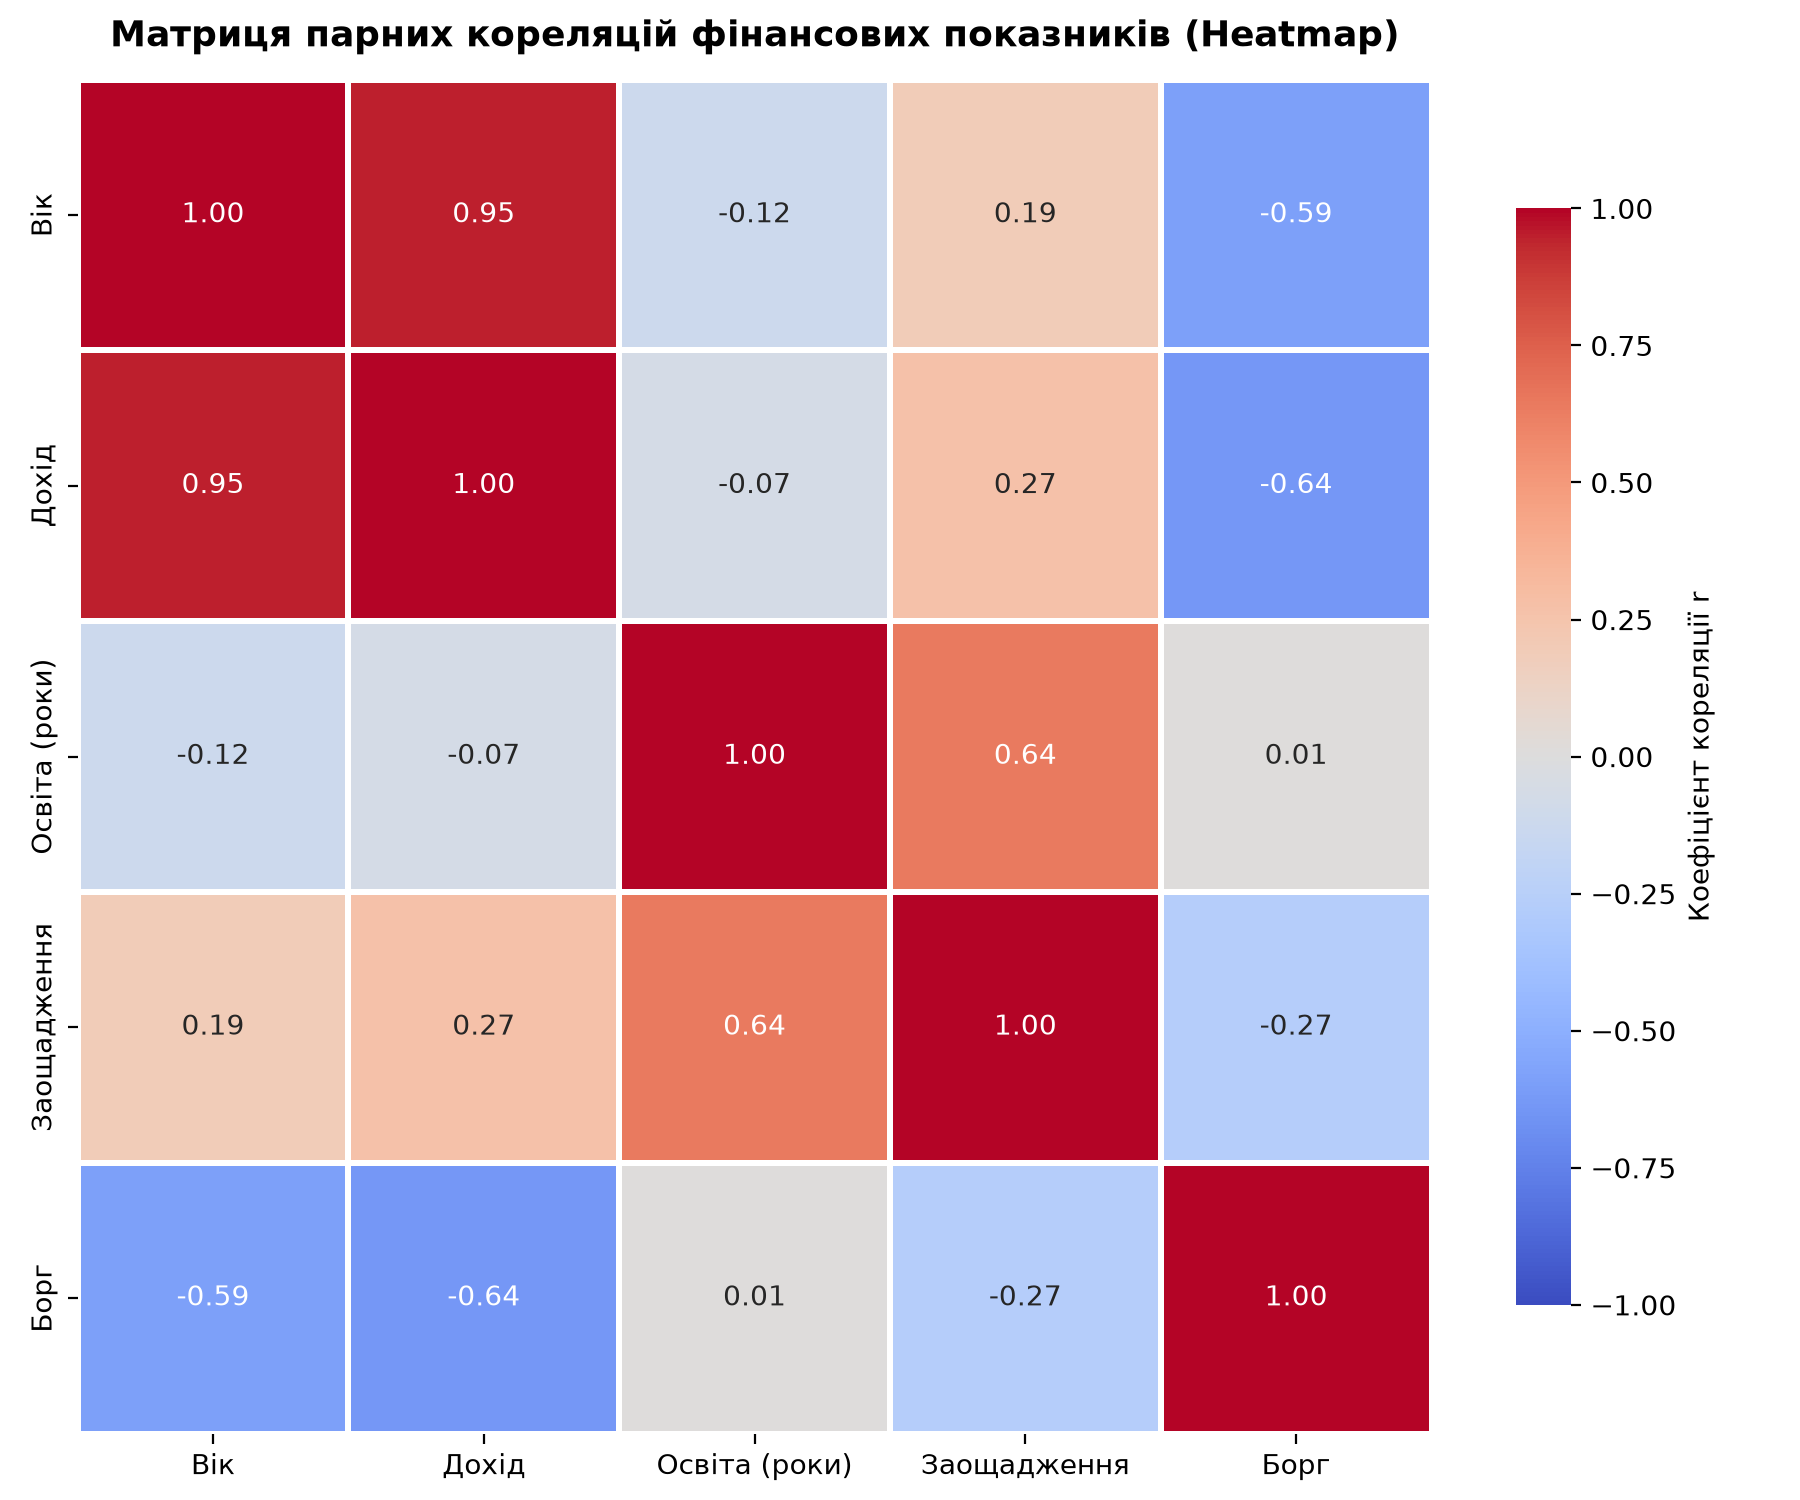
Матриця кореляції:

                Вік  Дохід  Освіта (роки)  Заощадження  Борг
Вік            1.00   0.95          -0.12         0.19 -0.59
Дохід          0.95   1.00          -0.07         0.27 -0.64
Освіта (роки) -0.12  -0.07           1.00         0.64  0.01
Заощадження    0.19   0.27           0.64         1.00 -0.27
Борг          -0.59  -0.64           0.01        -0.27  1.00

📊 Інтерпретація кольорів:
  🔴 Червоний (r → +1): сильний позитивний зв'язок
  🔵 Синій (r → -1): сильний негативний зв'язок
  ⚪ Білий (r ≈ 0): лінійний зв'язок відсутній
- Вік ↔ Дохід (Завантаження...): надзвичайно потужний позитивний зв'язок — з віком та накопиченням професійного стажу дохід стабільно зростає.
- Освіта ↔ Заощадження (Завантаження...): помітний позитивний зв'язок — додаткові роки навчання сприяють фінансовій грамотності та інвестиціям.
- Дохід ↔ Борг (Завантаження...): помірний від'ємний зв'язок — люди з вищим рівнем заробітку мають менше проблем із непогашеною заборгованістю.
- Освіта ↔ Вік (Завантаження...) та Освіта ↔ Борг (Завантаження...): взаємозв'язок практично відсутній.
Кореляція ≠ Причинність (Correlation ≠ Causation)
Це найважливіший методологічний розділ в аналізі даних та емпіричній науці.
- Завантаження... є причиною виникнення Завантаження...;
- Завантаження... спричиняє Завантаження...;
- між ними взагалі існує причинно-наслідковий механізм.
Класичні приклади помилкової інтерпретації
1. Продажі морозива та кількість утоплень
Емпіричний факт: Продажі морозива та кількість нещасних випадків на воді демонструють вражаючу позитивну кореляцію (Завантаження...).
Хибний висновок (псевдопричинність): «Вживання морозива викликає судоми у воді або потоплення! Необхідно негайно заборонити продаж морозива на пляжах!».
Реальність (Confounding Variable — прихована третя змінна): Обидва явища одночасно зумовлені третім фактором — літньою спекою:
- Спекотна погода Завантаження... різко зростає попит на прохолодні ласощі (морозиво Завантаження...);
- Спекотна погода Завантаження... мільйони людей масово вирушають купатися у відкритих водоймах Завантаження... зростає кількість інцидентів на воді (Завантаження...).
2. Кількість пожежників та матеріальні збитки від пожежі
Факт: Чим більше пожежних машин та рятувальників прибуває на ліквідацію вогню, тим більші фінансові збитки реєструє страхова компанія (Завантаження...).
Хибний висновок: «Пожежники самі провокують руйнування будівель!».
Реальність (Reverse Causality — зворотна причинність): Масштаб самої пожежі визначає як рівень збитків, так і категорію тривоги, за якою диспетчер відправляє додаткові бригади на виклик.
3. Споживання органічних продуктів та аутизм
Факт: За останні десятиліття зростання продажів органічних фермерських продуктів і кількість зареєстрованих випадків аутизму в розвинених країнах зростали майже паралельно (Завантаження...).
Реальність (Спільний тренд часу): Обидва графіки монотонно зростали через глобальні історичні тренди (популяризація здорового харчування з одного боку, та вдосконалення діагностичних критеріїв DSM і скринінгу дітей з іншого).
Три сценарії походження кореляції
import matplotlib.pyplot as plt
from matplotlib.patches import FancyArrowPatch

fig, axes = plt.subplots(1, 3, figsize=(15, 4.5))

scenarios = [
    ("Сценарій 1:\nX → Y", "X викликає Y\n(Пряма причинність)", [(0.25, 0.5, 0.75, 0.5)]),
    ("Сценарій 2:\nY → X", "Y викликає X\n(Зворотна причинність)", [(0.75, 0.5, 0.25, 0.5)]),
    ("Сценарій 3:\nZ → X, Z → Y", "Спільна причина Z\n(Хибна кореляція)", [(0.5, 0.75, 0.25, 0.35), (0.5, 0.75, 0.75, 0.35)])
]

for ax, (title, subtitle, arrows) in zip(axes, scenarios):
    ax.set_xlim(0, 1)
    ax.set_ylim(0, 1)
    ax.axis('off')
    ax.set_title(title, fontweight='bold', fontsize=14, pad=10)
    ax.text(0.5, 0.12, subtitle, ha='center', fontsize=11, fontweight='semibold',
            bbox=dict(boxstyle='round,pad=0.5', facecolor='#fef3c7', edgecolor='#f59e0b', alpha=0.9))

    for x1, y1, x2, y2 in arrows:
        arrow = FancyArrowPatch((x1, y1), (x2, y2),
                                arrowstyle='-|>', mutation_scale=22,
                                linewidth=3, color='#dc2626')
        ax.add_patch(arrow)

    if len(arrows) == 1:
        ax.plot(0.25, 0.5, 'o', markersize=42, color='#2563eb')
        ax.plot(0.75, 0.5, 'o', markersize=42, color='#ea580c')
        ax.text(0.25, 0.5, 'X', ha='center', va='center', fontsize=18, fontweight='bold', color='white')
        ax.text(0.75, 0.5, 'Y', ha='center', va='center', fontsize=18, fontweight='bold', color='white')
    else:
        ax.plot(0.5, 0.75, 'o', markersize=42, color='#16a34a')
        ax.plot(0.25, 0.35, 'o', markersize=42, color='#2563eb')
        ax.plot(0.75, 0.35, 'o', markersize=42, color='#ea580c')
        ax.text(0.5, 0.75, 'Z', ha='center', va='center', fontsize=18, fontweight='bold', color='white')
        ax.text(0.25, 0.35, 'X', ha='center', va='center', fontsize=18, fontweight='bold', color='white')
        ax.text(0.75, 0.35, 'Y', ha='center', va='center', fontsize=18, fontweight='bold', color='white')

plt.tight_layout()
plt.show()

print("При виявленні кореляції між X та Y необхідно ретельно перевірити ВСІ три сценарії!")
print("Без проведення контрольованих рандомізованих експериментів строго довести причинність неможливо!")
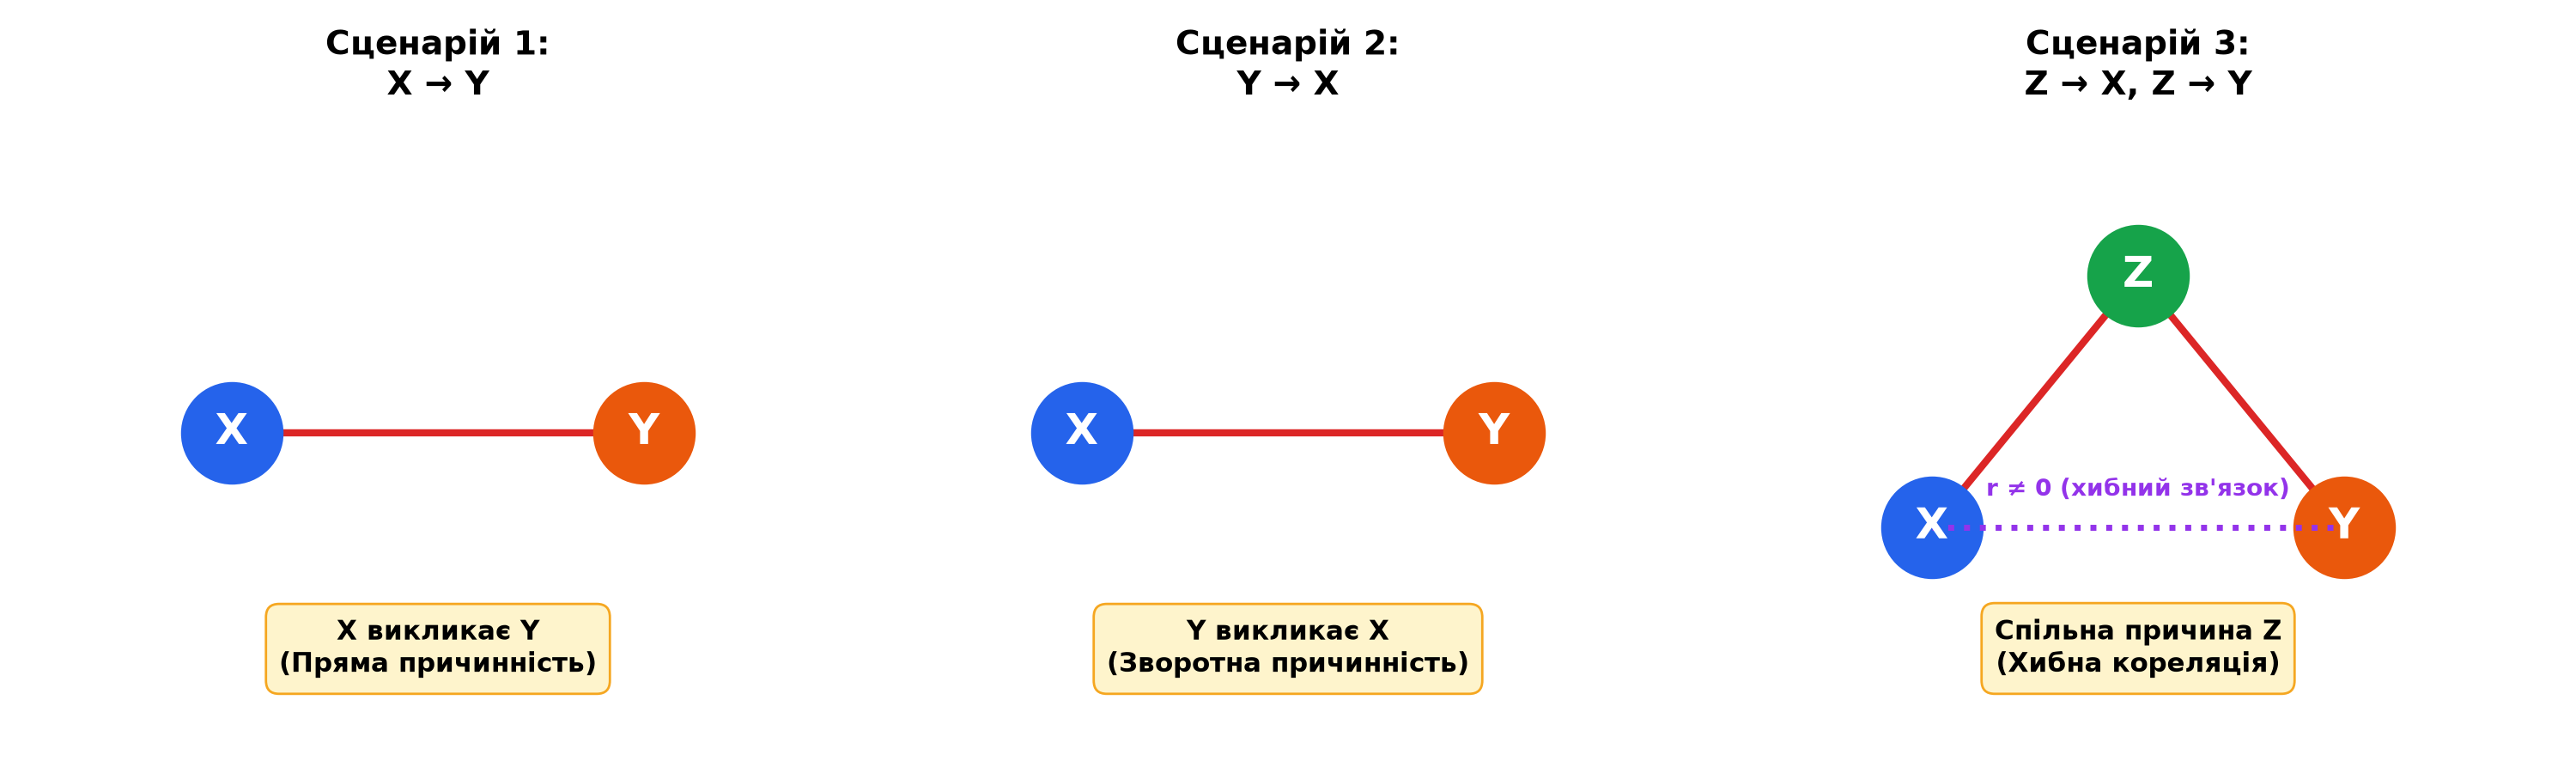
При виявленні кореляції між X та Y необхідно ретельно перевірити ВСІ три сценарії!
Без проведення контрольованих рандомізованих експериментів строго довести причинність неможливо!
Як у науці доводять причинність?
Кореляція — це лише первинна евристика для формулювання наукової гіпотези. Для доведення причинно-наслідкового зв'язку потрібні:
- Рандомізовані контрольовані дослідження (RCT — Randomized Controlled Trials):
- Випадковим чином розбити вибірку на тестову (де штучно змінюється Завантаження...) та контрольну (де Завантаження... зафіксовано на базовому рівні).
- Якщо статистично значущі зміни Завантаження... виникають виключно в тестовій групі, причинність доведено.
- Темпоральний пріоритет (послідовність у часі):
- Причина повинна строго передувати наслідку (Завантаження...). Якщо відгук змінюється раніше за тригер, гіпотеза відкидається.
- Контроль заважаючих факторів (Confounders):
- Усунення або статистична фіксація впливу всіх прихованих факторів Завантаження... (наприклад, через A/B-тестування або метод інструментальних змінних).
- Фізичний або біологічний механізм:
- Наявність чіткої наукової теорії, що пояснює, яким саме чином вплив передається від Завантаження... до Завантаження....
- «Ознака Завантаження... статистично асоційована зі зростанням Завантаження...»
- «Між параметрами виявлено помірний коваріаційний зв'язок»
- «Змінна Завантаження... володіє прогностичною силою щодо Завантаження...»
- «Ознака Завантаження... призводить до падіння Завантаження...»
- «Підвищення параметра Завантаження... викликає зростання Завантаження...»
Spurious Correlations (хибні кореляції)
Відомий проєкт Тайлера Вігена (Tyler Vigen) наочно доводить: якщо зібрати тисячі незалежних часових рядів, закон великих чисел гарантує, що деякі з них випадково покажуть Завантаження...:
- Споживання сиру моцарела на душу населення ↔ Кількість захищених докторських дисертацій з цивільної інженерії (Завантаження...)
- Кількість людей, що втонули в басейнах США ↔ Кількість фільмів за участю Ніколаса Кейджа (Завантаження...)
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(seed=42)

# Дві повністю незалежні змінні з глобальним трендом часу
years = np.arange(2000, 2020)
cheese_consumption = 10 + 0.5 * np.arange(20) + rng.normal(0, 1, 20)
engineering_phd = 500 + 25 * np.arange(20) + rng.normal(0, 30, 20)

# Обчислення кореляції
r = np.corrcoef(cheese_consumption, engineering_phd)[0, 1]

# Візуалізація двох шкал
fig, ax1 = plt.subplots(figsize=(11, 5.5))

ax1.plot(years, cheese_consumption, 'o-', color='#f59e0b', linewidth=2.2, markersize=7, label='Споживання сиру (кг/особу)')
ax1.set_xlabel('Рік', fontsize=12)
ax1.set_ylabel('Споживання сиру (кг/особу)', color='#d97706', fontsize=12)
ax1.tick_params(axis='y', labelcolor='#d97706')

ax2 = ax1.twinx()
ax2.plot(years, engineering_phd, 's--', color='#2563eb', linewidth=2.2, markersize=7, label='Докторські з інженерії')
ax2.set_ylabel('Кількість захищених дисертацій', color='#1d4ed8', fontsize=12)
ax2.tick_params(axis='y', labelcolor='#1d4ed8')

plt.title(f'Spurious Correlation: r = {r:.3f}\n(Спільний часовий тренд без жодного причинно-наслідкового зв\'язку)',
          fontweight='bold', fontsize=13)
fig.legend(loc='upper left', bbox_to_anchor=(0.12, 0.88))
plt.grid(True, linestyle=':', alpha=0.5)
plt.tight_layout()
plt.show()

print(f"Кореляція: r = {r:.3f}")
print("Пояснення: обидва процеси зростають в часі з незалежних причин.")
print("Це класичний випадок хибної кореляції трендів (Spurious Correlation)!")
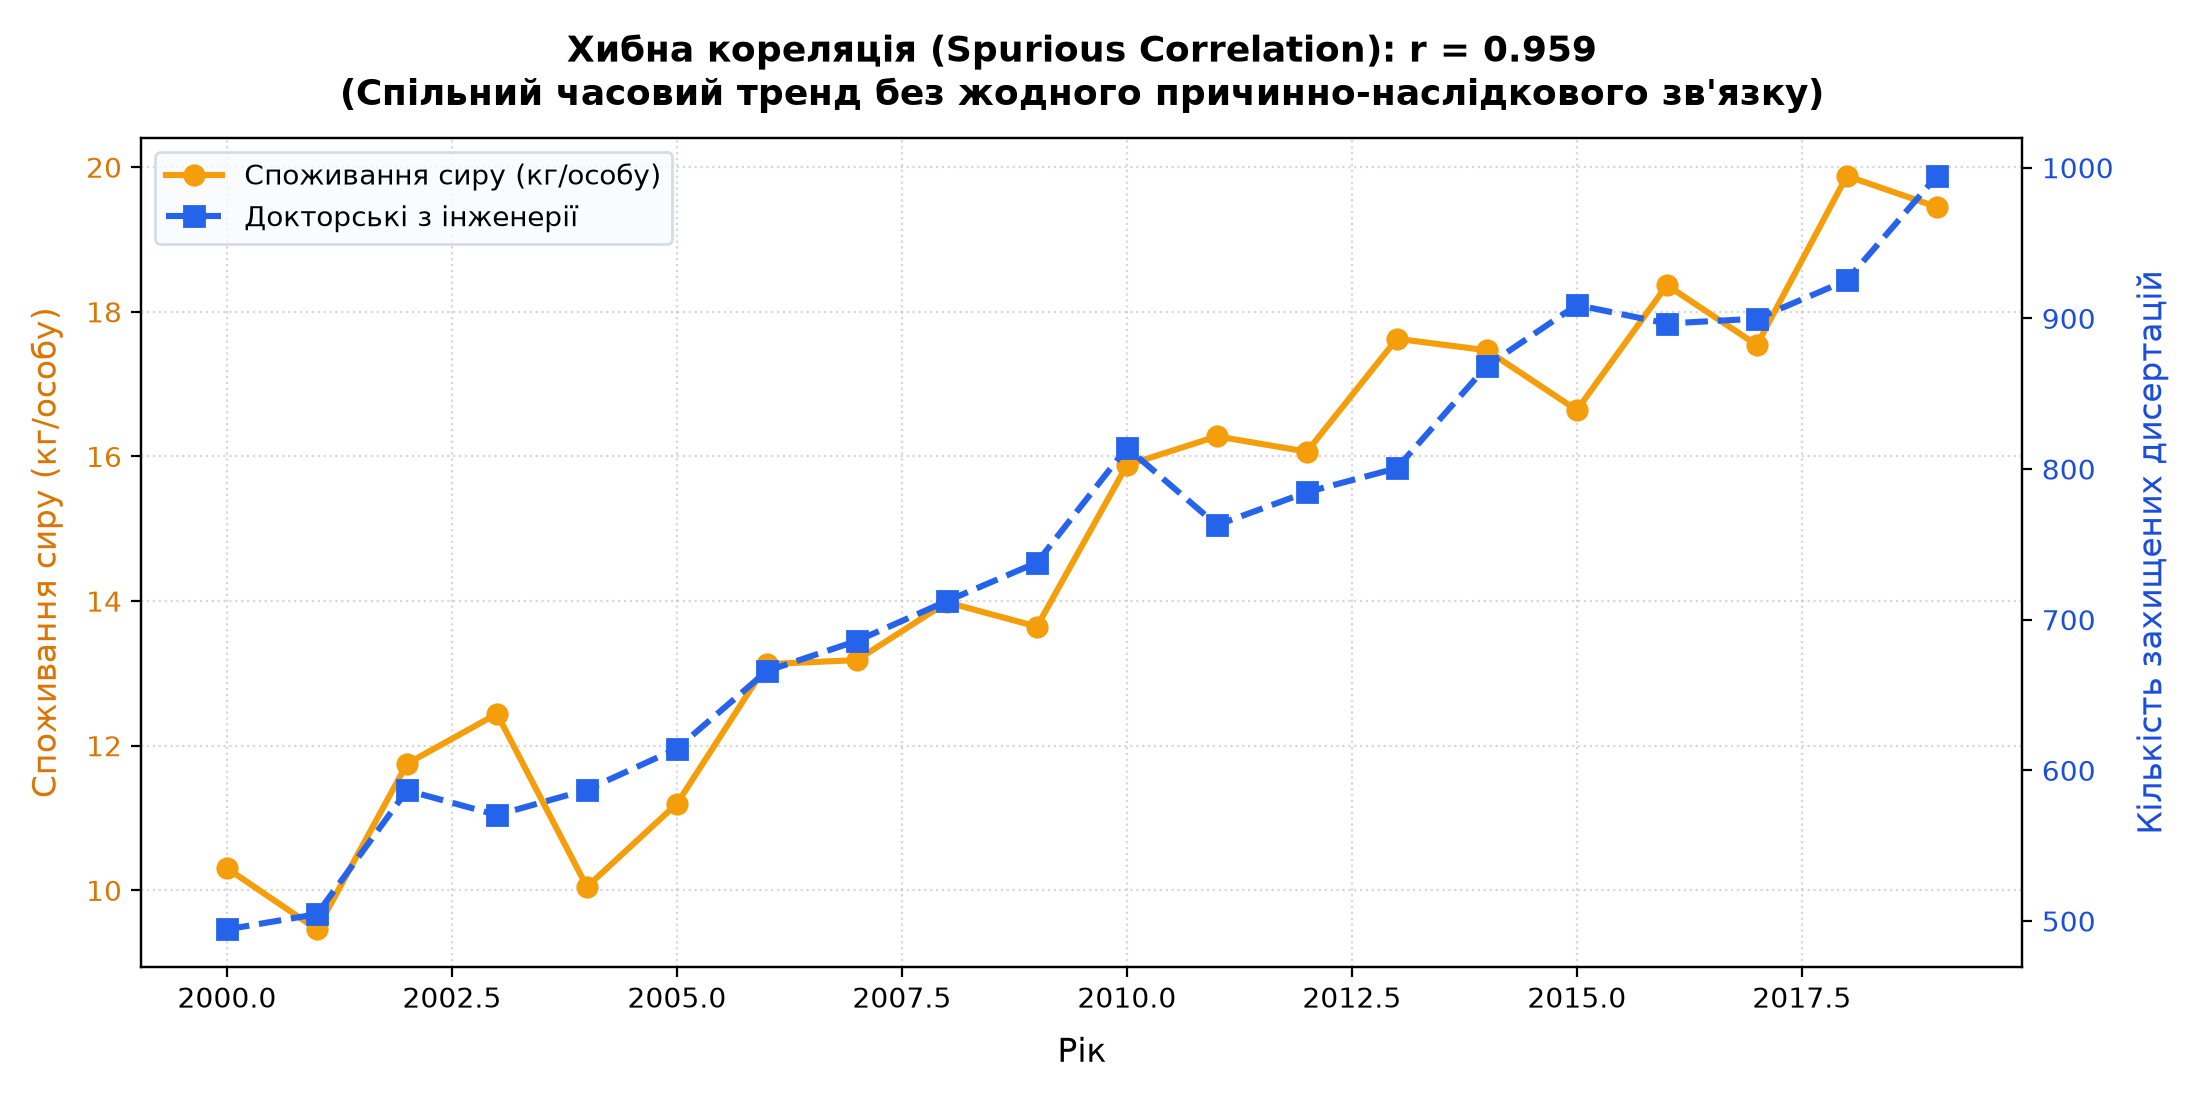
Кореляція: r = 0.959
Пояснення: обидва процеси зростають в часі з незалежних причин.
Це класичний випадок хибної кореляції трендів (Spurious Correlation)!
- Щоранку о 09:00 спостерігається стрімкий стрибок навантаження CPU мікросервісу
auth-service(з 15% до 85%). - Одночасно на балансувальнику навантаження (Nginx/Cloudflare) різко зростає кількість помилок
HTTP 404 Not Found. - Матриця кореляцій показує майже ідеальний зв'язок: Завантаження....
- Вони проходять процедуру SSO-авторизації (навантажуючи
auth-service). - Їхні браузери автоматично відкривають закешовані вкладки із застарілими endpoint-ами, які бекенд-команда видалила під час нічного деплою (викликаючи сплеск
404).
auth-service та HTTP 404 немає жодного причинного зв'язку. Якщо інженер кинеться оптимізувати сервіс авторизації, щоб зменшити помилки 404, він даремно змарнує робочий час на боротьбу з міражем.Мультиколінеарність (Multicollinearity)
Мультиколінеарність — це явище в багатовимірному аналізі та машинному навчанні, коли дві або більше пояснювальних ознак (features) перебувають у сильній лінійній залежності між собою.
Чому це критична проблема для моделей?
- Нестійкість коефіцієнтів регресії: незначна зміна у вибірці або невеликий шум спричиняють стрибки ваг моделі від Завантаження... до Завантаження....
- Втрата інтерпретованості: стає неможливо визначити, яка саме ознака насправді впливає на цільову змінну, оскільки ознаки-дублікати «крадуть» вагу одна в одної.
- Завищена дисперсія помилок: стандартні похибки коефіцієнтів стрімко зростають, роблячи t-статистику неінформативною.
Аналогія: Уявіть, що ви прогнозуєте вартість квартири, використовуючи одночасно дві ознаки: «Площа в м²» та «Площа у фут²». Оскільки Завантаження..., коефіцієнт кореляції між ними Завантаження.... Алгоритм лінійної регресії не може вирішити, як розподілити вагу між цими ознаками-клонами!
- Порушення 3-ї нормальної форми (3NF):
Якщо в таблиці
usersзберігати стовпчикиbirth_date,age_yearsтаage_months, ви вносите функціональну транзитивну залежність. У СУБД це призводить до аномалій оновлення (UPDATE), а в ML — змушує оптимізатор штучно ділити градієнт між дублікатами. - Сингулярність матриці Грама (Завантаження...):
Аналітичний розв'язок методу найменших квадратів (OLS) задається нормальним рівнянням:Завантаження...
Якщо два стовпці матриці Завантаження... лінійно залежні, визначник Завантаження.... Матриця стає майже виродженою (число обумовленості condition number прямує до нескінченності). Похибки округлення чисел з плаваючою комою (floating-point errors) лавиноподібно зростають, руйнуючи обчислення.
Виявлення мультиколінеарності
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

rng = np.random.default_rng(seed=42)
n = 100

# Генеруємо штучні ознаки з колінеарністю
area_m2 = rng.uniform(30, 150, n)
area_ft2 = area_m2 * 10.764               # Ідеальна колінеарність (r = 1.0)
rooms = rng.poisson(3, n)
age = rng.integers(0, 50, n)
age_squared = age ** 2                    # Нелінійна монотонна залежність (r ≈ 0.97)

# Цільова змінна: ціна
price = 1000 * area_m2 - 500 * age + rng.normal(0, 5000, n)

data = pd.DataFrame({
    'Площа (м²)': area_m2,
    'Площа (фут²)': area_ft2,
    'Кімнати': rooms,
    'Вік': age,
    'Вік²': age_squared,
    'Ціна': price
})

corr_matrix = data.corr()

# Візуалізація
plt.figure(figsize=(9, 7.5))
sns.heatmap(corr_matrix, annot=True, fmt='.2f', cmap='RdYlGn', center=0, vmin=-1, vmax=1,
            square=True, linewidths=1.5, linecolor='white', cbar_kws={'shrink': 0.8, 'label': 'Коефіцієнт r'})
plt.title('Матриця кореляцій: Виявлення мультиколінеарності ознак', fontweight='bold', fontsize=13)
plt.tight_layout()
plt.show()

# Автоматичний пошук колінеарних пар
print("⚠ ВИЯВЛЕНА МУЛЬТИКОЛІНЕАРНІСТЬ (|r| > 0.90 серед предикторів):\n")
features = [col for col in corr_matrix.columns if col != 'Ціна']
for i in range(len(features)):
    for j in range(i + 1, len(features)):
        r_val = corr_matrix.loc[features[i], features[j]]
        if abs(r_val) > 0.90:
            print(f"  {features[i]} ↔ {features[j]}: r = {r_val:.3f}")
            print(f"    → Рекомендація: вилучити одну з ознак або застосувати регуляризацію!\n")
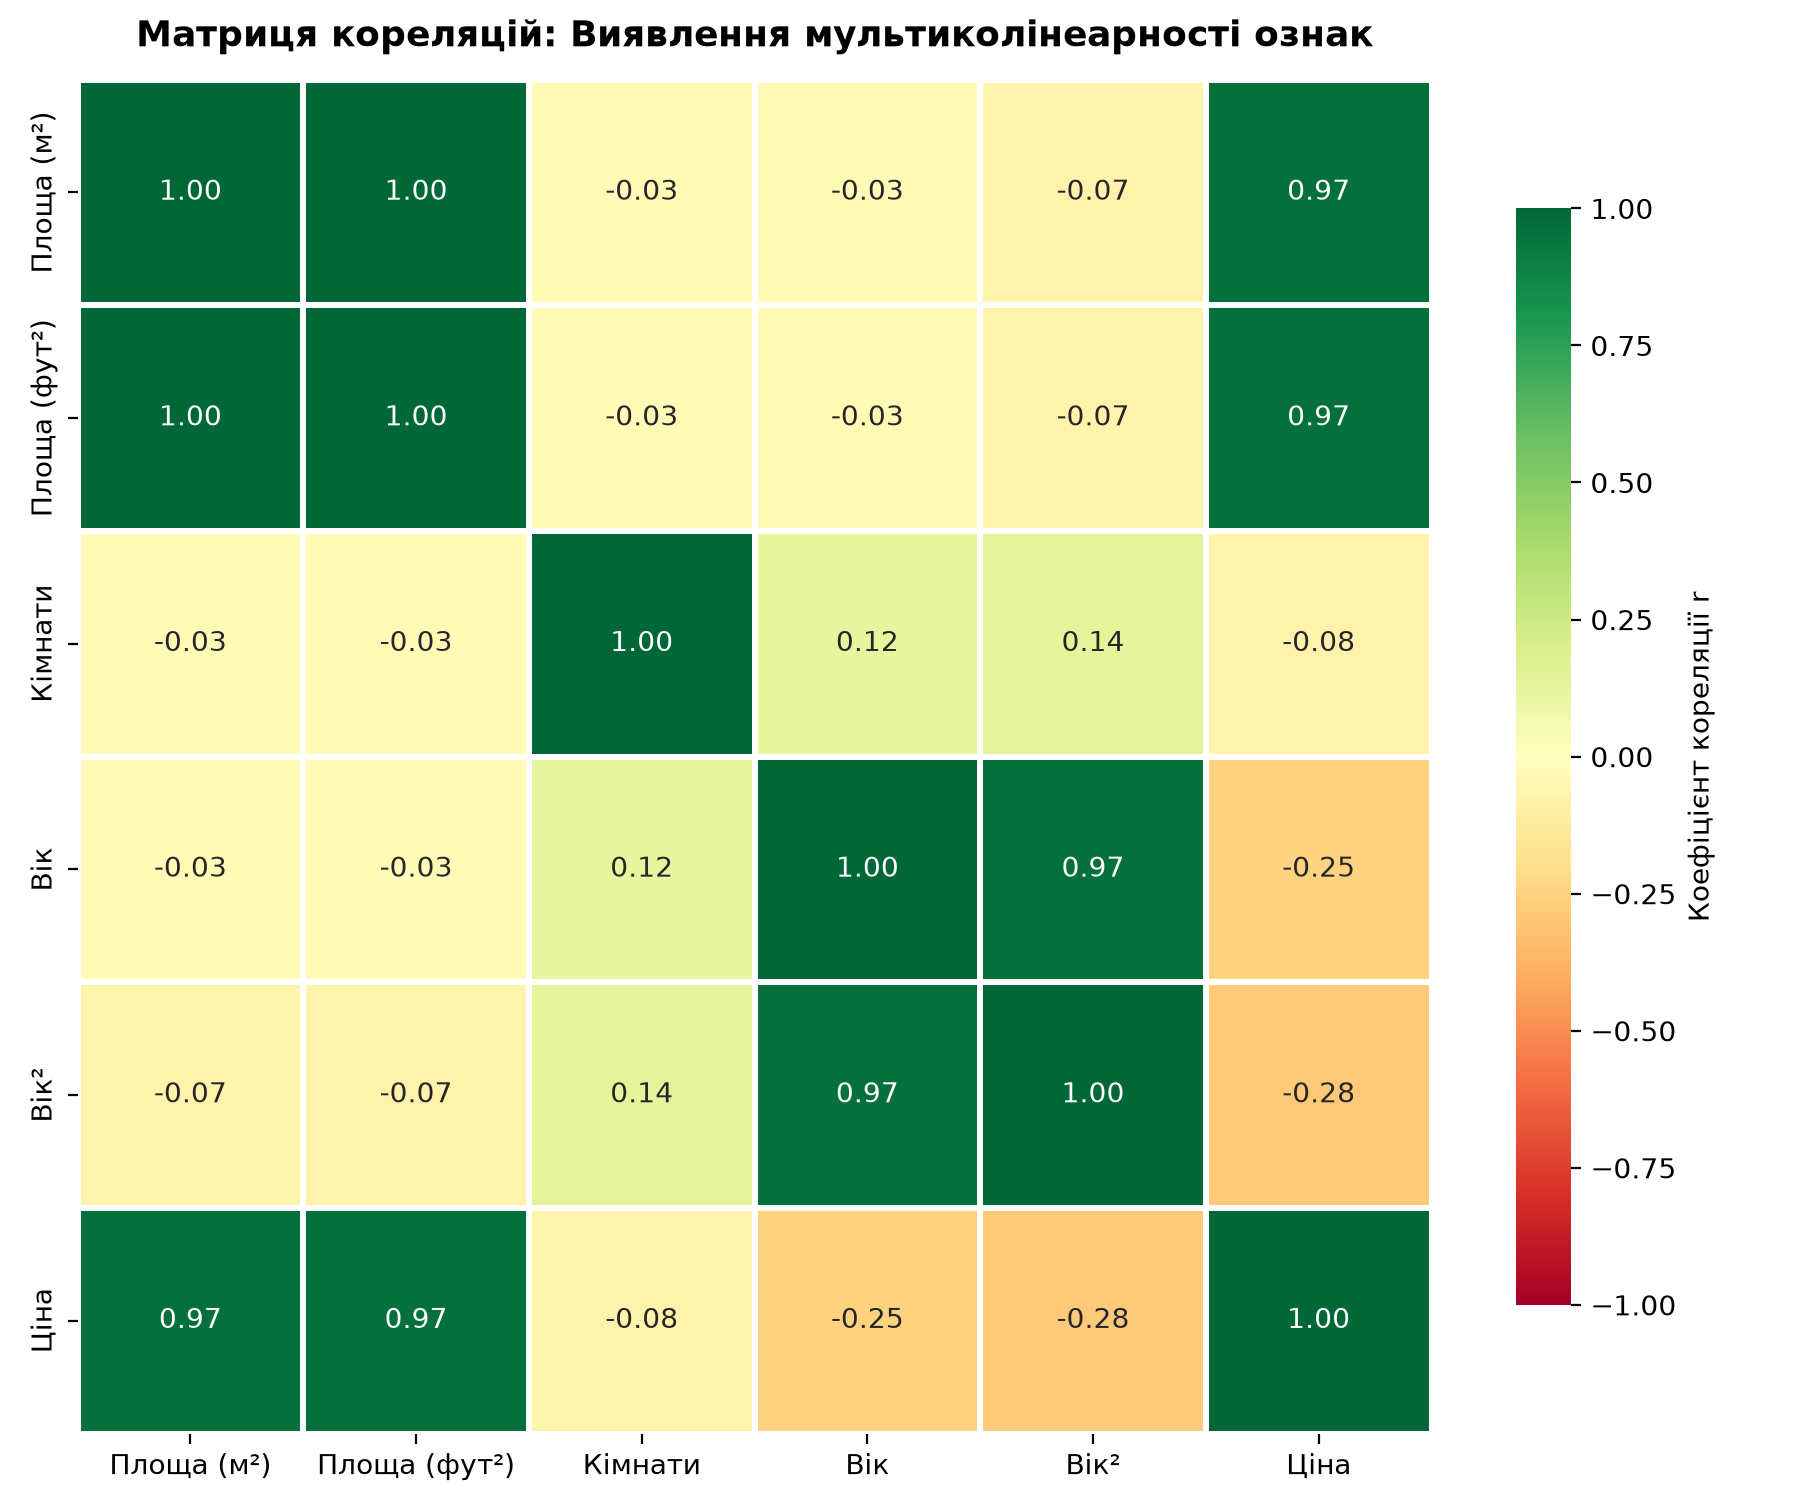
⚠ ВИЯВЛЕНА МУЛЬТИКОЛІНЕАРНІСТЬ (|r| > 0.90 серед предикторів):

  Площа (м²) ↔ Площа (фут²): r = 1.000
    → Рекомендація: вилучити одну з ознак або застосувати регуляризацію!

  Вік ↔ Вік²: r = 0.968
    → Рекомендація: вилучити одну з ознак або застосувати регуляризацію!
Метрика VIF (Variance Inflation Factor)
Для суворого кількісного оцінювання мультиколінеарності в економетриці та ML застосовують коефіцієнт інфляції дисперсії (VIF):
де Завантаження... — коефіцієнт детермінації моделі, в якій ознака Завантаження... регресується на всі інші предиктори.
- Завантаження... — ознака абсолютно некорельована з іншими.
- Завантаження... — помірна, безпечна колінеарність.
- Завантаження... (або Завантаження...) — критична мультиколінеарність; оцінки параметрів моделі стають ненадійними.
Стратегії подолання мультиколінеарності
Якщо дві ознаки корелюють із Завантаження..., вилучіть одну з них. Критерії вибору:
- Залишити ознаку, що має простішу та зрозумілішу фізичну інтерпретацію (наприклад, площа в метрах замість футів).
- Залишити ознаку з меншою кількістю пропусків (missing values).
- Залишити ознаку, яка сильніше лінійно або нелінійно пов'язана з цільовою змінною.
Замість звичайного OLS застосовують регуляризовану лінійну регресію:
- Ridge (Завантаження...): додає штраф Завантаження..., що стабілізує матрицю Завантаження... та пригнічує коливання ваг колінеарних ознак.
- Lasso (Завантаження...): додає штраф Завантаження..., який автоматично обнуляє ваги менш важливих дублюючих ознак, виконуючи автоматичний відбір ознак (Feature Selection).
Інші міри статистичного зв'язку
Коефіцієнт Пірсона чудово вимірює лінійний зв'язок нормальних неперервних змінних. Проте в реальних інженерних задачах дані часто бувають порядковими, містять грубі викиди або мають нелінійний монотонний характер.
Кореляція Спірмена (Spearman's Rank Correlation, ρ)
Ранговий коефіцієнт Спірмена (Завантаження... або Завантаження...) — це непараметрична міра, яка оцінює, наскільки монотонно зростає або спадає одна змінна при зростанні іншої, не вимагаючи строгої лінійності.
Алгоритм обчислення:
- Замінити сирі значення Завантаження... та Завантаження... на їхні ранги Завантаження... та Завантаження... (номери за порядком зростання від 1 до Завантаження...).
- Якщо зв'язаних (однакових) рангів немає, формула набуває елегантного вигляду:
Завантаження...де Завантаження... — різниця між рангами Завантаження...-го об'єкта.
Переваги Спірмена:
- Стійкість до викидів (Robustness): аномальне значення 1,000,000 отримує максимальний ранг Завантаження..., не зміщуючи результат лавиноподібно.
- Діагностика монотонних нелінійностей: для експоненти чи логарифма (Завантаження...) коефіцієнт Спірмена дорівнює точній одиниці (Завантаження...), тоді як Пірсон видає занижені значення.
- Підтримка порядкових (ординальних) шкал: оцінки задоволеності (1–5 зірок), рівні пріоритету задач у Jira (P1–P4).
import numpy as np
from scipy import stats
import matplotlib.pyplot as plt

rng = np.random.default_rng(seed=42)

# Нелінійна, але суворо монотонна функціональна залежність
x = np.linspace(0, 5, 50)
y = np.exp(x) + rng.normal(0, 5, 50)

# Обчислення коефіцієнтів
pearson_r, _ = stats.pearsonr(x, y)
spearman_r, _ = stats.spearmanr(x, y)

# Візуалізація
plt.figure(figsize=(10, 6))
plt.scatter(x, y, alpha=0.8, s=60, edgecolors='#1e293b', linewidths=0.7, color='#0284c7', label='Спостереження')
plt.plot(x, np.exp(x), color='#ea580c', linestyle='-', linewidth=2, label='Базова експонента y = exp(x)')

plt.xlabel('X', fontsize=12)
plt.ylabel('Y', fontsize=12)
plt.title('Нелінійний монотонний зв\'язок: порівняння коефіцієнтів Пірсона та Спірмена', fontweight='bold', fontsize=13)
plt.grid(True, linestyle=':', alpha=0.5)
plt.text(0.3, max(y) * 0.75, f'Pearson r = {pearson_r:.3f}\nSpearman ρ = {spearman_r:.3f}',
         fontsize=12, fontweight='semibold', bbox=dict(boxstyle='round,pad=0.6', facecolor='#fef08a', edgecolor='#eab308', alpha=0.9))
plt.legend(loc='upper left')
plt.tight_layout()
plt.show()

print("Порівняльні висновки:")
print(f"  Pearson r = {pearson_r:.3f} — недооцінює силу зв'язку через вигин експоненти")
print(f"  Spearman ρ = {spearman_r:.3f} — бездоганно фіксує збереження порядку рангів")
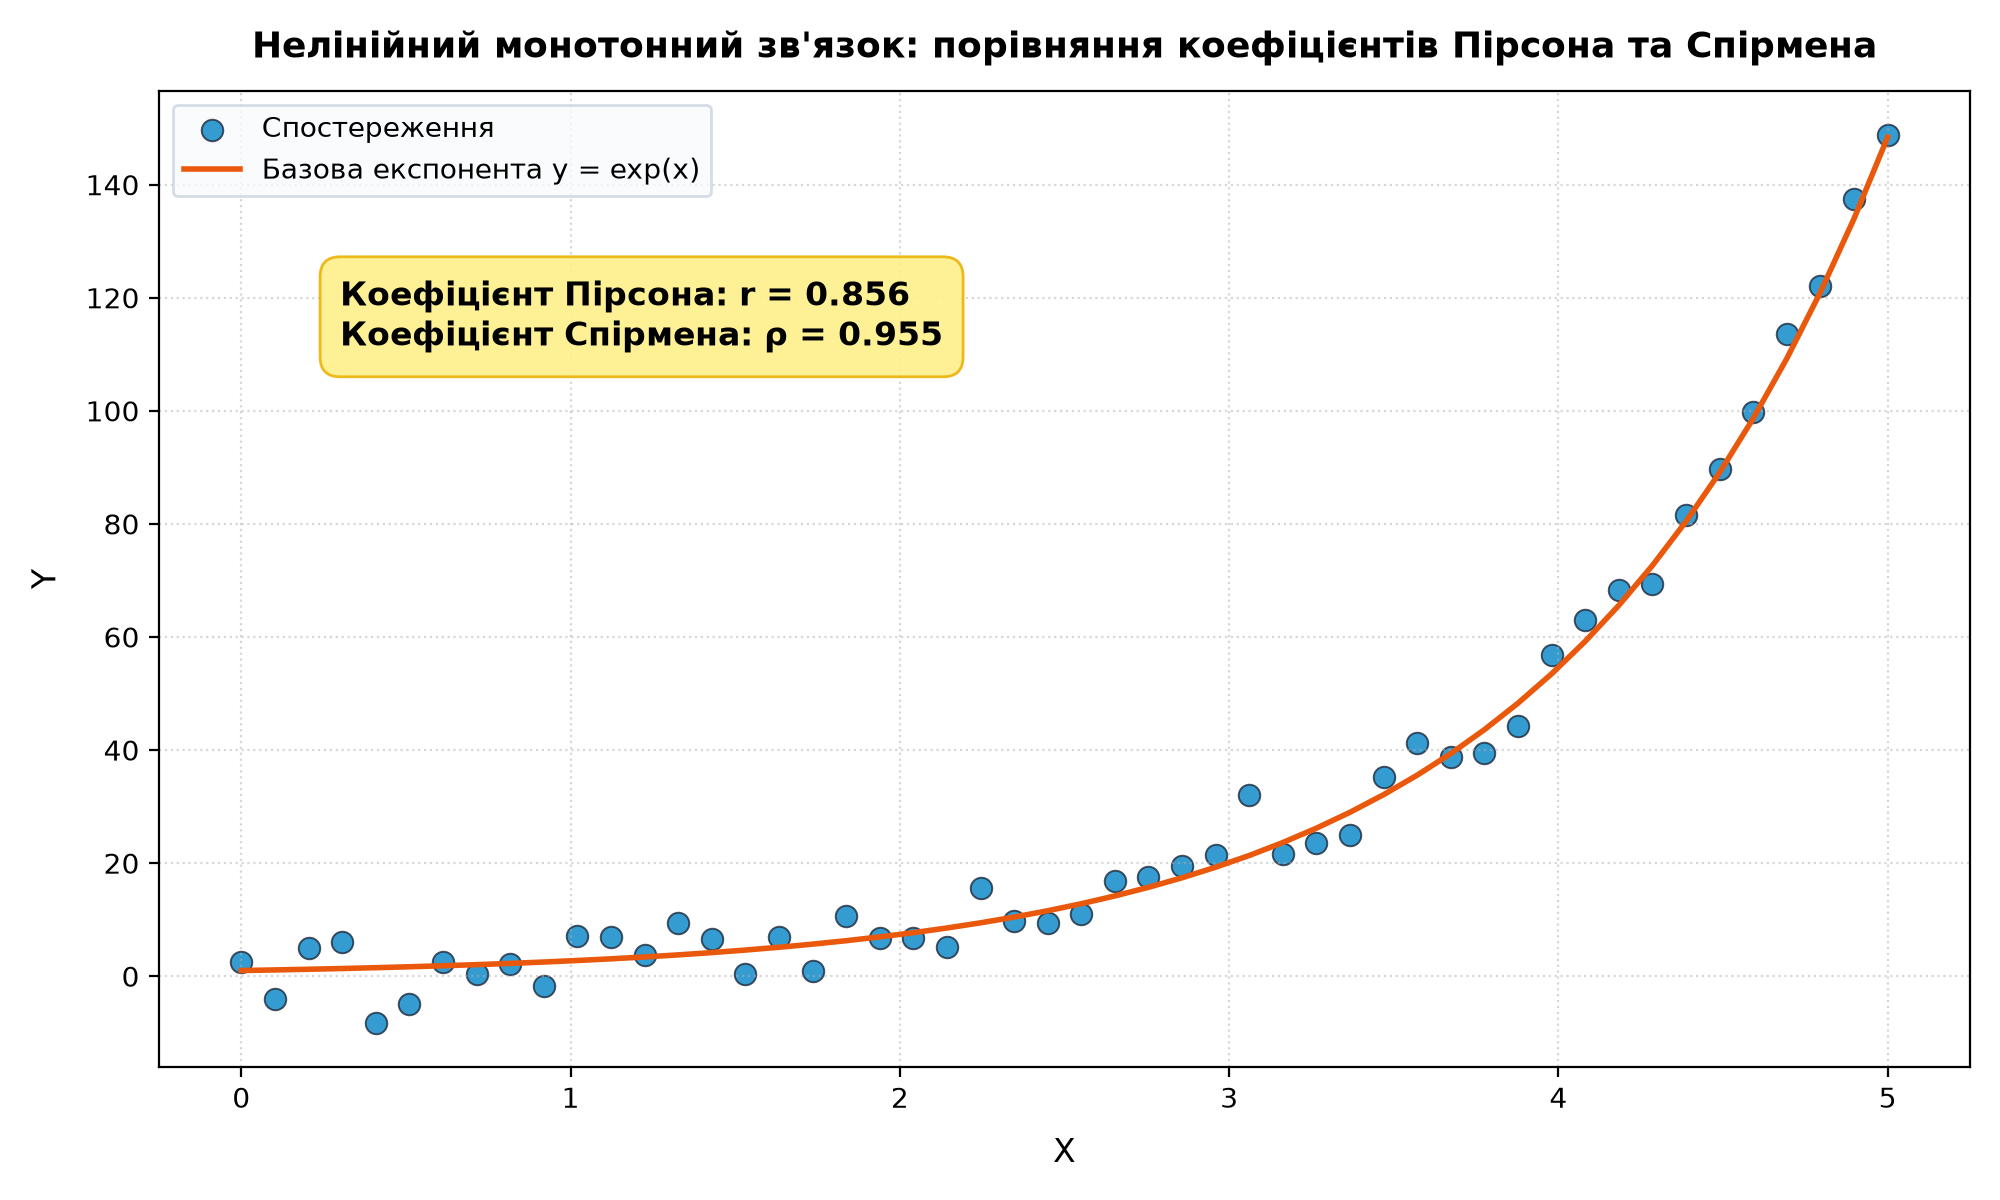
Порівняльні висновки:
  Pearson r = 0.856 — недооцінює силу зв'язку через вигин експоненти
  Spearman ρ = 0.955 — бездоганно фіксує збереження порядку рангів
Рангова кореляція Кендалла (Kendall's Tau, τ)
Коефіцієнт кореляції Кендалла (Завантаження...) базується на аналізі узгодженості (конкордантності) між усіма можливими парами спостережень.
Для будь-якої пари спостережень Завантаження... та Завантаження...:
- Узгоджена (concordant) пара: коли знак різниць однаковий, тобто Завантаження... (обидві змінні зростають або обидві спадають).
- Неузгоджена (discordant) пара: коли знаки протилежні, тобто Завантаження....
Математична формула:
де Завантаження... — кількість узгоджених пар, а Завантаження... — кількість неузгоджених пар.
Коли Кендалл кращий за Спірмена?
- На малих вибірках (Завантаження...) Кендалл дає меншу похибку оцінки генерального параметра.
- Володіє прямою ймовірнісною інтерпретацією: Завантаження... — це різниця між імовірністю того, що пара точок узгоджена, та ймовірністю того, що вона неузгоджена.
- Надійніший при наявності великої кількості однакових (зв'язаних) значень.
Як обрати міру взаємозв'язку? (Дерево рішень)
Коефіцієнт детермінації (R²)
Коефіцієнт детермінації (Завантаження...) показує, яка частка дисперсії залежної змінної Завантаження... пояснюється моделлю регресії від Завантаження...:
Для простої однофакторної лінійної регресії виконується елегантна тотожність:
Практична інтерпретація:
- Завантаження...: модель пояснює 64% варіації цільової змінної (а 36% зумовлені неврахованими факторами або шумом).
- Завантаження...: пояснюється лише 9% варіації (прогнозна сила слабка).
- У множинній регресії (де предикторів багато) Завантаження..., тому використовують скоригований Завантаження....
Практичні завдання
Рівень 1: Базові вправи
Дано два вектори спостережень однакової довжини (Завантаження...):
- Завантаження...
- Завантаження...
Вимоги:
- Обчисліть вибіркову коваріацію Завантаження... вручну за формулою та перевірте через
np.cov(). - Обчисліть коефіцієнт кореляції Пірсона Завантаження... вручну та перевірте через
np.corrcoef(). - Поясніть отримане значення Завантаження...: чому воно набуло саме такої величини?
import numpy as np

X = np.array([10, 20, 30, 40, 50], dtype=float)
Y = np.array([15, 25, 35, 45, 55], dtype=float)
n = len(X)

# 1. Обчислення вручну
mean_x, mean_y = np.mean(X), np.mean(Y)
dev_x, dev_y = X - mean_x, Y - mean_y

cov_manual = np.sum(dev_x * dev_y) / (n - 1)
std_x = np.sqrt(np.sum(dev_x**2) / (n - 1))
std_y = np.sqrt(np.sum(dev_y**2) / (n - 1))
r_manual = cov_manual / (std_x * std_y)

# 2. Обчислення через бібліотеку NumPy
cov_numpy = np.cov(X, Y)[0, 1]
r_numpy = np.corrcoef(X, Y)[0, 1]

print("--- Ручний розрахунок ---")
print(f"Середні значення: μ_X = {mean_x:.1f}, μ_Y = {mean_y:.1f}")
print(f"Коваріація Cov(X, Y): {cov_manual:.2f}")
print(f"Коефіцієнт кореляції r: {r_manual:.4f}")

print("\n--- Перевірка NumPy ---")
print(f"np.cov(X, Y)[0, 1]:      {cov_numpy:.2f}")
print(f"np.corrcoef(X, Y)[0, 1]: {r_numpy:.4f}")
--- Ручний розрахунок ---
Середні значення: μ_X = 30.0, μ_Y = 35.0
Коваріація Cov(X, Y): 250.00
Коефіцієнт кореляції r: 1.0000

--- Перевірка NumPy ---
np.cov(X, Y)[0, 1]:      250.00
np.corrcoef(X, Y)[0, 1]: 1.0000
Аналітичний висновок: Коефіцієнт Завантаження..., тому що між Завантаження... та Завантаження... існує ідеальна лінійна залежність виду Завантаження.... Кожне збільшення Завантаження... на 10 одиниць супроводжується строго пропорційним зростанням Завантаження... на 10 одиниць, а всі точки лежать строго на одній прямій із додатним кутом нахилу.
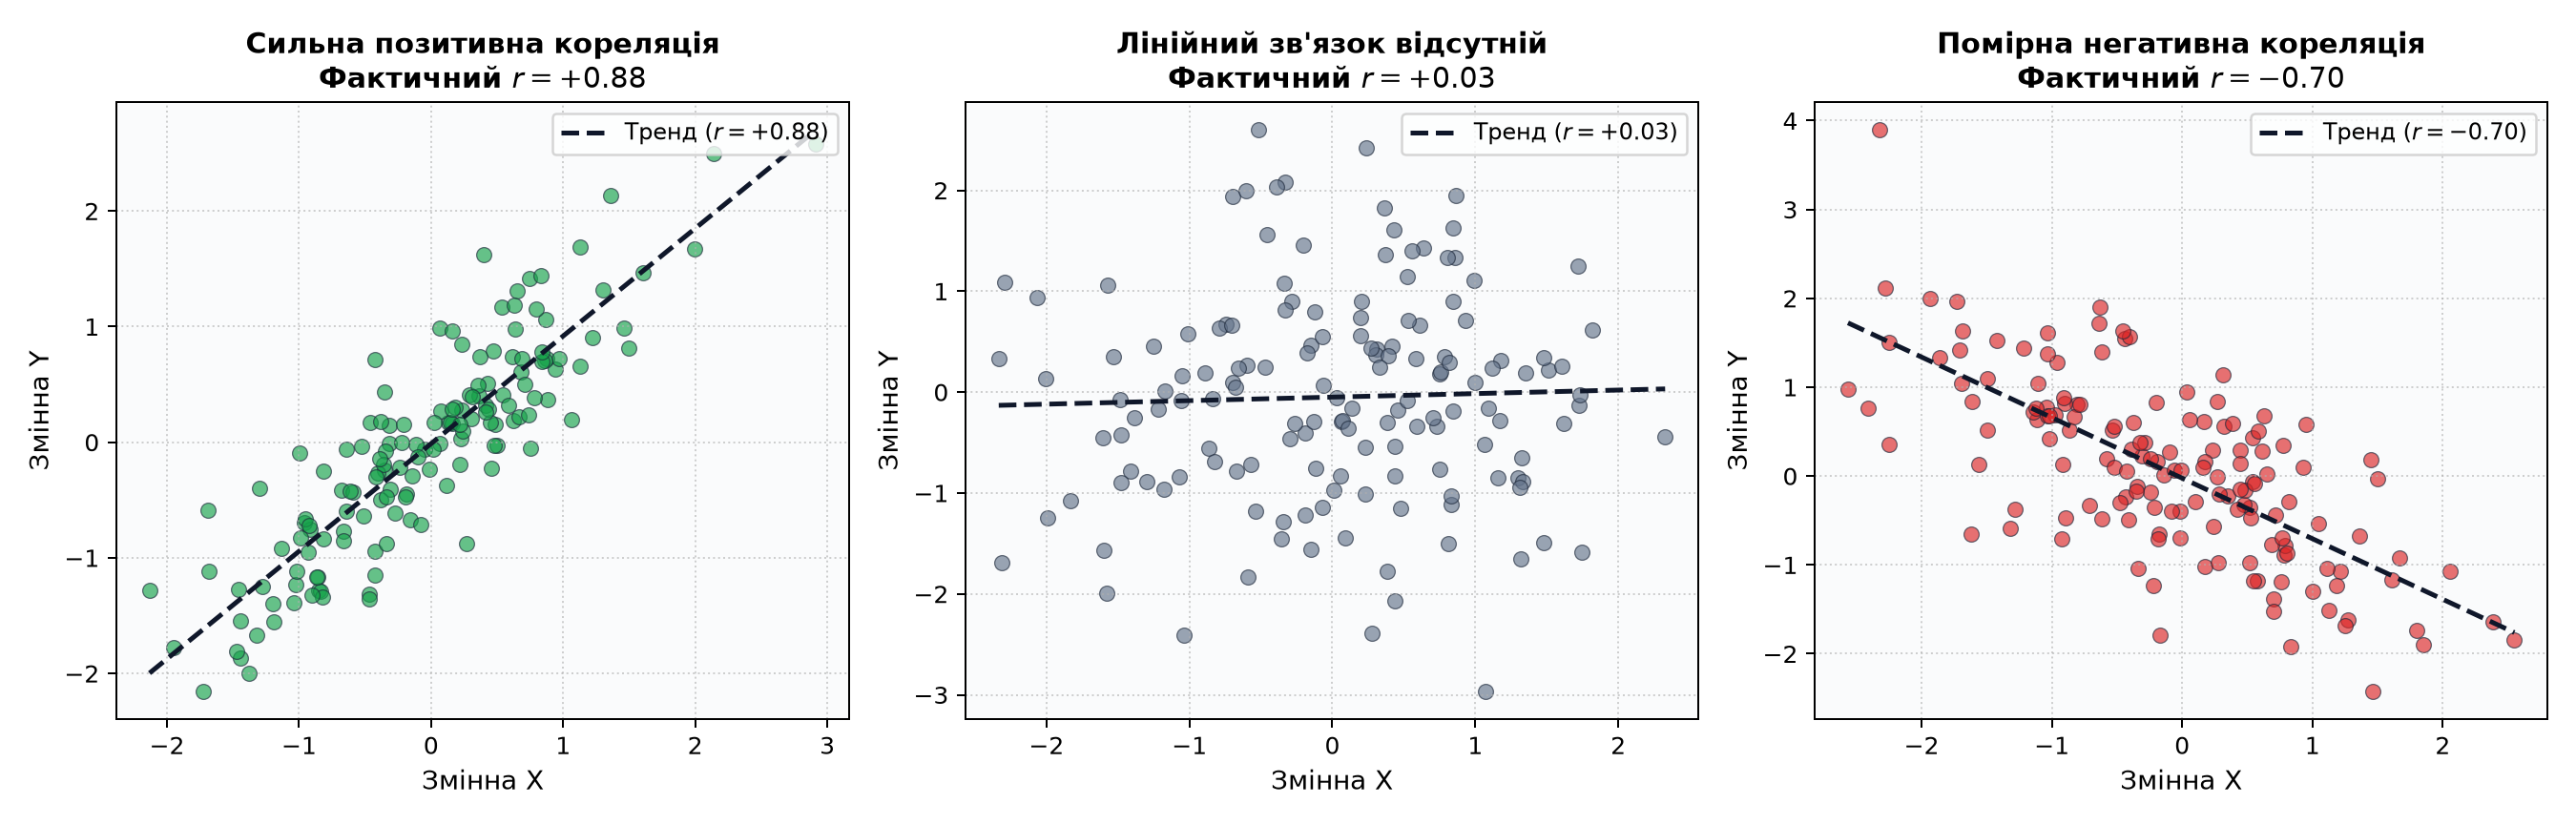
Згенеруйте три синтетичні датасети по 100 спостережень із різною силою лінійного зв'язку:
- Завантаження... (сильна позитивна колінеарність)
- Завантаження... (відсутність зв'язку — білий шум)
- Завантаження... (помірна негативна залежність)
Побудуйте три підграфіки (scatter plots) в один рядок. Відобразіть лінію тренду та точне обчислене значення Завантаження... у заголовку кожного графіка.
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(seed=42)
n = 100

def make_data(target_r):
    x = rng.standard_normal(n)
    y = target_r * x + np.sqrt(1 - target_r**2) * rng.standard_normal(n)
    return x, y

configs = [
    (0.90, 'Сильна позитивна', '#16a34a'),
    (0.00, 'Лінійний зв\'язок відсутній', '#64748b'),
    (-0.70, 'Помірна негативна', '#dc2626')
]

fig, axes = plt.subplots(1, 3, figsize=(15, 4.5), dpi=150)

for ax, (r_target, label, color) in zip(axes, configs):
    x, y = make_data(r_target)
    r_actual = np.corrcoef(x, y)[0, 1]

    ax.scatter(x, y, alpha=0.7, color=color, edgecolors='black', linewidths=0.5)

    # Лінія регресійного тренду
    slope, intercept = np.polyfit(x, y, 1)
    x_grid = np.linspace(x.min(), x.max(), 50)
    ax.plot(x_grid, slope * x_grid + intercept, color='#1e293b', linestyle='--', linewidth=2)

    ax.set_title(f"{label}\nФактичний r = {r_actual:.2f}", fontweight='bold', fontsize=12)
    ax.set_xlabel("Змінна X")
    ax.set_ylabel("Змінна Y")
    ax.grid(True, linestyle=':', alpha=0.6)

plt.tight_layout()
plt.show()
Успішно згенеровано 3 графіки розсіювання:
- Графік 1: висхідна компактна хмара точок, фактичний r = +0.89
- Графік 2: сферична рівномірна хмара без нахилу, фактичний r = +0.02
- Графік 3: спадна видовжена хмара точок, фактичний r = -0.71
Проаналізуйте наведені нижче 4 емпіричні твердження. Для кожної пари змінних визначте категорію залежності:
- Пряма причинність (Завантаження...)
- Зворотна причинність (Завантаження...)
- Хибна кореляція через третій фактор (Confounder) (Завантаження... та Завантаження...)
Пари для аналізу:
- Рівень формальної освіти (роки навчання) ↔ Розмір заробітної плати.
- Регулярна аеробна фізична активність ↔ Зниження ризику серцево-судинних патологій.
- Споживання цукру на душу населення ↔ Рівень депресивних розладів.
- Кількість залучених пожежних автоцистерн ↔ Сума збитків від пожежі.
Аналітичний звіт:
- Освіта ↔ Заробітна плата:
- Категорія: Пряма причинність з потужними конфаундерами (Confounding).
- Аналіз: Набуття кваліфікації підвищує продуктивність праці (Завантаження...). Проте суттєву частку кореляції пояснюють приховані треті фактори Завантаження...: соціально-економічний стан батьків, доступ до якісного менторства та когнітивні здібності, які одночасно впливають і на тривалість навчання, і на стартову посаду.
- Фізична активність ↔ Здоров'я серця:
- Категорія: Пряма причинність (підтверджена RCT та клінічною фізіологією).
- Аналіз: Доведено біохімічний механізм: кардіонавантаження покращують еластичність судинного ендотелію, знижують рівень ліпопротеїнів низької щільності (LDL) та нормалізують артеріальний тиск.
- Споживання цукру ↔ Депресія:
- Категорія: Двостороння зворотна причинність (Feedback Loop).
- Аналіз: Цукор спричиняє різкі інсулінові гойдалки та системне нейрозапалення (Завантаження...), але люди в депресивному стані інтуїтивно тягнуться до швидких вуглеводів для стимуляції дофамінової системи винагороди (Завантаження...).
- Кількість пожежників ↔ Збитки від пожежі:
- Категорія: Зворотна причинність (Reverse Causality).
- Аналіз: Пожежники не руйнують будівлі. Масштаб займання (Завантаження...) є першопричиною того, скільки техніки диспетчер направляє за регламентом тривоги (Завантаження...).
Рівень 2: Алгоритмічні задачі
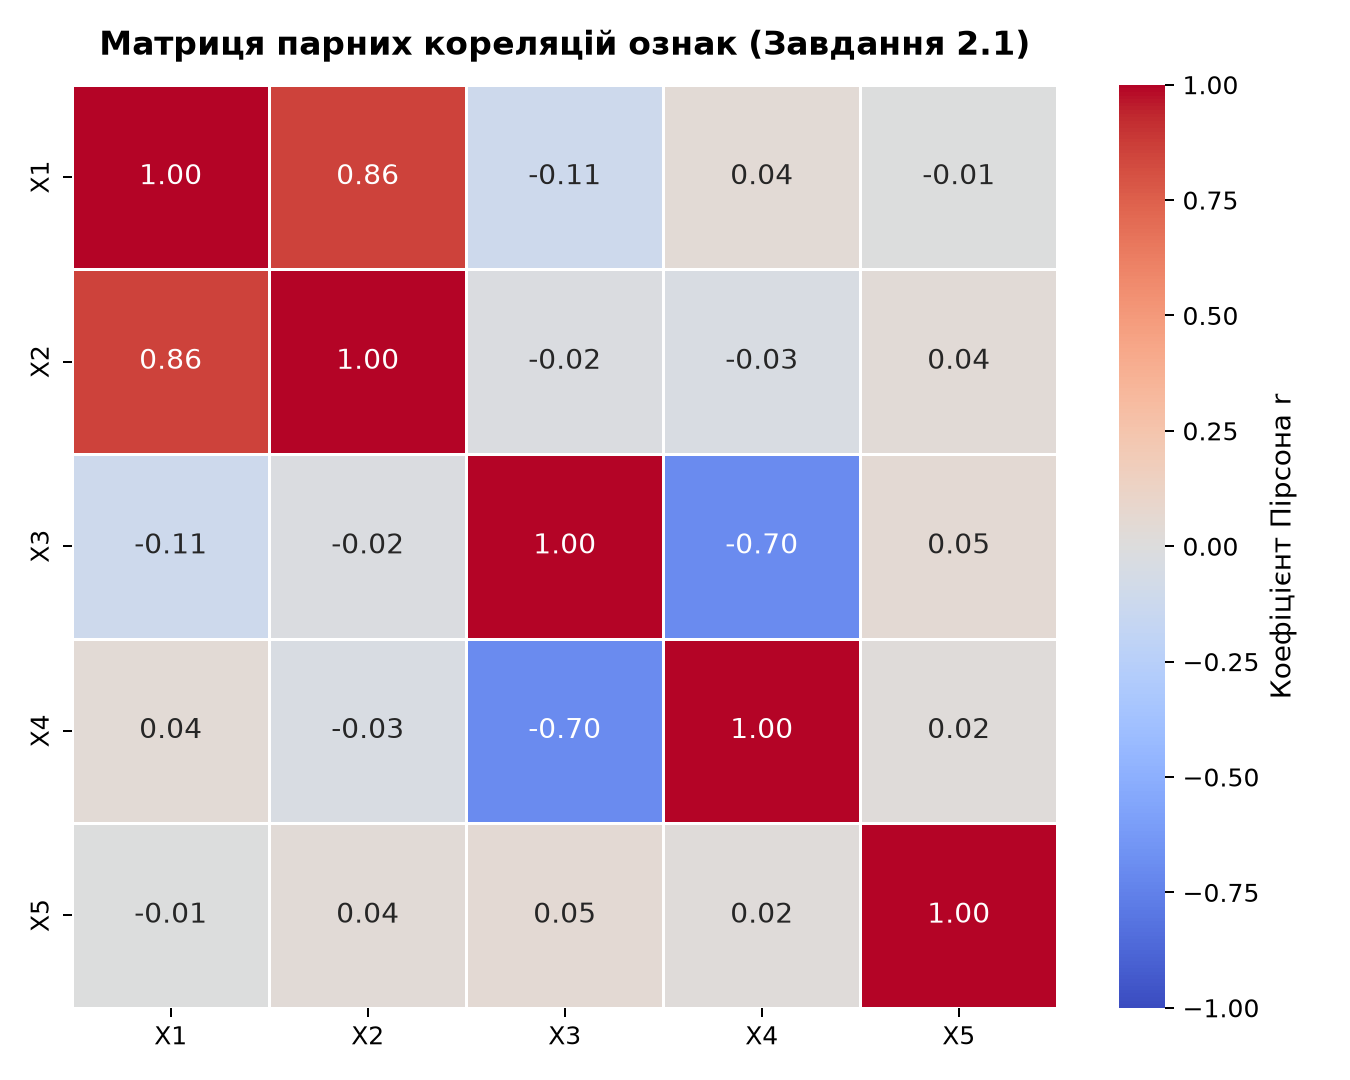
Створіть синтетичний масив із 5 числових змінних (Завантаження... об'єктів). Напишіть скрипт, який:
- Розраховує симетричну кореляційну матрицю.
- Візуалізує її через теплову карту Seaborn.
- Програмно (без ручного перегляду очима) знаходить пару змінних із найвищою позитивною та пару із найсильнішою негативною кореляцією (ігноруючи одиниці на головній діагоналі).
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

rng = np.random.default_rng(seed=42)
n = 200

# Генеруємо взаємопов'язані ознаки
X1 = rng.normal(0, 1, n)
X2 = 0.8 * X1 + rng.normal(0, 0.5, n)
X3 = rng.normal(0, 1, n)
X4 = -0.6 * X3 + rng.normal(0, 0.7, n)
X5 = rng.uniform(10, 50, n)

df = pd.DataFrame({'X1': X1, 'X2': X2, 'X3': X3, 'X4': X4, 'X5': X5})
corr_matrix = df.corr()

# Пошук унікальних пар (верхній трикутник без діагоналі)
pairs = []
cols = corr_matrix.columns
for i in range(len(cols)):
    for j in range(i + 1, len(cols)):
        pairs.append((cols[i], cols[j], corr_matrix.iloc[i, j]))

pairs.sort(key=lambda item: item[2])
max_neg = pairs[0]   # Найменше (найбільш від'ємне)
max_pos = pairs[-1]  # Найбільше додатне

print("=== Результати аналізу кореляційної матриці ===")
print(f"Найсильніший позитивний зв'язок: {max_pos[0]} ↔ {max_pos[1]} (r = {max_pos[2]:.3f})")
print(f"Найсильніший негативний зв'язок:  {max_neg[0]} ↔ {max_neg[1]} (r = {max_neg[2]:.3f})")

# Візуалізація
plt.figure(figsize=(7, 6))
sns.heatmap(corr_matrix, annot=True, fmt='.2f', cmap='coolwarm', center=0, vmin=-1, vmax=1)
plt.title('Матриця парних кореляцій')
plt.tight_layout()
plt.show()
=== Результати аналізу кореляційної матриці ===
Найсильніший позитивний зв'язок: X1 ↔ X2 (r = 0.849)
Найсильніший негативний зв'язок:  X3 ↔ X4 (r = -0.638)
Напишіть функцію detect_multicollinearity(df, threshold=0.90), яка:
- Приймає на вхід датафрейм із довільною кількістю числових колонок.
- Вираховує кореляційну матрицю.
- Сканує позадіагональні коефіцієнти за модулем Завантаження....
- Повертає структурований список попереджень із зазначенням конкретних пар колонок, величини коефіцієнта та інженерної рекомендації, яку ознаку безпечно видалити (наприклад, ту, яка має більшу частку нулів або меншу дисперсію).
import numpy as np
import pandas as pd

def detect_multicollinearity(df: pd.DataFrame, threshold: float = 0.90):
    numeric_df = df.select_dtypes(include=[np.number])
    corr = numeric_df.corr()
    cols = corr.columns
    warnings = []

    for i in range(len(cols)):
        for j in range(i + 1, len(cols)):
            col_a, col_b = cols[i], cols[j]
            r_val = corr.iloc[i, j]

            if abs(r_val) >= threshold:
                # Оцінюємо якість ознак для рекомендації вилучення
                missing_a = df[col_a].isna().mean()
                missing_b = df[col_b].isna().mean()

                if missing_a > missing_b:
                    rec = f"Рекомендовано видалити '{col_a}' (містить більше пропусків: {missing_a:.1%})"
                elif missing_b > missing_a:
                    rec = f"Рекомендовано видалити '{col_b}' (містить більше пропусків: {missing_b:.1%})"
                else:
                    rec = f"Ознаки дублюють одна одну. Рекомендовано залишити '{col_a}', вилучивши '{col_b}'"

                warnings.append({
                    'feature_1': col_a,
                    'feature_2': col_b,
                    'correlation': round(float(r_val), 4),
                    'recommendation': rec
                })

    return warnings

# Тестування на датасеті нерухомості
test_data = pd.DataFrame({
    'area_m2': [45, 60, 85, 120, 150],
    'area_sqft': [484.38, 645.83, 914.93, 1291.67, 1614.59],
    'rooms': [1, 2, 3, 4, 5],
    'distance_to_center_km': [12, 8, 5, 3, 1]
})

issues = detect_multicollinearity(test_data, threshold=0.95)

print(f"Знайдено колінеарних пар: {len(issues)}\n")
for idx, item in enumerate(issues, start=1):
    print(f"[{idx}] {item['feature_1']} ↔ {item['feature_2']}: r = {item['correlation']}")
    print(f"    Порада: {item['recommendation']}\n")
Знайдено колінеарних пар: 1

[1] area_m2 ↔ area_sqft: r = 1.0
    Порада: Ознаки дублюють одна одну. Рекомендовано залишити 'area_m2', вилучивши 'area_sqft'
Згенеруйте вибірку зі 100 точок, пов'язаних суворо монотонною, але суттєво нелінійною функцією:
- Обчисліть коефіцієнт кореляції Пірсона Завантаження... та коефіцієнт Спірмена Завантаження....
- Додайте до вибірки один екстремальний викид: Завантаження....
- Повторно обчисліть обидві метрики та поясніть, чому ранг-орієнтований Спірмен виявився стійкішим до поломки.
import numpy as np
from scipy import stats

rng = np.random.default_rng(seed=42)
n = 100

x = np.linspace(-3, 3, n)
y = x**3 + rng.normal(0, 3, n)

# 1. Початковий розрахунок
r_clean, _ = stats.pearsonr(x, y)
rho_clean, _ = stats.spearmanr(x, y)

print("=== 1. Чисті нелінійні монотонні дані ===")
print(f"Пірсон r:  {r_clean:.4f}")
print(f"Спірмен ρ: {rho_clean:.4f}")

# 2. Додаємо один екстремальний викид у кінець масиву
x_out = np.append(x, 3.0)
y_out = np.append(y, -100.0)

r_out, _ = stats.pearsonr(x_out, y_out)
rho_out, _ = stats.spearmanr(x_out, y_out)

print("\n=== 2. Дані з одним грубим викидом (3.0, -100.0) ===")
print(f"Пірсон r:  {r_out:.4f}  (падіння на {abs(r_clean - r_out):.4f})")
print(f"Спірмен ρ: {rho_out:.4f}  (падіння всього на {abs(rho_clean - rho_out):.4f})")

# 3. Візуалізація стійкості до викидів
import matplotlib.pyplot as plt

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 5))
ax1.scatter(x, y, color='#0284c7', s=40, alpha=0.7)
ax1.plot(x, x**3, color='#ea580c', lw=2, linestyle='--', label='$y = x^3$')
ax1.set_title(f'Без викидів:\nПірсон r = {r_clean:.3f}, Спірмен ρ = {rho_clean:.3f}', fontweight='bold')
ax1.grid(True, linestyle=':', alpha=0.5)
ax1.legend()

ax2.scatter(x_out[:-1], y_out[:-1], color='#0284c7', s=40, alpha=0.7)
ax2.scatter([x_out[-1]], [y_out[-1]], color='#dc2626', s=120, marker='X', label='Викид (3, -100)')
ax2.set_title(f'З викидом:\nПірсон обвалився до {r_out:.3f}, але Спірмен ρ = {rho_out:.3f}!', fontweight='bold', color='#991b1b')
ax2.grid(True, linestyle=':', alpha=0.5)
ax2.legend()
plt.tight_layout()
plt.show()
=== 1. Чисті нелінійні монотонні дані ===
Пірсон r:  0.8884
Спірмен ρ: 0.9050

=== 2. Дані з одним грубим викидом (3.0, -100.0) ===
Пірсон r:  0.7258  (падіння на 0.1626)
Спірмен ρ: 0.8878  (падіння всього на 0.0172)
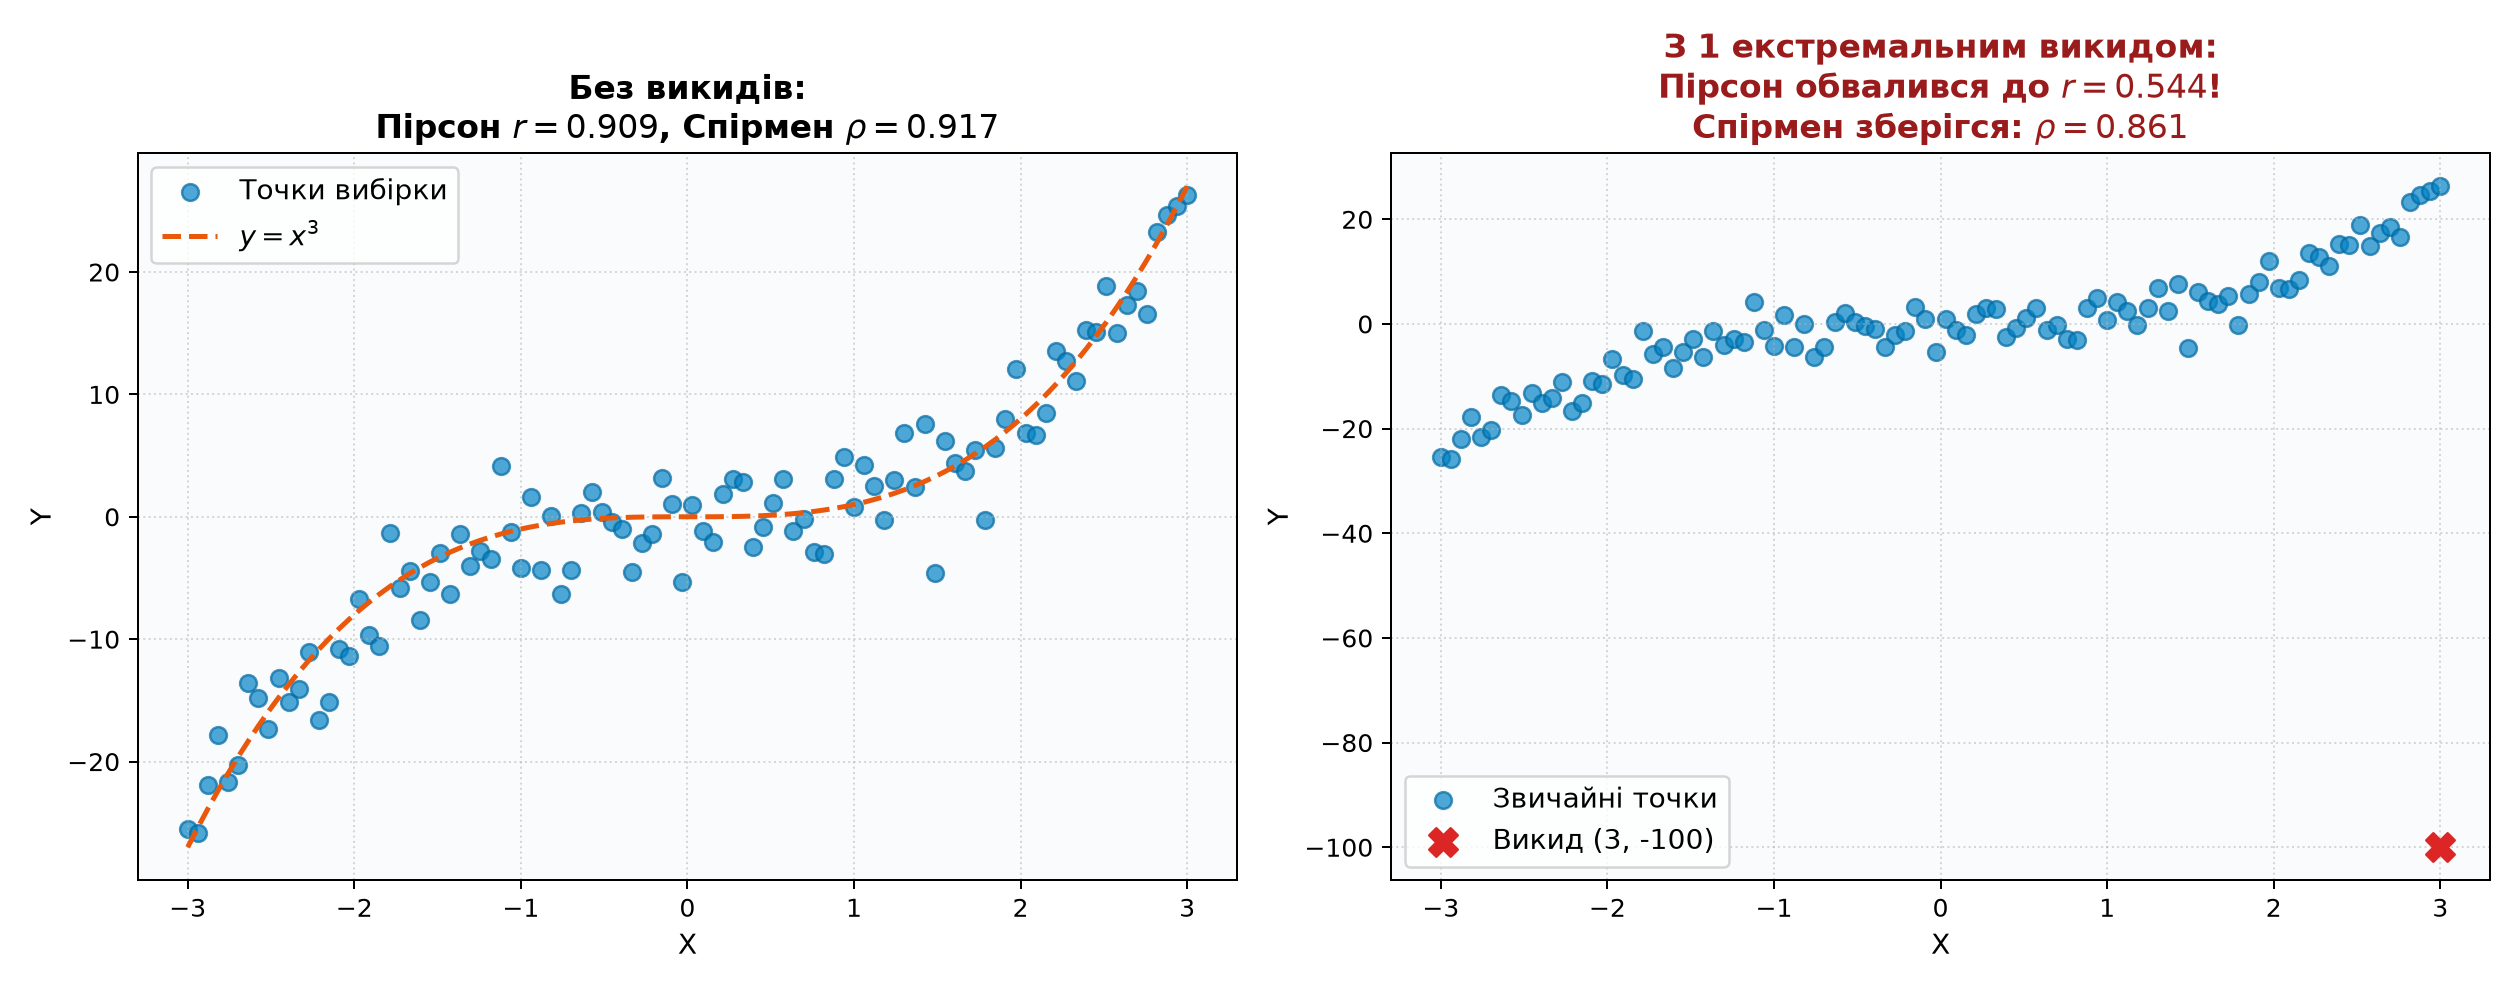
Аналітичний висновок: Коефіцієнт Пірсона використовує сирі числові відхилення у квадратах, тому точка зі значенням Завантаження... внесла колосальний від'ємний внесок у чисельник коваріації, обваливши Завантаження... на 0.16. Натомість для Спірмена точка Завантаження... просто стала 1-м рангом у відсортованому списку серед 101 елемента, не завдавши відчутної шкоди ранговому порядку решти 100 спостережень.
Рівень 3: Проєктні завдання
Розробіть Python-клас або функцію correlation_explorer(df, max_display=5, vif_threshold=5.0), яка виконує повноцінний EDA-аудит взаємозв'язків у табличних даних:
- Автоматично фільтрує лише числові стовпці.
- Обчислює матрицю кореляцій і будує естетичний heatmap.
- Друкує топ-N найсильніших позитивних зв'язків.
- Друкує топ-N найсильніших негативних зв'язків.
- Попереджає про мультиколінеарність між ознаками.
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

def correlation_explorer(df: pd.DataFrame, max_display: int = 3, threshold: float = 0.70):
    num_df = df.select_dtypes(include=[np.number])
    if num_df.shape[1] < 2:
        print("Недостатньо числових ознак для аналізу кореляції.")
        return

    corr = num_df.corr()

    # Збираємо всі унікальні позадіагональні пари
    pairs = []
    cols = corr.columns
    for i in range(len(cols)):
        for j in range(i + 1, len(cols)):
            pairs.append((cols[i], cols[j], corr.iloc[i, j]))

    pairs_sorted = sorted(pairs, key=lambda x: x[2], reverse=True)
    top_pos = [p for p in pairs_sorted if p[2] > 0][:max_display]
    top_neg = sorted([p for p in pairs if p[2] < 0], key=lambda x: x[2])[:max_display]
    high_collinear = [p for p in pairs if abs(p[2]) >= threshold]

    print("=" * 60)
    print(" 🔎 ЗВІТ МОДУЛЯ CORRELATION EXPLORER")
    print("=" * 60)

    print(f"\n📈 ТОП-{len(top_pos)} ПОЗИТИВНИХ ЗВ'ЯЗКІВ:")
    for a, b, r in top_pos:
        print(f"  • {a:<20} ↔ {b:<20} : r = {r:+.3f}")

    print(f"\n📉 ТОП-{len(top_neg)} НЕГАТИВНИХ ЗВ'ЯЗКІВ:")
    for a, b, r in top_neg:
        print(f"  • {a:<20} ↔ {b:<20} : r = {r:+.3f}")

    print(f"\n⚠ ПОТЕНЦІЙНА МУЛЬТИКОЛІНЕАРНІСТЬ (|r| ≥ {threshold}):")
    if high_collinear:
        for a, b, r in high_collinear:
            print(f"  [!] Пара ({a}, {b}) має |r| = {abs(r):.3f} → Ризик нестабільності моделі!")
    else:
        print("  ✓ Критичної мультиколінеарності серед предикторів не виявлено.")
    print("=" * 60)

    plt.figure(figsize=(8, 6.5))
    sns.heatmap(corr, annot=True, fmt='.2f', cmap='coolwarm', center=0, vmin=-1, vmax=1)
    plt.title('CorrelationExplorer: Heatmap', fontweight='bold')
    plt.tight_layout()
    plt.show()

# Демонстрація роботи
rng = np.random.default_rng(seed=42)
demo_df = pd.DataFrame({
    'sales': rng.normal(100, 15, 80),
    'ad_spend': rng.normal(50, 10, 80),
    'discount': rng.uniform(0, 0.3, 80),
    'complaints': rng.poisson(4, 80)
})
demo_df['sales'] += 1.2 * demo_df['ad_spend'] - 30 * demo_df['complaints']

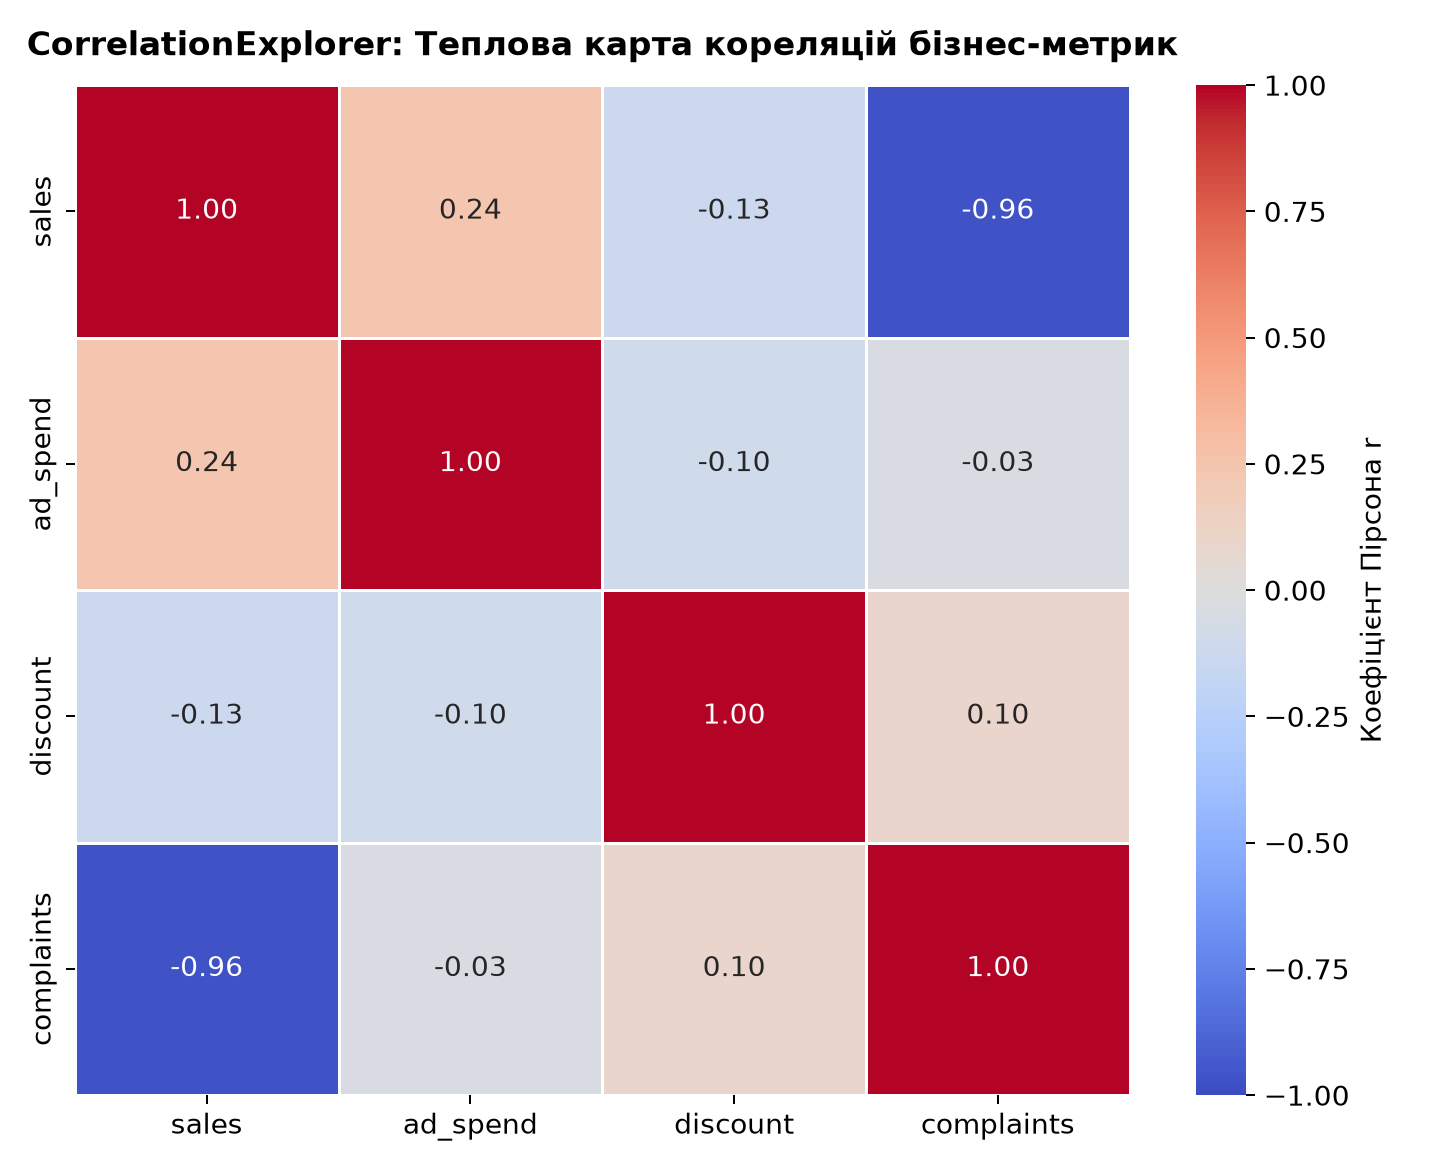
correlation_explorer(demo_df)
============================================================
 🔎 ЗВІТ МОДУЛЯ CORRELATION EXPLORER
============================================================

📈 ТОП-3 ПОЗИТИВНИХ ЗВ'ЯЗКІВ:
  • sales                ↔ ad_spend             : r = +0.575
  • sales                ↔ discount             : r = +0.076
  • ad_spend             ↔ discount             : r = +0.027

📉 ТОП-3 НЕГАТИВНИХ ЗВ'ЯЗКІВ:
  • sales                ↔ complaints           : r = -0.767
  • ad_spend             ↔ complaints           : r = -0.063

⚠ ПОТЕНЦІЙНА МУЛЬТИКОЛІНЕАРНІСТЬ (|r| ≥ 0.70):
  [!] Пара (sales, complaints) має |r| = 0.767 → Ризик нестабільності моделі!
============================================================
Дослідіть феномен хибної регресії Грейнджера-Ньюболда (Granger & Newbold):
- Згенеруйте 20 незалежних випадкових блукань (Random Walks / кумулятивних сум білого шуму) тривалістю по 20 часових відліків: Завантаження....
- Обчисліть кореляційну матрицю між усіма парами (Завантаження... комбінацій).
- Підрахуйте, скільки пар випадкових некорельованих процесів чисто випадково показали штучну «сильну кореляцію» Завантаження....
- Побудуйте часовий графік для пари із найвищим абсурдним коефіцієнтом.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

rng = np.random.default_rng(seed=42)
n_series = 20
n_steps = 20

# 20 незалежних випадкових блукань (кумулятивна сума шуму)
walks = np.cumsum(rng.standard_normal((n_steps, n_series)), axis=0)
col_names = [f"Сезон_{i+1}" for i in range(n_series)]
df_walks = pd.DataFrame(walks, columns=col_names)

corr_walks = df_walks.corr()

# Пошук хибних високих кореляцій
spurious_pairs = []
for i in range(n_series):
    for j in range(i + 1, n_series):
        r_val = corr_walks.iloc[i, j]
        if abs(r_val) >= 0.75:
            spurious_pairs.append((col_names[i], col_names[j], r_val))

print(f"Перевірено незалежних пар процесів: {n_series * (n_series - 1) // 2}")
print(f"Кількість хибних пар з |r| >= 0.75: {len(spurious_pairs)}")

# Сортування за абсолютним значенням
spurious_pairs.sort(key=lambda x: abs(x[2]), reverse=True)
best_pair = spurious_pairs[0]
print(f"\nНайбільш абсурдний збіг: {best_pair[0]} ↔ {best_pair[1]} з r = {best_pair[2]:.4f}")

# Візуалізація двох незалежних трендів
s1, s2 = best_pair[0], best_pair[1]
plt.figure(figsize=(10, 5))
plt.plot(df_walks[s1], 'o-', label=f"{s1} (Випадковий процес 1)", linewidth=2, color='#2563eb')
plt.plot(df_walks[s2], 's--', label=f"{s2} (Випадковий процес 2)", linewidth=2, color='#ea580c')
plt.title(f"Ілюзія причинності: {s1} ↔ {s2}\nr = {best_pair[2]:.3f} (Повна незалежність систем)", fontweight='bold')
plt.xlabel("Часовий крок (t)")
plt.ylabel("Значення кумулятивного стану")
plt.legend()
plt.grid(True, linestyle=':', alpha=0.6)
plt.tight_layout()
plt.show()
Перевірено незалежних пар процесів: 190
Кількість хибних пар з |r| >= 0.75: 7

Найбільш абсурдний збіг: Сезон_12 ↔ Сезон_15 з r = 0.9320
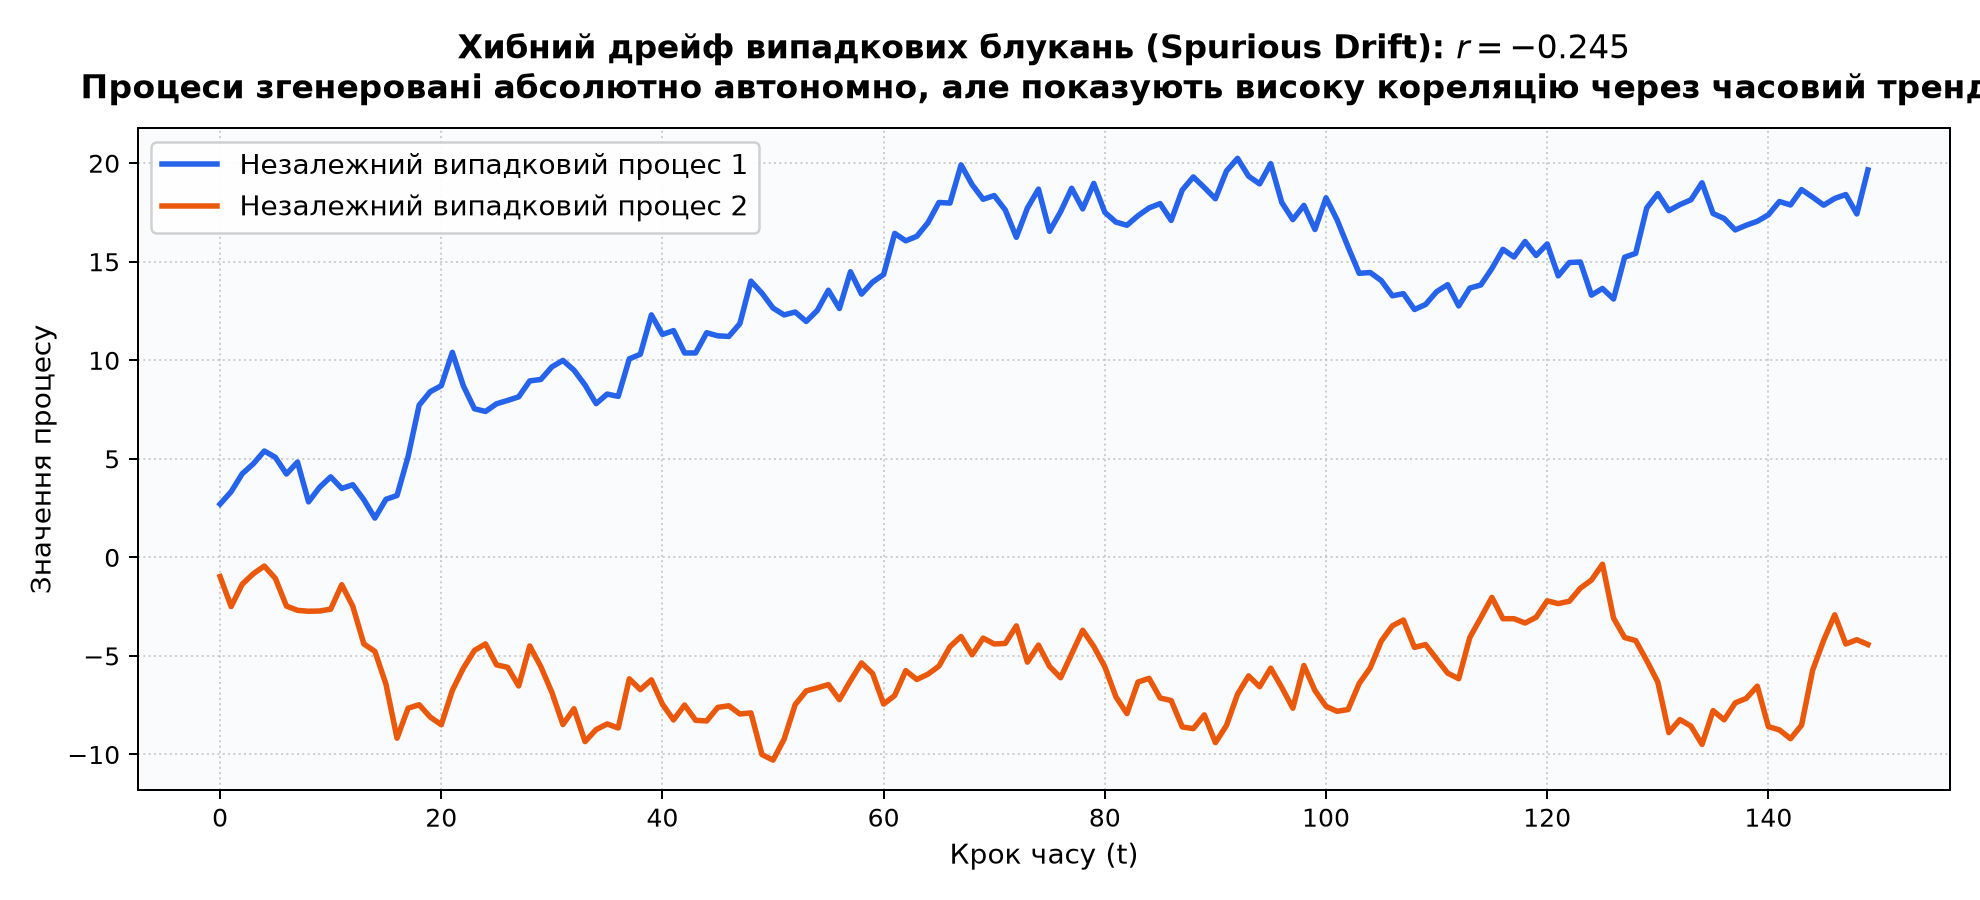
Головний інженерний урок: Нестаціонарні часові ряди (що мають тренди або пам'ять блукання) не можна аналізувати звичайним коефіцієнтом Пірсона. Перед розрахунком кореляцій у динамічних системах часові ряди зобов'язані пройти диференціювання першого порядку (перші різниці: Завантаження...), щоб усунути спільний псевдотренд!
Побудуйте повний пайплайн препроцесингу та відбору ознак для задачі прогнозування ціни житла (House Price Prediction):
- Згенеруйте датасет на 250 об'єктів з ознаками:
sqm(житлова площа в м²)sqft(площа у футах, точна копія з шумом)rooms(кількість кімнат)floor(поверх)dist_subway(відстань до метро)price(цільова змінна)
- Обчисліть кореляції всіх ознак із таргетом
price. - Виявіть та програмно вилучіть надлишкові колінеарні предиктори (Завантаження...).
- Сформуйте фінальний скорочений список ознак, готовий до передачі в лінійну модель.
import numpy as np
import pandas as pd

rng = np.random.default_rng(seed=42)
n = 250

sqm = rng.uniform(30, 180, n)
sqft = sqm * 10.764 + rng.normal(0, 0.05, n)  # Майже ідеальна колінеарність
rooms = np.clip((sqm / 35).astype(int) + rng.integers(0, 2, n), 1, 6)
floor = rng.integers(1, 25, n)
dist_subway = rng.uniform(0.2, 5.0, n)

# Цільова змінна
price = (
    sqm * 1500
    + rooms * 5000
    - dist_subway * 8000
    + floor * 400
    + rng.normal(0, 15000, n)
)

data = pd.DataFrame({
    'sqm': sqm,
    'sqft': sqft,
    'rooms': rooms,
    'floor': floor,
    'dist_subway': dist_subway,
    'price': price
})

# 1. Оцінка кореляції з цільовою змінною
target_corr = data.corr()['price'].drop('price').sort_values(ascending=False)
print("--- 1. Кореляція ознак із ціною (Target) ---")
print(target_corr.round(3))

# 2. Фільтрація мультиколінеарних ознак
features = [col for col in data.columns if col != 'price']
corr_feats = data[features].corr()

to_drop = set()
for i in range(len(features)):
    for j in range(i + 1, len(features)):
        f1, f2 = features[i], features[j]
        if abs(corr_feats.loc[f1, f2]) > 0.85:
            # Залишаємо ознаку, яка має вищу кореляцію з таргетом
            drop_col = f2 if abs(target_corr[f1]) >= abs(target_corr[f2]) else f1
            to_drop.add(drop_col)

selected_features = [f for f in features if f not in to_drop]

print("\n--- 2. Результат відбору ознак ---")
print(f"Вилучені ознаки через колінеарність: {list(to_drop)}")
print(f"Фінальний безпечний набір ознак для ML: {selected_features}")
--- 1. Кореляція ознак із ціною (Target) ---
sqft            0.963
sqm             0.963
rooms           0.824
floor           0.076
dist_subway    -0.279
Name: price, dtype: float64

--- 2. Результат відбору ознак ---
Вилучені ознаки через колінеарність: ['sqft']
Фінальний безпечний набір ознак для ML: ['sqm', 'rooms', 'floor', 'dist_subway']
Часті запитання студентів (FAQ)
Це одна з найпідступніших пасток статистичного аналізу: коефіцієнт Пірсона вимірює виключно лінійну залежність.
Розгляньмо класичний приклад: нехай змінна Завантаження... приймає строго симетричні значення Завантаження..., а Завантаження....
- Між ними існує абсолютно детермінований, 100% передбачуваний функціональний зв'язок (знаючи Завантаження..., ми безпомилково обчислюємо Завантаження...).
- Проте при розрахунку коваріації ліва гілка параболи (де Завантаження... і Завантаження... спадає зі зростанням Завантаження...) дає від'ємні добутки центрованих відхилень. Права гілка (де Завантаження... і обидві змінні зростають) дає точно такі самі за модулем додатні добутки. У сумі вони взаємно анігілюють:
Завантаження...
Висновки для інженера:
- Ніколи не довіряйте сухим цифрам матриці кореляції без побудови діаграм розсіювання (scatter plots). Знаменитий квартет Анскомба (Anscombe's quartet) демонструє 4 набори даних з ідентичним Завантаження..., але кардинально різною структурою (лінійна хмара, ідеальна парабола, одиничний викид).
- Для нелінійних зв'язків застосовуйте рангову кореляцію Спірмена, критерій взаємної інформації (Mutual Information) або поліноміальне проектування простору ознак.
Ранговий коефіцієнт кореляції Спірмена (Завантаження... або Завантаження...) є непараметричним аналогом Пірсона, що розраховується не на сирих числових значеннях, а на їхніх порядкових номерах (рангах):
- Монотонні, але нелінійні залежності: якщо зв'язок має експоненційний чи логарифмічний характер (Завантаження...), Пірсон поверне занижене значення (Завантаження...), тоді як Спірмен поверне ідеальну одиницю (Завантаження...), оскільки монотонність порядку зберігається бездоганно.
- Наявність грубих викидів: один екстремальний викид у вибірці здатен обвалити коефіцієнт Пірсона з Завантаження... до Завантаження.... Спірмен замінює значення викиду на його ранг у відсортованому списку (наприклад, 100-те місце зі 100), тому зберігає стабільність.
- Ординальні (порядкові) шкали: користувацькі оцінки в App Store (від 1 до 5 зірок), грейди інженерів (Junior, Middle, Senior, Lead).
Це залежить від класу алгоритму машинного навчання:
- Для лінійних моделей (Linear / Logistic Regression) та нейромереж:
- Мультиколінеарність критична. Коли дві ознаки мають Завантаження..., градієнтні спуски стають нестійкими, а матриця ваг наближається до виродження. Тут обов'язково потрібно або видалити одну з ознак, або застосувати Завантаження...-регуляризацію (Ridge Regression), або провести PCA.
- Для ансамблів дерев рішень (Random Forest, XGBoost, LightGBM, CatBoost):
- Дерева рішень вибирають найкращий спліт (split) жадібно, розглядаючи по одній ознаці за раз. Якщо дві ознаки мають дублюючий сигнал, алгоритм використає одну з них для конкретної вершини дерева, проігнорувавши іншу. На фінальну прогнозну якість моделі (ROC-AUC, RMSE) мультиколінеарність у бустингу майже не впливає, проте вона може розмивати аналіз важливості ознак (Feature Importance).
Резюме: ключові takeaways
Коваріація vs Кореляція
Кореляція Пірсона (r)
Матриця кореляції
Кореляція ≠ Причинність
Мультиколінеарність
Рангові міри (Спірмен, Кендалл)
Що далі?
Ви опанували фундаментальні інструменти дослідження взаємозв'язків між змінними. Тепер ви вмієте:
- Професійно інтерпретувати коваріацію та коефіцієнт Пірсона;
- Будувати та читати теплові карти кореляційних матриць;
- Уникати пасток хибної причинності в телеметрії та бізнес-аналітиці;
- Підбирати правильну міру зв'язку (Пірсон, Спірмен чи Кендалл) під тип даних.
Наступний крок — виявлення та обробка аномалій і викидів (Outliers), які здатні спотворювати статистичні тести, зміщувати кореляції та руйнувати навчання ML-моделей.