Метрики якості класифікації
Метрики якості класифікації
🎯 Мета підрозділу
- Зрозуміти обмеження метрики Accuracy
- Опанувати Confusion Matrix та її інтерпретацію
- Вивчити метрики Precision, Recall, F1-Score
- Познайомитися з ROC-кривою та AUC
- Навчитися обирати правильну метрику для задачі
- Зрозуміти проблему незбалансованих класів
🔑 Ключові терміни
- Confusion Matrix — матриця помилок класифікації
- Accuracy — загальна точність моделі
- Precision — точність позитивних прогнозів
- Recall (Sensitivity) — повнота виявлення позитивного класу
- F1-Score — гармонійне середнє Precision та Recall
- ROC-AUC — площа під ROC-кривою
Історія про систему виявлення раку
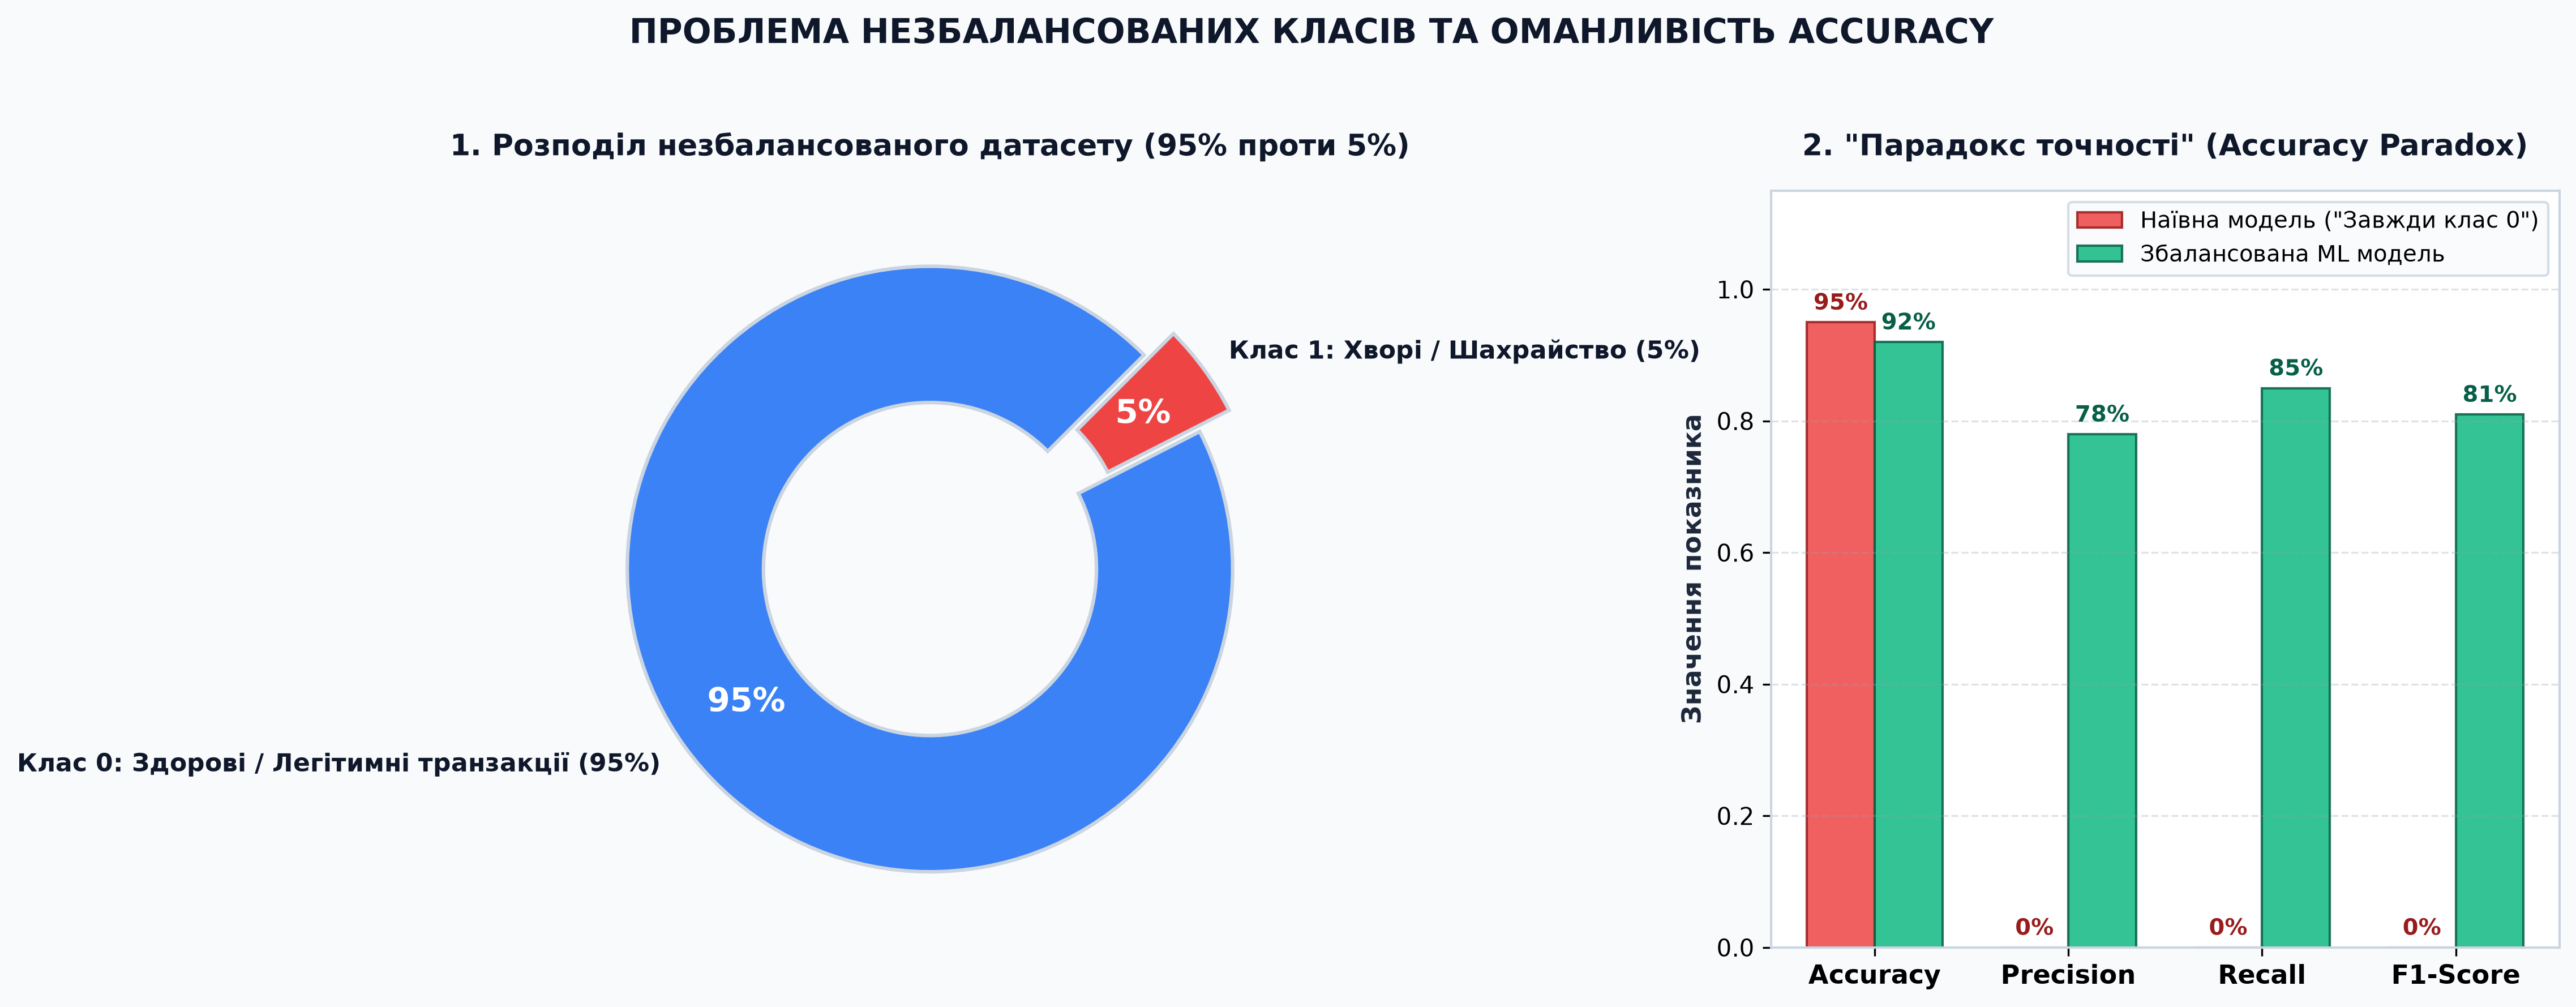
Лікарня розробила AI-систему для автоматичного аналізу рентгенівських знімків грудної клітки з метою раннього виявлення раку легень. Після навчання модель показала 95% точності на тестовій вибірці.
Керівництво лікарні в захваті: "95% — це чудовий результат! Впроваджуємо систему в роботу!"
Але головний онколог доктор Коваль насторожився та попросив детальніший звіт. Виявилося наступне:
📊 Статистика датасету
- Здорові пацієнти: 950 знімків (95%)
- Хворі на рак: 50 знімків (5%)
- Загалом: 1000 знімків
🤖 Поведінка моделі
Модель завжди прогнозує "здоровий" для будь-якого знімка.
Результат: 950 правильних прогнозів з 1000 → 95% accuracy!
⚠️ Критична проблема
Модель не виявила жодного хворого пацієнта!
Усі 50 випадків раку пропущено. Система марна для медичної діагностики.
Що не так з Accuracy?
Accuracy (точність) — це найпростіша та найінтуїтивніша метрика класифікації:
Де:
- TP (True Positive) — правильно передбачені позитивні випадки
- TN (True Negative) — правильно передбачені негативні випадки
- FP (False Positive) — хибнопозитивні (помилково визнані позитивними)
- FN (False Negative) — хибнонегативні (пропущені позитивні випадки)
Проблема 1: Незбалансовані класи
Коли один клас домінує над іншим (наприклад, 95% на 5%), модель може досягти високої accuracy, просто завжди передбачаючи більшинський клас.
import numpy as np
from sklearn.metrics import accuracy_score

# Дані: 950 здорових + 50 хворих
y_true = np.array([0] * 950 + [1] * 50)

# "Розумна" модель: завжди прогнозує клас 0
y_pred_naive = np.zeros(1000)

# "Ідеальна" модель: правильно класифікує всіх
y_pred_perfect = y_true.copy()

# Реальна модель: 90% правильно для кожного класу
y_pred_real = y_true.copy()
# Помиляється у 10% випадків для кожного класу
errors_class_0 = np.random.choice(950, size=95, replace=False)
errors_class_1 = np.random.choice(np.arange(950, 1000), size=5, replace=False)
y_pred_real[errors_class_0] = 1
y_pred_real[errors_class_1] = 0

print("Точність різних моделей:")
print(f"Наївна модель (завжди '0'): {accuracy_score(y_true, y_pred_naive):.1%}")
print(f"Реальна модель (90% для кожного класу): {accuracy_score(y_true, y_pred_real):.1%}")
print(f"Ідеальна модель: {accuracy_score(y_true, y_pred_perfect):.1%}")

import matplotlib.pyplot as plt
from sklearn.metrics import recall_score

names = ['Наївна', 'Реальна', 'Ідеальна']
preds = [y_pred_naive, y_pred_real, y_pred_perfect]
acc = [accuracy_score(y_true, p) for p in preds]
rec = [recall_score(y_true, p) for p in preds]

x = np.arange(len(names))
plt.figure(figsize=(9, 5))
plt.bar(x - 0.2, acc, 0.4, label='Accuracy', color='#3b82f6')
plt.bar(x + 0.2, rec, 0.4, label='Recall (клас "хворий")', color='#ef4444')
for i in range(len(names)):
    plt.text(x[i] - 0.2, acc[i] + 0.02, f'{acc[i]:.0%}', ha='center')
    plt.text(x[i] + 0.2, rec[i] + 0.02, f'{rec[i]:.0%}', ha='center')
plt.xticks(x, names)
plt.ylim(0, 1.15)
plt.title('Accuracy обманює на незбалансованих даних', fontsize=13)
plt.legend()
plt.show()
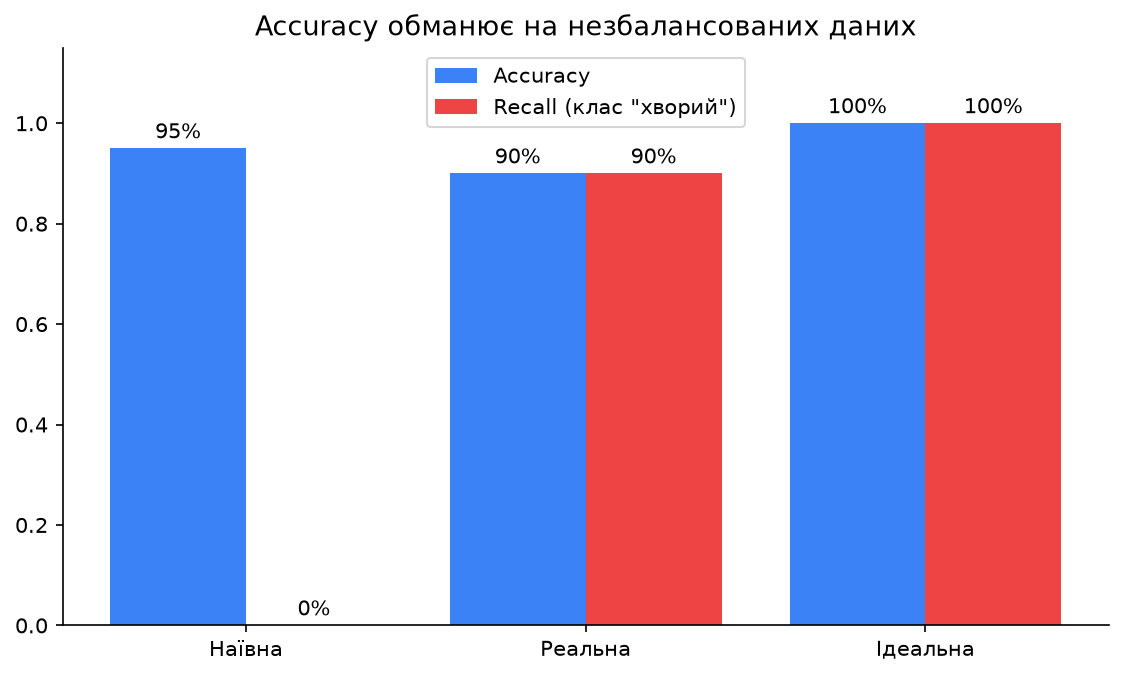
Точність різних моделей:
Наївна модель (завжди '0'): 95.0%
Реальна модель (90% для кожного класу): 90.0%
Ідеальна модель: 100.0%
Проблема 2: Не враховує ціну помилок
У різних задачах помилки мають різну вагу:
| Задача | False Negative (пропустили) | False Positive (хибна тривога) |
|---|---|---|
| Діагностика раку | 💀 Критично (пацієнт не отримає лікування) | ⚠️ Неприємно (зайві обстеження) |
| Детекція спаму | 😐 Трохи дратує (спам у поштовій скриньці) | 😡 Дуже погано (важливий лист втрачено) |
| Виявлення шахрайства | 💸 Втрата грошей | 😕 Незручність для клієнта |
| Прогноз відтоку клієнтів | 📉 Втрата клієнта | 💰 Вартість утримуючих акцій |
Accuracy однаково штрафує за FN та FP, що не відповідає реальності.
- False Negative: пожежа не виявлена, будинок згорів 🔥 → катастрофа!
- False Positive: сигналізація спрацювала без пожежі 🚨 → незручність, але не критично.
Confusion Matrix: матриця помилок
Confusion Matrix (матриця плутанини) — це таблиця, яка детально показує, як саме модель помилялася, розбиваючи всі прогнози на чотири категорії.
Структура матриці для бінарної класифікації
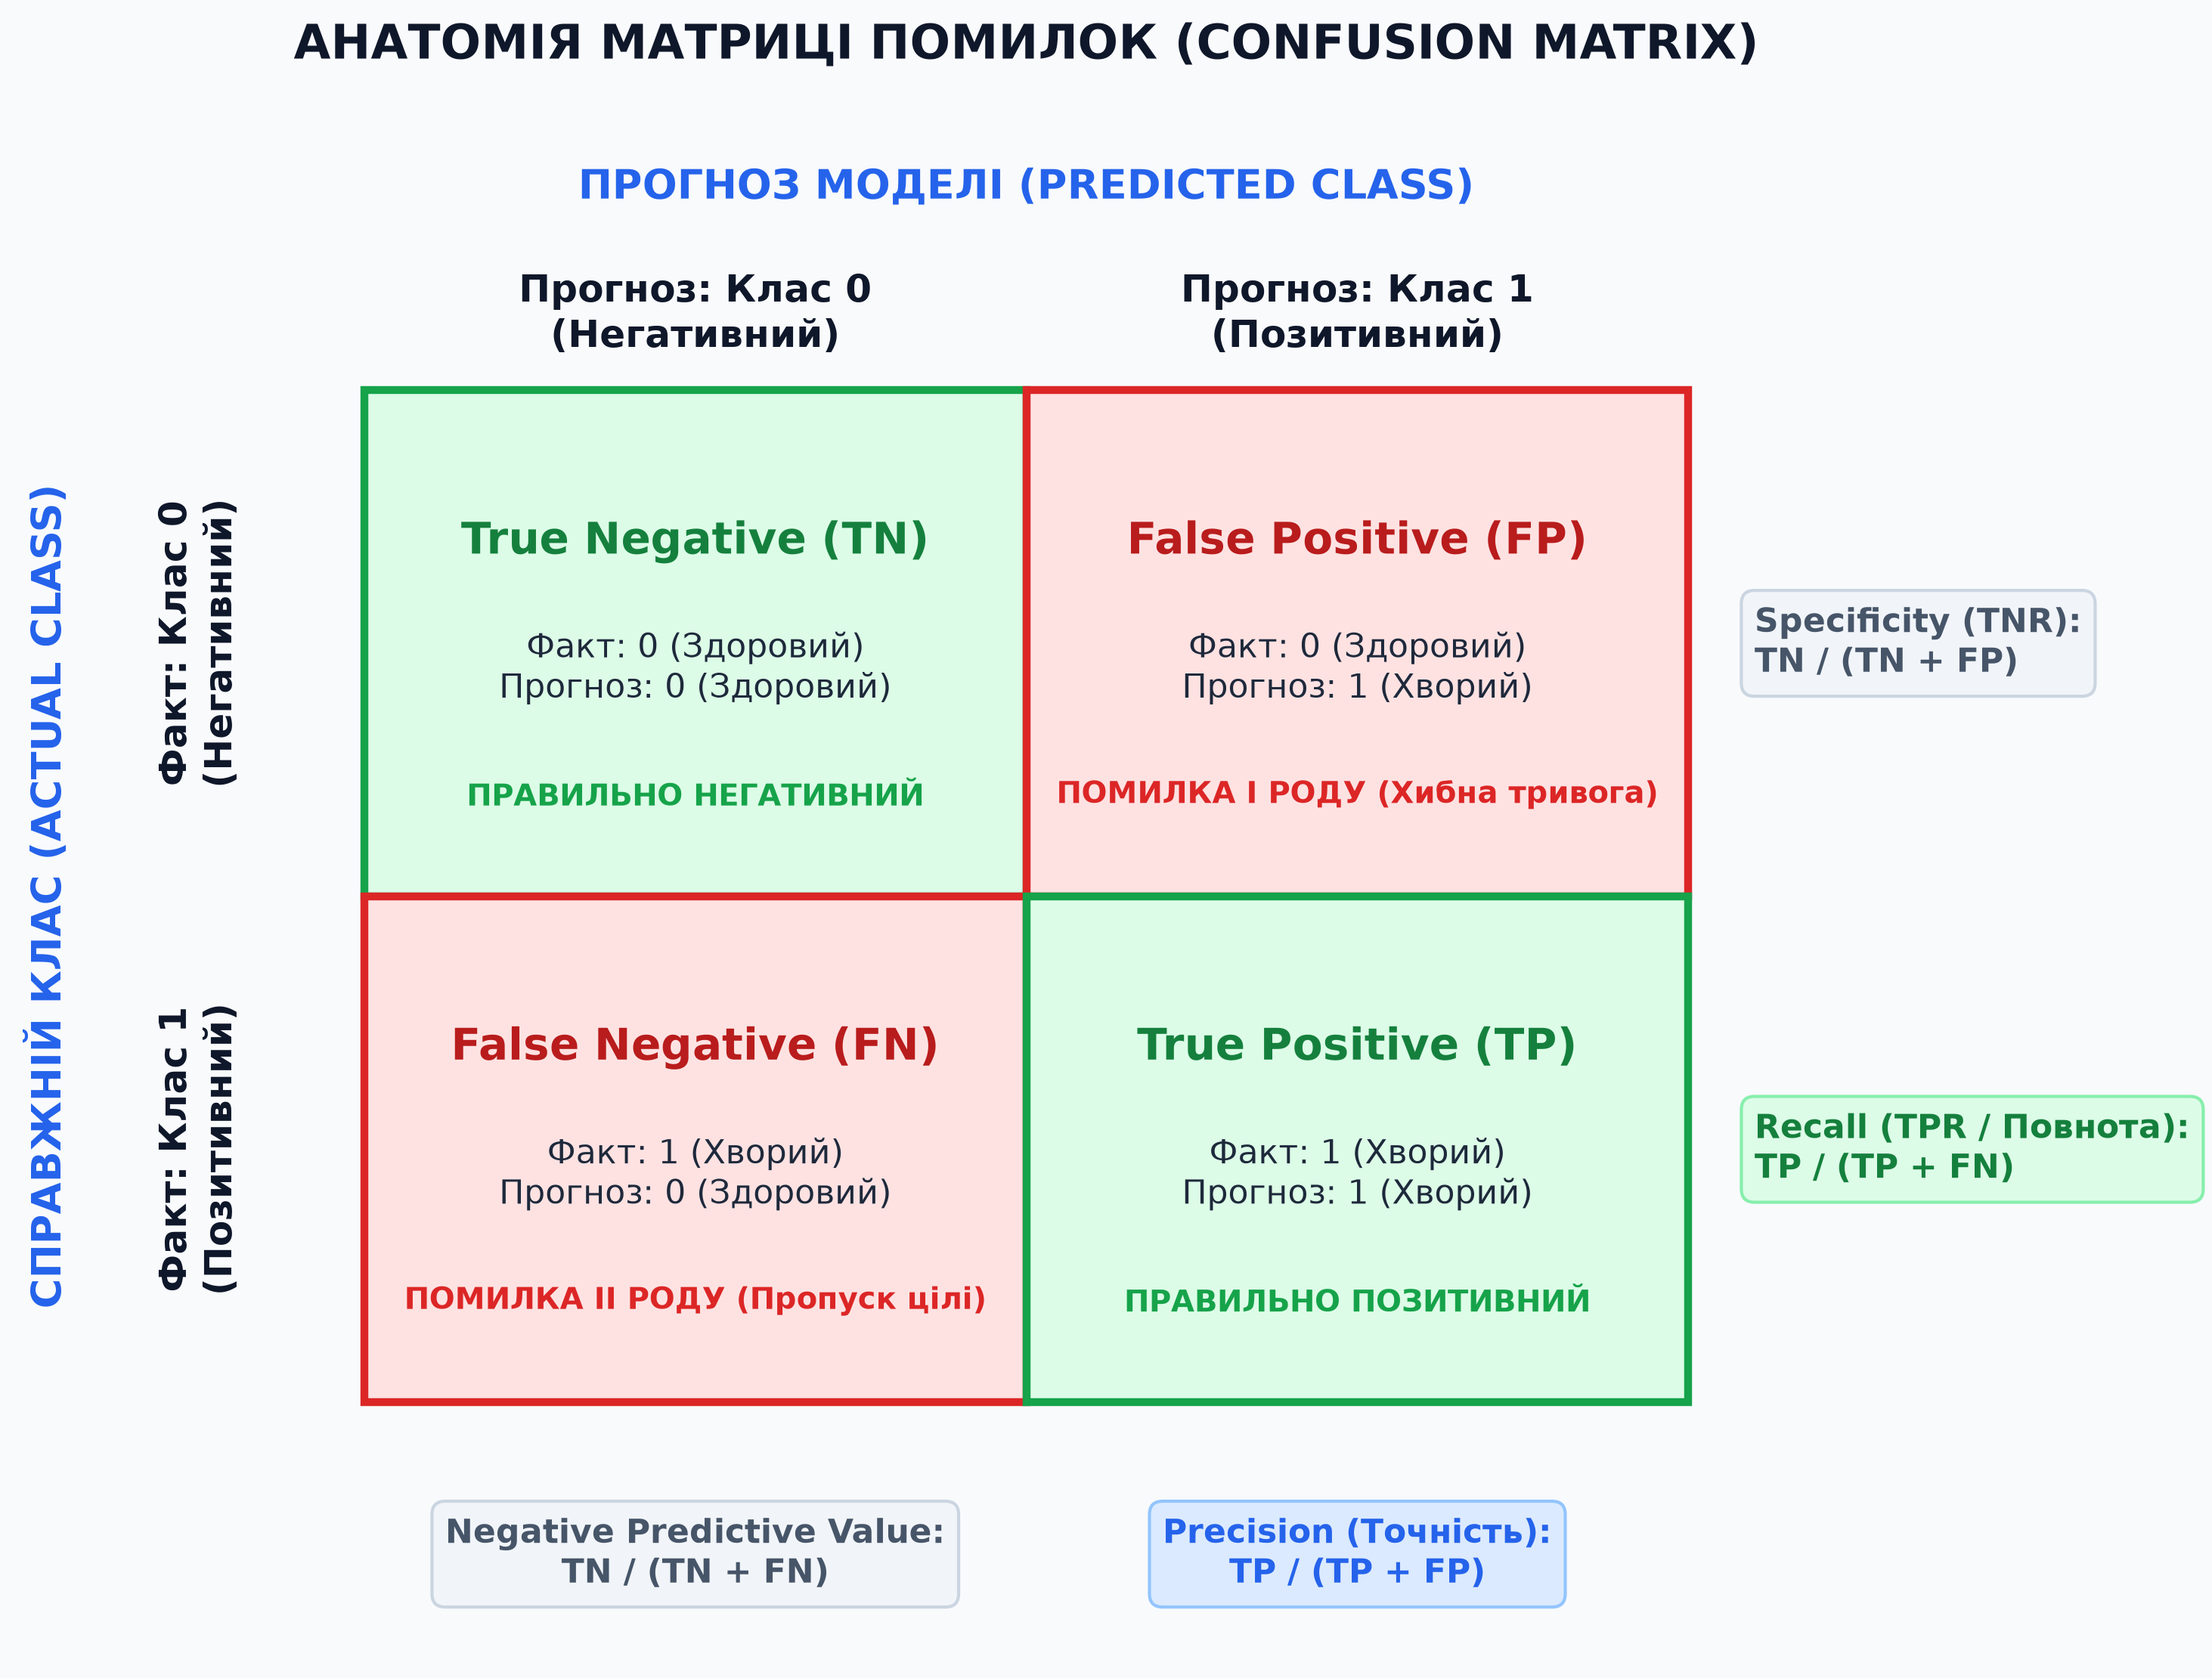
Чотири квадранти матриці
✅ True Positive (TP)
Правильно позитивні:
- Факт: клас 1 (хворий)
- Прогноз: клас 1 (хворий)
- Результат: Правильно! Модель виявила хворобу.
✅ True Negative (TN)
Правильно негативні:
- Факт: клас 0 (здоровий)
- Прогноз: клас 0 (здоровий)
- Результат: Правильно! Модель не помилилася.
❌ False Positive (FP)
Помилка I роду (хибна тривога):
- Факт: клас 0 (здоровий)
- Прогноз: клас 1 (хворий)
- Результат: Помилка! Здорового визнали хворим.
❌ False Negative (FN)
Помилка II роду (пропуск):
- Факт: клас 1 (хворий)
- Прогноз: клас 0 (здоровий)
- Результат: Помилка! Хворого не виявили.
- True/False — це про правильність прогнозу
- Positive/Negative — це про сам прогноз (що модель сказала)
Приклад побудови Confusion Matrix
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.metrics import confusion_matrix, ConfusionMatrixDisplay

# Реальні діагнози (ground truth)
y_true = np.array([0, 0, 1, 1, 0, 1, 0, 1, 0, 0,
                   0, 1, 0, 0, 1, 1, 0, 1, 0, 0])

# Прогнози моделі
y_pred = np.array([0, 0, 1, 0, 0, 1, 1, 1, 0, 0,
                   0, 1, 0, 0, 0, 1, 0, 1, 0, 0])

# Побудова Confusion Matrix
cm = confusion_matrix(y_true, y_pred)

print("Confusion Matrix:")
print(cm)
print(f"\nTrue Negatives (TN): {cm[0, 0]}")
print(f"False Positives (FP): {cm[0, 1]}")
print(f"False Negatives (FN): {cm[1, 0]}")
print(f"True Positives (TP): {cm[1, 1]}")
Confusion Matrix:
[[11  1]
 [ 2  6]]

True Negatives (TN): 11
False Positives (FP): 1
False Negatives (FN): 2
True Positives (TP): 6
# Візуалізація Confusion Matrix
fig, ax = plt.subplots(figsize=(8, 6))
disp = ConfusionMatrixDisplay(confusion_matrix=cm,
                               display_labels=['Здоровий (0)', 'Хворий (1)'])
disp.plot(cmap='Blues', ax=ax, colorbar=False)
plt.title('Confusion Matrix: Діагностика хвороби', fontsize=14, pad=20)
plt.xlabel('Прогноз моделі', fontsize=12)
plt.ylabel('Справжній діагноз', fontsize=12)
plt.tight_layout()
plt.show()

# Інтерпретація
total = cm.sum()
correct = cm[0, 0] + cm[1, 1]
accuracy = correct / total

print(f"\nЗагальна кількість пацієнтів: {total}")
print(f"Правильних діагнозів: {correct} ({accuracy:.1%})")
print(f"Помилкових діагнозів: {total - correct}")
print(f"\nЗ них:")
print(f"  - Хибна тривога (FP): {cm[0, 1]} (здорового визнали хворим)")
print(f"  - Пропуск хвороби (FN): {cm[1, 0]} (хворого не виявили)")
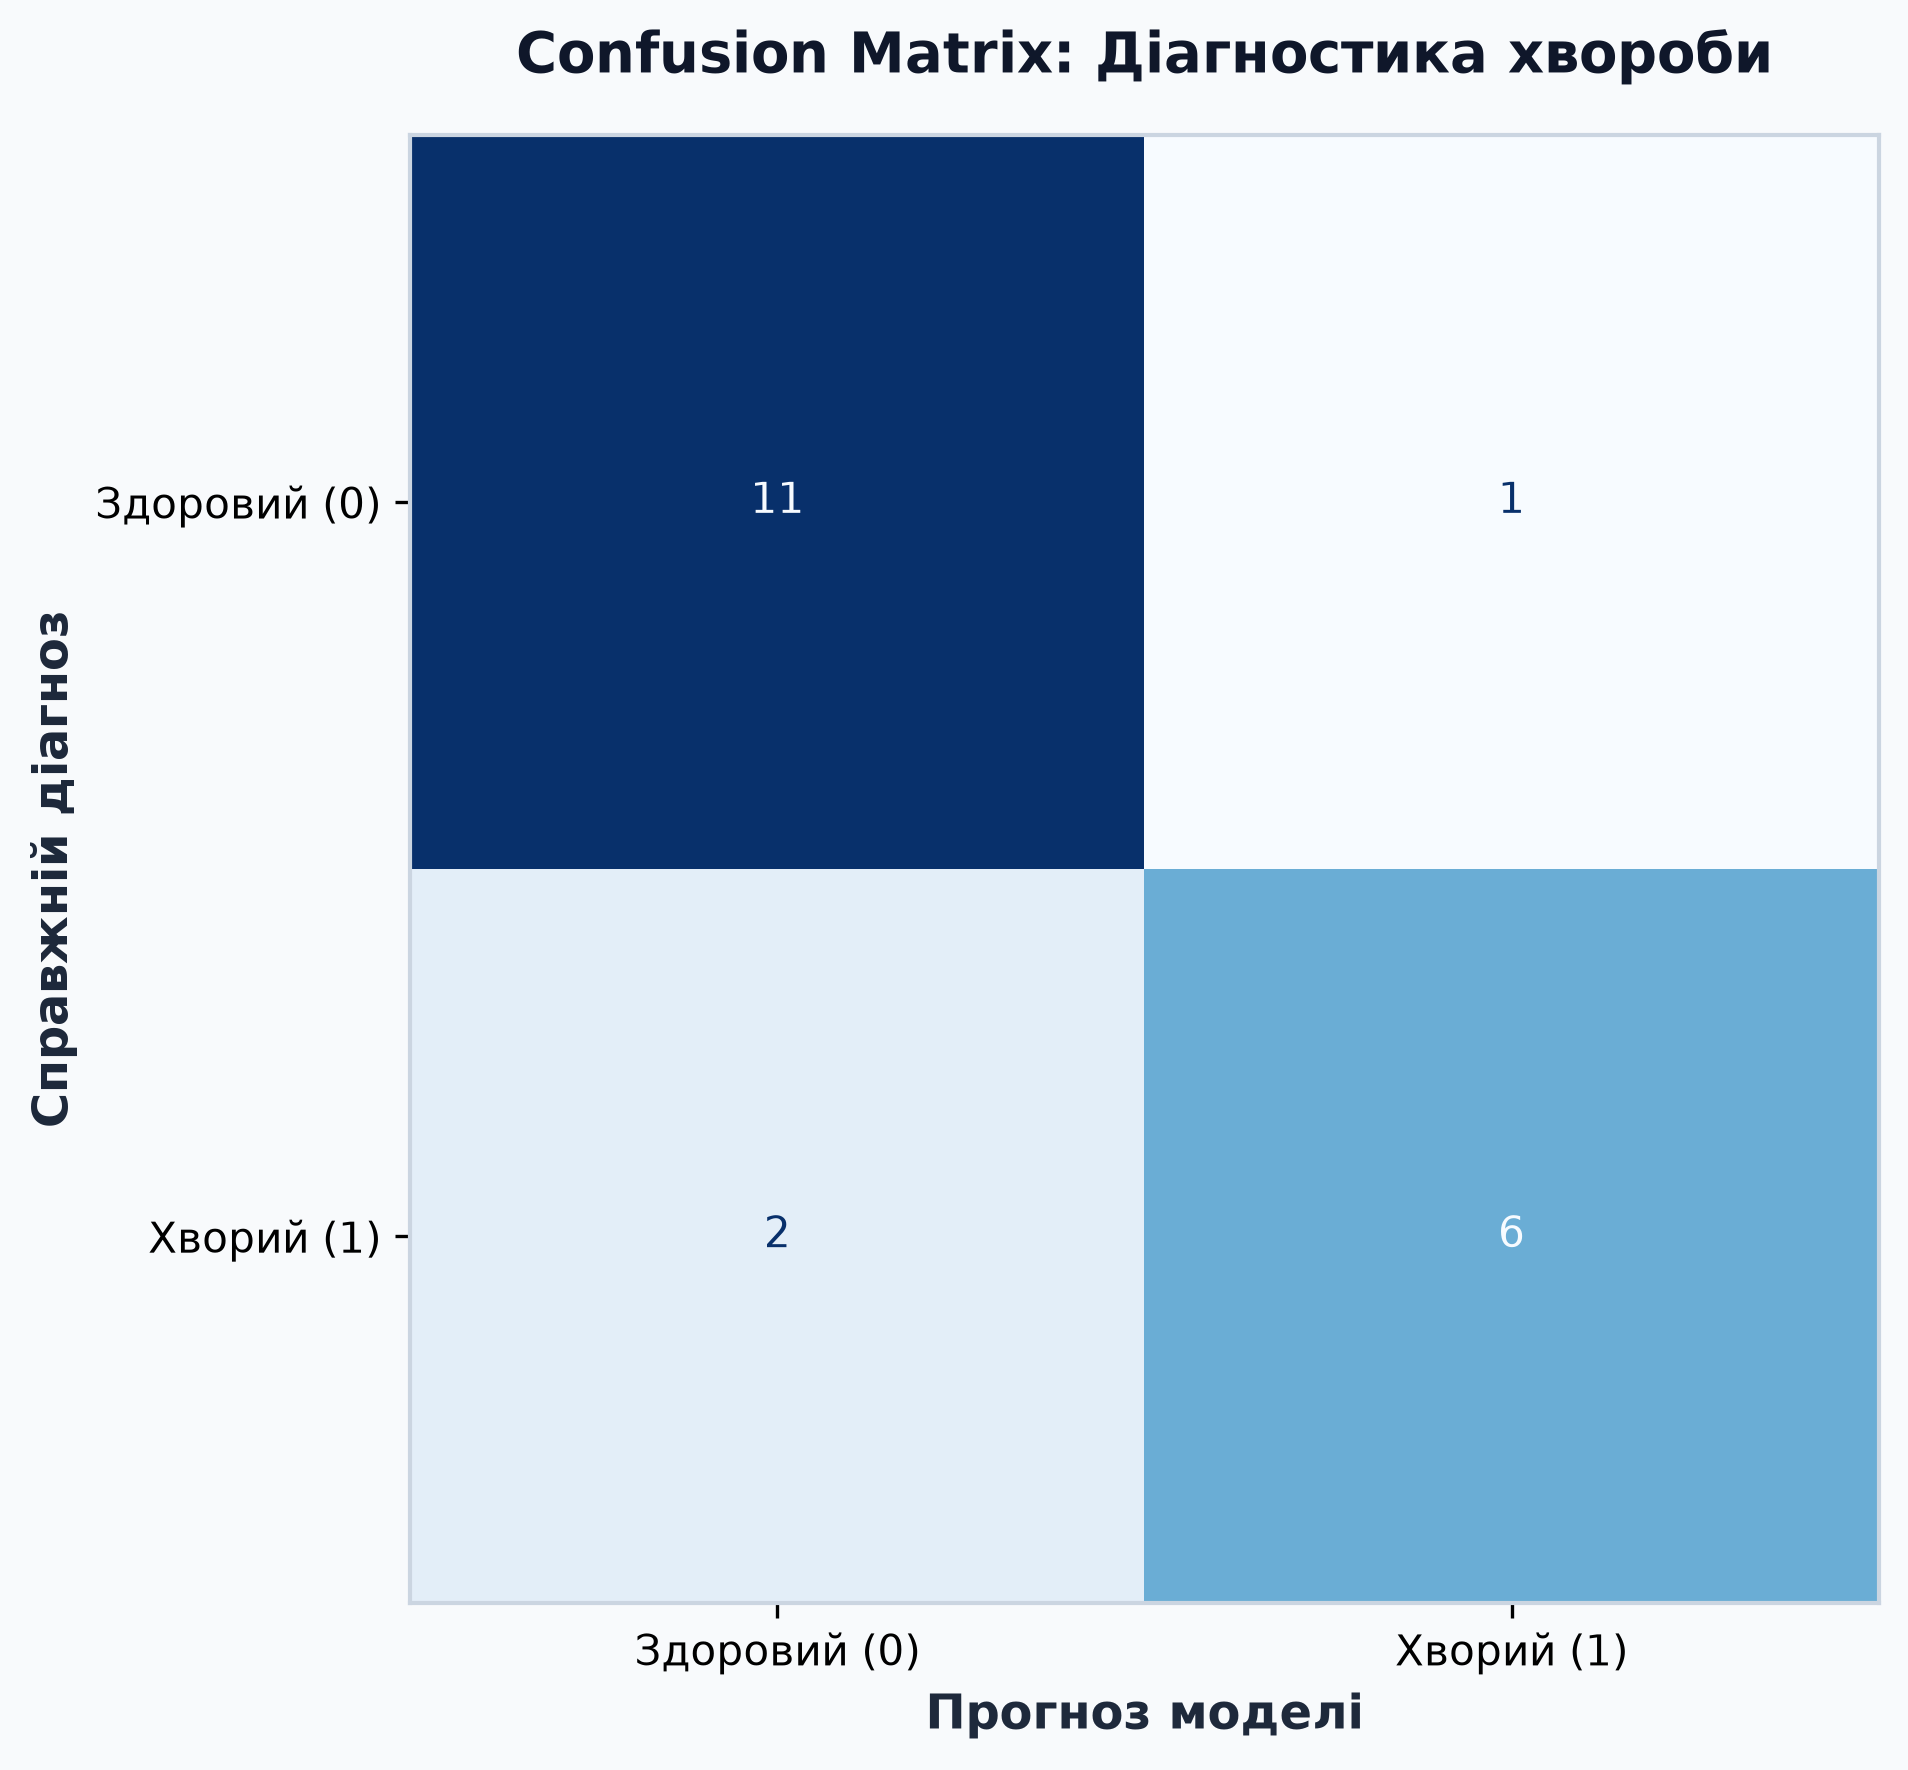
Загальна кількість пацієнтів: 20
Правильних діагнозів: 17 (85.0%)
Помилкових діагнозів: 3

З них:
  - Хибна тривога (FP): 1 (здорового визнали хворим)
  - Пропуск хвороби (FN): 2 (хворого не виявили)
Precision: точність позитивних прогнозів
Precision (точність) відповідає на питання: "Серед усіх випадків, які модель позначила як позитивні, скільки насправді були позитивними?"
Інтуїтивне розуміння
Коли важливий високий Precision?
| Задача | Чому важливий Precision? |
|---|---|
| Детекція спаму | Якщо важливий лист потрапить у спам (FP), користувач пропустить важливу інформацію 😡 |
| Рекомендаційна система | Якщо рекомендувати погані товари (FP), користувач втратить довіру до системи 👎 |
| Фінансові транзакції | Блокування легальної транзакції (FP) дратує клієнта та призводить до скарг 💳 |
| Юридичні документи | Хибне позначення документа як "конфіденційний" (FP) блокує доступ для тих, кому він потрібен 📄 |
Приклад обчислення Precision
from sklearn.metrics import precision_score

# З попереднього прикладу
y_true = np.array([0, 0, 1, 1, 0, 1, 0, 1, 0, 0,
                   0, 1, 0, 0, 1, 1, 0, 1, 0, 0])
y_pred = np.array([0, 0, 1, 0, 0, 1, 1, 1, 0, 0,
                   0, 1, 0, 0, 0, 1, 0, 1, 0, 0])

# Обчислення Precision
precision = precision_score(y_true, y_pred)

# Ручний підрахунок для перевірки
TP = ((y_true == 1) & (y_pred == 1)).sum()
FP = ((y_true == 0) & (y_pred == 1)).sum()
precision_manual = TP / (TP + FP)

print(f"Precision (sklearn): {precision:.3f}")
print(f"Precision (ручний): {precision_manual:.3f}")
print(f"\nІнтерпретація:")
print(f"Серед {TP + FP} прогнозів 'хворий', насправді хворих — {TP}")
print(f"Точність позитивних прогнозів: {precision:.1%}")

import matplotlib.pyplot as plt

plt.figure(figsize=(8, 3))
plt.barh(['Прогнози\n"хворий"'], [TP], color='#10b981', label=f'TP = {TP}')
plt.barh(['Прогнози\n"хворий"'], [FP], left=[TP], color='#ef4444', label=f'FP = {FP}')
plt.title(f'Precision = {TP}/{TP + FP} = {precision:.1%}', fontsize=13)
plt.xlabel('Кількість прогнозів')
plt.legend(loc='lower right')
plt.show()
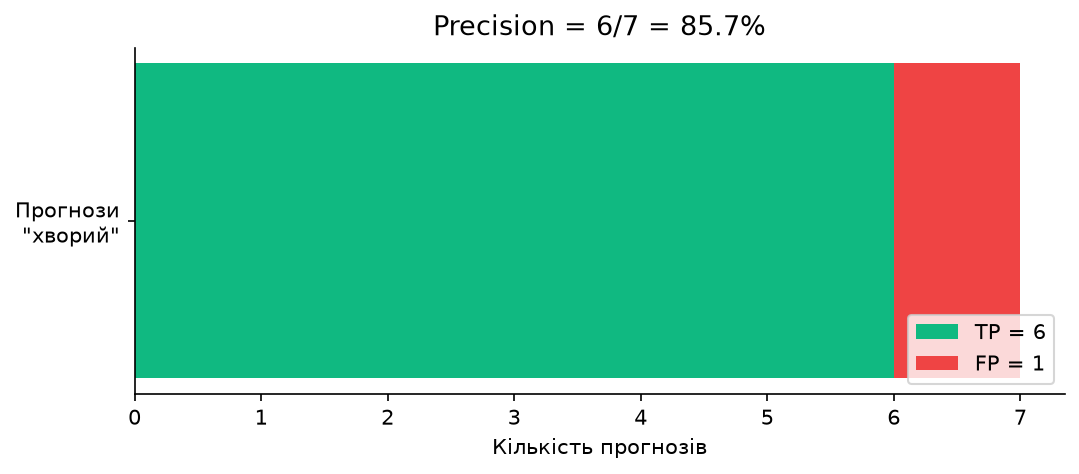
Precision (sklearn): 0.857
Precision (ручний): 0.857

Інтерпретація:
Серед 7 прогнозів 'хворий', насправді хворих — 6
Точність позитивних прогнозів: 85.7%
Recall: повнота виявлення позитивного класу
Recall (повнота, чутливість, sensitivity) відповідає на питання: "Серед усіх справжніх позитивних випадків, скільки модель змогла виявити?"
Інтуїтивне розуміння
Коли важливий високий Recall?
| Задача | Чому важливий Recall? |
|---|---|
| Діагностика раку | Пропустити хвороби (FN) — смертельно небезпечно! Треба виявити всіх хворих 🏥 |
| Виявлення шахрайства | Пропустити шахрайську транзакцію (FN) = втрата грошей 💸 |
| Пошук зниклих людей | Не знайти людину (FN) може коштувати життя 🚨 |
| Виявлення вразливостей у коді | Пропустити баг безпеки (FN) = потенційний злом системи 🔓 |
Приклад обчислення Recall
from sklearn.metrics import recall_score

# Обчислення Recall
recall = recall_score(y_true, y_pred)

# Ручний підрахунок
TP = ((y_true == 1) & (y_pred == 1)).sum()
FN = ((y_true == 1) & (y_pred == 0)).sum()
recall_manual = TP / (TP + FN)

print(f"Recall (sklearn): {recall:.3f}")
print(f"Recall (ручний): {recall_manual:.3f}")
print(f"\nІнтерпретація:")
print(f"Усього справжніх хворих: {TP + FN}")
print(f"Виявлено моделлю: {TP}")
print(f"Пропущено (FN): {FN}")
print(f"Повнота виявлення: {recall:.1%}")

import matplotlib.pyplot as plt

plt.figure(figsize=(8, 3))
plt.barh(['Справжні\nхворі'], [TP], color='#10b981', label=f'Виявлено TP = {TP}')
plt.barh(['Справжні\nхворі'], [FN], left=[TP], color='#f59e0b', label=f'Пропущено FN = {FN}')
plt.title(f'Recall = {TP}/{TP + FN} = {recall:.1%}', fontsize=13)
plt.xlabel('Кількість пацієнтів')
plt.legend(loc='lower right')
plt.show()
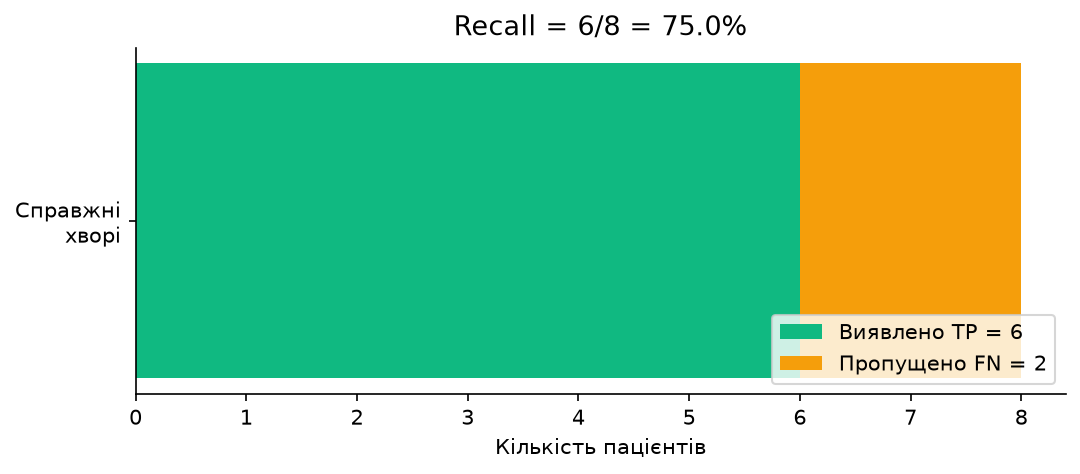
Recall (sklearn): 0.750
Recall (ручний): 0.750

Інтерпретація:
Усього справжніх хворих: 8
Виявлено моделлю: 6
Пропущено (FN): 2
Повнота виявлення: 75.0%
Precision vs Recall: компроміс
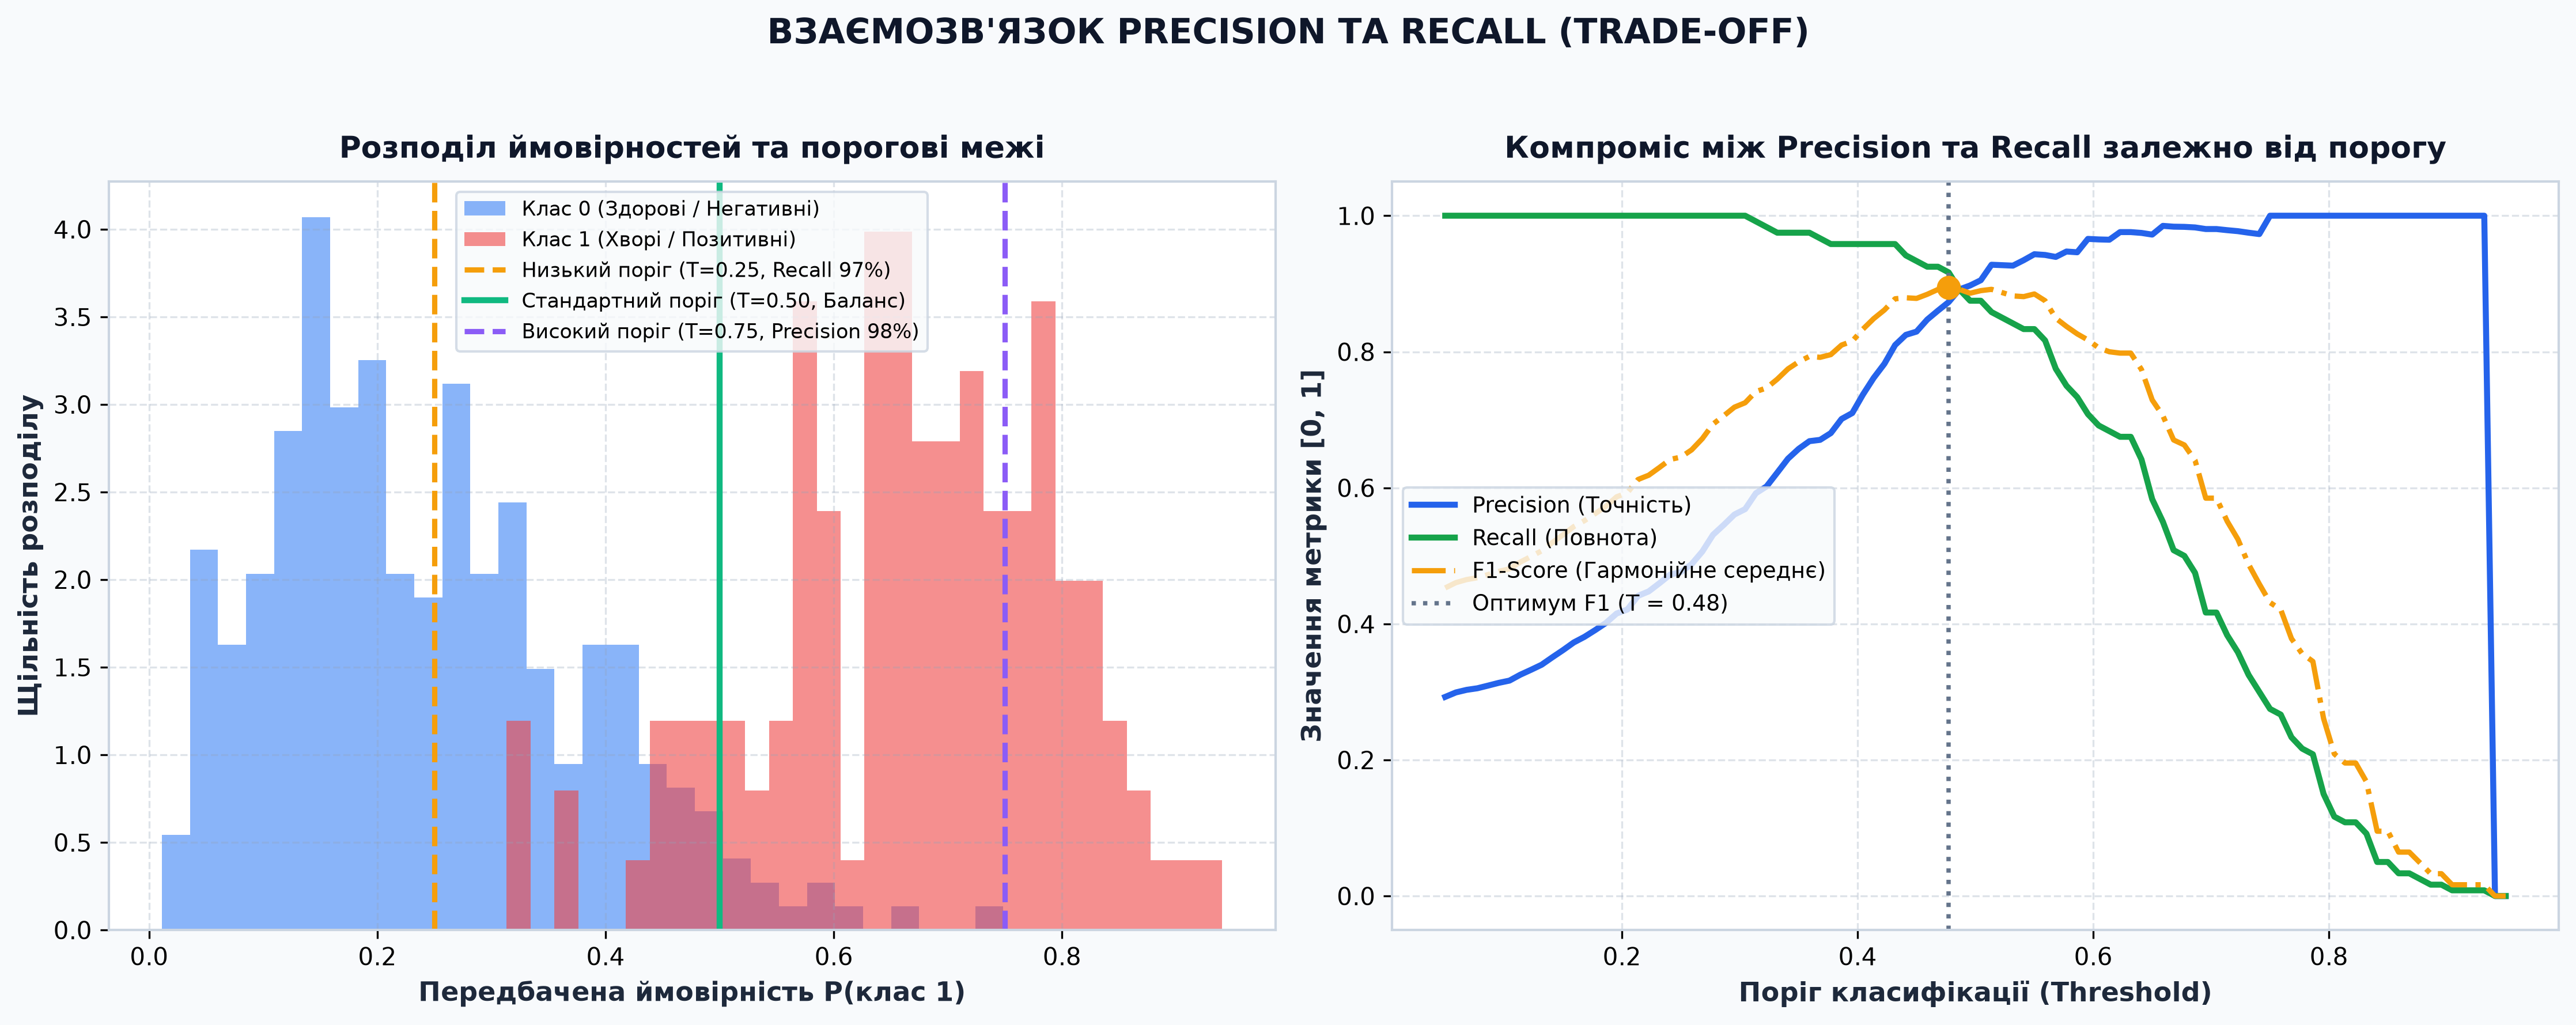
Precision та Recall часто конфліктують між собою: покращення однієї метрики може погіршити іншу.
Чому виникає компроміс?
Recall можна штучно підвищити, знизивши поріг класифікації — модель почне частіше прогнозувати "позитивний" клас. Але це призведе до збільшення False Positives, що знизить Precision.
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import precision_score, recall_score
from sklearn.datasets import make_classification

# Генерація синтетичних даних
X, y = make_classification(n_samples=200, n_features=10, n_informative=8,
                           n_redundant=2, n_classes=2, weights=[0.7, 0.3],
                           random_state=42)

# Навчання моделі
model = LogisticRegression(random_state=42)
model.fit(X, y)

# Отримання ймовірностей
y_probs = model.predict_proba(X)[:, 1]

# Тестування різних порогів
thresholds = [0.3, 0.5, 0.7, 0.9]
results = []

for threshold in thresholds:
    y_pred = (y_probs >= threshold).astype(int)
    precision = precision_score(y, y_pred)
    recall = recall_score(y, y_pred)

    results.append({
        'Поріг': threshold,
        'Precision': f'{precision:.3f}',
        'Recall': f'{recall:.3f}',
        'Прогнозів "1"': y_pred.sum()
    })

import pandas as pd
results_df = pd.DataFrame(results)
print(results_df.to_string(index=False))

import matplotlib.pyplot as plt

ts = np.linspace(0.05, 0.95, 91)
prec = [precision_score(y, (y_probs >= t).astype(int), zero_division=0) for t in ts]
rec = [recall_score(y, (y_probs >= t).astype(int)) for t in ts]

plt.figure(figsize=(10, 6))
plt.plot(ts, prec, color='#3b82f6', linewidth=2.5, label='Precision')
plt.plot(ts, rec, color='#ef4444', linewidth=2.5, label='Recall')
for t in thresholds:
    plt.axvline(t, color='gray', linestyle=':', alpha=0.6)
plt.xlabel('Поріг класифікації', fontsize=12)
plt.ylabel('Значення метрики', fontsize=12)
plt.title('Компроміс Precision / Recall', fontsize=14)
plt.legend()
plt.grid(alpha=0.3)
plt.show()
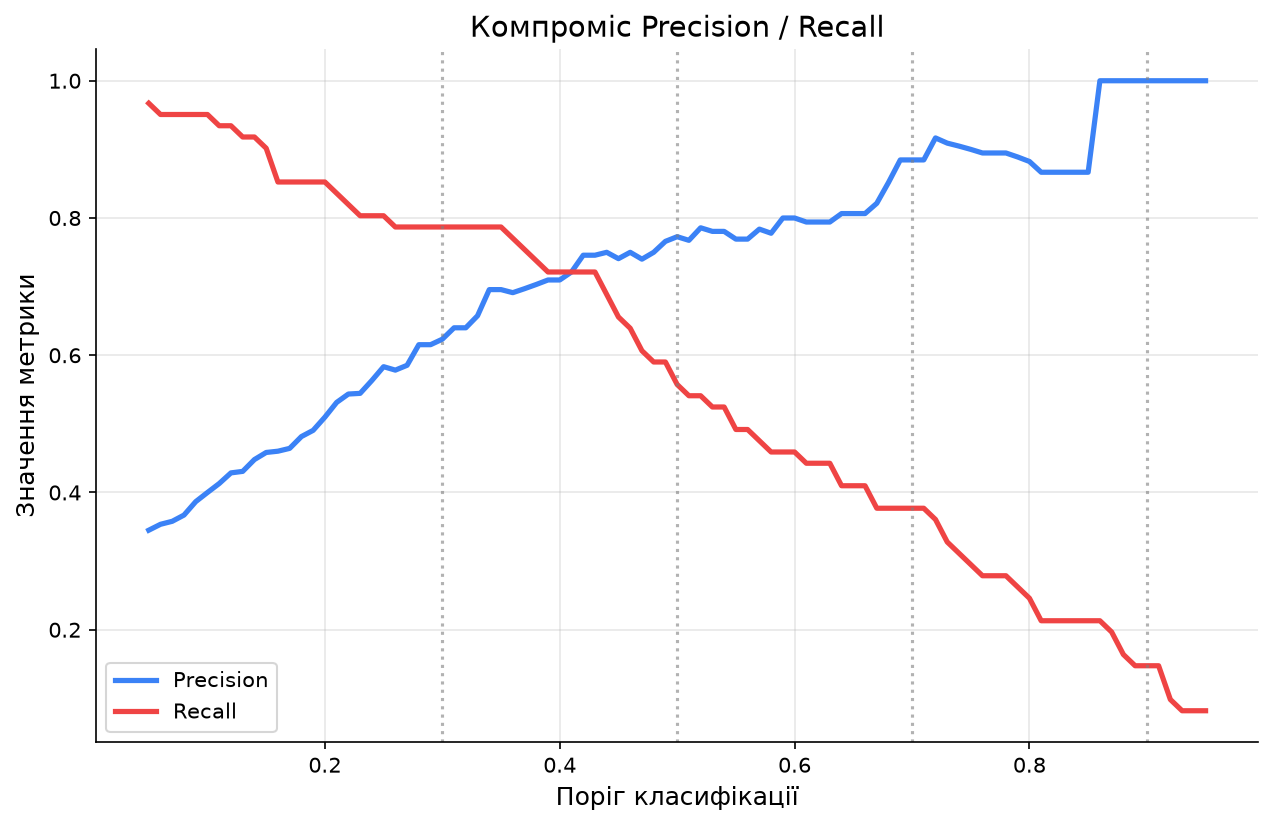
 Поріг Precision  Recall  Прогнозів "1"
    0.3     0.623   0.787             77
    0.5     0.773   0.557             44
    0.7     0.885   0.377             26
    0.9     1.000   0.148              9
- Низький поріг (0.3): висока повнота (79% хворих виявлено), але невисока точність (лише 62% прогнозів "хворий" правильні)
- Високий поріг (0.9): висока точність (100% прогнозів вірні), але низька повнота (лише 15% хворих виявлено)
Як обрати баланс?
⚖️ Медицина (рак)
Пріоритет: Recall
Пропустити хворобу (FN) — смертельно. Хибна тривога (FP) — зайві обстеження, але не критично.
Стратегія: знизити поріг до 0.3–0.4, щоб виявити якомога більше хворих.
📧 Фільтр спаму
Пріоритет: Precision
Важливий лист у спам (FP) — дуже погано. Спам у вхідних (FN) — трохи дратує.
Стратегія: підвищити поріг до 0.7–0.8, щоб бути впевненим перед блокуванням.
🎯 Рекомендації товарів
Баланс
Погана рекомендація (FP) псує UX. Пропуск хорошого товару (FN) — упущена можливість.
Стратегія: використати F1-Score для балансу.
F1-Score: гармонійне середнє
F1-Score — це єдина метрика, яка поєднує Precision та Recall у одне число через гармонійне середнє.
Чому гармонійне середнє, а не арифметичне?
Гармонійне середнє жорстко штрафує за низьке значення однієї з метрик:
# Порівняння середніх
precision_cases = [
    (0.9, 0.9),  # Обидві метрики високі
    (0.9, 0.1),  # Precision високий, Recall низький
    (0.5, 0.5),  # Обидві середні
]

for p, r in precision_cases:
    arithmetic = (p + r) / 2
    harmonic = 2 * (p * r) / (p + r) if (p + r) > 0 else 0

    print(f"Precision={p:.1f}, Recall={r:.1f}")
    print(f"  Арифметичне середнє: {arithmetic:.3f}")
    print(f"  F1-Score (гармонійне): {harmonic:.3f}")
    print()

import matplotlib.pyplot as plt

labels = [f'P={p}, R={r}' for p, r in precision_cases]
arith = [(p + r) / 2 for p, r in precision_cases]
harm = [2 * p * r / (p + r) for p, r in precision_cases]

x = np.arange(len(labels))
plt.figure(figsize=(9, 5))
plt.bar(x - 0.2, arith, 0.4, label='Арифметичне середнє', color='#94a3b8')
plt.bar(x + 0.2, harm, 0.4, label='F1 (гармонійне)', color='#3b82f6')
for i in range(len(labels)):
    plt.text(x[i] - 0.2, arith[i] + 0.02, f'{arith[i]:.2f}', ha='center')
    plt.text(x[i] + 0.2, harm[i] + 0.02, f'{harm[i]:.2f}', ha='center')
plt.xticks(x, labels)
plt.ylim(0, 1.1)
plt.title('F1 жорстко штрафує дисбаланс метрик', fontsize=13)
plt.legend()
plt.show()
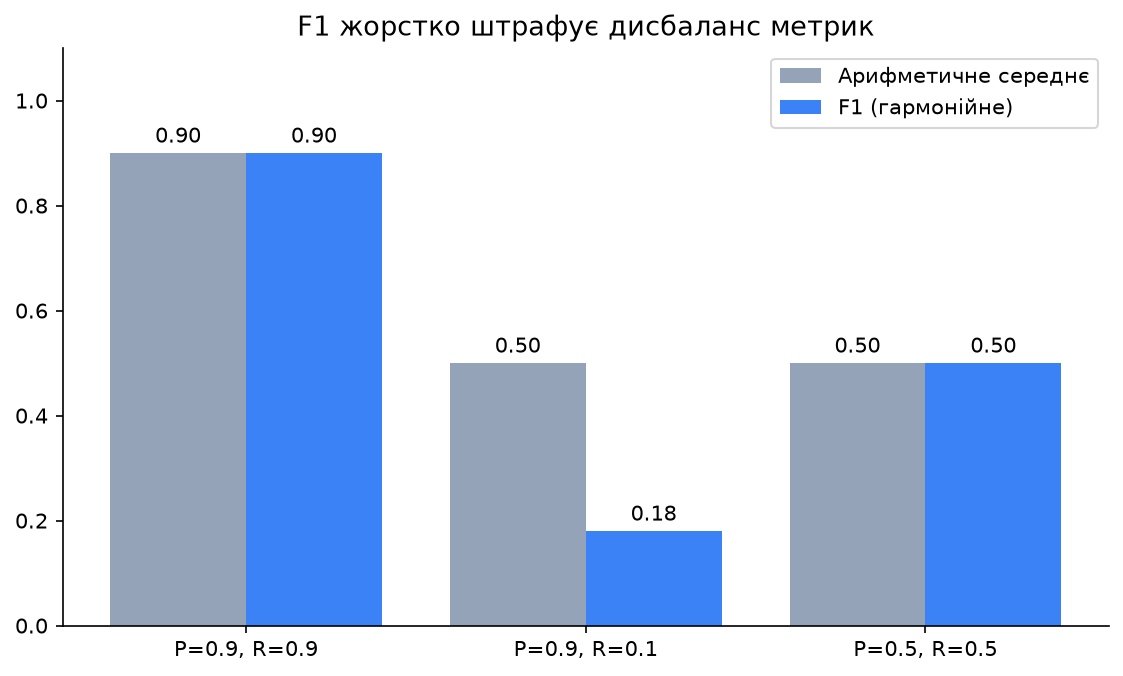
Precision=0.9, Recall=0.9
  Арифметичне середнє: 0.900
  F1-Score (гармонійне): 0.900

Precision=0.9, Recall=0.1
  Арифметичне середнє: 0.500
  F1-Score (гармонійне): 0.180

Precision=0.5, Recall=0.5
  Арифметичне середнє: 0.500
  F1-Score (гармонійне): 0.500
Приклад обчислення F1-Score
from sklearn.metrics import f1_score, precision_score, recall_score

# З попередніх прикладів
precision = precision_score(y_true, y_pred)
recall = recall_score(y_true, y_pred)
f1 = f1_score(y_true, y_pred)

# Ручний підрахунок
f1_manual = 2 * (precision * recall) / (precision + recall)

print(f"Precision: {precision:.3f}")
print(f"Recall: {recall:.3f}")
print(f"F1-Score (sklearn): {f1:.3f}")
print(f"F1-Score (ручний): {f1_manual:.3f}")
print(f"\nІнтерпретація:")
print(f"Модель досягла балансу між точністю ({precision:.1%})")
print(f"та повнотою ({recall:.1%}) з F1 = {f1:.3f}")

import matplotlib.pyplot as plt

names = ['Precision', 'Recall', 'F1-Score']
vals = [precision, recall, f1]

plt.figure(figsize=(8, 5))
bars = plt.bar(names, vals, color=['#3b82f6', '#ef4444', '#8b5cf6'])
for bar, v in zip(bars, vals):
    plt.text(bar.get_x() + bar.get_width() / 2, v + 0.02, f'{v:.3f}', ha='center', fontsize=12)
plt.ylim(0, 1.1)
plt.title('F1 лежить між Precision та Recall', fontsize=13)
plt.show()
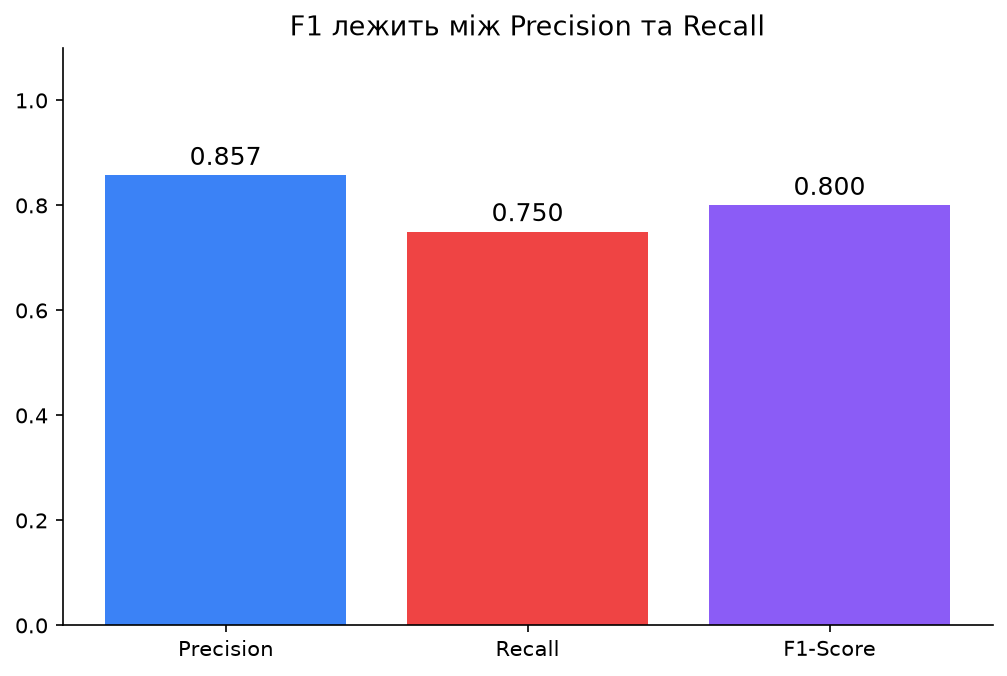
Precision: 0.857
Recall: 0.750
F1-Score (sklearn): 0.800
F1-Score (ручний): 0.800

Інтерпретація:
Модель досягла балансу між точністю (85.7%)
та повнотою (75.0%) з F1 = 0.800
Узагальнена F-міра: Fβ-Score
Іноді потрібно більше уваги приділити Recall або Precision. Для цього існує узагальнена Fβ-Score:
Де Завантаження... — вага важливості Recall відносно Precision:
- β = 1: F1-Score (рівна вага)
- β = 2: F2-Score (Recall в 2 рази важливіший за Precision)
- β = 0.5: F0.5-Score (Precision в 2 рази важливіший за Recall)
from sklearn.metrics import fbeta_score

# Обчислення різних F-мір
f05 = fbeta_score(y_true, y_pred, beta=0.5)  # Пріоритет Precision
f1 = fbeta_score(y_true, y_pred, beta=1.0)   # Баланс
f2 = fbeta_score(y_true, y_pred, beta=2.0)   # Пріоритет Recall

print(f"F0.5 (пріоритет Precision): {f05:.3f}")
print(f"F1   (баланс):              {f1:.3f}")
print(f"F2   (пріоритет Recall):    {f2:.3f}")
print(f"\nPrecision: {precision:.3f}")
print(f"Recall:    {recall:.3f}")

import matplotlib.pyplot as plt

names = ['Precision', 'F0.5', 'F1', 'F2', 'Recall']
vals = [precision, f05, f1, f2, recall]
colors = ['#3b82f6', '#60a5fa', '#8b5cf6', '#f87171', '#ef4444']

plt.figure(figsize=(9, 5))
bars = plt.bar(names, vals, color=colors)
for bar, v in zip(bars, vals):
    plt.text(bar.get_x() + bar.get_width() / 2, v + 0.01, f'{v:.3f}', ha='center', fontsize=12)
plt.ylim(0.6, 0.92)
plt.title('Fβ зміщується до Precision (β<1) або Recall (β>1)', fontsize=13)
plt.show()
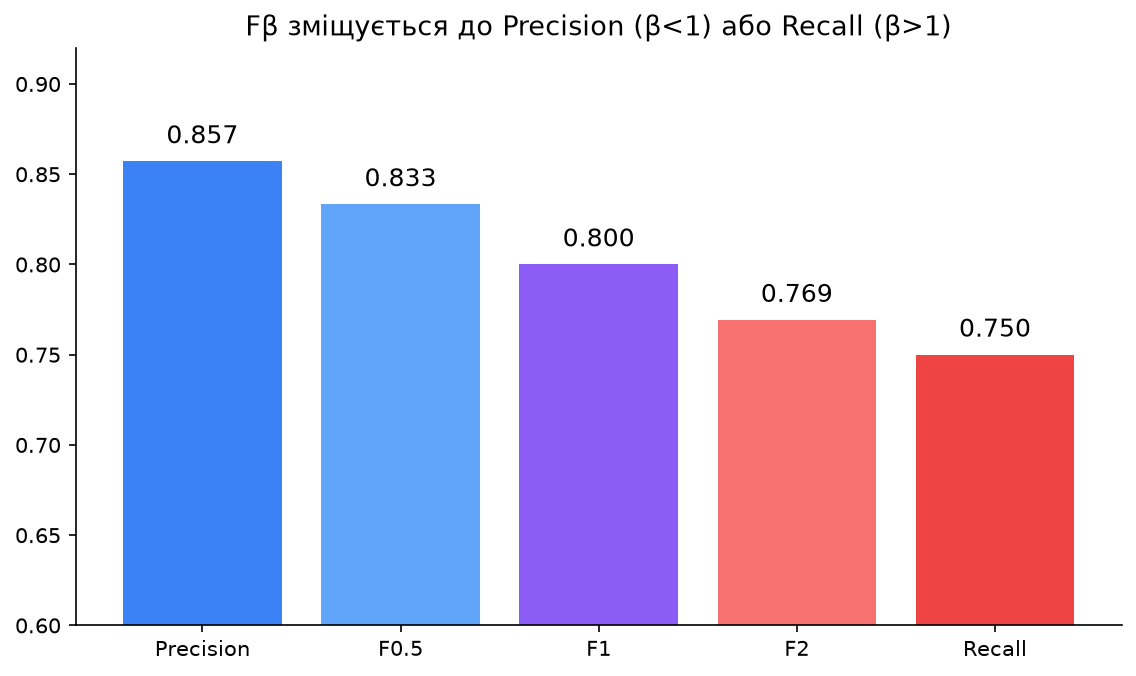
F0.5 (пріоритет Precision): 0.833
F1   (баланс):              0.800
F2   (пріоритет Recall):    0.769

Precision: 0.857
Recall:    0.750
- F0.5 — для задач, де FP дорожче за FN (спам-фільтр, юридичні документи)
- F1 — загальний випадок, коли обидві помилки рівнозначні
- F2 — для задач, де FN дорожче за FP (медицина, безпека)
ROC-крива та AUC: оцінка якості моделі
ROC (Receiver Operating Characteristic) крива — це графік, який показує залежність між True Positive Rate (TPR) та False Positive Rate (FPR) при зміні порогу класифікації.
AUC (Area Under the Curve) — площа під ROC-кривою, яка узагальнює якість моделі одним числом від 0 до 1.
Визначення TPR та FPR
- TPR (Recall): яка частка справжніх позитивних випадків правильно виявлена
- FPR: яка частка справжніх негативних випадків помилково класифікована як позитивні
Побудова ROC-кривої
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_curve, roc_auc_score

# Генерація даних
X, y = make_classification(n_samples=500, n_features=10, n_informative=8,
                           n_classes=2, weights=[0.6, 0.4], random_state=42)

# Розділення на навчальну та тестову вибірки
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42, stratify=y
)

# Навчання моделі
model = LogisticRegression(random_state=42)
model.fit(X_train, y_train)

# Отримання ймовірностей для побудови ROC
y_probs = model.predict_proba(X_test)[:, 1]

print(f"Навчальна вибірка: {X_train.shape}")
print(f"Тестова вибірка: {X_test.shape}")
print(f"Розподіл класів у тесті: {np.bincount(y_test)}")
Навчальна вибірка: (350, 10)
Тестова вибірка: (150, 10)
Розподіл класів у тесті: [90 60]
# Обчислення TPR та FPR для різних порогів
fpr, tpr, thresholds = roc_curve(y_test, y_probs)
auc_score = roc_auc_score(y_test, y_probs)

# Побудова графіка
plt.figure(figsize=(10, 7))

# ROC-крива моделі
plt.plot(fpr, tpr, linewidth=2.5, color='#3b82f6',
         label=f'Logistic Regression (AUC = {auc_score:.3f})')

# Діагональ (випадкова модель)
plt.plot([0, 1], [0, 1], 'k--', linewidth=2, alpha=0.7,
         label='Випадкова модель (AUC = 0.5)')

# Ідеальна модель
plt.plot([0, 0, 1], [0, 1, 1], 'g:', linewidth=2, alpha=0.7,
         label='Ідеальна модель (AUC = 1.0)')

plt.xlabel('False Positive Rate (FPR)', fontsize=12)
plt.ylabel('True Positive Rate (TPR / Recall)', fontsize=12)
plt.title('ROC-крива', fontsize=14, pad=15)
plt.legend(loc='lower right', fontsize=11)
plt.grid(alpha=0.3)
plt.xlim([-0.02, 1.02])
plt.ylim([-0.02, 1.02])
plt.tight_layout()
plt.show()

print(f"\nAUC (Area Under Curve): {auc_score:.3f}")
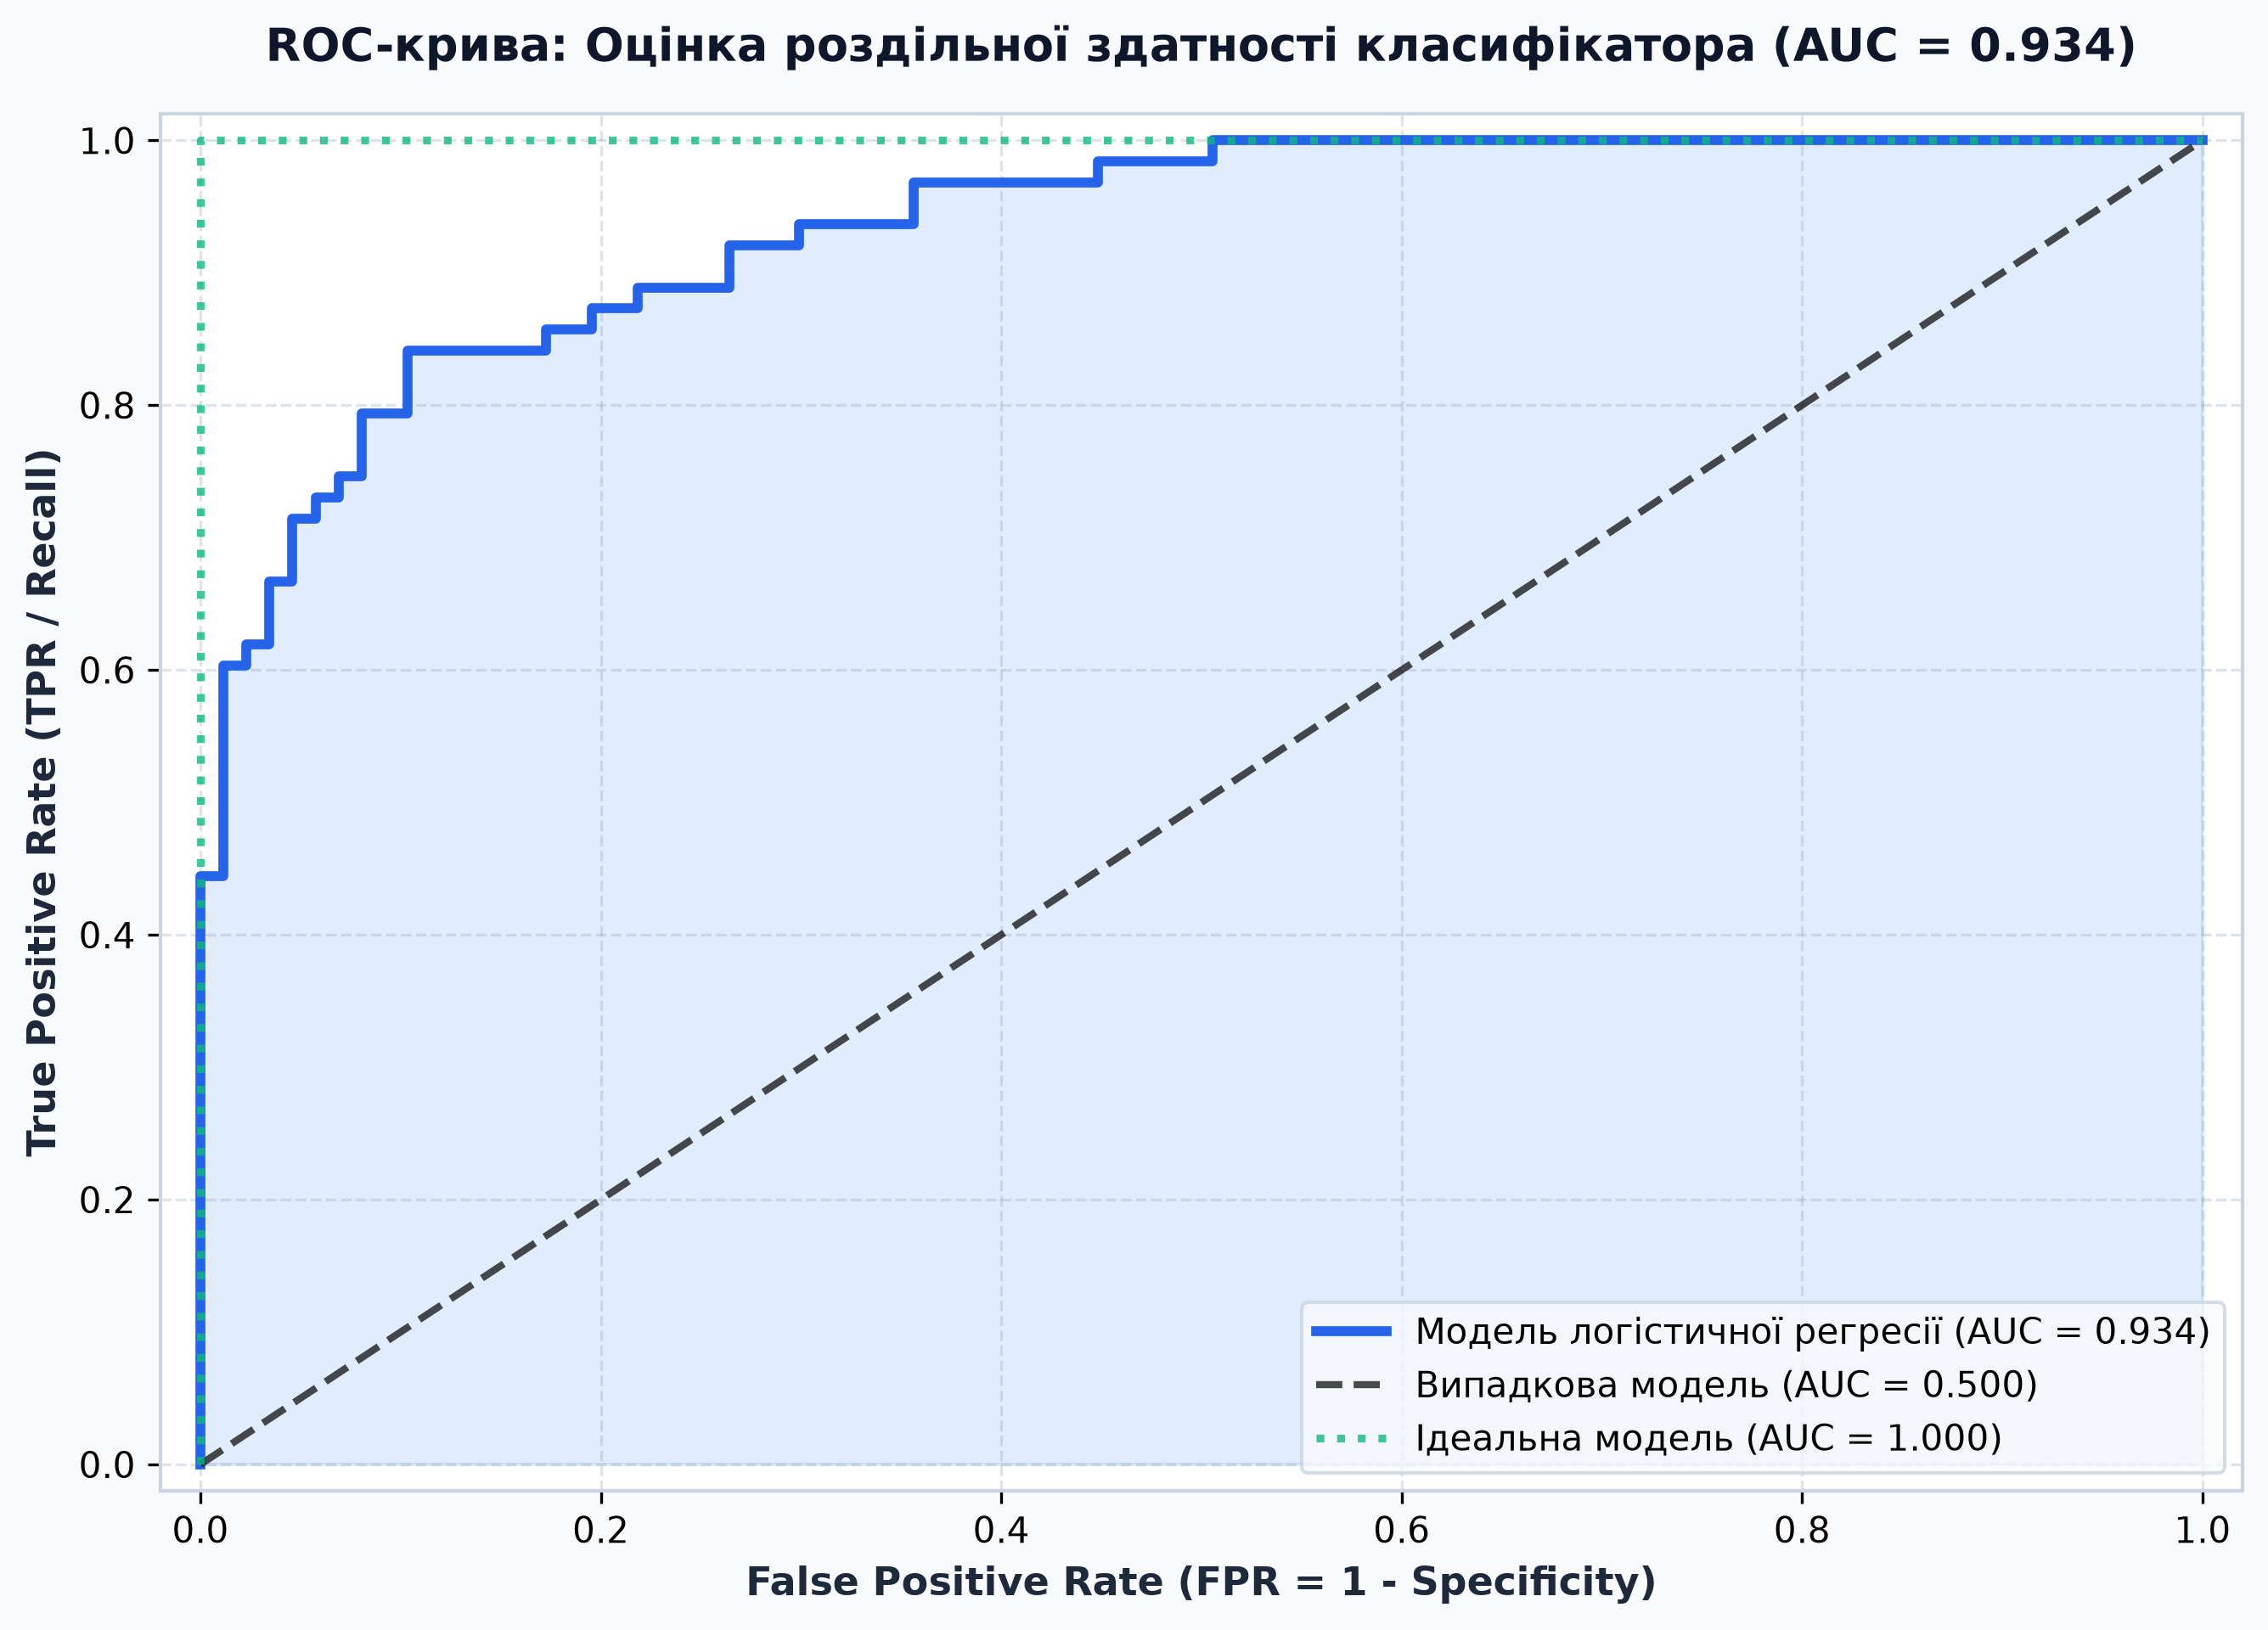
AUC (Area Under Curve): 0.946
Інтерпретація AUC
- Незалежна від порогу: не потрібно обирати конкретний поріг
- Стійка до незбалансованих класів: краще за Accuracy для imbalanced datasets
- Одне число: зручно порівнювати моделі між собою
- Не показує, як модель працює при конкретному порозі
- Може бути оманливою, якщо вартість FP та FN сильно відрізняється
Precision-Recall крива
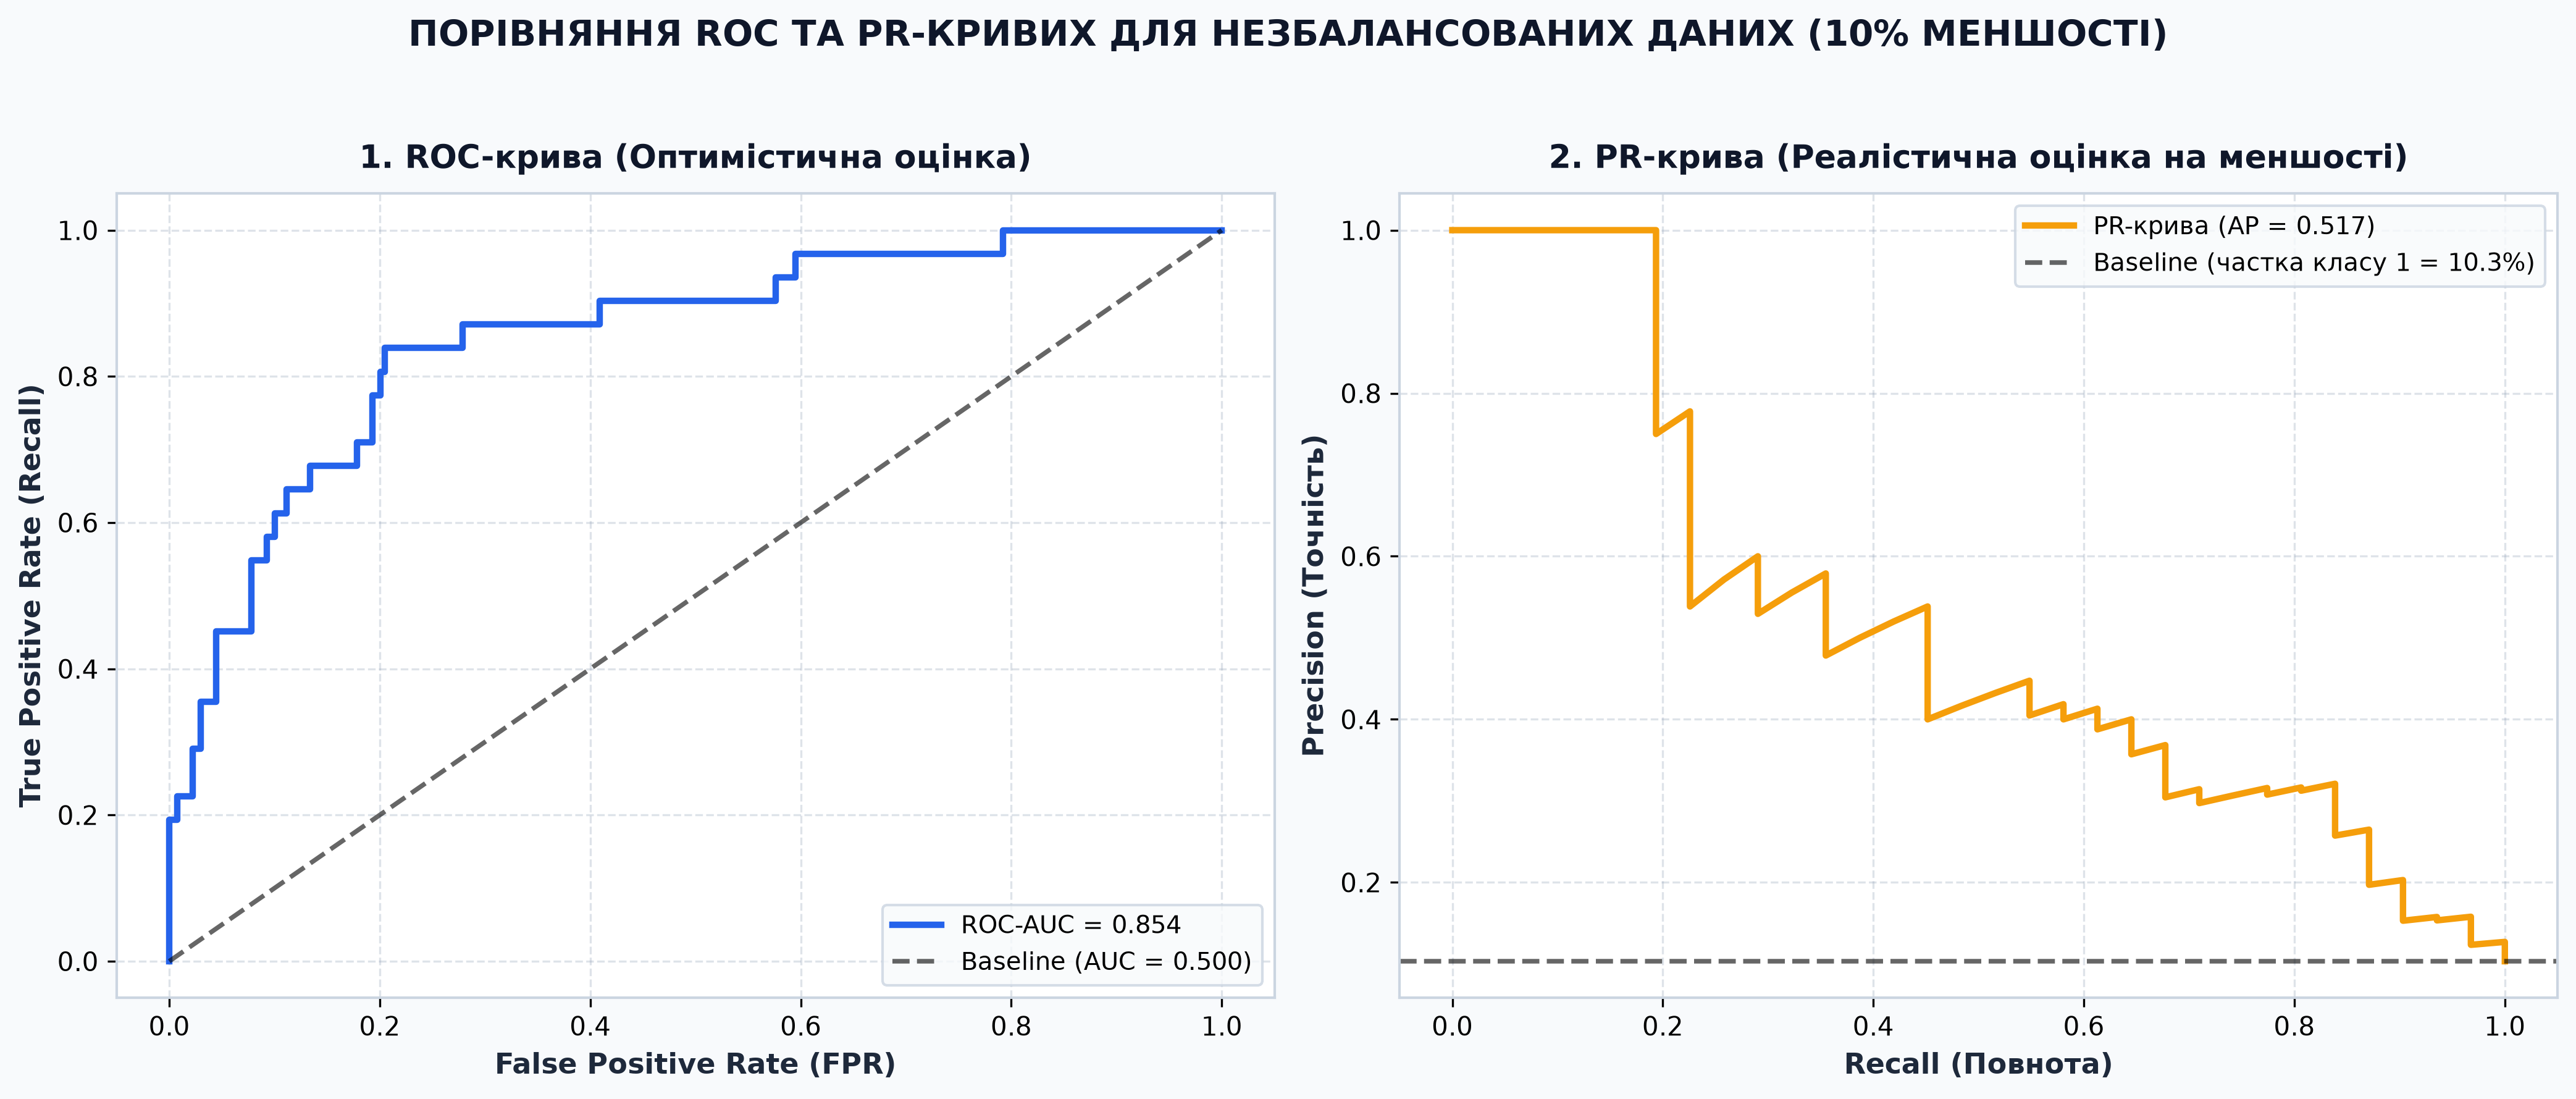
Для сильно незбалансованих датасетів (наприклад, 99% класу 0, 1% класу 1) ROC-крива може бути занадто оптимістичною. У таких випадках краще використовувати Precision-Recall (PR) криву.
from sklearn.metrics import precision_recall_curve, average_precision_score

# Створення сильно незбалансованого датасету (95% : 5%)
X_imb, y_imb = make_classification(n_samples=1000, n_features=10, n_informative=8,
                                    n_classes=2, weights=[0.95, 0.05], random_state=42)

X_train_imb, X_test_imb, y_train_imb, y_test_imb = train_test_split(
    X_imb, y_imb, test_size=0.3, random_state=42, stratify=y_imb
)

# Навчання моделі
model_imb = LogisticRegression(random_state=42, max_iter=1000)
model_imb.fit(X_train_imb, y_train_imb)
y_probs_imb = model_imb.predict_proba(X_test_imb)[:, 1]

# Обчислення метрик
precision, recall, pr_thresholds = precision_recall_curve(y_test_imb, y_probs_imb)
avg_precision = average_precision_score(y_test_imb, y_probs_imb)

fpr_imb, tpr_imb, roc_thresholds = roc_curve(y_test_imb, y_probs_imb)
auc_imb = roc_auc_score(y_test_imb, y_probs_imb)

print(f"Розподіл класів у тестовій вибірці:")
print(f"  Клас 0: {(y_test_imb == 0).sum()} ({(y_test_imb == 0).mean():.1%})")
print(f"  Клас 1: {(y_test_imb == 1).sum()} ({(y_test_imb == 1).mean():.1%})")
print(f"\nROC-AUC: {auc_imb:.3f}")
print(f"Average Precision: {avg_precision:.3f}")
Розподіл класів у тестовій вибірці:
  Клас 0: 285 (95.0%)
  Клас 1: 15 (5.0%)

ROC-AUC: 0.976
Average Precision: 0.743
# Візуалізація обох кривих
fig, axes = plt.subplots(1, 2, figsize=(14, 6))

# ROC-крива
axes[0].plot(fpr_imb, tpr_imb, linewidth=2.5, color='#3b82f6',
             label=f'AUC = {auc_imb:.3f}')
axes[0].plot([0, 1], [0, 1], 'k--', linewidth=2, alpha=0.7)
axes[0].set_xlabel('False Positive Rate', fontsize=12)
axes[0].set_ylabel('True Positive Rate', fontsize=12)
axes[0].set_title('ROC-крива (здається відмінно!)', fontsize=13)
axes[0].legend(loc='lower right')
axes[0].grid(alpha=0.3)

# Precision-Recall крива
axes[1].plot(recall, precision, linewidth=2.5, color='#f59e0b',
             label=f'AP = {avg_precision:.3f}')
axes[1].axhline(y=(y_test_imb == 1).mean(), color='k', linestyle='--',
                linewidth=2, alpha=0.7, label='Baseline (випадкова)')
axes[1].set_xlabel('Recall', fontsize=12)
axes[1].set_ylabel('Precision', fontsize=12)
axes[1].set_title('PR-крива (реалістичніша оцінка)', fontsize=13)
axes[1].legend(loc='lower left')
axes[1].grid(alpha=0.3)

plt.tight_layout()
plt.show()
Specificity та інші метрики
Крім основних метрик, існують додаткові показники, корисні в певних контекстах.
Specificity (True Negative Rate)
Specificity — це аналог Recall для негативного класу:
Відповідає на питання: "Яка частка справжніх негативних випадків правильно визначена?"
from sklearn.metrics import confusion_matrix

# Обчислення Specificity вручну
cm = confusion_matrix(y_test, model.predict(X_test))
TN, FP, FN, TP = cm.ravel()

specificity = TN / (TN + FP)
sensitivity = TP / (TP + FN)  # Це той самий Recall

print(f"Confusion Matrix:")
print(cm)
print(f"\nSensitivity (Recall для класу 1): {sensitivity:.3f}")
print(f"Specificity (Recall для класу 0): {specificity:.3f}")
print(f"\nІнтерпретація:")
print(f"  Серед {TP + FN} хворих виявлено {TP} ({sensitivity:.1%})")
print(f"  Серед {TN + FP} здорових правильно визначено {TN} ({specificity:.1%})")

import matplotlib.pyplot as plt

fig, ax = plt.subplots(figsize=(6.5, 5.5))
ax.imshow(cm, cmap='Blues')
for i in range(2):
    for j in range(2):
        ax.text(j, i, cm[i, j], ha='center', va='center', fontsize=22,
                color='white' if cm[i, j] > 50 else '#1f2937')
ax.set_xticks([0, 1]); ax.set_xticklabels(['Здоровий', 'Хворий'])
ax.set_yticks([0, 1]); ax.set_yticklabels(['Здоровий', 'Хворий'])
ax.set_xlabel('Прогноз'); ax.set_ylabel('Факт')
ax.set_title(f'Specificity = {specificity:.1%}  |  Sensitivity = {sensitivity:.1%}', fontsize=12)
plt.show()
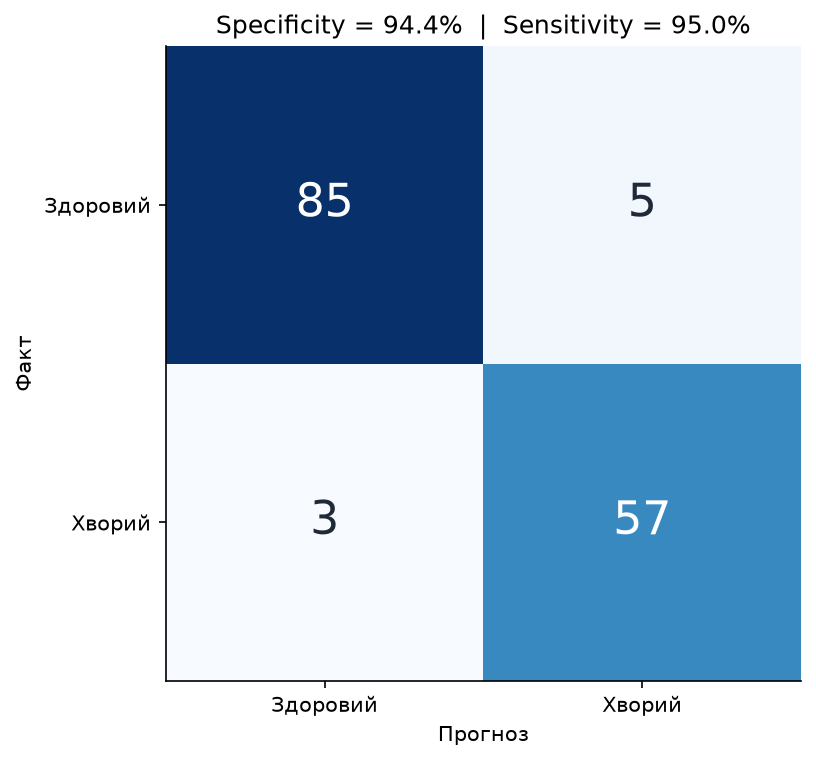
Confusion Matrix:
[[85  5]
 [ 3 57]]

Sensitivity (Recall для класу 1): 0.950
Specificity (Recall для класу 0): 0.944

Інтерпретація:
  Серед 60 хворих виявлено 57 (95.0%)
  Серед 90 здорових правильно визначено 85 (94.4%)
Negative Predictive Value (NPV)
NPV — це аналог Precision для негативних прогнозів:
Відповідає на питання: "Серед усіх прогнозів 'негативний', скільки справді були негативними?"
Зведена таблиця метрик
| Метрика | Формула | Питання | Коли важлива |
|---|---|---|---|
| Precision | Завантаження... | Скільки з прогнозів "+1" правильні? | Висока ціна FP |
| Recall (Sensitivity) | Завантаження... | Скільки справжніх "+1" виявлено? | Висока ціна FN |
| Specificity | Завантаження... | Скільки справжніх "0" правильно визначено? | Баланс обох класів |
| NPV | Завантаження... | Скільки з прогнозів "0" правильні? | Важлива якість негативних прогнозів |
| F1-Score | Завантаження... | Баланс Precision та Recall | Загальна оцінка |
| Accuracy | Завантаження... | Скільки всього правильних прогнозів? | Збалансовані класи |
Classification Report: комплексний звіт
Sklearn надає зручний інструмент classification_report, який виводить усі основні метрики одним викликом.
from sklearn.metrics import classification_report

# Прогнози моделі
y_pred = model.predict(X_test)

# Генерація звіту
report = classification_report(y_test, y_pred,
                               target_names=['Здоровий', 'Хворий'])

print(report)

import matplotlib.pyplot as plt

rep = classification_report(y_test, y_pred, target_names=['Здоровий', 'Хворий'],
                            output_dict=True)
classes = ['Здоровий', 'Хворий']
metrics = ['precision', 'recall', 'f1-score']
colors = ['#3b82f6', '#ef4444', '#8b5cf6']

x = np.arange(len(classes))
plt.figure(figsize=(9, 5))
for k, (m, c) in enumerate(zip(metrics, colors)):
    vals = [rep[cl][m] for cl in classes]
    plt.bar(x + (k - 1) * 0.25, vals, 0.25, label=m, color=c)
    for xi, v in zip(x, vals):
        plt.text(xi + (k - 1) * 0.25, v + 0.005, f'{v:.2f}', ha='center', fontsize=10)
plt.xticks(x, classes)
plt.ylim(0.85, 1.0)
plt.title('Метрики по класах (classification_report)', fontsize=13)
plt.legend()
plt.show()
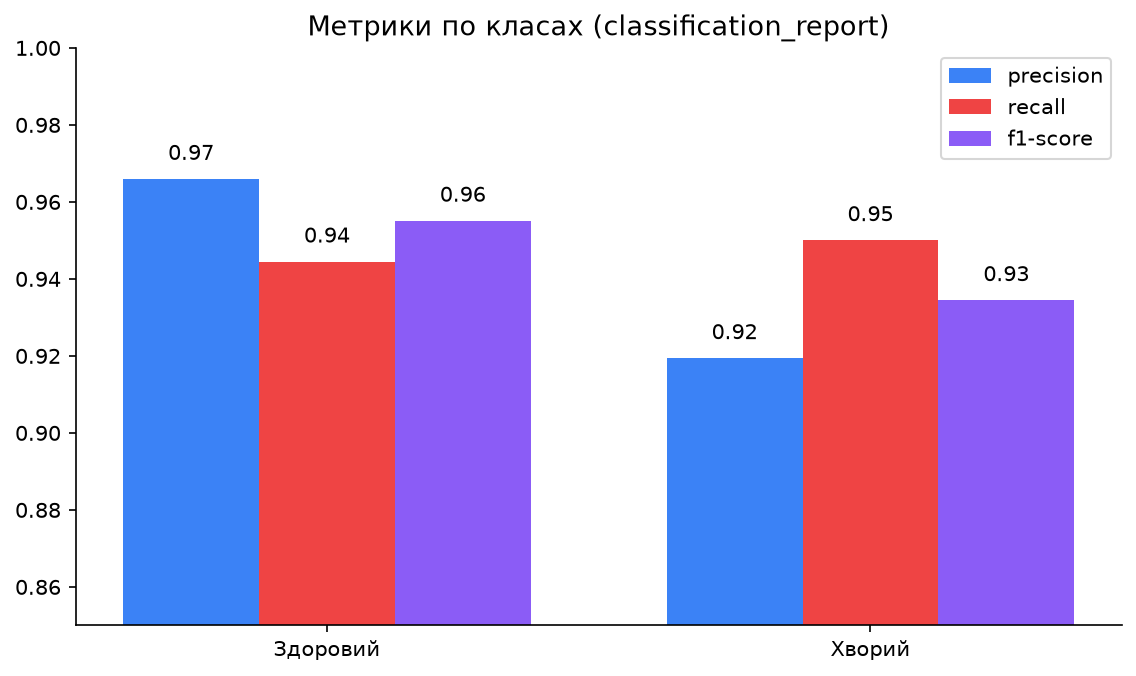
              precision    recall  f1-score   support

    Здоровий       0.97      0.94      0.95        90
      Хворий       0.92      0.95      0.93        60

    accuracy                           0.95       150
   macro avg       0.94      0.95      0.94       150
weighted avg       0.95      0.95      0.95       150
Розшифровка рядків звіту
- macro avg — коли класи рівнозначні (навіть якщо їх кількість різна)
- weighted avg — коли важливіший більший клас
Проблема незбалансованих класів
Незбалансовані класи (imbalanced classes) — це ситуація, коли один клас зустрічається значно частіше за інший (наприклад, 95% на 5%).
Чому це проблема?
- Модель схильна передбачати більшинський клас: вона отримує високу accuracy, просто завжди прогнозуючи клас 0
- Меншинський клас (часто найважливіший!) ігнорується: наприклад, в медицині хворі — це меншість, але їх виявлення критично важливе
- Стандартні метрики (Accuracy) оманливі
Стратегії боротьби з незбалансованістю
Найпростіший підхід — знизити поріг для класу 1, щоб модель частіше його прогнозувала.
# За замовчуванням: поріг = 0.5
y_pred_default = (y_probs_imb >= 0.5).astype(int)
recall_default = recall_score(y_test_imb, y_pred_default)

# Знижений поріг для меншинського класу
y_pred_tuned = (y_probs_imb >= 0.2).astype(int)
recall_tuned = recall_score(y_test_imb, y_pred_tuned)

print(f"Поріг 0.5: Recall = {recall_default:.3f}")
print(f"Поріг 0.2: Recall = {recall_tuned:.3f}")

import matplotlib.pyplot as plt

plt.figure(figsize=(7, 5))
bars = plt.bar(['Поріг 0.5', 'Поріг 0.2'], [recall_default, recall_tuned],
               color=['#94a3b8', '#10b981'], width=0.5)
for bar, v in zip(bars, [recall_default, recall_tuned]):
    plt.text(bar.get_x() + bar.get_width() / 2, v + 0.02, f'{v:.3f}', ha='center', fontsize=12)
plt.ylim(0, 1.1)
plt.ylabel('Recall')
plt.title('Зниження порогу підвищує Recall', fontsize=13)
plt.show()
- Завжди починайте з аналізу розподілу класів
- Не покладайтеся лише на Accuracy — використовуйте Recall, Precision, F1, AUC
- Спробуйте class_weight='balanced' — це найпростіший та часто ефективний спосіб
- Для екстремальної незбалансованості (99:1) — SMOTE + ансамблі
Порівняння моделей: практичний приклад
Розглянемо повний пайплайн оцінювання кількох моделей на одному датасеті.
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score, roc_auc_score

# Навчання трьох різних моделей
models = {
    'Logistic Regression': LogisticRegression(random_state=42, max_iter=1000),
    'Decision Tree': DecisionTreeClassifier(random_state=42, max_depth=5),
    'Random Forest': RandomForestClassifier(random_state=42, n_estimators=100)
}

results = []

for name, model in models.items():
    # Навчання
    model.fit(X_train, y_train)

    # Прогнози
    y_pred = model.predict(X_test)
    y_probs = model.predict_proba(X_test)[:, 1]

    # Метрики
    results.append({
        'Model': name,
        'Accuracy': accuracy_score(y_test, y_pred),
        'Precision': precision_score(y_test, y_pred),
        'Recall': recall_score(y_test, y_pred),
        'F1-Score': f1_score(y_test, y_pred),
        'ROC-AUC': roc_auc_score(y_test, y_probs)
    })

# Порівняльна таблиця
import pandas as pd
results_df = pd.DataFrame(results)
print(results_df.to_string(index=False))
                Model  Accuracy  Precision  Recall  F1-Score  ROC-AUC
 Logistic Regression     0.947      0.919   0.950     0.934    0.976
        Decision Tree     0.913      0.871   0.917     0.893    0.911
        Random Forest     0.953      0.935   0.950     0.942    0.984
# Побудова графіка порівняння
fig, ax = plt.subplots(figsize=(12, 6))

metrics = ['Accuracy', 'Precision', 'Recall', 'F1-Score', 'ROC-AUC']
x = np.arange(len(metrics))
width = 0.25

for i, (name, row) in enumerate(results_df.iterrows()):
    values = [row[m] for m in metrics]
    ax.bar(x + i * width, values, width, label=row['Model'], alpha=0.8)

ax.set_xlabel('Метрики', fontsize=12)
ax.set_ylabel('Значення', fontsize=12)
ax.set_title('Порівняння моделей за різними метриками', fontsize=14, pad=15)
ax.set_xticks(x + width)
ax.set_xticklabels(metrics)
ax.legend()
ax.set_ylim([0.85, 1.0])
ax.grid(axis='y', alpha=0.3)
plt.tight_layout()
plt.show()

# Висновок
best_model = results_df.loc[results_df['ROC-AUC'].idxmax(), 'Model']
print(f"\n🏆 Найкраща модель за ROC-AUC: {best_model}")
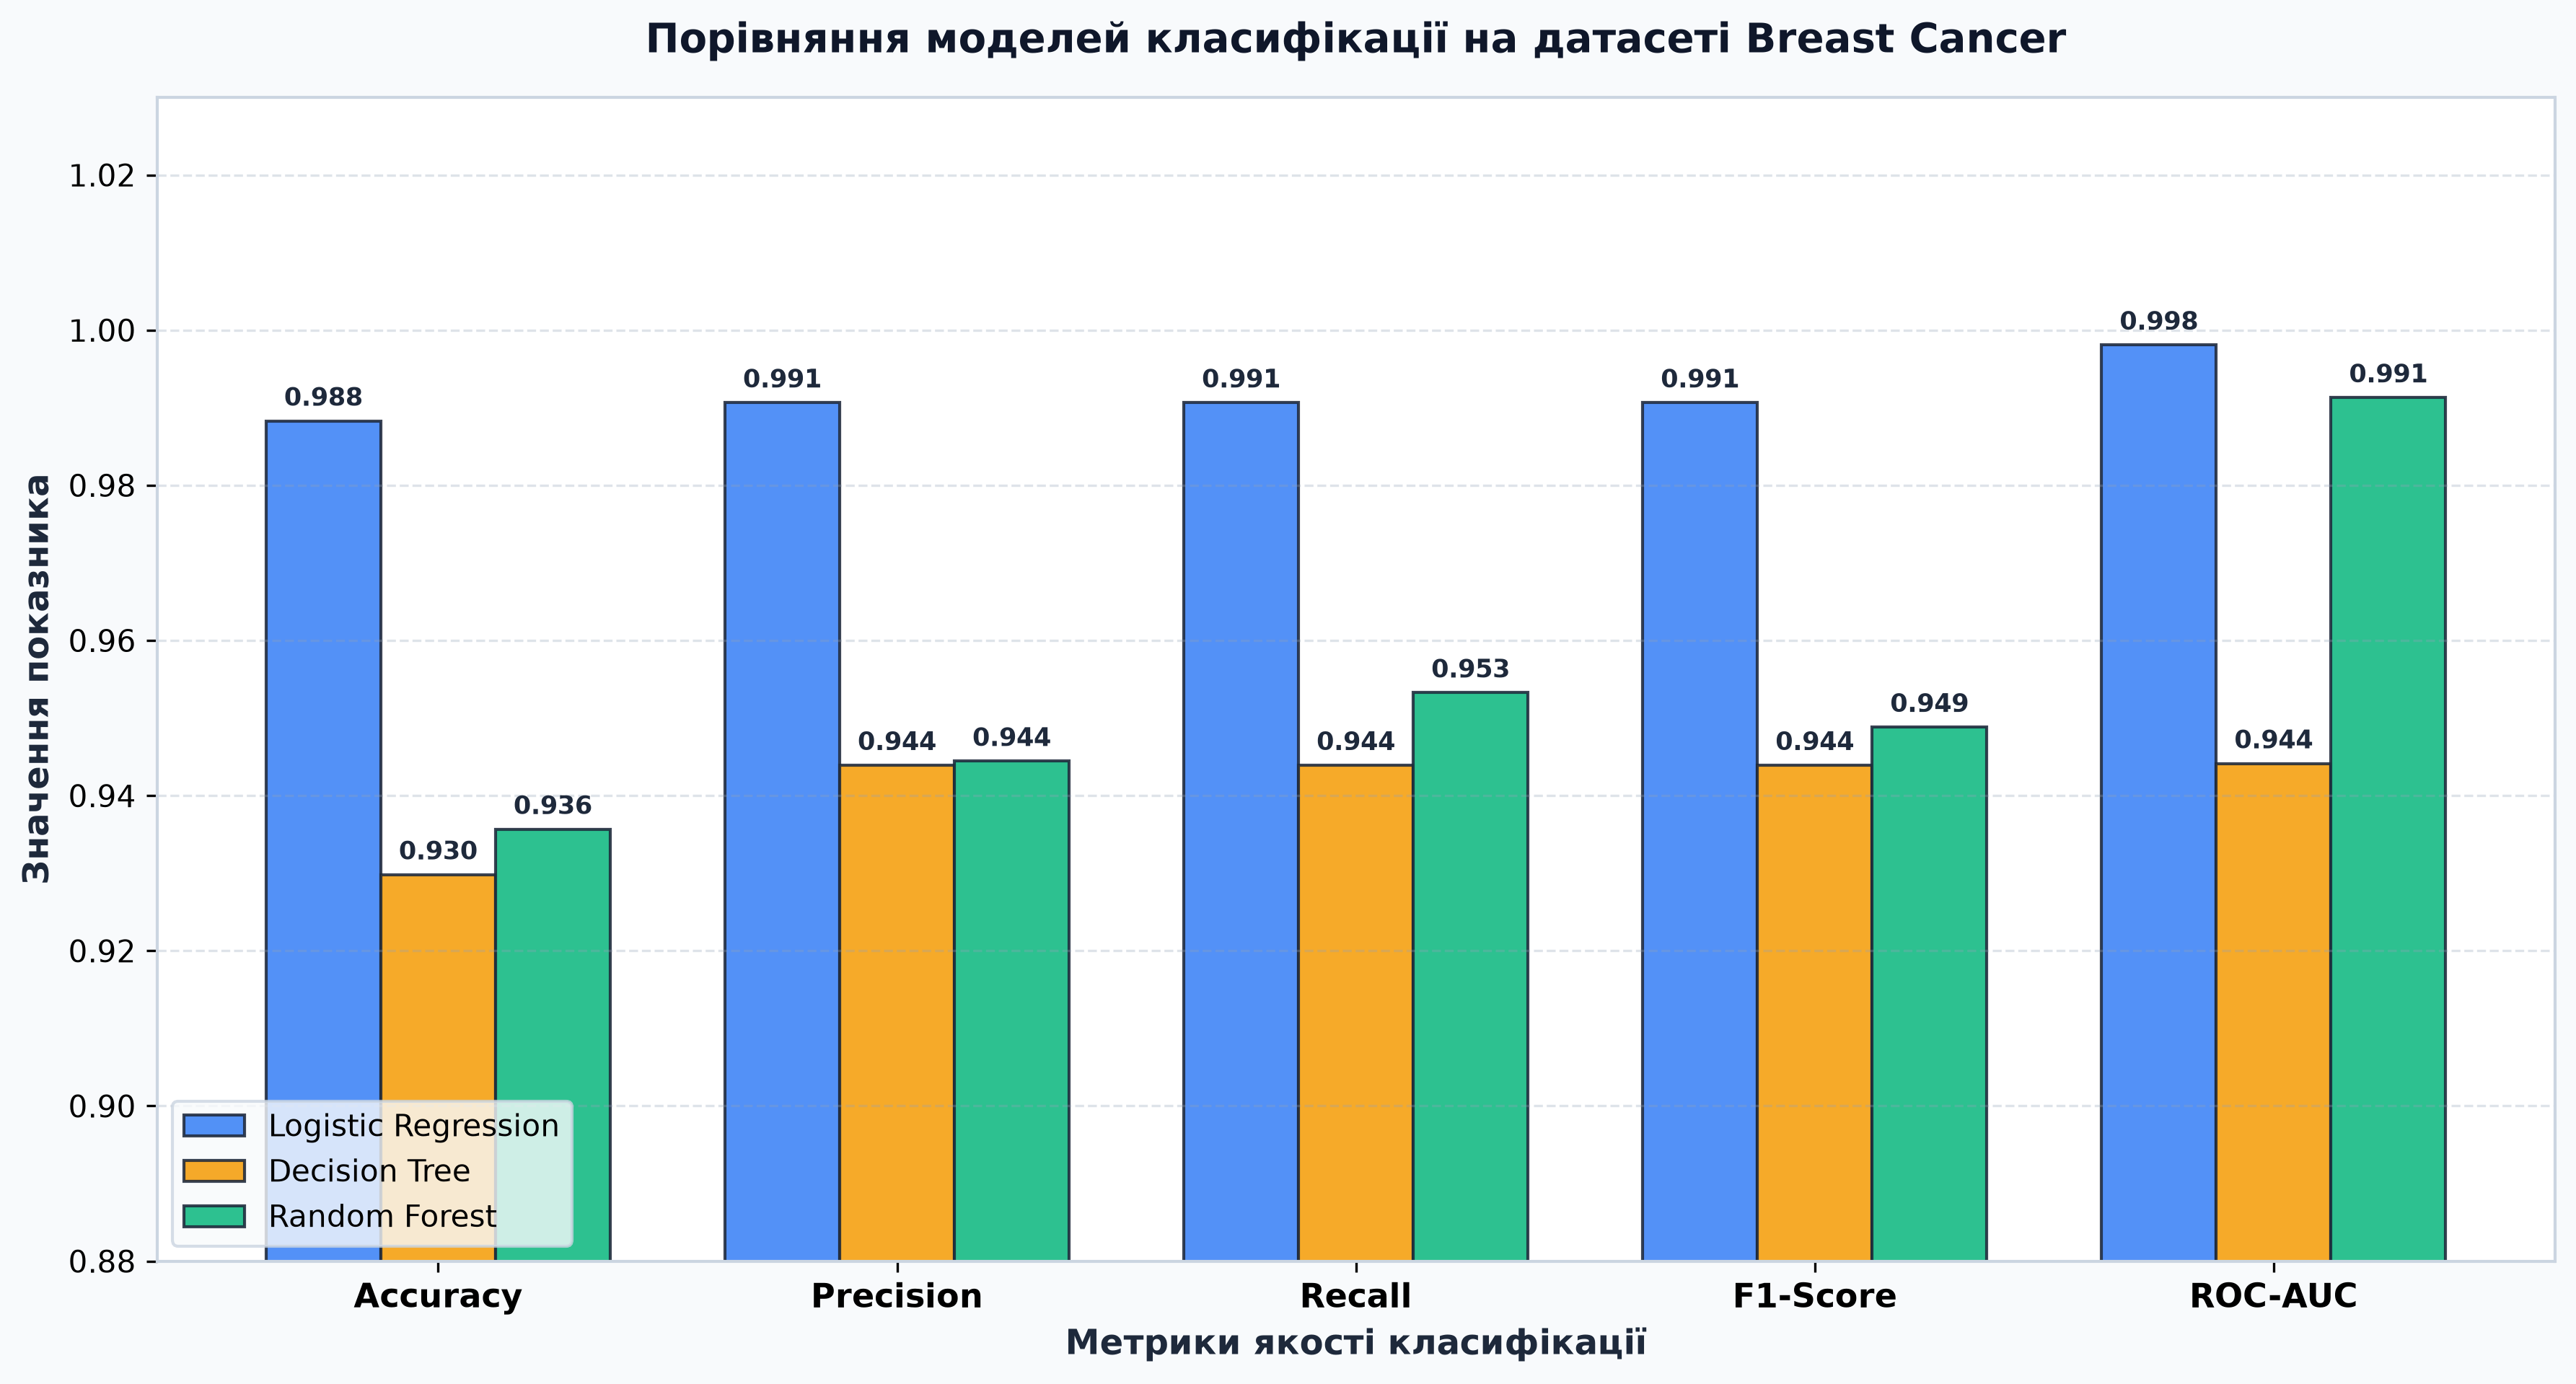
🏆 Найкраща модель за ROC-AUC: Random Forest
Типові помилки при оцінюванні моделей
Проблема: Accuracy не враховує незбалансованість класів та різну ціну помилок.
Рішення: Завжди дивіться на Confusion Matrix, Precision, Recall та F1-Score.
Проблема: Модель досягає 95% accuracy, просто завжди передбачаючи більшинський клас.
Рішення: Перевірте розподіл класів (np.bincount(y)), використовуйте class_weight='balanced' або SMOTE.
Проблема: Використання порогу 0.5 за замовчуванням для всіх задач.
Рішення: Оберіть поріг на основі бізнес-вимог — високий Recall для медицини, високий Precision для спам-фільтрів.
Проблема: Студенти часто плутають ці дві метрики.
Мнемоніка:
- Recall: з усіх справжніх позитивних, скільки REвернули (повернули назад, виявили)
- Precision: з усіх PREdicted позитивних (прогнозованих), скільки правильних
Проблема: Оцінювання на одній тестовій вибірці може дати завищ або зан занижену оцінку.
Рішення:
from sklearn.model_selection import cross_val_score

scores = cross_val_score(model, X, y, cv=5, scoring='f1')
print(f"F1-Score (5-fold CV): {scores.mean():.3f} ± {scores.std():.3f}")
Резюме статті
✅ Accuracy
✅ Confusion Matrix
✅ Precision
✅ Recall
✅ F1-Score
✅ ROC-AUC
✅ PR-крива
✅ Незбалансованість
class_weight='balanced', SMOTE або налаштування порогу.Інтерактивні запитання для самоперевірки
Уявіть датасет з 95% класу 0 та 5% класу 1 (наприклад, здорові та хворі пацієнти). "Модель", яка завжди передбачає клас 0, матиме accuracy = 95%, але вона марна — не виявляє жодного хворого!
Висновок: Accuracy може бути оманливою метрикою для незбалансованих класів. Завжди дивіться на розподіл класів та додаткові метрики (Precision, Recall, F1).
Precision відповідає на питання: "Коли модель каже 'так', наскільки їй можна вірити?"
- Приклад: з 100 прогнозів "спам" насправді спамом були 85. Precision = 85%.
Recall відповідає на питання: "З усіх випадків 'так', скільки модель знайшла?"
- Приклад: існувало 200 спам-листів, модель знайшла 150. Recall = 75%.
Аналогія (Риболовля):
- Precision: скільки з виловлених риб — справді риби (а не черевики чи сміття)
- Recall: скільки риб із водойми вдалося виловити
Коли ціна пропуску (False Negative) значно вища за ціну хибної тривоги (False Positive):
Приклади:
- Діагностика раку: краще направити здорову людину на зайві обстеження (FP), ніж пропустити хворобу (FN) 🏥
- Виявлення шахрайства: краще заблокувати легальну транзакцію (FP), ніж пропустити шахрайство (FN) 💳
- Пошук зниклих людей: краще перевірити 10 хибних сигналів (FP), ніж пропустити реальну людину (FN) 🚨
Стратегія: знизити поріг класифікації (наприклад, з 0.5 до 0.3), щоб модель частіше прогнозувала позитивний клас.
AUC = 0.5 означає, що модель працює не краще за випадкове вгадування (кидок монети).
Уявіть, що ви просто кидаєте монету: орел = клас 1, решка = клас 0. Така "модель" матиме AUC ≈ 0.5.
Висновок: якщо ваша модель показує AUC близько 0.5, вона не навчилася нічого корисного. Потрібні:
- Додаткові інформативні ознаки
- Інший алгоритм
- Перевірка правильності даних (можливо, мітки перемішані)
F1-Score = 0.8 означає, що модель досягла хорошого балансу між Precision та Recall.
Шкала інтерпретації:
- F1 > 0.9: відмінна модель
- 0.7 < F1 ≤ 0.9: хороша модель
- 0.5 < F1 ≤ 0.7: посередня модель
- F1 ≤ 0.5: слабка модель
Важливо: F1 = 0.8 не означає 80% accuracy! Це окрема метрика, яка враховує як точність, так і повноту позитивних прогнозів.
ROC-крива використовує FPR (False Positive Rate) у знаменнику якого — велика кількість негативних прикладів (TN + FP). Для незбалансованих датасетів (95% класу 0) навіть багато FP не сильно впливають на FPR, тому ROC виглядає оптимістично.
PR-крива фокусується на Precision та Recall, які безпосередньо залежать від позитивного класу (меншинського). Вона точніше показує, наскільки добре модель працює з рідкісним класом.
Правило: якщо позитивний клас < 20% від датасету, використовуйте PR-криву замість ROC.
Практичні завдання
Мета: навчитися інтерпретувати Confusion Matrix та обчислювати метрики вручну.
Дано:
Модель класифікує email на спам (1) / не спам (0). Confusion Matrix:
[[850  50]
 [ 30  70]]
Завдання:
- Визначте TP, TN, FP, FN
- Обчисліть вручну:
- Accuracy
- Precision
- Recall
- F1-Score
- Поясніть: чи підходить ця модель для production? Які ризики?
import numpy as np

cm = np.array([[850, 50],
               [30, 70]])

# 1. Визначення компонентів
TN, FP = cm[0]
FN, TP = cm[1]

print(f"True Negatives (TN): {TN}")   # 850
print(f"False Positives (FP): {FP}")  # 50
print(f"False Negatives (FN): {FN}")  # 30
print(f"True Positives (TP): {TP}")   # 70

# 2. Обчислення метрик
accuracy = (TP + TN) / (TP + TN + FP + FN)
precision = TP / (TP + FP)
recall = TP / (TP + FN)
f1 = 2 * (precision * recall) / (precision + recall)

print(f"\nAccuracy:  {accuracy:.3f}  (92.0%)")
print(f"Precision: {precision:.3f} (58.3%)")
print(f"Recall:    {recall:.3f}    (70.0%)")
print(f"F1-Score:  {f1:.3f}        (63.6%)")

# 3. Аналіз
print("\n🔍 Аналіз:")
print(f"- Модель блокує {FP} легальних листів як спам (False Positive)")
print(f"- Пропускає {FN} спам-листів у вхідні (False Negative)")
print(f"- Precision = {precision:.1%} — тільки 58% заблокованих листів — справді спам")
print(f"- Це ПОГАНА модель для спам-фільтра! Блокує багато важливих листів.")
Висновок: модель має низький Precision (58%), що означає багато хибних тривог. Для спам-фільтра це неприйнятно — користувачі втрачають важливі листи.
Мета: навчитися підбирати оптимальний поріг для конкретної задачі.
Завдання:
- Завантажте датасет Breast Cancer Wisconsin
- Навчіть логістичну регресію
- Протестуйте пороги від 0.1 до 0.9 (крок 0.1)
- Для кожного порогу обчисліть Precision, Recall, F1
- Знайдіть поріг, що максимізує:
- F1-Score
- Recall (пріоритет медицини — виявити всіх хворих)
- Побудуйте графік Precision та Recall від порогу
- Поясніть, який поріг обрали б ви та чому
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import precision_score, recall_score, f1_score
import matplotlib.pyplot as plt

# 1. Завантаження даних
data = load_breast_cancer()
X, y = data.data, data.target

# Розділення
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42, stratify=y
)

# Масштабування
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 2. Навчання моделі
model = LogisticRegression(max_iter=10000, random_state=42)
model.fit(X_train_scaled, y_train)
y_probs = model.predict_proba(X_test_scaled)[:, 1]

# 3-4. Тестування порогів
thresholds = np.arange(0.1, 1.0, 0.1)
results = []

for threshold in thresholds:
    y_pred = (y_probs >= threshold).astype(int)
    precision = precision_score(y_test, y_pred)
    recall = recall_score(y_test, y_pred)
    f1 = f1_score(y_test, y_pred)

    results.append({
        'Threshold': threshold,
        'Precision': precision,
        'Recall': recall,
        'F1': f1
    })

results_df = pd.DataFrame(results)
print("Результати для різних порогів:")
print(results_df.to_string(index=False))

# 5. Оптимальні пороги
best_f1_idx = results_df['F1'].idxmax()
best_recall_idx = results_df['Recall'].idxmax()

print(f"\n🎯 Оптимальний поріг для F1-Score: {results_df.loc[best_f1_idx, 'Threshold']:.1f}")
print(f"   F1 = {results_df.loc[best_f1_idx, 'F1']:.3f}")

print(f"\n🏥 Оптимальний поріг для Recall (медицина): {results_df.loc[best_recall_idx, 'Threshold']:.1f}")
print(f"   Recall = {results_df.loc[best_recall_idx, 'Recall']:.3f}")
Контрольний чеклист: як правильно оцінити модель класифікації
Крок 1: Перевірте розподіл класів
print(np.bincount(y_train))
print(f"Клас 0: {(y_train == 0).mean():.1%}")
print(f"Клас 1: {(y_train == 1).mean():.1%}")
Якщо класи незбалансовані (>70% на <30%), будьте обережні з Accuracy.
Крок 2: Побудуйте Confusion Matrix
from sklearn.metrics import ConfusionMatrixDisplay
ConfusionMatrixDisplay.from_estimator(model, X_test, y_test)
plt.show()
Візуально оцініть співвідношення TP, TN, FP, FN.
Крок 3: Обчисліть основні метрики
from sklearn.metrics import classification_report
print(classification_report(y_test, y_pred,
                           target_names=['Клас 0', 'Клас 1']))
Дивіться на Precision, Recall, F1 для кожного класу окремо.
Крок 4: Оцініть ROC-AUC або PR-AUC
# Для збалансованих класів
roc_auc = roc_auc_score(y_test, y_probs)

# Для незбалансованих класів
from sklearn.metrics import average_precision_score
pr_auc = average_precision_score(y_test, y_probs)
Крок 5: Налаштуйте поріг (якщо потрібно)
# Перевірте різні пороги
for threshold in [0.3, 0.5, 0.7]:
    y_pred_custom = (y_probs >= threshold).astype(int)
    print(f"Поріг {threshold}: Recall = {recall_score(y_test, y_pred_custom):.2f}")
Крок 6: Порівняйте з baseline
Створіть просту baseline-модель (наприклад, завжди передбачає більшинський клас) і переконайтеся, що ваша модель значно краща.
Фінальне резюме
🎯 Головний урок
📐 Вибір метрики
- Медицина, безпека: Recall (не пропустити FN)
- Спам, фінанси: Precision (не допустити FP)
- Загальний випадок: F1-Score (баланс)
⚖️ Незбалансованість
class_weight='balanced', SMOTE або налаштування порогу. Перевіряйте PR-криву замість ROC.📊 Порівняння моделей
Тепер ви готові професійно оцінювати моделі класифікації! 🚀
Основи класифікації та логістична регресія
Що таке задача класифікації, чим відрізняється від регресії, основи логістичної регресії та сигмоїдна функція
Вступ до нейронних мереж — від персептрона до багатошарових мереж
Еволюція від одношарового персептрона до багатошарових нейронних мереж. Функції активації, прямий та зворотний прохід, оптимізатори.