Вступ до нейронних мереж — від персептрона до багатошарових мереж
Від одного нейрона до мереж — чому лінійності недостатньо
Уявіть, що ви програміст у 1950-х роках і отримуєте завдання: навчити комп'ютер розпізнавати рукописні цифри. У вас немає готових бібліотек, лише базові математичні операції. З чого почати?
Інтуїція підказує: кожен піксель зображення — це число (яскравість). Якщо помножити кожен піксель на свою «вагу важливості» та просумувати, отримаємо «оцінку схожості» на певну цифру. Саме так народилася ідея персептрона — першої нейронної мережі.
Але швидко з'ясувалося: одного персептрона недостатньо. Він може розв'язати лише найпростіші задачі — ті, де класи можна розділити прямою лінією. Більшість реальних задач — складніші. Потрібна мережа персептронів, де виходи одних стають входами для інших. Так з'явилися багатошарові нейронні мережі.
🎯 Мета статті
- Зрозуміти структуру та обмеження одношарового персептрона
- Опанувати концепцію багатошарового персептрона (MLP) та роль прихованих шарів
- Вивчити функції активації та їхню критичну роль у створенні нелінійності
- Розібрати алгоритми прямого поширення (forward propagation) та зворотного поширення помилки (backpropagation)
- Познайомитися з оптимізаторами SGD, Momentum та Adam
🔑 Ключові терміни
- Персептрон (Perceptron): найпростіша нейронна мережа з одним шаром ваг
- MLP (Multi-Layer Perceptron): багатошарова нейронна мережа з прихованими шарами
- Функція активації (Activation Function): нелінійна функція, що перетворює зважену суму нейрона
- Прямий прохід (Forward Propagation): обчислення виходу мережі від входу до виходу
- Зворотний прохід (Backpropagation): обчислення градієнтів втрат по всіх вагах мережі
- Оптимізатор (Optimizer): алгоритм оновлення ваг на основі градієнтів
Архітектура персептрона — перший штучний нейрон
Персептрон — це математична модель біологічного нейрона, запропонована Френком Розенблаттом у 1957 році. Його структура надзвичайно проста, але концептуально революційна для свого часу.
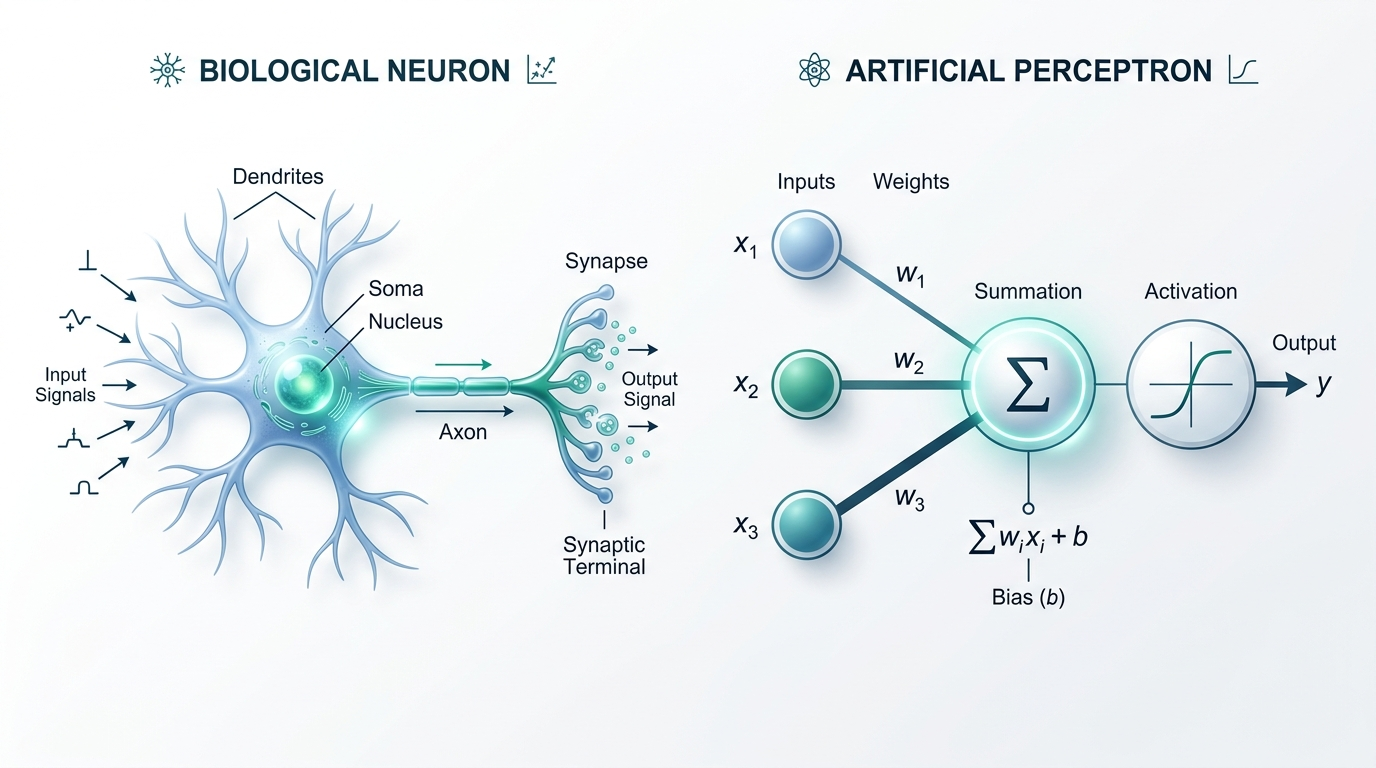
Структура персептрона
Персептрон складається з чотирьох компонентів:
Крок 1. Вхідний шар (Input Layer)
Кожна ознака об'єкта — це окремий вхід Завантаження.... Наприклад, для класифікації квіта Ірис:
- Завантаження... = довжина пелюстки
- Завантаження... = ширина пелюстки
- Завантаження... = довжина чашолистка
- Завантаження... = ширина чашолистка
Крок 2. Ваги (Weights) та зсув (Bias)
Кожен вхід Завантаження... має свою вагу Завантаження..., яка визначає, наскільки ця ознака важлива для передбачення. Додатково є зсув Завантаження... (bias), що дозволяє зміщувати порогову межу.
Інтуїція: Якщо довжина пелюстки дуже важлива для розпізнавання виду, то Завантаження... буде великою вагою. Якщо ознака неінформативна — вага буде близькою до нуля.
Крок 3. Зважена сума (Weighted Sum)
Обчислюється лінійна комбінація входів та ваг:
Або у векторній формі:
Крок 4. Функція активації (Activation Function)
Зважена сума Завантаження... перетворюється функцією активації Завантаження.... Для класичного персептрона це функція кроку (step function):
Результат Завантаження... — це передбачення класу: 1 або 0.
Об'єднуючи зважену суму та функцію активації, отримуємо повну математичну формулу функції персептрона Завантаження...:
Або у розгорнутій формі через суму всіх вхідних ознак:
Візуалізація персептрона
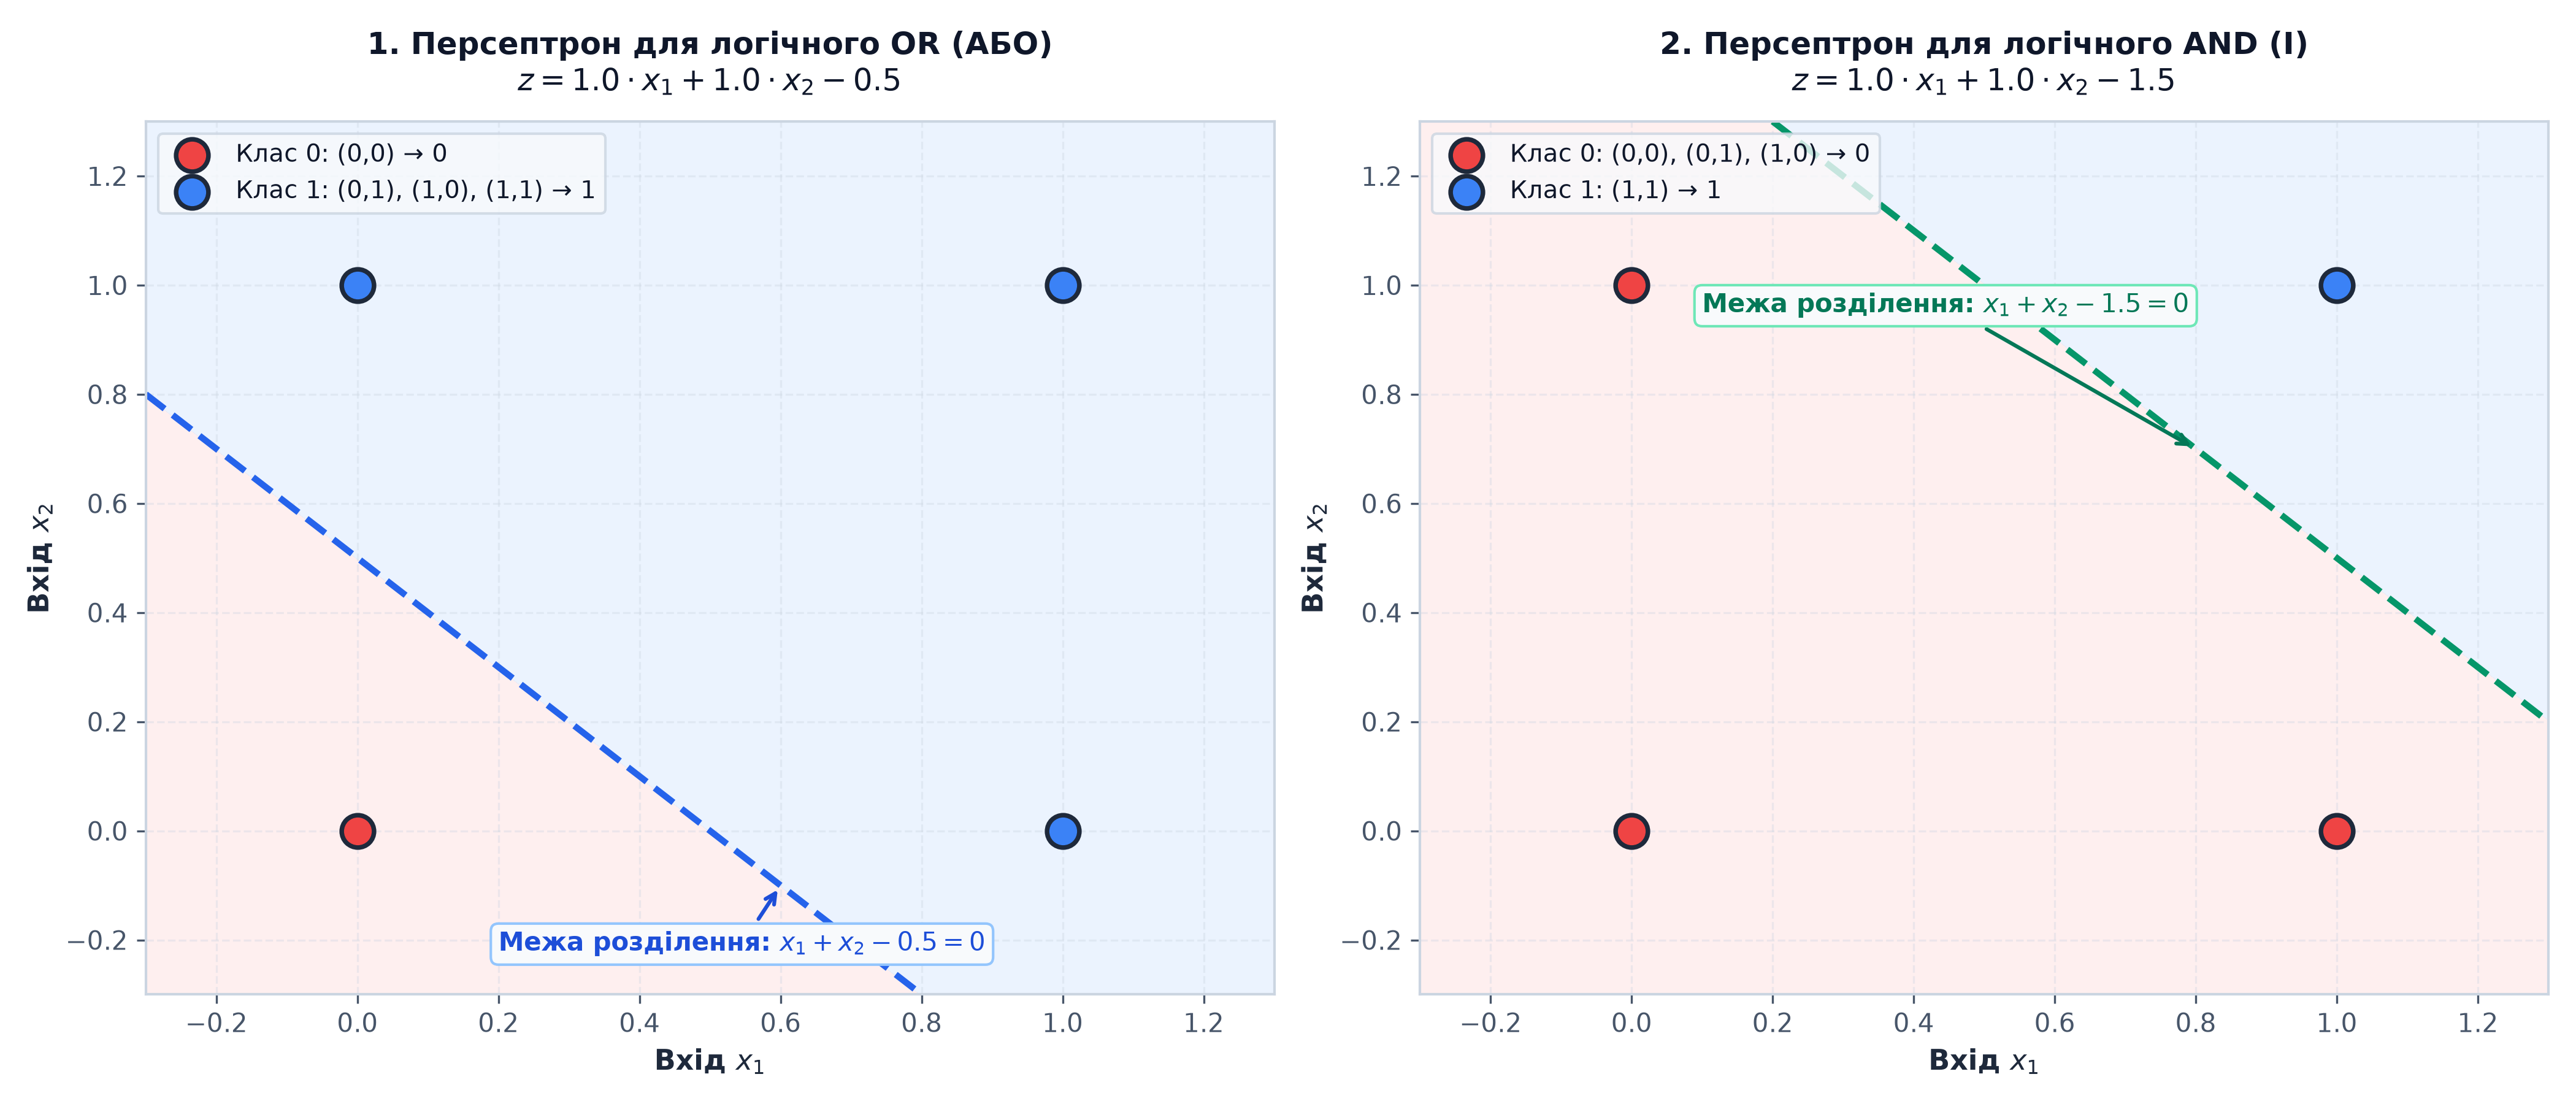
Приклад: персептрон для логічного АБО (OR)
Розглянемо найпростішу задачу: навчити персептрон логічній операції OR.
Таблиця істинності OR:
| x₁ | x₂ | y (OR) |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 1 |
Питання: чи можна знайти такі ваги Завантаження..., щоб персептрон правильно класифікував всі 4 приклади?
Відповідь: так! Наприклад, Завантаження....
Перевірка:
import numpy as np

def step_function(z):
    """Функція кроку: 1 якщо z >= 0, інакше 0"""
    return 1 if z >= 0 else 0

# Ваги персептрона для OR
w1, w2, b = 1.0, 1.0, -0.5

# Перевірка всіх комбінацій
inputs = [(0, 0), (0, 1), (1, 0), (1, 1)]

print("x₁  x₂  | z = w₁·x₁ + w₂·x₂ + b | σ(z) | Очікується")
print("-" * 55)

for x1, x2 in inputs:
    z = w1 * x1 + w2 * x2 + b
    output = step_function(z)
    expected = int(x1 or x2)
    status = "✓" if output == expected else "✗"
    print(f"{x1}   {x2}   |  {z:6.2f}               | {output}    | {expected}        {status}")
| $x_1$ | $x_2$ | $z = w_1 x_1 + w_2 x_2 + b$ | $\sigma(z)$ (вихід) | Очікуване (OR) | Статус тесту |
|---|---|---|---|---|---|
| 0 | 0 | -0.50 | 0 | 0 | ✅ Успішно (клас 0) |
| 0 | 1 | +0.50 | 1 | 1 | ✅ Успішно (клас 1) |
| 1 | 0 | +0.50 | 1 | 1 | ✅ Успішно (клас 1) |
| 1 | 1 | +1.50 | 1 | 1 | ✅ Успішно (клас 1) |
Проблема XOR — межа лінійної роздільності
Персептрон успішно вирішує логічні операції AND, OR, NOT. Але існує одна проста операція, яка повністю розбиває одношаровий персептрон: XOR (виключне АБО).
Таблиця істинності XOR:
| x₁ | x₂ | y (XOR) |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
Питання: чи можна знайти ваги Завантаження... для персептрона, щоб правильно класифікувати XOR?
Відповідь: НІ! Це математично неможливо.
Чому персептрон не може розв'язати XOR?
Персептрон — це лінійний класифікатор. Він може провести лише одну пряму лінію для розділення класів. Подивимося на візуалізацію XOR:
import matplotlib.pyplot as plt
import numpy as np

# Дані XOR
x_coords = [0, 0, 1, 1]
y_coords = [0, 1, 0, 1]
colors = ['red', 'blue', 'blue', 'red']  # клас 0 — червоний, клас 1 — синій
labels = [0, 1, 1, 0]

plt.figure(figsize=(8, 6))
plt.scatter(x_coords, y_coords, c=colors, s=300, edgecolors='black', linewidths=2, alpha=0.7)

# Додаємо підписи точок
for i, (x, y, label) in enumerate(zip(x_coords, y_coords, labels)):
    plt.text(x, y, f'  ({x}, {y})\n  y={label}', fontsize=12, ha='left')

# Спроба провести лінію розділення (завжди помилиться)
plt.axline((0.5, 0), slope=1, color='gray', linestyle='--', linewidth=2, alpha=0.5, label='Неможлива лінія розділення')

plt.xlim(-0.3, 1.5)
plt.ylim(-0.3, 1.5)
plt.xlabel('x₁', fontsize=14)
plt.ylabel('x₂', fontsize=14)
plt.title('Проблема XOR: класи не є лінійно роздільними', fontsize=16, fontweight='bold')
plt.legend(fontsize=12)
plt.grid(alpha=0.3)
plt.tight_layout()
plt.show()
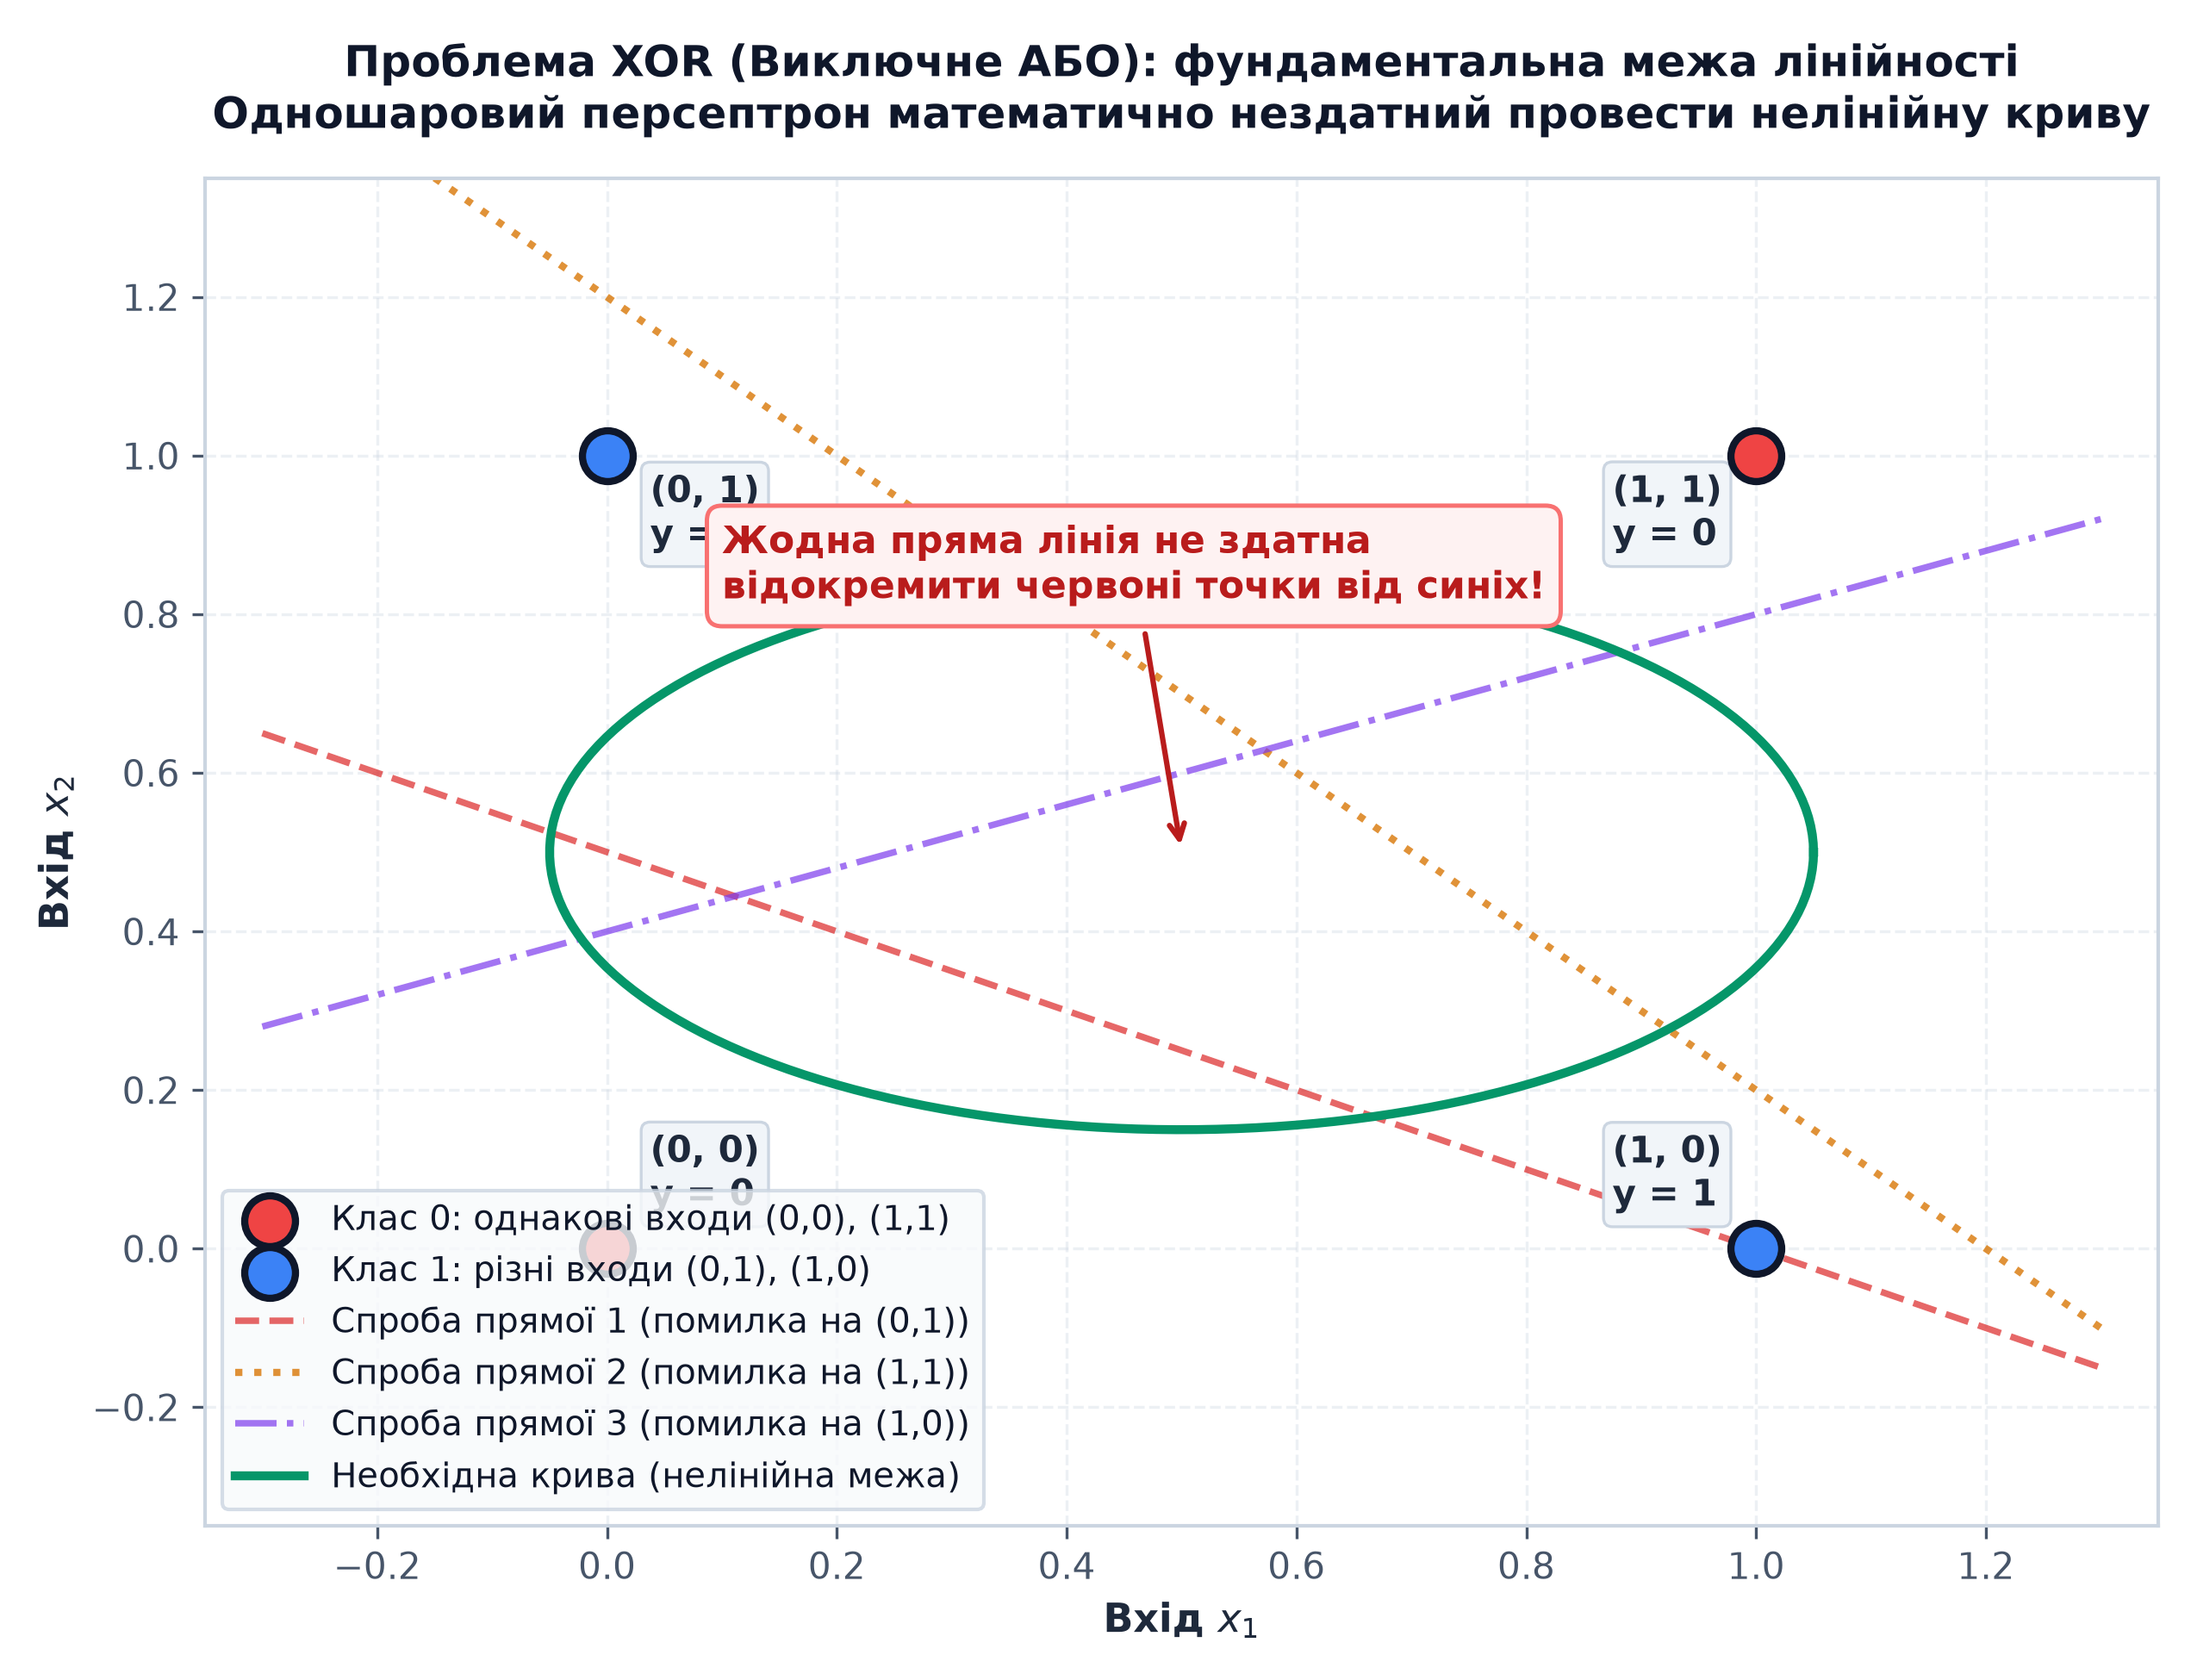
- Персептрон може розв'язувати лише лінійно роздільні задачі — ті, де класи можна розділити гіперплощиною (у 2D — прямою лінією, у 3D — площиною).
- Для XOR червоні точки (клас 0) розташовані діагонально від синіх (клас 1). Жодна пряма лінія не може їх розділити — потрібна крива або дві лінії. Одношаровий персептрон на це не здатний.
Історичний контекст: «зима AI» через XOR
У 1969 році математики Марвін Мінський та Сеймур Паперт опублікували книгу «Персептрони», де математично довели, що одношаровий персептрон принципово не може розв'язати XOR.
Це викликало першу «зиму штучного інтелекту» (1970–1980-ті роки) — різке скорочення фінансування досліджень AI, бо вважалося, що нейронні мережі — тупиковий шлях.
Аналогія з будівництвом:
Уявіть, що ви маєте лише прямокутні цеглини. З них можна збудувати стіни, але неможливо створити арку чи купол — потрібні цеглини інших форм. Одношаровий персептрон — це «прямокутні цеглини». Для складних форм (нелінійних задач) потрібні багатошарові мережі — цеглини різних форм і розмірів.
Рішення проблеми: додати приховані шари нейронів між входом і виходом. Так з'являються багатошарові нейронні мережі (Multi-Layer Perceptron, MLP).
Багатошаровий персептрон (MLP) — прорив у нелінійності
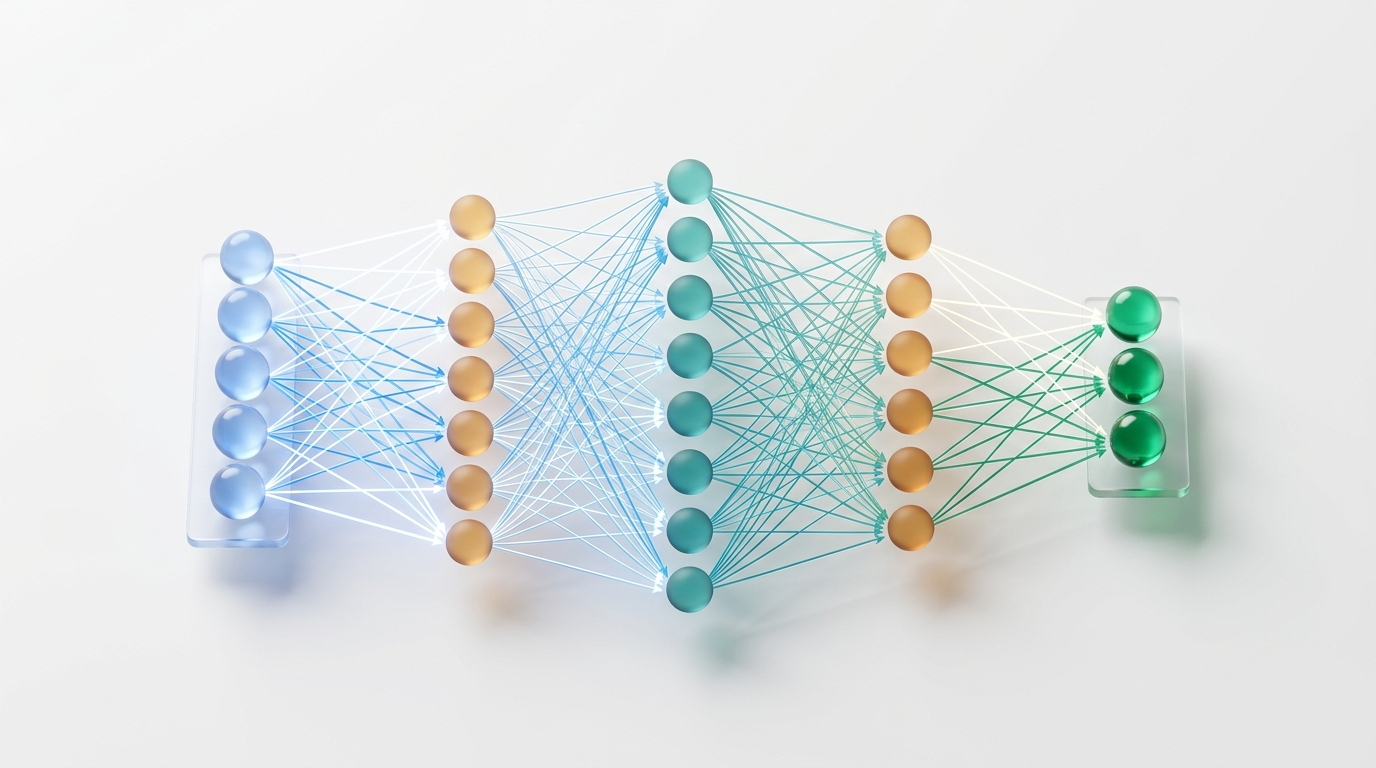
Якщо один персептрон — це одна пряма лінія, то кілька персептронів, з'єднаних у мережу, можуть створювати складні нелінійні межі розділення.
Архітектура MLP
Multi-Layer Perceptron (MLP) — це нейронна мережа, що складається з:
- Вхідного шару (Input Layer): приймає ознаки об'єкта (не виконує обчислень, лише передає дані далі)
- Прихованих шарів (Hidden Layers): один або кілька шарів нейронів, що виконують нелінійні перетворення
- Вихідного шару (Output Layer): повертає передбачення (одне число для регресії, ймовірності класів для класифікації)
Приклад: MLP для розв'язання XOR
Найпростіша архітектура для XOR:
- Вхідний шар: 2 нейрони (Завантаження...)
- Прихований шар: 2 нейрони (дозволяють створити дві лінії розділення)
- Вихідний шар: 1 нейрон (передбачення 0 або 1)
Як MLP розв'язує XOR: покрокове пояснення
Розберемо, як працює MLP з 2 входами → 2 прихованих нейронів → 1 вихід для задачі XOR.
Крок 1: Прихований шар створює проміжні ознаки
Перший прихований нейрон Завантаження... навчається розпізнавати «хоча б один вхід дорівнює 1» (логічне OR).
Другий прихований нейрон Завантаження... навчається розпізнавати «обидва входи дорівнюють 1» (логічне AND).
import numpy as np

def sigmoid(z):
    """Сигмоїда: σ(z) = 1 / (1 + e^(-z))"""
    return 1 / (1 + np.exp(-z))

# Ваги для прихованого шару (підібрані вручну для демонстрації)
W1 = np.array([
    [1.0, 1.0],   # h1: реагує на OR (x1 + x2)
    [1.0, 1.0]    # h2: реагує на AND (x1 * x2 при правильному bias)
])
b1 = np.array([-0.5, -1.5])  # Порогові значення

# Ваги для вихідного шару
W2 = np.array([1.0, -2.0])   # y = h1 - 2*h2
b2 = np.array([0.0])

# Вхідні дані XOR
X = np.array([
    [0, 0],
    [0, 1],
    [1, 0],
    [1, 1]
])

print("Обчислення MLP для XOR:\n")
print("x₁  x₂  | h₁ (OR-подібний) | h₂ (AND-подібний) | z_out      | ŷ (σ(z)) | Очікується")
print("-" * 90)

for x in X:
    # Прихований шар
    z_hidden = W1 @ x + b1
    h = sigmoid(z_hidden)

    # Вихідний шар
    z_out = W2 @ h + b2
    y_pred = sigmoid(z_out)

    expected = int(x[0] != x[1])  # XOR: 1 якщо входи різні
    status = "✓" if round(y_pred[0]) == expected else "✗"

    print(f"{x[0]}   {x[1]}   |      {h[0]:.3f}       |      {h[1]:.3f}        | {z_out[0]:7.3f}   | {y_pred[0]:7.3f}  | {expected}        {status}")
| $x_1$ | $x_2$ | $h_1$ (OR-подібний) | $h_2$ (AND-подібний) | $z_{\text{out}}$ | $\hat{y} = \sigma(z)$ | Очікуване (XOR) | Результат класифікації |
|---|---|---|---|---|---|---|---|
| 0 | 0 | 0.378 | 0.182 | -0.014 | 0.496 | 0 | ✅ Вірно (нижче порогу 0.5) |
| 0 | 1 | 0.622 | 0.378 | -0.134 | 0.467 | 1 | ✅ Вірно (активація $h_1$) |
| 1 | 0 | 0.622 | 0.378 | -0.134 | 0.467 | 1 | ✅ Вірно (активація $h_1$) |
| 1 | 1 | 0.818 | 0.622 | -0.426 | 0.395 | 0 | ✅ Вірно (гальмування $h_2$) |
Крок 2: Вихідний нейрон комбінує проміжні ознаки
Вихідний нейрон $\hat{y}$ обчислює XOR = OR AND NOT AND:
$$\text{XOR}(x_1, x_2) = \text{OR}(x_1, x_2) ; \text{AND NOT} ; \text{AND}(x_1, x_2)$$
Саме це робить формула $\hat{y} = h_1 - 2 \cdot h_2$: якщо обидва входи активні ($h_2$ велике), то сильне від'ємне значення від $-2 \cdot h_2$ «вимикає» вихід.
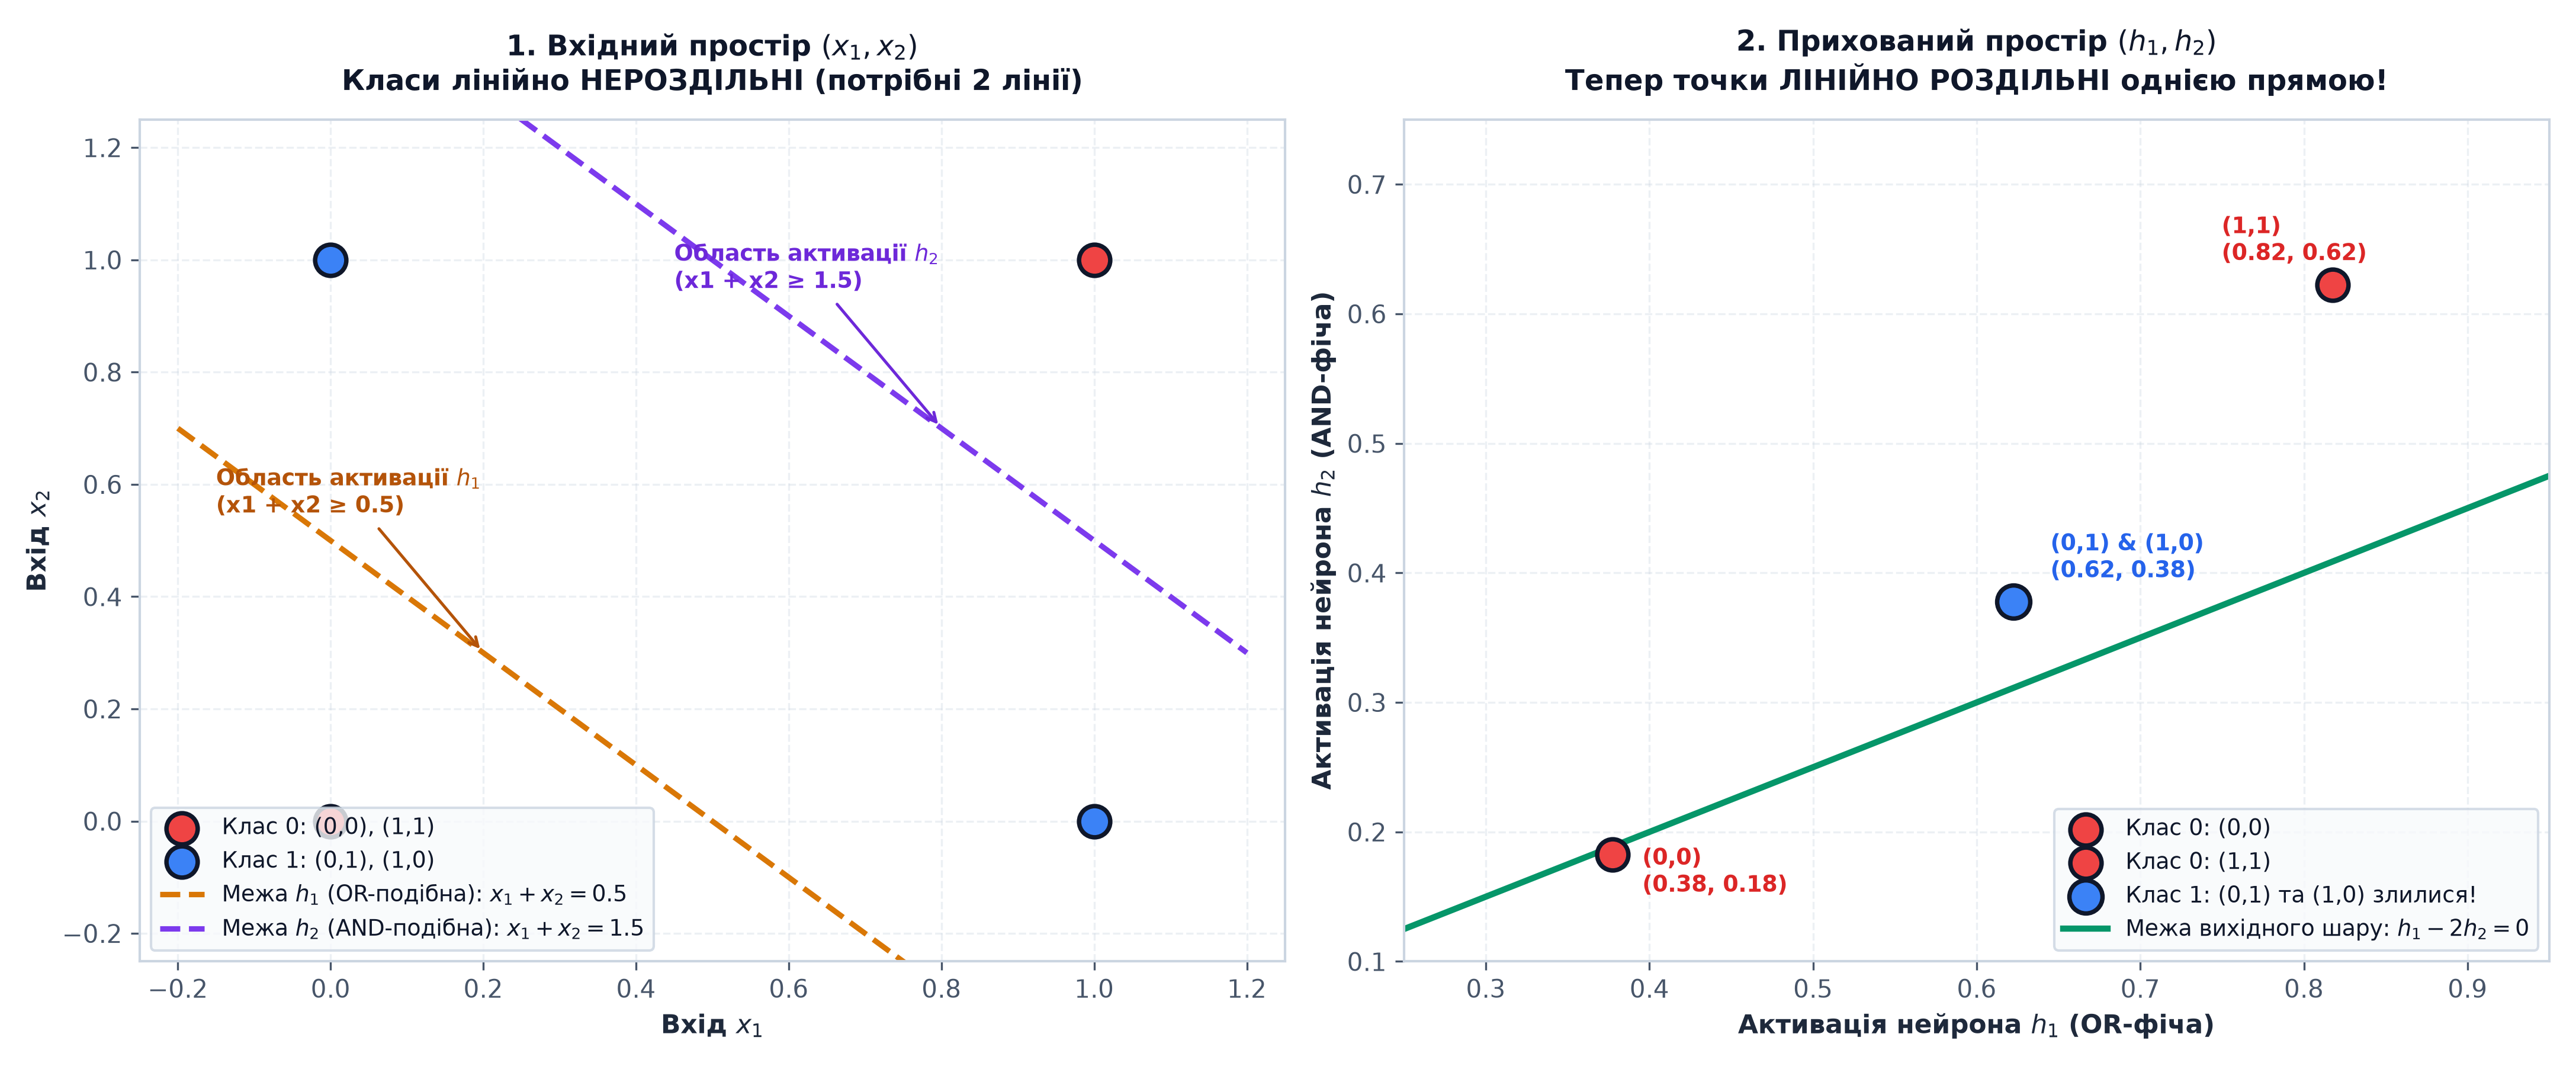
- Вхід: Завантаження... (лінійно нероздільні)
- Після прихованого шару: Завантаження... (вже лінійно роздільні!)
- Вихідний шар просто проводить лінію розділення у новому просторі Завантаження...
Функції активації — ключ до нелінійності
Ми вже бачили функцію кроку та сигмоїду. Але чому взагалі потрібна будь-яка функція активації? Що станеться, якщо її не буде?
Чому без активації мережа колапсує до лінійної моделі
Уявімо MLP без функцій активації (тобто кожен нейрон просто обчислює зважену суму):
Розкриємо дужки:
Позначимо Завантаження... та Завантаження...:
Результат: отримали просту лінійну модель! Неважливо, скільки шарів ви додасте — без нелінійної активації вся мережа редукується до однієї лінійної функції.
- Функція активації — це те, що дає мережі можливість моделювати нелінійні залежності.
Огляд популярних функцій активації
Розглянемо найважливіші функції активації, їхні переваги та недоліки.
1. Сигмоїда (Sigmoid)
Формула:
Діапазон виходу: Завантаження...
Властивості:
- Плавна S-подібна крива
- Інтерпретується як ймовірність
- Виходи завжди додатні
import numpy as np
import matplotlib.pyplot as plt

# Визначення функцій активації
def sigmoid(z):
    return 1 / (1 + np.exp(-z))

def tanh(z):
    return np.tanh(z)

def relu(z):
    return np.maximum(0, z)

def leaky_relu(z, alpha=0.01):
    return np.where(z > 0, z, alpha * z)

# Діапазон значень
z = np.linspace(-5, 5, 200)

# Візуалізація
fig, axes = plt.subplots(2, 2, figsize=(14, 10))

# Сигмоїда
axes[0, 0].plot(z, sigmoid(z), color='#3b82f6', linewidth=3)
axes[0, 0].axhline(0, color='gray', linestyle='--', alpha=0.3)
axes[0, 0].axvline(0, color='gray', linestyle='--', alpha=0.3)
axes[0, 0].grid(alpha=0.3)
axes[0, 0].set_title('Сигмоїда: σ(z) = 1/(1+e⁻ᶻ)', fontsize=14, fontweight='bold')
axes[0, 0].set_ylabel('σ(z)', fontsize=12)
axes[0, 0].set_ylim(-0.2, 1.2)

# Tanh
axes[0, 1].plot(z, tanh(z), color='#8b5cf6', linewidth=3)
axes[0, 1].axhline(0, color='gray', linestyle='--', alpha=0.3)
axes[0, 1].axvline(0, color='gray', linestyle='--', alpha=0.3)
axes[0, 1].grid(alpha=0.3)
axes[0, 1].set_title('Tanh: tanh(z)', fontsize=14, fontweight='bold')
axes[0, 1].set_ylabel('tanh(z)', fontsize=12)

# ReLU
axes[1, 0].plot(z, relu(z), color='#10b981', linewidth=3)
axes[1, 0].axhline(0, color='gray', linestyle='--', alpha=0.3)
axes[1, 0].axvline(0, color='gray', linestyle='--', alpha=0.3)
axes[1, 0].grid(alpha=0.3)
axes[1, 0].set_title('ReLU: max(0, z)', fontsize=14, fontweight='bold')
axes[1, 0].set_xlabel('z', fontsize=12)
axes[1, 0].set_ylabel('ReLU(z)', fontsize=12)

# Leaky ReLU
axes[1, 1].plot(z, leaky_relu(z), color='#f59e0b', linewidth=3)
axes[1, 1].axhline(0, color='gray', linestyle='--', alpha=0.3)
axes[1, 1].axvline(0, color='gray', linestyle='--', alpha=0.3)
axes[1, 1].grid(alpha=0.3)
axes[1, 1].set_title('Leaky ReLU: max(0.01z, z)', fontsize=14, fontweight='bold')
axes[1, 1].set_xlabel('z', fontsize=12)
axes[1, 1].set_ylabel('Leaky ReLU(z)', fontsize=12)

plt.tight_layout()
plt.show()
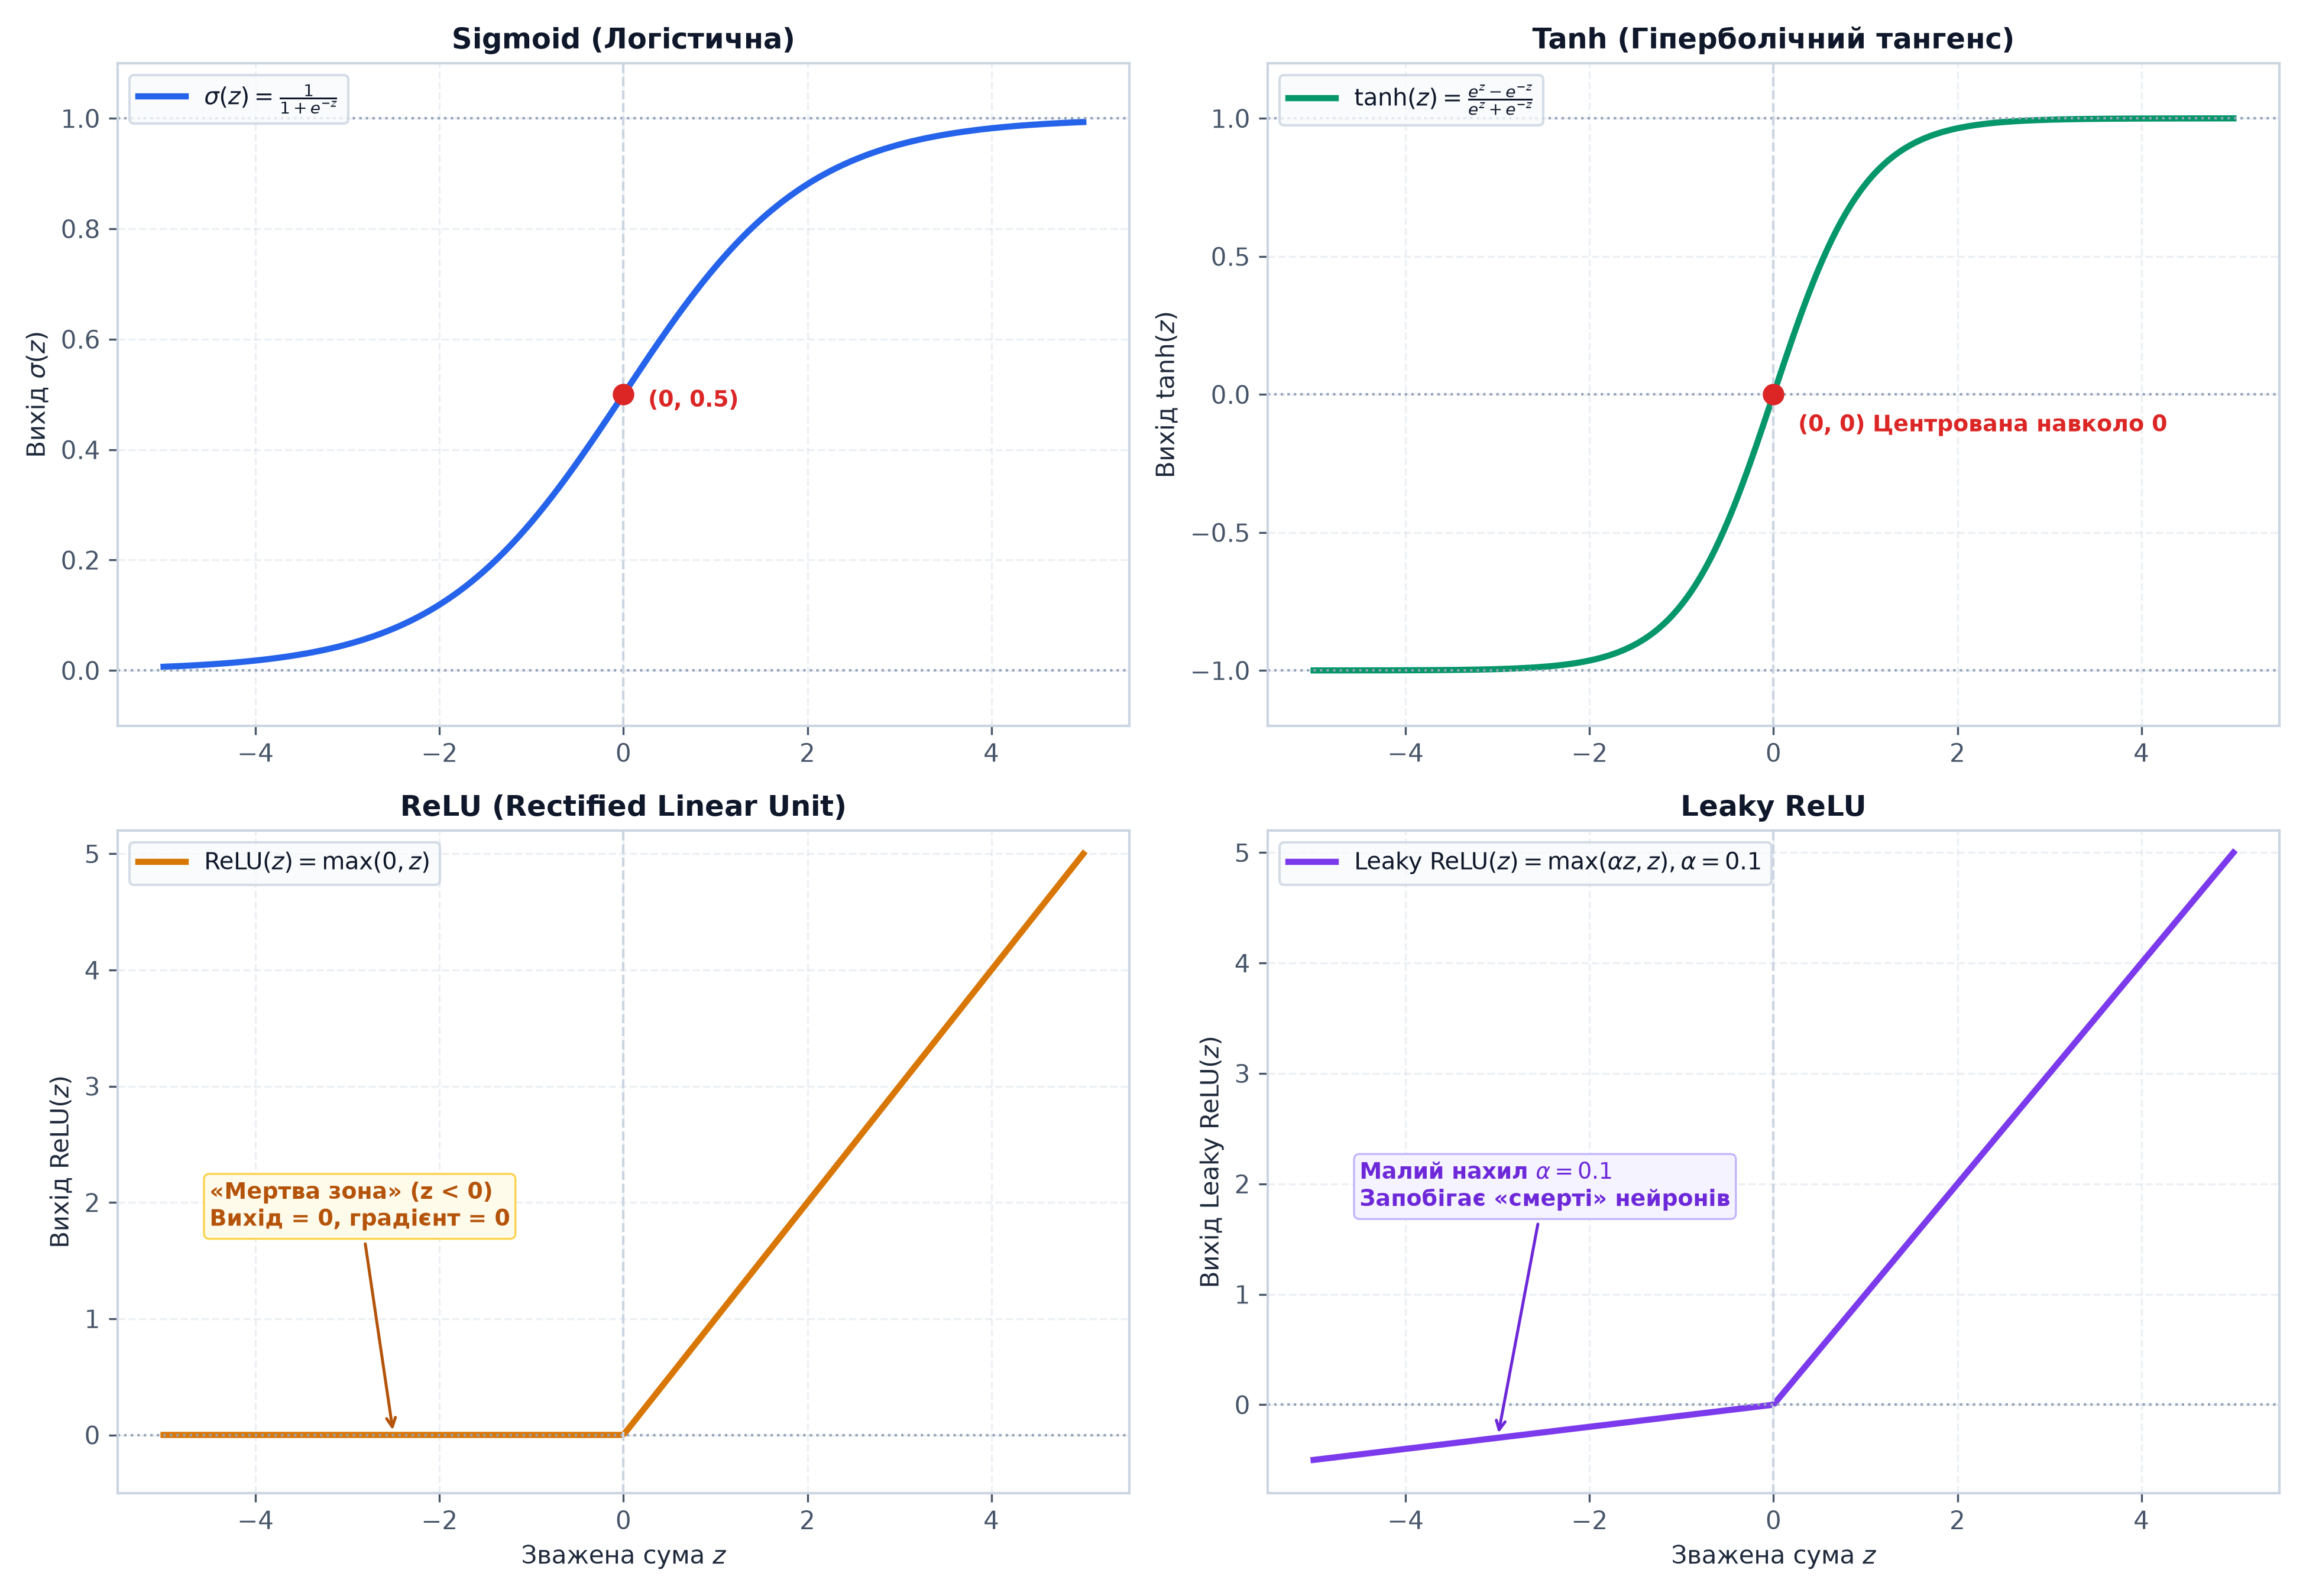
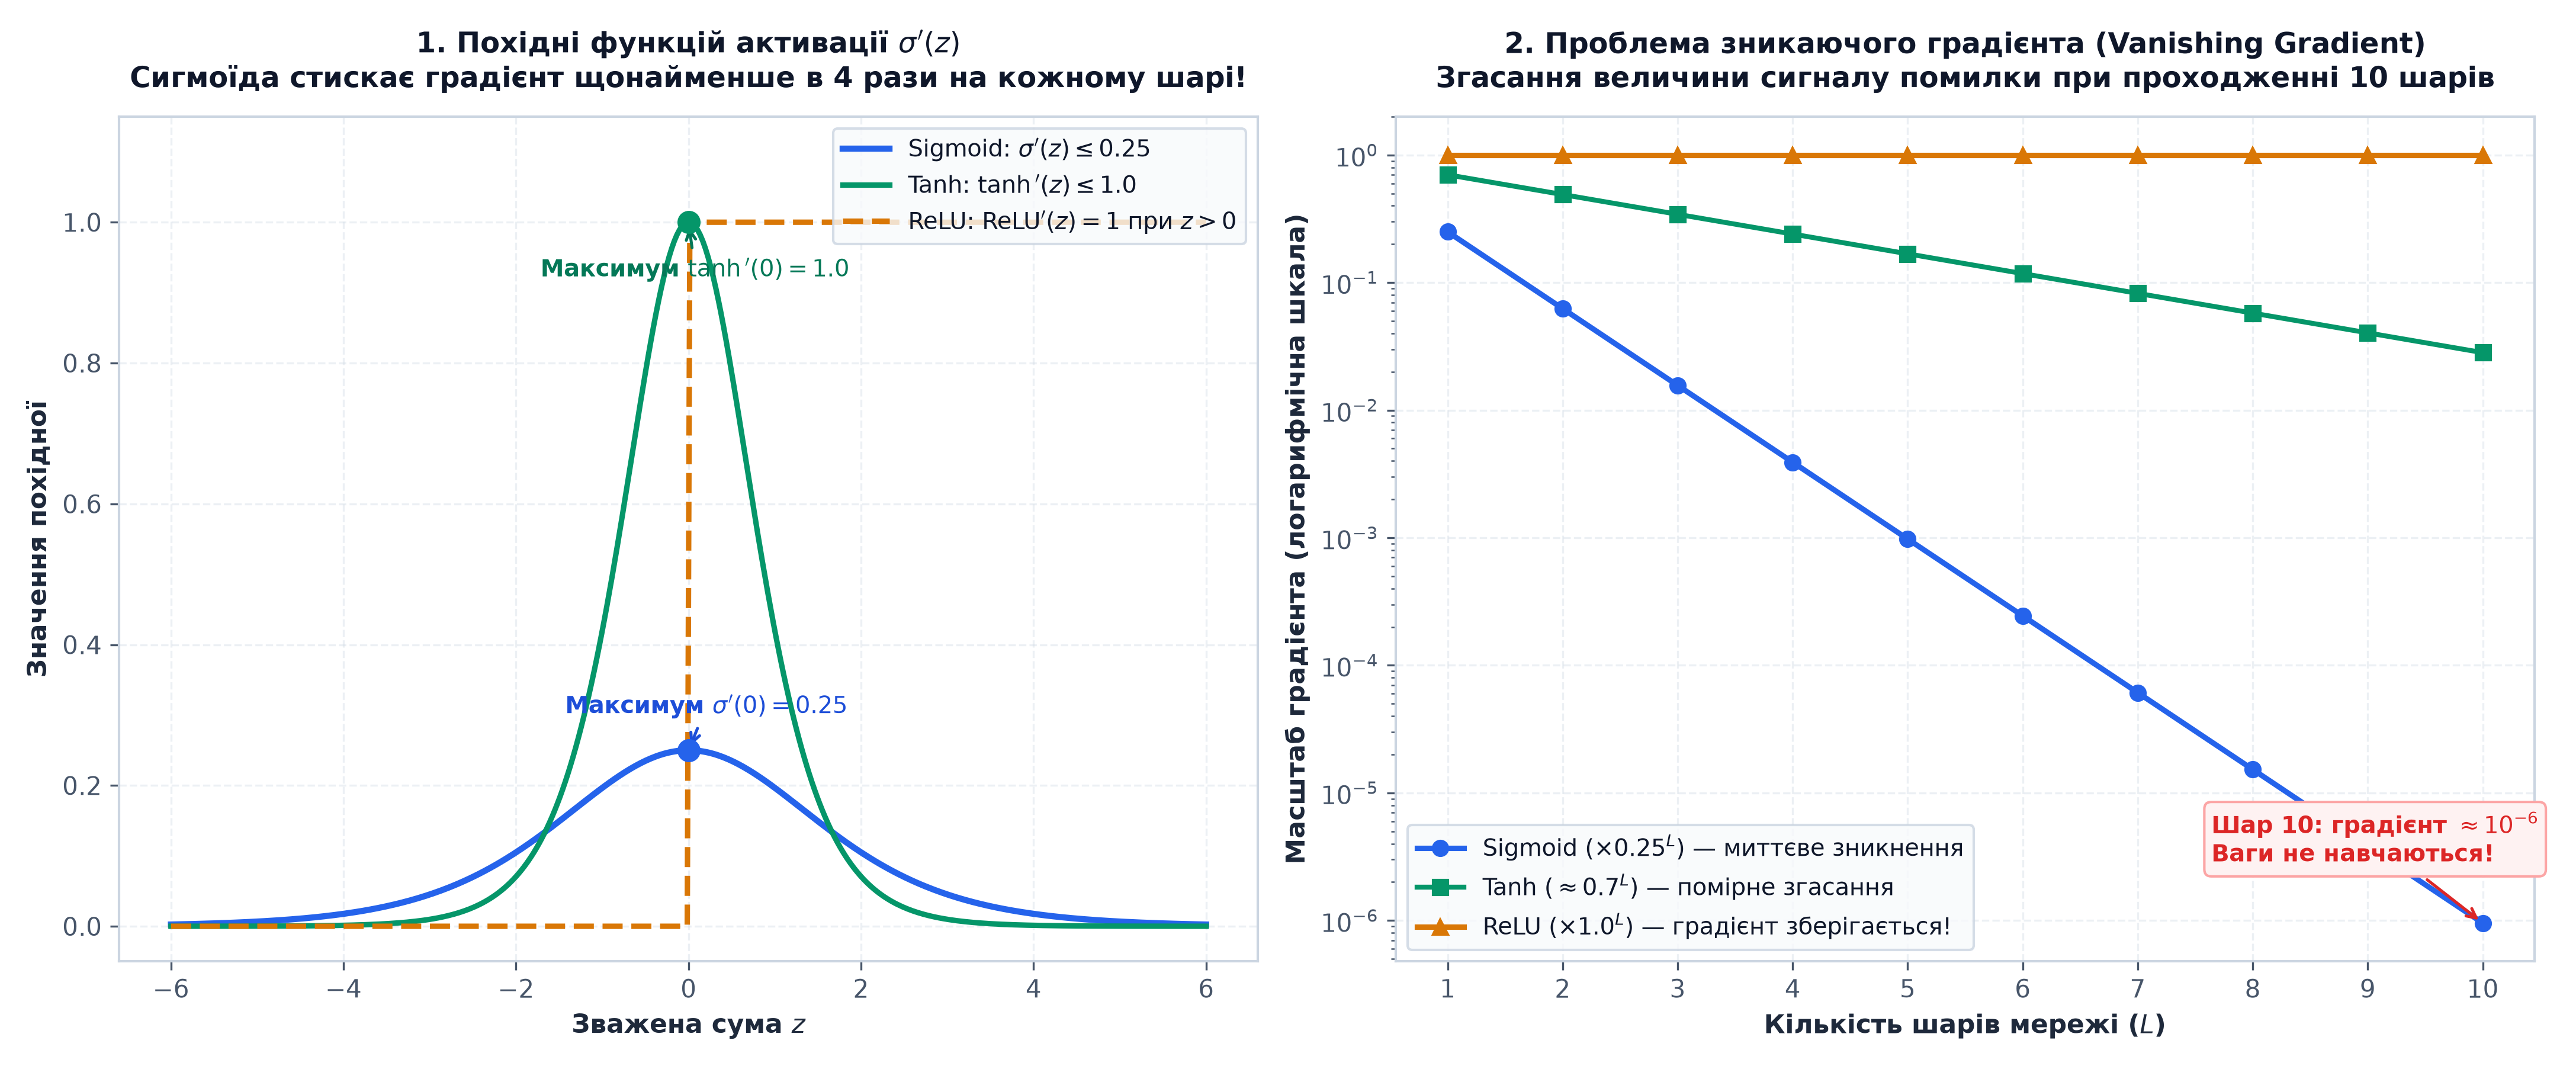
Проблеми сигмоїди:
⚠️ Vanishing Gradient Problem
⚠️ Не центрована навколо нуля
Коли використовувати: лише для вихідного шару в бінарній класифікації (інтерпретація як ймовірність класу 1).
2. Гіперболічний тангенс (Tanh)
Формула:
Діапазон виходу: Завантаження...
Переваги над сигмоїдою:
- Центрована навколо нуля: виходи симетричні відносно нуля, що прискорює збіжність
- Більший діапазон градієнтів
Недоліки:
- Також страждає від проблеми зникаючих градієнтів (хоча меншою мірою, ніж сигмоїда)
Коли використовувати: для прихованих шарів у рекурентних нейронних мережах (RNN, LSTM).
Аналогія:
Сигмоїда — як термометр, що показує від 0°C до 100°C. Tanh — як термометр із шкалою від -50°C до +50°C (центрований навколо нормальної температури). Другий термометр точніше реагує на невеликі зміни навколо середнього значення.
3. ReLU (Rectified Linear Unit)
Формула:
Діапазон виходу: Завантаження...
Чому ReLU стала революцією (2010-ті роки):
✅ Немає зникаючих градієнтів
✅ Обчислювальна простота
✅ Розріджена активація
Проблема: "мертві нейрони" (Dying ReLU)
Якщо нейрон отримує лише від'ємні входи, ReLU завжди повертає 0, градієнт також 0, і нейрон назавжди перестає навчатися. Це відбувається при:
- Дуже високому learning rate (ваги «перестрибують» в область, де вхід завжди від'ємний)
- Поганій ініціалізації ваг
- Використовувати помірковані learning rate (0.001–0.01 для Adam)
- Правильно ініціалізувати ваги (He initialization для ReLU)
- Розглянути варіанти ReLU: Leaky ReLU або ELU
Коли використовувати: для прихованих шарів у більшості завдань — стандартний вибір за замовчуванням.
4. Leaky ReLU
Формула:
Відмінність від ReLU: замість нуля для від'ємних значень використовується невеликий нахил Завантаження... (зазвичай 0.01).
Переваги:
- Немає "мертвих нейронів": навіть для Завантаження... градієнт Завантаження..., тому нейрон продовжує навчатися
- Всі переваги ReLU зберігаються
Коли використовувати: якщо ReLU призводить до великої кількості мертвих нейронів (експериментальна альтернатива).
5. Softmax (для багатокласової класифікації)
Формула (для вектора Завантаження...):
Властивості:
- Перетворює довільний вектор у розподіл ймовірностей: всі виходи в діапазоні Завантаження..., їхня сума дорівнює 1
- Клас з найбільшим Завантаження... отримує найвищу ймовірність
Коли використовувати: виключно для вихідного шару в задачах багатокласової класифікації (наприклад, розпізнавання 10 цифр MNIST).
import numpy as np

def softmax(z):
    """Обчислює softmax для вектора z"""
    exp_z = np.exp(z - np.max(z))  # Віднімаємо max для числової стабільності
    return exp_z / np.sum(exp_z)

# Приклад: мережа передбачає бали для 3 класів (кішка, собака, птах)
logits = np.array([2.0, 1.0, 0.1])  # Сирі виходи мережі (до softmax)

probabilities = softmax(logits)

print("Клас         | Логіт (z) | Ймовірність (softmax)")
print("-" * 55)
classes = ["Кішка", "Собака", "Птах"]
for cls, z, prob in zip(classes, logits, probabilities):
    print(f"{cls:12} |   {z:5.2f}   |   {prob:6.4f}  ({prob*100:5.2f}%)")

print(f"\nСума ймовірностей: {probabilities.sum():.6f}")
print(f"Передбачений клас: {classes[np.argmax(probabilities)]}")
| Клас об'єкта | Логіт ($z$) | Експонента ($e^z$) | Ймовірність Softmax | Розподіл впевненості |
|---|---|---|---|---|
| 🐱 Кішка | 2.00 | $7.389$ | 0.6590 ($65.90%$) | 🟩🟩🟩🟩🟩🟩🟩 (Переможець) |
| 🐶 Собака | 1.00 | $2.718$ | 0.2424 ($24.24%$) | 🟨🟨 |
| 🐦 Птах | 0.10 | $1.105$ | 0.0986 ($9.86%$) | ⬜ |
| Сума ймовірностей | — | 11.212 | 1.0000 ($100.0%$) | 🎯 Передбачено: Кішка |
Порівняльна таблиця функцій активації
| Функція | Формула | Діапазон | Прих. шари | Вих. шар | Переваги | Недоліки |
|---|---|---|---|---|---|---|
| Sigmoid | Завантаження... | (0, 1) | ❌ | ✅ | Інтерпретується як ймовірність | Зникаючі градієнти, повільна |
| Tanh | Завантаження... | (-1, 1) | ⚠️ | ❌ | Центрована навколо 0 | Зникаючі градієнти |
| ReLU | Завантаження... | [0, ∞) | ✅ | ❌ | Швидка, немає зникаючих градієнтів | Мертві нейрони |
| Leaky ReLU | Завантаження... | (-∞, ∞) | ✅ | ❌ | Вирішує проблему мертвих нейронів | Потребує налаштування α |
| Softmax | Завантаження... | (0, 1), Σ = 1 | ❌ | ✅ | Розподіл ймовірностей для K класів | Лише для вихідного шару |
- Приховані шари: ReLU (за замовчуванням) або Leaky ReLU
- Вихідний шар:
- Бінарна класифікація → Sigmoid
- Багатокласова класифікація → Softmax
- Регресія → без активації (лінійний вихід)
Прямий прохід (Forward Propagation) — від входу до виходу
Тепер, коли ми розуміємо архітектуру MLP та функції активації, розберемо покроково, як мережа обчислює своє передбачення.
Forward Propagation — це процес послідовного обчислення виходів кожного шару, починаючи від вхідного та закінчуючи вихідним.
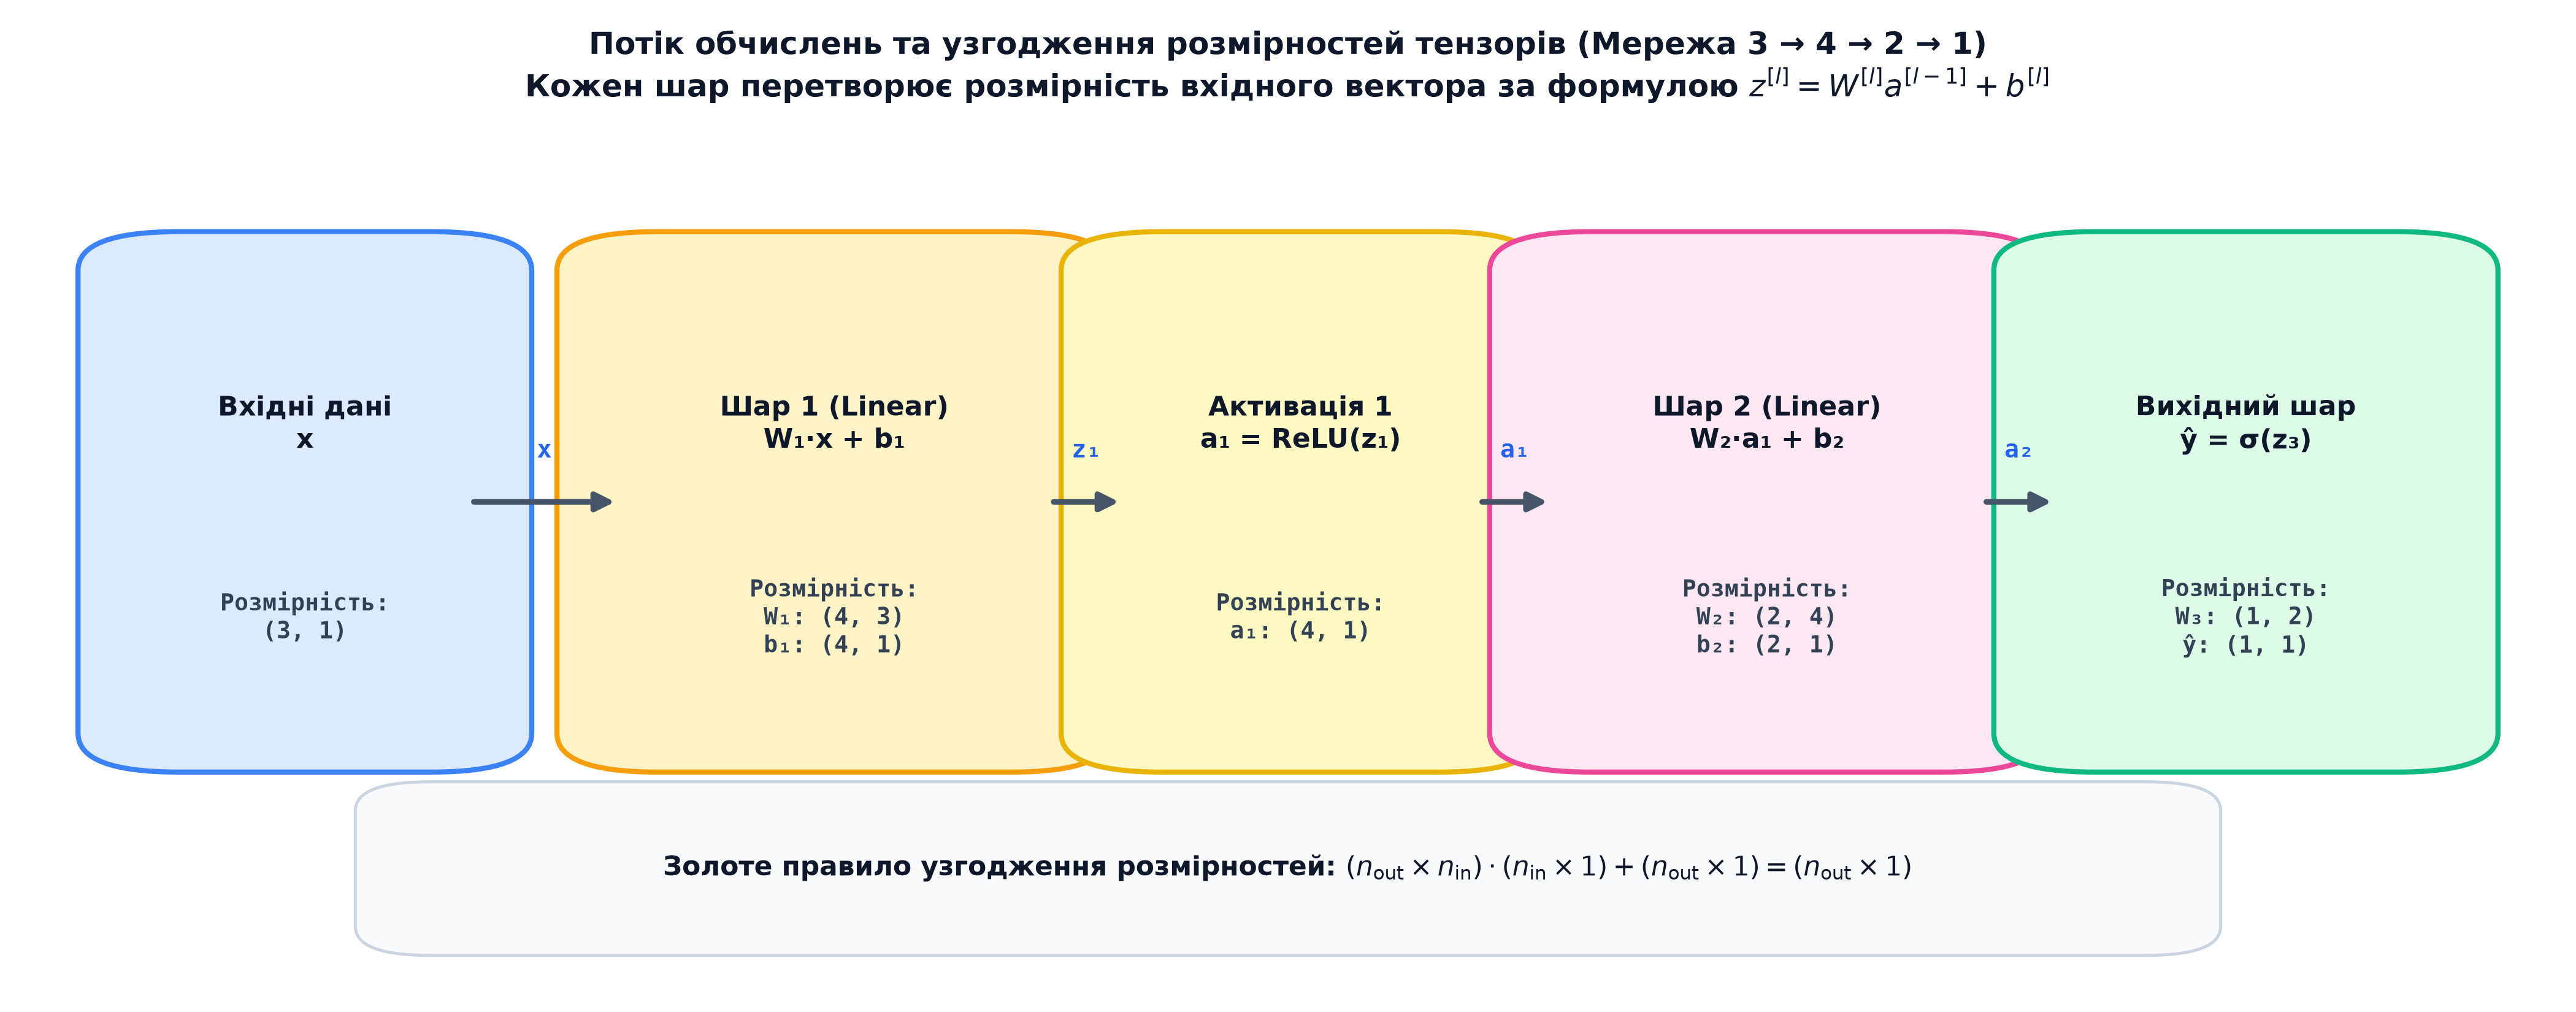
Загальна формула для одного шару
Для шару Завантаження... з Завантаження... нейронами:
Де:
- Завантаження... — активації попереднього шару (для першого шару це вхідні дані Завантаження...)
- Завантаження... — матриця ваг шару Завантаження... (розмір: Завантаження...)
- Завантаження... — вектор зсувів (bias) шару Завантаження...
- Завантаження... — функція активації шару Завантаження...
Приклад: прямий прохід для мережі 3 → 4 → 2 → 1
Розглянемо конкретну архітектуру:
- Вхід: 3 ознаки (Завантаження...)
- Прихований шар 1: 4 нейрони з ReLU
- Прихований шар 2: 2 нейрони з ReLU
- Вихід: 1 нейрон з sigmoid (бінарна класифікація)
Реалізація прямого проходу на NumPy
import numpy as np

def relu(z):
    """ReLU: max(0, z)"""
    return np.maximum(0, z)

def sigmoid(z):
    """Sigmoid: 1 / (1 + exp(-z))"""
    return 1 / (1 + np.exp(-z))

# Ініціалізація ваг (випадкові значення для демонстрації)
np.random.seed(42)

# Розміри шарів: 3 → 4 → 2 → 1
W1 = np.random.randn(4, 3) * 0.1  # Шар 1: 4 нейрони, кожен приймає 3 входи
b1 = np.zeros((4, 1))

W2 = np.random.randn(2, 4) * 0.1  # Шар 2: 2 нейрони, кожен приймає 4 входи
b2 = np.zeros((2, 1))

W3 = np.random.randn(1, 2) * 0.1  # Вихід: 1 нейрон, приймає 2 входи
b3 = np.zeros((1, 1))

# Вхідні дані: один приклад з 3 ознаками
x = np.array([[0.5], [0.3], [0.8]])  # Вектор-стовпець (3, 1)

print("ПРЯМИЙ ПРОХІД (Forward Propagation)\n")
print("=" * 60)

# Шар 1
z1 = W1 @ x + b1
a1 = relu(z1)
print(f"Шар 1 (Прихований):")
print(f"  z⁽¹⁾ = W⁽¹⁾·x + b⁽¹⁾ → shape: {z1.shape}")
print(f"  Зважені суми z⁽¹⁾: {z1.flatten()}")
print(f"  a⁽¹⁾ = ReLU(z⁽¹⁾): {a1.flatten()}\n")

# Шар 2
z2 = W2 @ a1 + b2
a2 = relu(z2)
print(f"Шар 2 (Прихований):")
print(f"  z⁽²⁾ = W⁽²⁾·a⁽¹⁾ + b⁽²⁾ → shape: {z2.shape}")
print(f"  Зважені суми z⁽²⁾: {z2.flatten()}")
print(f"  a⁽²⁾ = ReLU(z⁽²⁾): {a2.flatten()}\n")

# Вихідний шар
z3 = W3 @ a2 + b3
y_pred = sigmoid(z3)
print(f"Вихідний шар:")
print(f"  z = W⁽³⁾·a⁽²⁾ + b⁽³⁾: {z3.flatten()}")
print(f"  ŷ = σ(z): {y_pred.flatten()[0]:.4f}")
print(f"\n{'='*60}")
print(f"ПЕРЕДБАЧЕННЯ: ймовірність класу 1 = {y_pred[0, 0]:.2%}")
| Шар мережі | Розмірність ваг | Вхідні дані | Зважена сума $z$ | Активація $a$ (вихід шару) |
|---|---|---|---|---|
| Шар 1 (Hidden) Linear $3 \to 4$ + ReLU | $W^{(1)} \in \mathbb{R}^{4 \times 3}$ $b^{(1)} \in \mathbb{R}^{4 \times 1}$ | $x = 0.5,; 0.3,; 0.8^T$ | $z^{(1)} = 0.0494,; 0.0717,; -0.0052,; 0.0135^T$ | $a^{(1)} = 0.0494,; 0.0717,; 0.0000,; 0.0135^T$ (3-й нейрон занулено через ReLU) |
| Шар 2 (Hidden) Linear $4 \to 2$ + ReLU | $W^{(2)} \in \mathbb{R}^{2 \times 4}$ $b^{(2)} \in \mathbb{R}^{2 \times 1}$ | $a^{(1)} \in \mathbb{R}^{4 \times 1}$ | $z^{(2)} = 0.0104,; -0.0051^T$ | $a^{(2)} = 0.0104,; 0.0000^T$ (2-й нейрон відсічено) |
| Шар 3 (Output) Linear $2 \to 1$ + Sigmoid | $W^{(3)} \in \mathbb{R}^{1 \times 2}$ $b^{(3)} \in \mathbb{R}^{1 \times 1}$ | $a^{(2)} \in \mathbb{R}^{2 \times 1}$ | $z^{(3)} = -0.00097$ | $\hat{y} = \sigma(z^{(3)}) = \mathbf{0.4998}$ ($49.98%$ ймовірність класу 1) |
- Послідовне обчислення: Вихід кожного шару стає входом для наступного
- ReLU «вимикає» від'ємні значення: У шарі 1 третій нейрон отримав Завантаження..., після ReLU → 0
- Форма даних: Вектори мають форму Завантаження... (стовпці), що дозволяє коректне множення матриць
- Sigmoid на виході: Перетворює довільне число в ймовірність Завантаження...
Зворотний прохід (Backpropagation) — як мережа навчається
Ми отримали передбачення Завантаження.... Тепер потрібно порівняти його з правильною відповіддю Завантаження..., обчислити помилку та оновити ваги, щоб наступного разу помилка була меншою.
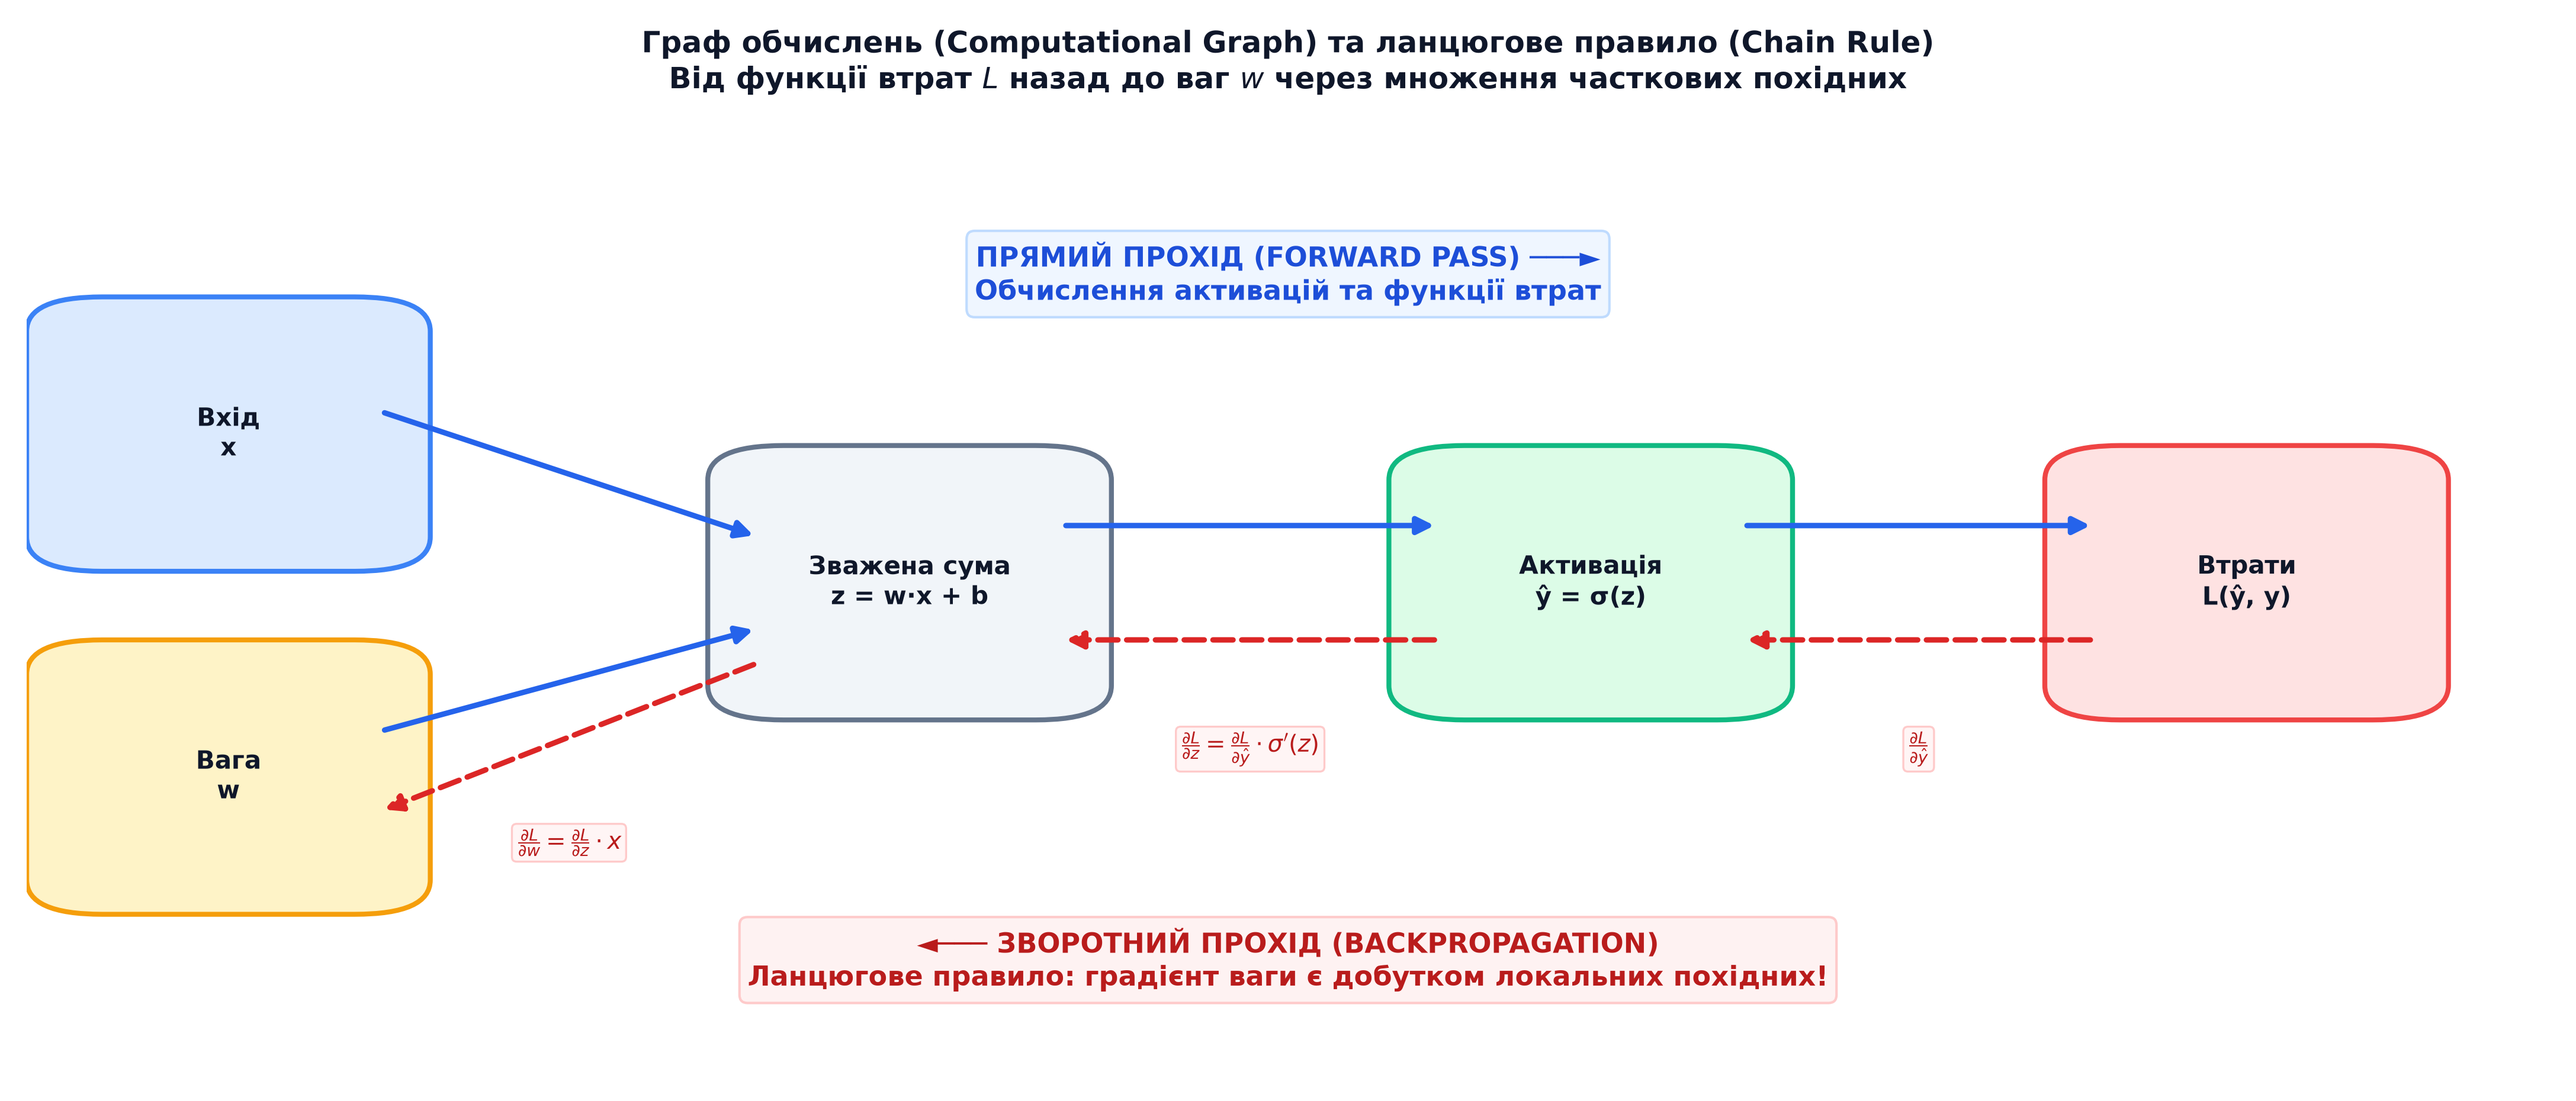
Backpropagation (зворотне поширення помилки) — це алгоритм обчислення градієнтів функції втрат по всіх параметрах мережі за допомогою ланцюгового правила диференціювання (chain rule).
Інтуїтивне пояснення
Аналогія з виробничим конвеєром:
Уявіть фабрику з 3 етапами виробництва печива:
- Етап А: Замішування тіста (робітник Андрій)
- Етап Б: Формування печива (робітник Богдан)
- Етап В: Випікання (робітник Віктор)
Печиво вийшло несмачним (висока функція втрат). Директор починає розслідування у зворотному порядку:
- Перевіряє Віктора (вихідний шар): температура печі занадто висока → коригує налаштування
- Перевіряє Богдана (прихований шар 2): печиво занадто товсте → коригує товщину
- Перевіряє Андрія (прихований шар 1): недостатньо борошна → коригує рецепт
Кожен етап отримує «частку провини» пропорційно свому впливу на кінцевий результат. Саме це робить backpropagation.
Ланцюгове правило (Chain Rule) — математична основа
Припустимо, функція втрат залежить від виходу останнього шару, який залежить від ваг:
Щоб знайти, як зміна ваги Завантаження... впливає на втрати Завантаження..., застосовуємо ланцюгове правило:
Інтерпретація:
- Завантаження... — наскільки втрати чутливі до зміни передбачення
- Завантаження... — наскільки передбачення чутливе до зміни зваженої суми (похідна функції активації)
- Завантаження... — наскільки зважена сума чутлива до зміни ваги (це просто Завантаження...)
Алгоритм backpropagation покроково
Для мережі з Завантаження... шарами:
Крок 1: Forward Pass
Обчислюємо активації всіх шарів Завантаження... та зберігаємо їх (потрібні для backprop).
Крок 2: Обчислення втрат
Для бінарної класифікації використовуємо Binary Cross-Entropy:
Крок 3: Градієнт на виході
Обчислюємо похідну втрат по виходу:
Для sigmoid з Binary Cross-Entropy це спрощується до:
Крок 4: Зворотний прохід по шарах
Для кожного шару Завантаження...:
Градієнт по вагах:
Градієнт по bias:
Градієнт для попереднього шару:
Де Завантаження... — поелементне множення, Завантаження... — похідна функції активації.
Крок 5: Оновлення параметрів
Де Завантаження... — learning rate.
Похідні функцій активації
Для backpropagation потрібні похідні функцій активації:
| Функція | Завантаження... | Похідна Завантаження... |
|---|---|---|
| Sigmoid | Завантаження... | Завантаження... |
| Tanh | Завантаження... | Завантаження... |
| ReLU | Завантаження... | Завантаження... |
| Leaky ReLU | Завантаження... | Завантаження... |
Спрощений приклад backpropagation на папері
Розглянемо мінімальну мережу: 1 вхід → 1 нейрон з sigmoid → 1 вихід.
Дано:
- Вхід: Завантаження...
- Вага: Завантаження...
- Bias: Завантаження...
- Правильна відповідь: Завантаження...
Forward pass:
import numpy as np

# Параметри
x = 0.5
w = 0.8
b = 0.2
y = 1.0
learning_rate = 0.5

# Forward pass
z = w * x + b
y_pred = 1 / (1 + np.exp(-z))  # sigmoid

# Loss (Binary Cross-Entropy)
loss = -(y * np.log(y_pred) + (1 - y) * np.log(1 - y_pred))

print("FORWARD PASS:")
print(f"z = w·x + b = {w}·{x} + {b} = {z:.4f}")
print(f"ŷ = σ(z) = {y_pred:.4f}")
print(f"Loss = -{y}·log({y_pred:.4f}) = {loss:.4f}\n")

# Backward pass
dL_dy_pred = -(y / y_pred) + (1 - y) / (1 - y_pred)  # Градієнт по виходу
dy_pred_dz = y_pred * (1 - y_pred)  # Похідна sigmoid
dL_dz = dL_dy_pred * dy_pred_dz  # Ланцюгове правило

# Для sigmoid з BCE це спрощується до:
dL_dz_simplified = y_pred - y

dz_dw = x  # Похідна z по w
dz_db = 1  # Похідна z по b

dL_dw = dL_dz_simplified * dz_dw
dL_db = dL_dz_simplified * dz_db

print("BACKWARD PASS:")
print(f"∂L/∂ŷ = {dL_dy_pred:.4f}")
print(f"∂ŷ/∂z = {dy_pred_dz:.4f}  (похідна sigmoid)")
print(f"∂L/∂z = {dL_dz:.4f}  або спрощено: {dL_dz_simplified:.4f}")
print(f"∂L/∂w = ∂L/∂z · ∂z/∂w = {dL_dz_simplified:.4f} · {x} = {dL_dw:.4f}")
print(f"∂L/∂b = ∂L/∂z · ∂z/∂b = {dL_dz_simplified:.4f} · 1 = {dL_db:.4f}\n")

# Оновлення параметрів
w_new = w - learning_rate * dL_dw
b_new = b - learning_rate * dL_db

print("ОНОВЛЕННЯ ПАРАМЕТРІВ:")
print(f"w := w - α·∂L/∂w = {w} - {learning_rate}·{dL_dw:.4f} = {w_new:.4f}")
print(f"b := b - α·∂L/∂b = {b} - {learning_rate}·{dL_db:.4f} = {b_new:.4f}\n")

# Перевірка: forward pass з новими вагами
z_new = w_new * x + b_new
y_pred_new = 1 / (1 + np.exp(-z_new))
loss_new = -(y * np.log(y_pred_new) + (1 - y) * np.log(1 - y_pred_new))

print("ПЕРЕВІРКА (після оновлення):")
print(f"ŷ_new = {y_pred_new:.4f}  (було {y_pred:.4f})")
print(f"Loss_new = {loss_new:.4f}  (було {loss:.4f})")
print(f"Покращення: {loss - loss_new:.4f} ✓" if loss_new < loss else "Погіршення ✗")
| Етап розрахунку | Параметри та формули | Числове значення | Інтерпретація ефекту |
|---|---|---|---|
| Forward Pass | $z = 0.8 \cdot 0.5 + 0.2$ $\hat{y} = \sigma(0.6000)$ $\text{Loss} = -1 \cdot \ln(0.6457)$ | $0.6000$ 0.6457 0.4378 | Початкова помилка класифікації для $y=1$ |
| Backward Pass | $\frac{\partial L}{\partial \hat{y}} = -\frac{1}{\hat{y}}$ $\frac{\partial \hat{y}}{\partial z} = \sigma(z)(1-\sigma(z))$ $\frac{\partial L}{\partial z} = \hat{y} - y$ $\frac{\partial L}{\partial w} = \frac{\partial L}{\partial z} \cdot x$ $\frac{\partial L}{\partial b} = \frac{\partial L}{\partial z} \cdot 1$ | $-1.5486$ $0.2288$ -0.3543 -0.1772 -0.3543 | Негативний градієнт вказує на необхідність збільшення ваги та зсуву |
| Оновлення ($\alpha=0.5$) | $w := 0.8 - 0.5 \cdot (-0.1772)$ $b := 0.2 - 0.5 \cdot (-0.3543)$ | w = 0.8886 b = 0.3772 | Вага та зміщення скориговані у бік класу 1 |
| Верифікація кроку | $\hat{y}{\text{new}} = \sigma(0.8886 \cdot 0.5 + 0.3772)$ $\text{Loss}{\text{new}} = -\ln(0.7220)$ | 0.7220 0.3260 | ✅ Покращення Loss: $\Delta = -0.1118$ за один крок! |
- Передбачення Завантаження... покращилося: 0.6457 → 0.7220 (ближче до правильної відповіді Завантаження...)
- Втрати зменшилися: 0.4378 → 0.3260
Оптимізатори — еволюція градієнтного спуску
Базовий градієнтний спуск має суттєві обмеження при навчанні нейронних мереж. Розглянемо еволюцію алгоритмів оптимізації від найпростішого до сучасних.
1. Vanilla Gradient Descent (Batch GD)
Формула оновлення:
Принцип: обчислюємо градієнт по всьому датасету, потім робимо один крок.
Проблеми:
⚠️ Повільність
⚠️ Пам'ять
2. Stochastic Gradient Descent (SGD)
Ідея: замість всього датасету використовуємо один випадковий приклад для обчислення градієнта.
Формула:
Переваги:
- ✅ Швидкі оновлення ваг (після кожного прикладу)
- ✅ Може «вистрибнути» з локальних мінімумів завдяки шуму градієнта
Проблеми:
- ⚠️ Дуже шумний градієнт — траєкторія навчання хаотична
- ⚠️ Може не досягти точного мінімуму (буде коливатися навколо нього)
3. Mini-Batch Gradient Descent
Ідея: обчислюємо градієнт по невеликій підмножині (batch) прикладів, зазвичай 32, 64, 128 або 256.
Формула:
Де Завантаження... — розмір батча.
Переваги:
- ✅ Баланс між швидкістю та стабільністю
- ✅ Ефективне використання GPU (паралельна обробка батча)
- ✅ Менш шумний градієнт, ніж у SGD
Зауваження: У сучасній літературі термін «SGD» часто означає саме Mini-Batch GD, а не справжній стохастичний (по одному прикладу).
4. SGD з Momentum
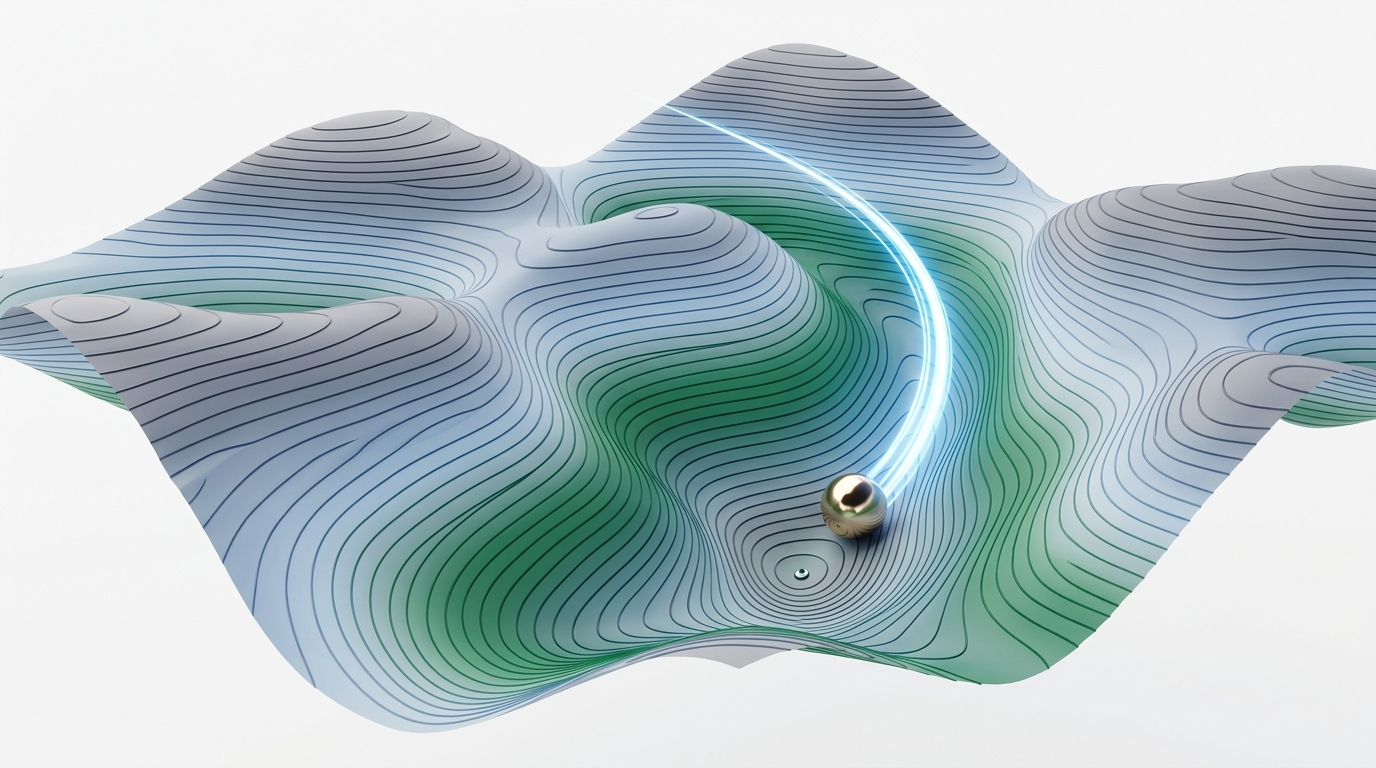
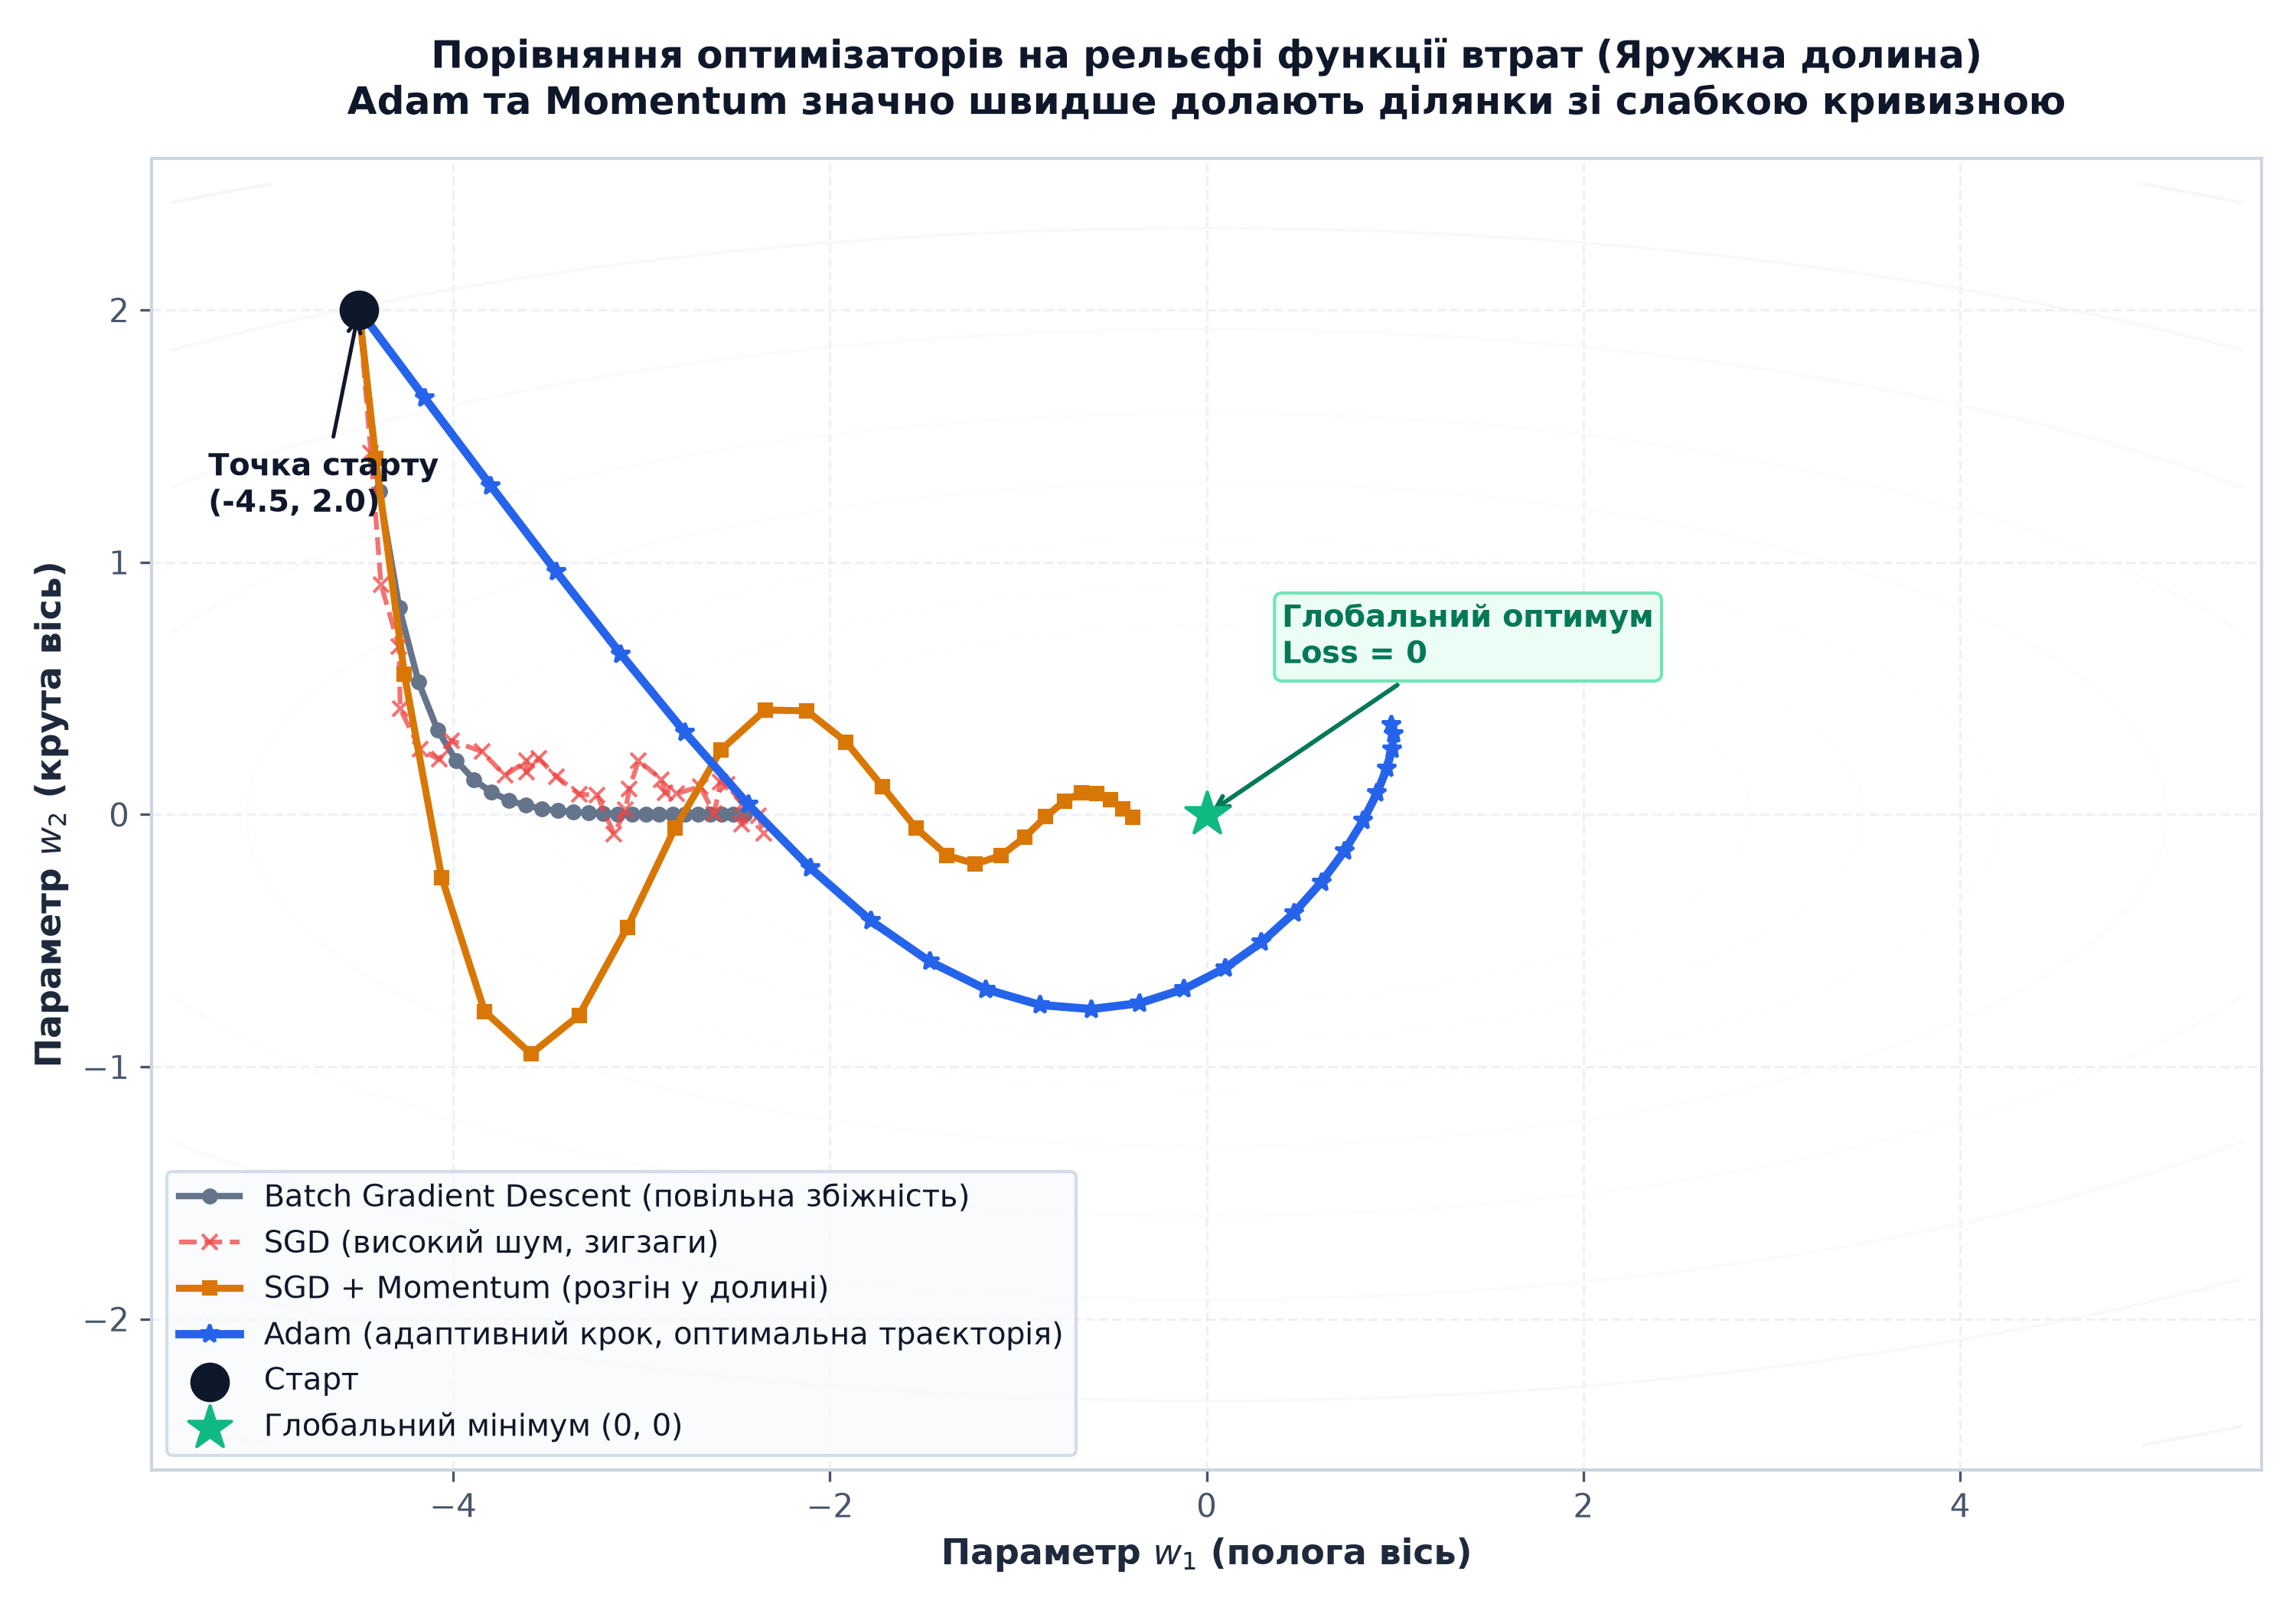
Проблема vanilla SGD: у регіонах з різною кривизною функції втрат (наприклад, вузькі «яри») градієнт коливається між стінками, уповільнюючи рух до мінімуму.
Ідея Momentum: додати «інерцію» — враховувати попередній напрямок руху.
Формули:
Де Завантаження... — швидкість (velocity), Завантаження... — коефіцієнт momentum (зазвичай 0.9).
Аналогія:
Уявіть м'яч, що котиться вниз по схилу. Без momentum він зупиняється при кожній малій нерівності. З momentum він набирає швидкість і пролітає крізь невеликі перешкоди, прямуючи до найнижчої точки.
Переваги:
- ✅ Швидша збіжність у напрямках зі слабкою кривизною
- ✅ Зменшує коливання у напрямках із сильною кривизною
- ✅ Може «перестрибнути» дрібні локальні мінімуми
5. Adam (Adaptive Moment Estimation)
Adam — це найпопулярніший оптимізатор у сучасному глибокому навчанні. Він поєднує ідеї Momentum та адаптивного learning rate для кожного параметра окремо.
Ідея:
- Для кожної ваги зберігаємо експоненційно згладжений градієнт (перший момент)
- Для кожної ваги зберігаємо експоненційно згладжений квадрат градієнта (другий момент)
- Автоматично адаптуємо learning rate: великий для параметрів із малими градієнтами, малий для параметрів із великими градієнтами
Формули:
Корекція зміщення (bias correction):
Оновлення параметрів:
Типові гіперпараметри:
- Завантаження... (learning rate)
- Завантаження... (експоненційне згасання для першого моменту)
- Завантаження... (експоненційне згасання для другого моменту)
- Завантаження... (для числової стабільності)
Переваги:
- ✅ Адаптивний learning rate для кожного параметра
- ✅ Добре працює «з коробки» без тонкого налаштування гіперпараметрів
- ✅ Ефективний для розріджених градієнтів (NLP, рекомендаційні системи)
- ✅ Швидка збіжність
Коли використовувати: за замовчуванням для більшості задач — якщо не маєте особливих причин, обирайте Adam.
Порівняльна таблиця оптимізаторів
| Оптимізатор | Learning Rate | Швидкість збіжності | Стабільність | Налаштування | Рекомендації |
|---|---|---|---|---|---|
| Batch GD | Фіксований | Повільна | Висока | α | ❌ Не використовується на практиці |
| SGD | Фіксований | Середня | Низька | α | Для простих задач, малих даних |
| Mini-Batch SGD | Фіксований | Середня | Середня | α, batch_size | Базовий вибір, якщо важлива передбачуваність |
| SGD + Momentum | Фіксований | Швидка | Середня | α, β | Для глибоких мереж, комп'ютерного зору |
| Adam | Адаптивний | Дуже швидка | Висока | α, β₁, β₂ | За замовчуванням для 90% задач |
- Починайте з Adam (learning_rate = 0.001) — він працює добре для більшості задач
- Якщо Adam призводить до перенавчання, спробуйте SGD + Momentum із меншим learning rate (0.01) та weight decay
- Для фінального тюнінгу (fine-tuning) моделі можна зменшити learning rate у 5–10 разів
- Використовуйте learning rate scheduler (зменшення lr під час навчання) для покращення збіжності
Практичні завдання
Умова: Дано архітектуру нейронної мережі:
- Вхід: 28×28 пікселів зображення (784 ознаки)
- Прихований шар 1: 128 нейронів, ReLU
- Прихований шар 2: 64 нейрони, ReLU
- Вихід: 10 нейронів, Softmax (класифікація 10 цифр)
Запитання: Скільки всього параметрів (ваг + bias) має ця мережа?
Розрахунок:
Шар 1 (784 → 128):
- Ваги: Завантаження...
- Bias: 128
- Разом: 100,480 параметрів
Шар 2 (128 → 64):
- Ваги: Завантаження...
- Bias: 64
- Разом: 8,256 параметрів
Вихідний шар (64 → 10):
- Ваги: Завантаження...
- Bias: 10
- Разом: 650 параметрів
Загальна кількість параметрів:
Умова: Реалізуйте функцію forward_pass, яка приймає:
- Вхідний вектор Завантаження... (наприклад,
[0.5, 0.3, 0.8]) - Список ваг та bias для кожного шару
- Список функцій активації
Функція має повертати остаточний вихід мережі.
Підказка: використайте цикл for для проходження по шарах.
import numpy as np

def relu(z):
    return np.maximum(0, z)

def sigmoid(z):
    return 1 / (1 + np.exp(-z))

def forward_pass(x, layers, activations):
    """
    Прямий прохід по нейронній мережі

    Parameters:
    - x: вхідний вектор (shape: n_features)
    - layers: список (W, b) для кожного шару
    - activations: список функцій активації для кожного шару

    Returns:
    - Вихід мережі (shape: n_output)
    """
    a = x.reshape(-1, 1)  # Перетворюємо на вектор-стовпець

    for (W, b), activation in zip(layers, activations):
        z = W @ a + b
        a = activation(z)

    return a.flatten()  # Повертаємо як 1D масив

# Приклад використання
np.random.seed(42)

# Архітектура: 3 → 4 (ReLU) → 2 (ReLU) → 1 (Sigmoid)
layers = [
    (np.random.randn(4, 3) * 0.1, np.zeros((4, 1))),  # Шар 1
    (np.random.randn(2, 4) * 0.1, np.zeros((2, 1))),  # Шар 2
    (np.random.randn(1, 2) * 0.1, np.zeros((1, 1)))   # Вихідний шар
]

activations = [relu, relu, sigmoid]

# Вхід
x = np.array([0.5, 0.3, 0.8])

# Прямий прохід
output = forward_pass(x, layers, activations)

print(f"Вхід: {x}")
print(f"Вихід мережі: {output[0]:.4f}")
print(f"Інтерпретація: ймовірність класу 1 = {output[0]:.2%}")
Відповідь:
У задачі XOR потрібно розділити:
- Клас 0 (червоні точки): (0, 0) та (1, 1)
- Клас 1 (сині точки): (0, 1) та (1, 0)
Якщо ми намалюємо ці точки на площині, побачимо, що вони розташовані по діагоналі — червоні точки в протилежних кутах, сині — у двох інших кутах.
Пряма лінія може розділити простір лише на два півпростори. Щоб правильно класифікувати XOR, потрібна крива (наприклад, коло) або дві лінії.
Одношаровий персептрон — це лінійний класифікатор, він може провести лише одну лінію. Тому для XOR математично неможливо знайти такі ваги Завантаження..., що персептрон правильно класифікує всі 4 точки.
Рішення: додати приховані шари → MLP зможе створити нелінійні межі розділення.
Резюме модуля
🧠 Персептрон
🔗 Багатошаровий персептрон (MLP)
⚡ Функції активації
➡️ Forward Propagation
⬅️ Backpropagation
🎯 Оптимізатори
Ключові терміни та визначення
| Термін | Визначення |
|---|---|
| Персептрон (Perceptron) | Одношарова нейронна мережа, що обчислює зважену суму входів та застосовує функцію активації |
| MLP (Multi-Layer Perceptron) | Багатошарова нейронна мережа з прихованими шарами |
| Лінійна роздільність | Властивість датасету, коли класи можна розділити гіперплощиною (лінією, площиною) |
| Функція активації | Нелінійна функція, що перетворює зважену суму нейрона |
| ReLU | Завантаження... — найпопулярніша функція активації для прихованих шарів |
| Sigmoid | Завантаження... — для бінарної класифікації на виході |
| Softmax | Перетворює вектор у розподіл ймовірностей — для багатокласової класифікації |
| Forward Propagation | Обчислення виходу мережі шляхом послідовного проходження даних через шари |
| Backpropagation | Алгоритм обчислення градієнтів за допомогою ланцюгового правила |
| Градієнт (Gradient) | Вектор часткових похідних функції втрат по всіх параметрах |
| Learning Rate (α) | Розмір кроку при оновленні ваг |
| Оптимізатор (Optimizer) | Алгоритм оновлення параметрів (SGD, Momentum, Adam) |
| Epoch (Епоха) | Один повний прохід по всьому тренувальному датасету |
| Batch (Батч) | Підмножина прикладів для одного кроку оновлення ваг |
Що далі?
У наступній статті ми познайомимося з бібліотекою PyTorch — найпопулярнішим фреймворком для побудови нейронних мереж. Ви навчитеся:
- Працювати з тензорами та графами обчислень
- Визначати моделі за допомогою
nn.Module - Використовувати вбудовані оптимізатори та функції втрат
- Навчати свою першу нейронну мережу на реальному датасеті
- Перегляньте відео «But what is a neural network?» від 3Blue1Brown (візуалізація backpropagation)
- Прочитайте оригінальну статтю «Learning representations by back-propagating errors» (Rumelhart et al., 1986)
- Реалізуйте MLP на чистому NumPy для датасету Iris (без використання бібліотек ML)
Метрики якості класифікації
Confusion Matrix, Accuracy, Precision, Recall, F1-Score, ROC-AUC — як правильно оцінювати моделі класифікації та уникати типових помилок
Тензори та автоматичне диференціювання в PyTorch
Основи роботи з тензорами, операції, broadcasting, граф обчислень та механізм autograd для автоматичного обчислення градієнтів.