Основи класифікації та логістична регресія
Основи класифікації та логістична регресія
🎯 Мета підрозділу
- Зрозуміти різницю між регресією та класифікацією
- Опанувати поняття бінарної та багатокласової класифікації
- Познайомитися з логістичною регресією та сигмоїдною функцією
- Навчитися інтерпретувати ймовірнісні прогнози
- Зрозуміти поняття порогу прийняття рішень
🔑 Ключові терміни
- Класифікація (classification) — передбачення категорії або класу об'єкта
- Бінарна класифікація (binary classification) — задача з двома класами
- Логістична регресія (logistic regression) — алгоритм для класифікації
- Сигмоїдна функція (sigmoid) — перетворює число у ймовірність від 0 до 1
- Поріг рішення (decision threshold) — межа, за якою відбувається класифікація
Історія про лікаря, який діагностує хвороби
Доктор Петренко працює в клініці і щодня приймає пацієнтів з підозрою на серцево-судинні захворювання. Після аналізів (рівень холестерину, тиск, вік, вага) він має прийняти важливе рішення: чи є у пацієнта підвищений ризик хвороби серця?
На відміну від завдання передбачення точної ціни квартири (де результат — будь-яке число), тут результат може бути лише одним із двох варіантів:
- Клас 0: здоровий пацієнт (низький ризик)
- Клас 1: пацієнт з підвищеним ризиком (потрібне подальше обстеження)
Це класична задача бінарної класифікації (binary classification). Доктор не оцінює «наскільки хворий» пацієнт числом від 0 до 100 — він приймає дискретне рішення: направляти на додаткові обстеження чи ні.
Що таке задача класифікації?
Класифікація (classification) — це тип завдання машинного навчання з учителем (supervised learning), де потрібно віднести об'єкт до одного з фіксованих дискретних класів на основі його ознак.
Приклади класифікаційних задач
| Вхідні ознаки | Цільова змінна (що передбачаємо) | Кількість класів |
|---|---|---|
| Текст листа, відправник, заголовок | Спам / не спам | 2 (бінарна) |
| Симптоми, результати аналізів | Здоровий / хворий | 2 (бінарна) |
| Фотографія руки з цифрою | Цифра від 0 до 9 | 10 (багатокласова) |
| Характеристики квітки (довжина пелюсток) | Вид квітки (Setosa / Versicolor / Virginica) | 3 (багатокласова) |
| Характеристики транзакції (сума, час, місце) | Шахрайство / легальна операція | 2 (бінарна) |
| Зображення тварини | Кіт / собака / пташка | 3 (багатокласова) |
Типи класифікації
У машинному навчанні розрізняють кілька фундаментальних типів класифікаційних задач залежно від кількості класів та їхньої структури.
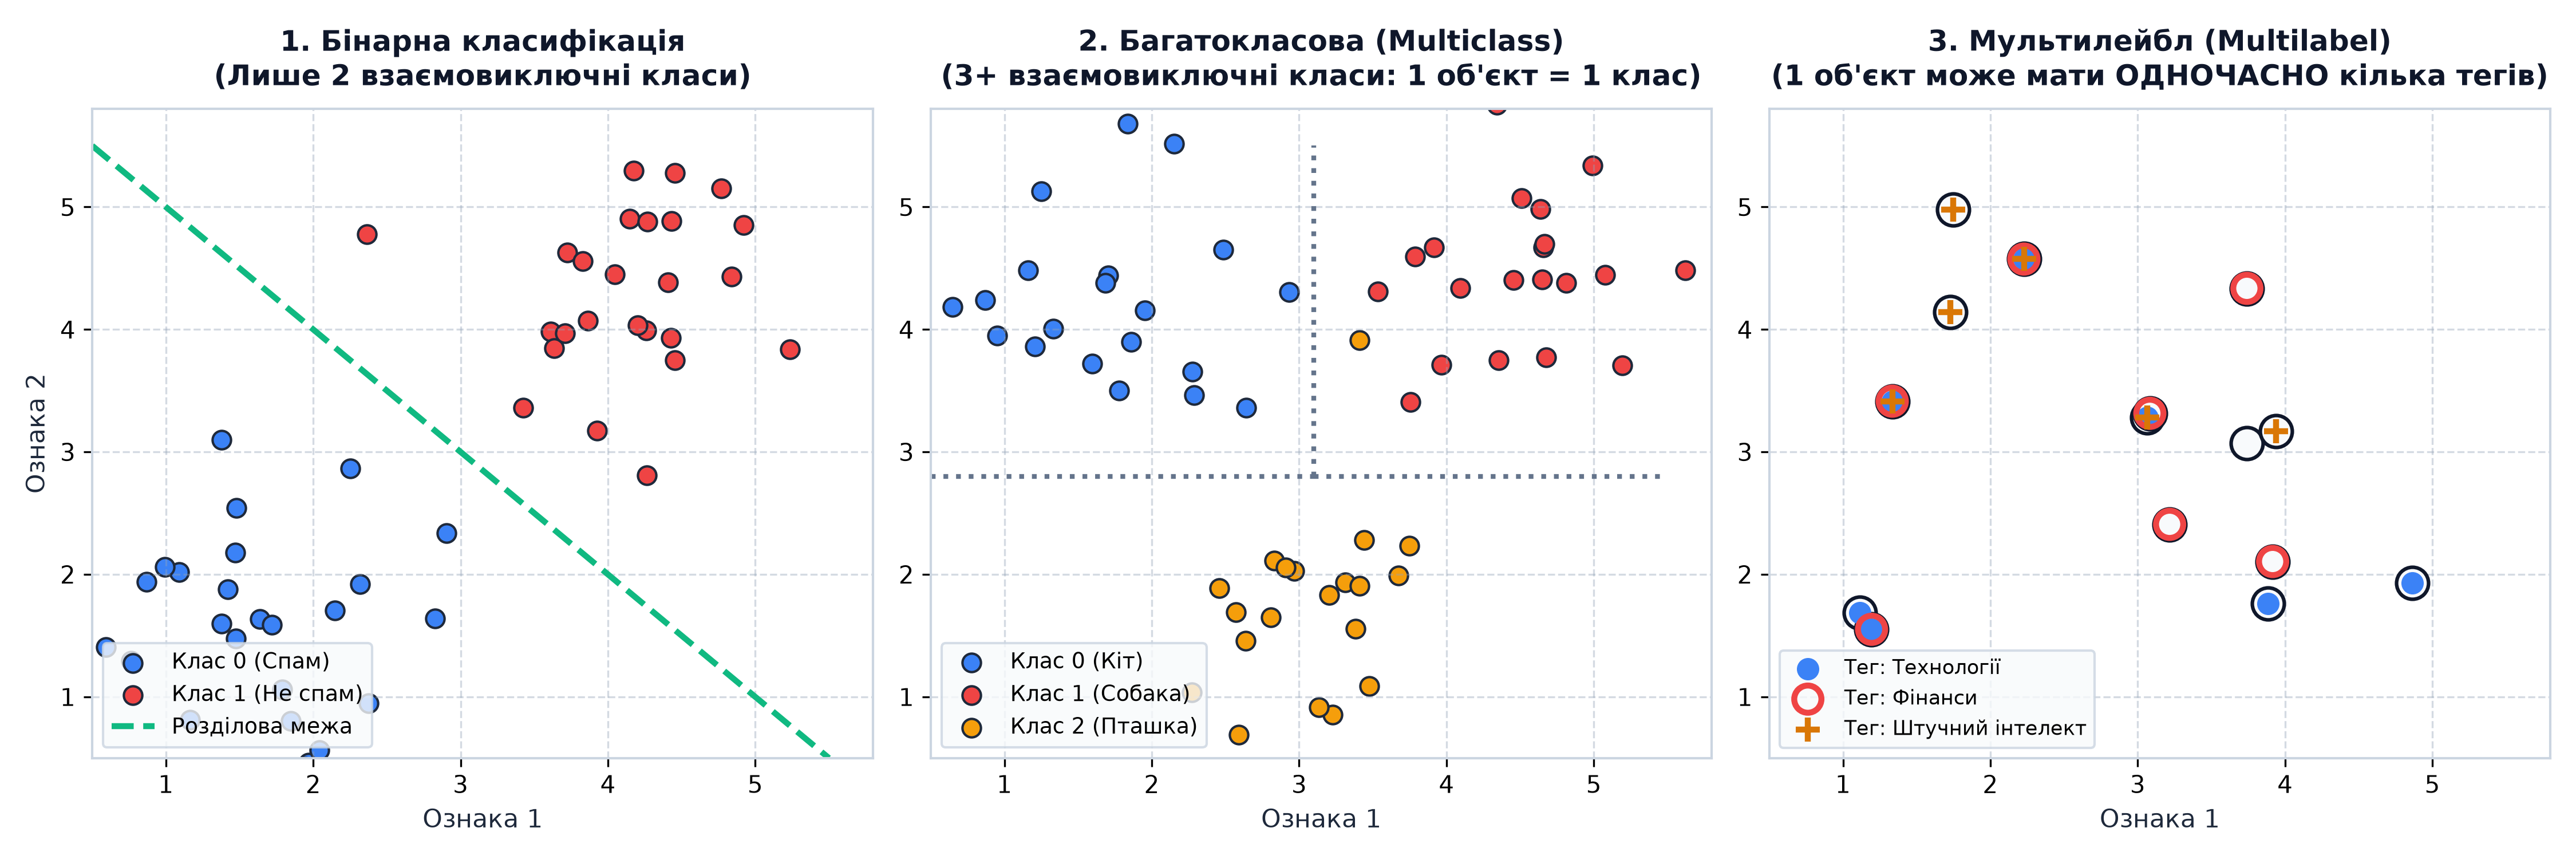
1. Бінарна класифікація (Binary Classification)
Визначення: задача, де об'єкт належить до одного з двох класів.
Зазвичай класи позначають як:
- 0 та 1 (у програмуванні та математиці)
- негативний та позитивний клас (negative / positive)
- False та True (у логічних задачах)
Приклади:
- Медична діагностика: хворий (1) / здоровий (0)
- Фінанси: дефолт (1) / виплата (0)
- Email: спам (1) / не спам (0)
- Кредитний скоринг: схвалити заявку (1) / відхилити (0)
# Датасет з двома класами
y_train = np.array([0, 1, 0, 0, 1, 1, 0, 1])

# Прогноз моделі
y_pred = model.predict(X_test)
# Результат: [1, 0, 0, 1, 1] — лише 0 або 1
# Той самий датасет з текстовими мітками
y_train = ["здоровий", "хворий", "здоровий", "здоровий", "хворий"]

# Кодування у числа
from sklearn.preprocessing import LabelEncoder
encoder = LabelEncoder()
y_encoded = encoder.fit_transform(y_train)
# Результат: [0, 1, 0, 0, 1]
2. Багатокласова класифікація (Multiclass Classification)
Визначення: задача, де об'єкт належить до одного з трьох або більше класів.
Кожен об'єкт має один і тільки один клас. Класи взаємовиключні.
Приклади:
- Розпізнавання рукописних цифр: 0, 1, 2, ..., 9 (10 класів)
- Класифікація квітів Iris: Setosa, Versicolor, Virginica (3 класи)
- Розпізнавання емоцій на фото: радість, сум, гнів, подив, страх (5 класів)
- Класифікація жанрів фільмів: драма, комедія, бойовик, фантастика
from sklearn.datasets import load_iris
from sklearn.linear_model import LogisticRegression

# Завантаження датасету Iris (3 класи)
iris = load_iris()
X, y = iris.data, iris.target

print(f"Кількість класів: {len(np.unique(y))}")
print(f"Класи: {iris.target_names}")

import matplotlib.pyplot as plt

colors = ['#ef4444', '#3b82f6', '#10b981']

plt.figure(figsize=(9, 6))
for k, name in enumerate(iris.target_names):
    plt.scatter(X[y == k, 2], X[y == k, 3], c=colors[k], s=60,
                alpha=0.8, edgecolor='white', label=name)
plt.xlabel('Довжина пелюстки (см)', fontsize=12)
plt.ylabel('Ширина пелюстки (см)', fontsize=12)
plt.title('Iris: три класи у просторі ознак пелюстки', fontsize=14)
plt.legend(title='Клас')
plt.grid(alpha=0.3)
plt.show()
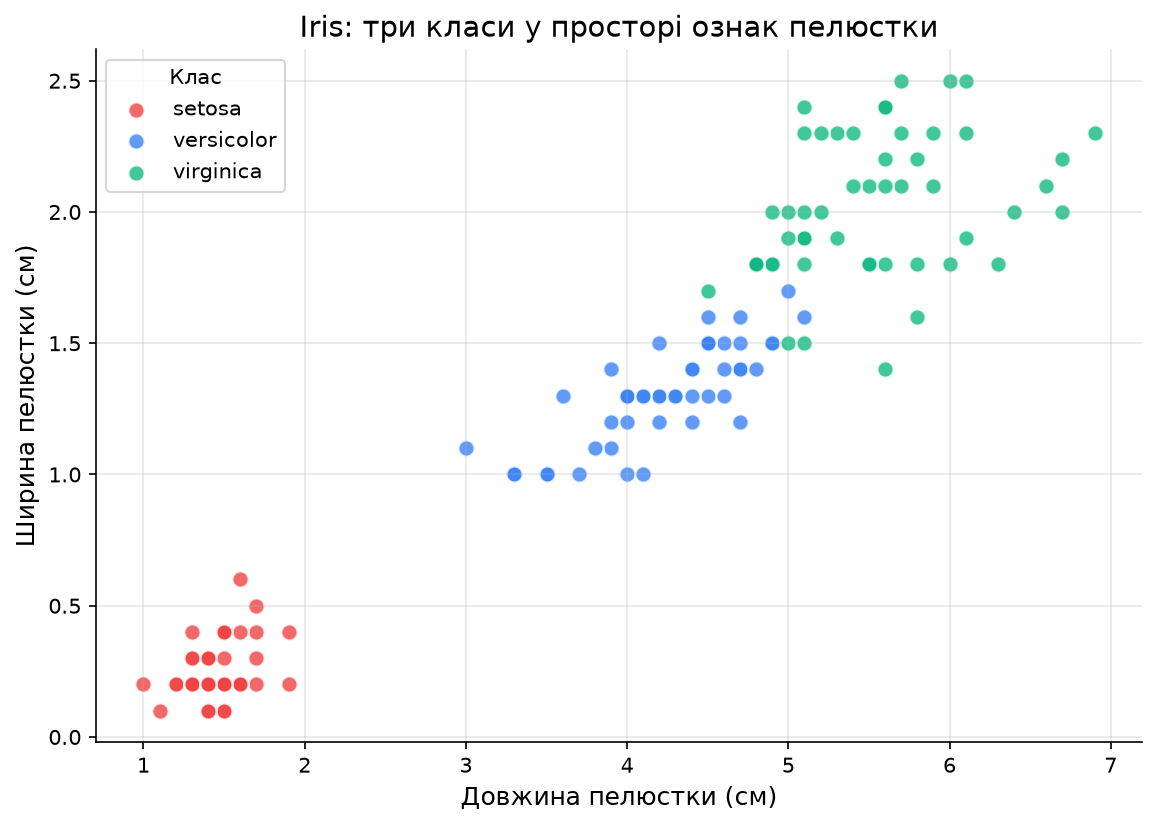
Кількість класів: 3
Класи: ['setosa' 'versicolor' 'virginica']
3. Мультилейбл класифікація (Multilabel Classification)
Визначення: задача, де об'єкт може одночасно належати до кількох класів.
На відміну від багатокласової класифікації, тут класи не взаємовиключні — об'єкт може мати кілька міток одночасно.
Приклади:
- Теги для статті: "Python", "Machine Learning", "Tutorial"
- Класифікація фільму за жанрами: "Action", "Sci-Fi", "Thriller"
- Медична діагностика з кількома хворобами одночасно
- Розпізнавання об'єктів на фото: "людина", "автомобіль", "будинок"
# Один клас на об'єкт
y = [2, 0, 1, 2, 1]
# Об'єкт належить ТІЛЬКИ до класу 2 АБО 0 АБО 1
# Кілька класів на об'єкт
y = [[1, 0, 1],    # Класи 0 та 2
     [0, 1, 0],    # Тільки клас 1
     [1, 1, 1]]    # Усі три класи одночасно
Регресія vs Класифікація: фундаментальні відмінності
Хоча обидва типи задач належать до навчання з учителем (supervised learning), між ними існують принципові відмінності у природі цільової змінної та способах оцінювання моделей.
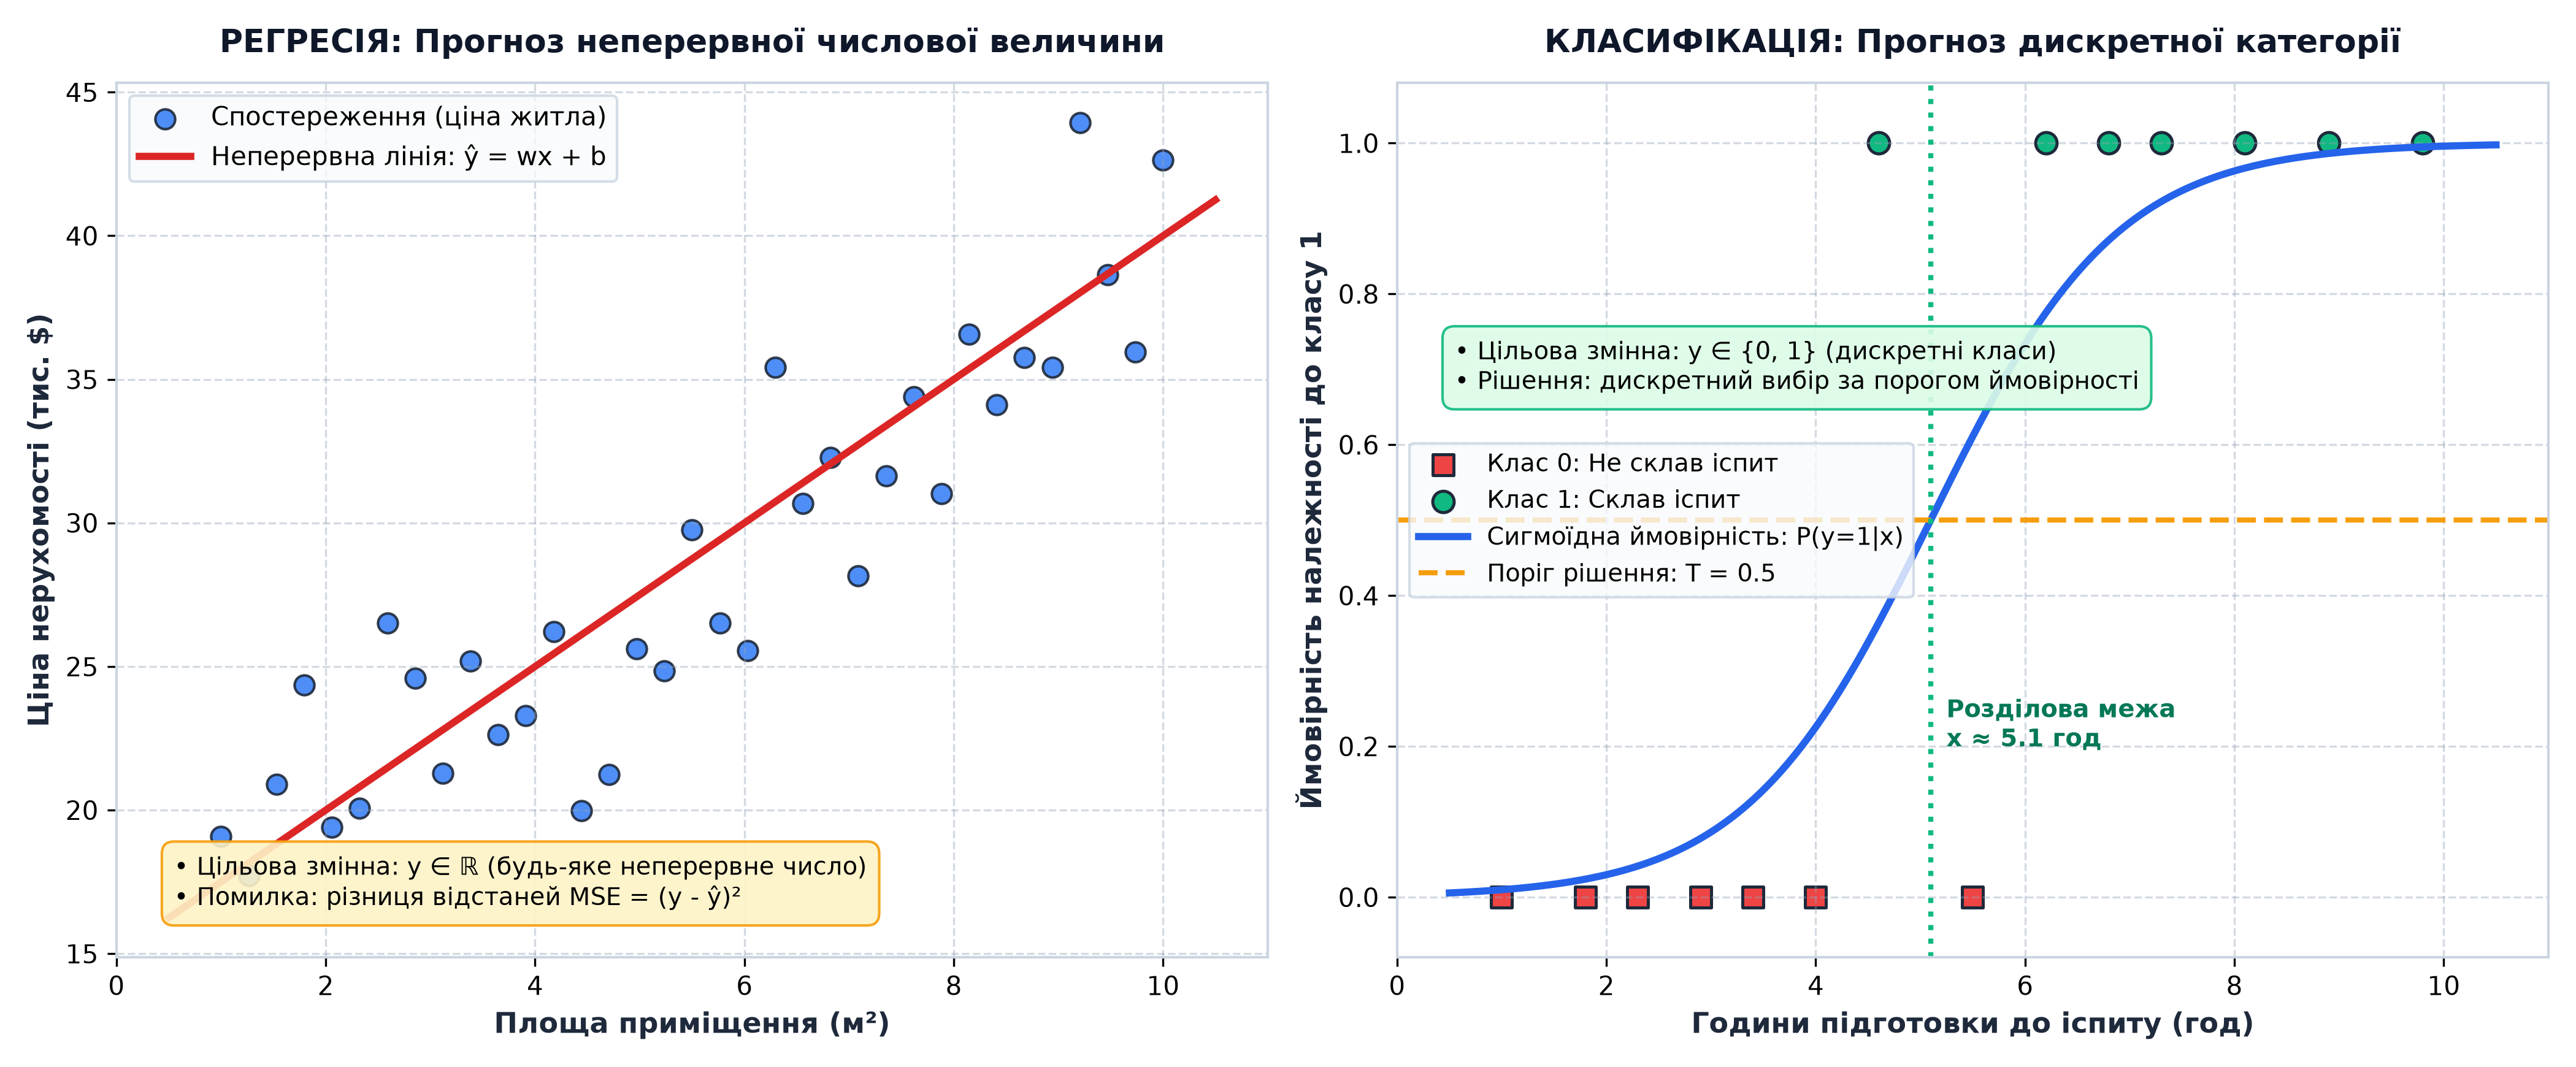
Концептуальні відмінності
| Характеристика | Регресія | Класифікація |
|---|---|---|
| Тип цільової змінної | Неперервна числова величина | Дискретна категорія |
| Приклад виводу | Завантаження... | Завантаження... |
| Діапазон значень | Завантаження... або Завантаження... | Фіксована скінченна множина класів |
| Функція активації | Лінійна (відсутня) | Сигмоїда, softmax, tanh |
| Функція втрат | MSE, MAE, Huber | Cross-Entropy, Hinge Loss |
| Метрики оцінки | Завантаження..., RMSE, MAE | Accuracy, Precision, Recall, F1-Score |
| Геометрична інтерпретація | Пряма/крива апроксимації | Розділова межа між класами |
- Якщо на запитання "скільки?" потрібна відповідь числом — це регресія
- Якщо на запитання "який?" потрібна відповідь категорією — це класифікація
Математична формалізація
Регресія:
Модель апроксимує неперервну функцію Завантаження..., де Завантаження... може приймати будь-яке дійсне значення.
Класифікація:
Модель обчислює розподіл ймовірностей по класах Завантаження... і обирає клас з найвищою ймовірністю.
- Регресія — це термометр: показує точне неперервне число на шкалі (Завантаження..., Завантаження...).
- Класифікація — це світлофор: обирає один із фіксованих станів (🔴 червоний, 🟡 жовтий, 🟢 зелений).
Чому лінійна регресія не підходить для класифікації?
На перший погляд, можна спробувати використати звичайну лінійну регресію для класифікації: позначити класи числами (0 та 1), навчити модель Завантаження..., і застосувати поріг — якщо Завантаження..., клас 1, інакше 0.
Але цей підхід має критичні проблеми.
Проблема 1: Прогнози виходять за межі 0, 1
Лінійна функція не обмежена зверху і знизу. Для великих або малих значень Завантаження... прогноз може бути меншим за 0 або більшим за 1, що не має сенсу як ймовірність.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression

# Дані: вік студента та чи склав іспит (0 = ні, 1 = так)
X = np.array([15, 18, 20, 22, 25, 28, 30, 35, 40, 45]).reshape(-1, 1)
y = np.array([0, 0, 0, 1, 1, 1, 1, 1, 1, 1])

# Навчання лінійної регресії
model = LinearRegression()
model.fit(X, y)

# Прогноз для різних значень віку
X_test = np.linspace(10, 50, 100).reshape(-1, 1)
y_pred = model.predict(X_test)

print(f"Прогноз для віку 10: {model.predict([[10]])[0]:.3f}")
print(f"Прогноз для віку 50: {model.predict([[50]])[0]:.3f}")
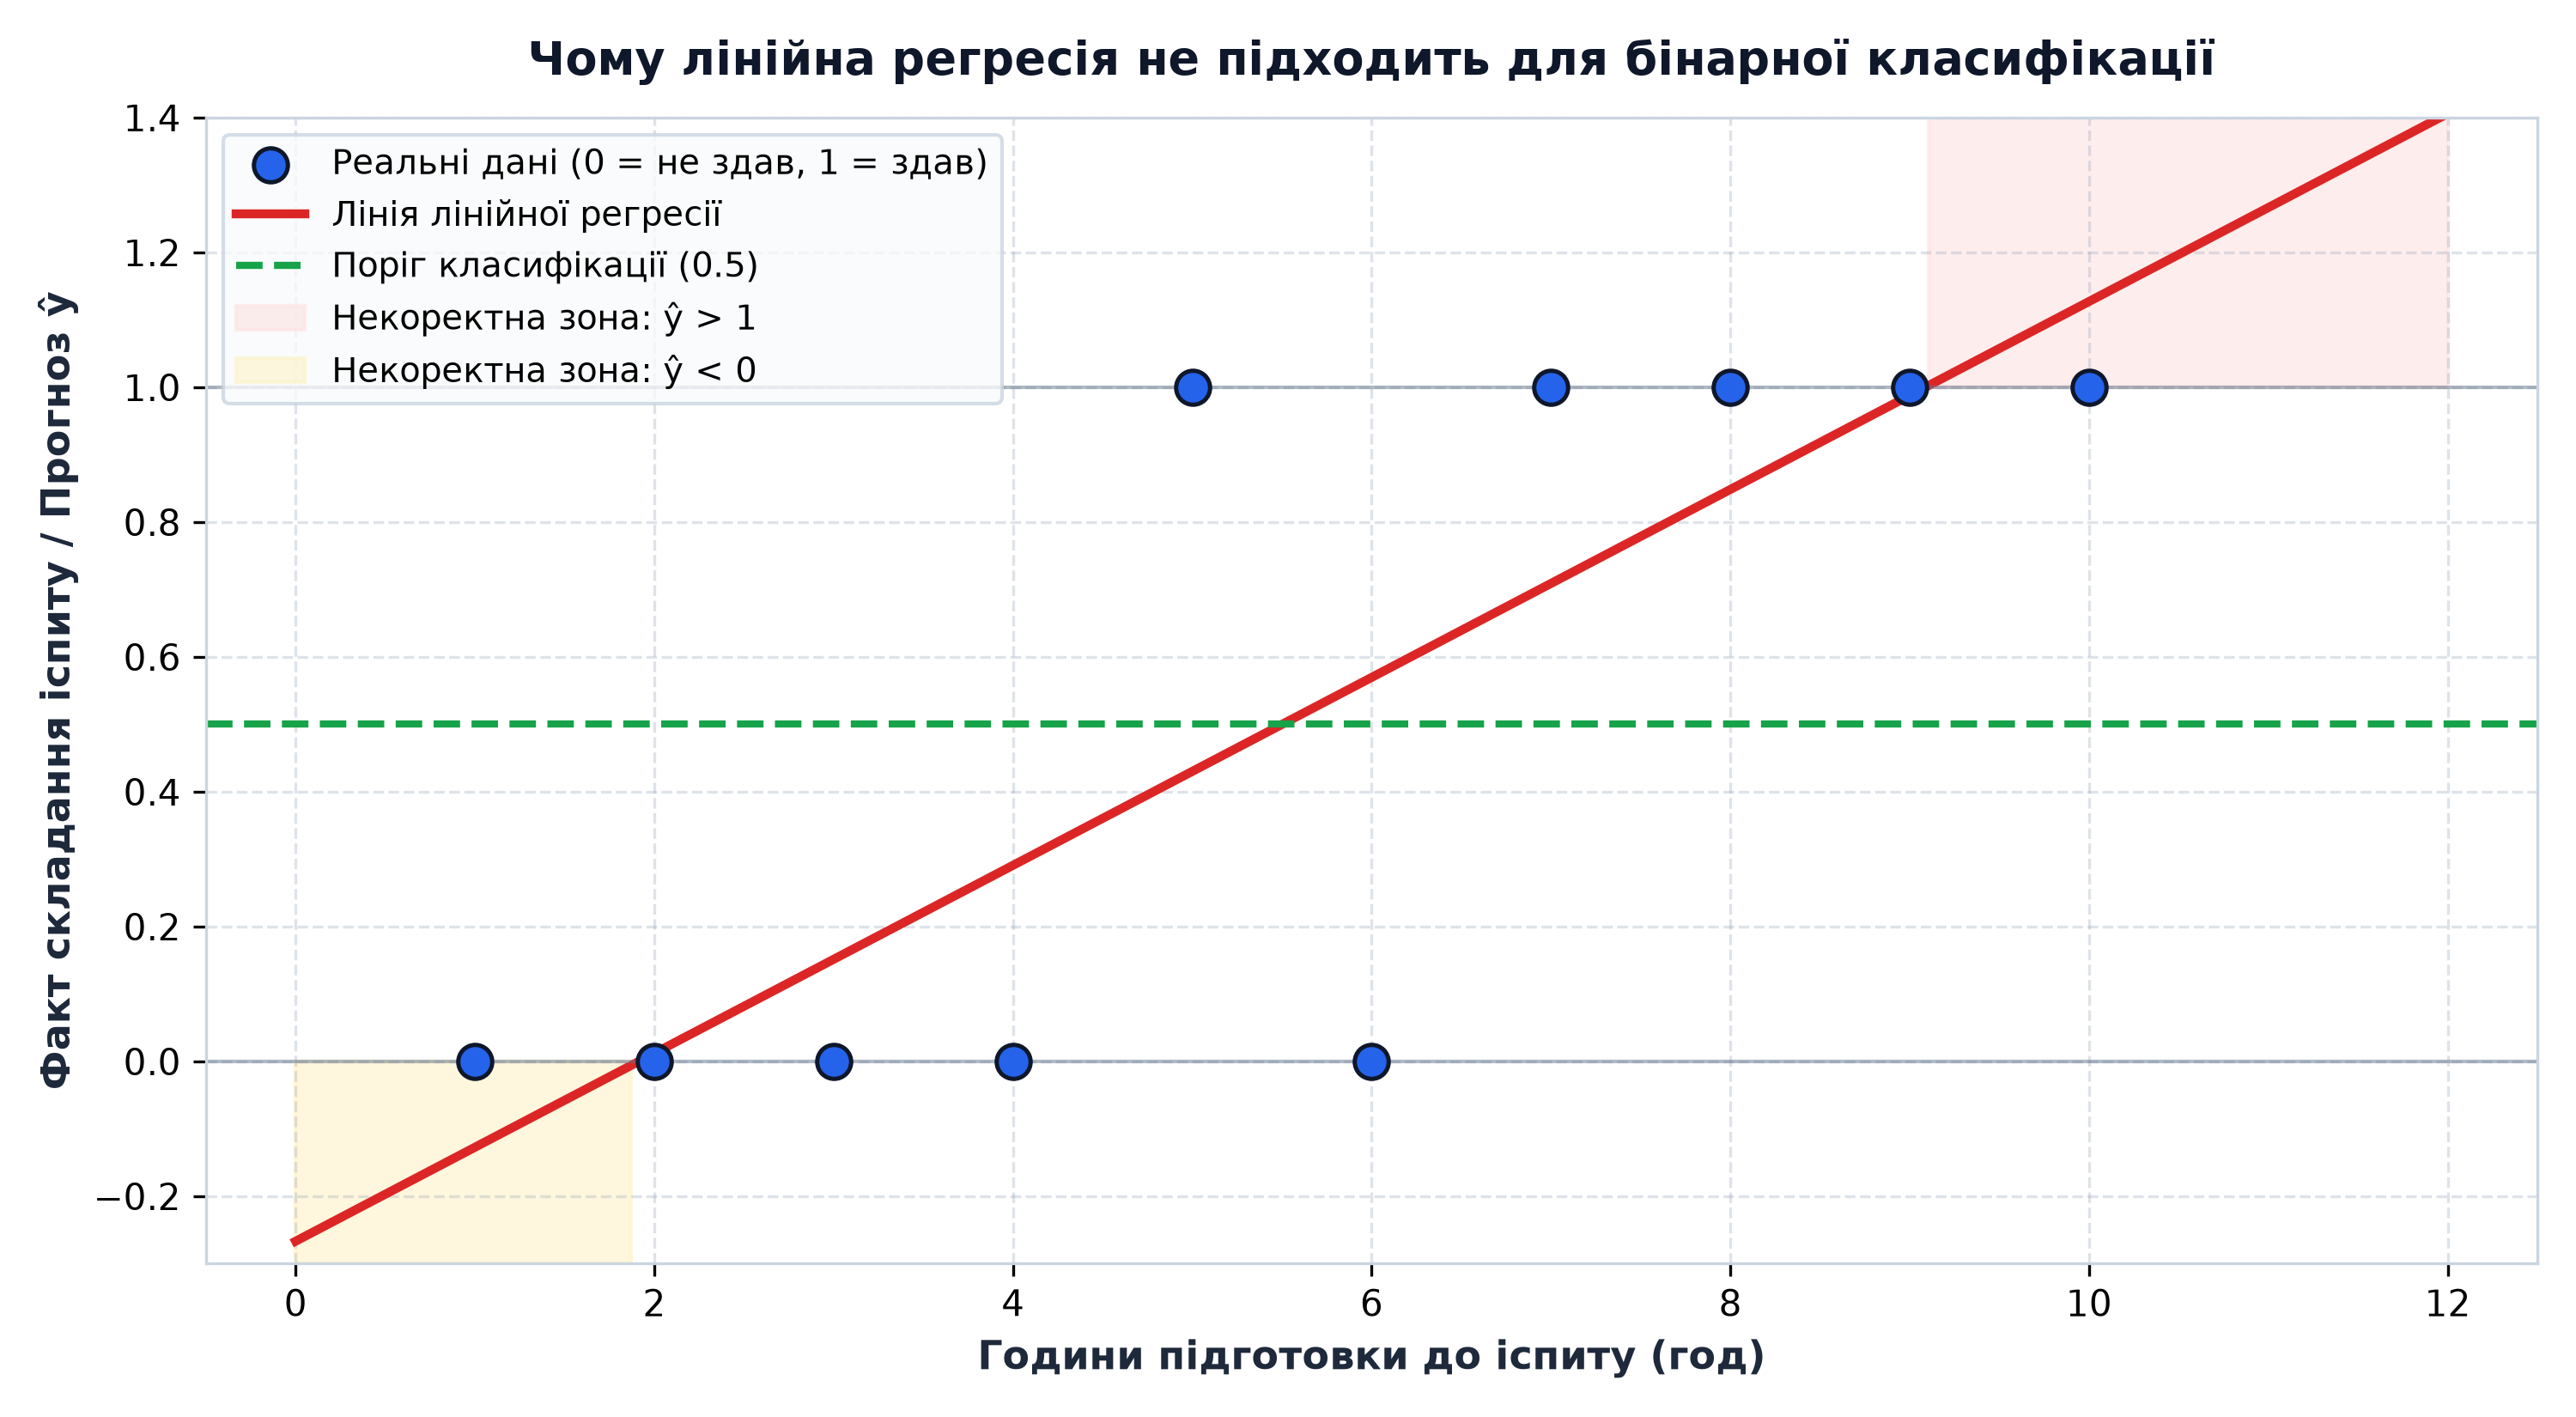
Прогноз для віку 10: -0.287
Прогноз для віку 50: 1.543
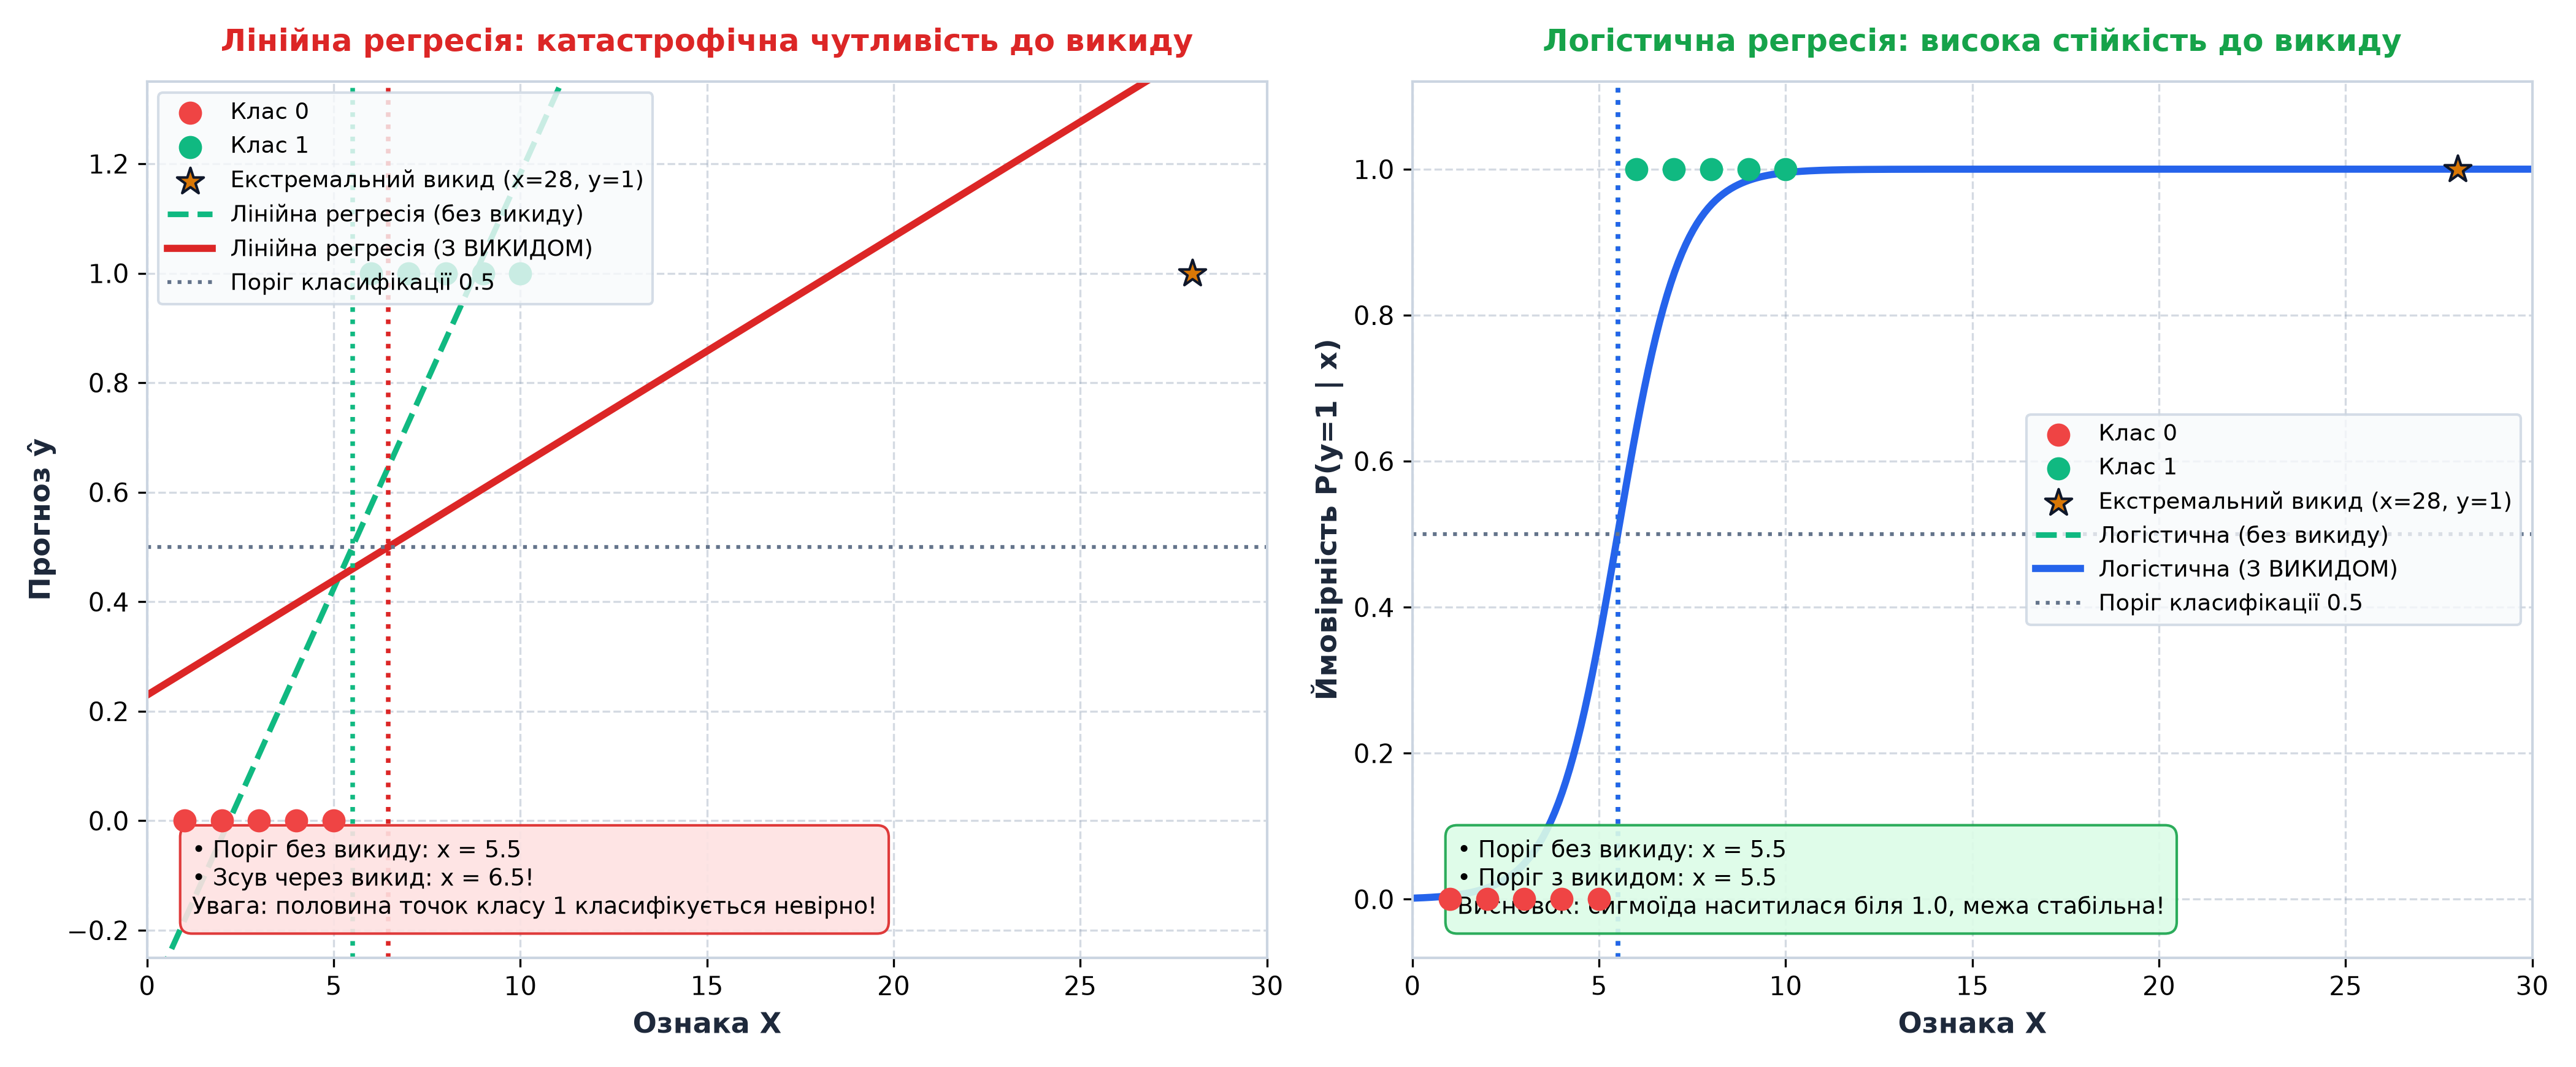
Проблема 2: Чутливість до викидів (outliers)
Лінійна регресія намагається мінімізувати середньоквадратичну помилку (MSE), що робить її надзвичайно чутливою до викидів. Один екстремальний об'єкт може сильно змістити лінію та зіпсувати класифікацію для всіх інших точок.
Проблема 3: Семантична невідповідність
Лінійна регресія припускає, що різниця між 0 і 0.5 та між 0.5 і 1.0 однакова та має сенс. Але для класифікації це не так: клас 0 та клас 1 — це просто мітки, а не числа на осі. Різниця «на 0.3» між класами безглузда.
- Обмежує прогнози діапазоном Завантаження...
- Інтерпретує вихід як ймовірність належності до класу
- Стійкий до викидів
- Використовує функцію втрат, що відповідає природі задачі
Що таке логістична регресія?
Логістична регресія (logistic regression) — це алгоритм машинного навчання для задач бінарної класифікації, який моделює ймовірність належності об'єкта до класу 1 за допомогою сигмоїдної функції (sigmoid function).
Ідея алгоритму
Логістична регресія складається з двох етапів:
- Лінійна комбінація ознак:
Це звичайна лінійна функція, де Завантаження....
- Застосування сигмоїдної функції:
Сигмоїда "стискає" будь-яке дійсне число Завантаження... у діапазон Завантаження..., що інтерпретується як ймовірність належності до класу 1.
# Ознаки: вік, холестерин
x = np.array([45, 220])  # вік = 45 років, холестерин = 220 мг/дл
w = np.array([0.05, 0.02])
b = -8.5

z = w @ x + b  # Скалярний добуток + зміщення
print(f"z = {z:.2f}")  # Може бути будь-яким числом
def sigmoid(z):
    return 1 / (1 + np.exp(-z))

y_prob = sigmoid(z)  # Ймовірність класу 1
print(f"P(клас=1) = {y_prob:.3f}")

# Прийняття рішення
y_pred = 1 if y_prob >= 0.5 else 0
print(f"Прогноз: клас {y_pred}")
Сигмоїдна функція: перетворення числа у ймовірність
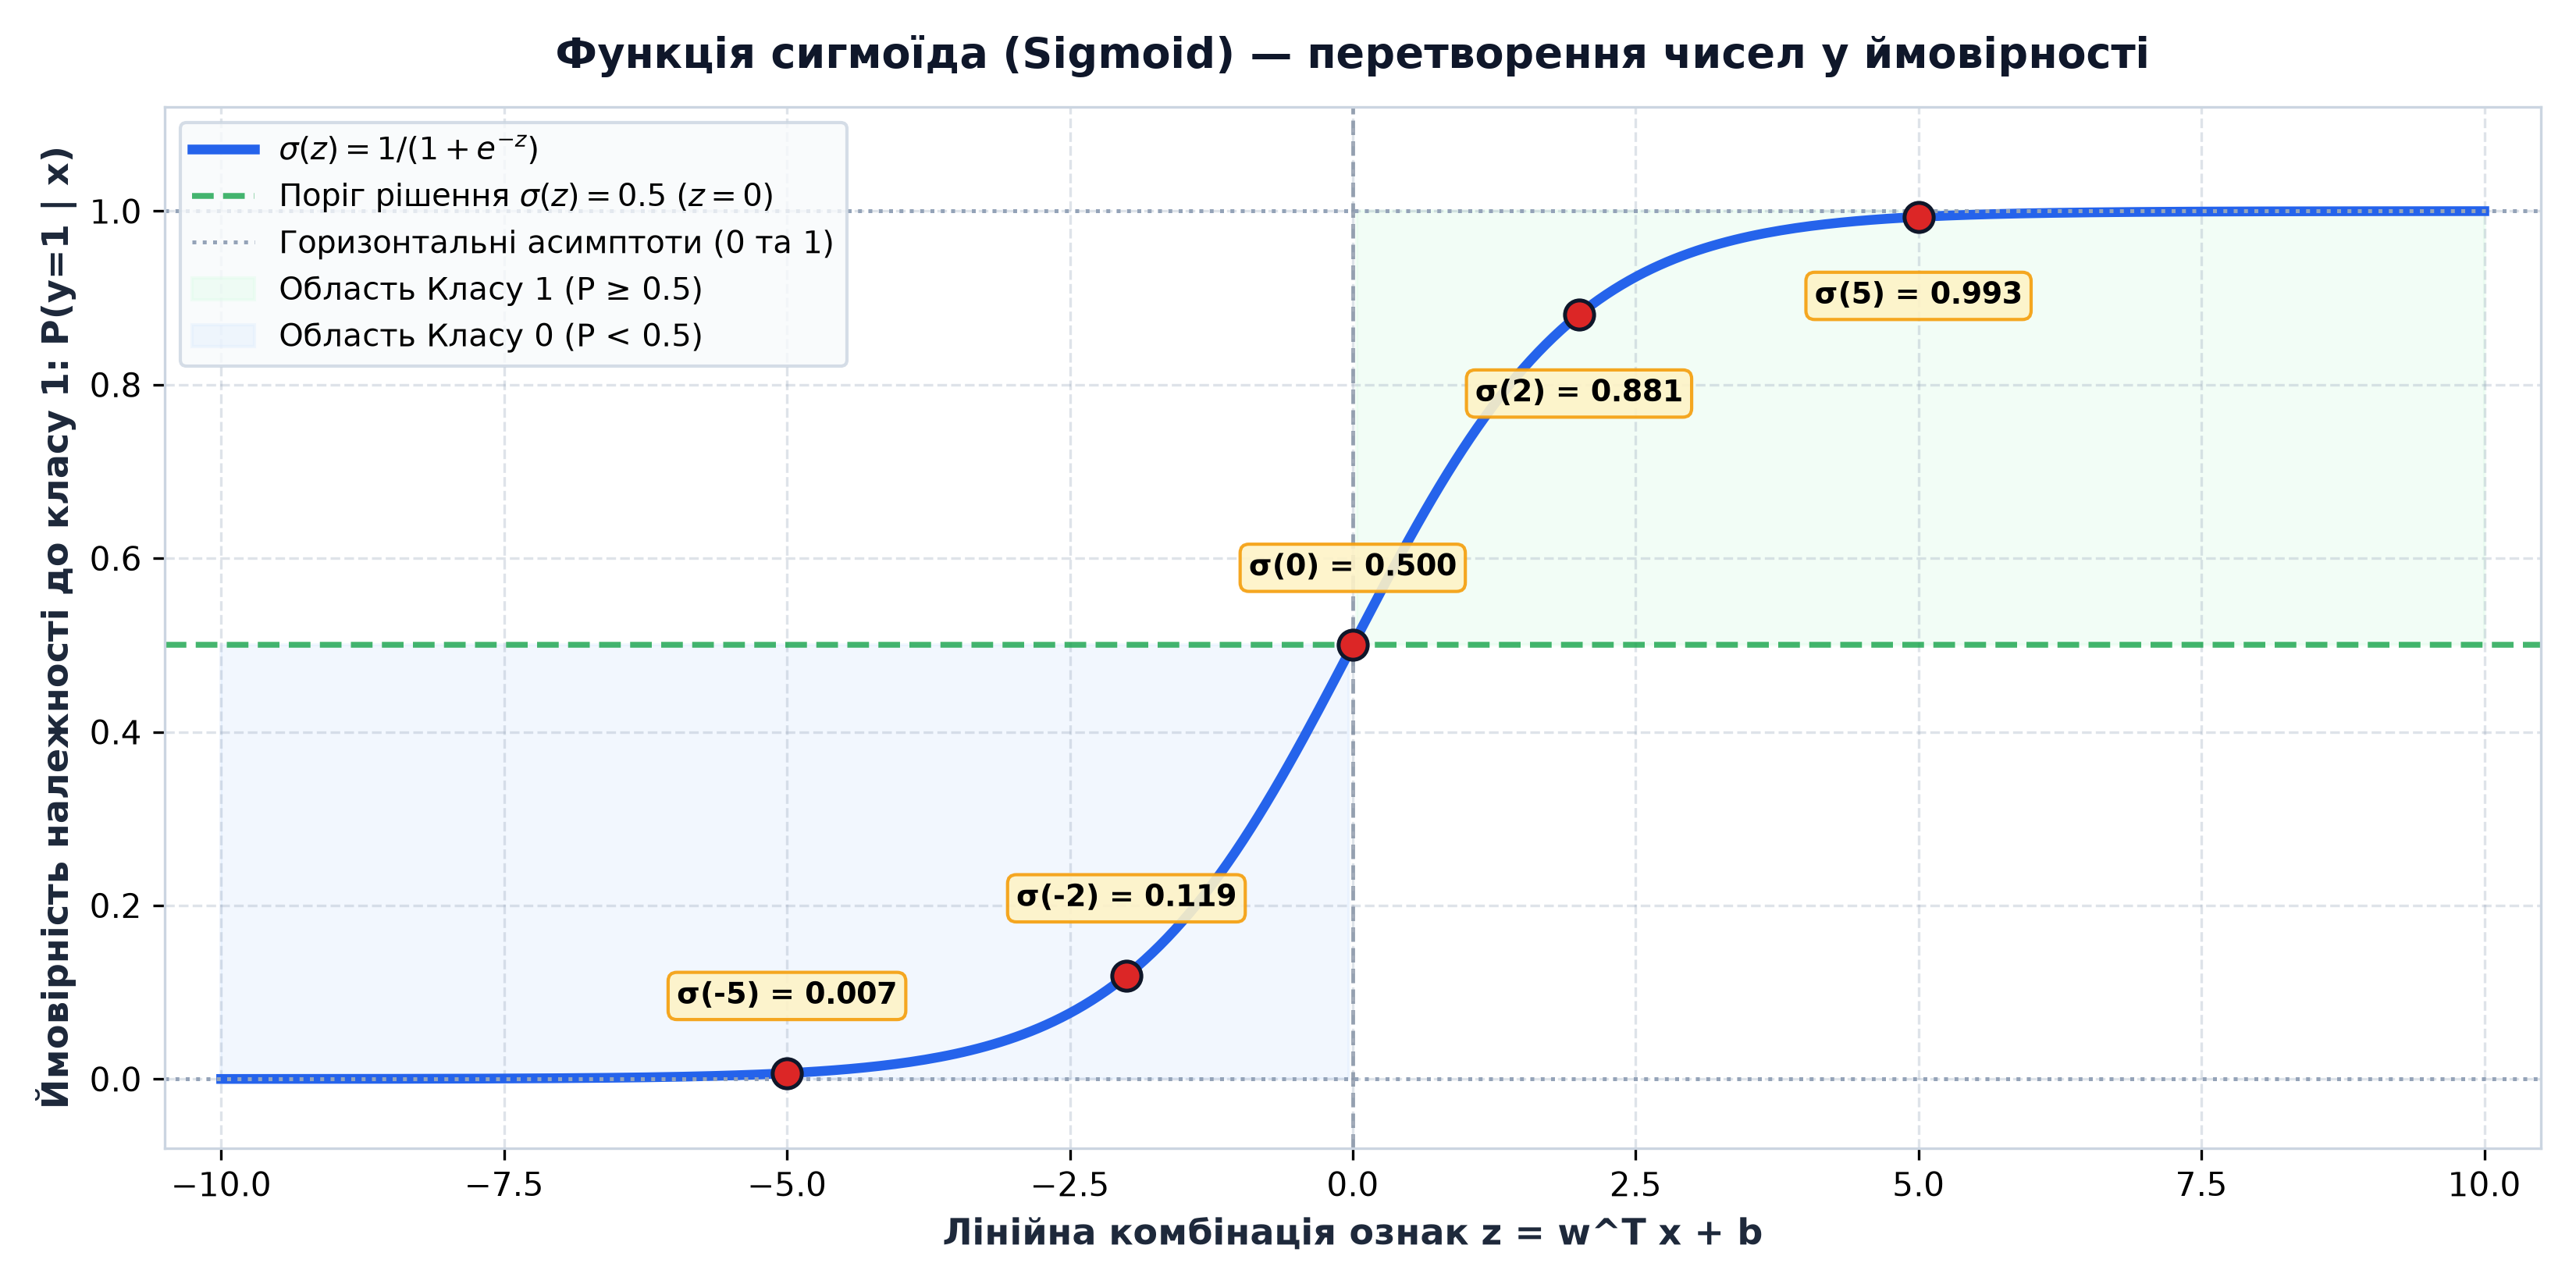
Сигмоїдна функція (sigmoid function), також відома як логістична функція, — це математична функція, що перетворює будь-яке дійсне число у значення від 0 до 1.
Математичне визначення
Де:
- Завантаження... — вхідне значення (лінійна комбінація ознак)
- Завантаження... — основа натурального логарифма
- Завантаження... — вихід у діапазоні ймовірностей
Властивості сигмоїди
import numpy as np
import matplotlib.pyplot as plt

def sigmoid(z):
    return 1 / (1 + np.exp(-z))

# Діапазон значень z від -10 до +10
z = np.linspace(-10, 10, 200)
y = sigmoid(z)

# Побудова графіка
plt.figure(figsize=(10, 6))
plt.plot(z, y, linewidth=2.5, color='#3b82f6', label='σ(z)')
plt.axhline(y=0.5, color='#ef4444', linestyle='--', alpha=0.7, label='Поріг 0.5')
plt.axvline(x=0, color='#10b981', linestyle='--', alpha=0.7, label='z = 0')
plt.grid(alpha=0.3)
plt.xlabel('z (лінійна комбінація)', fontsize=12)
plt.ylabel('σ(z) — ймовірність класу 1', fontsize=12)
plt.title('Сигмоїдна функція: перетворення z у ймовірність', fontsize=14)
plt.legend()
plt.show()

# Перевірка ключових точок
print(f"σ(-5) = {sigmoid(-5):.4f}")
print(f"σ(0)  = {sigmoid(0):.4f}")
print(f"σ(5)  = {sigmoid(5):.4f}")
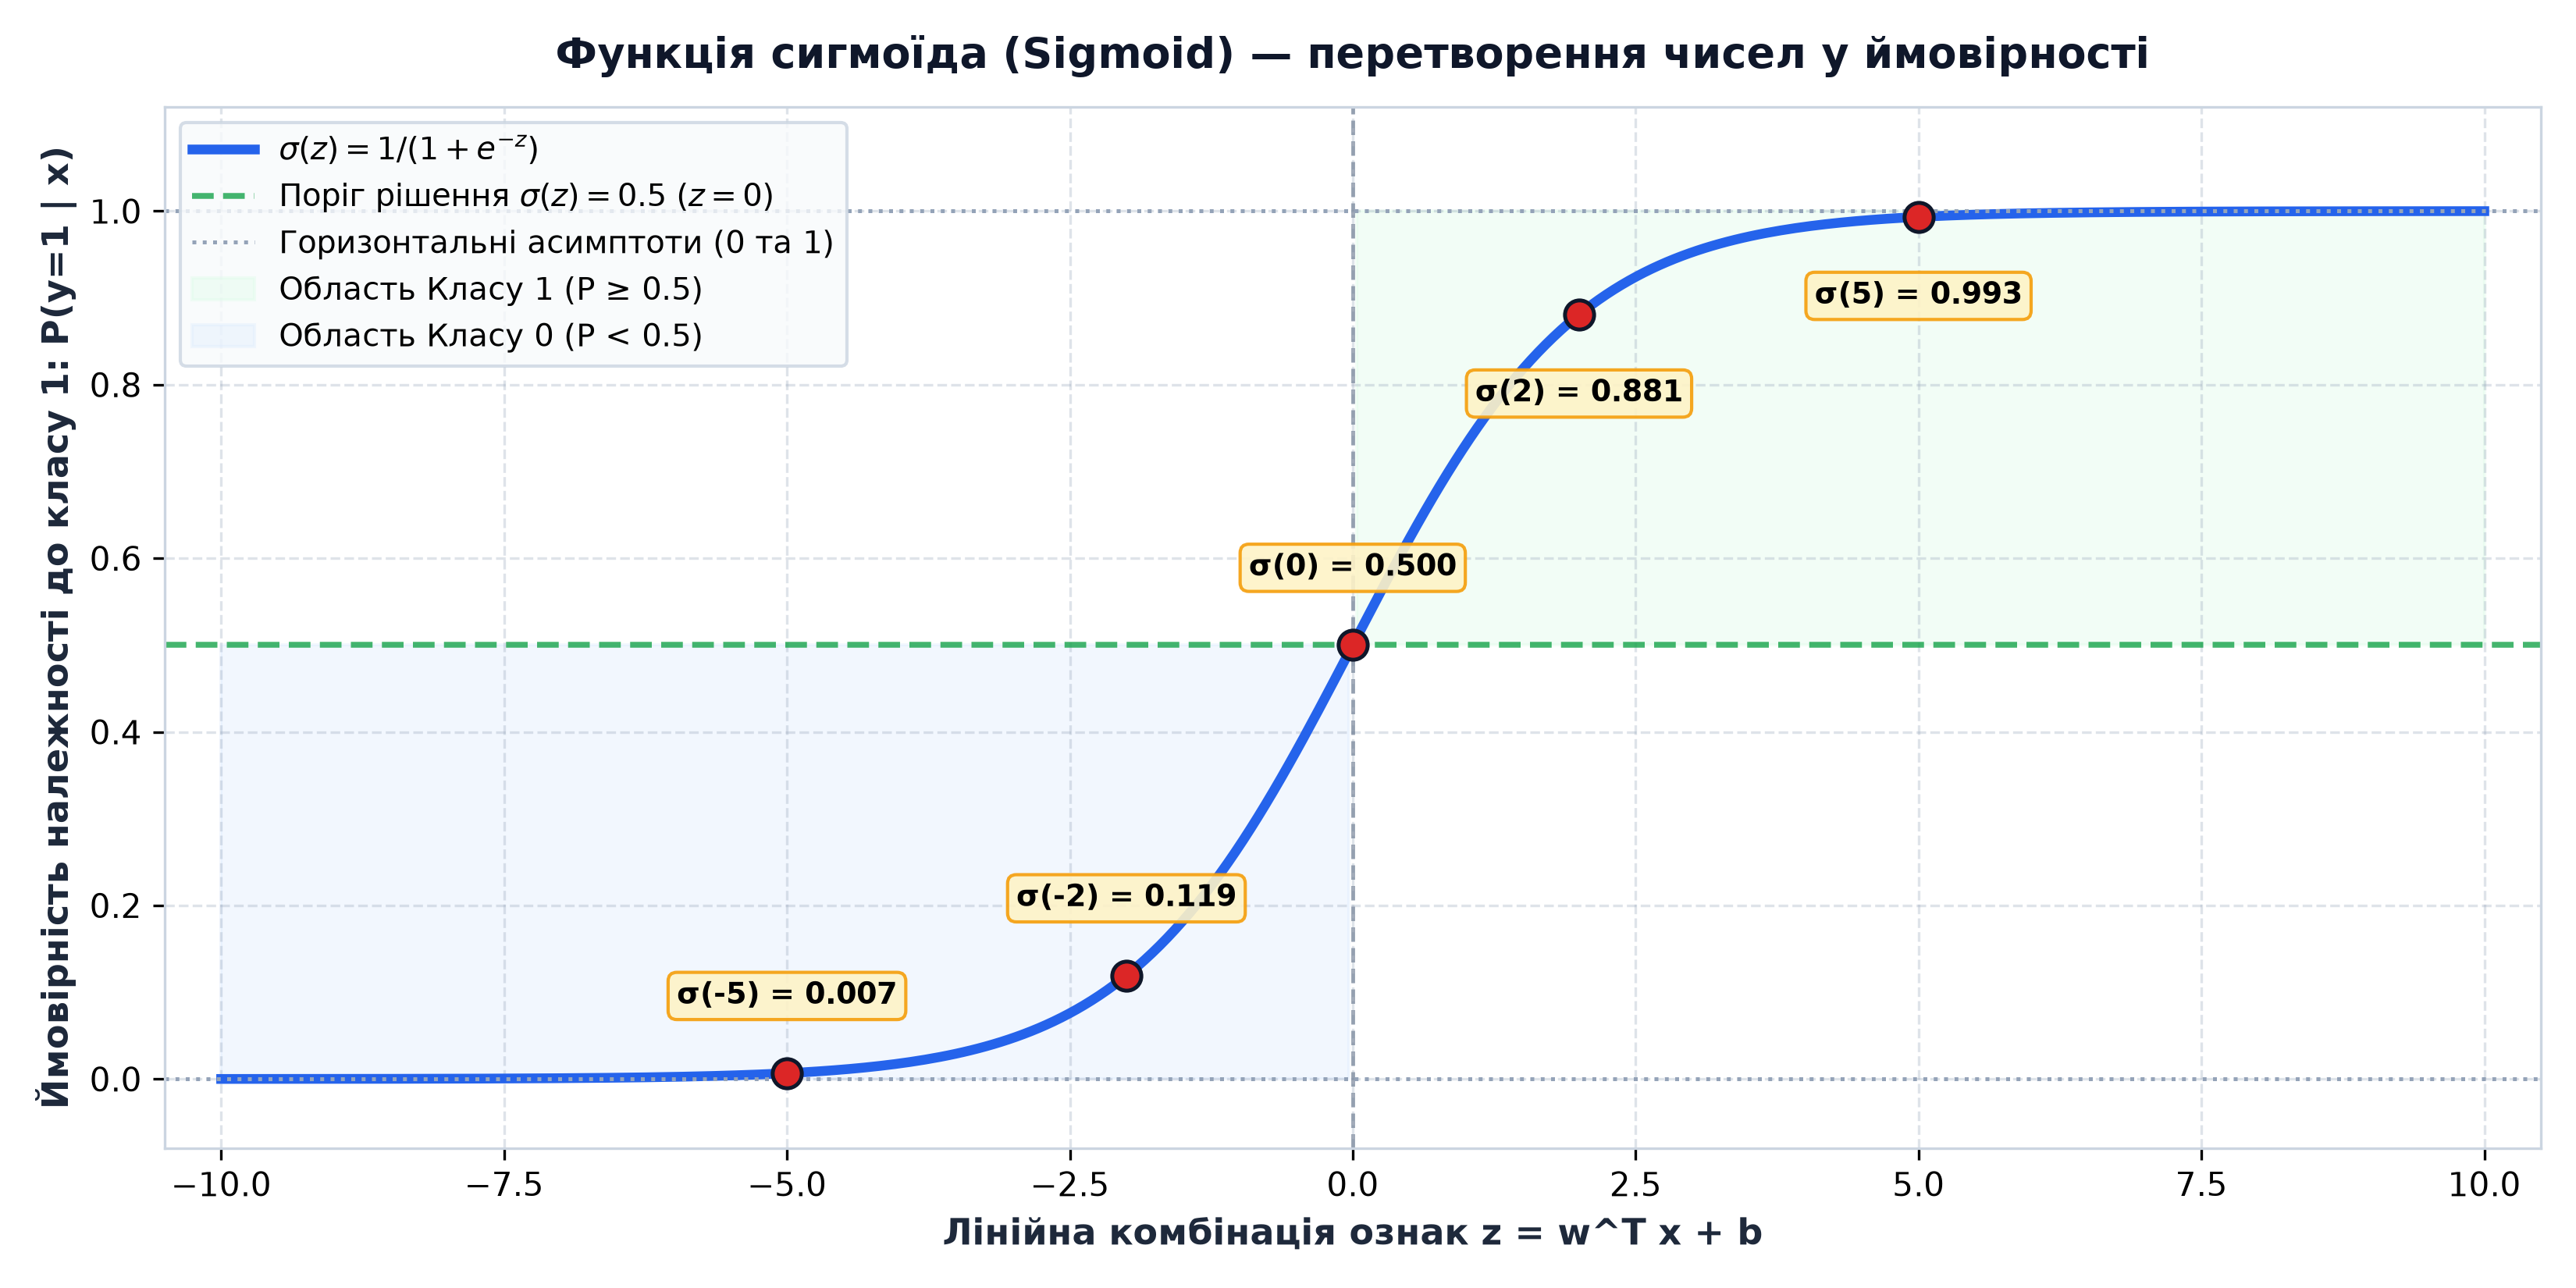
σ(-5) = 0.0067
σ(0)  = 0.5000
σ(5)  = 0.9933
Інтерпретація виходу логістичної регресії
Логістична регресія повертає ймовірність належності до класу 1: Завантаження....
Фінальне рішення про клас приймається через поріг (threshold), зазвичай 0.5:
Приклад інтерпретації
# Пацієнт: вік = 52, холестерин = 240, тиск = 145
X = np.array([[52, 240, 145]])

# Передбачена ймовірність (приклад)
y_prob = model.predict_proba(X)[0, 1]
y_class = model.predict(X)[0]

print(f"Ймовірність хвороби серця: {y_prob:.1%}")
print(f"Прогноз: {'підвищений ризик ⚠️' if y_class == 1 else 'низький ризик ✅'}")

import matplotlib.pyplot as plt

plt.figure(figsize=(9, 2.8))
plt.barh(['P(y=1)'], [y_prob], color='#ef4444' if y_prob >= 0.5 else '#10b981', height=0.5)
plt.barh(['P(y=1)'], [1 - y_prob], left=[y_prob], color='#e5e7eb', height=0.5)
plt.axvline(0.5, color='#1f2937', linestyle='--', label='Поріг 0.5')
plt.text(y_prob / 2, 0, f'{y_prob:.1%}', ha='center', va='center',
         color='white', fontsize=14, fontweight='bold')
plt.xlim(0, 1)
plt.xlabel('Ймовірність хвороби серця')
plt.title('Ймовірність → клас через поріг', fontsize=13)
plt.legend(loc='upper right')
plt.show()
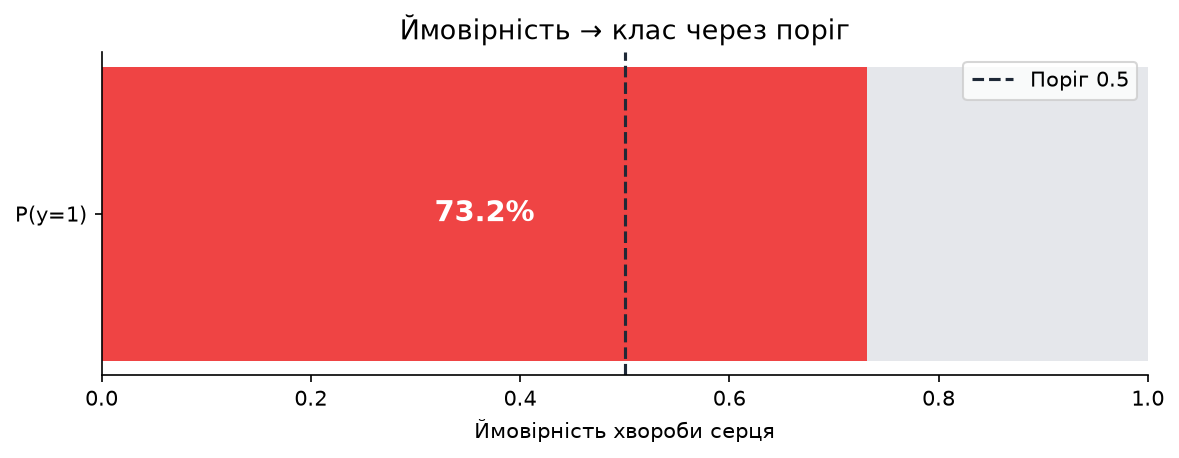
Ймовірність хвороби серця: 73.2%
Прогноз: підвищений ризик ⚠️
Коли використовувати логістичну регресію?
Логістична регресія — простий, інтерпретований та ефективний алгоритм, але має свої обмеження.
Переваги
✅ Простота інтерпретації
✅ Швидке навчання
✅ Ймовірнісні прогнози
✅ Не вимагає великих даних
Обмеження
❌ Тільки лінійна розділова межа
❌ Чутливість до мультиколінеарності
❌ Не працює зі складними залежностями
Резюме
📌 Класифікація
📌 Бінарна vs Багатокласова
📌 Логістична регресія
📌 Сигмоїдна функція
📌 Поріг рішення
📌 Переваги
Розділова межа (Decision Boundary)
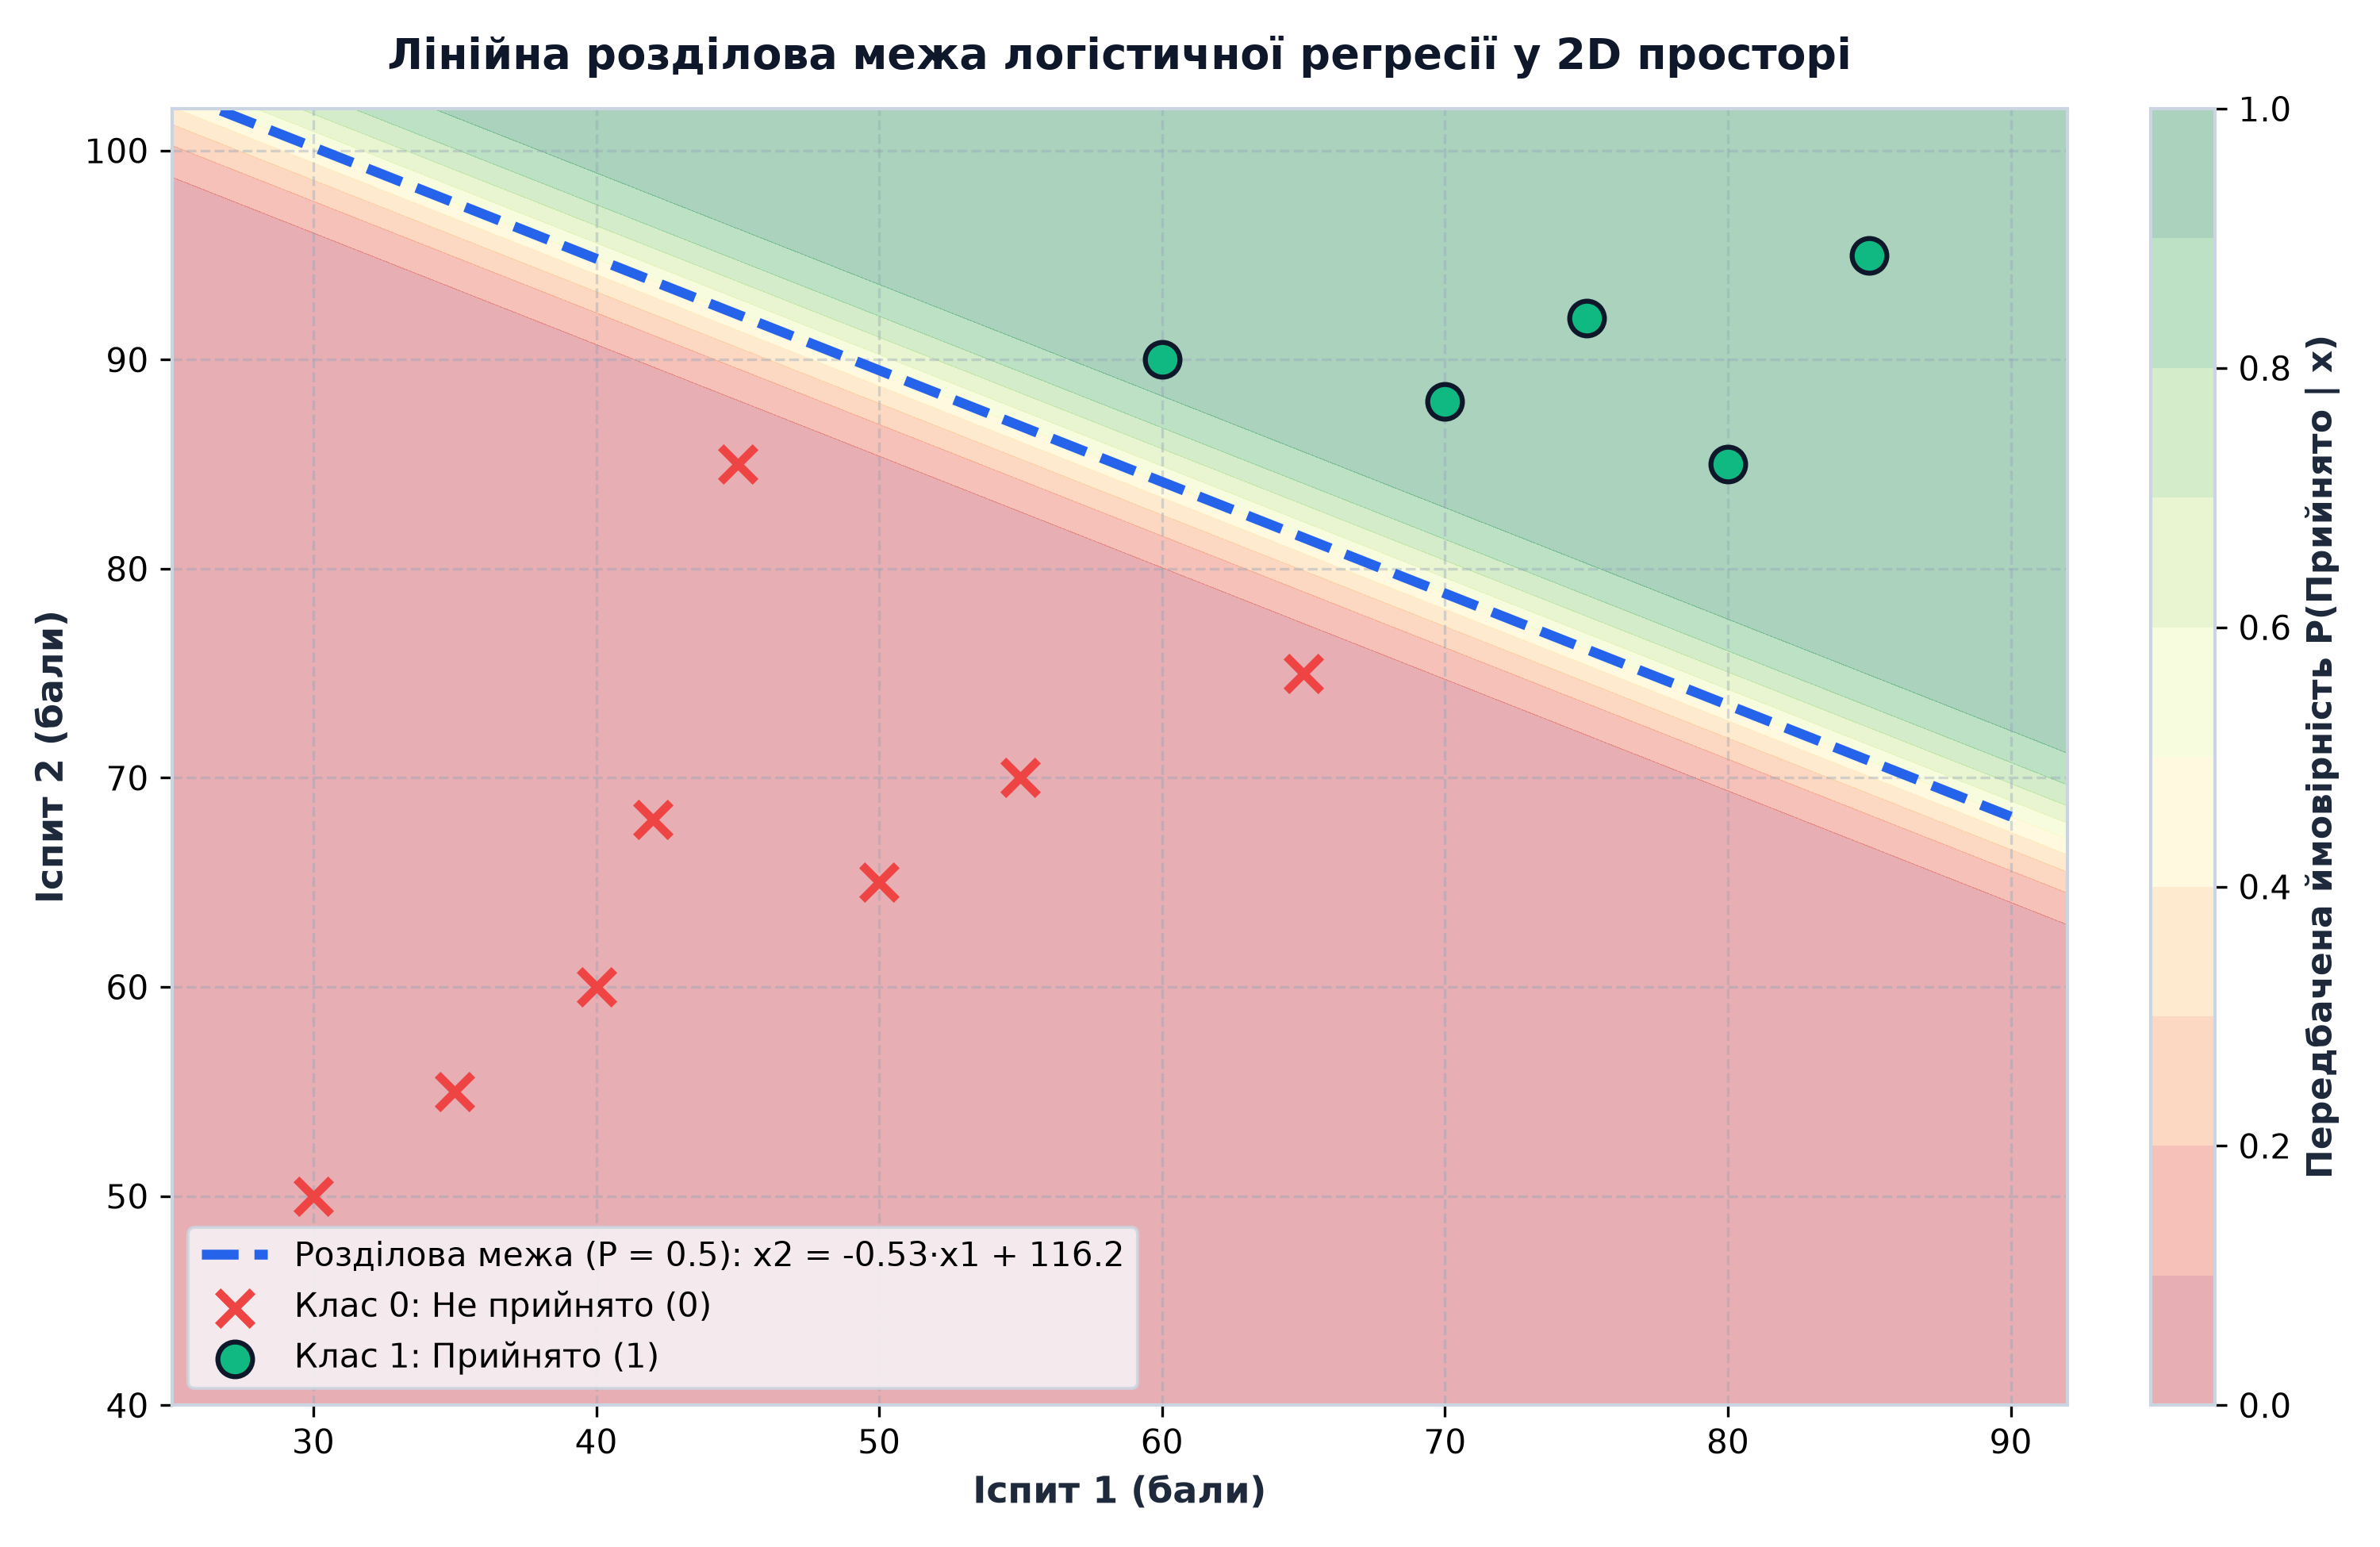
Одна з найважливіших концепцій у класифікації — розділова межа (decision boundary). Це геометричне представлення того, як модель "розрізає" простір ознак на області, що відповідають різним класам.
Математичне визначення
Розділова межа — це множина точок у просторі ознак, де ймовірність належності до класу 1 дорівнює 0.5:
Оскільки Завантаження..., розділова межа визначається рівнянням:
Приклад у двовимірному просторі
Розглянемо задачу класифікації студентів на основі двох іспитів:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression

# Дані: оцінки з двох іспитів та результат (0 = не прийнято, 1 = прийнято)
X_train = np.array([
    [45, 85], [55, 70], [60, 90], [65, 75], [70, 88],
    [75, 92], [80, 85], [85, 95], [30, 50], [40, 60],
    [50, 65], [35, 55], [42, 68]
])
y_train = np.array([0, 0, 1, 0, 1, 1, 1, 1, 0, 0, 0, 0, 0])

# Навчання моделі
model = LogisticRegression()
model.fit(X_train, y_train)

# Отримання параметрів
w1, w2 = model.coef_[0]
b = model.intercept_[0]

print(f"Рівняння розділової межі:")
print(f"{w1:.3f} * x1 + {w2:.3f} * x2 + {b:.3f} = 0")
print(f"\nСпрощено (x2 через x1):")
x2_formula = f"x2 = {-w1/w2:.3f} * x1 + {-b/w2:.3f}"
print(x2_formula)
Рівняння розділової межі:
0.057 * x1 + 0.089 * x2 + -6.421 = 0

Спрощено (x2 через x1):
x2 = -0.641 * x1 + 72.146
# Побудова графіка з розділовою межею
plt.figure(figsize=(10, 7))

# Точки класу 0 (не прийнято)
plt.scatter(X_train[y_train == 0, 0], X_train[y_train == 0, 1],
            c='#ef4444', marker='x', s=100, linewidths=2,
            label='Клас 0 (не прийнято)', alpha=0.8)

# Точки класу 1 (прийнято)
plt.scatter(X_train[y_train == 1, 0], X_train[y_train == 1, 1],
            c='#10b981', marker='o', s=100, linewidths=2,
            label='Клас 1 (прийнято)', alpha=0.8)

# Розділова межа
x1_line = np.linspace(20, 90, 100)
x2_line = -(w1 * x1_line + b) / w2
plt.plot(x1_line, x2_line, 'b--', linewidth=2.5, label='Розділова межа')

# Регіони класів (фон)
xx, yy = np.meshgrid(np.linspace(20, 90, 200), np.linspace(40, 100, 200))
Z = model.predict(np.c_[xx.ravel(), yy.ravel()]).reshape(xx.shape)
plt.contourf(xx, yy, Z, alpha=0.1, levels=[-0.5, 0.5, 1.5],
             colors=['#ef4444', '#10b981'])

plt.xlabel('Іспит 1 (бали)', fontsize=12)
plt.ylabel('Іспит 2 (бали)', fontsize=12)
plt.title('Розділова межа логістичної регресії', fontsize=14)
plt.legend(fontsize=11)
plt.grid(alpha=0.3)
plt.show()
Властивості розділової межі
Вплив параметрів на розділову межу
Параметри моделі Завантаження... (ваги) та Завантаження... (зміщення) повністю визначають положення та орієнтацію розділової межі.
Вплив ваг (w)
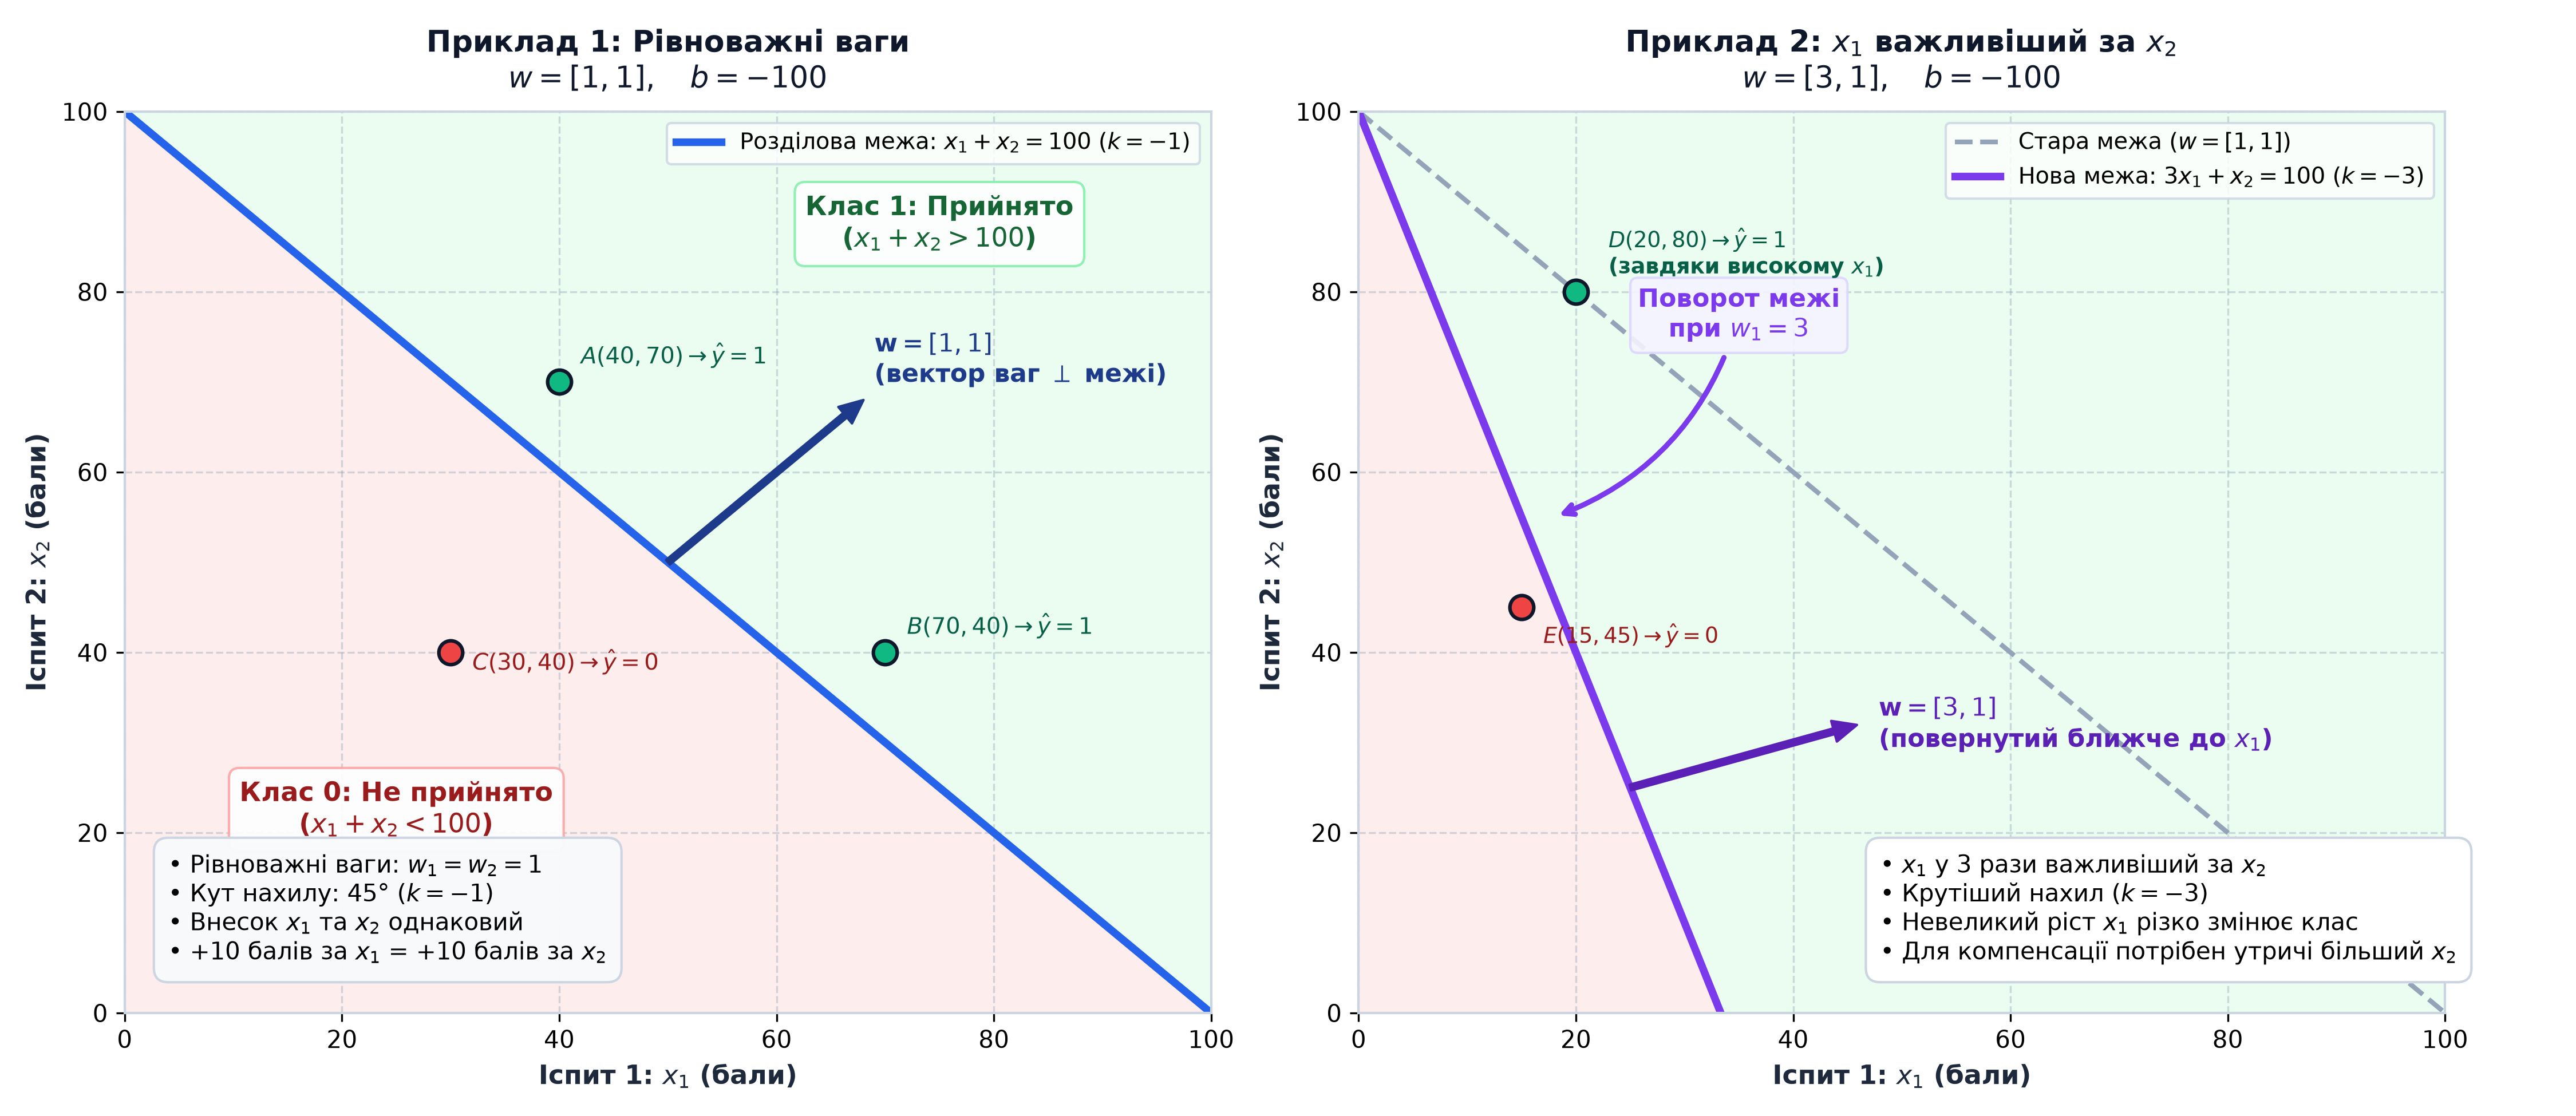
Ваги визначають нахил (кут) розділової межі та важливість кожної ознаки.
# Приклад 1: рівноважні ваги
w = np.array([1, 1])  # x1 та x2 однаково важливі
b = -100

# Рівняння: x1 + x2 = 100
# Це пряма під кутом 45° (нахил -1)

print("Приклад 1: w = [1, 1], b = -100")
print("Розділова межа: x2 = -x1 + 100 (діагональ)")

import matplotlib.pyplot as plt

x1 = np.linspace(0, 100, 100)
x2 = -(w[0] * x1 + b) / w[1]

plt.figure(figsize=(7, 6))
plt.plot(x1, x2, color='#3b82f6', linewidth=2.5, label='x1 + x2 = 100')
plt.fill_between(x1, x2, 100, color='#10b981', alpha=0.12, label='Клас 1')
plt.fill_between(x1, 0, x2, color='#ef4444', alpha=0.12, label='Клас 0')
plt.xlim(0, 100); plt.ylim(0, 100)
plt.xlabel('x1'); plt.ylabel('x2')
plt.title('w = [1, 1], b = -100: діагональна межа (45°)', fontsize=13)
plt.legend(); plt.grid(alpha=0.3)
plt.show()
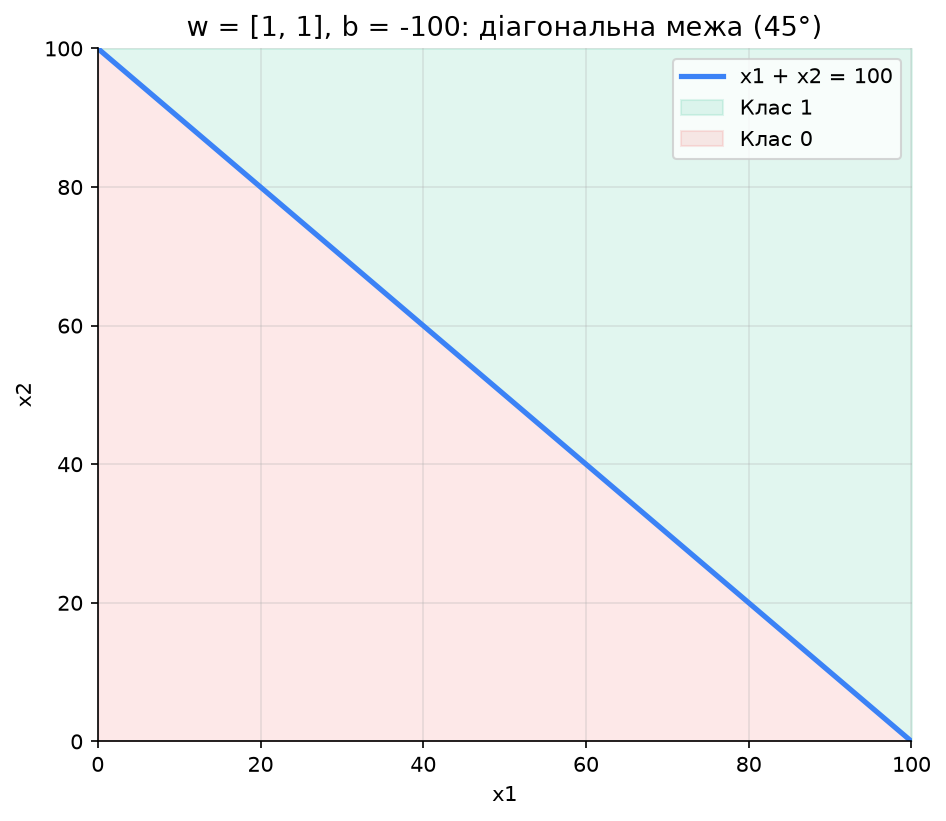
Приклад 1: w = [1, 1], b = -100
Розділова межа: x2 = -x1 + 100 (діагональ)
# Приклад 2: x1 важливіший за x2
w = np.array([3, 1])
b = -100

# Рівняння: 3*x1 + x2 = 100
# x2 = -3*x1 + 100 (крутіший нахил)

print("\nПриклад 2: w = [3, 1], b = -100")
print("Розділова межа: x2 = -3*x1 + 100 (більше залежить від x1)")
print("Інтерпретація: x1 в 3 рази важливіша за x2")

import matplotlib.pyplot as plt

x1 = np.linspace(0, 100, 200)

plt.figure(figsize=(7, 6))
plt.plot(x1, -(1 * x1 - 100) / 1, color='#3b82f6', linewidth=2.5, label='w = [1, 1]: x2 = -x1 + 100')
plt.plot(x1, -(3 * x1 - 100) / 1, color='#ef4444', linewidth=2.5, label='w = [3, 1]: x2 = -3·x1 + 100')
plt.xlim(0, 100); plt.ylim(0, 100)
plt.xlabel('x1'); plt.ylabel('x2')
plt.title('Більша вага x1 робить межу крутішою', fontsize=13)
plt.legend(); plt.grid(alpha=0.3)
plt.show()
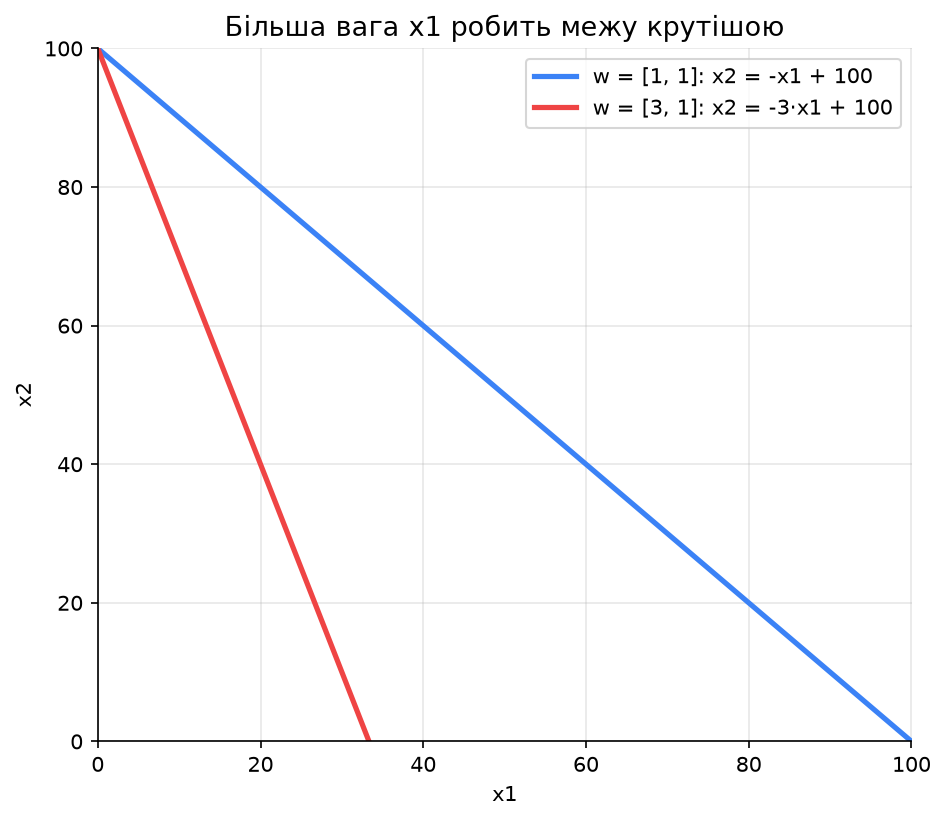
Приклад 2: w = [3, 1], b = -100
Розділова межа: x2 = -3*x1 + 100 (більше залежить від x1)
Інтерпретація: x1 в 3 рази важливіша за x2
Вплив зміщення (bias)
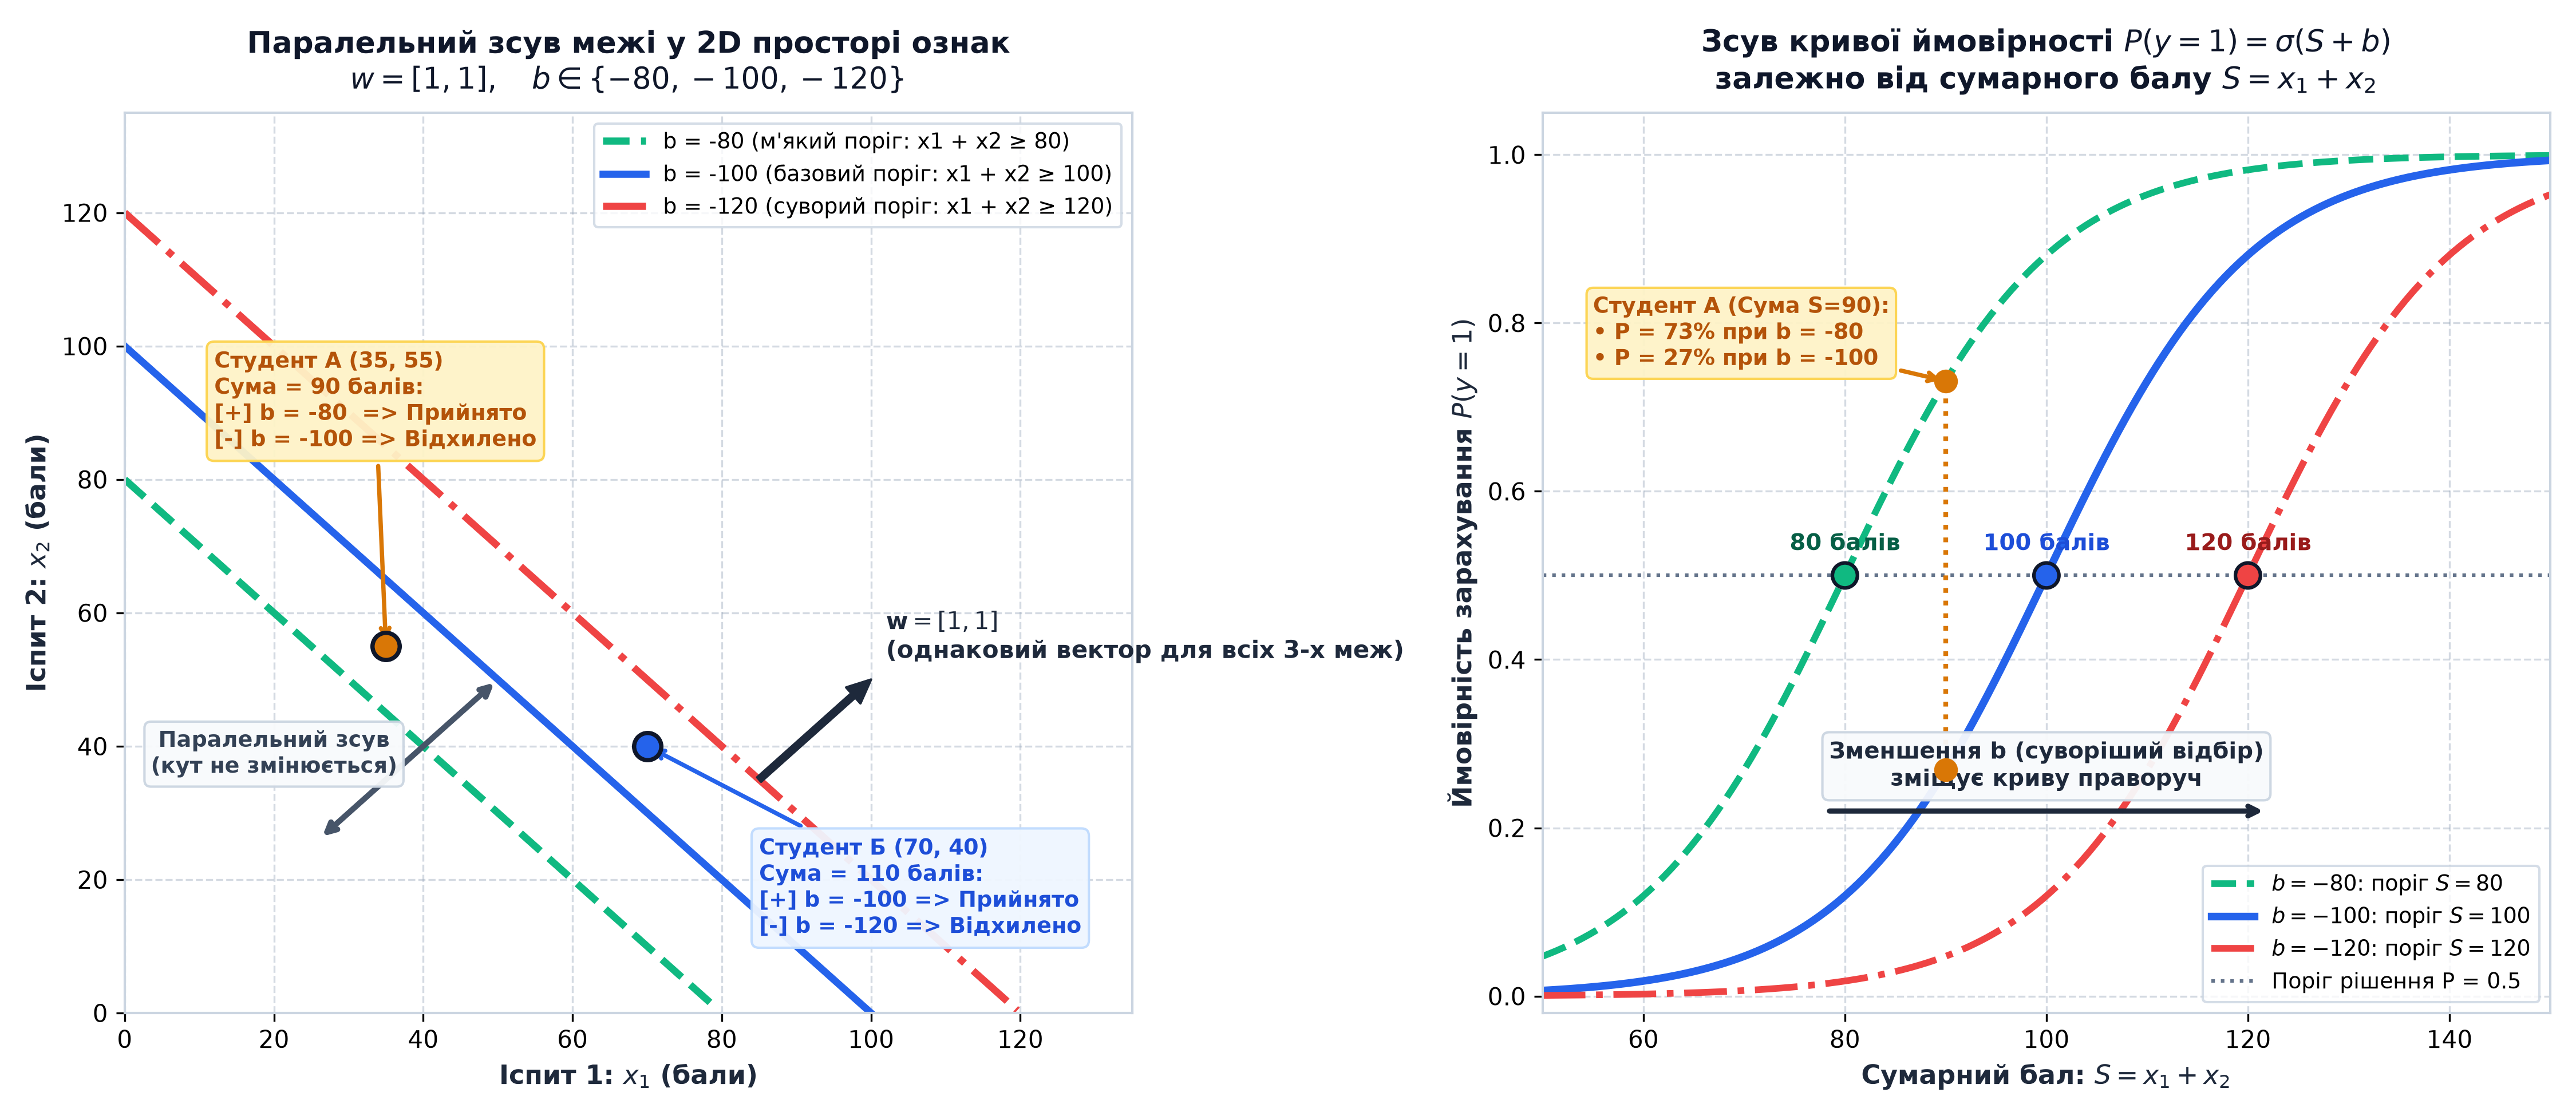
Bias Завантаження... зміщує розділову межу паралельно сама собі, не змінюючи її нахилу.
# Фіксуємо ваги, змінюємо bias
w = np.array([1, 1])

# Три різні bias
biases = [-80, -100, -120]

for b in biases:
    # x1 + x2 + b = 0  =>  x2 = -x1 - b
    print(f"b = {b:4d}  =>  x2 = -x1 + {-b} (пряма проходить через точку (0, {-b}))")

import matplotlib.pyplot as plt

x1 = np.linspace(0, 130, 200)
colors = ['#10b981', '#3b82f6', '#ef4444']

plt.figure(figsize=(7, 6))
for b, c in zip(biases, colors):
    plt.plot(x1, -x1 - b, color=c, linewidth=2.5, label=f'b = {b}')
plt.xlim(0, 130); plt.ylim(0, 130)
plt.xlabel('x1'); plt.ylabel('x2')
plt.title('Зміна bias зсуває межу паралельно', fontsize=13)
plt.legend(); plt.grid(alpha=0.3)
plt.show()
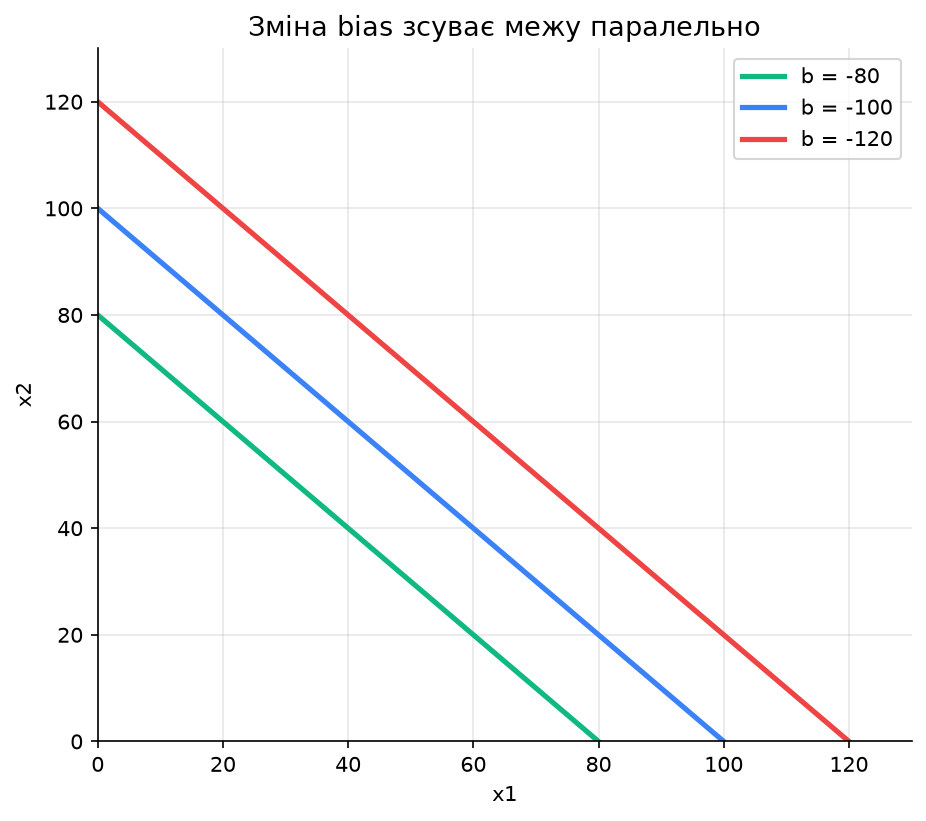
b =  -80  =>  x2 = -x1 + 80 (пряма проходить через точку (0, 80))
b = -100  =>  x2 = -x1 + 100 (пряма проходить через точку (0, 100))
b = -120  =>  x2 = -x1 + 120 (пряма проходить через точку (0, 120))
Нелінійні розділові межі: обмеження логістичної регресії
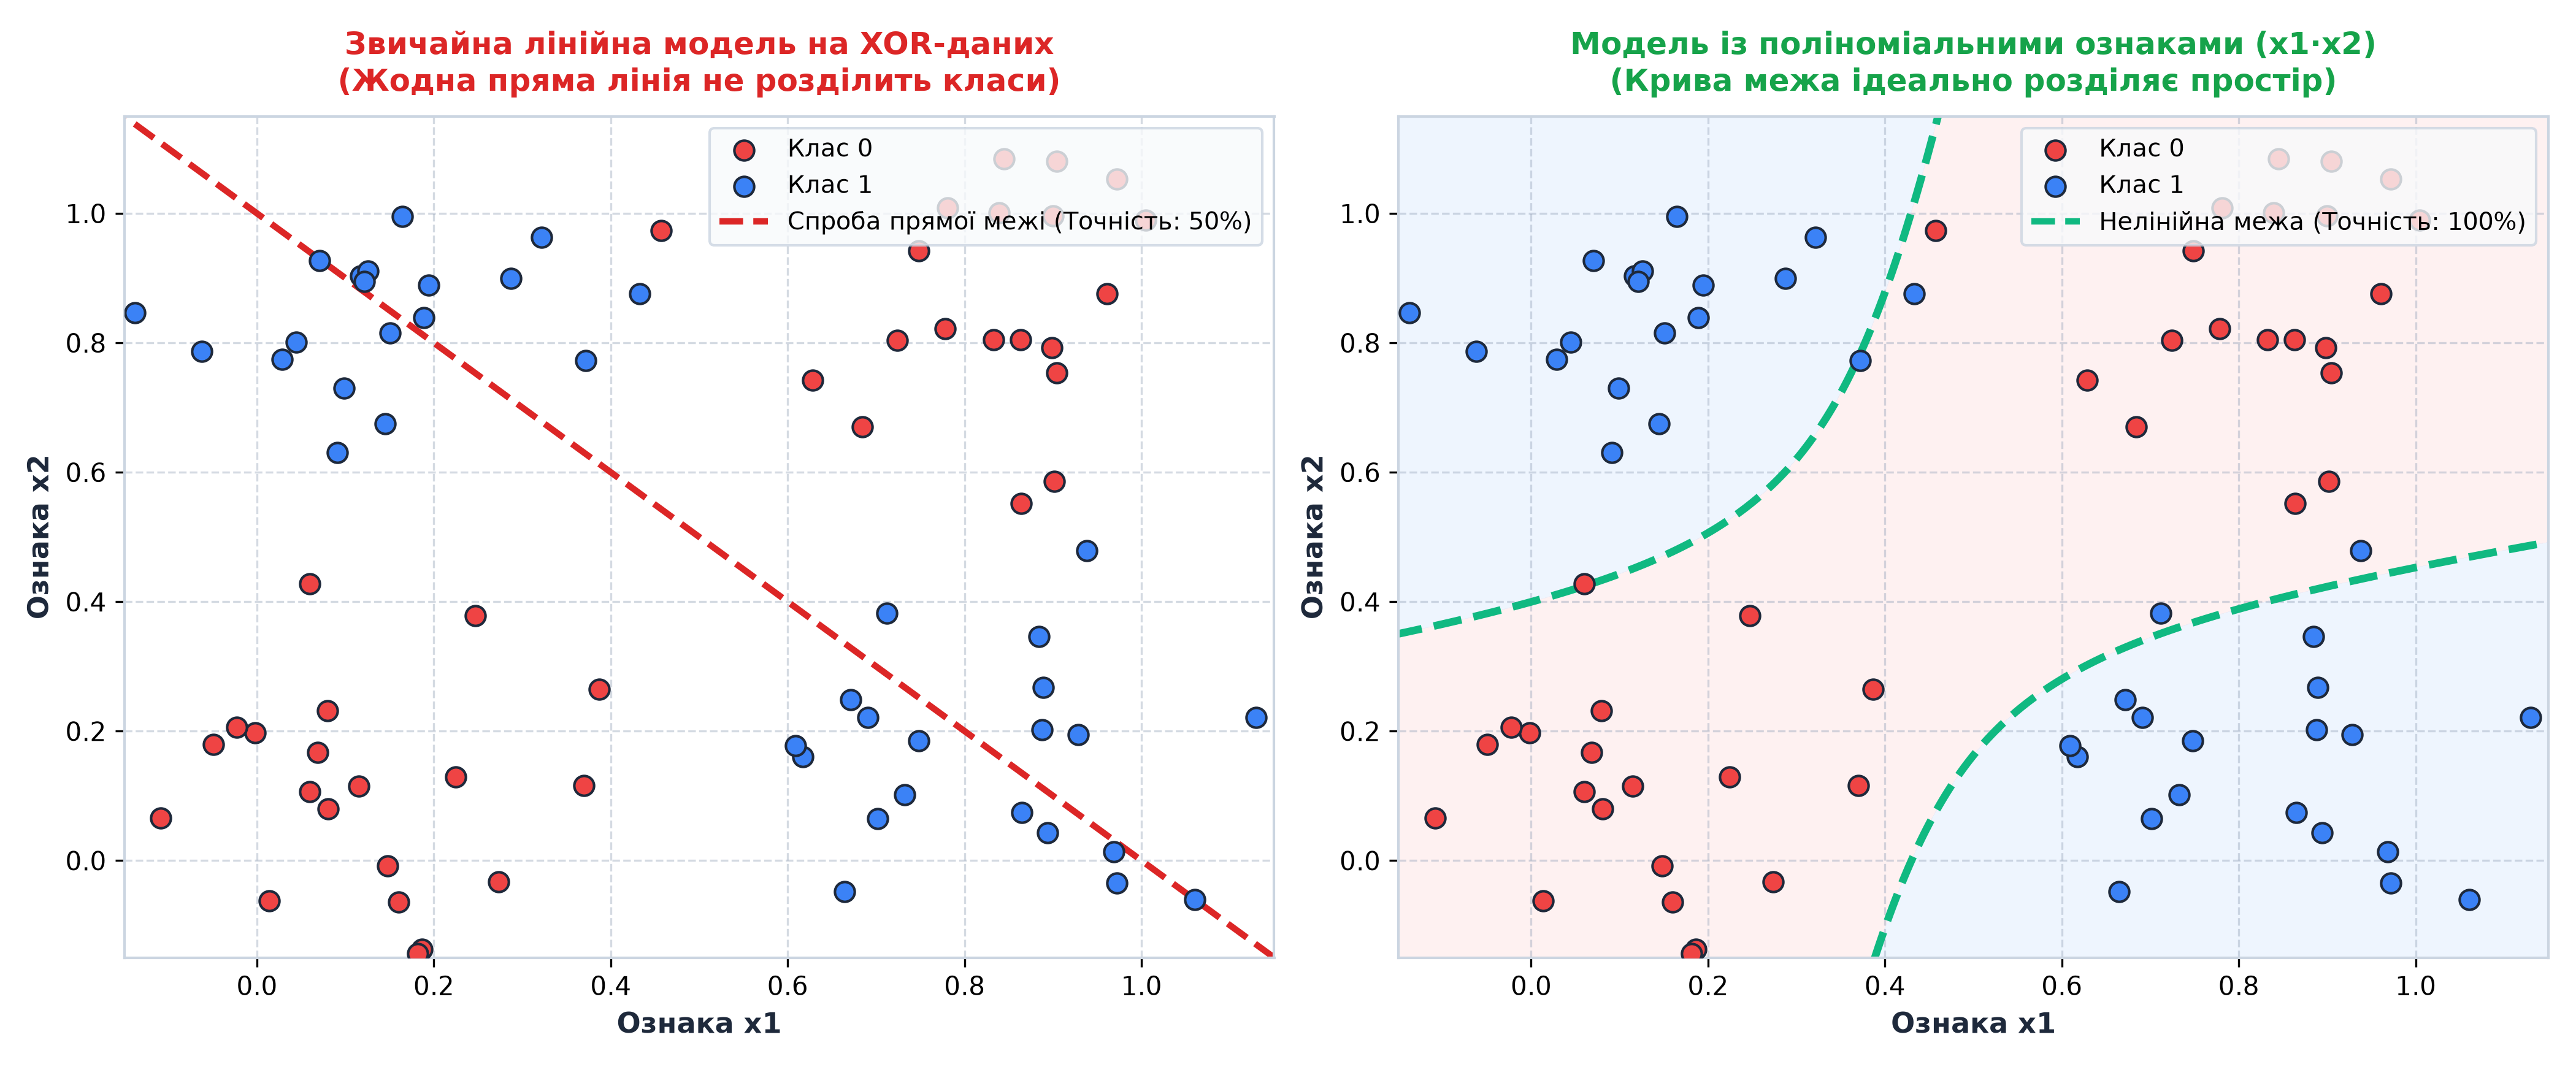
Базова логістична регресія може будувати лише лінійні розділові межі. Для складних паттернів, де класи розділені кривою, колом чи іншою нелінійною формою, потрібні розширення.
Приклад: XOR-задача
Розглянемо класичну задачу XOR (виключне АБО):
# Дані XOR: клас 1 у протилежних кутах квадрата
X_xor = np.array([
    [0, 0],  # клас 0
    [0, 1],  # клас 1
    [1, 0],  # клас 1
    [1, 1]   # клас 0
])
y_xor = np.array([0, 1, 1, 0])

# Спроба навчити звичайну логістичну регресію
model_linear = LogisticRegression()
model_linear.fit(X_xor, y_xor)

accuracy = model_linear.score(X_xor, y_xor)
print(f"Точність лінійної моделі на XOR: {accuracy:.0%}")
print("Проблема: жодна пряма лінія не може розділити ці точки!")

import matplotlib.pyplot as plt

xx, yy = np.meshgrid(np.linspace(-0.5, 1.5, 300), np.linspace(-0.5, 1.5, 300))
Z = model_linear.predict_proba(np.c_[xx.ravel(), yy.ravel()])[:, 1].reshape(xx.shape)

plt.figure(figsize=(7, 6))
plt.contourf(xx, yy, Z, levels=20, cmap='RdYlGn', alpha=0.35)
plt.contour(xx, yy, Z, levels=[0.5], colors='#1f2937', linewidths=2.5, linestyles='--')
plt.scatter(X_xor[y_xor == 0, 0], X_xor[y_xor == 0, 1], c='#ef4444', marker='x', s=200, linewidths=3, label='Клас 0')
plt.scatter(X_xor[y_xor == 1, 0], X_xor[y_xor == 1, 1], c='#10b981', marker='o', s=200, edgecolor='white', label='Клас 1')
plt.xlabel('x1'); plt.ylabel('x2')
plt.title(f'XOR: лінійна модель, точність {accuracy:.0%}', fontsize=13)
plt.legend(); plt.grid(alpha=0.3)
plt.show()
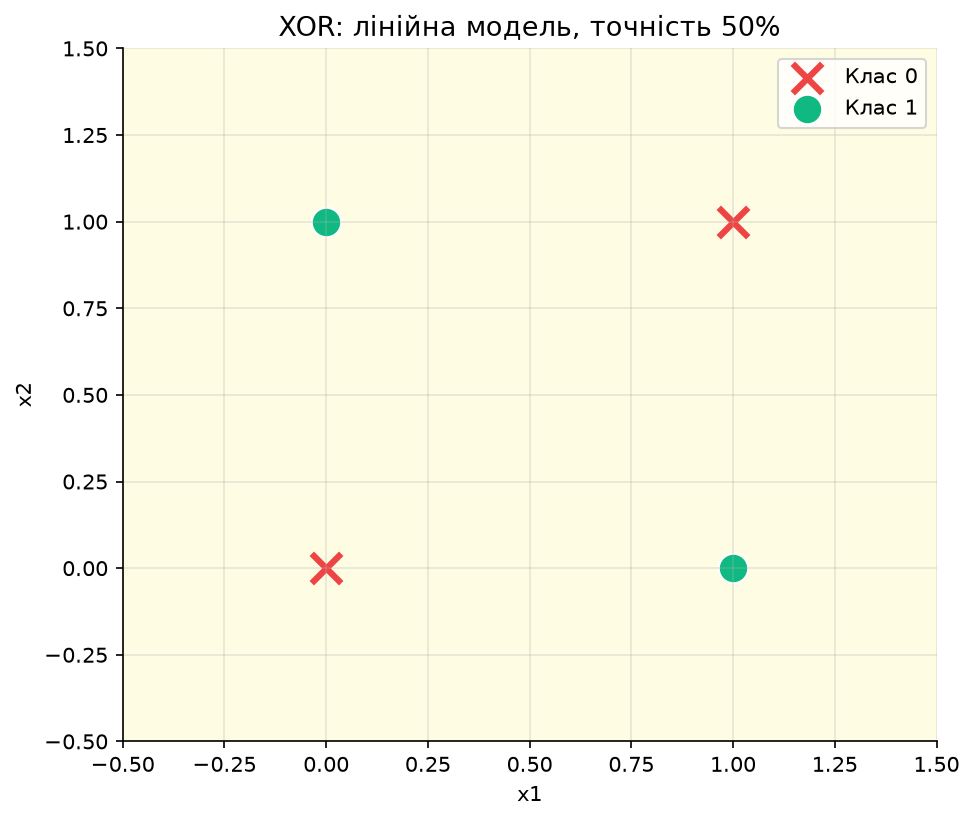
Точність лінійної моделі на XOR: 50%
Проблема: жодна пряма лінія не може розділити ці точки!
Рішення: поліноміальні ознаки
Щоб розв'язати нелінійні задачі, можна штучно створити нелінійні ознаки — квадрати, добутки, степені вихідних змінних.
from sklearn.preprocessing import PolynomialFeatures

# Створюємо поліноміальні ознаки (квадрати та добутки)
poly = PolynomialFeatures(degree=2, include_bias=False)
X_poly = poly.fit_transform(X_xor)

print("Вихідні ознаки:")
print(X_xor)
print("\nПісля перетворення (x1, x2, x1², x1*x2, x2²):")
print(X_poly)
Вихідні ознаки:
[[0 0]
 [0 1]
 [1 0]
 [1 1]]

Після перетворення (x1, x2, x1², x1*x2, x2²):
[[0. 0. 0. 0. 0.]
 [0. 1. 0. 0. 1.]
 [1. 0. 1. 0. 0.]
 [1. 1. 1. 1. 1.]]
# Навчання моделі на поліноміальних ознаках
# C=100 — слабка регуляризація, бо даних лише 4 точки
model_poly = LogisticRegression(C=100)
model_poly.fit(X_poly, y_xor)

accuracy_poly = model_poly.score(X_poly, y_xor)
print(f"Точність моделі з поліноміальними ознаками: {accuracy_poly:.0%}")
print("Успіх! Тепер розділова межа — це крива, а не пряма.")

import matplotlib.pyplot as plt

xx, yy = np.meshgrid(np.linspace(-0.5, 1.5, 300), np.linspace(-0.5, 1.5, 300))
grid_poly = poly.transform(np.c_[xx.ravel(), yy.ravel()])
Z = model_poly.predict_proba(grid_poly)[:, 1].reshape(xx.shape)

plt.figure(figsize=(7, 6))
plt.contourf(xx, yy, Z, levels=20, cmap='RdYlGn', alpha=0.35)
plt.contour(xx, yy, Z, levels=[0.5], colors='#1f2937', linewidths=2.5, linestyles='--')
plt.scatter(X_xor[y_xor == 0, 0], X_xor[y_xor == 0, 1], c='#ef4444', marker='x', s=200, linewidths=3, label='Клас 0')
plt.scatter(X_xor[y_xor == 1, 0], X_xor[y_xor == 1, 1], c='#10b981', marker='o', s=200, edgecolor='white', label='Клас 1')
plt.xlabel('x1'); plt.ylabel('x2')
plt.title(f'XOR: поліноміальні ознаки, точність {accuracy_poly:.0%}', fontsize=13)
plt.legend(); plt.grid(alpha=0.3)
plt.show()
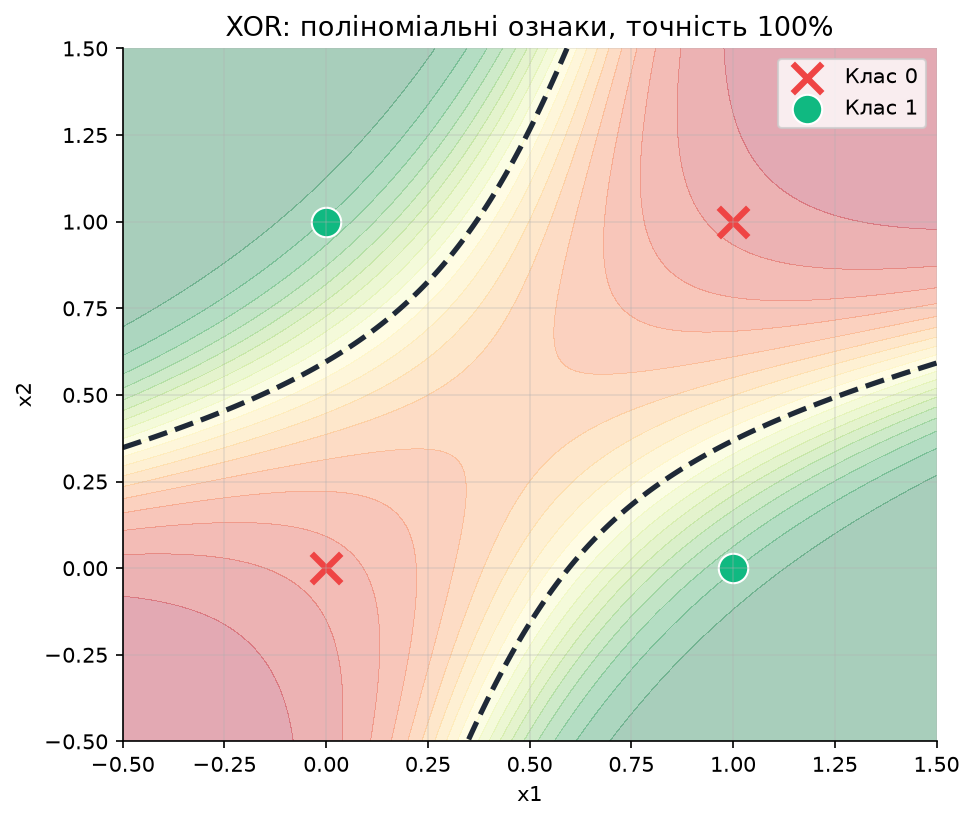
Точність моделі з поліноміальними ознаками: 100%
Успіх! Тепер розділова межа — це крива, а не пряма.
- Додати поліноміальні ознаки (степені 2 або 3)
- Використати ядрові методи (SVM з RBF ядром)
- Перейти до нелінійних моделей (дерева рішень, нейронні мережі)
Поріг прийняття рішень (Decision Threshold)
За замовчуванням, логістична регресія використовує поріг 0.5: якщо Завантаження..., прогнозується клас 1. Але цей поріг можна налаштувати під специфіку задачі.
Чому важливий вибір порогу?
У різних задачах помилки класифікації мають різну ціну:
🏥 Медична діагностика
False Negative (пропустили хвороби) — дуже небезпечно! Пацієнт не отримає лікування.
False Positive (хибна тривога) — менш критично, додаткові обстеження.
Рішення: знизити поріг до 0.3, щоб виявити більше потенційних хворих.
🛡️ Детекція спаму
False Positive (важливий лист у спам) — дуже погано! Користувач пропустить важливу інформацію.
False Negative (спам у вхідних) — менш критично, трохи дратує.
Рішення: підвищити поріг до 0.7, щоб бути впевненим перед блокуванням листа.
Зміна порогу у коді
from sklearn.linear_model import LogisticRegression
import numpy as np

# Припустимо, модель вже навчена
# model = LogisticRegression()
# model.fit(X_train, y_train)

# Отримуємо ймовірності для тестової вибірки
X_test = np.array([[50, 75], [70, 90], [40, 60]])
y_probs = model.predict_proba(X_test)[:, 1]  # Ймовірність класу 1

print("Ймовірності класу 1:")
print(y_probs)

import matplotlib.pyplot as plt

labels = [f'Об\'єкт {i + 1}' for i in range(len(y_probs))]

plt.figure(figsize=(9, 5))
plt.bar(labels, y_probs, color='#3b82f6', alpha=0.85, width=0.5)
for t, c in zip([0.3, 0.5, 0.7], ['#10b981', '#1f2937', '#ef4444']):
    plt.axhline(t, color=c, linestyle='--', linewidth=2, label=f'Поріг {t}')
for i, p in enumerate(y_probs):
    plt.text(i, p + 0.02, f'{p:.2f}', ha='center', fontsize=12)
plt.ylim(0, 1)
plt.ylabel('P(y = 1)')
plt.title('Той самий об\'єкт — різні рішення при різних порогах', fontsize=13)
plt.legend()
plt.show()
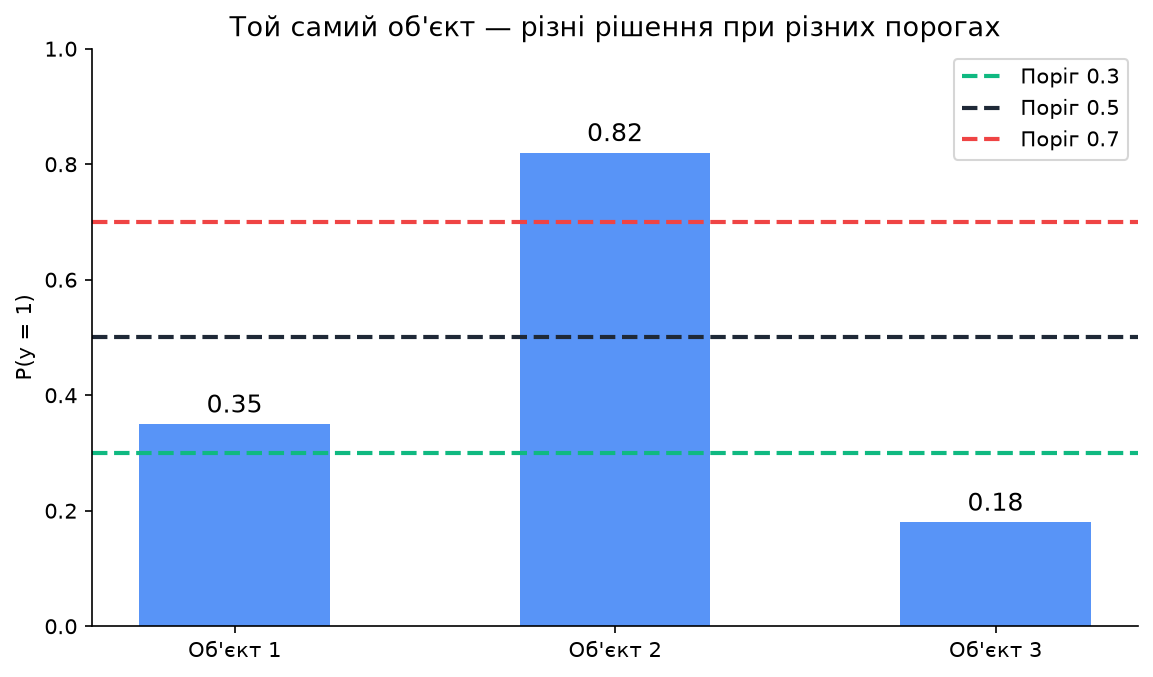
Ймовірності класу 1:
[0.35 0.82 0.18]
# Застосування різних порогів
thresholds = [0.3, 0.5, 0.7]

for threshold in thresholds:
    y_pred = (y_probs >= threshold).astype(int)
    print(f"\nПоріг {threshold}: прогнози = {y_pred}")
Поріг 0.3: прогнози = [1 1 0]
Поріг 0.5: прогнози = [0 1 0]
Поріг 0.7: прогнози = [0 1 0]
- Низький поріг (0.3) → модель стає більш "обережною", частіше прогнозує клас 1 (висока повнота, recall)
- Високий поріг (0.7) → модель стає більш "консервативною", рідше прогнозує клас 1 (висока точність, precision)
Багатокласова логістична регресія (Multiclass)
Базова логістична регресія призначена для бінарної класифікації (2 класи). Для задач з 3+ класами використовують розширення.
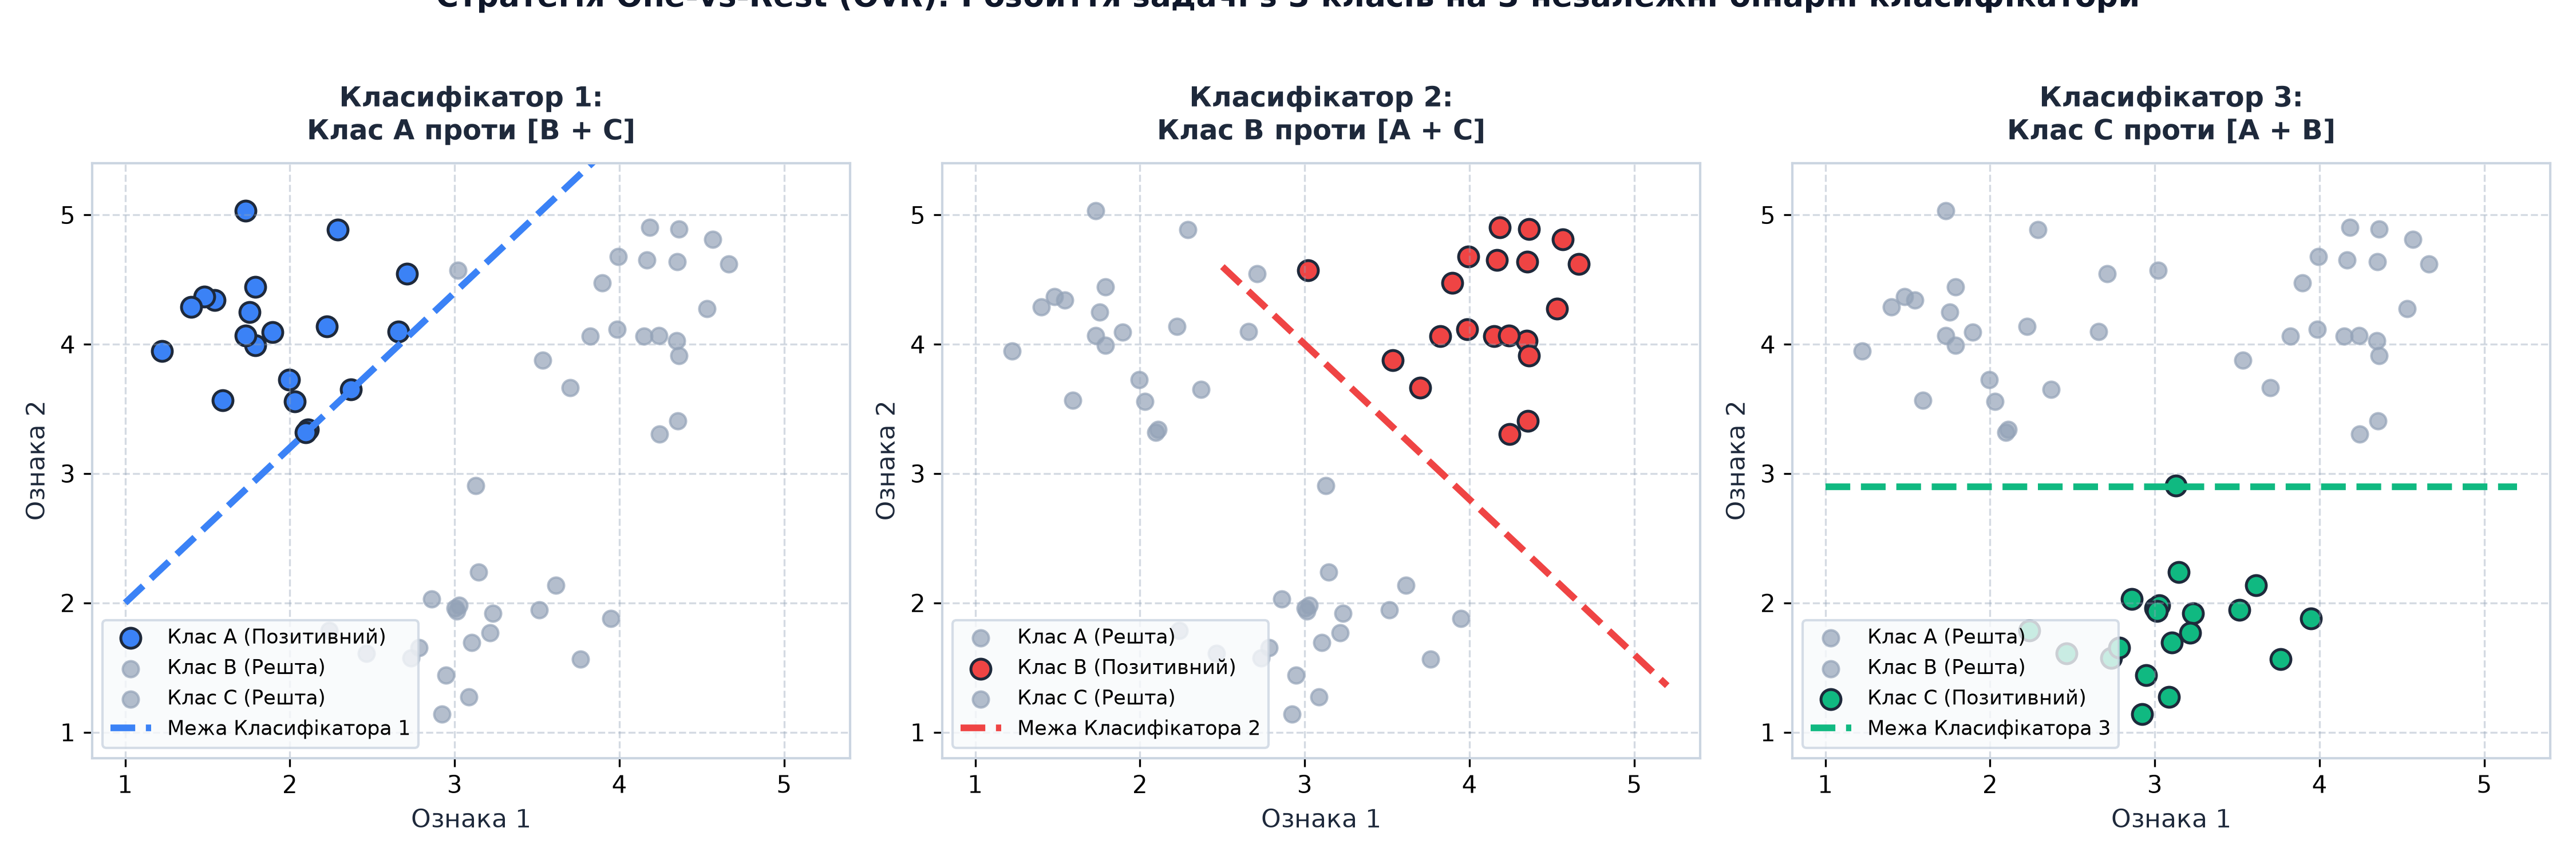
Стратегія "Один проти всіх" (One-vs-Rest)
Ідея: навчити Завантаження... окремих бінарних класифікаторів (де Завантаження... — кількість класів). Кожен класифікатор відповідає на питання: "Чи належить об'єкт до класу Завантаження...?"
from sklearn.datasets import load_iris
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split

# Завантаження датасету Iris
iris = load_iris()
X, y = iris.data, iris.target

# Розбиття на навчальну та тестову вибірки
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42
)

# Навчання моделі з multi_class='ovr'
model_ovr = LogisticRegression(multi_class='ovr', max_iter=200)
model_ovr.fit(X_train, y_train)

accuracy = model_ovr.score(X_test, y_test)
print(f"Точність на тестовій вибірці: {accuracy:.1%}")
print(f"\nМодель навчила {len(model_ovr.coef_)} бінарних класифікаторів")
print(f"Форма матриці ваг: {model_ovr.coef_.shape}")
Точність на тестовій вибірці: 97.8%

Модель навчила 3 бінарних класифікаторів
Форма матриці ваг: (3, 4)
# Прогноз для одного об'єкта
sample = X_test[0:1]
probs = model_ovr.predict_proba(sample)[0]

print("Ймовірності для кожного класу:")
for i, (class_name, prob) in enumerate(zip(iris.target_names, probs)):
    print(f"  Клас {i} ({class_name:10s}): {prob:.1%}")

predicted_class = model_ovr.predict(sample)[0]
print(f"\nПрогноз: клас {predicted_class} ({iris.target_names[predicted_class]})")

import matplotlib.pyplot as plt

colors = ['#ef4444', '#3b82f6', '#10b981']

plt.figure(figsize=(8, 5))
bars = plt.bar(iris.target_names, probs, color=colors, alpha=0.85)
for bar, p in zip(bars, probs):
    plt.text(bar.get_x() + bar.get_width() / 2, p + 0.02, f'{p:.1%}', ha='center', fontsize=12)
plt.ylim(0, 1.1)
plt.ylabel('Ймовірність')
plt.title(f'Прогноз: {iris.target_names[predicted_class]}', fontsize=13)
plt.show()
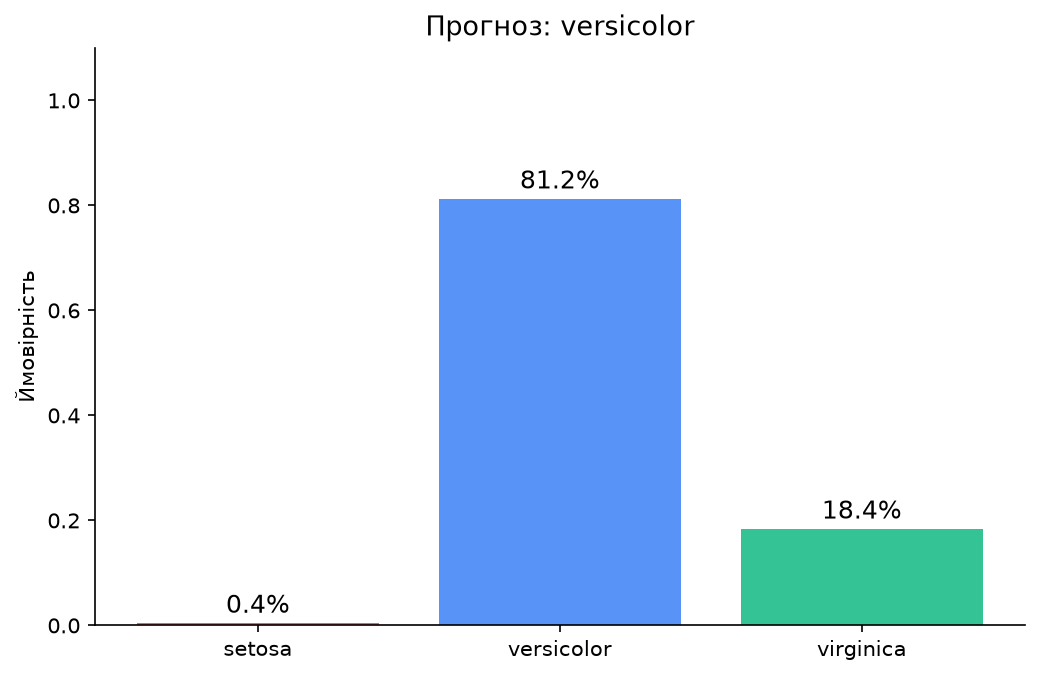
Ймовірності для кожного класу:
  Клас 0 (setosa    ): 0.1%
  Клас 1 (versicolor): 95.3%
  Клас 2 (virginica ): 4.6%

Прогноз: клас 1 (versicolor)
Стратегія "Мультиноміальна" (Softmax)
Ідея: навчити одну модель, яка одразу обчислює ймовірності для всіх класів через softmax-функцію.
Де Завантаження... — лінійна комбінація для класу Завантаження....
# Навчання моделі з multi_class='multinomial'
model_softmax = LogisticRegression(multi_class='multinomial', max_iter=200)
model_softmax.fit(X_train, y_train)

accuracy_softmax = model_softmax.score(X_test, y_test)
print(f"Точність (softmax): {accuracy_softmax:.1%}")

import matplotlib.pyplot as plt
from matplotlib.colors import ListedColormap

# Для 2D-візуалізації навчаємо softmax лише на ознаках пелюстки
model_2d = LogisticRegression(max_iter=200)
model_2d.fit(X_train[:, 2:], y_train)

xx, yy = np.meshgrid(np.linspace(0.5, 7.5, 300), np.linspace(-0.2, 2.8, 300))
Z = model_2d.predict(np.c_[xx.ravel(), yy.ravel()]).reshape(xx.shape)
colors = ['#ef4444', '#3b82f6', '#10b981']

plt.figure(figsize=(9, 6))
plt.contourf(xx, yy, Z, alpha=0.2, cmap=ListedColormap(colors))
for k, name in enumerate(iris.target_names):
    plt.scatter(X_train[y_train == k, 2], X_train[y_train == k, 3], c=colors[k],
                s=50, edgecolor='white', label=name)
plt.xlabel('Довжина пелюстки (см)', fontsize=12)
plt.ylabel('Ширина пелюстки (см)', fontsize=12)
plt.title('Softmax: три лінійні області рішень', fontsize=14)
plt.legend()
plt.show()
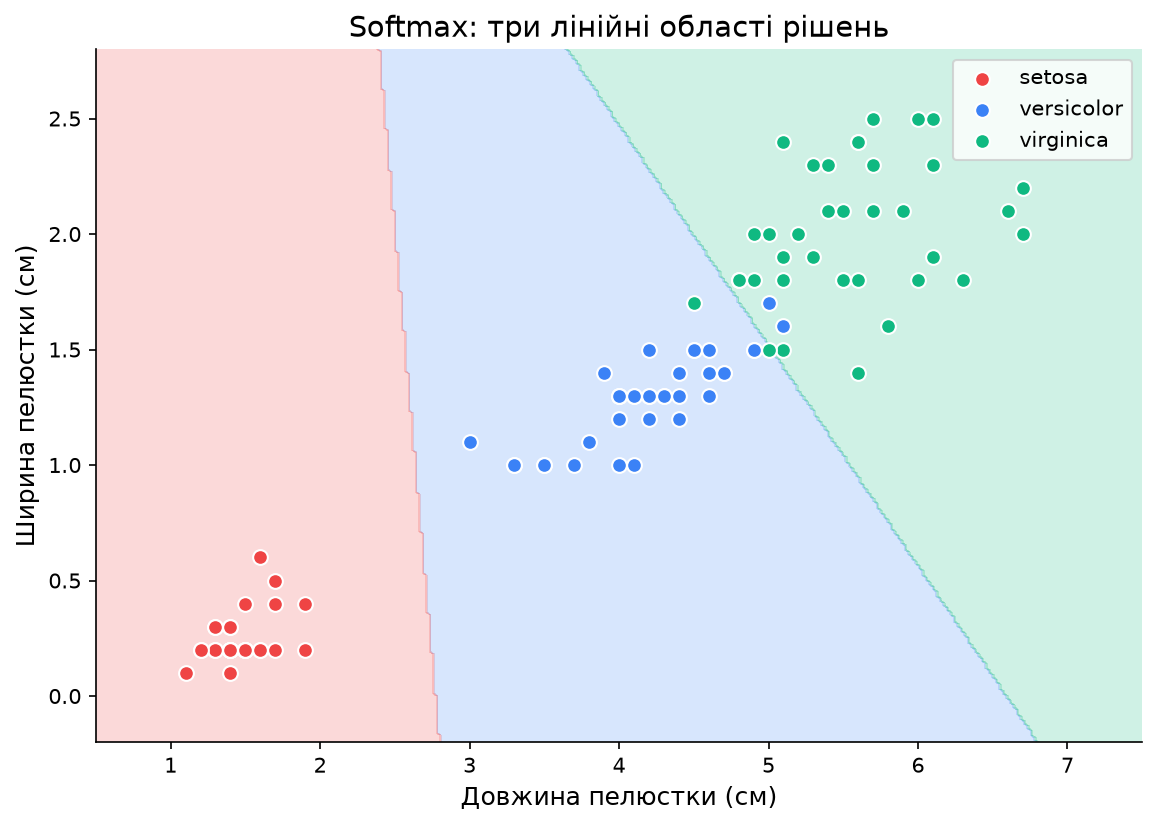
Точність (softmax): 100.0%
- One-vs-Rest: простіша, швидша для великої кількості класів (>10)
- Multinomial (Softmax): часто точніша, природніша для багатокласових задач, краще калібровані ймовірності
Резюме другої частини
📌 Розділова межа
📌 Вплив параметрів
📌 Нелінійні задачі
📌 Поріг рішення
📌 Багатокласова класифікація
Практичний приклад: передбачення ризику серцевих захворювань
Розглянемо реальну медичну задачу: на основі характеристик пацієнта передбачити, чи є у нього підвищений ризик хвороби серця.
Опис датасету
Припустимо, у нас є дані про 300 пацієнтів з такими ознаками:
| Ознака | Опис | Одиниці |
|---|---|---|
age | Вік пацієнта | роки |
cholesterol | Рівень холестерину | мг/дл |
blood_pressure | Артеріальний тиск (систолічний) | мм рт.ст. |
bmi | Індекс маси тіла | кг/м² |
smoking | Чи палить (1 = так, 0 = ні) | бінарна |
disease | Чи є хвороба серця (0 = ні, 1 = так) | цільова змінна |
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report

# Генерація синтетичних даних (імітація реального датасету)
rng = np.random.default_rng(seed=42)

n_samples = 300
age = rng.integers(30, 80, size=n_samples)
cholesterol = rng.integers(150, 300, size=n_samples)
blood_pressure = rng.integers(90, 180, size=n_samples)
bmi = rng.uniform(18, 40, size=n_samples)
smoking = rng.choice([0, 1], size=n_samples, p=[0.7, 0.3])

# Цільова змінна: ймовірність хвороби зростає з віком, холестерином, тиском
risk_score = (
    0.05 * age +
    0.01 * cholesterol +
    0.02 * blood_pressure +
    0.3 * bmi +
    5 * smoking - 12
)
disease = (risk_score + rng.normal(0, 5, n_samples) > 0).astype(int)

# Створення DataFrame
df = pd.DataFrame({
    'age': age,
    'cholesterol': cholesterol,
    'blood_pressure': blood_pressure,
    'bmi': bmi,
    'smoking': smoking,
    'disease': disease
})

print(df.head(10))
print(f"\nРозподіл класів:")
print(df['disease'].value_counts())
| age | cholesterol | blood_pressure | bmi | smoking | disease | |
|---|---|---|---|---|---|---|
| 0 | 60 | 233 | 148 | 28.95 | 0 | 1 |
| 1 | 45 | 198 | 122 | 24.12 | 1 | 1 |
| 2 | 72 | 265 | 165 | 31.78 | 0 | 1 |
| 3 | 38 | 187 | 105 | 22.45 | 0 | 0 |
| 4 | 55 | 221 | 138 | 27.33 | 1 | 1 |
Розподіл класів: disease 0 151 1 149
# Розділення на ознаки (X) та цільову змінну (y)
X = df.drop('disease', axis=1)
y = df['disease']

# Розбиття на навчальну та тестову вибірки (70% / 30%)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42, stratify=y
)

print(f"Розмір навчальної вибірки: {X_train.shape}")
print(f"Розмір тестової вибірки: {X_test.shape}")
print(f"\nРозподіл у навчальній вибірці:")
print(y_train.value_counts())
Розмір навчальної вибірки: (210, 5)
Розмір тестової вибірки: (90, 5)

Розподіл у навчальній вибірці:
disease
0    106
1    104
# Стандартизація ознак (важливо для логістичної регресії!)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

print("Середні значення до масштабування:")
print(X_train.mean())
print("\nСередні значення після масштабування:")
print(pd.DataFrame(X_train_scaled, columns=X_train.columns).mean())
Середні значення до масштабування:
age                54.419048
cholesterol       224.152381
blood_pressure    134.442857
bmi                29.156190
smoking             0.304762

Середні значення після масштабування:
age               -0.000000
cholesterol        0.000000
blood_pressure    -0.000000
bmi                0.000000
smoking           -0.000000
Навчання моделі
# Створення та навчання моделі
model = LogisticRegression(random_state=42, max_iter=1000)
model.fit(X_train_scaled, y_train)

# Прогнози на тестовій вибірці
y_pred = model.predict(X_test_scaled)
y_probs = model.predict_proba(X_test_scaled)[:, 1]

# Оцінка точності
accuracy = accuracy_score(y_test, y_pred)
print(f"Точність на тестовій вибірці: {accuracy:.1%}")
Точність на тестовій вибірці: 85.6%
# Отримання коефіцієнтів (ваг)
coef_df = pd.DataFrame({
    'Ознака': X.columns,
    'Коефіцієнт': model.coef_[0],
    'Абсолютне значення': np.abs(model.coef_[0])
}).sort_values('Абсолютне значення', ascending=False)

print("Важливість ознак (за абсолютним коефіцієнтом):")
print(coef_df)
print(f"\nВільний член (bias): {model.intercept_[0]:.4f}")

import matplotlib.pyplot as plt

plt.figure(figsize=(9, 5))
plt.barh(coef_df['Ознака'][::-1], coef_df['Коефіцієнт'][::-1], color='#3b82f6')
plt.axvline(0, color='#1f2937', linewidth=1)
plt.xlabel('Коефіцієнт (ознаки стандартизовані)')
plt.title('Вплив ознак на ризик хвороби серця', fontsize=13)
plt.grid(axis='x', alpha=0.3)
plt.show()
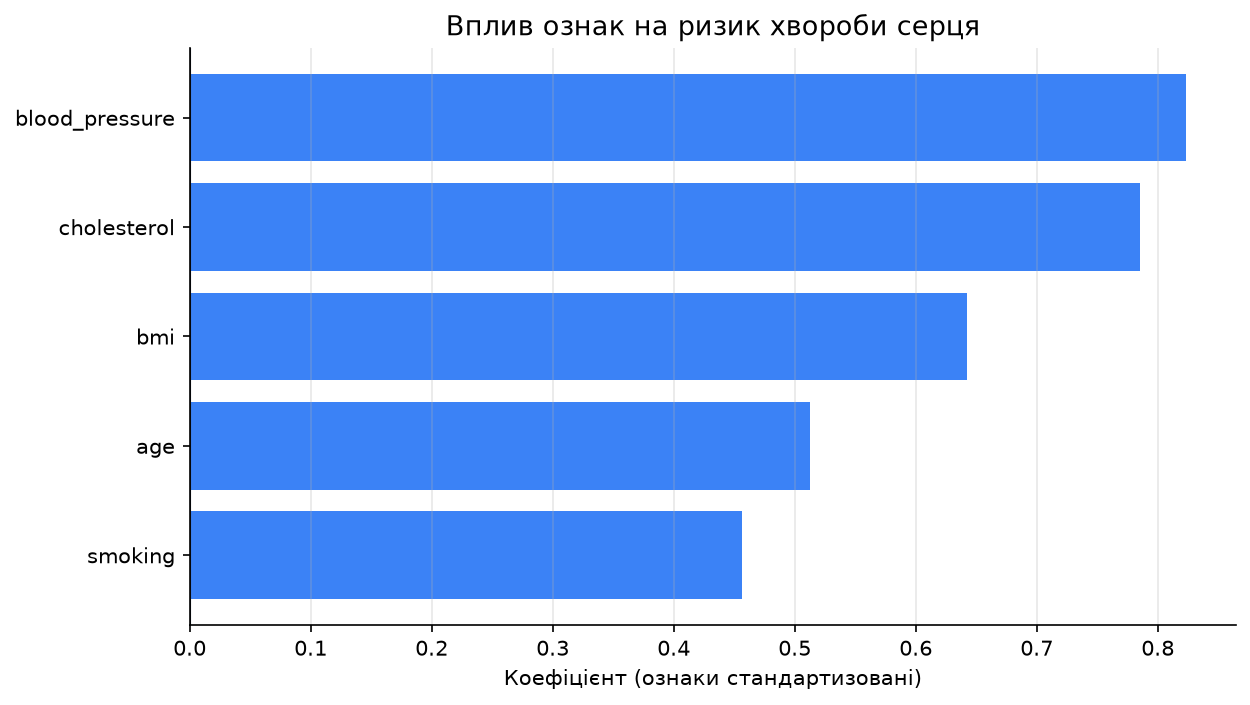
Важливість ознак (за абсолютним коефіцієнтом):
          Ознака  Коефіцієнт  Абсолютне значення
2  blood_pressure      0.8234              0.8234
1     cholesterol      0.7856              0.7856
3             bmi      0.6421              0.6421
0             age      0.5123              0.5123
4         smoking      0.4567              0.4567

Вільний член (bias): 0.0234
- Позитивний коефіцієнт (+0.82 для тиску) → зростання ознаки збільшує ймовірність хвороби
- Від'ємний коефіцієнт → зростання ознаки зменшує ймовірність хвороби
- Чим більше абсолютне значення → тим сильніший вплив ознаки на результат
Інтерпретація прогнозів
# Приклад: аналіз одного пацієнта
sample_index = 5
sample_patient = X_test.iloc[sample_index:sample_index+1]
sample_patient_scaled = X_test_scaled[sample_index:sample_index+1]

# Характеристики пацієнта
print("Характеристики пацієнта:")
print(sample_patient.to_string(index=False))

# Прогноз моделі
prob = model.predict_proba(sample_patient_scaled)[0, 1]
pred_class = model.predict(sample_patient_scaled)[0]
true_class = y_test.iloc[sample_index]

print(f"\nЙмовірність хвороби серця: {prob:.1%}")
print(f"Прогноз моделі: {'Підвищений ризик ⚠️' if pred_class == 1 else 'Низький ризик ✅'}")
print(f"Справжній діагноз: {'Хворий' if true_class == 1 else 'Здоровий'}")
Характеристики пацієнта:
age  cholesterol  blood_pressure   bmi  smoking
 62          245             158  32.1        1

Ймовірність хвороби серця: 82.3%
Прогноз моделі: Підвищений ризик ⚠️
Справжній діагноз: Хворий
Порівняння з іншими алгоритмами класифікації
Логістична регресія — не єдиний алгоритм для класифікації. Розглянемо, коли вона краща, а коли варто використати інші методи.
Порівняльна таблиця
| Алгоритм | Переваги | Недоліки | Коли використовувати |
|---|---|---|---|
| Логістична регресія | Швидка, інтерпретована, ймовірнісна | Тільки лінійна межа | Лінійно роздільні дані, потрібна інтерпретація |
| Дерева рішень | Нелінійні, інтерпретовані | Схильні до перенавчання | Категоріальні ознаки, нелінійні залежності |
| Random Forest | Висока точність, стійкі | Важко інтерпретувати | Складні задачі, великі датасети |
| SVM | Ефективні з ядрами (RBF) | Повільні на великих даних | Малі/середні датасети з нелінійними межами |
| Naive Bayes | Дуже швидкий | Припущення незалежності | Текстова класифікація, великі датасети |
| k-NN | Простий, без навчання | Дуже повільний прогноз | Малі датасети, прототипування |
| Нейронні мережі | Надзвичайно потужні | Багато даних, важко налаштувати | Зображення, текст, складні паттерни |
- Почніть з логістичної регресії — швидка baseline-модель
- Якщо точність <75%, спробуйте Random Forest або Gradient Boosting
- Для зображень та текстів — нейронні мережі
- Якщо потрібна інтерпретація — логістична регресія або дерева рішень
Типові помилки при роботі з логістичною регресією
Проблема: ознаки мають різні масштаби (вік від 0 до 100, зарплата від 20 000 до 200 000).
Наслідок: алгоритм градієнтного спуску збігається дуже повільно або взагалі не збігається.
Рішення:
from sklearn.preprocessing import StandardScaler

scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)  # Важливо: не fit!
Проблема: дані мають чітку нелінійну структуру (XOR, концентричні кола).
Наслідок: точність <55%, модель не може знайти паттерн.
Рішення:
from sklearn.preprocessing import PolynomialFeatures

poly = PolynomialFeatures(degree=2)
X_poly = poly.fit_transform(X)
Проблема: у датасеті 95% класу 0 та 5% класу 1 (дуже незбалансовані класи).
Наслідок: модель просто завжди передбачає клас 0 і досягає 95% точності, але це марна метрика!
Рішення:
# Варіант 1: Використати class_weight='balanced'
model = LogisticRegression(class_weight='balanced')

# Варіант 2: Oversample меншинського класу
from imblearn.over_sampling import SMOTE
smote = SMOTE()
X_resampled, y_resampled = smote.fit_resample(X_train, y_train)
Проблема: оцінюєте модель тільки за accuracy на незбалансованих даних.
Наслідок: не бачите, що модель погано виявляє меншинський клас.
Рішення: використовуйте F1-score, precision, recall та confusion matrix (детально у наступній статті).
Проблема: модель перенавчається на шумних даних або при великій кількості ознак.
Наслідок: висока точність на навчальній вибірці, низька на тестовій.
Рішення:
# L2 регуляризація (Ridge)
model = LogisticRegression(penalty='l2', C=0.1)  # Менший C = сильніша регуляризація

# L1 регуляризація (Lasso, вибір ознак)
model = LogisticRegression(penalty='l1', solver='liblinear', C=1.0)
Інтерактивні запитання для самоперевірки
Історично термін "регресія" з'явився через те, що алгоритм використовує лінійну комбінацію ознак (як у лінійній регресії): Завантаження.... Але потім ця лінійна комбінація пропускається через сигмоїду, яка перетворює Завантаження... у ймовірність класу 1. Тому фінальний результат — це клас (0 або 1), а не число.
Правильна назва за суттю: логістична класифікація. Але в історичній літературі та бібліотеках (sklearn) збереглася назва "логістична регресія".
Якщо одна ознака має значення від 0 до 1 (наприклад, ймовірність), а інша — від 0 до 100 000 (наприклад, зарплата), то:
- Градієнтний спуск стане нестабільним: кроки оптимізації будуть занадто великими для однієї ознаки та занадто малими для іншої.
- Модель може не збігтися: навчання триватиме дуже довго або взагалі застрягне в субоптимумі.
- Ваги будуть спотворені: ознака з великим масштабом отримає штучно малу вагу (оскільки Завантаження... має залишатися розумним).
Висновок: завжди масштабуйте ознаки перед навчанням логістичної регресії!
Ні, не може! Сигмоїдна функція асимптотично наближається до 0 та 1, але ніколи їх не досягає:
Навіть для дуже великих Завантаження... результат буде на кшталт Завантаження... або Завантаження..., але не точно 0 чи 1.
Практичне значення: модель ніколи не буває на 100% впевнена. Завжди залишається невелика невизначеність, що математично коректно відображає ймовірнісну природу класифікації.
predict(X):
- Повертає фінальне рішення про клас (0 або 1)
- Використовує поріг 0.5 за замовчуванням
- Приклад:
[0, 1, 1, 0]
predict_proba(X):
- Повертає ймовірності для кожного класу
- Формат: масив розміром
(n_samples, n_classes) - Приклад:
[[0.73, 0.27], [0.12, 0.88], ...](перший стовпець — P(клас=0), другий — P(клас=1))
Коли що використовувати:
predict()— коли потрібне остаточне рішення (наприклад, для автоматичної системи)predict_proba()— коли потрібна ймовірність для аналізу, калібрування порогу або візуалізації впевненості
Ні! sklearn.LogisticRegression викидає помилку, якщо у даних є NaN (відсутні значення).
Рішення:
# Варіант 1: Видалити рядки з пропусками
df_clean = df.dropna()

# Варіант 2: Заповнити медіаною/середнім
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(strategy='median')
X_filled = imputer.fit_transform(X)

# Варіант 3: Використати модель, стійку до пропусків (наприклад, XGBoost)
Параметр C контролює силу регуляризації:
Де Завантаження... — стандартний коефіцієнт регуляризації.
Інтерпретація:
- Великий
C(наприклад, 100) → слабка регуляризація → модель може перенавчитися - Малий
C(наприклад, 0.01) → сильна регуляризація → модель стає простішою, може недонавчитися
За замовчуванням: C=1.0 — розумний компроміс для більшості задач.
Як підібрати оптимальний C: використати крос-валідацію (GridSearchCV або LogisticRegressionCV).
Практичні завдання
Мета: навчитися будувати просту логістичну регресію на стандартному датасеті.
Завдання:
- Завантажте датасет "Breast Cancer" з sklearn (
from sklearn.datasets import load_breast_cancer) - Розділіть дані на навчальну та тестову вибірки (70%/30%)
- Масштабуйте ознаки за допомогою
StandardScaler - Навчіть логістичну регресію
- Обчисліть точність на тестовій вибірці
- Виведіть 5 найважливіших ознак (за абсолютним коефіцієнтом)
Очікуваний результат: точність >90%.
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
import pandas as pd
import numpy as np

# 1. Завантаження датасету
data = load_breast_cancer()
X, y = data.data, data.target

# 2. Розділення на навчальну та тестову вибірки
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42, stratify=y
)

# 3. Масштабування
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 4. Навчання моделі
model = LogisticRegression(max_iter=10000, random_state=42)
model.fit(X_train_scaled, y_train)

# 5. Обчислення точності
y_pred = model.predict(X_test_scaled)
accuracy = accuracy_score(y_test, y_pred)

print(f"Точність на тестовій вибірці: {accuracy:.1%}")

# 6. Топ-5 найважливіших ознак
feature_importance = pd.DataFrame({
    'Feature': data.feature_names,
    'Coefficient': np.abs(model.coef_[0])
}).sort_values('Coefficient', ascending=False)

print("\nТоп-5 найважливіших ознак:")
print(feature_importance.head().to_string(index=False))

import matplotlib.pyplot as plt

top5 = feature_importance.head()
plt.figure(figsize=(9, 5))
plt.barh(top5['Feature'][::-1], top5['Coefficient'][::-1], color='#10b981')
plt.xlabel('|Коефіцієнт|')
plt.title('Топ-5 ознак датасету breast cancer', fontsize=13)
plt.grid(axis='x', alpha=0.3)
plt.show()
Підсумкове резюме статті
✅ Класифікація vs Регресія
✅ Типи класифікації
✅ Логістична регресія
✅ Сигмоїдна функція
✅ Розділова межа
✅ Поріг рішення
✅ Обмеження
✅ Практичне застосування
Градієнтний бустинг та XGBoost — послідовне виправлення помилок
Алгоритм градієнтного бустингу як альтернатива Random Forest. Відмінність Boosting від Bagging. XGBoost як оптимізована реалізація. Порівняння всіх моделей регресії з модуля 3.
Метрики якості класифікації
Confusion Matrix, Accuracy, Precision, Recall, F1-Score, ROC-AUC — як правильно оцінювати моделі класифікації та уникати типових помилок