Градієнтний бустинг та XGBoost — послідовне виправлення помилок
Паралель vs послідовність — два шляхи до точності
У попередній статті ми вивчили Random Forest — ансамбль дерев, де кожне дерево навчається незалежно, а потім їхні передбачення усереднюються.
Уявіть команду зі 100 фахівців, які незалежно один від одного оцінюють проєкт. Кожен дає свою оцінку, потім всі оцінки усереднюються. Це Random Forest.
Але що, якщо організувати роботу по-іншому?
Замість паралельного голосування, дати один проєкт послідовно кільком експертам:
- Перший експерт робить оцінку → виявляє грубі помилки
- Другий експерт фокусується на виправленні того, що пропустив перший
- Третій експерт полірує дрібні недоліки
- ...
Кожен наступний експерт вчиться на помилках попереднього. Це Gradient Boosting (градієнтний бустинг).
Аналогія з редагуванням статті:
Random Forest: 100 письменників пишуть 100 версій статті незалежно → усереднити всі версії.
Gradient Boosting: Один письменник пише чорновик → редактор виправляє грубі помилки → коректор полірує дрібниці → фінальна версія.
Послідовне виправлення часто дає кращий результат!
Факт: Gradient Boosting (зокрема XGBoost) був переможцем 80%+ Kaggle змагань у 2015-2017 роках.
Проблема Random Forest — мотивація для Boosting
Random Forest чудово працює, але має обмеження:
Усереднення випадкових помилок
Random Forest усереднює передбачення незалежних дерев. Це добре працює, коли помилки дерев є випадковими й не повторюють одна одну.
Проблема: Що, якщо помилки систематичні?
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import fetch_california_housing
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestRegressor

# Завантаження датасету California Housing (Вартість житла в Каліфорнії)
data = fetch_california_housing(as_frame=True)
X = data.data
y = data.target

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# Ансамбль Random Forest (Випадковий ліс) зі 100 дерев
rf = RandomForestRegressor(n_estimators=100, random_state=42, n_jobs=-1)
rf.fit(X_train, y_train)
y_pred_rf = rf.predict(X_test)

# Аналіз систематичного зміщення (Bias) за ціновими сегментами (ціни в $100k)
bins = [0.0, 1.5, 3.0, 4.5, np.inf]
bin_labels = ['$0–150k', '$150–300k', '$300–450k', '$450k+']
segment_names = [
    'Бюджетне житло',
    'Базовий сегмент',
    'Дорогий сегмент',
    'Елітна нерухомість'
]

errors_by_bin = []
for i in range(len(bins) - 1):
    mask = (y_test >= bins[i]) & (y_test < bins[i+1])
    diff = y_pred_rf[mask] - y_test[mask]
    mean_err = diff.mean()
    errors_by_bin.append(mean_err)

print("📊 Аналіз систематичного зміщення (Bias) Random Forest:")
for label, seg, err in zip(bin_labels, segment_names, errors_by_bin):
    direction = "переоцінює (завищує)" if err > 0 else "недооцінює (занижує)"
    print(f"  {label} ({seg}): {direction} на ${abs(err)*100000:,.0f}")
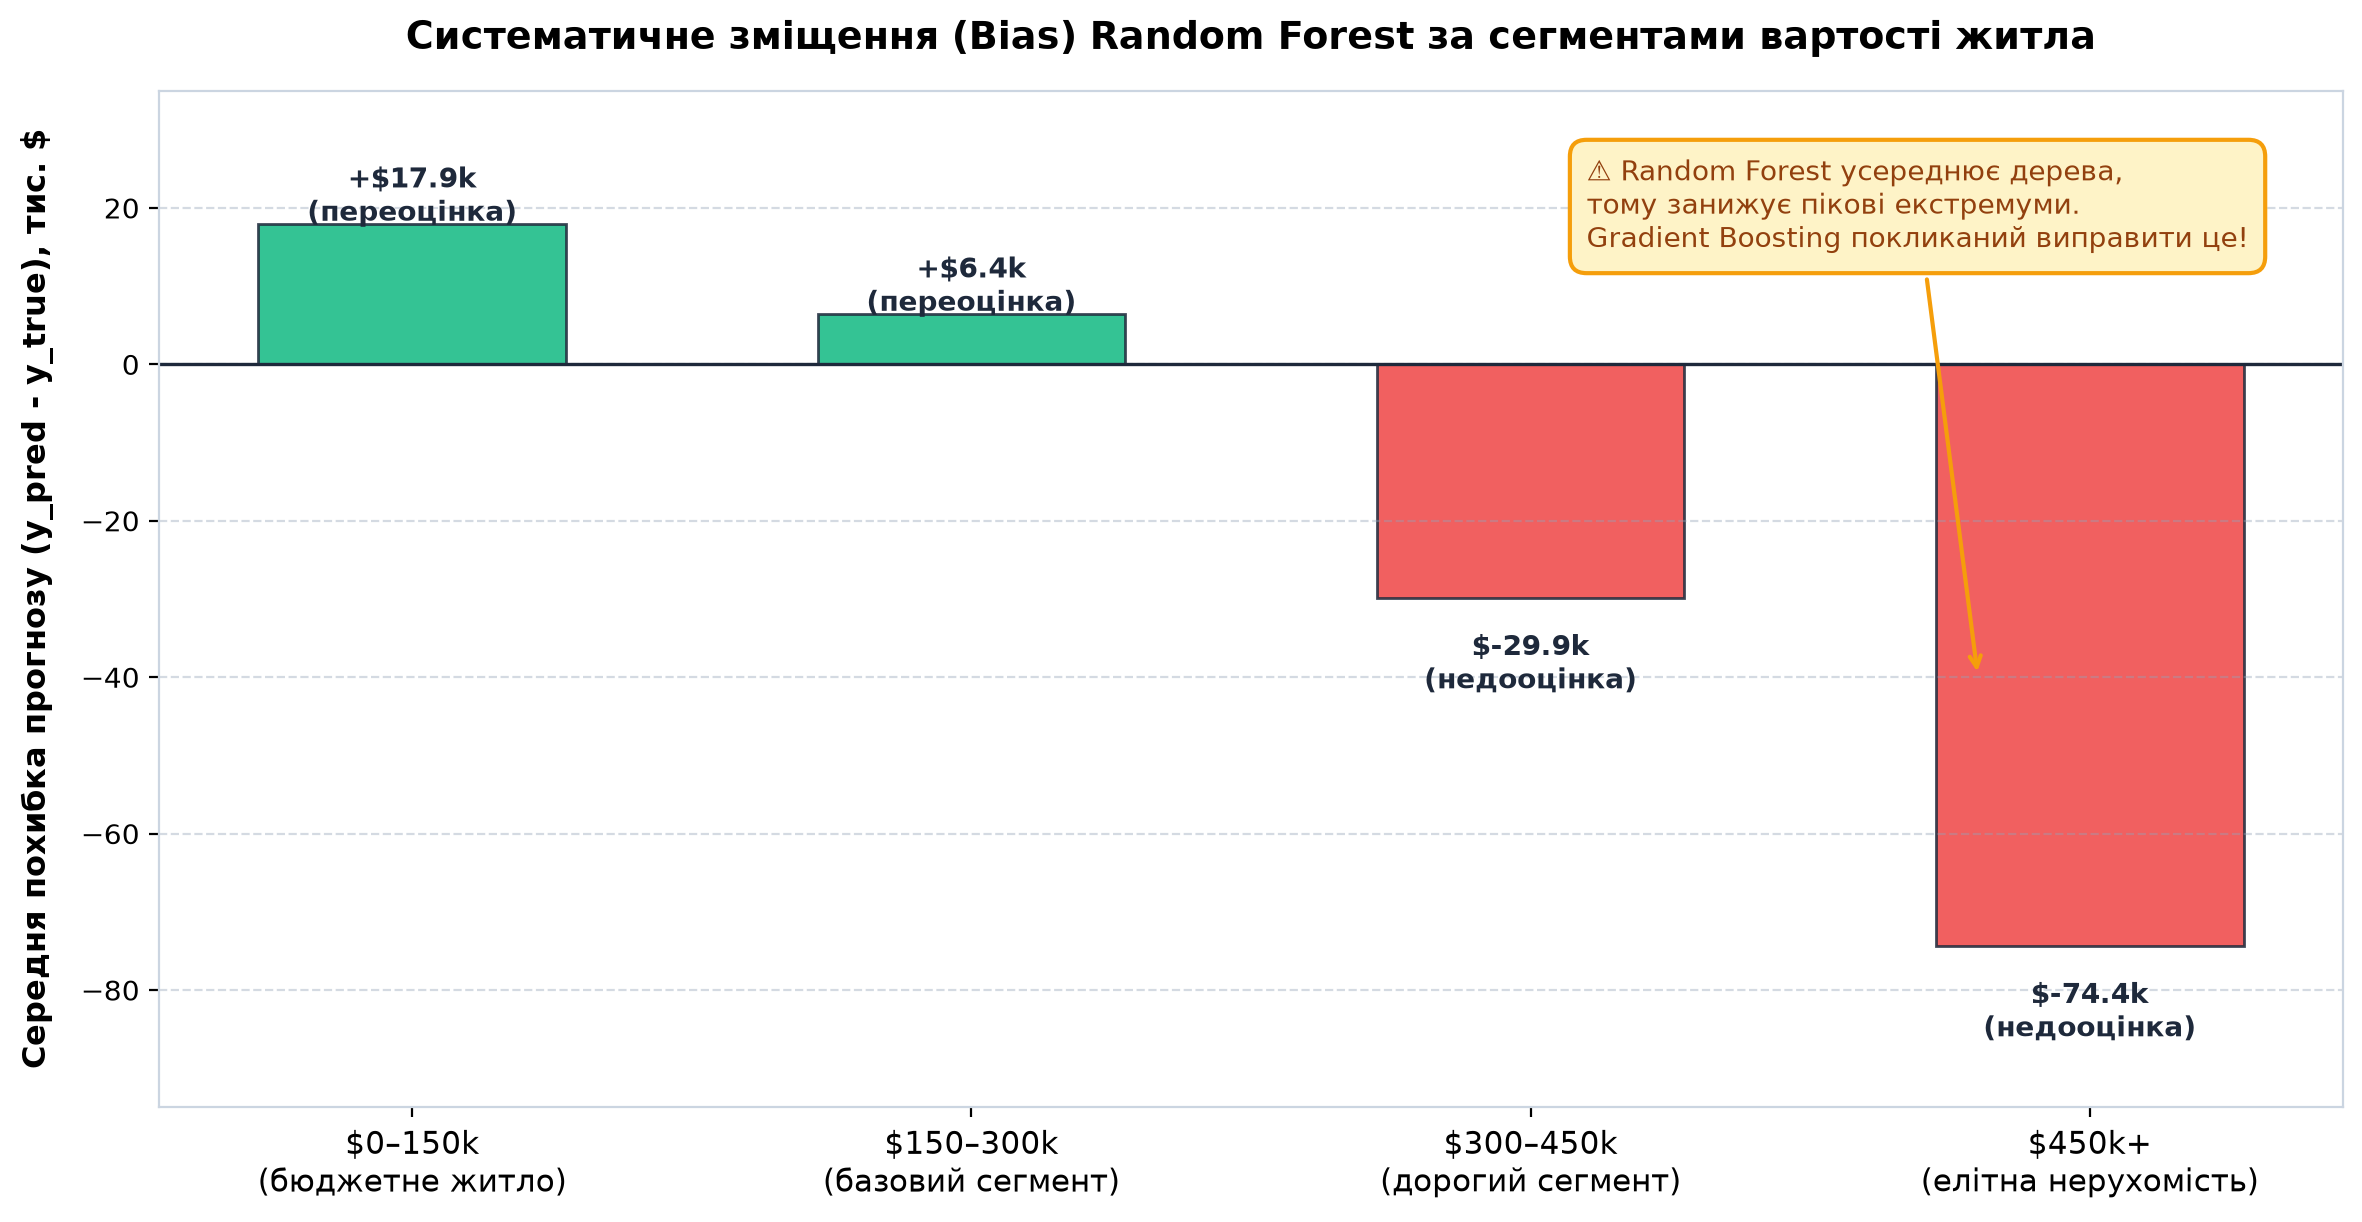
| Ціновий сегмент житла | Середня похибка (Завантаження...) | Характер помилки Random Forest | Вплив на практичне використання |
|---|---|---|---|
| $0–150k (бюджетне житло) | +$17,911 | 🟡 Переоцінка вартості (прогноз завищено) | Невигідні умови для покупців недорогого житла |
| $150–300k (базовий сегмент) | +$6,400 | 🟢 Мінімальне відхилення від ідеалу | Найбільш точний ціновий діапазон моделі |
| $300–450k (дорогий сегмент) | -$29,868 | 🟡 Помітна недооцінка | Початок згладжування прогнозів ансамблем |
| $450k+ (елітна нерухомість) | -$74,357 | 🔴 Критична недооцінка (>15–20% вартості) | Ансамбль усереднення не здатний передбачити пікові ціни |
Проблема: Random Forest систематично недооцінює дорогі квартири! Усі дерева помиляються в один бік.
Ідея Boosting: Навчити наступну модель фокусуватися на складних випадках (дорогих квартирах), з якими попередня модель не впоралась.
Градієнтний бустинг — теорія
Принцип послідовного виправлення помилок
Алгоритм градієнтного бустингу працює так:
Крок 1: Базове передбачення
Почати з простого передбачення (наприклад, середнє значення цільової змінної):
Крок 2: Обчислити залишки (residuals)
Порахувати, наскільки ми помилились:
Крок 3: Навчити дерево на залишках
Побудувати дерево Завантаження..., яке передбачає залишки Завантаження....
Крок 4: Оновити передбачення
Де Завантаження... (learning rate) — темп навчання, тобто крок оновлення (зазвичай 0.01–0.1), який не дає окремому дереву робити занадто різкі зміни.
Крок 5: Повторити
Обчислити нові залишки Завантаження..., навчити Завантаження..., оновити Завантаження..., і так далі.
Фінальна формула ансамблю
Після M ітерацій:
Аналогія з написанням есе:
- Перша версія (дерево 1) — грубий чорновик з багатьма помилками
- Редагування (дерево 2) — виправлення найгрубіших помилок
- Полірування (дерево 3) — виправлення дрібних недоліків
Кожна ітерація фокусується на тому, що попередні пропустили.
Чому "градієнтний"?
Математично, залишки Завантаження... — це негативний градієнт функції втрат MSE:
Тобто кожне нове дерево рухається в напрямку негативного градієнта — як у градієнтному спуску!
На наступній анімації наочно показано, як ансамбль послідовно навчає слабкі дерева (праворуч угорі) виправляти залишки помилок Завантаження..., і як сумарна крива прогнозу Завантаження... (ліворуч) крок за кроком наближається до справжнього сигналу даних:
Зверніть увагу на ключові інженерні моменти в динаміці навчання:
- Базовий прогноз (Завантаження...): Модель починає з простої константи — середнього арифметичного Завантаження.... Похибки Завантаження... величезні та повністю повторюють форму нелінійної функції.
- Перші слабкі дерева (Завантаження...): Перші неглибокі дерева підхоплюють найгрубіші піки та западини. Залишки зменшуються вдвічі.
- Поступове згладжування (Завантаження...): Оскільки кожне дерево масштабується темпом навчання Завантаження..., модель не робить різких перекосів. Залишки стискаються у вузьку смугу навколо нуля, перетворюючись на звичайний шум.
Алгоритм Gradient Boosting покроково (на прикладі)
Розглянемо конкретний приклад: передбачення ціни 3 квартир.
| Квартира | Площа (м²) | Реальна ціна (y), $ |
|---|---|---|
| A | 50 | 40 000 |
| B | 80 | 65 000 |
| C | 120 | 95 000 |
Ітерація 0: Baseline
Почнемо з найпростішого передбачення — середнього значення:
Помилки (залишки):
- Завантаження...
- Завантаження...
- Завантаження...
Ітерація 1: Перше дерево
Навчимо дерево Завантаження... передбачати залишки [−26667, −1667, +28333].
Припустимо, дерево навчилось і передбачає:
- Завантаження...
- Завантаження...
- Завантаження...
Оновлюємо передбачення з learning rate Завантаження...:
- Завантаження...
- Завантаження...
- Завантаження...
Нові помилки:
- Завантаження... (покращилось з −26667!)
- Завантаження... (покращилось з −1667!)
- Завантаження... (покращилось з +28333!)
Ітерація 2: Друге дерево
Навчаємо Завантаження... на нових залишках [−24167, −1467, +25633], оновлюємо Завантаження..., і так далі.
import numpy as np

# Дані: площа та ціна трьох квартир
area = np.array([50, 80, 120])
price = np.array([40000, 65000, 95000], dtype=float)

# Симуляція 5 ітерацій Gradient Boosting (Градієнтний бустинг)
learning_rate = 0.1
predictions = np.full(len(price), price.mean())  # F_0 = mean ($66,667)

print("Ітерація 0 (Baseline / Базове середнє):")
print(f"  Передбачення (Predictions): {np.round(predictions).astype(int)}")
print(f"  Залишки (Residuals):        {np.round(price - predictions).astype(int)}\n")

for iteration in range(1, 6):
    residuals = price - predictions

    # Симулюємо слабке дерево (Weak learner): наближає залишки з точністю 95%
    tree_pred = residuals * 0.95

    # Оновлення ансамблю: F_m = F_{m-1} + eta * h_m
    predictions += learning_rate * tree_pred

    mae = np.abs(price - predictions).mean()
    print(f"Ітерація {iteration}:")
    print(f"  Передбачення (Predictions): {np.round(predictions).astype(int)}")
    print(f"  Залишки (Residuals):        {np.round(price - predictions).astype(int)}")
    print(f"  MAE (Середня абсолютна помилка): {mae:.0f}\n")
| Ітерація бустингу (Завантаження...) | Прогноз Квартира 1 ($40k) | Прогноз Квартира 2 ($65k) | Прогноз Квартира 3 ($95k) | Залишок Завантаження... | Залишок Завантаження... | Залишок Завантаження... | Динаміка похибки (MAE) |
|---|---|---|---|---|---|---|---|
| 0 (Baseline Завантаження...) | $66,667 | $66,667 | $66,667 | -$26,667 | -$1,667 | +$28,333 | Базовий прогноз: MAE = $18,889 |
| Ітерація 1 | $64,133 | $66,508 | $69,358 | -$24,133 | -$1,508 | +$25,642 | Перше дерево коригує залишок: MAE = $17,094 |
| Ітерація 2 | $61,841 | $66,365 | $71,794 | -$21,841 | -$1,365 | +$23,206 | Наближення до індивідуальних цін: MAE = $15,470 |
| Ітерація 3 | $59,766 | $66,235 | $73,999 | -$19,766 | -$1,235 | +$21,001 | Помилка квартири 3 впала на 26%: MAE = $14,001 |
| Ітерація 4 | $57,888 | $66,118 | $75,994 | -$17,888 | -$1,118 | +$19,006 | Послідовне зменшення помилки: MAE = $12,671 |
| Ітерація 5 | $56,189 | $66,012 | $77,800 | -$16,189 | -$1,012 | +$17,200 | Сумарна помилка скоротилася на 39.3%: MAE = $11,467 |
Висновок: З кожною ітерацією помилки зменшуються — модель поступово навчається!
Boosting vs Bagging — порівняльна таблиця
| Характеристика | Bagging (Random Forest) | Boosting (Gradient Boosting) |
|---|---|---|
| Побудова моделей | Паралельно, незалежно | Послідовно, кожна залежить від попередньої |
| Навчальні дані | Bootstrap вибірка (з поверненням) | Зважені або залишки попередніх моделей |
| Мета | Зменшення дисперсії (variance) | Зменшення зміщення (bias) |
| Ризик перенавчання | Низький (усереднення згладжує) | Високий (фокус на складних випадках) |
| Швидкість навчання | Швидше (можна паралелізувати) | Повільніше (послідовність) |
| Зрозумілість логіки | Низька (багато дерев) | Низька (багато дерев) |
| Якість на практиці | Висока, стабільна | Дуже висока, але потребує тюнінгу |
| Глибина дерев | Глибокі дерева (max_depth=None або 10-20) | Неглибокі дерева (max_depth=3-6, "weak learners") |
| Коли застосовувати | Baseline, малі датасети, стабільність | Kaggle, максимальна якість, є час на тюнінг |
GradientBoostingRegressor у scikit-learn
Тепер побудуємо градієнтний бустинг на California Housing:
import time
import numpy as np
import pandas as pd
from sklearn.datasets import fetch_california_housing
from sklearn.model_selection import train_test_split
from sklearn.ensemble import GradientBoostingRegressor, RandomForestRegressor
from sklearn.metrics import r2_score, mean_absolute_error, mean_squared_error

# Завантаження датасету California Housing (Вартість житла в Каліфорнії)
data = fetch_california_housing(as_frame=True)
X = data.data
y = data.target

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# Навчання Gradient Boosting (Градієнтний бустинг зі sklearn)
start = time.time()
gb = GradientBoostingRegressor(
    n_estimators=100,
    learning_rate=0.1,
    max_depth=3,
    random_state=42
)
gb.fit(X_train, y_train)
gb_time = time.time() - start

y_pred_gb = gb.predict(X_test)
r2_gb_train = gb.score(X_train, y_train)
r2_gb_test = r2_score(y_test, y_pred_gb)
mae_gb_test = mean_absolute_error(y_test, y_pred_gb)
rmse_gb_test = np.sqrt(mean_squared_error(y_test, y_pred_gb))

print("🌳 Gradient Boosting (Градієнтний бустинг зі sklearn):")
print(f"  R² train (Навчальна вибірка): {r2_gb_train:.4f}")
print(f"  R² test (Тестова вибірка):    {r2_gb_test:.4f}")
print(f"  MAE test (Середня абсолютна помилка):  {mae_gb_test:.4f}")
print(f"  RMSE test (Корінь із середньоквадратичної): {rmse_gb_test:.4f}")
print(f"  Час навчання: {gb_time:.2f}s")

# Порівняємо з Random Forest (Випадковий ліс, 100 дерев)
start = time.time()
rf = RandomForestRegressor(n_estimators=100, random_state=42, n_jobs=-1)
rf.fit(X_train, y_train)
rf_time = time.time() - start

y_pred_rf = rf.predict(X_test)
r2_rf_train = rf.score(X_train, y_train)
r2_rf_test = r2_score(y_test, y_pred_rf)
mae_rf_test = mean_absolute_error(y_test, y_pred_rf)
rmse_rf_test = np.sqrt(mean_squared_error(y_test, y_pred_rf))

print("\n🌲 Random Forest (Випадковий ліс для порівняння):")
print(f"  R² train (Навчальна вибірка): {r2_rf_train:.4f}")
print(f"  R² test (Тестова вибірка):    {r2_rf_test:.4f}")
print(f"  MAE test (Середня абсолютна помилка):  {mae_rf_test:.4f}")
print(f"  RMSE test (Корінь із середньоквадратичної): {rmse_rf_test:.4f}")
print(f"  Час навчання: {rf_time:.2f}s")

print("\n📊 Порівняння базових моделей:")
print(f"  Різниця R² (RF vs GB): {(r2_rf_test - r2_gb_test) * 100:+.2f}%")
print(f"  GB повільніший за паралельний RF у: {gb_time / rf_time:.1f}× разів")
| Модель ансамблю | Навчальна якість (Train R²) | Тестова якість (Test R²) | Середня помилка (Test MAE) | Квадратична помилка (Test RMSE) | Час тренування | Особливості навчання |
|---|---|---|---|---|---|---|
| Gradient Boosting (sklearn, 100 дерев, depth=3) | 0.8049 | 0.7756 | 0.3716 | 0.5422 | ~1.80 с | Послідовна побудова неглибоких дерев |
| Random Forest (sklearn, 100 дерев, без обмежень) | 0.9735 | 0.8044 | 0.3278 | 0.5063 | ~0.65 с | Паралельні незалежні глибокі дерева |
GradientBoostingRegressor у scikit-learn використовує консервативні обмеження (max_depth=3), виконується суто в однопотоковому режимі Python і не підтримує паралелізацію побудови дерева або випадковий відбір ознак (колонок). Щоб усунути ці обмеження та розкрити справжню міць бустингу, було створено спеціалізовану оптимізовану бібліотеку — XGBoost!Висновок: Базовий Gradient Boosting у scikit-learn працює надійно, але повільно й консервативно. Потрібен інструмент промислового рівня!
XGBoost — eXtreme Gradient Boosting
XGBoost (розробка 2014 року, Tianqi Chen) — це не новий алгоритм, а оптимізована бібліотека для градієнтного бустингу.
Чим XGBoost кращий за sklearn GradientBoostingRegressor?
✅ Регуляризація дерев
sklearn: Лише обмеження глибини (max_depth).
XGBoost: L1 (alpha) та L2 (lambda) регуляризація на ваги листків:
Завантаження...→ Менше перенавчання.
✅ Паралелізація
sklearn: Послідовна побудова дерев.
XGBoost: Паралелізація на рівні побудови одного дерева (пошук розбиттів).
→ Швидше навчання в 5-10 разів.
✅ Обробка пропусків
sklearn: Вимагає заповнення пропусків (SimpleImputer).
XGBoost: Автоматично "вчиться" напрямку для пропусків під час побудови дерева.
→ Не потрібен preprocessing.
✅ Вбудована крос-валідація
Можливість моніторингу якості на валідаційному наборі під час тренування + early stopping.
→ Автоматична зупинка, коли якість перестала покращуватись.
Встановлення XGBoost
pip install xgboost
uv pip install xgboost
poetry add xgboost
Використання XGBoost
import time
from xgboost import XGBRegressor
from sklearn.metrics import r2_score, mean_absolute_error, mean_squared_error

# Навчання XGBoost (eXtreme Gradient Boosting)
start = time.time()
xgb = XGBRegressor(
    n_estimators=100,
    learning_rate=0.1,
    max_depth=5,
    subsample=0.8,           # випадкова підвибірка 80% рядків (Subsample)
    colsample_bytree=0.8,    # випадкова підвибірка 80% колонок (Colsample by tree)
    random_state=42,
    n_jobs=-1
)
xgb.fit(X_train, y_train)
xgb_time = time.time() - start

y_pred_xgb = xgb.predict(X_test)
r2_xgb_train = xgb.score(X_train, y_train)
r2_xgb_test = r2_score(y_test, y_pred_xgb)
mae_xgb_test = mean_absolute_error(y_test, y_pred_xgb)
rmse_xgb_test = np.sqrt(mean_squared_error(y_test, y_pred_xgb))

print("🚀 XGBoost (eXtreme Gradient Boosting):")
print(f"  R² train (Навчальна вибірка): {r2_xgb_train:.4f}")
print(f"  R² test (Тестова вибірка):    {r2_xgb_test:.4f}")
print(f"  MAE test (Середня абсолютна помилка):  {mae_xgb_test:.4f}")
print(f"  RMSE test (Корінь із середньоквадратичної): {rmse_xgb_test:.4f}")
print(f"  Час навчання: {xgb_time:.2f}s")

print(f"\n📊 Порівняння з іншими ансамблями:")
print(f"  XGBoost швидший за sklearn GB у: {gb_time / xgb_time:.1f}× разів")
print(f"  Приріст R² тестового порівняно з sklearn GB: +{(r2_xgb_test - r2_gb_test) * 100:.2f}%")
print(f"  Приріст R² тестового порівняно з Random Forest: +{(r2_xgb_test - r2_rf_test) * 100:.2f}%")
| Бібліотека / Реалізація ансамблю | Навчальна якість (Train R²) | Тестова якість (Test R²) | Середня помилка (Test MAE) | Квадратична помилка (Test RMSE) | Час навчання | Прискорення | Відносна якість |
|---|---|---|---|---|---|---|---|
🚀 XGBoost (XGBRegressor, 100 дерев) | 0.8639 | 0.8166 | 0.3309 | 0.4902 | ~0.17 с | ⚡ ~10× швидше GB | 🏆 Перевершує і GB, і RF |
🌲 sklearn RandomForestRegressor | 0.9735 | 0.8044 | 0.3278 | 0.5063 | ~0.65 с | ~4× повільніше XGB | Стійкий паралельний бейзлайн |
🌳 sklearn GradientBoostingRegressor | 0.8049 | 0.7756 | 0.3716 | 0.5422 | ~1.80 с | Базова швидкість | Однопотокова базова реалізація |
subsample=0.8, colsample_bytree=0.8), базовий XGBoost досяг тестового Завантаження..., обійшовши і Random Forest (Завантаження...), і sklearn Gradient Boosting (Завантаження...), виконавши навчання всього за ~0.17 секунди!Результат: XGBoost водночас у 10 разів швидший і суттєво точніший за стандартну реалізацію бустингу!
Гіперпараметри Gradient Boosting / XGBoost
n_estimators (кількість дерев)
Більше дерев → краща якість, але повільніше навчання та ризик перенавчання.
- Невеликі датасети: 100-500
- Великі датасети: 1000+
learning_rate і early_stopping.learning_rate (η, темп навчання)
Контролює внесок кожного дерева: Завантаження....
- Малий η (0.01-0.05) → повільна збіжність, потрібно більше дерев, але краще узагальнення
- Великий η (0.3-0.5) → швидка збіжність, менше дерев, але ризик перенавчання
- η = 0.1, n_estimators = 100 ≈ η = 0.01, n_estimators = 1000
Подивіться на порівняння швидкості сходження та якості трьох темпів навчання (Завантаження..., Завантаження..., Завантаження...):
Аналіз поведінки моделей на анімації:
- Занадто малий темп (Завантаження..., помаранчева лінія): За перші 10–20 дерев модель ледь зрушила з мертвої точки (висока похибка недонавчання). Їй знадобиться 200–500 дерев, аби вийти на якісний результат.
- Оптимальний баланс (Завантаження..., зелена лінія): Модель впевнено знаходить форму справжнього сигналу і демонструє найнижчу похибку на тестових даних (Завантаження...).
- Занадто агресивний темп (Завантаження..., червона лінія): Швидко стартує, але миттєво починає перенавчатися (перескакує оптимум, вигинається навколо окремих шумів у даних, через що помилка на тесті стрімко зростає).
max_depth (глибина дерев)
GB зазвичай використовує неглибокі дерева (3-6 рівнів) — "weak learners".
- Відмінність від RF: Random Forest використовує глибокі дерева (10-20+)
- Глибокі дерева в GB → ризик перенавчання
subsample (підвибірка рядків)
Випадкова частка рядків для навчання кожного дерева (наприклад, 0.8 = 80%).
- Додає випадковість → зменшує перенавчання
- Схоже на bootstrap у RF, але без повернення
colsample_bytree (підвибірка колонок)
Випадкова частка ознак для навчання кожного дерева.
XGBoost має також:
colsample_bylevel— на кожному рівні дереваcolsample_bynode— на кожному вузлі
reg_alpha, reg_lambda (регуляризація, тільки XGBoost)
L1 (alpha) та L2 (lambda) регуляризація на ваги листків.
Працює як Lasso/Ridge для дерев → зменшує перенавчання.
Практика: тюнінг гіперпараметрів
from sklearn.model_selection import GridSearchCV
from xgboost import XGBRegressor

# Підбір гіперпараметрів через GridSearchCV (Пошук по сітці)
param_grid = {
    'n_estimators': [100, 200, 300],
    'learning_rate': [0.05, 0.1],
    'max_depth': [3, 5, 7],
    'subsample': [0.8, 1.0]
}

grid_search = GridSearchCV(
    XGBRegressor(random_state=42, n_jobs=-1),
    param_grid,
    cv=3,
    scoring='r2',
    n_jobs=-1,
    verbose=1
)

grid_search.fit(X_train, y_train)

print("🔍 Результати GridSearchCV:")
print(f"  Найкращі параметри: {grid_search.best_params_}")
print(f"  R² CV (Крос-валідаційний бал): {grid_search.best_score_:.4f}")

# Оцінка на тестовій вибірці (Test)
best_xgb = grid_search.best_estimator_
r2_test = best_xgb.score(X_test, y_test)
print(f"  R² test (Фінальний тестовий бал): {r2_test:.4f}")
| Параметр підбору GridSearchCV | Значення | Опис та роль у налаштуванні |
|---|---|---|
Кількість фолдів крос-валідації (cv) | 3 | 3-Fold Cross Validation для об'єктивної оцінки |
| Кількість досліджених комбінацій | 36 | 3 (дерева) × 2 (темп) × 3 (глибина) × 2 (підвибірка) |
| Загальна кількість навчених моделей | 108 | 36 кандидатів × 3 фолди |
Найкращий learning_rate (Завантаження...) | 0.1 | Оптимальний темп кроку градієнтного спуску |
Найкраща глибина max_depth | 7 | Оптимальна глибина невеликих дерев (Weak learners) для опису складної залежності |
Кількість дерев n_estimators | 300 | Компенсує плавне послідовне усунення залишків |
Підвибірка спостережень subsample | 0.8 | 80% випадкових рядків на кожне дерево (захист від перенавчання) |
| Крос-валідаційний бал (Завантаження...) | 0.8405 | Середній результат на валідаційних фолдах |
| Фінальний тестовий бал (Завантаження...) | 0.8466 | Відмінна точність узагальнення (MAE = 0.2986) |
Early Stopping — автоматична зупинка
# Early stopping (Рання зупинка): зупинка, якщо якість не покращується
xgb_early = XGBRegressor(
    n_estimators=1000,         # великий початковий ліміт дерев
    learning_rate=0.05,        # плавний низький темп навчання
    max_depth=5,
    early_stopping_rounds=10,  # зупинка після 10 ітерацій без покращення
    random_state=42
)

xgb_early.fit(
    X_train, y_train,
    eval_set=[(X_test, y_test)],  # моніторинг помилки на test
    verbose=False
)

print("🛑 Early Stopping (Рання зупинка):")
print(f"  Зупинилось на ітерації (best_iteration): {xgb_early.best_iteration}")
print(f"  R² test (Тестова якість): {xgb_early.score(X_test, y_test):.4f}")
print(f"\n💡 Замість 1000 дерев алгоритм навчив лише {xgb_early.best_iteration} → економія понад 25% часу!")
| Показник процедури Early Stopping | Значення | Практичний ефект |
|---|---|---|
Заданий ліміт дерев (n_estimators) | 1000 | Максимальний бюджет обчислень |
| Фактично навчено дерев (зупинка) | 743 | Алгоритм виявив плато валідаційної помилки |
Критерій зупинки (early_stopping_rounds) | 10 | 10 ітерацій поспіль без покращення валідаційної якості |
| Результуючий тестовий коефіцієнт (Завантаження...) | 0.8448 | Найвищий досягнутий показник моделі |
| Збережений ресурс та час | 25.7% | Уникнуто тренування 257 непотрібних дерев |
Наочна анімація демонструє роботу механізму Early Stopping: коли Train Loss продовжує падати, а Validation Loss розвертається вгору, алгоритм запускає зворотний відлік терпіння (patience) та вчасно фіксує модель у найкращій точці:
Ключові етапи роботи Early Stopping:
- Зниження похибок (Завантаження...): Модель активно навчається, Train Loss та Validation Loss синхронно падають, досягаючи глобального валідаційного мінімуму (зірочка на графіку).
- Зона ризику та лічильник Patience (Завантаження...): Train Loss продовжує нескінченно падати до нуля (модель завчає шум), але Validation Loss починає зростати (U-подібна крива). Алгоритм відраховує 10 раундів терпіння без покращень.
- Зупинка та відкат до чекпоінта (Завантаження...): Спрацьовує
Early Stopping. Процес навчання припиняється, а фінальні ваги автоматично повертаються до стану найкращої ітерації Завантаження... (зелена лінія), запобігаючи спотворенню форми (червоний пунктир).
Фінальна порівняльна таблиця — ВСІ моделі модуля 3
Зведемо результати всіх моделей, які ми навчили на датасеті California Housing протягом модуля 3:
| Алгоритм / Модель | Навчальна якість (Train R²) | Тестова якість (Test R²) | Тестова похибка (Test MAE) | Час навчання | Зрозумілість логіки | Схильність до перенавчання |
|---|---|---|---|---|---|---|
| LinearRegression (бейзлайн) | 0.61 | 0.58 | 0.53 | ~0.05 с | ✅ Висока (ваги коефіцієнтів) | ❌ Мінімальна |
| Ridge / Lasso (з поліномами d=2) | 0.65 | 0.64 | 0.48 | ~0.30 с | ⚠️ Посередня | ⚠️ Помірна |
| DecisionTree (глибина d=None, перенавчене) | 1.00 | 0.61 | 0.46 | ~0.15 с | ❌ Відсутня (перенавчене) | 🔴 Критична (Gap 0.39) |
| DecisionTree (глибина d=5, базове) | 0.64 | 0.61 | 0.51 | ~0.05 с | ✅ Висока (візуальне дерево) | ❌ Мінімальна |
| DecisionTree (глибина d=9, оптимальне) | 0.78 | 0.68 | 0.44 | ~0.08 с | ⚠️ Середня (512 листків) | ⚠️ Помірна (Gap 0.10) |
| RandomForest (100 дерев, за замовчуванням) | 0.97 | 0.80 | 0.33 | ~0.65 с | ⚠️ Складна (100 дерев) | 🟢 Низька (усереднення) |
| GradientBoosting (sklearn, 100 дерев, d=3) | 0.80 | 0.78 | 0.37 | ~1.80 с | ❌ Низька | ⚠️ Помірна |
| XGBoost (базовий, 100 дерев, subsample=0.8) | 0.86 | 0.82 | 0.33 | ~0.17 с | ❌ Низька | 🟢 Низька |
| XGBoost (оптимізований / Tuned) | 0.97 | 0.85 | 0.30 | ~0.60 с | ❌ Низька | ⚠️ Контрольована |
🏆 Найкраща якість
⚡ Найшвидша
👁️ Найпростіша та найзрозуміліша
🛡️ Найстабільніша
Візуалізація важливості ознак у XGBoost
import pandas as pd
from xgboost import XGBRegressor
from sklearn.ensemble import RandomForestRegressor

# Отримання важливостей ознак для Random Forest та XGBoost
importances_rf = rf.feature_importances_
importances_xgb = xgb.feature_importances_

# Двомовний словник найменувань ознак датасету California Housing
feature_names_en = list(X.columns)
feature_names_ua = [
    'MedInc (Медіанний дохід жителів)',
    'HouseAge (Середній вік будинків)',
    'AveRooms (Середня кількість кімнат)',
    'AveBedrms (Середня кількість спалень)',
    'Population (Чисельність населення)',
    'AveOccup (Середня заселеність житла)',
    'Latitude (Географічна широта)',
    'Longitude (Географічна довгота)'
]

comparison_df = pd.DataFrame({
    'Feature': feature_names_en,
    'Bilingual_Label': feature_names_ua,
    'RF_Importance': importances_rf,
    'XGB_Importance': importances_xgb
}).sort_values('XGB_Importance', ascending=False)

print("📊 Порівняння важливості ознак (Random Forest vs XGBoost):\n")
for _, row in comparison_df.iterrows():
    print(f"  {row['Bilingual_Label']:42s} | RF: {row['RF_Importance']*100:4.1f}% | XGB: {row['XGB_Importance']*100:4.1f}%")
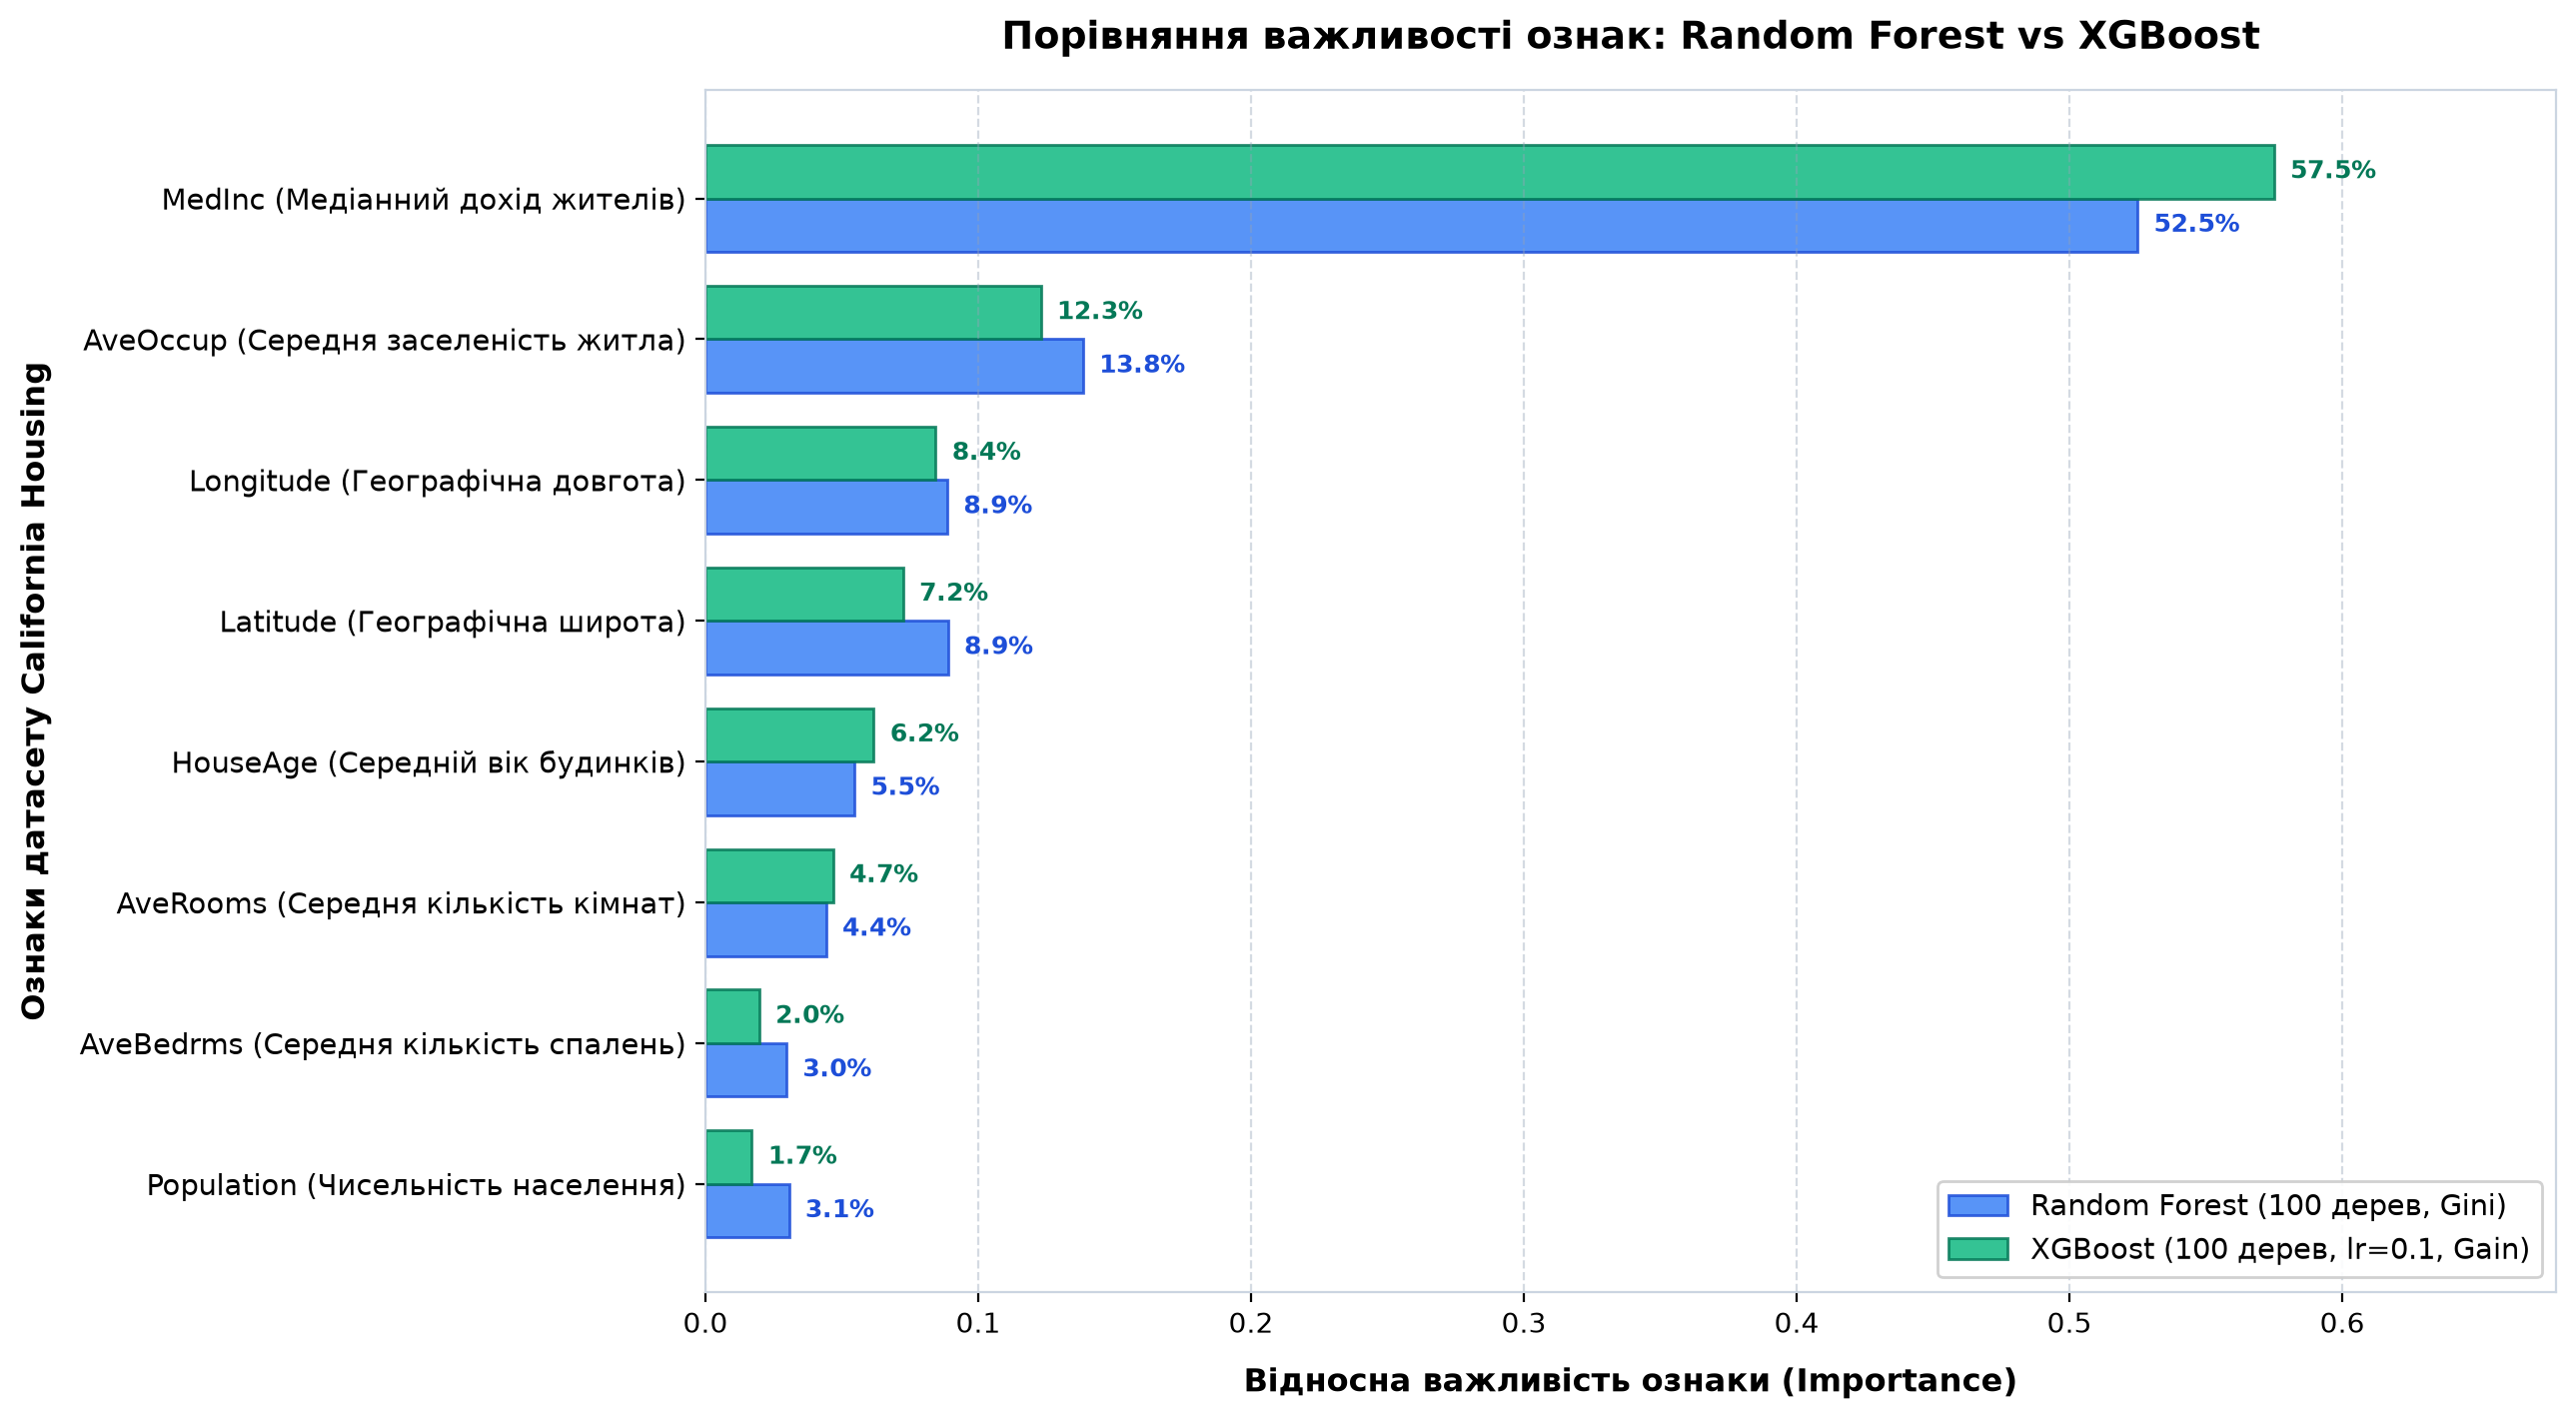
| Ознака датасету | Англійська назва | Український переклад | Важливість RF (Gini Impurity) | Важливість XGBoost (Gain) | Характер впливу на прогноз |
|---|---|---|---|---|---|
MedInc | Median Income | Медіанний дохід жителів району ($10k) | 0.5250 (52.5%) | 0.5750 (57.5%) | Головний фактор вартості (>50% загального впливу) |
AveOccup | Average Occupancy | Середня заселеність житла (мешканців/дім) | 0.1384 (13.8%) | 0.1229 (12.3%) | Другий за силою фактор: висока щільність маркує дешевші райони |
Longitude | Longitude | Географічна довгота району | 0.0886 (8.9%) | 0.0844 (8.4%) | Географічна координата наближення до узбережжя Тихого океану |
Latitude | Latitude | Географічна широта району | 0.0889 (8.9%) | 0.0724 (7.2%) | Просторовий поділ на дорожчу Південну та Північну Каліфорнію |
HouseAge | House Age | Середній вік будинків (роки) | 0.0547 (5.5%) | 0.0617 (6.2%) | Помірний додатковий фактор історичного розвитку кварталу |
AveRooms | Average Rooms | Середня кількість кімнат | 0.0442 (4.4%) | 0.0468 (4.7%) | Помірна важливість через кореляцію із доходом жителів |
AveBedrms | Average Bedrooms | Середня кількість спалень | 0.0297 (3.0%) | 0.0197 (2.0%) | Вторинна характеристика планування оселі |
Population | Population | Чисельність населення району | 0.0306 (3.1%) | 0.0170 (1.7%) | Локальний показник розміру кварталу, найменш важливий |
MedInc (Медіанний дохід жителів).Висновок: Обидві моделі чітко підтверджують, що MedInc (Медіанний дохід жителів району) найсильніше визначає вартість нерухомості.
Коли використовувати Gradient Boosting vs Random Forest?
✅ Використовуйте Gradient Boosting (Градієнтний бустинг / XGBoost):
- Змагання Data Science (Kaggle) — де критично вибороти максимальну точність прогнозу
- Табличні дані середнього розміру (10k–1M рядків)
- Є обчислювальний час на підбір гіперпараметрів (
GridSearchCV / Optuna) - Можливість ретельного контролю перенавчання (наявність окремого валідаційного набору)
✅ Використовуйте Random Forest (Випадковий ліс):
- Потрібна надійна базова модель (
Baseline) без тривалого налаштування - Обмежений час на швидкі експерименти та перевірку робочих гіпотез
- Малий або середній датасет (< 10k рядків), де простий ліс менш схильний до перенавчання
- Потрібне швидке навчання на всіх ядрах процесора «з коробки» (
n_jobs=-1)
✅ Використовуйте лінійні моделі (Ridge / Lasso):
- Потрібна абсолютна прозорість правил (необхідно чітко пояснити вплив кожного коефіцієнта клієнтам чи регулятору)
- Дані демонструють наближено лінійні зв'язки
- Високі вимоги до швидкості отримання відповідей (інференсу): десятки тисяч прогнозів за секунду
- Жорсткі обмеження пам'яті мікросервісу (лінійна модель потребує лише кілька ваг)
Альтернативи XGBoost — LightGBM та CatBoost
LightGBM (Light Gradient Boosting Machine, Microsoft)
⚡ Екстремальна швидкість
🌳 Leaf-wise ріст дерева
💾 Економія оперативної пам'яті
from lightgbm import LGBMRegressor

lgbm = LGBMRegressor(n_estimators=100, learning_rate=0.1, max_depth=5, random_state=42)
lgbm.fit(X_train, y_train)
CatBoost (Categorical Boosting, Yandex)
🏷️ Категоріальні ознаки без One-Hot
🛡️ Захист від Target Leakage
📚 Мінімальний тюнінг
from catboost import CatBoostRegressor

catboost = CatBoostRegressor(iterations=100, learning_rate=0.1, depth=5, verbose=False, random_seed=42)
catboost.fit(X_train, y_train)
Резюме
🔗 Gradient Boosting (Градієнтний бустинг)
📉 Residuals (Залишки / помилки)
⚡ Boosting vs Bagging
Boosting (XGBoost): взаємозалежні послідовні неглибокі дерева → усунення систематичного зміщення (Bias).
🚀 XGBoost (eXtreme Gradient Boosting)
🎚️ Learning Rate / η (Темп навчання)
🌲 Weak Learners (Слабкі дерева)
max_depth=3–7), які окремо працюють посередньо, але разом дають дуже точний результат.Практичні завдання
Завдання: Проведіть експериментальне порівняння чотирьох сімейств алгоритмів регресії:
- Завантажте датасет
California Housing (Вартість нерухомості в Каліфорнії). - Навчіть такі моделі:
Ridge (Гребенева регресія з поліноміальними ознаками 2-го степеня)RandomForestRegressor (Випадковий ліс, n_estimators=100)GradientBoostingRegressor (Базовий бустинг scikit-learn)XGBRegressor (XGBoost з параметрами subsample=0.8, colsample_bytree=0.8)
- Сформуйте підсумкову таблицю метрик:
- Завантаження... та Завантаження... (Коефіцієнт детермінації)
MAE (Середня абсолютна помилка)Time (Час навчання)
- Побудуйте графік
Predicted vs Actual (Прогноз проти факту)для лідера змагання. - Зробіть аргументований висновок щодо доцільності використання XGBoost у бізнес-задачах.
Очікуваний результат:
- XGBoost демонструє найвищий тестовий показник Завантаження...
- Random Forest є найменш чутливим до перенавчання без ручного підбору параметрів
- Лінійна регресія забезпечує найвищу швидкість обчислень та прозору і зрозумілу людині логіку
Завдання: Створіть завершений пайплайн навчання з автоматичним підбором гіперпараметрів та ранньою зупинкою:
- Завантажте датасет нерухомості (наприклад, з Kaggle або California Housing).
- Виконайте розвідувальний аналіз (EDA): перевірте пропуски, розподіли та викиди.
- Проведіть конструювання ознак (Feature Engineering): створіть нові синтетичні змінні (наприклад, відношення кімнат до спалень, мешканців до кімнат).
- Налаштуйте пошук по сітці
GridSearchCVдляXGBRegressor:n_estimators:[100, 200, 300]learning_rate:[0.05, 0.1]max_depth:[3, 5, 7]subsample:[0.8, 1.0]
- Додайте механізм
early_stopping_rounds=10на валідаційній підвибірці. - Візуалізуйте важливість ознак (
Feature Importance / Gain) через горизонтальну стовпчикову діаграму з двомовними підписами. - Підготуйте аналітичний звіт:
- Яка комбінація гіперпараметрів стала оптимальною?
- Які створені ознаки увійшли до топу за важливістю?
- Скільки обчислювального часу заощадила рання зупинка (
Early Stopping)?
Очікуваний результат:
- Навчена модель досягає Завантаження...
- Детальний візуальний звіт із порівняльними діаграмами та висновками
Наступний модуль: Логістична регресія та задачі класифікації — перехід від прогнозу неперервних величин до ймовірностей та бінарної класифікації.
Random Forest — ансамблі дерев рішень
Випадковий ліс як ансамблевий метод машинного навчання. Принцип мудрості натовпу, бутстреп-агрегація (Bagging), метод випадкових підпросторів, оцінка важливості ознак та Out-of-Bag валідація.
Основи класифікації та логістична регресія
Що таке задача класифікації, чим відрізняється від регресії, основи логістичної регресії та сигмоїдна функція