Візуалізація залежностей — scatter plots та кореляція
Візуалізація залежностей — scatter plots та кореляція
🎯 Мета підтеми
- Навчитися будувати scatter plots для двох змінних
- Візуально виявляти позитивну, негативну та нульову кореляцію
- Розрізняти лінійні та нелінійні залежності
- Додавати лінії тренду (regression lines) до графіків
- Будувати scatter matrices для багатовимірних даних
🔑 Ключові терміни
- Scatter plot — точкова діаграма, що показує взаємозв'язок між двома змінними
- Кореляція — міра лінійного зв'язку між змінними (−1 до +1)
- Regression line — лінія тренду, що найкраще апроксимує дані
- Scatter matrix — матриця точкових діаграм для всіх пар змінних
Плавний старт: Scatter plot за 3 рядки коду
Коли перед дата-аналітиком чи інженером постає фундаментальне питання: «Чи існує зв'язок між параметром X та показником Y?», найперший та найінформативніший інструмент — це точкова діаграма (scatter plot).
Погляньмо, як від трьох мінімальних рядків коду перейти до повноцінного інженерного графіка з лінією тренду:
Три рівні створення точкової діаграми
Від миттєвої побудови сирих точок до інформативного графіка з оцінкою тренду
import matplotlib.pyplot as plt
import numpy as np

# Змодельовані дані навантаження сервера: паралельні з'єднання vs затримка (мс)
rng = np.random.default_rng(42)
connections = rng.uniform(10, 200, 45)
latency = 25 + 0.35 * connections + rng.normal(0, 12, 45)

# --- РІВЕНЬ 0: Мінімальний код (3 рядки) ---
plt.scatter(connections, latency)
plt.show()

# --- РІВЕНЬ 1: Додавання контексту та одиниць виміру ---
fig, ax = plt.subplots(figsize=(6, 4))
ax.scatter(connections, latency, color='#2563eb', s=45)
ax.set_xlabel("Паралельні з'єднання (conn)")
ax.set_ylabel("Затримка відповіді Latency (ms)")
ax.set_title("Навантаження vs Затримка")
plt.show()

# --- РІВЕНЬ 2: Професійний інженерний графік з лінією тренду ---
fig, ax = plt.subplots(figsize=(7, 4.5))
ax.scatter(connections, latency, s=70, color='#3b82f6',
           edgecolor='#1e3a8a', linewidth=1, alpha=0.75, label="Логи запитів")

# Розрахунок та візуалізація лінійного тренду (y = ax + b)
z = np.polyfit(connections, latency, 1)
p = np.poly1d(z)
x_line = np.linspace(connections.min(), connections.max(), 100)
ax.plot(x_line, p(x_line), color='#ef4444', linestyle='--', linewidth=2,
        label=f"Тренд: {z[0]:.2f}x + {z[1]:.1f}")

ax.set_title("Діагностика затримки API-шлюзу", fontsize=12, fontweight='bold')
ax.set_xlabel("Паралельні з'єднання (conn)", fontsize=10)
ax.set_ylabel("Затримка відповіді Latency (ms)", fontsize=10)
ax.grid(True, linestyle=':', alpha=0.6)
ax.legend(frameon=True, facecolor='#f8fafc', edgecolor='#cbd5e1')
plt.show()
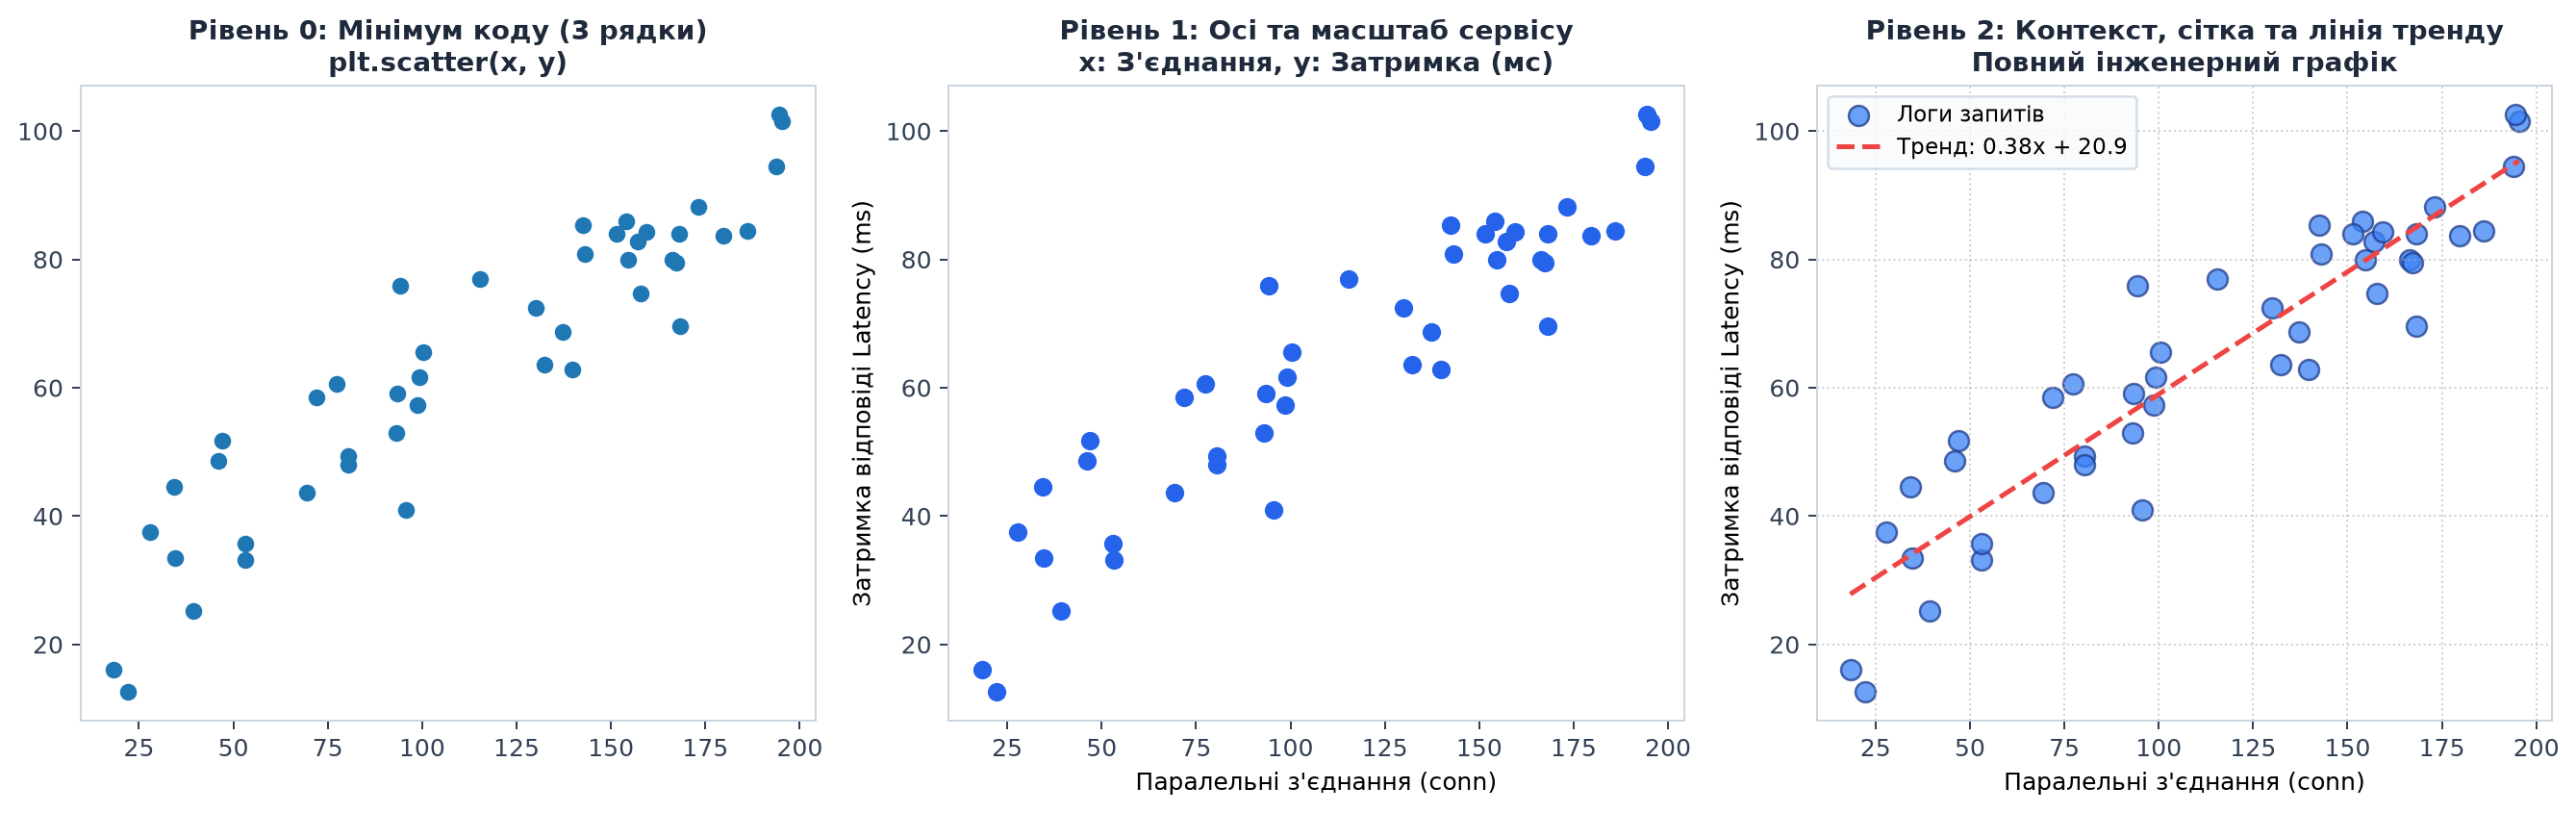
Чому Scatter Plot незамінний у дослідженні даних?
- Миттєве зчитування кореляції: людське око за частки секунди визначає напрямок нахилу хмари точок (вгору-вправо — зв'язок прямий, вниз-вправо — зворотний).
- Збереження кожного спостереження: на відміну від усереднених метрик (mean, median), scatter plot демонструє кожне окреме вимірювання, уможливлюючи виявлення прихованих викидів.
- Виявлення кластерів та нелінійності: розриви між групами або параболічні вигини неможливо зафіксувати однією цифрою — їх видно лише на графіку.
🧭 Наскрізна інженерна історія: Діагностика хмарного AI-сервісу
Уявіть, що ви — SRE/DevOps інженер у команді розподіленого AI-сервісу. Останніми днями система фіксує періодичну деградацію часу відповіді (Latency spikes) під час пікових навантажень.
Перед вами стоїть комплексне завдання розслідування:
- Крок 1 (Scatter): Чи є пряма залежність між кількістю активних користувачів та затримкою обробки запитів?
- Крок 2 (Кореляція vs Нелінійність): Чи справді затримка зростає лінійно, або при заповненні буфера пам'яті виникає квадратичний стрибок?
- Крок 3 (Лінія регресії): За якої критичної кількості запитів система вийде за межі регламентованого SLA (наприклад, понад 100 мс)?
- Крок 4 (4D Bubble Chart): Як додати на один графік два додаткові виміри — навантаження CPU (%) кольором та розмір запиту (Payload KB) діаметром точки?
- Крок 5 (Hexbin): Як відобразити 100 000 запитів без ризику перетворити графік на неінформативну суцільну пляму?
- Крок 6 (Кореляційна матриця): Як звести десятки системних метрик кластера в наочну теплову карту взаємозв'язків?
Розгляньмо кожен із цих аналітичних інструментів послідовно.
Історія про рієлтора та площу квартир
Рієлтор Олена хоче зрозуміти, чи справді ціна квартири залежить від площі. У неї є дані по 100 квартирах: площа та ціна.
Перший інстинкт — подивитися на таблицю:
Площа (м²) | Ціна ($)
-----------|----------
45         | 35 000
72         | 52 000
110        | 89 000
38         | 28 000
...        | ...
Важко побачити закономірність. А тепер — один графік:
Залежність ціни квартири від площі
Один графік показує більше, ніж 100 рядків таблиці
import matplotlib.pyplot as plt
import numpy as np

# Генеруємо реалістичні дані: ціна приблизно пропорційна площі + шум
rng = np.random.default_rng(seed=42)
area = rng.uniform(30, 150, 100)  # Площа 30–150 м²
price = 500 * area + rng.normal(0, 8000, 100)  # ~500$/м² + шум

fig, ax = plt.subplots(figsize=(10, 6))

ax.scatter(area, price, alpha=0.6, s=80, color="steelblue", edgecolor="navy")

ax.set_title("Залежність ціни квартири від площі",
             fontsize=14, fontweight="bold")
ax.set_xlabel("Площа (м²)", fontsize=12)
ax.set_ylabel("Ціна ($)", fontsize=12)
ax.grid(True, alpha=0.3)

# Додаємо лінію тренду для наочності
z = np.polyfit(area, price, 1)  # Лінійна регресія
p = np.poly1d(z)
ax.plot(area, p(area), color="red", linestyle="--", linewidth=2,
        label=f"Trend: ціна ≈ {z[0]:.0f}·площа + {z[1]:.0f}")
ax.legend(fontsize=11)

plt.tight_layout()
plt.show()
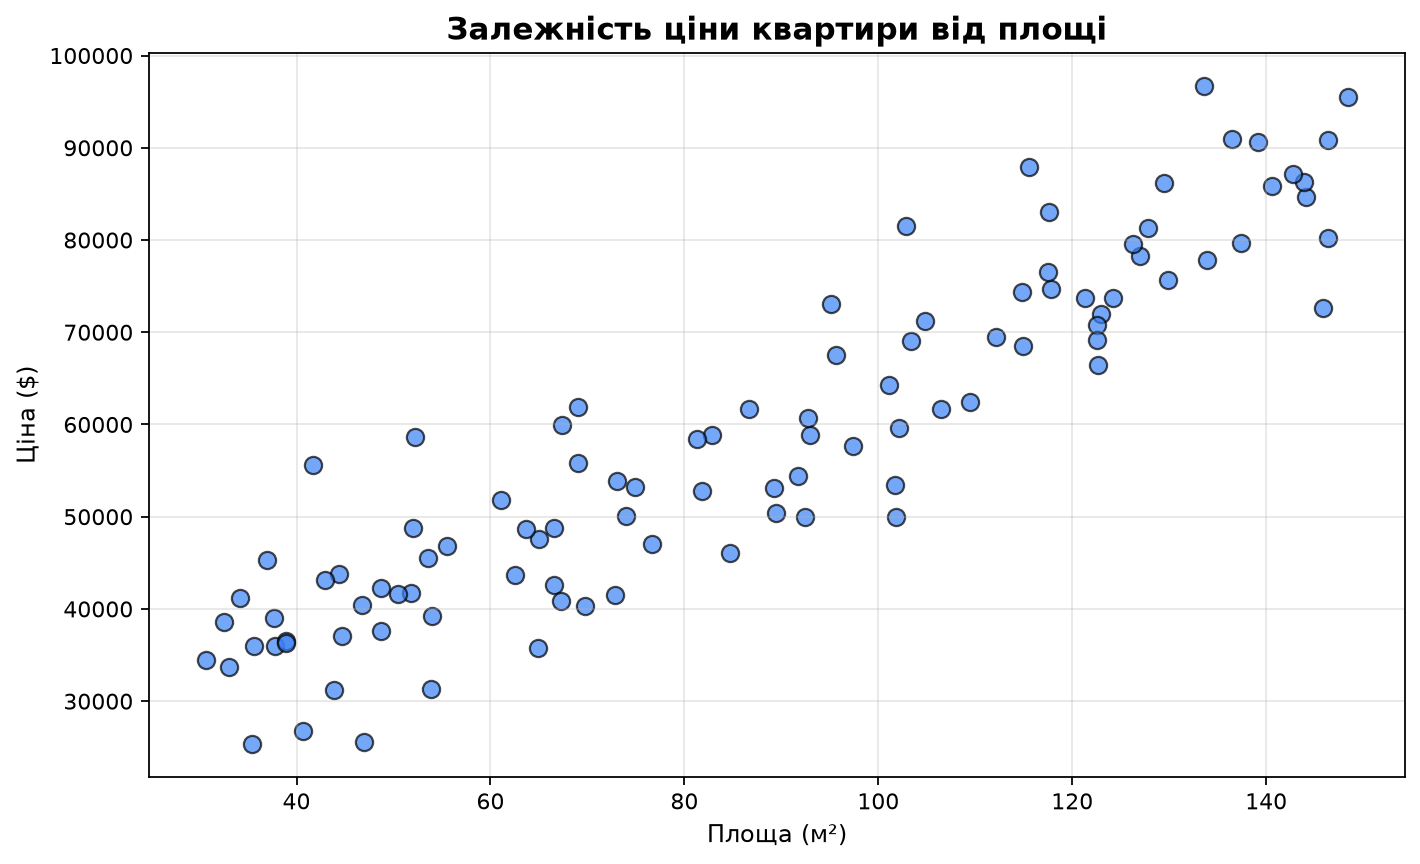
Висновки одразу видно:
- Чіткий позитивний зв'язок: більша площа → вища ціна
- Зв'язок майже лінійний (точки близько до прямої)
- Є розкид (шум): не всі квартири однакової площі коштують однаково (впливають інші фактори)
- Лінія тренду показує: ~500$ за кожен м²
Це неможливо побачити в таблиці з 100 рядків!
- Scatter plot візуалізує те, що описує коефіцієнт кореляції Пірсона
- Якщо точки йдуть «вгору вправо» — позитивна кореляція (r > 0)
- Якщо «вниз вправо» — негативна кореляція (r < 0)
- Якщо хаос — немає лінійного зв'язку (r ≈ 0)
- Чим щільніше точки до прямої — тим сильніша кореляція (|r| ближче до 1)
Scatter Plots — точкові діаграми для двох змінних
Що таке scatter plot?
Scatter plot — це графік, де кожна точка представляє одне спостереження з двома координатами: значення змінної X та значення змінної Y.
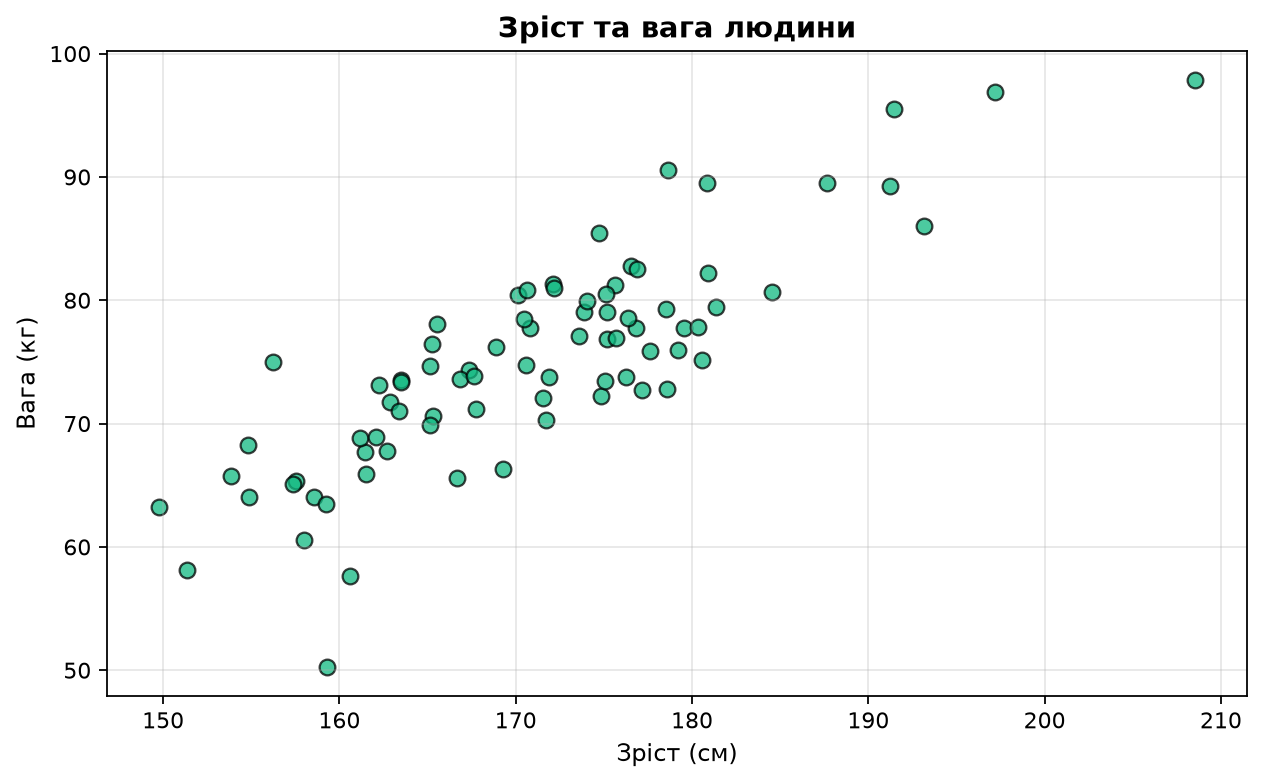
Аналогія: уявіть, що ви вимірювали зріст та вагу 100 людей. Кожна людина — це одна точка на графіку: по горизонталі — зріст, по вертикалі — вага. Якщо точки йдуть «вгору вправо» — вищі люди зазвичай важчі (позитивна кореляція).
Базовий scatter plot
import matplotlib.pyplot as plt
import numpy as np

# Дані: годин навчання → бали на іспиті (50 студентів)
rng = np.random.default_rng(seed=123)
hours_studied = rng.uniform(1, 10, 50)
exam_scores = 40 + 5 * hours_studied + rng.normal(0, 5, 50)

fig, ax = plt.subplots(figsize=(10, 6))

ax.scatter(hours_studied, exam_scores, s=100, alpha=0.6,
           color="coral", edgecolor="darkred", linewidth=1.5)

ax.set_title("Залежність балів на іспиті від годин навчання",
             fontsize=14, fontweight="bold")
ax.set_xlabel("Години навчання", fontsize=12)
ax.set_ylabel("Бали на іспиті (0–100)", fontsize=12)
ax.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
ax.scatter():ax.scatter(x, y,
s=50, # Розмір точок (size)
c="blue", # Колір (може бути масивом для кольорової карти)
alpha=0.7, # Прозорість (0 = невидимий, 1 = непрозорий)
marker="o", # Форма маркера ("o", "s", "^", "D", "*")
edgecolor="black", # Колір обведення точок
linewidth=1) # Товщина обведення
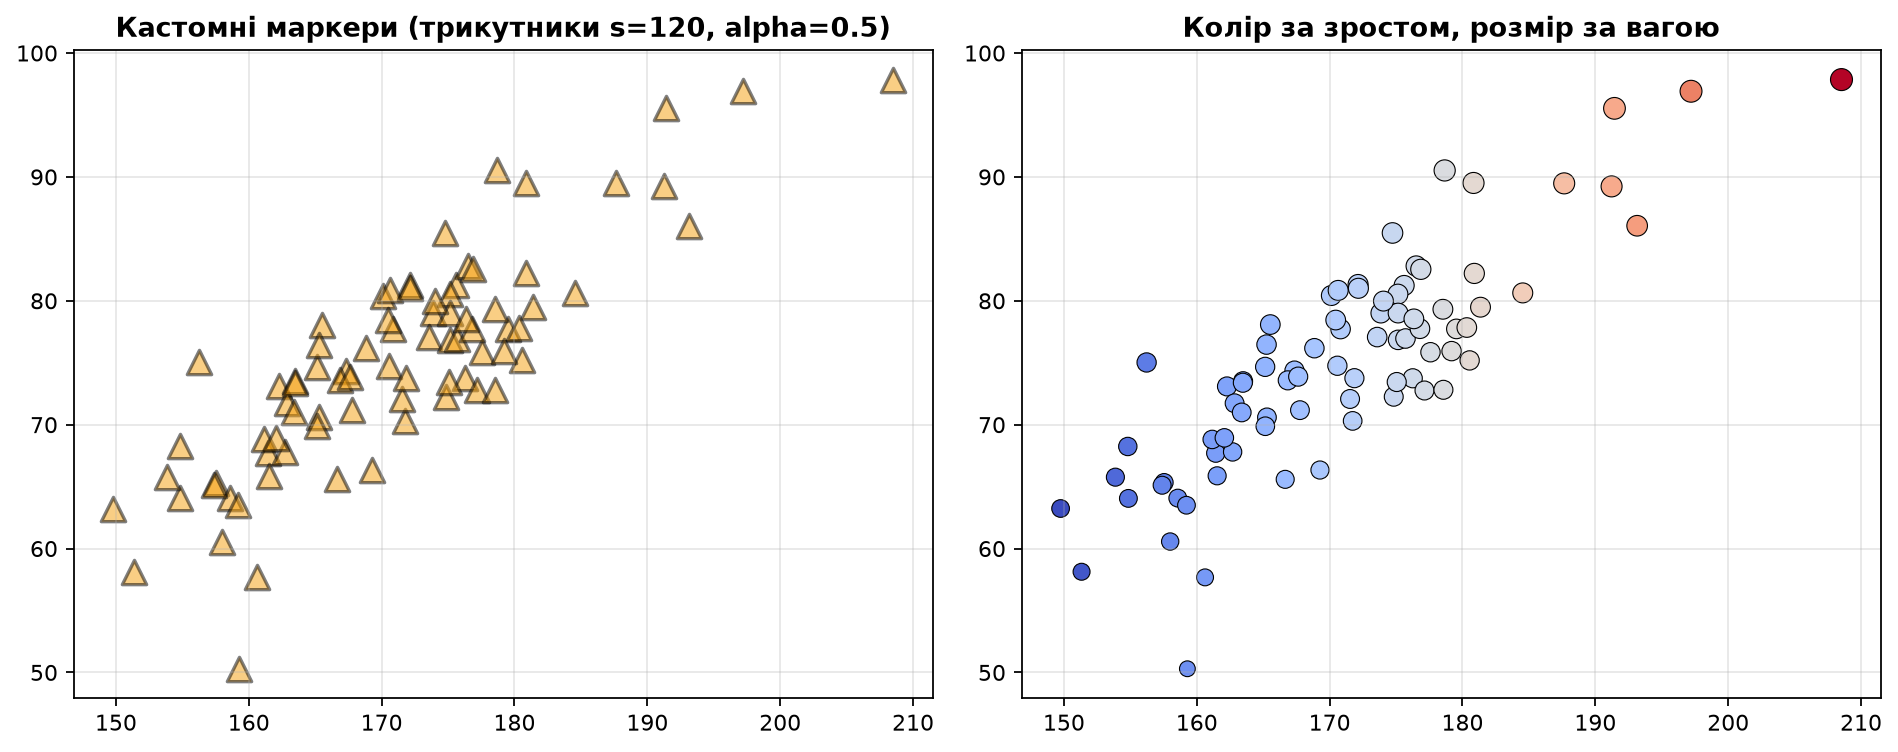 Рекомендації:
s=50–100для звичайних графіківalpha=0.5–0.7якщо точки перекриваютьсяedgecolorдодає контраст (особливо на світлих фонах)
Повна сигнатура та анатомія параметрів ax.scatter()
Метод ax.scatter() створює об'єкт PathCollection, оптимізований для індивідуального керування кожною точкою (на відміну від ax.plot(), де всі маркери мають однаковий стиль).
ax.scatter(
    x, y,
    s=None,
    c=None,
    marker=None,
    cmap=None,
    norm=None,
    vmin=None,
    vmax=None,
    alpha=None,
    linewidths=None,
    edgecolors=None,
    plotnonfinite=False,
    data=None,
    **kwargs
) -> PathCollection
| Параметр | Тип | За замовчуванням | Опис та інженерне призначення |
|---|---|---|---|
x, y | ArrayLike | обов'язкові | Координати точок (одновимірні масиви або Series однакової довжини). |
s | float | ArrayLike | rcParams['lines.markersize']**2 (~36) | Розмір точок у $pt^2$ (площа, а не радіус!). Може бути масивом для Bubble chart. |
c | color | ArrayLike | None | Колір точок. Якщо передати числовий масив — значення відображаються через cmap. |
marker | str | MarkerStyle | 'o' (коло) | Форма маркера: 'o' (коло), 's' (квадрат), '^' (трикутник), 'D' (ромб), 'X' (хрест), '*' (зірка). |
cmap | str | Colormap | None (rcParams) | Назва колірної карти ('viridis', 'plasma', 'coolwarm'), якщо c — числовий масив. |
norm | Normalize | None | Нормалізатор числових значень (наприклад, Normalize(vmin, vmax) або LogNorm()). |
vmin, vmax | float | None | Явні межі значень для прив'язки кольорів палітри. |
alpha | float | None (1.0) | Прозорість від 0.0 (повністю прозорий) до 1.0 (непрозорий). Ключ до боротьби з перекриттям. |
linewidths | float | Sequence | 1.5 | Товщина обведення контуру маркера. |
edgecolors | color | 'none' | 'face' | 'face' | Колір контуру маркера. Контрастний контур (наприклад, темно-синій або чорний) відділяє накладені точки. |
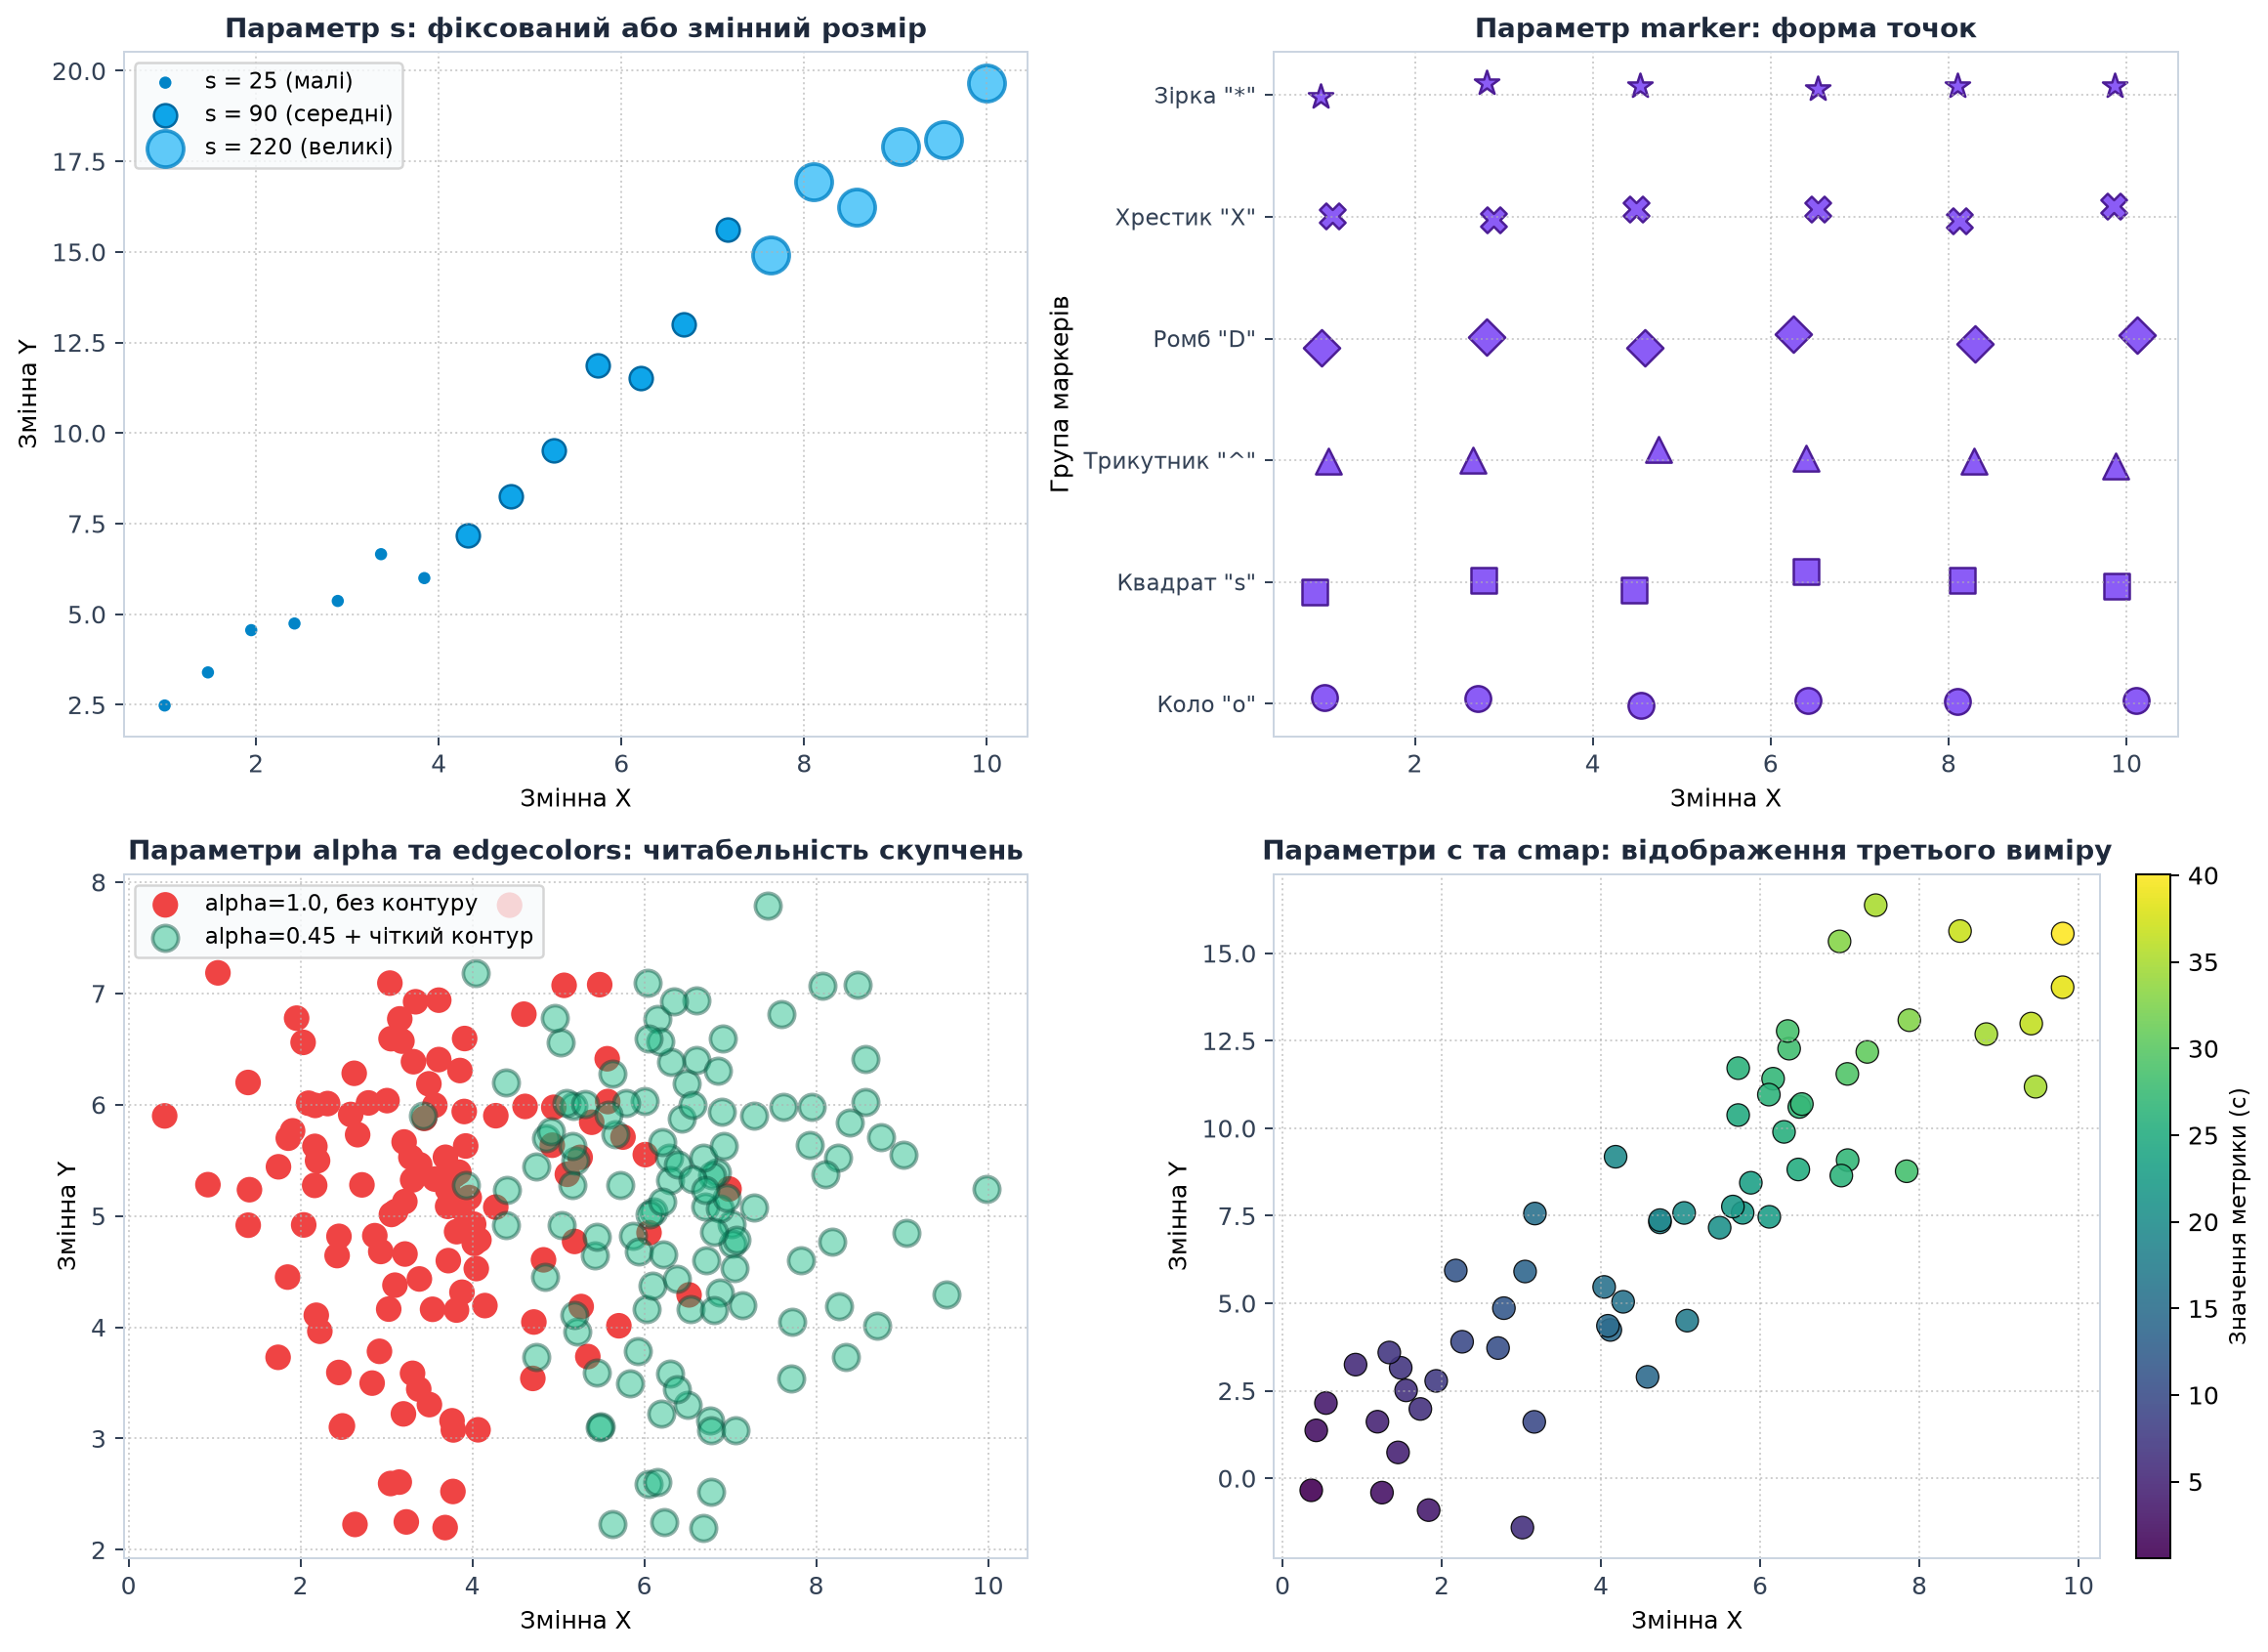
Візуальне дослідження параметрів ax.scatter()
Порівняння розмірів, типів маркерів, прозорості з обведенням та колірного кодування
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(42)
fig, axes = plt.subplots(2, 2, figsize=(13, 9.5))

# 1. Параметр s: малі, середні та великі маркери
x_s = np.linspace(1, 10, 20)
y_s = 2 * x_s + rng.normal(0, 1, 20)
axes[0, 0].scatter(x_s[:7], y_s[:7], s=25, color='#0284c7', label="s = 25 (малі)")
axes[0, 0].scatter(x_s[7:14], y_s[7:14], s=90, color='#0ea5e9', edgecolor='#0369a1', linewidth=1, label="s = 90 (середні)")
axes[0, 0].scatter(x_s[14:], y_s[14:], s=220, color='#38bdf8', edgecolor='#0284c7', linewidth=1.5, alpha=0.8, label="s = 220 (великі)")
axes[0, 0].set_title("Параметр s: фіксований або змінний розмір", fontweight='bold')
axes[0, 0].legend()
axes[0, 0].grid(True, linestyle=':', alpha=0.6)

# 2. Параметр marker: спектр геометричних форм
markers = [('o', 'Коло "o"'), ('s', 'Квадрат "s"'), ('^', 'Трикутник "^"'),
           ('D', 'Ромб "D"'), ('X', 'Хрестик "X"'), ('*', 'Зірка "*"')]
for i, (m, lbl) in enumerate(markers):
    xm = np.linspace(1, 10, 6) + rng.uniform(-0.15, 0.15, 6)
    ym = np.full(6, i + 1) + rng.uniform(-0.1, 0.1, 6)
    axes[0, 1].scatter(xm, ym, marker=m, s=110, color='#8b5cf6', edgecolor='#4c1d95', linewidth=1)
axes[0, 1].set_yticks(range(1, 7))
axes[0, 1].set_yticklabels([m[1] for m in markers])
axes[0, 1].set_title("Параметр marker: форма точок", fontweight='bold')
axes[0, 1].grid(True, linestyle=':', alpha=0.6)

# 3. Параметри alpha та edgecolors: читабельність скупчень
x_c = rng.normal(5, 1.2, 120)
y_c = rng.normal(5, 1.2, 120)
axes[1, 0].scatter(x_c - 1.5, y_c, s=110, color='#ef4444', alpha=1.0, edgecolor='none', label="alpha=1.0 (злипання)")
axes[1, 0].scatter(x_c + 1.5, y_c, s=110, color='#10b981', alpha=0.45, edgecolor='#064e3b', linewidth=1.5, label="alpha=0.45 + контур")
axes[1, 0].set_title("Параметри alpha та edgecolors: розрізнення густини", fontweight='bold')
axes[1, 0].legend(loc='upper left')
axes[1, 0].grid(True, linestyle=':', alpha=0.6)

# 4. Параметри c та cmap: відображення третього виміру
x_d = rng.uniform(0, 10, 60)
y_d = 1.5 * x_d + rng.normal(0, 2, 60)
c_vals = x_d * 2.5 + y_d
sc = axes[1, 1].scatter(x_d, y_d, c=c_vals, cmap='viridis', s=85, edgecolor='black', linewidth=0.5, alpha=0.9)
cbar = fig.colorbar(sc, ax=axes[1, 1], fraction=0.046, pad=0.04)
cbar.set_label("Значення метрики (c)")
axes[1, 1].set_title("Параметри c та cmap: числовий колірний градієнт", fontweight='bold')
axes[1, 1].grid(True, linestyle=':', alpha=0.6)

plt.tight_layout()
plt.show()
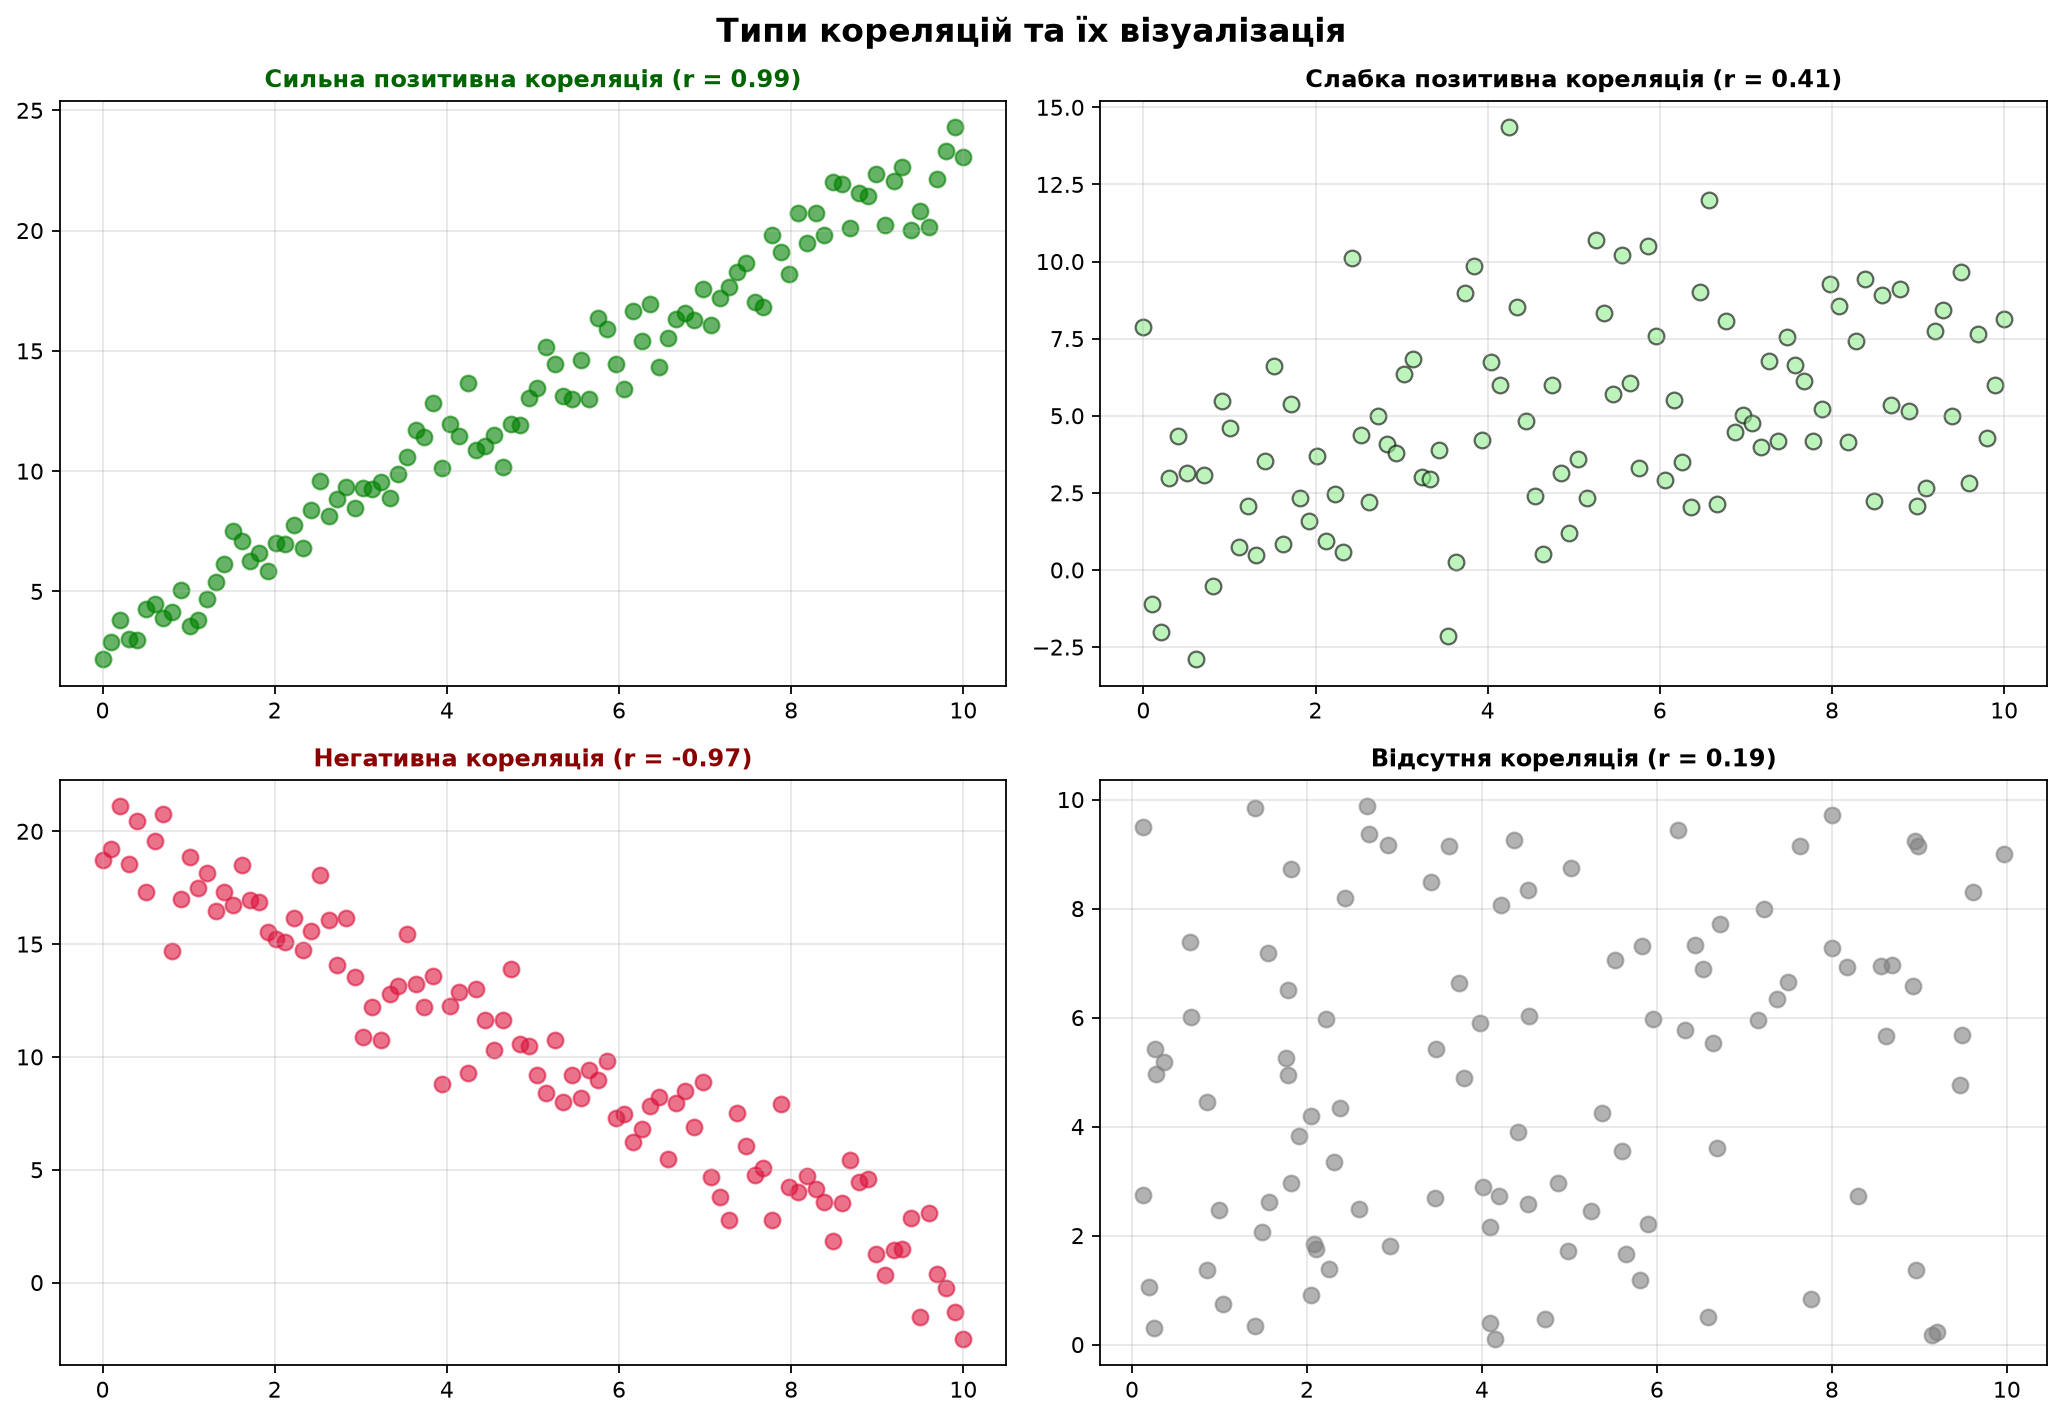
Види кореляцій та їх візуалізація
Scatter plot одразу показує тип зв'язку між змінними.
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(seed=42)

fig, axes = plt.subplots(2, 2, figsize=(14, 10))
fig.suptitle("Типи кореляцій та їх візуалізація", fontsize=16, fontweight="bold")

# 1. Сильна позитивна кореляція (r ≈ +0.95)
x1 = np.linspace(0, 10, 100)
y1 = 2 * x1 + 3 + rng.normal(0, 1, 100)
r1 = np.corrcoef(x1, y1)[0, 1]
axes[0, 0].scatter(x1, y1, alpha=0.6, color="green", s=60)
axes[0, 0].set_title(f"Сильна позитивна кореляція\nr = {r1:.2f}",
                     fontsize=12, fontweight="bold", color="darkgreen")
axes[0, 0].set_xlabel("Змінна X")
axes[0, 0].set_ylabel("Змінна Y")
axes[0, 0].grid(True, alpha=0.3)

# 2. Сильна негативна кореляція (r ≈ −0.92)
x2 = np.linspace(0, 10, 100)
y2 = 50 - 3 * x2 + rng.normal(0, 1.5, 100)
r2 = np.corrcoef(x2, y2)[0, 1]
axes[0, 1].scatter(x2, y2, alpha=0.6, color="red", s=60)
axes[0, 1].set_title(f"Сильна негативна кореляція\nr = {r2:.2f}",
                     fontsize=12, fontweight="bold", color="darkred")
axes[0, 1].set_xlabel("Змінна X")
axes[0, 1].set_ylabel("Змінна Y")
axes[0, 1].grid(True, alpha=0.3)

# 3. Слабка кореляція (r ≈ +0.3)
x3 = rng.uniform(0, 10, 100)
y3 = 0.5 * x3 + rng.normal(0, 4, 100)
r3 = np.corrcoef(x3, y3)[0, 1]
axes[1, 0].scatter(x3, y3, alpha=0.6, color="orange", s=60)
axes[1, 0].set_title(f"Слабка позитивна кореляція\nr = {r3:.2f}",
                     fontsize=12, fontweight="bold", color="darkorange")
axes[1, 0].set_xlabel("Змінна X")
axes[1, 0].set_ylabel("Змінна Y")
axes[1, 0].grid(True, alpha=0.3)

# 4. Немає кореляції (r ≈ 0)
x4 = rng.uniform(0, 10, 100)
y4 = rng.uniform(0, 10, 100)
r4 = np.corrcoef(x4, y4)[0, 1]
axes[1, 1].scatter(x4, y4, alpha=0.6, color="gray", s=60)
axes[1, 1].set_title(f"Немає лінійної кореляції\nr = {r4:.2f}",
                     fontsize=12, fontweight="bold", color="black")
axes[1, 1].set_xlabel("Змінна X")
axes[1, 1].set_ylabel("Змінна Y")
axes[1, 1].grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
- Продажі морозива ↔ Кількість утоплень (r ≈ +0.9)
- Причина: обидві зростають влітку (третя змінна — температура)
- Морозиво не спричиняє утоплення!
- Кількість пожежників на місці ↔ Збитки від пожежі (r ≈ +0.85)
- Більше пожежників → більші збитки? НІ!
- Третя змінна: розмір пожежі (на велику пожежу відправляють більше людей)
Лінійні vs нелінійні залежності
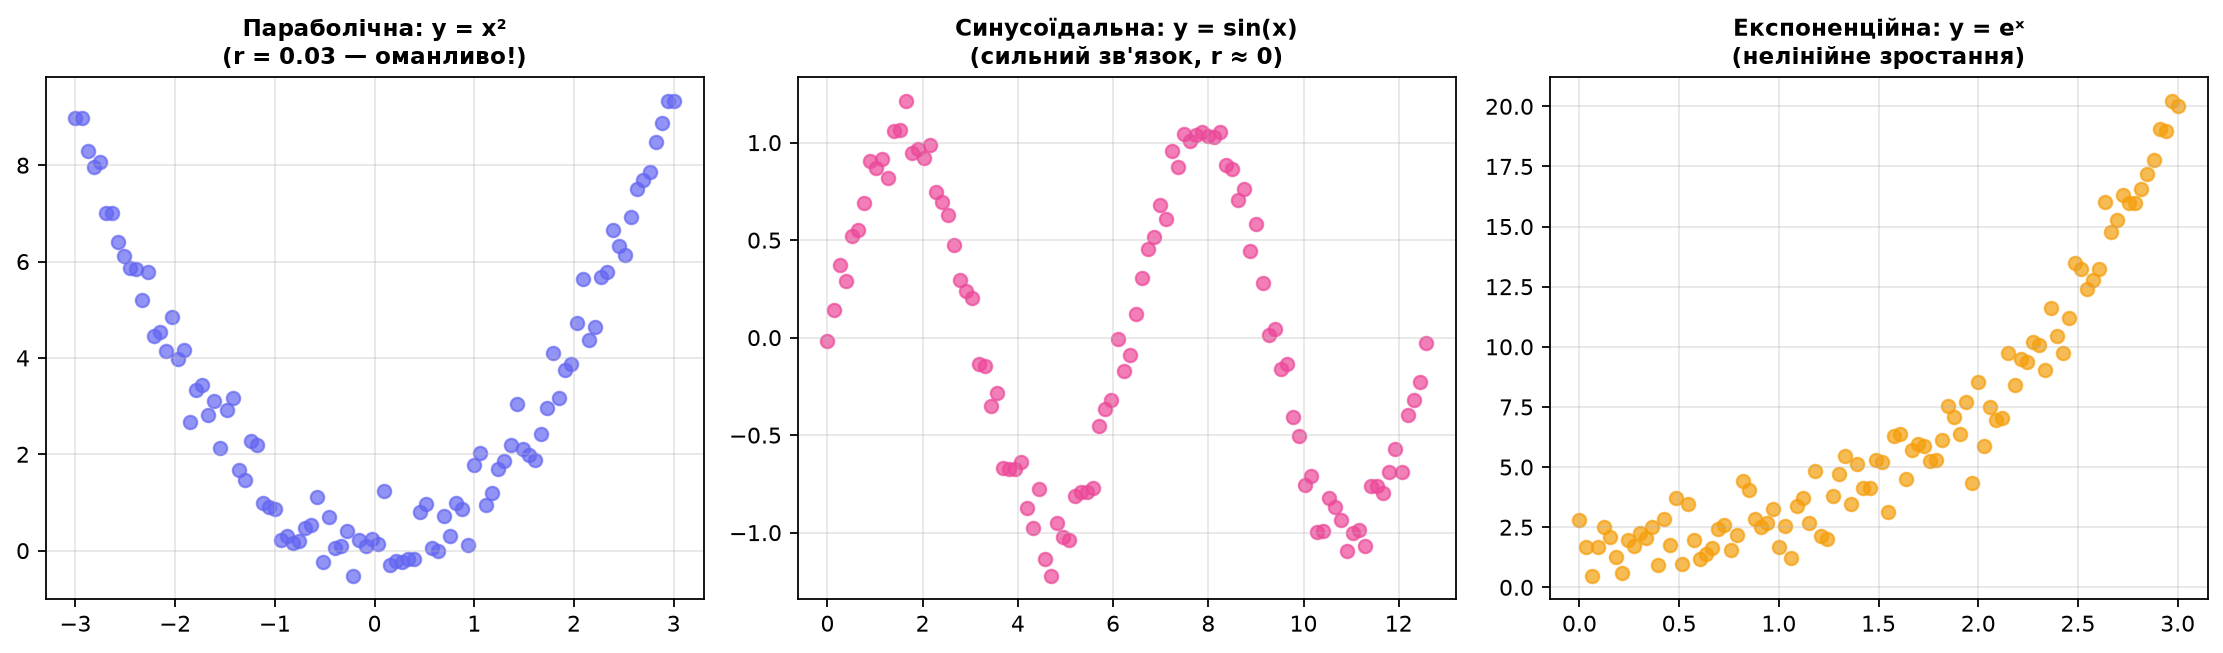
Коефіцієнт кореляції Пірсона вимірює лише лінійний зв'язок. Scatter plot може показати нелінійні залежності, які кореляція не бачить.
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(seed=42)

fig, axes = plt.subplots(1, 3, figsize=(16, 5))
fig.suptitle("Лінійні vs нелінійні залежності", fontsize=15, fontweight="bold")

# 1. Лінійна залежність (r показує правильно)
x1 = np.linspace(0, 10, 100)
y1 = 2 * x1 + rng.normal(0, 2, 100)
r1 = np.corrcoef(x1, y1)[0, 1]

axes[0].scatter(x1, y1, alpha=0.6, color="blue", s=50)
axes[0].set_title(f"Лінійна залежність\nr = {r1:.2f} (адекватно)", fontweight="bold")
axes[0].set_xlabel("X")
axes[0].set_ylabel("Y")
axes[0].grid(True, alpha=0.3)

# 2. Квадратична залежність (r близький до 0, але зв'язок очевидний!)
x2 = np.linspace(-5, 5, 100)
y2 = x2**2 + rng.normal(0, 2, 100)
r2 = np.corrcoef(x2, y2)[0, 1]

axes[1].scatter(x2, y2, alpha=0.6, color="red", s=50)
axes[1].set_title(f"Квадратична залежність\nr = {r2:.2f} (вводить в оману!)",
                  fontweight="bold", color="darkred")
axes[1].set_xlabel("X")
axes[1].set_ylabel("Y = X²")
axes[1].grid(True, alpha=0.3)

# 3. Синусоїдальна залежність (r ≈ 0, але чіткий паттерн)
x3 = np.linspace(0, 4*np.pi, 100)
y3 = np.sin(x3) + rng.normal(0, 0.1, 100)
r3 = np.corrcoef(x3, y3)[0, 1]

axes[2].scatter(x3, y3, alpha=0.6, color="green", s=50)
axes[2].set_title(f"Періодична залежність\nr = {r3:.2f} (не бачить паттерн)",
                  fontweight="bold", color="darkgreen")
axes[2].set_xlabel("X")
axes[2].set_ylabel("Y = sin(X)")
axes[2].grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
- Середнє X ≈ 9.0
- Середнє Y ≈ 7.5
- Кореляція r ≈ 0.816
- Регресійна лінія ідентична
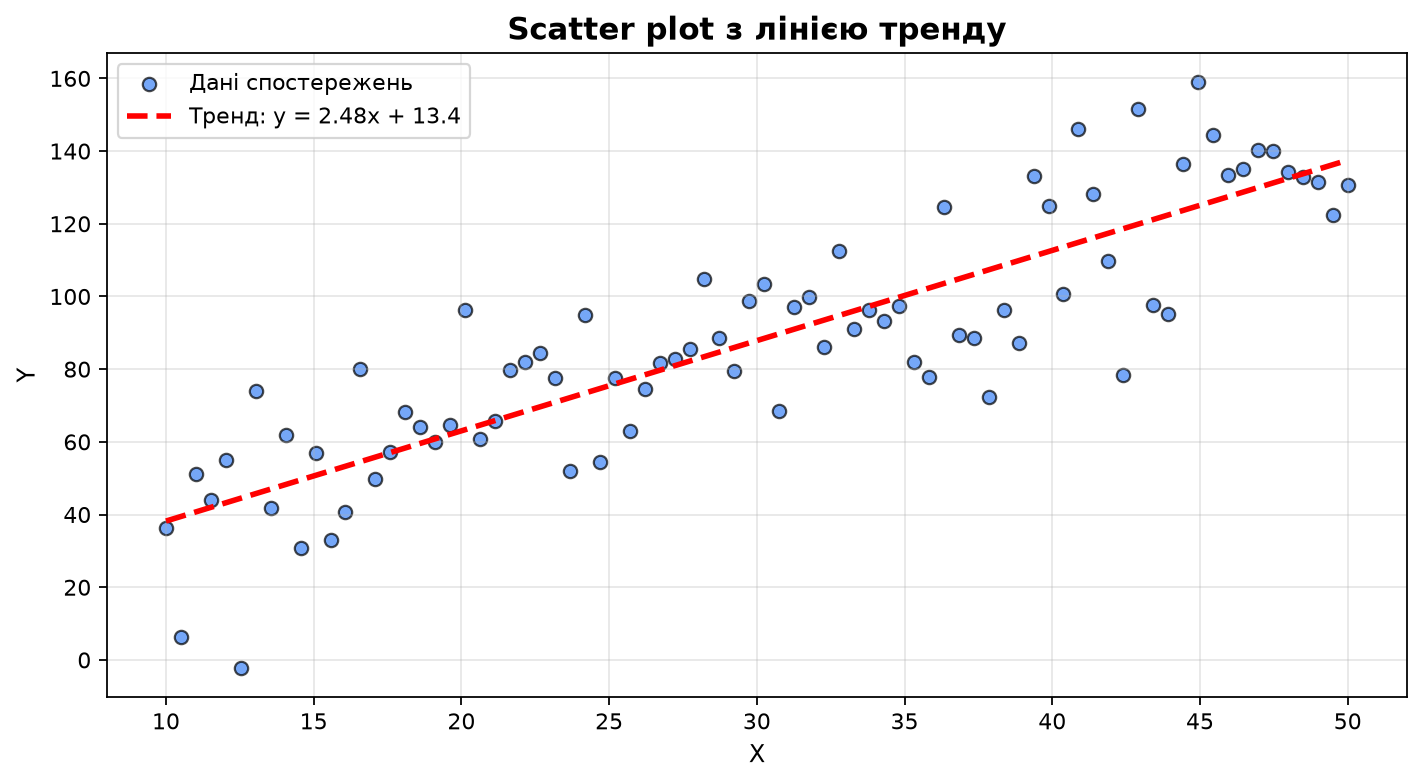
Додавання лінії тренду (regression line)
Лінія тренду допомагає побачити загальну тенденцію навіть у розкиданих даних.
import matplotlib.pyplot as plt
import numpy as np

# Дані: досвід роботи (роки) → зарплата ($)
rng = np.random.default_rng(seed=42)
experience = rng.uniform(0, 15, 80)
salary = 30000 + 3500 * experience + rng.normal(0, 8000, 80)

fig, ax = plt.subplots(figsize=(10, 6))

# Scatter plot
ax.scatter(experience, salary, alpha=0.6, s=70, color="purple",
           edgecolor="darkviolet", label="Дані")

# Лінія тренду (лінійна регресія)
z = np.polyfit(experience, salary, 1)  # Поліном 1-го ступеня (пряма)
p = np.poly1d(z)

x_trend = np.linspace(experience.min(), experience.max(), 100)
ax.plot(x_trend, p(x_trend), color="red", linestyle="--", linewidth=2.5,
        label=f"Trend: зарплата ≈ {z[0]:.0f}·досвід + {z[1]:.0f}")

ax.set_title("Залежність зарплати від досвіду роботи",
             fontsize=14, fontweight="bold")
ax.set_xlabel("Досвід роботи (роки)", fontsize=12)
ax.set_ylabel("Зарплата ($)", fontsize=12)
ax.legend(fontsize=11)
ax.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
# Метод 1: NumPy polyfit (універсальний)
z = np.polyfit(x, y, deg=1)  # deg=1 → пряма, deg=2 → парабола
p = np.poly1d(z)
ax.plot(x_sorted, p(x_sorted), color="red", linestyle="--")

# Метод 2: SciPy linregress (більше статистики)
from scipy.stats import linregress
slope, intercept, r_value, p_value, std_err = linregress(x, y)
ax.plot(x_sorted, slope * x_sorted + intercept, color="red")
print(f"R²= {r_value**2:.3f}")  # Коефіцієнт детермінації

# Метод 3: Seaborn regplot (найпростіше, але потребує seaborn)
import seaborn as sns
sns.regplot(x=x, y=y, ax=ax, scatter_kws={"alpha": 0.5})
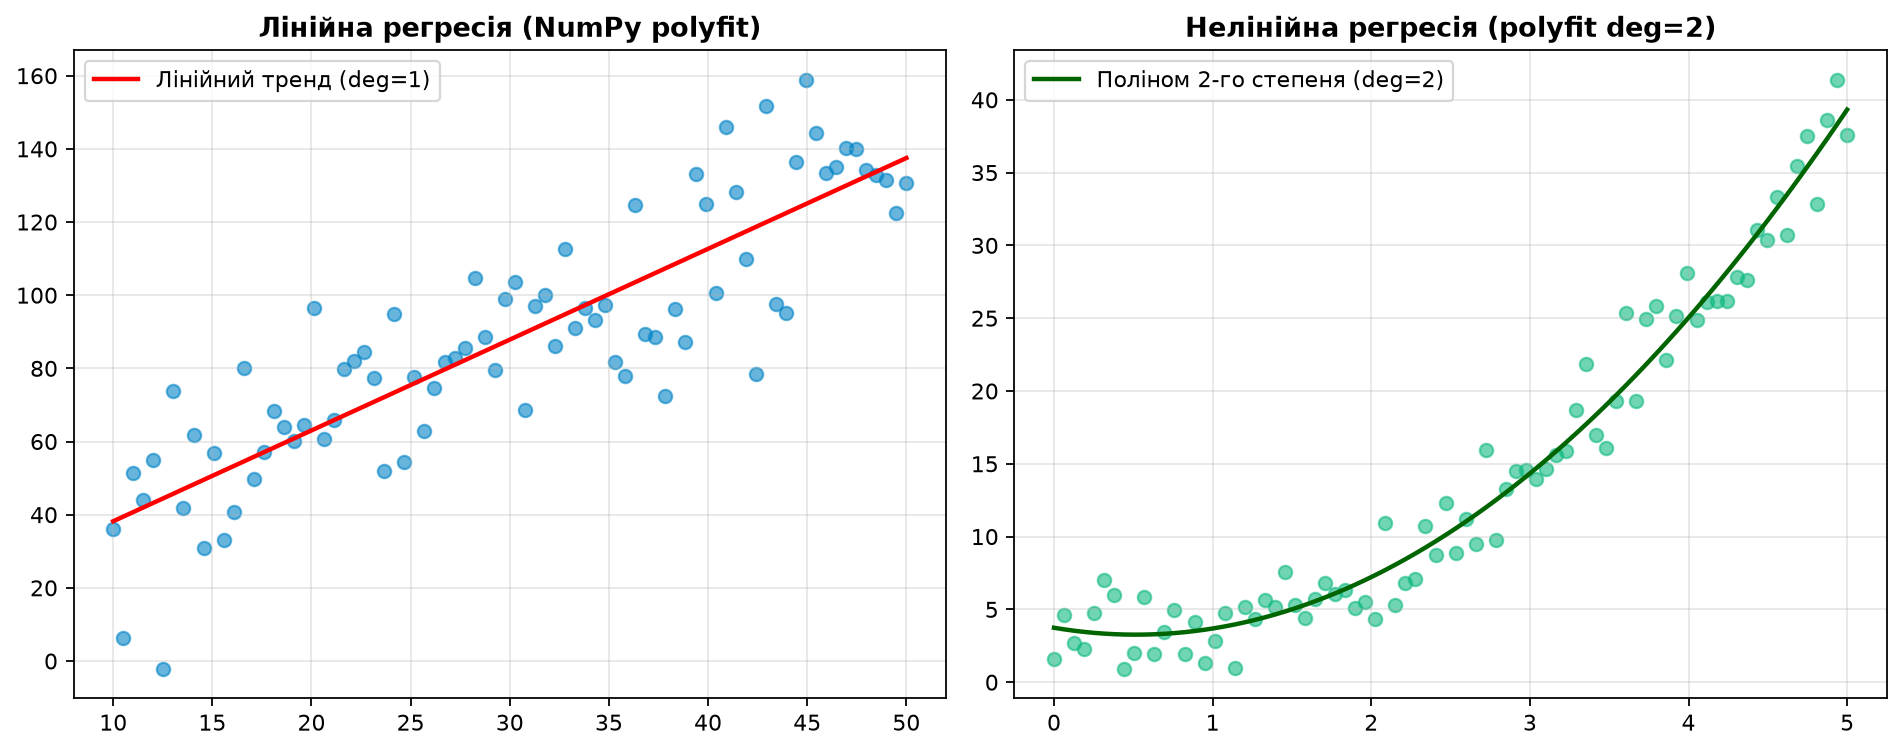
Математичний апарат трендів: сигнатура np.polyfit та вибір ступеня полінома
Лінія тренду є результатом підгонки математичної моделі за методом найменших квадратів (OLS — Ordinary Least Squares). Функція np.polyfit() обчислює коефіцієнти полінома $p(x) = c_d x^d + c_ x^{d-1} + \dots + c_1 x + c_0$, що мінімізує суму квадратичних відхилень від точок даних.
np.polyfit(
    x, y,
    deg: int,
    rcond: float | None = None,
    full: bool = False,
    w: np.ndarray | None = None,
    cov: bool | str = False
) -> np.ndarray | tuple
| Параметр | Тип | За замовчуванням | Опис та інженерне значення |
|---|---|---|---|
x, y | ArrayLike | обов'язкові | Масиви координат спостережень однакового розміру. |
deg | int | обов'язковий | Степінь апроксимуючого полінома: 1 — пряма, 2 — парабола, 3 — кубічна крива. |
w | ArrayLike | None | None | Ваги для точок даних ($w_i = 1/\sigma_i$). Дозволяє враховувати точність окремих вимірів. |
full | bool | False | Якщо True, повертає додаткову діагностику: нев'язки (residuals), ранг матриці, сингулярні числа. |
cov | bool | str | False | Якщо True, повертає коваріаційну матрицю оцінених коефіцієнтів (для побудови довірчих інтервалів). |
Дослідження степенів полінома: від наближення до оверфіттінгу
Порівняння лінійної апроксимації (deg=1), параболи (deg=2), кубічного тренду (deg=3) та небезпеки перенавчання (deg=10)
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(42)
x = np.linspace(1, 10, 40)
# Нелінійний процес із шумом: сповільнений логарифмічний ріст + прискорення наприкінці
y = 3.5 * np.log(x) + 0.15 * (x - 4)**2 + rng.normal(0, 0.4, 40)
x_dense = np.linspace(1, 10, 200)

fig, axes = plt.subplots(2, 2, figsize=(13, 9.5))
degs = [1, 2, 3, 10]
configs = [
    ("deg=1 (Лінійний тренд)", "Підходить для строго лінійних залежностей", '#dc2626'),
    ("deg=2 (Квадратична парабола)", "Враховує прискорення росту або вигин", '#2563eb'),
    ("deg=3 (Кубічний поліном)", "Гнучка апроксимація складної траєкторії", '#16a34a'),
    ("deg=10 (Оверфіттінг / Перенавчання)", "Небезпека: модель апроксимує випадковий шум!", '#d97706')
]

for idx, (deg, (t_main, t_sub, col)) in enumerate(zip(degs, configs)):
    ax = axes[idx // 2, idx % 2]
    ax.scatter(x, y, color='#475569', s=55, alpha=0.75, edgecolor='#0f172a', label="Виміри")

    # Розрахунок полінома
    coefs = np.polyfit(x, y, deg)
    poly = np.poly1d(coefs)
    y_dense = poly(x_dense)

    if deg == 10:
        ax.set_ylim(y.min() - 1.5, y.max() + 1.5)

    ax.plot(x_dense, y_dense, color=col, linewidth=2.2, label=f"polyfit(deg={deg})")
    ax.set_title(f"{t_main}\n{t_sub}", fontweight='bold')
    ax.set_xlabel("Навантаження (X)")
    ax.set_ylabel("Час виконання (Y)")
    ax.grid(True, linestyle=':', alpha=0.6)
    ax.legend()

plt.tight_layout()
plt.show()
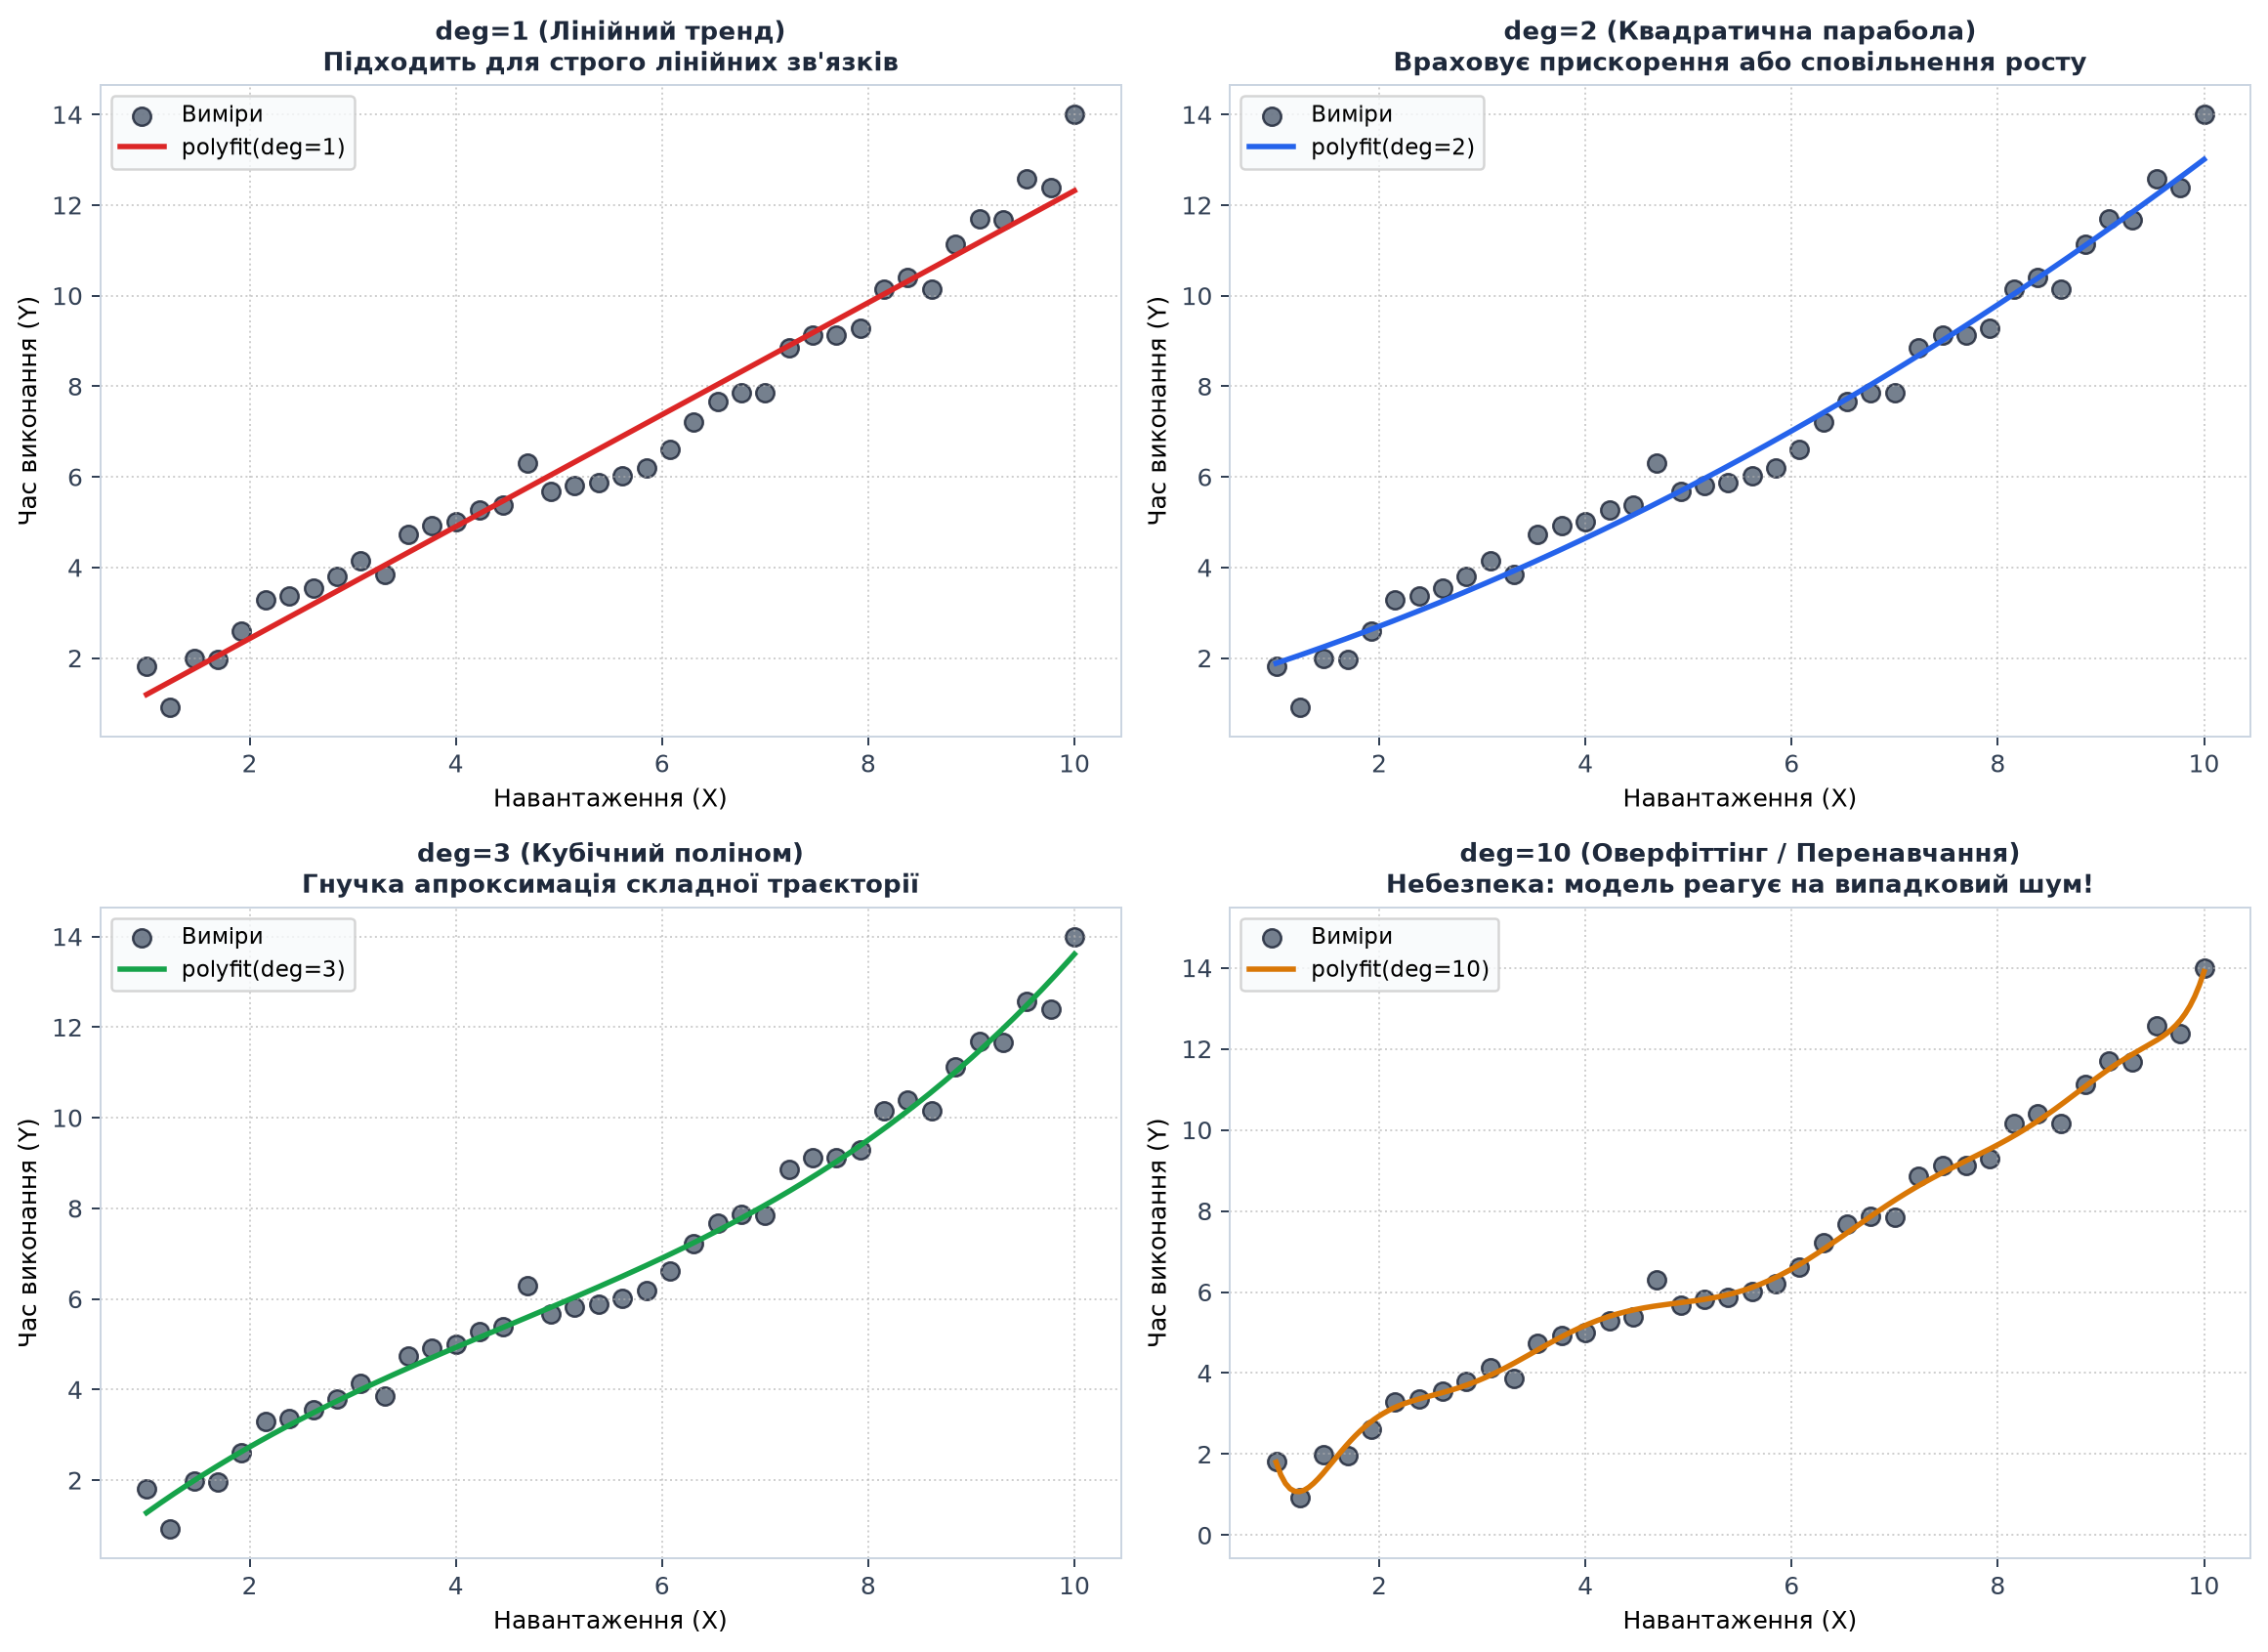
Інженерне застереження: феномен Рунге та перенавчання (Overfitting)
- Низькі степені (
deg=1абоdeg=2): забезпечують надійне згладжування випадкових коливань і дозволяють робити стійкі прогнози (екстраполяцію). - Високі степені (
deg >= 8): викликають катастрофічні коливання на краях інтервалу (феномен Рунге). Поліном намагається пройти точно крізь кожен шумовий викид, втрачаючи фізичну суть залежності. Завжди починайте з найпростішої моделі!
Колірне кодування третьої змінної
Іноді потрібно показати три змінні на одному scatter plot. Третю змінну можна закодувати кольором або розміром точок.
Візуалізація трьох змінних одночасно
Розмір точок = ціна, колір = район
import matplotlib.pyplot as plt
import numpy as np

# Дані про квартири: площа, кімнати, район (0=Схід, 1=Центр, 2=Захід)
rng = np.random.default_rng(seed=42)
n = 150
area = rng.uniform(30, 120, n)
rooms = rng.integers(1, 5, n)
district = rng.choice([0, 1, 2], n, p=[0.4, 0.3, 0.3])

# Ціна залежить від площі та району
price_per_sqm = np.array([400, 600, 500])  # Центр дорожчий
price = price_per_sqm[district] * area + rng.normal(0, 5000, n)

fig, ax = plt.subplots(figsize=(12, 7))

# Scatter з кольоровим кодуванням району
colors = ["#FF6B6B", "#4ECDC4", "#95E1D3"]  # Схід, Центр, Захід
district_names = ["Схід", "Центр", "Захід"]

for i, (color, name) in enumerate(zip(colors, district_names)):
    mask = district == i
    ax.scatter(area[mask], price[mask], c=color, s=80, alpha=0.7,
               edgecolor="black", linewidth=0.5, label=name)

ax.set_title("Ціна квартир: площа vs район", fontsize=14, fontweight="bold")
ax.set_xlabel("Площа (м²)", fontsize=12)
ax.set_ylabel("Ціна ($)", fontsize=12)
ax.legend(title="Район", fontsize=11)
ax.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
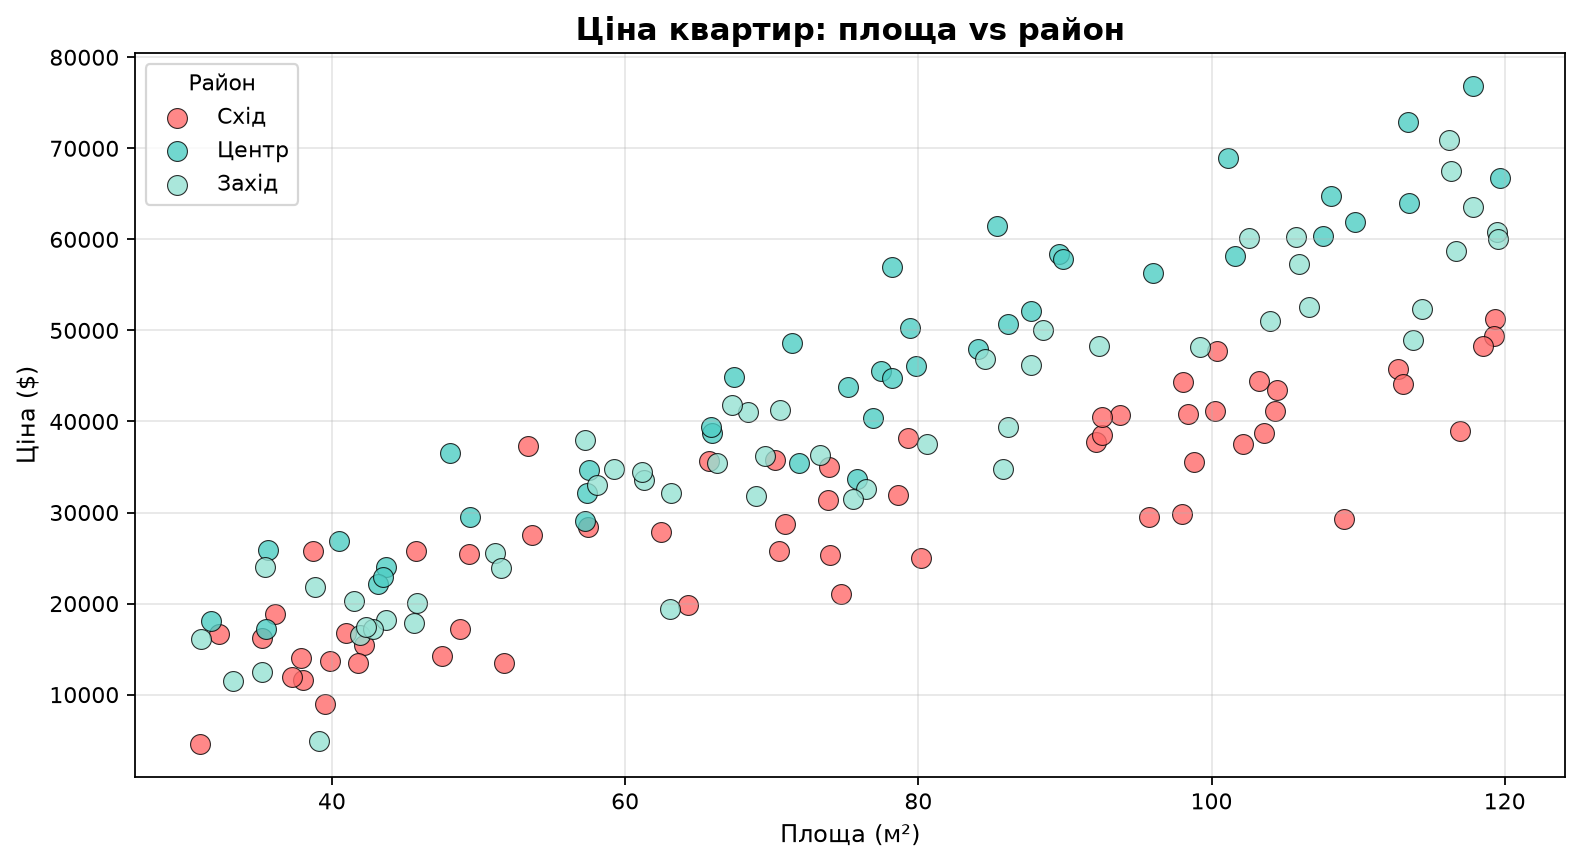
Розмір точок як четверта змінна
import matplotlib.pyplot as plt
import numpy as np

# Дані про міста: населення, ВВП на душу, регіон, площа міста
rng = np.random.default_rng(seed=123)
n = 50
population = rng.uniform(100, 5000, n)  # тисяч людей
gdp_per_capita = rng.uniform(5000, 50000, n)  # $
city_area = rng.uniform(50, 500, n)  # км²

fig, ax = plt.subplots(figsize=(12, 7))

# Розмір точок пропорційний площі міста
scatter = ax.scatter(population, gdp_per_capita, s=city_area, alpha=0.6,
                     c=city_area, cmap="viridis", edgecolor="black", linewidth=1)

ax.set_title("Населення vs ВВП на душу (розмір точки = площа міста)",
             fontsize=14, fontweight="bold")
ax.set_xlabel("Населення (тис. осіб)", fontsize=12)
ax.set_ylabel("ВВП на душу ($)", fontsize=12)
ax.grid(True, alpha=0.3)

# Додаємо colorbar для пояснення кольорів
cbar = plt.colorbar(scatter, ax=ax)
cbar.set_label("Площа міста (км²)", fontsize=11)

# Легенда для розміру точок
sizes = [100, 300, 500]
labels = ["100 км²", "300 км²", "500 км²"]
legend_handles = [plt.scatter([], [], s=size, c="gray", alpha=0.6, edgecolor="black")
                  for size in sizes]
ax.legend(legend_handles, labels, title="Площа міста",
          loc="upper left", frameon=True, fontsize=10)

plt.tight_layout()
plt.show()
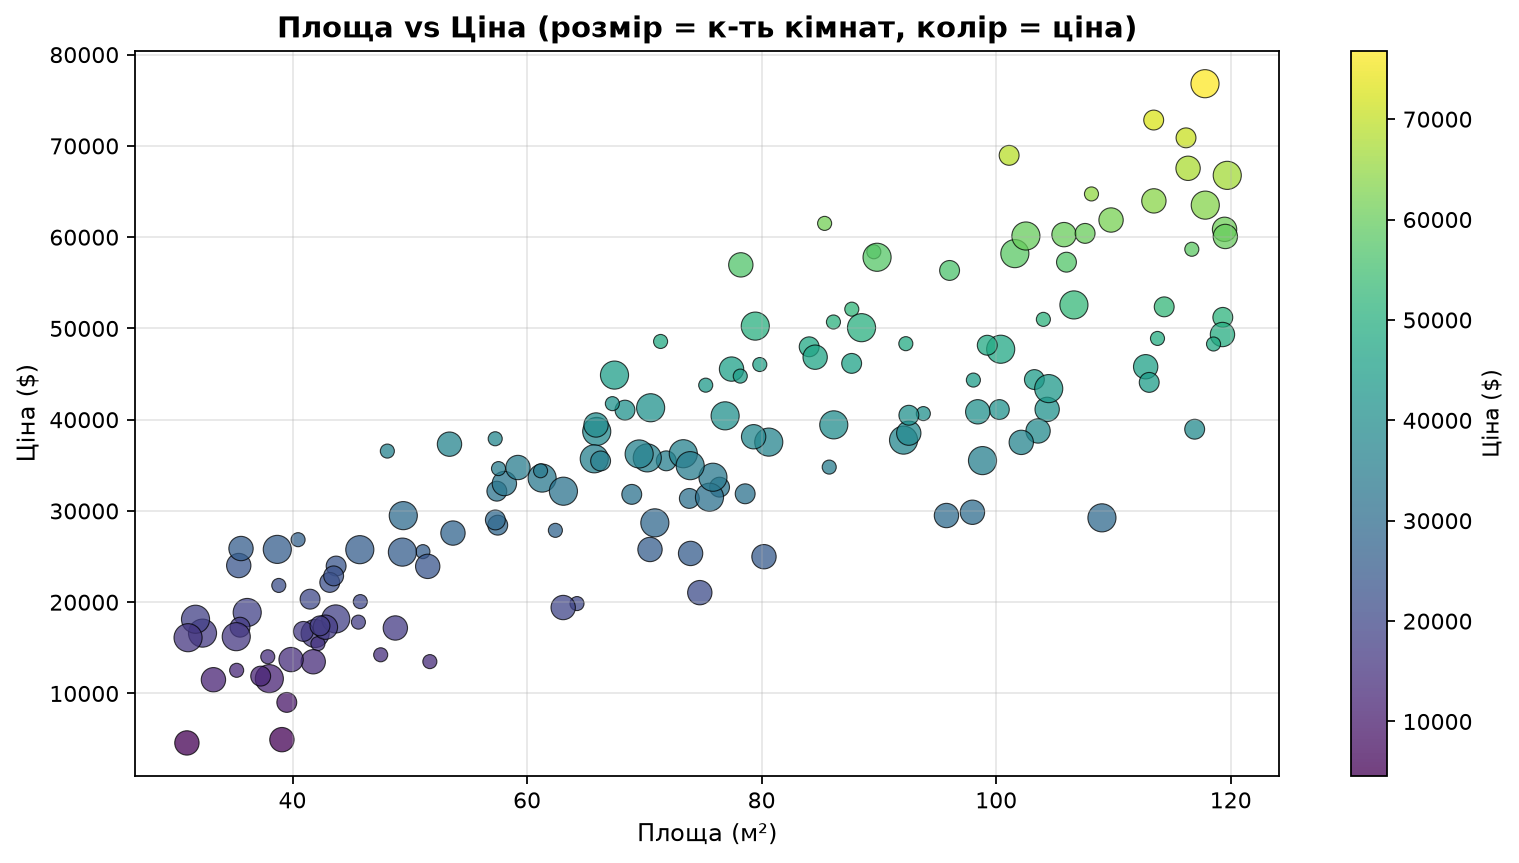
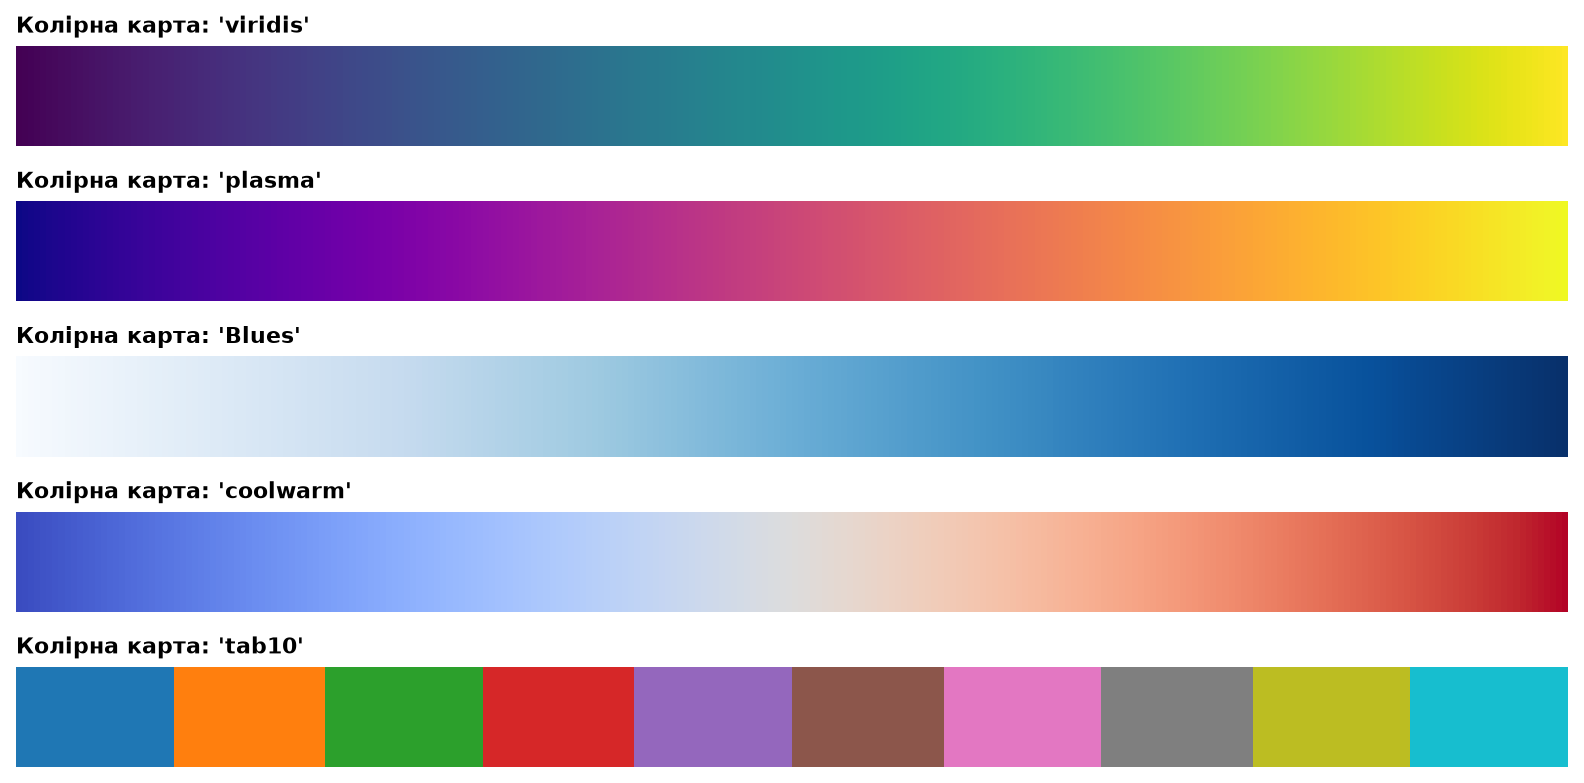
# Послідовні (для величин, що зростають)
c=values, cmap="viridis"   # Синій → Жовтий (рекомендовано, colorblind-safe)
c=values, cmap="plasma"    # Фіолетовий → Жовтий
c=values, cmap="Blues"     # Світло-синій → Темно-синій

# Дивергентні (для відхилень від центру: -10...0...+10)
c=values, cmap="coolwarm"  # Синій ← 0 → Червоний
c=values, cmap="RdYlGn"    # Червоний ← 0 → Зелений

# Категоріальні (для дискретних груп)
c=categories, cmap="tab10"  # 10 різних кольорів
c=categories, cmap="Set3"   # Пастельні кольори
 Уникайте:
"jet" (застарілий, не colorblind-safe, спотворює дані)Повна сигнатура fig.colorbar() та мультивимірне кодування (Bubble Chart)
Коли кольоровий градієнт кодує неперервну метрику, графік обов'язково повинен супроводжуватися шкалою відповідності значень кольорам — Colorbar. Метод fig.colorbar() підключається до об'єкта ScalarMappable (який повертає ax.scatter() або ax.imshow()).
fig.colorbar(
    mappable,
    cax=None,
    ax=None,
    use_gridspec=True,
    location=None,
    orientation='vertical',  # або 'horizontal'
    fraction=0.15,
    shrink=1.0,
    aspect=20,
    pad=0.04,
    label='',
    **kwargs
) -> Colorbar
| Параметр | Тип | За замовчуванням | Опис та інженерне призначення |
|---|---|---|---|
mappable | ScalarMappable | обов'язковий | Графічний об'єкт, з якого беруться колірна карта та межі vmin/vmax (результат ax.scatter() або ax.imshow()). |
ax | Axes | Sequence[Axes] | None | Вісь (або список осей), від якої відбирається простір для розміщення смуги шкали. |
orientation | 'vertical' | 'horizontal' | 'vertical' | Орієнтація шкали: вертикальна (праворуч від графіка) або горизонтальна (знизу). |
fraction | float | 0.15 | Частка початкової осі графіка, виділена під смугу шкали (для квадратних графіків зручно ставити 0.046). |
pad | float | 0.05 (vert) / 0.15 (horiz) | Відступ смуги colorbar від межі графіка. |
shrink | float | 1.0 | Масштабний коефіцієнт довжини шкали (наприклад, shrink=0.8 вкорочує шкалу). |
label | str | '' | Текстовий підпис фізичної величини та одиниць виміру шкали. |
Багатовимірне візуальне кодування: Color, Size та Colorbar
Порівняння послідовних і дивергентних палітр, зважування розміром точок (Bubble chart) та 4D аналіз
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(42)
fig, axes = plt.subplots(2, 2, figsize=(14, 10))

# Синтетичні системні метрики сервера
x_mem = rng.uniform(5, 50, 60)         # RAM (GB)
y_lat = 10 + 0.8 * x_mem + rng.normal(0, 5, 60)  # Latency (ms)
cpu_load = x_mem * 1.5 + rng.normal(0, 10, 60)   # CPU Load (%)
sla_delta = rng.normal(0, 4, 60)                 # Відхилення від SLA (ms)
payload = rng.uniform(20, 450, 60)               # Розмір тіла запиту (KB)

# 1. Sequential colormap ('viridis')
sc1 = axes[0, 0].scatter(x_mem, y_lat, c=cpu_load, cmap='viridis', s=70, edgecolor='#1e293b', linewidth=0.5)
cb1 = fig.colorbar(sc1, ax=axes[0, 0], fraction=0.046, pad=0.04)
cb1.set_label("CPU Load (%)")
axes[0, 0].set_title("Послідовна шкала (Sequential 'viridis'):\nдля величин від низьких до високих", fontweight='bold')
axes[0, 0].set_xlabel("Пам'ять RAM (GB)")
axes[0, 0].set_ylabel("Час відповіді (мс)")
axes[0, 0].grid(True, linestyle=':', alpha=0.6)

# 2. Diverging colormap ('coolwarm')
sc2 = axes[0, 1].scatter(x_mem, y_lat, c=sla_delta, cmap='coolwarm', vmin=-10, vmax=10, s=70, edgecolor='#1e293b', linewidth=0.5)
cb2 = fig.colorbar(sc2, ax=axes[0, 1], fraction=0.046, pad=0.04)
cb2.set_label("Відхилення SLA Δ (мс)")
axes[0, 1].set_title("Дивергентна шкала (Diverging 'coolwarm'):\nдля відхилень в обидва боки від 0", fontweight='bold')
axes[0, 1].set_xlabel("Пам'ять RAM (GB)")
axes[0, 1].set_ylabel("Час відповіді (мс)")
axes[0, 1].grid(True, linestyle=':', alpha=0.6)

# 3. Bubble Chart (розмір точки = розмір запиту)
axes[1, 0].scatter(x_mem, y_lat, s=payload, color='#0284c7', alpha=0.55, edgecolor='#0369a1', linewidth=1)
for s_val, s_lbl in [(50, "50 KB"), (200, "200 KB"), (400, "400 KB")]:
    axes[1, 0].scatter([], [], s=s_val, color='#0284c7', alpha=0.55, edgecolor='#0369a1', label=s_lbl)
axes[1, 0].legend(title="Розмір payload", loc='upper left')
axes[1, 0].set_title("Кодування розміром (Bubble chart, параметр s):\nвага кожного окремого вимірювання", fontweight='bold')
axes[1, 0].set_xlabel("Пам'ять RAM (GB)")
axes[1, 0].set_ylabel("Час відповіді (мс)")
axes[1, 0].grid(True, linestyle=':', alpha=0.6)

# 4. 4D поєднання (X, Y, Колір, Розмір) + горизонтальний Colorbar
sc4 = axes[1, 1].scatter(x_mem, y_lat, s=payload * 0.8, c=cpu_load, cmap='plasma', alpha=0.75, edgecolor='#0f172a', linewidth=0.6)
cb4 = fig.colorbar(sc4, ax=axes[1, 1], orientation='horizontal', fraction=0.046, pad=0.15)
cb4.set_label("CPU Load (%) — горизонтальний colorbar")
axes[1, 1].set_title("4D комбінація (X, Y, Колір, Розмір):\nодночасний аналіз 4 системних метрик", fontweight='bold')
axes[1, 1].set_xlabel("Пам'ять RAM (GB)")
axes[1, 1].set_ylabel("Час відповіді (мс)")
axes[1, 1].grid(True, linestyle=':', alpha=0.6)

plt.tight_layout()
plt.show()
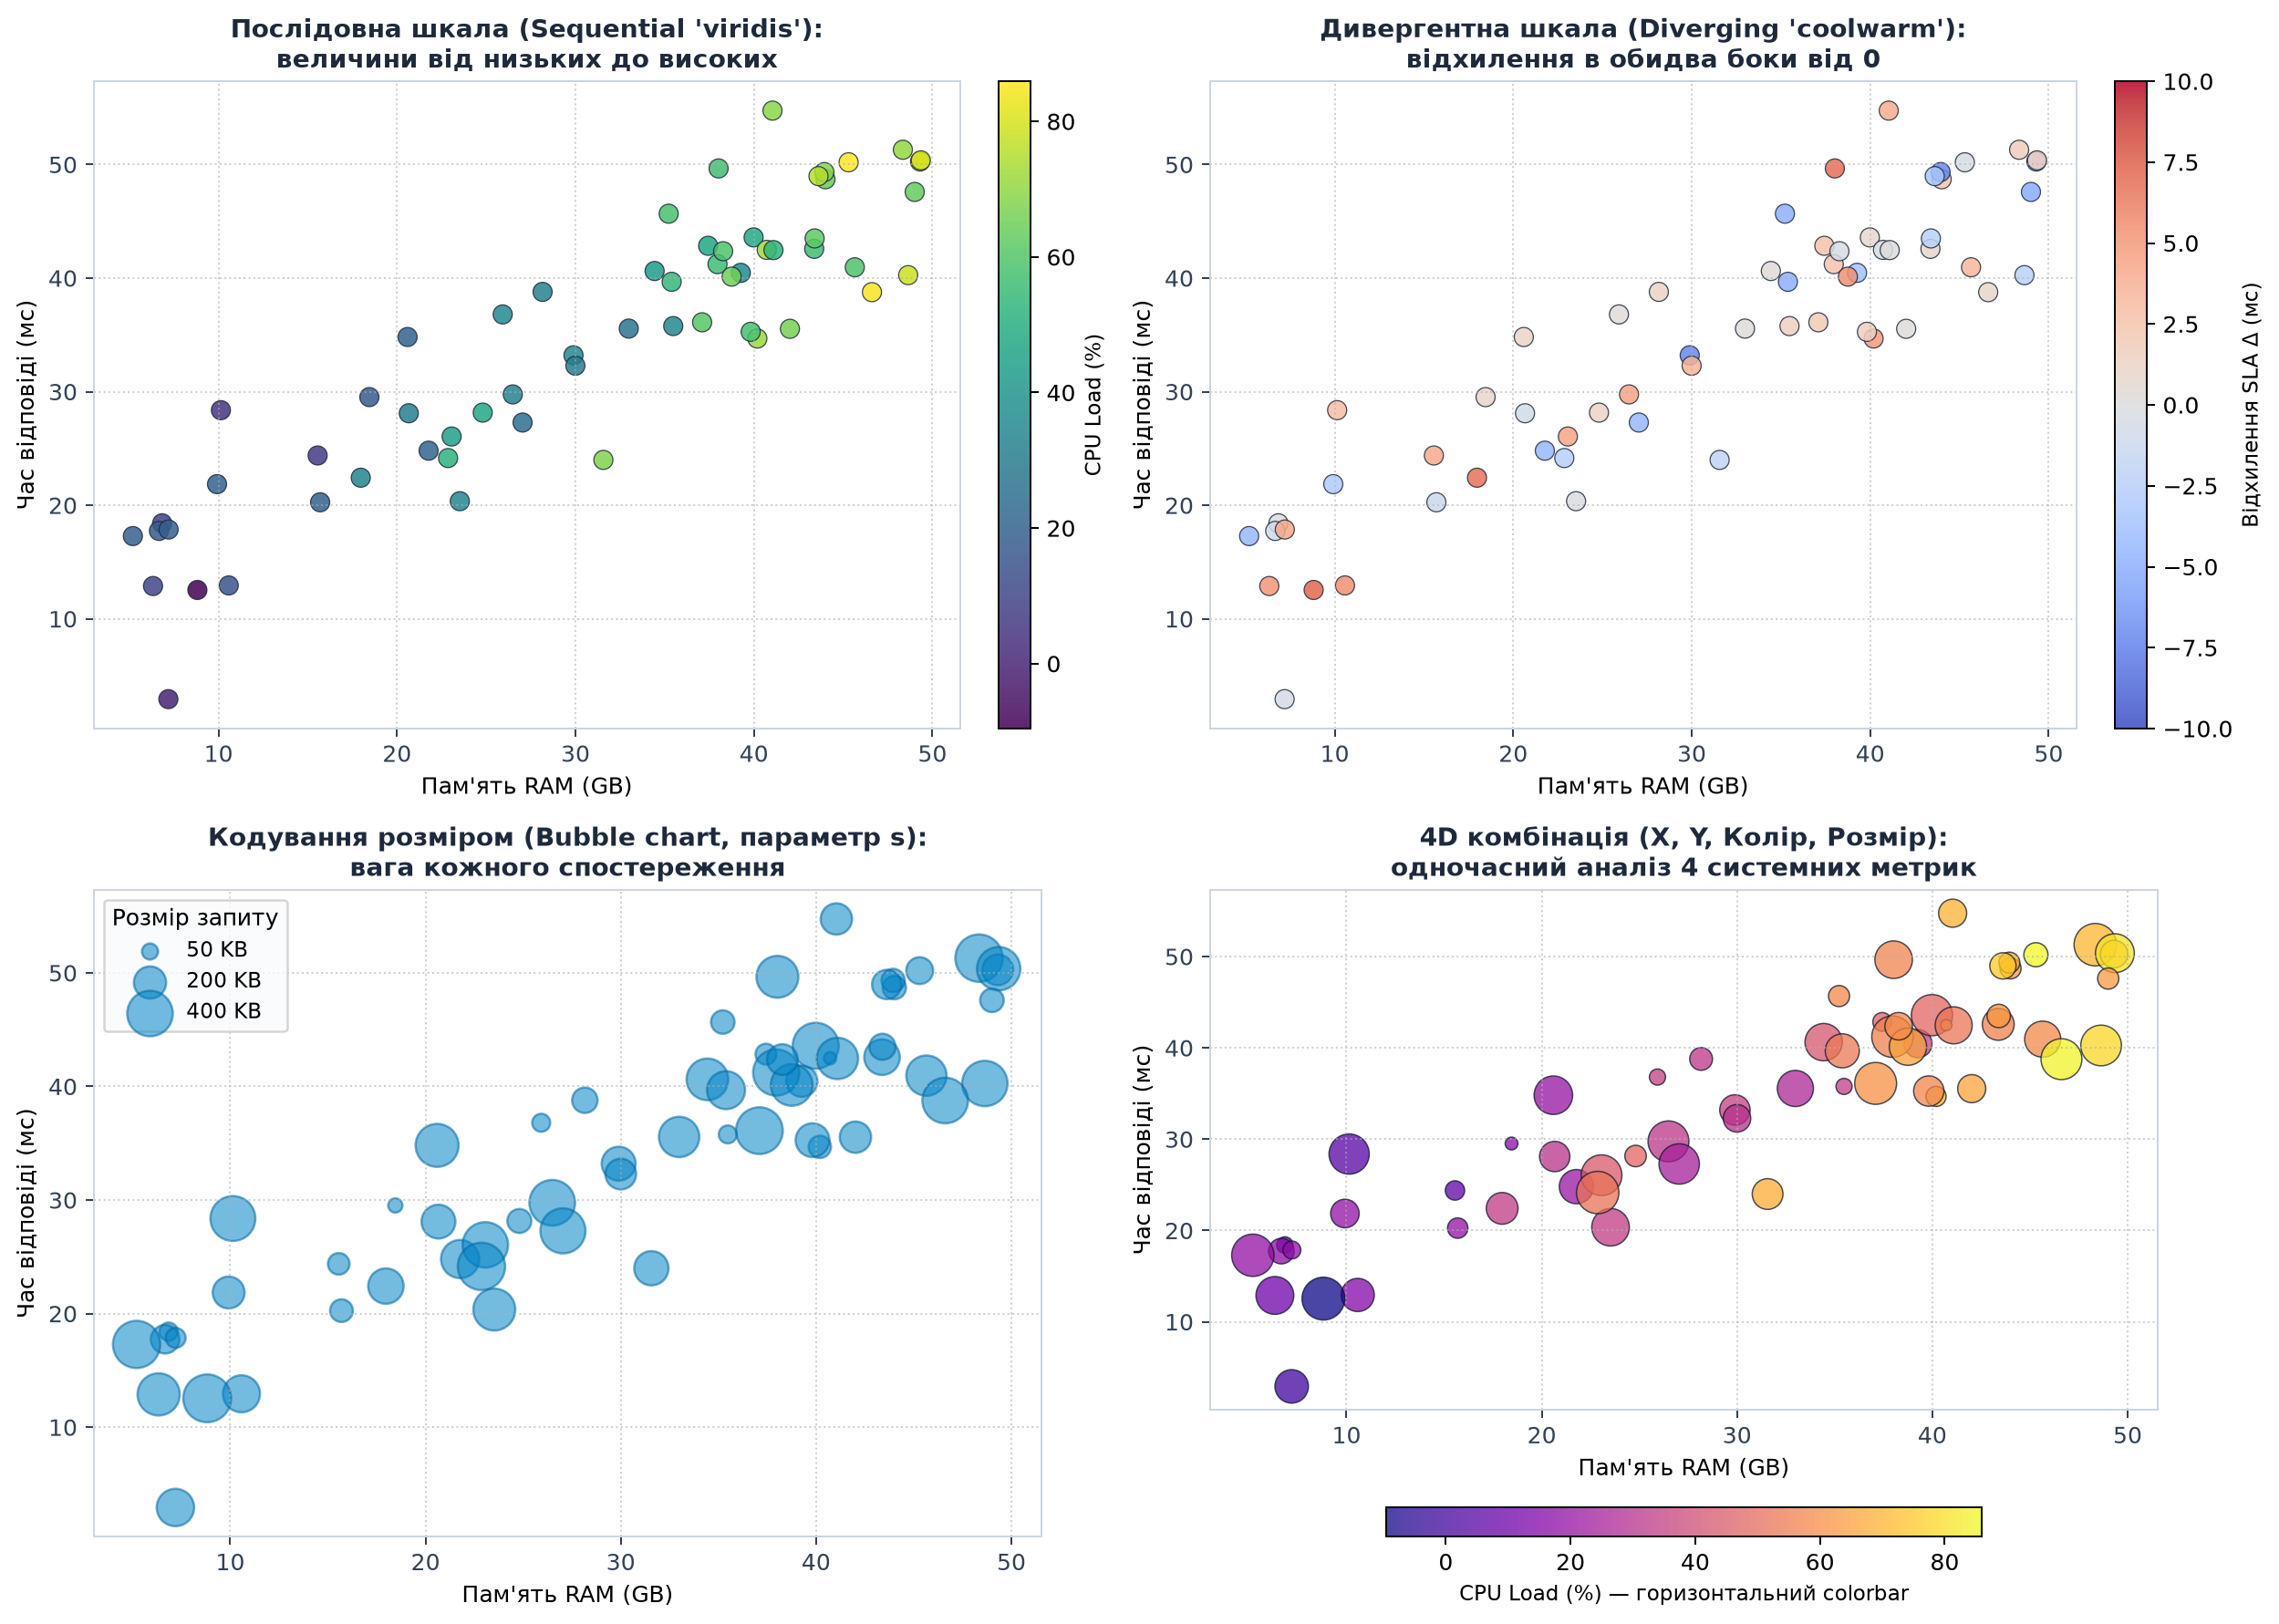
Важливе правило пропорційності площі у Bubble Charts
Людина оцінює розмір об'єкта за його площею, а не лінійним діаметром.
Оскільки параметр s в ax.scatter() приймає площу маркера в $pt^2$, передача значення змінної напряму забезпечує математично точне візуальне сприйняття. Якщо ж ви обчислюєте радіус $r$, пам'ятайте, що площа зростає квадратично ($S = \pi r^2$), що може створити оманливе враження надмірного розміру великих точок!
Подолання оверплотингу: ax.hexbin() та 2D-густина
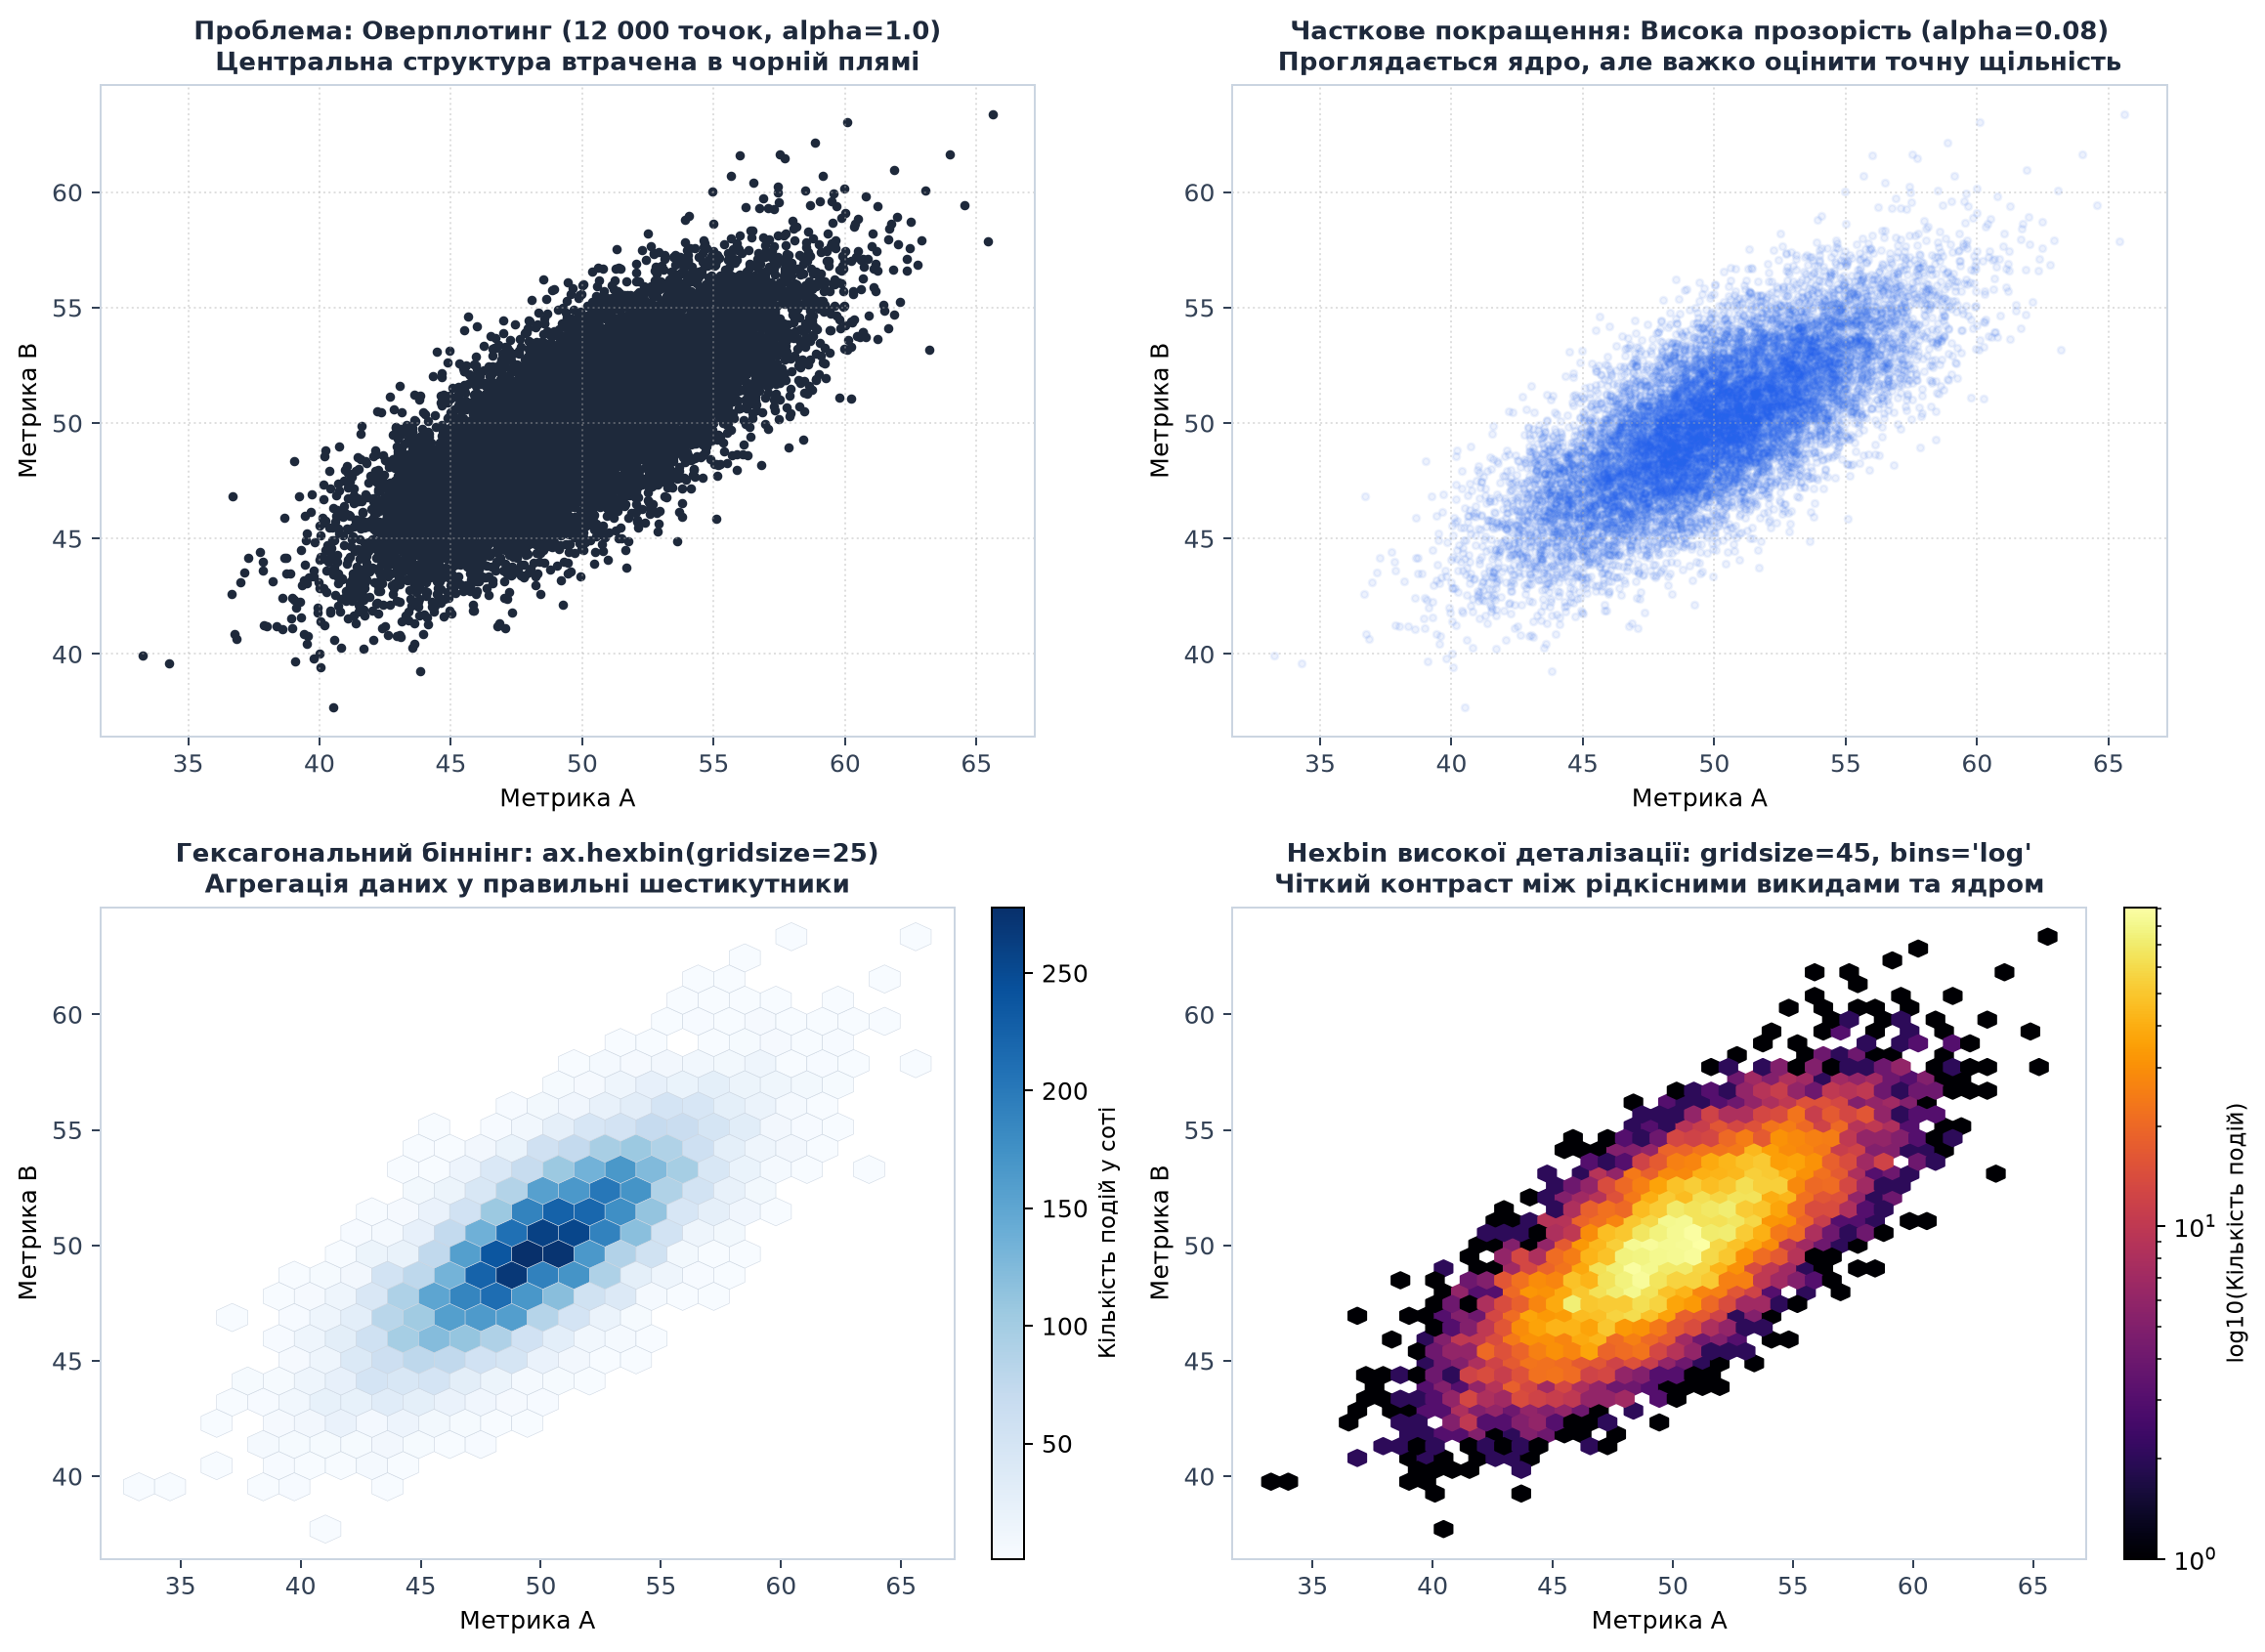
Коли обсяг даних сягає десятків або сотень тисяч записів (наприклад, реальні логи веб-сервера чи транзакції банку), класичний ax.scatter() стикається з критичною проблемою — оверплотингом (Overplotting). Точки накладаються одна на одну, утворюючи суцільну темну пляму, де неможливо зрозуміти, чи в центрі 100 точок, чи 100 000.
Найефективніший інструмент розв'язання цієї проблеми в Matplotlib — гексагональний біннінг (ax.hexbin()). Площина графіка розбивається на сітку правильних шестикутників (стільників), а колір кожного шестикутника відображає кількість точок, що потрапили всередину.
ax.hexbin(
    x, y,
    C=None,
    gridsize=100,
    bins=None,
    xscale='linear',
    yscale='linear',
    cmap=None,
    norm=None,
    vmin=None,
    vmax=None,
    alpha=None,
    linewidths=None,
    edgecolors='none',
    reduce_C_function=np.mean,
    mincnt=None,
    marginals=False,
    **kwargs
) -> PolyCollection
| Параметр | Тип | За замовчуванням | Опис та інженерне призначення |
|---|---|---|---|
x, y | ArrayLike | обов'язкові | Масиви спостережень великого обсягу (тисячі або мільйони точок). |
gridsize | int | tuple[int, int] | 100 | Кількість шестикутників по осі X. Чим більше значення, тим дрібніша сітка і вища деталізація. |
bins | None | 'log' | Sequence | None | Метод підрахунку щільності. При 'log' значення сортуються за шкалою $\log_{10}(N)$, що рятує при наявності екстремальних піків. |
mincnt | int | None | None | Мінімальна кількість точок для відображення стільника. Якщо mincnt=1, порожні стільники залишаються прозорими фоновими. |
cmap | str | Colormap | rcParams['image.cmap'] | Палітра градієнта щільності ('inferno', 'Blues', 'viridis'). |
edgecolors | color | 'none' | 'none' | Колір меж стільників (часто 'none' або тонка світло-сіра сітка). |
Боротьба з оверплотингом на 12 000 спостереженнях
Порівняння сирого scatter, прозорості alpha та гексагонального біннінгу з логарифмічною шкалою
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(42)
mean = [50, 50]
cov = [[15, 9], [9, 10]]
x_big, y_big = rng.multivariate_normal(mean, cov, 12000).T

fig, axes = plt.subplots(2, 2, figsize=(13, 9.5))

# 1. Проблема оверплотингу
axes[0, 0].scatter(x_big, y_big, color='#1e293b', s=8, alpha=1.0)
axes[0, 0].set_title("Проблема: Оверплотинг (12 000 точок, alpha=1.0)\nВнутрішня структура прихована в суцільній плямі", fontweight='bold')
axes[0, 0].set_xlabel("Метрика A")
axes[0, 0].set_ylabel("Метрика B")
axes[0, 0].grid(True, linestyle=':', alpha=0.4)

# 2. Часткове покращення: висока прозорість
axes[0, 1].scatter(x_big, y_big, color='#2563eb', s=8, alpha=0.08)
axes[0, 1].set_title("Часткове рішення: Прозорість (alpha=0.08)\nЯдро проглядається, але точну густину оцінити важко", fontweight='bold')
axes[0, 1].set_xlabel("Метрика A")
axes[0, 1].set_ylabel("Метрика B")
axes[0, 1].grid(True, linestyle=':', alpha=0.4)

# 3. Гексагональний біннінг (gridsize=25)
hb1 = axes[1, 0].hexbin(x_big, y_big, gridsize=25, cmap='Blues', mincnt=1, edgecolors='#cbd5e1', linewidths=0.2)
cb1 = fig.colorbar(hb1, ax=axes[1, 0], fraction=0.046, pad=0.04)
cb1.set_label("Кількість подій у стільнику")
axes[1, 0].set_title("Гексагональний біннінг: ax.hexbin(gridsize=25)\nАгрегація даних у правильні шестикутники", fontweight='bold')
axes[1, 0].set_xlabel("Метрика A")
axes[1, 0].set_ylabel("Метрика B")

# 4. Дрібний hexbin з логарифмічною шкалою (bins='log')
hb2 = axes[1, 1].hexbin(x_big, y_big, gridsize=45, cmap='inferno', bins='log', mincnt=1)
cb2 = fig.colorbar(hb2, ax=axes[1, 1], fraction=0.046, pad=0.04)
cb2.set_label("log10(Кількість подій)")
axes[1, 1].set_title("Hexbin з bins='log' та gridsize=45\nЧіткий контраст між поодинокими аномаліями та ядром", fontweight='bold')
axes[1, 1].set_xlabel("Метрика A")
axes[1, 1].set_ylabel("Метрика B")

plt.tight_layout()
plt.show()
Scatter Matrix — всі пари змінних одразу
Коли у датасеті багато змінних, корисно побачити всі можливі пари scatter plots одночасно.
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

# Створюємо датасет з 4 змінними
rng = np.random.default_rng(seed=42)
n = 200

data = pd.DataFrame({
    "Зріст (см)": rng.normal(170, 10, n),
    "Вага (кг)": rng.normal(70, 15, n),
    "Вік (роки)": rng.uniform(18, 65, n),
    "Дохід ($)": rng.lognormal(10, 0.5, n)
})

# Додаємо кореляцію між зростом та вагою
data["Вага (кг)"] = 0.4 * data["Зріст (см)"] + rng.normal(0, 8, n)

# Scatter matrix
from pandas.plotting import scatter_matrix

fig, axes = plt.subplots(4, 4, figsize=(14, 14))
scatter_matrix(data, ax=axes, alpha=0.6, figsize=(14, 14),
               diagonal="hist", color="steelblue", edgecolor="navy",
               linewidth=0.5, hist_kwds={"bins": 20, "edgecolor": "black"})

plt.suptitle("Scatter Matrix: всі пари змінних", fontsize=16, fontweight="bold", y=0.995)
plt.tight_layout()
plt.show()
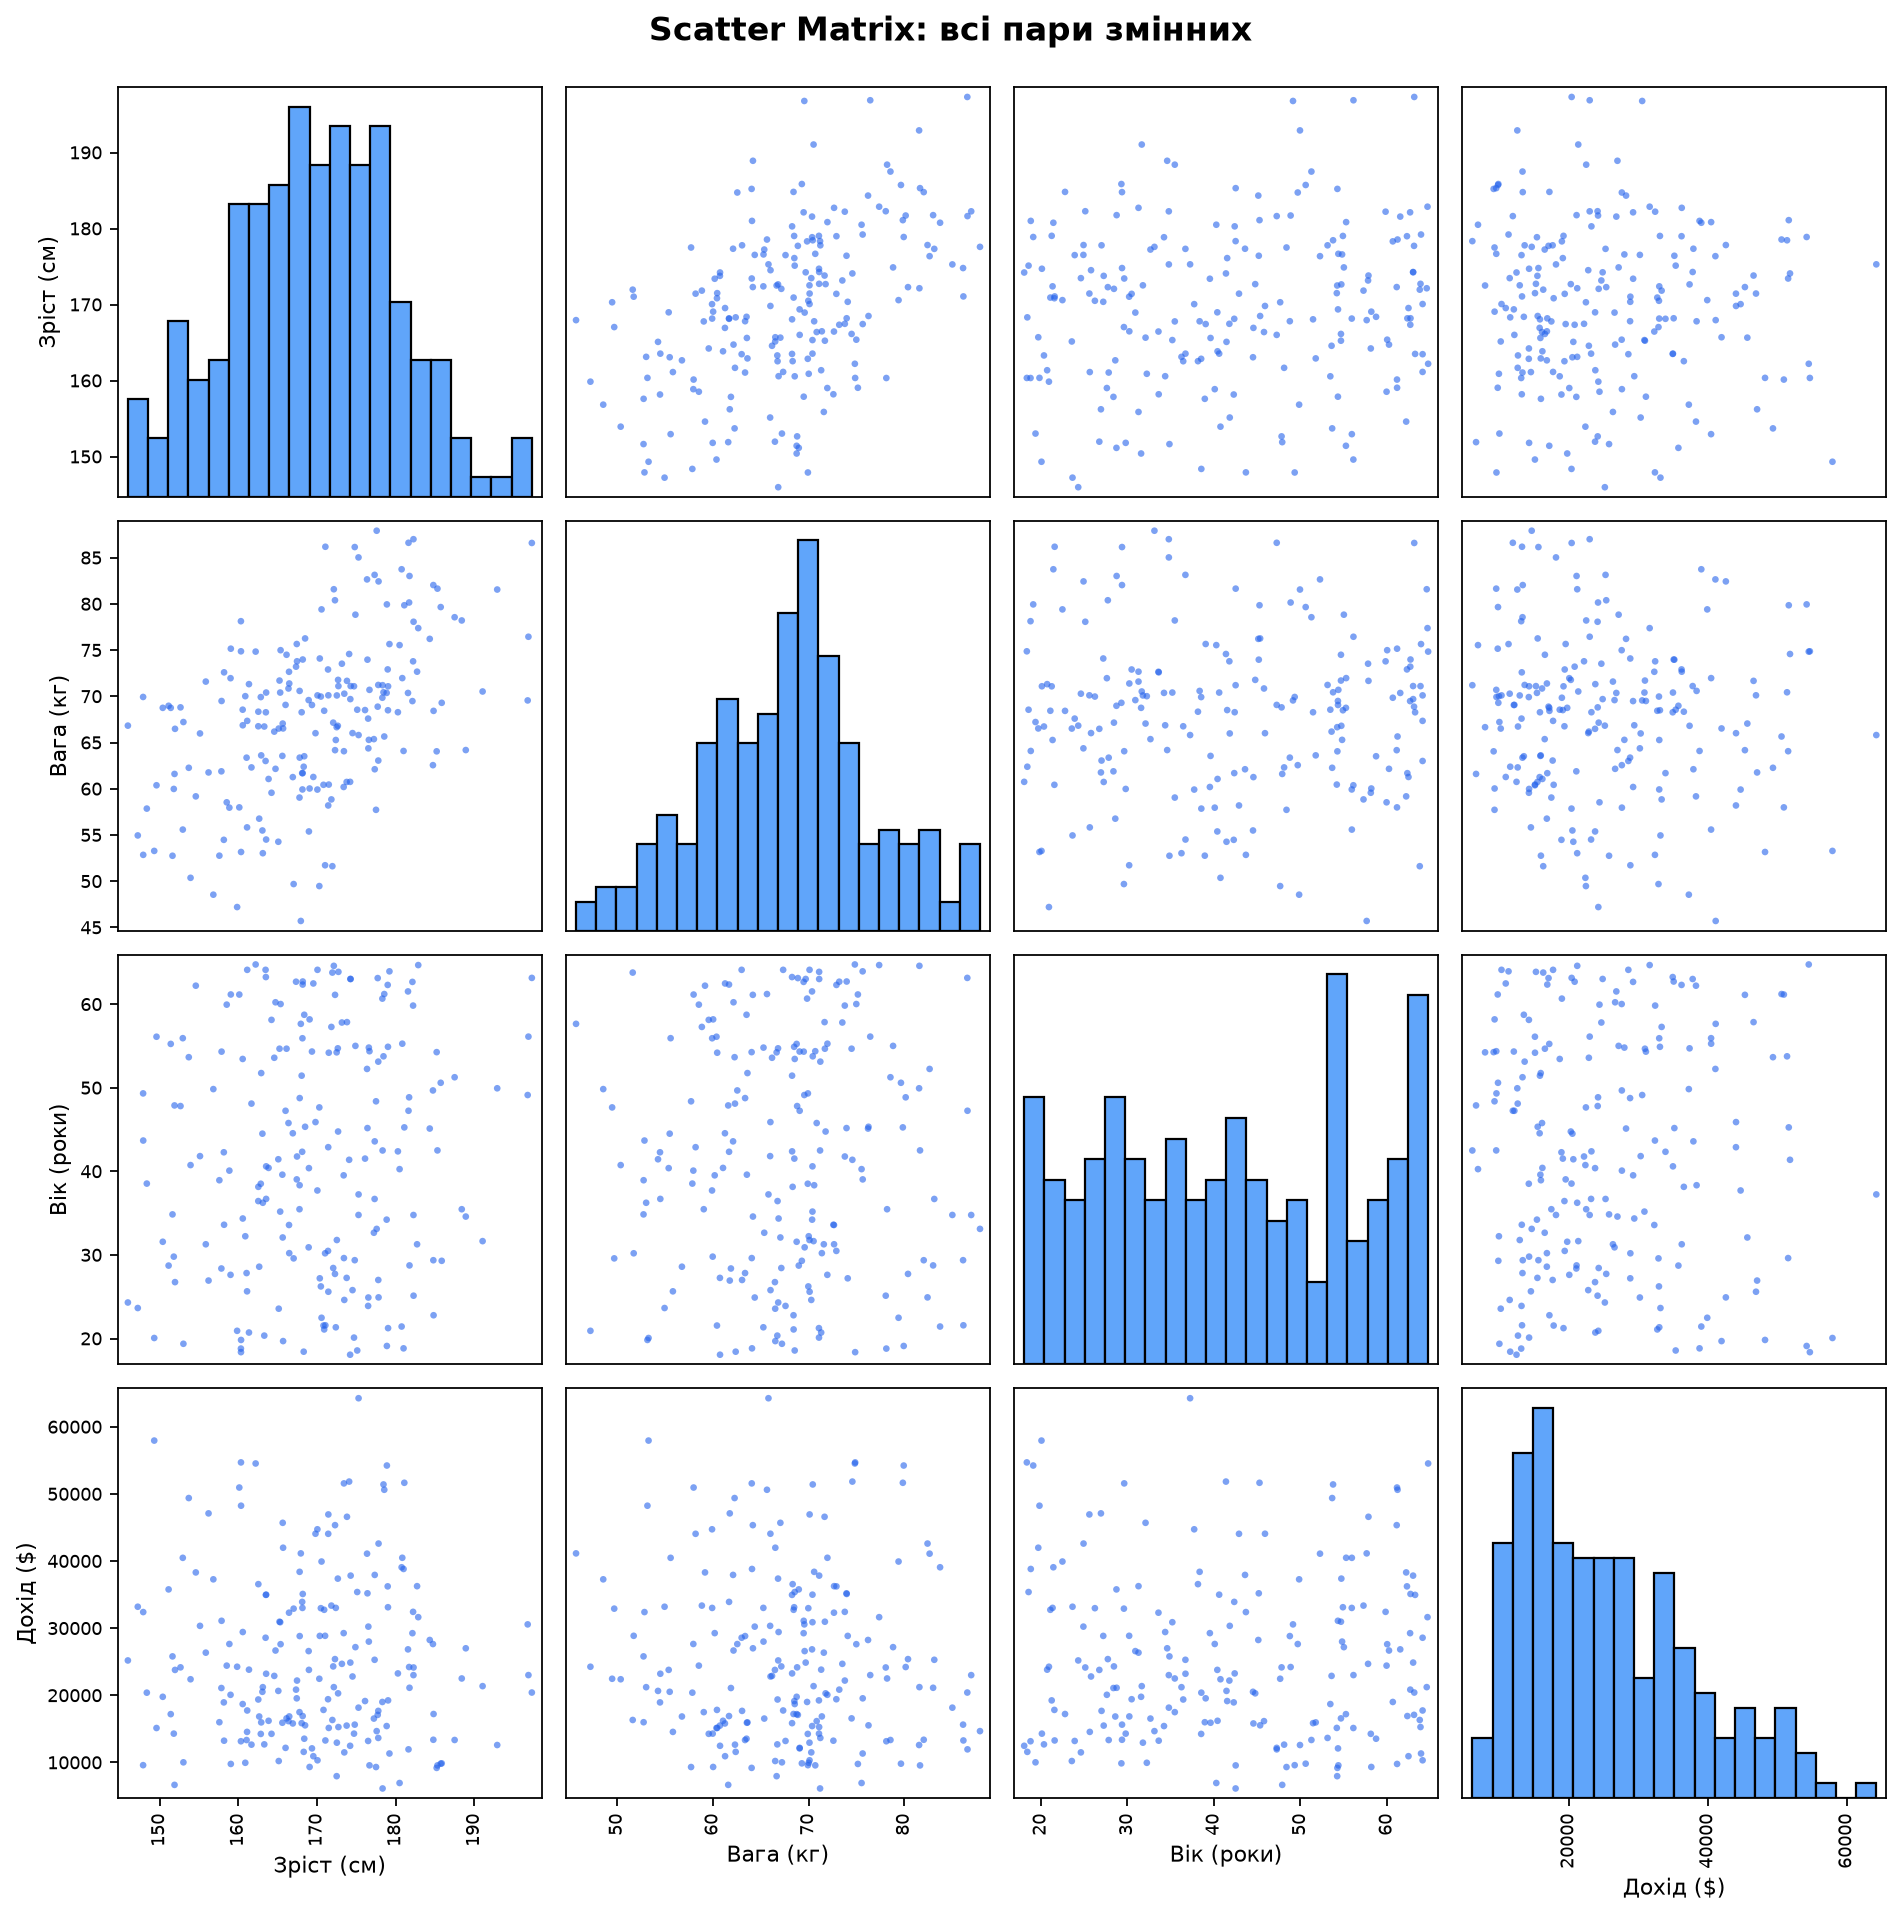
Як читати scatter matrix:
- Діагональ — гістограми розподілу кожної змінної
- Поза діагоналлю — scatter plots для пар змінних
- Клітинка (i, j) = scatter(змінна_i vs змінна_j)
- Симетрія: клітинка (i, j) = клітинка (j, i), але осі поміняні місцями
Що шукати:
- Сильні кореляції (точки вздовж прямої)
- Нелінійні залежності (викривлені паттерни)
- Викиди (самотні точки далеко від кластера)
import seaborn as sns

corr_matrix = data.corr()  # Обчислюємо кореляції
sns.heatmap(corr_matrix, annot=True, cmap="coolwarm", vmin=-1, vmax=1)
plt.title("Кореляційна матриця")
plt.show()
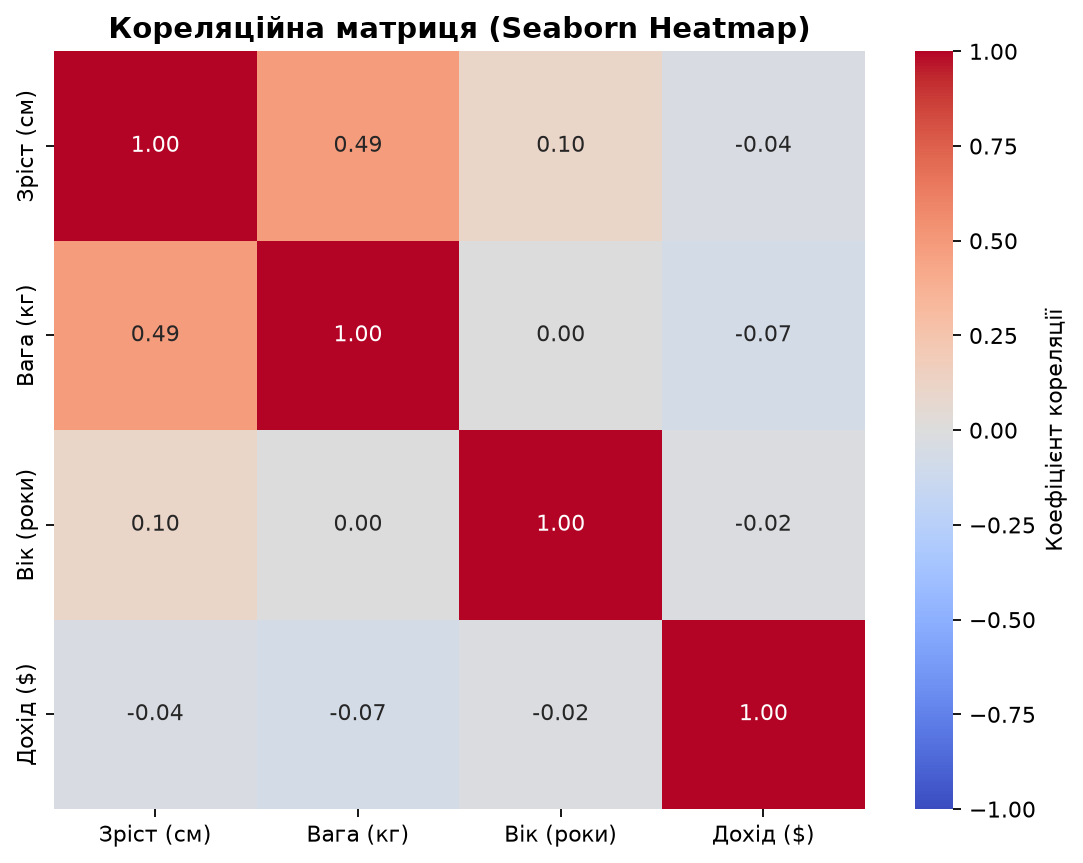 Показує ті ж залежності, але компактніше. Однак не показує нелінійні залежності та викиди.
Побудова кореляційної матриці засобами чистого Matplotlib: сигнатура ax.imshow()
Хоча Seaborn пропонує зручну обгортку sns.heatmap(), у виробничих середовищах із мінімальними залежностями або при створенні кастомних звітів фундаментальним інструментом є ax.imshow() з чистого Matplotlib. Він дозволяє візуалізувати двовимірний масив як матрицю кольорових пікселів із повним контролем над кожною клітинкою.
ax.imshow(
    X,
    cmap=None,
    norm=None,
    aspect=None,
    interpolation=None,
    alpha=None,
    vmin=None,
    vmax=None,
    origin='upper',
    extent=None,
    filternorm=True,
    filterrad=4.0,
    resample=None,
    url=None,
    **kwargs
) -> AxesImage
| Параметр | Тип | За замовчуванням | Опис та інженерне призначення |
|---|---|---|---|
X | ArrayLike (2D) | обов'язковий | Двовимірний масив кореляцій або значень розміром $(N, M)$. |
cmap | str | Colormap | rcParams['image.cmap'] | Колірна карта. Для кореляції використовуйте дивергентні ('coolwarm', 'RdBu_r'), де нейтральний колір відповідає нулю. |
vmin, vmax | float | min(X), max(X) | Критично для кореляції: завжди задавайте vmin=-1.0, vmax=1.0, щоб нульовий зв'язок гарантовано був нейтральним, а не зміщувався залежно від даних. |
aspect | 'equal' | 'auto' | float | rcParams['image.aspect'] | Співвідношення сторін: 'equal' гарантує правильні квадратні комірки таблиці. |
interpolation | str | 'none' / 'nearest' | Спосіб інтерполяції пікселів. Для табличних матриць кореляції слід обирати 'nearest' (без розмиття). |
origin | 'upper' | 'lower' | 'upper' | Розташування індексу 0, 0: 'upper' відповідає класичній математичній матриці (зліва зверху). |
Майстерність чистого Matplotlib: анотації та трикутна маска
Побудова інформативного Correlation Heatmap без сторонніх бібліотек
import matplotlib.pyplot as plt
import numpy as np

# Системні метрики сервера
metrics = ["CPU %", "RAM GB", "IOPS", "Net In", "Latency"]
corr = np.array([
    [1.00,  0.72,  0.58,  0.41,  0.86],
    [0.72,  1.00,  0.34,  0.28,  0.64],
    [0.58,  0.34,  1.00,  0.69,  0.45],
    [0.41,  0.28,  0.69,  1.00,  0.31],
    [0.86,  0.64,  0.45,  0.31,  1.00]
])

fig, axes = plt.subplots(2, 2, figsize=(13, 11))

# 1. Базовий imshow з фіксованими vmin/vmax
im1 = axes[0, 0].imshow(corr, cmap='coolwarm', vmin=-1, vmax=1)
fig.colorbar(im1, ax=axes[0, 0], fraction=0.046, pad=0.04)
axes[0, 0].set_xticks(range(len(metrics)))
axes[0, 0].set_yticks(range(len(metrics)))
axes[0, 0].set_xticklabels(metrics, rotation=35, ha='right')
axes[0, 0].set_yticklabels(metrics)
axes[0, 0].set_title("Базовий Heatmap: ax.imshow(corr, cmap='coolwarm')\nФіксований діапазон vmin=-1, vmax=1", fontweight='bold')

# 2. Матриця з динамічними текстовими анотаціями (ax.text)
im2 = axes[0, 1].imshow(corr, cmap='RdBu_r', vmin=-1, vmax=1)
fig.colorbar(im2, ax=axes[0, 1], fraction=0.046, pad=0.04)
axes[0, 1].set_xticks(range(len(metrics)))
axes[0, 1].set_yticks(range(len(metrics)))
axes[0, 1].set_xticklabels(metrics, rotation=35, ha='right')
axes[0, 1].set_yticklabels(metrics)
for i in range(len(metrics)):
    for j in range(len(metrics)):
        val = corr[i, j]
        # Адаптивний колір шрифту для контрасту на темних комірках
        txt_col = 'white' if abs(val) > 0.65 else 'black'
        axes[0, 1].text(j, i, f"{val:.2f}", ha='center', va='center',
                        color=txt_col, fontweight='bold', fontsize=9.5)
axes[0, 1].set_title("Матриця з числовими анотаціями (ax.text)\nТочні числові коефіцієнти всередині клітинок", fontweight='bold')

# 3. Ефект інтерполяції (bilinear vs nearest)
sub_corr = corr[:3, :3]
im3 = axes[1, 0].imshow(sub_corr, cmap='viridis', interpolation='bilinear')
fig.colorbar(im3, ax=axes[1, 0], fraction=0.046, pad=0.04)
axes[1, 0].set_xticks(range(3))
axes[1, 0].set_yticks(range(3))
axes[1, 0].set_xticklabels(metrics[:3])
axes[1, 0].set_yticklabels(metrics[:3])
axes[1, 0].set_title("Ефект інтерполяції: interpolation='bilinear'\nЗгладжування градієнтів для просторових карт", fontweight='bold')

# 4. Трикутна маска (усунення дублювання симетричних пар)
mask = np.triu(np.ones_like(corr, dtype=bool), k=1)
masked_corr = np.ma.masked_where(~mask, corr)
im4 = axes[1, 1].imshow(masked_corr, cmap='coolwarm', vmin=-1, vmax=1)
fig.colorbar(im4, ax=axes[1, 1], fraction=0.046, pad=0.04)
axes[1, 1].set_xticks(range(len(metrics)))
axes[1, 1].set_yticks(range(len(metrics)))
axes[1, 1].set_xticklabels(metrics, rotation=35, ha='right')
axes[1, 1].set_yticklabels(metrics)
for i in range(len(metrics)):
    for j in range(len(metrics)):
        if mask[i, j]:
            val = corr[i, j]
            txt_col = 'white' if abs(val) > 0.65 else 'black'
            axes[1, 1].text(j, i, f"{val:.2f}", ha='center', va='center',
                            color=txt_col, fontweight='bold', fontsize=9.5)
axes[1, 1].set_title("Трикутна маска (np.triu):\nусунення дублювання пар і тривіальної діагоналі", fontweight='bold')

plt.tight_layout()
plt.show()
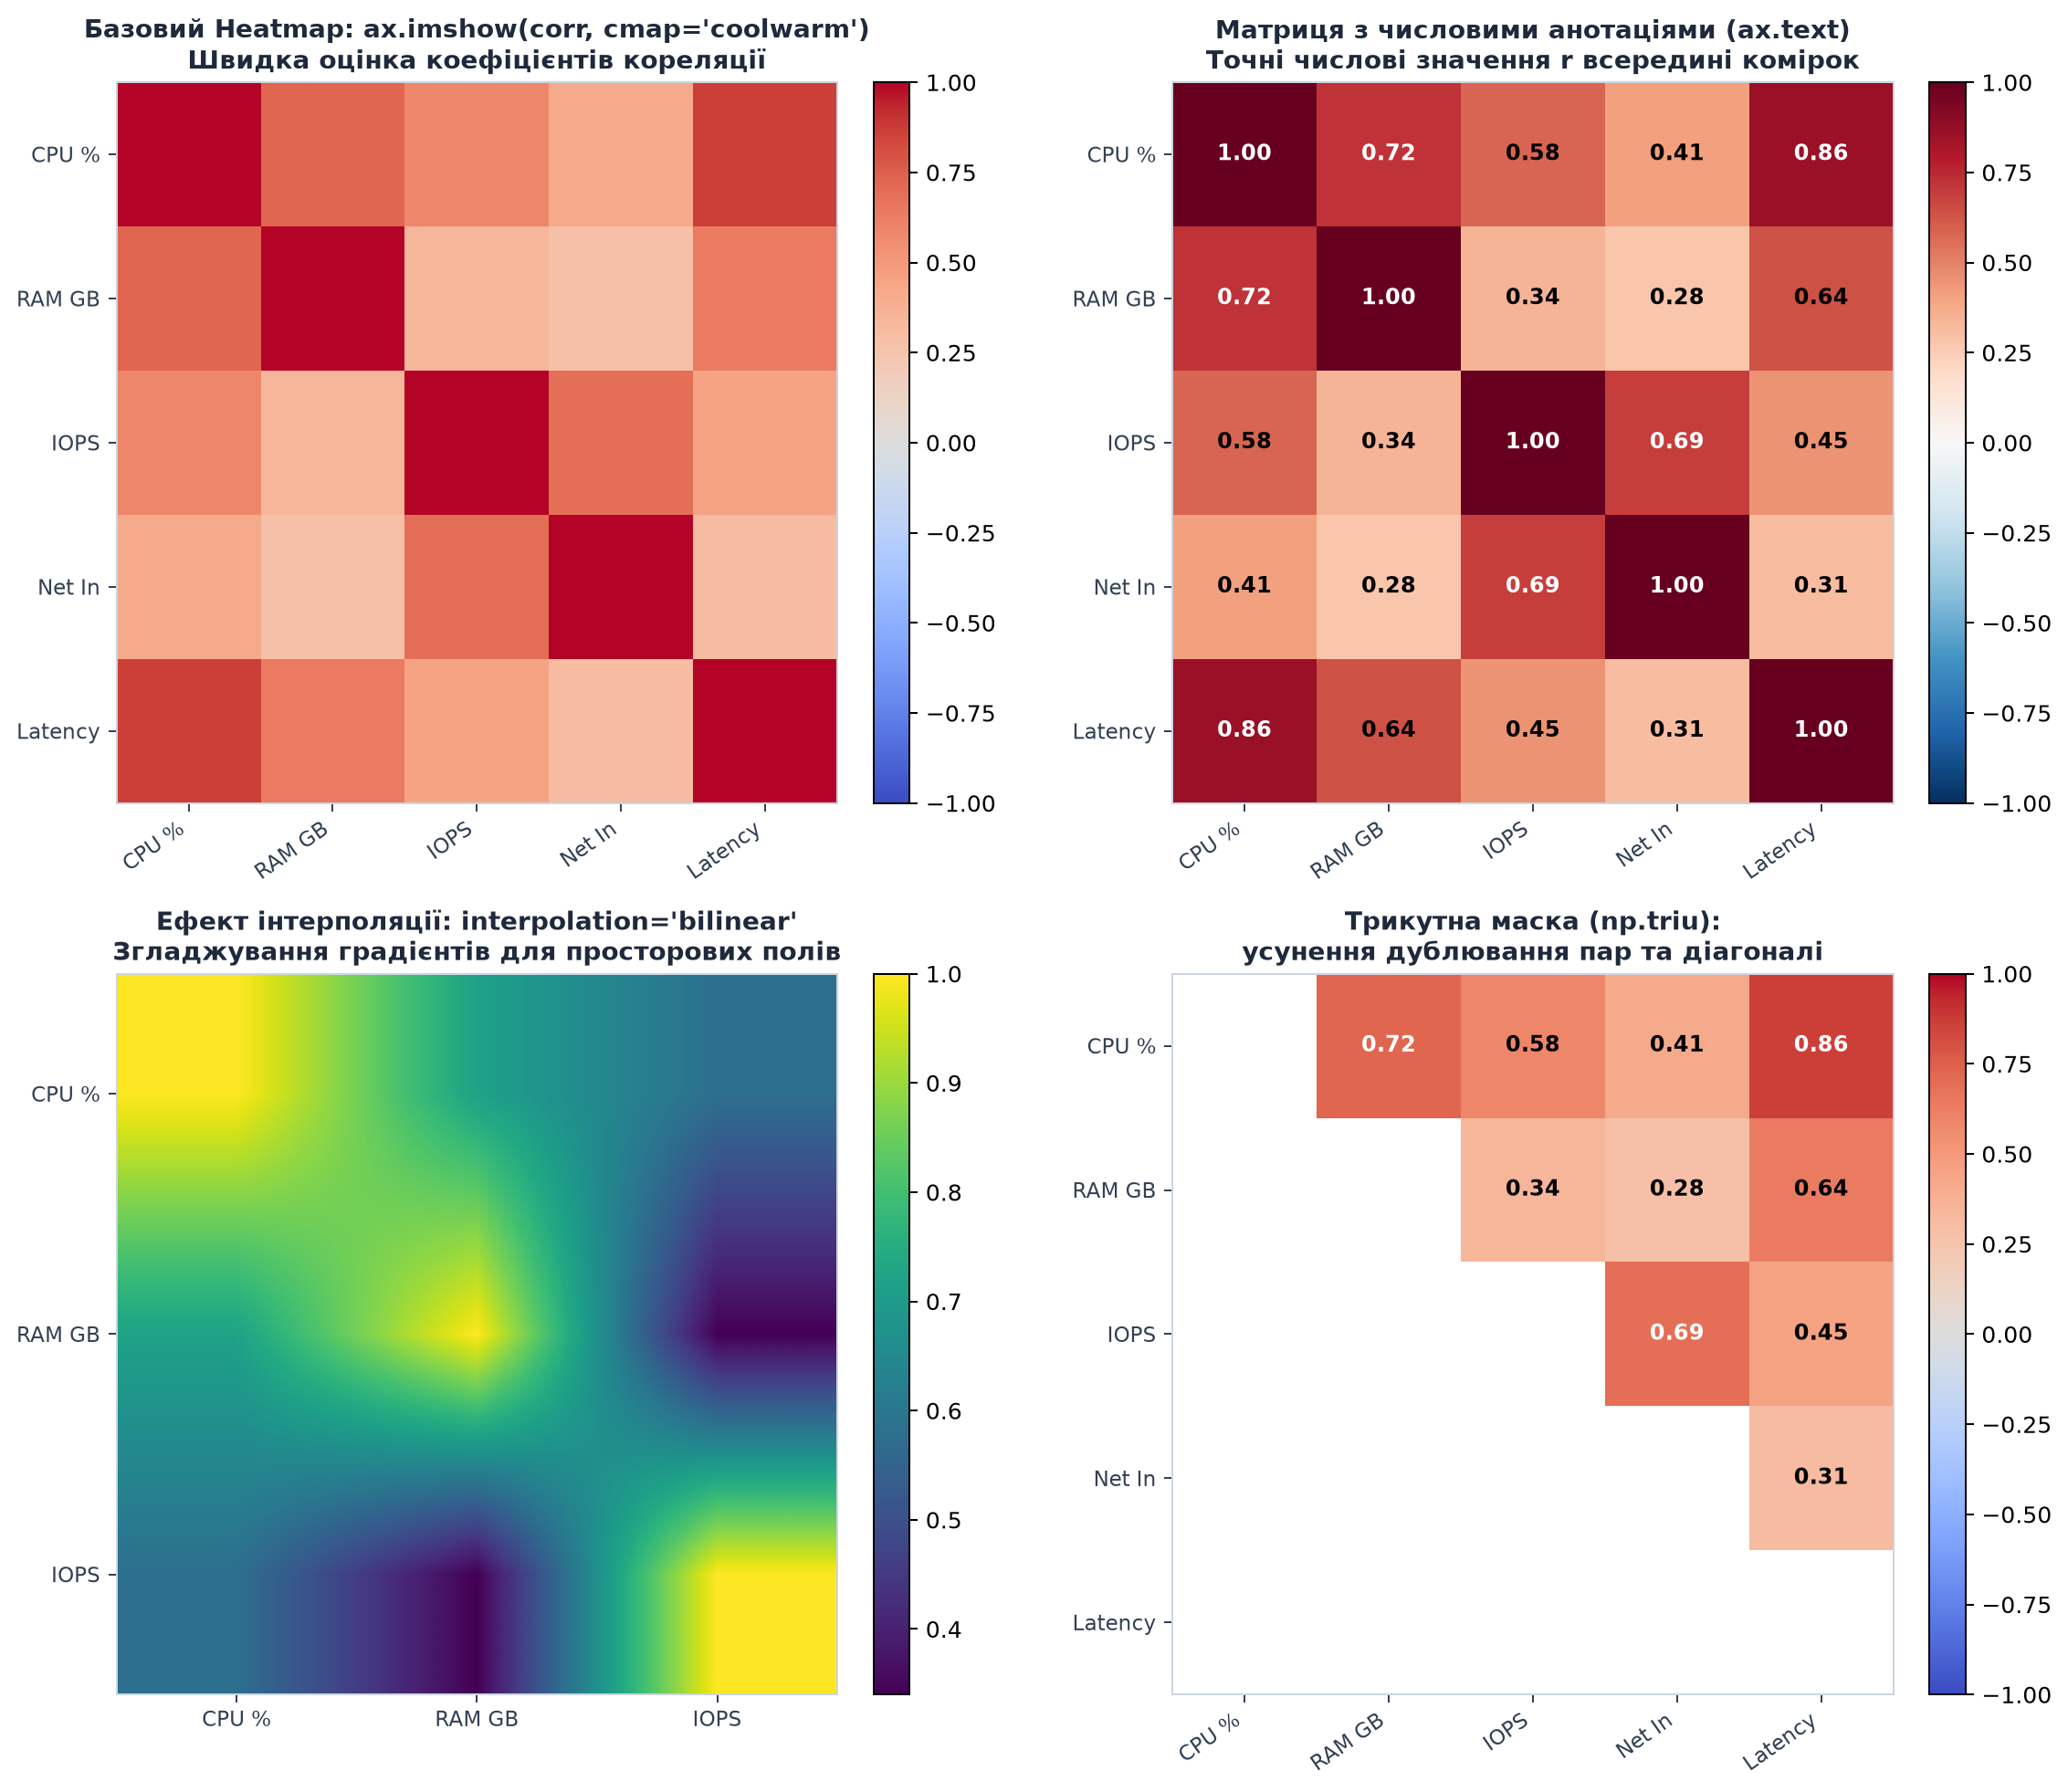
Професійний прийом: Маскування верхнього трикутника
Матриця кореляцій симетрична відносно головної діагоналі ($r_ = r_$), а на самій діагоналі завжди стоять тривіальні одиниці ($r_ = 1.0$).
Використання np.triu() або np.tril() у поєднанні з np.ma.masked_where() зменшує візуальне навантаження на людину вдвічі, залишаючи лише унікальні співвідношення пар змінних.
Практичні завдання
📝 Рівень 1: Базові навички
Завдання 1.1: Згенеруйте 100 пар (x, y), де y = 3x + 5 + шум. Побудуйте scatter plot. Додайте лінію тренду. Обчисліть коефіцієнт кореляції.
Завдання 1.2: Створіть датасет з нелінійною залежністю: y = x² + шум на інтервалі -5, 5. Побудуйте scatter. Обчисліть r. Поясніть, чому r близький до 0, хоча зв'язок очевидний.
Завдання 1.3: Побудуйте scatter plot з кольоровим кодуванням третьої змінної (наприклад, результати іспиту з годинами навчання, колір = спеціальність студента).
🧮 Рівень 2: Аналіз даних
Завдання 2.1: Завантажте датасет Iris (seaborn.load_dataset("iris")). Побудуйте scatter для sepal_length vs sepal_width. Кольором закодуйте вид (species). Зробіть висновки.
Завдання 2.2: Для датасету Tips (seaborn.load_dataset("tips")) побудуйте scatter: total_bill vs tip. Розміром точок закодуйте size (кількість людей). Кольором — time (день/вечір).
Завдання 2.3: Створіть scatter matrix для датасету з 5 змінних (наприклад, з модуля sklearn.datasets завантажте Boston Housing або California Housing). Знайдіть дві змінні з найсильнішою кореляцією.
🚀 Рівень 3: Дослідницький проєкт
Проєкт: Аналіз хибної кореляції
- Згенеруйте три змінні:
temperature(температура повітря 15–35°C)ice_cream_sales= f(temperature) + шумdrownings= g(temperature) + шум
- Побудуйте scatter plot:
ice_cream_salesvsdrownings. Обчисліть r. - Покажіть, що кореляція хибна: побудуйте два окремі scatter:
temperaturevsice_cream_salesтаtemperaturevsdrownings. Використайте колірне кодування температури. - Напишіть короткий висновок: чому продажі морозива корелюють з утопленнями, але не спричиняють їх.
Резюме підтеми
📊 Scatter Plots
ax.scatter(x, y)— візуалізація залежності між двома змінними- Форма хмари точок показує тип кореляції:
- Вгору вправо → позитивна (r > 0)
- Вниз вправо → негативна (r < 0)
- Хаос → немає лінійного зв'язку (r ≈ 0)
- Завжди будуйте scatter перед обчисленням r!
🎯 Кореляція vs Каузальність
- Кореляція — це асоціація (A та B змінюються разом)
- Каузальність — причинно-наслідковий зв'язок (A спричиняє B)
- Scatter показує кореляцію, але не доводить каузальність
- Завжди шукайте третю змінну (confounder)
🎨 Багатовимірна візуалізація
- Третя змінна → колір точок (
c=values, cmap="viridis") - Четверта змінна → розмір точок (
s=sizes) - Scatter matrix → всі пари змінних одразу
- Кореляційна heatmap → компактна альтернатива
- Побудували scatter plot для пари змінних
- Визначили тип залежності (лінійна / нелінійна / немає)
- Обчислили коефіцієнт кореляції r
- Перевірили, чи r адекватно описує зв'язок (для нелінійних — ні!)
- Додали лінію тренду, якщо залежність лінійна
- Замислились: чи є каузальний зв'язок або лише асоціація?
- Шукали викиди (точки далеко від основної хмари)
- Якщо змінних багато — побудували scatter matrix
Попередня підтема: Візуалізація розподілівНаступна підтема: Візуалізація категоріальних даних — bar charts та pie charts
Візуалізація розподілів — гістограми та box plots
Гістограми для неперервних даних, правило вибору bins, box plots для виявлення викидів, violin plots для порівняння груп
Візуалізація категоріальних даних — bar charts та pie charts
Стовпчасті діаграми для порівняння категорій, горизонтальні та вертикальні bar charts, групові та stacked bars, pie charts та коли їх уникати