Візуалізація розподілів — гістограми та box plots
Візуалізація розподілів — гістограми та box plots
🎯 Мета підтеми
- Навчитися будувати гістограми для візуалізації розподілів
- Зрозуміти правило вибору кількості bins (стовпців)
- Опанувати box plots для виявлення викидів та порівняння груп
- Навчитися інтерпретувати форму розподілу (нормальний, асиметричний, бімодальний)
🔑 Ключові терміни
- Гістограма (histogram) — графік розподілу неперервної змінної
- Bins — інтервали (стовпці), на які розбивається діапазон даних
- Box plot — діаграма «ящик з вусами» для візуалізації квартилів та викидів
- Квартилі — значення, що ділять дані на 4 рівні частини (Q1, Q2=медіана, Q3)
- IQR — міжквартильний розмах (Q3 - Q1)
Перша гістограма за 10 секунд: «Hello World» у візуалізації розподілів
Коли інженер працює з великим масивом числових даних, перше завдання — не рахувати складні статистичні формули, а побачити форму даних на власні очі. Таблиця з тисячі чисел створює інформаційний хаос. Гістограма здатна розкрити структуру всієї вибірки всього за 3 рядки коду.
Сюжетна лінія (Етап 1: Первинний аудит метрик сервісу):
Уявіть, що ви відповідаєте за стабільність бекенду веб-застосунку. Кожен HTTP-запит має свій час обробки (затримку або latency у мілісекундах). У логах сервера накопичилися тисячі записів:95, 110, 102, 105, 520, 108...
Тімлід запитує: «Чи стабільно працює система? Який типовий час очікування для більшості клієнтів і чи є критичні зависання?». Щоб миттєво відповісти на це питання, ми будуємо першу гістограму.
Рівень 0: Абсолютний мінімум (3 рядки коду)
Щоб побудувати гістограму, достатньо передати сирий список чисел у функцію plt.hist():
import matplotlib.pyplot as plt

raw_data = [1, 2, 2, 3, 3, 3, 4, 4, 5]
plt.hist(raw_data)
plt.show()
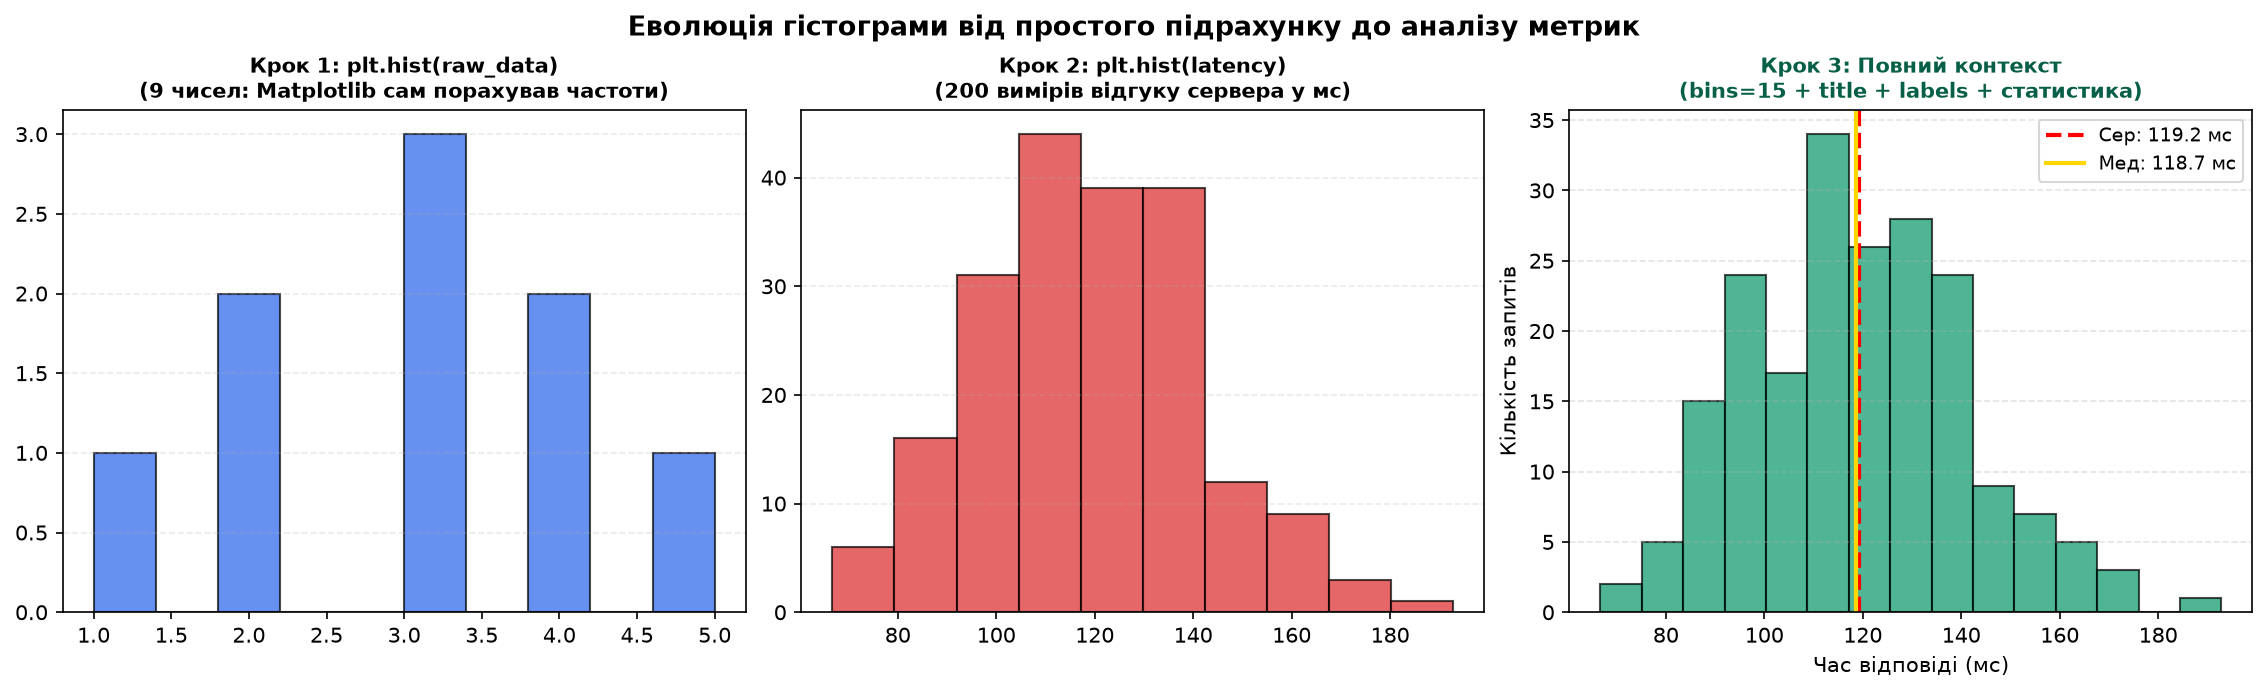
Вам не довелося вручну рахувати, скільки разів зустрічається кожне число. Matplotlib самостійно розбив діапазон на інтервали (bins), підрахував частоту появи значень і накреслив вертикальні стовпці.
Рівень 1: Реальні дані (семпл часу відповіді сервера)
Перейдемо до реальних метрик: згенеруємо 200 вимірів часу відповіді сервера (у мілісекундах) із середнім значенням 120 мс:
import numpy as np

rng = np.random.default_rng(seed=42)
latency = rng.normal(loc=120, scale=25, size=200)

plt.hist(latency)
plt.show()
Стовпці графіка одразу показують центр скупчення більшості запитів.
Рівень 2: Додаємо контекст (інтервали, підписи та орієнтири)
Щоб перетворити швидкий нарис на зрозумілий інженерний звіт, зафіксуємо кількість інтервалів (bins=15), додамо підписи осей та вертикальні лінії середнього значення й медіани:
plt.hist(latency, bins=15, color="#059669", edgecolor="black", alpha=0.7)
plt.axvline(np.mean(latency), color="red", linestyle="--", linewidth=2, label="Середнє")
plt.axvline(np.median(latency), color="gold", linestyle="-", linewidth=2, label="Медіана")
plt.title("Розподіл затримки сервера (Latency)")
plt.xlabel("Час відповіді (мс)")
plt.ylabel("Кількість запитів")
plt.legend()
plt.grid(axis="y", alpha=0.3)
plt.show()
import matplotlib.pyplot as plt
import numpy as np

fig, (ax1, ax2, ax3) = plt.subplots(1, 3, figsize=(15, 4.5), layout="constrained")

# Крок 1: Рівень 0 - Лише список чисел
raw_data = [1, 2, 2, 3, 3, 3, 4, 4, 5]
ax1.hist(raw_data, color="#2563EB", edgecolor="black", alpha=0.7)
ax1.set_title("Крок 1: plt.hist(raw_data)\n(9 чисел: Matplotlib сам порахував частоти)",
              fontsize=10, fontweight="bold")
ax1.grid(axis="y", alpha=0.25, ls="--")

# Крок 2: Рівень 1 - Реальний семпл часу відповіді сервера (Latency в мс)
rng = np.random.default_rng(seed=42)
latency = rng.normal(loc=120, scale=25, size=200)
ax2.hist(latency, color="#DC2626", edgecolor="black", alpha=0.7)
ax2.set_title("Крок 2: plt.hist(latency)\n(200 вимірів відгуку сервера у мс)",
              fontsize=10, fontweight="bold")
ax2.grid(axis="y", alpha=0.25, ls="--")

# Крок 3: Рівень 2 - Додавання контексту та ліній статистики
ax3.hist(latency, bins=15, color="#059669", edgecolor="black", alpha=0.7)
ax3.axvline(np.mean(latency), color="red", ls="--", lw=2, label=f"Сер: {np.mean(latency):.1f} мс")
ax3.axvline(np.median(latency), color="gold", ls="-", lw=2, label=f"Мед: {np.median(latency):.1f} мс")
ax3.set_title("Крок 3: Повний контекст\n(bins=15 + title + labels + статистика)",
              fontsize=10, fontweight="bold", color="#065F46")
ax3.set_xlabel("Час відповіді (мс)", fontsize=10)
ax3.set_ylabel("Кількість запитів", fontsize=10)
ax3.legend(fontsize=9)
ax3.grid(axis="y", alpha=0.35, ls="--")

fig.suptitle("Еволюція гістограми від простого підрахунку до аналізу метрик", fontsize=13, fontweight="bold")
plt.show()
Історія про вимірювання зросту
Уявіть: медична клініка виміряла зріст 500 пацієнтів. Директор хоче зрозуміти:
- Який типовий зріст? (не середнє — воно може бути спотворене)
- Чи є аномалії (наприклад, дитину виміряли разом з дорослими)?
- Як розподілені дані — симетрично чи є перекіс?
Перший інстинкт — подивитися на таблицю з 500 числами. Але це марно. Гістограма показує це за 3 секунди.
Розподіл зросту 500 пацієнтів
Візуалізація допомагає побачити паттерни, невидимі в таблиці
import matplotlib.pyplot as plt
import numpy as np

# Генеруємо реалістичні дані: зріст дорослих (нормальний розподіл)
rng = np.random.default_rng(seed=42)
heights = rng.normal(loc=170, scale=10, size=500)

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 5))

# Ліворуч: спроба показати дані текстом (нечитабельно)
ax1.text(0.05, 0.5, f"Перші 50 значень:\n{heights[:50].round(1)}",
         fontsize=7, family="monospace", verticalalignment="center")
ax1.set_title("Дані у вигляді чисел\n(неможливо зрозуміти структуру)",
              fontsize=12, fontweight="bold")
ax1.axis("off")

# Праворуч: гістограма (одразу видно розподіл!)
ax2.hist(heights, bins=30, color="steelblue", edgecolor="black", alpha=0.7)
ax2.axvline(heights.mean(), color="red", linestyle="--", linewidth=2,
            label=f"Середнє: {heights.mean():.1f} см")
ax2.axvline(np.median(heights), color="green", linestyle="--", linewidth=2,
            label=f"Медіана: {np.median(heights):.1f} см")

ax2.set_title("Гістограма розподілу зросту\n(структура видна одразу)",
              fontsize=12, fontweight="bold")
ax2.set_xlabel("Зріст (см)", fontsize=11)
ax2.set_ylabel("Кількість пацієнтів", fontsize=11)
ax2.legend()
ax2.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
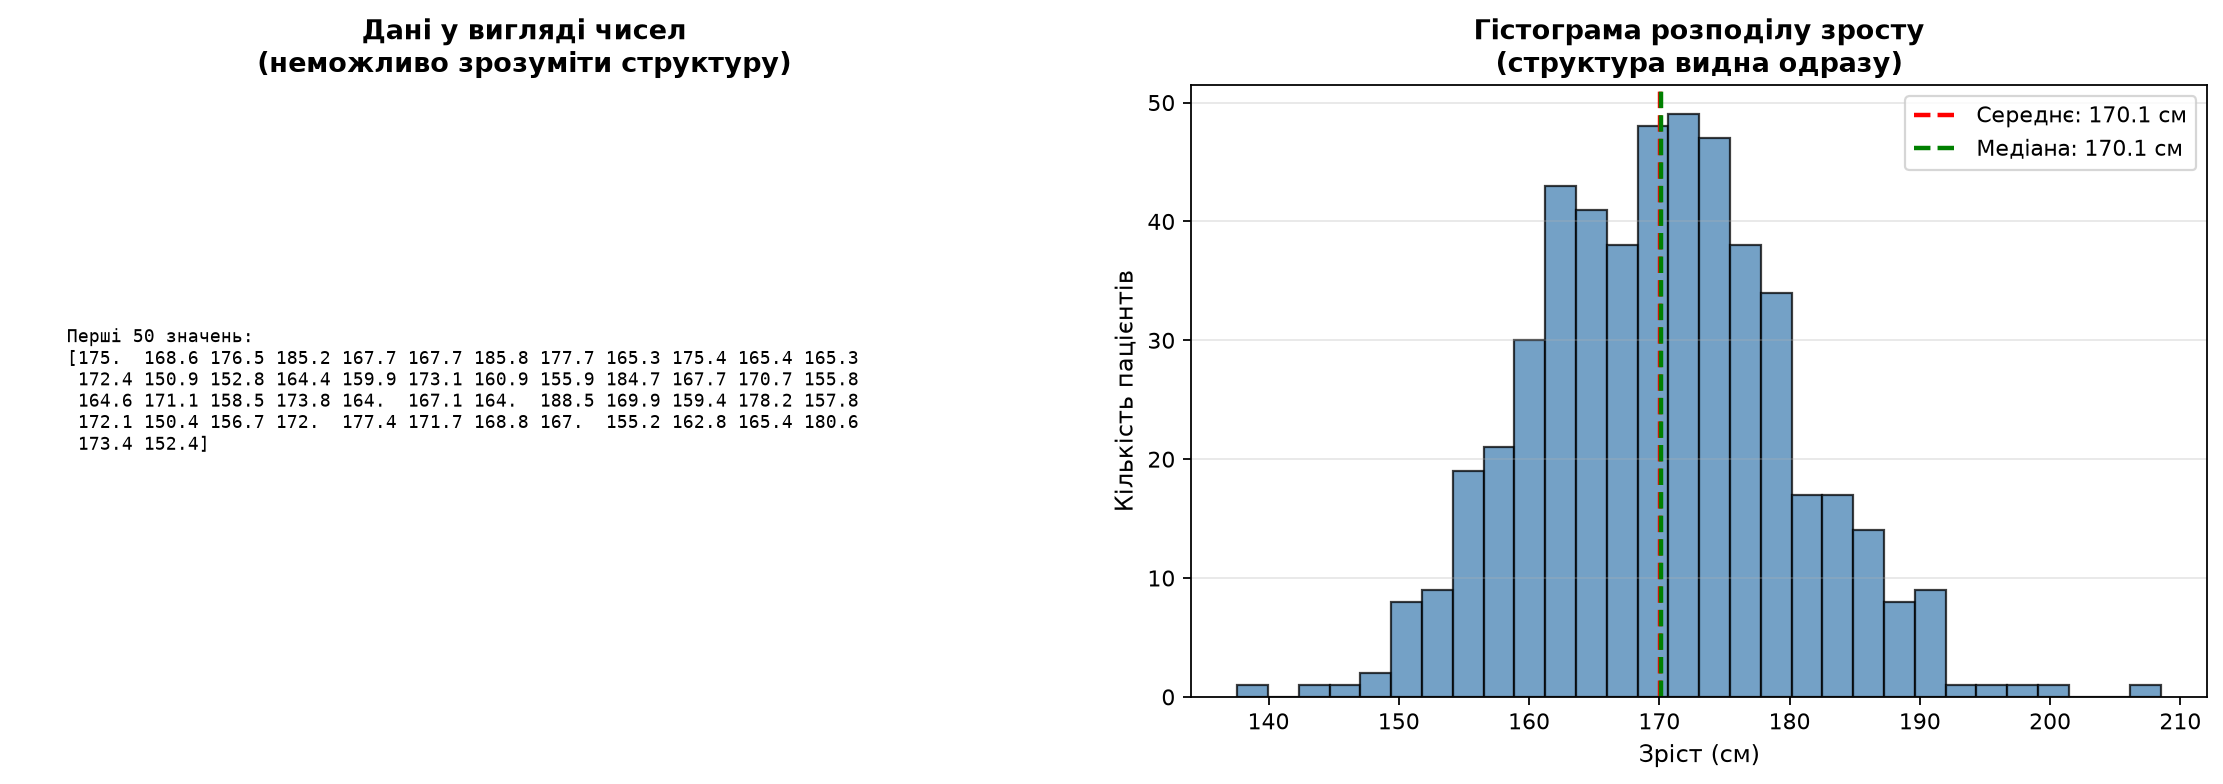
Висновки з гістограми:
- Розподіл майже симетричний (форма дзвона) → нормальний розподіл
- Пік близько 170 см → типовий зріст
- Середнє ≈ Медіана → немає сильних викидів
- Діапазон: ~145–195 см → відсутні аномальні значення
Це те, що неможливо побачити в таблиці з 500 чисел!
- Гістограма візуалізує те, що описують статистичні показники (середнє, дисперсія, медіана)
- Якщо ви бачите «дзвін» на гістограмі — це нормальний розподіл
- Якщо пік зсунутий вліво або вправо — асиметричний розподіл (skewed)
- Якщо два піки — бімодальний розподіл (дві підгрупи в даних)
Гістограми — візуалізація розподілу неперервних даних
Що таке гістограма?
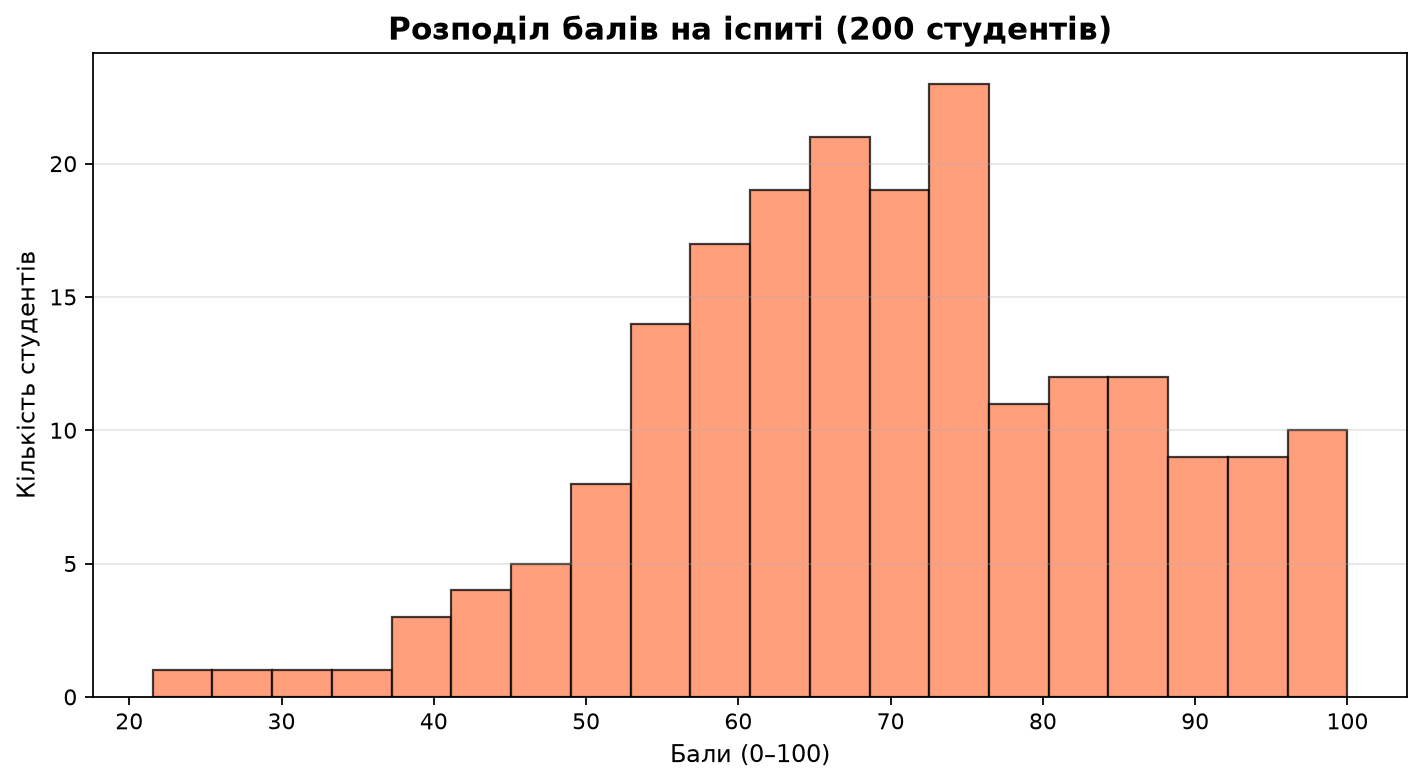
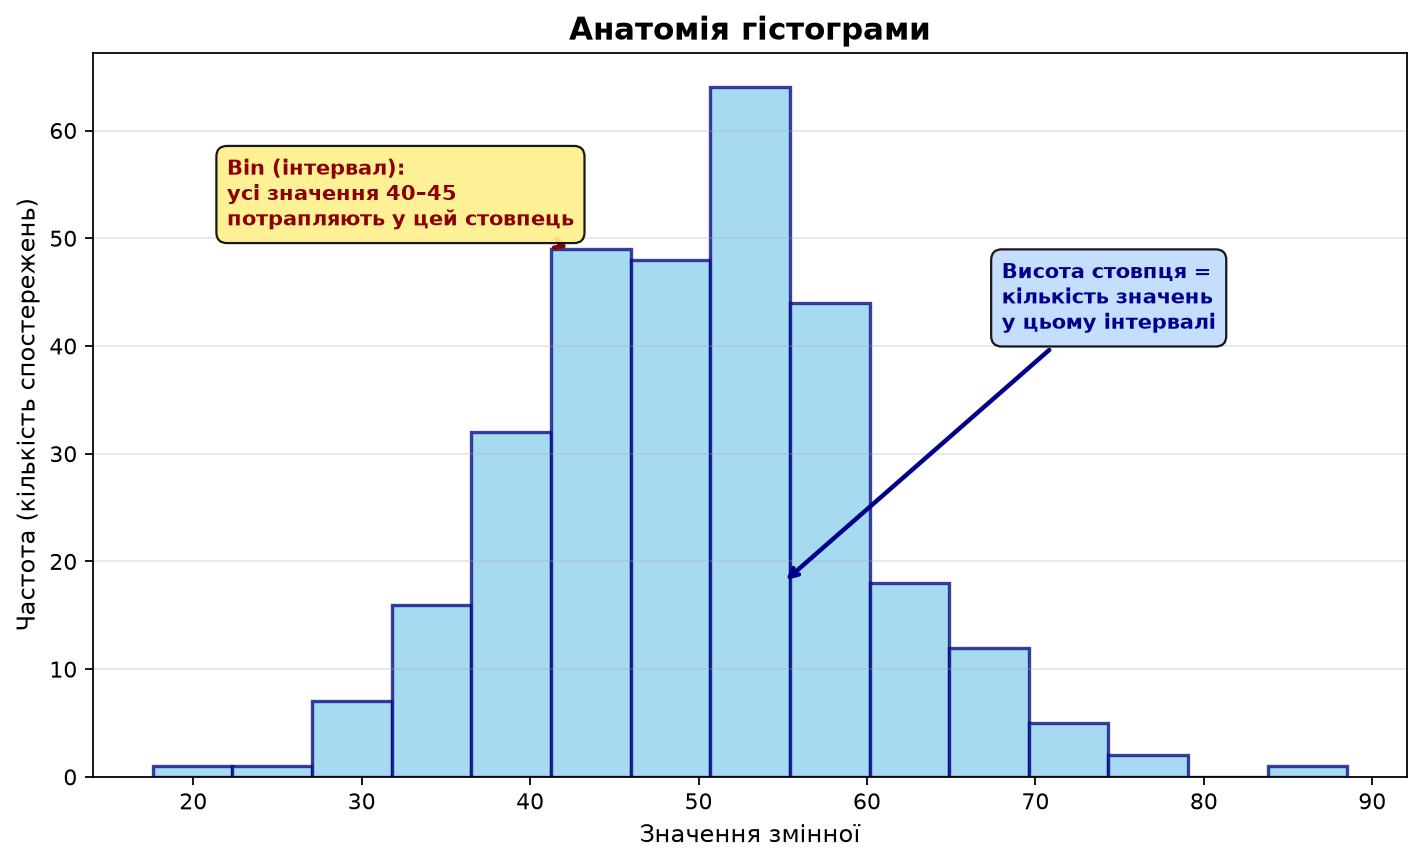
Гістограма (histogram) — це графік, що показує, як часто зустрічаються значення у певних інтервалах (bins).
Аналогія: уявіть, що ви сортуєте монети за номіналом у коробки. Перша коробка — монети 1–10 коп., друга — 11–25 коп., третя — 26–50 коп. тощо. Гістограма — це графік кількості монет у кожній коробці.
Відмінність від bar chart:
- Гістограма — для неперервних даних (зріст, вага, вік). Стовпці стикаються — бо між ними немає розривів
- Bar chart — для категорій (країни, продукти). Стовпці розділені — бо категорії дискретні
import matplotlib.pyplot as plt
import numpy as np

# Дані: результати іспиту 200 студентів (0–100 балів)
rng = np.random.default_rng(seed=123)
scores = rng.normal(loc=70, scale=15, size=200)
scores = np.clip(scores, 0, 100)  # Обмежуємо діапазон [0, 100]

fig, ax = plt.subplots(figsize=(10, 6))

# Будуємо гістограму
counts, bins, patches = ax.hist(scores, bins=20, color="coral",
                                 edgecolor="black", alpha=0.7)

ax.set_title("Розподіл балів на іспиті (200 студентів)",
             fontsize=14, fontweight="bold")
ax.set_xlabel("Бали (0–100)", fontsize=12)
ax.set_ylabel("Кількість студентів", fontsize=12)
ax.grid(axis="y", alpha=0.3)

# Додаємо вертикальні лінії для статистики
mean_score = scores.mean()
median_score = np.median(scores)

ax.axvline(mean_score, color="red", linestyle="--", linewidth=2,
           label=f"Середнє: {mean_score:.1f}")
ax.axvline(median_score, color="green", linestyle="--", linewidth=2,
           label=f"Медіана: {median_score:.1f}")
ax.legend(fontsize=11)

plt.tight_layout()
plt.show()
Анатомія гістограми
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(seed=42)
data = rng.normal(50, 10, 300)

fig, ax = plt.subplots(figsize=(10, 6))

counts, bins, patches = ax.hist(data, bins=15, color="skyblue",
                                 edgecolor="navy", alpha=0.7, linewidth=1.5)

ax.set_title("Анатомія гістограми", fontsize=14, fontweight="bold")
ax.set_xlabel("Значення змінної", fontsize=12)
ax.set_ylabel("Частота (кількість спостережень)", fontsize=12)

# Анотації для пояснення
ax.annotate("Bin (інтервал):\nусі значення 40–45\nпотрапляють у цей стовпець",
            xy=(42.5, counts[5]), xytext=(30, counts.max()*0.8),
            fontsize=10, color="darkred", weight="bold",
            arrowprops=dict(arrowstyle="->", color="darkred", lw=2),
            bbox=dict(boxstyle="round,pad=0.5", facecolor="yellow", alpha=0.7))

ax.annotate("Висота стовпця =\nкількість значень\nу цьому інтервалі",
            xy=(55, counts[9]), xytext=(70, counts.max()*0.6),
            fontsize=10, color="darkblue", weight="bold",
            arrowprops=dict(arrowstyle="->", color="darkblue", lw=2),
            bbox=dict(boxstyle="round,pad=0.5", facecolor="lightblue", alpha=0.7))

ax.grid(axis="y", alpha=0.3)
plt.tight_layout()
plt.show()
Сигнатура методу ax.hist() та параметричні варіації
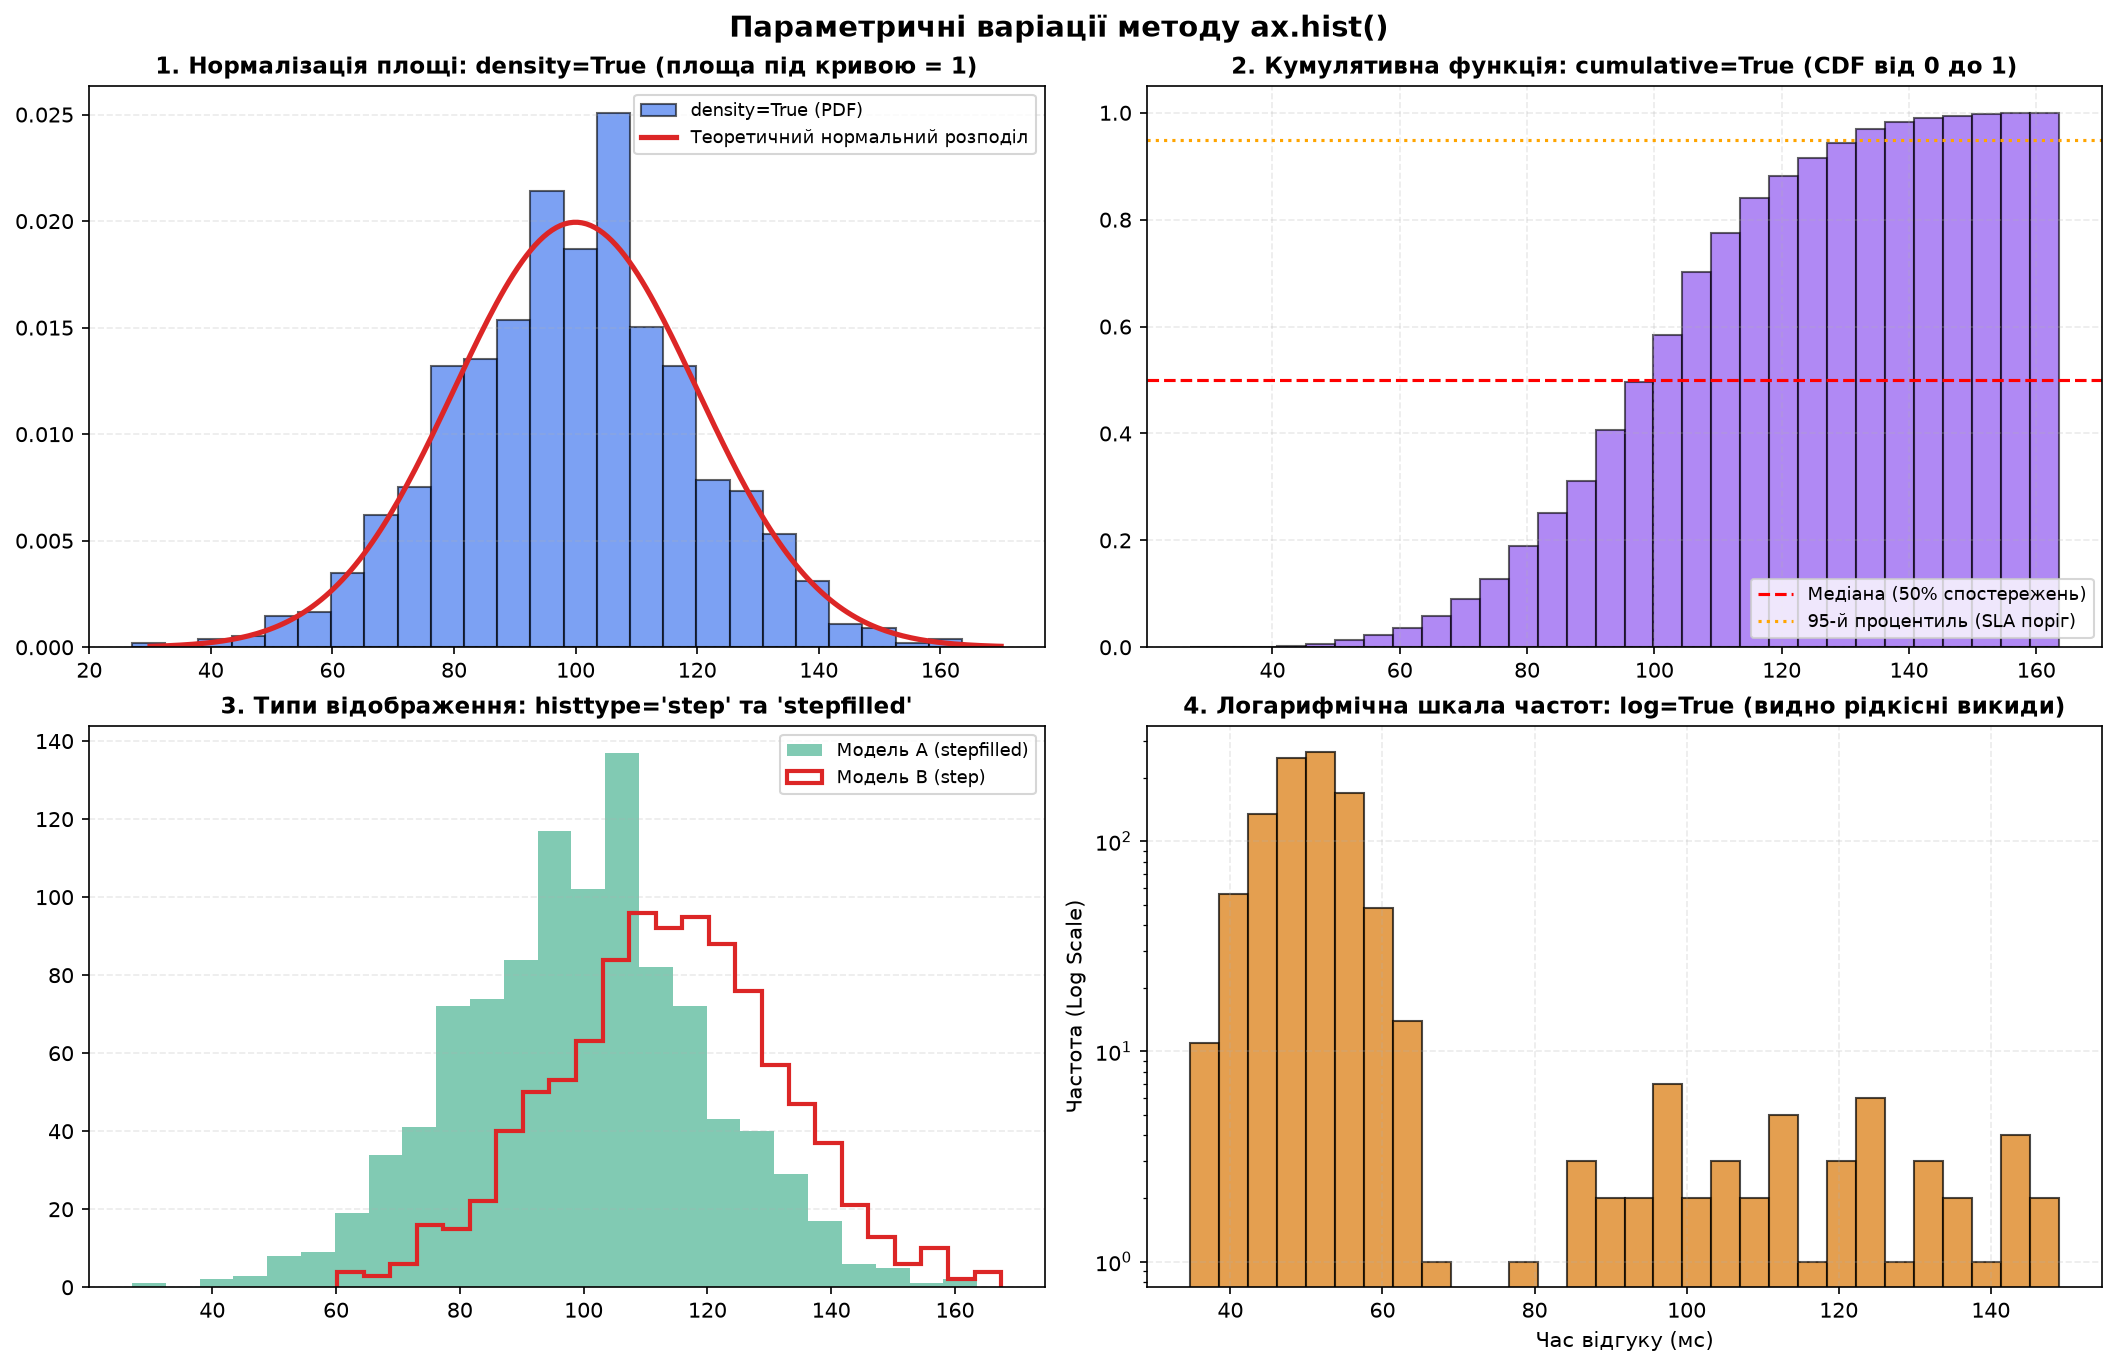
Метод ax.hist() розбиває числову послідовність на вказану кількість інтервалів, підраховує кількість точок у кожному стовпці та малює стовпчикову діаграму. Він повертає кортеж із трьох елементів: (counts, bins, patches).
Axes.hist(
    x: ArrayLike | Sequence[ArrayLike],
    bins: int | Sequence[float] | str | None = None,
    range: tuple[float, float] | None = None,
    density: bool = False,
    weights: ArrayLike | None = None,
    cumulative: bool | float = False,
    bottom: ArrayLike | float | None = None,
    histtype: Literal['bar', 'barstacked', 'step', 'stepfilled'] = 'bar',
    align: Literal['left', 'mid', 'right'] = 'mid',
    orientation: Literal['vertical', 'horizontal'] = 'vertical',
    rwidth: float | None = None,
    log: bool = False,
    color: ColorType | None = None,
    label: str | Sequence[str] | None = None,
    stacked: bool = False,
    **kwargs
) -> tuple[np.ndarray | list[np.ndarray], np.ndarray, BarContainer | Polygon | list[BarContainer | Polygon]]
Аналіз ключових параметрів:
x: вхідні дані (одновимірний масив або список кількох масивів для спільної побудови).bins: кількість інтервалів (ціле число), конкретні координати меж інтервалів (масив чисел) або автоматичний алгоритм оцінки ('auto','sturges','fd','scott').density: якщоTrue, висота стовпців нормується так, що загальна площа під усією гістограмою дорівнює1.0. Це перетворює гістограму на емпіричну функцію щільності ймовірності (PDF), що дозволяє порівнювати вибірки різного обсягу або накладати аналітичні криві розподілів.cumulative: якщоTrue, будується кумулятивна функція розподілу (CDF), де кожен наступний стовпець включає суму всіх попередніх частот від 0 до 1 (або від 0 до $N$). Дозволяє миттєво визначити процентилі або SLA-поріг.histtype: геометричний стиль:'bar'— класичні зафарбовані стовпчики.'step'— контурна лінія без внутрішньої заливки (незамінна для накладання 3–4 розподілів без візуального конфлікту).'stepfilled'— ступінчастий контур із напівпрозорою заливкою.
log: якщоTrue, вісь частот переводиться в логарифмічний масштаб. Це критично для виявлення одиничних аномальних сплесків, які на лінійній шкалі губляться на рівні нуля.orientation: напрямок стовпців ('vertical'— за замовчуванням,'horizontal'— для розташування поруч із графіками розсіювання).
import matplotlib.pyplot as plt
import numpy as np

fig, axes = plt.subplots(2, 2, figsize=(14, 9), layout="constrained")
rng = np.random.default_rng(seed=42)
sample = rng.normal(loc=100, scale=20, size=1000)

# 1. density=True (щільність імовірності vs частоти)
ax = axes[0, 0]
ax.hist(sample, bins=25, density=True, color="#2563EB", edgecolor="black", alpha=0.6, label="density=True (PDF)")
# Додаємо теоретичну криву Гаусса
x_grid = np.linspace(30, 170, 200)
pdf = (1 / (20 * np.sqrt(2 * np.pi))) * np.exp(-0.5 * ((x_grid - 100) / 20) ** 2)
ax.plot(x_grid, pdf, color="#DC2626", lw=2.5, label="Теоретичний нормальний розподіл")
ax.set_title("1. Нормалізація площі: density=True (площа під кривою = 1)", fontsize=11, fontweight="bold")
ax.legend(fontsize=8.5)
ax.grid(axis="y", alpha=0.25, ls="--")

# 2. cumulative=True (кумулятивна емпірична функція розподілу CDF)
ax = axes[0, 1]
ax.hist(sample, bins=30, cumulative=True, density=True, color="#7C3AED", edgecolor="black", alpha=0.6)
ax.axhline(0.5, color="red", ls="--", label="Медіана (50% спостережень)")
ax.axhline(0.95, color="orange", ls=":", label="95-й процентиль (SLA поріг)")
ax.set_title("2. Кумулятивна функція: cumulative=True (CDF від 0 до 1)", fontsize=11, fontweight="bold")
ax.legend(fontsize=8.5, loc="lower right")
ax.grid(True, alpha=0.25, ls="--")

# 3. histtype ('bar', 'step', 'stepfilled')
ax = axes[1, 0]
sample2 = rng.normal(loc=115, scale=18, size=1000)
ax.hist(sample, bins=25, histtype="stepfilled", color="#059669", alpha=0.5, label="Модель A (stepfilled)")
ax.hist(sample2, bins=25, histtype="step", color="#DC2626", lw=2, label="Модель B (step)")
ax.set_title("3. Типи відображення: histtype='step' та 'stepfilled'", fontsize=11, fontweight="bold")
ax.legend(fontsize=8.5)
ax.grid(axis="y", alpha=0.25, ls="--")

# 4. log=True та orientation='horizontal'
ax = axes[1, 1]
# Згенеруємо розподіл із рідкісними спайками
spikes = np.concatenate([rng.normal(50, 5, 950), rng.uniform(80, 150, 50)])
ax.hist(spikes, bins=30, log=True, color="#D97706", edgecolor="black", alpha=0.7)
ax.set_title("4. Логарифмічна шкала частот: log=True (видно рідкісні викиди)", fontsize=11, fontweight="bold")
ax.set_xlabel("Час відгуку (мс)")
ax.set_ylabel("Частота (Log Scale)")
ax.grid(True, alpha=0.25, ls="--")

fig.suptitle("Параметричні варіації методу ax.hist()", fontsize=14, fontweight="bold")
plt.show()
Правило вибору кількості bins
Найчастіше питання: скільки стовпців (bins) потрібно для гістограми?
Відповідь: немає «правильного» числа — це баланс між деталізацією та узагальненням.
Сюжетна лінія (Етап 2: Баланс деталізації при моніторингу черги):
Коли ви налаштовуєте моніторинг сервісу, вибір кількості інтервалів (bins) має прямий вплив на швидкість і правильність діагностики. Якщо стовпців замало (наприклад, 5) — ви пропустите небезпечний «другий горб» (окрему групу запитів із великою затримкою). Якщо стовпців забагато (100) — графік перетвориться на гребінець випадкового шуму, де неможливо розгледіти загальну закономірність.
Вплив кількості bins на читабельність
Той самий датасет з різною кількістю інтервалів
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(seed=42)
data = rng.exponential(scale=2, size=500)

fig, axes = plt.subplots(2, 3, figsize=(15, 8))
fig.suptitle("Той самий датасет з різною кількістю bins",
             fontsize=15, fontweight="bold")

bins_values = [5, 10, 20, 30, 50, 100]

for ax, bins in zip(axes.flat, bins_values):
    ax.hist(data, bins=bins, color="teal", edgecolor="black", alpha=0.7)
    ax.set_title(f"bins={bins}", fontsize=12, fontweight="bold")
    ax.set_xlabel("Значення")
    ax.set_ylabel("Частота")
    ax.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
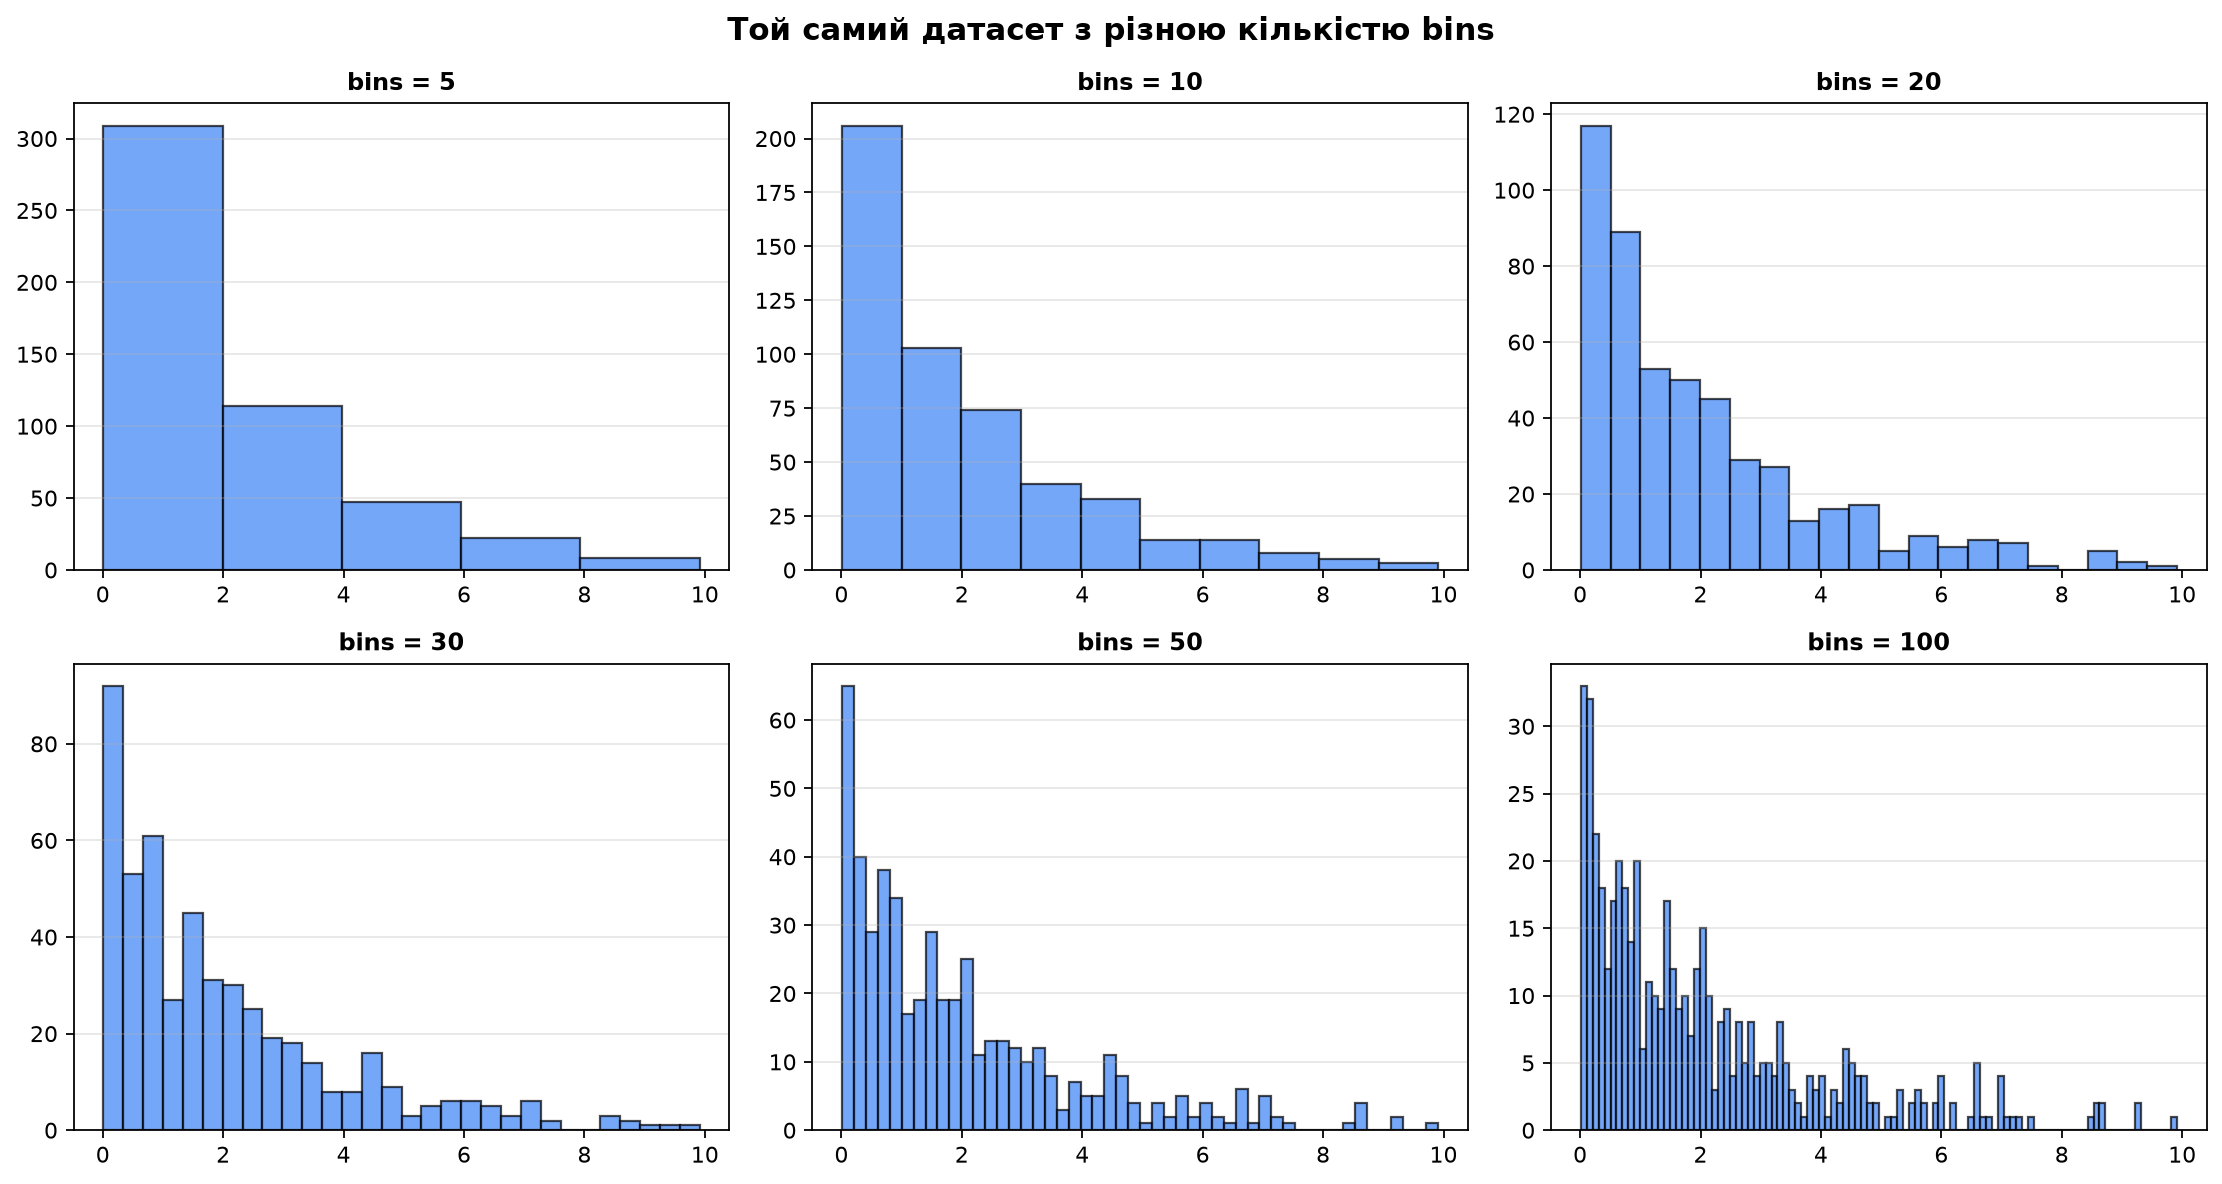
Висновки:
- bins=5 — занадто грубо, втрачаються деталі розподілу
- bins=10–20 — оптимально для більшості випадків, видно форму
- bins=50–100 — занадто детально, виникає «шум», важко побачити тренд
Золоте правило: для n спостережень використовуйте bins ≈ √n або bins ≈ log₂(n)
# Правило Стерджеса (для нормального розподілу)
ax.hist(data, bins="sturges")

# Правило Скотта (враховує розкид даних)
ax.hist(data, bins="scott")

# Правило Фрідмана-Діакона (robust метод)
ax.hist(data, bins="fd")

# Автоматичний вибір (рекомендовано)
ax.hist(data, bins="auto")
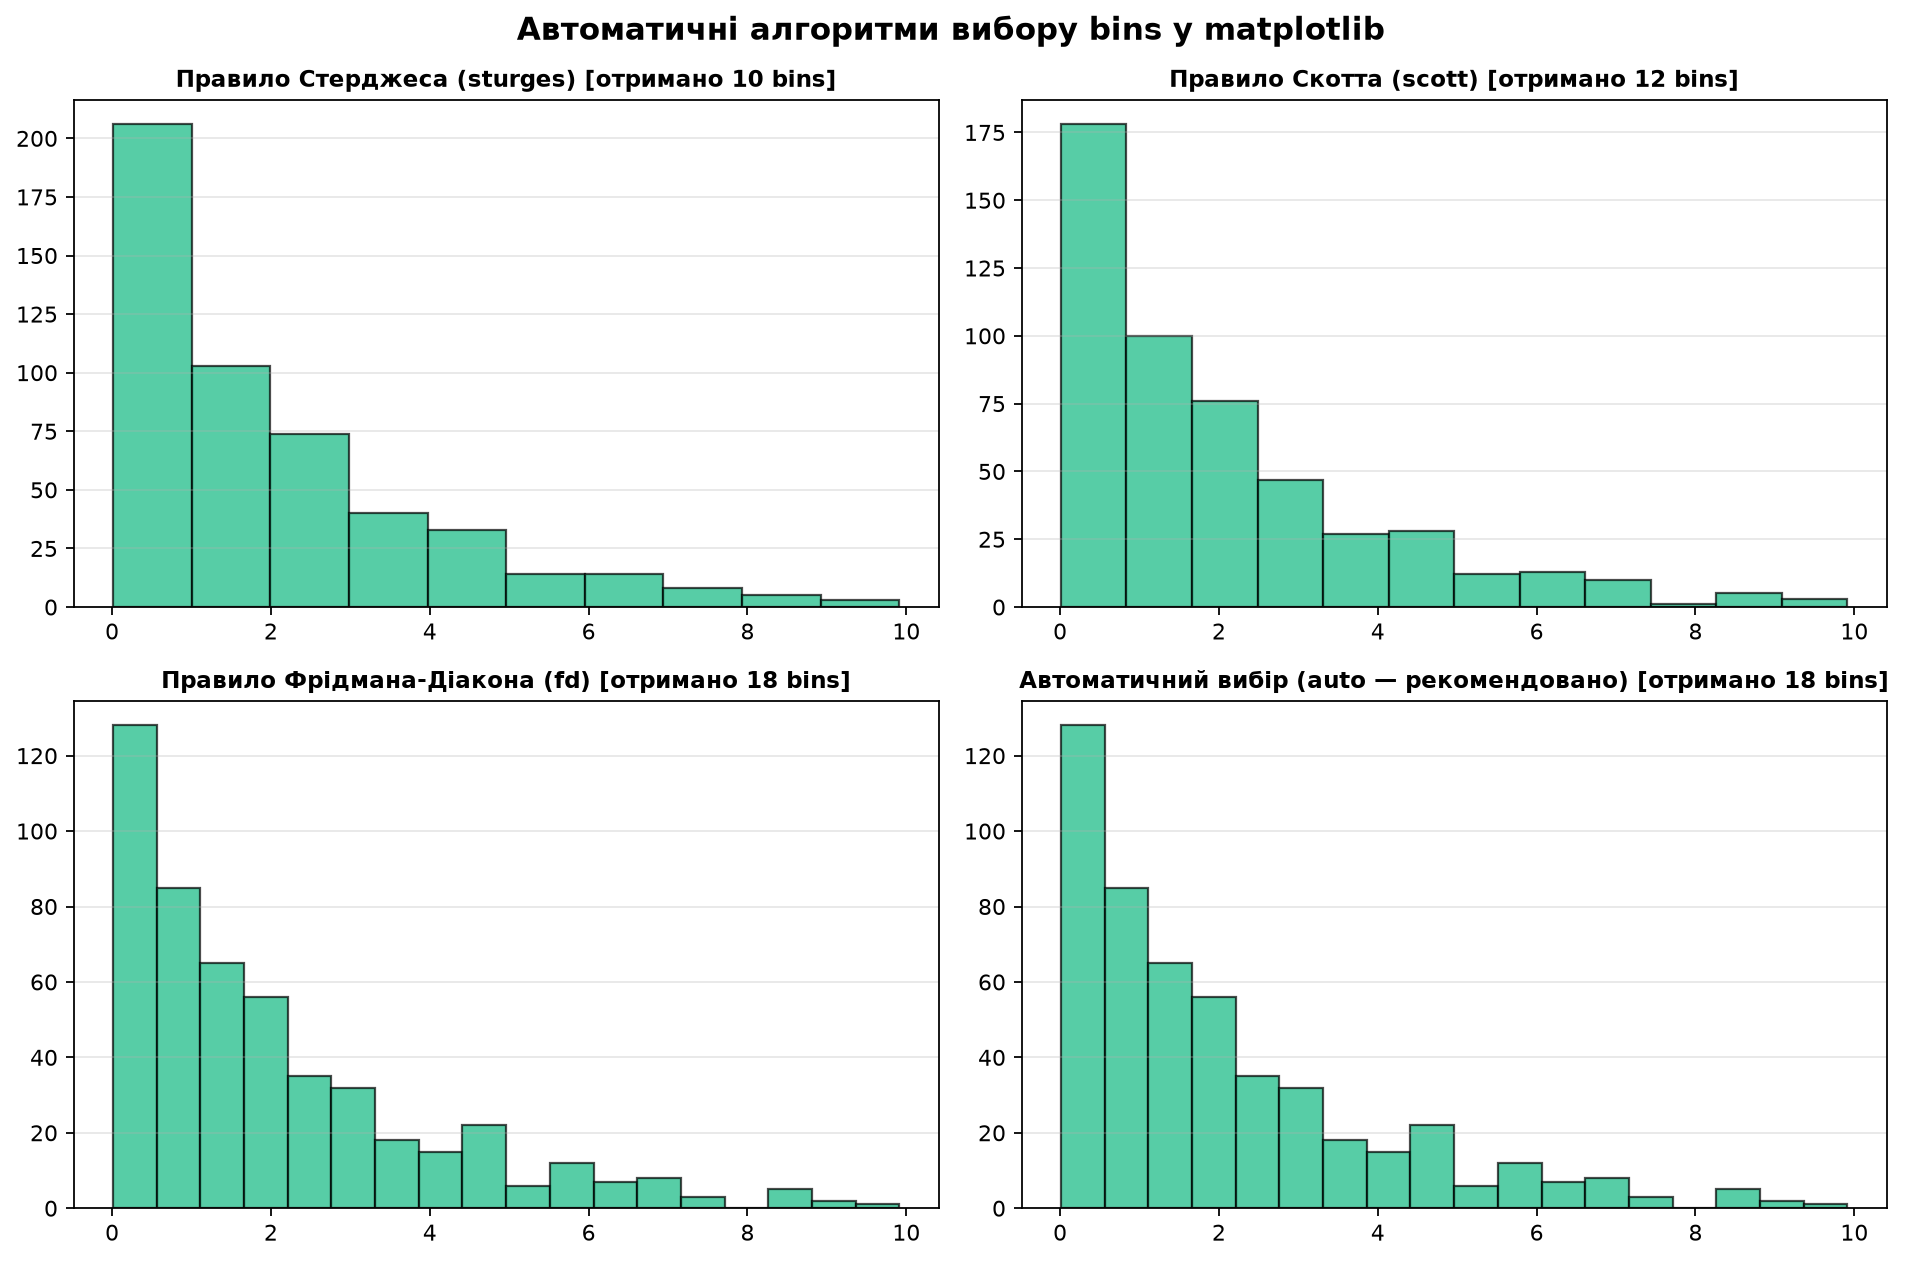 Для більшості випадків
bins="auto" дає чудовий результат!Інтерпретація форми розподілу
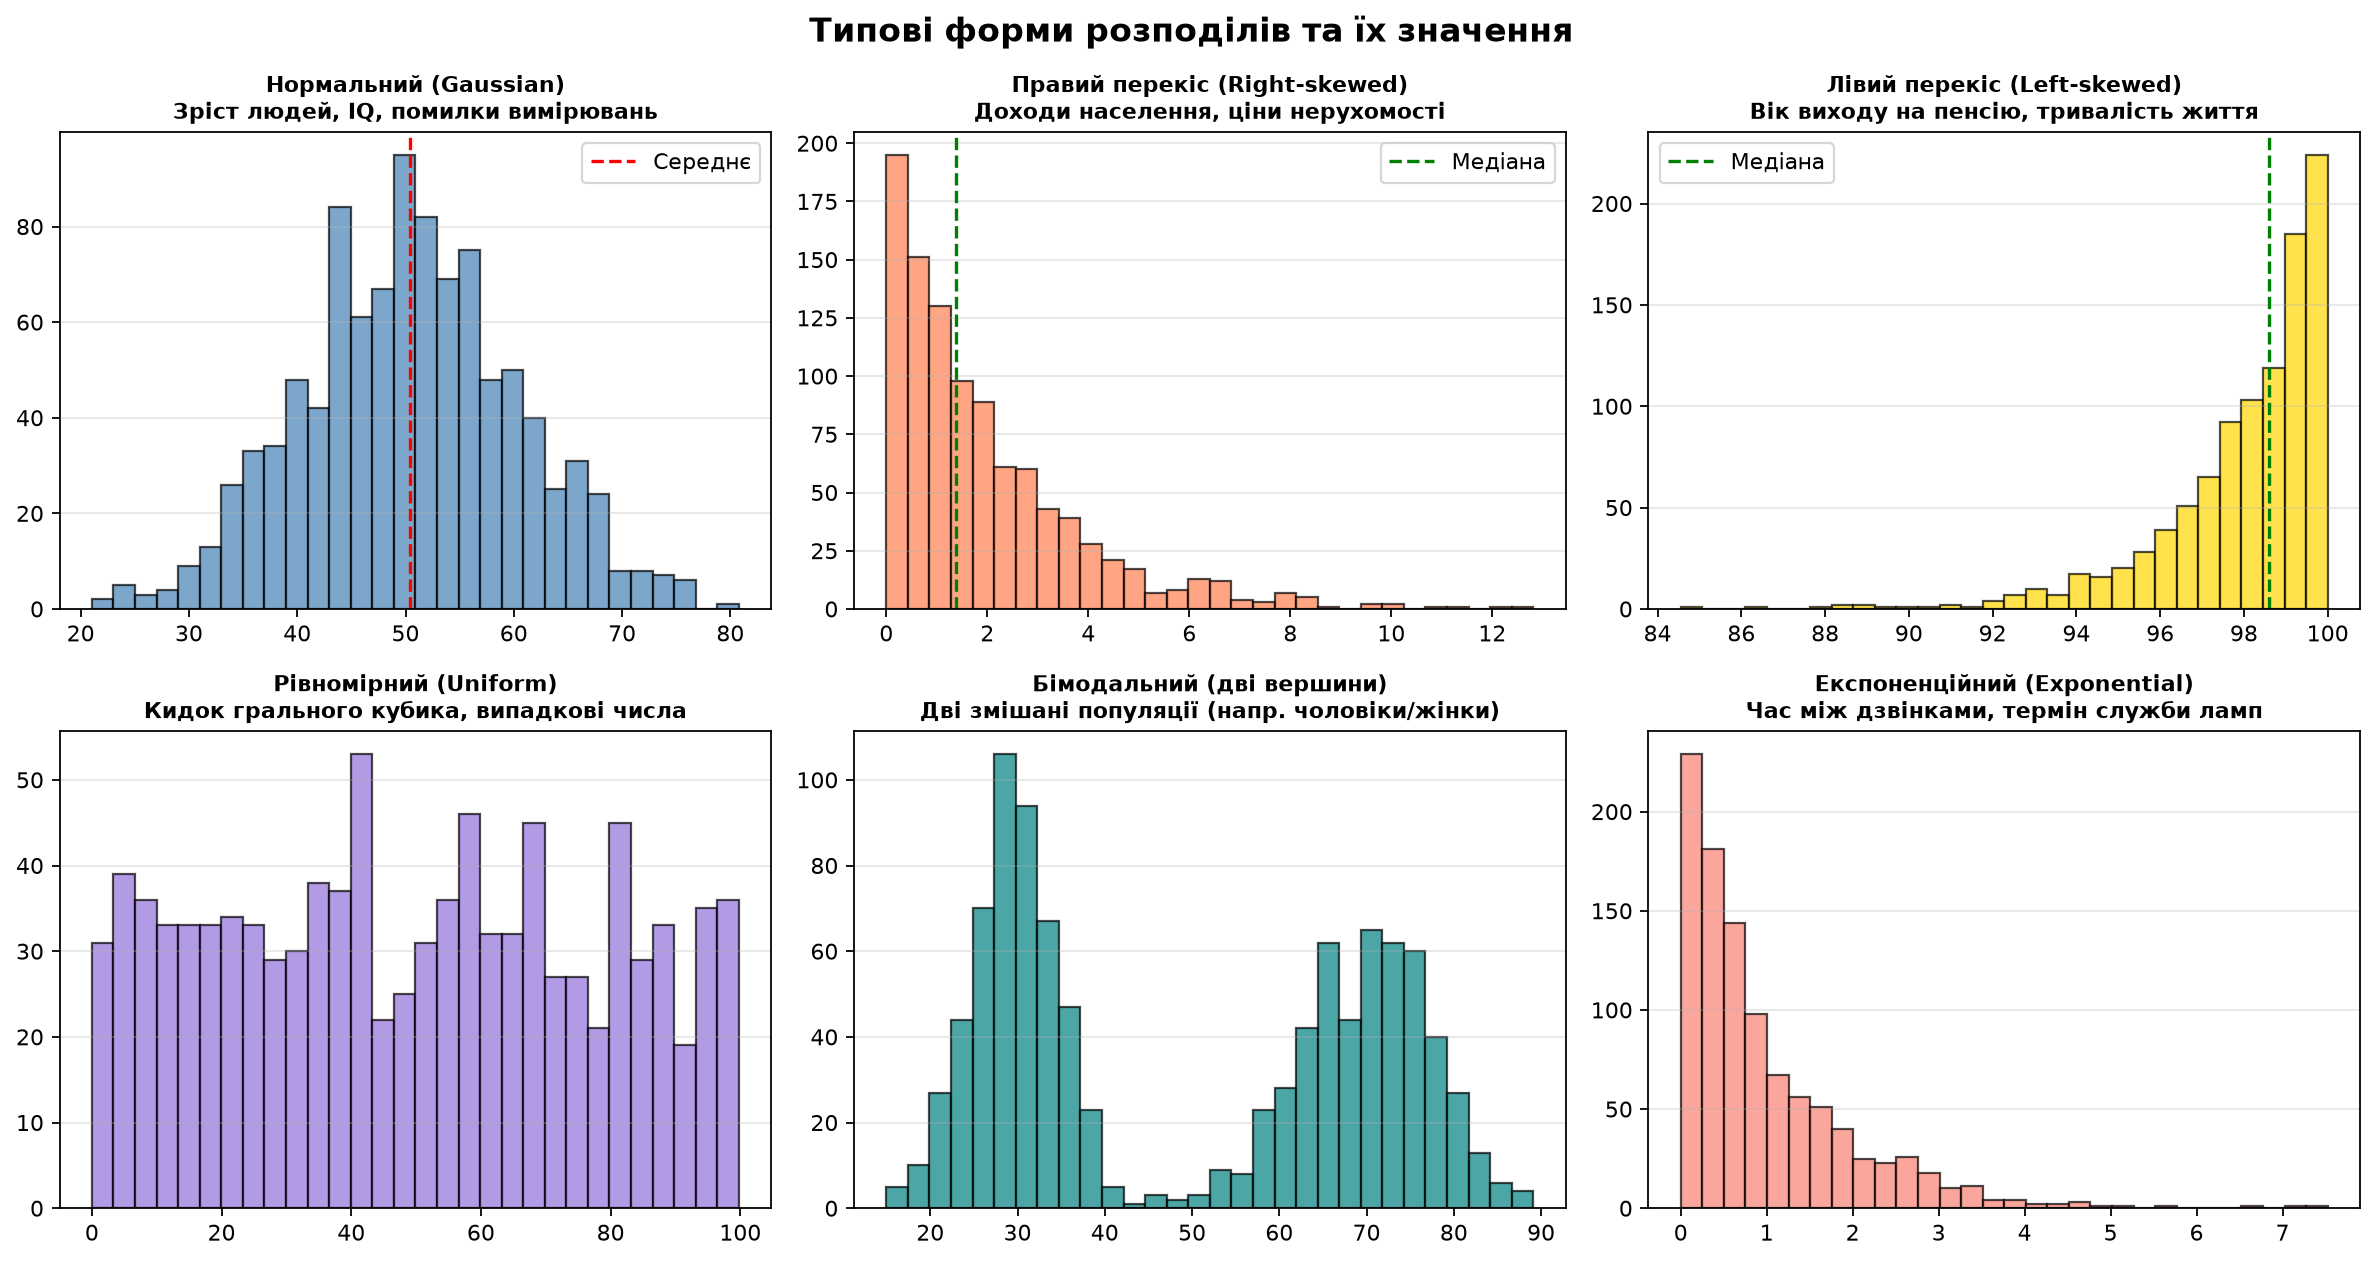
Форма гістограми розповідає історію про дані.
Сюжетна лінія (Етап 3: Діагностика поведінки бекенду за формою кривої):
Форма гістограми — це кардіограма здоров'я вашого сервісу:
- Дзвін (нормальний розподіл): стандартна штатна робота алгоритму з природними випадковими коливаннями довкола цільового часу.
- Правий перекіс (довгий хвіст праворуч): типова ситуація для веб-серверів — 90% запитів обробляються за 50 мс, але через черги до бази даних 10% клієнтів очікують до 1–2 секунд.
- Бімодальний розподіл (два піки): класичний симптом роботи дворівневої системи (наприклад, кешування). Перший пік на 10 мс — це попадання в оперативний кеш (cache hit), а другий пік на 150 мс — промах повз кеш і повне звернення до диска чи бази даних (cache miss).
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(seed=42)

fig, axes = plt.subplots(2, 3, figsize=(15, 8))
fig.suptitle("Типові форми розподілів та їх значення",
             fontsize=15, fontweight="bold")

# 1. Нормальний (симетричний)
data_normal = rng.normal(50, 10, 1000)
axes[0, 0].hist(data_normal, bins=30, color="steelblue", edgecolor="black", alpha=0.7)
axes[0, 0].set_title("Нормальний (Gaussian)\nЗріст людей, IQ, помилки вимірювань",
                     fontsize=10, fontweight="bold")
axes[0, 0].axvline(np.mean(data_normal), color="red", linestyle="--", label="Середнє")
axes[0, 0].legend()

# 2. Правий перекіс (right-skewed)
data_right_skew = rng.exponential(2, 1000)
axes[0, 1].hist(data_right_skew, bins=30, color="coral", edgecolor="black", alpha=0.7)
axes[0, 1].set_title("Правий перекіс (Right-skewed)\nДоходи населення, ціни нерухомості",
                     fontsize=10, fontweight="bold")
axes[0, 1].axvline(np.median(data_right_skew), color="green", linestyle="--", label="Медіана")
axes[0, 1].legend()

# 3. Лівий перекіс (left-skewed)
data_left_skew = 100 - rng.exponential(2, 1000)
axes[0, 2].hist(data_left_skew, bins=30, color="gold", edgecolor="black", alpha=0.7)
axes[0, 2].set_title("Лівий перекіс (Left-skewed)\nВік виходу на пенсію, тривалість життя",
                     fontsize=10, fontweight="bold")
axes[0, 2].axvline(np.median(data_left_skew), color="green", linestyle="--", label="Медіана")
axes[0, 2].legend()

# 4. Рівномірний
data_uniform = rng.uniform(0, 100, 1000)
axes[1, 0].hist(data_uniform, bins=20, color="lightgreen", edgecolor="black", alpha=0.7)
axes[1, 0].set_title("Рівномірний (Uniform)\nРезультат кидка кубика, випадкові числа",
                     fontsize=10, fontweight="bold")

# 5. Бімодальний (два піки)
data_bimodal = np.concatenate([rng.normal(30, 5, 500),
                                rng.normal(70, 5, 500)])
axes[1, 1].hist(data_bimodal, bins=30, color="orchid", edgecolor="black", alpha=0.7)
axes[1, 1].set_title("Бімодальний (Bimodal)\nЗріст чоловіків та жінок разом",
                     fontsize=10, fontweight="bold")

# 6. З викидами
data_outliers = np.concatenate([rng.normal(50, 5, 950),
                                 rng.uniform(90, 110, 50)])
axes[1, 2].hist(data_outliers, bins=40, color="crimson", edgecolor="black", alpha=0.7)
axes[1, 2].set_title("З викидами (Outliers)\nДані з помилками вимірювань",
                     fontsize=10, fontweight="bold")

for ax in axes.flat:
    ax.grid(axis="y", alpha=0.3)
    ax.set_xlabel("Значення")
    ax.set_ylabel("Частота")

plt.tight_layout()
plt.show()
- Середнє: 101.8k ← спотворене викидом
- Медіана: 22.5k ← типова зарплата
Box Plots — діаграми «ящик з вусами»
Box plot (або box-and-whisker plot) — це компактний спосіб показати п'ять ключових статистичних показників одночасно:
Сюжетна лінія (Етап 4: Полювання на приховані аномалії — Outlier Detection):
Гістограма дала загальну картину, але в продакшені є найнебезпечніша категорія проблем — «хвостові затримки» (tail latency). Це 0.5–1% користувачів, чиї запити зависають на 10–30 секунд через взаємне блокування транзакцій у базі даних або таймаут зовнішнього платіжного шлюзу.
На гістограмі з 100 000 запитів цей один відсоток майже невидимий (стовпчик висотою в пару пікселів на далекому краї). Але для бізнесу це втрачені замовлення та незадоволені клієнти.
Box plot виводить ці аномалії на перший план у вигляді окремих точок-викидів (outliers), дозволяючи інженеру негайно локалізувати збій.
- Мінімум (без викидів)
- Q1 (перший квартиль, 25%)
- Медіана (Q2, 50%)
- Q3 (третій квартиль, 75%)
- Максимум (без викидів)
- Викиди (outliers) — окремими точками
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(seed=42)
data = rng.normal(100, 15, 100)
# Додаємо кілька викидів
data = np.append(data, [150, 155, 45, 40])

fig, ax = plt.subplots(figsize=(8, 10))

bp = ax.boxplot(data, vert=True, patch_artist=True, widths=0.5,
                boxprops=dict(facecolor="lightblue", edgecolor="navy", linewidth=2),
                medianprops=dict(color="red", linewidth=3),
                whiskerprops=dict(color="navy", linewidth=2),
                capprops=dict(color="navy", linewidth=2),
                flierprops=dict(marker="o", markerfacecolor="red", markersize=8,
                                markeredgecolor="darkred"))

# Обчислюємо статистику
q1, median, q3 = np.percentile(data, [25, 50, 75])
iqr = q3 - q1
lower_fence = q1 - 1.5 * iqr
upper_fence = q3 + 1.5 * iqr

# Анотації
ax.annotate("Викиди (outliers)\nзначення > Q3 + 1.5·IQR",
            xy=(1, 150), xytext=(1.4, 150),
            fontsize=10, color="darkred", weight="bold",
            arrowprops=dict(arrowstyle="->", color="darkred", lw=2))

ax.annotate(f"Максимум (без викидів)\n≈ {upper_fence:.1f}",
            xy=(1, upper_fence), xytext=(1.4, upper_fence+5),
            fontsize=10, color="navy", weight="bold",
            arrowprops=dict(arrowstyle="->", color="navy"))

ax.annotate(f"Q3 (75% даних нижче)\n≈ {q3:.1f}",
            xy=(1, q3), xytext=(1.4, q3),
            fontsize=10, color="darkblue", weight="bold",
            arrowprops=dict(arrowstyle="->", color="darkblue"))

ax.annotate(f"Медіана (Q2, 50%)\n≈ {median:.1f}",
            xy=(1, median), xytext=(0.3, median+10),
            fontsize=11, color="red", weight="bold",
            arrowprops=dict(arrowstyle="->", color="red", lw=2))

ax.annotate(f"Q1 (25% даних нижче)\n≈ {q1:.1f}",
            xy=(1, q1), xytext=(1.4, q1-5),
            fontsize=10, color="darkblue", weight="bold",
            arrowprops=dict(arrowstyle="->", color="darkblue"))

ax.annotate(f"Мінімум (без викидів)\n≈ {lower_fence:.1f}",
            xy=(1, lower_fence), xytext=(1.4, lower_fence-10),
            fontsize=10, color="navy", weight="bold",
            arrowprops=dict(arrowstyle="->", color="navy"))

ax.annotate(f"IQR = Q3 - Q1\n= {iqr:.1f}",
            xy=(1.15, (q1+q3)/2), xytext=(0.5, (q1+q3)/2-15),
            fontsize=11, color="green", weight="bold",
            bbox=dict(boxstyle="round,pad=0.5", facecolor="lightgreen", alpha=0.8))

ax.set_title("Анатомія Box Plot", fontsize=14, fontweight="bold")
ax.set_ylabel("Значення", fontsize=12)
ax.set_xlim(0.5, 2)
ax.set_xticks([])
ax.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
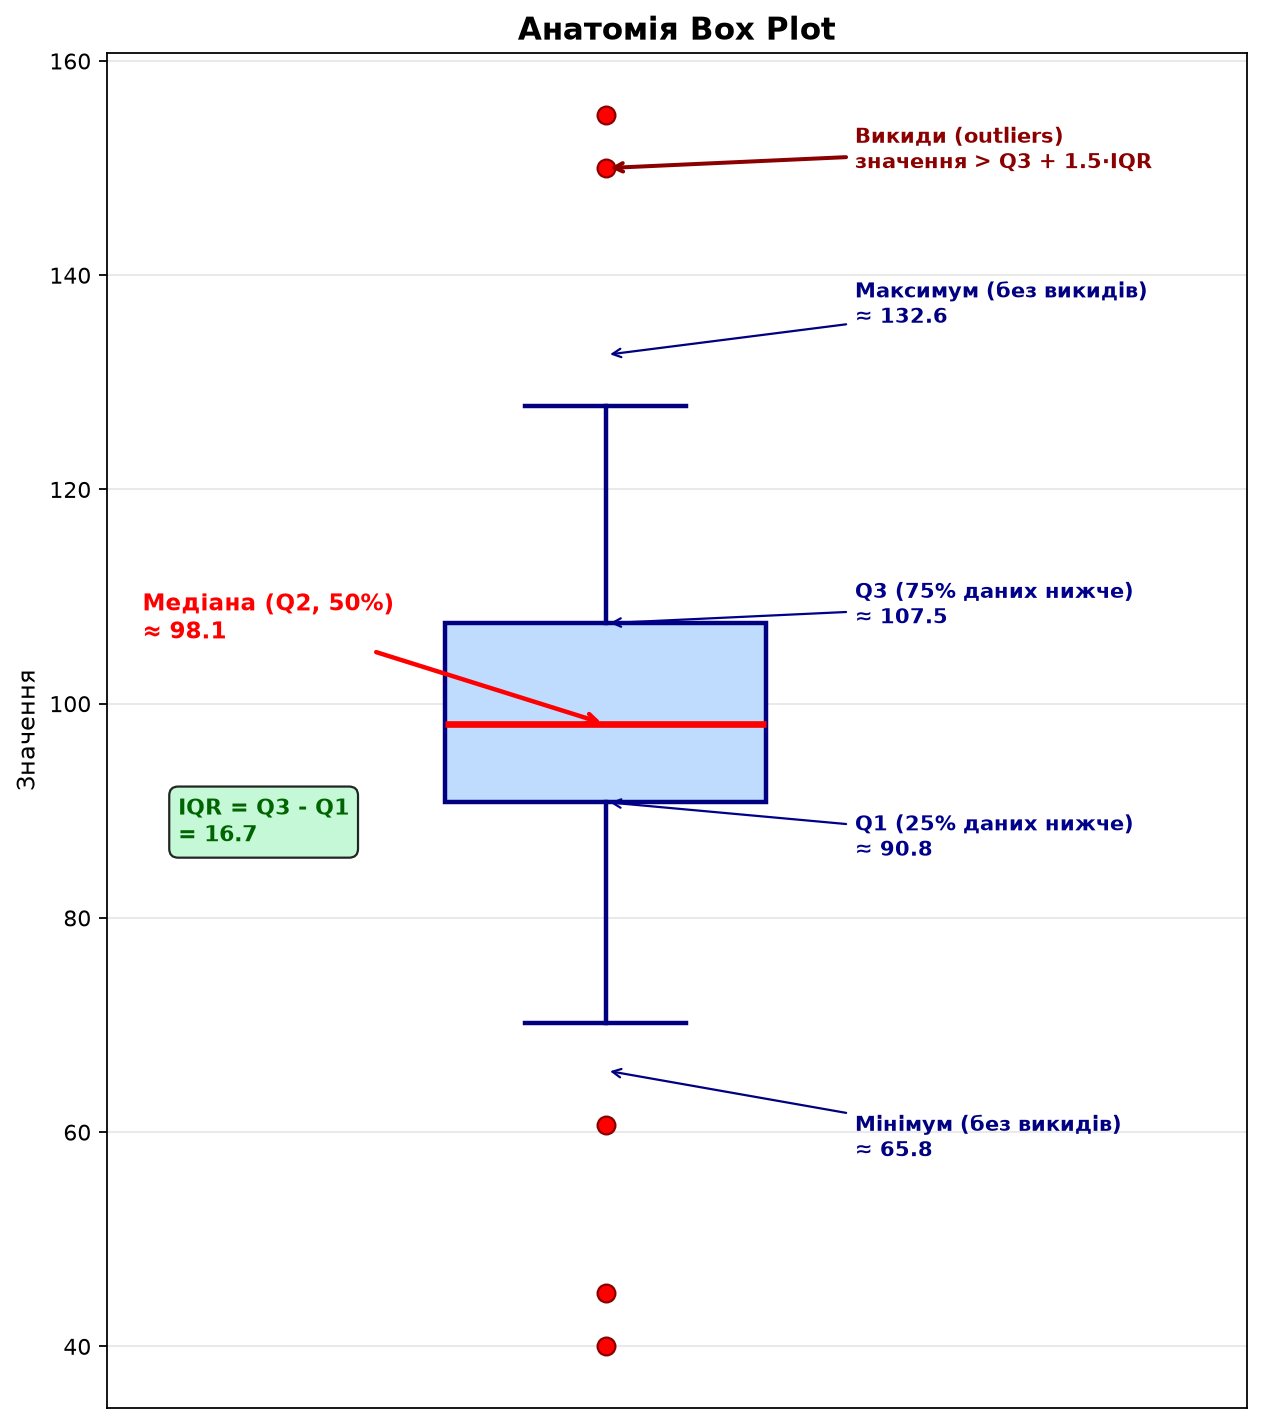
- Box plot використовує метод IQR для виявлення викидів
- Викид: значення < Q1 - 1.5·IQR або > Q3 + 1.5·IQR
- «Вуса» (whiskers) показують діапазон даних без викидів
- Чим більший «ящик» — тим більший розкид даних (дисперсія)
Сигнатура методу ax.boxplot() та параметричні варіації
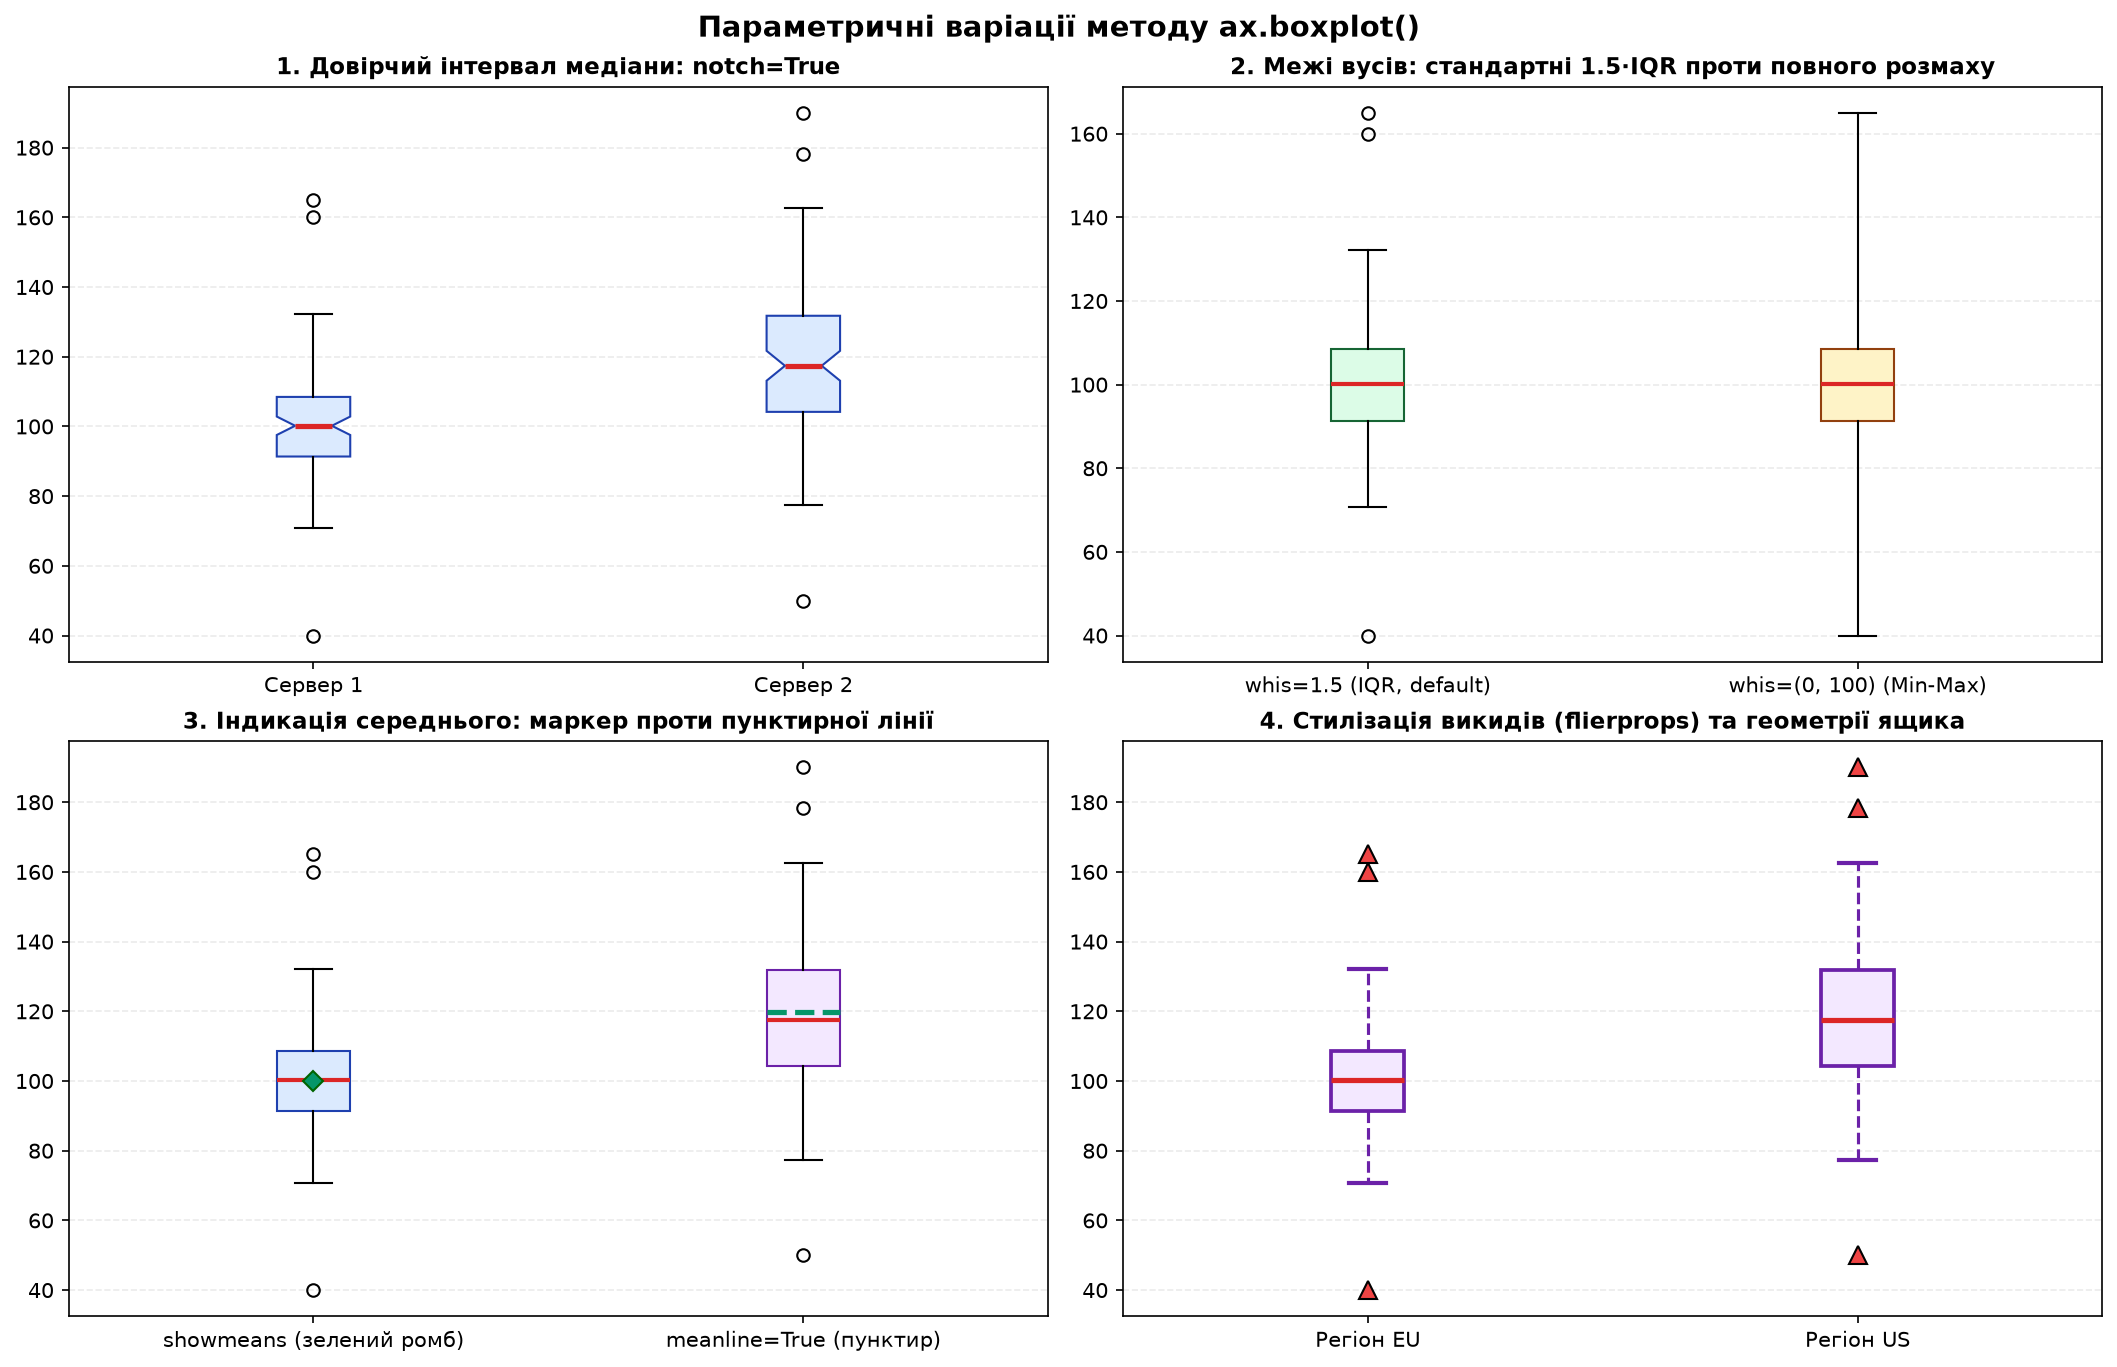
Метод ax.boxplot() обчислює квантилі, міжквартильний розмах і координати викидів, після чого створює сукупність графічних примітивів (ліній, прямокутників та маркерів).
Axes.boxplot(
    x: ArrayLike | Sequence[ArrayLike],
    notch: bool | None = None,
    sym: str | None = None,
    vert: bool | None = None,
    whis: float | tuple[float, float] | None = None,
    positions: Sequence[float] | None = None,
    widths: float | Sequence[float] | None = None,
    patch_artist: bool | None = None,
    bootstrap: int | None = None,
    usermedians: Sequence[float] | None = None,
    conf_intervals: ArrayLike | None = None,
    meanline: bool | None = None,
    showmeans: bool | None = None,
    showcaps: bool | None = None,
    showbox: bool | None = None,
    showfliers: bool | None = None,
    boxprops: dict[str, Any] | None = None,
    tick_labels: Sequence[str] | None = None,  # У Matplotlib 3.9+ замість застарілого labels
    flierprops: dict[str, Any] | None = None,
    medianprops: dict[str, Any] | None = None,
    meanprops: dict[str, Any] | None = None,
    capprops: dict[str, Any] | None = None,
    whiskerprops: dict[str, Any] | None = None,
    **kwargs
) -> dict[str, list[Line2D | PathPatch]]
labels перейменовано на tick_labels, щоб уніфікувати роботу з мітками осей. Старий параметр labels все ще підтримується для зворотної сумісності.Аналіз ключових параметрів:
notch: якщоTrue, навколо медіани формується V-подібний виріз, що візуалізує 95% довірчий інтервал. Якщо вирізи двох ящиків не перетинаються по висоті, різниця між медіанами є статистично значущою.whis: коефіцієнт множення $IQR$ для граничних вусів (за замовчуванням1.5). Якщо передати кортеж відсотків(0, 100), вуса простягнуться до абсолютних мінімуму та максимуму без окремих точок-викидів.showmeansтаmeanline: відображення середнього арифметичного. Приmeanline=Trueсереднє малюється пунктирною лінією на всю ширину ящика, а приmeanline=False— точковим маркером.patch_artist: обов'язковий прапорець (True), якщо ви бажаєте зафарбувати тіло ящика кольором через параметрboxprops=dict(facecolor=...).flierprops: словник стилізації викидів (marker,markersize,markerfacecolor,markeredgecolor).vert: орієнтація діаграми (True— вертикальна,False— горизонтальна).
import matplotlib.pyplot as plt
import numpy as np

fig, axes = plt.subplots(2, 2, figsize=(14, 9), layout="constrained")
rng = np.random.default_rng(seed=42)
data = [rng.normal(100, 15, 100), rng.normal(120, 20, 100)]
data[0] = np.append(data[0], [160, 165, 40])
data[1] = np.append(data[1], [190, 50])

# 1. notch=True (довірчий інтервал медіани)
ax = axes[0, 0]
ax.boxplot(data, tick_labels=["Сервер 1", "Сервер 2"], notch=True, patch_artist=True,
           boxprops=dict(facecolor="#DBEAFE", color="#1E40AF"),
           medianprops=dict(color="#DC2626", lw=2.5))
ax.set_title("1. Довірчий інтервал медіани: notch=True", fontsize=11, fontweight="bold")
ax.grid(axis="y", alpha=0.25, ls="--")

# 2. whis (налаштування довжини вусів)
ax = axes[0, 1]
ax.boxplot(data[0], positions=[1], whis=1.5, patch_artist=True,
           boxprops=dict(facecolor="#DCFCE7", color="#166534"),
           medianprops=dict(color="#DC2626", lw=2))
ax.boxplot(data[0], positions=[2], whis=(0, 100), patch_artist=True,
           boxprops=dict(facecolor="#FEF3C7", color="#92400E"),
           medianprops=dict(color="#DC2626", lw=2))
ax.set_xticks([1, 2], labels=["whis=1.5 (IQR, default)", "whis=(0, 100) (Min-Max)"])
ax.set_title("2. Межі вусів: стандартні 1.5·IQR проти повного розмаху", fontsize=11, fontweight="bold")
ax.grid(axis="y", alpha=0.25, ls="--")

# 3. showmeans=True та meanline=True
ax = axes[1, 0]
ax.boxplot(data[0], positions=[1], showmeans=True, meanline=False, patch_artist=True,
           boxprops=dict(facecolor="#DBEAFE", color="#1E40AF"),
           meanprops=dict(marker="D", markerfacecolor="#059669", markeredgecolor="darkgreen", markersize=7),
           medianprops=dict(color="#DC2626", lw=2))
ax.boxplot(data[1], positions=[2], showmeans=True, meanline=True, patch_artist=True,
           boxprops=dict(facecolor="#F3E8FF", color="#6B21A8"),
           meanprops=dict(color="#059669", lw=2.5, ls="--"),
           medianprops=dict(color="#DC2626", lw=2))
ax.set_xticks([1, 2], labels=["showmeans (зелений ромб)", "meanline=True (пунктир)"])
ax.set_title("3. Індикація середнього: маркер проти пунктирної лінії", fontsize=11, fontweight="bold")
ax.grid(axis="y", alpha=0.25, ls="--")

# 4. Повна кастомізація flierprops та стилів
ax = axes[1, 1]
ax.boxplot(data, tick_labels=["Регіон EU", "Регіон US"], patch_artist=True,
           boxprops=dict(facecolor="#F3E8FF", color="#6B21A8", lw=1.8),
           whiskerprops=dict(color="#6B21A8", lw=1.5, ls="--"),
           capprops=dict(color="#6B21A8", lw=2),
           medianprops=dict(color="#DC2626", lw=2.5),
           flierprops=dict(marker="^", markerfacecolor="#EF4444", markeredgecolor="black", markersize=9))
ax.set_title("4. Стилізація викидів (flierprops) та геометрії ящика", fontsize=11, fontweight="bold")
ax.grid(axis="y", alpha=0.25, ls="--")

fig.suptitle("Параметричні варіації методу ax.boxplot()", fontsize=14, fontweight="bold")
plt.show()
Порівняння груп за допомогою box plots
Box plots особливо корисні для порівняння кількох груп.
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(seed=42)

# Три групи студентів з різними характеристиками
group_a = rng.normal(75, 10, 80)   # Середня група
group_b = rng.normal(85, 7, 80)    # Сильна група
group_c = rng.normal(65, 15, 80)   # Слабка група (великий розкид)

data_to_plot = [group_a, group_b, group_c]

fig, ax = plt.subplots(figsize=(10, 6))

bp = ax.boxplot(data_to_plot, labels=["Група A", "Група B", "Група C"],
                patch_artist=True, notch=True, showmeans=True,
                boxprops=dict(facecolor="skyblue", edgecolor="navy", linewidth=1.5),
                medianprops=dict(color="red", linewidth=2),
                meanprops=dict(marker="D", markerfacecolor="green", markersize=8),
                whiskerprops=dict(linestyle="--", linewidth=1.5),
                flierprops=dict(marker="o", markerfacecolor="orange", markersize=6, alpha=0.5))

ax.set_title("Порівняння балів трьох груп студентів",
             fontsize=14, fontweight="bold")
ax.set_ylabel("Бали (0–100)", fontsize=12)
ax.set_xlabel("Група", fontsize=12)
ax.grid(axis="y", alpha=0.3)

# Легенда для пояснення символів
from matplotlib.lines import Line2D
custom_lines = [Line2D([0], [0], color="red", linewidth=2),
                Line2D([0], [0], marker="D", color="w", markerfacecolor="green", markersize=8)]
ax.legend(custom_lines, ["Медіана", "Середнє"], loc="lower right")

plt.tight_layout()
plt.show()
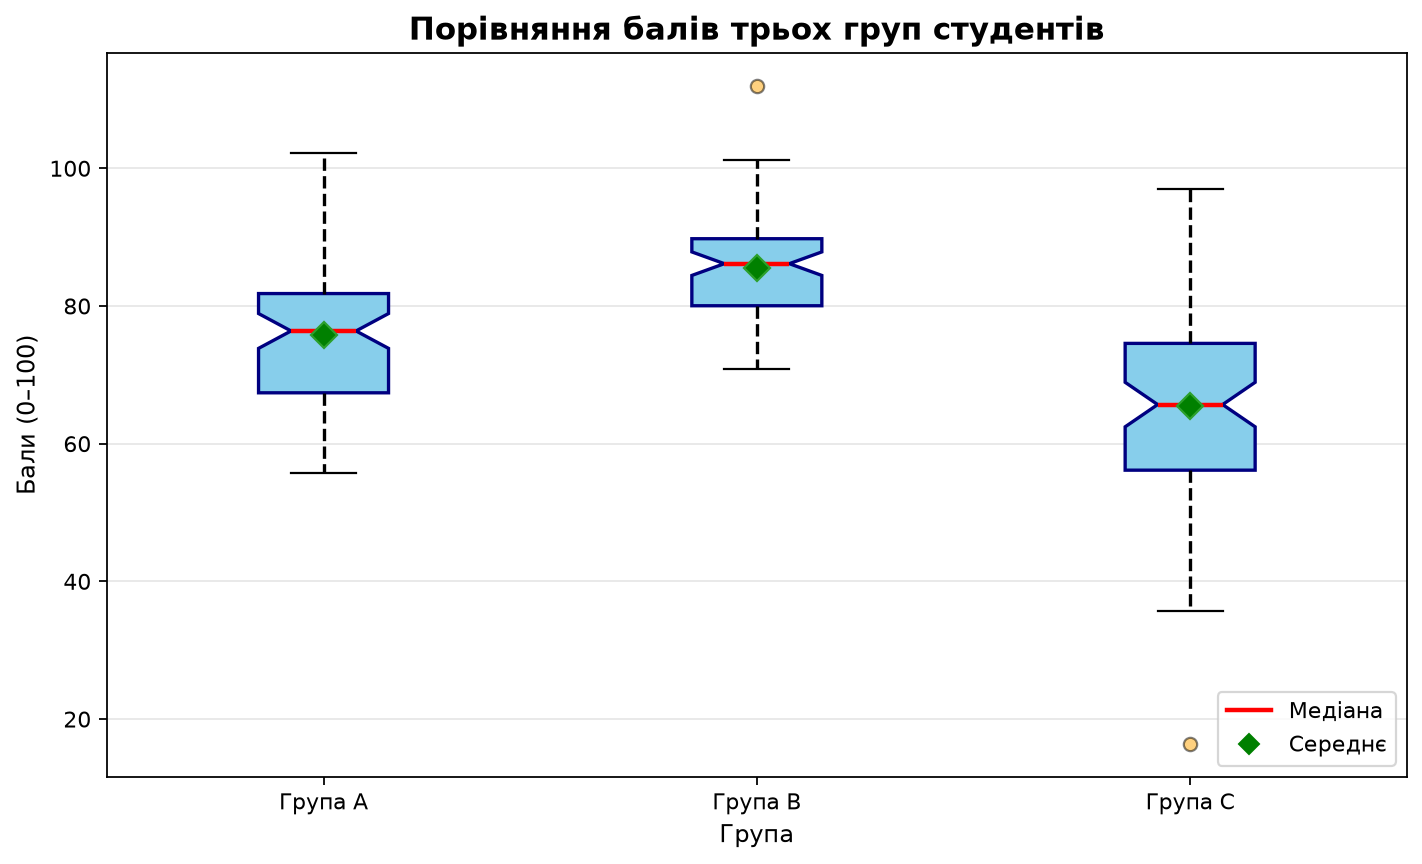
Висновки з графіка:
- Група B — найсильніша: медіана ~85, маленький розкид (вузький ящик)
- Група C — найслабша та найнестабільніша: медіана ~65, великий розкид (широкий ящик)
- Група A — посередині за всіма показниками
- У всіх групах є викиди (окремі студенти з аномальними результатами)
Це те, що неможливо побачити в трьох таблицях по 80 рядків!
boxplot():ax.boxplot(data,
labels=["A", "B"], # Підписи груп
vert=True, # Вертикальна орієнтація (False = горизонтальна)
patch_artist=True, # Дозволяє заливку кольором
notch=True, # Виріз на ящику (показує довірчий інтервал медіани)
showmeans=True, # Показати середнє (зелений ромб)
showfliers=True) # Показувати викиди (True = default)
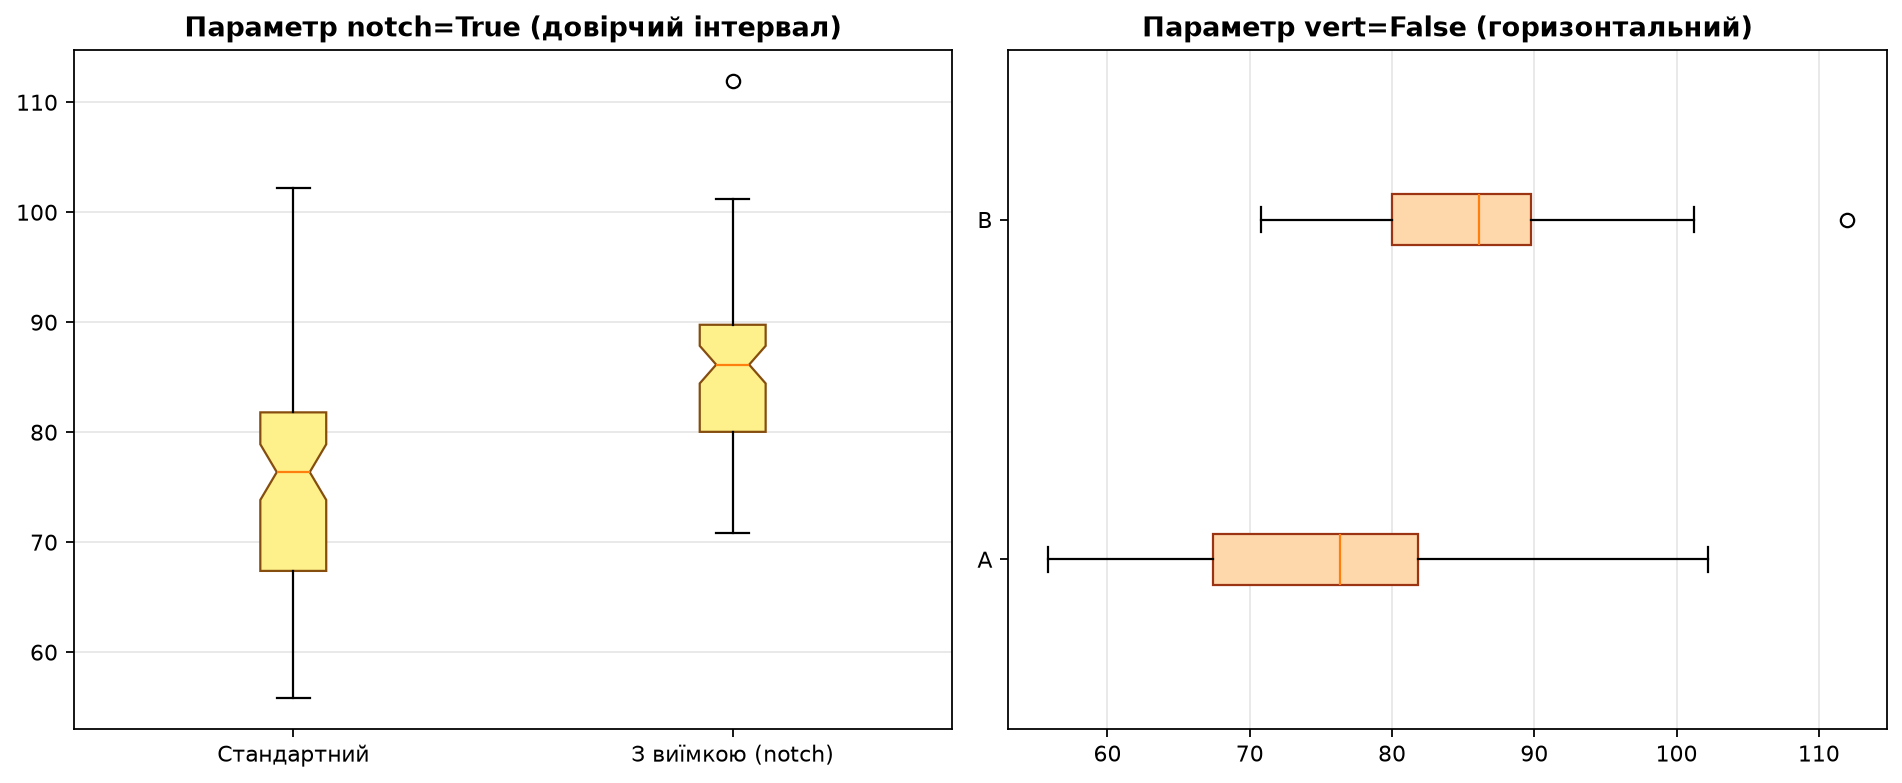 Різниця між медіаною та середнім:
- Якщо червона лінія (медіана) ≈ зелений ромб (середнє) → дані симетричні
- Якщо далеко один від одного → дані асиметричні або є викиди
Горизонтальні box plots
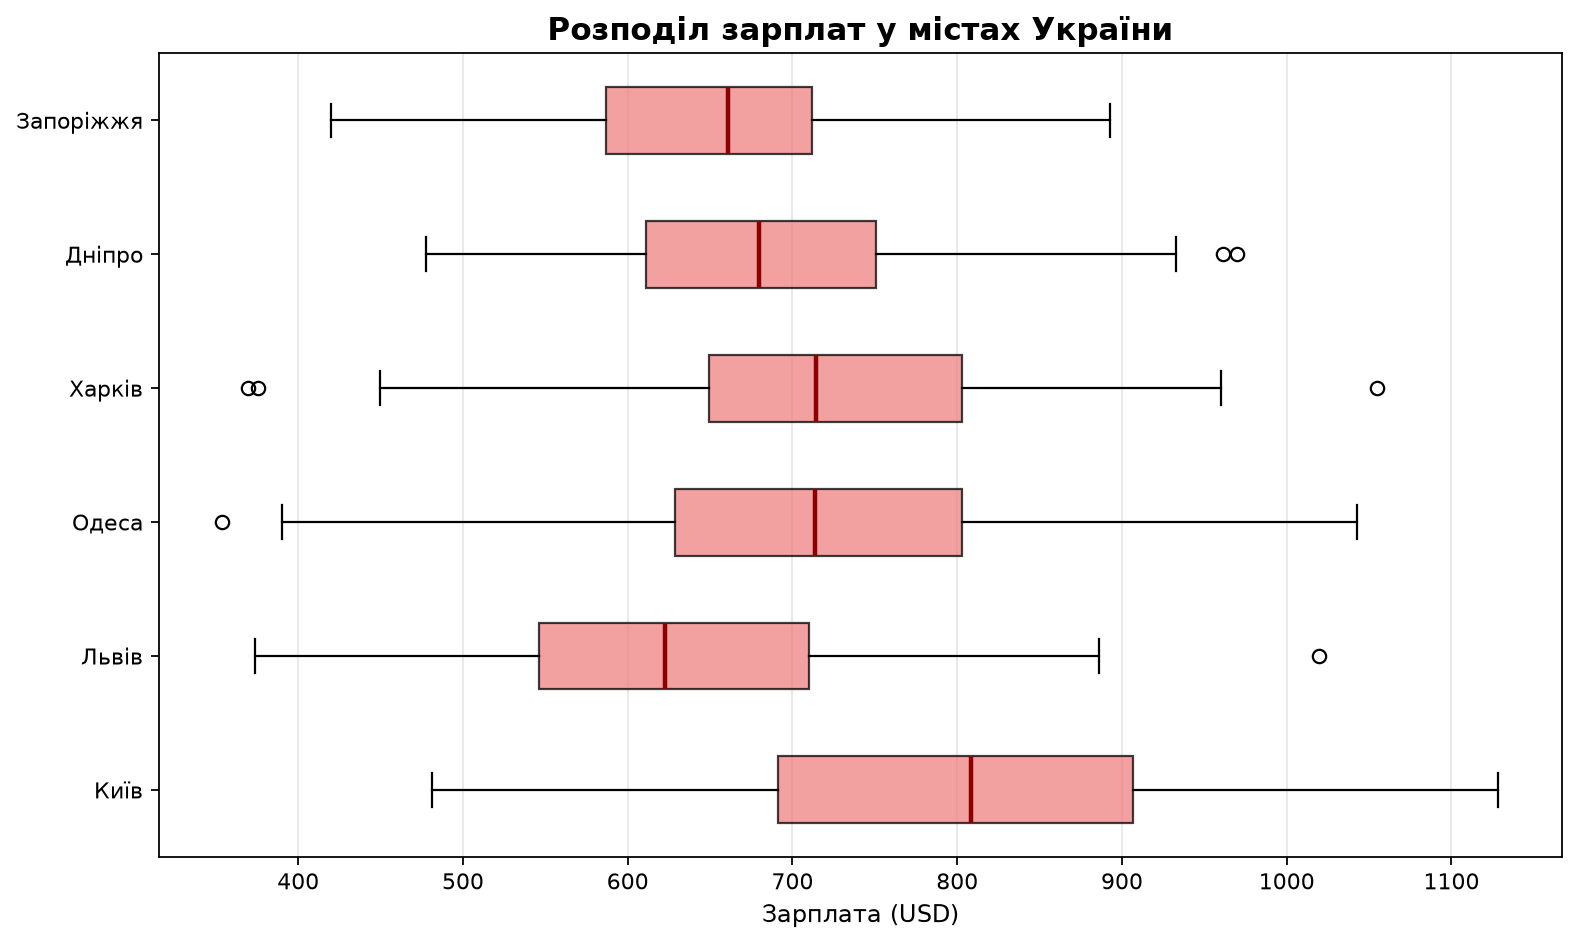
Іноді зручніше показувати box plots горизонтально — особливо коли багато груп або довгі назви.
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(seed=123)

# Зарплати в різних містах (для прикладу)
cities = ["Київ", "Львів", "Одеса", "Харків", "Дніпро", "Запоріжжя"]
salaries = [rng.normal(800, 150, 100),
            rng.normal(650, 120, 100),
            rng.normal(700, 140, 100),
            rng.normal(720, 130, 100),
            rng.normal(680, 110, 100),
            rng.normal(640, 100, 100)]

fig, ax = plt.subplots(figsize=(10, 7))

bp = ax.boxplot(salaries, labels=cities, vert=False, patch_artist=True,
                boxprops=dict(facecolor="lightcoral", alpha=0.7),
                medianprops=dict(color="darkred", linewidth=2))

ax.set_title("Розподіл зарплат у містах України",
             fontsize=14, fontweight="bold")
ax.set_xlabel("Зарплата (USD)", fontsize=12)
ax.grid(axis="x", alpha=0.3)

plt.tight_layout()
plt.show()
Violin Plots — скрипкові діаграми для оцінки форми та щільності
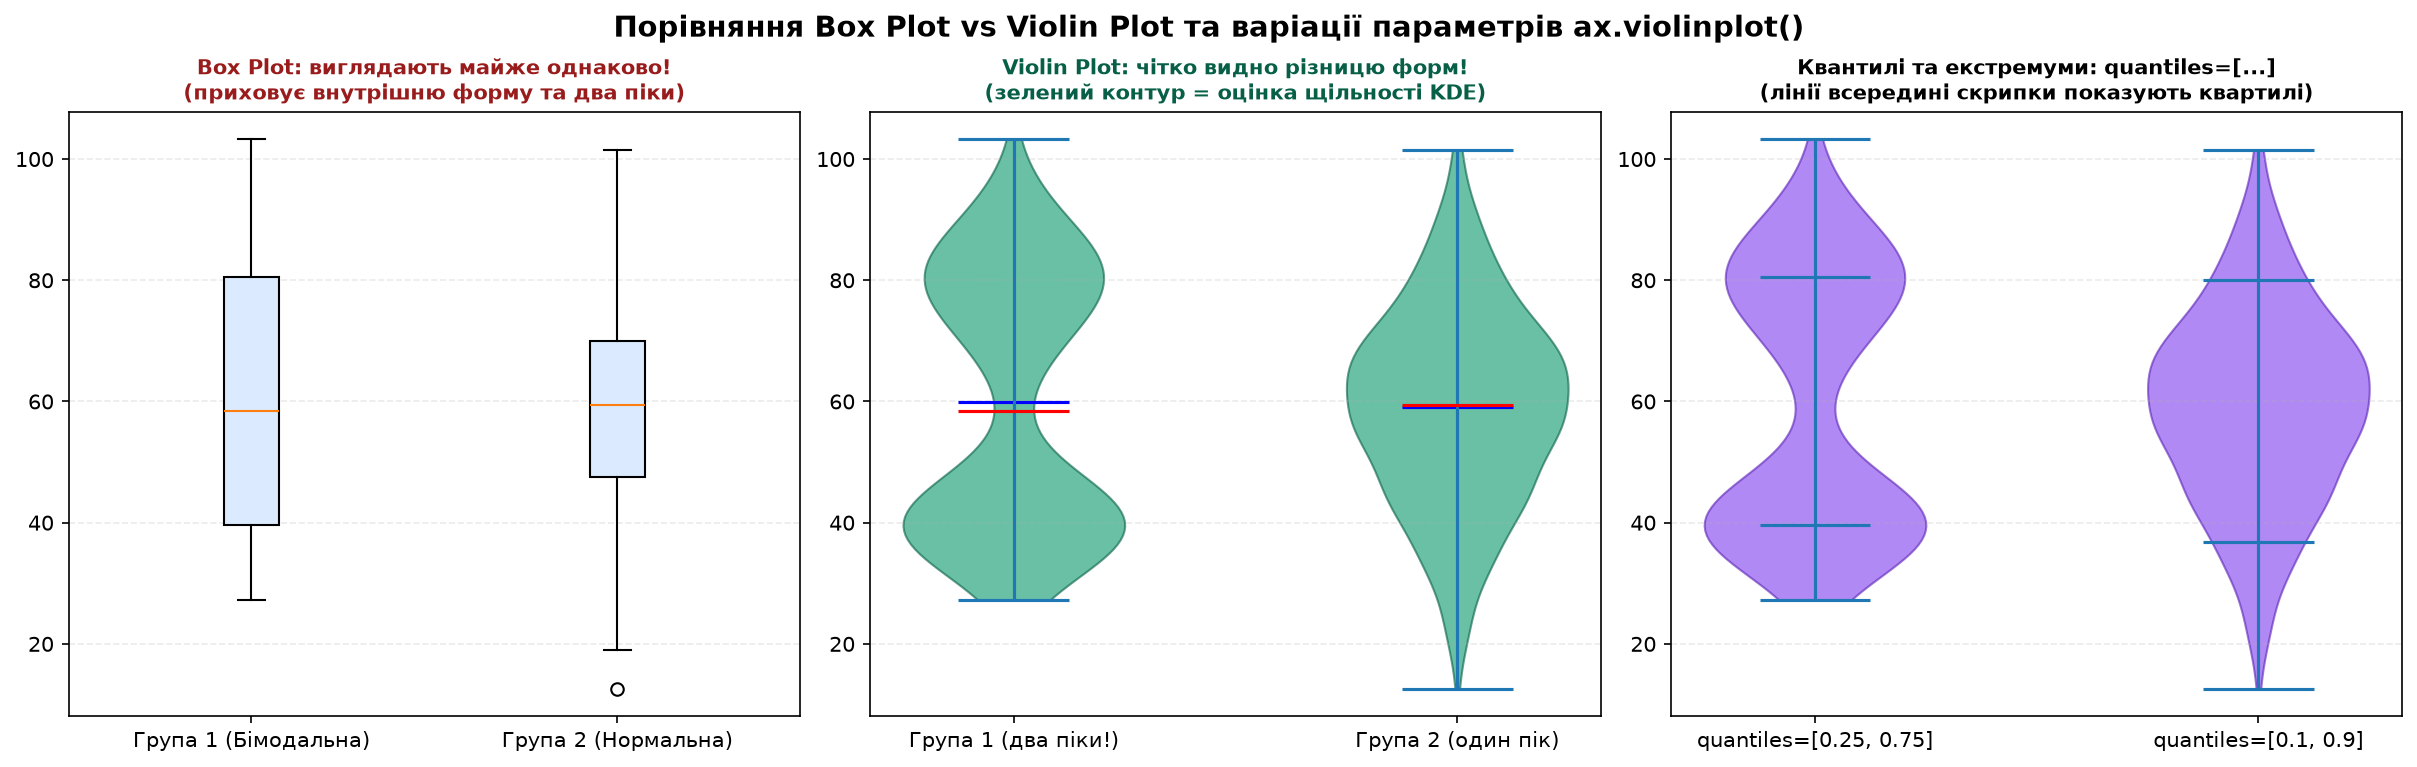
Хоча Box Plot чудово виявляє викиди та показує квартилі, він має фундаментальне обмеження: він повністю приховує внутрішню форму розподілу.
Парадокс прихованої структури:
Уявіть, що ви порівнюєте два сервіси:
- Перший має нормальний розподіл затримок довкола 60 мс.
- Другий — бімодальний (половина запитів обробляється за 20 мс завдяки кешу, а інша половина — за 100 мс через базу даних).
Звичайний Box Plot для обох вибірок покаже майже ідентичний прямокутник із медіаною ~60 мс! Інженер вирішить, що системи працюють однаково, і пропустить критичну особливість архітектури.
Violin Plot (скрипкова діаграма) розв'язує цю проблему, поєднуючи інформативність Box Plot із плавною ядерною оцінкою щільності (Kernel Density Estimation, KDE). Ширина «скрипки» в кожній точці показує, наскільки часто зустрічається це значення.
Axes.violinplot(
    dataset: ArrayLike | Sequence[ArrayLike],
    positions: Sequence[float] | None = None,
    vert: bool = True,
    widths: float | Sequence[float] = 0.5,
    showmeans: bool = False,
    showextrema: bool = True,
    showmedians: bool = False,
    quantiles: Sequence[float] | Sequence[Sequence[float]] | None = None,
    points: int = 100,
    bw_method: str | float | Callable | None = None,
    *,
    side: Literal['both', 'low', 'high'] = 'both',
    **kwargs
) -> dict[str, Any]
Ключові параметри методу violinplot():
dataset: одновимірний масив або список вибірок для порівняння.showmedians,showmeans: малювання горизонтальних позначок для медіани та середнього значення.showextrema: малювання вертикальної осі від абсолютного мінімуму до максимуму.quantiles: список квантилів, які слід накреслити всередині скрипки (наприклад,[0.25, 0.75]для відображення міжквартильного розмаху).bw_method: метод обчислення ширини вікна згладжування оцінки щільності (bandwidth). Можна передати правило Скотта'scott', Сільвермана'silverman'або скалярне число.vert: орієнтація (True— вертикальні скрипки,False— горизонтальні).
import matplotlib.pyplot as plt
import numpy as np

fig, axes = plt.subplots(1, 3, figsize=(16, 5), layout="constrained")
rng = np.random.default_rng(seed=42)

# Згенеруємо бімодальний розподіл (де boxplot приховує суть)
data1 = np.concatenate([rng.normal(40, 6, 200), rng.normal(80, 8, 200)])
data2 = rng.normal(60, 16, 400)
data_list = [data1, data2]

# 1. Звичайний boxplot (приховує бімодальність data1!)
axes[0].boxplot(data_list, tick_labels=["Група 1 (Бімодальна)", "Група 2 (Нормальна)"],
                patch_artist=True, boxprops=dict(facecolor="#DBEAFE"))
axes[0].set_title("Box Plot: виглядають майже однаково!\n(приховує внутрішню форму та два піки)",
                  fontsize=10, fontweight="bold", color="#991B1B")
axes[0].grid(axis="y", alpha=0.25, ls="--")

# 2. Violin Plot (одразу розкриває два піки!)
vp = axes[1].violinplot(data_list, positions=[1, 2], showmeans=True, showmedians=True)
for body in vp['bodies']:
    body.set_facecolor('#059669')
    body.set_edgecolor('#065F46')
    body.set_alpha(0.6)
vp['cmeans'].set_color('blue')
vp['cmedians'].set_color('red')
axes[1].set_xticks([1, 2], labels=["Група 1 (два піки!)", "Група 2 (один пік)"])
axes[1].set_title("Violin Plot: чітко видно різницю форм!\n(зелений контур = оцінка щільності KDE)",
                  fontsize=10, fontweight="bold", color="#065F46")
axes[1].grid(axis="y", alpha=0.25, ls="--")

# 3. Варіації параметрів violinplot (quantiles, bw_method)
vp2 = axes[2].violinplot(data_list, positions=[1, 2], quantiles=[[0.25, 0.75], [0.1, 0.9]],
                         showextrema=True)
for body in vp2['bodies']:
    body.set_facecolor('#7C3AED')
    body.set_edgecolor('#5B21B6')
    body.set_alpha(0.6)
axes[2].set_xticks([1, 2], labels=["quantiles=[0.25, 0.75]", "quantiles=[0.1, 0.9]"])
axes[2].set_title("Квантилі та екстремуми: quantiles=[...]\n(лінії всередині скрипки показують квартилі)",
                  fontsize=10, fontweight="bold")
axes[2].grid(axis="y", alpha=0.25, ls="--")

fig.suptitle("Порівняння Box Plot vs Violin Plot та варіації параметрів ax.violinplot()", fontsize=14, fontweight="bold")
plt.show()
Комбіновані графіки: гістограма + box plot
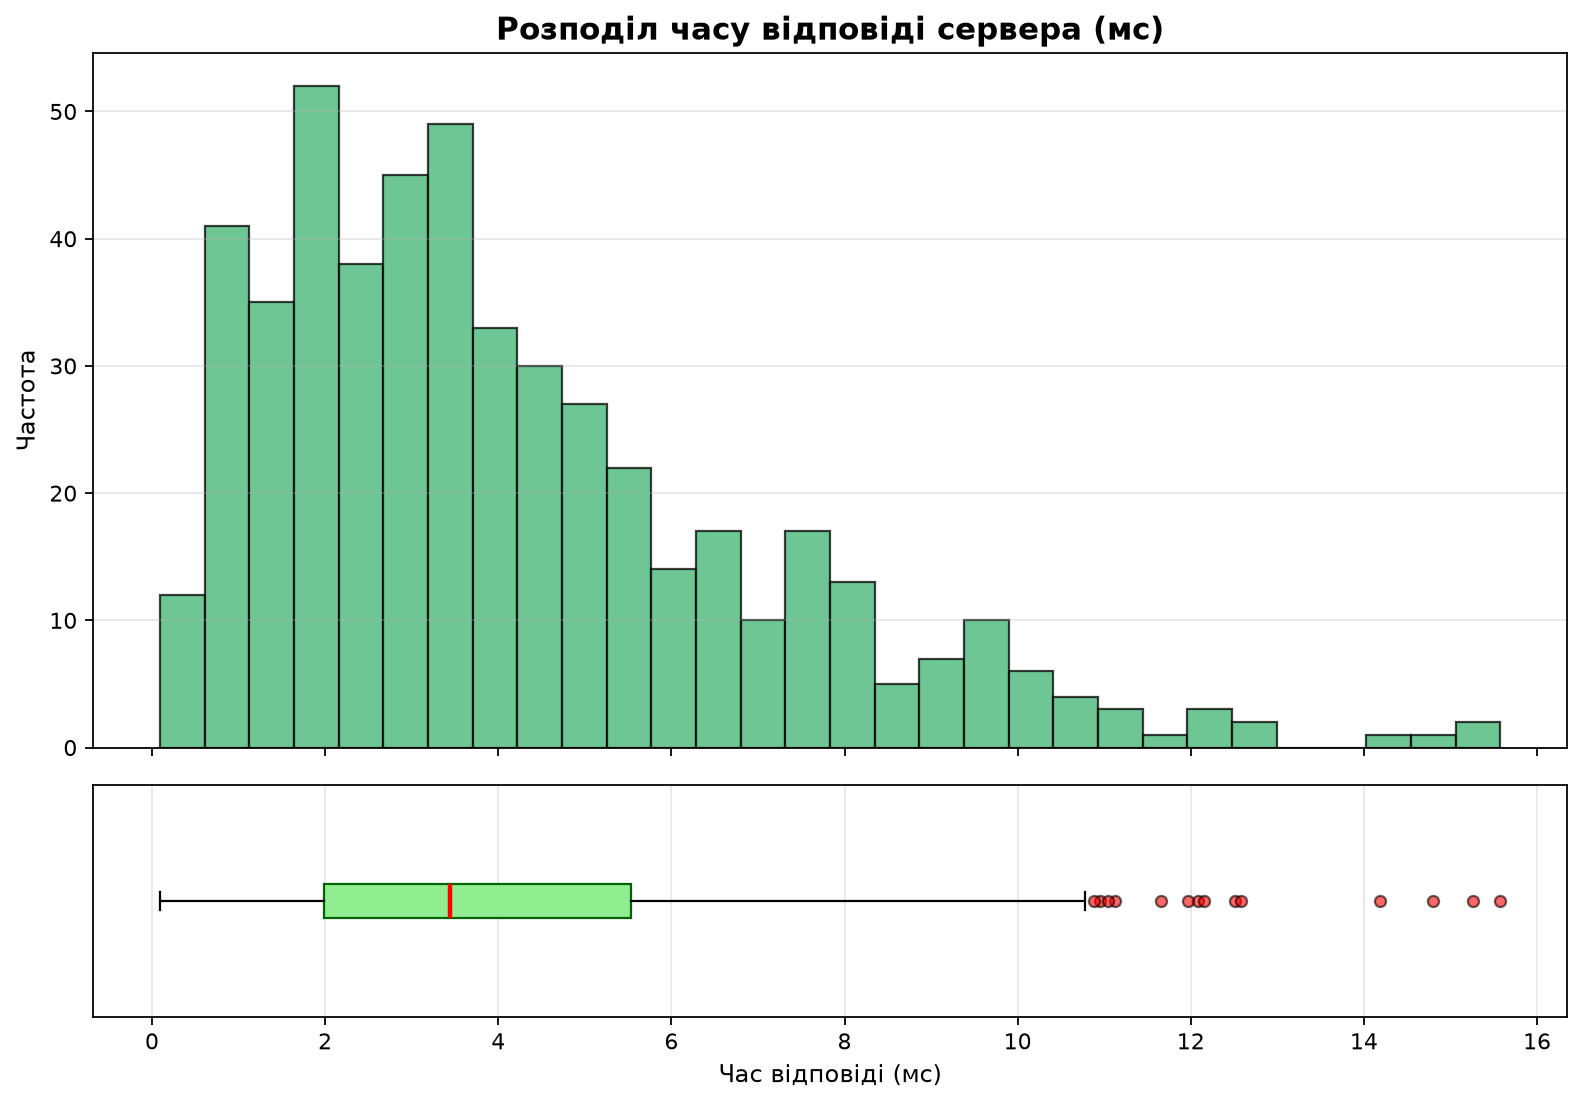
Іноді корисно показати обидва типи візуалізації одночасно.
Сюжетна лінія (Етап 5: Створення фінального інженерного дашборду):
Досвідчені SRE та DevOps інженери не обирають між гістограмою та box plot — вони поєднують їх на одному вертикальному дашборді. Верхня гістограма детально показує форму розподілу та піки навантаження, а нижній box plot під нею на спільній шкалі дає точну оцінку медіани, квартилів і рідкісних екстремальних викидів.
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(seed=42)
data = rng.gamma(2, 2, 500)

fig, (ax1, ax2) = plt.subplots(2, 1, figsize=(10, 8),
                                gridspec_kw={'height_ratios': [3, 1]})

# Верхній графік: гістограма
ax1.hist(data, bins=30, color="mediumseagreen", edgecolor="black", alpha=0.7)
ax1.set_title("Розподіл часу відповіді сервера (мс)",
              fontsize=14, fontweight="bold")
ax1.set_ylabel("Частота", fontsize=11)
ax1.grid(axis="y", alpha=0.3)

# Додаємо статистичні лінії на гістограму
median_val = np.median(data)
q1_val, q3_val = np.percentile(data, [25, 75])
ax1.axvline(median_val, color="red", linestyle="--", linewidth=2,
            label=f"Медіана: {median_val:.1f} мс")
ax1.axvline(q1_val, color="orange", linestyle=":", linewidth=2,
            label=f"Q1: {q1_val:.1f} мс")
ax1.axvline(q3_val, color="orange", linestyle=":", linewidth=2,
            label=f"Q3: {q3_val:.1f} мс")
ax1.legend()

# Нижній графік: box plot (той самий датасет)
bp = ax2.boxplot(data, vert=False, patch_artist=True, widths=0.6,
                 boxprops=dict(facecolor="mediumseagreen", alpha=0.7),
                 medianprops=dict(color="red", linewidth=2))

ax2.set_xlabel("Час відповіді (мс)", fontsize=11)
ax2.set_yticks([])
ax2.grid(axis="x", alpha=0.3)

plt.tight_layout()
plt.show()
| Гістограма | Box Plot |
|---|---|
| Показує форму розподілу (симетрія, піки, хвости) | Показує статистичні показники (медіана, квартилі, викиди) |
| Добре для одного датасету | Відмінно для порівняння груп |
| Візуально «багатий» | Компактний, займає мало місця |
| Потребує вибору bins | Не залежить від bins |
Практичні завдання
📝 Рівень 1: Базові навички
Завдання 1.1: Згенеруйте 1000 випадкових чисел з нормальним розподілом (середнє=100, std=15). Побудуйте гістограму з 30 bins. Додайте вертикальні лінії для середнього та медіани.
Завдання 1.2: Створіть box plot для трьох списків даних: 10, 15, 14, 16, 12, 18, 50, 8, 9, 10, 11, 9, 10, 20, 25, 22, 28, 30, 24. Визначте, в якому списку є викиди.
Завдання 1.3: Побудуйте гістограму з bins="auto", bins=10 та bins=50 для одного датасету. Порівняйте результати.
🧮 Рівень 2: Аналіз даних
Завдання 2.1: Завантажте датасет Titanic (seaborn.load_dataset("titanic")). Побудуйте гістограму розподілу віку пасажирів. Додайте вертикальні лінії для середнього, медіани та моди.
Завдання 2.2: Для того ж датасету Titanic побудуйте box plots для порівняння віку пасажирів у трьох класах (1st, 2nd, 3rd). Зробіть висновки.
Завдання 2.3: Згенеруйте дані з двох різних розподілів (наприклад, нормальний та експоненційний). Побудуйте для кожного гістограму та box plot на одній фігурі (2×2 subplots).
🚀 Рівень 3: Дослідницький проєкт
Проєкт: Дослідження розподілу доходів
- Згенеруйте реалістичні дані доходів (right-skewed розподіл): 90% людей — нормальний розподіл (середнє=50k, std=10k), 10% — багаті (uniform 100k–500k)
- Побудуйте гістограму та box plot
- Обчисліть середнє та медіану. Поясніть, чому вони так відрізняються
- Побудуйте «до та після» графіки: з викидами та без них (відфільтруйте топ-5%)
- Напишіть короткий висновок: чому для доходів медіана кращий показник, ніж середнє
Резюме підтеми
📊 Гістограми
ax.hist(data, bins=30)— візуалізація розподілуbins— кількість інтервалів ("auto", число, або "sturges", "scott")- Форма показує: симетрію, асиметрію, піки, хвости
- Для асиметричних даних: медіана > середнє
📦 Box Plots
ax.boxplot(data)— компактний показ 5 статистичних величин- Ящик = IQR (Q1–Q3), лінія всередині = медіана
- Вуса = діапазон без викидів (Q1 - 1.5·IQR, Q3 + 1.5·IQR)
- Точки = викиди (outliers)
- Ідеально для порівняння груп
🎯 Коли що використовувати
- Один датасет, потрібна форма → гістограма
- Кілька груп, потрібне порівняння → box plots
- Підозра на викиди → box plot їх покаже
- Презентація для нетехнічної аудиторії → гістограма (інтуїтивніша)
- Технічний звіт, багато груп → box plots (компактніші)
- Побудували гістограму → побачили форму
- Перевірили: симетричний чи асиметричний?
- Якщо асиметричний → використовуємо медіану, не середнє
- Побудували box plot → знайшли викиди
- Якщо потрібно порівняти групи → box plots поруч
- Інтерпретували: широкий ящик = великий розкид, вузький = стабільні дані
Попередня підтема: Основи matplotlibНаступна підтема: Візуалізація залежностей — scatter plots та кореляція
Основи matplotlib — Figure, Axes та перший графік
Архітектура matplotlib, різниця між pyplot та OOP інтерфейсами, побудова лінійних графіків, базова кастомізація
Візуалізація залежностей — scatter plots та кореляція
Точкові діаграми для виявлення кореляцій, візуалізація лінійних та нелінійних залежностей, regression lines, scatter matrices