Основи згорткових нейронних мереж — чому не MLP?
Від повнозв'язних мереж до згорткових — коли MLP здається
У попередніх статтях ми опанували багатошарові персептрони (MLP), навчилися будувати глибокі мережі на PyTorch та застосовували їх для класифікації медичних даних. MLP чудово справляються з табличними даними — рядками ознак, де кожна колонка має чітке значення (вік, тиск, холестерин). Але що станеться, якщо спробувати застосувати MLP до зображень?
Уявіть завдання: розпізнати, чи є на фотографії кішка чи собака. Зображення розміром 224×224 пікселі у форматі RGB (три колірних канали) містить 224 × 224 × 3 = 150 528 пікселів. Якщо подати це зображення на вхід повнозв'язної мережі, кожен піксель стане окремою ознакою. Навіть перший прихований шар із скромними 512 нейронами потребуватиме:
77 мільйонів параметрів лише в першому шарі! Це катастрофічно багато:
⚠️ Проблема 1: Вибух параметрів
⚠️ Проблема 2: Втрата просторової структури
⚠️ Проблема 3: Відсутність інваріантності до трансформацій
Інтуїція згорткової мережі — як бачить людське око
Перш ніж перейти до математики, зрозуміймо інтуїцію згорткових мереж через аналогію з людським зором.
Коли ви дивитеся на фотографію обличчя, ваш мозок не обробляє кожен піксель окремо. Натомість:
Крок 1. Локальне сприйняття
Нейрони у первинній зоровій корі (V1) реагують на локальні шаблони — невеликі ділянки зображення. Один нейрон може бути «детектором вертикальних ліній», інший — «детектором діагональних країв», третій — «детектором кутів».
Аналог у CNN: згортковий фільтр розміром 3×3 пікселі, який «сканує» зображення та шукає конкретний візуальний шаблон (наприклад, горизонтальну лінію).
Крок 2. Ієрархічне представлення
Нейрони наступного рівня (V2) комбінують виходи детекторів країв, створюючи детектори більш складних форм — частин обличчя (око, ніс). Ще вищі рівні розпізнають об'єкти цілком (обличчя, автомобіль).
Аналог у CNN: перші згорткові шари виявляють прості ознаки (лінії, кольори), наступні — текстури та частини об'єктів, останні — цілі об'єкти.
Крок 3. Інваріантність до позиції
Ви розпізнаєте кішку незалежно від того, у якому кутку фото вона знаходиться. Детектор «вуха кішки» працює однаково для всіх позицій.
Аналог у CNN: один фільтр застосовується до всіх ділянок зображення (розділення ваг — weight sharing). Якщо фільтр навчився виявляти вухо у верхньому лівому куті, він зможе виявити його і в центрі, і внизу справа.
Операція згортки — математика локальних фільтрів
Згортка (Convolution) — це математична операція, яка застосовує невеликий фільтр (матрицю ваг) до локальних ділянок зображення, обчислюючи скалярний добуток.
Формальне визначення
Нехай маємо:
- Вхідне зображення Завантаження... розміром Завантаження... (висота × ширина)
- Фільтр (ядро згортки) Завантаження... розміром Завантаження... (зазвичай 3×3 або 5×5)
Вихід згортки Завантаження... обчислюється як:
Де Завантаження... — позиція у вихідній карті ознак (Feature Map).
Інтуїція: Ми беремо маленьке «віконце» фільтра розміром Завантаження..., накладаємо його на відповідну ділянку зображення, множимо поелементно та сумуємо всі добутки. Це дає одне число у вихідній карті. Потім зсуваємо віконце на крок (stride) і повторюємо.
Приклад: детектор вертикальних ліній
Розглянемо конкретний фільтр, який виявляє вертикальні краї:
Фільтр Собеля для вертикальних країв
Класичний фільтр, що реагує на перехід від темного до світлого зліва направо:
import numpy as np
import matplotlib.pyplot as plt

# Фільтр Собеля для вертикальних країв (3×3)
kernel_vertical = np.array([
    [-1, 0, 1],
    [-2, 0, 2],
    [-1, 0, 1]
])

print("Фільтр для вертикальних країв (Sobel):\n")
print(kernel_vertical)
print("\nІнтерпретація:")
print("  Ліва колонка (від'ємні ваги): реагує на темні пікселі зліва")
print("  Центральна колонка (нулі): ігнорує центр")
print("  Права колонка (додатні ваги): реагує на світлі пікселі справа")
| Позиція | Вага | Роль |
|---|---|---|
| Ліва колонка | -1, -2, -1 | Реагує на темну область зліва |
| Центральна колонка | 0, 0, 0 | Ігнорує центральну область |
| Права колонка | +1, +2, +1 | Реагує на світлу область справа |
Висновок: Якщо зліва темно, справа світло — сильна вертикальна межа! Скалярний добуток дасть велике додатне число.
Застосування до зображення
Створимо просте зображення з вертикальною лінією та застосуємо згортку:
# Створюємо зображення 7×7 з вертикальною лінією посередині
image = np.array([
    [0, 0, 0, 255, 0, 0, 0],
    [0, 0, 0, 255, 0, 0, 0],
    [0, 0, 0, 255, 0, 0, 0],
    [0, 0, 0, 255, 0, 0, 0],
    [0, 0, 0, 255, 0, 0, 0],
    [0, 0, 0, 255, 0, 0, 0],
    [0, 0, 0, 255, 0, 0, 0]
], dtype=np.float32)

# Ручне обчислення згортки (без padding)
def convolve2d(image, kernel):
    k_h, k_w = kernel.shape
    i_h, i_w = image.shape
    output_h = i_h - k_h + 1
    output_w = i_w - k_w + 1
    output = np.zeros((output_h, output_w))

    for i in range(output_h):
        for j in range(output_w):
            # Вирізаємо ділянку зображення
            region = image[i:i+k_h, j:j+k_w]
            # Поелементне множення та сума
            output[i, j] = np.sum(region * kernel)

    return output

# Застосовуємо фільтр
feature_map = convolve2d(image, kernel_vertical)

# Візуалізація
fig, axes = plt.subplots(1, 3, figsize=(15, 5))

# Оригінал
axes[0].imshow(image, cmap='gray', vmin=0, vmax=255)
axes[0].set_title('Вхідне зображення (7×7)', fontsize=14, fontweight='bold')
axes[0].axis('off')

# Фільтр
axes[1].imshow(kernel_vertical, cmap='RdBu_r', vmin=-2, vmax=2)
axes[1].set_title('Фільтр Собеля (3×3)', fontsize=14, fontweight='bold')
for i in range(3):
    for j in range(3):
        axes[1].text(j, i, f'{kernel_vertical[i, j]:+.0f}',
                     ha='center', va='center', fontsize=12, fontweight='bold')
axes[1].axis('off')

# Feature Map
im = axes[2].imshow(feature_map, cmap='hot', interpolation='nearest')
axes[2].set_title(f'Feature Map (5×5)\nВертикальна межа виявлена!', fontsize=14, fontweight='bold')
plt.colorbar(im, ax=axes[2], fraction=0.046, pad=0.04)
axes[2].axis('off')

plt.tight_layout()
plt.show()

print(f"Розмір виходу: {feature_map.shape}")
print(f"Максимальна активація (вертикальна межа): {feature_map.max():.0f}")
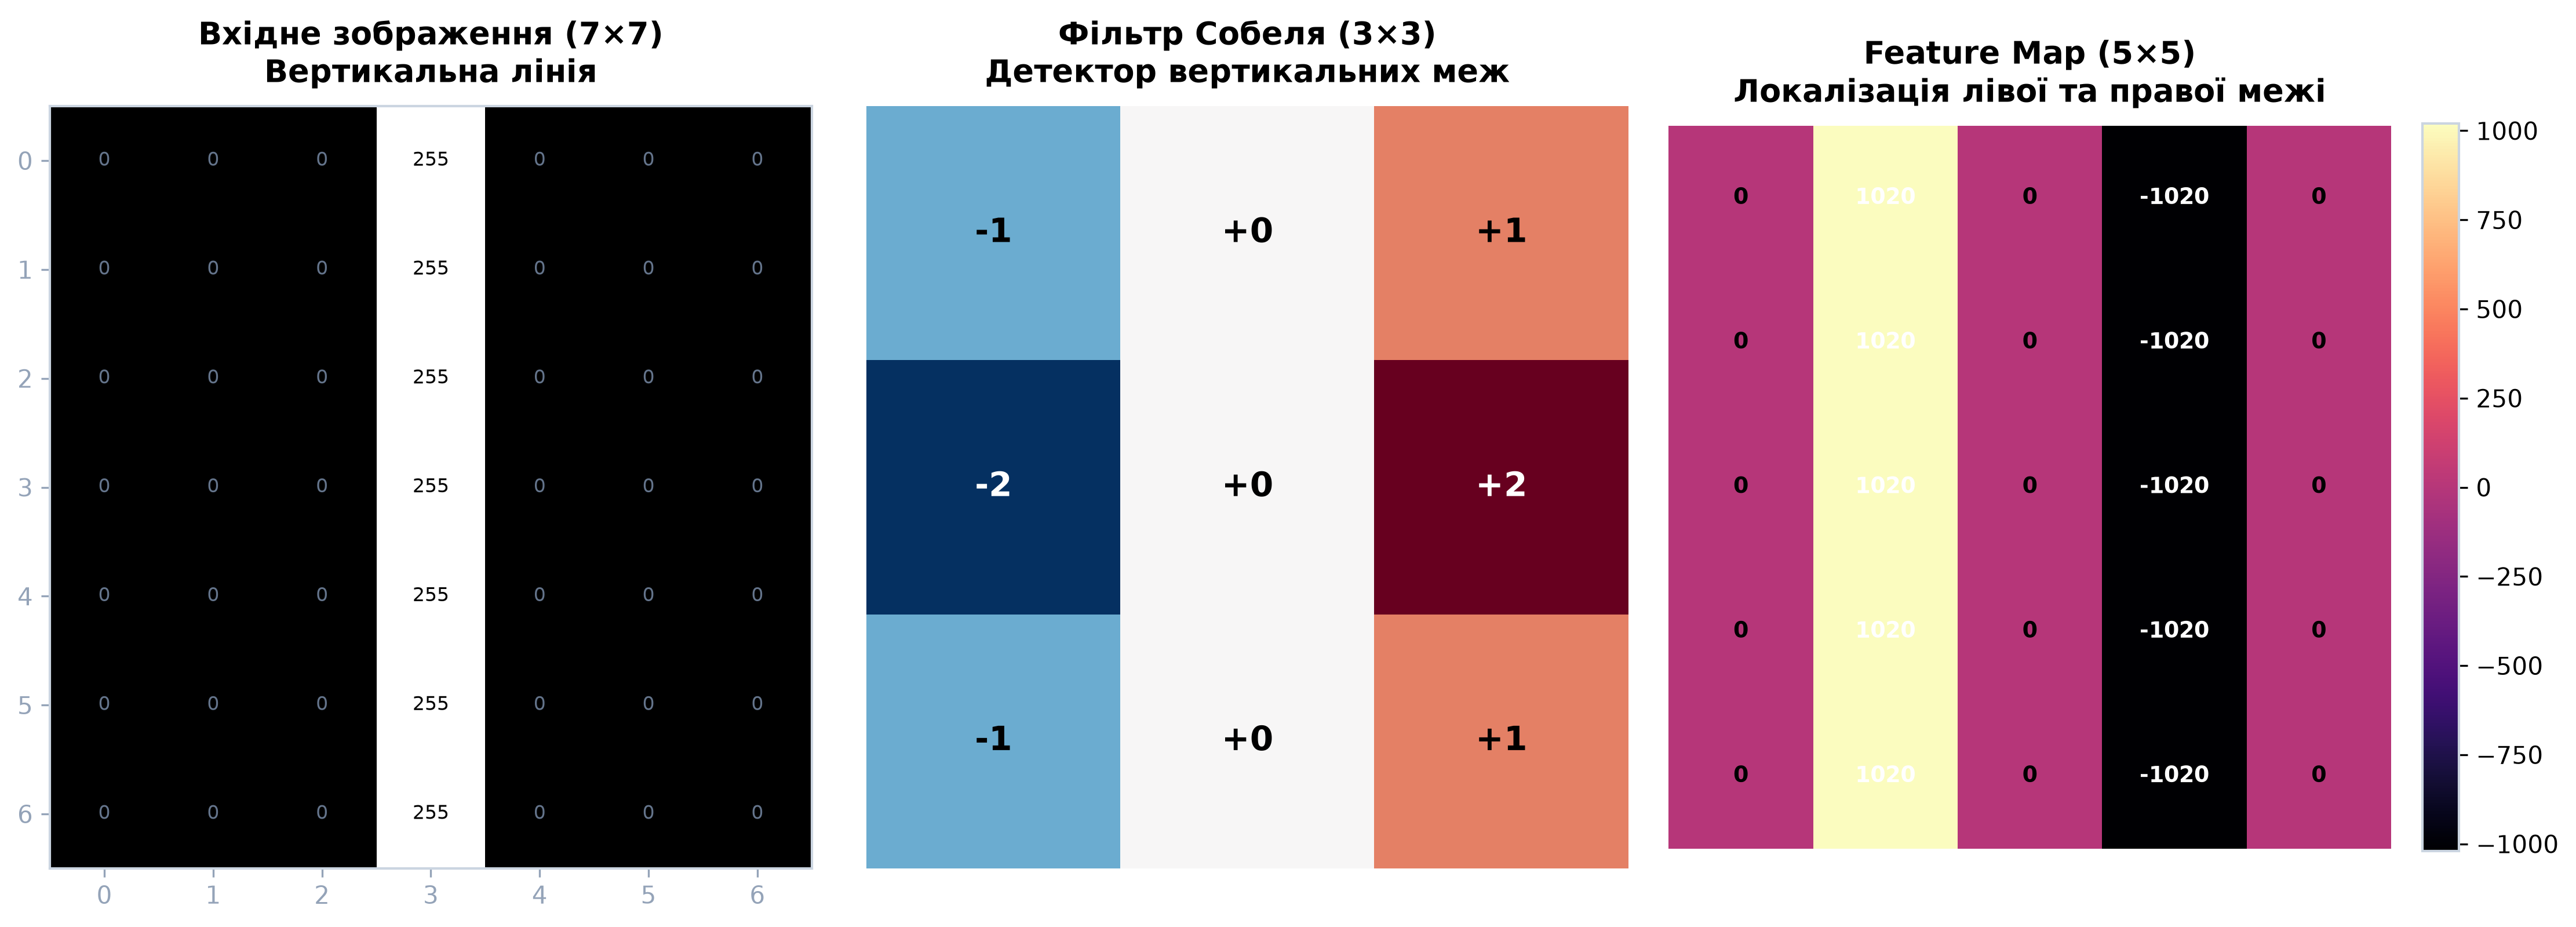
Розмір виходу: 5×5 (з 7×7 зображення та 3×3 фільтра: 7 - 3 + 1 = 5)
Спостереження: Найсильніша активація (найяскравіша точка) знаходиться у центральній колонці Feature Map — саме там, де проходить вертикальна лінія!
Параметри згортки — stride, padding та їхній вплив
Операція згортки має три ключових гіперпараметри, які визначають розмір та характер виходу:
Stride (крок згортки)
Stride — на скільки пікселів зсувається фільтр при кожному кроці.
- Stride = 1: Фільтр зсувається на 1 піксель (стандартний варіант, максимальна деталізація)
- Stride = 2: Фільтр «перестрибує» через кожен другий піксель (зменшує розмір виходу вдвічі)
# Порівняння stride=1 та stride=2
image_8x8 = np.random.randint(0, 256, (8, 8), dtype=np.float32)
kernel_3x3 = np.ones((3, 3)) / 9  # Фільтр усереднення

def convolve_with_stride(image, kernel, stride=1):
    k_h, k_w = kernel.shape
    i_h, i_w = image.shape
    output_h = (i_h - k_h) // stride + 1
    output_w = (i_w - k_w) // stride + 1
    output = np.zeros((output_h, output_w))

    for i in range(output_h):
        for j in range(output_w):
            region = image[i*stride:i*stride+k_h, j*stride:j*stride+k_w]
            output[i, j] = np.sum(region * kernel)

    return output

output_stride1 = convolve_with_stride(image_8x8, kernel_3x3, stride=1)
output_stride2 = convolve_with_stride(image_8x8, kernel_3x3, stride=2)

print(f"Вхід: 8×8")
print(f"Stride=1 → Вихід: {output_stride1.shape} (6×6)")
print(f"Stride=2 → Вихід: {output_stride2.shape} (3×3)")
print(f"\nВисновок: Stride=2 зменшує розмір у ~2 рази по кожній осі")
| Параметр | Вхід | Фільтр | Stride | Вихід | Коментар |
|---|---|---|---|---|---|
| Stride=1 | 8×8 | 3×3 | 1 | 6×6 | Максимальна деталізація |
| Stride=2 | 8×8 | 3×3 | 2 | 3×3 | Зменшення розміру вдвічі |
Формула розрахунку виходу:
::
::
Padding (доповнення нулями)
Padding — додавання рамки з нулів навколо зображення перед згорткою. Вирішує дві проблеми:
- Збереження розміру: Без padding зображення зменшується після кожного шару
- Обробка країв: Пікселі на краях зображення беруть участь у меншій кількості обчислень, ніж центральні. Padding робить обробку рівномірною.
# Демонстрація padding
image_5x5 = np.array([
    [1, 2, 3, 4, 5],
    [6, 7, 8, 9, 10],
    [11, 12, 13, 14, 15],
    [16, 17, 18, 19, 20],
    [21, 22, 23, 24, 25]
], dtype=np.float32)

# Додаємо padding=1 (один шар нулів навколо)
padded = np.pad(image_5x5, pad_width=1, mode='constant', constant_values=0)

print("Оригінал (5×5):")
print(image_5x5.astype(int))
print(f"\nПісля padding=1 (7×7):")
print(padded.astype(int))
print(f"\nТепер згортка з фільтром 3×3 дасть вихід: 7 - 3 + 1 = 5×5")
print("(збережено оригінальний розмір!)")
| Етап перетворення | Розмір матриці | Формат простору | Ефект згортки 3×3 |
|---|---|---|---|
| Оригінальне зображення | (5, 5) | Початковий числовий тензор $5 \times 5$ | Вихід $3 \times 3$ (втрата крайових пікселів) |
З Zero-Padding (p=1) | (7, 7) | Додано рамку з нулів товщиною 1 піксель | 5 × 5 (ідеальне збереження розмірності) |
💡 Математичний висновок: Для фільтра непарного розміру $K$ симетричний падінг $p = (K - 1) / 2$ забезпечує формулу $(W - K + 2p) + 1 = W$, зберігаючи геометричний розмір карти ознак без стиснення.
padding='same' автоматично обчислює потрібну кількість нулів, щоб вихід мав такий самий розмір, як вхід (за умови stride=1).Для фільтра Завантаження... формула:- Фільтр 3×3 → padding = 1
- Фільтр 5×5 → padding = 2
- Фільтр 7×7 → padding = 3
Feature Maps — карти ознак як нове представлення
Після застосування згортки ми отримуємо Feature Map (карту ознак) — двовимірну матрицю, де кожне значення показує, наскільки сильно фільтр «відреагував» на відповідну ділянку зображення.
Ключова ідея: Один згортковий шар застосовує кілька різних фільтрів (зазвичай 32, 64, 128 чи більше) до одного зображення, створюючи стільки ж Feature Maps. Кожен фільтр навчається виявляти свій унікальний візуальний шаблон.
Інтерпретація:
- Feature Map 1: «Де на зображенні є горизонтальні краї?»
- Feature Map 2: «Де є вертикальні краї?»
- Feature Map 3: «Де є діагональні лінії під кутом 45°?»
- ...
- Feature Map 32: «Де є складна текстура X?»
Наступні шари CNN беруть ці Feature Maps як вхід та комбінують їх, створюючи детектори ще складніших форм (очі, вуха, коліс автомобіля тощо).
Pooling шари — зменшення розмірності та інваріантність
Після згорткового шару зазвичай застосовують Pooling шар (шар об'єднання) — операцію зменшення просторової розмірності Feature Maps. Найпопулярніші варіанти: Max Pooling та Average Pooling.
Max Pooling — вибір максимуму
Max Pooling бере максимальне значення з кожної невеликої ділянки (зазвичай 2×2) Feature Map.
# Приклад Max Pooling 2×2
feature_map = np.array([
    [1, 3, 2, 4],
    [5, 6, 1, 2],
    [7, 2, 9, 3],
    [1, 8, 4, 6]
], dtype=np.float32)

def max_pool_2x2(feature_map):
    h, w = feature_map.shape
    output = np.zeros((h//2, w//2))
    for i in range(0, h, 2):
        for j in range(0, w, 2):
            region = feature_map[i:i+2, j:j+2]
            output[i//2, j//2] = np.max(region)
    return output

pooled = max_pool_2x2(feature_map)

print("Feature Map (4×4):")
print(feature_map.astype(int))
print("\nПісля Max Pooling 2×2 (2×2):")
print(pooled.astype(int))
print("\nВибрано максимальні значення з кожного блоку 2×2:")
print("  [1, 3]  →  [5, 6]  →  max = 6")
print("  [5, 6]     [7, 2]")
| Блок 2×2 Feature Map | Елементи вікна 2×2 | Операція Max Pooling | Результат у вихідній карті |
|---|---|---|---|
| Верхній лівий квадрант | [1, 3] / [5, 6] | $\max(1, 3, 5, 6)$ | 6 |
| Верхній правий квадрант | [2, 4] / [1, 2] | $\max(2, 4, 1, 2)$ | 4 |
| Нижній лівий квадрант | [7, 2] / [1, 8] | $\max(7, 2, 1, 8)$ | 8 |
| Нижній правий квадрант | [9, 3] / [4, 6] | $\max(9, 3, 4, 6)$ | 9 |
⚡ Результат Max Pooling: Розмір карти ознак зменшено рівно вдвічі ($4 \times 4 \to 2 \times 2$), зберігши найбільш виражені активації та забезпечивши локальну інваріантність до просторового зсуву.
Чому Max Pooling корисний:
✅ Зменшення розмірності
✅ Локальна інваріантність
✅ Фокус на найсильніших активаціях
Average Pooling — усереднення
Average Pooling обчислює середнє значення замість максимуму. Використовується рідше (зазвичай лише у фінальних шарах для глобального об'єднання).
- Max Pooling: Стандартний вибір для прихованих шарів. Зберігає найсильніші ознаки, краще для задач класифікації.
- Average Pooling: Іноді використовується у фінальному шарі перед класифікатором (Global Average Pooling) для агрегації всієї Feature Map в одне число на канал.
Повна архітектура CNN — від пікселів до класів
Тепер зберемо всі компоненти разом у типову архітектуру згорткової мережі для класифікації зображень.
Покроковий аналіз архітектури
Крок 1. Вхідне зображення (28×28×1)
Grayscale зображення (наприклад, цифра MNIST): 28 пікселів у висоту, 28 у ширину, 1 канал (відтінки сірого).
Крок 2. Перший згортковий блок
- Conv2d (3×3, 32 filters, padding=1): Застосовуємо 32 різних фільтри розміром 3×3. Вихід: 28×28×32 Feature Maps.
- ReLU: Нелінійна активація Завантаження....
- MaxPool2d (2×2): Зменшуємо розмір вдвічі. Вихід: 14×14×32.
Параметрів у цьому блоці: Завантаження... (1 вхідний канал, 32 фільтри, +1 bias на фільтр).
Крок 3. Другий згортковий блок
- Conv2d (3×3, 64 filters, padding=1): 64 фільтри обробляють 32 Feature Maps з попереднього шару. Вихід: 14×14×64.
- ReLU
- MaxPool2d (2×2): Вихід: 7×7×64.
Параметрів: Завантаження....
Крок 4. Flatten (згладжування)
Перетворюємо тривимірний тензор 7×7×64 у плоский вектор: Завантаження... чисел.
Крок 5. Повнозв'язний класифікатор
- Dense (3136 → 128): Повнозв'язний шар із 128 нейронами. Параметрів: Завантаження....
- ReLU
- Dropout (0.5): Під час навчання випадково вимикаємо 50% нейронів для запобігання перенавчанню.
- Dense (128 → 10): Фінальний шар для 10 класів (цифри 0-9). Параметрів: Завантаження....
- Softmax: Перетворюємо 10 чисел у розподіл ймовірностей (сума = 1).
Загальна кількість параметрів: ~421 тисяча.
Порівняння з MLP: Якби ми подали 28×28=784 пікселі напряму у повнозв'язний шар із 128 нейронами, потрібно було б Завантаження... ваг вже в першому шарі. CNN ефективніша завдяки розділенню ваг у згорткових шарах!
- Кілька блоків Conv → ReLU → Pool: Поступово зменшуємо просторову розмірність (28×28 → 14×14 → 7×7), одночасно збільшуючи кількість каналів (1 → 32 → 64 → 128).
- Flatten
- Кілька повнозв'язних шарів для фінальної класифікації.
Підсумок — чому CNN працюють для зображень
У цій статті ми розібрали фундаментальні принципи згорткових нейронних мереж:
🎯 Ключові концепції
- Локальна зв'язність: Нейрон обробляє лише невелику ділянку зображення
- Розділення ваг: Один фільтр застосовується до всього зображення
- Ієрархічність: Прості ознаки → складні ознаки → об'єкти
- Зменшення розмірності: Pooling для ефективності та інваріантності
🔑 Переваги над MLP
- Менше параметрів: 320 ваг у Conv3×3 vs 100K+ у FC шарі
- Інваріантність до зсувів: Об'єкт розпізнається у будь-якій позиції
- Збереження просторової структури: Сусідні пікселі залишаються поруч
Наступним кроком ми застосуємо ці знання на практиці, побудувавши CNN на PyTorch для класифікації рукописних цифр MNIST та досягнемо >98% accuracy.
Запитання для самоконтролю
Відповідь: Зображення 224×224×3 містить 150,528 пікселів. Повнозв'язний шар навіть із 512 нейронами потребує 77 мільйонів ваг лише в першому шарі. Це призводить до:
- Катастрофічного споживання пам'яті (~300 МБ для одного шару)
- Перенавчання через величезну кількість параметрів
- Втрати просторової структури (сусідні пікселі стають незалежними ознаками)
CNN вирішує це через локальну зв'язність (фільтр 3×3 замість повного зв'язку) та розділення ваг (один фільтр для всього зображення).
Загальна формула:
Приклад: Вхід 32×32, фільтр 5×5, stride=1, padding=2:
Вихід: 32×32 (розмір збережено!)
Без padding: Завантаження... (зменшення!).
Max Pooling — це фіксована операція вибору максимуму, без навчаємих ваг. Він завжди бере найбільше число з кожного вікна 2×2 (або іншого розміру).
Порівняння:
- Conv2d: Має ваги фільтра, які навчаються градієнтним спуском.
- MaxPool2d: Просто обирає max, ніяких ваг.
Це зменшує кількість параметрів у мережі та робить Pooling дуже швидким.
Умова: Створіть архітектуру CNN для класифікації 5 класів кольорових зображень розміром 64×64×3.
Вимоги:
- Два згорткових блоки (Conv → ReLU → MaxPool)
- Перший блок: 16 фільтрів 3×3
- Другий блок: 32 фільтри 3×3
- Padding='same', stride=1 для згорток
- MaxPool 2×2
- Один повнозв'язний прихований шар (128 нейронів)
- Вихідний шар для 5 класів
Обчисліть розміри тензорів на кожному етапі.
Архітектура:
- Вхід: 64×64×3
- Блок 1:
- Conv2d(3→16, kernel=3×3, padding=1, stride=1): 64×64×16
- ReLU
- MaxPool2d(2×2): 32×32×16
- Блок 2:
- Conv2d(16→32, kernel=3×3, padding=1, stride=1): 32×32×32
- ReLU
- MaxPool2d(2×2): 16×16×32
- Flatten: Завантаження...
- FC (8192 → 128): ReLU
- FC (128 → 5): Softmax
Кількість параметрів:
- Conv1: Завантаження...
- Conv2: Завантаження...
- FC1: Завантаження...
- FC2: Завантаження...
Загалом: ~1.05 млн параметрів.
Бонус — Повний приклад Student Performance Prediction
Детальна імплементація системи передбачення успішності студентів з аналізом важливості ознак, інтерпретацією результатів та рекомендаціями для освітніх закладів.
Практична імплементація CNN для класифікації MNIST
Побудова згорткової нейронної мережі на PyTorch для розпізнавання рукописних цифр. Цикл навчання, візуалізація метрик, аналіз помилок та Confusion Matrix.