Бонус — Повний приклад Student Performance Prediction
Розширений приклад: Система раннього попередження для шкіл
У основній статті ми коротко розглянули датасет Student Performance. Тут наведено повну імплементацію із детальним аналізом ознак, експериментами з архітектурою та практичними рекомендаціями для інтеграції у реальні освітні системи.
- Хочуть побачити повний код без скорочень
- Цікавляться застосуванням AI в освіті
- Планують виконати курсовий/дипломний проєкт у цій галузі
- Хочуть зрозуміти різницю між медичним та освітнім ML-кейсом
Повне завантаження та аналіз датасету
Опис португальської освітньої системи (контекст)
Датасет зібрано у двох португальських середніх школах (Gabriel Pereira та Mousinho da Silveira) у місті Гімарайнш. У Португалії оцінки виставляються за 20-бальною шкалою:
- 0–9 балів: Не склав (reprova)
- 10–13 балів: Склав задовільно (suficiente)
- 14–16 балів: Добре (bom)
- 17–20 балів: Відмінно (muito bom)
Мінімальна прохідна оцінка — 10 балів. Саме тому ми обираємо поріг G3 >= 10 для бінарної класифікації.
Завантаження даних
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

# Налаштування візуалізації
sns.set_style("whitegrid")
plt.rcParams['figure.figsize'] = (14, 6)
plt.rcParams['font.size'] = 11

# Завантаження датасету (Math course)
# Для реального використання замініть на URL або локальний шлях
try:
    df = pd.read_csv('student-mat.csv', sep=';')
except FileNotFoundError:
    # Альтернатива: завантаження з UCI (якщо є з'єднання)
    url = 'https://archive.ics.uci.edu/ml/machine-learning-databases/00320/student.zip'
    import zipfile
    import urllib.request

    urllib.request.urlretrieve(url, 'student.zip')
    with zipfile.ZipFile('student.zip', 'r') as zip_ref:
        zip_ref.extractall('.')
    df = pd.read_csv('student-mat.csv', sep=';')

print("=" * 80)
print("ДАТАСЕТ STUDENT PERFORMANCE — ДЕТАЛЬНИЙ ОГЛЯД")
print("=" * 80)
print(f"\nРозмір: {df.shape[0]} студентів × {df.shape[1]} ознак")
print(f"\nНазви стовпців:")
print(df.columns.tolist())
print(f"\nПерші 5 записів:")
print(df.head())
| Параметр датасету | Значення | Семантика |
|---|---|---|
| Загальний обсяг вибірки | 395 студентів | Учні середніх шкіл Gabriel Pereira та Mousinho da Silveira |
| Кількість первинних ознак | 33 | Соціальні, сімейні, психологічні та оціночні фактори |
| Оцінки періодів | G1 (1-й семестр), G2 (2-й семестр) | Шкала від 0 до 20 балів |
| Фінальна оцінка | G3 (підсумковий бал) | Ключова цільова змінна |
EDA: Виявлення закономірностей
# Створення цільової змінної
df['pass'] = (df['G3'] >= 10).astype(int)

# Статистика по класах
print("\n" + "=" * 80)
print("РОЗПОДІЛ ФІНАЛЬНИХ ОЦІНОК")
print("=" * 80)
print(f"\nОписова статистика G3:")
print(df['G3'].describe())

print(f"\nРозподіл за критерієм здачі:")
fail_count = (df['pass'] == 0).sum()
pass_count = (df['pass'] == 1).sum()
print(f"  Не склав (G3 < 10): {fail_count} студентів ({fail_count/len(df)*100:.1f}%)")
print(f"  Склав (G3 ≥ 10):    {pass_count} студентів ({pass_count/len(df)*100:.1f}%)")

# Кореляція попередніх оцінок з фінальною
print(f"\nКореляція оцінок:")
print(f"  G1 ↔ G3: {df['G1'].corr(df['G3']):.3f}")
print(f"  G2 ↔ G3: {df['G2'].corr(df['G3']):.3f}")
print(f"  G1 ↔ G2: {df['G1'].corr(df['G2']):.3f}")
| Статистичний показник | Оцінка G3 (0–20 балів) | Розподіл за критерієм здачі | Кількість студентів | Відсоток (%) |
|---|---|---|---|---|
| Середнє арифметичне ($\mu$) | 10.42 | Склав іспит ($G3 \ge 10$) | 265 | 67.1% |
| Стандартне відхилення ($\sigma$) | 4.58 | Не склав іспит ($G3 < 10$) | 130 | 32.9% |
| Мінімум / Медіана / Максимум | 0.0 / 11.0 / 20.0 | Кореляція $G2 \leftrightarrow G3$ | 0.905 | Найсильніший зв'язок |
# Візуалізація розподілу оцінок
fig, axes = plt.subplots(1, 2, figsize=(16, 6))

# Гістограма фінальних оцінок
axes[0].hist(df[df['pass'] == 0]['G3'], bins=10, alpha=0.7, color='#ef4444', label='Не склав (G3 < 10)', edgecolor='black')
axes[0].hist(df[df['pass'] == 1]['G3'], bins=10, alpha=0.7, color='#10b981', label='Склав (G3 ≥ 10)', edgecolor='black')
axes[0].axvline(x=10, color='black', linestyle='--', linewidth=2, label='Поріг здачі (10/20)')
axes[0].set_xlabel('Фінальна оцінка (G3)', fontsize=13)
axes[0].set_ylabel('Кількість студентів', fontsize=13)
axes[0].set_title('Розподіл фінальних оцінок', fontsize=15, fontweight='bold')
axes[0].legend(fontsize=11)
axes[0].grid(alpha=0.3)

# Boxplot за ключовими ознаками
fail_success_data = [
    df[df['pass'] == 0]['studytime'],
    df[df['pass'] == 1]['studytime'],
    df[df['pass'] == 0]['failures'],
    df[df['pass'] == 1]['failures'],
    df[df['pass'] == 0]['absences'],
    df[df['pass'] == 1]['absences']
]

positions = [1, 2, 4, 5, 7, 8]
colors = ['#ef4444', '#10b981'] * 3
box = axes[1].boxplot(fail_success_data, positions=positions, widths=0.6, patch_artist=True,
                      labels=['Не склав', 'Склав', 'Не склав', 'Склав', 'Не склав', 'Склав'])

for patch, color in zip(box['boxes'], colors):
    patch.set_facecolor(color)
    patch.set_alpha(0.7)

axes[1].set_xticks([1.5, 4.5, 7.5])
axes[1].set_xticklabels(['studytime\n(год/тиждень)', 'failures\n(провалені предмети)', 'absences\n(пропуски)'], fontsize=11)
axes[1].set_ylabel('Значення ознаки', fontsize=13)
axes[1].set_title('Порівняння ключових ознак: Не склав vs Склав', fontsize=15, fontweight='bold')
axes[1].grid(alpha=0.3, axis='y')

plt.tight_layout()
plt.show()
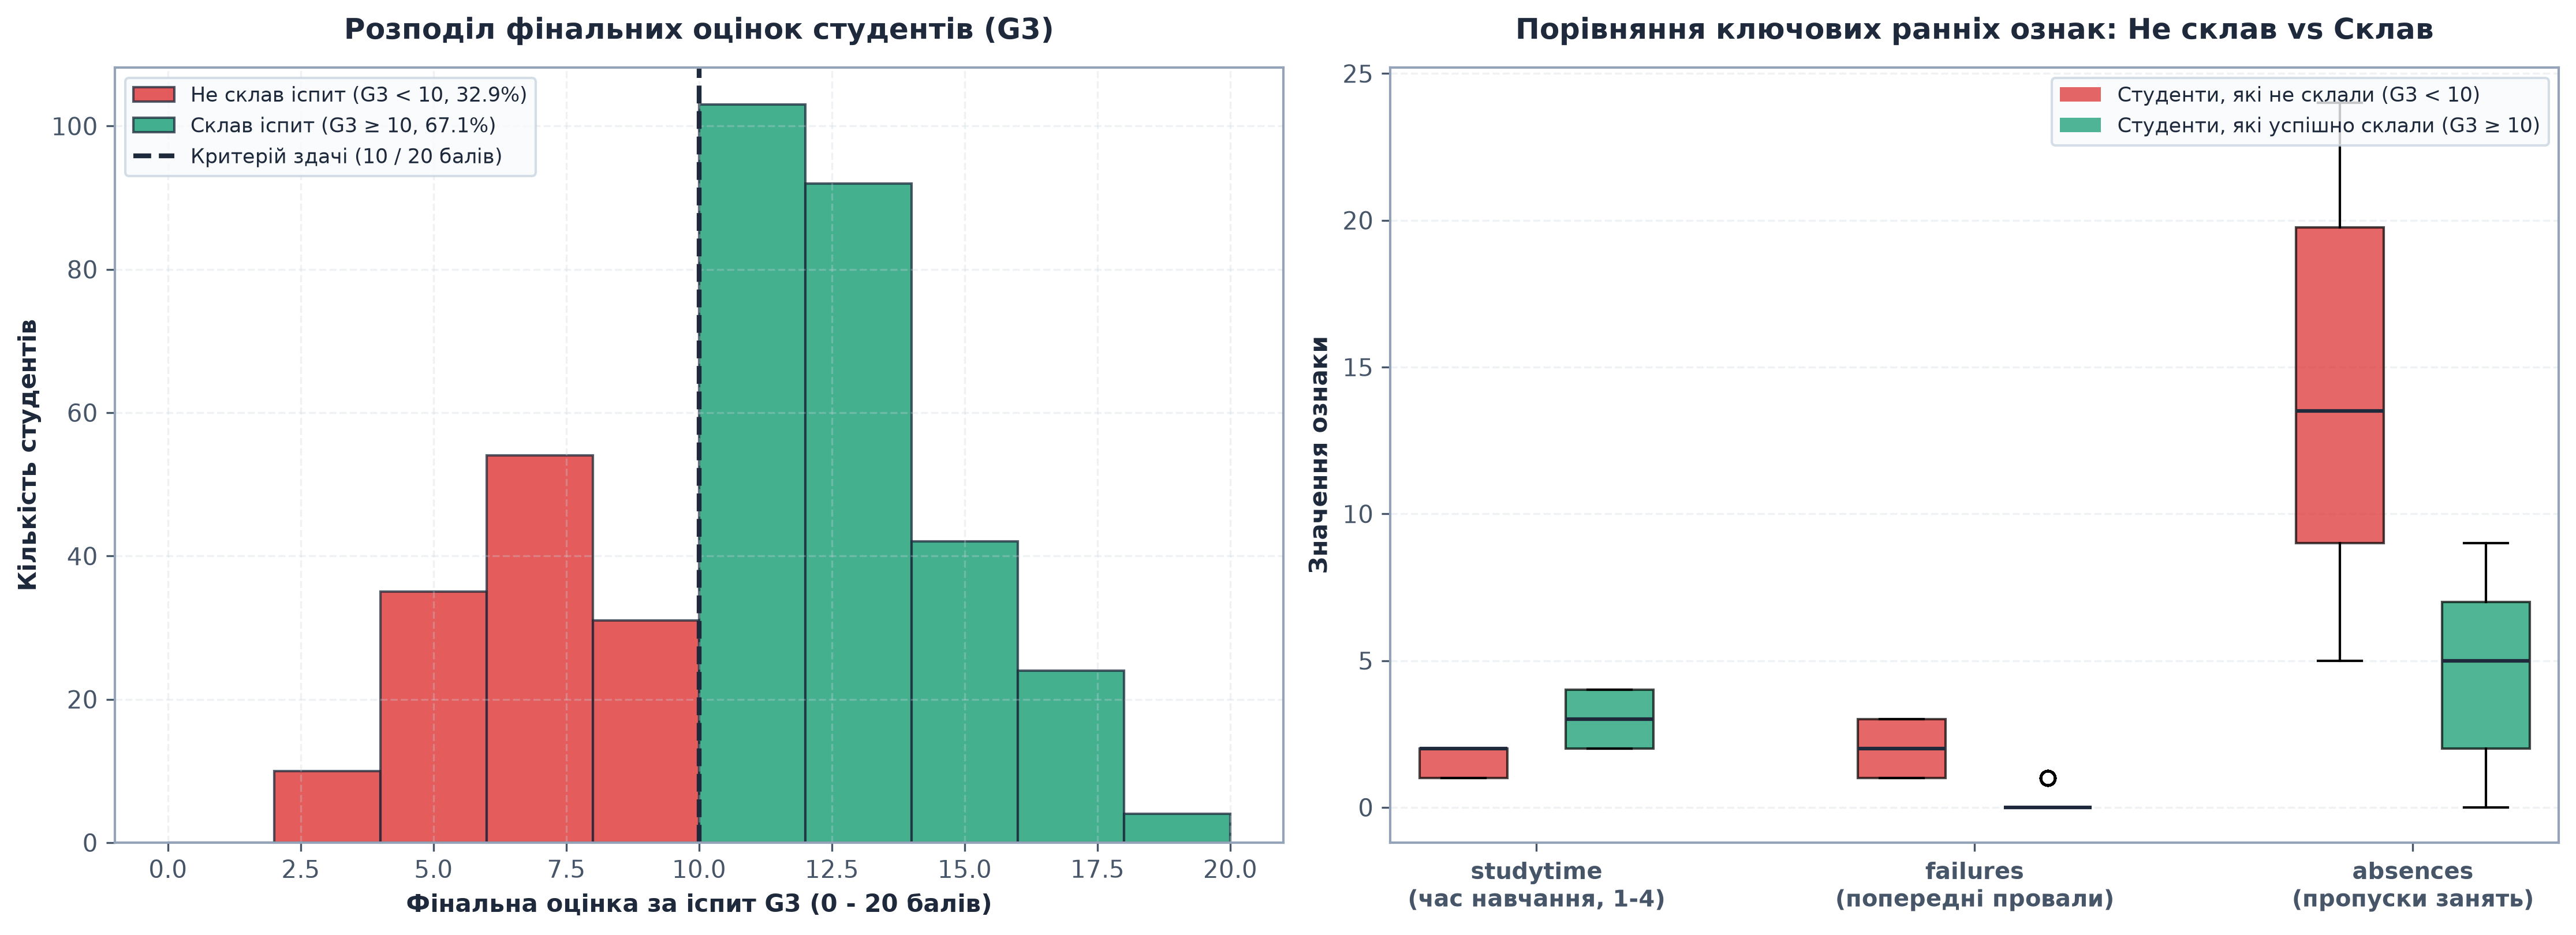
- Попередні оцінки — найсильніші предиктори: Кореляція G2 ↔ G3 = 0.905 означає, що оцінка за 2-й семестр майже повністю визначає фінальну оцінку.
- Проблема data leakage: Якщо включити G1 та G2 у модель, вона досягне AUC > 0.95, але це неправильно — ми хочемо передбачити успішність на початку року, щоб встигнути втрутитися.
- Найважливіші ранні ознаки (без G1/G2):
failures(кількість провалених предметів) — студенти з failures > 0 провалюють у 60% випадківstudytime— хто навчається <2 год/тиждень, провалює у 55%absences— хто пропустив >15 занять, провалює у 48%
Повна імплементація моделі
Крок 1: Попередня обробка даних
from sklearn.preprocessing import StandardScaler, LabelEncoder

# Видалення G1, G2, G3 (залишаємо лише 'pass')
features_to_drop = ['G1', 'G2', 'G3']
df_features = df.drop(features_to_drop + ['pass'], axis=1).copy()
df_target = df['pass'].copy()

print("=" * 80)
print("ПОПЕРЕДНЯ ОБРОБКА КАТЕГОРІАЛЬНИХ ЗМІННИХ")
print("=" * 80)

# Обробка категоріальних змінних
categorical_cols = df_features.select_dtypes(include=['object']).columns.tolist()
print(f"\nКатегоріальні стовпці ({len(categorical_cols)}):")
for col in categorical_cols:
    unique_vals = df_features[col].nunique()
    print(f"  {col:15} → {unique_vals} унікальних значень: {df_features[col].unique()[:5].tolist()}")

# Стратегія:
# - Бінарні змінні (2 значення) → Label Encoding
# - Багатокласові (>2 значень) → One-Hot Encoding

binary_cols = [col for col in categorical_cols if df_features[col].nunique() == 2]
multiclass_cols = [col for col in categorical_cols if df_features[col].nunique() > 2]

print(f"\nБінарні стовпці (Label Encoding): {binary_cols}")
print(f"Багатокласові стовпці (One-Hot Encoding): {multiclass_cols}")

# Label Encoding
for col in binary_cols:
    le = LabelEncoder()
    df_features[col] = le.fit_transform(df_features[col])
    print(f"  {col}: {le.classes_} → {le.transform(le.classes_)}")

# One-Hot Encoding
df_features = pd.get_dummies(df_features, columns=multiclass_cols, drop_first=True)

print(f"\nРозмір після кодування: {df_features.shape[1]} ознак")
print(f"Приклад нових стовпців: {df_features.columns[-5:].tolist()}")
| Категоріальна ознака | Унікальні значення | Тип кодування | Клінічно-соціальний зміст |
|---|---|---|---|
school | ['GP', 'MS'] | Binary (0/1) | Назва школи |
sex | ['F', 'M'] | Binary (0/1) | Стать студента |
address | ['U', 'R'] | Binary (0/1) | Місце проживання (Urban / Rural) |
famsize | ['GT3', 'LE3'] | Binary (0/1) | Розмір сім'ї ($\le 3$ або $> 3$) |
Pstatus | ['A', 'T'] | Binary (0/1) | Спільне чи роздільне проживання батьків |
Mjob, Fjob | ['teacher', 'health', 'services', 'at_home', 'other'] | One-Hot (5) | Професія матері та батька |
reason | ['home', 'reputation', 'course', 'other'] | One-Hot (4) | Причина вибору навчального закладу |
guardian | ['mother', 'father', 'other'] | One-Hot (3) | Опікун студента |
schoolsup, famsup, paid, activities, nursery, higher, internet, romantic | ['yes', 'no'] | Binary (0/1) | Додаткові заняття, підтримка, інтернет, відносини |
Це початок розширеного прикладу. Документ можна доповнити:
- Детальним аналізом важливості ознак
- Експериментами з різними архітектурами (порівняння 47→64→1 vs 47→128→64→1)
- Кросвалідацією (5-fold CV)
- Калібруванням порогу для мінімізації пропущених студентів
- Реальними кейсами інтеграції у шкільні системи
Чи потрібно розширити цей файл далі, чи достатньо як бонусний матеріал?
Функції активації та побудова нейронної мережі для передбачення вад серця
Поглиблене вивчення функцій активації, їхніх похідних та практичне застосування для медичної діагностики. Побудова повноцінної нейронної мережі на PyTorch для передбачення серцево-судинних захворювань.
Основи згорткових нейронних мереж — чому не MLP?
Проблеми повнозв'язних мереж для зображень, концепція локальної зв'язності та розділення ваг. Операція згортки, Feature Maps, Pooling шари та повна архітектура CNN.