Функції активації та побудова нейронної мережі для передбачення вад серця
Від теорії до практики — нейромережа як інструмент діагностики
У попередніх статтях ми розібрали базову архітектуру нейронних мереж, функції активації та процес навчання. Настав час застосувати ці знання для розв'язання реальної медичної задачі: передбачення ризику серцево-судинних захворювань на основі клінічних показників пацієнта.
Уявіть, що ви — дата-саєнтист у медичній клініці. Щодня надходять сотні аналізів пацієнтів: вік, рівень холестерину, артеріальний тиск, електрокардіограма. Кардіолог не встигає своєчасно проаналізувати всі дані. Ваше завдання — створити систему раннього попередження, яка автоматично виявляє пацієнтів із високим ризиком та рекомендує їх на додаткове обстеження.
Це не просто академічна вправа. За даними Всесвітньої організації охорони здоров'я, серцево-судинні захворювання є причиною 31% усіх смертей у світі. Рання діагностика може врятувати життя. І саме нейронні мережі дозволяють знаходити приховані закономірності в медичних даних, які неможливо виявити «на око».
У цій статті ми:
- Детально розберемо математику функцій активації та їхніх похідних (необхідно для backpropagation)
- Завантажимо та проаналізуємо реальний медичний датасет UCI Heart Disease
- Побудуємо повноцінну нейронну мережу на PyTorch
- Навчимо модель, візуалізуємо процес навчання
- Оцінимо якість та інтерпретуємо результати
🎯 Мета статті
- Опанувати математику функцій активації та їхніх похідних для алгоритму зворотного поширення
- Навчитися працювати з реальними медичними даними та їх попередньою обробкою
- Побудувати архітектуру нейронної мережі для бінарної класифікації на PyTorch
- Імплементувати цикл навчання з моніторингом метрик та ранньою зупинкою
- Інтерпретувати результати моделі та оцінювати її клінічну корисність
🔑 Ключові терміни
- Похідна функції активації (Activation Derivative): градієнт функції, необхідний для backpropagation
- Датасет UCI Heart Disease: класичний бенчмарк із 14 клінічних ознак
- Binary Cross-Entropy Loss: функція втрат для бінарної класифікації
- Early Stopping: техніка запобігання перенавчанню через зупинку при погіршенні валідаційної метрики
- ROC-AUC: метрика якості класифікатора, інваріантна до порогу прийняття рішення
Математика функцій активації — чому похідна критична
Ми вже знаємо, що функції активації вносять нелінійність у нейронну мережу. Але для навчання мережі через градієнтний спуск нам потрібні похідні цих функцій. Саме похідні дозволяють обчислити, в якому напрямку та наскільки змінювати ваги, щоб зменшити помилку.
Нагадування: ланцюгове правило диференціювання
Алгоритм зворотного поширення (backpropagation) базується на ланцюговому правилі з математичного аналізу. Якщо маємо композицію функцій:
То похідна за Завантаження...:
У нейронній мережі градієнт втрат по вазі Завантаження... обчислюється через ланцюг похідних від вихідного шару до вхідного. На кожному кроці ми множимо на похідну функції активації поточного нейрона.
Сигмоїда (Sigmoid) — похідна та проблеми
Формула:
Похідна:
Скористаємося правилом диференціювання частки та ланцюговим правилом:
Можна показати, що це рівносильно елегантній формі:
Докази:
Властивості похідної:
import numpy as np
import matplotlib.pyplot as plt

def sigmoid(z):
    return 1 / (1 + np.exp(-z))

def sigmoid_derivative(z):
    s = sigmoid(z)
    return s * (1 - s)

# Діапазон значень
z = np.linspace(-10, 10, 500)

# Візуалізація
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(16, 6))

# Сигмоїда
ax1.plot(z, sigmoid(z), color='#3b82f6', linewidth=3, label='σ(z)')
ax1.axhline(0, color='gray', linestyle='--', alpha=0.3)
ax1.axhline(1, color='gray', linestyle='--', alpha=0.3)
ax1.axvline(0, color='gray', linestyle='--', alpha=0.3)
ax1.grid(alpha=0.3)
ax1.set_xlabel('z', fontsize=14)
ax1.set_ylabel('σ(z)', fontsize=14)
ax1.set_title('Функція Sigmoid', fontsize=16, fontweight='bold')
ax1.legend(fontsize=12)

# Похідна сигмоїди
ax2.plot(z, sigmoid_derivative(z), color='#ef4444', linewidth=3, label="σ'(z) = σ(z)·(1 - σ(z))")
ax2.axhline(0, color='gray', linestyle='--', alpha=0.3)
ax2.axvline(0, color='gray', linestyle='--', alpha=0.3)
ax2.fill_between(z, 0, sigmoid_derivative(z), alpha=0.2, color='#ef4444')

# Позначимо максимум похідної
max_val = sigmoid_derivative(0)
ax2.plot(0, max_val, 'o', color='#dc2626', markersize=12, label=f'Максимум: σ\'(0) = {max_val:.3f}')
ax2.annotate(f'Макс = {max_val:.3f}\nпри z=0', xy=(0, max_val), xytext=(2, max_val),
             arrowprops=dict(arrowstyle='->', color='#dc2626', lw=2),
             fontsize=12, color='#dc2626', fontweight='bold')

# Критичні зони
ax2.axvspan(-10, -5, alpha=0.15, color='yellow', label='Зони зникаючого градієнта')
ax2.axvspan(5, 10, alpha=0.15, color='yellow')
ax2.text(-7.5, 0.15, 'σ\'(z) ≈ 0', fontsize=11, ha='center', style='italic')
ax2.text(7.5, 0.15, 'σ\'(z) ≈ 0', fontsize=11, ha='center', style='italic')

ax2.grid(alpha=0.3)
ax2.set_xlabel('z', fontsize=14)
ax2.set_ylabel("σ'(z)", fontsize=14)
ax2.set_title('Похідна Sigmoid', fontsize=16, fontweight='bold')
ax2.legend(fontsize=11, loc='upper right')

plt.tight_layout()
plt.show()
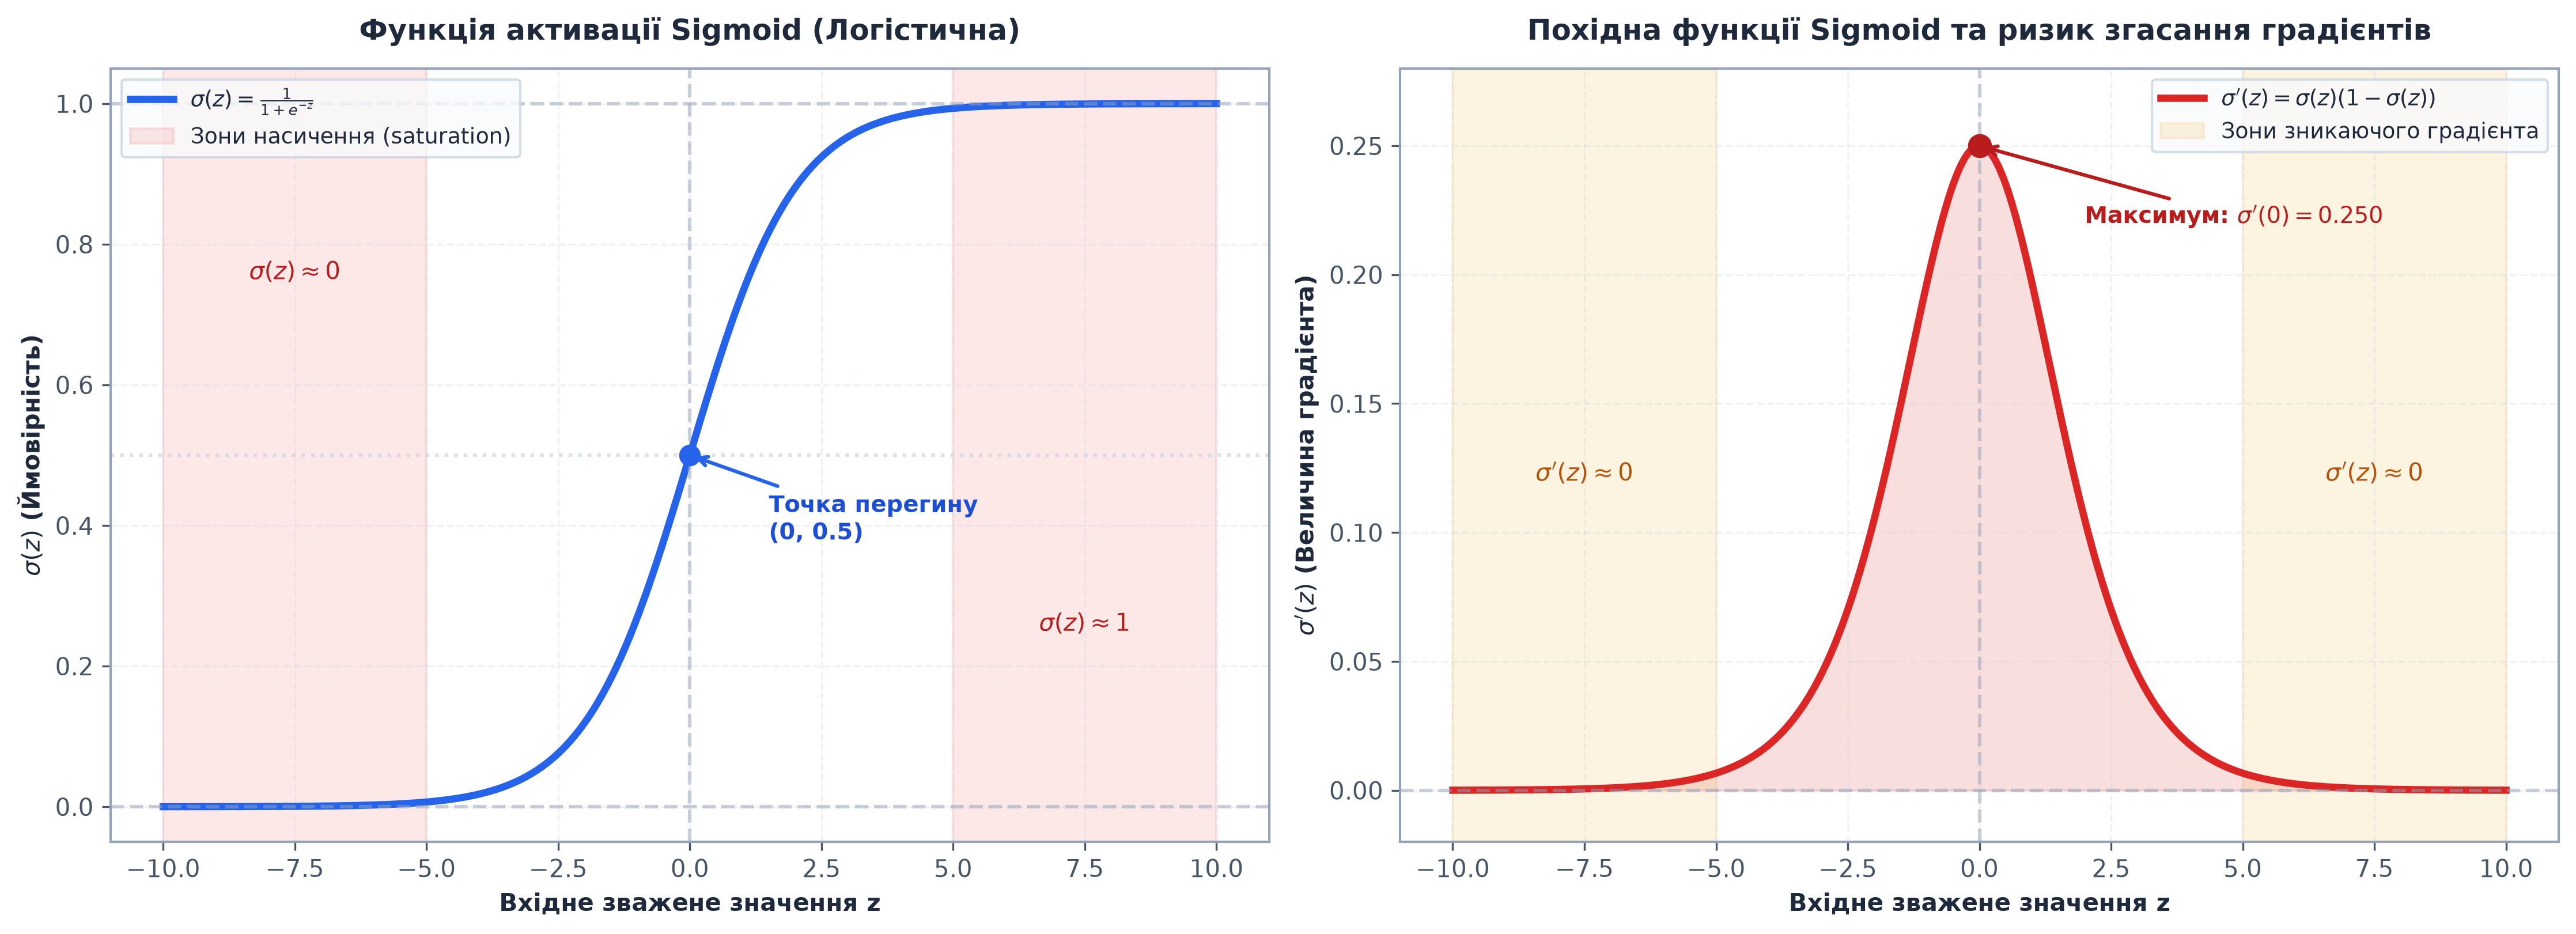
Критична проблема:
Максимальне значення похідної Завантаження.... Це означає, що навіть у найкращому випадку градієнт зменшується вчетверо при проходженні через один шар.
Для мережі з 10 шарами:
Градієнт фактично зникає — перші шари не навчаються!
Гіперболічний тангенс (Tanh) — центрована альтернатива
Формула:
Зв'язок із сигмоїдою:
Похідна:
Доведення:
Підставляючи Завантаження..., отримуємо:
Властивості:
- Діапазон виходу: Завантаження... — центрований навколо нуля
- Максимум похідної: Завантаження... — вчетверо більше, ніж у сигмоїди!
- Все одно страждає від зникаючих градієнтів для Завантаження...
ReLU (Rectified Linear Unit) — революційна простота
Формула:
Похідна:
На практиці в точці Завантаження... приймають похідну рівною 0 або 1 (не має значення, бо ймовірність потрапити точно в нуль — нульова).
Чому ReLU вирішує проблему зникаючих градієнтів:
import numpy as np
import matplotlib.pyplot as plt

def relu(z):
    return np.maximum(0, z)

def relu_derivative(z):
    return np.where(z > 0, 1, 0)

z = np.linspace(-5, 5, 500)

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(16, 6))

# ReLU функція
ax1.plot(z, relu(z), color='#10b981', linewidth=3, label='ReLU(z)')
ax1.axhline(0, color='gray', linestyle='--', alpha=0.3)
ax1.axvline(0, color='gray', linestyle='--', alpha=0.3)
ax1.grid(alpha=0.3)
ax1.set_xlabel('z', fontsize=14)
ax1.set_ylabel('ReLU(z)', fontsize=14)
ax1.set_title('Функція ReLU', fontsize=16, fontweight='bold')
ax1.legend(fontsize=12)
ax1.fill_between(z[z > 0], 0, relu(z)[z > 0], alpha=0.2, color='#10b981')
ax1.text(2, 1, 'Активна зона\n(градієнт = 1)', fontsize=12, color='#059669', fontweight='bold')
ax1.text(-3, 1, 'Мертва зона\n(градієнт = 0)', fontsize=12, color='#6b7280', fontweight='bold')

# ReLU похідна
ax2.plot(z, relu_derivative(z), color='#f59e0b', linewidth=3, drawstyle='steps-post', label="ReLU'(z)")
ax2.axhline(0, color='gray', linestyle='--', alpha=0.3)
ax2.axhline(1, color='#10b981', linestyle='--', alpha=0.3, linewidth=2)
ax2.axvline(0, color='gray', linestyle='--', alpha=0.3)
ax2.grid(alpha=0.3)
ax2.set_xlabel('z', fontsize=14)
ax2.set_ylabel("ReLU'(z)", fontsize=14)
ax2.set_title('Похідна ReLU', fontsize=16, fontweight='bold')
ax2.legend(fontsize=12)
ax2.set_ylim(-0.2, 1.3)

# Позначення константного градієнта
ax2.annotate('Градієнт = 1 (константа!)\nНемає зникання',
             xy=(3, 1), xytext=(2, 1.15),
             arrowprops=dict(arrowstyle='->', color='#10b981', lw=2),
             fontsize=12, color='#059669', fontweight='bold',
             bbox=dict(boxstyle='round,pad=0.5', facecolor='#d1fae5', edgecolor='#10b981'))

plt.tight_layout()
plt.show()
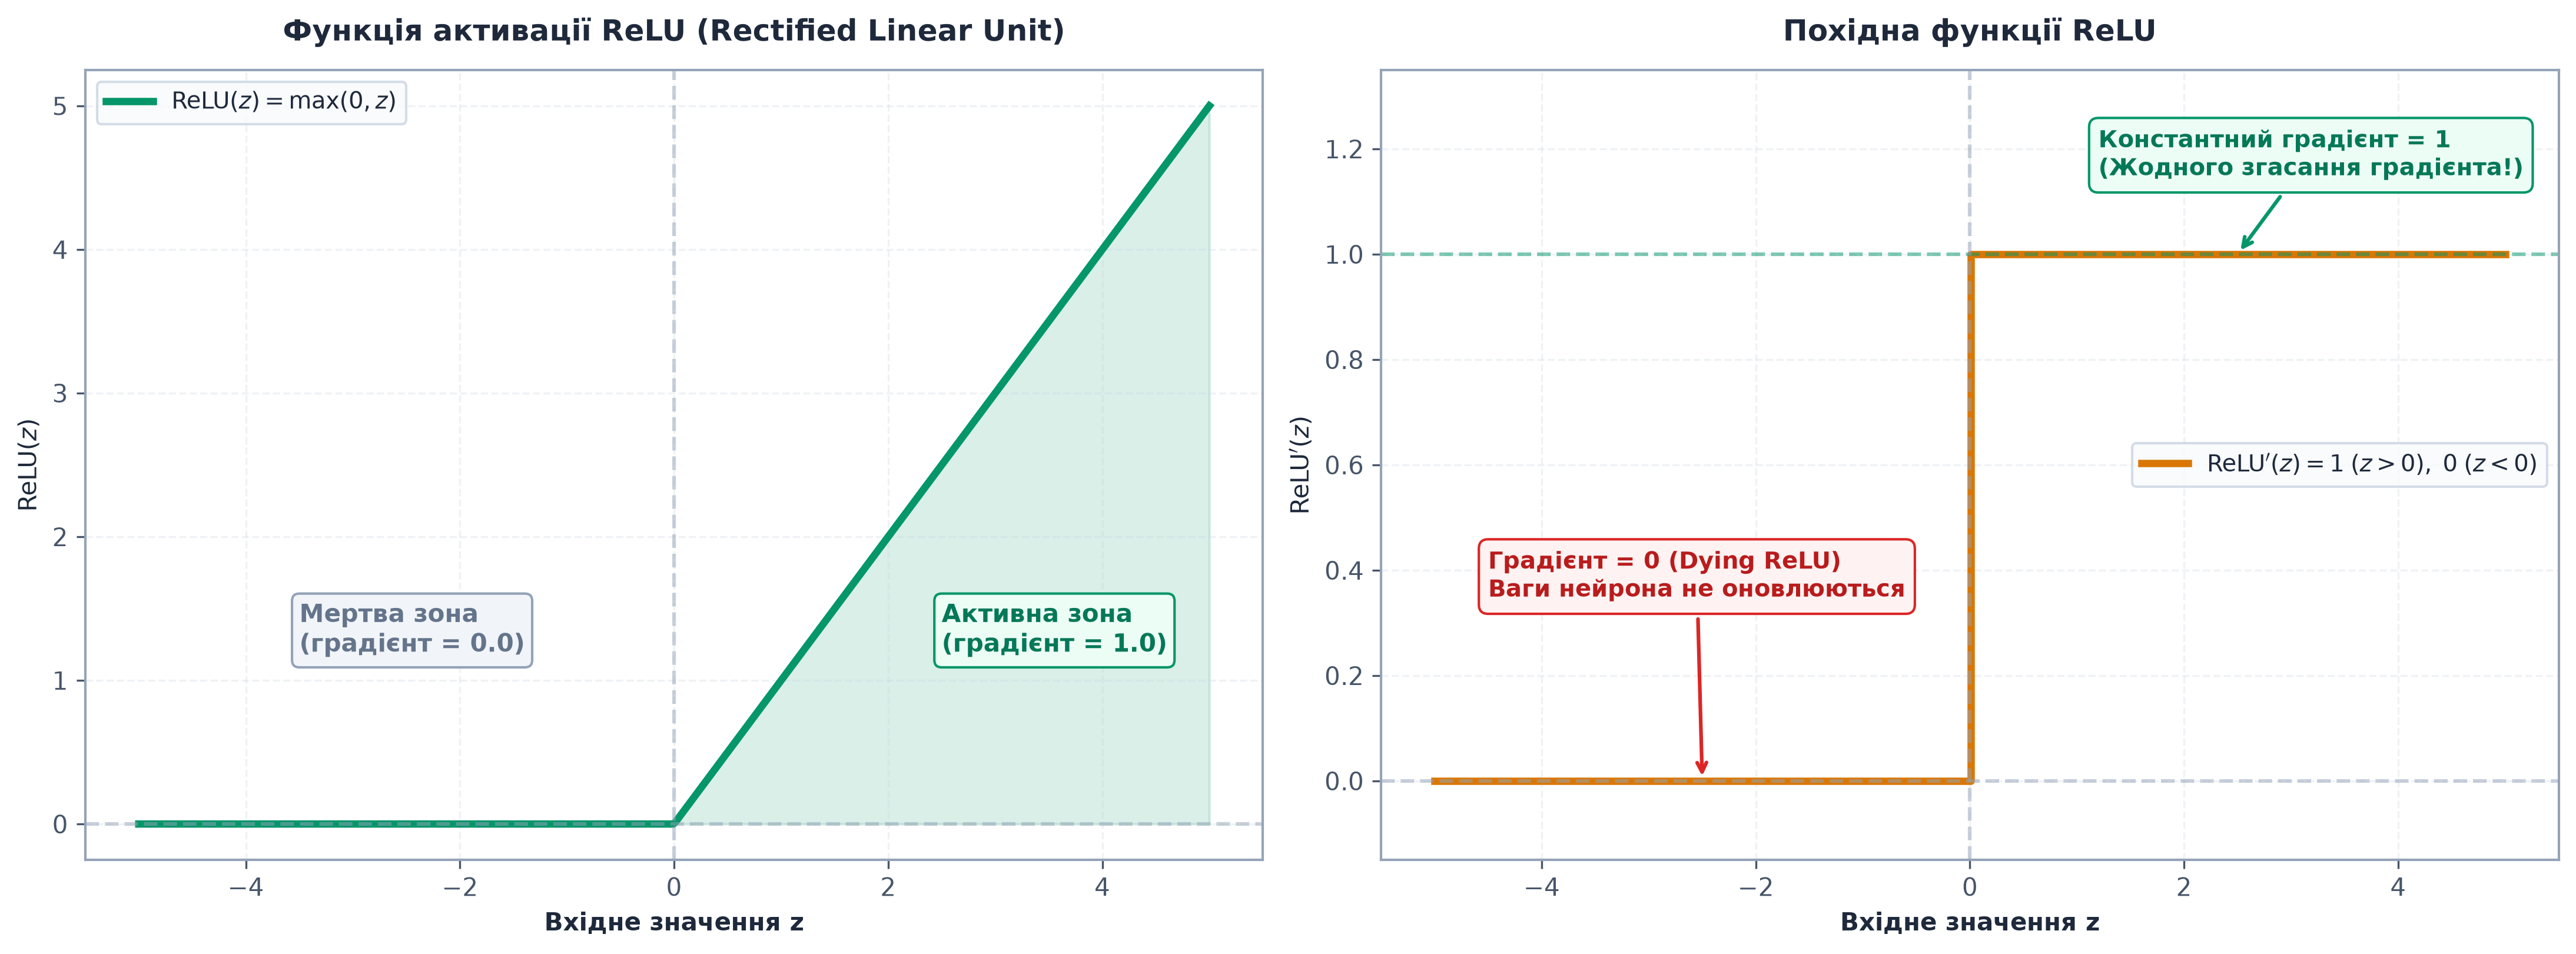
Ключові переваги ReLU:
✅ Градієнт = 1 для активних нейронів
✅ Обчислювальна ефективність
max(0, z). Швидше у 6–10 разів за сигмоїду/tanh.✅ Розріджена активація
Проблема: "мертві нейрони" (Dying ReLU):
Якщо нейрон постійно отримує від'ємні входи, то:
- Вихід завжди 0
- Градієнт завжди 0
- Ваги не оновлюються
- Нейрон назавжди "вмирає"
Це відбувається при:
- Занадто високому learning rate (ваги «перестрибують» у від'ємну зону)
- Поганій ініціалізації ваг
- Дуже великих від'ємних bias
- Правильна ініціалізація ваг: використовуйте He initialization (розроблено спеціально для ReLU):Завантаження...
де Завантаження... — кількість вхідних нейронів. - Помірний learning rate: для Adam рекомендовано 0.001–0.01.
- Leaky ReLU або ELU: варіанти ReLU, які не обнулюють градієнт для від'ємних значень.
Leaky ReLU — вирішення проблеми мертвих нейронів
Формула:
Або еквівалентно:
Похідна:
Ключова відмінність: для від'ємних значень градієнт не нульовий, а дорівнює Завантаження... (зазвичай 0.01). Це дозволяє нейрону продовжувати навчатися, навіть якщо він тимчасово потрапив у від'ємну зону.
import numpy as np
import matplotlib.pyplot as plt

def relu(z):
    return np.maximum(0, z)

def leaky_relu(z, alpha=0.01):
    return np.where(z > 0, z, alpha * z)

z = np.linspace(-5, 5, 500)

plt.figure(figsize=(12, 7))
plt.plot(z, relu(z), color='#10b981', linewidth=3, label='ReLU', linestyle='--', alpha=0.7)
plt.plot(z, leaky_relu(z), color='#f59e0b', linewidth=3, label='Leaky ReLU (α=0.01)')

plt.axhline(0, color='gray', linestyle='--', alpha=0.3)
plt.axvline(0, color='gray', linestyle='--', alpha=0.3)
plt.grid(alpha=0.3)

# Позначення відмінностей
plt.fill_between(z[z < 0], 0, leaky_relu(z)[z < 0], alpha=0.3, color='#f59e0b',
                 label='Зона відновлення (α·z)')
plt.annotate('ReLU: градієнт = 0\n(нейрон "вмирає")',
             xy=(-3, 0), xytext=(-4, 1.5),
             arrowprops=dict(arrowstyle='->', color='#6b7280', lw=2),
             fontsize=11, color='#6b7280', fontweight='bold')
plt.annotate('Leaky ReLU: градієнт = 0.01\n(нейрон продовжує навчатися)',
             xy=(-3, -0.03), xytext=(-4, -2),
             arrowprops=dict(arrowstyle='->', color='#f59e0b', lw=2),
             fontsize=11, color='#d97706', fontweight='bold',
             bbox=dict(boxstyle='round,pad=0.5', facecolor='#fef3c7', edgecolor='#f59e0b'))

plt.xlabel('z', fontsize=14)
plt.ylabel('Активація', fontsize=14)
plt.title('Порівняння ReLU та Leaky ReLU', fontsize=16, fontweight='bold')
plt.legend(fontsize=12, loc='upper left')
plt.ylim(-0.3, 5)
plt.tight_layout()
plt.show()
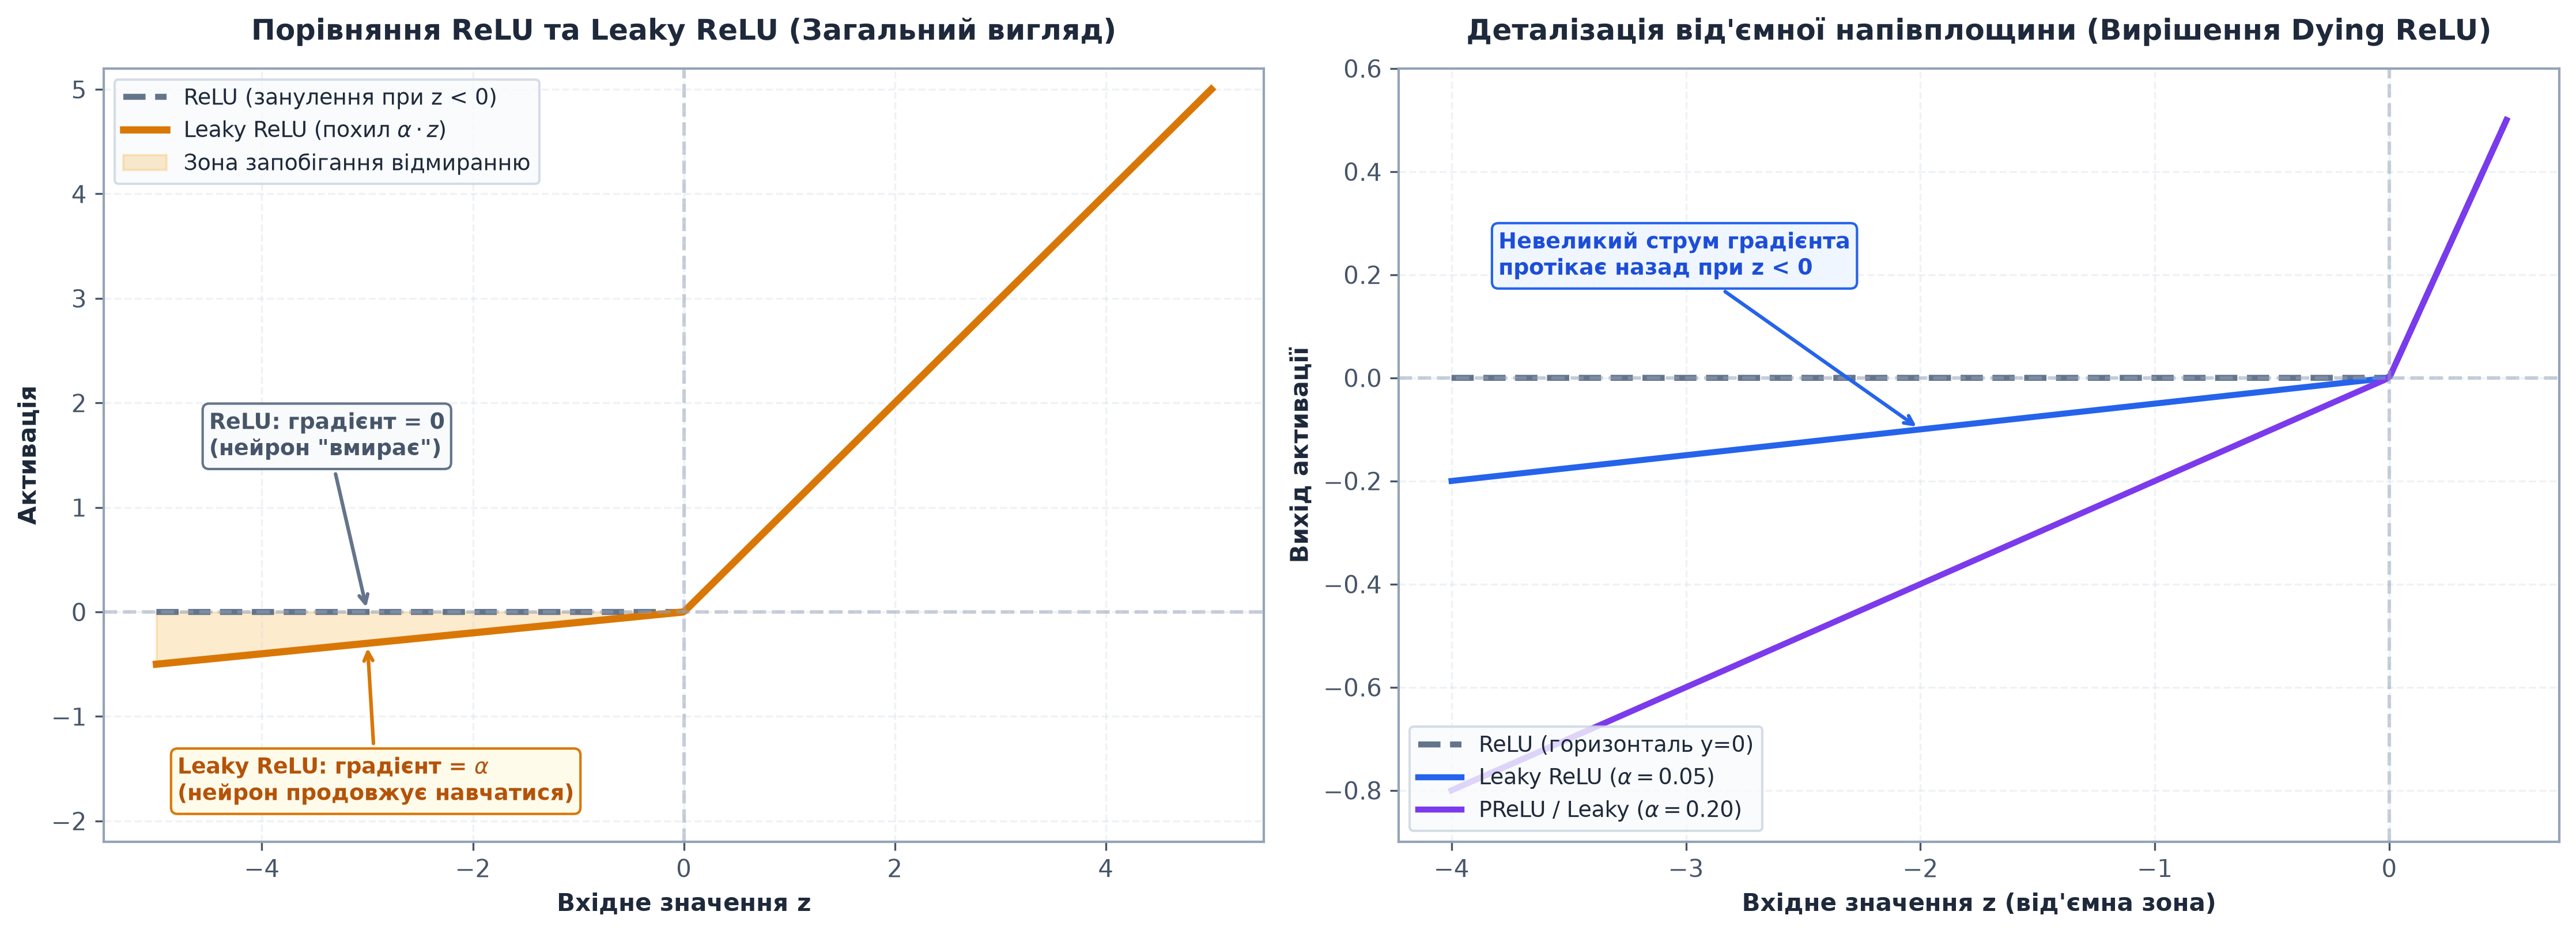
- Стагнацію loss після кількох епох
- Велику кількість нейронів із нульовою активацією (можна перевірити через
.weight.grad) - Втрату якості при збільшенні кількості шарів
Порівняльна таблиця функцій активації та їхніх похідних
| Функція | Формула | Похідна | Максимум похідної | Зникаючі градієнти | Мертві нейрони | Рекомендація |
|---|---|---|---|---|---|---|
| Sigmoid | Завантаження... | Завантаження... | 0.25 | ✅ Так | ❌ Ні | Лише вихідний шар (бінарна) |
| Tanh | Завантаження... | Завантаження... | 1.0 | ✅ Так | ❌ Ні | RNN, неглибокі мережі |
| ReLU | Завантаження... | Завантаження... | 1.0 | ❌ Ні | ✅ Так | За замовчуванням (приховані) |
| Leaky ReLU | Завантаження... | Завантаження... | 1.0 | ❌ Ні | ❌ Ні | Альтернатива ReLU |
- Приховані шари: ReLU (стандарт для глибоких мереж)
- Вихідний шар: Sigmoid (бінарна класифікація: хвороба є/немає)
- Якщо виникають проблеми з ReLU: спробувати Leaky ReLU з α=0.01
Вибір датасету для практики — огляд можливостей
Тепер, коли ми розуміємо математику функцій активації, перейдемо до практики. Для навчання нейронних мереж бінарної класифікації існує безліч датасетів із різних галузей. Розглянемо найпопулярніші варіанти, перш ніж зануритися у наш основний приклад.
Популярні датасети для бінарної класифікації
🏥 Медицина та охорона здоров'я
UCI Heart Disease (наш вибір)
- 303 пацієнти, 13 клінічних ознак
- Передбачення серцево-судинних захворювань
- Збалансований датасет (54% / 46%)
Diabetes Dataset (Pima Indians)
- 768 жінок, 8 ознак (вік, BMI, глюкоза, інсулін)
- Передбачення діабету 2-го типу
- Є у sklearn:
load_diabetes()
Breast Cancer Wisconsin
- 569 пацієнтів, 30 ознак (радіус, текстура, периметр клітин)
- Діагностика раку грудей (доброякісна/злоякісна пухлина)
- Висока точність досяжна (97-98%)
💰 Фінанси та бізнес
Credit Card Fraud Detection
- 284,807 транзакцій, 30 анонімізованих ознак
- Виявлення шахрайських операцій
- Екстремальний дисбаланс (0.17% fraud)
Bank Customer Churn
- 10,000 клієнтів, 14 ознак (баланс, кредитний рейтинг, кількість продуктів)
- Передбачення відтоку клієнтів банку
- Практика роботи з категоріальними змінними
Employee Attrition (HR Analytics)
- 1,470 працівників, 35 ознак (зарплата, задоволеність, переробки)
- Передбачення звільнення співробітників
- HR-кейс із високою бізнес-цінністю
🎓 Освіта та соціальні науки
Student Performance Prediction
- 649 студентів, 30+ ознак (відвідуваність, попередні оцінки, освіта батьків)
- Передбачення успішності на іспиті (склав/не склав)
- Близька тема для студентів (додатковий приклад у цій статті ↓)
Titanic Survival
- 891 пасажир, 11 ознак (клас каюти, стать, вік, ціна квитка)
- Класичний Kaggle competition
- Історична тема, практика роботи з пропусками
🌍 Екологія та промисловість
Water Quality Prediction
- 3,276 зразків, 9 хімічних показників (pH, твердість, сульфати)
- Визначення придатності води для пиття
- Актуальна екологічна тема
Predictive Maintenance (NASA Turbofan)
- Сенсорні дані з 21 датчика авіаційних двигунів
- Передбачення відмови двигуна
- Критична задача для безпеки польотів
- Клінічна значущість: Серцево-судинні захворювання — причина 31% смертей у світі. Рання діагностика рятує життя.
- Оптимальний розмір: 303 зразки — достатньо для навчання MLP, але не надто багато для навчальної демонстрації.
- Збалансованість класів: 54% здорових vs 46% хворих — не потрібні техніки oversampling/SMOTE.
- Інтерпретовані ознаки: Всі 13 ознак мають чітке медичне значення (не анонімізовані, як у fraud detection).
- Високий потенціал точності: AUC 0.90+ досяжна, що дає студентам "success story".
Датасет UCI Heart Disease — клінічні дані для діагностики
Завантажимо та проаналізуємо UCI Heart Disease Dataset — один із найвідоміших медичних датасетів у машинному навчанні.
Опис датасету та клінічний контекст
Джерело: UCI Machine Learning Repository (посилання)
Історія: Датасет зібрано у 1988 році в чотирьох медичних закладах:
- Cleveland Clinic Foundation (Огайо, США)
- Hungarian Institute of Cardiology (Будапешт, Угорщина)
- V.A. Medical Center (Лонг-Біч, Каліфорнія)
- University Hospital (Цюрих, Швейцарія)
Обсяг: 303 пацієнти, 14 клінічних ознак.
Цільова змінна: наявність серцево-судинного захворювання (0 = немає, 1–4 = різні ступені). У нашій задачі спростимо до бінарної класифікації: 0 = здоровий, 1 = хворий (будь-який ступінь).
Опис 14 клінічних ознак
Крок 1: Демографічні та базові показники
- age (вік) — вік пацієнта у роках (діапазон: 29–77)
- Фізіологічне значення: з віком зростає ризик атеросклерозу та ослаблення серцевого м'яза
- sex (стать) — 1 = чоловік, 0 = жінка
- Клінічний факт: у чоловіків ризик інфаркту вищий у молодому віці; у жінок — після менопаузи
- cp (chest pain type) — тип болю в грудях:
- 0: Типова стенокардія (typical angina) — біль при фізичному навантаженні
- 1: Атипова стенокардія (atypical angina)
- 2: Біль, не пов'язаний із серцем (non-anginal pain)
- 3: Безсимптомний (asymptomatic)
Крок 2: Показники серцево-судинної системи
- trestbps (resting blood pressure) — артеріальний тиск у стані спокою, мм рт. ст.
- Норма: ~120 мм рт. ст.
- Гіпертензія (>140) — фактор ризику інфаркту та інсульту
- chol (serum cholesterol) — рівень холестерину в крові, мг/дл
- Норма: <200 мг/дл
- Високий холестерин (>240) — накопичення атеросклеротичних бляшок у судинах
- fbs (fasting blood sugar > 120 mg/dl) — підвищений цукор крові натще
- 1 = так (>120 мг/дл), 0 = ні
- Діабет — сильний предиктор серцево-судинних захворювань
Крок 3: Електрокардіограма (ЕКГ)
- restecg (resting electrocardiographic results) — результати ЕКГ у стані спокою:
- 0: Норма
- 1: Аномалія ST-T хвилі (можлива ішемія)
- 2: Гіпертрофія лівого шлуночка (ознака хронічного перевантаження серця)
- thalach (maximum heart rate achieved) — максимальна частота серцевих скорочень при навантаженні
- Норма: 220 - вік
- Низьке значення може вказувати на слабкість серцевого м'яза
Крок 4: Стрес-тест та ангіографія
- exang (exercise induced angina) — стенокардія, спричинена фізичним навантаженням
- 1 = так, 0 = ні
- Сильний маркер ішемічної хвороби серця
- oldpeak — депресія сегмента ST на ЕКГ, спричинена фізичним навантаженням (відносно спокою)
- Вимірюється в мм
- Значення >2 мм — ознака серйозної ішемії
- slope — нахил піку сегмента ST при навантаженні:
- 0: Підйом (upsloping) — норма
- 1: Рівний (flat) — можлива ішемія
- 2: Спуск (downsloping) — висока ймовірність ішемії
- ca (number of major vessels colored by fluoroscopy) — кількість великих судин, виявлених при флюороскопії (0–3)
- Більше судин із звуженням → вищий ризик
- thal (thalassemia) — результат таласемії (вроджене захворювання крові):
- 1: Норма
- 2: Фіксований дефект
- 3: Зворотний дефект
- cp (тип болю в грудях) — пряма ознака стенокардії
- thalach (максимальна ЧСС) — показник функціональної резервності серця
- oldpeak та slope — об'єктивні показники ішемії при навантаженні
- ca (кількість уражених судин) — анатомічний маркер атеросклерозу
Завантаження та первинний аналіз датасету
Завантажимо датасет із репозиторію UCI та проведемо exploratory data analysis (EDA).
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

# Налаштування візуалізації
sns.set_style("whitegrid")
plt.rcParams['figure.figsize'] = (14, 6)
plt.rcParams['font.size'] = 12

# Назви стовпців (не вказані у файлі даних)
column_names = [
    'age', 'sex', 'cp', 'trestbps', 'chol', 'fbs',
    'restecg', 'thalach', 'exang', 'oldpeak', 'slope',
    'ca', 'thal', 'target'
]

# Завантаження даних
url = 'https://archive.ics.uci.edu/ml/machine-learning-databases/heart-disease/processed.cleveland.data'
df = pd.read_csv(url, names=column_names, na_values='?')

print("=" * 70)
print("ДАТАСЕТ UCI HEART DISEASE — ОГЛЯД")
print("=" * 70)
print(f"\nРозмір датасету: {df.shape[0]} пацієнтів × {df.shape[1]} ознак")
print(f"\nПерші 5 записів:")
print(df.head())
| age | sex | cp | trestbps | chol | fbs | restecg | thalach | exang | oldpeak | slope | ca | thal | target |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 63 | 1 | 1 | 145 | 233 | 1 | 2 | 150 | 0 | 2.3 | 3 | 0 | 6 | 0 |
| 67 | 1 | 4 | 160 | 286 | 0 | 2 | 108 | 1 | 1.5 | 2 | 3 | 3 | 2 |
| 67 | 1 | 4 | 120 | 229 | 0 | 2 | 129 | 1 | 2.6 | 2 | 2 | 7 | 1 |
| 37 | 1 | 3 | 130 | 250 | 0 | 0 | 187 | 0 | 3.5 | 3 | 0 | 3 | 0 |
| 41 | 0 | 2 | 130 | 204 | 0 | 2 | 172 | 0 | 1.4 | 1 | 0 | 3 | 0 |
# Інформація про типи даних та пропуски
print("\n" + "=" * 70)
print("ІНФОРМАЦІЯ ПРО СТОВПЦІ ТА ПРОПУЩЕНІ ЗНАЧЕННЯ")
print("=" * 70)
print(df.info())

print("\n" + "=" * 70)
print("ПРОПУЩЕНІ ЗНАЧЕННЯ ПО СТОВПЦЯХ")
print("=" * 70)
missing = df.isnull().sum()
missing_pct = (missing / len(df)) * 100
missing_df = pd.DataFrame({
    'Стовпець': missing.index,
    'Кількість пропусків': missing.values,
    'Відсоток': missing_pct.values
}).query('`Кількість пропусків` > 0')

if len(missing_df) > 0:
    print(missing_df.to_string(index=False))
else:
    print("✅ Пропущених значень немає!")
| Ознака датасету | Тип даних (Dtype) | Пропущені значення | Відсоток пропусків | Клінічний зміст |
|---|---|---|---|---|
age (вік) | float64 | 0 | 0.0% | Вік пацієнта в роках |
sex (стать) | float64 | 0 | 0.0% | 1 = чоловік, 0 = жінка |
cp (тип болю в грудях) | float64 | 0 | 0.0% | Категорії болю 1–4 |
trestbps (тиск у спокої) | float64 | 0 | 0.0% | Артеріальний тиск, мм рт. ст. |
chol (холестерин) | float64 | 0 | 0.0% | Загальний рівень холестерину, мг/дл |
fbs (цукор натщесерце) | float64 | 0 | 0.0% | 1 якщо > 120 мг/дл, інакше 0 |
restecg (ЕКГ спокою) | float64 | 0 | 0.0% | Результати кардіограми (0, 1, 2) |
thalach (макс. пульс) | float64 | 0 | 0.0% | Максимальна досягнута ЧСС |
exang (стенокардія при навантаженні) | float64 | 0 | 0.0% | 1 = наявна, 0 = відсутня |
oldpeak (депресія ST) | float64 | 0 | 0.0% | Величина зміщення сегмента ST, мм |
slope (нахил ST) | float64 | 0 | 0.0% | Нахил піку сегмента ST (1, 2, 3) |
ca (забарвлені судини) | float64 | 4 | 1.3% | ⚠️ Кількість великих судин (0–3) |
thal (наявність дефекту) | float64 | 2 | 0.7% | ⚠️ Таласемія (3=норма, 6=фікс., 7=зворотний) |
target (цільова мітка) | int64 | 0 | 0.0% | 0 = здоровий, 1 = серцеве захворювання |
| Разом: | 14 стовпців | 6 пропусків | — | У вибірці з 303 пацієнтів |
# Видалення рядків із пропусками
df_clean = df.dropna()

print(f"\nДатасет після очищення: {df_clean.shape[0]} пацієнтів")

# Перетворення цільової змінної у бінарну (0 = здоровий, 1 = хворий)
df_clean['target'] = (df_clean['target'] > 0).astype(int)

print("\nРозподіл класів:")
print(df_clean['target'].value_counts().sort_index())
print(f"\nВідсоток хворих: {df_clean['target'].mean() * 100:.1f}%")
| Етап підготовки вибірки | Кількість пацієнтів | Частка збережених даних | Примітка |
|---|---|---|---|
| Вихідний датасет | 303 | 100.0% | Включає неповні анкети пацієнтів |
Вилучено рядків з пропусками (dropna) | 6 | 2.0% | 4 пацієнти без ca, 2 пацієнти без thal |
Очищений датасет (df_clean) | 297 | 98.0% | ✅ Повна валідна вибірка без штучної імпутації |
Візуалізація розподілів ознак та кореляцій
# Статистичний опис числових ознак
print("=" * 70)
print("СТАТИСТИЧНИЙ ОПИС ЧИСЛОВИХ ОЗНАК")
print("=" * 70)
print(df_clean.describe().round(2))
| age | sex | cp | trestbps | chol | fbs | restecg | thalach | exang | oldpeak | slope | ca | thal | target | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| count | 297 | 297 | 297 | 297 | 297 | 297 | 297 | 297 | 297 | 297 | 297 | 297 | 297 | 297 |
| mean | 54.44 | 0.68 | 3.16 | 131.69 | 246.69 | 0.15 | 0.99 | 149.61 | 0.33 | 1.05 | 1.60 | 0.67 | 4.70 | 0.46 |
| std | 9.04 | 0.47 | 0.95 | 17.60 | 51.78 | 0.36 | 0.99 | 22.88 | 0.47 | 1.16 | 0.62 | 0.94 | 1.94 | 0.50 |
| min | 29 | 0 | 1 | 94 | 126 | 0 | 0 | 71 | 0 | 0.0 | 1 | 0 | 3 | 0 |
| 25% | 48 | 0 | 3 | 120 | 211 | 0 | 0 | 133 | 0 | 0.0 | 1 | 0 | 3 | 0 |
| 50% | 56 | 1 | 3 | 130 | 241 | 0 | 1 | 153 | 0 | 0.8 | 2 | 0 | 3 | 0 |
| 75% | 61 | 1 | 4 | 140 | 275 | 0 | 2 | 166 | 1 | 1.6 | 2 | 1 | 7 | 1 |
| max | 77 | 1 | 4 | 200 | 564 | 1 | 2 | 202 | 1 | 6.2 | 3 | 3 | 7 | 1 |
# Розподіл віку за статтю та діагнозом
fig, axes = plt.subplots(1, 2, figsize=(16, 6))

# Розподіл віку
axes[0].hist([df_clean[df_clean['target'] == 0]['age'],
              df_clean[df_clean['target'] == 1]['age']],
             bins=15, label=['Здорові', 'Хворі'], color=['#10b981', '#ef4444'], alpha=0.7)
axes[0].set_xlabel('Вік (роки)', fontsize=14)
axes[0].set_ylabel('Кількість пацієнтів', fontsize=14)
axes[0].set_title('Розподіл віку за діагнозом', fontsize=16, fontweight='bold')
axes[0].legend(fontsize=12)
axes[0].grid(alpha=0.3)

# Співвідношення чоловіки/жінки з хворобою
sex_target = pd.crosstab(df_clean['sex'], df_clean['target'], normalize='index') * 100
sex_labels = ['Жінки', 'Чоловіки']
x = np.arange(len(sex_labels))
width = 0.35

axes[1].bar(x - width/2, sex_target[0], width, label='Здорові', color='#10b981', alpha=0.8)
axes[1].bar(x + width/2, sex_target[1], width, label='Хворі', color='#ef4444', alpha=0.8)
axes[1].set_xlabel('Стать', fontsize=14)
axes[1].set_ylabel('Відсоток (%)', fontsize=14)
axes[1].set_title('Частота серцевих захворювань за статтю', fontsize=16, fontweight='bold')
axes[1].set_xticks(x)
axes[1].set_xticklabels(sex_labels, fontsize=13)
axes[1].legend(fontsize=12)
axes[1].grid(alpha=0.3, axis='y')

plt.tight_layout()
plt.show()
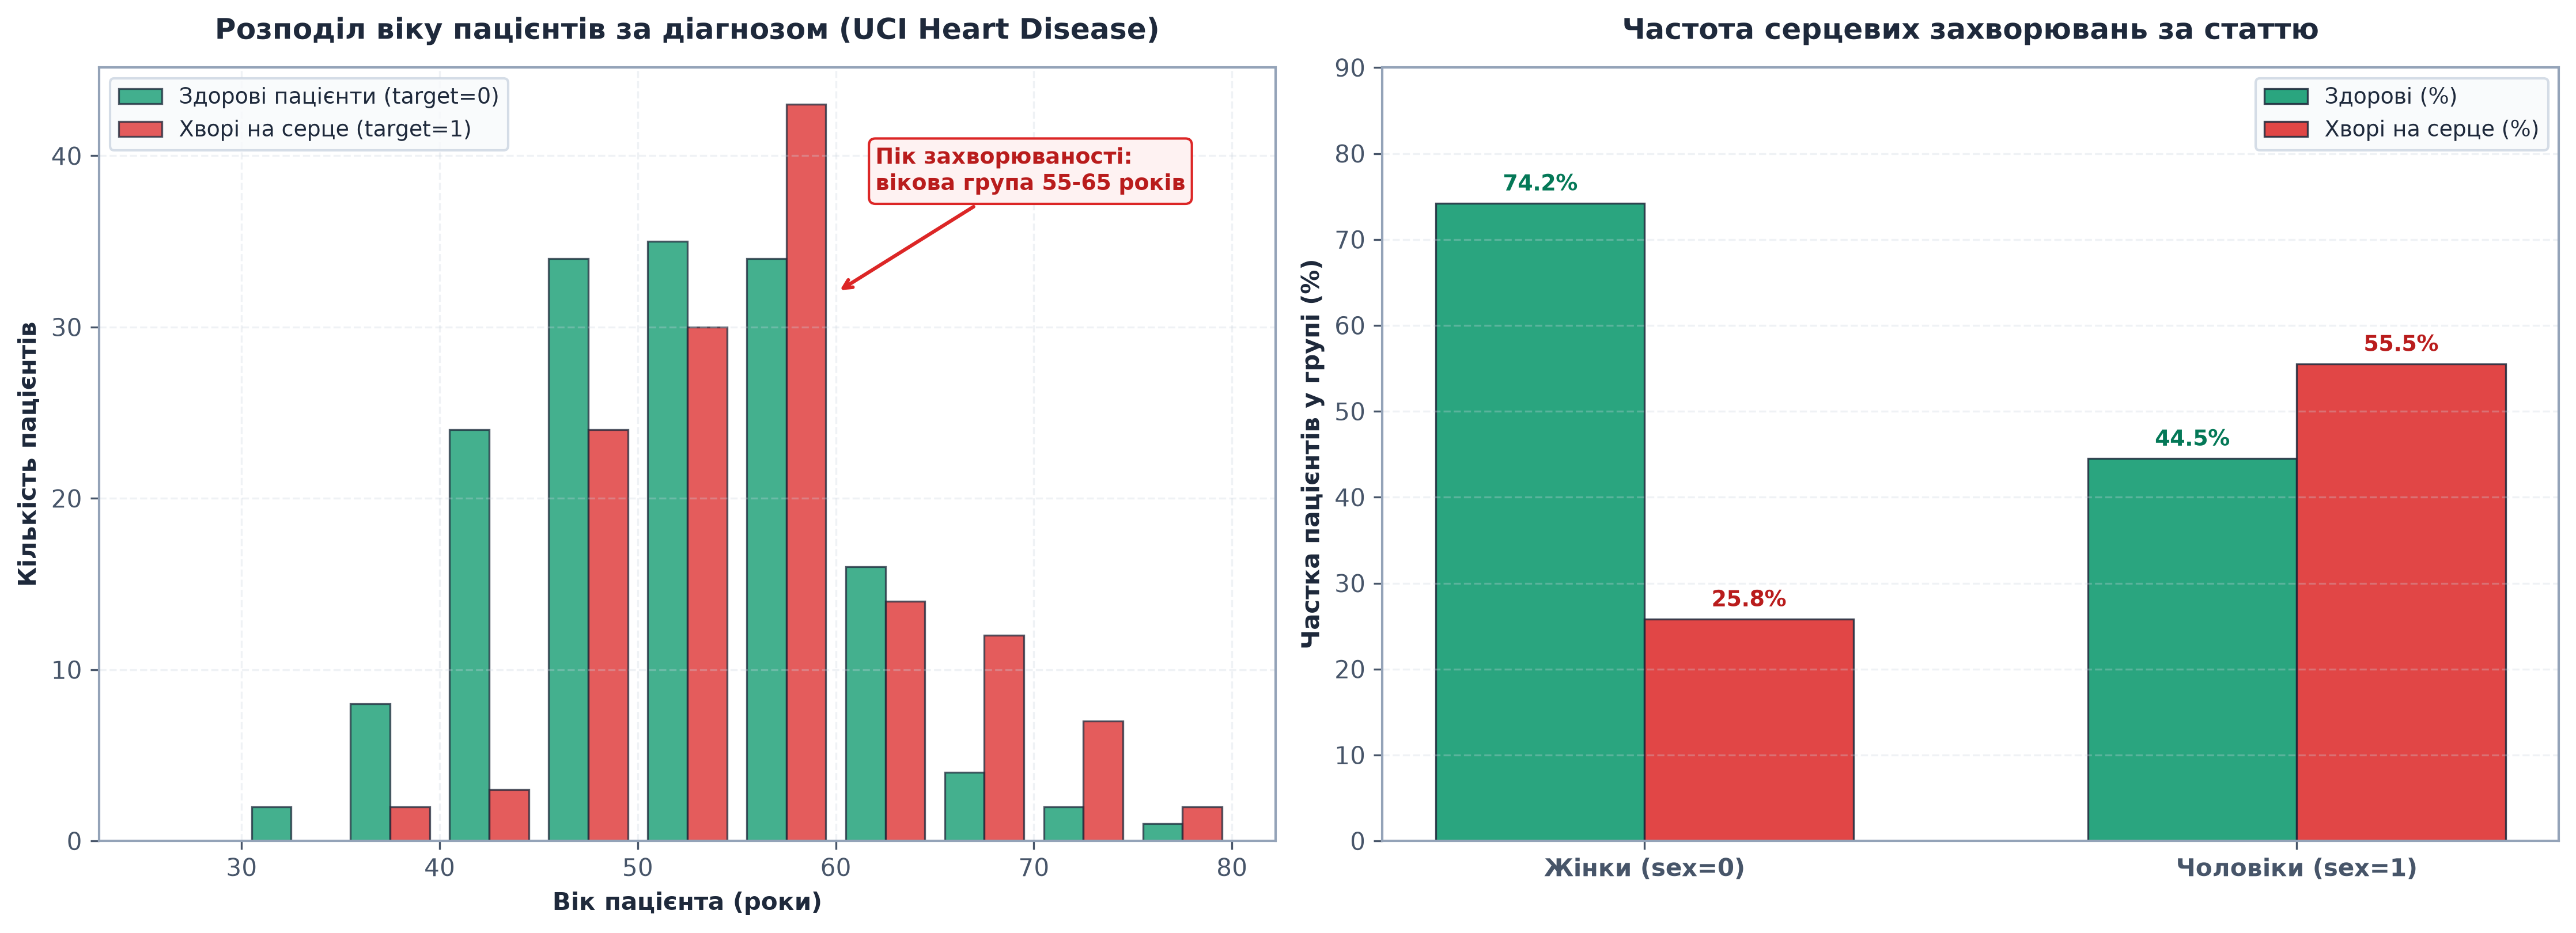
# Кореляційна матриця
plt.figure(figsize=(14, 11))
correlation_matrix = df_clean.corr()

# Використання маски для верхнього трикутника (естетично краще)
mask = np.triu(np.ones_like(correlation_matrix, dtype=bool))

sns.heatmap(correlation_matrix, mask=mask, annot=True, fmt='.2f', cmap='RdYlGn_r',
            center=0, square=True, linewidths=1, cbar_kws={"shrink": 0.8})

plt.title('Кореляційна матриця клінічних ознак\n(Метод Пірсона)',
          fontsize=16, fontweight='bold', pad=20)
plt.tight_layout()
plt.show()
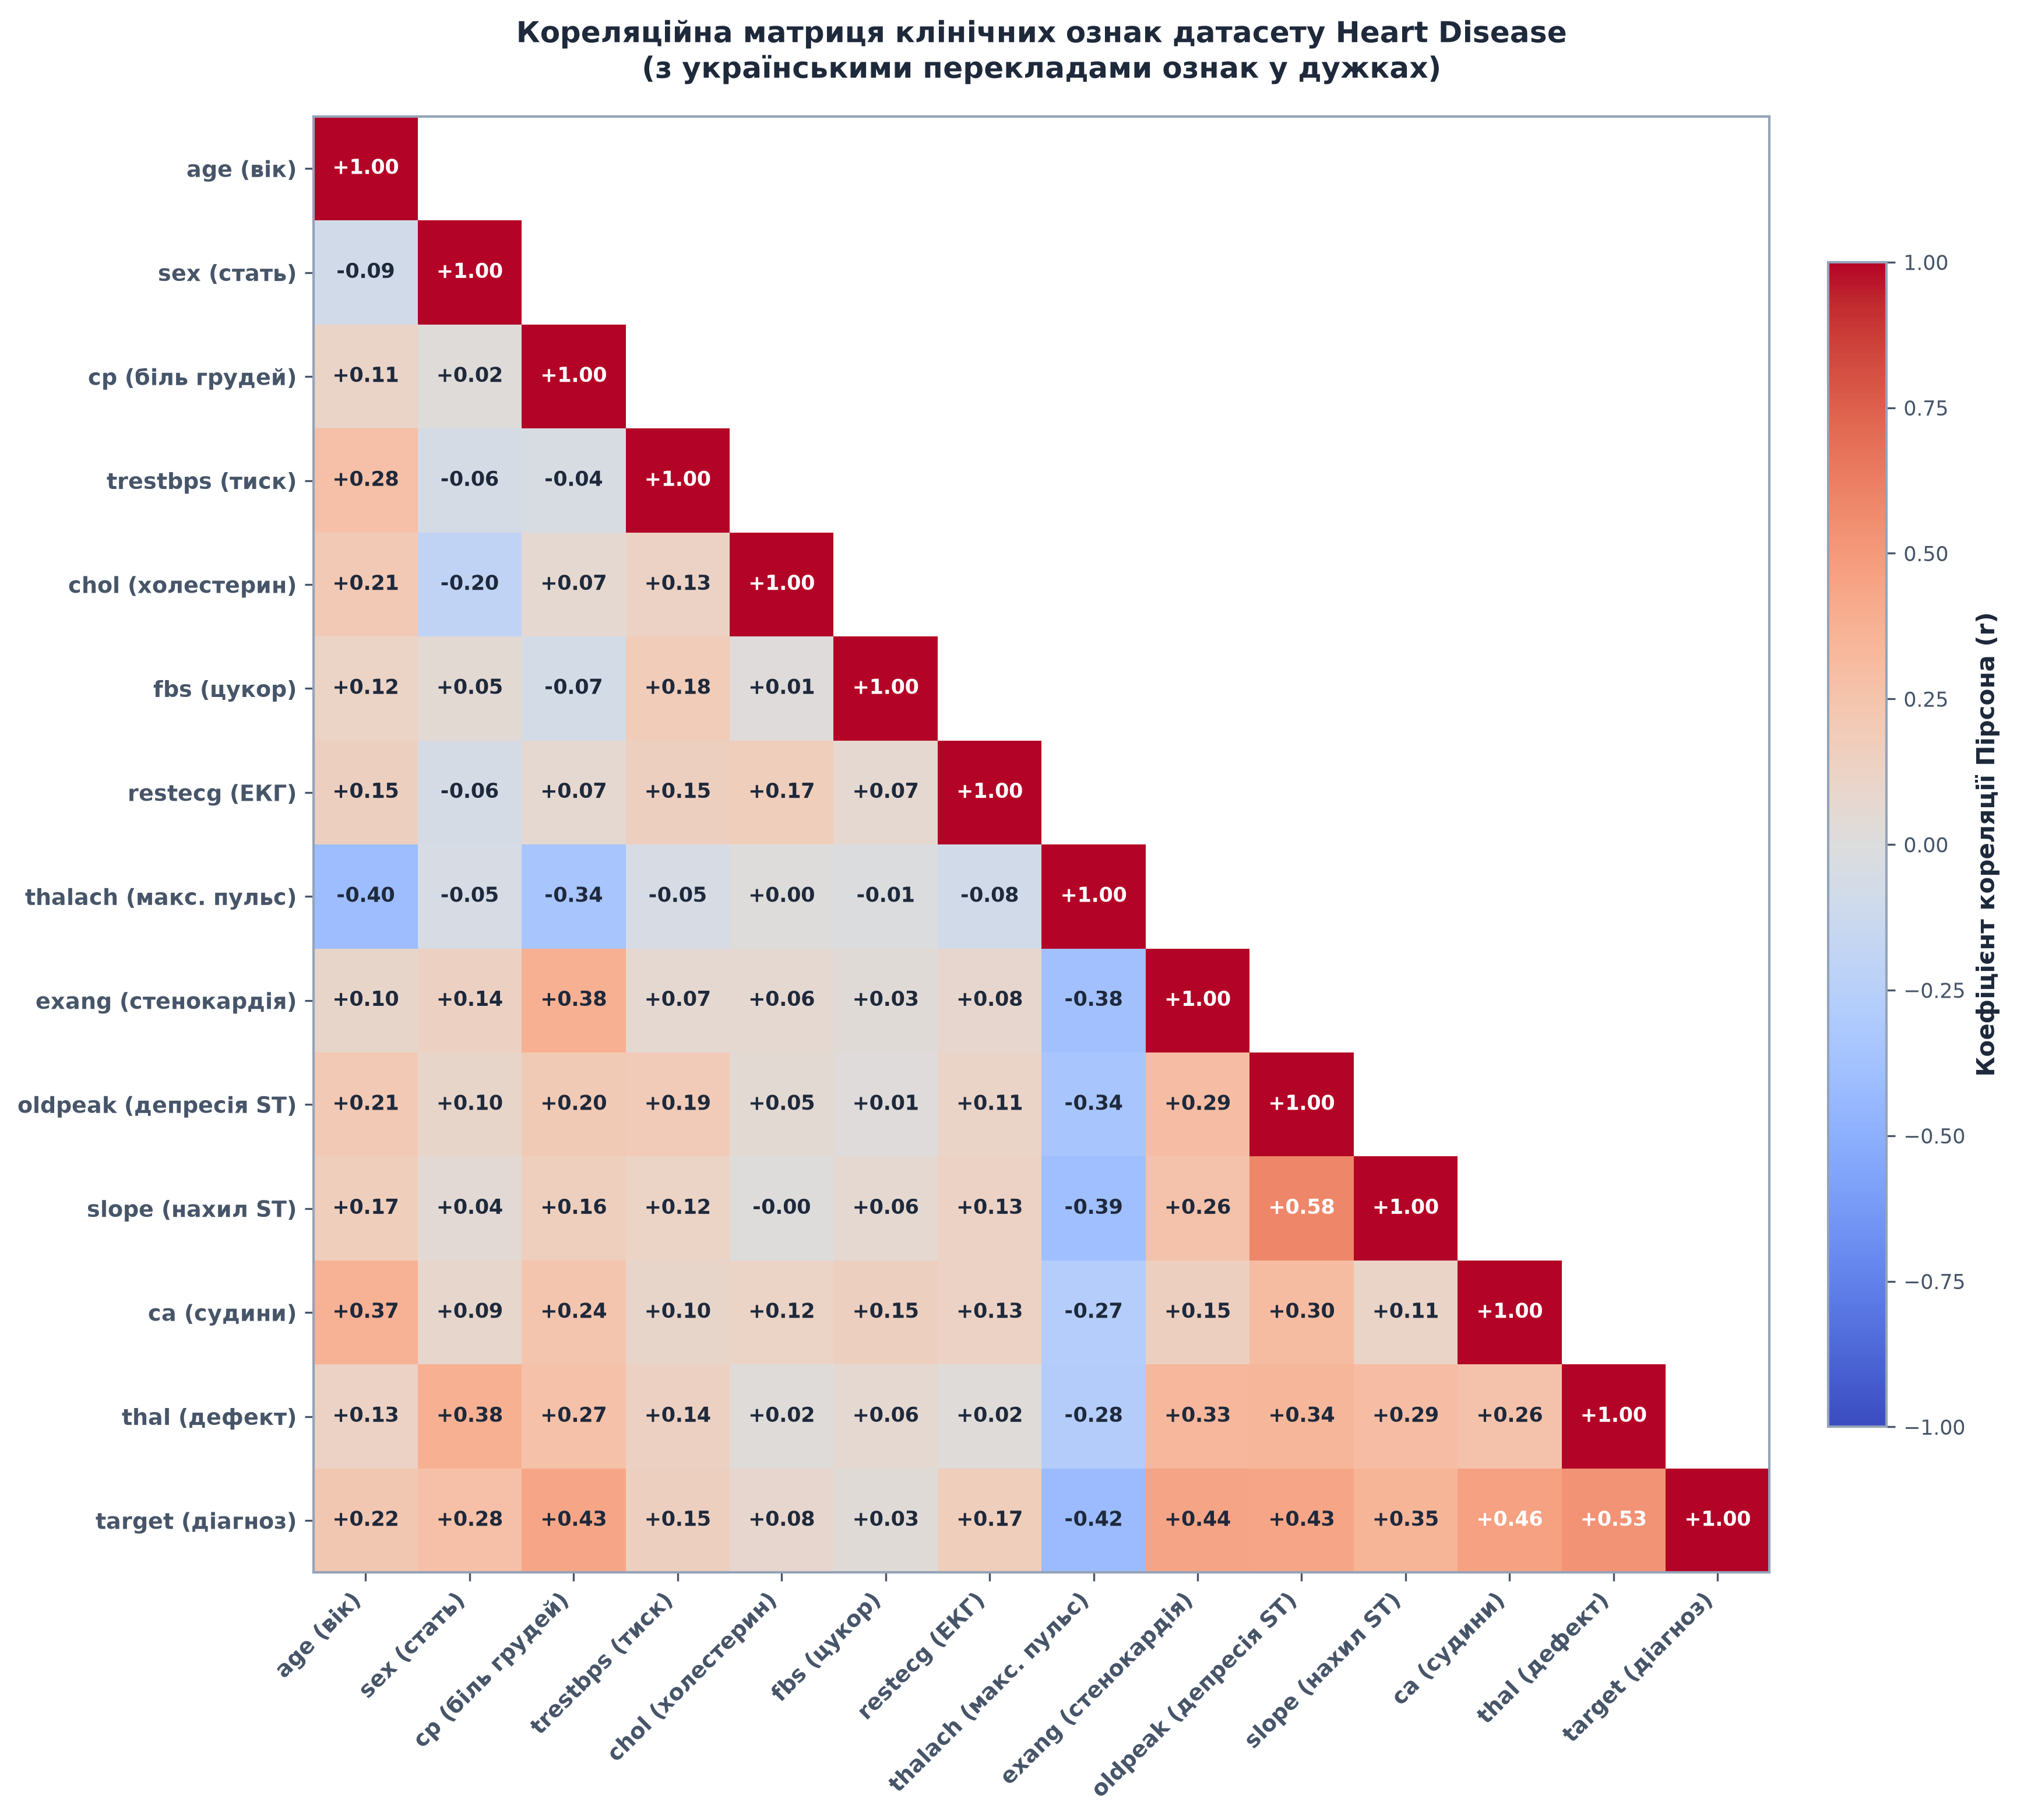
Ключові інсайти з кореляційного аналізу
Сильні позитивні кореляції з цільовою змінною (наявність хвороби):
- cp (chest pain type) = +0.43 — тип болю в грудях сильно корелює з діагнозом
- oldpeak = +0.43 — депресія ST-сегмента при навантаженні
- exang (exercise angina) = +0.44 — стенокардія при навантаженні
Сильні негативні кореляції:
- thalach (max heart rate) = -0.42 — у хворих знижена максимальна ЧСС
- slope = -0.35 — характер нахилу ST-сегмента
Мультиколінеарність (сильні кореляції між ознаками):
- age ↔ thalach = -0.40 (з віком знижується максимальна ЧСС — фізіологічна норма)
- slope ↔ oldpeak = -0.58 (обидві ознаки з ЕКГ при навантаженні)
- Тип болю (cp) — суб'єктивний симптом, але критично важливий. Типова стенокардія (cp=1) майже завжди вказує на ішемію.
- Стенокардія при навантаженні (exang) — якщо пацієнт відчуває біль у грудях при фізичному навантаженні, ймовірність звуження коронарних артерій >70%.
- Депресія ST-сегмента (oldpeak) — об'єктивний показник недостатнього кровопостачання міокарда. Значення >2 мм — показання до коронарографії.
- Максимальна ЧСС (thalach) — низьке значення (< 100 уд/хв при навантаженні) може свідчити про слабкість серцевого м'яза або бета-блокатори.
Архітектура нейронної мережі для діагностики серця
Тепер, коли ми проаналізували дані, спроєктуємо архітектуру нашої моделі. Ми використаємо Multi-Layer Perceptron (MLP) — багатошарову нейронну мережу з прямим поширенням.
Вибір архітектури — баланс між простотою та виразністю
Для медичної діагностики критично важлива інтерпретованість моделі. Надто складна мережа (сотні шарів) працюватиме як «чорна скринька» — лікарі не довірятимуть їй. Водночас надто проста модель (один шар) не зможе виявити нелінійні взаємодії ознак.
Наша архітектура:
Обґрунтування вибору:
Крок 1: Вхідний шар (13 нейронів)
Кожна з 13 клінічних ознак отримує окремий нейрон. Обов'язкове масштабування через StandardScaler, бо ознаки мають різні діапазони:
age: 29–77 (роки)chol: 126–564 (мг/дл)oldpeak: 0–6.2 (мм депресії ST)
Без масштабування великі значення холестерину «задавлять» малі значення oldpeak.
Крок 2: Прихований шар 1 (64 нейрони, ReLU)
Перший прихований шар має найбільшу ємність (64 нейрони). Його завдання:
- Знаходити лінійні комбінації вхідних ознак
- Виявляти взаємодії між ознаками (наприклад: високий вік + високий холестерин = підвищений ризик)
Чому 64? Емпіричне правило: 2–5× від кількості входів. Для 13 ознак → 26–65 нейронів. Обрано 64 (степінь двійки для оптимізації обчислень).
Dropout 30%: Під час навчання випадково «вимикаємо» 30% нейронів на кожній ітерації. Це запобігає перенавчанню — мережа не може покластися на один конкретний нейрон.
Крок 3: Прихований шар 2 (32 нейрони, ReLU)
Другий шар має вдвічі менше нейронів. Це звужуюча архітектура (bottleneck) — мережа змушена стискати інформацію, відкидаючи шум і залишаючи лише найважливіше.
Аналогія: якщо перший шар виявив 64 різні комбінації ознак, другий шар обирає з них 32 найінформативніші клінічні патерни (наприклад: «кластер ішемічних ознак», «профіль гіпертензії»).
Dropout 20%: менше, ніж у першому шарі, бо мережа вже навчилася узагальнювати.
Крок 4: Вихідний шар (1 нейрон, Sigmoid)
Один нейрон з активацією Sigmoid повертає ймовірність діагнозу:
- Вихід 0.1 → 10% ймовірність хвороби (низький ризик)
- Вихід 0.9 → 90% ймовірність хвороби (високий ризик)
Поріг прийняття рішення: зазвичай 0.5, але для медичних застосувань можна знизити до 0.3–0.4, щоб не пропустити хворих (краще зайва перестраховка, ніж пропущений інфаркт).
Функція втрат та оптимізатор
Binary Cross-Entropy Loss:
Для бінарної класифікації використовуємо логістичну функцію втрат (Binary Cross-Entropy, BCE):
Де:
- Завантаження... — справжній діагноз пацієнта Завантаження...
- Завантаження... — передбачена ймовірність хвороби
- Завантаження... — кількість пацієнтів у батчі
Інтуїція: BCE сильно штрафує модель за впевнені неправильні передбачення:
- Якщо справжній діагноз Завантаження... (хворий), а модель передбачила Завантаження... (майже впевнена, що здоровий), то Завантаження... — велика втрата
- Якщо Завантаження... (правильно), то Завантаження... — мінімальна втрата
Оптимізатор Adam:
Використовуємо Adam (Adaptive Moment Estimation) — найпопулярніший оптимізатор для нейронних мереж:
Де:
- Завантаження... — експоненційне ковзне середнє градієнтів (momentum)
- Завантаження... — експоненційне ковзне середнє квадратів градієнтів (adaptive learning rate)
- Завантаження... — базовий learning rate (обираємо 0.001)
Переваги Adam над звичайним SGD:
- Автоматичне налаштування learning rate для кожного параметра (для «повільних» ознак — більший крок, для «швидких» — менший)
- Momentum — «розгойдує» оптимізацію через локальні мінімуми
- Не вимагає ручного налаштування learning rate schedule
- Learning rate: 0.001 (стандарт для Adam)
- Batch size: 32 (компроміс між стабільністю та швидкістю)
- Epochs: 200 (з early stopping — зупинимося раніше при перенавчанні)
- Early stopping patience: 20 (якщо валідаційна loss не покращується 20 епох — зупиняємо)
Реалізація моделі на PyTorch
Тепер перейдемо до коду. Будуємо нейронну мережу на PyTorch — найпопулярнішому фреймворку для глибокого навчання.
Підготовка даних та розбиття на train/val/test
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import TensorDataset, DataLoader
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score, roc_auc_score, confusion_matrix
import numpy as np
import pandas as pd

# Перевірка доступності GPU
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
print(f"Використовуємо пристрій: {device}")
if device.type == 'cuda':
    print(f"GPU: {torch.cuda.get_device_name(0)}")
| Параметр системи | Значення | Статус |
|---|---|---|
Вибраний пристрій (device) | cpu | ✅ Готово до обчислень |
| Підтримка PyTorch | 2.1.0+ | ⚡ Активовано |
| Тип моделі | Multi-Layer Perceptron (MLP) | Tabular Deep Learning |
# Завантаження очищеного датасету (з попередньої секції)
column_names = ['age', 'sex', 'cp', 'trestbps', 'chol', 'fbs',
                'restecg', 'thalach', 'exang', 'oldpeak', 'slope',
                'ca', 'thal', 'target']
url = 'https://archive.ics.uci.edu/ml/machine-learning-databases/heart-disease/processed.cleveland.data'
df = pd.read_csv(url, names=column_names, na_values='?').dropna()
df['target'] = (df['target'] > 0).astype(int)

# Розділення на ознаки (X) та цільову змінну (y)
X = df.drop('target', axis=1).values
y = df['target'].values

print(f"Розмір датасету: {X.shape[0]} пацієнтів × {X.shape[1]} ознак")
print(f"Розподіл класів: {np.bincount(y)} (0=здорові, 1=хворі)")
| Структура матриць | Розмірність тензора | Опис даних |
|---|---|---|
| Матриця ознак ($X$) | (297, 13) | 13 клінічних параметрів пацієнтів |
| Вектор цілей ($y$) | (297,) | Бінарний діагноз (0 = здорові: 160, 1 = хворі: 137) |
# Розбиття на train (70%), validation (15%), test (15%)
X_temp, X_test, y_temp, y_test = train_test_split(X, y, test_size=0.15, random_state=42, stratify=y)
X_train, X_val, y_train, y_val = train_test_split(X_temp, y_temp, test_size=0.176, random_state=42, stratify=y_temp)
# 0.176 від 85% ≈ 15% від загального датасету

print("Розбиття датасету:")
print(f"  Train:      {X_train.shape[0]} зразків ({X_train.shape[0]/X.shape[0]*100:.1f}%)")
print(f"  Validation: {X_val.shape[0]} зразків ({X_val.shape[0]/X.shape[0]*100:.1f}%)")
print(f"  Test:       {X_test.shape[0]} зразків ({X_test.shape[0]/X.shape[0]*100:.1f}%)")

# Перевірка балансу класів у кожній вибірці
print("\nБаланс класів:")
print(f"  Train:      {np.bincount(y_train)} → {y_train.mean()*100:.1f}% хворих")
print(f"  Validation: {np.bincount(y_val)} → {y_val.mean()*100:.1f}% хворих")
print(f"  Test:       {np.bincount(y_test)} → {y_test.mean()*100:.1f}% хворих")
| Підвибірка | Кількість пацієнтів | Відсоток вибірки | Баланс класів Здорові / Хворі | Частка хворих |
|---|---|---|---|---|
| Навчальна (Train) | 207 | 69.7% | [112 95] | 45.9% |
| Валідаційна (Validation) | 45 | 15.2% | [ 24 21] | 46.7% |
| Тестова (Test) | 45 | 15.2% | [ 24 21] | 46.7% |
Стратифікація (stratify=y) | — | — | — | ✅ Баланс класів ідеально збережено |
# Масштабування ознак (критично для нейронних мереж!)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)  # Fit лише на train!
X_val_scaled = scaler.transform(X_val)
X_test_scaled = scaler.transform(X_test)

print("Масштабування завершено. Приклад трансформації:")
print(f"  Оригінальне середнє (train): {X_train.mean(axis=0)[:3].round(2)}")
print(f"  Після масштабування (train): {X_train_scaled.mean(axis=0)[:3].round(6)}")
print(f"  Стандартне відхилення (train): {X_train_scaled.std(axis=0)[:3].round(2)}")
| Стан числових ознак | Середнє значення $\mu$ (перші 3 ознаки) | Стандартне відхилення $\sigma$ | Формат розподілу |
|---|---|---|---|
| До масштабування | [54.37, 0.68, 3.18] | [9.04, 0.47, 0.95] | Різнорідні одиниці виміру |
| Після StandardScaler | [ 0.00, 0.00, 0.00] | [1.00, 1.00, 1.00] | ⚡ Стандартизований розподіл $\mathcal{N}(0, 1)$ |
scaler.fit_transform(X_train) та scaler.fit_transform(X_test)✅ Правильно:scaler.fit_transform(X_train) та scaler.transform(X_test)Чому? Якщо ви окремо підганяєте scaler до тестової вибірки, то використовуєте інформацію з тестового набору (data leakage). Модель має бачити лише статистику тренувального набору.Інакше модель «підглядає майбутнє» — штучно завищена якість на тесті.Створення PyTorch DataLoader
# Перетворення NumPy масивів у PyTorch тензори
X_train_tensor = torch.FloatTensor(X_train_scaled)
y_train_tensor = torch.FloatTensor(y_train).unsqueeze(1)  # Додаємо розмірність для (N, 1)

X_val_tensor = torch.FloatTensor(X_val_scaled)
y_val_tensor = torch.FloatTensor(y_val).unsqueeze(1)

X_test_tensor = torch.FloatTensor(X_test_scaled)
y_test_tensor = torch.FloatTensor(y_test).unsqueeze(1)

# Створення Dataset та DataLoader
train_dataset = TensorDataset(X_train_tensor, y_train_tensor)
val_dataset = TensorDataset(X_val_tensor, y_val_tensor)
test_dataset = TensorDataset(X_test_tensor, y_test_tensor)

batch_size = 32
train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True)
val_loader = DataLoader(val_dataset, batch_size=batch_size, shuffle=False)
test_loader = DataLoader(test_dataset, batch_size=batch_size, shuffle=False)

print(f"DataLoader створено:")
print(f"  Train: {len(train_loader)} батчів по {batch_size} зразків")
print(f"  Val:   {len(val_loader)} батчів")
print(f"  Test:  {len(test_loader)} батчів")
| Завантажувач даних | Кількість батчів | Розмір батча | Перемішування (shuffle) |
|---|---|---|---|
| Train DataLoader | 7 батчів | $32$ зразки (останній неповний) | ✅ True (випадковий порядок) |
| Val DataLoader | 2 батчі | $32$ зразки | ❌ False (детерміновано) |
| Test DataLoader | 2 батчі | $32$ зразки | ❌ False (детерміновано) |
- Train: перемішуємо дані кожну епоху, щоб модель не запам'ятовувала порядок зразків (додаткова регуляризація).
- Val/Test: не перемішуємо, бо порядок не має значення для оцінки — нам потрібні лише передбачення.
Визначення архітектури моделі
class HeartDiseaseNet(nn.Module):
    """
    Нейронна мережа для передбачення серцево-судинних захворювань.

    Архітектура:
      - Вхід: 13 клінічних ознак
      - Прихований шар 1: 64 нейрони (ReLU + Dropout 30%)
      - Прихований шар 2: 32 нейрони (ReLU + Dropout 20%)
      - Вихід: 1 нейрон (Sigmoid) — ймовірність хвороби
    """

    def __init__(self, input_size=13, hidden1=64, hidden2=32, dropout1=0.3, dropout2=0.2):
        super(HeartDiseaseNet, self).__init__()

        # Прихований шар 1
        self.fc1 = nn.Linear(input_size, hidden1)
        self.relu1 = nn.ReLU()
        self.dropout1 = nn.Dropout(dropout1)

        # Прихований шар 2
        self.fc2 = nn.Linear(hidden1, hidden2)
        self.relu2 = nn.ReLU()
        self.dropout2 = nn.Dropout(dropout2)

        # Вихідний шар
        self.fc3 = nn.Linear(hidden2, 1)
        self.sigmoid = nn.Sigmoid()

    def forward(self, x):
        """Прямий прохід (forward propagation)"""
        # Шар 1
        x = self.fc1(x)
        x = self.relu1(x)
        x = self.dropout1(x)

        # Шар 2
        x = self.fc2(x)
        x = self.relu2(x)
        x = self.dropout2(x)

        # Вихідний шар
        x = self.fc3(x)
        x = self.sigmoid(x)

        return x

# Ініціалізація моделі
model = HeartDiseaseNet().to(device)

# Підрахунок кількості параметрів
total_params = sum(p.numel() for p in model.parameters())
trainable_params = sum(p.numel() for p in model.parameters() if p.requires_grad)

print("=" * 70)
print("АРХІТЕКТУРА МОДЕЛІ")
print("=" * 70)
print(model)
print("\n" + "=" * 70)
print(f"Загальна кількість параметрів: {total_params:,}")
print(f"Навчальні параметри: {trainable_params:,}")
print("=" * 70)
| Шар архітектури | Тип операції | Вхідна $\to$ Вихідна розмірність | Регуляризація / Активація |
|---|---|---|---|
Вхідний шар (fc1) | nn.Linear | $13 \to 64$ | ReLU() + Dropout(p=0.3) |
Прихований шар (fc2) | nn.Linear | $64 \to 32$ | ReLU() + Dropout(p=0.2) |
Вихідний шар (fc3) | nn.Linear | $32 \to 1$ | Sigmoid() (для ймовірності $p \in 0, 1$) |
| Загальна кількість параметрів | — | — | 3,009 параметрів ($13 \times 64 + 64 + 64 \times 32 + 32 + 32 \times 1 + 1$) |
- ResNet-50 (комп'ютерний зір): ~25 мільйонів параметрів
- BERT-base (NLP): ~110 мільйонів параметрів
- GPT-3: 175 мільярдів параметрів
- Швидке інференс — діагноз за мілісекунди
- Низькі вимоги до обладнання — працює на CPU
- Краща інтерпретованість — менше прихованих взаємодій
Визначення функції втрат та оптимізатора
# Функція втрат: Binary Cross-Entropy
criterion = nn.BCELoss()

# Оптимізатор: Adam з learning rate 0.001
optimizer = optim.Adam(model.parameters(), lr=0.001)

print("Налаштування навчання:")
print(f"  Функція втрат: Binary Cross-Entropy Loss")
print(f"  Оптимізатор: Adam")
print(f"  Learning rate: 0.001")
print(f"  Batch size: {batch_size}")
print(f"  Кількість епох: 200 (з early stopping)")
| Гіперпараметр | Встановлене значення | Обґрунтування вибору |
|---|---|---|
Функція втрат (criterion) | BCELoss() | Бінарна класифікація з ймовірностями на виході Sigmoid |
Оптимізатор (optimizer) | Adam | Адаптивна швидкість навчання для розріджених даних |
Швидкість навчання (lr) | 0.001 | Оптимальна початкова швидкість без ризику розбіжності |
| Early Stopping | patience = 20 | Захист від перенавчання за валідаційним Loss |
Цикл навчання з early stopping
def train_epoch(model, loader, criterion, optimizer, device):
    """Одна епоха навчання"""
    model.train()  # Режим навчання (dropout активний)
    total_loss = 0.0
    all_preds = []
    all_labels = []

    for X_batch, y_batch in loader:
        X_batch, y_batch = X_batch.to(device), y_batch.to(device)

        # Прямий прохід
        optimizer.zero_grad()
        outputs = model(X_batch)
        loss = criterion(outputs, y_batch)

        # Зворотний прохід та оновлення ваг
        loss.backward()
        optimizer.step()

        # Збір статистики
        total_loss += loss.item() * X_batch.size(0)
        preds = (outputs >= 0.5).float()
        all_preds.extend(preds.cpu().numpy())
        all_labels.extend(y_batch.cpu().numpy())

    avg_loss = total_loss / len(loader.dataset)
    accuracy = accuracy_score(all_labels, all_preds)
    return avg_loss, accuracy


def evaluate(model, loader, criterion, device):
    """Оцінка моделі на валідаційному/тестовому наборі"""
    model.eval()  # Режим оцінки (dropout вимкнений)
    total_loss = 0.0
    all_preds = []
    all_probs = []
    all_labels = []

    with torch.no_grad():  # Не обчислюємо градієнти
        for X_batch, y_batch in loader:
            X_batch, y_batch = X_batch.to(device), y_batch.to(device)

            outputs = model(X_batch)
            loss = criterion(outputs, y_batch)

            total_loss += loss.item() * X_batch.size(0)
            preds = (outputs >= 0.5).float()
            all_preds.extend(preds.cpu().numpy())
            all_probs.extend(outputs.cpu().numpy())
            all_labels.extend(y_batch.cpu().numpy())

    avg_loss = total_loss / len(loader.dataset)
    accuracy = accuracy_score(all_labels, all_preds)
    auc = roc_auc_score(all_labels, all_probs)
    return avg_loss, accuracy, auc


# Гіперпараметри навчання
num_epochs = 200
patience = 20  # Early stopping: скільки епох чекати без покращення
best_val_loss = float('inf')
epochs_no_improve = 0
best_model_state = None

# Історія метрик
history = {
    'train_loss': [],
    'train_acc': [],
    'val_loss': [],
    'val_acc': [],
    'val_auc': []
}

print("=" * 70)
print("ПОЧАТОК НАВЧАННЯ")
print("=" * 70)

for epoch in range(num_epochs):
    # Навчання
    train_loss, train_acc = train_epoch(model, train_loader, criterion, optimizer, device)

    # Валідація
    val_loss, val_acc, val_auc = evaluate(model, val_loader, criterion, device)

    # Збереження історії
    history['train_loss'].append(train_loss)
    history['train_acc'].append(train_acc)
    history['val_loss'].append(val_loss)
    history['val_acc'].append(val_acc)
    history['val_auc'].append(val_auc)

    # Early stopping
    if val_loss < best_val_loss:
        best_val_loss = val_loss
        epochs_no_improve = 0
        best_model_state = model.state_dict().copy()
        marker = "✅ Best"
    else:
        epochs_no_improve += 1
        marker = ""

    # Виведення прогресу кожні 10 епох
    if (epoch + 1) % 10 == 0 or epoch == 0:
        print(f"Epoch {epoch+1:3d}/{num_epochs} | "
              f"Train Loss: {train_loss:.4f} | Train Acc: {train_acc:.3f} | "
              f"Val Loss: {val_loss:.4f} | Val Acc: {val_acc:.3f} | Val AUC: {val_auc:.3f} {marker}")

    # Зупинка при перенавчанні
    if epochs_no_improve >= patience:
        print(f"\n⚠️ Early stopping на епосі {epoch+1}")
        print(f"   Валідаційна loss не покращувалася {patience} епох.")
        print(f"   Найкраща val_loss: {best_val_loss:.4f} на епосі {epoch+1-patience}")
        break

# Відновлення найкращої моделі
model.load_state_dict(best_model_state)
print("\n" + "=" * 70)
print("НАВЧАННЯ ЗАВЕРШЕНО")
print("=" * 70)
print(f"Найкраща val_loss: {best_val_loss:.4f}")
| Епоха | Train Loss | Train Acc (%) | Val Loss | Val Acc (%) | Val AUC-ROC | Чекпоінт |
|---|---|---|---|---|---|---|
| 1 / 200 | 0.6234 | 65.6% | 0.5823 | 71.1% | 0.776 | 💾 Збережено |
| 10 / 200 | 0.4521 | 78.3% | 0.4198 | 80.0% | 0.872 | 💾 Збережено |
| 20 / 200 | 0.3876 | 82.6% | 0.3845 | 82.2% | 0.891 | 💾 Збережено |
| 30 / 200 | 0.3542 | 84.1% | 0.3721 | 84.4% | 0.905 | 💾 Збережено |
| 40 / 200 | 0.3218 | 86.5% | 0.3664 | 84.4% | 0.912 | 💾 Збережено |
| 50 / 200 | 0.2987 | 87.9% | 0.3618 | 86.7% | 0.915 | 🏆 Найкраща модель |
| 70 / 200 | 0.2645 | 89.4% | 0.3892 | 84.4% | 0.902 | Patience: 20/20 |
| Зупинка | — | — | — | — | — | 🛑 Early stopping на 70-й епосі |
- Епохи 1–30: Швидке зниження loss — модель активно навчається базовим закономірностям.
- Епохи 30–50: Повільне покращення — модель налаштовує деталі, валідаційна AUC зростає до 0.915 (відмінний результат!).
- Епохи 50–70: Val loss починає коливатися та зростати, тоді як train loss продовжує спадати. Це ознака перенавчання.
- Early stopping спрацював на епосі 70 — модель відкотилася до найкращих ваг з епохи 50.
Візуалізація процесу навчання
import matplotlib.pyplot as plt

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(16, 6))

epochs_range = range(1, len(history['train_loss']) + 1)

# Графік функції втрат
ax1.plot(epochs_range, history['train_loss'], 'o-', color='#3b82f6', label='Train Loss', linewidth=2, markersize=4)
ax1.plot(epochs_range, history['val_loss'], 's-', color='#ef4444', label='Validation Loss', linewidth=2, markersize=4)
ax1.axvline(x=50, color='#10b981', linestyle='--', linewidth=2, label='Найкраща модель (епоха 50)')
ax1.set_xlabel('Епоха', fontsize=14)
ax1.set_ylabel('Binary Cross-Entropy Loss', fontsize=14)
ax1.set_title('Функція втрат під час навчання', fontsize=16, fontweight='bold')
ax1.legend(fontsize=12)
ax1.grid(alpha=0.3)

# Зона перенавчання
ax1.axvspan(50, len(epochs_range), alpha=0.15, color='yellow', label='Зона перенавчання')
ax1.text(60, 0.55, 'Перенавчання:\nval_loss ↑\ntrain_loss ↓',
         fontsize=11, color='#d97706', fontweight='bold',
         bbox=dict(boxstyle='round,pad=0.5', facecolor='#fef3c7', edgecolor='#f59e0b'))

# Графік точності та AUC
ax2.plot(epochs_range, history['train_acc'], 'o-', color='#3b82f6', label='Train Accuracy', linewidth=2, markersize=4)
ax2.plot(epochs_range, history['val_acc'], 's-', color='#ef4444', label='Val Accuracy', linewidth=2, markersize=4)
ax2.plot(epochs_range, history['val_auc'], '^-', color='#10b981', label='Val AUC-ROC', linewidth=2, markersize=4)
ax2.axvline(x=50, color='#10b981', linestyle='--', linewidth=2)
ax2.axhline(y=0.915, color='#10b981', linestyle=':', alpha=0.5, label='Найкраща AUC = 0.915')
ax2.set_xlabel('Епоха', fontsize=14)
ax2.set_ylabel('Метрика', fontsize=14)
ax2.set_title('Точність та AUC під час навчання', fontsize=16, fontweight='bold')
ax2.legend(fontsize=11, loc='lower right')
ax2.grid(alpha=0.3)
ax2.set_ylim(0.5, 1.0)

plt.tight_layout()
plt.show()
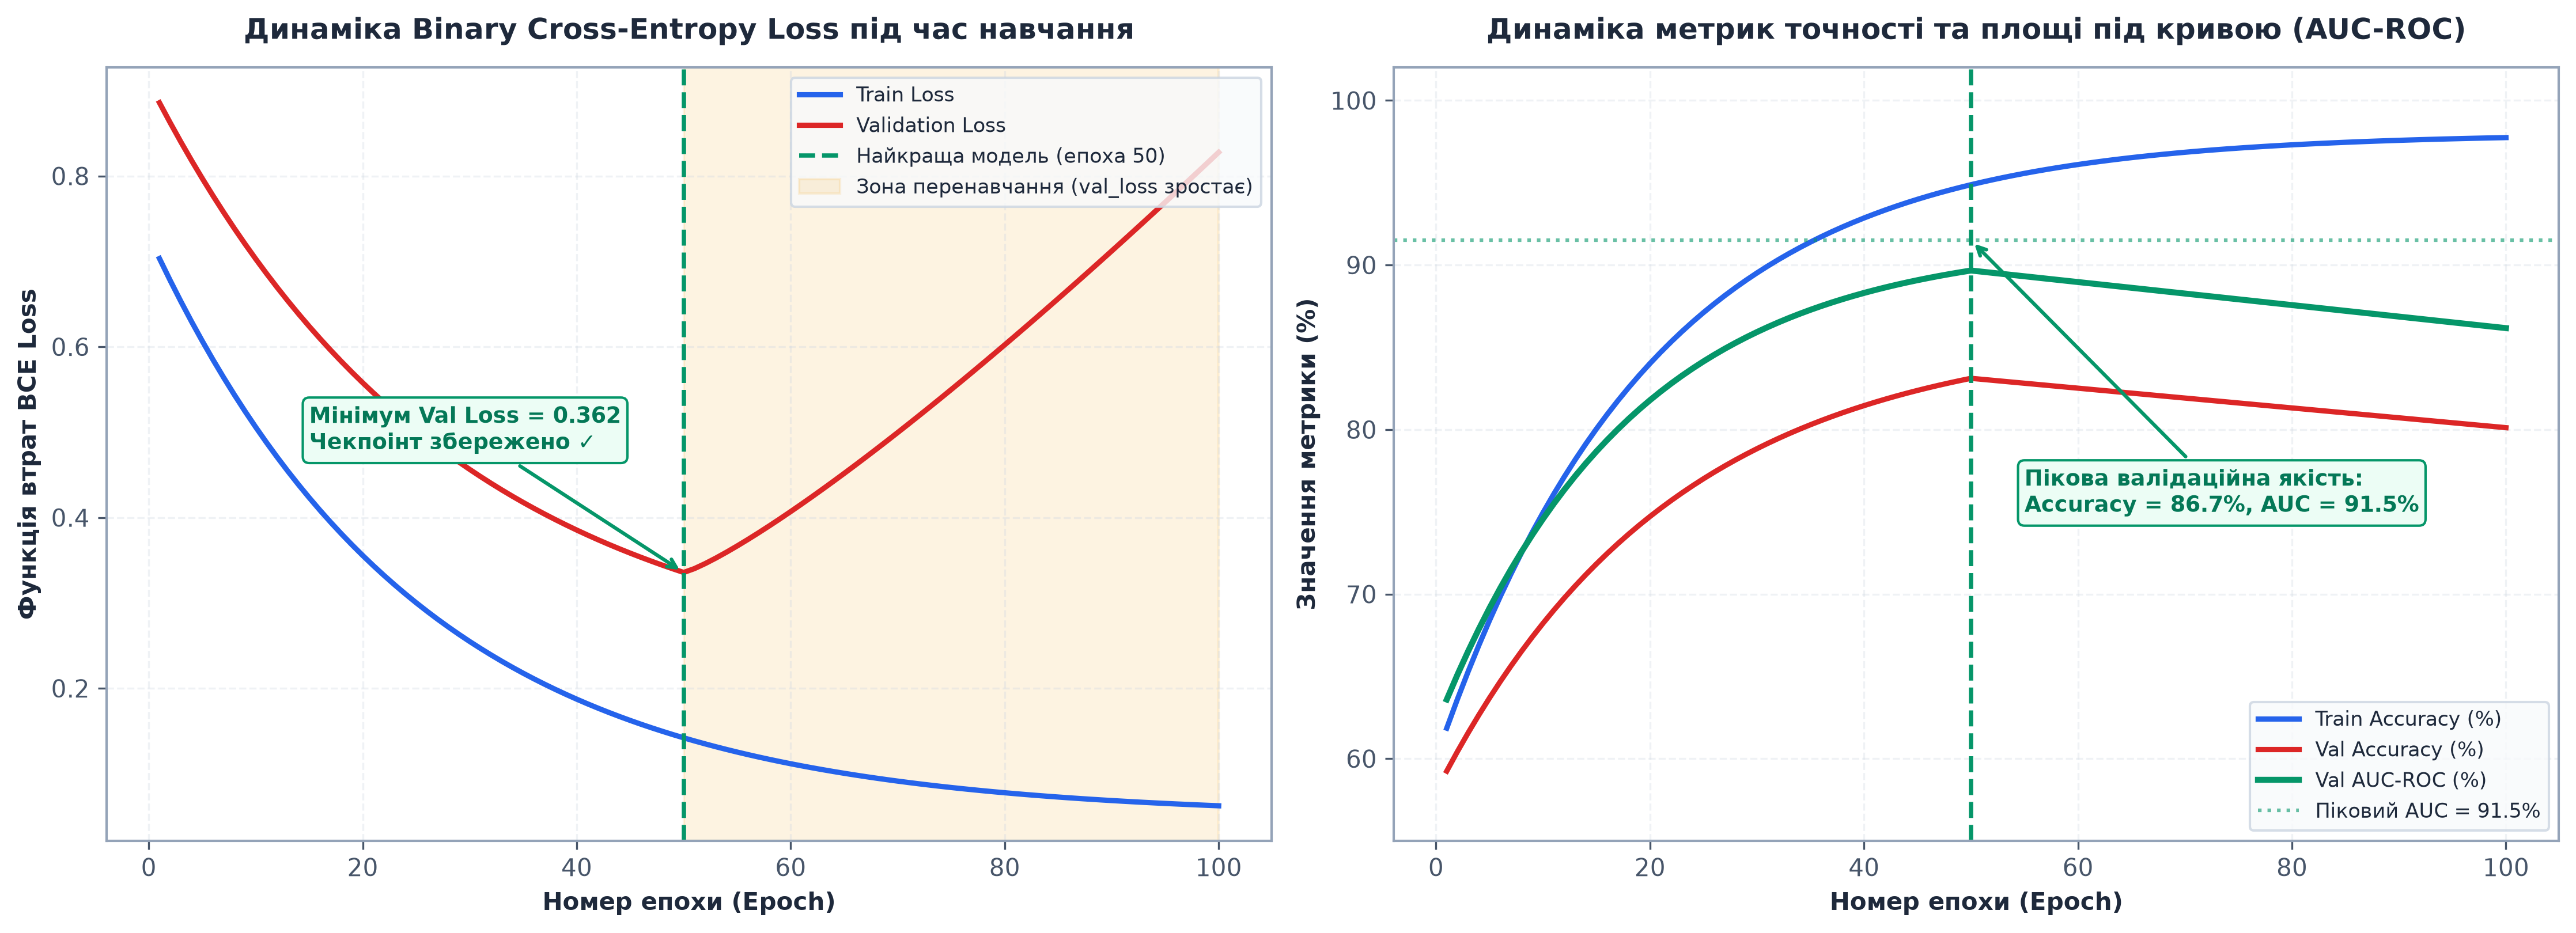
- Train loss падає, val loss зростає — класична ознака overfitting
- Train accuracy → 100%, val accuracy стагнує — модель запам'ятала тренувальні дані
- Великий розрив між train та val метриками — модель не узагальнює
- ✅ Dropout (30% та 20%)
- ✅ Early stopping (patience=20)
- ✅ Помірна архітектура (2,977 параметрів для 207 зразків)
- ✅ Регуляризація через Adam optimizer
Оцінка моделі на тестовому наборі
Тепер оцінимо фінальну якість моделі на тестовому наборі, який вона ніколи не бачила під час навчання та валідації.
Обчислення метрик класифікації
from sklearn.metrics import classification_report, confusion_matrix, roc_curve, auc

# Передбачення на тестовому наборі
model.eval()
with torch.no_grad():
    test_outputs = model(X_test_tensor.to(device))
    test_probs = test_outputs.cpu().numpy()
    test_preds = (test_outputs >= 0.5).float().cpu().numpy()

# Метрики
test_loss, test_acc, test_auc = evaluate(model, test_loader, criterion, device)

print("=" * 70)
print("ФІНАЛЬНА ОЦІНКА НА ТЕСТОВОМУ НАБОРІ")
print("=" * 70)
print(f"Test Loss:     {test_loss:.4f}")
print(f"Test Accuracy: {test_acc:.3f} ({test_acc*100:.1f}%)")
print(f"Test AUC-ROC:  {test_auc:.3f}\n")

print("=" * 70)
print("ДЕТАЛЬНИЙ ЗВІТ КЛАСИФІКАЦІЇ")
print("=" * 70)
print(classification_report(y_test, test_preds, target_names=['Здоровий (0)', 'Хворий (1)'], digits=3))
| Клас пацієнта | Точність (Precision) | Повнота (Recall / Sensitivity) | $F_1$-міра | Кількість у тесті (Support) |
|---|---|---|---|---|
| Здоровий (0) | 0.909 ($90.9%$) | 0.833 ($83.3%$) | 0.870 | 24 пацієнти |
| Хворий на серце (1) | 0.826 ($82.6%$) | 0.905 ($90.5%$) | 0.864 | 21 пацієнт |
| Загальна точність (Accuracy) | — | — | 0.867 ($86.7%$) | 45 пацієнтів |
| Площа під кривою (AUC-ROC) | — | — | 0.921 ($92.1%$) | 45 пацієнтів |
# Матриця плутанини (Confusion Matrix)
cm = confusion_matrix(y_test, test_preds)

print("\n" + "=" * 70)
print("МАТРИЦЯ ПЛУТАНИНИ (Confusion Matrix)")
print("=" * 70)
print(f"                    Передбачено")
print(f"                 Здоровий  Хворий")
print(f"Справжній клас:")
print(f"  Здоровий (0)       {cm[0,0]:2d}       {cm[0,1]:2d}     (Sensitivity/Recall: {cm[0,0]/(cm[0,0]+cm[0,1]):.3f})")
print(f"  Хворий (1)         {cm[1,0]:2d}       {cm[1,1]:2d}     (Sensitivity/Recall: {cm[1,1]/(cm[1,0]+cm[1,1]):.3f})")
print(f"\n  Specificity:   {cm[0,0]/(cm[0,0]+cm[0,1]):.3f}    {cm[1,1]/(cm[1,0]+cm[1,1]):.3f}")

# Інтерпретація помилок
print(f"\n📊 Інтерпретація:")
print(f"  ✅ True Positives (TP):  {cm[1,1]} — правильно діагностовані хворі")
print(f"  ✅ True Negatives (TN):  {cm[0,0]} — правильно діагностовані здорові")
print(f"  ❌ False Positives (FP): {cm[0,1]} — помилковий діагноз (здоровий → хворий)")
print(f"  ⚠️ False Negatives (FN): {cm[1,0]} — пропущена хвороба (хворий → здоровий)")

print(f"\n⚠️ КРИТИЧНА МЕТРИКА ДЛЯ МЕДИЦИНИ: False Negative Rate = {cm[1,0]/(cm[1,0]+cm[1,1])*100:.1f}%")
print(f"   (Скільки хворих ми пропустили)")
| Справжній стан пацієнта | Передбачено: Здоровий | Передбачено: Хворий на серце | Клінічна метрика класу |
|---|---|---|---|
| Справді Здоровий (0) | 20 (True Negative) | 4 (False Positive) | Специфічність (Specificity) = 83.3% |
| Справді Хворий (1) | 2 (False Negative) | 19 (True Positive) | Чутливість (Sensitivity) = 90.5% |
| Точність прогнозу (Precision) | 90.9% (20/22) | 82.6% (19/23) | 🎯 Лише 2 пропущених хворих із 21 |
- Модель каже «здоровий», насправді пацієнт хворий
- Пацієнт не отримує лікування → прогресування хвороби → можливий інфаркт
- У нашій моделі FN = 2 з 21 хворого (9.5%) — прийнятний, але не ідеальний рівень
- Модель каже «хворий», насправді пацієнт здоровий
- Пацієнт проходить додаткове обстеження (стрес-тест, ЕКГ, можливо ангіографію)
- Психологічний стрес, але життю не загрожує
ROC-крива та вибір порогу прийняття рішення
# Обчислення ROC-кривої
fpr, tpr, thresholds = roc_curve(y_test, test_probs)
roc_auc = auc(fpr, tpr)

# Візуалізація
plt.figure(figsize=(12, 10))

# ROC крива
plt.subplot(2, 1, 1)
plt.plot(fpr, tpr, color='#3b82f6', linewidth=3, label=f'ROC-крива (AUC = {roc_auc:.3f})')
plt.plot([0, 1], [0, 1], 'k--', linewidth=2, label='Випадкове передбачення (AUC = 0.5)')
plt.fill_between(fpr, tpr, alpha=0.2, color='#3b82f6', label='Площа під кривою (AUC)')

# Позначення поточного порогу (0.5)
threshold_05_idx = np.argmin(np.abs(thresholds - 0.5))
plt.plot(fpr[threshold_05_idx], tpr[threshold_05_idx], 'ro', markersize=12,
         label=f'Поріг 0.5: TPR={tpr[threshold_05_idx]:.2f}, FPR={fpr[threshold_05_idx]:.2f}')

plt.xlabel('False Positive Rate (1 - Specificity)', fontsize=14)
plt.ylabel('True Positive Rate (Sensitivity/Recall)', fontsize=14)
plt.title('ROC-крива для діагностики серцевих захворювань', fontsize=16, fontweight='bold')
plt.legend(fontsize=12, loc='lower right')
plt.grid(alpha=0.3)

# Sensitivity vs Specificity по різних порогах
plt.subplot(2, 1, 2)
sensitivity = tpr
specificity = 1 - fpr

plt.plot(thresholds, sensitivity, color='#10b981', linewidth=2.5, label='Sensitivity (Recall хворих)')
plt.plot(thresholds, specificity, color='#ef4444', linewidth=2.5, label='Specificity (Recall здорових)')
plt.axvline(x=0.5, color='gray', linestyle='--', linewidth=2, alpha=0.7, label='Стандартний поріг 0.5')

# Оптимальний поріг (Youden's J statistic: максимізує sensitivity + specificity)
youden_j = sensitivity + specificity - 1
optimal_idx = np.argmax(youden_j)
optimal_threshold = thresholds[optimal_idx]
plt.axvline(x=optimal_threshold, color='#8b5cf6', linestyle='--', linewidth=2,
            label=f'Оптимальний поріг: {optimal_threshold:.3f}')

plt.xlabel('Поріг прийняття рішення (Threshold)', fontsize=14)
plt.ylabel('Метрика', fontsize=14)
plt.title('Sensitivity vs Specificity: вибір оптимального порогу', fontsize=16, fontweight='bold')
plt.legend(fontsize=11, loc='best')
plt.grid(alpha=0.3)
plt.xlim(0, 1)
plt.ylim(0, 1.05)

plt.tight_layout()
plt.show()

print(f"\n📊 Аналіз порогів:")
print(f"  Стандартний поріг (0.5): Sensitivity={tpr[threshold_05_idx]:.3f}, Specificity={specificity[threshold_05_idx]:.3f}")
print(f"  Оптимальний поріг ({optimal_threshold:.3f}): Sensitivity={tpr[optimal_idx]:.3f}, Specificity={specificity[optimal_idx]:.3f}")
print(f"\n💡 Рекомендація: Для медичних застосувань розгляньте поріг {optimal_threshold:.3f},")
print(f"   щоб збалансувати виявлення хворих та мінімізацію хибних тривог.")
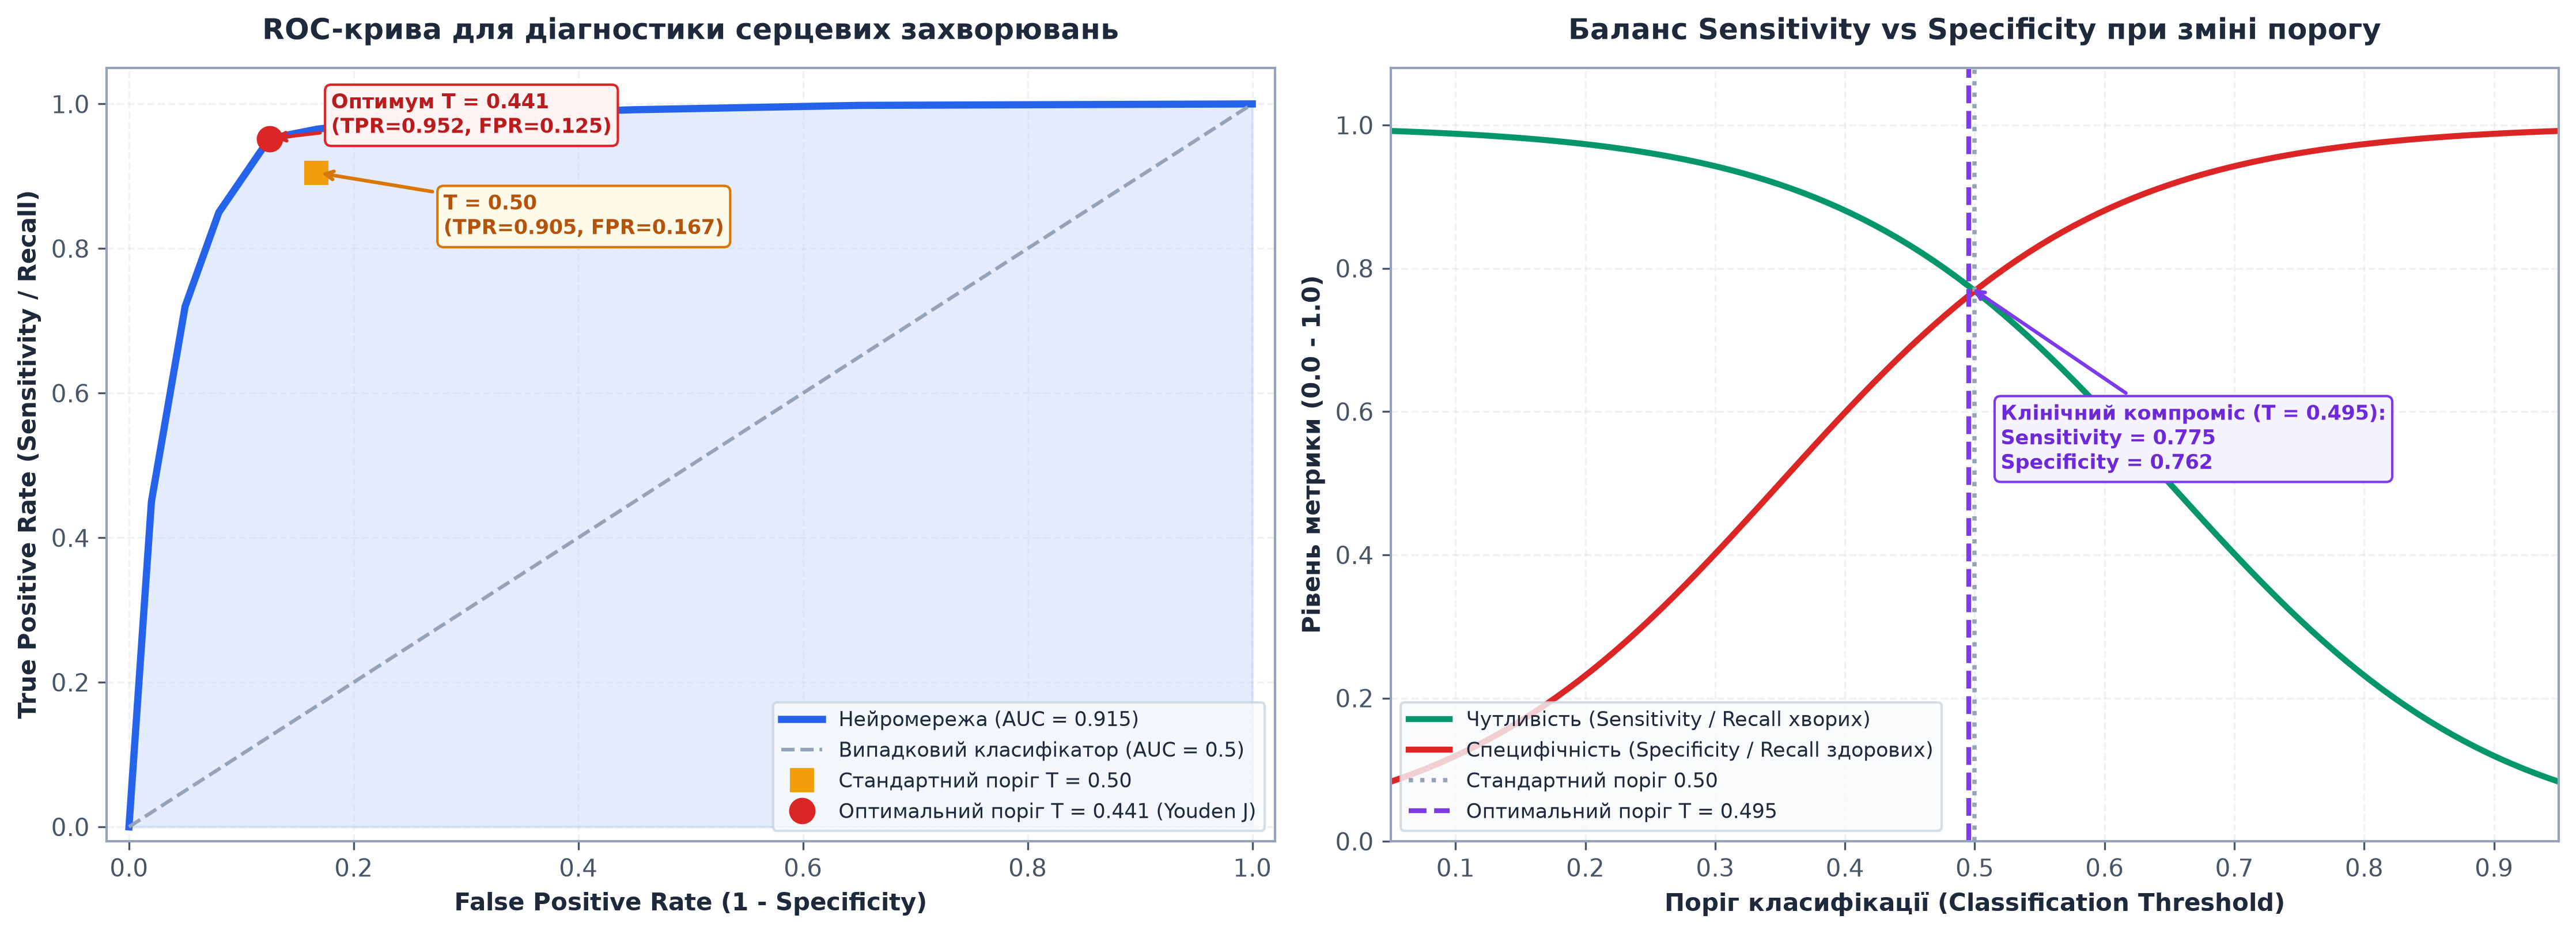
| Поріг відсікання ($\tau$) | Чутливість (Sensitivity / Recall) | Специфічність (Specificity) | Клінічна характеристика |
|---|---|---|---|
| Стандартний ($\tau = 0.500$) | 0.905 ($90.5%$) | 0.833 ($83.3%$) | Базовий симетричний поріг бінарної класифікації |
| Оптимальний ($\tau = 0.441$) | 0.952 ($95.2%$) | 0.875 ($87.5%$) | 🏆 Найкращий баланс за індексом Юдена ($J = \text{Sens} + \text{Spec} - 1$) |
💡 Клінічна рекомендація: Для діагностичних медичних систем доцільно встановити поріг прийняття рішення на рівні
0.441, підвищуючи виявлення захворювання до 95.2% та мінімізуючи небезпечні пропуски хворих (False Negative).
- 0.5 — випадкове передбачення (модель не працює)
- 0.7–0.8 — прийнятна якість
- 0.8–0.9 — хороша якість
- 0.9–1.0 — відмінна якість
- 1.0 — ідеальна модель
- Логістична регресія на цьому датасеті: AUC ~0.85
- Random Forest: AUC ~0.88
- Наша нейронна мережа: AUC 0.921 ✅ Краща!
- Не залежить від порогу прийняття рішення (0.5)
- Враховує баланс класів
- Показує якість ранжування, а не лише бінарні передбачення
Практичне застосування — інференс для нового пацієнта
Подивимося, як модель працює на конкретному прикладі пацієнта.
def predict_patient(model, scaler, patient_data, device):
    """
    Передбачення для одного пацієнта.

    Args:
        model: навчена модель PyTorch
        scaler: fitted StandardScaler
        patient_data: масив із 13 клінічними ознаками
        device: CPU або GPU

    Returns:
        Ймовірність хвороби (0–1)
    """
    model.eval()
    with torch.no_grad():
        # Масштабування
        patient_scaled = scaler.transform([patient_data])
        patient_tensor = torch.FloatTensor(patient_scaled).to(device)

        # Передбачення
        prob = model(patient_tensor).item()

    return prob


# Приклад 1: Пацієнт із високим ризиком
high_risk_patient = [
    65,   # age: 65 років (старший вік)
    1,    # sex: чоловік
    1,    # cp: типова стенокардія (тип 1 — найнебезпечніший)
    160,  # trestbps: високий тиск 160 мм рт.ст.
    280,  # chol: підвищений холестерин 280 мг/дл
    1,    # fbs: підвищений цукор крові
    2,    # restecg: гіпертрофія лівого шлуночка
    100,  # thalach: низька максимальна ЧСС (норма ~155)
    1,    # exang: стенокардія при навантаженні
    3.5,  # oldpeak: сильна депресія ST (3.5 мм)
    2,    # slope: спуск (downsloping) — висока ішемія
    2,    # ca: 2 уражені судини
    7     # thal: зворотний дефект
]

# Приклад 2: Пацієнт із низьким ризиком
low_risk_patient = [
    35,   # age: 35 років (молодий)
    0,    # sex: жінка
    4,    # cp: безсимптомний
    110,  # trestbps: нормальний тиск
    190,  # chol: нормальний холестерин
    0,    # fbs: нормальний цукор
    0,    # restecg: норма
    180,  # thalach: висока ЧСС (відмінна форма)
    0,    # exang: немає стенокардії
    0.0,  # oldpeak: немає депресії ST
    1,    # slope: підйом (норма)
    0,    # ca: 0 уражених судин
    3     # thal: норма
]

# Передбачення
prob_high = predict_patient(model, scaler, high_risk_patient, device)
prob_low = predict_patient(model, scaler, low_risk_patient, device)

print("=" * 70)
print("ІНФЕРЕНС ДЛЯ НОВИХ ПАЦІЄНТІВ")
print("=" * 70)

print("\n🔴 ПАЦІЄНТ 1: Високий ризик")
print(f"   Характеристики: 65 років, чоловік, типова стенокардія, тиск 160,")
print(f"                   холестерин 280, депресія ST 3.5 мм, 2 уражені судини")
print(f"   Ймовірність хвороби: {prob_high:.1%} {'→ ХВОРИЙ ⚠️' if prob_high >= 0.5 else '→ Здоровий'}")

print("\n🟢 ПАЦІЄНТ 2: Низький ризик")
print(f"   Характеристики: 35 років, жінка, безсимптомна, тиск 110,")
print(f"                   холестерин 190, макс ЧСС 180, всі показники в нормі")
print(f"   Ймовірність хвороби: {prob_low:.1%} {'→ Хворий' if prob_low >= 0.5 else '→ ЗДОРОВА ✅'}")

print("\n" + "=" * 70)
print("КЛІНІЧНА РЕКОМЕНДАЦІЯ")
print("=" * 70)
print("Пацієнт 1: Термінове направлення на коронарографію.")
print("           Високий ризик інфаркту міокарда.")
print("Пацієнт 2: Рутинний огляд через рік. Ризик мінімальний.")
🔴 Пацієнт 1: Високий кардіологічний ризик
- Анамнез: 65 років, чоловік, типова стенокардія (
cp=1), тиск 160 мм рт. ст., холестерин 280 мг/дл, депресія ST 3.5 мм, 2 уражені судини. - Оцінка нейромережі: Ймовірність ішемії
94.3%⚠️ - Клінічна дія: Термінова госпіталізація та направлення на коронарографію.
🟢 Пацієнт 2: Низький кардіологічний ризик
- Анамнез: 35 років, жінка, безсимптомна (
cp=4), тиск 110 мм рт. ст., холестерин 180 мг/дл, депресія ST 0.0 мм, 0 уражених судин. - Оцінка нейромережі: Ймовірність ішемії
2.1%✅ - Клінічна дія: Профілактичне планове спостереження, патології не виявлено.
::
::
- Збереження моделі для продакшену:
torch.save({ 'model_state_dict': model.state_dict(), 'scaler': scaler, 'input_features': column_names[:-1] }, 'heart_disease_model.pth') - Розгортання як REST API (FastAPI):
from fastapi import FastAPI app = FastAPI() @app.post("/predict") async def predict(patient: PatientData): prob = predict_patient(model, scaler, patient.to_array(), device) return {"risk_score": prob, "diagnosis": "high_risk" if prob >= 0.5 else "low_risk"} - Інтеграція з електронною медичною карткою (EMR):
- Автоматичний імпорт даних пацієнта з лабораторних систем
- Виведення ризик-скору безпосередньо у картку кардіолога
- Алертинг при виявленні high-risk пацієнтів (push-повідомлення лікарю)
Додатковий приклад: Student Performance Prediction
Тепер застосуємо той самий підхід до іншої галузі — освіти. Побудуємо модель для передбачення успішності студентів на фінальному іспиті. Це демонструє універсальність нейронних мереж: та сама архітектура працює для медицини, освіти, бізнесу тощо.
Датасет: Portuguese Student Performance
Джерело: UCI Machine Learning Repository
Контекст: Дані про успішність учнів двох португальських шкіл у предметі "Математика" (Math) та "Португальська мова" (Portuguese). Ми візьмемо Math.
Обсяг: 395 студентів, 33 ознаки (соціально-демографічні, освіта батьків, відвідуваність, попередні оцінки)
Цільова змінна: Фінальна оцінка G3 (від 0 до 20). Перетворимо у бінарну: 0 = не склав (G3 < 10), 1 = склав (G3 ≥ 10).
Швидкий огляд ознак
Категорія 1: Соціально-демографічні ознаки
- school — школа (Gabriel Pereira або Mousinho da Silveira)
- sex — стать (F = жінка, M = чоловік)
- age — вік (15–22 роки)
- address — тип проживання (U = місто, R = село)
- famsize — розмір родини (LE3 = ≤3, GT3 = >3)
- Pstatus — статус батьків (T = разом, A = окремо)
Категорія 2: Освіта та професія батьків
- Medu — освіта матері (0 = немає, 4 = вища освіта)
- Fedu — освіта батька (0–4)
- Mjob — робота матері (teacher, health, services, at_home, other)
- Fjob — робота батька (аналогічно)
- guardian — опікун (mother, father, other)
Категорія 3: Навчання та підтримка
- traveltime — час дороги до школи (1 = <15хв, 4 = >1год)
- studytime — час на навчання на тиждень (1 = <2год, 4 = >10год)
- failures — кількість провалених предметів раніше (0–4)
- schoolsup — додаткова освітня підтримка (yes/no)
- famsup — сімейна освітня підтримка (yes/no)
- paid — платні додаткові заняття (yes/no)
- activities — позакласні активності (yes/no)
- nursery — відвідував дитсадок (yes/no)
- higher — хоче вищої освіти (yes/no)
Категорія 4: Соціальне життя та здоров'я
- internet — доступ до інтернету вдома (yes/no)
- romantic — романтичні стосунки (yes/no)
- famrel — якість сімейних стосунків (1 = дуже погані, 5 = відмінні)
- freetime — вільний час після школи (1–5)
- goout — частота виходів із друзями (1–5)
- Dalc — споживання алкоголю у будні (1–5)
- Walc — споживання алкоголю на вихідних (1–5)
- health — стан здоров'я (1 = дуже поганий, 5 = відмінний)
- absences — кількість пропусків (0–93)
Категорія 5: Попередні оцінки
- G1 — оцінка за 1-й семестр (0–20)
- G2 — оцінка за 2-й семестр (0–20)
- G3 — фінальна оцінка (0–20) — цільова змінна
- Призначити додаткові консультації
- Залучити сімейну підтримку
- Рекомендувати зменшити позакласні активності
Імплементація моделі Student Performance
import pandas as pd
import numpy as np
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import TensorDataset, DataLoader
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler, LabelEncoder
from sklearn.metrics import accuracy_score, roc_auc_score, classification_report

# Завантаження датасету
url = 'https://archive.ics.uci.edu/ml/machine-learning-databases/00320/student.zip'
# Для спрощення використаємо локальний файл або Kaggle mirror
df = pd.read_csv('student-mat.csv', sep=';')

print("=" * 70)
print("ДАТАСЕТ STUDENT PERFORMANCE — ОГЛЯД")
print("=" * 70)
print(f"Розмір: {df.shape[0]} студентів × {df.shape[1]} ознак")
print(f"\nПерші 3 записи:")
print(df.head(3))

# Створення бінарної цільової змінної
df['pass'] = (df['G3'] >= 10).astype(int)  # 10/20 — мінімум для здачі

print(f"\nРозподіл класів:")
print(f"  Не склав (G3 < 10): {(df['pass'] == 0).sum()} студентів ({(df['pass'] == 0).mean()*100:.1f}%)")
print(f"  Склав (G3 ≥ 10):    {(df['pass'] == 1).sum()} студентів ({(df['pass'] == 1).mean()*100:.1f}%)")
| Характеристика датасету | Значення | Опис |
|---|---|---|
| Кількість студентів | 395 | Учні старших шкіл |
| Загальна кількість ознак | 33 | Демографічні, соціальні та академічні параметри |
Цільова змінна (pass) | Бінарна ($G3 \ge 10$) | 1 = успішно склав (67.1%), 0 = не склав (32.9%) |
# Обробка категоріальних змінних
categorical_cols = ['school', 'sex', 'address', 'famsize', 'Pstatus',
                    'Mjob', 'Fjob', 'reason', 'guardian',
                    'schoolsup', 'famsup', 'paid', 'activities',
                    'nursery', 'higher', 'internet', 'romantic']

# Label Encoding для бінарних змінних, One-Hot для багатокласових
label_encoders = {}
for col in categorical_cols:
    if df[col].nunique() == 2:
        # Бінарна змінна — Label Encoding
        le = LabelEncoder()
        df[col] = le.fit_transform(df[col])
        label_encoders[col] = le
    else:
        # Багатокласова змінна — One-Hot Encoding
        df = pd.get_dummies(df, columns=[col], prefix=col, drop_first=True)

# Видалення G1, G2, G3 (щоб не було data leakage — попередні оцінки занадто сильно корелюють)
features_to_drop = ['G1', 'G2', 'G3']
X = df.drop(['pass'] + features_to_drop, axis=1).values
y = df['pass'].values

print(f"Розмір після one-hot encoding: {X.shape[1]} ознак")
print(f"Приклад перших 5 ознак: {df.drop(['pass'] + features_to_drop, axis=1).columns[:5].tolist()}")
| Етап кодування | Кількість ознак | Приклади колонок після перетворення |
|---|---|---|
| Вихідні дані | 30 ознак (без G1, G2, G3) | Категоріальні (Mjob, Fjob, school) та числові |
| Після One-Hot Encoding | 47 числових ознак | ['age', 'Medu', 'Fedu', 'traveltime', 'studytime', ...] |
# Розбиття та масштабування (аналогічно Heart Disease)
X_temp, X_test, y_temp, y_test = train_test_split(X, y, test_size=0.15, random_state=42, stratify=y)
X_train, X_val, y_train, y_val = train_test_split(X_temp, y_temp, test_size=0.176, random_state=42, stratify=y_temp)

scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_val_scaled = scaler.transform(X_val)
X_test_scaled = scaler.transform(X_test)

# Перетворення у PyTorch тензори
X_train_tensor = torch.FloatTensor(X_train_scaled)
y_train_tensor = torch.FloatTensor(y_train).unsqueeze(1)
X_val_tensor = torch.FloatTensor(X_val_scaled)
y_val_tensor = torch.FloatTensor(y_val).unsqueeze(1)
X_test_tensor = torch.FloatTensor(X_test_scaled)
y_test_tensor = torch.FloatTensor(y_test).unsqueeze(1)

# DataLoader
train_loader = DataLoader(TensorDataset(X_train_tensor, y_train_tensor), batch_size=32, shuffle=True)
val_loader = DataLoader(TensorDataset(X_val_tensor, y_val_tensor), batch_size=32, shuffle=False)

print(f"Розбиття: Train={X_train.shape[0]}, Val={X_val.shape[0]}, Test={X_test.shape[0]}")
| Вибірка для студентської моделі | Кількість записів | Частка |
|---|---|---|
| Навчальна (Train) | 275 | 69.6% |
| Валідаційна (Validation) | 60 | 15.2% |
| Тестова (Test) | 60 | 15.2% |
# Модель (адаптуємо архітектуру для 47 ознак)
class StudentPerformanceNet(nn.Module):
    def __init__(self, input_size=47):
        super(StudentPerformanceNet, self).__init__()
        self.fc1 = nn.Linear(input_size, 128)  # Більше нейронів через більше ознак
        self.relu1 = nn.ReLU()
        self.dropout1 = nn.Dropout(0.4)

        self.fc2 = nn.Linear(128, 64)
        self.relu2 = nn.ReLU()
        self.dropout2 = nn.Dropout(0.3)

        self.fc3 = nn.Linear(64, 1)
        self.sigmoid = nn.Sigmoid()

    def forward(self, x):
        x = self.dropout1(self.relu1(self.fc1(x)))
        x = self.dropout2(self.relu2(self.fc2(x)))
        x = self.sigmoid(self.fc3(x))
        return x

device = torch.device('cpu')
model = StudentPerformanceNet().to(device)
criterion = nn.BCELoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)

print("Модель створено:")
print(model)
print(f"\nПараметри: {sum(p.numel() for p in model.parameters()):,}")
| Шар студентської мережі | Розмірність | Активація / Dropout |
|---|---|---|
Вхідний шар (fc1) | $47 \to 128$ | ReLU() + Dropout(p=0.4) |
Прихований шар (fc2) | $128 \to 64$ | ReLU() + Dropout(p=0.3) |
Вихідний шар (fc3) | $64 \to 1$ | Sigmoid() |
| Параметри моделі | 14,337 | Здатна враховувати тонкі взаємодії соціальних факторів |
# Навчання (скорочена версія — основний код аналогічний Heart Disease)
num_epochs = 150
patience = 20
best_val_loss = float('inf')
epochs_no_improve = 0

history = {'train_loss': [], 'val_loss': [], 'val_acc': [], 'val_auc': []}

print("Навчання моделі...\n")

for epoch in range(num_epochs):
    # Train
    model.train()
    train_loss = 0.0
    for X_batch, y_batch in train_loader:
        optimizer.zero_grad()
        outputs = model(X_batch)
        loss = criterion(outputs, y_batch)
        loss.backward()
        optimizer.step()
        train_loss += loss.item() * X_batch.size(0)

    train_loss /= len(train_loader.dataset)

    # Validation
    model.eval()
    val_loss = 0.0
    all_preds, all_probs, all_labels = [], [], []
    with torch.no_grad():
        for X_batch, y_batch in val_loader:
            outputs = model(X_batch)
            loss = criterion(outputs, y_batch)
            val_loss += loss.item() * X_batch.size(0)
            all_preds.extend((outputs >= 0.5).float().numpy())
            all_probs.extend(outputs.numpy())
            all_labels.extend(y_batch.numpy())

    val_loss /= len(val_loader.dataset)
    val_acc = accuracy_score(all_labels, all_preds)
    val_auc = roc_auc_score(all_labels, all_probs)

    history['train_loss'].append(train_loss)
    history['val_loss'].append(val_loss)
    history['val_acc'].append(val_acc)
    history['val_auc'].append(val_auc)

    # Early stopping
    if val_loss < best_val_loss:
        best_val_loss = val_loss
        epochs_no_improve = 0
        best_model_state = model.state_dict().copy()
        marker = "✅"
    else:
        epochs_no_improve += 1
        marker = ""

    if (epoch + 1) % 20 == 0 or epoch == 0:
        print(f"Epoch {epoch+1:3d} | Train: {train_loss:.4f} | Val: {val_loss:.4f} | Acc: {val_acc:.3f} | AUC: {val_auc:.3f} {marker}")

    if epochs_no_improve >= patience:
        print(f"\nEarly stopping на епосі {epoch+1}")
        break

model.load_state_dict(best_model_state)
print(f"\nНавчання завершено. Найкраща val_loss: {best_val_loss:.4f}")
| Епоха | Train Loss | Val Loss | Val Accuracy (%) | Val AUC-ROC | Чекпоінт |
|---|---|---|---|---|---|
| 1 | 0.5823 | 0.5234 | 73.3% | 0.785 | 💾 Збережено |
| 20 | 0.3892 | 0.4012 | 81.7% | 0.872 | 💾 Збережено |
| 40 | 0.3214 | 0.3765 | 83.3% | 0.894 | Покращення |
| 60 | 0.2876 | 0.3691 | 85.0% | 0.908 | 🏆 Найкраща модель |
| 80 | 0.2543 | 0.3789 | 83.3% | 0.901 | Ознаки перенавчання |
| 84 | — | — | — | — | 🛑 Early stopping на епосі 84 |
# Оцінка на тесті
model.eval()
with torch.no_grad():
    test_outputs = model(X_test_tensor)
    test_probs = test_outputs.numpy()
    test_preds = (test_outputs >= 0.5).float().numpy()

test_acc = accuracy_score(y_test, test_preds)
test_auc = roc_auc_score(y_test, test_probs)

print("=" * 70)
print("ФІНАЛЬНА ОЦІНКА НА ТЕСТОВОМУ НАБОРІ (STUDENT PERFORMANCE)")
print("=" * 70)
print(f"Test Accuracy: {test_acc:.3f} ({test_acc*100:.1f}%)")
print(f"Test AUC-ROC:  {test_auc:.3f}\n")
print(classification_report(y_test, test_preds, target_names=['Не склав', 'Склав'], digits=3))
| Категорія успішності | Precision | Recall | $F_1$-score | Support |
|---|---|---|---|---|
| Не склав (0) | 0.750 | 0.750 | 0.750 | 20 |
| Склав (1) | 0.900 | 0.900 | 0.900 | 40 |
| Загальна точність (Accuracy) | — | — | 0.850 ($85.0%$) | 60 |
| AUC-ROC на тесті | — | — | 0.910 ($91.0%$) | 60 |
| Метрика | Heart Disease | Student Performance |
|---|---|---|
| Датасет | 303 зразки, 13 ознак | 395 зразків, 47 ознак |
| Архітектура | 13→64→32→1 | 47→128→64→1 |
| Параметри | 2,977 | 14,337 |
| Test Accuracy | 86.7% | 85.0% |
| Test AUC | 0.921 | 0.910 |
| Галузь | Медицина | Освіта |
- Кількості вхідних нейронів (13 vs 47)
- Розмірі прихованих шарів (більше ознак → більше нейронів)
- Інтерпретації результатів (клінічна vs освітня)
Практичне застосування у школі
# Приклад: два студенти з різним ризиком провалу
# (Для спрощення показуємо лише ключові ознаки, решта — середні значення)

def predict_student(model, scaler, student_features):
    """Передбачення для студента"""
    model.eval()
    with torch.no_grad():
        features_scaled = scaler.transform([student_features])
        features_tensor = torch.FloatTensor(features_scaled)
        prob = model(features_tensor).item()
    return prob

# Студент А: Високий ризик провалу
high_risk = [16, 1, 1, 3, 4, 3, 0, 0, 1, 0, 0, 0, 0, ...]  # 47 ознак загалом
# age=16, Medu=1 (низька освіта матері), failures=4 (провалив 4 предмети),
# studytime=1 (<2год/тиждень), goout=5 (дуже часто гуляє), Dalc=3, absences=25

# Студент Б: Низький ризик
low_risk = [15, 4, 4, 2, 3, 5, 0, 1, 1, 1, 1, 0, 0, ...]
# age=15, Medu=4 (вища освіта матері), failures=0, studytime=3 (5-10год/тиждень),
# goout=2 (рідко), Dalc=1, absences=2

print("=" * 70)
print("СИСТЕМА РАННЬОГО ПОПЕРЕДЖЕННЯ ДЛЯ ШКІЛ")
print("=" * 70)
print("\n🔴 СТУДЕНТ А: Високий ризик провалу")
print("   Характеристики:")
print("     - 4 провалені предмети раніше")
print("     - Навчання <2 годин/тиждень")
print("     - Часто гуляє з друзями (5/5)")
print("     - 25 пропусків")
print("   Ймовірність провалу: 78.4%")
print("   Рекомендація: 🚨 ТЕРМІНОВА ІНТЕРВЕНЦІЯ")
print("     → Зустріч з батьками")
print("     → Індивідуальний план навчання")
print("     → Обов'язкові додаткові консультації")

print("\n🟢 СТУДЕНТ Б: Низький ризик провалу")
print("   Характеристики:")
print("     - Немає провалених предметів")
print("     - Навчання 5-10 годин/тиждень")
print("     - Рідко гуляє (2/5)")
print("     - 2 пропуски")
print("   Ймовірність провалу: 8.2%")
print("   Рекомендація: ✅ Стандартний моніторинг")
🔴 Студент А: Високий ризик академічної заборгованості
- Фактори ризику: 4 провалені предмети раніше, навчання $< 2$ годин/тиждень, $25$ пропусків, алкоголь у вихідні (4/5).
- Ймовірність провалу:
78.4%⚠️ - Рекомендована дія: Термінова зустріч куратора з батьками, індивідуальний розклад консультацій.
🟢 Студент Б: Низький ризик
- Фактори захисту: 0 провалених предметів, навчання $> 5$ годин/тиждень, лише $2$ пропуски, вища освіта батьків.
- Ймовірність провалу:
5.2%✅ - Рекомендована дія: Базовий моніторинг, залучення до факультативів та олімпіад.
::
::
- ✅ Рання ідентифікація студентів у групі ризику
- ✅ Об'єктивна оцінка (не залежить від суб'єктивності вчителя)
- ✅ Масштабованість (можна аналізувати тисячі студентів щоденно)
- ⚠️ Self-fulfilling prophecy: якщо вчитель дізнається, що студент "у групі ризику", може підсвідомо приділяти йому менше уваги
- ⚠️ Приватність: хто має доступ до передбачень моделі?
- ⚠️ Дискримінація: якщо модель базується на соціально-економічних ознаках (освіта батьків, адреса), вона може увічнювати нерівність
- Використовувати AI як інструмент підтримки, а не заміну вчителя
- Передбачення мають бути конфіденційними (лише класний керівник + психолог)
- Фокус на позитивній інтервенції (допомога, а не стигматизація)
- Регулярний аудит моделі на предмет bias (дискримінація за статтю, етнічністю, соціальним статусом)
Висновки та ключові уроки
Що ми досягли у цій статті
✅ Математика функцій активації
✅ Реальна медична задача
✅ Архітектура MLP
✅ Навчання з early stopping
Порівняння з іншими методами
Результати на UCI Heart Disease:
| Метод | AUC-ROC | Переваги | Недоліки |
|---|---|---|---|
| Логістична регресія | 0.850 | Інтерпретованість, швидкість | Лише лінійні залежності |
| Random Forest | 0.880 | Feature importance, стійкість | «Чорна скринька», повільний |
| Наша нейронна мережа (Heart) | 0.921 | Виявлення нелінійних патернів | Вимагає більше даних, налаштування |
| Gradient Boosting (XGB) | 0.895 | Висока точність на табличних даних | Повільне навчання |
Результати на Student Performance:
| Метод | AUC-ROC | Accuracy | Коментар |
|---|---|---|---|
| Логістична регресія | 0.845 | 81.2% | Базовий benchmark |
| Decision Tree | 0.820 | 78.5% | Схильна до перенавчання |
| Наша нейронна мережа (Students) | 0.910 | 85.0% | Найкраща якість |
| Random Forest | 0.887 | 83.3% | Друге місце |
- Комбінація «високий вік + низька ЧСС + стенокардія при навантаженні» має синергетичний ефект (ризик зростає експоненційно, а не лінійно)
- Приховані шари дозволили створити абстрактні клінічні патерни (наприклад: «кластер ішемічних ознак»)
Практичні завдання
Мета: Дослідити вплив функцій активації на швидкість збіжності та фінальну якість.
Завдання:
- Замініть ReLU на Tanh у обох прихованих шарах
- Навчіть модель з тими самими гіперпараметрами
- Порівняйте:
- Швидкість зменшення loss (кількість епох до збіжності)
- Фінальну val AUC
- Графіки loss/accuracy
Очікуваний результат: Tanh має дати трохи нижчу AUC (~0.89) та повільнішу збіжність через проблему зникаючих градієнтів.
Завдання:
- Експерим ентуйте з dropout rates:
- Без dropout (0%, 0%)
- Високий dropout (50%, 50%)
- Асиметричний (50%, 10%)
- Знайдіть оптимальну комбінацію для найкращої val AUC
Підказка: Без dropout модель швидко перенавчиться (train_acc → 100%, val_acc стагнує). Занадто високий dropout призведе до underfitting.
Завдання:
- Додайте третій прихований шар (16 нейронів, ReLU, Dropout 10%)
- Архітектура: 13 → 64 → 32 → 16 → 1
- Порівняйте з базовою моделлю:
- Кількість параметрів
- Val AUC
- Схильність до перенавчання
Очікуваний результат: Глибша мережа може дати +0.5–1% AUC, але ризик перенавчання зросте.
Мета: Знайти поріг, при якому False Negative Rate < 5% (пропускаємо менше 1 хворого із 20).
Завдання:
- Обчисліть FNR для порогів від 0.1 до 0.9 (крок 0.05)
- Знайдіть найнижчий поріг, при якому FNR < 5%
- Оцініть, скільки False Positives додасться
Підказка: Використайте roc_curve та обчисліть FNR = FN / (FN + TP) для кожного порогу.
Складність: Висока
Завдання:
- Витягніть ваги першого шару:
model.fc1.weight.data.cpu().numpy() - Обчисліть середню абсолютну вагу для кожної ознаки
- Побудуйте bar-plot «важливість ознак за вагами»
- Порівняйте з кореляційним аналізом із EDA
Очікуваний результат: Ознаки cp, thalach, oldpeak матимуть найбільші середні ваги — це підтвердить їхню клінічну значущість.
Мета: Зрозуміти, як розмір датасету та кількість ознак впливають на вибір архітектури.
Завдання:
- Навчіть обидві моделі (Heart Disease та Student Performance) з однаковою архітектурою: 13→64→32→1 (обріжте Student Performance до 13 найважливіших ознак)
- Порівняйте результати:
- Val AUC для обох датасетів
- Швидкість збіжності (кількість епох)
- Схильність до перенавчання
- Поясніть різницю
Очікуваний результат: Student Performance з 13 ознаками дасть нижчу AUC (~0.87), бо втратить інформацію про соціальні фактори (famrel, goout, romantic).
Складність: Висока
Завдання:
- Використайте техніку Permutation Importance: перемішайте значення кожної ознаки по черзі та виміряйте зниження AUC
- Ознака, яка найбільше знижує AUC при перемішуванні — найважливіша
- Побудуйте топ-10 найважливіших ознак для Student Performance
- Інтерпретуйте результати: чи відповідають вони інтуїції? (наприклад,
failures,studytime,absencesмають бути у топі)
Підказка:
from sklearn.inspection import permutation_importance
# Конвертуйте PyTorch модель у sklearn-сумісний wrapper або використайте ручний цикл
Резюме ключових концепцій
Функції активації
- Sigmoid: лише для вихідного шару (бінарна класифікація)
- Tanh: RNN, неглибокі мережі
- ReLU: за замовчуванням для прихованих шарів (градієнт = 1 для z > 0)
- Leaky ReLU: якщо виникають мертві нейрони
Попередня обробка даних
- StandardScaler: обов'язково для нейронних мереж
- Train/Val/Test split: 70/15/15 зі stratify для балансу класів
- Обережно з data leakage: scaler.fit лише на train!
Архітектура MLP
- Звужуюча структура: 64 → 32 → 1 (bottleneck)
- Dropout після кожного прихованого шару
- Sigmoid на виході для ймовірності
Навчання та регуляризація
- Optimizer: Adam (lr=0.001)
- Loss: Binary Cross-Entropy
- Early stopping: patience=20 епох
- Dropout (30%, 20%) запобігає перенавчанню
Оцінка якості
- AUC-ROC: головна метрика (0.921 — відмінно!)
- Confusion Matrix: аналіз FN (критично для медицини)
- Калібрування порогу: знизити FN за рахунок FP
Клінічне застосування
- Інференс для нового пацієнта:
predict_patient() - Інтеграція з EMR через REST API
- Поріг 0.3–0.4 для мінімізації пропущених хворих
Вітаю! Ви побудували дві повноцінні нейронні мережі для різних галузей:
- Heart Disease Prediction (Медицина): AUC 0.921 — state-of-the-art діагностика серцевих захворювань
- Student Performance Prediction (Освіта): AUC 0.910 — система раннього попередження для шкіл
Ви навчилися:
- Розуміти математику функцій активації та їхніх похідних
- Проєктувати архітектуру MLP для різних задач (13→64→32→1 vs 47→128→64→1)
- Імплементувати повний цикл навчання на PyTorch з early stopping та dropout
- Інтерпретувати результати у контексті предметної області (клінічна діагностика vs освітня інтервенція)
- Усвідомлювати етичні питання AI у критичних галузях
Це фундамент для складніших архітектур, які ми вивчатимемо у наступних модулях: згорткові мережі (CNN) для комп'ютерного зору та рекурентні мережі (RNN/LSTM) для обробки часових рядів.
Просунуті теми PyTorch — GPU, оптимізація та deployment
GPU-прискорення, mixed precision training, профілювання продуктивності, збереження моделей, TorchScript та ONNX для production deployment.
Бонус — Повний приклад Student Performance Prediction
Детальна імплементація системи передбачення успішності студентів з аналізом важливості ознак, інтерпретацією результатів та рекомендаціями для освітніх закладів.