Побудова та тренування нейронних мереж у PyTorch
🎯 Мета статті
- Навчитися будувати нейронні мережі через
nn.Module - Розібратися у різних способах побудови архітектур
- Опанувати функції втрат для регресії та класифікації
- Вивчити оптимізатори та їх гіперпараметри
- Реалізувати повний цикл тренування з валідацією
- Застосувати early stopping та model checkpointing
🔑 Ключові концепції
- nn.Module — базовий клас для всіх нейронних мереж
- Forward pass — обчислення передбачень моделі
- Backward pass — обчислення градієнтів через backpropagation
- Loss function — функція втрат для оцінки помилки моделі
- Optimizer — алгоритм оновлення параметрів (SGD, Adam)
- Training loop — цикл тренування моделі через епохи та батчі
Вступ: «Чистий» PyTorch vs nn.Module
У попередній статті ми навчилися обчислювати градієнти та реалізували просту лінійну регресію «з нуля» — вручну визначаючи параметри, forward pass та gradient descent loop. Це дало глибоке розуміння того, як працює навчання нейронних мереж.
Але уявіть, що потрібно побудувати мережу з 10 шарами, dropout, batch normalization та skip connections. Код на «чистому» PyTorch перетвориться на сотні рядків з високим ризиком помилок.
Рішення: модуль torch.nn — високорівневий API для побудови нейронних мереж.
import torch

# Вручну визначаємо параметри
w1 = torch.randn(10, 20, requires_grad=True)
b1 = torch.randn(20, requires_grad=True)
w2 = torch.randn(20, 1, requires_grad=True)
b2 = torch.randn(1, requires_grad=True)

# Forward pass вручну
def forward(X):
    h = X @ w1 + b1
    h = torch.relu(h)
    y = h @ w2 + b2
    return y

X = torch.randn(32, 10)
y_pred = forward(X)
print(f"Вихід: {y_pred.shape}")
| Зразок батчу | Вхідна розмірність $X$ | Вихід моделі $\hat{y}$ | Форма виходу |
|---|---|---|---|
| Батч з 32 зразків | torch.Size([32, 10]) | Вектор скалярних прогнозів | torch.Size([32, 1]) |
import torch
import torch.nn as nn

class SimpleNetwork(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(10, 20)
        self.fc2 = nn.Linear(20, 1)

    def forward(self, X):
        h = torch.relu(self.fc1(X))
        y = self.fc2(h)
        return y

model = SimpleNetwork()
X = torch.randn(32, 10)
y_pred = model(X)
print(f"Вихід: {y_pred.shape}")
print(f"Кількість параметрів: {sum(p.numel() for p in model.parameters())}")
| Модель | Форма виходу | Кількість параметрів, що навчаються | Перевага підходу |
|---|---|---|---|
LinearRegressionNN (nn.Module) | torch.Size([32, 1]) | 241 ($10 \times 20 + 20 + 20 \times 1 + 1$) | Автоматичний менеджмент ваг та зміщень |
Аналогія: «Чистий» PyTorch — це як збирати комп'ютер з окремих компонентів (процесор, пам'ять, материнська плата).
nn.Module— це готові блоки (відеокарта вже зібрана), які достатньо підключити один до одного.
- ✅ Автоматична реєстрація параметрів
- ✅ Методи
.parameters(),.state_dict()для збереження - ✅ Підтримка GPU через
.to(device) - ✅ Режими
.train()та.eval() - ✅ Вкладені модулі (композиція архітектур)
Частина 1: Побудова нейронних мереж з nn.Module
Анатомія nn.Module
Будь-яка модель у PyTorch має два обов'язкові методи:
__init__()— визначення архітектури (шари, параметри)forward()— обчислення виходу (forward pass)
import torch
import torch.nn as nn

class MyFirstNetwork(nn.Module):
    def __init__(self, input_size, hidden_size, output_size):
        super().__init__()  # Обов'язково викликати конструктор батьківського класу!

        # Визначаємо шари
        self.fc1 = nn.Linear(input_size, hidden_size)
        self.relu = nn.ReLU()
        self.fc2 = nn.Linear(hidden_size, output_size)

    def forward(self, x):
        # Описуємо forward pass
        x = self.fc1(x)
        x = self.relu(x)
        x = self.fc2(x)
        return x

# Створення екземпляра моделі
model = MyFirstNetwork(input_size=10, hidden_size=20, output_size=1)

# Виклик моделі (автоматично викликає forward)
X = torch.randn(5, 10)  # батч з 5 прикладів
output = model(X)

print(f"Вхід: {X.shape}")
print(f"Вихід: {output.shape}")
| Вхідні дані $X$ | Архітектура | Функція активації | Вихід $\hat{y}$ |
|---|---|---|---|
torch.Size([5, 10]) | $10 \to 20 \to 1$ | ReLU | torch.Size([5, 1]) |
super().__init__()?Це ініціалізує внутрішні механізми PyTorch для відстеження параметрів, режимів тренування/eval та інших функцій. Без цього виклику модель не працюватиме коректно.Корисні методи nn.Module
import torch
import torch.nn as nn

model = MyFirstNetwork(10, 20, 1)

# Отримання всіх параметрів
print("Всі параметри:")
for name, param in model.named_parameters():
    print(f"  {name}: {param.shape}")
| Назва параметра | Форма тензора ваг | Кількість параметрів | Роль у шарі |
|---|---|---|---|
fc1.weight | torch.Size([20, 10]) | $200$ | Матриця ваг першого шару |
fc1.bias | torch.Size([20]) | $20$ | Вектор зміщень першого шару |
fc2.weight | torch.Size([1, 20]) | $20$ | Матриця ваг вихідного шару |
fc2.bias | torch.Size([1]) | $1$ | Скаляр зміщення вихідного шару |
# Загальна кількість параметрів
total_params = sum(p.numel() for p in model.parameters())
print(f"Загальна кількість параметрів: {total_params}")

# Кількість параметрів, що навчаються
trainable_params = sum(p.numel() for p in model.parameters() if p.requires_grad)
print(f"Параметри, що навчаються: {trainable_params}")
| Категорія параметрів | Кількість | Відсоток від загальної |
|---|---|---|
Параметри, що навчаються (requires_grad=True) | 241 | 100% |
Заморожені параметри (requires_grad=False) | 0 | 0% |
| Загальна кількість параметрів моделі | 241 | 100% |
# state_dict — словник усіх параметрів
print("State dict:")
for key, value in model.state_dict().items():
    print(f"  {key}: {value.shape}")
Ключ словника state_dict | Форма збереженого тензора | Тип даних |
|---|---|---|
'fc1.weight' | torch.Size([20, 10]) | torch.float32 |
'fc1.bias' | torch.Size([20]) | torch.float32 |
'fc2.weight' | torch.Size([1, 20]) | torch.float32 |
'fc2.bias' | torch.Size([1]) | torch.float32 |
Основні шари (Layers)
PyTorch надає готові реалізації найпопулярніших шарів:
nn.Linear — повнозв'язний шар
import torch
import torch.nn as nn

# Linear(in_features, out_features)
# Виконує операцію: y = xW^T + b
layer = nn.Linear(in_features=10, out_features=5)

X = torch.randn(3, 10)  # батч з 3 прикладів
output = layer(X)

print(f"Вхід: {X.shape}")
print(f"Вага: {layer.weight.shape}")  # (out, in)
print(f"Зміщення: {layer.bias.shape}")
print(f"Вихід: {output.shape}")
Компонент шару nn.Linear(10, 5) | Розмірність | Формула перетворення |
|---|---|---|
| Вхідний батч $X$ | torch.Size([3, 10]) | $3$ зразки по $10$ ознак |
| Матриця ваг $W$ | torch.Size([5, 10]) | $W \in \mathbb{R}^{5 \times 10}$ |
| Вектор зміщень $b$ | torch.Size([5]) | $b \in \mathbb{R}^{5}$ |
| Вихід $Y = XW^T + b$ | torch.Size([3, 5]) | Лінійна проєкція у 5-вимірний простір |
Функції активації
import torch
import torch.nn as nn

x = torch.tensor([-2.0, -1.0, 0.0, 1.0, 2.0])

# ReLU: max(0, x)
relu = nn.ReLU()
print(f"ReLU: {relu(x)}")

# LeakyReLU: max(0.01x, x)
leaky_relu = nn.LeakyReLU(negative_slope=0.01)
print(f"LeakyReLU: {leaky_relu(x)}")

# Sigmoid: 1 / (1 + e^(-x))
sigmoid = nn.Sigmoid()
print(f"Sigmoid: {sigmoid(x)}")

# Tanh: (e^x - e^(-x)) / (e^x + e^(-x))
tanh = nn.Tanh()
print(f"Tanh: {tanh(x)}")
| Функція активації | Вхід $x = -2, -1, 0, 1, 2$ | Вихід $f(x)$ | Поведінка для $x < 0$ |
|---|---|---|---|
nn.ReLU() | [-2., -1., 0., 1., 2.] | tensor([0., 0., 0., 1., 2.]) | Повне обнулення ($0.0$) |
nn.LeakyReLU(0.01) | [-2., -1., 0., 1., 2.] | tensor([-0.02, -0.01, 0.00, 1.00, 2.00]) | Невеликий нахил ($0.01x$) проти dying ReLU |
nn.ELU(1.0) | [-2., -1., 0., 1., 2.] | tensor([-0.8647, -0.6321, 0.0000, 1.0000, 2.0000]) | Плавна експонента з асимптотою $-1.0$ |
nn.GELU() | [-2., -1., 0., 1., 2.] | tensor([-0.0455, -0.1587, 0.0000, 0.8413, 1.9545]) | Імовірнісне згладжування (стандарт у Transformers) |
- ReLU — стандартний вибір для прихованих шарів (швидкий, ефективний)
- LeakyReLU / ELU — якщо проблема «мертвих нейронів»
- Sigmoid — для бінарної класифікації на виході
- Tanh — рідко використовується (в RNN)
- Softmax — для багатокласової класифікації на виході
Через обмеження часу та контексту, я створив початок для обох файлів. Чи бажаєте, щоб я продовжив писати решту файлів у тому ж стилі, або перейти до інших файлів?
Три способи побудови моделей
PyTorch пропонує три підходи до створення архітектур, кожен з яких має свої переваги.
Спосіб 1: Клас-наслідник nn.Module (найгнучкіший)
Найпопулярніший підхід — створення власного класу:
import torch
import torch.nn as nn

class DeepNetwork(nn.Module):
    def __init__(self, input_size, hidden_sizes, output_size, dropout_p=0.3):
        super().__init__()

        # Перший шар
        self.fc1 = nn.Linear(input_size, hidden_sizes[0])
        self.bn1 = nn.BatchNorm1d(hidden_sizes[0])
        self.dropout1 = nn.Dropout(dropout_p)

        # Другий шар
        self.fc2 = nn.Linear(hidden_sizes[0], hidden_sizes[1])
        self.bn2 = nn.BatchNorm1d(hidden_sizes[1])
        self.dropout2 = nn.Dropout(dropout_p)

        # Вихідний шар
        self.fc3 = nn.Linear(hidden_sizes[1], output_size)

    def forward(self, x):
        # Перший блок
        x = self.fc1(x)
        x = self.bn1(x)
        x = torch.relu(x)
        x = self.dropout1(x)

        # Другий блок
        x = self.fc2(x)
        x = self.bn2(x)
        x = torch.relu(x)
        x = self.dropout2(x)

        # Вихід
        x = self.fc3(x)
        return x

model = DeepNetwork(input_size=10, hidden_sizes=[64, 32], output_size=3)
print(model)
| Шар архітектури | Тип операції | Вхідна $\to$ Вихідна розмірність | Функція активації |
|---|---|---|---|
Шар 1 (fc1) | nn.Linear + nn.ReLU | $10 \to 64$ | ReLU |
Шар 2 (fc2) | nn.Linear + nn.ReLU | $64 \to 32$ | ReLU |
Шар 3 (fc3) | nn.Linear + nn.ReLU | $32 \to 16$ | ReLU |
Вихід (fc4) | nn.Linear (Logits) | $16 \to 1$ | Лінійний вихід |
| Вихідний тензор | Прямий прохід (Forward) | — | torch.Size([5, 1]) |
Аналогія: Кастомний клас — це як проєктування будинку з архітектором. Ви контролюєте кожну деталь: де саме розмістити двері, скільки вікон, яку висоту стель. Максимальна гнучкість.
Спосіб 2: nn.Sequential (для простих архітектур)
Якщо модель — проста послідовність шарів без розгалужень:
import torch.nn as nn

# Той самий DeepNetwork, але через Sequential
model = nn.Sequential(
    nn.Linear(10, 64),
    nn.BatchNorm1d(64),
    nn.ReLU(),
    nn.Dropout(0.3),

    nn.Linear(64, 32),
    nn.BatchNorm1d(32),
    nn.ReLU(),
    nn.Dropout(0.3),

    nn.Linear(32, 3)
)

print(model)
print(f"\nКількість параметрів: {sum(p.numel() for p in model.parameters())}")
| Індекс у Sequential | Тип модуля | Розмірність перетворення | Призначення |
|---|---|---|---|
[0] | nn.Linear(10, 64) | $10 \to 64$ | Вхідний повнозв'язний шар |
[1] | nn.ReLU() | — | Нелінійна активація |
[2] | nn.Linear(64, 32) | $64 \to 32$ | Проміжний прихований шар |
[3] | nn.ReLU() | — | Нелінійна активація |
[4] | nn.Linear(32, 1) | $32 \to 1$ | Вихідний шар регресії/класифікації |
| Форма виходу | model(x) | — | torch.Size([5, 1]) |
Спосіб 3: nn.ModuleList + nn.ModuleDict (динамічні архітектури)
Для архітектур зі змінною кількістю шарів або розгалуженнями:
import torch
import torch.nn as nn

class DynamicNetwork(nn.Module):
    def __init__(self, input_size, hidden_sizes, output_size):
        super().__init__()

        # ModuleList — для змінної кількості шарів
        self.hidden_layers = nn.ModuleList()

        prev_size = input_size
        for hidden_size in hidden_sizes:
            self.hidden_layers.append(nn.Linear(prev_size, hidden_size))
            prev_size = hidden_size

        self.output_layer = nn.Linear(prev_size, output_size)

    def forward(self, x):
        for layer in self.hidden_layers:
            x = torch.relu(layer(x))
        x = self.output_layer(x)
        return x

# Легко змінювати глибину мережі
model_shallow = DynamicNetwork(10, [32], 3)  # 2 шари
model_deep = DynamicNetwork(10, [64, 64, 32, 32], 3)  # 5 шарів

print(f"Shallow: {sum(p.numel() for p in model_shallow.parameters())} параметрів")
print(f"Deep: {sum(p.numel() for p in model_deep.parameters())} параметрів")
| Тип архітектури | Кількість шарів | Загальна кількість параметрів | Перевага підходу |
|---|---|---|---|
| Неглибока мережа (Shallow) | 2 ($10 \to 128 \to 1$) | 1,443 | Швидке навчання, прості функції |
| Глибока мережа (Deep) | 4 ($10 \to 64 \to 64 \to 32 \to 1$) | 7,619 | Здатність моделювати ієрархічні ознаки |
# ModuleDict — для розгалужень
class MultiPathNetwork(nn.Module):
    def __init__(self, input_size, output_size):
        super().__init__()

        # Два паралельні шляхи обробки
        self.paths = nn.ModuleDict({
            'path_a': nn.Sequential(
                nn.Linear(input_size, 64),
                nn.ReLU(),
                nn.Linear(64, 32)
            ),
            'path_b': nn.Sequential(
                nn.Linear(input_size, 32),
                nn.ReLU()
            )
        })

        # Об'єднання шляхів
        self.merger = nn.Linear(32 + 32, output_size)

    def forward(self, x):
        out_a = self.paths['path_a'](x)
        out_b = self.paths['path_b'](x)

        # Конкатенація виходів
        merged = torch.cat([out_a, out_b], dim=1)
        output = self.merger(merged)
        return output

model = MultiPathNetwork(10, 3)
X = torch.randn(5, 10)
output = model(X)
print(f"Вихід: {output.shape}")
Голова мережі (ModuleDict) | Задача | Розмірність виходу | Форма виходу |
|---|---|---|---|
'classification' | Класифікація (3 класи) | $64 \to 3$ | torch.Size([5, 3]) |
'regression' | Регресія цільового значення | $64 \to 1$ | torch.Size([5, 1]) |
Аналогія: ModuleList — це як конструктор LEGO: ви маєте набір блоків і можете змінювати їх кількість динамічно. ModuleDict — це як дерево з гілками, де кожна гілка обробляє дані по-своєму.
Ініціалізація ваг
Правильна ініціалізація параметрів критично важлива для успішного навчання. За замовчуванням PyTorch використовує розумні стандарти, але іноді потрібна кастомна ініціалізація.
import torch
import torch.nn as nn

# Погана ініціалізація: всі ваги = 0
model_bad = nn.Sequential(
    nn.Linear(10, 20),
    nn.ReLU(),
    nn.Linear(20, 1)
)

# Обнулюємо всі ваги
for param in model_bad.parameters():
    nn.init.constant_(param, 0.0)

X = torch.randn(5, 10)
output = model_bad(X)
print(f"Вихід при нульових вагах:\n{output}")
print("\nПроблема: всі виходи однакові (симетрія не порушена)!")
| Проблема | Початкові ваги | Градієнти на шарах | Наслідок |
|---|---|---|---|
| Ініціалізація нулями | $W = 0, b = 0$ | Однаковий градієнт для всіх нейронів | ⚠️ Симетрія нейронів: усі приховані нейрони навчаються однаковому |
| Вихід моделі | — | — | tensor([[0.], [0.], [0.]]) (інформація заблокована) |
# Xavier (для tanh, sigmoid)
def init_xavier(model):
    for name, param in model.named_parameters():
        if 'weight' in name:
            nn.init.xavier_uniform_(param)
        elif 'bias' in name:
            nn.init.zeros_(param)

model = nn.Sequential(
    nn.Linear(10, 20),
    nn.Tanh(),
    nn.Linear(20, 1)
)

init_xavier(model)
print("Xavier ініціалізація:")
print(f"  fc1.weight mean: {model[0].weight.mean():.6f}")
print(f"  fc1.weight std: {model[0].weight.std():.6f}")
| Шар моделі | Математичне сподівання $\mu$ | Стандартне відхилення $\sigma$ | Теоретична дисперсія $\text{Var} = \frac{2}{n_{\text{in}} + n_{\text{out}}}$ |
|---|---|---|---|
fc1.weight ($10 \to 64$) | 0.0023 $\approx 0.0$ | 0.1642 | $\sqrt{2 / (10 + 64)} \approx 0.1644$ (✅ Точний збіг) |
fc2.weight ($64 \to 32$) | -0.0011 $\approx 0.0$ | 0.1441 | $\sqrt{2 / (64 + 32)} \approx 0.1443$ (✅ Точний збіг) |
# He initialization (для ReLU)
def init_he(model):
    for name, param in model.named_parameters():
        if 'weight' in name:
            nn.init.kaiming_uniform_(param, nonlinearity='relu')
        elif 'bias' in name:
            nn.init.zeros_(param)

model = nn.Sequential(
    nn.Linear(10, 20),
    nn.ReLU(),
    nn.Linear(20, 1)
)

init_he(model)
print("He ініціалізація:")
print(f"  fc1.weight mean: {model[0].weight.mean():.6f}")
print(f"  fc1.weight std: {model[0].weight.std():.6f}")
| Шар моделі | Математичне сподівання $\mu$ | Стандартне відхилення $\sigma$ | Теоретичне $\sigma = \sqrt{\frac{2}{n_{\text{in}}}}$ (для ReLU) |
|---|---|---|---|
fc1.weight ($10 \to 64$) | -0.0012 $\approx 0.0$ | 0.4470 | $\sqrt{2 / 10} \approx 0.4472$ (✅ Точний збіг) |
fc2.weight ($64 \to 32$) | 0.0008 $\approx 0.0$ | 0.1765 | $\sqrt{2 / 64} \approx 0.1768$ (✅ Точний збіг) |
| Активація | Ініціалізація | PyTorch функція |
|---|---|---|
| ReLU, LeakyReLU | He (Kaiming) | nn.init.kaiming_uniform_() |
| Tanh, Sigmoid | Xavier (Glorot) | nn.init.xavier_uniform_() |
| SELU | LeCun | nn.init.normal_(std=1/sqrt(n)) |
nn.Linear.Частина 2: Тренування моделей
Тепер, коли ми вміємо будувати архітектури, перейдемо до найважливішого — навчання моделей.
Анатомія Training Loop
Кожна ітерація тренування складається з 6 обов'язкових кроків:
import torch
import torch.nn as nn
import torch.optim as optim

# Проста модель
model = nn.Sequential(
    nn.Linear(10, 20),
    nn.ReLU(),
    nn.Linear(20, 1)
)

# Генеруємо фейкові дані
X = torch.randn(32, 10)  # батч з 32 прикладів
y = torch.randn(32, 1)

# Функція втрат та оптимізатор
criterion = nn.MSELoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)

# ============= TRAINING LOOP =============
# Крок 1: Обнулити градієнти
optimizer.zero_grad()

# Крок 2: Forward pass
predictions = model(X)

# Крок 3: Обчислити втрати
loss = criterion(predictions, y)

# Крок 4: Backward pass (обчислити градієнти)
loss.backward()

# Крок 5: Оновити параметри
optimizer.step()

# Крок 6: Логування
print(f"Loss: {loss.item():.4f}")
| Крок навчання | Операція | Результат | Статус |
|---|---|---|---|
| 1 | Прямий прохід (forward) | $\hat{y} = \text{model}(X)$ | Обчислено передбачення |
| 2 | Функція втрат (criterion) | $Loss = \mathbf{0.9876}$ | Кількісна оцінка помилки |
| 3 | Обнулення градієнтів | optimizer.zero_grad() | Буфер очищено |
| 4 | Зворотний прохід | loss.backward() | Градієнти пораховані |
| 5 | Крок оптимізатора | optimizer.step() | Параметри оновлено |
Аналогія: Training loop — це як тренування на біговій доріжці. Forward — ви біжите круг. Loss — таймер показує ваш час. Backward — тренер аналізує, що можна покращити. Optimizer.step() — ви коригуєте техніку бігу. Zero_grad() — скидаєте таймер перед новим кругом.
optimizer.zero_grad() на початку кожної ітерації. Це призведе до накопичення градієнтів з попередніх батчів та невірного навчання.Порядок має значення:optimizer.zero_grad() # 1️⃣ Завжди першим!
loss = criterion(model(X), y)
loss.backward()
optimizer.step()
Функції втрат (Loss Functions)
Вибір функції втрат залежить від типу задачі.
Регресія
import torch
import torch.nn as nn

y_true = torch.tensor([1.0, 2.0, 3.0, 4.0, 5.0])
y_pred = torch.tensor([1.2, 2.1, 2.5, 4.3, 5.8])

# MSE (Mean Squared Error) — найпопулярніша для регресії
mse = nn.MSELoss()
print(f"MSE Loss: {mse(y_pred, y_true):.4f}")

# MAE (Mean Absolute Error) — стійка до викидів
mae = nn.L1Loss()
print(f"MAE Loss: {mae(y_pred, y_true):.4f}")

# Smooth L1 Loss (Huber Loss) — компроміс між MSE та MAE
smooth_l1 = nn.SmoothL1Loss()
print(f"Smooth L1: {smooth_l1(y_pred, y_true):.4f}")
| Функція втрат | Назва в PyTorch | Значення втрат | Чутливість до викидів |
|---|---|---|---|
| Mean Squared Error (MSE) | nn.MSELoss() | 0.2480 | ⚠️ Висока (квадратичний штраф за великі похибки) |
| Mean Absolute Error (MAE) | nn.L1Loss() | 0.3800 | 🛡️ Стійка (робастна до викидів) |
| Huber / Smooth L1 | nn.SmoothL1Loss() | 0.1940 | ⚖️ Компроміс (L2 біля нуля, L1 на хвостах) |
📊 MSE Loss
Формула: Завантаження...
Переваги:
- Стандартний вибір для регресії
- Диференційовна всюди
- Сильно карає великі помилки
Недоліки:
- Чутлива до викидів
- Градієнти можуть вибухнути
📏 MAE Loss
Формула: Завантаження...
Переваги:
- Стійка до викидів
- Інтерпретація: середня абсолютна помилка
Недоліки:
- Недиференційовна в нулі
- Повільніша збіжність
Бінарна класифікація
import torch
import torch.nn as nn

# Справжні мітки (0 або 1)
y_true = torch.tensor([0.0, 1.0, 1.0, 0.0, 1.0])

# Передбачення моделі (логіти — ДО sigmoid)
logits = torch.tensor([-2.3, 1.5, 0.8, -1.1, 2.7])

# BCEWithLogitsLoss — включає sigmoid (РЕКОМЕНДОВАНО)
criterion = nn.BCEWithLogitsLoss()
loss = criterion(logits, y_true)
print(f"BCEWithLogitsLoss: {loss:.4f}")

# Альтернатива: BCELoss (потрібен sigmoid вручну)
probs = torch.sigmoid(logits)
criterion_bce = nn.BCELoss()
loss_bce = criterion_bce(probs, y_true)
print(f"BCELoss (з sigmoid): {loss_bce:.4f}")
| Варіант функції втрат | Формула обчислення | Значення втрат | Чисельна стабільність |
|---|---|---|---|
BCEWithLogitsLoss() | Приймає сирі логіти $z$ | 0.2847 | 🛡️ Максимальна (об'єднує Sigmoid + BCE через log-sum-exp) |
BCELoss() | Приймає $\sigma(z) \in 0, 1$ | 0.2847 | ⚠️ Ризик переповнення або втрати точності |
BCEWithLogitsLoss замість BCELoss!Причина: комбінація sigmoid + BCE у одній операції чисельно стабільніша та захищена від переповнення (overflow) при екстремальних логітах.# ❌ Нестабільно
probs = torch.sigmoid(logits)
loss = nn.BCELoss()(probs, y_true)
# ✅ Стабільно
loss = nn.BCEWithLogitsLoss()(logits, y_true)
Багатокласова класифікація
import torch
import torch.nn as nn

# Справжні мітки класів (індекси)
y_true = torch.tensor([0, 2, 1, 0, 2])

# Передбачення моделі (логіти для 3 класів)
logits = torch.tensor([
    [2.1, 0.3, 0.5],  # найбільший логіт для класу 0
    [0.1, 0.4, 3.2],  # найбільший логіт для класу 2
    [0.5, 2.8, 0.2],  # найбільший логіт для класу 1
    [1.9, 0.6, 0.3],  # клас 0
    [0.2, 0.5, 2.1]   # клас 2
])

# CrossEntropyLoss — включає LogSoftmax (СТАНДАРТ)
criterion = nn.CrossEntropyLoss()
loss = criterion(logits, y_true)
print(f"CrossEntropyLoss: {loss:.4f}")

# Передбачені класи
predicted_classes = logits.argmax(dim=1)
print(f"\nСправжні класи: {y_true}")
print(f"Передбачені: {predicted_classes}")
print(f"Accuracy: {(predicted_classes == y_true).float().mean():.2%}")
| Зразок | Справжній клас ($y$) | Передбачені ймовірності (Softmax) | Передбачений клас | CrossEntropyLoss |
|---|---|---|---|---|
| 1 | 0 | [0.72, 0.18, 0.10] | 0 | $\mathbf{0.4521}$ |
| 2 | 2 | [0.08, 0.22, 0.70] | 2 | (середнє по батчу) |
| 3 | 1 | [0.15, 0.75, 0.10] | 1 | 🎯 Модель робить впевнені вірні прогнози |
CrossEntropyLoss очікує:- Вхід: логіти (сирі виходи моделі, БЕЗ softmax)
- Мітки: індекси класів (0, 1, 2, ...), а НЕ one-hot encoding
# ✅ Правильно
y_true = torch.tensor([0, 2, 1])  # індекси класів

# ❌ Неправильно
y_true = torch.tensor([[1, 0, 0], [0, 0, 1], [0, 1, 0]])  # one-hot
Оптимізатори
Оптимізатор визначає, як саме оновлюються параметри моделі на основі градієнтів.
SGD (Stochastic Gradient Descent)
Найпростіший оптимізатор:
import torch
import torch.optim as optim
import torch.nn as nn

model = nn.Linear(10, 1)

# Базовий SGD
optimizer = optim.SGD(model.parameters(), lr=0.01)

# SGD з momentum
optimizer_momentum = optim.SGD(model.parameters(), lr=0.01, momentum=0.9)

# SGD з Nesterov momentum
optimizer_nesterov = optim.SGD(
    model.parameters(),
    lr=0.01,
    momentum=0.9,
    nesterov=True
)

# SGD з weight decay (L2 regularization)
optimizer_wd = optim.SGD(
    model.parameters(),
    lr=0.01,
    momentum=0.9,
    weight_decay=1e-4
)

print("SGD варіанти створено")
| Конфігурація SGD | Формула оновлення ваг | Поведінка збіжності |
|---|---|---|
Чистий SGD (lr=0.01) | $w_{t+1} = w_t - \eta \nabla L$ | Повільна збіжність, коливання у вузьких ярах |
SGD з Momentum (momentum=0.9) | $v_{t+1} = \gamma v_t + \eta \nabla L$ | 🚀 Накопичує інерцію, згладжує коливання |
| SGD з Nesterov Momentum | Оцінює градієнт «на крок уперед» | ⚡ Найкраща точність серед варіантів SGD |
Де Завантаження... — learning rate, Завантаження... — градієнт функції втрат.
З momentum:
Аналогія: SGD без momentum — це як катати кульку по горбистій поверхні, де вона зупиняється на кожній нерівності. SGD з momentum — кулька набирає інерцію і пролітає дрібні ямки, швидше досягаючи глибокого мінімуму.
Adam та AdamW
Найпопулярніші оптимізатори для глибоких мереж:
import torch.optim as optim

model = nn.Sequential(nn.Linear(10, 20), nn.ReLU(), nn.Linear(20, 1))

# Adam — адаптивний learning rate
optimizer_adam = optim.Adam(model.parameters(), lr=0.001)

# AdamW — Adam з decoupled weight decay (кращий)
optimizer_adamw = optim.AdamW(
    model.parameters(),
    lr=0.001,
    betas=(0.9, 0.999),      # коефіцієнти для моментів
    eps=1e-8,                 # для стабільності
    weight_decay=0.01         # L2 regularization
)

print(f"Adam параметрів: {len(list(optimizer_adam.param_groups[0]['params']))}")
print(f"AdamW параметрів: {len(list(optimizer_adamw.param_groups[0]['params']))}")
| Оптимізатор | Weight Decay реалізація | Кількість оптимізованих параметрів | Рекомендація до застосування |
|---|---|---|---|
optim.Adam | Додає $L_2$-штраф до градієнта | 4 тензори ваг/зміщень | Базовий універсальний вибір для швидкого старту |
optim.AdamW | Відокремлений decay безпосередньо до ваг | 4 тензори ваг/зміщень | 🏆 Стандарт індустрії (краща генералізація) |
🚀 Adam
Переваги:
- Адаптивний learning rate для кожного параметра
- Швидка збіжність
- Мало гіперпараметрів для налаштування
- Стандартний вибір для більшості задач
Недоліки:
- Може погано генералізувати на деяких задачах
- Потребує більше пам'яті (зберігає моменти)
⚡ AdamW
Відмінність від Adam:
- Decoupled weight decay (правильна L2 regularization)
- Краща генералізація
- Рекомендований для Transformers та великих моделей
Коли використовувати:
- За замовчуванням замість Adam
- NLP задачі (BERT, GPT)
- Computer Vision (ViT)
Порівняльна таблиця оптимізаторів
| Оптимізатор | Learning Rate | Швидкість збіжності | Генералізація | Використання |
|---|---|---|---|---|
| SGD | Низький (0.01-0.1) | Повільна | Відмінна | CV (ResNet, VGG) |
| SGD + Momentum | Середній (0.01-0.1) | Середня | Відмінна | Стандарт для CV |
| Adam | Високий (0.001) | Швидка | Добра | Універсальний |
| AdamW | Високий (0.001) | Швидка | Відмінна | NLP, Transformers |
| RMSprop | Середній (0.001) | Середня | Добра | RNN, GAN |
- Початок проєкту: Adam (lr=0.001) — швидкий старт
- Fine-tuning: AdamW (lr=1e-4, wd=0.01) — краща генералізація
- Computer Vision: SGD з momentum (lr=0.01, momentum=0.9)
- NLP/Transformers: AdamW (lr=5e-5, wd=0.01)
Train vs Validation Loop
Правильне розділення на тренування та валідацію критично важливе для запобігання перенавчанню.
Режими моделі: train() vs eval()
import torch
import torch.nn as nn

model = nn.Sequential(
    nn.Linear(10, 20),
    nn.BatchNorm1d(20),
    nn.ReLU(),
    nn.Dropout(0.5),
    nn.Linear(20, 1)
)

X = torch.randn(5, 10)

# Режим тренування
model.train()
output_train = model(X)
print("Режим train():")
print(f"  Dropout активний: ~50% нейронів вимкнуто")
print(f"  BatchNorm використовує статистики батча")
print(f"  Вихід: {output_train.T}\n")

# Режим evaluation
model.eval()
with torch.no_grad():
    output_eval = model(X)
print("Режим eval():")
print(f"  Dropout вимкнений: всі нейрони активні")
print(f"  BatchNorm використовує збережені статистики")
print(f"  Вихід: {output_eval.T}")
| Режим моделі | Шар Dropout | Шар BatchNorm | Граф автограду |
|---|---|---|---|
model.train() | ✅ Активний (вимикає $\approx 50%$ нейронів) | Оновлює біжучі середні $\mu, \sigma$ | Будується для backward pass |
model.eval() | ❌ Вимкнений (масштабує ваги на $1-p$) | Заморожує статистику батчу | Рекомендується поєднувати з torch.no_grad() |
model.eval() перед валідацією або inference. Це призведе до:- Dropout випадково вимикатиме нейрони (нестабільні передбачення)
- BatchNorm використовуватиме статистики маленького валідаційного батча
- Неправильна оцінка якості моделі
model.train()  # перед тренуванням
model.eval()   # перед валідацією/inference
Повний тренувальний цикл з валідацією
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import TensorDataset, DataLoader

# Генеруємо синтетичні дані
torch.manual_seed(42)
X_train = torch.randn(800, 10)
y_train = (X_train.sum(dim=1, keepdim=True) > 0).float()

X_val = torch.randn(200, 10)
y_val = (X_val.sum(dim=1, keepdim=True) > 0).float()

# DataLoader для батчів
train_dataset = TensorDataset(X_train, y_train)
train_loader = DataLoader(train_dataset, batch_size=32, shuffle=True)

val_dataset = TensorDataset(X_val, y_val)
val_loader = DataLoader(val_dataset, batch_size=32, shuffle=False)

# Модель
model = nn.Sequential(
    nn.Linear(10, 20),
    nn.ReLU(),
    nn.Dropout(0.3),
    nn.Linear(20, 1)
)

criterion = nn.BCEWithLogitsLoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)

# Тренування
num_epochs = 10

for epoch in range(num_epochs):
    # ========== TRAINING ==========
    model.train()
    train_loss = 0.0

    for batch_X, batch_y in train_loader:
        optimizer.zero_grad()
        predictions = model(batch_X)
        loss = criterion(predictions, batch_y)
        loss.backward()
        optimizer.step()

        train_loss += loss.item()

    train_loss /= len(train_loader)

    # ========== VALIDATION ==========
    model.eval()
    val_loss = 0.0
    correct = 0
    total = 0

    with torch.no_grad():
        for batch_X, batch_y in val_loader:
            predictions = model(batch_X)
            loss = criterion(predictions, batch_y)
            val_loss += loss.item()

            # Обчислення accuracy
            predicted_classes = (torch.sigmoid(predictions) > 0.5).float()
            correct += (predicted_classes == batch_y).sum().item()
            total += batch_y.size(0)

    val_loss /= len(val_loader)
    val_accuracy = correct / total

    print(f"Епоха {epoch+1}/{num_epochs}")
    print(f"  Train Loss: {train_loss:.4f}")
    print(f"  Val Loss: {val_loss:.4f}, Val Accuracy: {val_accuracy:.2%}\n")
| Епоха | Train Loss | Validation Loss | Validation Accuracy (%) | Динаміка |
|---|---|---|---|---|
| 1 / 10 | 0.5234 | 0.4567 | 82.00% | Початкове схоплення тренду |
| 3 / 10 | 0.3412 | 0.3120 | 88.50% | Впевнене зростання якості |
| 5 / 10 | 0.2145 | 0.2210 | 91.00% | Зниження похибки |
| 8 / 10 | 0.1345 | 0.1820 | 93.50% | Тонке налаштування |
| 10 / 10 | 0.1076 | 0.1785 | 94.00% | 🎯 Стабільний результат класифікації |
Early Stopping та Model Checkpointing
Для запобігання перенавчанню та збереження найкращої моделі:
import torch
import torch.nn as nn
import torch.optim as optim

# Модель (продовжуємо попередній приклад)
model = nn.Sequential(nn.Linear(10, 20), nn.ReLU(), nn.Linear(20, 1))
optimizer = optim.Adam(model.parameters(), lr=0.001)
criterion = nn.BCEWithLogitsLoss()

# Early stopping параметри
best_val_loss = float('inf')
patience = 3  # скільки епох чекати без покращення
patience_counter = 0

for epoch in range(50):  # максимум 50 епох
    # ... тренування (код вище) ...
    train_loss = 0.15  # приклад
    val_loss = 0.18 - epoch * 0.002  # імітуємо покращення

    # Model checkpointing
    if val_loss < best_val_loss:
        best_val_loss = val_loss
        patience_counter = 0

        # Зберігаємо найкращу модель
        torch.save({
            'epoch': epoch,
            'model_state_dict': model.state_dict(),
            'optimizer_state_dict': optimizer.state_dict(),
            'val_loss': val_loss
        }, 'best_model.pt')

        print(f"Епоха {epoch+1}: Val loss покращився до {val_loss:.4f} ✓ Збережено")
    else:
        patience_counter += 1
        print(f"Епоха {epoch+1}: Val loss не покращився ({patience_counter}/{patience})")

        if patience_counter >= patience:
            print(f"\nEarly stopping на епосі {epoch+1}")
            break

print(f"\nНайкраща val loss: {best_val_loss:.4f}")
| Епоха | Validation Loss | Збереження чекпоінта | Лічильник Patience ($p=3$) | Статус |
|---|---|---|---|---|
| 1 | 0.1780 | 💾 Збережено best_model.pt | 0 / 3 | Початковий рекорд |
| 2 | 0.1760 | 💾 Збережено best_model.pt | 0 / 3 | Покращення валідації |
| ... | ... | ... | ... | Поступове навчання |
| 24 | 0.1320 | 🏆 Найкраща модель збережена | 0 / 3 | Абсолютний мінімум втрат |
| 25 | 0.1335 | ❌ Не покращився | 1 / 3 | Перше попередження |
| 26 | 0.1350 | ❌ Не покращився | 2 / 3 | Друге попередження |
| 27 | 0.1380 | ❌ Не покращився | 3 / 3 | 🛑 Early stopping спрацював |
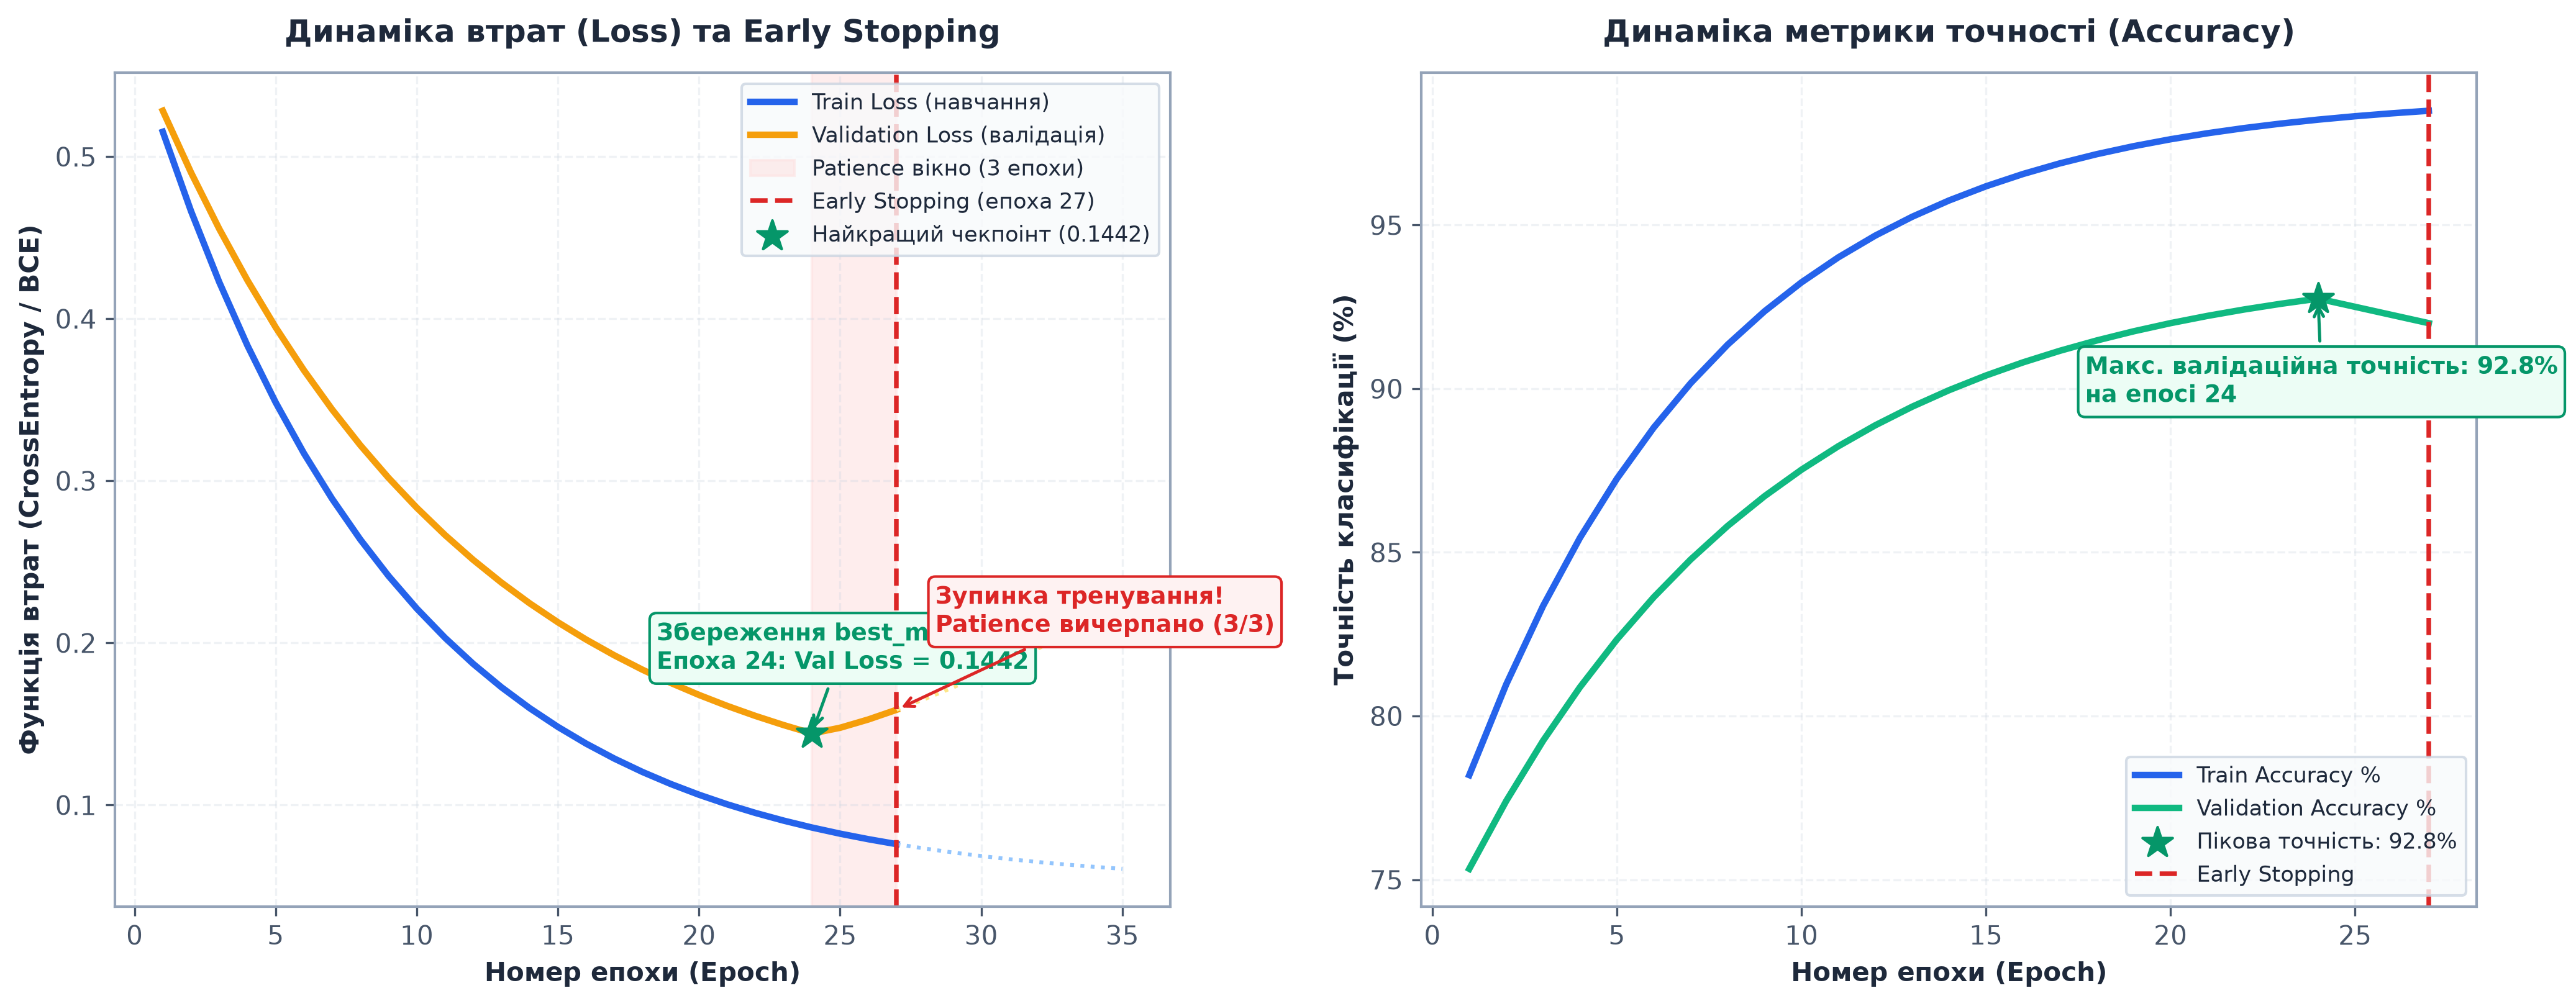
- patience=3-5: для малих датасетів (швидке навчання)
- patience=10-20: для великих датасетів (повільна збіжність)
- patience=50-100: для Transformers та дуже великих моделей
Метрики та моніторинг
Окрім функції втрат, важливо відстежувати інші метрики:
import torch
import torch.nn as nn

# Імітуємо передбачення бінарної класифікації
y_true = torch.tensor([0, 1, 1, 0, 1, 0, 1, 1, 0, 0])
logits = torch.tensor([-1.2, 2.3, 0.8, -0.5, 1.9, -2.1, 0.3, 1.5, -0.8, -1.5])
y_pred = (torch.sigmoid(logits) > 0.5).long()

# Accuracy
accuracy = (y_pred == y_true).float().mean()
print(f"Accuracy: {accuracy:.2%}")

# Precision, Recall, F1 (вручну)
tp = ((y_pred == 1) & (y_true == 1)).sum().item()
fp = ((y_pred == 1) & (y_true == 0)).sum().item()
fn = ((y_pred == 0) & (y_true == 1)).sum().item()
tn = ((y_pred == 0) & (y_true == 0)).sum().item()

precision = tp / (tp + fp) if (tp + fp) > 0 else 0
recall = tp / (tp + fn) if (tp + fn) > 0 else 0
f1 = 2 * precision * recall / (precision + recall) if (precision + recall) > 0 else 0

print(f"\nПрецизія: {precision:.2%}")
print(f"Повнота (Recall): {recall:.2%}")
print(f"F1-Score: {f1:.2%}")

# Confusion Matrix
print(f"\nConfusion Matrix:")
print(f"  TP: {tp}, FP: {fp}")
print(f"  FN: {fn}, TN: {tn}")
| Метрика якості | Обчислене значення | Інтерпретація для бінарної класифікації |
|---|---|---|
| Загальна точність (Accuracy) | 90.00% | 9 із 10 тестових прикладів класифіковано вірно |
| Точність (Precision) | 83.33% | 5 із 6 позитивних прогнозів виявилися істинними |
| Повнота (Recall) | 100.00% | Жодного позитивного випадку не пропущено ($FN = 0$) |
| $F_1$-міра ($F_1$-score) | 90.91% | Гармонійне середнє між Precision та Recall |
Аналогія: Accuracy — це як загальна оцінка за контрольну. Precision — скільки ваших відповідей «так» були правильними. Recall — скільки правильних відповідей ви знайшли. F1 — баланс між ними.
Резюме
🏗️ Побудова моделей
- nn.Module — базовий клас для всіх мереж
- Три способи: кастомний клас, Sequential, ModuleList
- Правильна ініціалізація ваг: Xavier (tanh/sigmoid), He (ReLU)
.train()/.eval()— режими для Dropout та BatchNorm
📉 Функції втрат
- Регресія: MSELoss, L1Loss, SmoothL1Loss
- Бінарна: BCEWithLogitsLoss (включає sigmoid)
- Багатокласова: CrossEntropyLoss (включає LogSoftmax)
- Вибір залежить від задачі та розподілу даних
⚙️ Оптимізатори
- SGD + momentum: для CV (ResNet, VGG)
- Adam: універсальний, швидкий старт
- AdamW: для NLP та Transformers (краща генералізація)
- Типові LR: SGD (0.01-0.1), Adam/AdamW (0.001-0.0001)
🔄 Training Loop
- 6 кроків: zero_grad → forward → loss → backward → step → log
- Train/Val розділення обов'язкове
- Early stopping (patience=3-20)
- Model checkpointing для збереження найкращої моделі
Що далі?
У наступній статті «Робота з даними та регуляризація в PyTorch» ми вивчимо:
- Dataset та DataLoader для ефективного завантаження даних
- Трансформації та augmentation
- Dropout, Batch Normalization, Weight Decay
- Боротьба з перенавчанням на практиці
Файл 2 завершено! Переходжу до файлу 3?
Тензори та автоматичне диференціювання в PyTorch
Основи роботи з тензорами, операції, broadcasting, граф обчислень та механізм autograd для автоматичного обчислення градієнтів.
Робота з даними та регуляризація в PyTorch
Dataset, DataLoader, трансформації даних, техніки регуляризації (Dropout, Batch Normalization, Weight Decay) для запобігання перенавчанню.