Дерева рішень — моделі з прозорою та зрозумілою логікою
Гра «20 питань» — природна логіка прийняття рішень
Пригадайте популярну салонну гру «20 питань»: один ведучий загадує таємний предмет або персонажа, а гравці намагаються його відгадати, ставлячи запитання, на які можна відповісти виключно «так» або «ні».
Як у цій грі поводиться людина з неефективною стратегією? Вона намагається вгадувати випадковими переборами:
- «Це яблуко?» — Ні.
- «Це автомобіль?» — Ні.
- «Це ноутбук?» — Ні.
За такої стратегії шанси вгадати загадане слово за 20 спроб прямують до нуля, адже кожна невдала спроба відкидає лише один-єдиний варіант із мільйонів можливих.
Натомість досвідчений гравець обирає розумну стратегію послідовних запитань, які щоразу відкидають половину варіантів:
- «Це жива істота?» — Так (одразу відсікається 50% неживого світу).
- «Це тварина?» — Так (залишаємо тільки тварин).
- «Вона живе у воді?» — Ні (залишаються лише наземні істоти).
- «Це ссавець?» — Так.
- «Це хижак?» — Так.
Кожне вдале запитання щоразу скорочує кількість варіантів удвічі, стрімко наближаючи гравця до правильної відповіді за мінімум кроків.
За таким самим принципом мислять люди у повсякденній інженерній чи медичній роботі:
- Лікар у приймальному відділенні не перебирає тисячі рідкісних хвороб навмання: спершу він перевіряє температуру, потім наявність кашлю, далі рівень кисню в крові.
- Кредитний відділ банку оцінює платоспроможність клієнта: спершу перевіряється кредитний рейтинг, потім офіційний дохід, далі наявність застави.
Модель машинного навчання, що реалізує цей природний деревоподібний ланцюжок запитань, називається деревом рішень (Decision Tree).
Чому саме дерева рішень? Від лінійних формул до прозорих правил
У попередніх темах ми детально досліджували сімейство лінійних моделей:
- Лінійна регресія (Linear Regression) намагається описати весь світ єдиною прямою лінією або площиною виду Завантаження....
- Поліноміальна регресія (Polynomial Regression) та моделі з регуляризацією Ridge / Lasso дозволяють моделювати нелінійні криві, проте роздувають простір ознак до десятків штучних колонок (Завантаження...).
У лінійних моделей є дві критичні практичні проблеми:
- Ваги діють однаково для всіх даних: якщо коефіцієнт ваги біля площі Завантаження..., це означає, що за збільшення площі на кожен 1 м² ціна завжди зростає на 1500 $, незалежно від того, де розташована квартира — в елітному центрі чи в промисловій зоні за містом. Проте в реальному житті вплив ознак залежить від контексту: велика площа в центрі коштує набагато дорожче за велику площу на околиці!
- Складність для розуміння: коли Ridge-регресія видає формулу з 60 дробовими коефіцієнтами, важко пояснити людині чи бізнесу, чому модель видала саме таку оцінку.
Дерева рішень працюють зовсім по-іншому — замість складної формули вони будують прості умовні правила (if-then-else):
ЯКЩО площа > 80 м²:
    ЯКЩО район = "Центр":
        → Прогнозована ціна = 75,000 $
    ІНАКШЕ:
        → Прогнозована ціна = 45,000 $
ІНАКШЕ:
    ЯКЩО вік будинку <= 5 років:
        → Прогнозована ціна = 35,000 $
    ІНАКШЕ:
        → Прогнозована ціна = 25,000 $
Така логіка прозора, не потребує складних інструкцій і зрозуміла кожному з першого погляду.
Анатомія дерева рішень
Дерево рішень — це ієрархічна схема, що росте «зверху вниз» і складається з трьох ключових будівельних блоків:
🔵 Вузли прийняття рішень (Decision Nodes)
Вузли дерева, де перевіряється конкретна умова (правило) щодо ознаки:
- Для числових ознак: «Площа > 80 м²?», «Вік будинку <= 10 років?»
- Для категоріальних ознак: «Район == Центр?»
Найперший початковий вузол на верхівці дерева називається кореневим вузлом (Root Node).
➡️ Гілки переходів (Branches)
Стрілки між вузлами, що відповідають результатам перевірки умови:
- Гілка «Так» (True): об'єкти, що задовольняють умову вузла.
- Гілка «Ні» (False): об'єкти, для яких умова хибна.
Кожна гілка спрямовує відповідну частину даних далі до наступного вузла.
🟢 Кінцеві листки (Leaves)
Кінцеві вузли дерева, які більше не діляться і містять фінальний прогноз моделі:
- У задачах класифікації: найчастіший клас або ймовірності для кожного класу.
- У задачах регресії: числове значення (середнє арифметичне всіх значень, що потрапили в цей листок).
Візуальна схема структури дерева
Як дерево обирає розбиття для класифікації: Ентропія та Критерій Джині
Уявіть, що алгоритм розпочинає побудову дерева. У датасеті є 10 ознак, і кожна з них має десятки можливих порогових значень. Загалом існує сотні потенційних запитань:
- «Площа > 50?» чи «Площа > 75?»
- «Кімнати >= 2?» чи «Вік <= 5?»
Яке саме запитання алгоритм має поставити першим у кореневому вузлі, а яке — на наступних рівнях?
Щоб зробити вибір, алгоритму потрібна міра «змішаності» або «неоднорідності» (Impurity) у вузлі. Ідеальне запитання — це те, яке якнайкраще розділяє перемішані класи на чисті, однорідні групи.
Ентропія Клода Шеннона: міра невизначеності
Для оцінки хаосу та невизначеності використовується інформаційна ентропія (Entropy), запропонована Клодом Шенноном у 1948 році:
де Завантаження... — кількість класів у вибірці, а Завантаження... — частка прикладів Завантаження...-го класу у поточному вузлі (Завантаження...).
Що означає ентропія на практиці:
- Ентропія Завантаження... (Повний порядок): Усі об'єкти у вузлі належать до одного й того самого класу. Жодної невизначеності немає — перед нами чистий листок.
- Ентропія Завантаження... (Максимальний хаос для 2 класів): Класи розділені порівну (Завантаження...). Це стан повної невизначеності — як результат підкидання звичайної монетки (орел чи решка з шансом 50/50).
import numpy as np

def entropy(counts):
    """Обчислення інформаційної ентропії Шеннона"""
    total = sum(counts)
    if total == 0:
        return 0.0
    probabilities = [count / total for count in counts]
    return float(-sum(p * np.log2(p) if p > 0 else 0.0 for p in probabilities))

# Тестові набори розподілу класів
sets = {
    'Набір 1 (5 дорогих, 5 дешевих)': [5, 5],
    'Набір 2 (9 дорогих, 1 дешевий)': [9, 1],
    'Набір 3 (10 дорогих, 0 дешевих)': [10, 0]
}

print("Обчислення ентропії для різних станів вибірки:\n")
for name, counts in sets.items():
    h = entropy(counts)
    status = 'Максимальний хаос (50/50)' if h >= 0.9 else 'Повна визначеність (чистий вузол)' if h == 0.0 else 'Висока однорідність'
    print(f"{name:32s} -> Ентропія H = {h:.4f} біт ({status})")
| Набір даних | Розподіл класів | Ентропія Завантаження... | Інтерпретація стану |
|---|---|---|---|
| Набір 1 (5 дорогих, 5 дешевих) | [5, 5] (Завантаження...) | 1.0000 | 🔴 Повна невизначеність (максимальний хаос) |
| Набір 2 (9 дорогих, 1 дешевий) | [9, 1] (Завантаження...) | 0.4690 | 🟡 Висока визначеність (переважає один клас) |
| Набір 3 (10 дорогих, 0 дешевих) | [10, 0] (Завантаження...) | 0.0000 | 🟢 Повна визначеність (чистий вузол / ідеальний розподіл) |
Покроковий розрахунок ентропії: демо-приклад із вазою кульок
Щоб формула Шеннона перестала бути абстракцією, розглянемо простий приклад: у закритій вазі лежать 8 кульок — 6 зелених (клас Завантаження...) та 2 червоні (клас Завантаження...).
Крок 1. Обчислення часток класів
Завантаження...,
Завантаження....
Крок 2. Обчислення двійкових логарифмів
Логарифм оцінює обсяг невизначеності у бітах:
Завантаження...,
Завантаження....
Крок 3. Множення часток на логарифми
Множимо ймовірність кожного результату на відповідний логарифм:
Завантаження...,
Завантаження....
Крок 4. Додавання та зміна знака
Завантаження....
def explain_entropy(classes: dict[str, int]) -> float:
    total = sum(classes.values())
    print(f"Загальна кількість об'єктів N = {total}")
    print("-" * 52)

    entropy_val = 0.0
    for label, count in classes.items():
        p = count / total
        log_val = np.log2(p) if p > 0 else 0.0
        weighted = p * log_val
        entropy_val -= weighted
        print(f"Клас '{label}': {count}/{total} (p={p:.2f}) -> log2(p)={log_val:+.4f} -> p*log2(p)={weighted:+.4f}")

    print("-" * 52)
    print(f"Ентропія H = {entropy_val:.4f} біт")
    return entropy_val

result = explain_entropy({'Зелені': 6, 'Червоні': 2})
Загальна кількість об'єктів N = 8
Клас 'Зелені': 6/8 (p=0.75) -> log2(p)=-0.4150 -> plog2(p)=-0.3113 Клас 'Червоні': 2/8 (p=0.25) -> log2(p)=-2.0000 -> plog2(p)=-0.5000
Ентропія H = 0.8113 біт
Критерій Джині (Gini Impurity) проти Ентропії: чому scikit-learn використовує Gini?
Якщо відкрити документацію DecisionTreeClassifier у scikit-learn, ви побачите параметр за замовчуванням criterion='gini', а не 'entropy'. Чому?
Формула критерію неоднорідності Джині (Gini Impurity):
Просте пояснення критерію Джині: Уявіть, що ми навмання дістаємо елемент із вузла, а потім навмання приписуємо йому клас згідно з розподілом у цьому ж вузлі. Яка ймовірність того, що ми помилимося? Це і є Gini Impurity!
- Якщо всі елементи одного класу (Завантаження...): Завантаження... (чистий вузол).
- Якщо класи розділені порівну (Завантаження...): Завантаження....
Чому на практиці частіше обирають Gini Impurity?
Розрахунок ентропії вимагає обчислення двійкових логарифмівЗавантаження... для тисяч потенційних розбиттів. Обчислення логарифма на процесорі вимагає набагато більше ресурсів.Формула Джині потребує лише простого піднесення часток до квадрата (Завантаження...). Завдяки цьому Gini рахується швидше, а отримані дерева у більшості випадків практично не відрізняються від дерев за ентропією.Information Gain: вибір найкращого запитання
Коли дерево тестує запитання, воно оцінює Information Gain (Приріст інформації) — різницю між ентропією батьківського вузла та зваженою сумою ентропій дочірніх гілок:
Правило алгоритму: З усіх можливих запитань обирається те, яке забезпечує максимальний Information Gain (найсильніше зменшує хаос).
На анімації наочно показано, як алгоритм CART сканує вісь значень неперервної ознаки:
- Зліва направо рухається жовтий поріг Завантаження...: При кожному кроці вибірка ділиться на ліву групу (Завантаження...) та праву групу (Завантаження...).
- Перерахунок ентропії (знизу праворуч): Якщо поріг розрізає скупчення навпіл, ентропія в обох гілках залишається високою (багато суміші класів). Коли поріг точно відокремлює сині точки від червоних, ентропія різко спадає.
- Крива Information Gain (зверху праворуч): Алгоритм відстежує приріст інформації для кожної координати. Зелена зірочка позначає глобальний пік — ідеальний числовий поріг, який дерево обере як умову в цьому вузлі.
# Порівняння двох варіантів розбиття вибірки з 10 квартир (5 дорогих, 5 дешевих)
initial_counts = [5, 5]
h_before = entropy(initial_counts)

# Варіант 1: "Площа > 70 м²"
left1, right1 = [4, 1], [1, 4]
h_l1, h_r1 = entropy(left1), entropy(right1)
weighted_h1 = (5/10) * h_l1 + (5/10) * h_r1
ig1 = h_before - weighted_h1

# Варіант 2: "Кімнати >= 3"
left2, right2 = [5, 2], [0, 3]
h_l2, h_r2 = entropy(left2), entropy(right2)
weighted_h2 = (7/10) * h_l2 + (3/10) * h_r2
ig2 = h_before - weighted_h2

print(f"Початкова ентропія: {h_before:.4f}")
print(f"Варіант 1 (Площа > 70):   IG = {ig1:.4f}")
print(f"Варіант 2 (Кімнати >= 3): IG = {ig2:.4f}")
print(f"Переможець: {'Варіант 2' if ig2 > ig1 else 'Варіант 1'} (максимізує приріст інформації)")
| Критерій розбиття | Ліва гілка | Права гілка | Зважена ентропія Завантаження... | Information Gain (Завантаження...) | Статус вибору |
|---|---|---|---|---|---|
| Початковий стан (до розбиття) | — | — | 1.0000 | — | Базовий стан вибірки |
Варіант 1: Площа > 70 м² | [4, 1] (Завантаження...) | [1, 4] (Завантаження...) | 0.7219 | 0.2781 | Відхилено (менший приріст інформації) |
Варіант 2: Кімнати >= 3 | [5, 2] (Завантаження...) | [0, 3] (Завантаження...) | 0.6042 | 0.3958 | 🏆 Обрано алгоритмом (найбільший Завантаження...) |
Як дерево обирає розбиття для регресії: Дисперсія та середнє значення
Тепер поглянемо, як дерево працює в задачі регресії, коли цільове значення Завантаження... є неперервним числом (ціна квартири, температура тощо).
Для чисел немає окремих класів, тому ентропію тут застосувати не вийде.
Що містить листок регресійного дерева?
У регресії прогноз листка — це звичайне середнє арифметичне всіх тренувальних прикладів, які потрапили в цей листок:
Якщо в листок потрапили три будинки з цінами 40 000 $, 45 000 $ та 50 000 $, модель передбачить для будь-якого нового об'єкта в цьому листку середнє значення: 45 000 $.
Критерій розбиття: мінімізація середньоквадратичної помилки (MSE)
Що є мірою «хаосу» та розкиду для чисел? Дисперсія (Variance) або середньоквадратична помилка (MSE) відносно середнього значення:
Дерево регресії шукає таке розбиття, яке мінімізує зважену суму MSE лівої та правої гілок:
Ключові висновки з динаміки апроксимації:
- Шматочково-постійна форма (Piecewise Constant): Регресійне дерево ніколи не проводить нахилених ліній, як лінійна регресія. Його прогноз — це набір горизонтальних сходинок (середніх значень у кожному відрізку).
- Зниження дисперсії та MSE: На нульовій глибині (Завантаження...) дерево прогнозує єдине середнє для всієї вибірки. Із кожним новим розбиттям ширина сегментів зменшується, сходинки точніше огинають нелінійну хвилю, а сумарна помилка MSE стрімко падає.
- Ризик при великій глибині: При Завантаження... сходинок стає занадто багато — дерево починає повторювати кожну окрему шумну точку вимірювання (перенавчання).
Як алгоритм знаходить числові пороги (наприклад, «Дохід <= 5.09»)?
Як алгоритм визначає конкретне числове порогове значення серед тисяч чисел? Розглянемо міні-приклад із 4 навчальними квартирами:
| Спостереження | Площа квартири (Завантаження..., м²) | Реальна вартість (Завантаження..., тис. $) |
|---|---|---|
| 1 | 40 | 60 |
| 2 | 60 | 70 |
| 3 | 80 | 110 |
| 4 | 100 | 130 |
Покроковий пошук порогу розбиття:
- Сортування ознаки: Дані сортуються за зростанням площі:
[40, 60, 80, 100]. - Пошук можливих порогів: Беремо середнє значення між кожною парою сусідніх чисел:
- Поріг 1: Завантаження...
- Поріг 2: Завантаження...
- Поріг 3: Завантаження...
- Оцінка кандидатів: Для кожного порогу алгоритм ділить 4 будинки на дві групи, обчислює середні прогнози та вимірює сумарну помилку MSE.
- Вибір найкращого: Поріг
70 м²чітко відокремлює дешеві будинки[60, 70]від дорогих[110, 130], забезпечуючи мінімальну дисперсію. Він і стає умовою розбиття у вузлі!
Саме так дерево знаходить поріг MedInc <= 5.09 для датасету California Housing, перевіривши всі проміжні значення впорядкованої колонки доходів.
Геометрична природа рішень: прямокутні сходинки
Важливо розуміти, як саме дерева рішень геометрично бачать і розділяють простір ознак.
На відміну від лінійних моделей, які проводять суцільні похилі гіперплощини (Завантаження...), дерево рішень порівнює лише одну ознаку з одним числовим порогом у кожному окремому вузлі (Завантаження...).
Через це межі рішень дерева на графіку завжди є прямими лініями, строго паралельними до осей координат (під прямим кутом).
Уявіть кухаря, якому дозволено різати піцу лише двома типами рухів: строго вертикально або строго горизонтально від краю до краю. Він фізично не може зробити плавний круглий чи похилий діагональний надріз. Будь-яка складна фігура виходить у нього складеною з прямокутних шматочків-сходинок. Саме так алгоритм CART розрізає простір ознак!
Динаміка розбиття 2D-простору та зростання дерева
Щоб наочно побачити взаємозв'язок між графічною геометрією та структурою вузлів, подивіться на динамічну анімацію процесу навчання: ліворуч алгоритм крок за кроком розрізає площину ознак «Площа — Відстань» на прямокутні сектори, а праворуч синхронно формує відповідний граф CART-дерева:
Зверніть увагу на важливі геометричні та алгоритмічні закономірності на анімації:
- Початковий стан (Крок 0): Усі 52 приклади зібрані разом у неподіленому просторі. У дереві праворуч існує лише корінь, який аналізує всі можливі порогові кандидати для вибору найчистішого першого розбиття.
- Перша умова в корені (Розбиття 1): Алгоритм обирає перевірку Завантаження.... На площині з'являється вертикальна лінія-ніж, що ділить простір на ліву зону (компактні квартири) та праву зону (просторі). У дереві додаються дві головні гілки.
- Локальність наступних розбиттів (Розбиття 2 та 3): Лінії більше не перетинають увесь простір наскрізь! У лівій зоні горизонтальний розріз Завантаження... ділить лише компактні квартири, а в правій зоні умова Завантаження... ділить лише просторі. Кожен внутрішній вузол оперує виключно своєю локальною підмножиною даних.
- Формування областей рішень (Decision Regions): Простір остаточно покривається 4 прямокутними комірками сітки. Кожна комірка закріплюється за окремим листком дерева (червоний = Дорога, блакитний = Дешева).
- Передбачення для нового об'єкта (спуск по дереву): Коли з'являється новий будинок (наприклад, Об'єкт А: Завантаження...), він потрапляє в червоний нижній прямокутник. Праворуч на схемі дерева золотистим сяйвом підсвічується точний ланцюжок перевірок:
Корінь ➔ Вузол 2 ➔ Листок 1із фінальним передбаченням класу.
🟩 Сходинчаста форма меж
Дерево розрізає простір ознак на сітку прямокутників (або багатовимірних блоків). Усередині кожної такої області модель видає одне стале число (константу).
Якщо реальна залежність у природі є плавною лінією (Завантаження...), дерево намагається наблизити її сходинками.
🚫 Нездатність до екстраполяції (прогнозу поза межами)
Оскільки кожен листок прогнозує середнє значення своїх прикладів, дерево ніколи не видасть число, більше за максимум у тренувальних даних:
Навіть якщо на вхід надійде вілла площею 10 000 м², дерево відправить її в крайній листок і видасть середнє значення найбільших будинків із тренувального набору.
Рекурсивний алгоритм побудови дерева (Алгоритм CART)
Дерево будується покроково за допомогою жадібного алгоритму CART (Classification and Regression Trees): на кожному кроці алгоритм шукає найкраще розбиття тут і зараз, не заглядаючи наперед.
Покрокова побудова дерева на Python:
class TreeNode:
    def __init__(self, is_leaf=False, prediction=None, question=None, left=None, right=None, samples=0, entropy=0.0):
        self.is_leaf = is_leaf
        self.prediction = prediction
        self.question = question
        self.left = left
        self.right = right
        self.samples = samples
        self.entropy = entropy

def build_tree_demo(node_name, samples, expensive, cheap, depth, max_depth=2):
    total = expensive + cheap
    p1 = expensive / total if total > 0 else 0
    p2 = cheap / total if total > 0 else 0

    h = -sum(p * np.log2(p) for p in [p1, p2] if p > 0)
    indent = "    " * depth

    if h == 0.0:
        label = "ДОРОГА" if expensive > 0 else "ДЕШЕВА"
        print(f"{indent}🍃 [{node_name}] Чистий листок -> Прогноз: {label} (N={total}, H=0.0)")
        return TreeNode(is_leaf=True, prediction=label, samples=total, entropy=h)

    if depth >= max_depth:
        majority = "ДОРОГА" if expensive >= cheap else "ДЕШЕВА"
        print(f"{indent}🛑 [{node_name}] Ліміт max_depth={max_depth} -> Прогноз: {majority} (N={total}, H={h:.4f})")
        return TreeNode(is_leaf=True, prediction=majority, samples=total, entropy=h)

    if depth == 0:
        question = "Кімнати >= 3"
        print(f"{indent}🌳 [{node_name}] N={total}, H={h:.4f} -> Обрано спліт: '{question}'")
        left_node = build_tree_demo("Ліва гілка (Так)", 7, 5, 2, depth + 1, max_depth)
        right_node = build_tree_demo("Права гілка (Ні)", 3, 0, 3, depth + 1, max_depth)
    else:
        question = "Площа > 75 м²"
        print(f"{indent}🌿 [{node_name}] N={total}, H={h:.4f} -> Обрано спліт: '{question}'")
        left_node = build_tree_demo("Підгілка (Так)", 4, 4, 0, depth + 1, max_depth)
        right_node = build_tree_demo("Підгілка (Ні)", 3, 1, 2, depth + 1, max_depth)

    return TreeNode(is_leaf=False, question=question, left=left_node, right=right_node, samples=total, entropy=h)

print("=== Симуляція рекурсивного розбиття CART ===")
root = build_tree_demo("Корінь", 10, 5, 5, depth=0, max_depth=2)
Регресія на практиці: DecisionTreeRegressor у scikit-learn
Перейдемо до навчання моделі регресії на реальних даних вартості житла в Каліфорнії (California Housing):
import numpy as np
import pandas as pd
from sklearn.datasets import fetch_california_housing
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeRegressor
from sklearn.metrics import r2_score, mean_absolute_error, mean_squared_error

# Завантаження датасету California Housing
data = fetch_california_housing(as_frame=True)
X = data.data
y = data.target

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# Навчання базового дерева з фіксованою глибиною max_depth=5
model = DecisionTreeRegressor(max_depth=5, random_state=42)
model.fit(X_train, y_train)

y_train_pred = model.predict(X_train)
y_test_pred = model.predict(X_test)

r2_train = r2_score(y_train, y_train_pred)
r2_test = r2_score(y_test, y_test_pred)
mae_test = mean_absolute_error(y_test, y_test_pred)
rmse_test = np.sqrt(mean_squared_error(y_test, y_test_pred))

print("📊 Метрики DecisionTreeRegressor (max_depth=5):")
print(f"  R² train: {r2_train:.4f}")
print(f"  R² test:  {r2_test:.4f}")
print(f"  MAE test: {mae_test:.4f} (~${mae_test*100000:,.0f})")
print(f"  RMSE test: {rmse_test:.4f}")
print(f"  Різниця Train-Test (Gap): {r2_train - r2_test:.4f}")
| Метрика якості моделі | Навчальна (Train) | Тестова (Test) | Різниця (Gap) | Інтерпретація |
|---|---|---|---|---|
| Коефіцієнт детермінації (Завантаження...) | 0.6377 | 0.5997 | +0.0379 | Модель пояснює ~60% коливань цін житла |
| Середня абсолютна помилка (MAE) | 0.5063 | 0.5223 | +0.0160 | Середня похибка становить ~$52,230 |
| Корінь із середньоквадратичної (RMSE) | 0.6959 | 0.7242 | +0.0283 | Помірний розкид помилок на тесті |
Візуалізація та розбір вузлів дерева
Головна перевага дерева — можливість наочно побачити кожне його правило за допомогою функції plot_tree:
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

feature_names_ua = [
    'Медіанний дохід', 'Вік будинку', 'Кількість кімнат', 'Кількість спалень',
    'Населення', 'Середня заселеність', 'Широта', 'Довгота'
]

model_small = DecisionTreeRegressor(max_depth=3, random_state=42)
model_small.fit(X_train, y_train)

plt.figure(figsize=(22, 11))
plot_tree(
    model_small,
    feature_names=feature_names_ua,
    filled=True,
    rounded=True,
    fontsize=10,
    precision=2
)
plt.title('Дерево рішень для регресії (California Housing, max_depth=3)', fontsize=18, fontweight='bold')
plt.tight_layout()
plt.show()
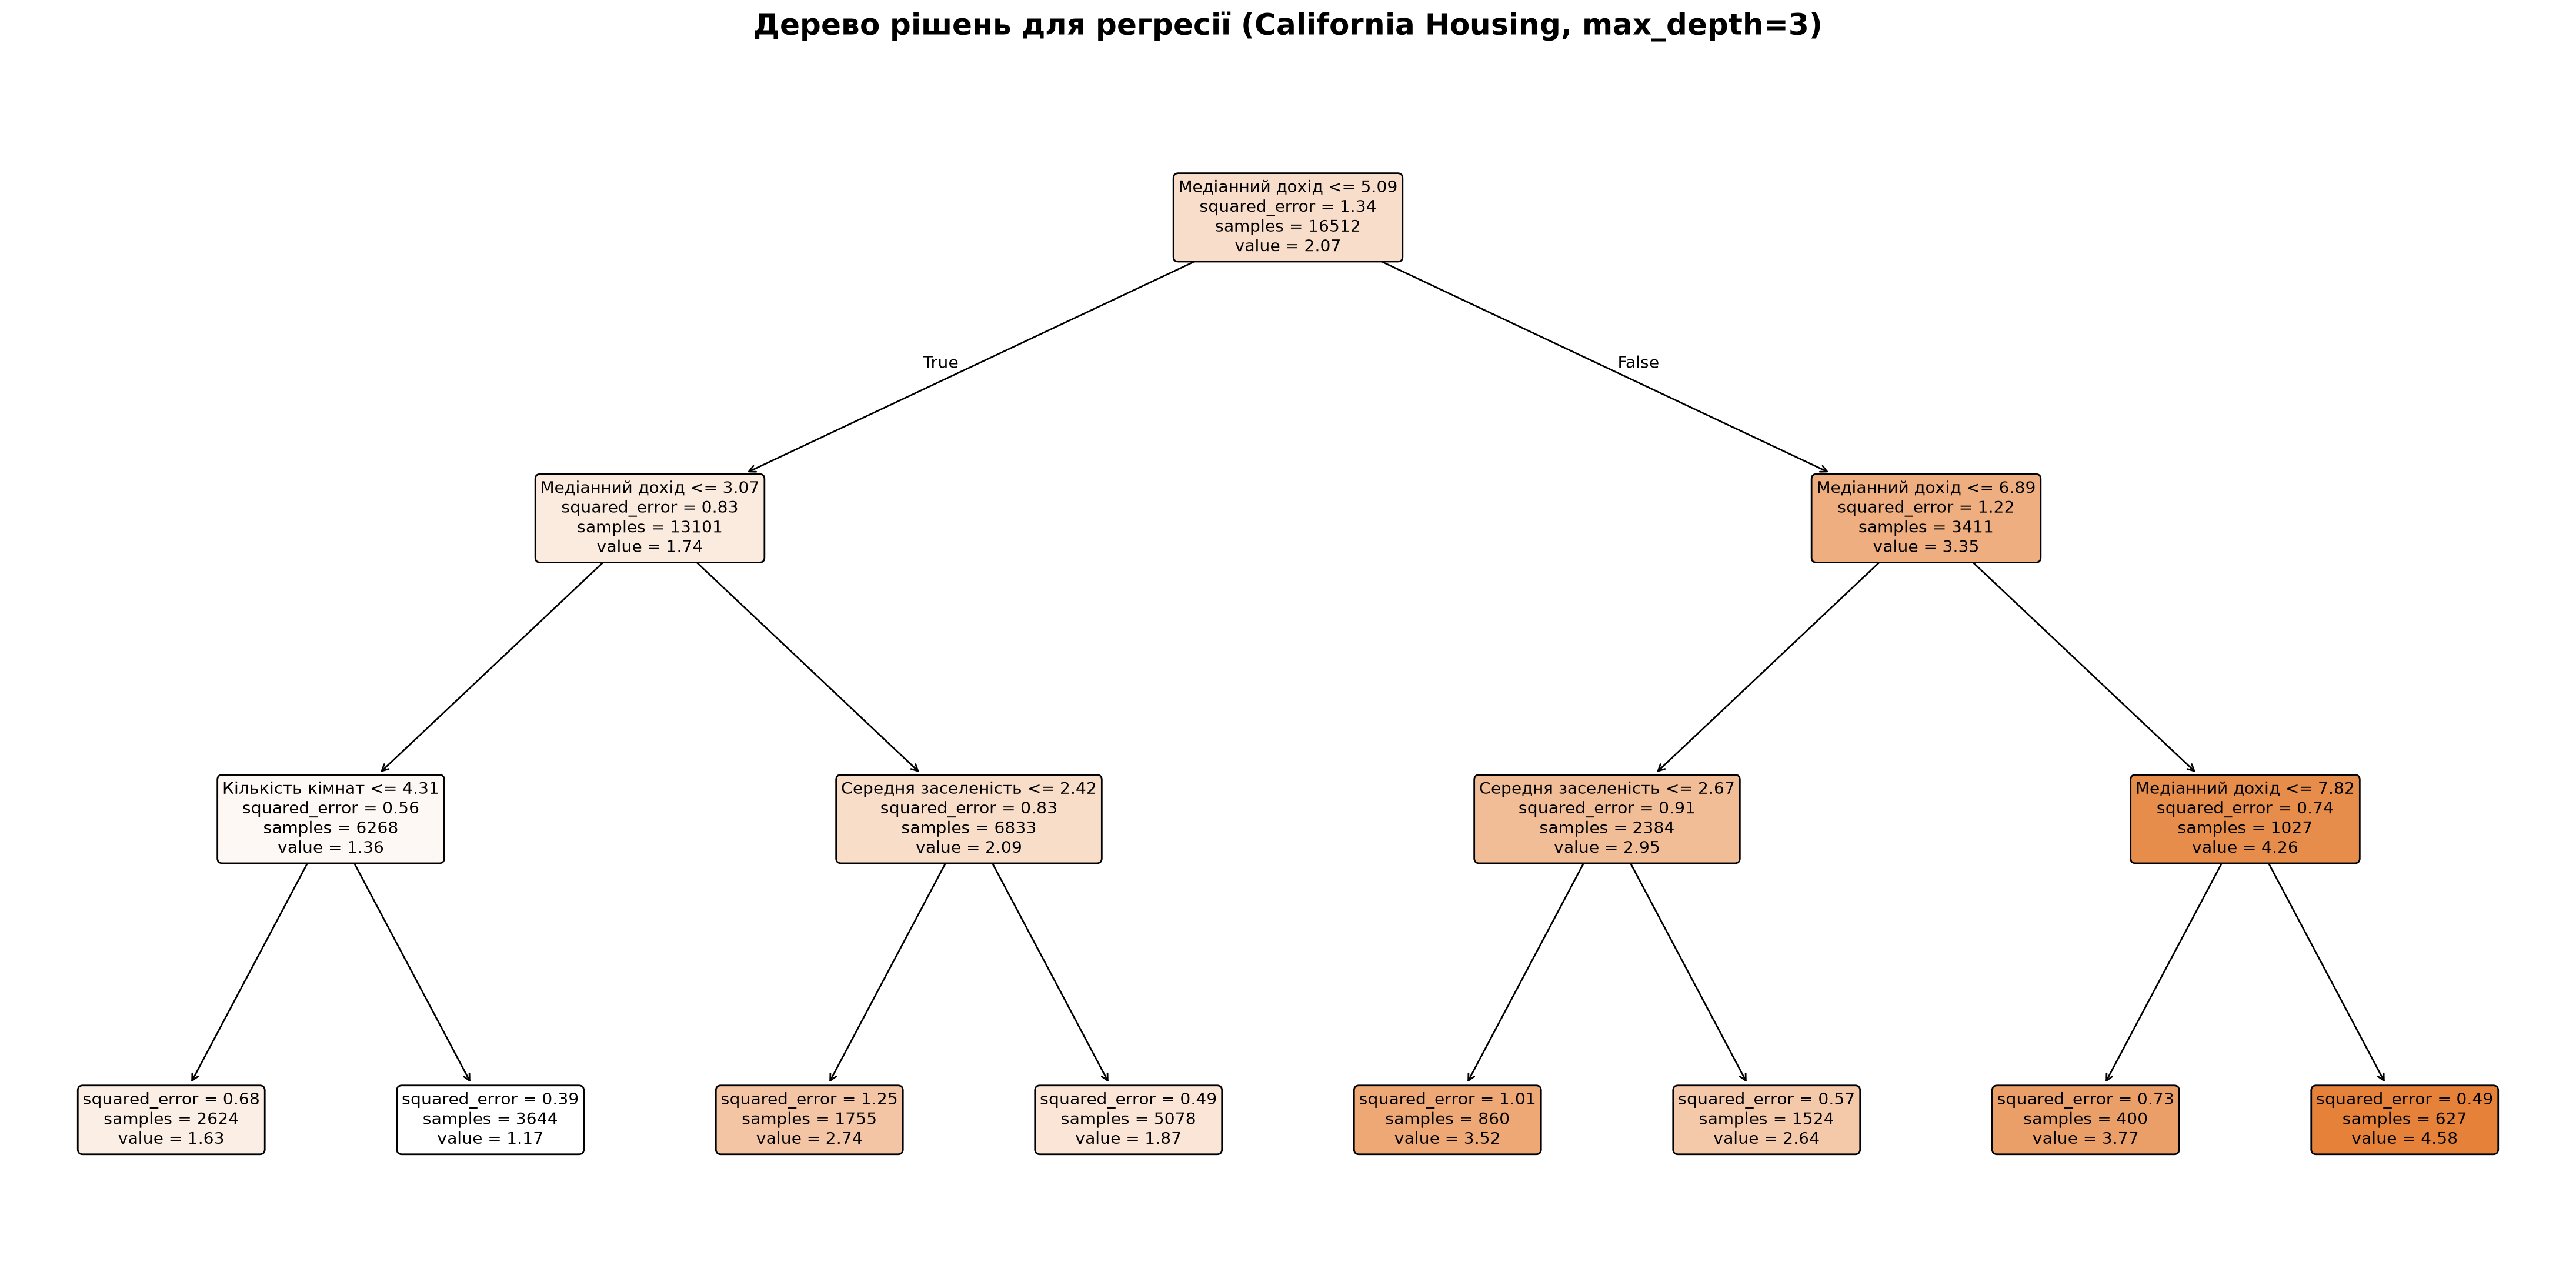
| Елемент вузла дерева | Значення у блоці | Практичний зміст |
|---|---|---|
| Критерій розбиття | Медіанний дохід <= 5.09 | Перше вирішальне питання для розділення кварталів |
| Критерій неоднорідності | squared_error = 1.34 | Середньоквадратична помилка / дисперсія ціни у вузлі |
| Кількість спостережень | samples = 16512 | Кількість зразків тренувальної вибірки у цьому вузлі |
| Передбачення (value) | value = 2.07 | Середня вартість житла (~$207,000), що є прогнозом |
Як читати кожен прямокутник на діаграмі:
- Перший рядок (
Медіанний дохід <= 5.09): Умова розбиття. Якщо для кварталу умова істинна — переходимо в ліву гілку, якщо ні — в праву. - Другий рядок (
squared_error = 1.34): Поточний розкид (дисперсія помилки) серед цін квартир у цьому вузлі. - Третій рядок (
samples = 16512): Скільки прикладів потрапило до цього вузла. - Четвертий рядок (
value = 2.07): Прогноз! Це середня ціна (у сотнях тисяч доларів, тобто $207,000) для об'єктів вузла.
Чому дерево перенавчається та як це обмежити
Чому ми штучно обмежили глибину дерева параметром max_depth=5? Що станеться, якщо дозволити дереву рости без жодних обмежень (max_depth=None)?
depths = [1, 3, 5, 10, None]
results = []

for depth in depths:
    m = DecisionTreeRegressor(max_depth=depth, random_state=42)
    m.fit(X_train, y_train)

    r2_tr = m.score(X_train, y_train)
    r2_te = m.score(X_test, y_test)

    results.append({
        'max_depth': str(depth),
        'R² train': r2_tr,
        'R² test': r2_te,
        'Gap': r2_tr - r2_te
    })

df_res = pd.DataFrame(results)
print(df_res.to_string(index=False))
Глибина (max_depth) | Завантаження... | Завантаження... | Розрив (Завантаження...) | Діагностика стану моделі |
|---|---|---|---|---|
1 | 0.3170 | 0.2795 | 0.0375 | ⚠️ Недонавчання (Underfitting) — надто просте дерево з одного питання (decision stump) |
3 | 0.5379 | 0.5098 | 0.0281 | 🟢 Проста і зрозуміла модель, але ще занадто груба |
5 | 0.6377 | 0.5997 | 0.0379 | 🟢 Гарний базовий баланс швидкості та якості |
10 | 0.8348 | 0.6822 | 0.1526 | 🟡 Початок перенавчання — Train різко відривається від Test |
None (без обмежень) | 1.0000 | 0.6161 | 0.3839 | 🔴 Катастрофічне перенавчання (Overfitting) — модель завчила шум |
При max_depth=None дерево продовжує ділитися доти, доки в кожному листку не залишиться буквально по 1 будинку. Воно ідеально зазубрило тренувальні дані (Завантаження...), але різниця в точності між навчанням і тестом склала аж 38.4% (модель перенавчилася)!
Як зміна глибини трансформує простір рішень (зліва) та криву помилок (справа):
- Глибина 1–2 (Недонавчання / High Bias): Занадто проста межа (одна-дві прямі лінії). Помилка висока як на навчанні, так і на тесті.
- Глибина 3 (Оптимальна точка / Sweet Spot): Акуратні прямокутні блоки охоплюють реальну форму розподілу. Помилка на тестових даних (Завантаження...) мінімальна.
- Глибина 8–14 (Критичне перенавчання / High Variance): Межа рішень розпадається на хаотичну мозаїку. Дерево створило індивідуальні прямокутні «кишені» навколо кожного окремого шумового викиду. Помилка тренування падає до 0%, а тестова помилка різко летить угору.
Параметри для обмеження росту дерева (рання зупинка):
max_depth(Глибина дерева): Обмежує довжину найдовшої гілки від кореня до листка.min_samples_split: Скільки щонайменше прикладів має бути у вузлі, щоб йому дозволили ділитися далі.min_samples_leaf: Скільки щонайменше прикладів зобов'язано залишитися в кожному новому листку.
Пошук оптимальної глибини: крива валідації
Побудуємо криву зміни якості для глибин від 1 до 20:
depths_range = list(range(1, 21))
train_scores = []
test_scores = []

for depth in depths_range:
    m = DecisionTreeRegressor(max_depth=depth, random_state=42)
    m.fit(X_train, y_train)
    train_scores.append(m.score(X_train, y_train))
    test_scores.append(m.score(X_test, y_test))

opt_depth = depths_range[int(np.argmax(test_scores))]
print(f"Оптимальна глибина: {opt_depth} | Максимальний R² test: {max(test_scores):.4f}")
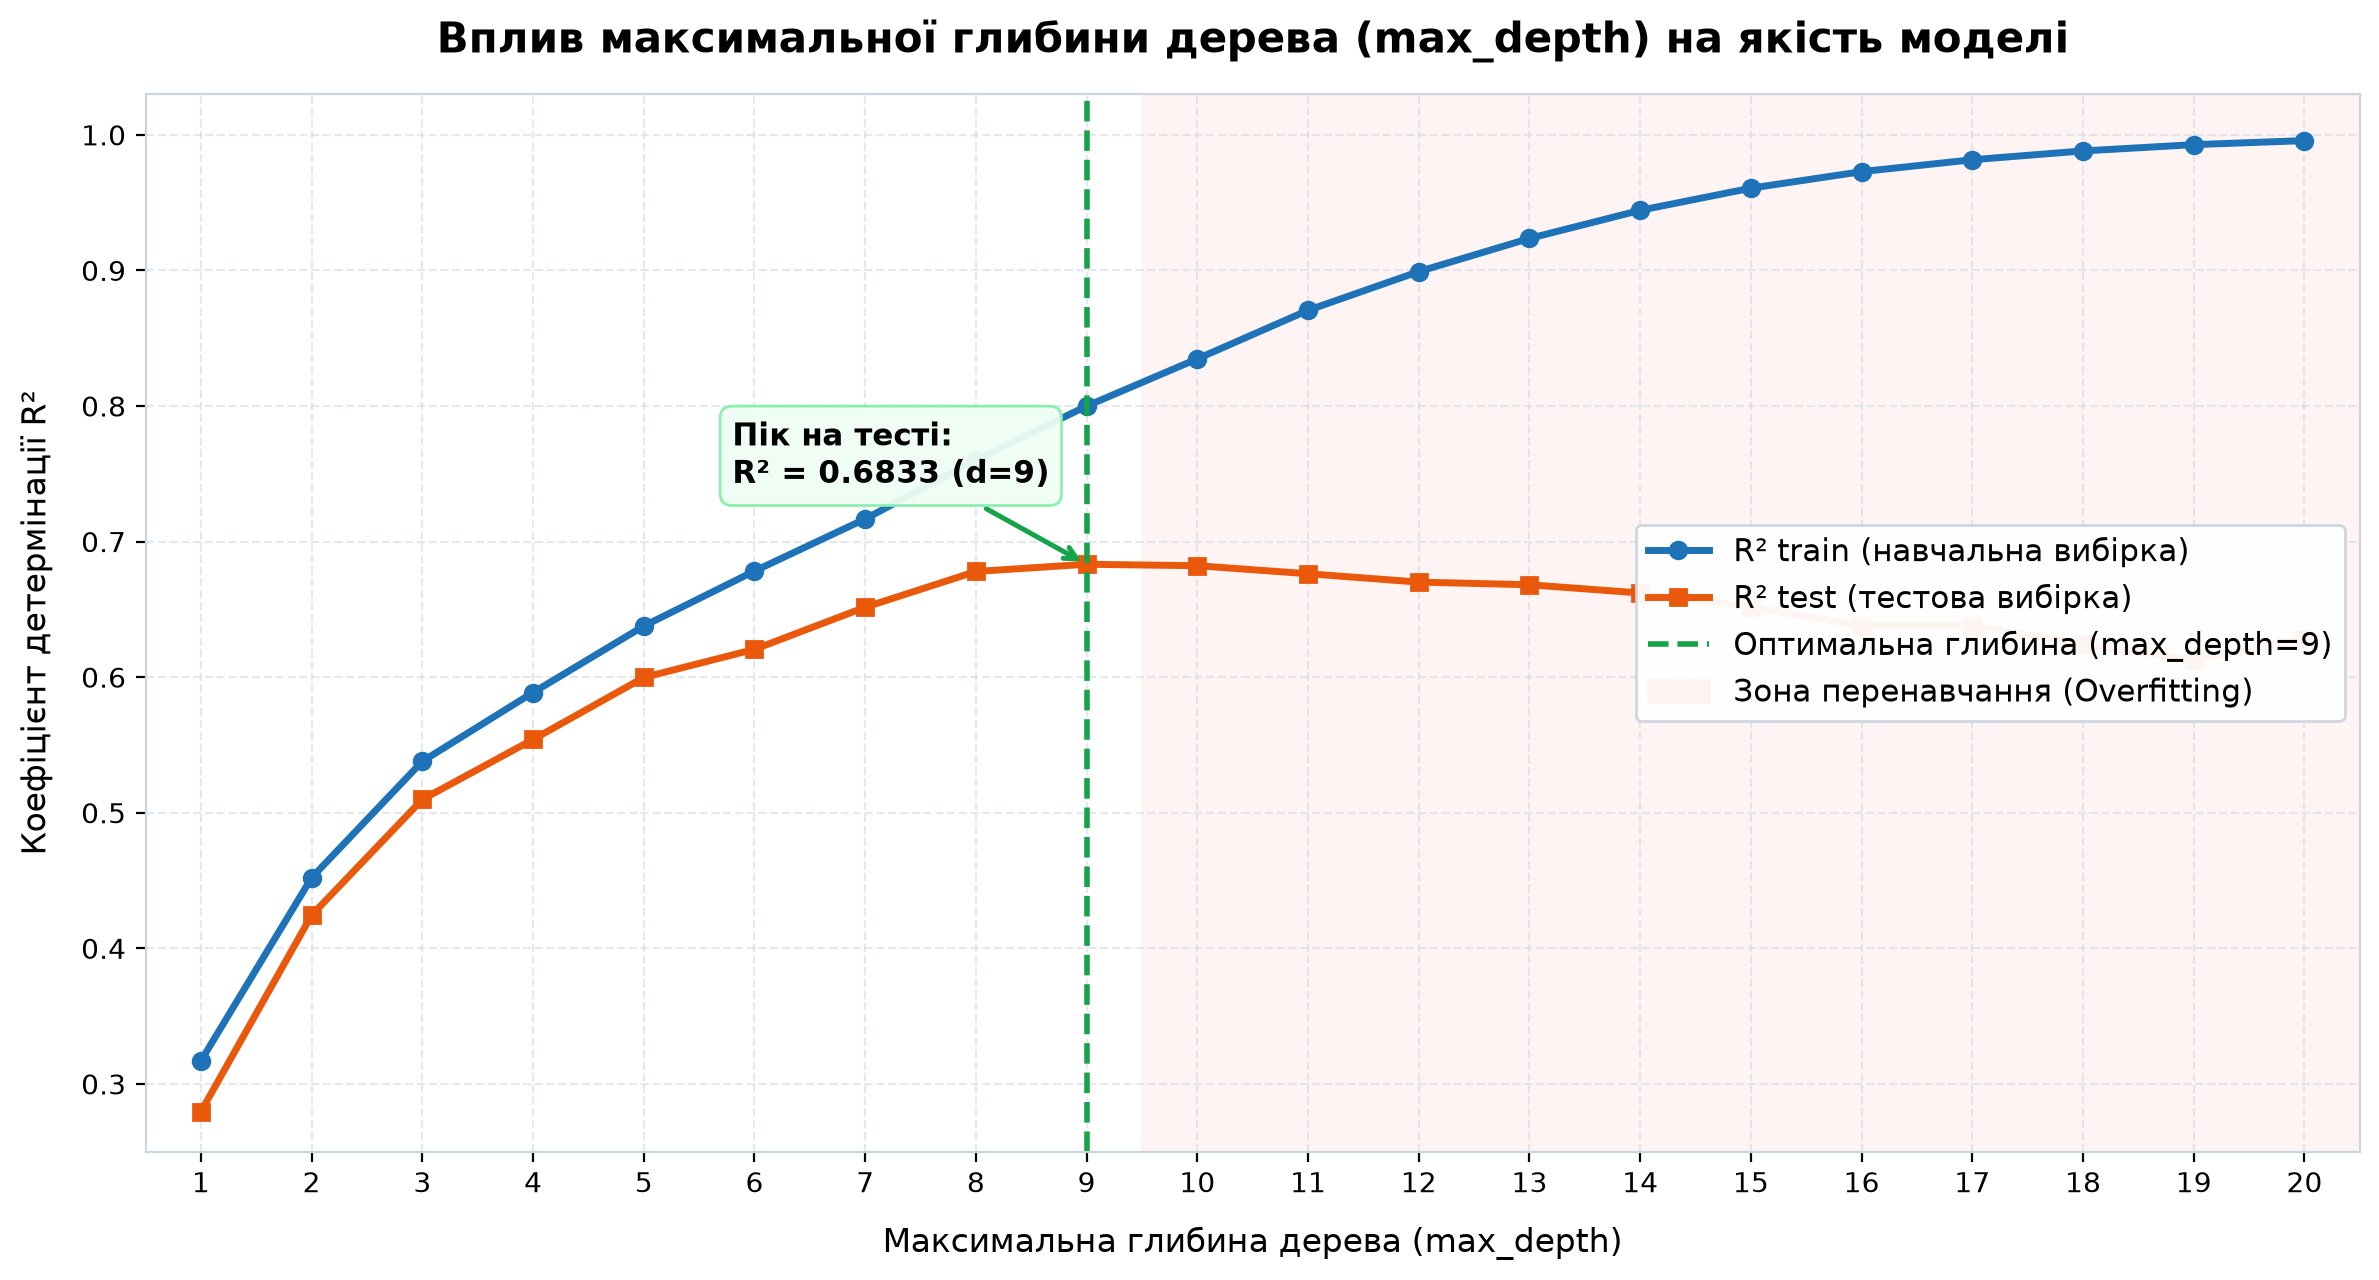
| Параметр кривої валідації | Оптимальне значення | Коментар |
|---|---|---|
Оптимальна глибина (max_depth) | 9 | Точка глобального максимуму точності на тестовій вибірці |
| Максимальний тестовий бал (Завантаження...) | 0.6833 | Найкращий баланс між недонавчанням і перенавчанням (Bias-Variance tradeoff) |
| Початок зони перенавчання | max_depth >= 10 | Test спадає з 0.68 до 0.61, тоді як Train прямує до 1.0 |
При max_depth=9 одиночне дерево рішень досягає рекордної точності Завантаження..., перевершуючи поліноміальну регресію Ridge!
Зведена таблиця моделей регресії модуля
Порівняємо всі регресійні моделі, які ми навчили на California Housing:
| Алгоритм / Модель | Навчальна якість (Завантаження...) | Тестова якість (Завантаження...) | Тестова похибка (MAE) | Зрозумілість моделі |
|---|---|---|---|---|
| LinearRegression (Базова пряма лінія) | 0.61 | 0.58 | 0.53 | ✅ Висока (ваги коефіцієнтів) |
| Ridge / Lasso (Поліноми d=2) | 0.65 | 0.64 | 0.48 | ❌ Низька (складна алгебра) |
| DecisionTree (d=None, без обмежень) | 1.00 | 0.62 | 0.49 | ❌ Перенавчене (завчений шум) |
| DecisionTree (d=5, базове зрозуміле) | 0.64 | 0.60 | 0.52 | ✅ Ідеальна (32 прозорі правила) |
| DecisionTree (d=9, оптимізоване) | 0.78 | 0.68 | 0.44 | ⚠️ Помірна (512 листків) |
Дерева для класифікації: DecisionTreeClassifier на датасеті Iris
Наостанок продемонструємо роботу дерева в задачі багатокласової класифікації на датасеті сортів ірисів Фішера (Iris dataset):
from sklearn.datasets import load_iris
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score, classification_report

iris = load_iris(as_frame=True)
X_i, y_i = iris.data, iris.target

X_train_i, X_test_i, y_train_i, y_test_i = train_test_split(
    X_i, y_i, test_size=0.3, random_state=42
)

clf = DecisionTreeClassifier(max_depth=3, random_state=42)
clf.fit(X_train_i, y_train_i)

y_pred_i = clf.predict(X_test_i)
print(f"Точність Accuracy на тесті: {accuracy_score(y_test_i, y_pred_i):.4f}\n")
print(classification_report(y_test_i, y_pred_i, target_names=iris.target_names))
| Сорт Iris (клас квітки) | Точність (Precision) | Повнота (Recall) | F1-Score | Кількість зразків (Support) |
|---|---|---|---|---|
| Iris-setosa (Сетоза) | 1.0000 | 1.0000 | 1.0000 | 19 |
| Iris-versicolor (Версиколор) | 1.0000 | 1.0000 | 1.0000 | 13 |
| Iris-virginica (Вірджиніка) | 1.0000 | 1.0000 | 1.0000 | 13 |
| Загальна точність (Accuracy) | — | — | 1.0000 | 45 |
| Macro Average | 1.0000 | 1.0000 | 1.0000 | 45 |
| Weighted Average | 1.0000 | 1.0000 | 1.0000 | 45 |
feature_names_iris_ua = [
    'Довжина чашолистка (см)', 'Ширина чашолистка (см)',
    'Довжина пелюстки (см)', 'Ширина пелюстки (см)'
]
class_names_iris_ua = ['Сетоза (Setosa)', 'Версиколор (Versicolor)', 'Вірджиніка (Virginica)']

plt.figure(figsize=(20, 10))
plot_tree(
    clf,
    feature_names=feature_names_iris_ua,
    class_names=class_names_iris_ua,
    filled=True,
    rounded=True,
    fontsize=11,
    precision=2
)
plt.title('Дерево рішень для класифікації (Датасет Iris, max_depth=3)', fontsize=18, fontweight='bold')
plt.tight_layout()
plt.show()
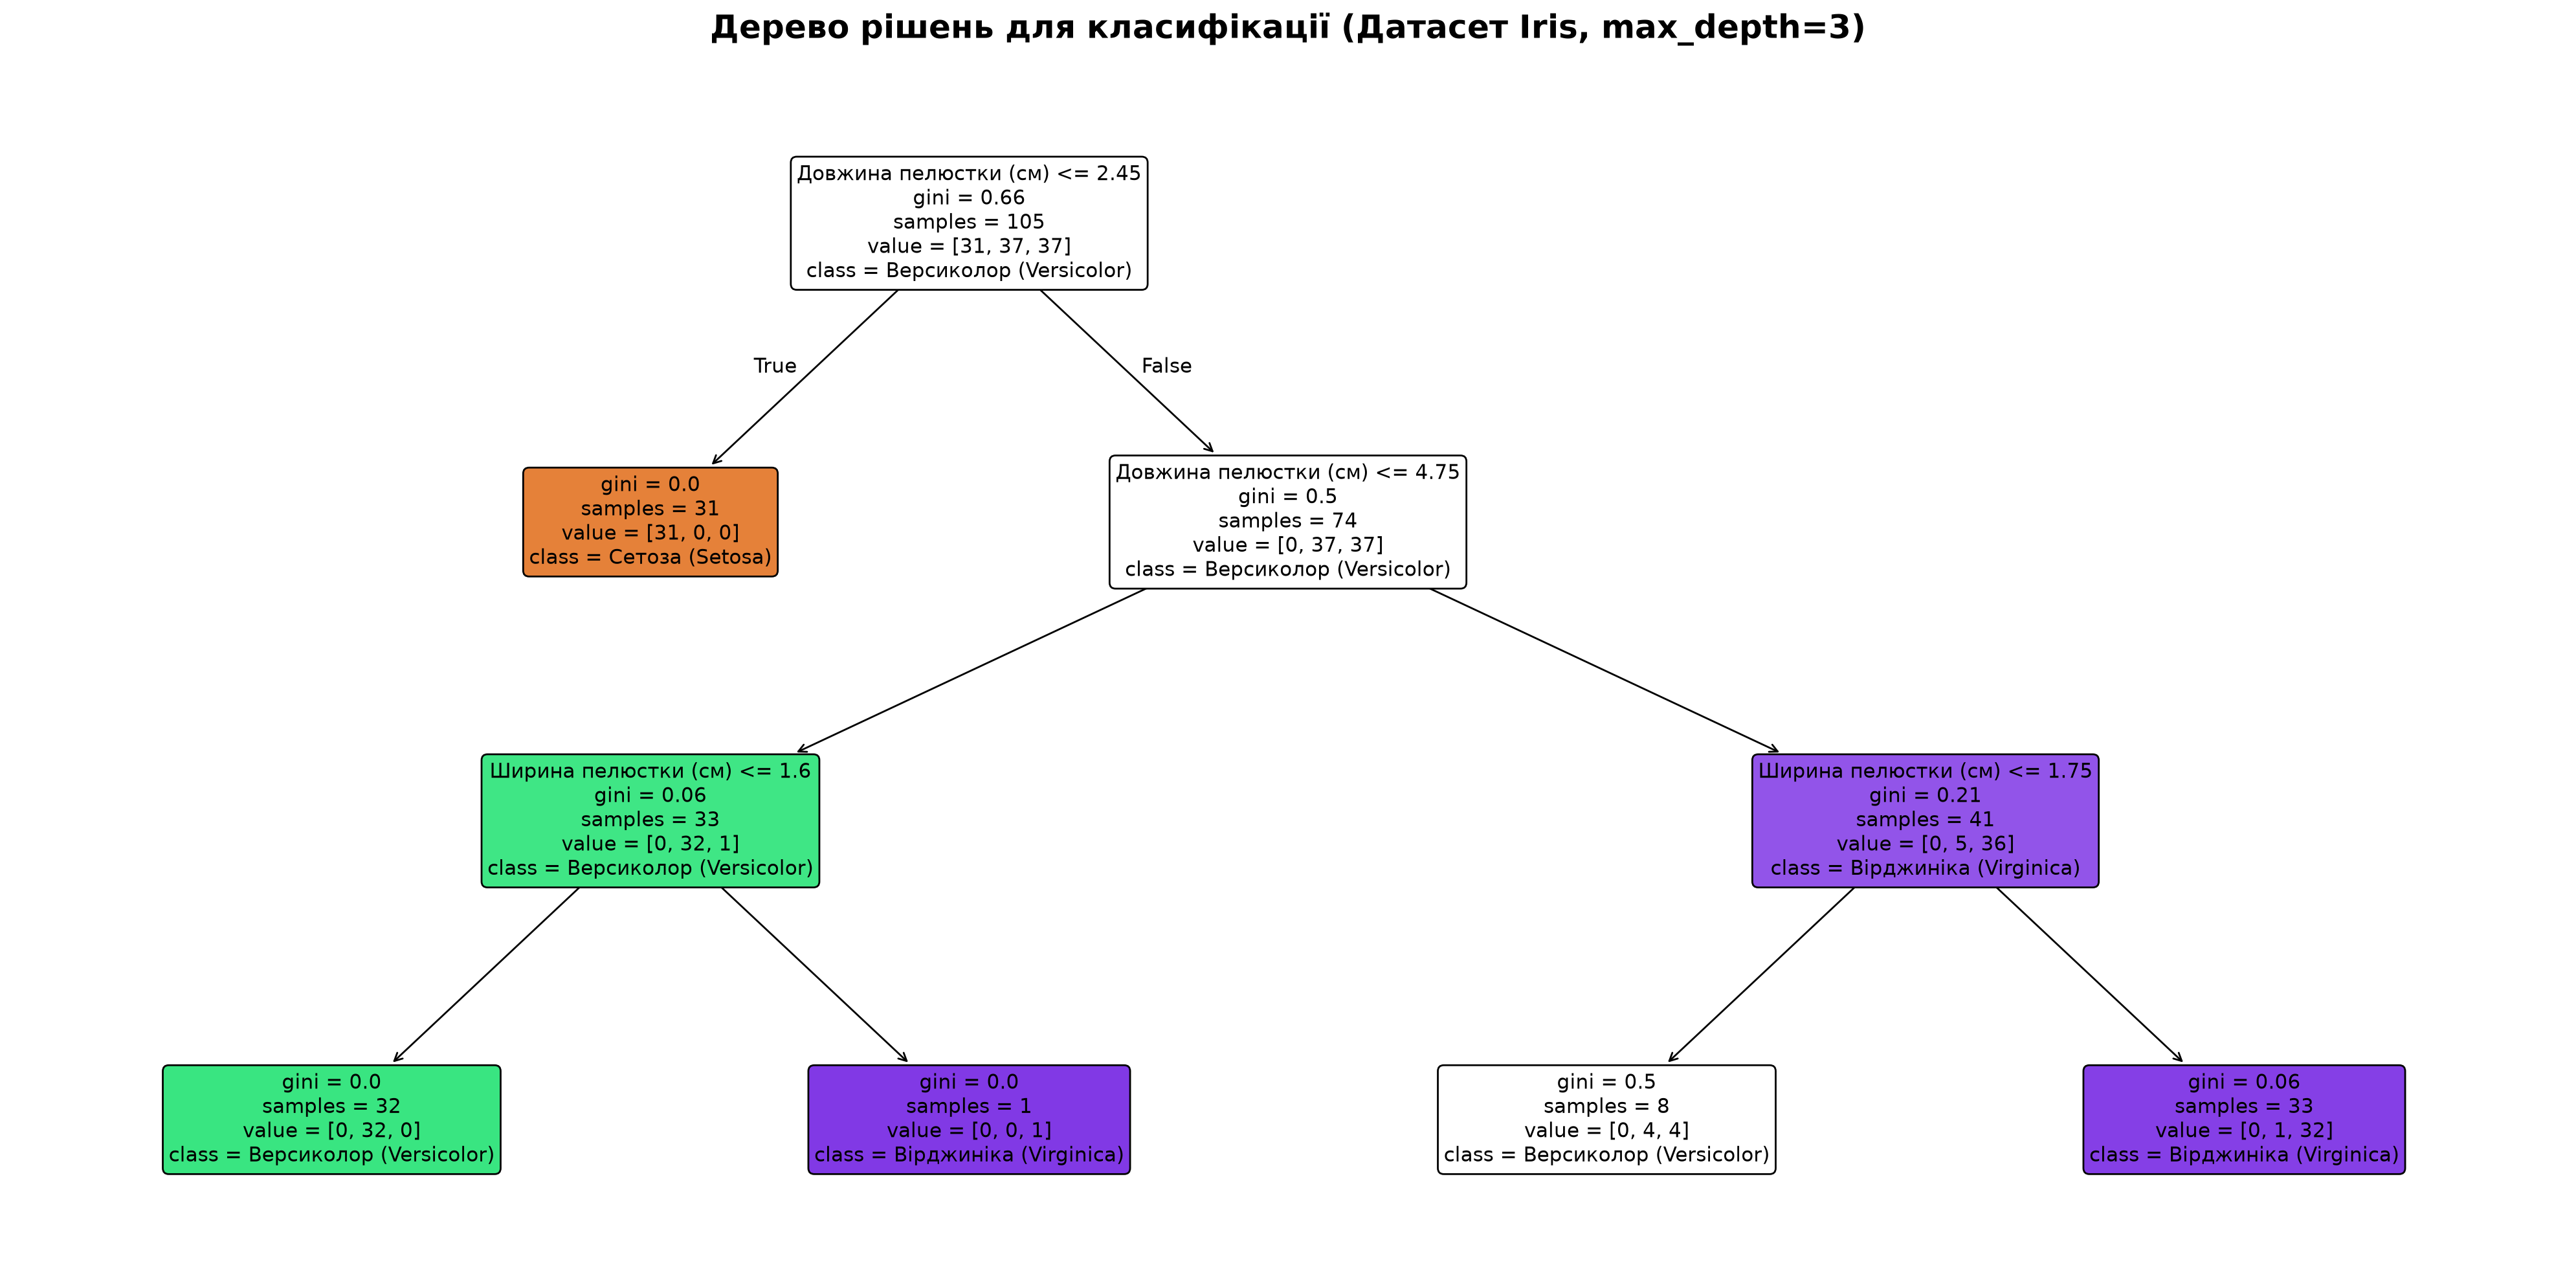
| Ознака квітки Iris | Українська назва | Роль у класифікації |
|---|---|---|
petal length (cm) | Довжина пелюстки (см) | 🌟 Ключове перше питання для миттєвого відокремлення Setosa (Завантаження...) |
petal width (cm) | Ширина пелюстки (см) | 🎯 Вирішальний поріг для розрізнення Versicolor та Virginica (Завантаження...) |
sepal length (cm) | Довжина чашолистка (см) | Додаткова характеристика квітки (не знадобилася дереву глибини 3) |
sepal width (cm) | Ширина чашолистка (см) | Додаткова характеристика квітки |
Плюси та мінуси дерев рішень
✅ Сильні сторони
- Повна зрозумілість: Логіку можна перетворити на просту блок-схему або список
if-elseправил. - Жодного масштабування: Не потрібен
StandardScaler. - Стійкість до викидів: Викиди не зсувають порогові значення всередині вузлів так сильно, як коефіцієнти регресії.
- Швидкий прогноз (інференс): Щоб отримати відповідь, потрібно лише кілька простих порівнянь «більше/менше».
❌ Слабкі сторони
- Нестабільність (висока дисперсія): Навіть невелика зміна у вибірці може кардинально змінити вигляд і структуру всього дерева.
- Схильність до перенавчання: Якщо не обмежувати глибину, дерево просто зазубрить тренувальні дані разом із шумом.
- Сходинкова форма і нездатність до екстраполяції: Модель не вміє будувати плавні лінії та виходити за межі відомого числового діапазону.
Резюме
🌳 Дерево рішень
🎲 Критерії класифікації
📉 Критерій регресії
⚙️ Регуляризація
max_depth, min_samples_split та min_samples_leaf захищає дерево від перенавчання.Практичні завдання
Мета: Навчитися читати структуру дерева рішень і перетворювати її на програмні правила.
- Завантажте датасет
California Housingта навчітьDecisionTreeRegressor(max_depth=3). - Побудуйте візуалізацію через
plot_tree. - Випишіть повний логічний шлях від кореня до листка з найвищою середньою ціною (
value). - Запишіть цей ланцюжок у вигляді звичайного умовного блоку
if/elseна Python.
Мета: Знайти оптимальний баланс складності дерева для захисту від перенавчання.
- Розбийте вибірку на
Train (80%)таTest (20%). - Проведіть ітеративне навчання з
max_depthвід 1 до 15. - Побудуйте спільний графік
R² trainтаR² test. - Визначте точку, де різниця між train і test починає різко зростати (перенавчання), та поясніть вибір оптимальної глибини.
Наступна тема: Random Forest — ансамблі дерев рішень — як об'єднання 100 різних дерев у спільне голосування прибирає нестабільність і суттєво підвищує точність.
Практика — поліноміальна регресія та регуляризація на Housing Prices
Застосування поліноміальних ознак та регуляризації на реальному датасеті Housing Prices. Повний пайплайн від EDA до порівняння моделей. Інтерпретація результатів та практичні завдання.
Random Forest — ансамблі дерев рішень
Випадковий ліс як ансамблевий метод машинного навчання. Принцип мудрості натовпу, бутстреп-агрегація (Bagging), метод випадкових підпросторів, оцінка важливості ознак та Out-of-Bag валідація.